1-虚拟化
1. 虚拟化基础
https://www.vmware.com/cn/solutions/virtualization.html
1.1. 传统的物理机部署方案
服务器选型及采购—IDC选择及上架--系统选择及安装–应用规划及部署–域名选择及注册–DNS映射–外网访问:
工信部备案-公安部备案–ICP备案(电子商务网站–>ICP证经营性ICP备案), 游戏公司文化部(文网文)备案等, 在备案没有成功之前网站是不能上线访问的, 论坛BBS有BBS公告备案是备案的前置审批, 没有的话备案不成功, 还要在公安局系统备案, 另外域名接入到一个地方比如机房还要做接入备案, 备案在个人名下的备案不能直接转公司, 个人注销后网站属于未备案状态随时可能会被封, 域名备案一般可以找代理, 因为过程比较复杂:
传统数据中心面临的问题:
服务器资源利用率低下, CPU、内存等不能共享
资源分配不合理
初始化成本高
自动化能力差
集群环境需要大量的服务器主机
2. 虚拟化
在计算机技术中 , 虚拟化(Virtualization)是一种资源管理技术, 是将计算机的各种实体资源( CPU、内存、磁盘空间、网络适配器等), 予以抽象、转换后呈现出来并可供分割、组合为一个或多个计算机配置环境, 并重新分割、重新组合, 以达到最大化合理利用物理资源的目的。
虚拟化可以提高 IT 敏捷性、灵活性和可扩展性, 同时大幅节约成本, 实现更高的工作负载移动性、更高的性能和资源可用性、自动化运维 - 这些都是虚拟化的优势, 虚拟化技术可以使 IT 部门更轻松地进行管理以及降低拥有成本和运维成本。其他优势包括:
降低资金成本和运维成本。
最大限度减少或消除停机。
提高 IT 部门的工作效率、效益、敏捷性和响应能力。
加快应用和资源的调配速度。
提高业务连续性和灾难恢复能力。
简化数据中心管理。
真正的 Software-Defined Data Center 的可用性。
虚拟化的由来
1964年, IBM推出了专为
System/360 Mainframe量身订造的操作系统CP-40, 首次实现了虚拟内存和虚拟机。1967 年, 第一个管理程序(
hypervisor)诞生, 5年之后, IBM 发布用于创建灵活大型主机的虚拟机(VM)技术, 该技术可根据动态的需求快速而有效地使用各种资源。从此, 虚拟化这一词汇正式被引入了IT的现实世界。20世纪 90 年代 Windows 的广泛使用以及 Linux 作为服务器系统的出现奠定了 x86 服务器的行业标准地位。
1998年
VMware公司在美国成立, 1999年VMware发布了它的第一款产品VMware Workstation、 2001年发布VMware GSX Server和VMware ESXI Server宣布进入服务器虚拟化市场, 2003年VMware推出了VMware Virtual Center, 2004年推出了64位支持版本, 同年被EMC收购, 2013年收入52.1亿美元。2007年8月21日, 思杰宣布5亿美元收购
XenSource公司, 并推出服务器虚拟化XenServer、桌面虚拟化XenDesktop和应用虚拟化XenApp, 2013年收入29亿美元。2008年3月13日微软在北京发布
Windows Server 2008, 内置虚拟化技术hyper-v。2008年9月, 红帽以1.07亿美元的价格收购KVM的母公司
Qumranet, 并推出企业级虚拟化解决方案RHEV, 目前最新版本3.3, 2013年收入超过13亿美元

在一般的计算机中, 按照冯诺依曼的计算机架构而言, 一般的计算机有五部分组成:运算器, 存储器, 控制器以及输入输出设备。因此虚拟化的本事也是对这五个部分的虚拟化。
2.1 内存虚拟化
对于内存而言 , 假设一个程序有4G的内存空间 , 程序在运行过程中会随机调用4G空间中的任意内存地址 , 此时这样的空间叫做线性地址内存空间。这个时候底层物理地址空间可能只有1G内存地址与之对应。程序员引用时都是引用线性地址空间中的地址,之后由内核转为物理内存中的地址。因此系统会将实际的内存空间切成N片,将每一片按照空间大小, 分别分配给进程使用。
虚拟地址映射为物理地址这个过程是由MMU(Memory Management Unit)硬件提供的。MMU是Memory Management Unit的缩写, 中文名是内存管理单元, 有时称作分页内存管理单元(英语:paged memory management unit, 缩写为PMMU)。它是一种负责处理中央处理器(CPU)的内存访问请求的计算机硬件。它的功能包括虚拟地址到物理地址的转换(即虚拟内存管理)、内存保护、中央处理器高速缓存的控制, 在较为简单的计算机体系结构中, 负责总线的仲裁以及存储体切换(bank switching, 尤其是在8位的系统上)。
为了加快MMU规则匹配的处理过程, 有效地址和实际物理地址的对应表通常保存在一块单独的高速缓存中, 称为对应查找表(Translation Lookaside Buffer, TLB), TLB和实际物理存储器可以同时进行并行的访问。有效地址的高位作为在TLB进行匹配查找的依据, 而有效地址的低位作为页面内的偏址。此时TLB也算是映射过程中的一种缓存机制。
因此对于虚拟机而言,当虚拟机使用内存时,由于虚拟机本身认为自己运行在实际的硬件地址之上, 所以虚拟机需要做两次地址映射,第一次由虚拟机中虚拟地址空间映射到模拟软件的内存空间中,这个过程需要使用软件模拟一个MMU来实现, 第二次由模拟软件的地址空间映射到实际的宿主机内存地址空间中,这个过程由硬件的MMU 实现。
上述所说的内存虚拟方式在映射过程中,映射了两次地址空间, 这样的效率明显不高, 所以直接由虚拟机的虚拟内存线性地址空间映射至宿主机物理内存地址空间, 这个过程由软件直接模拟出一个MMU出来实现, 此时这个软件模拟的MMU叫做影子MMU。之后在CPU的硬件上直接实现了这个功能,AMD 中叫做NPT,Intle叫做EPT。
如果A,B两个虚拟机从虚拟机的同一个位置访问物理地址 , 这个时候TLB功能就会出现问题, 此时TLB会记录是从哪个虚拟机发出的内存地址映射请求 , 这个时候TLB叫做Tag TLB。
2.2 CPU虚拟化
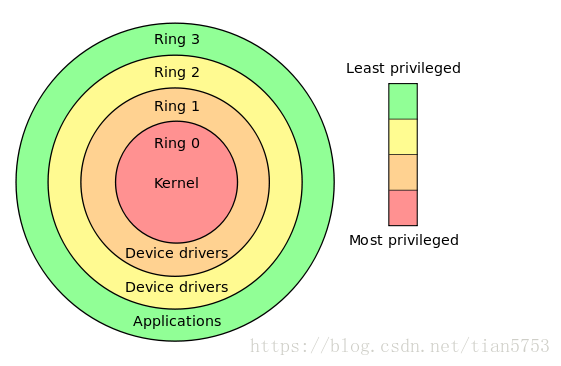
首先X86体系架构为了让上层的软件(操作系统、应用程序)能够访问硬件, 提供了四个CPU特权级别, Ring 0是最高级别, Ring 1 次之, Ring 2 更次之, Ring 3 是最低级别。
一般, 操作系统由于要直接访问硬件和内存, 因此它的代码需要运行在最高级别 Ring 0上, 而应用程序的代码运行在最低级别Ring 3 上, 如果要访问硬件和内存, 比如设备访问, 写文件等, 就要执行相关的系统调用, CPU 的运行级别发生从 Ring 3 到 Ring 0 的切换, 当完成之后, 再切换回去, 我们熟悉的用户态和内核态切换的本质就来自这里。
2.2.1 CPU 软件虚拟化
虚拟化的实现也是基于这个思想, VMM本质上是个Host OS, 运行在Ring 0上, Guest OS 运行在 Ring 1 上, 再往上是相应层次的应用程序运行在 Ring 2 和 Ring 3 上。
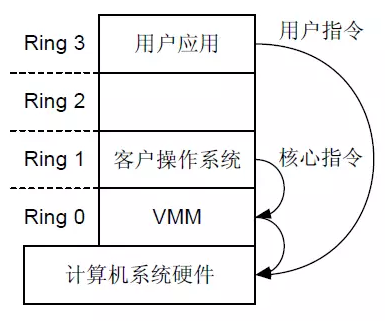
当 Guest OS或上层应用在执行相关的特权指令时, 就会发生越权访问, 触发异常, 这个时候 VMM 就截获(intercept)这个指令, 然后模拟(virtualize)这个指令, 返回给 Guest OS, 让其以为自己的特权指令可以正常工作, 继续运行。整个过程其实就是优先级压缩和二进制代码翻译的体现。
2.2.2 CPU硬件辅助虚拟化
上面的这种截获再模拟的纯软件的虚拟化方式, 势必是性能非常低的。那怎么样提高性能呢, 有一种改进的方式是修改 Guest OS 中关于特权指令的相关操作, 将其改为一种函数调用的方式 , 让VMM直接执行, 而不是截获和模拟, 这样就能在一定程度上提高性能。
但这种方式并不通用, 要去改Guest OS的代码, 只能看作是一种定制。为了能够通用, 又能够提高性能, 就只能从硬件上去做文章了。所以, 后来, 以 Intel 的VT-x和 AMD 的AMD-V 为主的硬件辅助的CPU虚拟化就被提出来(Intel VT 包括VT-x (支持 CPU 虚拟化)、EPT(支持内存虚拟化)和VT-d(支持I/O 虚拟化))。
Intel VT-x技术解决了早期x86架构在虚拟化方面存在的缺陷, 可使未经修改的Guest OS运行在特权级0 , 同时减少VMM对Guest OS的干预。Intel VT-d技术通过使VMM将特定I/O设备直接分配给特定的Guest OS, 减少VMM对I/O处理的管理, 不但加速数据传输, 且消除了大部分性能开销。
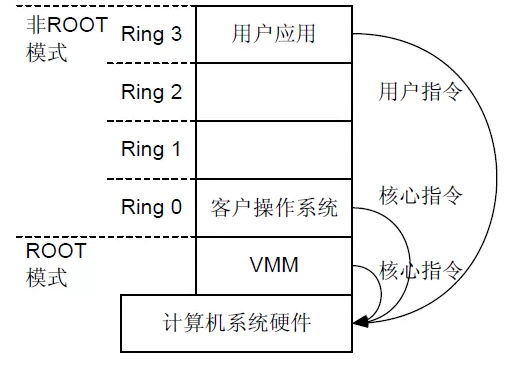
CPU 硬件辅助虚拟化在 Ring 模式的基础上引入了一种新的模式 , 叫 VMX 模式。它包括根操作模式(VMX Root Operation)和非根操作模式(VMX Non-Root Operation)。这两种模式都有Ring 0 - Ring 3 的特权级。所以, 在描述某个应用程序时, 除了描述其属于哪个特权级, 还要指明其处于根模式还是非根模式。引入这种模式的好处就在于, Guest OS 运行在Ring 0上, 就意味着它的核心指令可以直接下达到硬件层去执行, 而特权指令等敏感指令的执行则是由硬件辅助, 直接切换到VMM执行, 这是自动执行的, 应用程序是感知不到的, 性能自然就提高了。
这种切换VT-x定义了一套机制 , 称为VM-entry和VM-exit。从非根模式切换到根模式, 也就是从Guest切换到Host VMM, 称为VM-exit , 反之称为VM-entry。
VM-exit: 如果Guest OS运行过程中遇到需要VMM处理的事件, 比如中断或缺页异常, 或者主动调用VMCALL指令调用VMM服务的时候(类似于系统调用), 硬件自动挂起Guest OS, 切换到根模式,VMM 开始执行。VM-entry:VMM通过显示调用VMLAUNCH或VMRESUME指令切换到非根模式, 硬件自动加载Guest OS的上下文,Guest OS开始执行
简单一点理解,CPU硬件辅助虚拟化主要是通过在CPU中生成一个ring-1,也就是上图所示的root模式下。虚拟机运行在ring 0上, 虚拟机直接将虚拟机自身生成的特权指令发给ring0 ,宿主机主要将自身的特权指令发送给ring -1也就是root模式上。
2.2.3 CPU半虚拟化
半虚拟化的本质是让虚拟机本身知道自身处于虚拟化环境中。
为了解决全虚拟化开销较大的问题, 半虚拟化技术应用而生。半虚拟化在虚拟机操作系统和虚拟层之间增加了一个特殊指令的过渡模块, 通过修改虚拟机操作系统的内核, 将执行特殊敏感指令替换为对虚拟化层进行超级调用的方式来达到此目的。除CPU之外, 虚拟化层也对内存操作诸如内存管理、中断处理、时间同步提供了超级调用的接口。
选用基于半虚拟化的CPU虚拟化, 能使虚拟机使用CPU如同在物理机上使用CPU一样。对于开源的系统我们可以对其内核指令替换, 那么对于Windows操作系统, 这样闭源的操作系统, 这种方式就吃不开了。
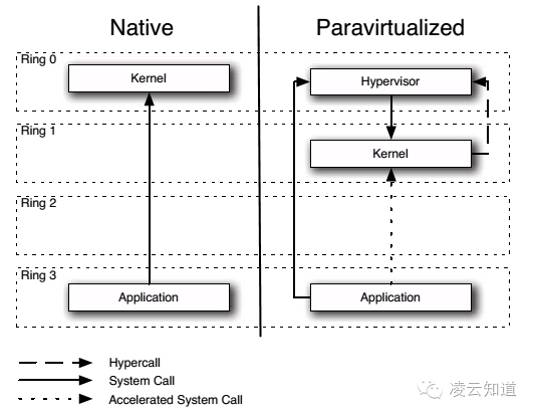
通过修改Guest OS的内核。使Guest OS明确知道自己是运行在1环上, 而不是通常OS的0环, 有效的避免了虚拟化的执行冲突问题。Guest OS也清楚VMM给自己提供了一个虚拟的寄存器组, 并能通过其他方式去访问他们, 避免了访问冲突的问题。
解决了敏感指令问题只是解决了x86架构下的半虚拟化的第一步。运行在1环的操作系统没有权限执行的指令 , 交给0环的VMM来处理, 这个很大程度上与应用程序的系统调用很类似 : 系统调用的作用是把应用程序无权执行的指令交给操作系统完成。因此, Xen向Guest OS提供了一套系统调用 。以方便Guest OS调用, 这部分”系统调用“就是超级调用(Hypercall)。
超级调用Hypercall的机制使用, 不仅使x86架构的指令虚拟化得以实现, 也为后面的内存虚拟化和I/O虚拟化提供了新的思路和方法, 超级调用和事件通道是整个半虚拟化的基础。
2.3 IO虚拟化
在现实生活中 , 可用的物理资源往往是有限的, 虚拟机的个数往往会比实际的物理设备个数要多。为了提高资源的利用率, 满足多个虚拟机操作系统对外部设备的访问需求, 虚拟机监视器必须通过I/O虚拟化的方式来实现资源的复用, 让有限的资源能被多个虚拟机共享。
I/O 虚拟化的目的可以归纳为两个:
设备发现, 即需要控制各 VM 能够访问的设备;
访问截获, 即可以通过 I/O 端口截获 VM 对设备的访问指令。
I/O虚拟化虽然有着显著的优点, 但是具体实现并没有那么简单, 要考虑的因素也很多的, 基本要求主要有以下的三点:
保真性 : 要求在虚拟化平台下进行的I/O访问与非虚拟化条件下的I/O访问除了完成时间差别外, 其它效果相同
安全性 : 要求各虚拟机操作系统只能访问虚拟机监视器分配给其的I/O资源, 而各I/O设备也只能与属于同一个虚拟机的其它资源进行交互, 如存储空间和CPU, 而不能越界访问属于其它虚拟机的资源
性能 : 要求虚拟化系统下I/O访问的性能与非虚拟化系统下的I/O访问性能接近。
在这三个基本要求之中最为重要的就是安全性方面的要求, 这是保证虚拟化环境可以正常运行的根本, 只有首先满足这一要求才能保证虚拟化I/O的保真性, 对于性能的要求才会有意义。虚拟化环境下之所以会出现安全性的问题是因为虚拟机操作系统可见的地址并不是实际的机器物理地址, 而是客户物理地址, 设备若无法获知客户物理地址和机器物理地址间的转换关系, 会直接使用客户物理地址进行内存访问, 这会导致非法地址访问、破坏正常数据。
正是由于I/O虚拟化对于I/O空间安全隔离性方面的要求, 所以对于虚拟机操作系统的I/O访问操作一般都需要虚拟机监视器的干预, 而不允许虚拟机操作系统与I/O设备直接进行交互, 这也就使得虚拟化系统下的I/O性能与非虚拟化系统的I/O性能有着较大的差距。在设备直接分配模型中, 有IOMMU的硬件辅助, 实现了域间隔离和设备地址转换, 保证被分配给虚拟机的设备不会访问不属于该虚拟机的存储器空间。
2.3.1 IO虚拟化开销
因为I/O虚拟化安全性的要求, 导致虚拟机操作系统的I/O访问会受到虚拟机监视器干预, 导致性能与非虚拟化环境有较大差距。而虚拟机监视器介入之所以会导致性能严重损失的根本原因就是发生了上下文切换。
上下文切换分为两种, 虚拟机与虚拟机之间发生的上下文切换以及虚拟机与虚拟机监视器之间发生的上下文切换。在I/O虚拟化中影响性能的就是虚拟机和虚拟机监视器之间的上下文切换。虚拟机操作系统产生的I/O请求会被监视器截获, 监视器将I/O请求交由驱动域去处理, 驱动域完成I/O请求要返回执行结果, 这些过程都是造成上下文切换。
虚拟机和监视器之间的上下文切换的开销主要分为以下三个部分:
直接开销 : 这个部分主要由CPU的切换造成, CPU需要停滞虚拟机切换到虚拟机监视器去执行, 之后又要从监视器程序转回虚拟机执行下一条指令;
间接开销 : 两种环境的切换导致需要保存上下文环境。
同步开销 : 这个部分主要是虚拟机监视器处理VM EXIT造成的。
因此, 一旦发生大量的上下文切换, 将严重影响I/O虚拟化的性能, 尤其在I/O密集型的任务中, 上下文切换导致的开销往往是无法忍受的
2.3.2 IO完全虚拟化
监视器程序需要截获虚拟机操作系统对外部设备的访问请求, 通过软件的方式模拟出真实的物理设备的效果, 这样, 虚拟机看到的实际只是一个虚拟设备, 而是真正的物理设备, 这种模拟的方式就是I/O虚拟化的一种实现, 下图所示就是一个典型的虚拟机I/O模型。
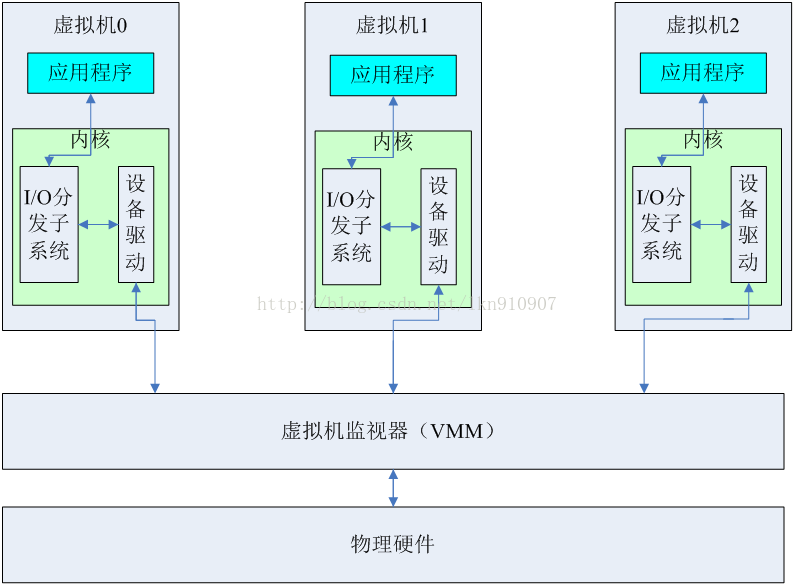
如上图所示, 虚拟化技术通过在物理硬件上抽象出一个虚拟化层, 来实现对整个物理平台的虚拟化, 这个虚拟化层通常被称为虚拟机监视器(VMM)。通过对硬件层的模拟, 将一台物理计算机抽象成了多台虚拟计算机, 每个虚拟机都运行独立的操作系统, 有各自的I/O子系统。I/O虚拟化并不需要完整地虚拟化出所有外设的所有接口, 究竟怎样做完全取决于设备与VMM的策略以及客户机操作系统的需求。
这种模式下, Guest OS 所能看到的就是一组统一的 I/O 设备。VMM 截获 Guest OS 对 I/O 设备的访问请求, 然后通过软件模拟真实的硬件。这种方式对 Guest OS 而言非常透明, 无需考虑底层硬件的情况。
2.3.3 IO半虚拟化
即前端(Front-End)和后端(Back-End)模型, 模拟实现虚拟化。其中, Guest OS 中的驱动程序为前端, VMM 提供的与 Guest 通信的驱动程序为后端。如下图所示:
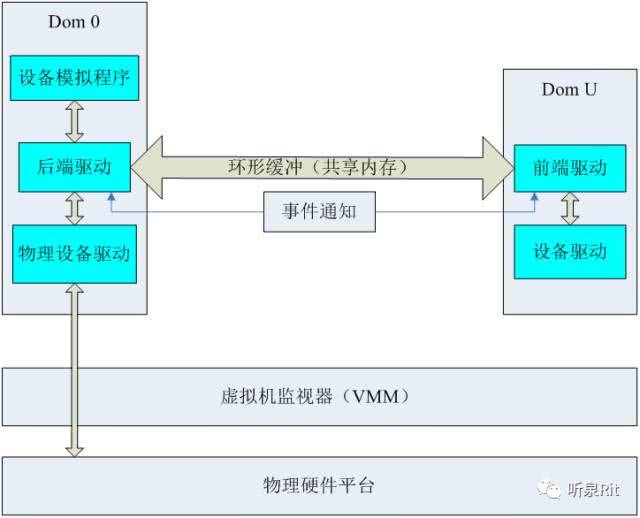
前端驱动将 Guest OS 的请求通过与 VMM 间的特殊通信机制和接口发送给 VMM 的后端驱动, 后端驱动对 VM 的数据进行分时分通道处理, 处理完请求后再发送给物理驱动。
该模型采用了 I/O 环机制, 减少了虚拟机与虚拟机监视器之间的切换;同时该模型摒弃了传统的中断机制, 而采用事件或回调机制来实现设备与客户机间的通信。进行中断处理时, 传统的中断服务程序需要进行中断确认和上下文切换, 而采用事件或回调机制, 无需进行上下文切换。
I/O 半虚拟化模型虽然在性能上比 I/O 全虚拟化模型要好, 但是这种 I/O 模型有一个很大的缺点, 就是要修改操作系统内核以及驱动程序, 因此会存在移植性和适用性方面的问题, 导致其使用受限。
2.3.4 IO硬件辅助虚拟化
这种技术直接给虚拟机分配物理设备, 例如直接分配一个硬盘或网卡给虚拟机。在 Xen 下由 Dom0 分配, 但是访问使用直接使用, 不经过 Dom0。需要硬件支持。这种模式, 主要有三种网卡硬件作为辅助:IO透传、VMDq 直通 和 SR-IOV
2.3.4.1 I/O 透传
把某一个设备直接分配给一个虚拟机, 让虚拟机可以直接访问该物理设备而不需要通过虚拟机监视器或被虚拟机监视器截获。
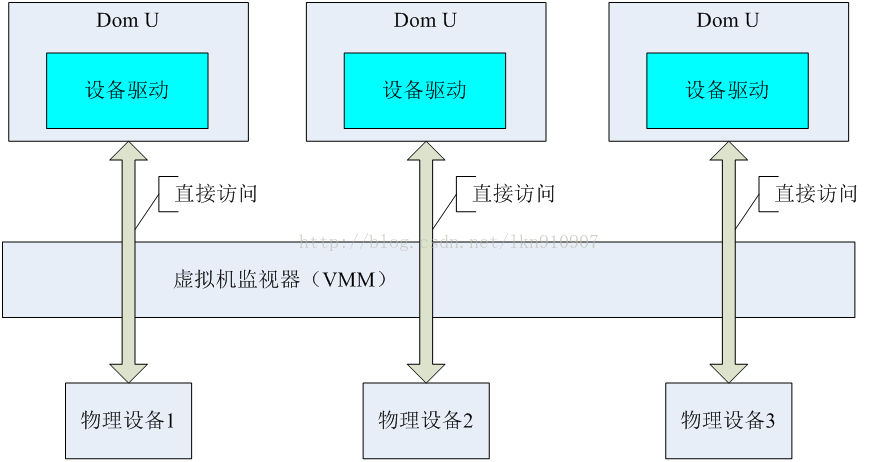
设备直接分配模型虽然在性能上相比主流的两种I/O设备虚拟化模型有着很大的提升, 但是该模型的使用也是有一定限制的。因为该模型将一件物理设备直接分配给了一个虚拟机, 其它虚拟机是无法使用该设备的, 所产生的一个问题就是如果其它虚拟机需要访问该设备则无法满足需求, 解决的办法就是服务器上还有一个同样的设备以供其它虚拟机使用。因此, 设备直接分配模型的使用必须满足物理资源较为充足的前提条件, 对于那些紧缺的物理资源, 该模型是不适用的。
2.3.4.2 VMDq:虚拟机设备队列
VMM 在服务器的物理网卡中为每个虚拟机分配一个独立的队列, 虚拟机出来的流量可直接经过软件交换机发送到指定队列上, 软件交换机无需进行排序和路由操作。VMM 和虚拟交换机仍然需要将网络流量在 VMDq 和虚拟机之间进行复制。
2.3.4.3 SR-IOV
为降低虚拟机 I/O 的性能开销, 学术界和工业界从软硬件方面对虚拟机 I/O 模型做了大量的改进。Intel VT-d 技术和 Passthrough 技术通过降低 I/O 操作中 VMM 的参与提升了虚拟机的 I/O 性能。
SR-IOV 这种技术更为彻底, 它通过创建不同虚拟功能(VF)的方式, 一个物理网卡可以虚拟出多个网卡, 分配给虚拟机的就是独立网卡, 实现虚拟机直接跟硬件网卡通信, 不再经过软件交换机, 减少了Hypervisor层的地址转换。
SR-IOV 标准定义了设备原生共享所需的软硬件支持。硬件支持包括芯片组对 SR-IOV 设备的识别, BIOS 为 SR-IOV 分配足够的资源, 此外为保证对设备的安全、隔离访问还需要北桥芯片的 VT-d 支持。软件方面, VMM 将驱动管理权限交给Domain 0, Domain 0 操作系统必须支持 SR-IOV 功能。Domain 0 通过物理功能(physical function, PF)驱动发现设备的 SR-IOV 功能后将包括发送、接收队列在内的物理资源依据 VF 数目划分成多个子集, 然后PF驱动将这些资源子集抽象成设备即系统中所见的虚拟功能(virtual function, VF)设备, 创建 VF 设备后 , Domain 0 可将 VF 设备以 Passthrough(PCIPCIe) 方式分配给虚拟机。如下图所示:
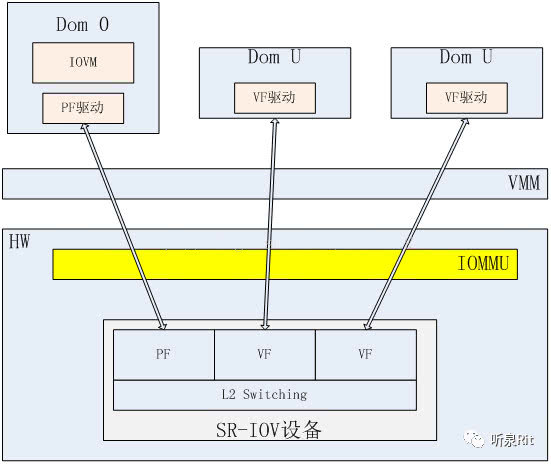
SR-IOV的软件架构分成四个部分 :PF、VF、控制面板以及PF 和 VF 间的通信机制。其中:PF(物理功能), 是 Domain 0 中负责管理 SR-IOV 设备的特殊驱动, 其主要功能是为特权 Domain 0 提供设备访问功能和全局贡献资源配置的功能, 虚拟机所有影响设备状态的操作均需通过通信机制向 PF 发出请求完成。
VF(虚拟功能), 是轻量级的 PCIe 功能, 其功能包含三个方面:
向虚拟机操作系统提供的接口;
数据的发送、接收功能;
与 PF 进行通信, 完成全局相关操作。
由于 VF 的资源仅是设备资源的子集, 因此 VF 驱动能够访问的资源有限, 对其它资源的访问要求通过 PF 完成。
控制面板 : 同
PF一样位于特权Domain 0中, 其主要功能是负责生成 PCIe 配置空间并将 VF 抽象成 PCIe 设备, 并向用户提供 VF 分配、回收等接口。通信机制 :一旦在
PF中启用了SR-IOV, 就可以通过 PF 的总线、设备和功能编号(路由 ID)访问各个 VF 的 PCI 配置空间。每个 VF 都具有一个 PCI 内存空间, 用于映射其寄存器集。VF 设备驱动程序对寄存器集进行操作以启用其功能, 并且显示为实际存在的 PCI 设备。创建 VF 后, 可以直接将其指定给 I/O 来宾域或各个应用程序。此功能使得虚拟功能可以共享物理设备, 并在没有 CPU 和虚拟机管理程序软件开销的情况下执行 I/O。
2.4 网络虚拟化
网络虚拟化主要解决的是虚拟机构成的网络通信问题, 完成的是各种网络设备的虚拟化, 如网卡、交换设备、路由设备等。
为了完成虚拟机在同主机和跨主机之间的通信 , 需要借助某种“桥梁”来完成用户态到内核态(Guest 到 Host)的数据传输, 这种桥梁的角色就是由虚拟的网络设备来完成, Linux 本身由于虚拟化技术的演进, 也集成了一些虚拟网络设备的解决方案, 主要有以下几种:
TAP/TUN/VETHbridge
2.4.1 TAP/TUN/VETH
TAP/TUN 是 Linux 内核实现的一对虚拟网络设备, TAP 工作在二层, TUN 工作在三层。Linux 内核通过 TAP/TUN 设备向绑定该设备的用户空间程序发送数据, 反之, 用户空间程序也可以像操作物理网络设备那样, 向 TAP/TUN 设备发送数据。
基于 TAP 驱动, 即可实现虚拟机vNIC的功能, 虚拟机的每个vNIC 都与一个TAP 设备相连, vNIC 之于 TAP 就如同 NIC之于 eth。
当一个TAP设备被创建时, 在 Linux 设备文件目录下会生成一个对应的字符设备文件, 用户程序可以像打开一个普通文件一样对这个文件进行读写。
比如, 当对这个TAP文件执行write操作时, 相当于TAP设备收到了数据, 并请求内核接受它, 内核收到数据后将根据网络配置进行后续处理, 处理过程类似于普通物理网卡从外界收到数据。当用户程序执行 read 请求时, 相当于向内核查询 TAP 设备是否有数据要发送, 有的话则发送, 从而完成 TAP设备的数据发送。
TUN 则属于网络中三层的概念, 数据收发过程和TAP 是类似的, 只不过它要指定一段IPv4 地址或 IPv6 地址, 并描述其相关的配置信息, 其数据处理过程也是类似于普通物理网卡收到三层 IP 报文数据。
VETH 设备总是成对出现, 一端连着内核协议栈, 另一端连着另一个设备, 一个设备收到内核发送的数据后, 会发送到另一个设备上去, 这种设备通常用于容器中两个 namespace 之间的通信。
2.4.2 Bridge
Bridge也是 Linux 内核实现的一个工作在二层的虚拟网络设备, 但不同于 TAP/TUN 这种单端口的设备, Bridge 实现为多端口, 本质上是一个虚拟交换机, 具备和物理交换机类似的功能。
Bridge 可以绑定其他 Linux 网络设备作为从设备, 并将这些从设备虚拟化为端口, 当一个从设备被绑定到 Bridge 上时, 就相当于真实网络中的交换机端口上插入了一根连有终端的网线。
如下图所示, Bridge 设备br0 绑定了实际设备eth0和 虚拟设备设备tap0/tap1, 当这些从设备接收到数据时, 会发送给 br0 , br0 会根据 MAC 地址与端口的映射关系进行转发。
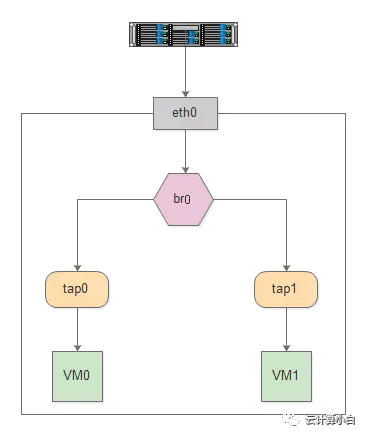
因为 Bridge 工作在二层, 所以绑定到它上面的从设备 eth0、tap0、tap1 均不需要设 IP, 但是需要为 br0 设置 IP, 因为对于上层路由器来说, 这些设备位于同一个子网, 需要一个统一的 IP 将其加入路由表中。
这里有人可能会有疑问, Bridge 不是工作在二层吗, 为什么会有IP的说法?其实 Bridge 虽然工作在二层, 但它只是 Linux 网络设备抽象的一种, 能设IP也不足为奇。
对于实际设备eth0来说, 本来它是有自己的IP的, 但是绑定到br0之后, 其IP就失效了, 就和br0共享一个IP网段了, 在设路由表的时候, 就需要将 br0 设为目标网段的地址。
3. 虚拟机
虚拟计算机称为“虚拟机”(VM,Virtual Machine), 它是一种严密隔离且内含操作系统和应用的软件容器。每个自包含虚拟机都是完全独立的。通过将多台虚拟机放置在一台计算机上, 可仅在一台物理服务器或“主机”上运行多个操作系统和应用, 名为hypervisor的精简软件层可将虚拟机与主机分离开来, 并根据需要为每个虚拟机动态分配计算资源。
虚拟机的主要特性
共享硬件
可在一台物理机上运行多个操作系统。
可在虚拟机之间分配系统硬件资源。
相互隔离
可在硬件级别进行故障和安全隔离。
可利用高级资源控制功能保持性能。
封装
可将虚拟机的完整状态保存到文件中。
移动和复制虚拟机就像移动和复制文件一样轻松。
独立于硬件
可将任意虚拟机调配或迁移到其他理服务器上。
3.1 虚拟化类型
服务器虚拟化
服务器虚拟化支持将多个操作系统作为高效的虚拟机在单个物理服务器上运行。主要优势包括:
提升 IT 效率
降低运维成本
更快地部署工作负载
提高应用性能
提高服务器可用性
消除服务器数量剧增情况和复杂性
网络虚拟化
通过软件定义网络 , 即网络的创建不再依赖于物理设备 , 如公有云厂商允许用户自己创建新的网络 , 在
kubernetes、openstack中都会使用到网络虚拟化。通过完全复制物理网络 , 网络虚拟化支持应用在虚拟网络上运行, 就像在物理网络上运行一样。但它具有更大的运维优势并可实现虚拟化的所有硬件独立性。(网络虚拟化为连接的工作负载提供逻辑网络连接设备和服务, 包括逻辑端口、交换机、路由器、防火墙、负载均衡器、VPN 等。)
桌面虚拟化
将桌面部署为代管服务使 IT 组织能够更快地响应不断变化的工作场所需求和新出现的机会。还可以将虚拟化桌面和应用快速、轻松地交付给分支机构、外包和离岸员工以及使用 iPad 和 Android 平板电脑的移动员工。
应用虚拟化
将软件虚拟化, 比如
office 365
存储虚拟化
SAN(基于磁盘)/NAS(NFS/Samba)/GlusterFS/ceph等
库虚拟化
在
linux上运行windows程序使用wine, 在mac系统运行windows程序使用CrossOver等
容器虚技术
被称为下一代虚拟化技术, 典型的就是
docker、Linux Container(LXC)、pouch
3.2 虚拟化技术分类
模拟器
在一个
host之上通过虚拟化模拟器软件 , 模拟出一个硬件或者多个硬件环境 , 每个环境都是一个独立的虚拟机 , CPU、IO、内存等都是模拟出来的 , 可以在宿主机模拟出不同于当前物理机CPU指令集的虚拟机, 比如可以在Windows模拟出mac OS、unix系统, 比较出名的模拟器有:pearpc、QEMU、Bochs。
全虚拟机化(
full virtualization) / 准虚拟化 (native virtualization) 全虚拟化/准虚拟化不做CPU和内存模拟, 只对CPU和内存做相应的分配等操作,全虚拟化需要物理硬件的支持, 比如需要CPU必须支持并且打开虚拟化功能, 例如Intel 的Intel VT-X/EPT,AMD的AMD-V/RVI,以在CPU 层面支持虚拟化功能和内存虚拟化技术, 因此完全虚拟化也是基于硬件辅助的虚拟化技术。全虚拟化软件(硬件辅助全虚拟化):
vmware esxiparalles desktopKVMMicrosoft Hyper-VVirtualBox
KVM是硬件辅助的虚拟化技术 , 主要负责 比较繁琐的 CPU 和内存虚拟化,而Qemu则负责I/O虚拟化, 两者合作各自发挥自身的优势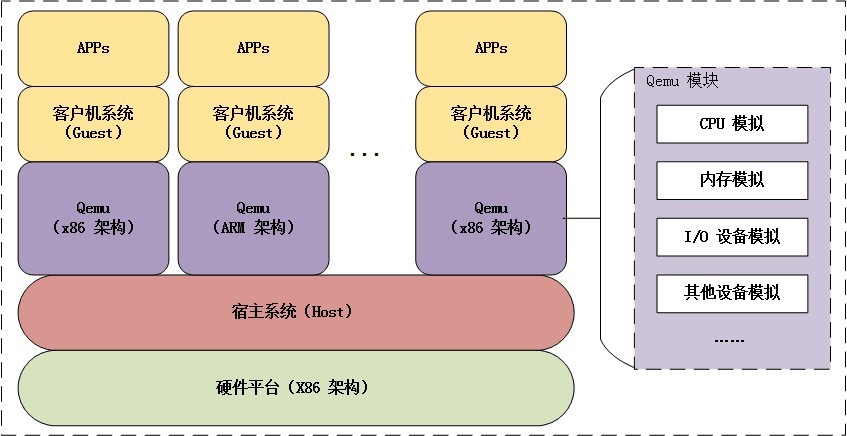
半虚拟化(
para virtualization)半虚拟化要求
guest OS的内核是知道自己运行在虚拟化环境当中的 , 因此guest OS的系统架构必须和宿主机的系统架构相同 , 并且要求对guest OS的内核做相应的修改 , 因此半虚拟化只支持开源内核的系统, 不支持闭源的系统 , 比较常见的半虚拟化就是早期版本的XEN, 但是Xen从其3.0版本开始, 可以支持利用硬件虚拟化技术的支持(http://www-archive.xenproject.org/files/xen_3.0_datasheet.pdf), 实现了完全虚拟化, 可以在其平台上不加修改的直接运行如Linux/Windows等系列的操作系统, 使得系统具备了更好的兼容性。半虚拟化软件---
XenDomain 0:Domain 0是一个修改过的Linux kernel, 是唯一运行在Xen Hypervisor之上的虚拟机, 它拥有访问物理I/O资源的权限, 同时和系统上运行的其他虚拟机进行交互。Domain 0需要在其它Domain启动之前启动。Domain U: 运行在Xen Hypervisor上的所有半虚拟化(paravirtualized)虚拟机被称为“Domain U PV Guests”, 其上运行着被修改过内核的操作系统, 如Linux、Solaris、FreeBSD等其它UNIX操作系统。所有的全虚拟化虚拟机被称为Domain U HVM Guests, 其上运行着不用修改内核的操作系统, 如Windows等。

kvm与Xen对比
各虚拟化技术性能对比:
3.3 Hypervisor类型
Hypervisor是一种运行在基础物理服务器和操作系统之间的中间软件层, 其可以允许多个操作系统和应用共享底层的内存、CPU、磁盘等物理硬件, 也可叫做VMM( virtual machine monitor ), 即虚拟机监视器。
Hypervisor是所有虚拟化技术的核心, 非中断地支持多工作负载迁移的能力是Hypervisor的基本功能, 当服务器启动并执行Hypervisor时,它会给每一台虚拟机分配适量的内存、CPU、网络和磁盘, 并加载所有虚拟机的客户操作系统。
常见的hypervisor类型:
类型I-裸机型 : 直接运行在硬件设备上的 , 这种架构搭建的虚拟化环境称为裸机虚拟化环境(
Bare-Metal Hardware Virtualization),比如:VMware ESXI。类型II-主机托管型 : 运行在具有虚拟化功能的操作系统上的, 构建的是主机虚拟化环境(
HostedVirtualization),比如:VMware Workstation、VirtualBox。
Redhat将KVM划分到类型I即裸机型: https://www.redhat.com/zh/topics/virtualization/what-is-KVM
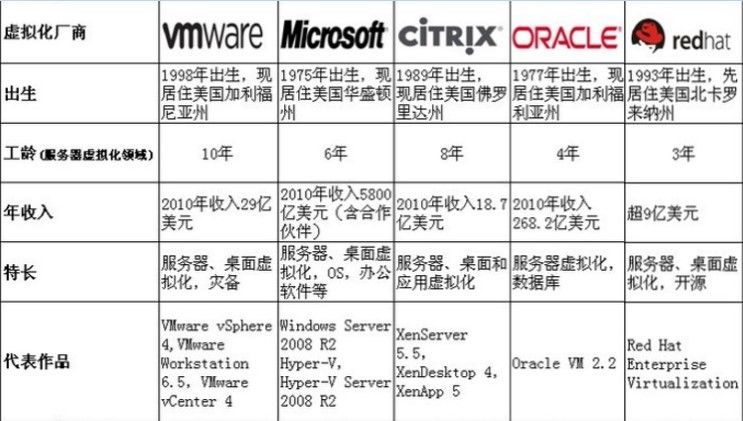
3.4. 虚拟化技术厂商
3.4.1 软件技术厂商
3.4.2 硬件技术厂商
Intel从2005年开始支持在CPU中加入硬件虚拟化的支持, intel virtualazation tochnology, 简称intel VT, IntelVT虚拟化技术包括分别针对CPU的增强虚拟化技术IntelVT-x、I/O虚拟化的IntelVT-d、网络虚拟化的IntelVT-c技术。
3.4.2.1 Intel VT-x
Intel VT-x 可以让一个CPU工作起来像多个CPU在并行运行, 从而使得在一台物理服务器内可以同时运行多个操作系统, 能够降低(甚至消除)多个虚拟机操作系统之间的资源争夺和限制, 从硬件上极大地改善虚拟机的安全性和性能, 有助于提高基于软件的虚拟化解决方案的灵活性与稳定性, 此外, IntelVT-x具备的虚拟机迁移特性还可为IT投资提供有力保护, 并进一步提高故障切换、负载均衡、灾难恢复和维护的灵活性。
Intel VT Flex Priority(灵活优先级) : 当处理器执行任务时, 往往会收到其它设备或应用发出的请求或“中断”命令。为了最大程度减少对性能的影响, 处理器内的一个寄存器专用来监控任务优先级, 只有优先级高于当前运行任务的请求或“中断”才被及时处理。Intel VT Flex Migration(灵活迁移) : 虚拟化能够在无需停机的情况下, 将运行中的虚拟机在物理服务器之间进行迁移, 借助此项技术, 管理程序能够在迁移池内的所有服务器中建立一套一致的指令, 实现工作负载的无缝迁移Intel VT Extended Page Tables(EPT, 扩展页表): 为了降低实现内存虚拟化的难度和提升内存虚拟化的性能,Extended Page Tables直接在硬件上支持虚拟机内存的逻辑地址->虚拟机内存的物理地址->物理服务器内存的物理地址的两次转换。
3.4.2.2 Intel VT-d技术
Intel VT-d技术支持直接I/O访问 , 虚拟机创建好之后, 数据即可直接在虚拟机与为其分配的I/O设备之间进行传输 , 这样就加快了I/O的流动, 减少VMM活动及服务器处理器的负载。
3.4.2.3 Intel VT-c
Intel VT-c技术 : 支持网络连接的Intel虚拟化技术 , 包括虚拟机设备队列(VMDq)、虚拟机直接互连(VMDc)。
虚拟机设备队列(
VMDq) : 最大限度提高I/O吞吐率,Intel VT-c可将网络I/O吞吐量提高一倍以上 , 使虚拟化应用达到接近物理服务器的吞吐率。虚拟机直接互连(
VMDc) : 大幅提升虚拟化性能。VMDc支持虚拟机直接访问网络I/O硬件, 从而显著提升虚拟机性能, 这些通信链路直接绕过了VMM交换机, 进一步提升了I/O性能并减少服务器处理器的负载。
4. 云计算
云计算(Cloud Computing)是概念最早是由Google 前首席执行官 埃里克•施密特(Eric Schmidt)在2006 年8 月9日的搜索引擎大会上首次提出的一种构想,而“云计算”就是这种构想的代名词,云计算以虚拟化为基础, 以网络为中心, 为用户提供安全、快速、便捷的数据存储和网络计算服务, 包括所需要的硬件、平台、软件及服务等资源, 而提供资源的网络就被称为“云”。
https://www.redhat.com/zh/topics/cloud-computing/cloud-vs-virtualization
#虚拟化与云计算区别
以下为虚拟化和云计算的对比:
4.1 云计算分类
公有云 : 比如阿里云/aws、azure、金山云、腾讯云等都属于公有云, 每个人都可以付费使用, 不需要自己关心底层硬件, 但是数据安全需要考利。
私有云 : 在自己公司内部或IDC自建Openstack、VMware等环境
混合云 : 既要使用公有云, 又要使用私有云, 即自己的私有云的部分业务和公有云有交接, 这部分称为混合云
4.2 云计算分层
传统IDC : 直接在物理机运行服务, 不能快速对业务横向扩容。
IaaS : 基础设施服务,
Infrastructure as a service,自检机房(openstack)、阿里云ECS。PaaS : 平台服务,
Platform-as-a-service,公有云上的Redis、RDS、Docker等服务。SaaS : 软件服务,
Software-as-a-service,企业邮箱、OA系统等可以通过浏览器直接访问。

参考链接
CSDN: ftian_:CPU 的 ring0, ring1,ring2,ring3
博客园: 猿大白@公众号 Linux云计算网络 : CPU 虚拟化
CSDN:锋影Q: [转]漫谈虚拟化-计算虚拟化中的 I/O 虚拟化
博客园: 猿大白@公众号 Linux云计算网络 : 网络虚拟化