
1-1-ELK基础和安装
1. ELK介绍
1.1 ELK简介
ELK是Elasticsearch、Logstash、Kibana三大开源框架首字母大写简称(但是后期出现的filebeat(beats中的一种)可以用来替代logstash的数据收集功能 , 比较轻量级)。市面上也被称为Elastic Stack。
Filebeat是用于转发和集中日志数据的轻量级传送工具。Filebeat监视您指定的日志文件或位置 , 收集日志事件 , 并将它们转发到Elasticsearch或Logstash进行索引。Filebeat的工作方式如下 : 启动Filebeat时 , 它将启动一个或多个输入 , 这些输入将在为日志数据指定的位置中查找。对于Filebeat所找到的每个日志 , Filebeat都会启动收集器。每个收集器都读取单个日志以获取新内容 , 并将新日志数据发送到libbeat , libbeat将聚集事件 , 并将聚集的数据发送到为Filebeat配置的输出。
Logstash是免费且开放的服务器端数据处理管道 , 能够从多个来源采集数据 , 转换数据 , 然后将数据发送到您最喜欢的“存储库”中。Logstash能够动态地采集、转换和传输数据 , 不受格式或复杂度的影响。利用Grok从非结构化数据中派生出结构 , 从IP地址解码出地理坐标 , 匿名化或排除敏感字段 , 并简化整体处理过程。
Elasticsearch是Elastic Stack核心的分布式搜索和分析引擎,是一个基于Lucene、分布式、通过Restful方式进行交互的近实时搜索平台框架。Elasticsearch为所有类型的数据提供近乎实时的搜索和分析。无论您是结构化文本还是非结构化文本 , 数字数据或地理空间数据 , Elasticsearch都能以支持快速搜索的方式有效地对其进行存储和索引。
Kibana是一个针对Elasticsearch的开源分析及可视化平台 , 用来搜索、查看交互存储在Elasticsearch索引中的数据。使用Kibana , 可以通过各种图表进行高级数据分析及展示。并且可以为Logstash和ElasticSearch 提供的日志分析友好的 Web 界面 , 可以汇总、分析和搜索重要数据日志。还可以让海量数据更容易理解。它操作简单 , 基于浏览器的用户界面可以快速创建仪表板(dashboard)实时显示Elasticsearch查询动态
1.2 为什么使用ELK
日志主要包括系统日志、应用程序日志和安全日志。系统运维和开发人员可以通过日志了解服务器软硬件信息、检查配置过程中的错误及错误发生的原因。经常分析日志可以了解服务器的负荷 , 性能安全性 , 从而及时采取措施纠正错误。
往往单台机器的日志我们使用grep、awk等工具就能基本实现简单分析 , 但是当日志被分散的储存不同的设备上。如果你管理数十上百台服务器 , 你还在使用依次登录每台机器的传统方法查阅日志。这样是不是感觉很繁琐和效率低下。当务之急我们使用集中化的日志管理 , 例如 : 开源的syslog , 将所有服务器上的日志收集汇总。集中化管理日志后 , 日志的统计和检索又成为一件比较麻烦的事情 , 一般我们使用grep、awk和wc等Linux命令能实现检索和统计 , 但是对于要求更高的查询、排序和统计等要求和庞大的机器数量依然使用这样的方法难免有点力不从心。
一般大型系统是一个分布式部署的架构 , 不同的服务模块部署在不同的服务器上 , 问题出现时 , 大部分情况需要根据问题暴露的关键信息 , 定位到具体的服务器和服务模块 , 构建一套集中式日志系统 , 可以提高定位问题的效率。
1.3 完整日志系统基本特征
收集 : 能够采集多种来源的日志数据
传输 : 能够稳定的把日志数据解析过滤并传输到存储系统
存储 : 存储日志数据
分析 : 支持 UI 分析
警告 : 能够提供错误报告 , 监控机制
2. ELK架构分析
2.1 beats+elasticsearch+kibana模式
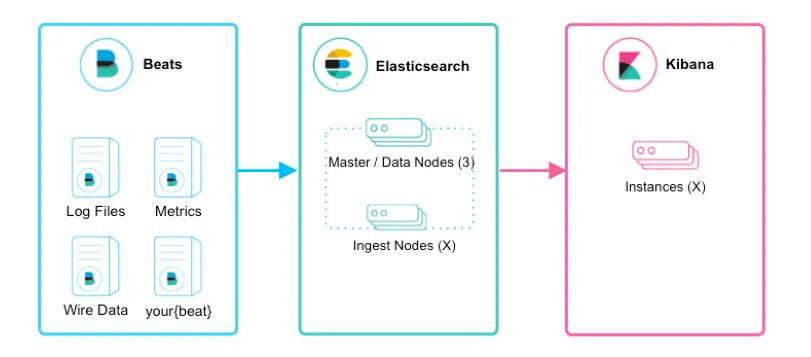
如上图所示 , 该ELK框架由beats( 日志分析我们通常使用filebeat)+elasticsearch+kibana构成 , 这个框架比较简单 , 入门级的框架。其中filebeat也能通过module对日志进行简单的解析和索引。并查看预建的Kibana仪表板。
该框架适合简单的日志数据 , 一般可以用来玩玩 , 生产环境建议接入logstash
2.2 beats+logstash+elasticsearch+kibana模式
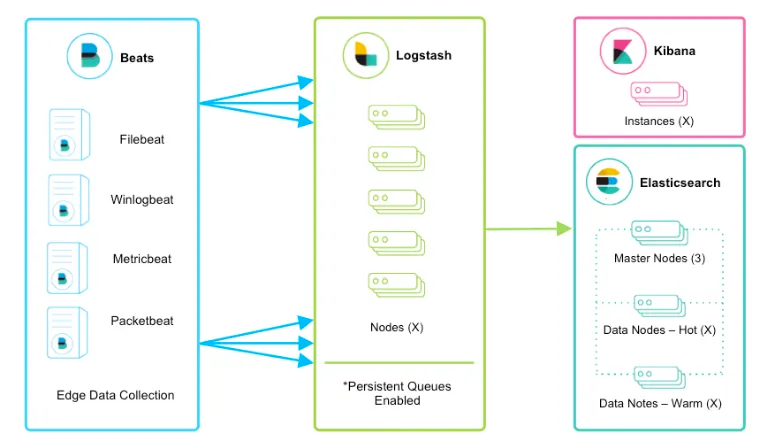
该框架是在上面的框架的基础上引入了logstash , 引入logstash带来的好处如下 :
通
Logstash具有基于磁盘的自适应缓冲系统 , 该系统将吸收传入的吞吐量 , 从而减轻背压从其他数据源( 例如数据库 , S3或消息传递队列) 中提取
将数据发送到多个目的地 , 例如S3 , HDFS或写入文件
使用条件数据流逻辑组成更复杂的处理管道
filebeat结合logstash带来的优势 :
水平可扩展性 , 高可用性和可变负载处理 :
filebeat和logstash可以实现节点之间的负载均衡 , 多个logstash可以实现logstash的高可用消息持久性与至少一次交付保证 : 使用
Filebeat或Winlogbeat进行日志收集时 , 可以保证至少一次交付。从Filebeat或Winlogbeat到Logstash以及从Logstash到Elasticsearch的两种通信协议都是同步的 , 并且支持确认。Logstash持久队列提供跨节点故障的保护。对于Logstash中的磁盘级弹性 , 确保磁盘冗余非常重要。具有身份验证和有线加密的端到端安全传输 : 从
Beats到Logstash以及从Logstash到Elasticsearch的传输都可以使用加密方式传递 。与Elasticsearch进行通讯时 , 有很多安全选项 , 包括基本身份验证 ,TLS,PKI,LDAP,AD和其他自定义领域
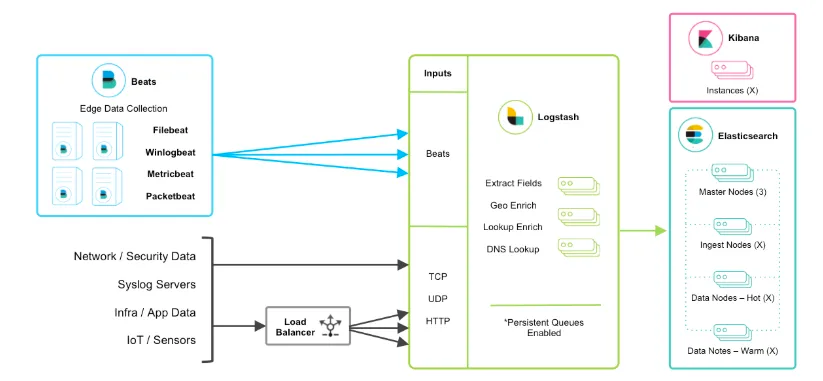
当然在该框架的基础上还可以引入其他的输入数据的方式 : 比如 : TCP , UDP和HTTP协议是将数据输入Logstash的常用方法(如下图所示) :
2.3 beats+缓存/消息队列+logstash+elasticsearch+kibana模式
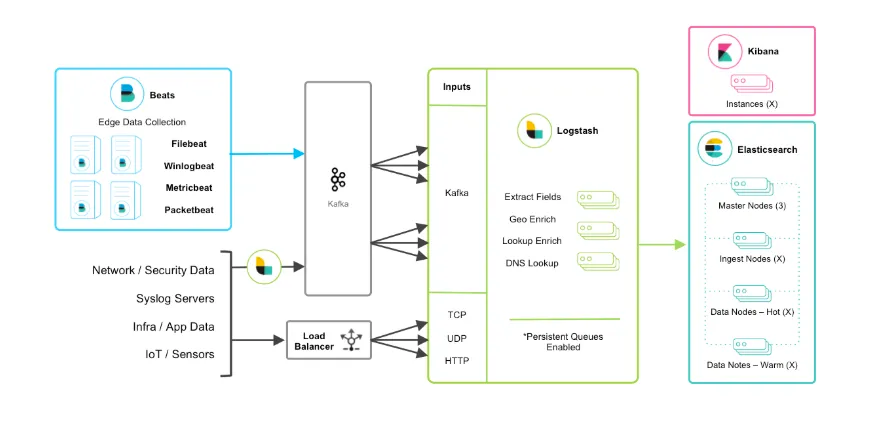
在如上的基础上我们可以在beats和logstash中间添加一些组件redis、kafka、RabbitMQ等 , 添加中间件将会有如下好处:
第一 , 降低对日志所在机器的影响 , 这些机器上一般都部署着反向代理或应用服务 , 本身负载就很重了 , 所以尽可能的在这些机器上少做事 ;
第二 , 如果有很多台机器需要做日志收集 , 那么让每台机器都向Elasticsearch持续写入数据 , 必然会对Elasticsearch造成压力 , 因此需要对数据进行缓冲 , 同时 , 这样的缓冲也可以一定程度的保护数据不丢失 ;
第三 , 将日志数据的格式化与处理放到Indexer中统一做 , 可以在一处修改代码、部署 , 避免需要到多台机器上去修改配置
3. 基础概念
3.1 elasticsearch 介绍
Elasticsearch(ES)是一个基于Lucene构建的开源、分布式、RESTful接口的全文搜索引擎。Elasticsearch还是一个分布式文档数据库 , 其中每个字段均可被索引 , 而且每个字段的数据均可被搜索 , ES能够横向扩展至数以百计的服务器存储以及处理PB级的数据。可以在极短的时间内存储、搜索和分析大量的数据。
基本概念有 : Cluster 集群、Node节点、Index索引、Document文档、Shards &Replicas分片与副本等
elasticsearch的优势 :
分布式 : 横向扩展非常灵活
全文检索 : 基于
lucene的强大的全文检索能力;近实时搜索和分析 : 数据进入
ES, 可达到近实时搜索 , 还可进行聚合分析高可用 : 容错机制 , 自动发现新的或失败的节点 , 重组和重新平衡数据
模式自由 :
ES的动态mapping机制可以自动检测数据的结构和类型 , 创建索引并使数据可搜索。RESTful API:JSON + HTTP
Elasticsearch也使用Java开发并使用Lucene作为其核心来实现所有索引和搜索的功能 , 但是它的目的是通过简单的RESTful API来隐藏Lucene的复杂性 , 从而让全文搜索变得简单。
Lucene只是一个库。想要使用它 , 你必须使用Java来作为开发语言并将其直接集成到你的应用中 , 更糟糕的是 , Lucene非常复杂 , 你需要深入了解检索的相关知识来理解它是如何工作的。
Elasticsearch也使用Java开发并使用Lucene作为其核心来实现所有索引和搜索的功能 , 但是它的目的是通过简单的RESTful API来隐藏Lucene的复杂性 , 从而让全文搜索变得简单。
当ElasticSearch的节点启动后 , 它会利用多播(multicast)(或者单播 , 如果用户更改了配置)寻找集群中的其它节点 , 并与之建立连接。
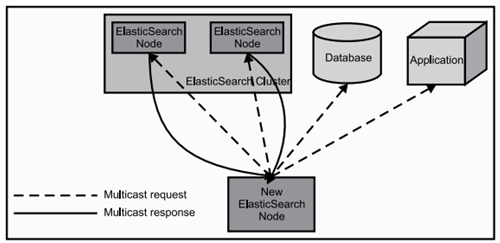
ES核心概念
Cluster: 集群ES可以作为一个独立的单个搜索服务器。不过 , 为了处理大型数据集 , 实现容错和高可用性 ,ES可以运行在许多互相合作的服务器上。这些服务器的集合称为集群。Node: 节点形成集群的每个服务器称为节点。
Shard: 分片当有大量的文档时 , 由于内存的限制、磁盘处理能力不足、无法足够快的响应客户端的请求等 , 一个节点可能不够。这种情况下 , 数据可以分为较小的分片。每个分片放到不同的服务器上。
当你查询的索引分布在多个分片上时 ,
ES会把查询发送给每个相关的分片 , 并将结果组合在一起 , 而应用程序并不知道分片的存在。即 : 这个过程对用户来说是透明的。Replia: 副本为提高查询吞吐量或实现高可用性 , 可以使用分片副本。
副本是一个分片的精确复制 , 每个分片可以有零个或多个副本。
ES中可以有许多相同的分片 , 其中之一被选择更改索引操作 , 这种特殊的分片称为主分片。当主分片丢失时 , 如 : 该分片所在的数据不可用时 , 集群将副本提升为新的主分片。
全文检索
全文检索就是对一篇文章进行索引 , 可以根据关键字搜索 , 类似于
mysql里的like语句。全文索引就是把内容根据词的意义进行分词 , 然后分别创建索引 , 例如”你们的激情是因为什么事情来的” 可能会被分词成 : “你们“ , ”激情“ , “什么事情“ , ”来“ 等
token, 这样当你搜索“你们” 或者 “激情” 都会把这句搜出来。
ES数据架构的主要概念
这里主要以关系数据库Mysql进行对比
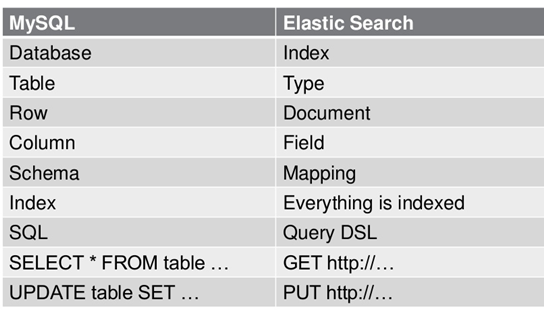
关系型数据库中的数据库(
DataBase) , 等价于ES中的索引(Index)一个数据库下面有N张表(
Table) , 等价于1个索引Index下面有N多类型(Type)一个数据库表(
Table)下的数据由多行(ROW)多列(column, 属性) 组成 , 等价于1个Type由多个文档(Document)和多Field组成。在一个关系型数据库里面 ,
schema定义了表、每个表的字段 , 还有表和字段之间的关系。 与之对应的 , 在ES中 :Mapping定义索引下的Type的字段处理规则 , 即索引如何建立、索引类型、是否保存原始索引JSON文档、是否压缩原始JSON文档、是否需要分词处理、如何进行分词处理等。在数据库中的增
insert、删delete、改update、查search操作等价于ES中的增PUT/POST、删Delete、改_update、查GET。
3.2 kibana介绍
Kibana是一个开源的数据分析和可视化平台 , 专门设计用于与Elasticsearch配合使用。它提供了一个用户友好的界面 , 让用户能够搜索、查看、分析和展示存储在Elasticsearch索引中的数据。Kibana作为Elastic Stack的一部分 , 广泛应用于日志分析、性能监控、内容搜索等多个领域。
Kibana的主要特点包括 :
数据可视化 :
Kibana提供了多种可视化工具 , 如图表、地图、表格和热图 , 帮助用户直观地理解数据。强大的搜索功能 : 用户可以执行复杂的搜索查询 , 使用过滤器和聚合来细化搜索结果。
仪表板和可视化 : 用户可以创建和分享仪表板 , 将多个可视化组件组合在一起 , 以监控和展示数据的特定方面。
安全性 :
Kibana支持用户身份验证、角色管理和索引模式 , 确保数据的安全性和访问控制。可扩展性 :
Kibana可以通过插件扩展其功能 , 社区和商业插件提供了额外的可视化类型、报告工具和其他功能。与 Elastic Stack 集成 :
Kibana与Elasticsearch、Logstash和Beats无缝集成 , 形成了一个强大的端到端解决方案 , 用于数据收集、搜索、分析和可视化。
Kibana的用户界面可以通过Web浏览器访问 , 支持多种操作系统 , 包括Windows、Linux和macOS。它通常作为独立的服务运行 , 也可以作为Docker容器部署。
Kibana的使用场景非常广泛 , 从IT运维监控、网络安全分析到业务智能和市场研究 , Kibana都能提供强大的数据探索和分析能力。随着数据量的不断增长 ,Kibana在帮助用户理解和利用数据方面发挥着越来越重要的作用。
kibana是您走进Elastic Stack的窗口 , Kibana让您能够可视化Elasticsearch中的数据并操作Elastic Stack , 因此您可以在这里解开任何疑问 : 例如 , 为何会在凌晨 2:00 被传呼 , 雨水会对季度数据造成怎样的影响。
一张图片胜过千万行日志
Kibana让您能够自由地选择如何呈现您的数据。或许您一开始并不知道自己想要什么。不过借助Kibana的交互式可视化 , 您可以先从一个问题出发 , 看看能够从中发现些什么。从基础入手
Kibana核心搭载了一批经典功能 : 柱状图、线状图、饼图、环形图 , 等等。它们充分利用了Elasticsearch 的聚合功能。
将地理数据融入任何地图
利用我们的
Elastic Maps Services来实现地理空间数据的可视化 , 或者发挥创意 , 在您自己的地图上实现自定义位置数据的可视化。时间序列也在菜单之列
您可以利用
Timelion, 对您Elasticsearch中的数据执行高级时间序列分析。您可以利用功能强大、简单易学的表达式来描述查询、转换和可视化。利用
graph功能探索关系
凭借搜索引擎的相关性功能 , 结合graph探索 , 揭示您Elasticsearch数据中极其常见的关系。
3.3 logstash介绍
3.3.1 基础
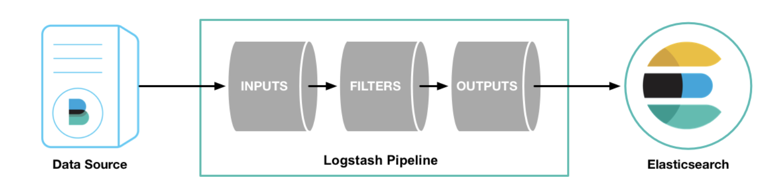
官方介绍 : Logstash is an open source data collection engine with real-time pipelining capabilities。简单来说logstash就是一根具备实时数据传输能力的管道 , 负责将数据信息从管道的输入端传输到管道的输出端;与此同时这根管道还可以让你根据自己的需求在中间加上滤网 , Logstash提供里很多功能强大的滤网以满足你的各种应用场景。
Logstash的事件( logstash将数据流中等每一条数据称之为一个event) 处理流水线有三个主要角色完成 : inputs –> filters –> outputs :
inpust: 必须( 标准输入) , 负责产生事件(Inputs generate events) , 常用 :File、syslog、redis、beats( 如 :Filebeats)filters: 可选 , 负责数据处理与转换(filters modify them) , 常用 :grok、mutate、drop、clone、geoipoutput: 必须( 标准输出) , 负责数据输出(outputs ship them elsewhere) , 常用 :elasticsearch、file、graphite、statsd
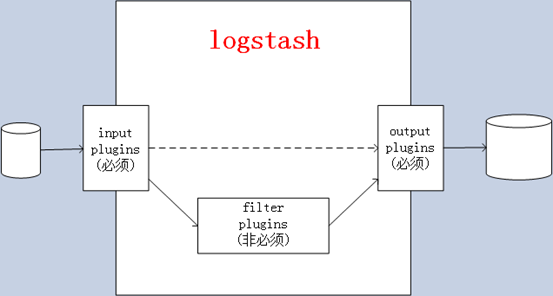
Logstash管道中的每个input阶段都在自己的线程中运行。将写事件输入到内存( 默认) 或磁盘上的中心队列。每个管道工作线程从该队列中取出一批事件 , 通过配置的filter处理该批事件 , 然后通过output输出到指定的组件存储。管道处理数据量的大小和管道工作线程的数量是可配置的
Logstash是一个功能强大的工具 , 可与各种部署集成。它提供了大量插件 , 可帮助你解析 , 丰富 , 转换和缓冲来自各种来源的数据。如果你的数据需要Beats中没有的其他处理 , 则需要将Logstash添加到部署中。
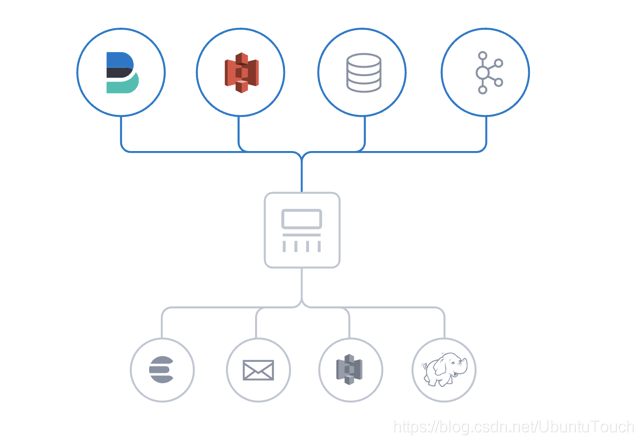
Logstash是Elastic栈非常重要的一部分 , 但是它不仅仅为Elasticsearch所使用。它可以介绍广泛的各种数据源。Logstash可以帮利用它自己的Filter帮我们对数据进行解析 , 丰富 , 转换等。
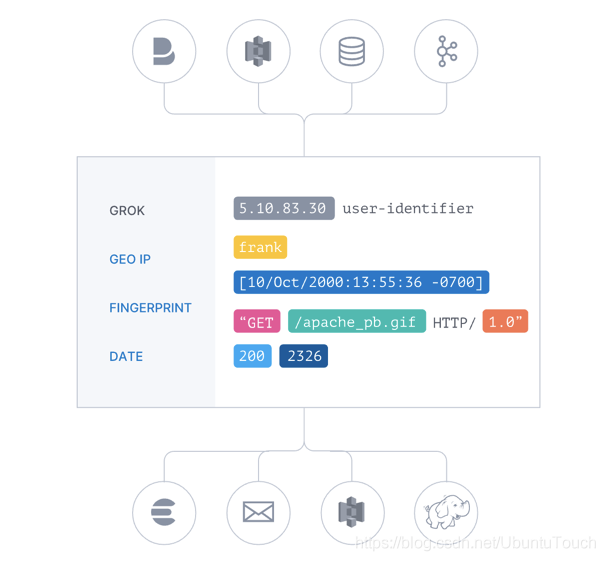
最后 , 它可以把自己的数据输出到各种需要的数据储存地 , 这其中包括Elasticsearch。
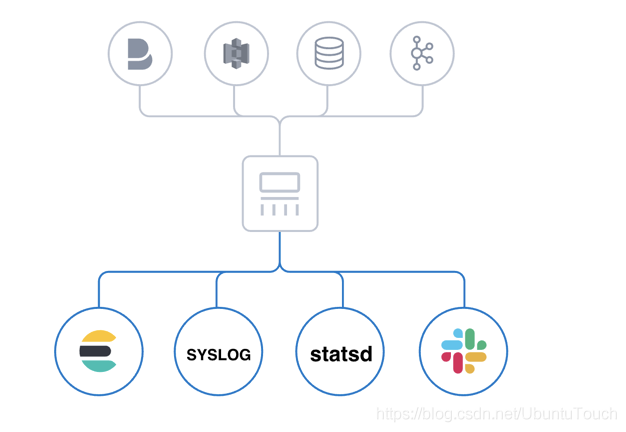
3.3.2 工作原理
输入 , 以下是常见的输入内容
file: 从文件系统上的文件读取 , 与UNIX命令非常相似tail -0Fsyslog: 在已知端口上侦听syslog消息进行解析redis: 使用redis通道和redis列表从redis服务器读取。Redis通常用作集中式Logstash安装中的“代理” , 该安装将Logstash事件从远程Logstash“托运人”排队。beats: 处理Beats发送的事件 ,beats包括filebeat、packetbeat、winlogbeat。
过滤 , 以下是常见的过滤器
grok: 解析并构造任意文本。Grok是目前Logstash中将非结构化日志数据解析为结构化和可查询内容的最佳方式。Logstash内置了120种模式 , 您很可能会找到满足您需求的模式!mutate: 对事件字段执行常规转换。您可以重命名 , 删除 , 替换和修改事件中的字段。drop: 完全删除事件 , 例如调试事件。clone: 制作事件的副本 , 可能添加或删除字段。geoip: 添加有关IP地址的地理位置的信息(也在Kibana中显示惊人的图表!)
输出 , 以下是常见的输出内容
elasticsearch: 将事件数据发送给Elasticsearch。如果您计划以高效 , 方便且易于查询的格式保存数据......Elasticsearch是您的最佳选择file: 将事件数据写入磁盘上的文件。graphite: 将事件数据发送到graphite, 这是一种用于存储和绘制指标的流行开源工具。http://graphite.readthedocs.io/en/latest/statsd: 将事件数据发送到statsd, 这是一种“侦听统计信息 , 如计数器和定时器 , 通过UDP发送并将聚合发送到一个或多个可插入后端服务”的服务。如果您已经在使用statsd, 这可能对您有用!
编解码器
编解码器基本上是流过滤器 , 可以作为输入或输出的一部分运行。使用编解码器可以轻松地将消息传输与序列化过程分开。流行的编解码器包括
json,multiline等。json: 以JSON格式编码或解码数据。multiline: 将多行文本事件(例如java异常和堆栈跟踪消息)合并到一个事件中
3. ELK部署
ELK官网: https://www.elastic.co/cn/
ELK中文社区 : 搜索客 , 搜索人自己的社区 (elasticsearch.cn)
ELK下载地址: Past Releases of Elastic Stack Software | Elastic
ELK官方使用文档 : Elasticsearch Guide 8.13] | Elastic
ELK各个版本对应支持一览表: 支持一览表 | Elastic
ELK官方文档总览: Elastic documentation | Elastic
4.1 安装部署elasticsearch
4.1.1 linux系统参数设置
设置系统配置
ulimit                    #暂时修改 , 切换到该用户es , ulimit -n 65535
/etc/security/limits.conf #永久修改 es - nofile 65535
ulimit -a                 #查看当前用户的资源限制

#配置文件描述符
ulimit -n 65535                #临时修改
vim /etc/security/limits.conf  #永久修改
es     soft  nofile   65535
es     hard  nofile   65535

#配置线程数
ulimit -u 4096                 #临时修改
vim /etc/security/limits.conf  #永久修改
es         soft    nproc     65535
es         hard    nproc     65535
禁用
sawpping方式一:swapoff -a #临时禁用所有的swap文件 vim /etc/fstab #注释掉所有的swap相关的行 , 永久禁用方式二 :
cat /proc/sys/vm/swappiness  #查看该值
sysctl vm.swappiness=1       #临时修改该值为1
vim /etc/sysctl.conf         #修改文件 永久生效
vm.swappiness = 1            #如果有该值 , 则修改该值 , 若没有 , 则追加该选项 , sysctl -p生效命令
方式三 :
配置elasticsearch.yml文件 , 添加如下配置 :
bootstrap.memory_lock: true
GET _nodes?filter_path=**.mlockall   #检查如上配置是否成功
注意 : 如果试图分配比可用内存更多的内存 , mlockall可能会导致JVM或shell会话退出!
配置虚拟内存
sysctl -w vm.max_map_count=262144  #临时修改该值
vim /etc/sysctl.conf               #永久修改
vm.max_map_count=262144
这里官方提供的安装包在elasticsearch 6版本之前需要手动安装jdk1.8环境。在elasticsearch 7版本的时候, 提供了自带jdk和没有jdk的两个版本。在elasticsearch 8版本之后所有软件包默认带有jdk了
4.1.2 安装
4.1.2.1 apt/yum安装
清华大学下载地址 : Index of /elasticstack/ | 清华大学开源软件镜像站 | Tsinghua Open Source Mirror
官网下载地址 : https://www.elastic.co/cn/downloads/past-releases#elasticsearch
安装
elasticsearchroot@elasticsearch01:~# dpkg -i elasticsearch-8.13.1-amd64.deb准备存放目录
root@elasticsearch02:~# mkdir /data
root@elasticsearch02:~# chown elasticsearch -R /data
修改
elasticsearch配置文件root@elasticsearch01:~# grep "^[a-Z]" /etc/elasticsearch/elasticsearch.yml cluster.name: elasticsearch-cluster # cluster集群名称 , 与其他集群的名称一致 node.name: elasticsearch-cluster-node01 # 写一个node名称 , 与其他node名称不一致 path.data: /data/esdata # 将数据保存在挂载的独立的data磁盘目录下 path.logs: /data/eslog # 日志保存的目录 bootstrap.memory_lock: true # 开启的话就会固定占用默认的2g内存, 防止数据写入SWAP network.host: 0.0.0.0 # 监听的IP地址 http.port: 9200 # 监听端口 discovery.seed_hosts: ["192.168.71.29", "192.168.71.30", "192.168.71.31"] #集群中node节点发现列表 cluster.initial_master_nodes: ["192.168.71.29", "192.168.71.30","192.168.71.31"] # 集群初始化那些节点可以被选举为master gateway.recover_after_data_nodes: 2 #一个集群中的N个节点启动后,才允许进行数据恢复处理 , 默认是1 action.destructive_requires_name: true #设置是否可以通过正则或者_all删除或者关闭索引库 , 默认true表示必须需要 显式指定索引库名称 , 生产环境建议设置为true , 删除索引库的时候必须指定 , 否则可能会误删索引库中的索引库。 xpack.security.enabled: false #关闭证书验证 xpack.security.enrollment.enabled: false #关闭证书验证 xpack.security.http.ssl: xpack.security.transport.ssl: http.host: 0.0.0.0 #Elasticsearch7新增参数 , 设置每个节点在选中的主节点的检查之间等待的时间。默认为1秒 cluster.fault_detection.leader_check.interval: 2s #Elasticsearch7新增参数 , 启动后30秒内 , 如果集群未形成 , 那么将会记录一条警告信息 , 警告信息未master not fount开始 , 默认为10秒 discovery.cluster_formation_warning_timeout: 30s #Elasticsearch7新增参数 , 节点发送请求加入集群后 , 在认为请求失败后 , 再次发送请求的等待时间 , 默认为60秒 cluster.join.timeout: 30s #Elasticsearch7新增参数 , 设置主节点等待每个集群状态完全更新后发布到所有节点的时间 , 默认为30秒 cluster.publish.timeout: 90s #集群内同时启动的数据任务个数 , 默认是2个 cluster.routing.allocation.cluster_concurrent_rebalance: 32 #添加或删除节点及负载均衡时并发恢复的线程个数 , 默认4个 cluster.routing.allocation.node_concurrent_recoveries: 32 #初始化数据恢复时 , 并发恢复线程的个数 , 默认4个 cluster.routing.allocation.node_initial_primaries_recoveries: 32 # 开启xpack安全验证 xpack.security.enabled: true xpack.license.self_generated.type: basic xpack.security.transport.ssl.enabled: true # 证书配置 xpack.security.transport.ssl.verification_mode: certificate xpack.security.transport.ssl.keystore.path: certs/elastic-certificates.p12 xpack.security.transport.ssl.truststore.path: certs/elastic-certificates.p12将此配置文件传到另外一个
elasticsearch主机上 , 修改node名称即可 , 实现集群分布root@elasticsearch02:~# grep "^[a-Z]" /etc/elasticsearch/elasticsearch.yml cluster.name: elasticsearch-cluster node.name: elasticsearch-cluster-node02 path.data: /data/esdata path.logs: /data/eslog bootstrap.memory_lock: true network.host: 0.0.0.0 http.port: 9200 discovery.seed_hosts: ["192.168.71.29", "192.168.71.30", "192.168.71.31"] cluster.initial_master_nodes: ["192.168.71.29", "192.168.71.30","192.168.71.31"] gateway.recover_after_data_nodes: 2 action.destructive_requires_name: true xpack.security.enabled: false xpack.security.enrollment.enabled: false xpack.security.http.ssl: xpack.security.transport.ssl: http.host: 0.0.0.0修改
elasticsearch内存限制由于默认占用内存为2G , 生产中肯定不够使用 , 我们需要将占用的固定内存改为物理机内存的
50%, 最大不要超过32Groot@elasticsearch02:~# vi /lib/systemd/system/elasticsearch.service LimitMEMLOCK=infinity # 修改elasticsearch启动服务的无限制使用内存修改
elasticsearch的内存使用配置文件 , 为了覆盖默认堆大小,需要将最大最小内存设置一样root@elasticsearch01:~# vi /etc/elasticsearch/jvm.options -Xms2g # 最小内存为2g -Xmx2g # 最大内存为2g修改
/etc/security/limits.conf配置文件 ,centos系统前面写*可以生效 , 但是ubuntu需要写上elsaticsearch用户名 , 才能生效。* soft core unlimited * hard core unlimited * soft nproc 1000000 * hard nproc 1000000 * soft nofile 1000000 * hard nofile 1000000 * soft memlock 32000 * hard memlock 32000 * soft msgqueue 8192000 * hard msgqueue 8192000
启动
elasticsearch服务root@elasticsearch01:~# systemctl daemon-reload root@elasticsearch01:~# systemctl restart elasticsearch验证服务
root@elasticsearch01:~# ss -ntlp
State       Recv-Q      Send-Q           Local Address:Port            Peer Address:Port      Process
LISTEN      0           128                    0.0.0.0:22                   0.0.0.0:*          users:(("sshd",pid=733,fd=3))
LISTEN      0           4096             127.0.0.53%lo:53                   0.0.0.0:*          users:(("systemd-resolve",pid=663,fd=14))
LISTEN      0           4096                         *:9300                       *:*          users:(("java",pid=4532,fd=449))
LISTEN      0           4096                         *:9200                       *:*          users:(("java",pid=4532,fd=490))
LISTEN      0           128                       [::]:22                      [::]:*          users:(("sshd",pid=733,fd=4))
通过网站访问
elasticsearch, 查看是否能够访问 :192.168.71.29:9200、192.168.71.30:9200、192.168.71.31:9200root@elasticsearch01:~# curl 192.168.71.29:9200 { "name" : "elasticsearch-cluster-node01", "cluster_name" : "elasticsearch-cluster", "cluster_uuid" : "BP7ppt1yTwKQB2W_MupHCw", "version" : { "number" : "8.13.1", "build_flavor" : "default", "build_type" : "deb", "build_hash" : "9287f29bba5e270bd51d557b8daccb7d118ba247", "build_date" : "2024-03-29T10:05:29.787251984Z", "build_snapshot" : false, "lucene_version" : "9.10.0", "minimum_wire_compatibility_version" : "7.17.0", "minimum_index_compatibility_version" : "7.0.0" }, "tagline" : "You Know, for Search" } root@elasticsearch01:~# curl 192.168.71.30:9200 { "name" : "elasticsearch-cluster-node02", "cluster_name" : "elasticsearch-cluster", "cluster_uuid" : "BP7ppt1yTwKQB2W_MupHCw", "version" : { "number" : "8.13.1", "build_flavor" : "default", "build_type" : "deb", "build_hash" : "9287f29bba5e270bd51d557b8daccb7d118ba247", "build_date" : "2024-03-29T10:05:29.787251984Z", "build_snapshot" : false, "lucene_version" : "9.10.0", "minimum_wire_compatibility_version" : "7.17.0", "minimum_index_compatibility_version" : "7.0.0" }, "tagline" : "You Know, for Search" } root@elasticsearch01:~# curl 192.168.71.31:9200 { "name" : "elasticsearch-cluster-node03", "cluster_name" : "elasticsearch-cluster", "cluster_uuid" : "BP7ppt1yTwKQB2W_MupHCw", "version" : { "number" : "8.13.1", "build_flavor" : "default", "build_type" : "deb", "build_hash" : "9287f29bba5e270bd51d557b8daccb7d118ba247", "build_date" : "2024-03-29T10:05:29.787251984Z", "build_snapshot" : false, "lucene_version" : "9.10.0", "minimum_wire_compatibility_version" : "7.17.0", "minimum_index_compatibility_version" : "7.0.0" }, "tagline" : "You Know, for Search" }
由于对应包里面的systemd文件中是静默输出,可以通过去掉运行命令中的--quiet查看具体的输出信息, 以方便排错
ExecStart=/usr/share/elasticsearch/bin/systemd-entrypoint -p ${PID_DIR}/elasticsearch.pid --quiet
修改为
ExecStart=/usr/share/elasticsearch/bin/systemd-entrypoint -p ${PID_DIR}/elasticsearch.pid
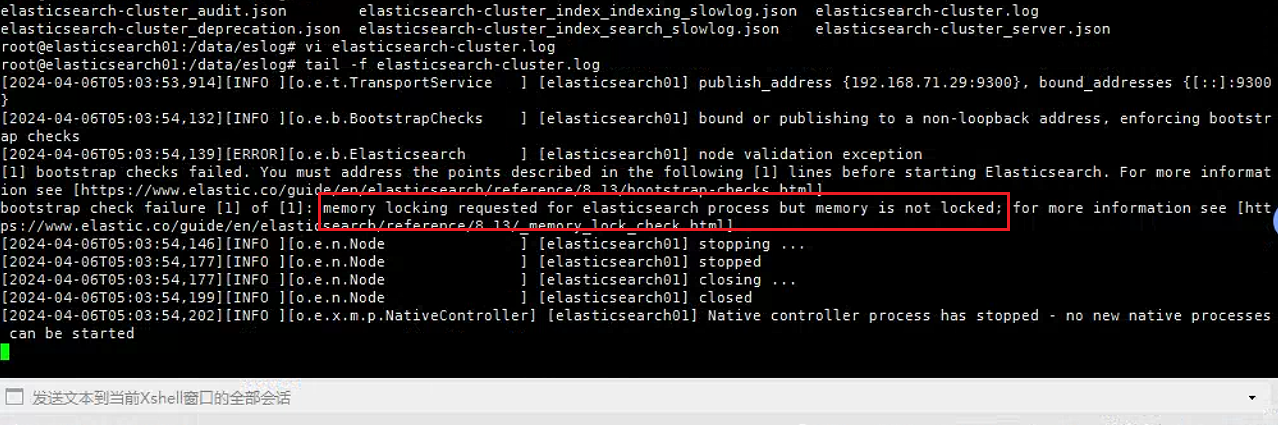
如果没有配置内存限制, 会提示如下图所示报错 :
4.1.2.2 二进制安装
下载
elasticsearch解压
[root@elasticsearch-85 ~]# tar -xf elasticsearch-8.13.1-linux-x86_64.tar.gz -C /usr/local/src/
[root@elasticsearch-85 ~]# ln -sv /usr/local/src/elasticsearch-8.13.1 /usr/local/src/elasticsearch
'/usr/local/src/elasticsearch' -> '/usr/local/src/elasticsearch-8.13.1'
创建对应用户, 用以启动
elasticsearch[root@elasticsearch-85 ~]# useradd -r -M -s /bin/false es创建对应systemd文件, 之后直接启动即可
[root@elasticsearch-85 elasticsearch]# cat /usr/lib/systemd/system/elasticsearch.service
[Unit]
Description=Elasticsearch
Documentation=https://www.elastic.co
Wants=network-online.target
After=network-online.target

[Service]
Type=simple

User=es
Group=es

ExecStart=/usr/local/src/elasticsearch/bin/elasticsearch

# StandardOutput is configured to redirect to journalctl since
# some error messages may be logged in standard output before
# elasticsearch logging system is initialized. Elasticsearch
# stores its logs in /var/log/elasticsearch and does not use
# journalctl by default. If you also want to enable journalctl
# logging, you can simply remove the "quiet" option from ExecStart.
StandardOutput=journal
StandardError=inherit

# Specifies the maximum file descriptor number that can be opened by this process
LimitNOFILE=65535

# Specifies the maximum number of processes
LimitNPROC=4096

# Specifies the maximum size of virtual memory
LimitAS=infinity
LimitMEMLOCK=infinity

# Specifies the maximum file size
LimitFSIZE=infinity

# Disable timeout logic and wait until process is stopped
TimeoutStopSec=0

# SIGTERM signal is used to stop the Java process
KillSignal=SIGTERM

# Send the signal only to the JVM rather than its control group
KillMode=process

# Java process is never killed
SendSIGKILL=no

# When a JVM receives a SIGTERM signal it exits with code 143
SuccessExitStatus=143

# Allow a slow startup before the systemd notifier module kicks in to extend the timeout
TimeoutStartSec=900

[Install]
WantedBy=multi-user.target

# Built for packages-8.13.1 (packages)
4.1.3 配置文件说明
rpm/deb包涉及到的目录:
elasticsearch整体存放目录:/usr/share/elasticsearch配置文件目录:
/etc/elasticsearchPID目录:/var/run/elasticsearch服务启动时读取的参数配置文件:
/etc/default/elasticsearch(ubuntu)/etc/sysconfig/elasticsearch(centos)
Cluser配置
Node配置
Indices部分
Indices Circuit Breaker
elasticsearch包含多个circuit breaker来避免操作的内存溢出。每个breaker都指定可以使用内存的限制。另外有一个父级breaker指定所有的breaker可以使用的总内存Field Data Circuit Breaker
允许
elasticsearch预算待加载field的内存 , 防止field数据加载引发异常Request Circuit Breaker
请求断路器,允许
elasticsearch防止每个请求的数据结构超过了一定量的内存Indices Fielddata Cache
字段数据缓存主要用于排序字段和计算聚合。将所有的字段值加载到内存中 , 以便提供基于文档快速访问这些值
Indices Node Query Cache
query cache负责缓存查询结果 , 每个节点都有一个查询缓存共享给所有的分片。缓存实现一个LRU驱逐策略 : 当缓存使用已满 , 最近最少使用的数据将被删除 , 来缓存新的数据。query cache只缓存过滤过的上下文Indexing Buffer
索引缓冲区用于存储新索引的文档。缓冲区写满 , 缓冲区的文件才会写到硬盘。缓冲区划分给节点上的所有分片。
Indexing Buffer的配置是静态配置 , 必须配置都集群中的所有数据节点
Indices Shard Request Cache
当一个搜索请求是对一个索引或者多个索引的时候 , 每一个分片都是进行它自己内容的搜索然后把结果返回到协调节点 , 然后把这些结果合并到一起统一对外提供。分片缓存模块缓存了这个分片的搜索结果。这使得搜索频率高的请求会立即返回。
注意 : 请求缓存只缓存查询条件 size=0的搜索 , 缓存的内容有hits.total, aggregations, suggestions , 不缓存原始的hits。通过now查询的结果将不缓存。 缓存失效 : 只有在分片的数据实际上发生了变化的时候刷新分片缓存才会失效。刷新的时间间隔越长 , 缓存的数据越多 , 当缓存不够的时候 , 最少使用的数据将被删除
缓存过期可以手工设置 , 例如:
curl -XPOST 'localhost:9200/kimchy,elasticsearch/_cache/clear?request_cache=true'默认情况下缓存未启用 , 但在创建新的索引时可启用 , 例如:
curl -XPUT localhost:9200/my_index -d'
{
  "settings": {
    "index.requests.cache.enable": true
  }
}'
当然也可以通过动态参数配置来进行设置:
curl -XPUT localhost:9200/my_index/_settings -d'
{ "index.requests.cache.enable": true }'
每请求启用缓存 , 查询字符串参数request_cache可用于启用或禁用每个请求的缓存。例如:
curl 'localhost:9200/my_index/_search?request_cache=true' -d'
{
  "size": 0,
  "aggs": {
    "popular_colors": {
      "terms": {
        "field": "colors"
      }
    }
  }
}'
分片请求缓存是在节点级别进行管理的 , 并有一个默认的值是JVM堆内存大小的1% , 可以通过配置文件进行修改。 例如 : indices.requests.cache.size: 2%
分片缓存大小的查看方式:
curl 'localhost:9200/_stats/request_cache?pretty&human'或者curl 'localhost:9200/_nodes/stats/indices/request_cache?pretty&human'
Indices Recovery
Indices TTL Interval
Paths配置
Memory配置
可以通过请求查看
mlockall的值是否设定:curl http://localhost:9200/_nodes/process?pretty如果
mlockall的值是false, 则设置失败。可能是由于elasticsearch的临时目录( /tmp) 挂载的时候没有可执行权限。可以使用下面的命令来更改临时目录:
./bin/elasticsearch -Djna.tmpdir=/path/to/new/dir
Network,Transport,HTTP配置
Discovery配置
elasticsearch 6 之前的配置
elasticsearch 7 之后的配置
Gateway配置
elasticsearch7 之后有效的参数: gateway.expected_data_nodes ,gateway.recover_after_data_nodes ,gateway.recover_after_time: 5m
4.1.4 监控elasticsearch集群服务器的健康性
用curl命令对集群的健康性状态进行检查 , 如果返回值是green , 说明正常 , 是yellow , 说明是副本的分片丢失 , 如果是red , 表示主片丢失。
[root@elasticsearch-85 ~]# curl -sXGET http://192.168.71.29:9200/_cluster/health?pretty=true
{
  "cluster_name" : "elasticsearch-cluster",
  "status" : "green",
  "timed_out" : false,
  "number_of_nodes" : 3,
  "number_of_data_nodes" : 3,
  "active_primary_shards" : 0,
  "active_shards" : 0,
  "relocating_shards" : 0,
  "initializing_shards" : 0,
  "unassigned_shards" : 0,
  "delayed_unassigned_shards" : 0,
  "number_of_pending_tasks" : 0,
  "number_of_in_flight_fetch" : 0,
  "task_max_waiting_in_queue_millis" : 0,
  "active_shards_percent_as_number" : 100.0
} 以下是编辑对集群健康性检查的python脚本 , 如果返回值是50 , 说明elasticsearch集群正常。
[root@elasticsearch-85 ~]# cat test.py
#!/usr/bin/env python
#coding:utf-8
#Author liu
import smtplib
from email.mime.text import MIMEText
from email.utils import formataddr
import subprocess
body = ""
false="false"
obj = subprocess.Popen(("curl -sXGET http://192.168.71.29:9200/_cluster/health?pretty=true"),shell=True,stdout=subprocess.PIPE)
data=obj.stdout.read()
data1=eval(data)
status=data1.get("status")
if status == "green":
        print("50")
else:
        print("100")
[root@elasticsearch-85 ~]# python3 test.py
50
4.1.5. 插件安装
插件是为了完成不同的功能 , 官方提供了一些插件但大部分是收费的 , 另外也有一些开发 爱好者提供的插件 , 可以实现对elasticsearch集群的状态监控与管理配置等功能。
4.1.5.1 elasticsearch 插件之head
在elasticsearch 5.x版本以后不再支持直接安装head插件 , 而是需要通过启动 一个服务方式。
git地址 : https://github.com/mobz/elasticsearch-head
4.1.5.1.1 通过npm安装
由于git地址在外网,手动下载对应包
解压
[root@elasticsearch-85 ~]# unzip elasticsearch-head-master.zip安装
[root@elasticsearch-85 elasticsearch-head-master]# npm install grunt -save
npm WARN deprecated coffee-script@1.10.0: CoffeeScript on NPM has moved to "coffeescript" (no hyphen)
npm notice created a lockfile as package-lock.json. You should commit this file.
npm WARN elasticsearch-head@0.0.0 license should be a valid SPDX license expression

+ grunt@1.0.1
added 97 packages from 67 contributors and audited 97 packages in 14.184s

6 packages are looking for funding
  run `npm fund` for details

found 22 vulnerabilities (2 low, 7 moderate, 10 high, 3 critical)
  run `npm audit fix` to fix them, or `npm audit` for details
[root@elasticsearch-85 elasticsearch-head-master]# ll node_modules/grunt     #确认生成文件
total 32
drwxr-xr-x 2 root root 4096 Apr  6 19:49 bin
-rw-r--r-- 1 root root 7111 Apr  6  2016 CHANGELOG
drwxr-xr-x 4 root root 4096 Apr  6 19:49 lib
-rw-r--r-- 1 root root 1592 Mar 23  2016 LICENSE
drwxr-xr-x 5 root root 4096 Apr  6 19:49 node_modules
-rw-r--r-- 1 root root 2509 Apr  6 19:49 package.json
-rw-r--r-- 1 root root  878 Feb 12  2016 README.md
[root@elasticsearch-85 elasticsearch-head-master]# npm install

[root@elasticsearch-85 elasticsearch-head-master]# npm run start   #前台启动插件

> elasticsearch-head@0.0.0 start /root/elasticsearch-head-master
> grunt server

>> Local Npm module "grunt-contrib-jasmine" not found. Is it installed?

Running "connect:server" (connect) task
Waiting forever...
Started connect web server on http://localhost:9100
修改
elasticsearch配置文件, 添加如下内容http.cors.enabled: true http.cors.allow-origin: "*"访问页面:
http://IP:9100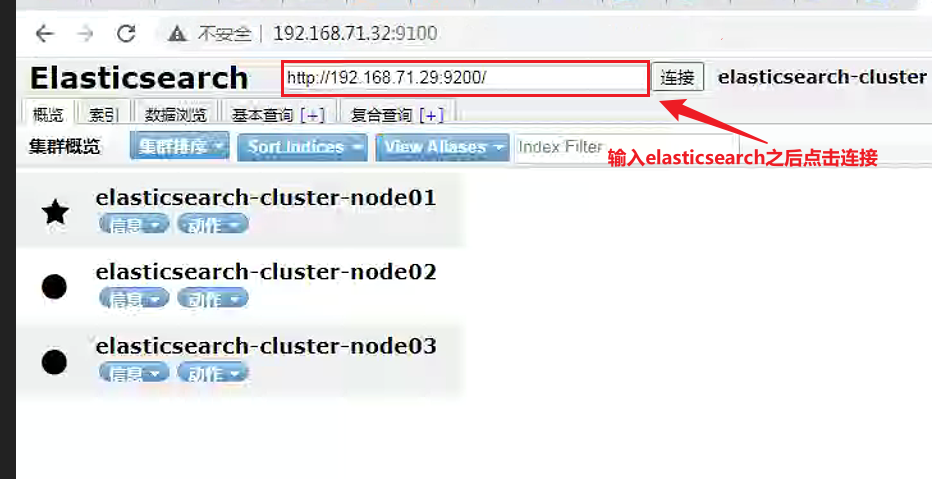
4.1.5.1.2 通过docker安装
安装并启动
docker[root@elasticsearch-85 ~]# yum install docker [root@elasticsearch-85 ~]# systemctl start podman下载并启动
elasticsearch head插件[root@elasticsearch-85 ~]# docker run -p 9100:9100 mobz/elasticsearch-head:5之后访问页面即可
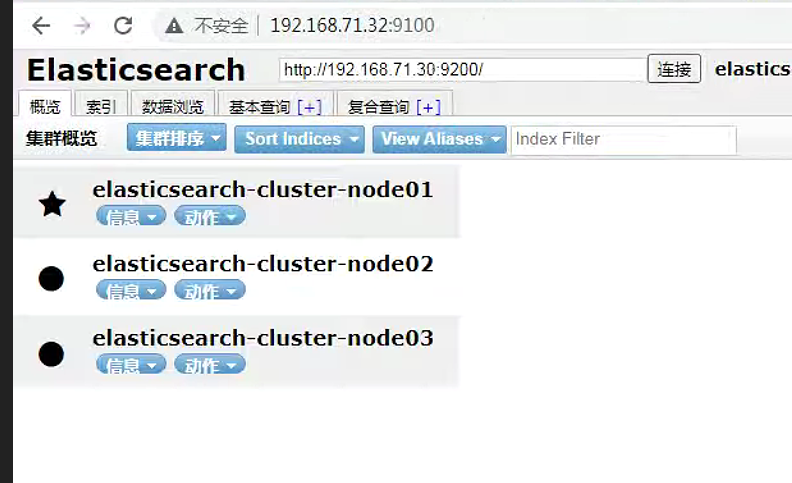
4.1.5.2 elasticsearch 插件之 kopf
Git 地址为https://github.com/lmenezes/elasticsearch-kopf , 但是目前还不支持5.x版本的elasticsearch , 但是可以安装在elasticsearc 1.x 或2.x的版本安装。
4.1.5.3 elasticsearch 插件之 cerebo
4.1.5.3.1 安装
新开源的elasticsearch集群 web 管理程序 , 需要java11或者更高版本 , https://github.com/lmenezes/cerebro
下载对应软件包
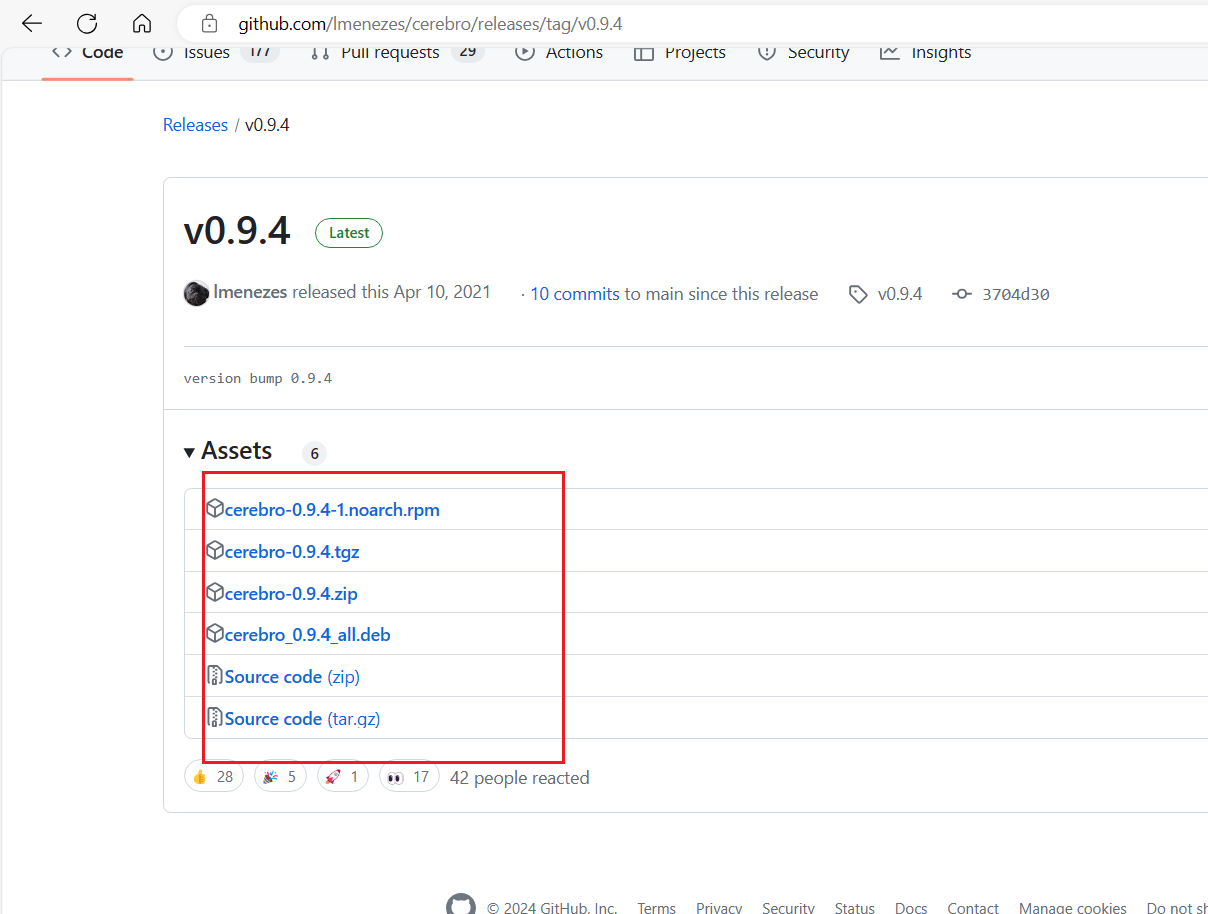
直接安装对应的rpm包
[root@elasticsearch-79 ~]# rpm -ivh cerebro-0.9.4-1.noarch.rpmcerebro直接运行以下命令就可以直接启动, 开启端口为9000。运行过程中可以通过-java-home指定java命令位置[root@elasticsearch-79 ~]# /usr/share/cerebro/bin/cerebro [root@elasticsearch-79 ~]# /usr/share/cerebro/bin/cerebro -h Usage: [options] -h | -help print this message -v | -verbose this runner is chattier -d | -debug enable debug output for the launcher script -no-version-check Don't run the java version check. -main <classname> Define a custom main class -jvm-debug <port> Turn on JVM debugging, open at the given port. # java version (default: java from PATH, currently java version "11.0.22" 2024-01-16 LTS) -java-home <path> alternate JAVA_HOME # jvm options and output control JAVA_OPTS environment variable, if unset uses "" -Dkey=val pass -Dkey=val directly to the java runtime -J-X pass option -X directly to the java runtime (-J is stripped) # special option -- To stop parsing built-in commands from the rest of the command-line. e.g.) enabling debug and sending -d as app argument $ ./start-script -d -- -d In the case of duplicated or conflicting options, basically the order above shows precedence: JAVA_OPTS lowest, command line options highest except "--". Available main classes: -jar "/usr/share/cerebro/lib/cerebro.cerebro-0.9.4-launcher.jar"配置
cerebro配置文件[root@elasticsearch-79 ~]# cat /etc/cerebro/application.conf java.home = /usr/local/src/jdk hosts = [ { # host = "http://localhost:9200" host = "http://192.168.71.30:9200" # name = "Localhost cluster" # headers-whitelist = [ "x-proxy-user", "x-proxy-roles", "X-Forwarded-For" ] } ]之后直接启动服务即可
[root@elasticsearch-79 ~]# systemctl start cerebro

[root@elasticsearch-79 ~]# systemctl cat cerebro
# /usr/lib/systemd/system/cerebro.service
[Unit]
Description=Elasticsearch web admin tool
Requires=network.target

[Service]
Type=simple
WorkingDirectory=/usr/share/cerebro
EnvironmentFile=/etc/default/cerebro
ExecStart=/usr/share/cerebro/bin/cerebro
ExecReload=/bin/kill -HUP $MAINPID
Restart=always
RestartSec=60
SuccessExitStatus=143
TimeoutStopSec=5
User=cerebro
ExecStartPre=/bin/mkdir -p /run/cerebro
ExecStartPre=/bin/chown cerebro:cerebro /run/cerebro
ExecStartPre=/bin/chmod 755 /run/cerebro
PermissionsStartOnly=true
LimitNOFILE=1024

[Install]
WantedBy=multi-user.target
另外可以通过命令下载docker镜像即可
docker run -p 9000:9000 --env-file env-ldap lmenezes/cerebro4.1.5.3.2 基本使用
之后页面访问9000端口即可
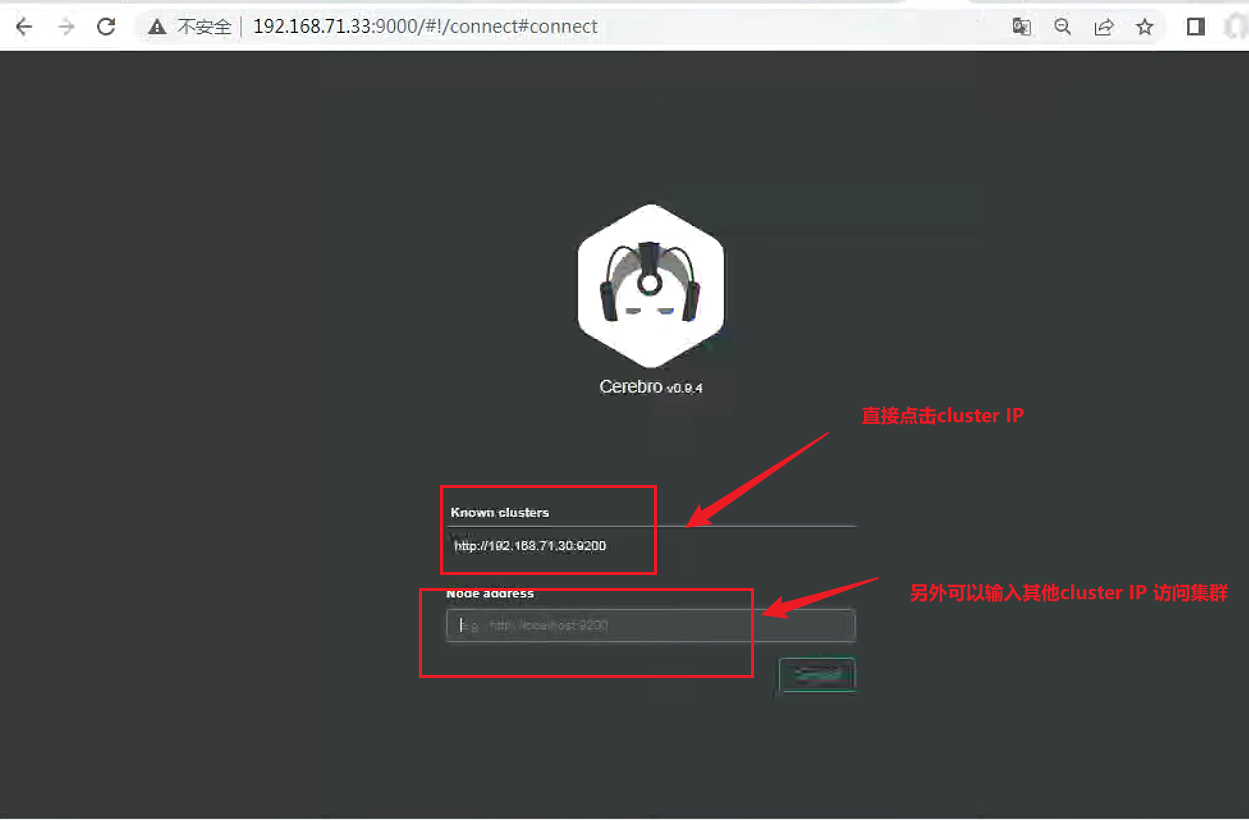
登录之后看到如图所示内容
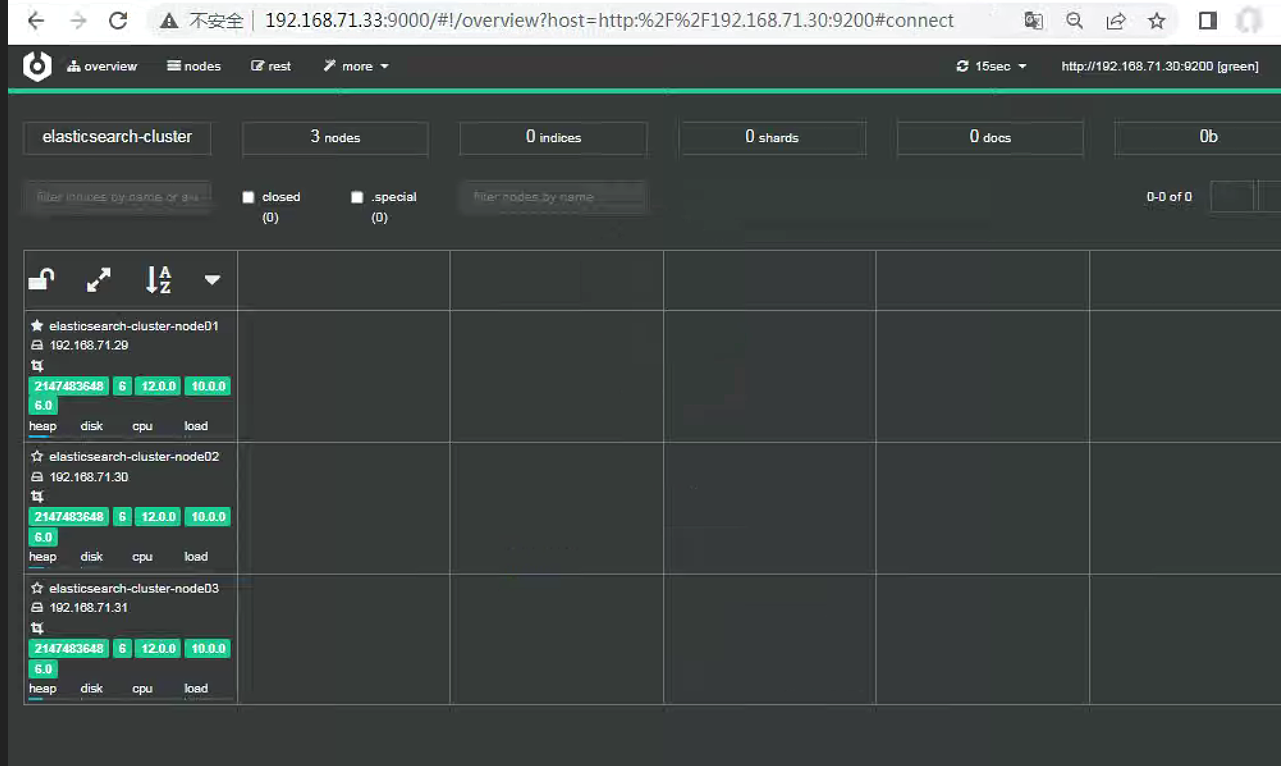
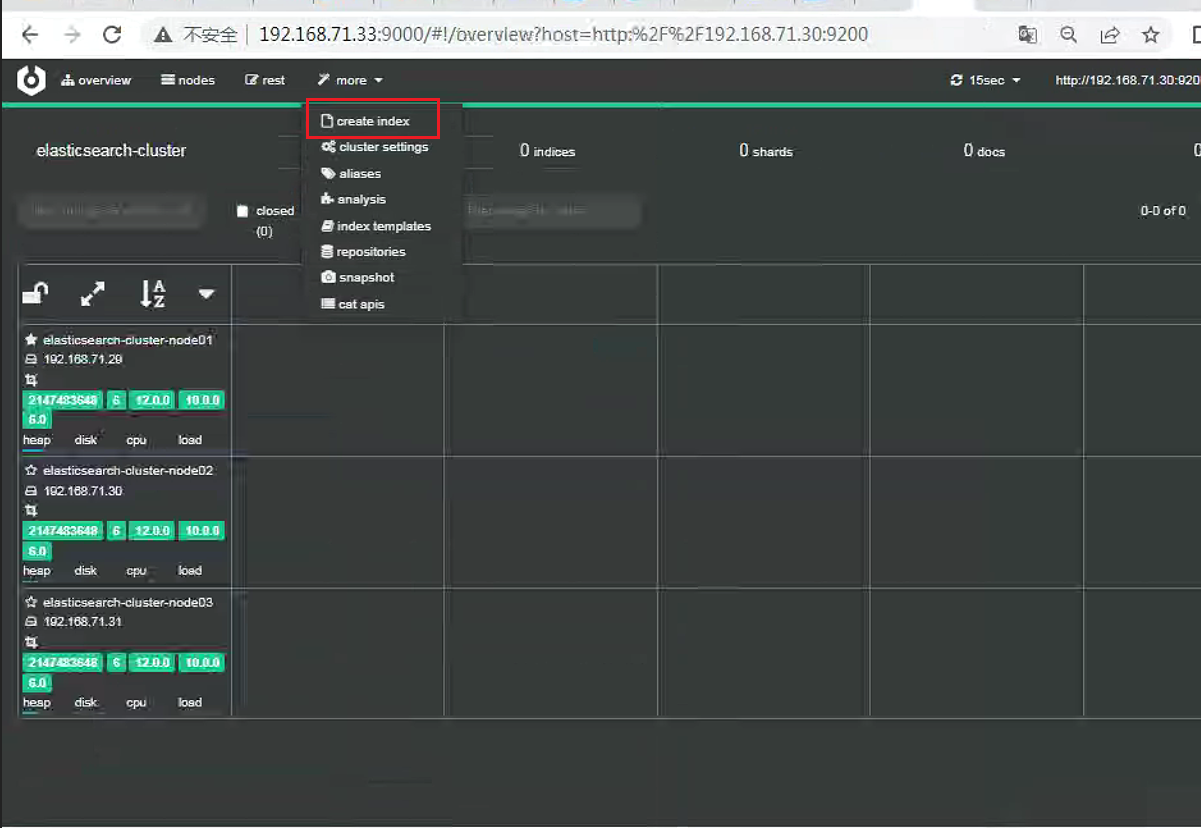
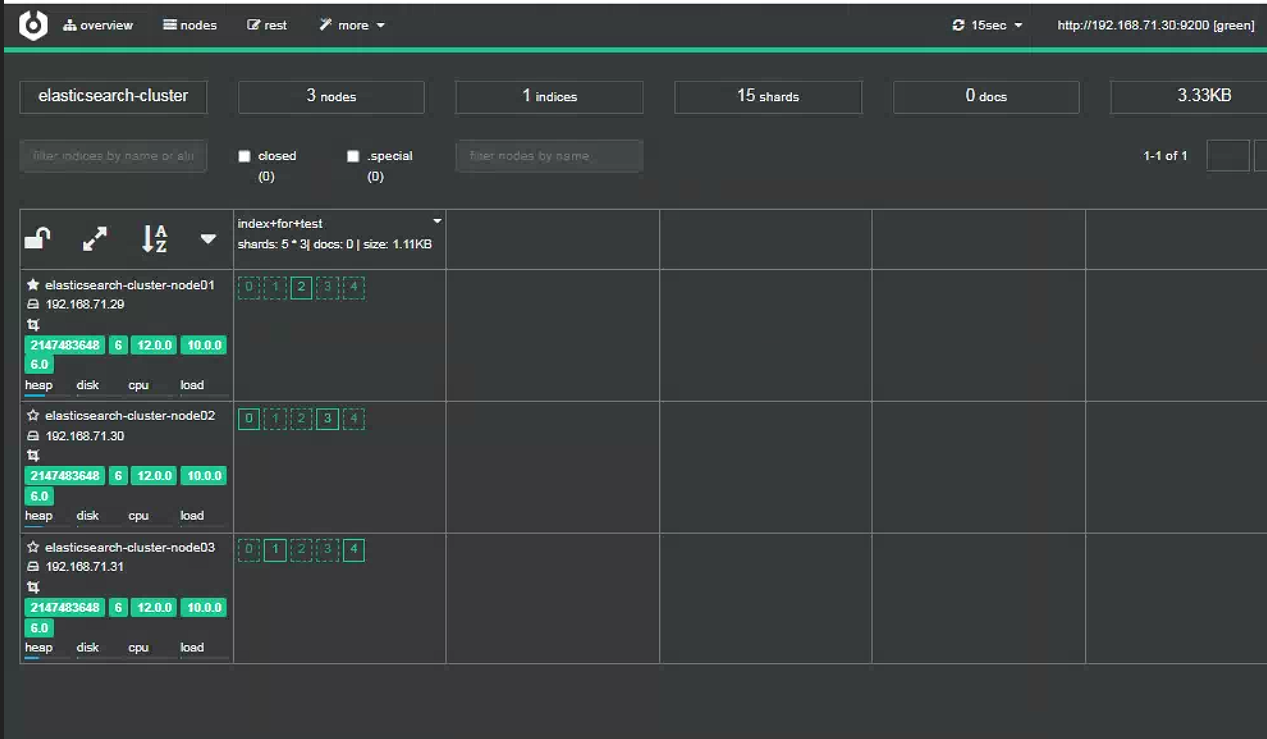
cerebro中可以通过点击Create index实现创建索引的功能
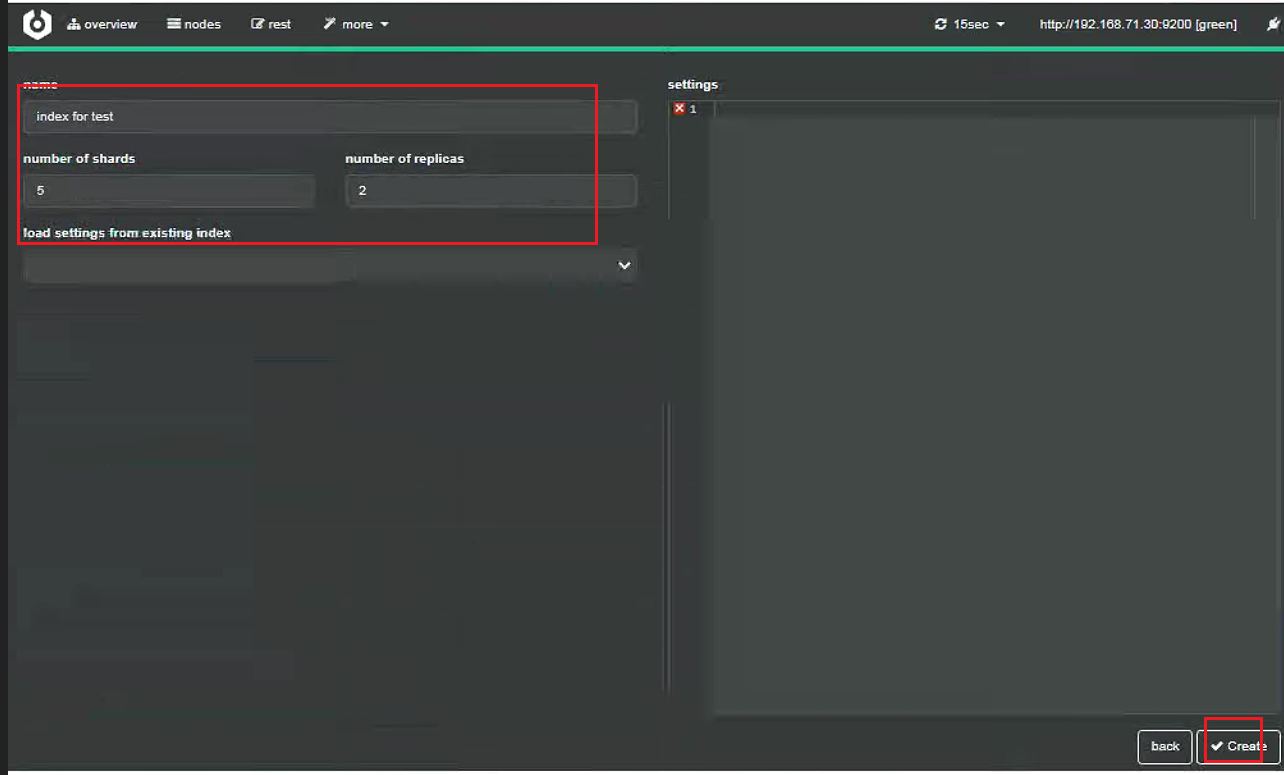
这里设置五个分片两个副本
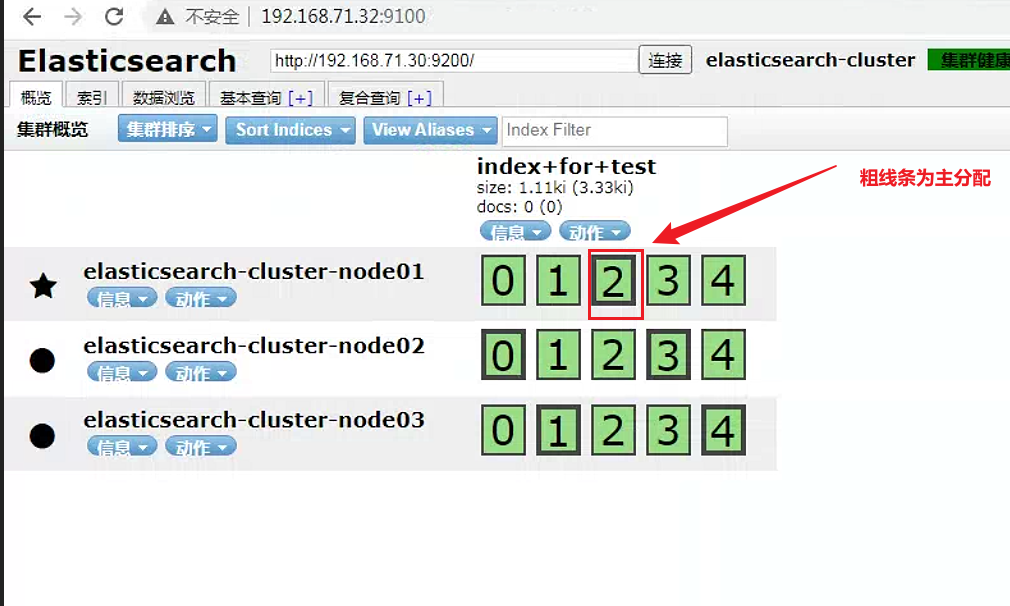
之后可以通过head查看分配。 其中粗线条为主分片
4.1.6 读写性能提升
读写就是插入和查询嘛 , 写的话可能有并发写 , 还有就是是否写完要立马可见 , 查的话还是和需求有关系 , 还有就是对查询一个语法的使用 , 还有就是查询数据会不会在内存中命中 , 这样的就减少去访问磁盘了 , 这里不说查询的一些语法和怎么查询更优 , 因为个人觉得这是属于应用级别的 , 和集群相关性不强 , 这里大概例举几个配置。
首先这里说一句 , 当并发写入的时候 , 必定涉及到thread pool的配置 , 这些配置不建议修改 , 但是实在不行 , 也可以提高到cpu核数的两倍 , 所以涉及到并发的 , 和计算的 , 当然cpu越好性能就会也好。
写和查询的时候会涉及到一些参数 , 可以根据实际情况调整提升性能:(下面的都不是默认值了 , 可以在官网去查询)
#可以配置在elasticsearch.yml文件中indices.memory.index_buffer_size: 20%
indices.memory.min_index_buffer_size: 96mb
indices.queries.cache.size: 20%
indices.requests.cache.size: 2%
#这里是索引级别的配置,需要配置在索引里面
index.merge.scheduler.max_thread_count: 1 #这个如果是ssd,使用默认的配置就好,这里配置为机械磁盘
index.refresh_interval: 60s
index.store.type: hybridfs
index.translog.sync_interval: 10s
index.translog.flush_threshold_size: 1024mb当然还有很多的配置,比如有配置translog的类型,可以提升性能,但是可能会牺牲数据的一致性。优化这种事情还是根据实际情况进行针对性的优化和取舍比较好。
4.1.7 HTTP filter
为了使用 HTTP filter,我们来修改 Elasticsearch 的配置文件 config/elasticsearch.yml :
xpack.security.http.filter.allow: "192.168.0.4"
xpack.security.http.filter.deny: "192.168.0.0/24"我们在Elasticsearch的配置文件中添加上面的两行配置。重新启动Elasticsearch。上面的两行表示只允许从 IP 地址 192.168.0.4 来进行访问,但是不支持从任何其它的 IP 地址,比如 192.168.0.0/24 进行访问。
同时可以用以下API更改配置。这样更改配置不用重启服务
curl -u elastic:password -XPUT 'http://192.168.0.3:9200/_cluster/settings?pretty=true' -H 'Content-Type: application/json' -d '
{
    "persistent": {
    "xpack.security.http.filter.deny": "_all",
    "xpack.security.http.filter.allow": ["localhost"]
  }
}'
4.2 安装部署 kibana
Kibana官网下载地址 : https://www.elastic.co/cn/downloads/past-releases#kibana
下载软件包, 并且安装
root@kibana:~# dpkg -i kibana-8.13.1-amd64.deb修改
kibana配置文件/etc/kibana/kibana.ymlroot@kibana:~# grep -i "^[a-Z]" /etc/kibana/kibana.yml server.port: 5601 # 默认的监听端口5601 server.host: "0.0.0.0" # 监听的IP地址 elasticsearch.hosts: ["http://192.168.71.29:9200"] # 对端elasticsearch集群主机的IP地址 i18n.locale: "zh-CN" # 添加此项支持汉化版启动
kibana服务 , 并设置为开机启动root@kibana:/etc/kibana# systemctl enable kibana --now Created symlink /etc/systemd/system/multi-user.target.wants/kibana.service → /lib/systemd/system/kibana.service.直接访问页面:
http://IP:5601。如果后端的elasticsearch出现故障,kibana页面也无法访问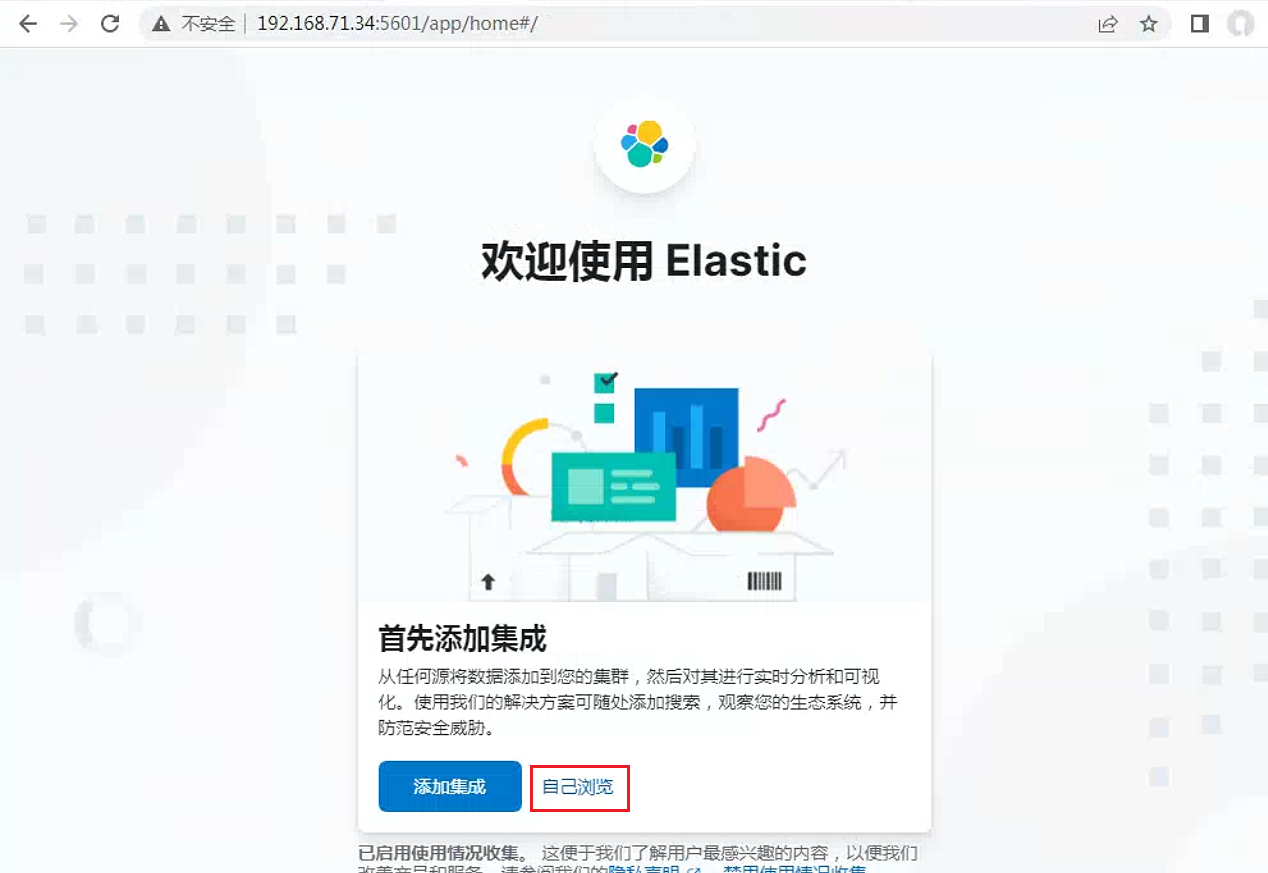
用样例数据测试功能
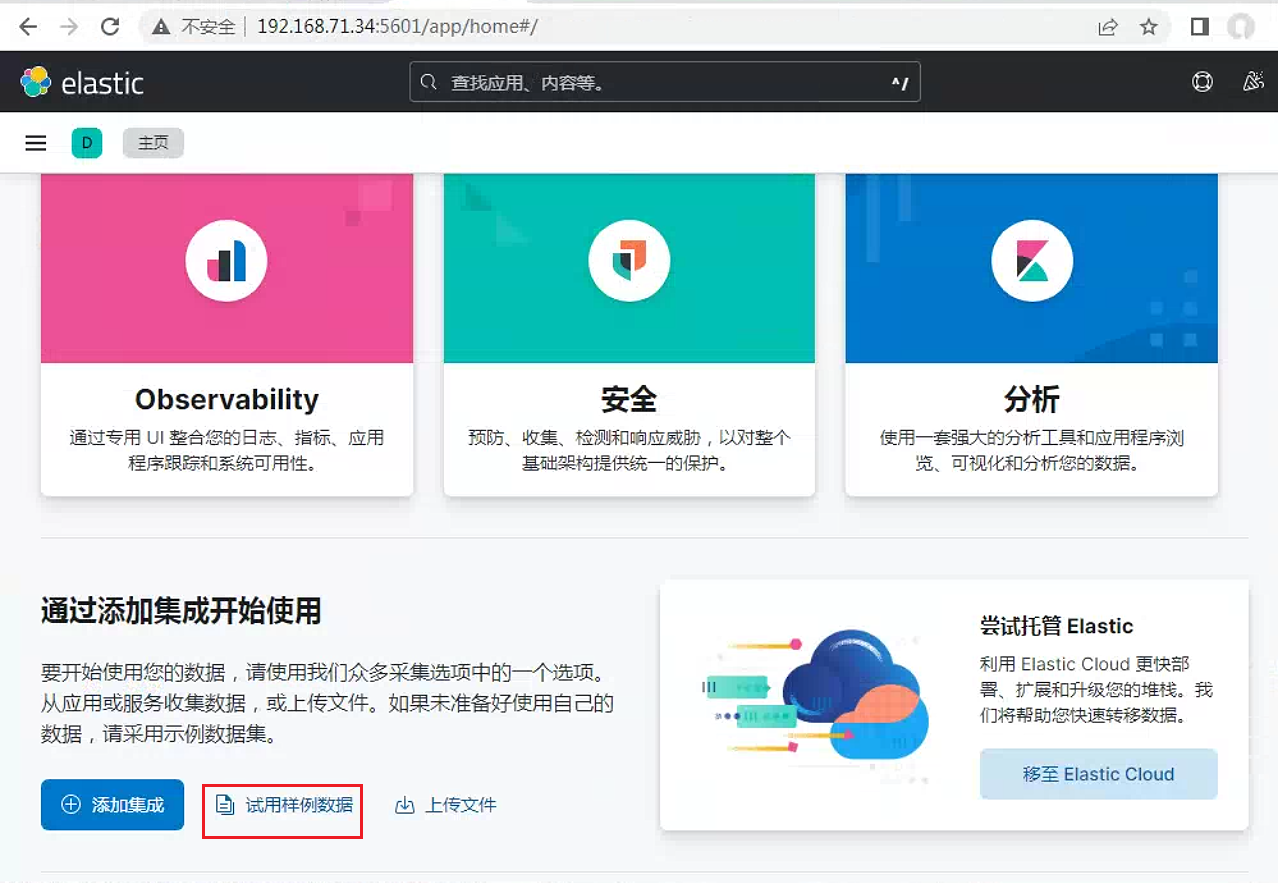
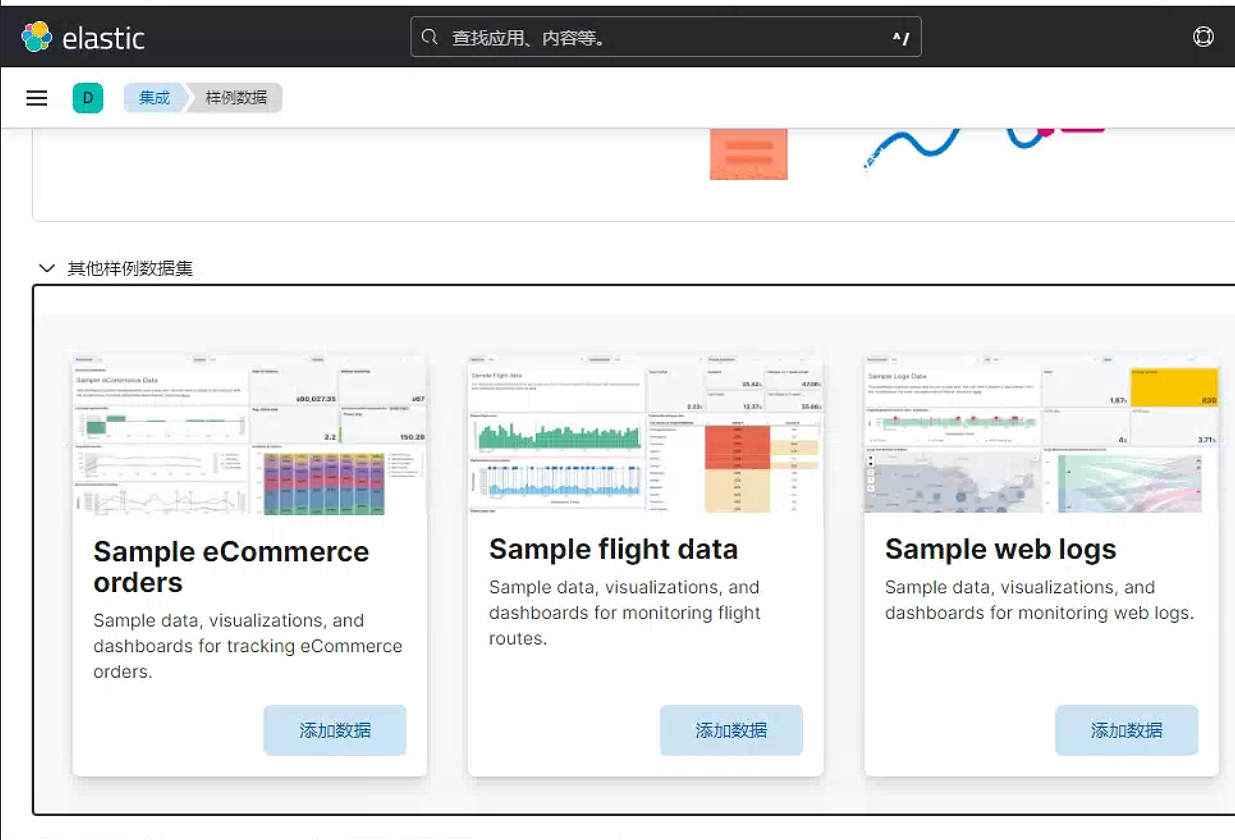
在
Discover中查看数据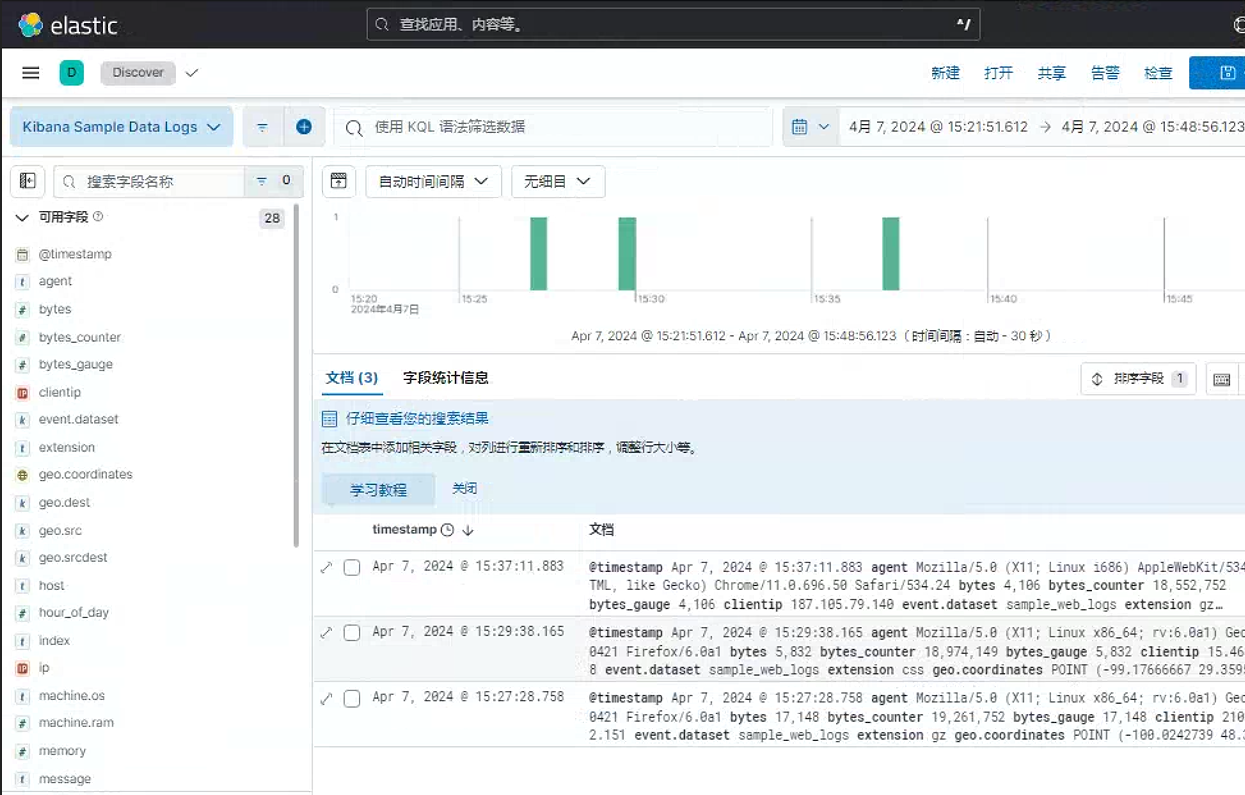
在head插件中插件
kibana数据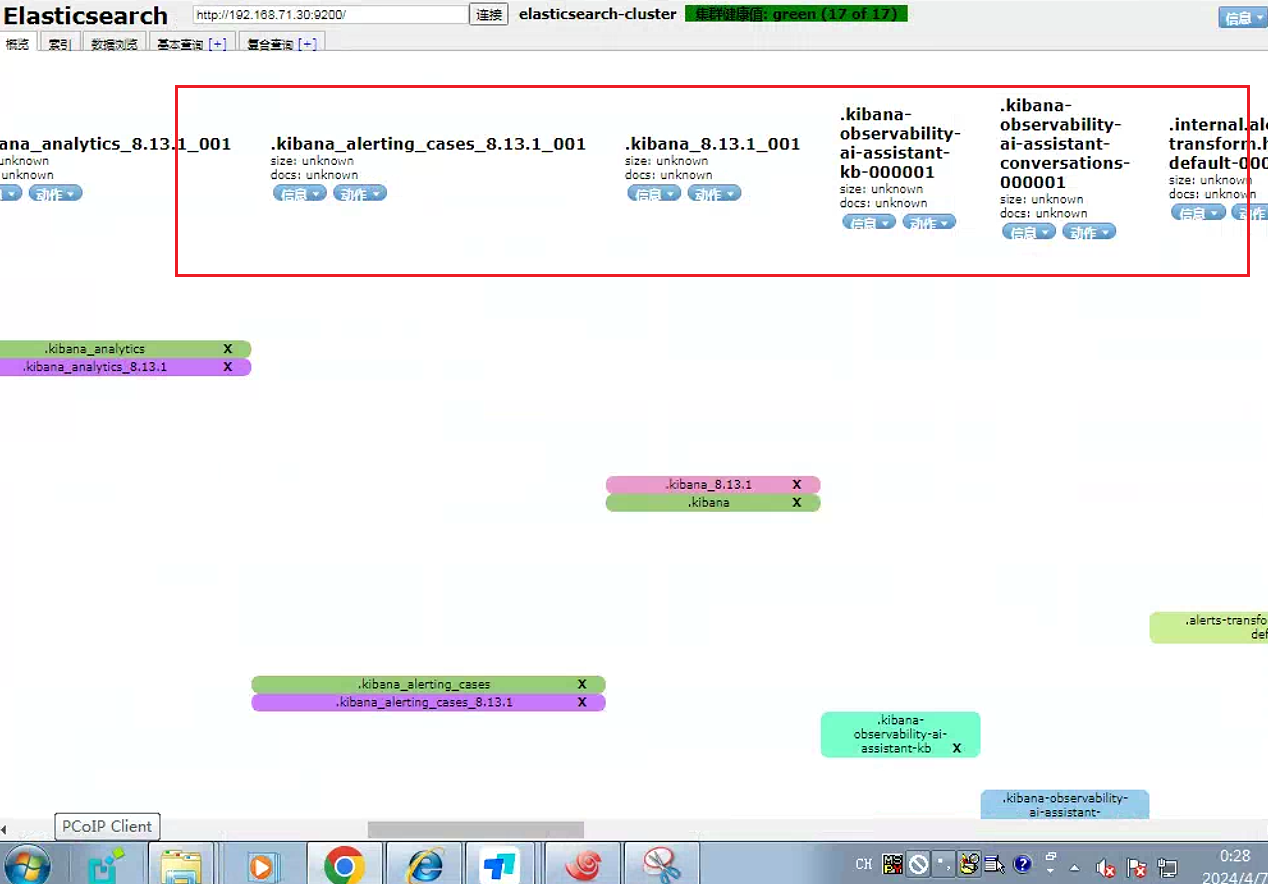
在
elasticsearch主机上查看创建的数据。默认以前版本的索引信息是创建时的索引名称,现在是已经HASH之后的root@elasticsearch03:/data/esdata/indices# pwd /data/esdata/indices root@elasticsearch03:/data/esdata/indices# ls 2HaJ6hBKQjKJIyPB6jAVdg eRSRkIyeTxaKst3DbOvNXA K6DUkkz1RhKsOG-0ECO1nw sLydbwtRQR-3OG47AC43Ww zEpfaYIxTRuSbA4RSdlayg cDY5InpTSHmU8pGrrmpEeA fZJjiyb9QpevdyGIbR2scw L4hMUiFARjCsLuSgpkgXig Smar6OBcTGiVwJHQwJpe6Q zNfBjUy0TnWTFpmhyDfT7Q _CK5dOlxQJu5LMFcWicfVg gXI4ckI4Sy2eml3TTDKUpg p-xgFirJQ3-zraf_ZwXeXA UELWjmRmRHOkts1ccZFydQ cpyP_CNfRuqF5F8cl4XLUQ JCehYR_uSYmZl7rL0LmzxQ _q9RwxUMTzOcvuE0bY6Lcw uIEbzWHUQheZ_DPTralj-g c_yUA5V7RIGxi7XjxCLjgA JtHWVGE9QHm1QH6mKJvjQA Rc2SQwjdRCiFRO9XZyBcnw xYf5iYahTBm4tMKzX_NfTA
4.3 安装部署 logstash
官方文档 https://www.elastic.co/cn/products/logstash
4.3.1 安装
针对logstash和前两个工具一样, 在logstash7 之前的版本需要手动安装java环境。7之后的版本默认已经安装有对应的java
下载地址1 : https://www.elastic.co/cn/downloads/logstash
下载地址2 : https://elasticsearch.cn/download/
安装过程下载对应rpm/deb包即可。另外直接下载对应的二进制包。这里以deb包为例。
root@ubuntu2204:~# dpkg -i logstash-8.13.1-amd64.deb 涉及到的配置文件说明
jvm.options: 这个文件用于配置Java虚拟机(JVM)的启动选项 , 比如堆内存大小、垃圾收集器设置等。这些选项直接影响Logstash运行时的JVM行为和性能。log4j2.properties: 这个文件用于配置Logstash的日志记录行为。它遵循Log4j2的配置格式 , 允许你设置日志级别、模式、输出目标( 如控制台、文件等) 以及其他日志相关属性。logstash-sample.conf: 这是一个示例配置文件 , 通常随Logstash安装一起提供。它展示了如何编写Logstash配置文件 , 包括输入、过滤和输出的配置示例。新手可以从这个文件开始学习如何配置Logstash。logstash.yml: 在Logstash 6.x及之前的版本中 , 这个文件用于配置Logstash的主要设置 , 如HTTP端口、节点名称、管道路径等。从Logstash 7.x开始 , 这个文件被pipelines.yml取代。pipelines.yml: 从Logstash 7.x开始引入的文件 , 用于管理和配置多个管道(pipeline) 。每个管道代表一个独立的数据处理流程 , 包括输入、过滤和输出的配置。这个文件允许用户定义和运行多个管道 , 而无需启动多个Logstash进程。startup.options: 这个文件包含了Logstash启动时的命令行选项。它通常用于设置JVM选项 , 但也可以用于其他启动时的配置 , 如指定配置文件路径、设置环境变量等。如果需要使用自己安装的
java环境, 可以在这个文件调整之后,需要执行软件包中的bin/ system-install文件, 重新配置环境。同时配置
[root@elasticsearch-79 ~]# cat /etc/sysconfig/logstash
JAVA_HOME="/usr/local/src/jdk"
如果需要手动启动logstash , 运行命令/logstash -f logstash-simple.conf
4.3.2 命令行参数
-e: 意即执行(exec)。我们在 "Hello World" 的时候已经用过这个参数了。事实上你可以不写任何具体配置 ,直接运行bin/logstash -e'' 达到相同效果。这个参数的默认值是下面这样 :input { stdin { }}output { stdout { }}
--conf或者-f这种配置文件的形式 ,是我们工作中最常用的形式
意即文件。真实运用中 ,我们会写很长的配置 ,甚至可能超过
shell所能支持的1024个字符长度。所以我们必把配置固化到文件里 ,然后通过bin/logstash -f agent.conf这样的形式来运行。如果我们想运行一个文件夹下的所有配置文件 ,
logstash还提供一个方便我们规划和书写配置的小功能。你可以直接用bin/logstash -f /etc/logstash.d/来运行。logstash会自动读取/etc/logstash.d/目录下所有*.conf的文本文件 ,然后在自己内存里拼接成一个完整的大配置文件 ,再去执行。 但是 ,logstash列出目录下所有文件时 ,是字母排序的。而logstash配置段的filter和output都是顺序执行 ,所以顺序非常重要。采用多文件管理的用户 ,推荐采用数字编号方式命名配置文件 ,同时在配置中 ,严谨采用if判断限定不同日志的动作。-t或者--configtest意即测试。用来测试
Logstash读取到的配置文件语法是否能正常解析。Logstash配置语法是用grammar.treetop定义的。尤其是使用了上一条提到的读取目录方式的读者 , 尤其要提前测试。--log或者-l意即日志。
Logstash默认输出日志到标准错误。生产环境下你可以通过bin/logstash -l logs/logstash.log命令来统一存储日志。--pipeline-workers或-w运行
filter和output的pipeline线程数量。默认是CPU核数。--pipeline-batch-size或-b每个
Logstash pipeline线程 ,在执行具体的filter和output函数之前 ,最多能累积的日志条数。默认是125条。越大性能越好 ,同样也会消耗越多的JVM内存。--pipeline-batch-delay或-u每个
Logstash pipeline线程 ,在打包批量日志的时候 ,最多等待几毫秒。默认是5 ms。--pluginpath或-P可以写自己的插件 ,然后用
bin/logstash --pluginpath /path/to/own/plugins加载它们。--verbose输出一定的调试日志。
--debug输出更多的调试日志。
4.3.3 配置文件
可以通过logstash的主配置文件修改个性化配置 , 可不做更改
root@ubuntu2204:~# cat /etc/logstash/logstash.yml
#使用分层表单来设置管道的批处理大小和批处理延迟
   pipeline:
     batch:
       size: 125        #管道批处理大小
       delay: 5             #管道批处理延迟

#若要表示与平面键相同的值 :
   pipeline.batch.size: 125
   pipeline.batch.delay: 5


#节点名称 , 在集群中具备唯一性 , 默认为logstash主机的主机名
node.name: logstast-node1

#logstash及其插件所使用的数据路径 , 默认路径为logstash家目录下的data目录
path.data: /usr/local/logstash-7.0.0/data/

#管道的ID , 默认为main
pipeline.id: main

#输入、输出及过滤器的总工作数量 , 也就是logstash的工作进程 , 此工作进程默认为主机的cpu核心数量
pipeline.workers: 16

#在输入阶段 , 单个工作线程将从输入中收集的最大事件数 , 此事件数堆内存开销较大 , 内存开销可在jvm.options中设置堆内存大小来优化此选项
pipeline.batch.size: 125

#在将一个较小的批发送到filters+output之前,轮询下一个事件时等待的时间(以毫秒为单位)
pipeline.batch.delay: 50

#设置为true时 , 在强制关闭logstash期间 , 即使内存中还有事件 , 那么为true将会强制关闭 , 导致数据丢失;默认为false , false在强制关闭logstash期间 , 将拒绝退出 , 直到所有在管道中的事件被安全输出 , 再关闭。
pipeline.unsafe_shutdown: false

#指定管道配置的目录 , 在此目录下的所有管道配置文件都将被logstash读取 , 除管道配置外 , 不要放任何文件
path.config: /usr/local/logstash-7.0.0/conf.d/

#在启动时 , 测试配置是否有效并退出 , 检测配置文件是否正确 , 包括检测管道配置文件 , 默认为false
config.test_and_exit: true

#定期检查配置是否更改并重新加载管道 , 默认为false
config.reload.automatic: true

#logstash间隔多久检查一次配置中的更改 , 默认为3秒
config.reload.interval: 600s

#设置为true时 , 将完全编译的配置显示为调试日志消息
config.debug: false

#用于事件缓冲的内部排队模型;可以指定内存memory或者磁盘persisted , 内存处理速度相对磁盘来说效率要高 , 默认为内存
queue.type: memory

#启用持久队列时将存储数据文件的目录路径,默认为logstash路径下的queue
path.queue: /usr/local/logstash-7.0.0/queue/

#启用持久队列时使用的页面数据文件的大小(queue.type: persisted)队列数据由分成页面的仅附加数据文件组成
queue.page_capacity: 64mb

#启用持久队列时队列中未读事件的最大数量(queue.type: persisted) , 默认为0 , 0为无限制
queue.max_events: 0

#队列的总容量 , 以字节数表示 , 默认为1G , 根据业务需求而定
queue.max_bytes: 1024mb

#启用持久队列时强制检查点之前最大的ACK事件数量(queue.type: persisted) , 设置为0 , 表示无限制 , 默认为1024
queue.checkpoint.acks: 1024

#启用持久队列时强制检查点之前写入事件的最大数量(queue,type: persisted) , 设置为0 , 表示无限制 , 默认为1024
queue.checkpoint.writes: 1024

#启用持久队列(queue,type: persisted) , 强制在头部页面上设置检查点的间隔(以毫秒为单位) , 有周期性检查点的默认值是1000毫秒
queue.checkpoint.interval: 1000

#用于指示logstast启用插件支持DLQ功能的标志 , 默认为false
dead_letter_queue.enable: false

#每个死信队列的最大大小 , 如果条目超过此设置会增加死信队列的大小 , 则会删除条目 , 默认为1024mb
dead_letter_queue.max_bytes: 1024mb

#为死信队列存储数据文件的目录路径
path.dead_letter_queue: /usr/local/logstash-7.0.0/letter-queue

#度量标准REST端点的绑定地址 , 默认为127.0.0.1
http.host: "127.0.0.1"

#度量标准REST端点的绑定端口 , 默认为9600
http.port: 9600

#日志级别 , 可以设置为以下几种级别 , 默认为info
log.level: info
           fatal
           error
           warn
           info (default)
           debug
           trace

#logstash日志目录位置 , 默认为logstash路径下的logs
path.logs: /usr/local/logstash-7.0.0/logs


#logstash插件路径
path.plugins: []
4.3.4基本使用
首先 , 让我们通过最基本的Logstash管道来测试一下刚才安装的Logstash
Logstash管道有两个必需的元素 , 输入和输出 , 以及一个可选元素过滤器。输入插件从数据源那里消费数据 , 过滤器插件根据你的期望修改数据 , 输出插件将数据写入目的地。
logstash有两种方式运行 , 分别是命令行的方式、定义配置文件方式
使用命令行运行一个简单的logstash程序
root@elasticsearch01:~# /usr/share/logstash/bin/logstash -e 'input{stdin{}}output{stdout{codec=>rubydebug}}'在控制台输入
abc, 控制台会输出如下内容 :{ "@timestamp" => 2024-04-07T07:17:45.932730425Z, "event" => { "original" => "abc" }, "host" => { "hostname" => "elasticsearch01" }, "message" => "abc", "@version" => "1" }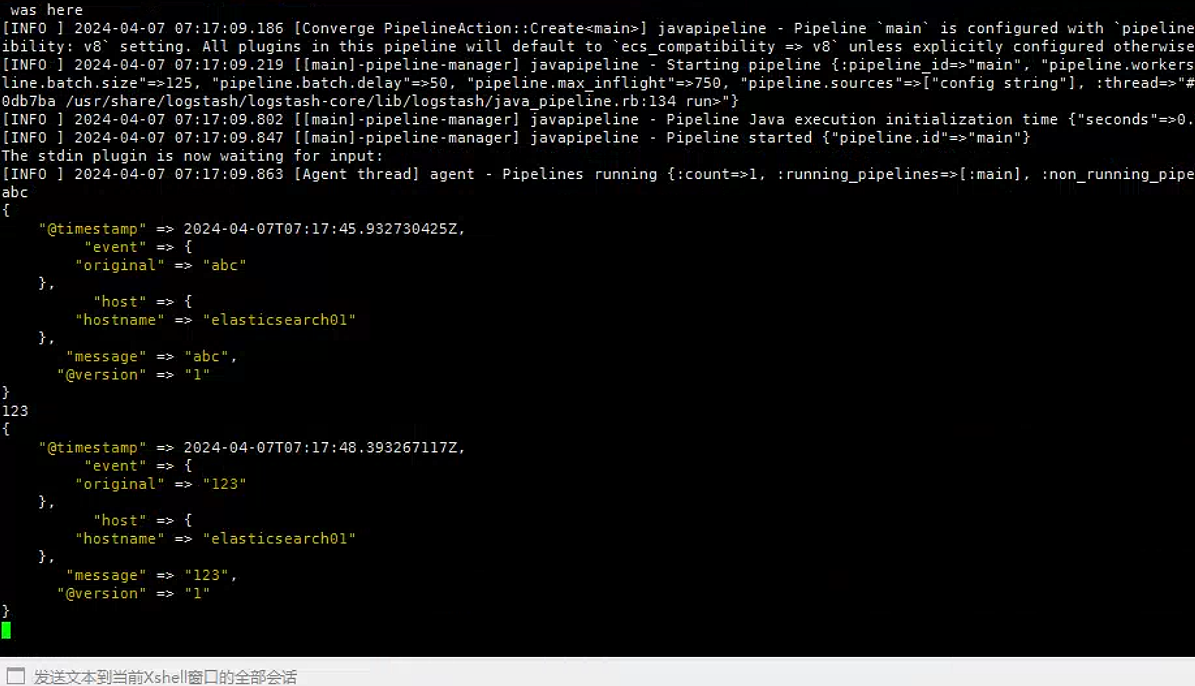
配置语法讲解
最基本的配置文件定义 , 必须包含
input和output, 修改logstash.conf文件# 最基本的配置文件定义 , 必须包含input 和 output。 input{ stdin{ } } output{ stdout{ codec=>rubydebug } } # 如果需要对数据进操作 , 则需要加上filter段 input{ stdin{ } } filter{ # 里面可以包含各种数据处理的插件 , 如文本格式处理 grok、键值定义 kv、字段添加、 # geoip 获取地理位置信息等等... } output{ stdout{ codec=>rubydebug } } # 可以定义多个输入源与多个输出位置 input{ stdin{ } file{ path => ["/var/log/message"] type => "system" start_position => "beginning" } } output{ stdout{ codec=>rubydebug } file { path => "/var/datalog/mysystem.log.gz" gzip => true } }运行命令:
logstash -f logstash.conf
4.3.5 持久化配置
当发生异常情况 , 比如logstash重启 , 有可能发生数据丢失 , 可以选择logstash持久化到磁盘 , 修改之前重启logstash数据丢失 , 修改之后重启logstash数据不丢失。在config/logstash.yml中进行配置以下内容:
queue.type: persisted
path.queue: /usr/share/logstash/data  #队列存储路径;如果队列类型为persisted , 则生效
queue.page_capacity: 250mb  #队列为持久化 , 单个队列大小
queue.max_events: 0  #当启用持久化队列时 , 队列中未读事件的最大数量 , 0为不限制
queue.max_bytes: 1024mb   #队列最大容量
queue.checkpoint.acks: 1024  #在启用持久队列时强制执行检查点的最大数量,0为不限制
queue.checkpoint.writes: 1024  #在启用持久队列时强制执行检查点之前的最大数量的写入事件 , 0为不限制
queue.checkpoint.interval: 1000  #当启用持久队列时 , 在头页面上强制一个检查点的时间间隔
4.3.6 性能测试
Logstash有kibana专门的模拟数据插件 , 以及速率分析工具 , 此处准备模拟数据量1千万条。
操作步骤 :
配置Logstash目录下面的pipeline/logstash.conf , 配置完重启Logstash
input{
  generator {
    count => 10000000 # 模拟数据1千万条
    # 模拟数据具体内容
    message => 'INFO 2018-07-30 0911 springfox.documentation.spring.web.readers.operation.CachingOperationNameGenerator[startingWith:40] - Generating unique operation named: getUsingGET1$i'
    # multiline插件 , 用于合并事件
    codec => multiline {
      pattern => "^\s" # 匹配空格
      what =>"previous" # 当匹配到空格 , 合并到上一个事件 , 如果是next , 则合并到下一个事件
    }
    type => "probe_log" # 类型名称
  }
}

filter {
  grok {
    # 通过正则表达式匹配日志
    match => {
      "message" => "%{LOGLEVEL:level}\s%{TIMESTAMP_ISO8601:timestamp}\s%{JAVACLASS:class}[%{WORD:method}:%{NUMBER:line}]\s-\s(?([\s\S]*))"
    }
  }
  date {
    match => [ "timestamp" , "yyyy-MM-dd HHss", "ISO8601" ]  # 匹配timestamp字段
    target => "@timestamp"  # 覆盖@timestamp
  }
  mutate {
    remove_field => "timestamp" #移除timestamp字段
  }
}

output {
  # 输出到elasticsearch
  elasticsearch {
    hosts => ["192.168.2.227:9200"]
    index => "logstash-api-%{+YYYY.MM.dd}"
  }
}
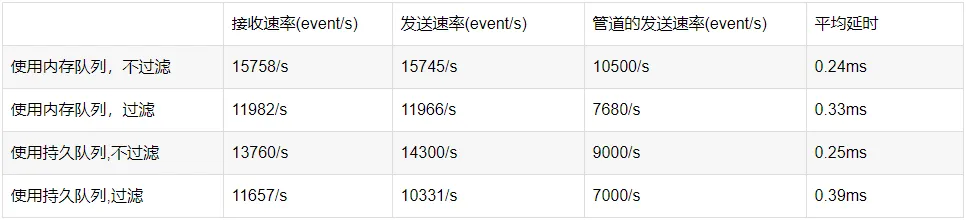
测试结果
模拟数据量1千万条 , 通过kibana的monitoring监控
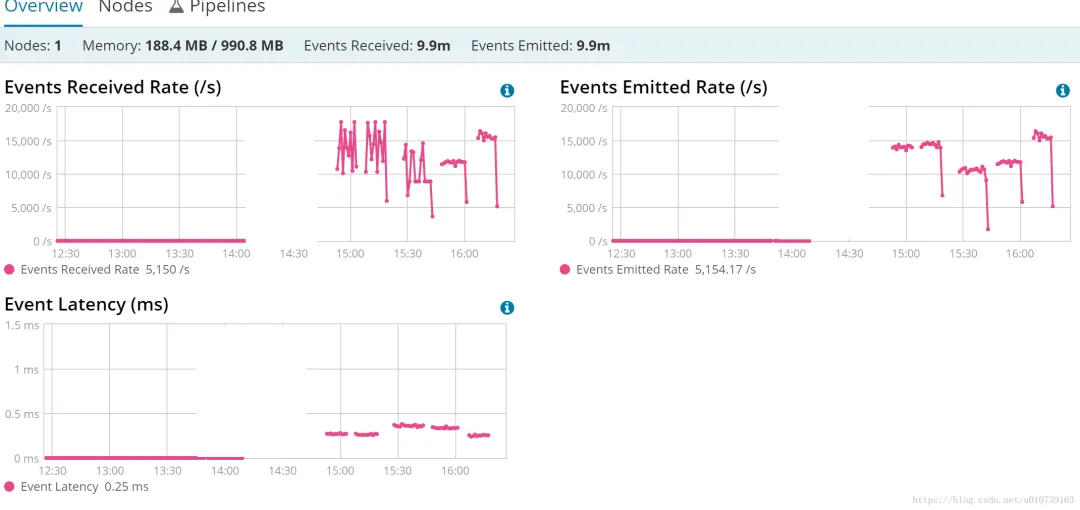
后面四个分别为 :
使用持久队列过滤
使用持久队列不过滤
使用内存队列过滤
使用内存队列不过滤的情况
由此估算出下面一张表 :
参考链接
ELK之一-----Elasticsearch介绍与部署 - 一叶知秋~~ - 博客园 (cnblogs.com)
ElasticSearch(三)-常见配置以及配置文件详解 | HoleLin's Blog
Elasticsearch 7x 配置文件详解_elasticsearch7配置详解-CSDN博客
ELK系列(一)、Elasticsearch相关概念说明 (qq.com)
ELK系列(七)、Logstash原理及使用入门 (qq.com)
elasticsearch如何设计集群 - 一寸HUI - 博客园 (cnblogs.com)