
1-2-elasticsearch中node角色说明
1. role简介
在Elastic Stack 7.9之后的发布中 , 我们可以直接在 Elasticsearch的配置文件中配置Node的角色 (node roles)。这是一个新的变化。在 7.9 发布版之前 , 我们使用 node.master: true这样的方式来定义一个 master 节点 , 但是从 7.9 开始之后 , 我们也可以使用另外一个方法来定义一个master 节点。我们可以通过 node.roles 来定义一个 master 节点。但是这两种方法只可以选其一 , 不能两种方法同时使用。从7.9发布后 , 建议使用node.roles来定义node的角色。在今天的文章中 , 我来介绍node.roles。
每当你启动Elasticsearch实例时 , 你都在启动节点。 连接的节点的集合称为群集。 如果你正在运行Elasticsearch的单个节点 , 那么你将拥有一个节点的集群。
默认情况下 , 群集中的每个节点都可以处理HTTP和Transport流量。 Transport 层专门用于节点之间的通信。HTTP层由REST客户端使用。
所有节点都知道群集中的所有其他节点 , 并且可以将客户端请求转发到适当的节点。
默认情况下 , 节点为以下所有类型: master-eligible, data, ingest和(如果可用)machine learning。 所有data节点也是 transform节点。
友情提示: 随着集群的增长 , 特别是如果你有大量机器学习工作或连续转换 , 请考虑将专用于master-eligible节点与专用data节点 , machine learning节点和transform节点分离。
你可以通过设置node.roles来定义节点的角色。 如果你未配置此设置 , 则该节点默认具有角色: master、data、data_content、data_hot 、data_warm 、data_cold 、ingest 、ml 、remote_cluster_client
注意: 如果你设置node.roles , 那么node将被分配为指定的角色。
Master-eligible node: 具有master role(默认)的节点 , 这使其有资格被选作控制群集的主节点。Data node: 具有data role的节点(默认)。 数据节点保存数据并执行与数据相关的操作 , 例如CRUD, 搜索和聚合。 具有数据角色的节点可以填充任何专门的数据节点角色。Ingest node: 具有ingest role的节点(默认)。 摄入节点能够将提取管道应用于文档 , 以便在建立索引之前转换和丰富文档。 在繁重的摄取负载下 , 使用专用的摄取节点并且不包含具有master role或data role的节点中的摄取角色是有意义的。用于数据前期的预处理, 类似logstash,node node.ingest: trueRemote-eligible node: 具有remote_cluster_client角色(默认)的节点 , 这使其有资格充当远程客户端。 默认情况下 , 集群中的任何节点都可以充当跨集群客户端并连接到远程集群。Machine learning node: 具有xpack.ml.enabled和ml角色的节点 , 这是Elasticsearch默认发布中的默认行为。 如果要使用机器学习功能 , 则集群中必须至少有一个机器学习节点。重要提示: 如果你使用
OSS发布版 , 千万不要添加ml角色 , 否则该节点将无法启动。Transform node: 具有transform role的节点。 如果要使用转换 , 则群集中至少有一个转换节点。 如果是数据节点, 则默认为true, 否则falseCoordnating node: 协调节点。每个节点都是协调节点, 不可关闭, 协调节点将请求转发给持有数据的数据节点。每个数据节点在本地执行请求, 并将其结果返回给协调节点。在收集阶段, 协调节点将每个数据节点的结果减少为单个全局结果集诸如搜索请求或批量索引请求之类的请求可能涉及保存在不同数据节点上的数据。 例如 , 搜索请求在两个阶段中执行 , 这两个阶段由接收客户请求的节点(即协调节点)协调。
在分散阶段 , 协调节点将请求转发到保存数据的数据节点。 每个数据节点在本地执行该请求 , 并将其结果返回到协调节点。 在收集阶段 , 协调节点将每个数据节点的结果缩减为单个全局结果集。
每个节点都隐式地是一个协调节点。 这意味着通过
node.roles具有明确的空角色列表的节点将仅充当协调节点 , 无法禁用。 结果 , 这样的节点需要具有足够的内存和CPU才能处理收集阶段。协调节点的定义为:node.roles: []
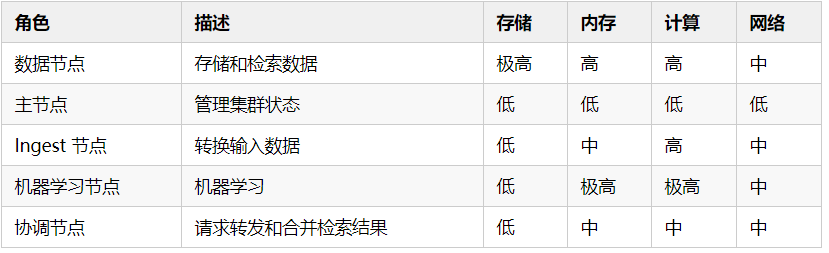
如果集群很小, 机器不够用的情况下, 可以把数据节点和主节点公用, 如果想要主节点高可用的话, 就要至少在3台机器上配置node.master: true, 当然还可以更多, 奇数就好了, 如果机器很多, 可以把主节点和数据节点分离, 这样配置更加单一原则, 主节点更加稳定, 所以集群也会更加稳定。具体怎么配置见官网: https://www.elastic.co/guide/en/elasticsearch/reference/7.8/modules-node.html
2. Master-eligible node
主节点负责集群范围内的轻量级操作 , 例如创建或删除索引 , 跟踪哪些节点是集群的一部分以及确定将哪些shard分配给哪些节点。 拥有稳定的主节点对于群集健康非常重要。
任何一个非voting-only节点且具有 master-eligible 属性的节点可以通过master election process , 使其成为主节点。
重要提示 : 主节点必须有权访问 data/ 目录(就像数据节点一样) , 因为这是节点重新启动之间保持群集状态的位置。
2.1 专有 master-eligible node
一旦一个master-eligible节点被选举为master节点 , 它需要履行其职责以保持资源集群的健康。如果当选主节点因为其他繁重的任务使之超负荷运行 , 那么集群可能不能很好地工作。 特别是 , 建立索引数据和搜索数据可能会占用大量资源 , 因此 , 在大型或高吞吐量群集中 , 最好避免使用master-eligible节点来执行诸如索引和搜索之类的任务。 你可以通过将三个节点配置为专用master-eligible节点来完成此操作。 专用master-eligible节点仅具有master role , 从而使他们可以专注于管理集群。 尽管主节点还可以充当协调节点 , 并将搜索和索引请求从客户端路由到数据节点 , 但最好不要为此目的使用专用的master节点。
要创建专用的符合主机资格的节点 , 请设置 :
node.roles: [ master ]2.2 Voting-only master-eligible node
仅投票的master-eligible节点是参与master 选举但不会充当集群的主节点。 特别是 , 仅投票节点可以在选举中充当决胜局。
使用术语 "master eligible" 来描述仅投票的节点似乎令人困惑 , 因为这样的节点实际上根本没有资格成为主机。这个术语是历史的一个不幸后果 : 主节点资格是那些参加选举 , 并在集群状态发布执行某些任务 , 只有投票节点具有相同的责任 , 即使他们永远不能成为当选的主节点。
要将符合条件的主节点配置为仅投票节点 , 请在角色列表中包括master和voting_only。 例如 , 创建voting_only以及数据节点 :
node.roles: [ data, master, voting_only ]重要提示 : voting_only需要Elasticsearch的默认发布版 , 并且在 OSS 发布中不支持该角色。 如果使用OSS发行版并添加 voting_only角色 , 则该节点将无法启动。 还要注意 , 只有具有master节点才能被标记为具有voting_only角色。
高可用性(HA)群集至少需要三个主节点 , 其中至少两个不是voting_only节点。即使其中一个节点发生故障 , 这样的群集也将能够选举一个主节点。
由于voting_only节点从来不会担任集群主节点 , 和真正的主节点相比较 , 他们可能需要需要较少的堆和一个不太强大的CPU。但是 , 所有master-eligible节点(包括voting_only节点)都需要相当快的持久性存储以及到集群其余部分的可靠且低延迟的网络连接 , 因为它们位于发布集群状态更新的关键路径上。
具有voting_only的master-eligible节点也可以充当群集中的其他角色。例如 , 一个节点既可以是数据节点 , 又可以是voting_only 的master-eligible节点。专用的voting_only master-eligible是不具备群集中的其他任何角色。要在默认发布中 , 创建专用的 voting_only master-eligible节点 , 请设置 :
node.roles: [ master, voting_only ]3. Data node
数据节点包含包含你已建立索引的文档的分片。 数据节点处理与数据相关的操作 , 例如CRUD , 搜索和聚合。 这些操作是I/O , 内存和 CPU密集型的。 监视这些资源并在过载时添加更多数据节点非常重要。
具有专用数据节点的主要好处是将master 和data角色分开。
要创建专用数据节点 , 请设置 :
node.roles: [ data ]在多层(multi-tier)部署体系结构中 , 你可以使用专门的数据角色将数据节点分配给特定的层 : data_content , data_hot , data_warm或data_cold。 一个节点可以属于多个层 , 但是具有专用数据角色之一的节点不能具有通用数据角色。
3.1 Content data node
Content data节点容纳用户创建的内容。 它们启用CRUD , 搜索和聚合之类的操作。
要创建专用的content节点 , 请设置 :
node.roles: [ data_content ]3.2 Hot data node
Hot data数据节点在输入Elasticsearch时会存储时间序列数据。 热层必须能够快速进行读写操作 , 并且需要更多的硬件资源(例如 SSD驱动器)。
要创建专用的hot节点 , 请设置 :
node.roles: [ data_hot ]3.3 Warm data node
Warm data节点存储的索引不再定期更新 , 但仍在查询中。 查询量通常比索引处于热层时的频率低。 性能较低的硬件通常可用于此层中的节点。
要创建专用的 Warm节点 , 请设置 :
node.roles: [ data_warm ]3.4 Cold data node
Cold data节点存储只读索引 , 该索引的访问频率较低。 该层使用性能较低的硬件 , 并且可能会利用可搜索的快照索引来最大程度地减少所需的资源。
要创建专用的cold节点 , 请设置 :
node.roles: [ data_cold ]4.Coordinating only node
如果一个节点不担任master节点的职责 , 不保存数据 , 也不预处理文档 , 那么这个节点将拥有一个仅可路由请求 , 处理搜索缩减阶段并分配批量索引的协调节点。 本质上 , 仅协调节点可充当智能负载平衡器。
仅协调节点可以通过从data和master-eligible节点上分担大量的协调角色从而使大型集群受益。 他们加入群集并像其他所有节点一样接收完整的群集状态 , 并且使用群集状态将请求直接路由到适当的位置。
警告 : 在集群中添加过多的仅协调节点会增加整个集群的负担 , 因为选择的主节点必须等待每个节点的集群状态更新确认! 仅协调节点的好处不应被夸大-数据节点可以很高兴地达到相同的目的。
要创建专用的协调节点 , 请设置 :
node.roles: [ ]5. Remote-eligible node
默认情况下 , 集群中的任何节点都可以充当跨集群客户端并连接到远程集群。 连接后 , 你可以使用跨集群搜索来搜索远程集群。 你还可以使用跨集群复制在集群之间同步数据。
node.roles: [ remote_cluster_client ]6. Machine learning node
机器学习功能提供了机器学习节点 , 该节点运行作业并处理机器学习API请求。 如果xpack.ml.enabled设置为true , 并且该节点不具有ml角色 , 则该节点可以处理 API 请求 , 但不能运行作业。
如果要在群集中使用机器学习功能 , 则必须在所有符合主机资格的节点上启用机器学习(将xpack.ml.enabled设置为true) 。 如果要在客户端(包括Kibana)中使用机器学习功能 , 则还必须在所有协调节点上启用它。 如果你只有 OSS 发行版 , 请不要使用这些设置。
有关这些设置的更多信息 , 请参阅机器学习设置。
要在默认发布中创建专用的机器学习节点 , 请设置 :
node.roles: [ ml ]
xpack.ml.enabled: true
在默认的情况下 , xpack.ml.enabled已经被启动。
7. Transform node
转换节点运行转换并处理转换 API 请求。 如果你只有OSS发行版 , 请不要使用这些设置。 有关更多信息 , 请参见转换设置。
要在默认分发中创建专用的变换节点 , 请设置 :
node.roles: [ transform ]8. 改变一个节点的角色
每个数据节点在磁盘上维护以下数据 :
分配给该节点的每个分片的分片数据 ,
与分配给该节点的每个分片相对应的索引元数据
集群范围的元数据 , 例如设置和索引模板。
同样 , 每个master-eligible节点都会在磁盘上维护以下数据 :
集群中每个索引的索引元数据 , 以及
集群范围的元数据 , 例如设置和索引模板。
每个节点在启动时都会检查其数据路径的内容。如果发现意外数据 , 它将拒绝启动。这是为了避免导入可能导致群集健康状态变红的不必要的悬挂索引。更准确地说 , 如果没有data role的节点在启动时在磁盘上找到任何分片数据 , 它们将拒绝启动 , 而没有master和data角色的节点如果在启动时在磁盘上具有任何索引元数据 , 则将拒绝启动。
可以通过调整节点的elasticsearch.yml文件并重新启动来更改其角色。这称为重新利用节点。为了满足上述对意外数据的检查 , 在启动没有data或master角色的节点时 , 你必须执行一些额外的步骤来准备要重新使用的节点。
如果要通过删除data角色来重新利用数据节点 , 则应首先使用分配过滤器将所有分片数据安全地迁移到群集中的其他节点上。
如果要使节点既无data角色又master主角色 , 则最简单的方法是使用空数据路径和所需角色启动一个全新的节点。你可能会发现使用分配过滤器首先将分片数据迁移到集群中其他位置最安全。
如果无法执行这些额外的步骤 , 则可以使用elasticsearch-node重新利用工具删除任何阻止节点启动的多余数据。
9. 通过 API 来获得 node roles
在Kibana的console中 , 我们可以通过如下的命令来获得所有node的角色 :
GET _cat/nodes?v你可能看到如下的结果 :
ip        heap.percent ram.percent cpu load_1m load_5m load_15m node.role   master name
127.0.0.1 3 99 4 2.58 cdfhilmrstw * liuxg在上面的node.role中 , 我们可以看到这个node的角色。根据链接 , 上面的字母的意思是 : c : cold node ; d : data node; f : frozen node ; h : hot node ; i : ingest node ; l : machine learning node ; m : master eligible node ; r : remote cluster client node ; s : content node ; t : transform node ; v : voting-only node ; w : warm node; -: coordinating node only
在上面的node role中 , 我们可以看出来 , 它同时具有多种角色。在实际的使用中 , 我们可以根据自己的需要为某些node定义特定的角色。
参考链接
elasticsearch如何设计集群 - 一寸HUI - 博客园 (cnblogs.com)