
1-3-elasticsearch中索引模板使用
1. 索引模板基础
Elasticsearch索引模板(Index Template) 是一种用于自动创建和管理索引的模板 , 它允许你在创建新索引时自动应用一组预定义的设置和映射规则。索引模板通常用于定义一组共享的索引设置 , 确保新创建的索引具有一致的结构和配置。
索引模板的主要目的是在索引创建时自动应用一组规则 , 而无需手动干预或重复定义设置。这对于拥有多个类似结构的索引非常有用 , 例如日志索引、时间序列索引等。
在创建索引之前可以先配置模板 , 这样在创建索引(手动创建索引或通过对文档建立索引) 时 , 模板设置将用作创建索引的基础。
这里说明下 , elasticsearch7.8的模板接口发生了一些变化 , _template接口将在后期被废弃
1.1 模板类型
现在模板分为两种模板 , 一个索引模板(index templates ) , 一个是组件模板( component templates) , 索引模板是告诉Elasticsearch如何在创建索引时配置索引的一种方法。模板是在创建索引之前配置的 , 当手动或通过索引文档创建索引时 , 模板的基础设置将用作创建索引。组件模板是可重用的构建块 , 用于配置映射、设置和别名。使用组件模板来构造索引模板 , 组件模板不能直接应用于索引。索引模板可以包含组件模板的集合 , 也可以直接指定设置、映射和别名。组件模板的接口是 : _component_template , 而索引模板的接口是 : _index_template , 下面来个官方的例子 , 可以明显的看出来组件模板component_template1和other_component_template被索引模板通过参数composed_of被引用 , 所以索引模板template_1既包括自己的设置 , 又包括了两个组件模板的设置 , 这样就可以轻松灵活的做组合 , 降低耦合性。
模板有两种类型: 索引模板和组件模板。
组件模板是可重用的构建块 , 用于配置映射 , 设置和别名 ; 它们不会直接应用于一组索引。
索引模板可以包含组件模板的集合 , 也可以直接指定设置 , 映射和别名
PUT _component_template/component_template1
{
  "template": {
    "mappings": {
      "properties": {
        "@timestamp": {
          "type": "date"
        }
      }
    }
  }
}

PUT _component_template/other_component_template
{
  "template": {
    "mappings": {
      "properties": {
        "ip_address": {
          "type": "ip"
        }
      }
    }
  }
}

PUT _index_template/template_1
{
  "index_patterns": ["te*", "bar*"],
  "template": {
    "settings": {
      "number_of_shards": 1
    },
    "mappings": {
      "_source": {
        "enabled": false
      },
      "properties": {
        "host_name": {
          "type": "keyword"
        },
        "created_at": {
          "type": "date",
          "format": "EEE MMM dd HH:mm:ss Z yyyy"
        }
      }
    },
    "aliases": {
      "mydata": { }
    }
  },
  "priority": 10,
  "composed_of": ["component_template1", "other_component_template"],
  "version": 3,
  "_meta": {
    "description": "my custom"
  }
}
1.1.1 Component templates(组件模板)
先上官网 : https://www.elastic.co/guide/en/elasticsearch/reference/7.8/indices-component-template.html
组件模板是构建索引模板的构建块。比如指定索引映射、设置和别名等。
使用语法 :
PUT /_component_template/<component-template>索引模板可以由多个组件模板组成。要使用组件模板 , 请在索引模板通过参数composed_of指定。组件模板仅作为匹配索引模板的一部分。在任何的索引或者索引模板中定义的一些内容( 设置 , mapping等) 都会覆盖组件模板中与之相同的内容 , 也就是说组件模板等级最低了 , 容易被取代。组件模板的只会在索引创建的时候生效 , 修改组件模板不会对现有的索引有影响。下面介绍下组件模板请求体的一些参数 :
举个例子 , 一看就懂 :
PUT _component_template/template_1
{
  "template": {
    "settings": {
      "number_of_shards": 1
    },
    "aliases": {
      "alias1": {},
      "alias2": {
        "filter": {
          "term": {
            "user.id": "kimchy"
          }
        },
        "routing": "shard-1"
      },
      "{index}-alias": {}
    }
  },
  "version": 123,
  "_meta": {
    "description": "set number of shards to one",
    "serialization": {
      "class": "MyComponentTemplate",
      "id": 10
    }
  }
}
1.1.2 index templaes(索引模板)
先看官网 : https://www.elastic.co/guide/en/elasticsearch/reference/7.8/indices-put-template.html
使用语法:
PUT /_index_template/<index-template>索引模板定义可以定义设置、映射和别名等 , 然后通过匹配自动应用于新建的索引。Elasticsearch基于与索引名称匹配的通配符模式将模板应用于新索引 , 也就是说通过索引进行匹配 , 看看新建的索引是否符合索引模板 , 如果符合 , 就将索引模板的相关设置应用到新的索引 , 如果同时符合多个索引模板呢 , 这里需要对参数priority进行比较 , 这样会选择priority大的那个模板进行创建索引。在创建索引模板时 , 如果匹配有包含的关系 , 或者相同 , 则必须设置priority为不同的值 , 否则会报错。索引模板也是只有在新创建的时候起到作用 , 修改索引模板对现有的索引没有影响。同样如果在索引中设置了一些设置或者mapping都会覆盖索引模板中相同的设置或者mapping。接下来看看创建索引模板请求体的一些参数 :
看这些 , 好像很复杂 , 举个例子就容易了: (匹配所有te开头的新建索引 , 分片为1 , 优先级为10)
PUT /_index_template/template_1
{
    "index_patterns": [
        "te*"
    ],
    "template": {
        "settings": {
            "number_of_shards": 1
        },
        "aliases": {
            "alias1": {},
            "alias2": {
                "filter": {
                    "term": {
                        "user.id": "kimchy"
                    }
                },
                "routing": "shard-1"
            },
            "{index}-alias": {}
        },
        "mappings": {
            "_source": {
                "enabled": true
            }
        }
    },
    "version": 123,
    "priority": 10,
    "_meta": {
        "description": "set number of shards to three",
        "serialization": {
            "class": "MyIndexTemplate",
            "id": 17
        }
    }
}
这里没有说组合索引的使用 , 请看第一节介绍部分 , 这两种索引的关系 , 还有就是组合索引被引用顺序 , 后者更具有更高的优先级 , 会覆盖前面的一些组合索引的一些相同的设置 , 然而组件索引不同的部分将会叠加在一起成为索引模板的设置。
1.2 Dynamic Mapping(动态映射)
注意 : 其实个人觉得把动态模板写这里是为了区分索引模板和动态模板 , 因为个人混淆过 , 所以写这里比较好区别 , 其实动态模板不是索引模板 , 这里不要误会 , 其实动态模板就是可以配置在索引中或者配置在索引模板中 , 作用是elasticsearch对数据探索自发现添加 , 可以指定匹配 , 并映射成指定类型。这里要记住elasticsearch只有组合模板和索引模板 , 动态模板时动态映射的一种实现。动态模板定义了索引创建后新添加字段的映射规则 , 而索引模板是在创建索引时默认为索引添加的别名、配置和映射等信息。索引模板包含该模板适用索引的模式或规则 , 以及索引创建时默认包含的别名、配置和映射关系等。它们分别通过index_patterns、aliases、settings和mappings等四个参数设置
在说动态模板之前 , 先要说说动态映射。
Elasticsearch最重要的功能之一就是可以自动探索数据。要为文档编制索引 , 不必首先创建索引、定义映射类型和定义字段 , 只需为文档编制索引 , 索引、类型和字段就会自动生成。
自动检测和添加新字段以及字段类型称为动态映射 , 主要分为动态字段和动态模板。这里引出动态字段和动态模板 , 所以先看看动态字段。
1.2.1 Dynamic field mapping(动态字段映射)
先看官网 : https://www.elastic.co/guide/en/elasticsearch/reference/7.8/dynamic-field-mapping.html
默认情况下 , 当在文档中找到索引没有定义的字段时 , Elasticsearch会将新字段添加到类型映射中。通过将参数dynamic设置为false(忽略新字段)或strict(遇到未知字段时引发异常) , 可以在文档和对象级别禁用此行为。
假设启用了动态字段映射 , 则使用一些简单规则来确定字段应具有的数据类型 : 当然不是所有的类型都可以自动映射的 , 只有field data types这些可以动态的探索映射 , 所以其他的数据类型需要显示的指定。例如 :
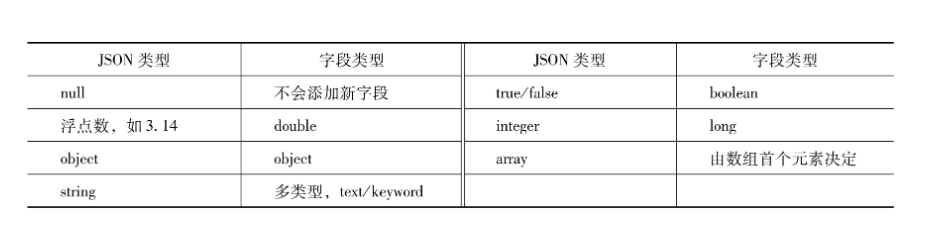
说起来可能比较有点不好理解 , 那就需要例子说明了:
PUT my-index-000001/_doc/1
{
  "create_date": "2015/09/02"
}

GET my-index-000001/_mapping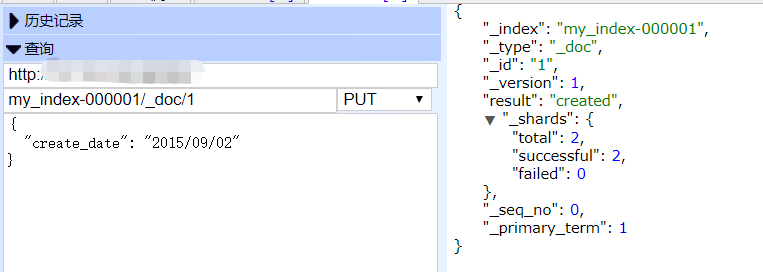
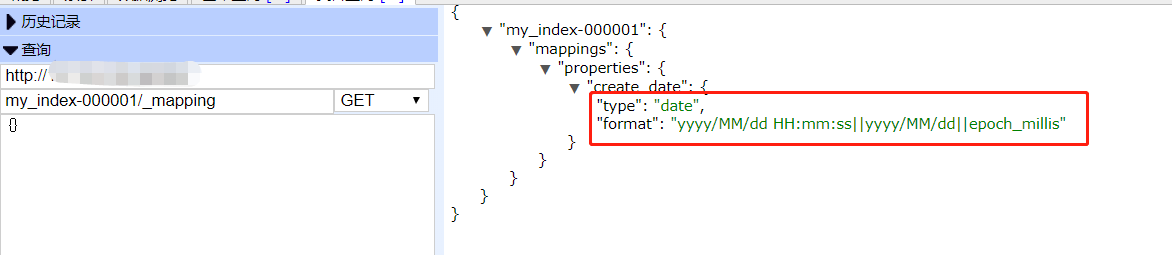
这样就自动把create_date在映射中添加了 , 并且字段类型为date , 这就是动态字段映射 , 也就是elasticsearch的一个特色 , 这样就不要给所有的字段提前定义好 , 但是虽然方便了 , 但是不利于索引的管理 , 如果出现了一条异常的数据插入到索引中 , 这样就会导致索引中的mapping中出现很多不必要的字段 , 动态字段映射可以更具需求对其进行配置。
1.2.2 Dynamic templates(动态模板)
详情见官网: https://www.elastic.co/guide/en/elasticsearch/reference/7.8/dynamic-templates.html
动态模板(Dynamic Template)用于自定义动态添加字段时的映射规则 , 可通过索引映射类型的dynamic_templates参数设置。该参数接收一组命名的动态模板 , 每一个模板由匹配条件和映射规则组成。匹配条件定义了新字段是否可以使用当前模板 , 可根据新字段的数据类型、名称和路径来定义条件 ; 而映射规则由参数mapping定义 , 它需要给出新字段要使用哪些参数 , 可使用type定义新字段数据类型。
使用规则如下:
匹配规则可使用关键字
match_mapping_type匹配新字段数据类型 , 这可以用于将一种默认类型转换为其他类型或者设置其他特性。还可使用
match、match_pattern和unmatch匹配新字段名称。其中match和unmatch可以使用星号“*”做名称匹配 , 而match_pattern则支持正则表达式匹配新字段路径可使用
path_match和path_unmatch, 路径与名称的区别是其中包含点“.”。在mapping参数中 , 还可以使用{name}和{dynamic_type}代表新字段名称和类型。
如果提供的映射包含无效的映射片段 , 则返回验证错误。验证发生在索引时应用动态模板时 , 在大多数情况下 , 发生在更新动态模板时。在某些情况下 , 提供无效的映射片段可能会导致动态模板的更新或验证失败:
如果没有指定match_mapping_type , 但模板至少对一个预定义的映射类型有效 , 则认为映射片段有效。但是 , 如果匹配模板的字段被索引为不同的类型 , 则在索引时返回验证错误。例如 , 配置一个没有match_mapping_type的动态模板被认为是有效的字符串类型 , 但是如果匹配动态模板的字段被索引为long , 则在索引时返回验证错误。
使用语法:
"dynamic_templates": [
    {
      "my_template_name": {  //这里可以随便写 , 便于辨别就好 ,
        ...  match conditions ... //这里就是上面说的规则 , 比如match_mapping_type
        "mapping": { ... }  //匹配字段使用的映射 , 意思就是把匹配到的内容映射为你想要设置的内容
      }
    },
    ...
  ]
这里只举例说明一个规则或者说是条件: match_mapping_type
PUT my-index-000002
{
  "mappings": {
    "dynamic_templates": [
      {
        "integers": {
          "match_mapping_type": "long",
          "mapping": {
            "type": "integer"
          }
        }
      },
      {
        "strings": {
          "match_mapping_type": "string",
          "mapping": {
            "type": "text",
            "fields": {
              "raw": {
                "type":  "keyword",
                "ignore_above": 256
              }
            }
          }
        }
      }
    ]
  }
}

PUT my-index-000002/_doc/1
{
  "my_integer": 5,
  "my_string": "Some string"
}
查看结果
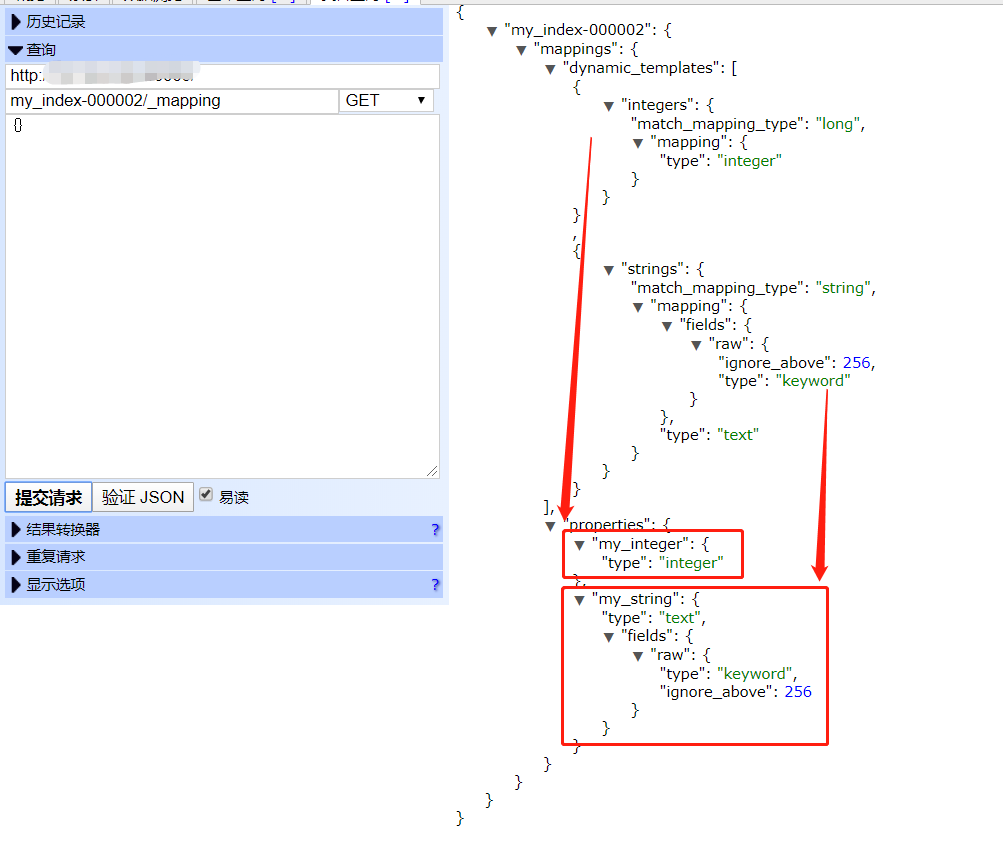
match_mapping_type
match_mapping_type是JSON解析器检测到的数据类型。因为JSON不会区分long型和整型 , 也不会区分double型和浮点型 , 所以它总是选择更宽的数据类型 , 比如long型是整型 ,double型是浮点型。
以下数据类型可能被自动检测到:
当遇到
true或flase为boolean启用
data_detection并且找到与任何配置的日期格式匹配的字符串时的日期。PUT my-index-000001 { "mappings": { "date_detection": false } } PUT my-index-000001/_doc/1 { "create": "2015/09/02" }带有小数部分的数字为
Double。对于没有小数部分的数字 , 使用Long。
object为对象 , 也称为哈希。string为字符串
也可以使用*来匹配所有数据类型。
例如 , 如果要将所有integer 字段映射为integer而不是long , 并将所有string字段同时映射为text和keyword , 可以使用以下模板:
PUT my-index-000001
{
  "mappings": {
    "dynamic_templates": [
      {
        "integers": {
          "match_mapping_type": "long",
          "mapping": {
            "type": "integer"
          }
        }
      },
      {
        "strings": {
          "match_mapping_type": "string",
          "mapping": {
            "type": "text",
            "fields": {
              "raw": {
                "type":  "keyword",
                "ignore_above": 256
              }
            }
          }
        }
      }
    ]
  }
}

PUT my-index-000001/_doc/1
{
  "my_integer": 5,
  "my_string": "Some string"
}
match和unmatch
match参数使用一个模式来匹配字段名 , 而unmatch使用一个模式来排除match匹配的字段。
下面的示例匹配所有名称以long_开头的字符串字段(以_text结尾的除外) , 并将它们映射为long字段:
PUT my-index-000001
{
  "mappings": {
    "dynamic_templates": [
      {
        "longs_as_strings": {
          "match_mapping_type": "string",
          "match":   "long_*",
          "unmatch": "*_text",
          "mapping": {
            "type": "long"
          }
        }
      }
    ]
  }
}

PUT my-index-000001/_doc/1
{
  "long_num": "5",
  "long_text": "foo"
}

long_text使用默认 string .

long_num映射为long
match_pattern
match_pattern参数调整match参数的行为 , 使其支持对字段名进行完整的Java正则表达式匹配 , 而不是简单的通配符 , 例如:
  "match_pattern": "regex",
  "match": "^profit_\d+$"
path_match and path_unmatch
path_match和path_unmatch参数的工作方式与match和unmatch相同 , 但操作的是字段的完整点路径 , 而不仅仅是最终名称 , 例如some_object.*.some_field。
下面的例子将name对象中所有字段的值复制到顶层的full_name字段 , 中间字段除外:
PUT my-index-000001
{
  "mappings": {
    "dynamic_templates": [
      {
        "full_name": {
          "path_match":   "name.*",
          "path_unmatch": "*.middle",
          "mapping": {
            "type":       "text",
            "copy_to":    "full_name"
          }
        }
      }
    ]
  }
}

PUT my-index-000001/_doc/1
{
  "name": {
    "first":  "John",
    "middle": "Winston",
    "last":   "Lennon"
  }
}
注意 , 除了叶子字段之外 , path_match和path_unmatch参数还匹配对象路径。例如 , 对以下文档进行索引将导致错误 , 因为path_match设置也匹配对象字段name.title, 不能映射为文本:
PUT my-index-000001/_doc/2
{
  "name": {
    "first":  "Paul",
    "last":   "McCartney",
    "title": {
      "value": "Sir",
      "category": "order of chivalry"
    }
  }
}
{name} 和 {dynamic_type}
{name}和{dynamic_type}占位符将在映射中用字段名和检测到的动态类型替换。下面的例子将所有字符串字段设置为使用与该字段同名的分析器 , 并禁用所有非字符串字段的doc_values :
PUT my-index-000001
{
  "mappings": {
    "dynamic_templates": [
      {
        "named_analyzers": {
          "match_mapping_type": "string",
          "match": "*",
          "mapping": {
            "type": "text",
            "analyzer": "{name}"
          }
        }
      },
      {
        "no_doc_values": {
          "match_mapping_type":"*",
          "mapping": {
            "type": "{dynamic_type}",
            "doc_values": false
          }
        }
      }
    ]
  }
}

PUT my-index-000001/_doc/1
{
  "english": "Some English text",
  "count":   5
}使用englisth分析器englih字段映射为string。
count字段被映射为禁用doc_values的长字段。
示例
结构化搜索
默认情况下 ,
Elasticsearch将`string字段映射为带有子keyword字段的text字段。然而 , 如果你只是索引结构化的内容 , 而对全文搜索不感兴趣 , 你可以让Elasticsearch只将你的字段映射为“关键字”。请注意 , 这意味着为了搜索这些字段 , 您必须搜索与索引完全相同的值。PUT my-index-000001 { "mappings": { "dynamic_templates": [ { "strings_as_keywords": { "match_mapping_type": "string", "mapping": { "type": "keyword" } } } ] } }字符串的纯文本映射
与前面的例子相反 , 如果你唯一关心的字符串字段是全文搜索 , 如果你不打算在字符串字段上运行聚合、排序或精确搜索 , 你可以告诉
Elasticsearch只将其映射为文本字段(这是5.0之前的默认行为):PUT my-index-000001 { "mappings": { "dynamic_templates": [ { "strings_as_text": { "match_mapping_type": "string", "mapping": { "type": "text" } } } ] } }禁用规范
规范是指数时间评分因素。如果您不关心评分 , 例如从不按评分对文档进行排序 , 则可以禁用索引中这些评分因素的存储 , 从而节省一些空间。
PUT my-index-000001
{
  "mappings": {
    "dynamic_templates": [
      {
        "strings_as_keywords": {
          "match_mapping_type": "string",
          "mapping": {
            "type": "text",
            "norms": false,
            "fields": {
              "keyword": {
                "type": "keyword",
                "ignore_above": 256
              }
            }
          }
        }
      }
    ]
  }
}
sub keyword字段在此模板中显示为与动态映射的默认规则一致。当然 , 如果您不需要它们 , 因为您不需要对该字段执行精确的搜索或聚合 , 那么您可以像前一节中描述的那样删除它。时间序列
在使用
Elasticsearch进行时间序列分析时,通常会有许多数字字段,您经常会对这些字段进行聚合,但从不进行过滤。在这种情况下,你可以禁用这些字段的索引,以节省磁盘空间,也可能获得一些索引速度:PUT my-index-000001 { "mappings": { "dynamic_templates": [ { "unindexed_longs": { "match_mapping_type": "long", "mapping": { "type": "long", "index": false } } }, { "unindexed_doubles": { "match_mapping_type": "double", "mapping": { "type": "float", "index": false } } } ] } }与默认的动态映射规则一样,双精度数被映射为浮点数,这通常足够精确,但需要一半的磁盘空间。
1.3 索引模板中的优先级
可组合模板优先于旧模板。如果没有可组合模板匹配给定索引 , 则旧版模板可能仍匹配并被应用。
如果使用显式设置创建索引并且该索引也与索引模板匹配 , 则创建索引请求中的设置将优先于索引模板及其组件模板中指定的设置。
如果新数据流或索引与多个索引模板匹配 , 则使用优先级最高的索引模板。
1.4 内置索引模板
Elasticsearch具有内置索引模板 , 每个索引模板的优先级为100 , 适用于以下索引模式:
logs-*-*metrics-*-*synthetics-*-*
所以在涉及内建索引模板时 , 要避免索引模式冲突。更多可以参考这里
2. 模板索引内容
settings: 指定index的配置信息, 比如分片数、副本数,tranlog同步条件、refresh策略等信息;mappings: 指定index的内部构建信息, 主要有:_all:All Field字段, 如果开启,_all字段就会把所有字段的内容都包含进来,检索的时候可以不用指定字段查询 —— 会检索多个字段, 设置方式:"_all": {"enabled": true};在ES
6.0开始,_all字段被禁用了, 作为替换, 可以通过copy_to自定义实现all字段的功能._source:Source Field字段,ES为每个文档都保存一份源数据, 如果不开启, 也就是"_source": {"enabled": false}, 查询的时候就只会返回文档的ID, 其他的文档内容需要通过Fields字段到索引中再次获取, 效率很低. 但若开启, 索引的体积会更大, 此时就可以通过Compress进行压缩, 并通过inclueds、excludes等方式在field上进行限制 —— 指定义允许哪些字段存储到_source中, 哪些不存储;properties: 最重要的配置, 是对索引结构和文档字段的设置.
索引模板一般用在时间序列相关的索引中 。也就是说, 如果你需要每间隔一定的时间就建立一次索引, 你只需要配置好索引模板, 以后就可以直接使用这个模板中的设置, 不用每次都设置settings和mappings。
3. 创建索引模板
创建一个商品的索引模板的示例:
ES 6.0之前的版本:PUT _template/shop_template { "template": "shop*", // 可以通过"shop*"来适配 "order": 0, // 模板的权重, 多个模板的时候优先匹配用, 值越大, 权重越高 "settings": { "number_of_shards": 1 // 分片数量, 可以定义其他配置项 }, "aliases": { "alias_1": {} // 索引对应的别名 }, "mappings": { "_default": { // 默认的配置, ES 6.0开始不再支持 "_source": { "enabled": false }, // 是否保存字段的原始值 "_all": { "enabled": false }, // 禁用_all字段 "dynamic": "strict" // 只用定义的字段, 关闭默认的自动类型推断 }, "type1": { // 默认的文档类型设置为type1, ES 6.0开始只支持一种type, 所以这里不需要指出 */ "_source": {"enabled": false}, "properties": { // 字段的映射 "@timestamp": { // 具体的字段映射 "type": "date", "format": "yyyy-MM-dd HH:mm:ss" }, "@version": { "doc_values": true, "index": "not_analyzed", // 不索引 "type": "string" // string类型 }, "logLevel": { "type": "long" } } } } }ES 6.0之后的版本:PUT _template/shop_template { "index_patterns": ["shop*", "bar*"], // 可以通过"shop*"和"bar*"来适配, template字段已过期 "order": 0, // 模板的权重, 多个模板的时候优先匹配用, 值越大, 权重越高 "settings": { "number_of_shards": 1 // 分片数量, 可以定义其他配置项 }, "aliases": { "alias_1": {} // 索引对应的别名 }, "mappings": { // ES 6.0开始只支持一种type, 名称为“_doc” "_doc": { "_source": { // 是否保存字段的原始值 "enabled": false }, "properties": { // 字段的映射 "@timestamp": { // 具体的字段映射 "type": "date", "format": "yyyy-MM-dd HH:mm:ss" }, "@version": { "doc_values": true, "index": "false", // 设置为false, 不索引 "type": "text" // text类型 }, "logLevel": { "type": "long" } } } } }
说明:
直接修改mapping的优先级 > 索引模板中的设置;
索引匹配了多个template , 当属性等配置出现不一致时, 以模板的权重(order属性的值)为准, 值越大越优先, order的默认值是0.
ES 6.0之后的版本API变化较大, 请重点关注
4. 查看索引模板
查看示例:
GET _template                // 查看所有模板
GET _template/temp*          // 查看与通配符相匹配的模板
GET _template/temp1,temp2    // 查看多个模板
GET _template/shop_template  // 查看指定模板
判断模板是否存在:
判断示例:
HEAD _template/shop_tem结果说明:
如果存在, 响应结果是:
200 - OK如果不存在, 响应结果是:
404 - Not Found
5. 删除示例:
DELETE _template/shop_template // 删除上述创建的模板如果模板不存在, 将抛出如下错误:
{
  "error" : {
    "root_cause" : [
      {
        "type" : "index_template_missing_exception",
        "reason" : "index_template [shop_temp] missing"
      }
    ],
    "type" : "index_template_missing_exception",
    "reason" : "index_template [shop_temp] missing"
  },
  "status" : 404
}
5 模板的使用建议
5.1 一个index中不能有多个type
Elasticsearch 6.X版本中已经不支持在同一个index下创建多个type
6.X之前的版本中, 父子文档的实现是一个索引中定义多个type,6.X中实现方式改变为join方式.
如果在同一个index下创建多个type, 会报出如下错误信息:
{
  "error": {
    "root_cause": [
      {
        "type": "illegal_argument_exception",
        "reason": "Rejecting mapping update to [book_shop] as the final mapping would have more than 1 type: [books, novel_book]"
      }
    ],
    "type": "illegal_argument_exception",
    "reason": "Rejecting mapping update to [book_shop] as the final mapping would have more than 1 type: [books, novel_book]"
  },
  "status": 400
}
错误信息指出: 拒绝对[book_shop]的mapping信息进行修改, 因为它作为final mapping(终态的mapping), 将会有超过2个type.
5.2 设置_source = false
如果我们只关心查询的评分结果, 而不用查看原始文档的内容, 就设置"_source": {"enabled": false}.
—— 这能节省磁盘空间并减少磁盘IO上的开销.
我们可以把原始的数据存储在
MySQL、HBase等数据库, 从ES中得到文档的ID之后, 再到相应的数据库中获取数据.
5.3 设置_all = false
如果能够确切地知道要对哪个field做查询操作, 就设置"_all": {"enabled": false}.
—— 这能实现性能提升, 并节省存储空间. 而在6.X版本开始, _all字段也不再支持了,ES官方建议我们通过copy_to自定义我们自己的all字段.
5.4 设置dynamic = strict
如果我们的数据是结构化数据, 就设置"dynamic": "strict".
—— 把动态类型判断设置为严格, 也就是不允许ES为插入的数据进行动态类型设置, 避免注入脏数据.
5.5 使用keyword类型
如果我们只关心精确匹配, 就设置test_field: {"type": "keyword"}.
—— keyword类型要比text类型的性能更高 , 并且还能节省磁盘的存储空间
参考链接
ES详解 - 索引: 索引模板(Index Template)详解 | Java 全栈知识体系 (pdai.tech)
ES 10 - 如何使用Elasticsearch的索引模板(index template) - 瘦风 - 博客园 (cnblogs.com)
聊聊elasticsearch7.8的模板和动态映射 - 一寸HUI - 博客园 (cnblogs.com)