1-监控系统概述及其发展
企业的IT架构逐步从传统的物理服务器 , 迁移到以虚拟机为主导的 IaaS 云 , 抑或当前流行的容器云PaaS 平台。无论基础架构如何调整 , 都离不开监控系统的支撑。
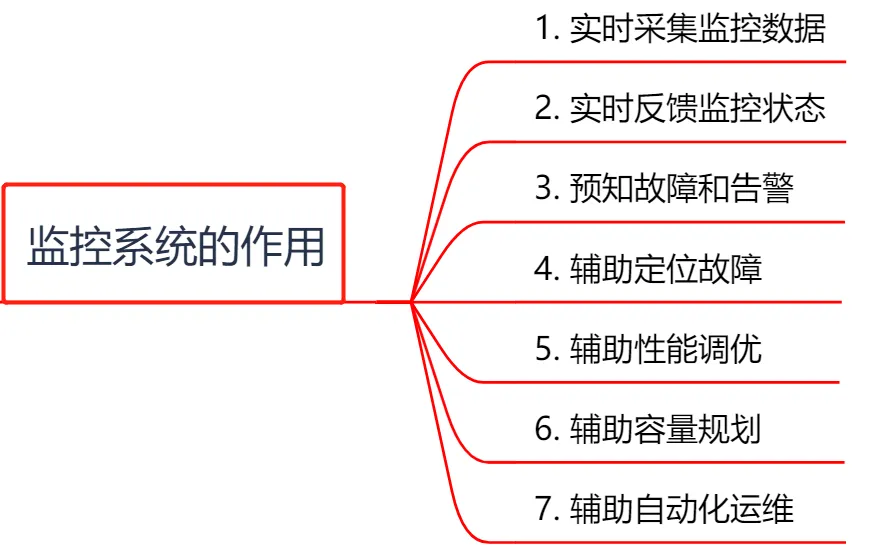
监控系统处理能提供实时监控和告警 , 还能辅助决策 , 所有决策都以数据为支撑 , 而非主观臆断。在大数据时代 , 数据变得越来越重要 , 监控数据不仅能提供实时状态展现 , 更能帮助故障回溯和预测风险等。当我们充分了解当前数据中心的真实资源使用情况时 , 才能绝对是否需要迁移服务、重新调度资源、清理垃圾数据及采购新的服务器。在故障发生后 , 通过分析历史监控数据 , 可以准确定位故障源 , 确定故障的发生时间及持续时间等 , 从而避免后续相关故障的发生。
从监控对象的角度来看 , 可以将监控分为网络监控、存储监控、服务器监控和应用监控等。
从程序设计的角度来看 , 可以将监控分为基础资源监控、中间件监控、应用程序监控和日志监控。
1. 基础资源监控
从监控对象的角度来看 , 可以将基础监控分为网络监控、存储监控和服务器监控。
1.1 网络监控
网络监控主要分为以下几个方向。
网络性能监控 (
Network Performance Monitor,NPM)主要涉及网络监测、网络实时流量监控 ( 网络延迟、访问量、成功率等 ) 和历史数据统计、汇总和历史数据分析等功能。
目前 , 有很多公司提供了
NPM解决方案 , 比如天旦、nCompass、SolarWinds、Nagios( 已开源 ) 等。
网络攻击检查
主要针对内网或外网的网络攻击如
DDoS攻击等 , 通过分析异常流量来确定网络攻击行为。
设备监控
主要针对数据中心的多种网络设备进行监控 , 包括路由器、防火墙和交换机等硬件设备 , 可以通过
SNMP等协议收集数据。
1.2 存储监控
存储主要分为云存储和分布式存储两部分。
云存储主要通过存储设备构建存储资源池 , 并对操作系统提供统一的存储接口 , 例如块存储的
SCSI和文件存储NFS等。它们的特点是存储接口统一 , 并不识别存储数据的格式和内容 , 例如块存储只负责保存二进制数据块 , 这些二进制数据可能来自图片或视频 , 对于块存储来说都是一样的。分布式存储主要构建在操作系统之上 , 提供分布式集群存储服务 , 主要是针对特定数据结构的数据存储。例如
HDFS的大文件存储、Dynamo的键值数据存储、Elasticsearch的日志文档存储等。
我们通常说到的存储监控主要是指云存储监控 , 主要监控数据中心内部的存储使用量和读写速度。
我们可以将云存储监控分为存储性能监控、存储系统监控及存储设备监控。
存储性能监控方面 , 块存储通常监控块的读写速率、
IOPS、读写延迟、磁盘使用量等 ; 文件存储通常监控文件系统Inode、读写速度、目录权限等。存储系统监控方面 , 不同的存储系统有不同的指标。例如 , 对于
Ceph存储 , 需要监控OSD、MON的运行状态 , 各种状态的数量 , 以及集群IOPS等信息。存储设备监控方面 , 对于构建在 x86 服务器上的存储设备 , 设备监控通过每个存储节点上的采集器统一收集磁盘、
SSD、网卡等设备信息 ; 存储厂商以黑盒方式提供的商业存储设备通常自带监控功能 , 可监控设备的运行状态、性能和容量等。
1.3 服务器监控
每个程序最终都会在对应的服务器上运行 , 对服务器的监控一方面是提供服务进程的运行环境信息 , 另一方面是通过汇总服务器上的监控数据来了解整个数据中心内部的服务器资源使用情况。
服务器监控包括物理服务器主机监控、虚拟机监控和容器监控 , 需要做到对多种环境的兼容 , 如下所述。
对服务器硬件的兼容。数据中心内的服务器通常来自多个厂商如Dell、华为或者联想等 , 服务器监控需要获取不同厂商的服务器硬件信息。
对操作系统的兼容。为了适应不同软件的需求 , 在服务器上会安装不同的操作系统如
Windows、Linux, 采集软件需要做到跨平台运行以获取对应的指标。对虚拟化环境的兼容。当前 , 虚拟化已经成为数据中心的标配 , 可以更加高效便捷地获取计算和存储服务。服务器监控需要兼容各种虚拟化环境如虚拟机 (
KVM、VMware、Xen) 及容器 (Docker、rkt) 。
采集监控数据的方式通常分为两种 : 一种是内置客户端 , 即在每台机器上都安装采集客户端 ; 另一种是在外部采集 , 例如在虚拟化环境中可以通过Xen API、VMware Vcenter API 或者 Libvirt 的接口分别获取监控数据。
从操作系统层次来看 , 采集指标通常有如下几种。
CPU: 涉及整体的CPU使用量、用户态百分比、内核态百分比、每个CPU的使用量、等待队列长度、I/O 等待百分比、CPU 消耗最多的进程、上下文切换次数、缓存命中率等。内存 : 涉及内存使用量、剩余量、内存占用最高的进程、交换分区大小、缺页异常数等。
网络I/O : 涉及每个网卡的上行流量、下行流量、网络延迟、丢包率等。
磁盘I/O : 涉及磁盘的读写速率、
IOPS( 每秒读写次数 ) 、磁盘用量、读写延迟等。
伴随着云计算的兴起 , 容器和虚拟机监控成为最近几年所有监控系统的必备功能 , 我们通常可以通过虚拟化软件提供的监控接口获取其监控数据。由 Google 开源的 cAdvisor 可以获取主机上所有容器的性能指标。
开源的服务器监控项目主要有 Prometheus、Zabbix 及 Open-Falcon 等。
2. 中间件监控
中间件是指系统软件和应用软件之间的连接软件 , 无论是在分布式系统中还是在单体系统中 , 中间件都发挥着重要的作用。
常用的中间件主要有以下几类。
消息中间件 , 例如
RabbitMQ、Kafka。Web服务中间件 , 例如Tomcat、Jetty、Nginx。缓存中间件 , 例如
Redis、Memcached。数据库中间件 , 例如
MySQL、PostgreSQL。
中间件的运行状态会直接影响服务程序的运行状态 , 很多系统的性能都受中间件的限制。Web 服务的并发上限很大程度上取决于数据库的并发能力 , 所以中间件监控既可以用于应用调优 , 也可以在高并发或者大流量的情况下及时反馈。
中间件监控需要针对不同中间件的特点和属性分别监控 , 目前并没有统一的标准和规范。例如 , 针对 Kafka 的性能监控通常需要采集 Kafka 集群的 Topic 个数、Broker 数据分区数量、日志 Offset 值、和生产消费流量等指标 ; 针对 Redis 的性能监控通常需要采集 Redis 的内存使用量、连接数、和缓存命中率等指标。解决方案通常是分别开发一个数据收集 Agent , 该 Agent 将采集中间件的性能指标并将其统一转换成 JSON、文本或者其他监控系统能识别的数据格式 , 然后汇总到监控中心。Prometheus 针对不同的中间件开发了对应的监控代理 , 例如 Kafka exporter、MySQL server exporter、Apache exporter、Redis exporter 等 exporter , 它们负责采集这些中间件的特定指标 , 并提供 HTTP 查询接口。
3. 应用程序监控(APM)
APM 主要是针对应用程序的监控 , 包括应用程序的运行状态监控、性能监控、日志监控及调用链跟踪等。调用链跟踪是指追踪整个请求过程 , 从用户发送请求 ( 通常指浏览器或者应用客户端 ) 到后端 API 服务 , 以及 API 服务和关联的中间件或者其他组件之间的调用 , 构建出一个完整的调用拓扑结构。不仅如此 , APM 还可以监控组件内部方法的调用层次 ( Controller-->Service-->DAO ) , 获取每个函数的执行耗时 , 从而为性能调优提供数据支撑。
4. 日志监控
区别于指标监控 , 日志监控采集日志数据 ( 文本类型 ) , 并将这些数据汇总到日志存储和搜索引擎中 , 提供日志检索的 Web 接入。指标监控的对象通常都是数字 , 而日志监控的对象是文本数据 , 这就要求存储系统具备文本检索功能。
日志监控不仅可以用于性能问题定位 , 还可以用于数据统计和故障告警。例如 , 在某个时间段内的程序输出日志中 , 若异常数超过阈值 , 则发出告警。
如下图所示 , 展现了目前业内比较流行的日志监控黄金组合 , 当然 , 每个组件都有一些替代方案。
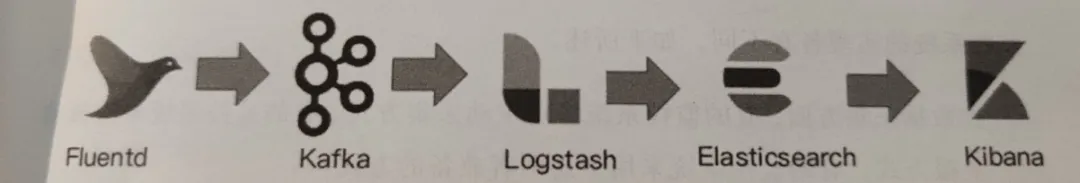
接下来对上图的组件进行简单介绍。
Fluentd主要负责日志采集 , 其他开源组件还有Filebeat、Flume、Fluent Bit等 , 也有一些应用集成Log4g等日志组件直接输出日志。Kafka主要负责数据整流合并 , 避免突发日志流量直接冲击Logstash, 业内也有用Redis替换Kafka的方案。Logstash负责日志整理 , 可以完成日志过滤、日志修改等功能。Elasticsearch负责日志存储和日志检索 , 自带分布式存储 , 可以将采集的日志进行分片存储。为保证数据高可用 ,Elasticsearch引入多副本概念 , 并通过Lucene实现日志的索引和查询。Kibana是一个日志查询组件 , 负责日志展现 , 主要通过Elasticsearch的HTTP接口展现日志。
5. 监控系统的实现
5.1 总体架构
监控系统的实现各有不同。
在数据采集方面 , 有的监控系统采用主动采集方式 , 有的监控系统采用被动上报方式 , 有的监控系统采用上述两者兼备的方式。
在数据传输方面 , 有的监控系统采用
Socket传输 , 有的监控系统采用HTTP传输。在数据存储方面 , 有的监控系统将监控数据保存在
MySQL中 , 有的监控系统将监控数据保存在MongoDB、OpenTSDB、InfluxDB等时序数据库中。
但是 , 所有监控系统的核心都是采集和处理数据。
监控系统通常由指标采集子系统和数据处理子系统这两大子系统组成 , 对这两大子系统说明如下。
指标采集子系统主要负责信息采集、过滤、汇总和存储。
数据处理子系统主要负责数据分析、展现、预警、告警动作触发和告警等。
5.2 指标采集
指标采集包括数据采集、数据传输和过滤 , 以及数据存储。
数据采集
数据采集有两种方式 : 通过客户端进行数据采集 ; 通过标准协议 ( 如 SNMP、JMX、IPMI 等 ) 进行数据采集。
数据传输和过滤
我们还需要将采集的数据传输到数据存储节点 , 这时可以通过 HTTP、Socket 连接进行点对点传输 , 还可以通过 RabbitMQ、Kafka 等消息中间件进行传输。
HTTP 是目前互联网最流行的协议 , 通过 HTTP 方式传输需要一个 HTTP 客户端和一个 HTTP 服务端。如果 Agent ( 采集器 ) 是一个 HTTP 服务端 , 那么采集中心节点会周期性调用 Agent 的接口获取数据 , 这种方式被称为 Pull ( 拉取 ) ; 相反 , 如果 Agent 是一个 HTTP 客户端 , 它就会调用中心节点的 HTTP 服务 , 将数据发送到中心节点 , 这种方式被称为 Push ( 推送 ) 。Socket 方式是指直接建立 TCP/IP 的传输通道 , 在传输上会更加高效 , 但对 Socket 连接的维护额外增加开发维护成本 , 对于开发人员的要求也更高。
使用消息中间件传输的方式在结构上充分解耦 , 数据采集组件只需将采集的数据放到消息中间件中 , 数据收集组件只需要从消息中间件中获取数据。消息中间件不仅可以将监控数据进行一定程度的持久化 , 而且可以对监控数据进行整流 , 避免突发流量冲击数据收集组件。数据收集组件可以部署多个接收消息 , 均衡流量。采用消息中间件传输的方式也有一定的弊端 , 即会造成整个系统对中间件的强依赖 , 如果中间件发生故障 , 则可能导致整个系统发生故障 , 并且消息中间件在安装部署及后期的运维中都比较复杂。采用 HTTP 传输的方式虽然有一定的耦合度 , 但系统可以足够简单 , 易于扩展和维护 , 大部分开源监控系统都采用这种方式。
数据存储
对监控数据的存储通常借助于时序数据库 ( TSDB ) 。监控数据的最大特点是有时间属性 , 每个监控数据都有一个时间维度 ( 属性 ) , 被称为时序数据 , 展现了一个物体的某些特征在一段时间内的变化情况。例如 , 股市数据就是典型的时序数据 , 在开盘的时候 , 每个时间点对应一个股价 , 并且股价随着时间的推移不断改变。
时序数据的特点有 :
一次性写入多次读取 , 时序数据通常不会修改更新 , 一旦存入 , 则后期只会对数据进行查询操作。
数据流持续平稳 , 时序数据量往往和采集点的数据量成正比 , 不会出现业务系统流量突增的情况 , 并且数据流是持续稳定的 , 通常间隔一个稳定的采集周期来获取数据 ; 相应的 , 随着时间的推移 , 存储的数据量会变得非常大。
查询方式以时间为维度 , 数据查询通常会指定一段时间 , 并且热数据通常都是最新采集的数据。在实际场景中 , 通常查询最近几个小时的监控数据 , 很少会查询一周之前的监控数据。
5.3 数据处理
数据处理分为数据查询、数据分析和基于规则告警等。
数据查询
数据查询指通过展现层 ( 浏览器或者客户端 ) 多维度展现实时数据和历史数据。实时数据查询严格要求数据的准确性和实时性 , 查询接口需要迅速响应。历史数据的查询则要求数据的时间跨度长 , 并且可以生成对应的监控报表。
另外 , 可以通过一些 Web 工具 , 把后端分析的数据以可视化的方式展现。折线图能够很好地展现数据变化的趋势 ; 饼状图能够更好地展现系统中各个子模块的占比 ; 柱状图的优势在于对数据的对比。这些图像化的展现能够让数据 “动起来” , 使其更加直观。
目前开源的工具有 Grafana、Kibana等 , 它们都允许用户自定义监控视图。
数据分析
数据分析是指为用户或者其他系统提供对监控数据的性能分析、关联分析和趋势分析。
基于规则告警
基于规则告警是指利用已经采集的监控数据 , 匹配用户自定义的多维度告警规则 , 如果满足 , 则触发相应规则的告警。
例如 , 性能告警规则一般是设定某个阈值、触发次数和告警行为 , 对于 CPU 利用率、内存使用量、 QPS 等性能指标 , 如果在某个时间段内多次触发该阈值 , 则将其视为满足告警条件 ; 如果是站点告警 , 则一般设置请求的返回码或者正则匹配消息体的内容、触发次数和告警动作 ; 还有一些告警属于异常告警 , 例如服务器宕机、网络不通等情况 , 通常不需要设置告警规则。
如果某个告警规则被触发 , 则在接下来的一段时间内 , 为避免相同的告警被多次触发 , 需要进行告警抑制 ; 如果是一个由 “根问题” 触发的一系列子问题告警 , 则都需要收敛到这次 “根问题” 上面。
6. 监控系统的发展趋势
监控系统提供的对单个指标的监控并不能很好地反映运行系统和程序的当前状态。告警都发送在故障发生之后 , 并不能对故障提前预警 , 并且告警处理基本通过简单的通知机制实现 , 运维人员还需要通过综合分析来确定问题 , 使问题处理时间延长。在分布式系统普及后 , 定位问题变得更加复杂。单纯的指标监控系统已经不能满足业务的需求。
如今 , 监控系统朝着自动化和智能化的方向发展 , 我们把性能监控、健康状态监控、应用监控等提供基础能力的监控称为传统监控 ; 把具备机器学习和自动化运维能力 , 能够进行智能分析和故障处理的监控系统称为智能监控。
智能监控需要具备以下能力 :
通过多种维度的指标分析定位问题的故障点。数据中心内的指标种类繁多 , 需要根据从硬件 ( 机房温度、风扇转速 ) 到软件 (
TCP延迟、网络丢包率 ) 等多个维度的监控指标 , 准确定位故障点。故障和风险预测。指通过对以往故障的学习 , 预测未来的故障时间。
AWS(Amazon Web Services) 通过对大量服务器发生故障的时间、故障前某些指标的异常等数据进行机器学习 , 可以准确预测服务器发生故障的时间 , 从而提前更换服务器。在 AWS 数据中心内有百万量级的服务器 , 故障发生的频率非常高 , 如果能够提前更换服务器 , 则会极大降低故障率。另外在互联网场景中 , 风险预测也非常重要 , 为了应对突发流量 , 通过对历史服务请求的QPS学习 , 可以预测未来某个时间段将会出现的流量高峰 , 从而提前将服务扩容。智能处理。单纯的通知告警并不能解决问题 , 现在的告警处理逐步从完全的人工处理 , 发展为目前的专家系统 ( 机器提供一些处理意见 ) , 下一阶段将会是机器的自动化运维 , 在不需要人为干涉的情况下 , 能够通过机器处理故障 , 而智能监控系统正是运维自动化的首要环节。
智能监控将会是监控的发展趋势 , 但它并不是空中楼阁 , 而是建立在传统运维基础之上的 , 如果没有传统监控的支持 , 就没有实时数据的支持 ; 如果没有对大量基础指标监控数据的学习 , 就没有智能决策。
参考链接
构建企业级监控平台系列 ( 一 ) : 监控系统概述及发展趋势