1. 集群cluster
集群是指将多台服务器集中在一起 , 每台服务器都实现相同的业务 , 做相同的事情。但是每台服务器并不是缺一不可 , 存在的作用主要是缓解并发压力和单点故障转移问题。我们可以利用一些廉价的符合工业标准的硬件构造高扩展、高性能、低成本、高可用的系统。
Cluster分为三种类型 :
LB: (Load Balancing), 负载均衡 , 多个主机组成 , 每个主机只承担一部分访问请求。集群中所有的节点都处于活动状态,它们分摊系统的工作负载。这种集群可以在接到请求时 , 检查接受请求较少 、不繁忙的服务器 , 并把请求转到这些服务器上。从检查其他服务器状态这一点上看,负载均衡和容错集群很接近, 不同之处是数量上更多。HA(High Availiablity) , 高可用 , 避免SPOF(single Point Of failure)。高可用集群解决的是保障用户的应用程序持续对外提供服务的能力。MTBF(Mean Time Between Failure) : 平均无故障时间 , 正常时间MTTR(Mean Time To Restoration): 平均恢复(repair) 前时间 , 故障时间A = MTBF / (MTBF+MTTR): (0,1) , 99%,99.5%,99.9%,99.99%,99.999%服务等级协议( 简称 :
SLA, 全称:service level agreement) 。是在一定开销下为保障服务的性能和可用性 , 服务提供商与用户间定义的一种双方认可的协定。通常这个开销是驱动提供服务质量的主要因素。在常规的领域中 , 总是设定所谓的三个9 , 四个9来进行表示 , 当没有达到这种水平的时候 , 就会有一系列的惩罚措施 ,而运维最主要的目标就是达成这种服务水平。 停机时间又分为两种 , 一种是计划内停机时间 , 一种是计划外停机时间。而运维则主要关注计划外 停机时间。
HPC(High-performance computing) : 这类集群致力于提供单个计算机所不能提供的强大的计算能力。 高性能计算分类高吞吐计算(High-throughput Computing)有一类高性能计算 , 可以把它分成若干可以并行的子任务,而且各个子任务彼此间没有什么关联。
集群主要具有以下特性:
伸缩性(
scalability)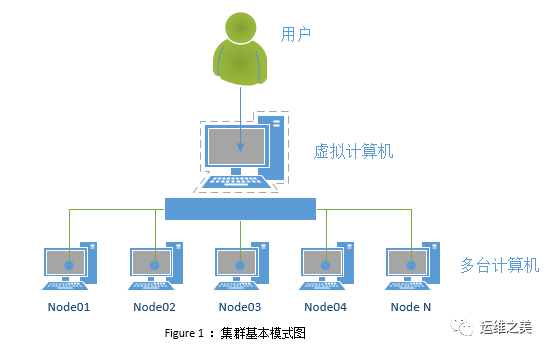
在一些大的系统中 , 预测最终用户的数量和行为是非常困难的 , 伸缩性是指系统适应不断增长的用户数的能力。提高这种并发会话能力的一种最直观的方式就是增加资源(CPU , 内存 , 硬盘等) ,集群是解决这个问题的另一种方式 , 它允许一组服务器组在一起 ,像单个服务器一样分担处理一个繁重的任务 , 我们只需要将新的服务器加入集群中即可 , 对于客户来看 , 服务无论从连续性还是性能上都几乎没有变化 , 好像系统在不知不觉中完成了升级。
高可用性(
High availability)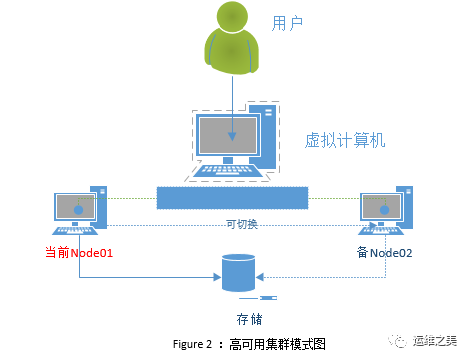
单一服务器的解决方案并不是一个健壮方式 , 因为容易出现单点失效。像银行、账单处理这样一些关键的应用程序是不能容忍的 , 哪怕是几分钟的死机。它们需要这样一些服务在任何时间都可以访问并在可预期的合理时间周期内有响应。高可用性集群的出现就是为了使集群的整体服务尽可能可用 , 以便考虑计算硬件和软件的易错性。如果高可用性集群中的主节点发生了故障 , 那么这段时间内将由次节点代替它。次节点通常是主节点的镜像 , 所以当它代替主节点时 , 它可以完全接管其身份。因此系统环境对于用户是一致的。
负载均衡(
Load balancing)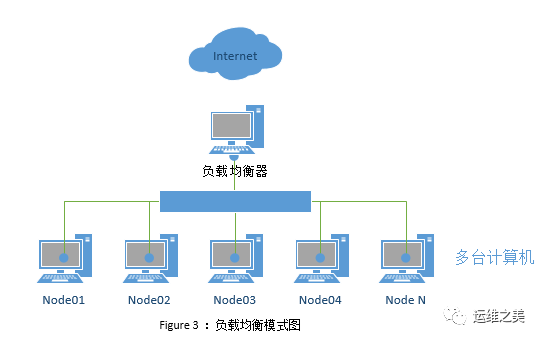
负载均衡集群为企业需求提供了更实用的系统。如名称所暗示的 , 该系统使负载可以在计算机集群中尽可能平均地分摊处理。该负载可能是需要均衡的应用程序处理负载或网络流量负载。这样的系统非常适合于运行同一组应用程序的大量用户。每个节点都可以处理一部分负载 , 并且可以在节点之间动态分配负载,以实现平衡。
高性能(
High Performance)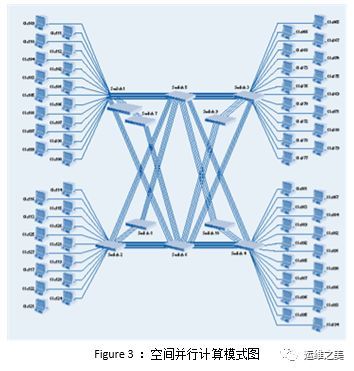
通常 , 这种设计的集群是用来开发并行编程应用程序 , 以解决复杂的科学问题。并行计算(或称平行计算)是相对于串行计算来说的 , 并行计算能力的目的是用来提高计算速度。它实际是一个计算机集群 , 其处理能力与真的超级计算机相等。
2. 分布式系统
2.1 分布式基础
分布式系统是由一组通过网络进行通信、为了完成共同的任务而协调工作的计算机节点组成的系统。分布式系统的出现是为了用廉价的、普通的机器完成单个计算机无法完成的计算、存储任务。其目的是利用更多的机器,处理更多的数据。
首先需要明确的是 , 只有当单个节点的处理能力无法满足日益增长的计算、存储任务的时候,且硬件的提升(加内存 、加磁盘、使用更好的CPU)高昂到得不偿失的时候,应用程序也不能进一步优化的时候 , 我们才需要考虑分布式系统。因为 , 分布式系统要解决的问题本身就是和单机系统一样的 , 而由于分布式系统多节点、通过网络通信的拓扑结构 , 会引入很多单机系统没有的问题,为了解决这些问题又会引入更多的机制、协议,带来更多的问题。
在很多文章中 , 主要讲分布式系统分为分布式计算(computation)与分布式存储(storage)。计算与存储是相辅相成的 , 计算需要数据 , 要么来自实时数据(流数据) , 要么来自存储的数据 ; 而计算的结果也是需要存储的。在操作系统中 , 对计算与存储有非常详尽的讨论,分布式系统只不过将这些理论推广到多个节点罢了。
那么分布式系统怎么将任务分发到这些计算机节点呢 , 很简单的思想 , 分而治之 , 即分片(partition) 。对于计算 ,那么就是对计算任务进行切换 , 每个节点算一些,最终汇总就行了 , 这就是MapReduce的思想 ; 对于存储 , 更好理解一下 , 每个节点存一部分数据就行了。当数据规模变大的时候 , Partition是唯一的选择 , 同时也会带来一些好处:
提升性能和并发 , 操作被分发到不同的分片 , 相互独立
提升系统的可用性 , 即使部分分片不能用,其他分片不会受到影响
理想的情况下 , 有分片就行了 , 但事实的情况却不大理想。原因在于 , 分布式系统中有大量的节点 , 且通过网络通信。单个节点的故障( 进程crash、断电、磁盘损坏 ) 是个小概率事件 , 但整个系统的故障率会随节点的增加而指数级增加 , 网络通信也可能出现断网、高延迟的情况。在这种一定会出现的“异常”情况下 , 分布式系统还是需要继续稳定的对外提供服务 , 即需要较强的容错性。最简单的办法 , 就是冗余或者复制集( Replication) , 即多个节点负责同一个任务 , 最为常见的就是分布式存储中 , 多个节点复杂存储同一份数据 , 以此增强可用性与可靠性。同时, Replication也会带来性能的提升 , 比如数据的locality可以减少用户的等待时间。
下面这种来自Distributed systems for fun and profit 的图形象生动说明了Partition与Replication是如何协作的。
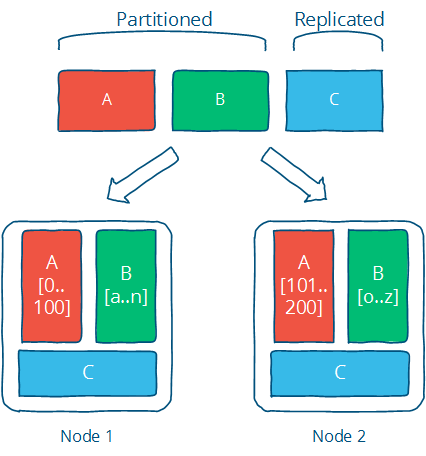
Partition和Replication是解决分布式系统问题的一记组合拳 , 很多具体的问题都可以用这个思路去解决。但这并不是银弹 , 往往是为了解决一个问题 , 会引入更多的问题 , 比如为了可用性与可靠性保证 , 引用了冗余(复制集 ) 。有了冗余 , 各个副本间的一致性问题就变得很头疼 , 一致性在系统的角度和用户的角度又有不同的等级划分 。如果要保证强一致性 , 那么会影响可用性与性能 , 在一些应用( 比如电商、搜索) 是难以接受的。如果是最终一致性 , 那么就需要处理数据冲突的情况。CAP、FLP这些理论告诉我们 , 在分布式系统中 , 没有最佳的选择 , 都是需要权衡 , 做出最合适的选择。
2.2 分布式系统挑战
分布式系统需要大量机器协作 , 面临诸多的挑战 :
异构的机器与网络:
分布式系统中的机器 , 配置不一样 , 其上运行的服务也可能由不同的语言、架构实现 , 因此处理能力也不一样 ;节点间通过网络连接 , 而不同网络运营商提供的网络的带宽、延时、丢包率又不一样。怎么保证大家齐头并进 , 共同完成目标 , 这四个不小的挑战。
普遍的节点故障 :
虽然单个节点的故障概率较低 , 但节点数目达到一定规模 , 出故障的概率就变高了。分布式系统需要保证故障发生的时候 , 系统仍然是可用的 ,这就需要监控节点的状态 , 在节点故障的情况下将该节点负责的计算、存储任务转移到其他节点
不可靠的网络 :
节点间通过网络通信 , 而网络是不可靠的。可能的网络问题包括 : 网络分割、延时、丢包、乱序。
相比单机过程调用 , 网络通信最让人头疼的是超时 : 节点
A向节点B发出请求 , 在约定的时间内没有收到节点B的响应 , 那么B是否处理了请求 , 这个是不确定的 , 这个不确定会带来诸多问题 , 最简单的是否要重试请求 , 节点B会不会多次处理同一个请求。
总而言之 , 分布式的挑战来自不确定性 , 不确定计算机什么时候crash、断电,不确定磁盘什么时候损坏,不确定每次网络通信要延迟多久 , 也不确定通信对端是否处理了发送的消息。而分布式的规模放大了这个不确定性 , 不确定性是令人讨厌的 , 所以有诸多的分布式理论、协议来保证在这种不确定性的情况下 , 系统还能继续正常工作。
2.3 分布式系统特性与衡量标准
透明性 : 使用分布式系统的用户并不关心系统是怎么实现的 , 也不关心读到的数据来自哪个节点 , 对用户而言 , 分布式系统的最高境界是用户根本感知不到这是一个分布式系统。
可扩展性 : 分布式系统的根本目标就是为了处理单个计算机无法处理的任务 , 当任务增加的时候 , 分布式系统的处理能力需要随之增加。简单来说 , 要比较方便的通过增加机器来应对数据量的增长 , 同时 , 当任务规模缩减的时候 , 可以撤掉一些多余的机器 ,达到动态伸缩的效果
可用性与可靠性 : 一般来说 , 分布式系统是需要长时间甚至7*24小时提供服务的。可用性是指系统在各种情况对外提供服务的能力 , 简单来说 , 可以通过不可用时间与正常服务时间的必知来衡量 ; 而可靠性而是指计算结果正确、存储的数据不丢失。
高性能 : 不管是单机还是分布式系统 , 大家都非常关注性能。不同的系统对性能的衡量指标是不同的 。最常见的 :高并发 , 单位时间内处理的任务越多越好 ; 低延迟 : 每个任务的平均时间越少越好。这个其实跟操作系统CPU的调度策略很像。
一致性 :分布式系统为了提高可用性可靠性 , 一般会引入冗余 (复制集) 。那么如何保证这些节点上的状态一致 , 这就是分布式系统不得不面对的一致性问题。一致性有很多等级 , 一致性越强 , 对用户越友好 , 但会制约系统的可用性 ; 一致性等级越低 , 用户就需要兼容数据不一致的情况 , 但系统的可用性、并发性很高很多。
2.4 分布式软件
分布式存储 : Ceph ,GlusterFS ,FastDFS , MogileFS。
分布式计算 : hadoop , Spark。
分布式常见应用
分布式应用 :服务按照功能拆分 , 使用微服务
分布式静态资源 : 静态资源放在不同的存储集群上
分布式数据和存储 : 使用
key-value缓存系统分布式计算 : 对特殊业务使用分布式计算 , 比如
Hadoop集群
3. 集群和分布式区别
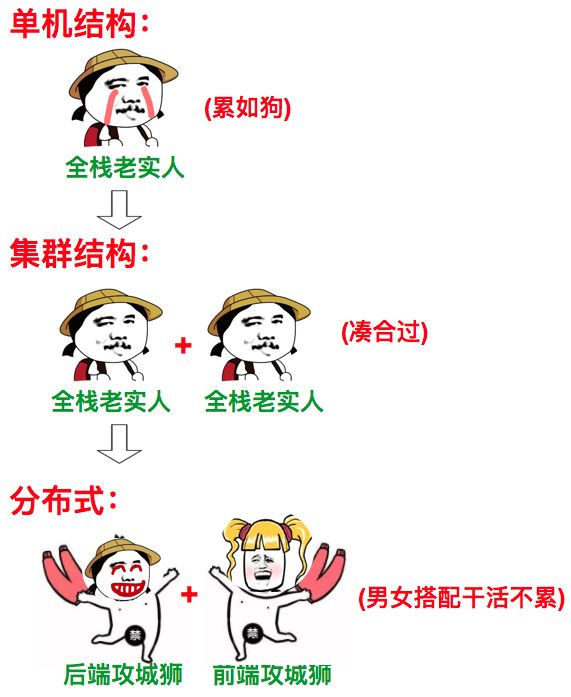
集群 : 同一个业务系统 , 部署在多台服务器上。集群中 , 每一台服务器实现的功能没有差别 , 数据和代码都是一样的
分布式 : 一个业务被拆成多个子业务 , 或者本身就是不同的业务 , 部署在多台服务器上。分布式中 , 每一台服务器实现的功能是有差别的 , 数据和代码也是不一样的 , 分布式每台服务器功能加起来 , 才是完整的业务
分布式是以缩短单个任务的执行时间来提升效率的 , 而集群则是通过提高单位时间内执行的任务数来提升效率。
对于大型网站 , 访问用户很多 , 实现一个群集 , 在前面部署一个负载均衡服务器 , 后面几台服务器完成同一业务。如果有用户进行相应业务访问时 , 负载均衡器根据后端哪台服务器的负载情况 , 决定由给哪一台去完成响应 , 并且一台服务器垮了 , 其它的服务器可以顶上来。分布式的每一个节点 , 都完成不同的业务 , 如果一个节点垮了 , 那这个业务可能就会失败
4. 负载均衡高可用
在解释这个专业术语之前 , 我们需要弄明白一个问题: 为什么需要负载均衡( Load Balancer ) ?在这里先举一个例子 , 假如我们有一个金融资讯类的网站,只允许100 个用户同时在线访问。网站上线初期 , 由于知名度较小 , 加上没有宣传 , 只有几个用户经常上线。后期知名度上升 , 宣传力度也加大了 , 且百度和谷歌收录了我们的网站 , 这时 , 同时在线的用户数量直线上升 , 甚至达到上千人。于是 , 网站变得异常繁忙 , 经常会反应不过来 , 这个时候用户体验势必下降 , 为了不影响客户对我们的信心 , 一定要想办法解决这个问题。试想 , 如果有几台或几十台相同配置的机器 , 前端放一个转发器 , 轮流转发客户对网站的请求 , 每台机器都将用户数控制在100 之内 , 那么网站的反应速度就会大大提升 , 即使其中的某台服务器因为硬件故障岩机了 , 也不会影响用户的访问。其中 , 这个神奇的转发器 就是负载均衡器 , 英文名为Director。那么什么是负载均衡呢?负载均衡建立在现有的网络结构之上 , 它提供了一种廉价、有效透明的方法来扩展网络设备和服务器的带宽 , 增加吞吐量 , 加强网络数据处理能力 , 提高网络的灵活性和可用性。通过负载均衡器可以实现N台廉价的PC 服务器并行处理 , 从而达到小型机或大型机的计算能力, 这也是目前负载均衡如此流行的主要原因。
高可用(High Availability )其实有两种不同的含义 : 在广义环境中指整个系统的高可用(High Availability )性 ; 在狭义方面一般指主机的冗余接管 , 如主机HA 。如无特殊说明 , 本书中的HA都是指广义的高可用性 , 即保证整个系统不会因为某一台主机崩溃或故障损坏而发生停止服务的现象 , 而狭义的就是我们前面提到的主机的冗余接管 , 我们可以从最前端的负载均衡器谈起。
单台负载均衡器位于网站的最前端 , 它起着对客户请求分流的作用 , 相当于整个网站或系统的人口 , 如果它不幸Crash (崩溃)了 , 整个网站也会宕机 , 所以我们要求有一种方案能在短时间(这个时间一般要求小于1秒)内将崩溃的负载均衡器接管过去 , 这称之为高可用。由于这个时间非常短 , 我们的客户完全没有察觉到我们其中的一台机器已经发生了崩溃情况。至于负载均衡器后端的Web集群、数据库集群 , 因为有负载均衡器的内部机制 , 即使是其中的某一台或两台发生问题 , 也不会影响整套系统的使用 , 这种意义上的高可用就是广义上的。
另外 , 现在我们俗称的Linux集群 , 它指的是大范围内的整套系统架构 , 相对于负载均衡器后端的Web集(Cluster ) 、Resin集群(Cluster)或MySQL 集群(Cluster )来说 , 它的涵盖面要广得多 , 包括了负载均衡高可用。这里为了便于区别 , 笔者在提到集群(Cluster ) 时一般会带上前缀 , 比方说Web集群(Cluster ) , 那么此时所指的是后端提供相同服务的Web 机器群 ; 如果是Linux 集群 , 那么指的就是大范围的系统集群架构 , 希望大家不要混淆。
目前 , 在线上环境中应用较多的负载均衡器硬件有自BIG-IP和Citrix NetScaler , 软件有LVS, Nginx 及HAProxy , 高可用软件有Heartbeat 、Keepalived , 成熟的Linux集群架构有DNS轮询、LVS+Keepalived 、Nginx/HAproxy十Keeaplived及DRBD+Heartbeat。
参考链接
浅谈集群、分布式、微服务的异同 - 云+社区 - 腾讯云 (tencent.com)
大白话解说,半分钟就懂 --- 分布式与集群是什么 ? 区别是什么?愿我如星君如月 ... 夜夜流光相皎洁 ...-CSDN博客分布式和集群
架构-分布式与集群的区别-收货人 余杭嘉云淘宝-程序博客网 (csdndocs.com)
什么是分布式系统,如何学习分布式系统 - xybaby - 博客园 (cnblogs.com)