1-Openstack基础
1. OpenStack简介
1.1 Openstack背景介绍
OpenStack是一个自由、开源的云计算平台。它主要作为基础设施即服务(IaaS)部署在公用云和私有云中 , 提供虚拟服务器和其他资源给用户使用。该软件平台由相互关联的组件组成 , 控制着整个数据中心内不同的厂商的计算、存储和网络资源的硬件池。用户可以通过基于网络的仪表盘、命令行工具或RESTful网络服务来管理。
OpenStack始于2010年 , 是Rackspace和美国国家航空航天局NASA的合作项目。截至2012年 , 它由2012年9月成立的非营利组织OpenStack基金会管理 , 旨在促进OpenStack软件及其社区。到2018年 , 已经有500多家公司加入了该项目。在2020年 , 该基金会宣布它将在2021年更名为Open Infrastructure Foundation(开放基础设施基金会)。
1.2. OpenStack应用场景
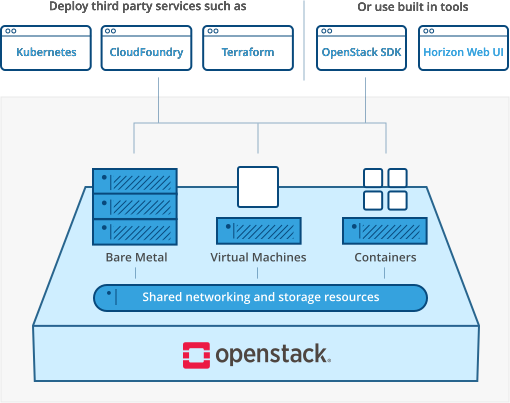
OpenStack是基础设施即服务(IaaS)软件 , 让任何人都可以自行创建和提供云计算服务。
此外 , OpenStack也用作创建防火墙内的"私有云"(Private Cloud) , 提供机构或企业内各部门共享资源。
1.3. OpenStack发展历程
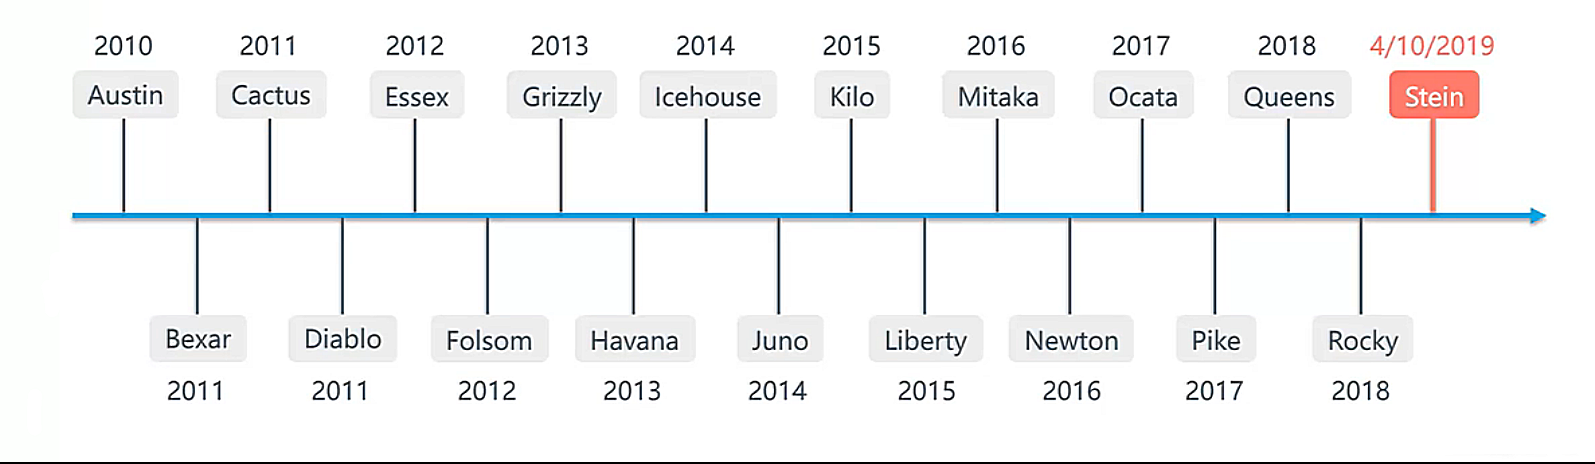
OpenStack每半年会发布一个版本 , 版本从字母A开始向后按顺序的命名 ; OpenStack社区为了方便描述 , 因此他们为每一个字母来进行投票 , 来选出一个单词。
2. OpenStack架构
2.1 架构设计原则
学习OpenStack的部署和运维之前 , 应当熟悉它的系统架构和运行机制 , 作为一个开源的、可扩展、富有弹性的操作系统 , 遵从以下的一些设计原则 :
按照不同的功能和通用性划分不同项目 , 拆分子系统
按照不同功能 , 划分不同服务 , 将一个整体功能拆分成各个子功能 , 并且服务之间相互隔离 , 只通过
API作为统一交互入口相互对接 , 方便管理 , 排障。按照逻辑计划、规范子系统之间的通信
API之间进行交互会有特定/通用的格式 , 各个子功能模块会通过一个公共的API进行交互/通讯 , 比如 :nova-api。通过分层设计整个系统架构
当一个请求进入的时候 , 首先会去找到
keystone进行认证鉴权 , 然后发送给对应的API入口 , 接着交由对应的子功能模块执行具体的逻辑。
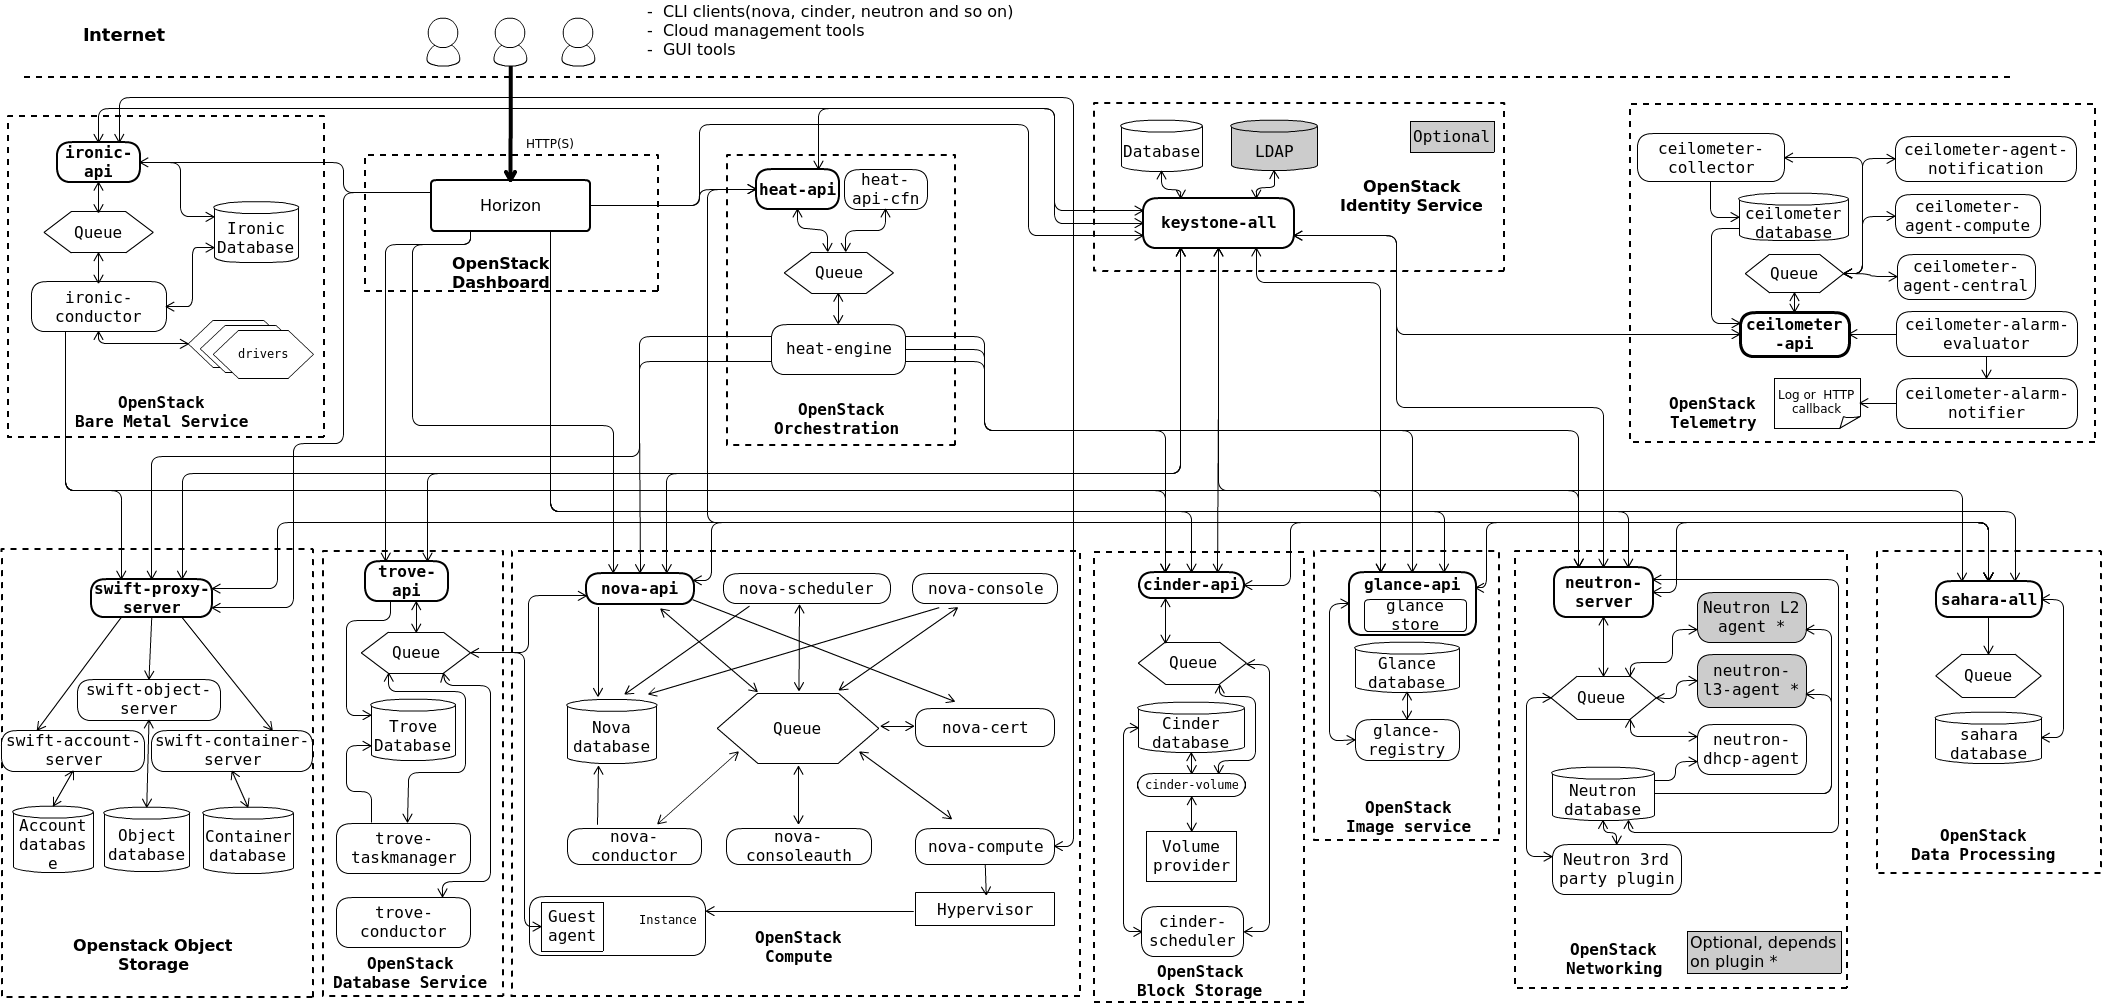
2.2 架构全景图
2.3 核心服务组件
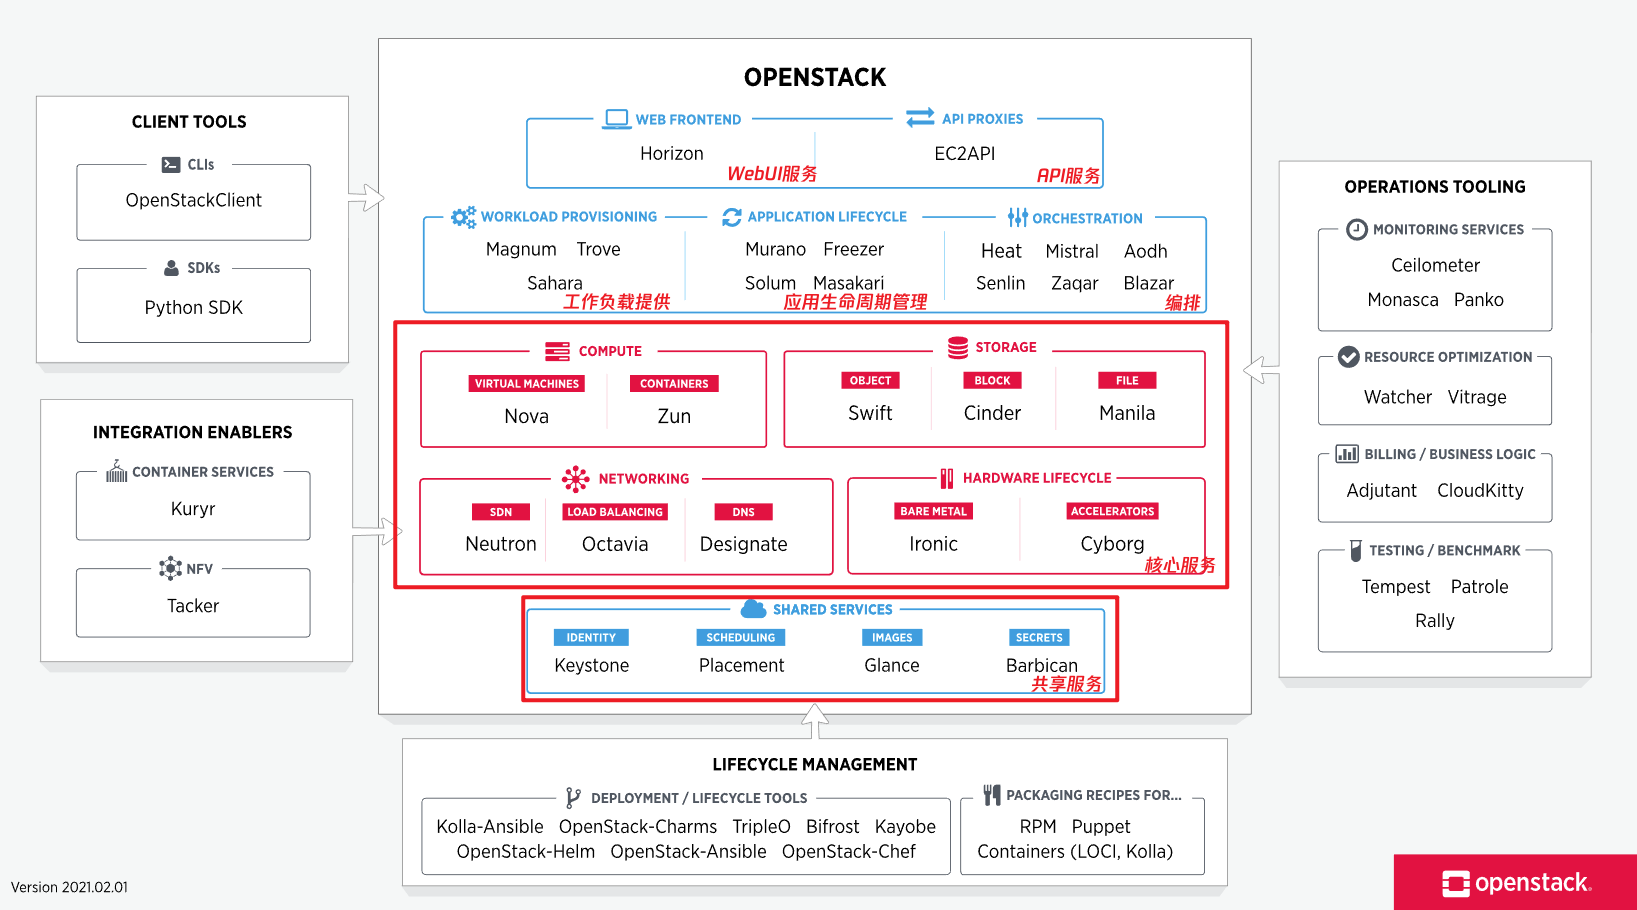
全局组件 :
Keystone: 管理全局认证和授权的组件 ;Ceilometer: 监控集群的状态 , 监控集群虚拟机的使用量 ;Horizon: 控制台可以控制OpenStack架构内部的所有功能 ;
辅助组件 :
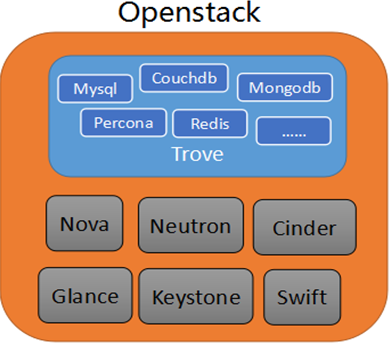
Ironic: 裸金属管理和控制基础硬件资源 ;Trove: 管理数据库的服务 , 管理关系型数据库和非关系型数据库 , 可以存储虚拟机和各组件调用的数据 , 以及各种日志 ;Heat和Sahara: 做数据的分析 , 编排和处理 , 精细化的管理 ;
核心组件 : 为虚拟机/实例提供服务
Nova: 负责虚拟机实例的生命周期管理、网络管理、存储卷管理、用户管理以及其他的相关云平台管理功能 , 支持虚拟机核心资源的横向扩展 , 支持虚拟机数量的横向扩展 ( 将资源提供给虚拟机 ) ;Neutron: 实现实例与实例之间以及实例与外部网络之间的通信 ;Cinder: 提供对Volume从创建到删除整个生命周期的管理 ;Glance: 提供发现、注册和下载的镜像服务 , 虚拟机镜像的集中式仓库 ; 通过虚拟机镜像创建虚拟机 , 对镜像进行精细化管理 , 提供管理镜像的服务(快照) , 修改镜像的元数据 ;Swift: 使用普通硬件来构建冗余的、可扩展的分布式对象存储集群 , 存储容量可达PB级。Swift属于对象存储 , 用于永久类型的静态数据的长期存储(如虚拟机镜像、图片存储、邮件存储和存档备份)。
OpenStack创建实例工作流简述 : 云平台用户在经过Keystone服务认证授权后 , 通过Horizon或者Rest API来创建虚拟机实例 , 创建过程中包括利用Nova服务创建虚拟机实例 , 虚拟机实例采用Glance提供镜像服务 , 然后使用Neutron为新建的虚拟机分配IP地址 , 并将其纳入虚拟网络中 , 之后再通过Cinder创建的卷为虚拟机挂载存储块 , 整个过程都在Ceilometer模块资源的监控下 , Cinder产生的卷(Volume)和Glance提供的镜像(Image)可以通过Swift的对象存储进行保存。
2.4 系统通信机制
在OpenStack系统中 , 有许多服务 ( Nova、Cinder、Neutron等 ) , 每个服务中有非常多的子功能模块(比如 : Nova , 有nova-api、nova-scheduler等) , 那么这些不同服务以及其中的子功能模块是如何进行通信的呢?
主要分为两类:
RESTful APIRPC
2.4.1 RESTful API
REST , 表示性状态转移 ( representation state transfer ) 。简单来说 , 就是用URI表示资源 , 用HTTP方法(GET, POST, PUT, DELETE)表征对这些资源的操作。
Resource: 资源 , 即数据 , 存在互联网上的可被访问的实体Representation: 数据的某种表现形式 , 如HTML,JSON。State Transfer: 状态变化 ,HTTP方法实现
RESTful API是一套架构约束条件和原则 , 通过URL来定位资源 , 用HTTP动词 ( GET、POST、PUT、DELETE ) 描述操作。
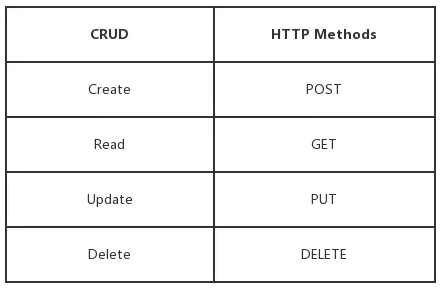
REST定义的原则:
所有事务都定义了
ID,OpenStack中每个资源都有唯一的UUID所有事务都链接在一起 , 在
OpenStack中将资源的ID放在URL中使用标准的
HTTP方法 , 如GET/POST/PUT/DELETE来获取/新增/修改/删除资源
使用RESTful API有什么好处:
客户端与服务端解耦 : 在
API接口不变的情况下 , 客户端和服务端可以独立进行更新迭代。无状态性: 用户的状态保存在客户端 , 服务端无需保存用户的状态。客户端向服务端发送请求时 , 必须发送所有的数据 , 包括用户状态。
统一的接口:
RESTful API的URL格式需要遵从统一的规范
利用PasteDeploy定制WSGI服务 ( OpenStack中所有Web服务都是通过WSGI部署的 )
2.4.2 RPC
RPC , 远程过程调用 ( Remote Procedure Call Protocol )
RPC采用AMQP协议实现进程间的通信 , 在OpenStack中采用的是 RabbitMQ 和 qpid 。
AMQP协议: 高级消息队列 , 基于消息的中间件提供的开放的应用层标准协议 , 能够有效地支持各种通信模型或者 报文传送方面的应用。
特点: 二进制的应用层通信协议 , 进程之间对称的异步通信协议 , 消息格式 , 一系列标准化的但可拓展的消息能力 ( 订阅者和发布者 , 两个节点无需知道对方是什么节点 , 也不用管对方节点怎么去处理发送消息 )
组成: 生产者 ( Publisher ) 、消费者 ( Comsumer ) 、中间件 ( Broker )
流程: 生产者将消息发布到中间件中 , 中间件将消息存储到消息队列中 , 最后订阅者从消息队列中获取消息。
Tips:
生产者无需知道消费者的位置
客户端与服务端无需同步运行 , 客户端可以先发
RPC调用 , 然后存储在消息队列中远程调用的随即均衡性 , 当客户端发起
RPC调用时 , 可以随机选择一个服务器来处理消息
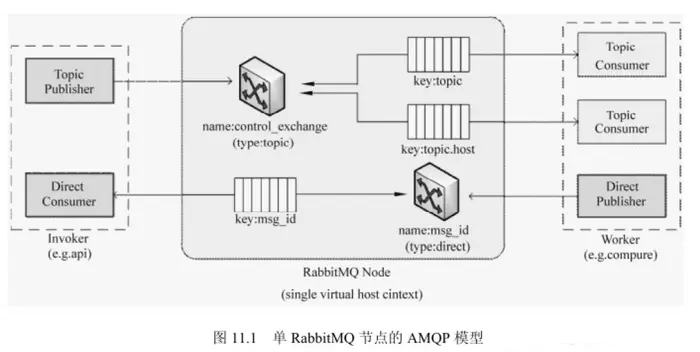
两种交换方式:
直接交换方式 (
direct exchange) : 主要用于服务端返回rpc.call调用的结果 , 订阅者直接点名要哪台服务器进行响应主题交换方式 (
topic exchange) : 主要用户客户端发起远程调用rpc.call和rpc.cast, 发布者不指定响应的服务器 , 可实现负载均衡
区别:
只需要记住一点: RPC是以动词为中心的 , REST是以名词为中心的 , 此处的动词指的是一些方法 , 名词是指资源。
RPC以动词为中心 , 意味着 , 当你要需要加入新功能时 , 你必须要添加更多的动词 , 这时候服务器端需要实现相应的动词 ( 方法 ) , 客户端需要知道这个新的动词并进行调用。而
REST以名词为中心 , 假使我请求的是hostname/friends/, 无论这个URI对应的服务怎么变化 , 客户端是无需关注和更新的 , 而这种变化对客户端也是透明的。
3. 认证服务【Keystone】
3.1 作用
用户管理: 验证用户身份信息合法性
认证服务: 提供了其余所有组件的认证信息/令牌的管理 , 创建 , 修改等 , 用专门的数据库来统一存放 ( 以前是
MySQL, 后面变成MariaDB)Keystone是OpenStack用来进行身份验证及高级授权的身份识别服务 , 目前支持基于口令的authN和用户服务授权
3.2 概念
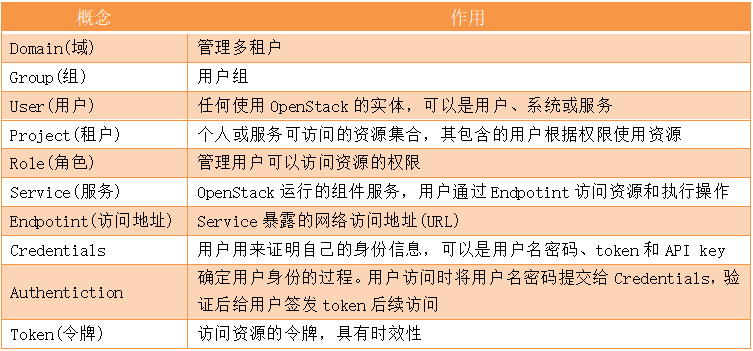
租户 (
Project) : 个人或服务所拥有的资源集合。在一个Project(Tenant)中可以包含多个User, 每一个User都会根据权限的划分来使用Project(Tenant)中的资源。用户 (
User) : 访问OpenStack的对象。用户拥有证书 (credentials) , 且可能分配给一个或多个租户。经过验证后 , 会为每个单独的租户提供一个特定的令牌。证书 (
Credentials) : 确认用户身份的凭证。可以是用户名和密码、用户名和API Key和Token。令牌 (
Token) : 一个字符串表示 , 作为访问资源的令牌。Token包含了在指定范围和有效时间内可以被访问的资源 , 具有时效性。角色 (
Role) : 用于划分权限。可以通过给User指定Role, 使User获得Role对应的操作权限。Keystone返回给User的Token包含了Role列表 , 被访问的Services会判断访问它的User和User提供的Token中所包含的Role。Policy: 用来控制User对Project中资源(包括Services)的操作权限。对于Keystone service来说 ,Policy就是一个JSON文件 , 默认是/etc/keystone/policy.json。Authentication: 确定用户身份的过程服务 (
Service) :Openstack中运行的组件服务Endpoint: 通过网络来访问和定位某个Openstack service的地址 , 通常是一个URL, 分为三类 :admin url—>管理员用户使用 ,Port : 35357internal url—>openstack内部组件间互相通信 ( 内部访问) ,Port : 5000( 组件之间通信基于Restful api)public url—> 其他用户访问地址 ( 全局访问) ,Port : 5000
3.2 工作原理
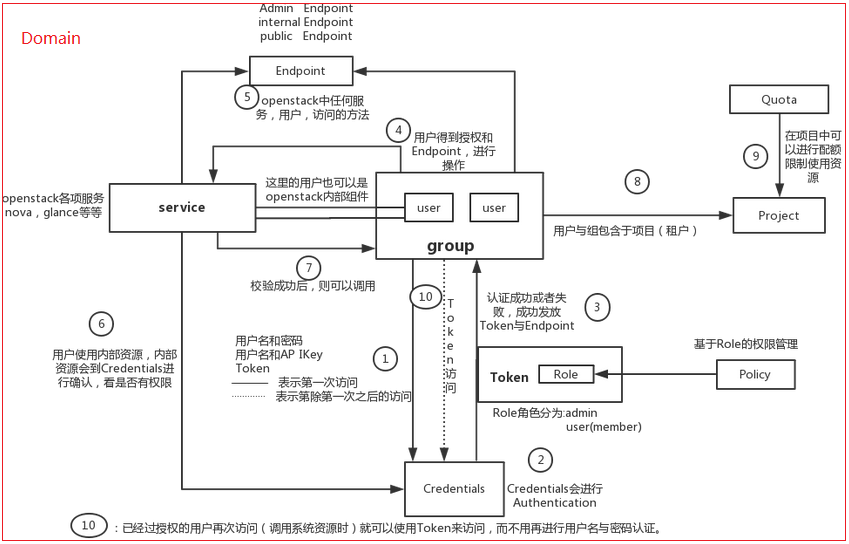
首先
User向Keystone提供自己的Credentials( 凭证: 用于确认用户身份的数据 , 例如:username/password) ;Keystone根据User提供的Credentials从SQL Database中进行身份和权限校验 , 验证通过返回User一个Token和Endpoint;User得到授权 (Token) 和Endpoint后根据自身权限操作OpenStack的资源。
3.3 在各个组件中的作用
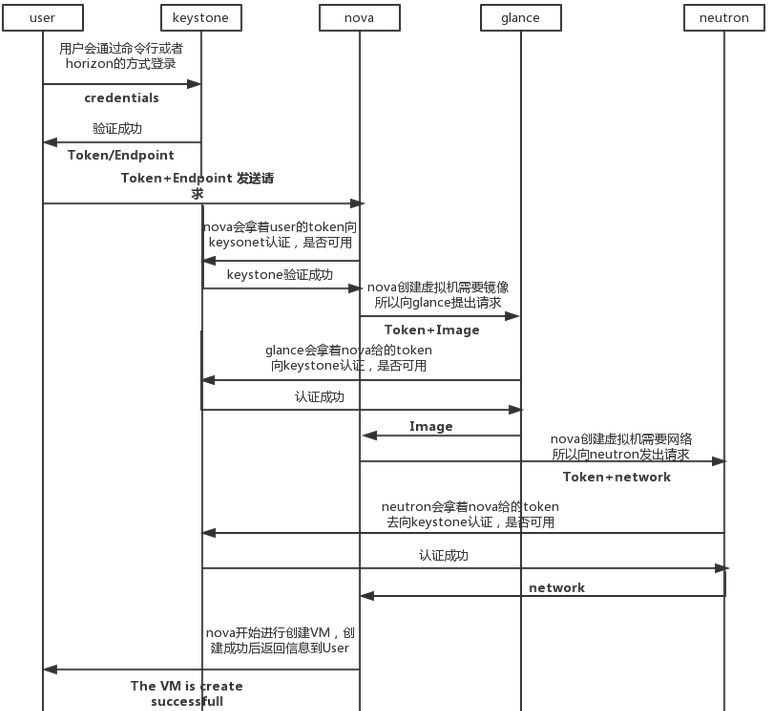
User通过命令行或者API的方式登录后 , 提供自己的Credentials(凭证: 用于确认用户身份的数据 , 例如:username/password)。Keystone根据User提供的Credentials从SQL Database中进行身份和权限校验 , 验证通过返回User一个Token和Endpoint。此后
User所有的Request都会使用该Token进行身份验证。
Tips: 从以上过程可以看出 , 用户的角色管理在
Keystone中是很重要的工作。在Keystone V3之前 , 用户的权限管理以每一个用户为单位 , 需要对每一个用户进行角色分配 , 并不存在一种对一组用户进行统一管理的方案 , 这给系统管理员带来了额外的工作和不便。此外 ,Keystone V3之前的版本中 , 资源分配是以Tenant为单位的 , 这不太符合现实世界中的层级关系。如一个公司在Openstack中拥有两个不同的项目 , 他需要管理两个Tenant来分别对应这两个项目 , 并对这两个Tenant中的用户分别分配角色。由于在Tenant之上并不存在一个更高层的概念 , 无法对Tenant进行统一的管理 , 所以这给多Tenant的用户带来了不便。为了解决这些问题 ,Keystone V3提出了新的概念Domain和Group。
3.4 访问流程
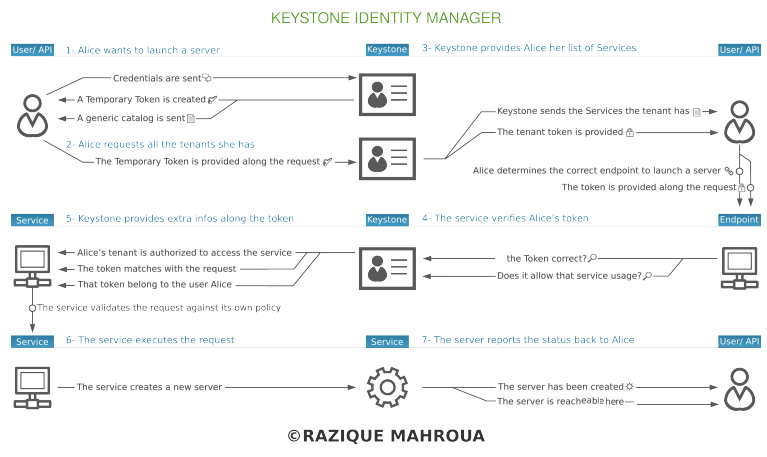
User/API想创建一个实例 , 首先会将自己的Credentials发给Keystone。认证成功后 ,keystone会颁给User/API一个临时的令牌(Token)和一个访问服务的Endpoint;User/API把临时Token提交给Keystone,Keystone返回一个Tenant(Project) ;User/API向Keystone发送带有特定租户的凭证(交互权限) , 告诉Keystone User/API在哪个项目中 ,Keystone收到请求后 , 会发送一个项目的Token到User/API( 访问权限 ) ,User/API拿着Token和Endpoint找到可访问服务 ;服务向
keystone进行认证 ,Token是否合法 , 它允许访问使用该服务 ( 判断用户/API中role权限 ) ;Keystone向服务提供额外的信息。User/API是允许方法服务 , 这个Token匹配请求 , 这个Token是User/API的 ;服务执行
User/API发起的请求 , 创建实例 ;服务会将状态报告给
用户/API。最后返回结果 , 实例已经创建。
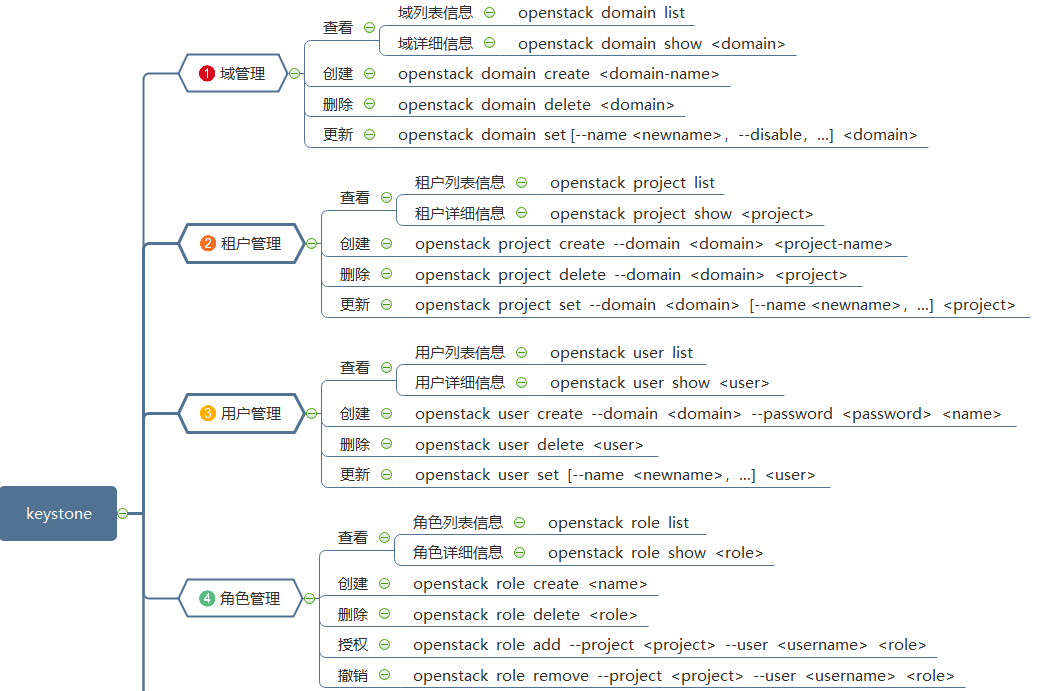
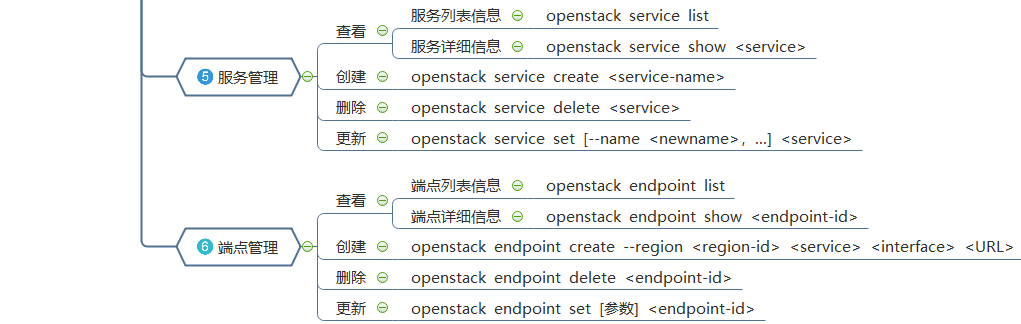
3.5 常用操作
4. 镜像服务【Glance】
4.1 作用
Glance是OpenStack镜像服务 , 用来注册、登陆和检索虚拟机镜像 ;Glance服务提供了一个REST API, 使你能够查询虚拟机镜像元数据和检索的实际镜像 ;通过镜像服务提供的虚拟机镜像可以存储在不同的位置 , 从简单的文件系统对象存储到类似
OpenStack对象存储系统 ;提供了对虚拟机部署的时候所能提供的镜像的管理 , 包含镜像的导入 , 格式 , 以及制作相应的模板。
4.2 镜像状态
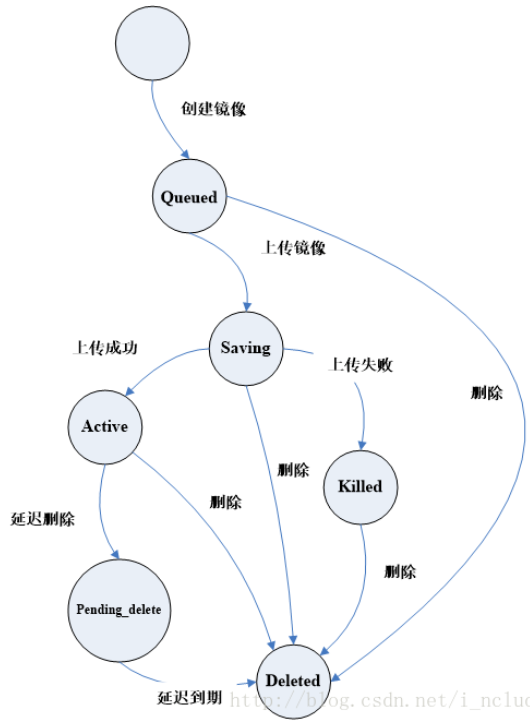
Queued: 初始化镜像状态 , 在镜像文件刚刚被创建 , 在glance数据库中已经保存了镜像标示符 , 但还没有上传至glance中 , 此时的glance对镜像数据没有任何描述 , 其存储空间为0 ;
Saving: 镜像的原始数据在上传中的一种过度状态 , 它产生在镜像数据上传至glance的过程中 , 一般来讲 , glance收到一个image请求后 , 才将镜像上传给glance ;
Active: 镜像成功上传完毕以后的一种状态 , 它表明glance中可用的镜像 ;
Killed: 镜像上传失败或者镜像文件不可读的情况下 , glance将镜像状态设置成Killed ;
Deleted: 镜像文件马上会被删除 , 只是当前glance这种仍然保留该镜像文件的相关信息和原始镜像数据 ;
Pending_delete: 镜像文件马上会被删除 , 镜像文件不能恢复。
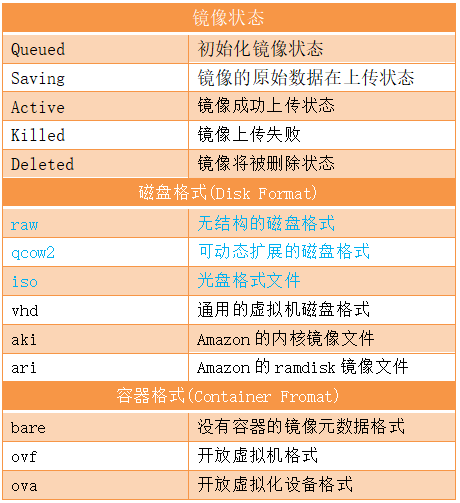
4.3 磁盘格式
RAW: RAW即常说的裸格式 , 它其实就是没有格式 , 最大的特点就是简单 , 数据写入什么就是什么 , 不做任何修饰 , 所以再性能方面很不错 , 甚至不需要启动这个镜像的虚拟机 , 只需要文件挂载即可直接读写内部数据。并且由于RAW格式简单 , 因此RAW和其他格式之间的转换也更容易。在KVM的虚拟化环境下 , 有很多使用RAW格式的虚拟机。
QCOW2: 它是QEMU的CopyOn Write特性的磁盘格式 , 主要特性是磁盘文件大小可以随着数据的增长而增长。譬如创建一个10GB的虚拟机 , 实际虚拟机内部只用了5GB , 那么初始的qcow2磁盘文件大小就是5GB。与RAW相比 , 使用这种格式可以节省一部分空间资源。
VHD: VHD也是一种通用的磁盘格式。微软公司的Virtual PC和Hyper-V使用的就是VHD格式。VirtualBox也提供了对VHD的支持。如果要在OpenStack上使用Hyper-V的虚拟化 , 就应该上传VHD格式的镜像文件。
VMDK: VMware创建的一个虚拟机磁盘格式 , 目前也是一个开放的通用格式 , 除了VMware自家的产品外 , QEMU和VirtualBox也提供了对VMDK格式的支持。
VDI: Oracle公司的VirtualBox虚拟软件所使用的格式。
ISO: ISO是指一种存档数据文件在光盘上的格式。
AKI、ARI、AMI : Amazon公司的AWS所使用的镜像格式。
4.4 容器格式
BARE: 没有容器的一种镜像元数据格式。
OVF: 开放虚拟化格式。
OVA: 开放虚拟化设备格式。
AKI、ARI: Amazon公司的AWS所使用的镜像格式。
4.5 核心架构
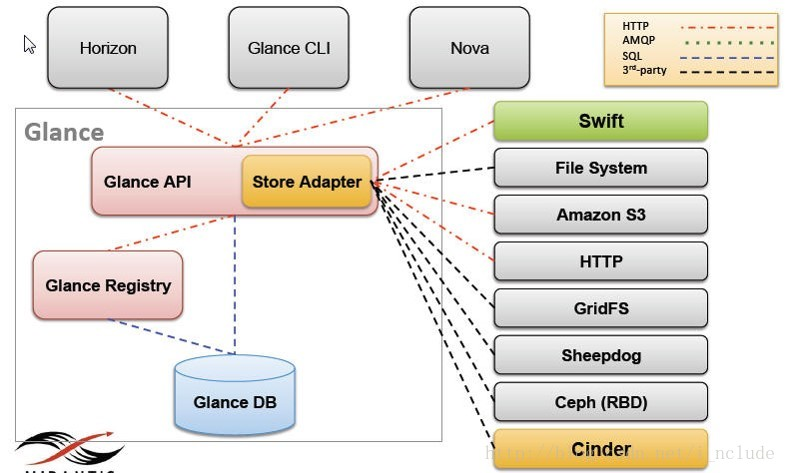
Glance-api : 接收REST API的请求: 然后通过其他模块(glance-registry及image store)来完成诸如镜像的查找、获取、上传、删除等操作: 默认监听端口9292。
Glance-registry : 用于与MariaDB数据库交互: 用于存储或获取镜像的元数据(metadata) : 默认监听端口9191。
Store Adapter : 通过提供的存储接口来获取镜像
Database : Image的metadata会保持到database中: 主要使用MySQL和SQLite。
4.6 配置文件
glance-api.conf:Glance api服务配置文件Glance服务安装的日志和调试信息 , 例如 :debug、日志文件路径log_file等参数。Glance服务的API服务器的相关信息。例如 : 服务绑定的IP地址、端口bind_port等参数。Registry服务的相关信息 , 例如 :Registry服务的网络地址、监听的端口号、Glance与Registry间通信的协议等。系统消息相关参数 , 该部分主要配置
Glance与系统消息的收发 , 消息队列RabbitMQ的IP地址、监听端口等参数。镜像后端存储的相关配置 , 一般情况下 ,
glance-api.config中包含普通文件存储、Swfit、S3、RBD等较为常见的存储设备的信息配置。
glance-registry.conf:glance-registry服务配置文件 , 用户存储镜像有关的元数据。glance-scrubber.conf: 用于清理已删除的镜像的服务。policy.json: 镜像服务的访问控制。在这里 , 我们可以定义角色和策略 , 是OpenStack Glance中的安全特性。
4.7 工作流程
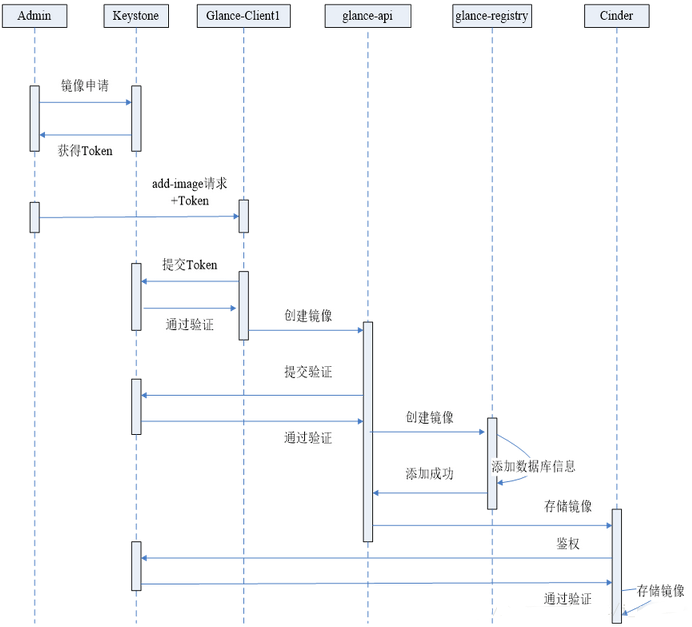
4.8 常用操作
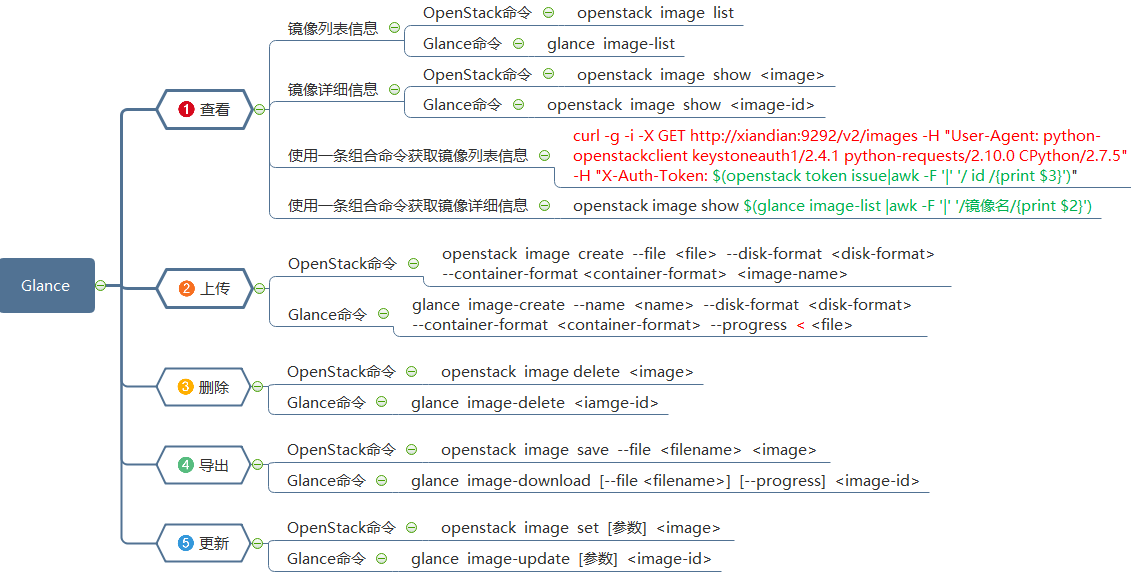
5. 计算服务【Nova】
5.1 概念
Nova和Swift是OpenStack最早的两个组件 ,nova分为控制节点和计算节点。计算节点通过
Nova Compute进行虚拟机创建 , 通过libvirt调用kvm创建虚拟机 ,nova之间通信通过rabbitMQ队列进行通信。Nova位于Openstack架构的中心 , 其他服务或者组件(比如Glance、Cinder、Neutron等) 对它提供支持 , 另外它本身的架构也比较复杂。
5.2 作用
Nova是OpenStack最核心的服务模块 , 负责管理和维护云计算环境的计算资源 , 负责整个云环境虚拟机生命周期的管理。Nova是OpenStack的计算服务 , 负责维护和管理的网络和存储 , 提供计算服务。
5.3 核心架构
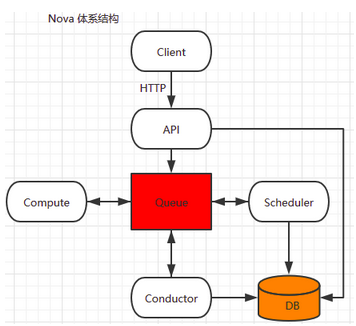
5.4 组件
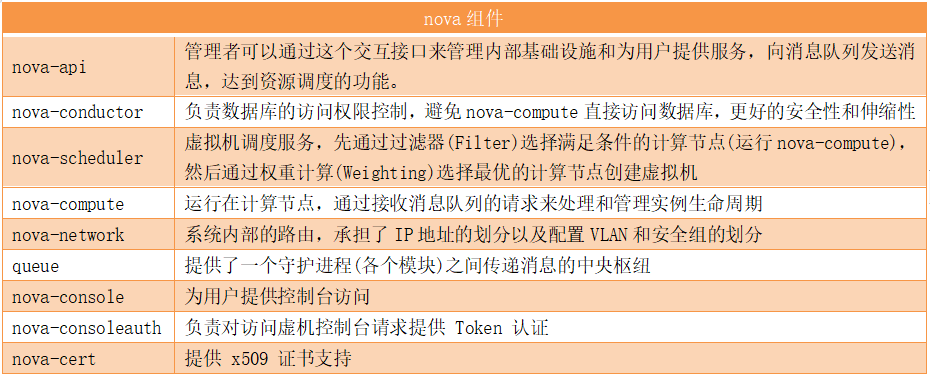
nova-api: 实现了RESTful API功能 , 是外部访问Nova的唯一途径。接收外部的请求并通过Message Queue将请求发送给其他的服务组件 , 同时也兼容EC2 API, 所以也可以用EC2的管理工具对nova进行日常管理。nova-scheduler: 决策虚拟机创建在哪个主机 ( 计算节点 ) 上。决策一个虚拟机应该调度到某物理节点 , 需要分为两个步骤 :过滤 (
filter) : 过滤出可以创建虚拟机的主机。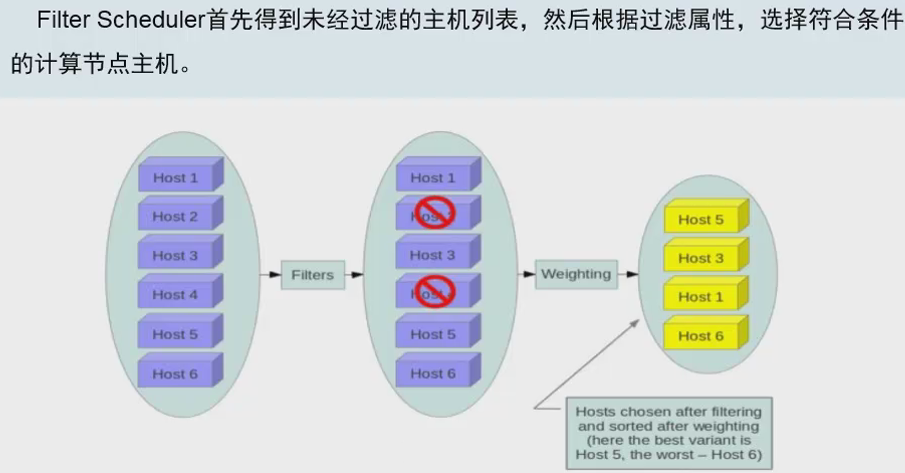
计算权值(
weight) : 根据权重大小进行分配 , 默认根据资源可用空间进行权重排序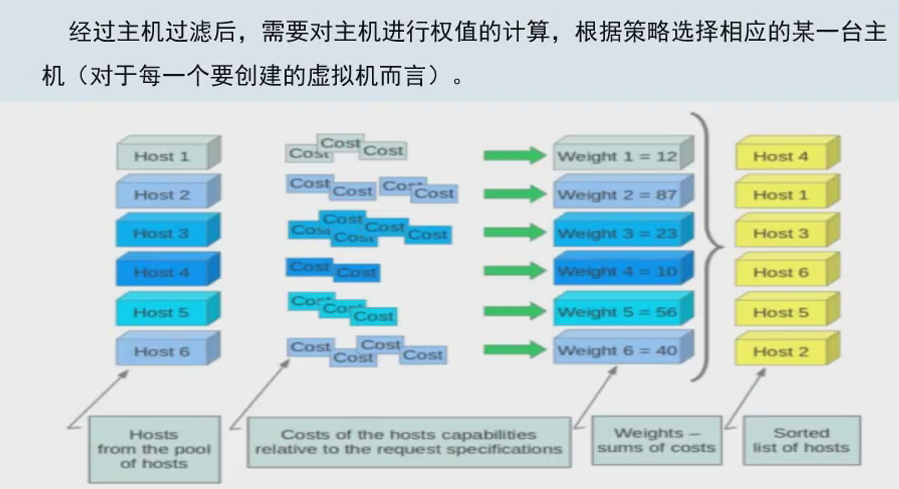
nova-compute: 负责虚拟机的生命周期管理 , 创建并终止虚拟机实例的工作后台程序Hypervisor api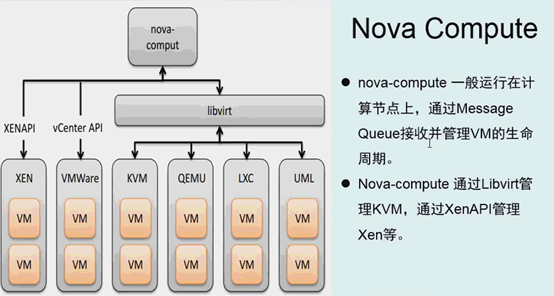
nova-conductor: 计算节点访问数据的中间件 ,nova-compute服务和数据库之间的中间件。它消除了对云数据库的直接访问。nova-api-metadata: 从实例中接收元数据请求。nova-api-metadata服务通常在nova-network安装时使用的是多宿主模式运行。nova-placement-api: 跟踪每个计算提供者的仓库和使用情况。nova-consoleauth: 用于控制台的授权验证 , 授权控制台代理提供的用户令牌。此服务必须运行用于控制台代理工作。您可以运行任何类型的代理 , 而不是集群配置中的单nova-consoleauth服务。Queue: 在守护进程之间传递消息的中心。通常使用RabbitMQ也可以用另一个基于AMQP的消息队列 , 例如ZeroMQ。
5.4 工作流程
Nova创建虚拟机的过程中 , 会与Keystone、Glance、Cinder、Neutron等组件联动
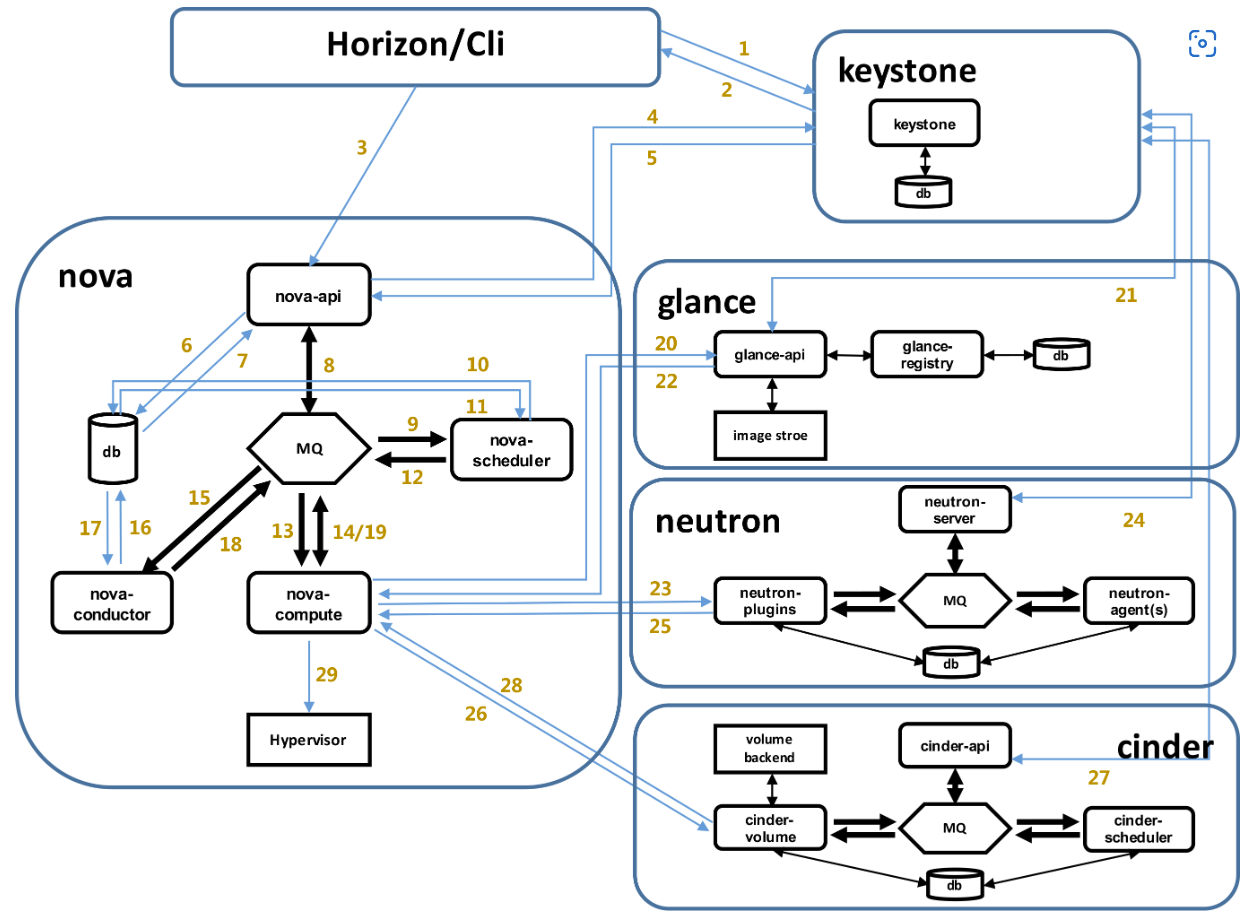
Nova创建虚拟机的过程 :
通过
Web界面或命令行通过RESTful API向keystone获取认证信息。keystone通过用户请求认证信息 , 并生成auth-token返回给对应的认证请求。界面或命令行通过
RESTful API向nova-api发送一个boot instance的请求(携带auth-token)。nova-api接受请求后向keystone发送认证请求 , 查看token是否为有效用户和token。keystone验证token是否有效 , 如有效则返回有效的认证和对应的角色(注:有些操作需要有角色权限才能操作)。通过认证后
nova-api和数据库通讯。初始化新建虚拟机的数据库记录。
nova-api通过rpc.call向nova-scheduler请求是否有创建虚拟机的资源(Host ID)。nova-scheduler进程侦听消息队列 , 获取nova-api的请求。nova-scheduler通过查询nova数据库中计算资源的情况 , 并通过调度算法计算符合虚拟机创建需要的主机。对于有符合虚拟机创建的主机 ,
nova-scheduler更新数据库中虚拟机对应的物理主机信息。nova-scheduler通过rpc.cast向nova-compute发送对应的创建虚拟机请求的消息。nova-compute会从对应的消息队列中获取创建虚拟机请求的消息。nova-compute通过rpc.call向nova-conductor请求获取虚拟机消息。 (Flavor)nova-conductor从消息队队列中拿到nova-compute请求消息。nova-conductor根据消息查询虚拟机对应的信息。nova-conductor从数据库中获得虚拟机对应信息。nova-conductor把虚拟机信息通过消息的方式发送到消息队列中。nova-compute从对应的消息队列中获取虚拟机信息消息。nova-compute通过keystone的RESTfull API拿到认证的token, 并通过HTTP请求glance-api获取创建虚拟机所需要镜像。glance-api向keystone认证token是否有效 , 并返回验证结果。token验证通过 ,nova-compute获得虚拟机镜像信息(URL)。nova-compute通过keystone的RESTfull API拿到认证的token, 并通过HTTP请求neutron-server获取创建虚拟机所需要的网络信息。neutron-server向keystone认证token是否有效 , 并返回验证结果。token验证通过 ,nova-compute获得虚拟机网络信息。nova-compute通过keystone的RESTfull API拿到认证的token, 并通过HTTP请求cinder-api获取创建虚拟机所需要的持久化存储信息。cinder-api向keystone认证token是否有效 , 并返回验证结果。token验证通过 ,nova-compute获得虚拟机持久化存储信息。nova-compute根据instance的信息调用配置的虚拟化驱动来创建虚拟机。
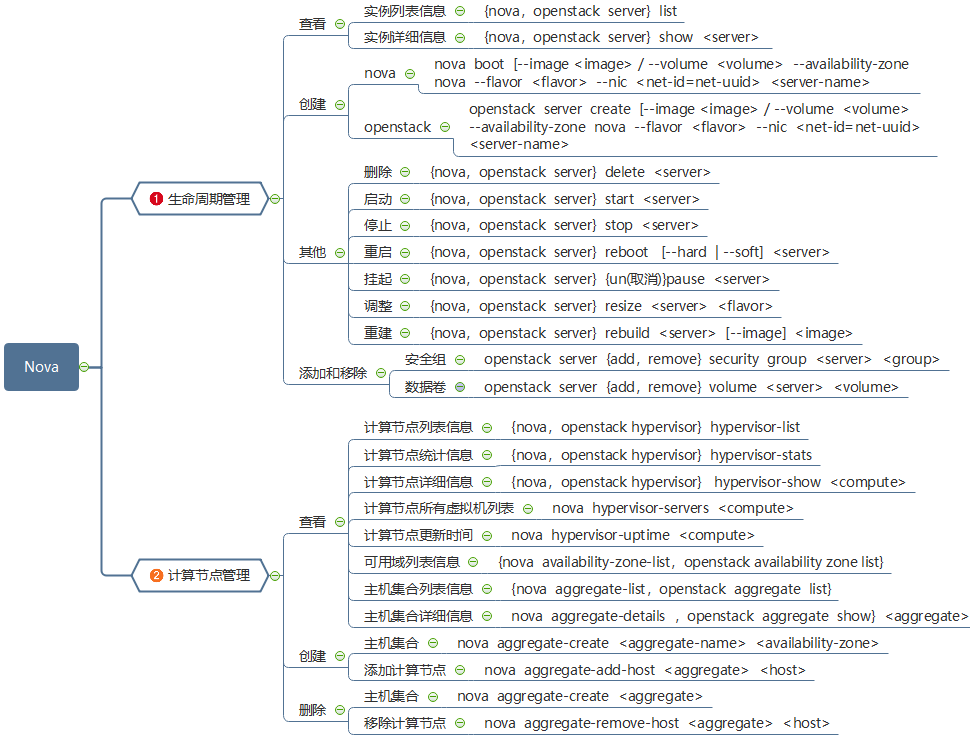
5.5 常用操作
生命周期和虚拟机管理
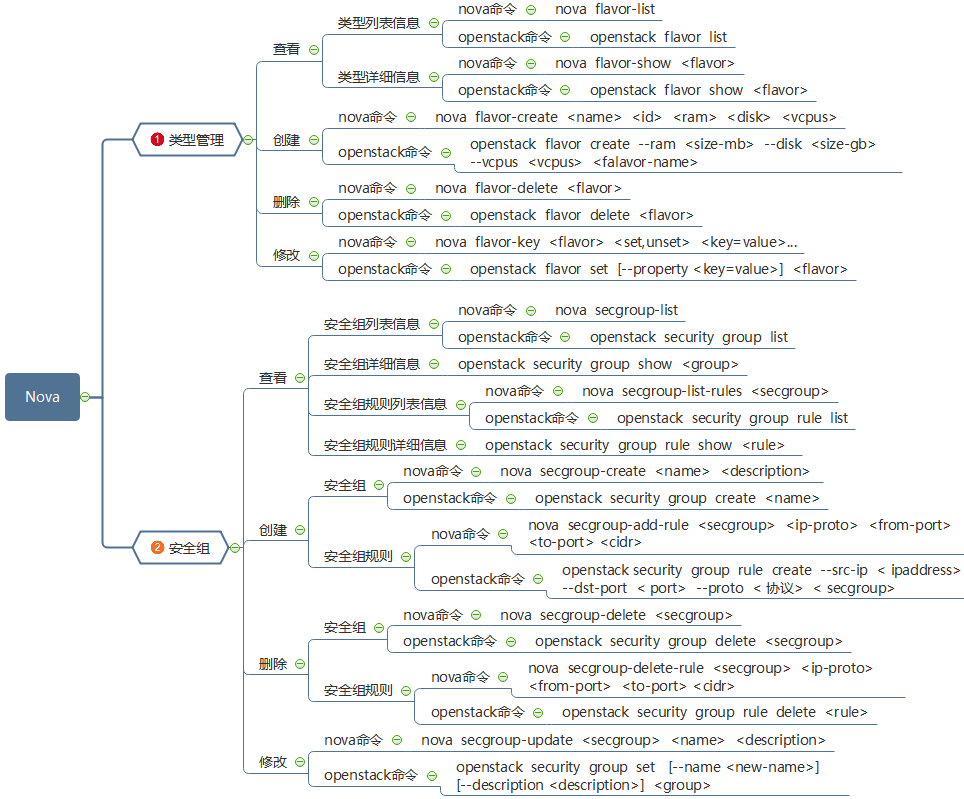
云主机规格和安全组管理
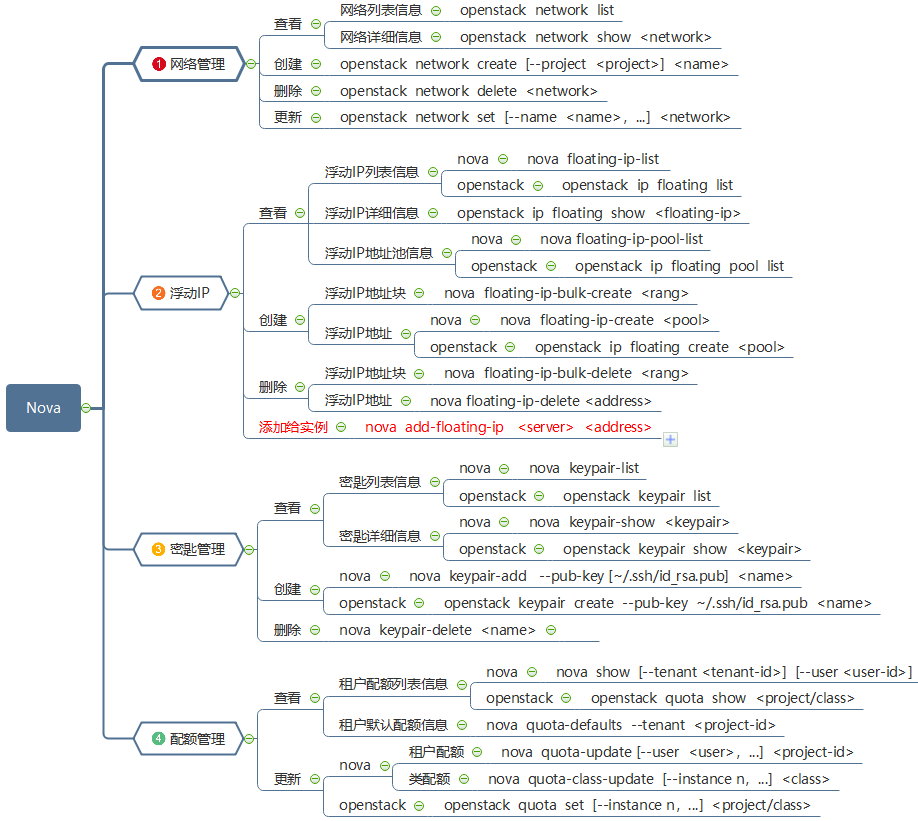
网络、浮动IP密钥和配额管理
6. 网络服务【Neutron】
6.1 概述
传统的网络管理方式很大程度上依赖于管理员手工配置和维护各种网络硬件设备 ; 而云环境下的网络已经变得非常复杂 , 特别是在多租户的场景里 , 用户随时都可能需要创建、修改和删除网络 , 此时网络的连通性和隔离就不能通过手工配置来保证了。
如何快速响应业务的需求 , 这无疑对网络管理提出了更高的要求。传统的网络管理方式已经很难胜任这项工作 , 而"软件定义网络 (
Software-defined networking,SDN) "所具有的灵活性和自动化优势使其成为云时代网络管理的主流。Neutron的设计目标是实现"网络即服务 (Networking as a Service) "。为了达到这一目标 , 在设计上遵从了基于SDN实现网络虚拟化的原则 , 充分利用了Linux系统上的各种网络虚拟化技术。最开始在
OpenStack负责网络的组件叫做Quantum, 后面从nova体系中分离出来 , 独立成Neutron项目。
6.2 基本概念
Network : 是一个隔离的二层广播域。Neutron 支持多种类型的 Network , 包括 Local, Flat, VLAN, VxLAN 和 GRE。
Local网络与其他网络和节点隔离。Local网络中的instance只能与位于同一节点上同一网络的Instance通信 , 主要用于单机测试。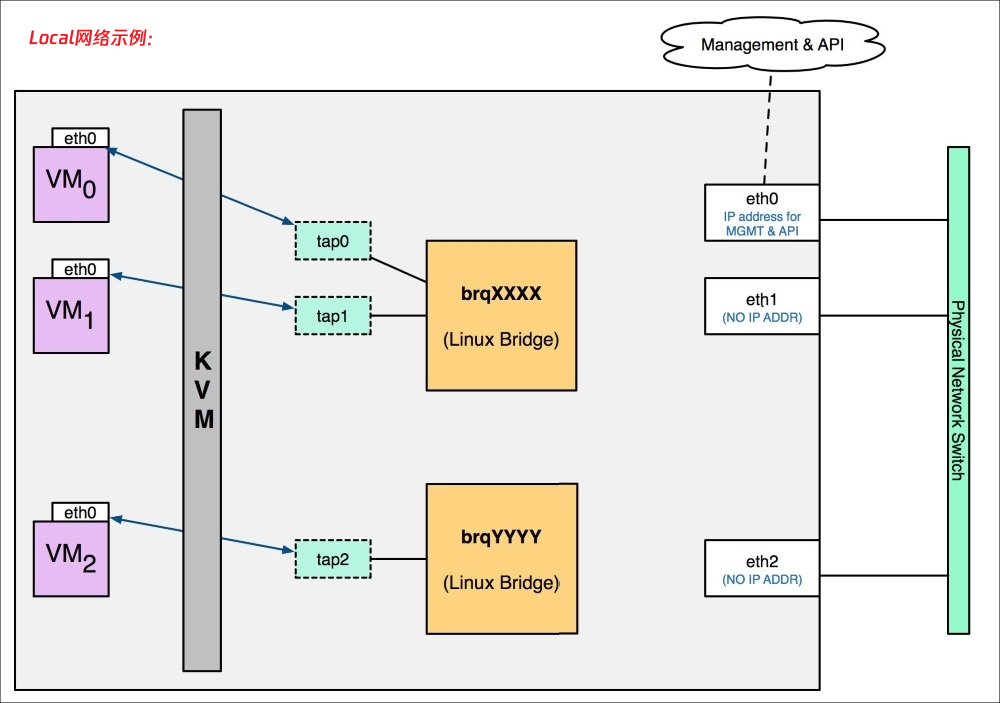
Flat网络是无VLAN Tag的网络 , 它要求宿主机的物理网卡直接与Linux Bridge连接。Flat网络中的instance能与位于同一网络的instance通信 , 并且可以跨多个节点。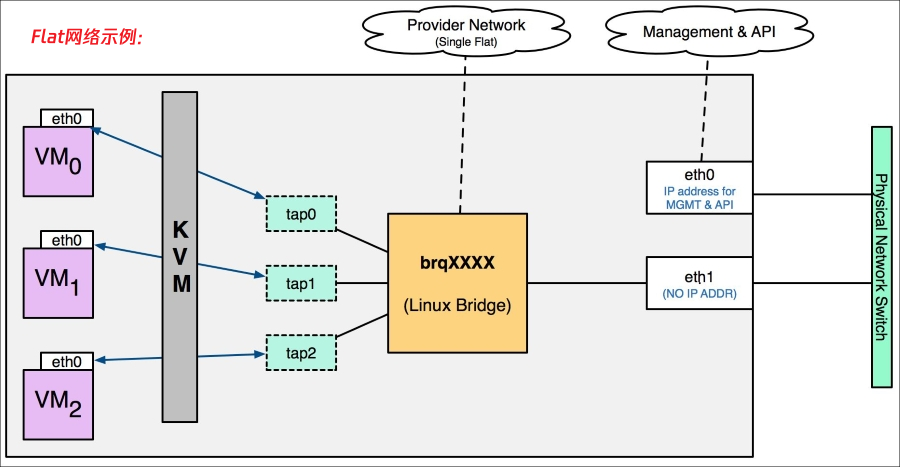
上面图中
eth1桥接到brqXXX, 为instance提供flat网络如果需要创建多个
flat network, 就得准备多个物理网卡 , 如下图所示 :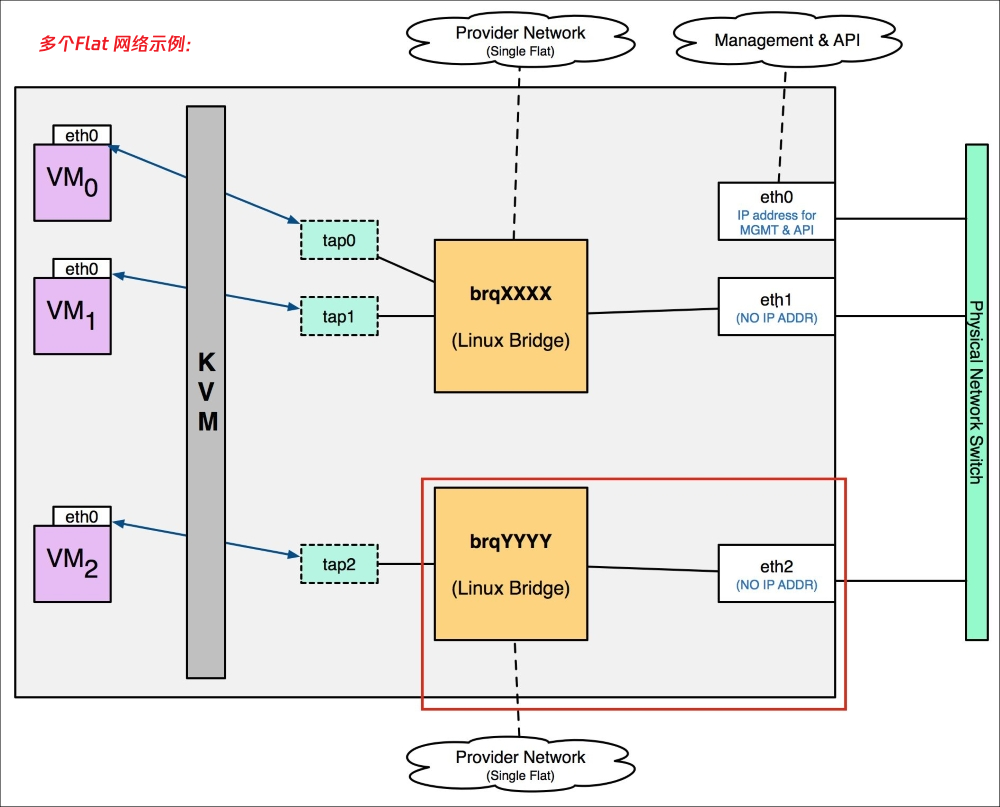
因为
flat网络与物理网卡一一对应 , 一般情况下租户网络不会采用flat, 接着需要指明flat网络与物理网卡的对应关系。在
[ml2_type_flat]中通过flat_networks定义了一个flat网络 ,label为"default"。在
[linux_bridge]中通过physical_interface_mappings指明default对应的物理网卡为eth1。
VLAN网络是具有802.1q tag的网络 , 是一个二层的广播域 , 同一VLAN中的instance可以通信 , 不同VLAN只能通过Router通信。VLAN网络可跨节点 , 是应用最广泛的网络类型。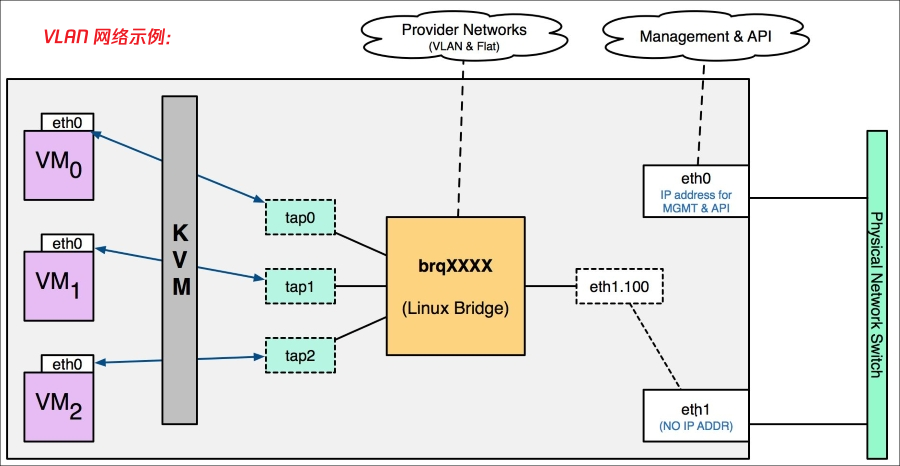
三个
Instance通过TAP设备连接到名为 "brqXXXX"Linux Bridge。在物理网卡
eth1上创建了eth1.100的VLAN Interface,eth1.100连接到brqXXXX。Instance通过eth1.100发送到eth1的数据包就会打上VLAN100的Tag。
如果再创建一个
VLAN Network 101,eth1上会相应的创建VLAN Interface eth1.101, 并且连接到新的Linux Bridge"brqYYYY"。每个VLAN Network有自己的Bridge, 从而也就实现了基于VLAN的隔离。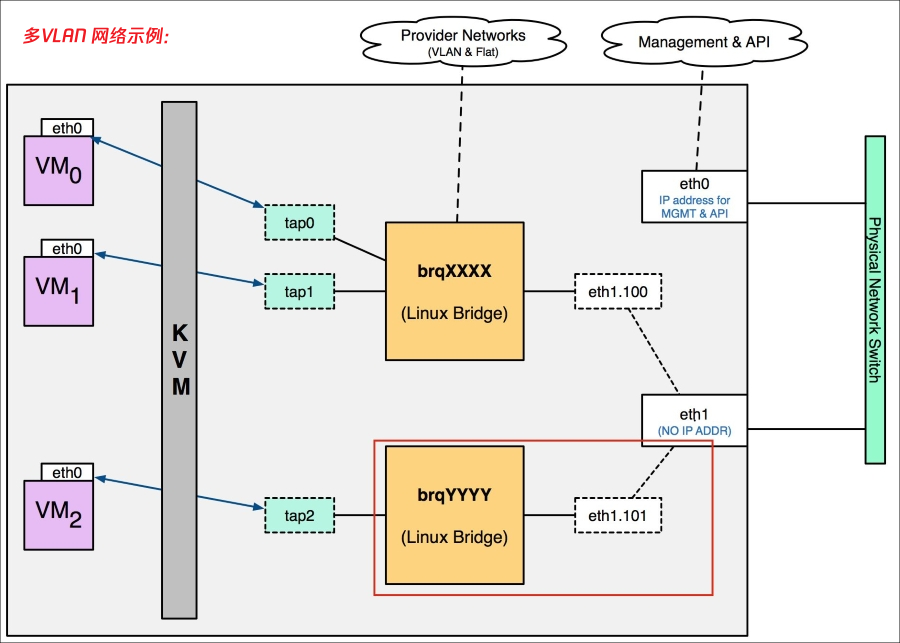
因为物理网卡
eth1上面可以走多个VLAN的数据 , 那么物理交换机上与eth1相连的Port要设置成trunk模式 , 而不是access模式。 那么 , 不同的VLAN设备怎么样才可以通信呢?那就需要Router来提供数据转发服务 , 如下图。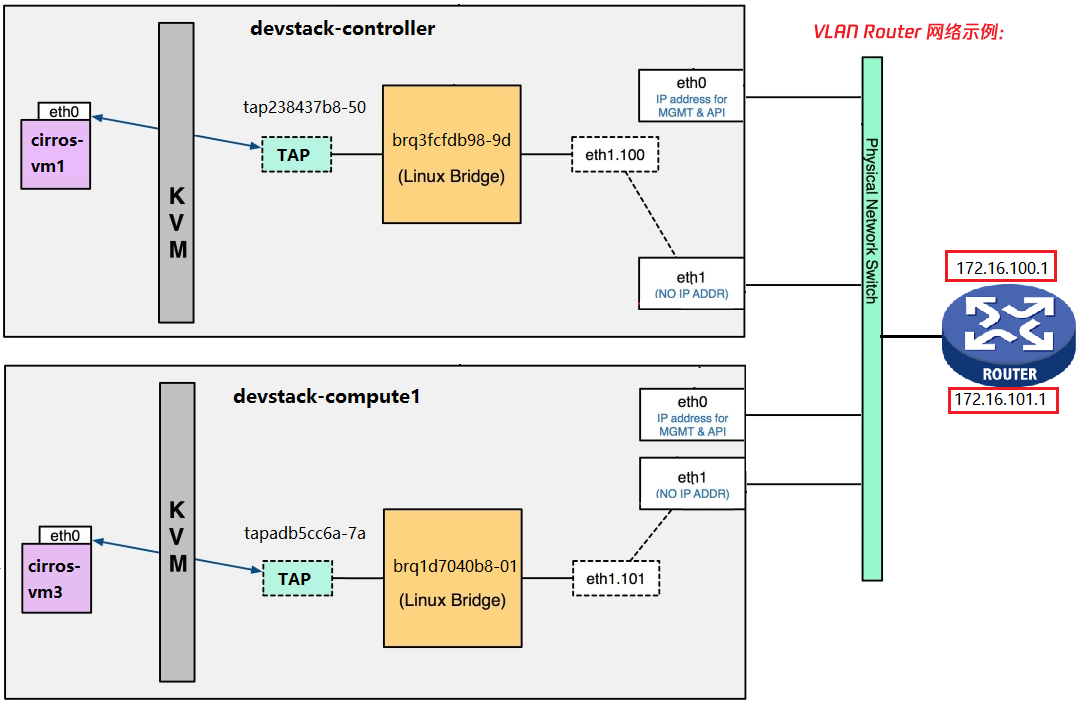
VxLAN是一种在现有物理网络设施中支持大规模多租户网络环境的解决方案 , 它的传输协议是IP + UDP。VXLAN定义了一个MAC-in-UDP的封装格式 , 在原始的Layer 2网络包前加上VXLAN header, 然后放到UDP和IP包中 , 通过MAC-in-UDP封装 ,VXLAN能够在Layer 3网络上建立起了一条Layer 2的隧道。因为二层的包通过封装在三层传输 , 能够克服VLAN和物理网络基础设施的限制。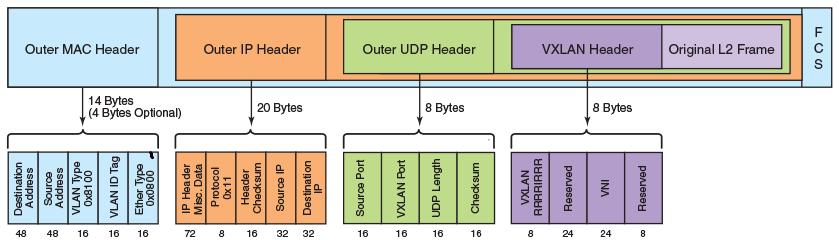
上图是
VxLAN的数据包格式 , 从图中我们可以得知 ,VXLAN引入了8Bytes的VXLAN Header, 其中VNI占24bit。VXLAN和原始的L2 Frame被封装到UDP包中 , 这24bit的VNI用于标识不同的二层网段 , 能够支持2^24=16777216个网段。GRE是与VxLAN类似的一种overlay网络。主要区别在于使用IP包而非UDP进行封装。
Subnet : 是一个 IPv4 或者 IPv6 地址段。实例 ( Instance ) 的 IP 从 Subnet 中分配。每个 Subnet 需要定义 IP 地址的范围和掩码。
Network与Subnet是1对多 关系。同一个Network的Subnet可以是不同的IP段 , 但CIDR不能重叠。有效配置示例 :
network A
subnet A-a: 10.10.1.0/24 {"start":"10.10.1.1","end":"10.10.1.50"}
subnet A-b: 10.10.2.0/24 {"start":"10.10.2.1","end":"10.10.2.50"}
无效配置示例 :
# 同一个Network中的Subnet的CIDR重叠了 , 因此是无效配置
network A
subnet A-a: 10.10.1.0/24 {"start":"10.10.1.1","end":"10.10.1.50"}
subnet A-b: 10.10.1.0/24 {"start":"10.10.1.51","end":"10.10.1.100"}
不同
Network的Subnet的CIDR和IP都是可以重叠的。因此Neutron的Router是通过Linux network namespace实现的。# 通过namespace隔离 , 因此CIDR和IP都是可以重叠的 network A subnet A-a: 10.10.1.0/24 {"start":"10.10.1.1","end":"10.10.1.50"} network B subnet B-a: 10.10.1.0/24 {"start":"10.10.1.1","end":"10.10.1.50"}Network Namespace: 是一种网络隔离机制 , 通过网络命名空间的每个Router都有自己独立的路由表如果两个
Subnet是通过同一个Router路由 , 根据Router的配置 , 只有指定的一个Subnet可被路由。如果两个
Subnet是通过不同Router路由 , 因为Router的路由表是独立的 , 所以两个Subnet都可以被路由。
Port : 是虚拟交换机上的一个端口。Port 上定义了 MAC地址 和 IP地址 , 当 instance 的虚拟网卡 VIF ( Virtual Interface ) 绑定到 Port 时 , Port 会将 MAC 和 IP 分配给 VIF。
6.3 功能
Neutron为整个OpenStack环境提供网络支持 , 包括二层交换 , 三层路由 , 负载均衡 , 防火墙和VPN等。Neutron提供了一个灵活的框架 , 通过配置 , 无论时开源还是商业软件都可以被用来实现这些功能。二层交换
SwitchNova的Instance是通过虚拟交换机连接到虚拟二层网络的。Neutron支持多种虚拟交换机 , 包括Linux原生的Linux Bridge和Open vSwitch。Open vSwitch(OVS) 是一个开源的虚拟交换机 , 它支持标准的管理接口和协议。利用
Linux Bridge和OVS,Neutron除了可以创建传统的VLAN网络 , 还可以创建基于隧道技术的Overlay网络 , 比如VxLAN和GRE(Linux Bridge目前只支持VxLAN) 。
三层路由
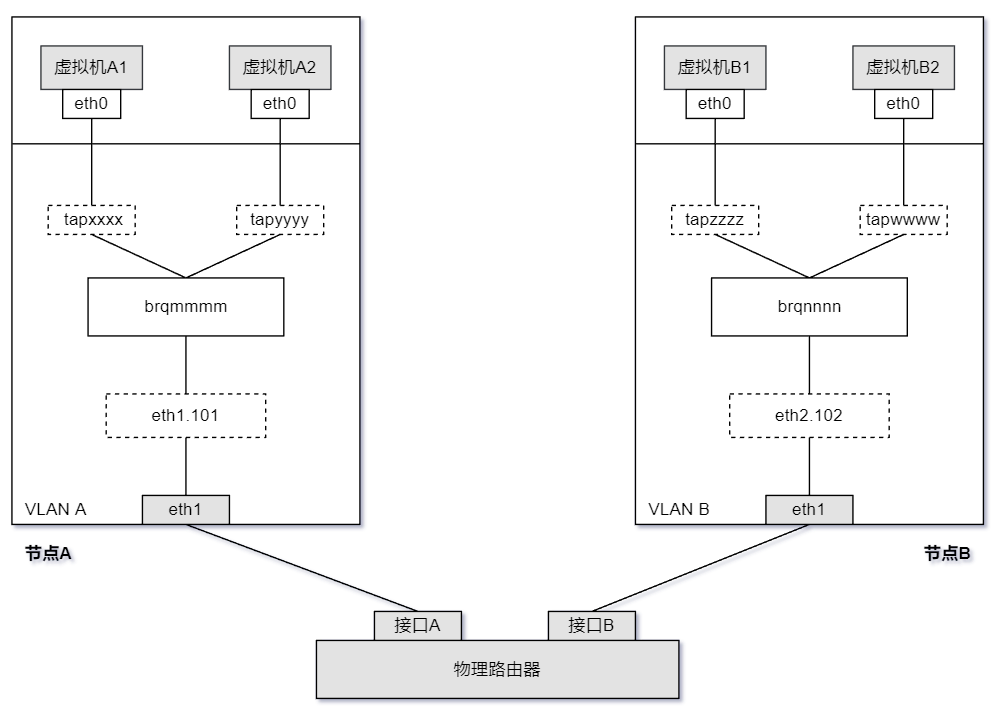
RouteInstance可以配置不同网段的IP ,Neutron的Router( 虚拟路由器 ) 实现Instance跨网段通信。Router通过IPforwarding,iptables等技术来实现路由和NAT。Neutron路由器是一个三层的 (L3) 抽象 , 其模拟物理路由器 , 为用户提供路由、NAT等服务 , 在OpenStack网络中 , 不用子网之间的通信需要路由器 , 网络与外部网络之间的通信更需要路由器。Neutron提供虚拟路由器 , 也支持物理路由器。例如 , 两个隔离的VLAN网络之间需要实现通信 , 可以通过物理路由器实现 , 由物理路由器提供相应的IP路由表 , 确保两个IP子网之间的通信 , 将两个VLAN网络中的虚拟机默认网关分别设置为路由器的接口A和B的IP地址。VLAN A中的虚拟机要与VLAN B中的虚拟机通信时 , 数据包将通过VLAN A中的物理网卡到达路由器 , 由物理路由器转发到VLAN B中的物理网卡 , 再到达目的虚拟机。
负载均衡
Load BalanceOpenstack在Grizzly版本第一次引入了Load-Balancing-as-a-Service(LBaaS) , 提供了将负载分发到多个instance的能力。LBaaS支持多种负载均衡产品和方案 , 不同的实现以Plugin的形式集成到Neutron, 目前默认的Plugin是HAProxy。
防火墙
FirewallNeutron通过Security Group和Firewall-as-a-Service两种方式来保障instance和网络的安全性。Security Group通过iptables限制进出的instance的网络包。Firewall-as-a-Service FWaas通过iptables限制进出虚拟路由器的网络包。
6.4 核心架构
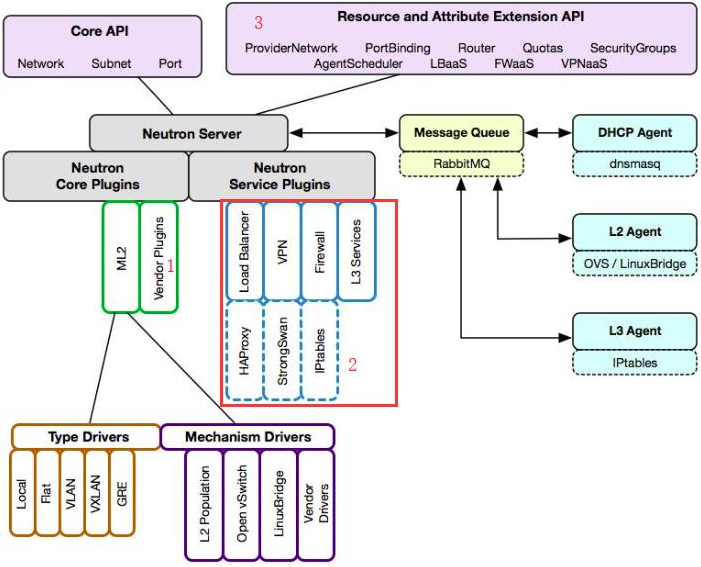
Neutron Server : 对外提供 OpenStack 网络 API , 接收请求 , 并调用 Plugin 处理请求。
Plugin : 处理 Neutron Server 发来的请求 , 维护 OpenStack 逻辑网络状态 , 并调用 Agent 处理请求。
Agent : 处理 Plugin 的请求 , 负责在 network provider 上真正实现各种网络功能。
Network Provider : 提供网络服务的虚拟或物理网络设备 , 例如 Linux Bridge , Open vSwitch 或者其他支持 Neutron 的物理交换机。
Queue : Neutron Server , Plugin 和 Agent 之间通过 Messaging Queue 通信和调用。
Database : 存放 OpenStack 的网络状态信息 , 包括 Network, Subnet, Port, Router 等。
6.5 组件详解
Neutron Server 详解 :
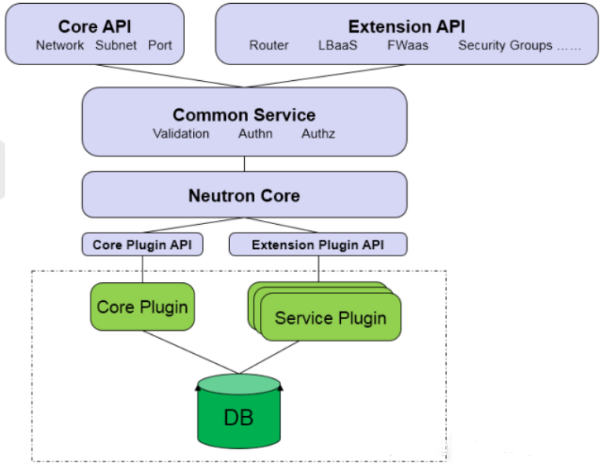
Core API: 对外提供管理Network,Subnet和Port的RESTful API。Extension API: 对外提供管理Router,Load Balance,Firewall等资源的RESTful API。Common Service: 认证和校验API请求。Neutron Core:Neutron Server的 核心处理程序 , 通过调用相应的Plugin处理请求。Core Plugin API: 定义了Core Plugin的抽象功能集合 ,Neutron Core通过该API调用相应的Core Plugin。Extension Plugin API: 定义了Service Plugin的抽象功能集合 ,Neutron Core通过该API调用相应的Service Plugin。Core Plugin: 实现了Core Plugin API, 在数据库中维护Network,Subnet和Port的状态 , 并负责调用相应的Agent在Network Provider上执行相关的操作。Service Plugin: 实现了Extension Plugin API, 在数据库中维护Router,Load Balance,Security Group等资源的状态 , 并调用相应的Agent在Network Provider上执行相关的操作 , 例如创建Router。ML2 Core Plugin 详解 :
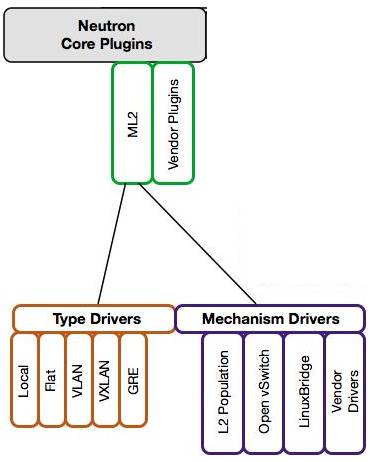
Neutron可以通过开发不同的plugin和agent支持不同的网络技术 , 但是随着支持的network provider数量的增加 , 开发人员发现两个突出的问题 :只能在
OpenStack中使用一种Core Plugin, 多种Network Provider无法共存。只使用一个Core Plugin本身没有问题。但问题在于传统的Core Plugin与Core Plugin agent是一一对应的。也就是说 , 如果选择了Linux Bridge Plugin, 那么Linux Bridge agent将是唯一选择 , 就必须在OpenStack的所有节点上使用Linux Bridge作为虚拟交换机 ( 即network provider) 。不同
Plugin之间存在大量重复代码 , 开发新的Plugin工作量大。所有传统的Core Plugin都需要编写大量重复和类似的数据库访问的代码 , 大大增加了Plugin开发和维护的工作量。
Moduler Layer 2(ML2): 是Neutron在Havana版本实现的一个新的Core Plugin, 用于替代原有的Linux Bridge Plugin和Open vSwitch Plugin。作为新一代的Core Plugin, 提供了一个框架 , 允许在OpenStack网络中同时使用多种Layer 2网络技术 , 不同的节点可以使用不同的网络实现机制。ML2对两层网络进行抽象和建模 , 引入了type driver和mechansim driver。type driver负责维护网络类型的状态 , 执行验证 , 创建网络等。Type Driver:Neutron支持的每一种网络类型都有一个对应的ML2 type driver。type driver负责维护网络类型的状态 , 执行验证 , 创建网络等。ML2支持的网络类型包括ML2支持的网络类型包括Local,Flat,VLAN,VxLAN和GRE。Mechanism Driver:Neutron支持的每一个网络机制都有一个对应的ML2 mechansim driver。mechanism driver负责获取由type driver维护的网络状态 , 并确保在相应的网络设备上 ( 物理或虚拟 ) 上正确实现这些状态。Agent-based类型 : 包括Linux Bridge,Open vSwitch等Controller-based类型 : 包括OpenDaylight,VMware NSX等基于物理交换机 : 包括
Cisco Nexus,Arista,Mellanox等
Service Plugin / Agent 详解
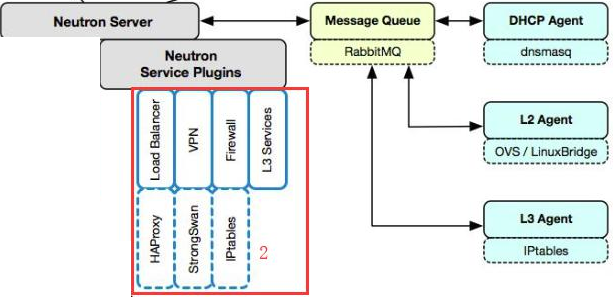
Core Plugin和Agent负责管理核心实体 :Net,Subnet和Port。而对于更高级的网络服务 , 则由Service Plugin/Agent管理。Service Plugin及其Agent提供更丰富的扩展功能 , 包括路由 ,Load Balance,Firewall等。DHCP:DHCP Agent通过dnsmasq为instance提供DHCP服务。Routing:L3 Agent可以为Project( 租户 ) 创建Router, 提供Neutron Subnet之间的路由服务 , 路由功能默认通过IPtables实现。Firewall:L3 Agent可以在Router上配置防火墙策略 , 提供网络安全防护。另一个与安全相关的功能是Security Group, 也是通过IPtables实现。Firewall与Security Group的区别在于 :Firewall: 安全策略位于Router, 保护的是某个Project的所有network。Security Group: 安全策略位于instance, 保护的是单个instance。
Load Balance:Neutron默认通过HAProxy为Project中的多个instance提供Load Balance服务。
6.6 部署方式
计算节点 和 控制节点
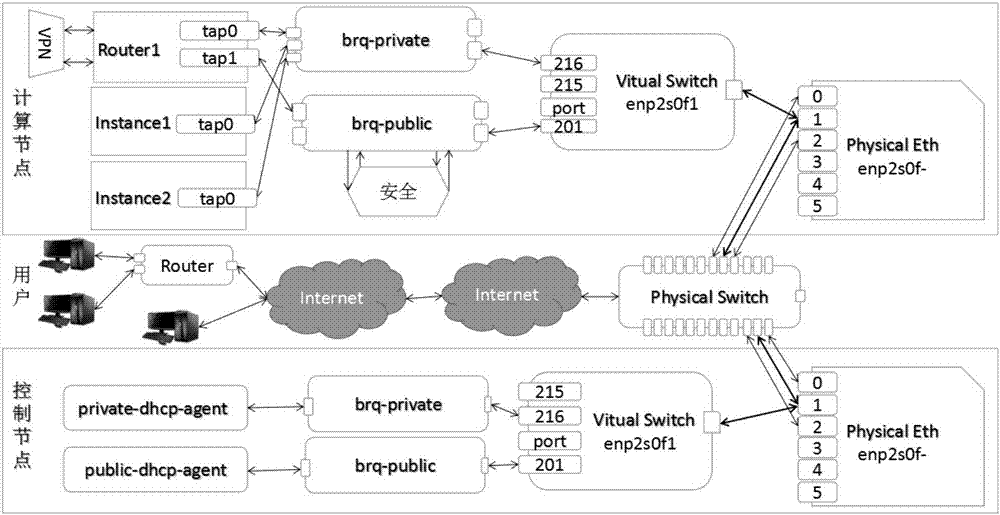
这里使用的是物理交换机 , 实现的网络互通。
多个节点 , 适合大规模的
OpenStack平台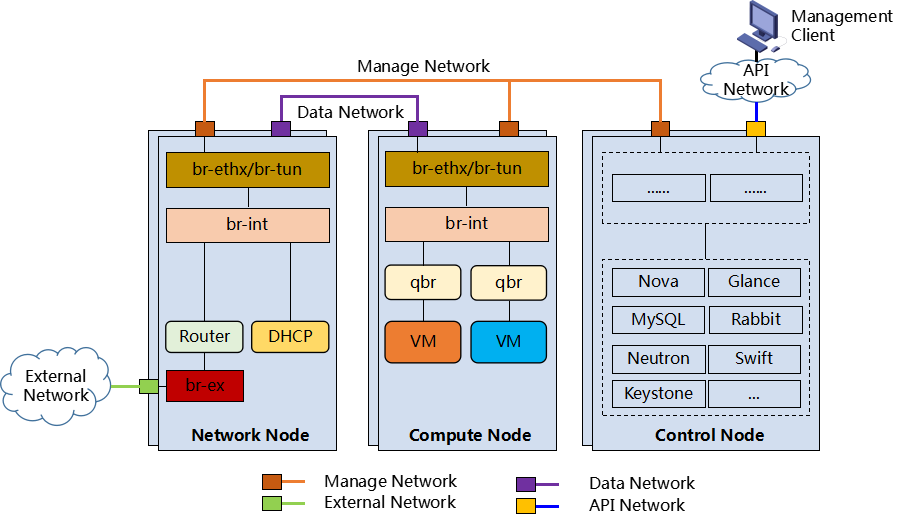
这里使用的是虚拟交换机 , 通过网络节点实现的网络互通。
6.7 常用操作
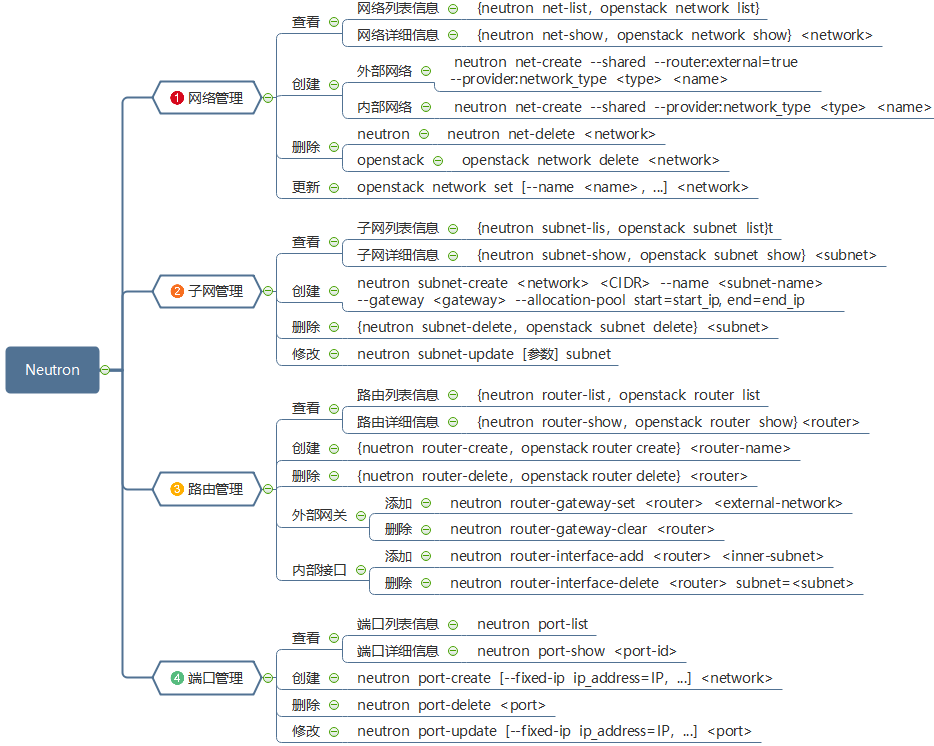
网络、子网、路由、端口管理
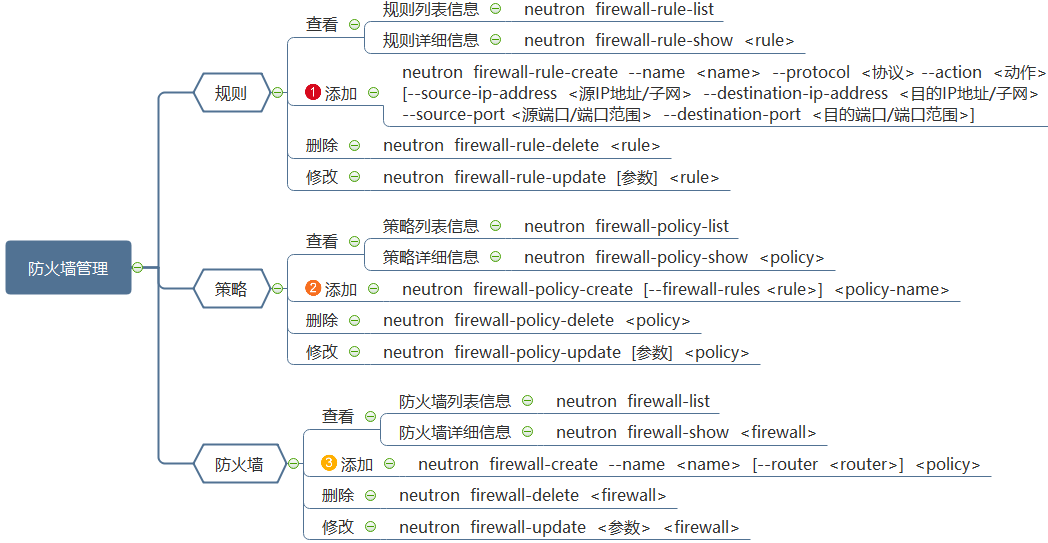
防火墙管理
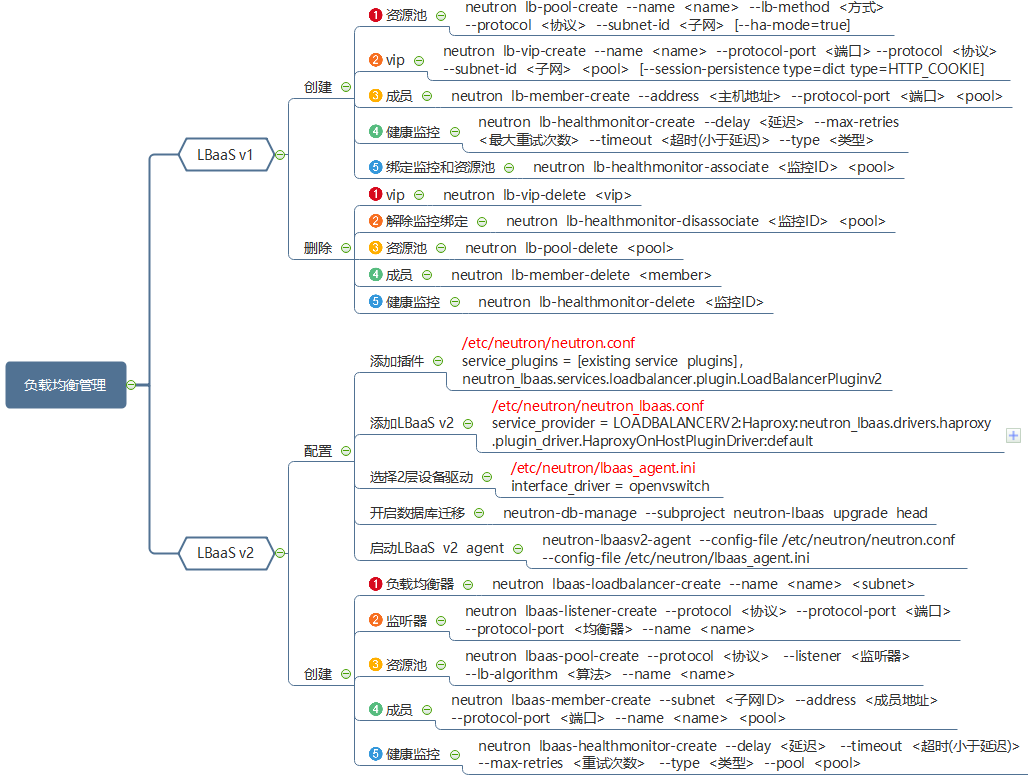
负载均衡管理
6.8 扩展 : Open vSwitch
6.8.1 简介
概念 : Open vSwitch , 简称OVS , 是一个虚拟交换软件 , 主要用于虚拟机VM环境 , 作为一个虚拟交换机 , 支持Xen/XenServer , KVM 和 VirtualBox 多种虚拟化技术。
作用 : 让大规模网络自动化可以通过编程扩展 , 支持跨越多个物理服务器的分布式环境 , 同时仍然支持标准的管理接口和协议 ( 例如 : NetFlow , sFlow , SPAN , RSPAN , CLI , LACP , 802.1ag )
工作原理 :
在虚拟化环境中 , 一个虚拟交换机主要有两个作用 : ①传递虚拟机之间的流量 , 以及 ②实现虚拟机和外界网络的通信。
内核模块实现了多个"数据路径" ( 类似于网桥 ) , 每个都可以有多个"
vports" ( 类似于桥内的端口 ) 。每个数据路径也通过关联流表 (Flow Table) 来设置操作 , 而这些流表中的流都是用户空间在报文头和元数据的基础上映射的关键信息 , 一般的操作都是将数据包转发到另一个vport。当一个数据包到达一个vport, 内核模块所做的处理是提取其流的关键信息并在流表中查找这些关键信息。当有一个匹配的流时它执行对应的操作。如果没有匹配 , 它会将数据包送到用户空间的处理队列中 ( 作为处理的一部分 , 用户空间可能会设置一个流用于以后碰到相同类型的数据包可以在内核中执行操作 )
6.8.2 组成
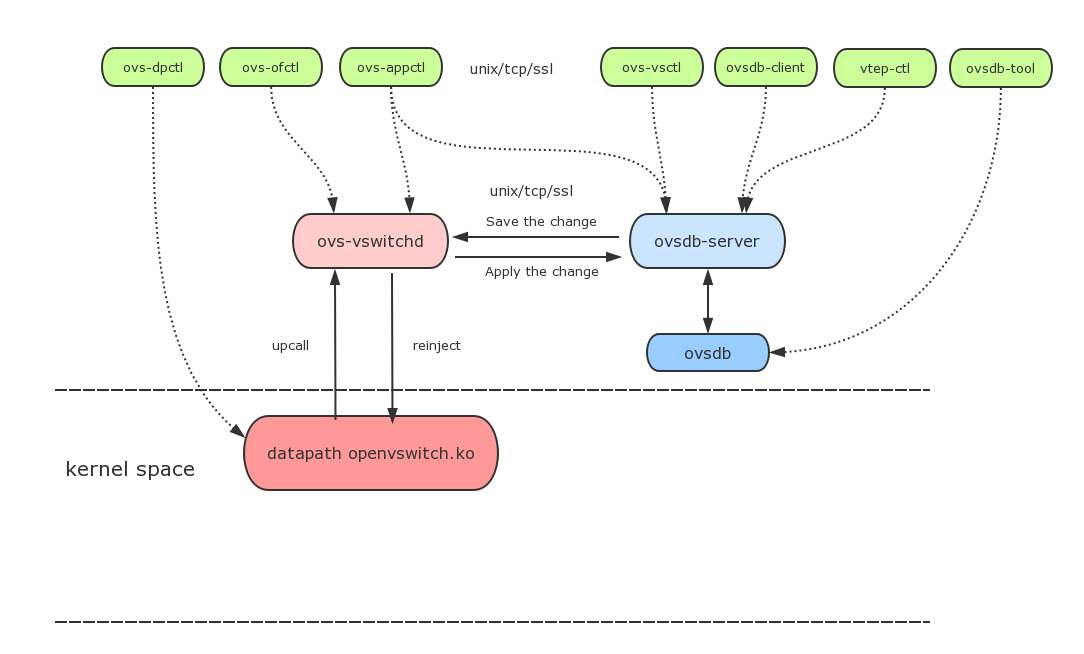
ovs-vswitchd : 守护程序 , 实现交换功能 , 和Linux内核兼容模块一起 , 实现基于流的交换flow-based switching。
ovsdb-server : 轻量级的数据库服务 , 主要保存了整个OVS的配置信息 , 包括接口 , 交换内容 , VLAN等等。ovs-vswitchd会根据数据库中的配置信息工作。
ovs-dpctl : 一个工具 , 用来配置交换机内核模块 , 可以控制转发规则。
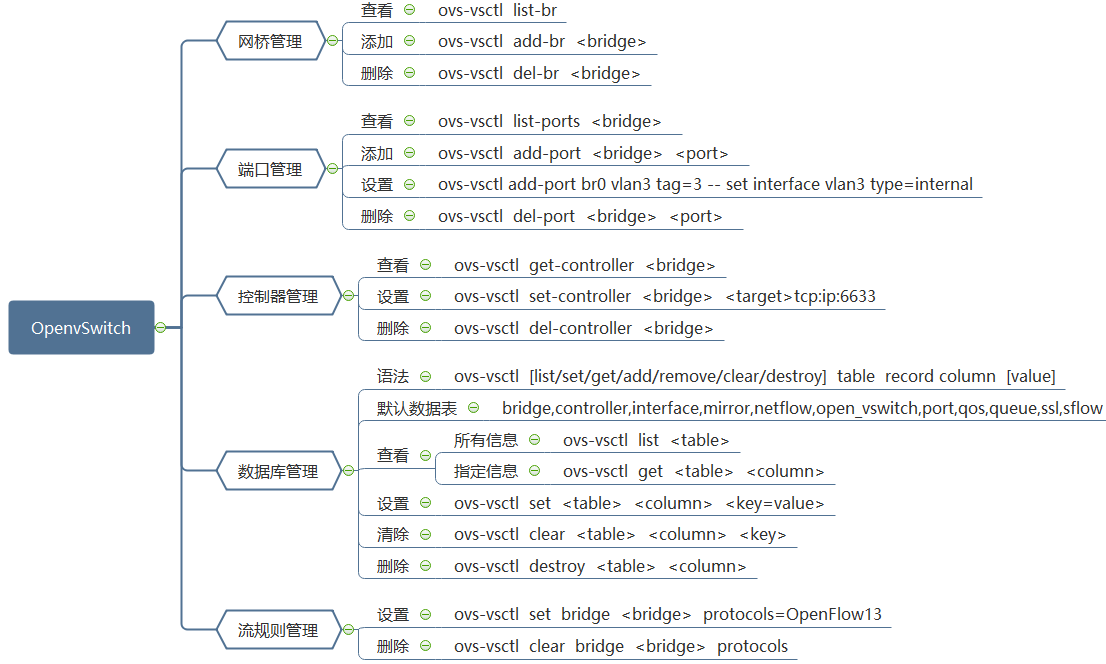
ovs-vsctl : 网桥、接口等的创建、删除、设置、查询等。
ovs-appctl : 主要是向OVS守护进程发送命令的 , 一般用不上。
ovsdbmonitor : GUI工具来显示ovsdb-server中数据信息。
ovs-controller : 一个简单的OpenFlow控制器
ovs-ofctl : 用来控制OVS作为OpenFlow交换机工作时候的流表内容。
6.8.3 工作流程
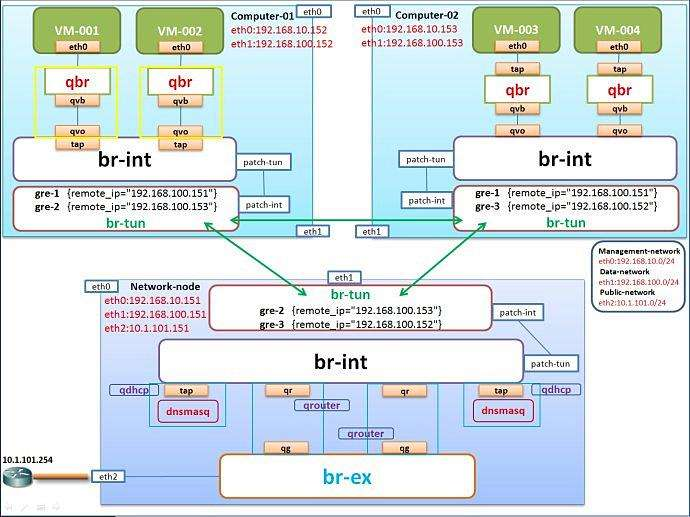
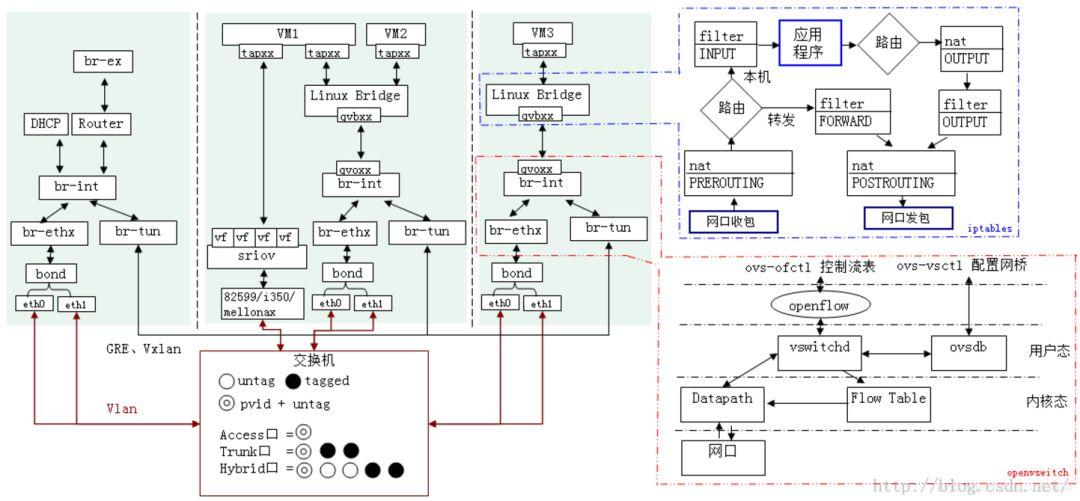
VM实例instance产生一个数据包并发送至实例内的虚拟网络接口VNIC, 图中就是instance中的eth0.这个数据包会传送到物理节点上的
VNIC接口 , 如图就是vnet接口vnet1。数据包从
vnet NIC出来 , 到达桥 ( 虚拟交换机 )br100上.数据包经过交换机的处理 , 从物理节点上的物理接口发出 , 如图中物理节点上的
eth0.数据包从
eth0出去的时候 , 是按照物理节点上的路由以及默认网关操作的 , 这个时候该数据包其实已经不受我们的linux-box的控制了,进入报文的传输环节。
6.8.4 Open vSwitch管理常用命令
7. 块存储服务【Cinder】
7.1 简介
块存储服务 , 为运行实例提供稳定的数据块存储服务
块存储服务 , 提供对
Volume从创建到删除整个生命周期的管理。
Block Storage :
操作系统获得存储空间的方式一般有两种 :
通过某种协议 (
SAS、SCSI、SAN、iSCSI等 ) 挂接裸硬盘 , 然后分区、格式化、创建文件系统 ; 或者使用裸硬盘存储数据 ( 数据库 ) 。通过
NFS、CIFS等协议 ,mount远程的文件系统。
第一种裸硬盘的方式叫做
Block Storage( 块存储 ) , 每个裸硬盘通常也称作Volume( 卷 ) , 第二种叫作文件系统存储。NAS和NFS服务器 , 以及各种分布式文件系统提供的都是这种类型的存储。
Block Storage Service :
块存储服务提供对
Volume从创建到删除整个生命周期的管理。从instance的角度看 , 挂载的每一个Volume都是一块硬盘。OpenStack提供Block Storage Service的是Cinder, 其具体功能是 :提供
REST API使用户能够查询和管理volume、volume snapshot以及volume type。提供
scheduler调度volume创建请求 , 合理优化存储资源的分配。通过
driver架构支持多种back-end( 后端 ) 存储方式 , 包括LVM、NFS、Ceph和其它诸如EMC、IBM等商业存储产品和方案。
7.2 架构
Cinder采用的是松散的架构理念 , 由 cinder-api 统一管理外部对 cinder 的调用 , cinder-scheduler 负责调度合适的节点去构建 volume 存储。volume-provider 通过对 driver 负责具体的存储空间 , 然后 cinder 内部依旧通过消息队列 queue 沟通 , 解耦各子服务支持异步调用。
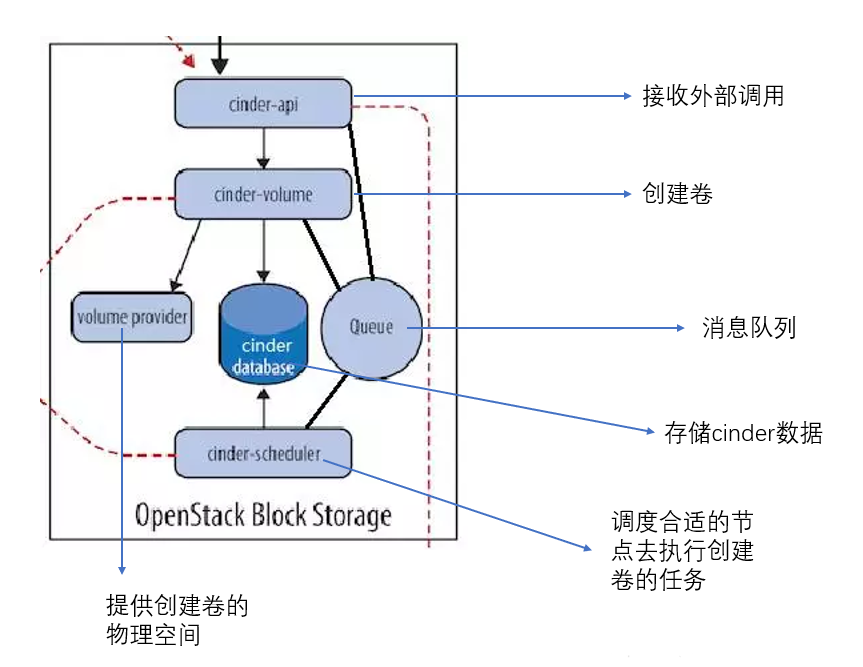
cinder-scheduler : 通过 filter 进行筛选 , 允许使用第三方的 filter , 自定义筛选内容。
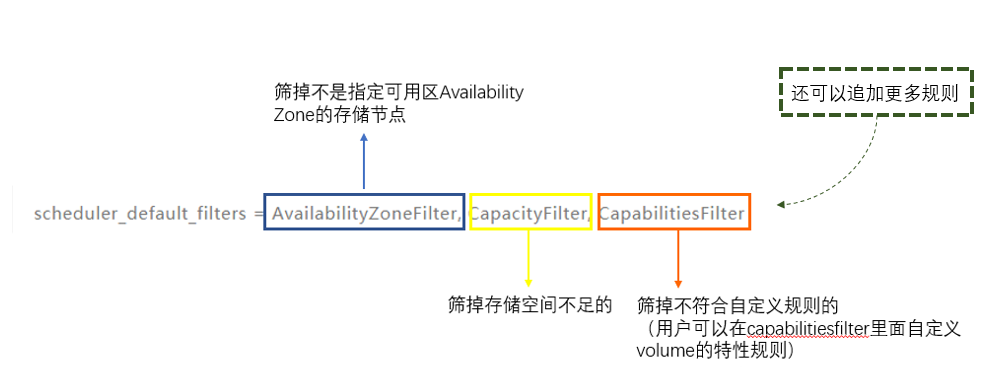
7.3 核心组件
cinder-api : 接收
API请求 , 调用cinder-volume执行操作。cinder-api对接收到的HTTP API请求会做如下处理 :检查客户端传入的参数是否合法有效
调用
cinder其它子服务的处理客户端请求将
cinder其它子服务返回的结果序列号并返回给客户端
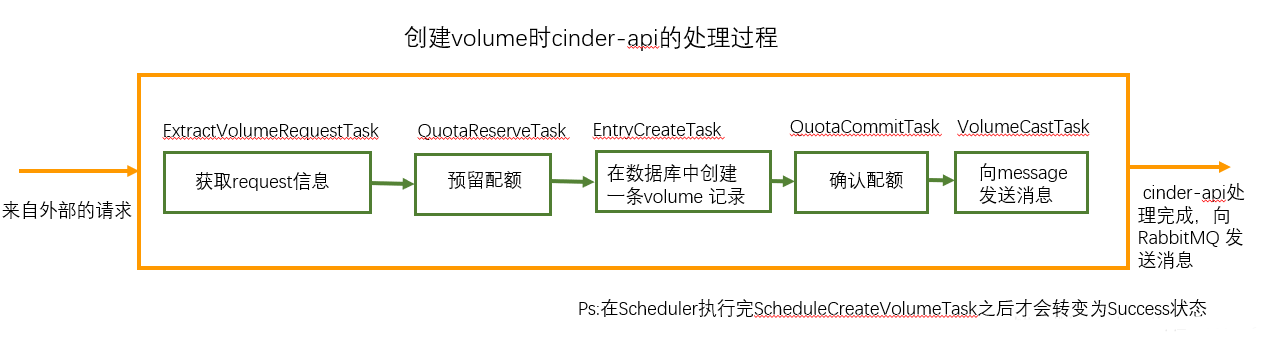
cinder-scheduler :
Cinder可以有多个存储节点 , 当需要创建volume时 ,cinder-scheduler会根据存储节点的属性和资源使用情况选择一个最合适的节点来创建volume。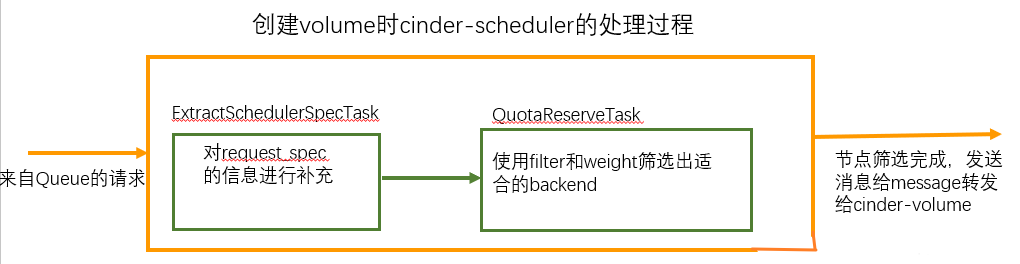
cinder-volume :
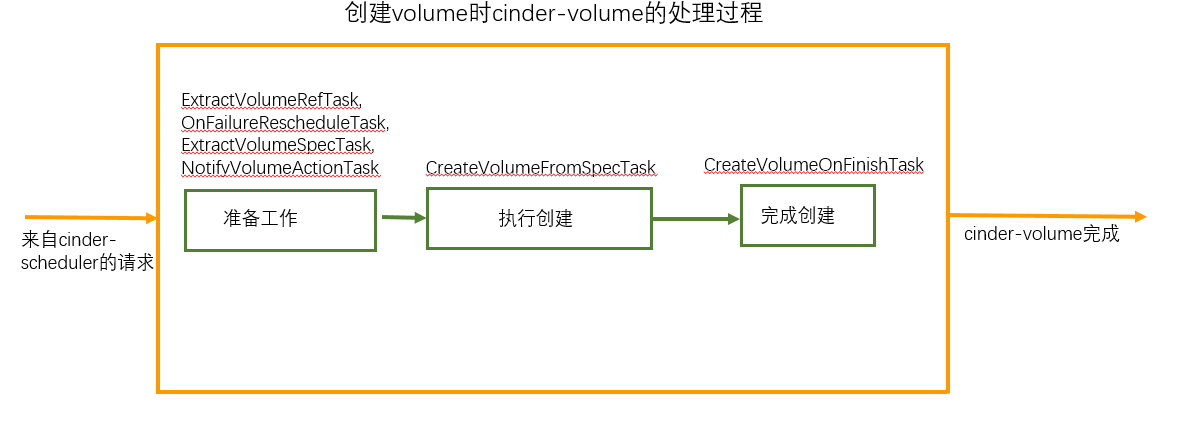
cinder-volume在存储节点上运行 ,OpenStack对Volume的操作 , 最后都是交给cinder-volume来完成的。 (cinder-volume自身并不管理真正的存储设备 , 存储设备是由volume provider管理的。cinder-volume与volume provider一起实现volume的生命周期管理 ) 。通过
Driver架构支持多种volume provider。定期向
OpenStack报告计算节点的状态。cinder-volume会定期向cinder报告存储节点的空闲容量来做筛选启动volume。实现
volume生命周期管理。cinder对volume的生命周期的管理最终都是通过cinder-volume完成的 , 包括volume的create、extend、attach、snapshot、delete等。
volume provider: 数据的存储设备 , 为volume提供物理存储空间。cinder-volume支持多种volume provider, 每种volume provider通过自己的driver与cinder-volume协调工作。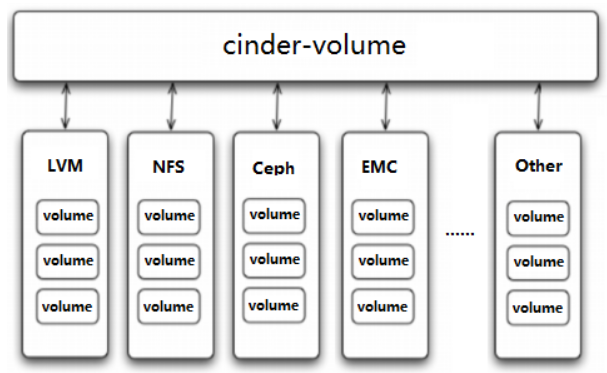
Message Queue:cinder各个子服务通过消息队列实现进程间通信和相互协作。因为有了消息队列 , 子服务之间实现了解耦 , 这种松散的结构也是分布式系统的重要特征。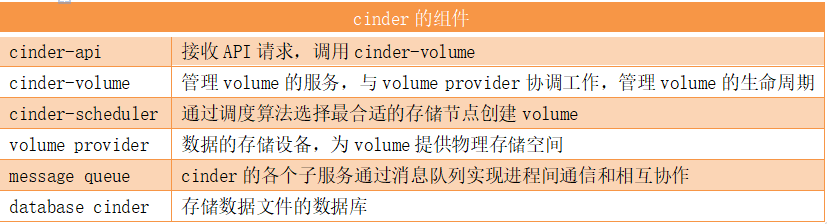
7.4 工作流程
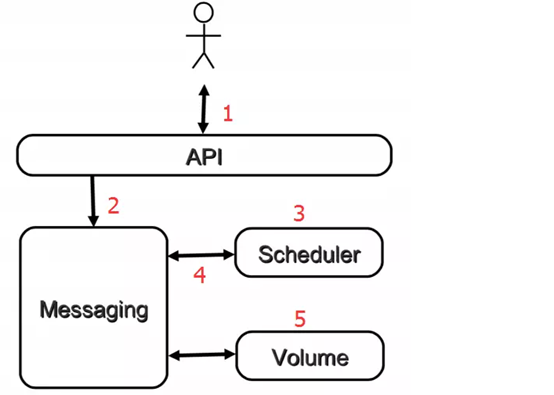
用户向
cinder-api发送创建volume的请求cinder-api对请求做一些必要处理后 , 通过Messaging将创建消息发送给cinder-schedulercinder-scheduler从Messaging获取到cinder-api发给它的消息 , 然后执行调度算法 , 从若干计存储点中选出节点Acinder-scheduler通过Messaging将创建消息发送给存储节点A存储节点
A的cinder-volume从Messaging中获取到cinder-scheduler发给它的消息 , 然后通过driver在volume provider上创建volume。
7.5 常用操作
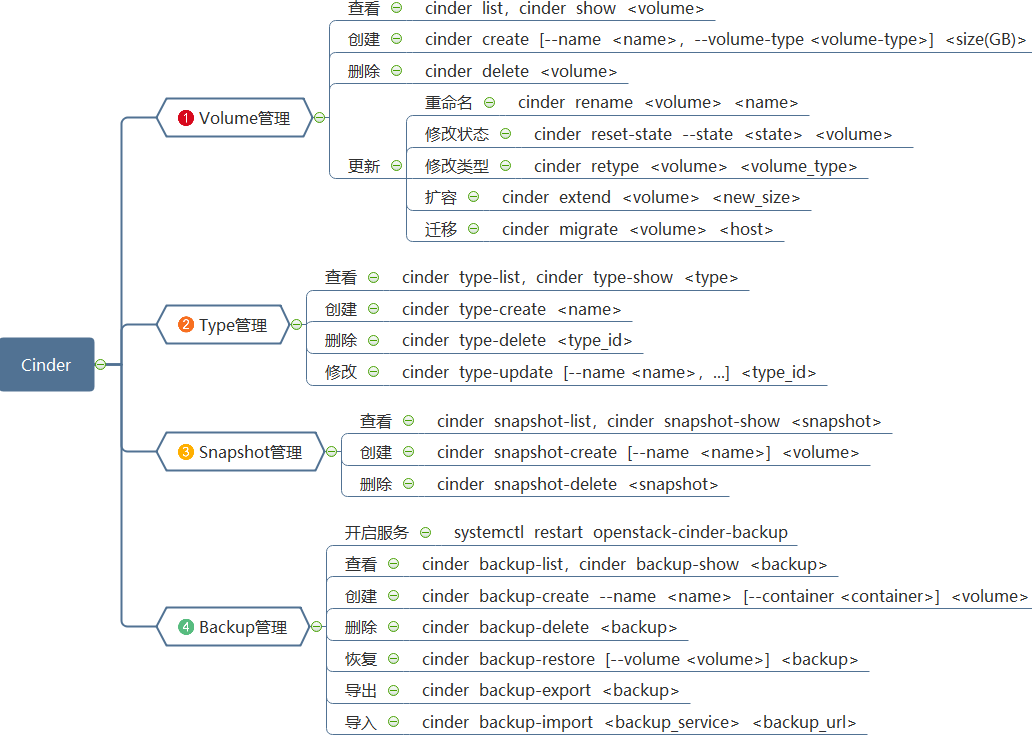
Volume、类型、快照、备份管理
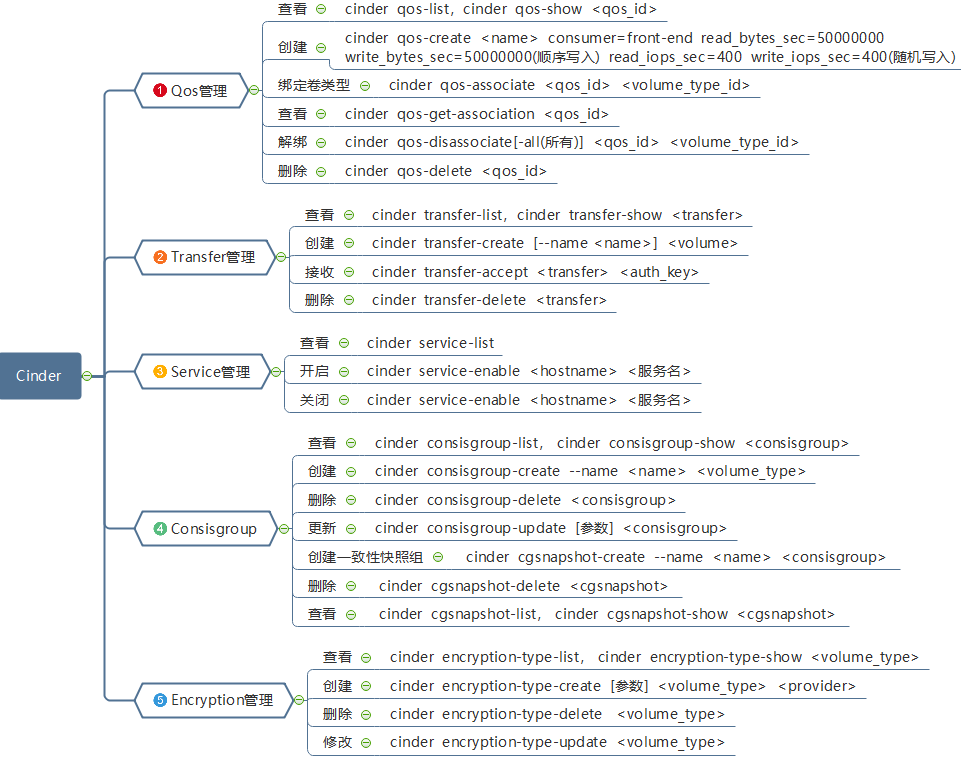
限速、转移、服务、一致性组、加密管理
8. 对象存储服务【Swift】
8.1 简介
背景
Swift最初是由RackSpace公司开发的高可用分布式对象存储服务 (Object Storage Service) , 并于2010年贡献给OpenStack开源社区作为其最初的核心子项目之一 , 为其Nova子项目提供虚拟机镜像存储服务。Swift构筑在比较便宜的标准硬件存储基础设施之上 , 无需采用RAID( 磁盘冗余阵列 ) , 通过在软件层面引入一致性散列技术和数据冗余性 , 牺牲一定程度的数据一致性来达到高可用和可伸缩性 , 支持多租户模式、容器和对象读写操作 , 适合解决互联网的应用场景下非结构化数据存储问题。Swift包括2个组成部分 , 一个是代理服务 (Proxy) , 一个是存储服务 (Storage) 。代理服务是
Swift内部存储的拓扑逻辑 , 即一个具体文件位于哪个存储节点的哪个区上。它同时是一个Web服务器 , 通过HTTP或HTTPS对外提供REST API服务。存储服务是负责文件存储的服务 , 由
3个组件组成 :account-server、container-server、object-server。其中object-server负责具体的文件存储 ,container-server包含到每个object的索引 ,account-server包含到每个container的索引。
原理
一致性散列 (
Consistent Hashing) :Swift是基于一致性散列技术 , 通过计算可将对象均匀分布到虚拟空间的虚拟节点上 , 在增加或删除节点时可大大减少需移动的数据量 ; 虚拟空间大小通常采用2^n次幂 , 便于进行高效的移位操作 ; 然后通过独特的数据结构Ring( 环 ) 再将虚拟节点映射到实际的物理存储设备上 , 完成寻址过程。平衡性 : 平衡性是指哈希的结果能够尽可能的分不到所有的缓冲中去 , 这样可以使得所有缓冲空间能够得到利用。为了更好的满足平衡性 , 引入了虚拟节点概念 , 虚拟节点是实际节点在
hash空间的复制品 , 一个实际节点对应若干个虚拟节点 , 这个对应的个数也称为复制个数 , 虚拟节点在hash空间以hash值排列。单调性 : 单调性是指如果已经有些内容通过
Hash分派到相应的缓冲中 , 又有新的缓冲加入到系统中 , 哈希的结果应能够保证原有已分配的内容可以被映射到原有或者新的缓冲中区 , 而不会被映射到旧的或者其他缓冲区。分散性 : 在分布式环境中 , 客户端可能看不到所有的缓冲 , 而只能看到其中一部分。当终端希望通过哈希过程将内容映射到缓冲上时 , 由于不同的客户端所看到的缓冲范围可能不同 , 从而导致得到的
Hash结果不一致 , 导致结果相同的内容被映射到不同的缓冲区中。这种情况应该被避免 , 因为这将会导致相同的内容将会被映射到不同缓冲区中 , 降低了系统的存储效率。负载均衡 : 负载时对分散性要求的另一个维度。既然相同的内容可能被映射到不同的缓冲区中 , 那么对于同一个缓冲而言 , 就有可能被不同的用户映射不同的内容。与分散性一样 , 这种情况应该被避免。
如图所示 , 以逆时针方向递增的散列空间有
4个字节长共32位 , 整数范围是[0 ~ 2^{32}-1] ; 将散列结果右移m位 , 可产生个虚拟节点 , 例如m=29时可产生8个虚拟节点。在实际部署的时候需要经过仔细计算得到合适的虚拟节点数 , 以达到存储空间和工作负载之间的平衡。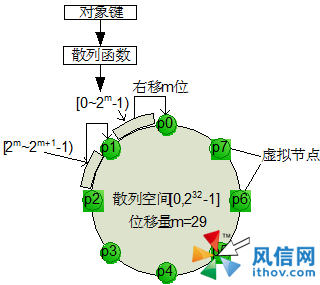
数据一致性模型 (
Consistency Model)按照
Eric Brewer的CAP(Consistency,Availability,Partition Tolerance) 理论 , 无法同时满足3个方面 ,Swift放弃严格一致性 ( 满足ACID事务级别 ) , 而采用最终一致性模型 (Eventual Consistency) , 来达到高可用性和无限水平扩展能力。为了实现这一目标 ,Swift采用Quorum仲裁协议 (Quorum有法定投票人数的含义 ) :定义 → N : 数据的副本总数 ;
W: 写操作被确认接受的副本数量 ;R: 读操作的副本数量强一致性 :
R+W > N, 以保证对副本的读写操作会产生交集 , 从而保证可以读取到最新版本 ; 如果W=N,R=1, 则需要全部更新 , 适合大量读少量写操作场景下的强一致性 ; 如果R=N,W=1, 则只更新一个副本 , 通过读取全部副本来获得最新的版本 , 适合大量写少量读场景下的强一致性。弱一致性 :
R+W <= N, 如果读写操作的副本集合不产生交集 , 就可能会读到脏数据 ; 适合对一致性要求比较低的场景。
Swift针对的是读写都比较频繁的场景 , 所以采用了比较折中的策略 , 即写操作需要满足至少一半以上成功W>N/2, 再保证读操作与写操作的副本集合至少产生一个交集 , 即R+W>N。Swift默认配置是N=3 , W=2>N/2,R=1或2, 即每个对象会存在3个副本 , 这些副本会尽量被存储在不同区域的节点上 ;W=2表示至少需要更新2个副本才算写成功 ; 当R=1时意味着某一个读操作成功便立刻返回 , 此种情况下可能会读取到旧版本 ( 弱一致性模型 ) ; 当R=2时 , 需要通过在读操作请求头中增加x-newest=true参数来同时读取2个副本的元数据信息 , 然后比较时间戳来确定哪个是最新版本 ( 强一致性模型 ) ; 如果数据出现了不一致 , 后台服务进程会在一定时间窗口内通过检测和复制协议来完成数据同步 , 从而保证达到最终一致性。如图 2 所示 :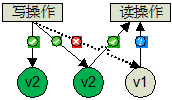
环的数据结构
环是为了将虚拟节点 ( 分区 ) 映射到一组物理存储设备上 , 并提供一定的冗余度而设计的 , 其数据结构由以下信息组成 :
存储设备列表、设备信息包括唯一标识号 (
id) 、区域号 (zone) 、权重 (weight) 、IP地址 (ip) 、端口 (port) 、设备名称 (device) 、元数据 (meta) 。分区到设备映射关系 (
replica2part2dev_id, 数组 ) 。计算分区号的偏移 (
part_shift, 即上面图中的m) 。
使用对象的层次结构
account/container/object作为键 , 使用MD5散列算法得到一个散列值 , 对该散列值的前4个字节进行右移操作得到分区索引号 , 移动位数由上面的part_shift设置指定 ; 按照分区索引号再分区到设备映射表 (replica2part2dev_id) 里查找该对象所在分区的对应的所有设备编号 , 这些设备会被尽量选择部署在不同区域 (Zone) 内 , 区域只是个抽象概念 , 它可以是某台机器 , 某个机架 , 甚至某个建筑内的机群 , 以提供最高级别的冗余性 , 建议至少部署5个区域 ; 权重参数是个相对值 , 可以根据磁盘的大小来调节 , 权重越大表示可分配的空间越多 , 可部署更多的分区。
数据模型
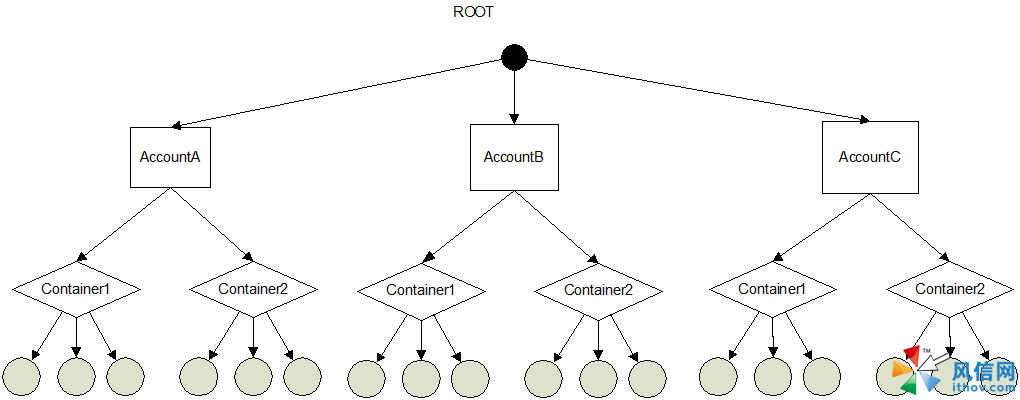
Swift采用层次数据模型 , 共设三层逻辑结构 :Account/Container/Object( 即账户/容器/对象 ) , 每层节点数均没有限制 , 可以任意扩展。账户和个人账户不是一个概念 , 可以理解为租户 , 用来做顶层的隔离机制 , 可以被多个个人账户所共同使用。
容器代表封装一组对象 , 类似文件夹或目录 ; 叶子节点代表对象 , 由元数据和内容两部分组成 , 如图所示 :
8.2 特性
大量对象的存储 (
Storage of large number of objects) 。大对象的存储 (
Storage of large sized objects) 。数据冗余 (
Data Redundancy) 。档案能力——存储大数据集 (
Archival capabilities - Work with large datasets) 。虚拟机和云应用的数据容器 (
Data container for virtual machines and cloud apps) 。流媒体的能力 (
Media Streaming capabilities) 。对象存储安全 (
Secure storage of objects) 。备份和档案 (
Backup and archival) 。极高的扩展性 (
Extreme scalability)
8.3 架构
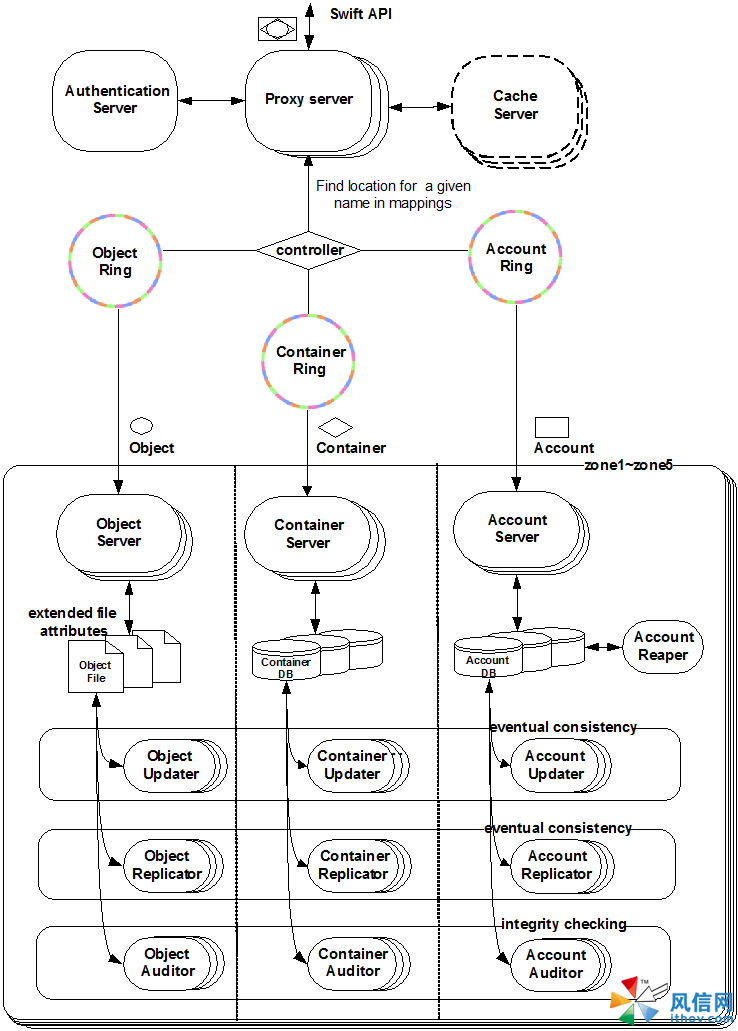
8.4 核心组件
代理服务 ( Proxy Server ) : 对外提供对象服务 API , 会根据环的信息来查找服务地址并转发用户请求至相应的账户、容器或者对象服务 ; 由于采用无状态的 REST 请求协议 , 可以进行横向扩展来均衡负载。
认证服务 ( Authentication Server ) : 验证访问用户的身份信息 , 并获得一个对象访问令牌 ( Token ) , 在一定的时间内会一直有效 ; 验证访问令牌的有效性并缓存下来直至过期时间。
缓存服务 ( Cache Server ) : 缓存的内容包括对象服务令牌 , 账户和容器的存在信息 , 但不会缓存对象本身的数据 ; 缓存服务可采用 Memcached 集群 , Swift 会使用一致性散列算法来分配缓存地址。
账户服务 ( Account Server ) : 提供账户元数据和统计信息 , 并维护所含容器列表的服务 , 每个账户的信息被存储在一个 SQLite 数据库中。
容器服务 ( Container Server ) : 提供容器元数据和统计信息 , 并维护所含对象列表的服务 , 每个容器的信息也存储在一个 SQLite 数据库中。
对象服务 ( Object Server ) : 提供对象元数据和内容服务 , 每个对象的内容会以文件的形式存储在文件系统中 , 元数据会作为文件属性来存储 , 建议采用支持扩展属性的 XFS 文件系统。
复制服务 ( Replicator ) : 会检测本地分区副本和远程副本是否一致 , 具体是通过对比散列文件和高级水印来完成 , 发现不一致时会采用推式 ( Push ) 更新远程副本 , 例如对象复制服务会使用远程文件拷贝工具 rsync 来同步 ; 另外一个任务是确保被标记删除的对象从文件系统中移除。
更新服务 ( Updater ) : 当对象由于高负载的原因而无法立即更新时 , 任务将会被序列化到在本地文件系统中进行排队 , 以便服务恢复后进行异步更新 ; 例如成功创建对象后容器服务器没有及时更新对象列表 , 这个时候容器的更新操作就会进入排队中 , 更新服务会在系统恢复正常后扫描队列并进行相应的更新处理。
审计服务 ( Auditor ) : 检查对象 , 容器和账户的完整性 , 如果发现比特级的错误 , 文件将被隔离 , 并复制其他的副本以覆盖本地损坏的副本 ; 其他类型的错误会被记录到日志中。
账户清理服务 ( Account Reaper ) : 移除被标记为删除的账户 , 删除其所包含的所有容器和对象。
8.5 Swift对CAP的支持程度
CAP概述 : 美国著名科学家 , Berkerly大学Brewer教授提出的一个分布式系统不能同时满足一致性 , 可用性和分区容错性这三个需求 , 最多只能同时满足两个。重要属性 :
一致性(
Consistency) : 任何一个读操作总是能读取到之前完成的写操作结果 , 也就是在分布式环境中 , 多点的数据是一致的。可用性(
Availability) : 每一个操作总是能够在确定的时间内返回 , 也就是系统随时都是可用的。分区可容忍性(
Tolerance of network Partition) : 在出现网络分区 ( 比如断网 ) 的情况下 , 分离的系统也能正常运行。
Swift对CAP的支持 :
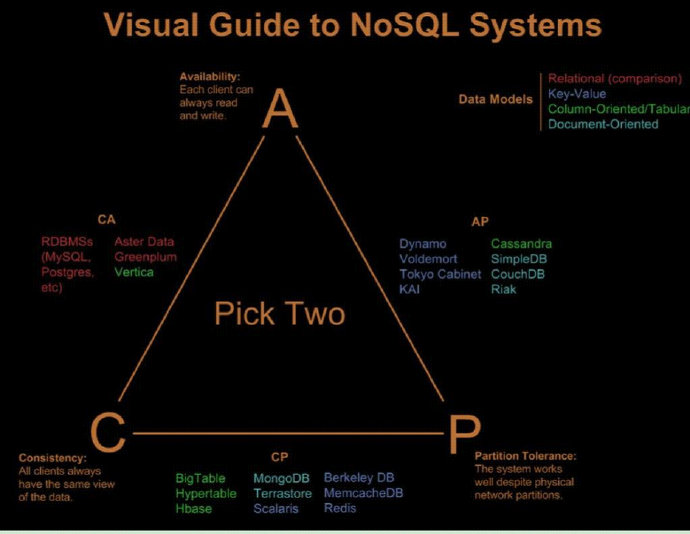
Consistency : Swift的一致性归为弱一致性模型。Swift 由 updater 保证最终一致性 , auditor 保证存储对象的完整性。Swift 只能保证数据的最终一致性 , 即 , 如果upload(update也是一种upload)一个object , 从其他客户端GET这个object , 不一定是最新的。
Availability : 基于python对hash的 原生支持 , swift中广泛使用了hash算法。比如均衡ring中partition的分布 , object update备份策略。sqlite控制account/container/object的相关信息 , 简化了维护成本。
8.6 常用操作
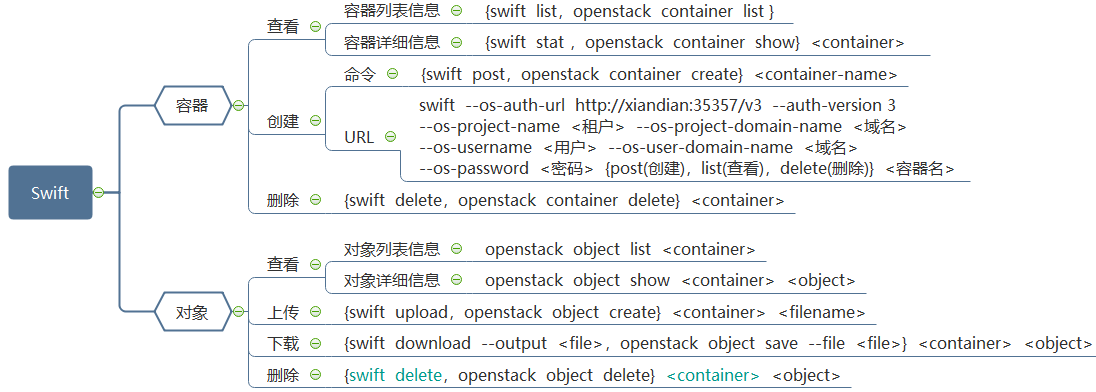
9. 编排服务【Heat】
9.1 简介
什么是Heat?
Heat是一套业务流程平台 , 旨在帮助用户更轻松地配置以OpenStack为基础的云体系。利用Heat应用程序 , 开发人员能够在程序中使用模板以实现资源的自动化部署。Heat能够启动应用、创建虚拟机并自动处理整个流程。它还拥有出色的跨平台兼容性 , 能够与Amazon Web Services业务流程平台CloudFormation相对接——这意味着用户完全可以将AWS模板引入OpenStack环境当中。Heat是OpenStack提供的自动编排功能的组件 , 基于描述性的模板 , 来编排复合云应用程序。
为什么需要Heat?
更快更有效的管理
OpenStack的资源 : 云平台系统在相对比较稳定的情况下 , 管理成本逐渐变成首要的解决问题。云上自动化能力是一个云平台的刚需 , 可以有效降低维护难度。Heat采用了模板方式来设计或者定义编排 , 为方便用户使用 ,Heat还提供了大量的模板例子 , 使用户能够方便地得到想要的编排。更小的研发成本 : 引入
Heat, 对于不了解OpenStack的研发者来说 , 可以更快的接入现有的业务系统。开发者更关心的是授权认证和对虚拟资源的增删改 , 而对于底层的状态并不用太多了解。
相关概念
堆栈 (
stack) : 管理资源的集合。单个模板中定义的实例化资源的集合 , 是Heat管理应用程序的逻辑单元 , 往往对应一个应用程序。模板 (
template) : 如何使用代码定义和描述堆栈。描述了所有组件资源以及组件资源之间的关系 , 是Heat的核心。资源 (
resource) : 将在编排期间创建或修改的对象。资源可以是网络、路由器、子网、实例、卷、浮动IP、安全组等。参数 (
parameters) :heat模板中的顶级key, 定义在创建或更新 stack 时可以传递哪些数据来定制模板。参数组 (
parameter_groups) : 用于指定如何对输入参数进行分组 , 以及提供参数的顺序。输出 (
outputs) : heat模板中的顶级key, 定义实例化后stack将返回的数据。
9.2 核心架构
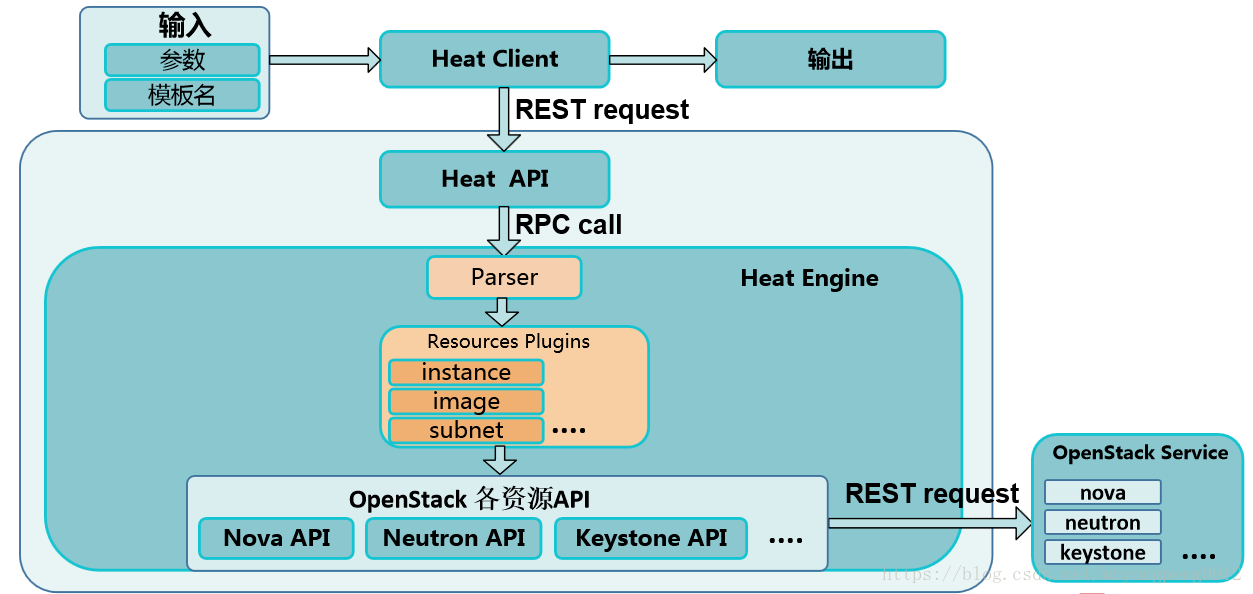
heat command-line client : CLI通过与 heat-api 通信 , 来调用 API 实现相关功能。终端开发者可以直接使用编排 REST API。
heat-api : 实现 OpenStack 原生支持的 REST API。该组件通过把 API 请求经由 AMQP 传送给 Heat engine 来处理 API 请求。
heat-api-cfn : 提供与 AWS CloudFormation 兼容的、AWS 风格的查询 API , 处理请求并通过 AMQP 将它们发送到 heat-engine。
heat-engine : 执行模板内容 , 最终完成应用系统的创建和部署 , 并把执行结果返回给 API 调用者。
heat-cfntools : 完成虚拟机实例内部的操作配置任务 , 需要单独下载。
9.3 工作流程
用户在
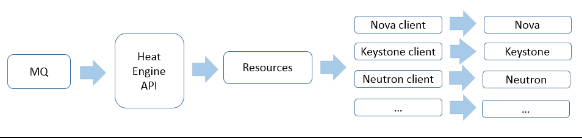
Horizon中或者命令行中提交包含模板和参数输入的请求Horizon或者命令行工具会将接收到的请求转化为REST格式的API调用Heat-api或者是Heat-api-cfn。Heat-api和Heat-api-cfn会验证模板的正确性 , 然后通过AMQP异步传递给Heat Engine来处理请求。Heat Engine接收到请求后 , 会把请求解析为各种类型的资源 , 每种资源都对应OpenStack其它的服务客户端 , 然后通过发送REST的请求给其它服务。Heat Engine在这里的作用分为三层 : 第一层处理Heat层面的请求 , 就是根据模板和输入参数来创建Stack, 这里的Stack是由各种资源组合而成。 第二层解析Stack里各种资源的依赖关系 ,Stack和嵌套Stack的关系。第三层就是根据解析出来的关系 , 依次调用各种服务客户段来创建各种资源。
9.4 常用操作
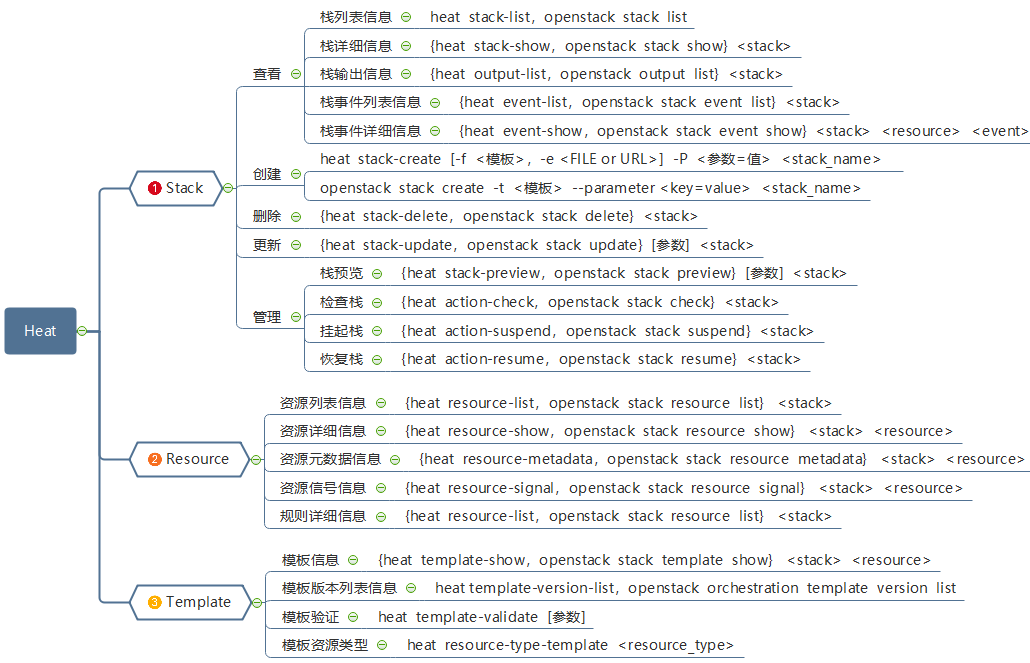
栈、资源、模板管理
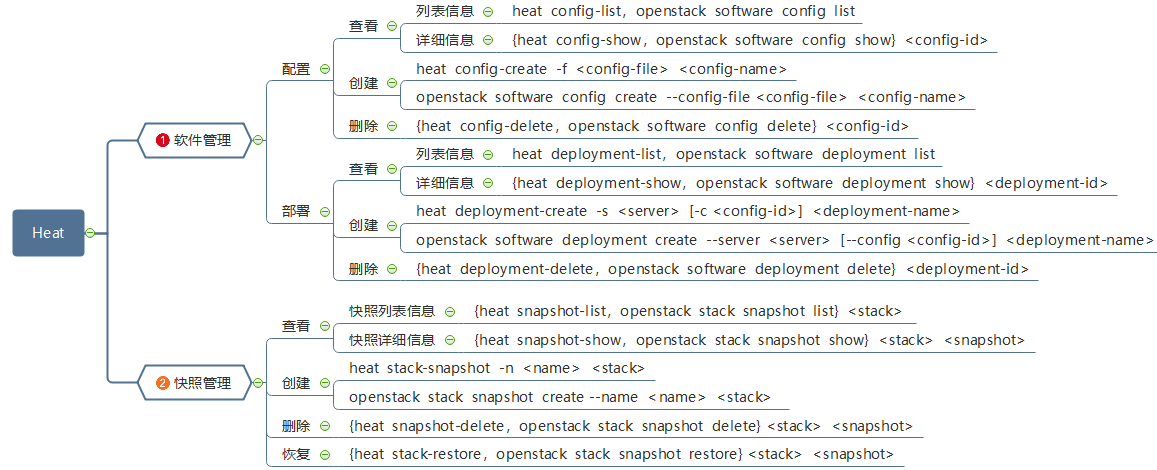
软件、快照管理
10. 数据库服务【Trove】
10.1 简介
背景
对于公有云计算平台来说 , 只有计算、网络与存储这三大服务往往是不太够的 , 在目前互联网应用百花齐放的背景下 , 几乎所有应用都使用到数据库 , 而数据库承载的往往是应用最核心的数据。此外 , 在大数据分析越来越盛行的背景下 , 对数据库的可靠便捷管理也变得更为重要。因此 ,
DBase as a Service(DBaaS, 数据库服务 ) 也就顺理成章地成为了云计算平台为用户创造价值的一个重要服务。对比
Amazon AWS中各种关于数据的服务 , 其中最著名的是RDS(SQL-base) 和DynamoDB(NoSQL) , 除了实现了基本的数据管理能力 , 还具备良好的伸缩能力、容灾能力和不同规格的性能表现。因此 , 对于最炙手可热的开源云计算平台Openstack来说 , 也从Icehouse版加入了DBaaS服务 , 代号Trove。直到去年底发布的Openstack Liberty版本 ,Trove已经经过了4个版本的迭代发布 , 目前已经成为Openstack官方可选的核心服务之一。本文将深入介绍Trove的原理、架构与功能 , 并通过实践来展示Trove的应用。
设计目标
Trove is Database as a Service for OpenStack. It’s designed to run entirely on OpenStack, with the goal of allowing users to quickly and easily utilize the features of a relational or non-relational database without the burden of handling complex administrative tasks. ”这是Trove在官方首页上对这个项目的说明 , 有两个关键点。一个是从产品设计上说 , 它定位不仅仅是关系型数据库 , 而且还涵盖非关系数据库的服务。另一个是从产品实现上说 , 它是完全基于Openstack的。从第一点可以看出
Trove解决问题的高度已经超越了同类产品。因为我们从其他云计算平台对比去看 , 关系型和非关系型数据库都是由不同的服务去提供 ( 比如AWS的RDS和DynamoDB) , 而且实现上也往往互相独立的系统 , 不仅UI不同 ,API也不一样。而Trove的目标是抽象尽可能多的东西 , 对外提供统一的UI和API, 尽量减少冗余实现 , 提升平台内聚。只要具备了实例、数据库、用户、配置、备份、集群、主从复制这些概念 , 不管是关系型还是非关系型数据库 , 都能统一管理起来。从最新的Liberty版本发布的情况下 , 目前开源的主流关系型和非关系型数据库也得到了支持 , 比如Mysql( 包括Percona和MariaDB分支 ) 、Postgresql、Redis、MongoDB、CouchDB、Cassandra等等。不过根据官方的介绍 , 目前只有Mysql是得到了充分的生产性测试 , 其他的还处于实验性阶段。而第二点完全基于
Openstack的 , 可以说是一个较大的创新。试想 , 假设你是一个云计算服务商 , 如果现在要提供数据库服务 , 只需要在原有平台软件上升级与配置一下就行 , 其他什么都不需要 , 不需要采购数据库服务器硬件 , 不需要规划网络 , 不需要规划IDC, 这是一种什么样的感觉?Trove完全构建于Openstack原有的几大基础服务之上。打个比喻类似于Google著名的Bigtable服务是构建于GFS、Borg、Chubby等几个基础服务之上。所以 ,Trove实际上拥有了云平台的一些基础特性 , 比如容灾隔离、动态调度、快速响应等能力 , 而且从研发的角度看 , 也大大减少了重复造轮子的现象。
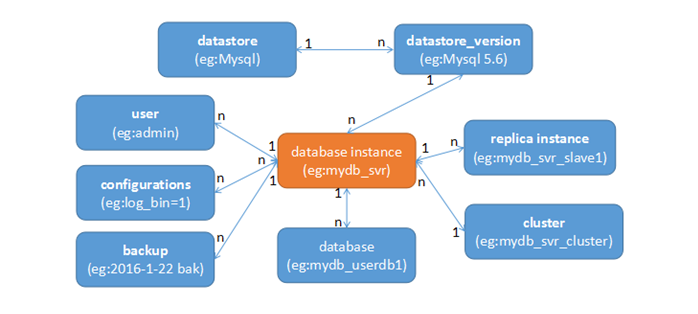
基本概念
数据库实例 (
Instance) : 包含数据库程序的openstack虚拟机 , 如果用户创建了一个数据库实例 , 那么他其实就创建了一台openstack虚拟机 , 并在该虚拟机上启动了数据库服务。Datastore: 用来表示和存储数据库的类型、版本、虚拟机镜像等信息。当用户创建一个数据库实例时需要指定Datastore.配置组(
Configuration Group) : 数据库参数组成的集合。用户可以将配置组应用到一个或多个数据库实例上 , 因而避免了大量的重复操作。
10.2 核心架构
10.3 组件详解
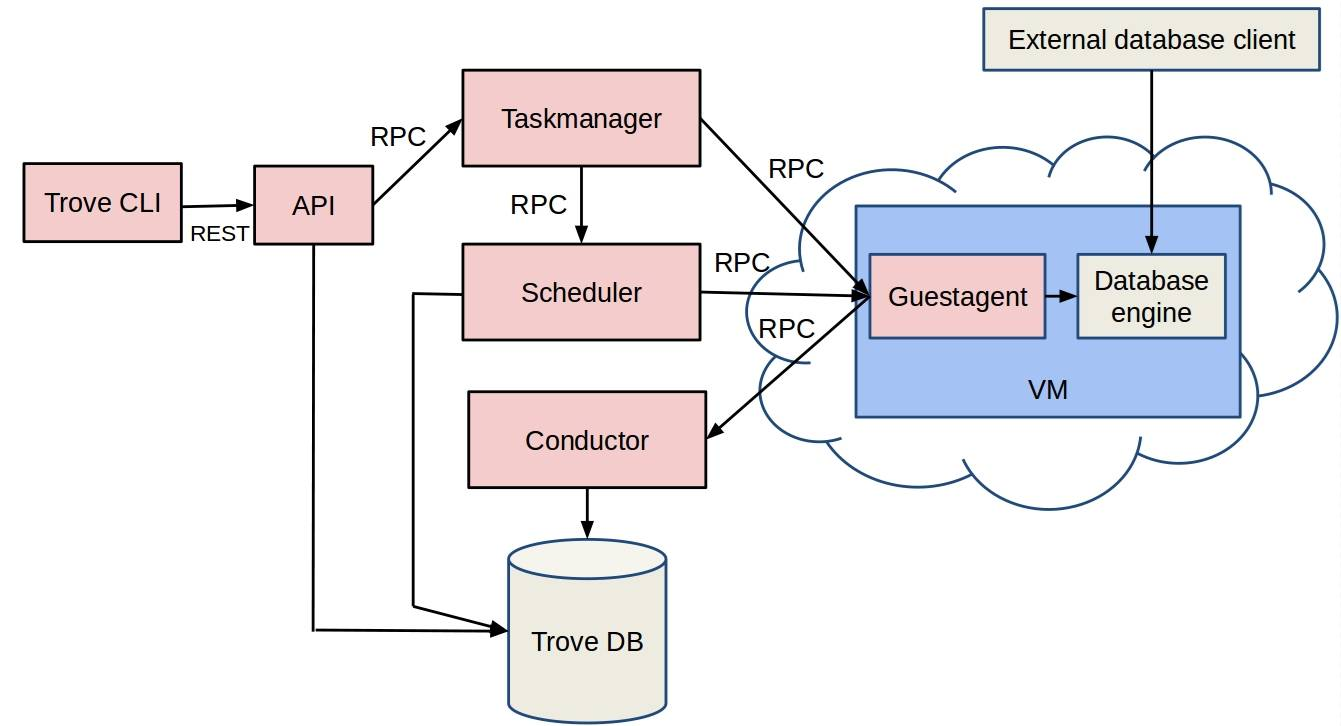
trove-api : 用于操作请求的接收和分发操作提供 REST 风格的 API , 同时与 trove-conductor 和 trove-taskmanager 通信 , 一些轻量级的请求 , 比如获取实例状态 , 实例数量等操作都是自身直接处理或访问 trove。trove-conductor 和 trove-taskmanager处理比较重量级的操作。比如创建数据库 , 创建备份等操作都是通过rpc传递给 trove-taskmanager , 然后通过调用 nova、swift、neutron、cinder等组件来完成操作。
trove-conductor : 将 vm 内 trove-guestagent 发送的状态信息保存到数据库 , 与 trove-guestagent 的通信是通过rpc来实现的 , trove-conductor 这个组件的目的是为了避免创建的数据库的实例直接访问数据库 , 它是做为一个 trove-guestagent 将昨天写入数据库的中间件。
trove-taskmanager : 执行 trove 中大部分复杂的操作 , 请求者发送消息到 trove-taskmanager , trove-taskmanager 在请求者的上下文中调用相应的程序执行这些请求。taskmanager 处理一些操作 , 包括实例的创建、删除 , 与其他服务如Nova、Cinder、Swift等的交互 , 一些更复杂的Trove操作如复制和集群 , 以及对实例的整个生命周期的管理。trove-taskmanager就像是其他openstack服务的客户端 , 如nova , swift , cinder等 , 当要创建数据库实例时就将请求发送给nova , 让nova去创建个实例 , 要备份的话就调用swift接口上传备份。
trove-guestagent : 集成在vm镜像里面 , 通过监听rpc里面task manager发过来的指令 , 并在本地执行代码完成数据库任务 , taskmanager将消息发送到guest agent , guest agent通过调用相应的程序执行这些请求。
10.4 功能
1. 动态`resize`能力 : 分为`instance-resize`和`volume-resize` , 前者主要是实例运行的内存大小和`cpu`核数 , 后者主要是指数据库分区对应的硬盘卷的大小。由于实例是跑在`vm`上的 , 而`vm`的`cpu`和`memory`的规格可以通过`Nova`来进行动态调整 , 所以调整是非常方便快捷的。另外硬盘卷也是由`Cinder`提供的动态扩展功能来实现`resize`。`resize`过程中服务会有短暂的中断 , 是由于`mysqld`重启导致的。
2. 全量与增量备份 : 目前`mysql`的实现中 , 备份是由实例`vm`上的`guestagent`运行`xtrabackup`工具进行备份 , 且备份后的文件会存储在`Swift`对象存储中。从备份创建实例的过程则相反。由于`xtrabackup`强大的备份功能 , 所以`Trove`要做的只是做一些粘胶水的工作。
3. 动态配置更新 : 目前支持实例的自定义配置 , 可以创建配置组应该到一组实例上 , 且动态`attach`到运行中的实例中生效。
4. 一主多从的一键创建 : 在创建数据库实例的`API`中 , 支持批量创建多个从实例 , 并以指定的实例做主进行同步复制。这样就方便了从一个已有实例创建多个从实例的操作。而且`mysql5.6`版本之后的同步复制支持`GTID`二进制日志 , 使得主从实例之间关系的建立更加可靠和灵活 , 在`failover`处理上也更加快速。
5. 集群创建与管理 ( `percona/mariadb`支持 )  : `Cluster` 功能目前在 `mysql`原生版本暂时不支持 , 但是其两个分支版本 `percona`和 `mariadb`基于 `Galera`库实现的集群复制技术是支持的。另外`Liberty`版本的`Trove`也提供了对`mongodb`的集群支持。
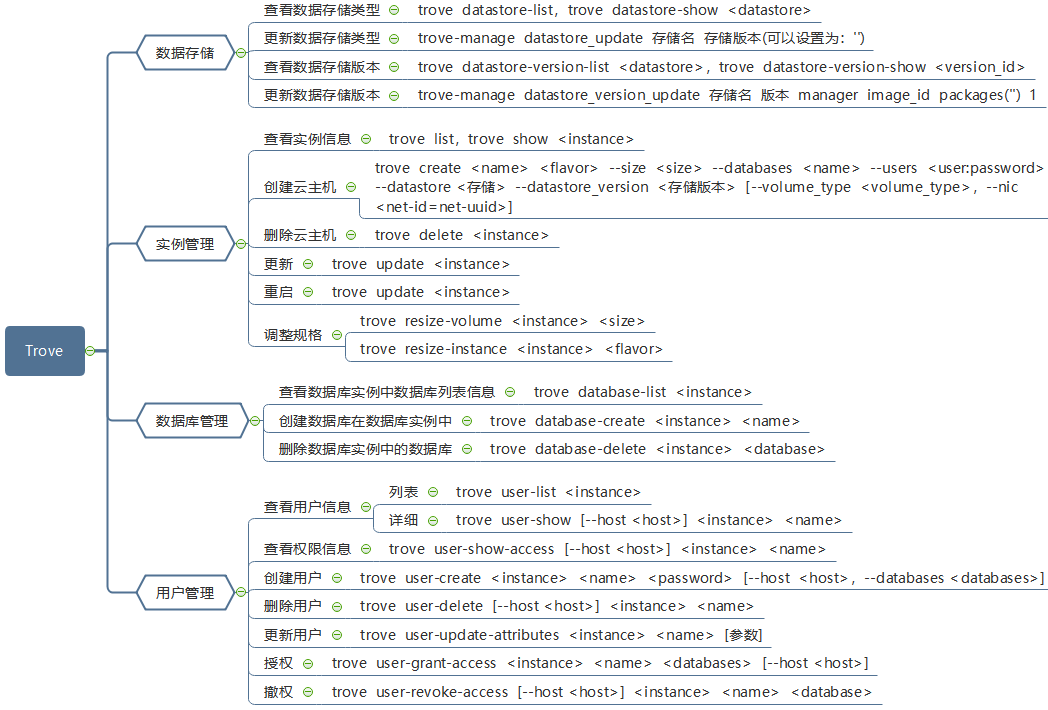
10.5 常用操作
实例、数据库、数据库用户管理
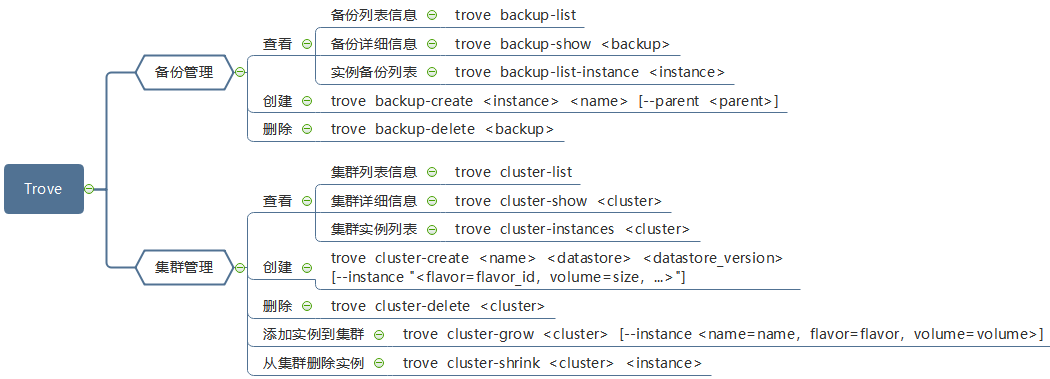
备份和集群管理
参考链接
[云计算]OpenStack这一篇就够了! - SkyBiuBiu - 博客园 (cnblogs.com)