
1-2-kubernetes组件
当你部署完 Kubernetes ,便拥有了一个完整的集群。
一组工作机器 ,称为节点 , 会运行容器化应用程序。每个集群至少有一个工作节点。
工作节点会托管Pod ,而 Pod 就是作为应用负载的组件。控制平面管理集群中的工作节点和 Pod。 在生产环境中 ,控制平面通常跨多台计算机运行 , 一个集群通常运行多个节点 ,提供容错性和高可用性。
本文档概述了一个正常运行的Kubernetes集群所需的各种组件。
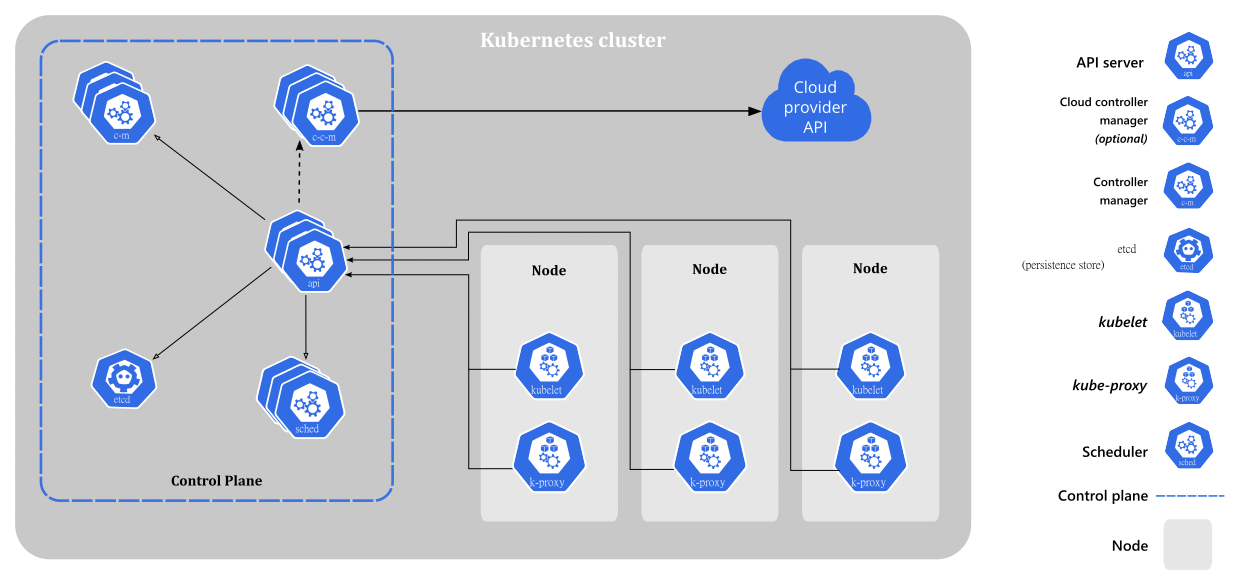
1. 控制平面组件( Control Plane Components)
控制平面组件会为集群做出全局决策 , 比如资源的调度。 以及检测和响应集群事件 ,例如当不满足部署的 replicas 字段时 ,要启动新的Pod)。
控制平面组件可以在集群中的任何节点上运行。 然而 ,为了简单起见 ,设置脚本通常会在同一个计算机上启动所有控制平面组件 , 并且不会在此计算机上运行用户容器。
1.1 kube-apiserver
1.1.1 基础介绍
API 服务器是 Kubernetes 控制平面的组件 , 该组件负责公开了 Kubernetes API , 负责处理接受请求的工作。 API 服务器是 Kubernetes 控制平面的前端。
Kubernetes API 服务器的主要实现是 kube-apiserver。 kube-apiserver 设计上考虑了水平扩缩 , 也就是说 , 它可通过部署多个实例来进行扩缩。 你可以运行 kube-apiserver 的多个实例 , 并在这些实例之间平衡流量。
Kubernetes API server为api对象验证并配置数据 ,包括pods、services、replicationcontrollers和其它api对象API Server提供REST操作和到集群共享状态的前端 , 所有其他组件通过它进行交互。
k8s API Server提供了k8s各类资源对象( pod,RC,Service等)的增删改查及watch等HTTP Rest接口, 是整个系统的数据总线和数据中心。 apiserver 目前在master监听两个端口, 通过 --insecure-port int 监听一个非安全的127.0.0.1本地端口(默认为 8080)。该端口用于接收HTTP请求 ; 该端口默认值为8080, 可以通过API Server的启动参数“--insecure-port”的值来修改默认值 ; 默认的IP地址为“localhost”, 可以通过启动参数“--insecure-bind-address”的值来修改该IP地址 ; 非认证或未授权的HTTP请求通过该端口访问API Server(kube-controller-manager、kube-scheduler)。
通过参数--bind-address=192.168.7.101 监听一个对外访问且安全(https)的端口(默认为6443) 。该端口默认值为6443, 可通过启动参数“--secure-port”的值来修改默认值 ; 默认IP地址为非本地(Non-Localhost)网络端口, 通过启动参数“--bind-address”设置该值 ; 该端口用于接收客户端、dashboard等外部HTTPS请求 ; 用于基于Tocken文件或客户端证书及HTTP Base的认证 ; 用于基于策略的授权 ;
1.1.2 API使用
kubernetes API Server的功能与使用 :
提供了集群管理的REST API接口(包括认证授权、数据校验以及集群状态变更) ; 提供其他模块之间的数据交互和通信的枢纽( 其他模块通过API Server查询或修改数据 , 只有API Server才直接操作 etcd) ; 是资源配额控制的入口 ; 拥有完备的集群安全机制
curl localhost: 8080 /api
curl localhost: 8080 /api/v1/pods
curl localhost: 8080 /api/v1/services
curl localhost: 8080 /api/v1/replicationcontrollers
Node相关接口
关于Node相关的接口的REST路径为: /api/v1/proxy/nodes/{name} , 其中{name}为节点的名称或IP地址。
/api/v1/proxy/nodes/{name}/pods/ #列出指定节点内所有Pod的信息
/api/v1/proxy/nodes/{name}/stats/ #列出指定节点内物理资源的统计信息
/api/v1/prxoy/nodes/{name}/spec/ #列出指定节点的概要信息这里获取的Pod信息来自Node而非etcd 数据库 , 两者时间点可能存在偏差。如果在kubelet进程启动时加--enable-debugging-handles=true参数 , 那么kubernetes Proxy API还会增加以下接口:
/api/v1/proxy/nodes/{name}/run #在节点上运行某个容器
/api/v1/proxy/nodes/{name}/exec #在节点上的某个容器中运行某条命令
/api/v1/proxy/nodes/{name}/attach #在节点上attach某个容器
/api/v1/proxy/nodes/{name}/portForward #实现节点上的Pod端口转发
/api/v1/proxy/nodes/{name}/logs #列出节点的各类日志信息
/api/v1/proxy/nodes/{name}/metrics #列出和该节点相关的Metrics信息
/api/v1/proxy/nodes/{name}/runningpods #列出节点内运行中的Pod信息
/api/v1/proxy/nodes/{name}/debug/pprof #列出节点内当前web服务的状态 , 包括CPU和内存的使用情况Pod相关接口
/api/v1/proxy/namespaces/{namespace}/pods/{name}/{path:*} #访问pod的某个服务接口
/api/v1/proxy/namespaces/{namespace}/pods/{name} #访问Pod
#以下写法不同 , 功能一样
/api/v1/namespaces/{namespace}/pods/{name}/proxy/{path:*} #访问pod的某个服务接口
/api/v1/namespaces/{namespace}/pods/{name}/proxy #访问PodService相关接口
/api/v1/proxy/namespaces/{namespace}/services/{name}1.1.3 集群功能模块之间的通信
kubernetes API Server作为集群的核心 , 负责集群各功能模块之间的通信 , 集群内各个功能模块通过API Server将信息存入etcd , 当需要获取和操作这些数据时 , 通过API Server提供的REST接口(GET\LIST\WATCH方法)来实现 , 从而实现各模块之间的信息交互。
kubelet与API Server交互
每个Node节点上的kubelet定期就会调用API Server的REST接口报告自身状态 , API Server接收这些信息后 , 将节点状态信息更新到etcd中。kubelet也通过API Server的Watch接口监听Pod信息 , 从而对Node机器上的POD进行管理。
kube-controller-manager与API Server交互
kube-controller-manager中的Node Controller模块通过API Server提供的Watch接口 , 实时监控Node的信息 , 并做相应处理。
kube-scheduler与API Server交互
Scheduler通过API Server的Watch接口监听到新建Pod副本的信息后 , 它会检索所有符合该Pod要求的Node列表 , 开始执行Pod调度逻辑。调度成功后将Pod绑定到目标节点上。
1.1.4 API Server参数介绍
API Server 主要是和 etcd 打交道 , 并且对外提供 HTTP 服务 , 以及进行安全控制 , 因此它的命令行提供的参数也主要和这几个方面有关。下面是一些比较重要的参数以及说明(不同版本参数可能会有不同) :
具体参数可以查看链接: kube-apiserver | Kubernetes
root@k8s-master01:~# systemctl cat kube-apiserver
# /etc/systemd/system/kube-apiserver.service
[Unit]
Description=Kubernetes API Server
Documentation=https://github.com/GoogleCloudPlatform/kubernetes
After=network.target
[Service]
ExecStart=/opt/kube/bin/kube-apiserver \
--allow-privileged=true \
--anonymous-auth=false \
--api-audiences=api,istio-ca \
--authorization-mode=Node,RBAC \
--bind-address=192.168.71.29 \
--client-ca-file=/etc/kubernetes/ssl/ca.pem \
--endpoint-reconciler-type=lease \
--etcd-cafile=/etc/kubernetes/ssl/ca.pem \
--etcd-certfile=/etc/kubernetes/ssl/kubernetes.pem \
--etcd-keyfile=/etc/kubernetes/ssl/kubernetes-key.pem \
--etcd-servers=https://192.168.71.42:2379,https://192.168.71.43:2379,https://192.168.71.44:2379 \
--kubelet-certificate-authority=/etc/kubernetes/ssl/ca.pem \
--kubelet-client-certificate=/etc/kubernetes/ssl/kubernetes.pem \
--kubelet-client-key=/etc/kubernetes/ssl/kubernetes-key.pem \
--secure-port=6443 \
--service-account-issuer=https://kubernetes.default.svc \
--service-account-signing-key-file=/etc/kubernetes/ssl/ca-key.pem \
--service-account-key-file=/etc/kubernetes/ssl/ca.pem \
--service-cluster-ip-range=10.68.0.0/16 \
--service-node-port-range=30000-32767 \
--tls-cert-file=/etc/kubernetes/ssl/kubernetes.pem \
--tls-private-key-file=/etc/kubernetes/ssl/kubernetes-key.pem \
--requestheader-client-ca-file=/etc/kubernetes/ssl/ca.pem \
--requestheader-allowed-names= \
--requestheader-extra-headers-prefix=X-Remote-Extra- \
--requestheader-group-headers=X-Remote-Group \
--requestheader-username-headers=X-Remote-User \
--proxy-client-cert-file=/etc/kubernetes/ssl/aggregator-proxy.pem \
--proxy-client-key-file=/etc/kubernetes/ssl/aggregator-proxy-key.pem \
--enable-aggregator-routing=true \
--v=2
Restart=always
RestartSec=5
Type=notify
LimitNOFILE=65536
[Install]
WantedBy=multi-user.target
1.2 etcd
github地址: Tags · etcd-io/etcd · GitHub
一致且高可用的键值存储 , 用作 Kubernetes 所有集群数据的后台数据库。
如果你的 Kubernetes 集群使用 etcd 作为其后台数据库 , 请确保你针对这些数据有一份 备份计划。
1.3 kube-scheduler
kube-scheduler 是控制平面的组件 , 负责监视新创建的、未指定运行节点(node)的 Pods , 并选择节点来让 Pod 在上面运行。
调度决策考虑的因素包括单个 Pod 及 Pods 集合的资源需求、软硬件及策略约束、 亲和性及反亲和性规范、数据位置、工作负载间的干扰及最后时限。
Kubernetes scheduler是一个拥有丰富策略、能够感知拓扑变化、支持特定负载的功能组件 ,它对集群的可用性、性能表现以及容量都影响巨大。 scheduler需要考虑独立的和集体的资源需求、
服务质量需求、硬件/软件/策略限制、亲和与反亲和规范、数据位置、内部负载接口、截止时间等等。如有必要 ,特定的负载需求可以通过API暴露出来。
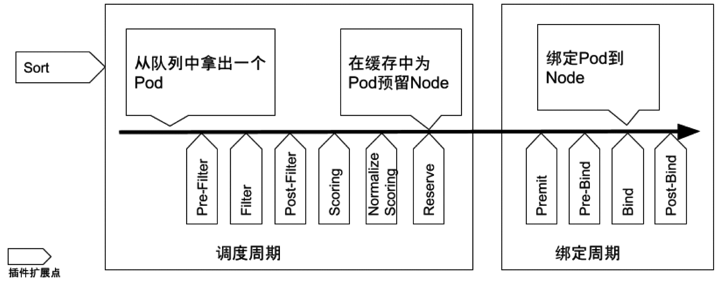
特殊的Controller , 工作原理与其他控制器无差别。
Scheduler的特殊职责在于监控当前集群所有未调度的Pod , 并且获取当前集群所有节点的健康状况和资源使用情况 , 为待调度Pod选择最佳计算节点 , 完成调度。
调度阶段分为:
Predict∶过滤不能满足业务需求的节点 , 如资源不足、端口冲突等。Priority∶按既定要素将满足调度需求的节点评分 , 选择最佳节点。Bind∶将计算节点与Pod绑定 , 完成调度。
root@k8s-master01:~# systemctl cat kube-scheduler
# /etc/systemd/system/kube-scheduler.service
[Unit]
Description=Kubernetes Scheduler
Documentation=https://github.com/GoogleCloudPlatform/kubernetes
[Service]
ExecStart=/opt/kube/bin/kube-scheduler \
--authentication-kubeconfig=/etc/kubernetes/kube-scheduler.kubeconfig \
--authorization-kubeconfig=/etc/kubernetes/kube-scheduler.kubeconfig \
--bind-address=0.0.0.0 \
--kubeconfig=/etc/kubernetes/kube-scheduler.kubeconfig \
--leader-elect=true \
--v=2
Restart=always
RestartSec=5
[Install]
WantedBy=multi-user.target
1.4 kube-controller-manager
kube-controller-manager是控制平面的组件 , 负责运行控制器进程。
Controller Manager 作为集群内部的管理控制中心 ,非安全默认端口10252, 负责集群内的 Node 、 Pod 副本、服务端点(Endpoint )、命名空间(Namespace ) 、服务账号(ServiceAccount)、资源定额 ResourceQuota)的管理 ,当某个Node意外宕机时 , Controller Manager 会及时发现并执行自动化修复流程 ,确保集群始终处于预期的工作状态。
从逻辑上讲 , 每个控制器都是一个单独的进程 , 但是为了降低复杂性 , 它们都被编译到同一个可执行文件 , 并在同一个进程中运行。
有许多不同类型的控制器。以下是一些例子:
节点控制器(
Node Controller): 负责在节点出现故障时进行通知和响应任务控制器(
Job Controller): 监测代表一次性任务的Job对象 , 然后创建Pod来运行这些任务直至完成端点分片控器(
EndpointSlice controller): 填充端点分片(EndpointSlice)对象(以提供Service和Pod之间的链接)。服务账号控制器(
ServiceAccount controller): 为新的命名空间创建默认的服务账号(ServiceAccount)。
以上并不是一个详尽的列表。
root@k8s-master01:~# systemctl cat kube-controller-manager
# /etc/systemd/system/kube-controller-manager.service
[Unit]
Description=Kubernetes Controller Manager
Documentation=https://github.com/GoogleCloudPlatform/kubernetes
[Service]
ExecStart=/opt/kube/bin/kube-controller-manager \
--allocate-node-cidrs=true \
--authentication-kubeconfig=/etc/kubernetes/kube-controller-manager.kubeconfig \
--authorization-kubeconfig=/etc/kubernetes/kube-controller-manager.kubeconfig \
--bind-address=0.0.0.0 \
--cluster-cidr=172.20.0.0/16 \
--cluster-name=kubernetes \
--cluster-signing-cert-file=/etc/kubernetes/ssl/ca.pem \
--cluster-signing-key-file=/etc/kubernetes/ssl/ca-key.pem \
--kubeconfig=/etc/kubernetes/kube-controller-manager.kubeconfig \
--leader-elect=true \
--node-cidr-mask-size=24 \
--root-ca-file=/etc/kubernetes/ssl/ca.pem \
--service-account-private-key-file=/etc/kubernetes/ssl/ca-key.pem \
--service-cluster-ip-range=10.68.0.0/16 \
--use-service-account-credentials=true \
--v=2
Restart=always
RestartSec=5
[Install]
WantedBy=multi-user.targetController Manager是多个控制器的组合 , 每个Controller事实上都是一个control loop , 负责侦听其管控的对象 , 当对象发生变更时完成配置;
Controller配置失败通常会触发自动重试 , 整个集群会在控制器不断重试的机制下确保最终一致性(Eventual Consistency)。
稍微展开一下控制器的工作流程:
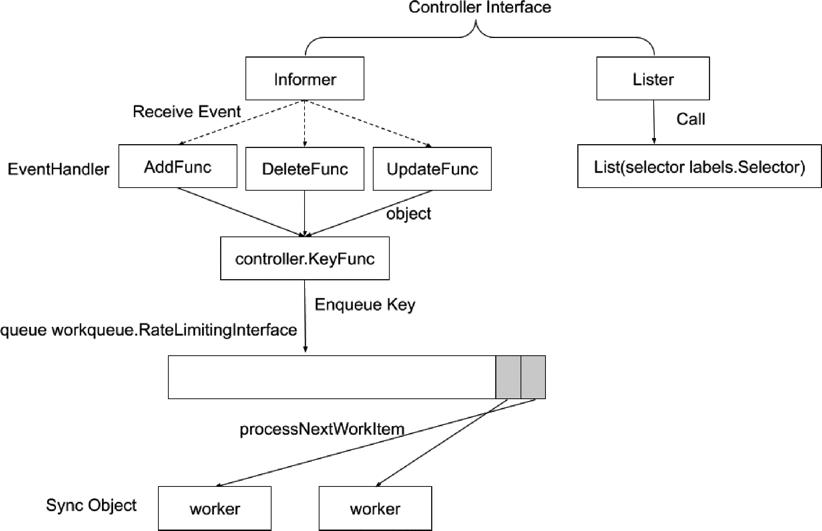
针对任何对象 , Kubernetes 有一些辅助工具 Codegenerator , 可以帮助我们生成这个对象的一些访问框架、代码框架 , 这个框架主要就是 Controller Interface , 分为 Informer 和 Lister 两部分。
Informer相当于去监听某个对象 , 任何一个对象的状态发生变化 , 或者对一个对象的增删改操作 ,Informer都会生成一个新的Event, 控制器利用这些frameworker就可以去监听这些事件(AddFunc、DeleteFunc、UpdateFunc)。当监听到某个事件时 , 就会把事件的key拿出来放到一个队列中 , 模拟生产者消费者模型;消费者就是一些worker Thread, 其不停的从队列中取数据 , 取出来去做配置。Lister相当于Kubernetes的所有对象在创建监听后在客户端创建了一个缓存 , 通过Lister就可以直接从缓存获取 , 就不需要再请求APIServer了。
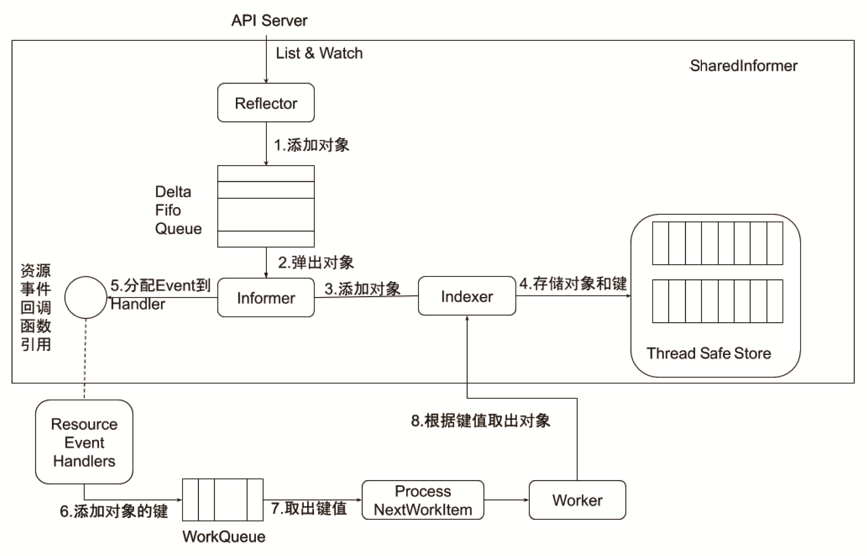
Informer的内部机制
SharedInformer通过 List&Watch 去关注一个对象(List&Watch : 第一 , 会把所有当前所有对象的List对象返回回来 , 第二 , 作为长连接 , 关注后面的变更)
接口是通用的 , 那么对于不同的对象如何转换为统一的接口使用的 , 就是通过Reflector进行反射生成对象 , 然后把对象放入队列中然后就是将对象添加到 Thread Safe Store , 另外如果监听到变化 , informer 分配 Event 到 Handler , handler 则进行事件处理
控制器的协同工作原理:
当我们使用 kubectl apply -f nginx-deploy.yml 去更新时(可以加-v 9 查看整体流程日志) , 配置文件内容:
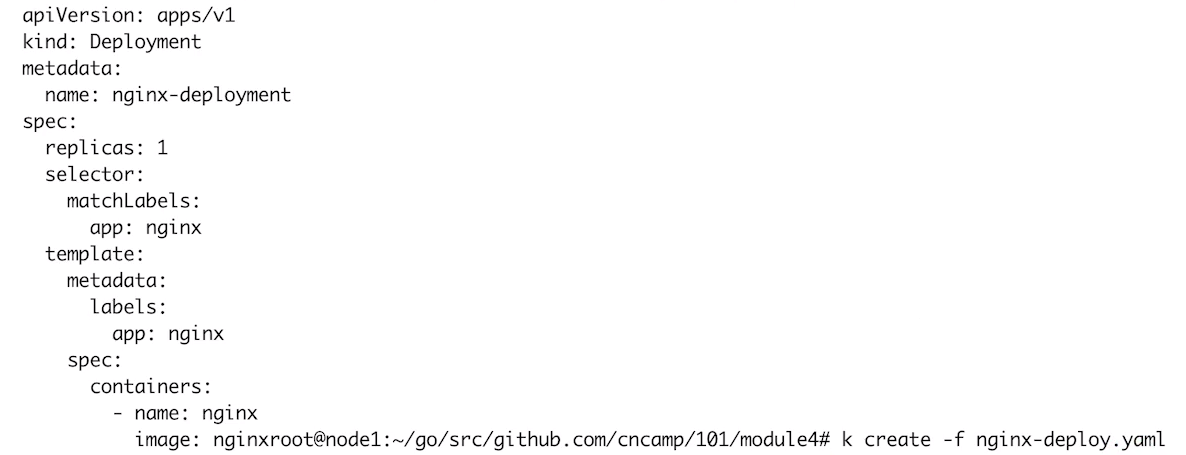
流程如下:
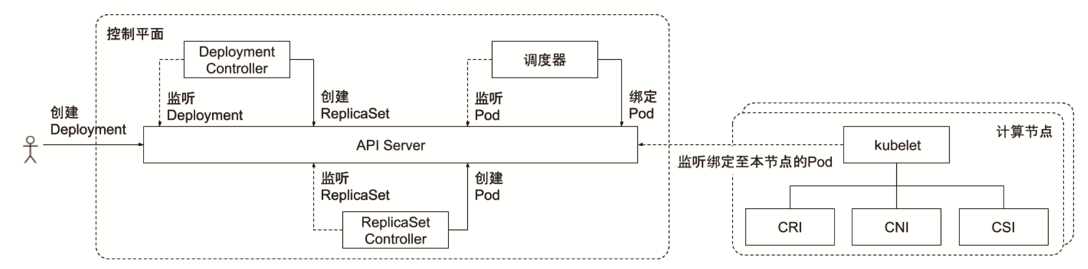
从配置文件获取
APIServer的地址然后会将这个请求发到
APIServer中 ,APIServer会做认证、鉴权、准入等操作 , 执行完之后会将请求存储到etcd中。当请求存入到
etcd后 , 就需要控制器进行操作了 , 控制器有很多种 , 例如Deployment Controller, 其关注的就是Deployment对象 , 上面的nginx-deploy.yml里面是要创建一个Deployment, 因此Deployment Controller就监听到该事件 , 然后看到其是要创建一个副本集 , 因此就将创建ReplicaSet的请求发给APIServer,APIServer会将该请求放入etcd中。ReplicaSet Controller监听到创建副本集的任务时 , 就会读取请求 , 通过上述配置文件可以看到 , 需要创建一个pod对象 , 因此就会将创建Pod的请求发给APIServer,APIServer会将请求存入etcd调度器监听到创建
Pod的请求后 , 会进行调度 , 选择一个合适的节点与pod进行绑定节点监听到其绑定了一个新的
pod, 就会进行初始化 ,Kubernetes对容器的初始化已经做好了抽象 , 使用CRI抽象了初始化一个容器环境 , 使用CNI抽象了一个网络环境 , 使用CSI抽象了文件挂载。
2. Node组件
节点组件会在每个节点上运行 , 负责维护运行的 Pod 并提供 Kubernetes 运行环境。
2.1 kubelet
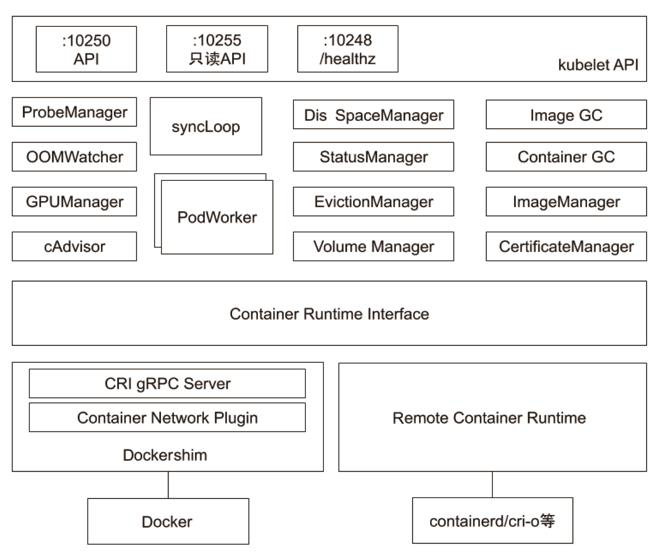
Kubernetes的初始化系统(init system)
从不同源获取Pod清单 , 并按需求启停Pod的核心组件:
Pod清单可从本地文件目录 , 给定的HTTPServer或Kube-APIServer等源头获取;Kubelet将运行时 , 网络和存储抽象成了CRI,CNI,CSI。
负责汇报当前节点的资源信息和健康状态;
负责Pod的健康检查和状态汇报。
kubelet 会在集群中每个节点(node)上运行。 它保证容器(containers)都运行在Pod中。
kubelet接收一组通过各类机制提供给它的 PodSpec , 确保这些 PodSpec 中描述的容器处于运行状态且健康。 kubelet 不会管理不是由 Kubernetes 创建的容器。
kubelet: 是主要的节点代理 ,它会监视已分配给节点的pod ,具体功能如下:
向
master汇报node节点的状态信息接受指令并在
Pod中创建docker容器准备
Pod所需的数据卷返回
pod的运行状态在
node节点执行容器健康检查
root@k8s-node01:~# systemctl cat kubelet
# /etc/systemd/system/kubelet.service
[Unit]
Description=Kubernetes Kubelet
Documentation=https://github.com/GoogleCloudPlatform/kubernetes

[Service]
WorkingDirectory=/var/lib/kubelet
ExecStartPre=/bin/mount -o remount,rw '/sys/fs/cgroup'
ExecStart=/opt/kube/bin/kubelet \
  --config=/var/lib/kubelet/config.yaml \
  --container-runtime-endpoint=unix:///run/containerd/containerd.sock \
  --hostname-override=k8s-node01.cbear.top \
  --kubeconfig=/etc/kubernetes/kubelet.kubeconfig \
  --root-dir=/var/lib/kubelet \
  --v=2
Restart=always
RestartSec=5

[Install]
WantedBy=multi-user.target
2.2 kube-proxy
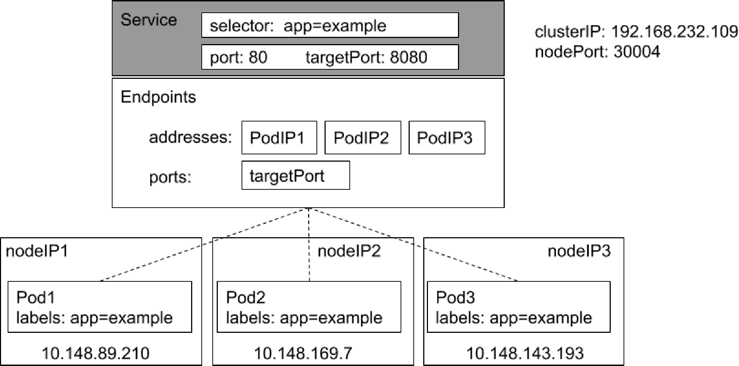
监控集群中用户发布的服务 , 并完成负载均衡配置。每个节点的Kube-Proxy都会配置相同的负载均衡策略 , 使得整个集群的服务发现建立在分布式负载均衡器之上 , 服务调用无需经过额外的网络跳转(Network Hop)。
负载均衡配置基于不同插件实现:userspace、操作系统网络协议栈不同的Hooks点和插件(iptables、ipvs)
kube-proxy是集群中每个节点(node)上所运行的网络代理 , 实现 Kubernetes 服务(Service)概念的一部分。
kube-proxy 维护节点上的一些网络规则 , 这些网络规则会允许从集群内部或外部的网络会话与 Pod 进行网络通信。
如果操作系统提供了可用的数据包过滤层 , 则 kube-proxy 会通过它来实现网络规则。 否则 , kube-proxy 仅做流量转发。
Kubernetes网络代理运行在 node 上 ,它反映了 node 上Kubernetes API 中定义的服务 ,并可以通过一组后端进行简单的 TCP 、 UDP 流转发或循环模式(round robin)的TCP 、UDP 转发 ,用户必须使用 apiserver API 创建一个服务来配置代理 ,其实就是kube proxy通过在主机上维护网络规则并执行连接转发来实现 Kubernetes服务访问 。
root@k8s-node01:~# systemctl cat kube-proxy
# /etc/systemd/system/kube-proxy.service
[Unit]
Description=Kubernetes Kube-Proxy Server
Documentation=https://github.com/GoogleCloudPlatform/kubernetes
After=network.target

[Service]
WorkingDirectory=/var/lib/kube-proxy
ExecStart=/opt/kube/bin/kube-proxy \
  --config=/var/lib/kube-proxy/kube-proxy-config.yaml
Restart=always
RestartSec=5
LimitNOFILE=65536

[Install]
WantedBy=multi-user.target
2.3 容器运行时
这个基础组件使 Kubernetes 能够有效运行容器。 它负责管理 Kubernetes 环境中容器的执行和生命周期。
Kubernetes 支持许多容器运行环境, 例如 containerd、 CRI-O以及 Kubernetes CRI (容器运行环境接口)的其他任何实现。
3. 插件
插件使用 Kubernetes 资源( DaemonSet、 Deployment 等)实现集群功能。 因为这些插件提供集群级别的功能, 插件中命名空间域的资源属于 kube-system 命名空间。
3.1 DNS
尽管其他插件都并非严格意义上的必需组件, 但几乎所有 Kubernetes 集群都应该有集群DNS, 因为很多示例都需要 DNS 服务。
集群 DNS 是一个 DNS 服务器, 和环境中的其他 DNS 服务器一起工作, 它为 Kubernetes 服务提供 DNS 记录。
Kubernetes 启动的容器自动将此 DNS 服务器包含在其 DNS 搜索列表中。
3.2 Web 界面(仪表盘)
Dashboard是 Kubernetes 集群的通用的、基于 Web 的用户界面。 它使用户可以管理集群中运行的应用程序以及集群本身, 并进行故障排除。
3.3 容器资源监控
容器资源监控将关于容器的一些常见的时间序列度量值保存到一个集中的数据库中, 并提供浏览这些数据的界面。
3.4 集群层面日志
集群层面日志机制负责将容器的日志数据保存到一个集中的日志存储中, 这种集中日志存储提供搜索和浏览接口。
3.5 网络插件
网络插件 是实现容器网络接口(CNI)规范的软件组件。它们负责为 Pod 分配 IP 地址, 并使这些 Pod 能在集群内部相互通信。
参考链接
01-Kubernetes 架构原则和对象设计 - 李聪龙 - 博客园 (cnblogs.com)