
2-1-kubernetes安装-kubadm
使用批量部署工具如(ansible/ saltstack)、手动二进制、kubeadm、apt-get/yum 等方式安装 , 以守护进程的方式启动在宿主机上 , 类似于是Nginx一样使用service脚本启动。
1. kubeadm部署
1.1 kubeadm工具简介
kubeadm是Kubernetes社区提供的集群构建工具 , 它负责构建一个最小化可用集群并执行启动等必要的基本步骤 , 简单来讲 , kubeadm是 Kubernetes集群全生命周期管理工具 , 可用于实现集群的部署、升级/ 降级及卸载等 , 如下图所示。在部署操作中 , kubeadm仅关心如何初 始化并拉起一个集群 , 其职责仅限于图中的Layer2和Layer3中的部分附件 , 至于准备基础设施的Layer1和包含其他附件的Layer3则不在其职责之内。
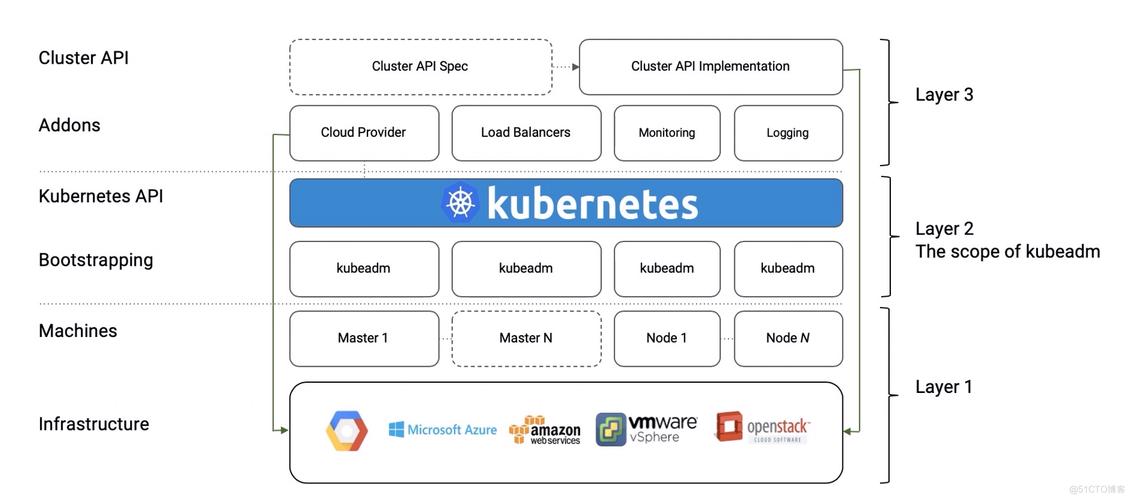
换句话说 , kubeadm专注于在现有基础架构上引导Kubernetes集群启动并执行一系列基本的维护任务 , 其功能未涉及底层基础环境的构 建 , 也不会管理如图中的每一个附件 , 而仅仅是为集群添加最为要紧的核心附件CoreDNS和kube-proxy。余下的其他附件 , 例如Kubernetes Dashboard、监控系统和日志系统等必要的附加组件则不在kubeadm考虑范围内 , 这些附加组件由管理员按需自行部署。 kubeadm的核心工具是kubeadm init和kubeadm join , 前者用于创建新的控制平面节点 , 后者则用于将节点快速连接到指定 的控制平面 , 它们是创建Kubernetes集群最佳实践的“快速路径”。
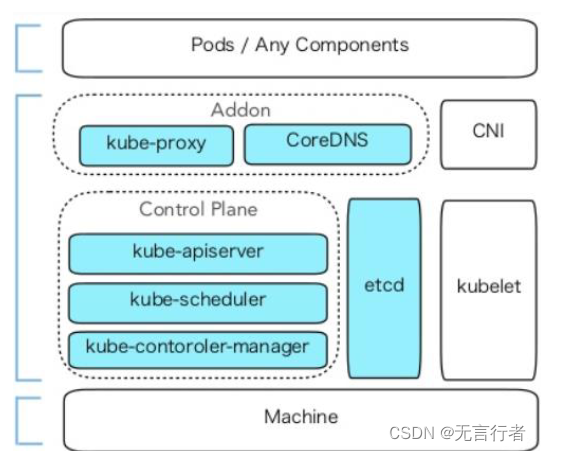
此外 , kubeadm token命令负责可管理集群构建后节点加入集群时使用的认证令牌 , 以供新节点基于预共享密钥在首次联系API Server 时进行身份认证。而删除集群构建过程中生成的文件并重置回初始状态 , 则是kubeadm reset命令的功能。其他几个可用的工具包括 kubeadm config和kubeadm upgrade等。这些工具随Kubernetes 1.13 版发布时已正式进入GA阶段 , 其命令接口的使用、底层实现、配置文 件模式、次要版本升级以及etcd存储系统部署设定等已成熟到可创建 一致的Kubernetes集群 , 并能够支持多种多样的部署选项。
概括来说 , 使用kubeadm部署Kubernetes集群有以下几个方面的优 势。
简单易用 :
kubeadm可完成集群的部署、升级和卸载操作 , 并且 对新手用户非常友好。适用领域广泛 : 支持将集群部署于裸机、
VMware、AWS、Azure、GCE及更多环境的主机上 , 且部署过程基本一致。富有弹性 : 支持阶段式部署 , 管理员可分多个独立步骤完成部署 操作。
生产环境可用:
kubeadm遵循最佳实践的方式部署Kubernetes集 群 , 它强制启用RBAC, 设定Master的各组件间以及API Server与kubelet之间进行认证和安全通信 , 并锁定了kubelet API等。
kubeadm并不仅仅是一键安装类的解决方案 , 它还有着更宏大的目 标 , 旨在成为一个更大解决方案的一部分 , 试图为集群创建和运营构 建一个声明式的API驱动模型 , 它把集群本身视为不可变组件 , 而升级 操作等同于全新部署或就地更新。目前 , kubeadm已经成为越来越多的 组织或企业部署测试或生产环境时的选择。
1.2 集群组件运行模式
Kubernetes集群主要由Master和Node两类节点组成 : Master节点主要运行etcd、kube-apiserver、kube controller-manager和kube-scheduler这4个组件 , 而各Node节点则分别运行kubelet和kube-proxy等组件 , 以及容器的运行时引擎。事实 上 , 这些组件自身也是应用程序 , 除了kubelet和Docker等容器引擎之 外 , 其他几个组件同样可以运行为容器。原因在于 , kubelet运行在各Node之上 , 负责操作Docker这类运行时引擎 , 并管理容器网络和存储卷等宿主机级别的功能 , 而将kubelet运行于容器中显然难以完成其中 的部分功能 , 例如管理宿主机的文件系统或Pod的存储卷等。
以集群的组件是否以容器方式运行 , 以及是否运行为自托管模式为标准 , Kubernetes集群可部署为3种运行模式。
独立组件模式 :
Master各组件和Node各组件直接以守护进程方式运行于节点之上 , 以二进制程序部署的集群隶属于此种类型 ,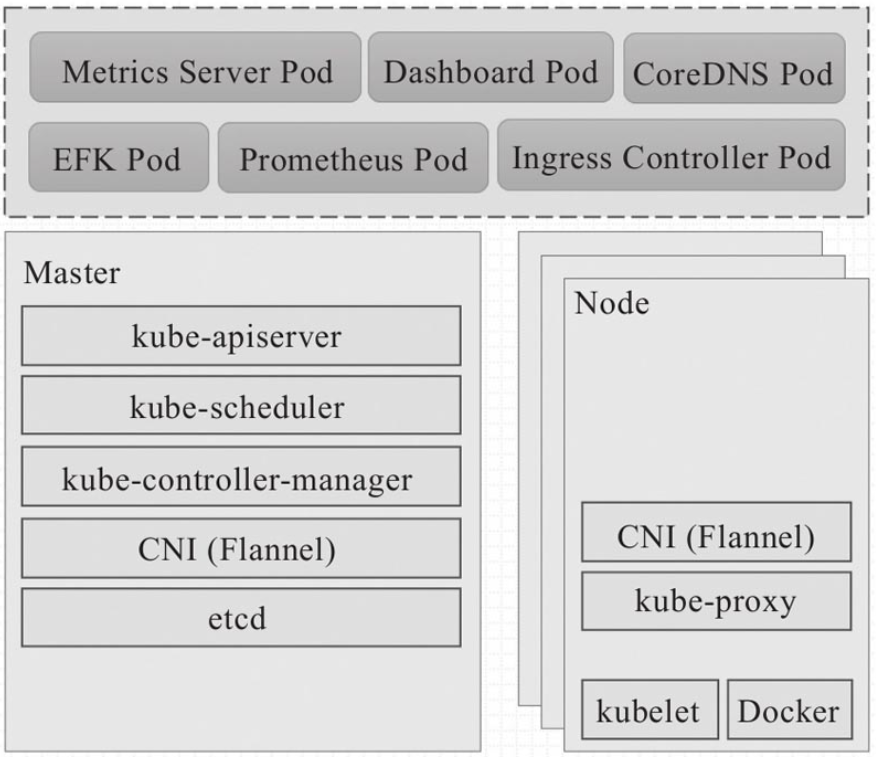
静态Pod模式:控制平面的各组件以静态
Pod对象形式运行在Master主机之上 , 而Node主机上的kubelet和Docker运行为系统级守护 进程 ,kube-proxy托管于集群上的DaemonSet控制器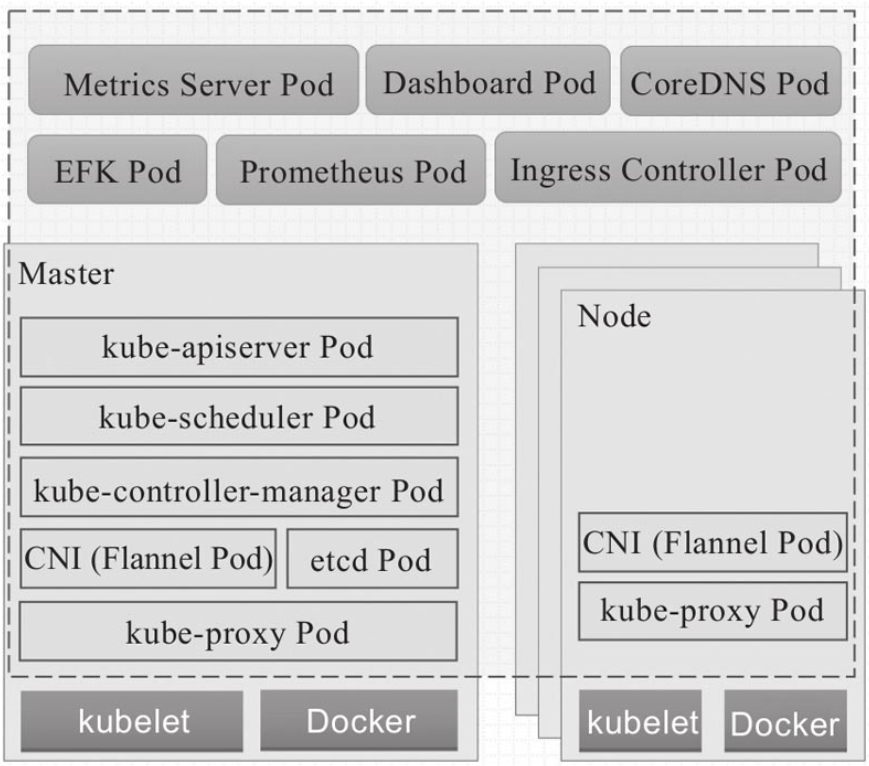
自托管(
self-hosted)模式 : 类似于第二种模式 , 但控制平面的各组件运行为Pod对象(非静态) , 并且这些Pod对象同样托管运 行在集群之上 , 且同样受控于DaemonSet类型的控制器。
使用kubeadm部署的Kubernetes集群可运行为第二种或第三种模式 , 默认为静态Pod对象模式 , 当需要使用自托管模式时 , 可使用 kubeadm init命令的--features-gates=selfHosting选项激活。在独立组件模式进行集群的构建时 , 需要把各组件运行在系统的独立守护 进程中 , 其间需要用到的证书及Token等认证信息也都需要手动生成 , 过程烦琐且极易出错 ; 若有必要 , 建议使用GitHub上的适当的项目辅助进行 , 例如通过Ansible Playbook进行自动部署等
1.3 kubeadm init工作流程
kubeadm拉起一个Kubernetes集群主要需要两个步骤 : 先在第一个 Master主机上运行kubeadm init命令初始化控制平面 , 待其完成后 , 在其他主机上运行kubeadm join命令逐一加入控制平面 , 进而成为集 群成员。
初始化一个控制平面需要一系列复杂的过程 , kubeadm init命令 将其分割成多个阶段逐一实现 , 例如环境预检(preflight)、启动 kubelet(kubelet-start)、为集群生成所需CA及数字证书(cert)等10多个阶段 , 各阶段的描述可参考kubeadm init --help命令提供的 配置信息。各阶段的简要说明如下。
preflight                      预置检查
certs                          生成认证
  /ca                          生成自签名的 Kubernetes CA , 为其他 Kubernetes 组件预配标识
  /apiserver                   生成用于提供 Kubernetes API 的证书 api server端证书
  /apiserver-kubelet-client    为 API 服务器生成证书以连接到 kubelet
  /front-proxy-ca              生成自签名 CA 以预配front proxy 标识
  /front-proxy-client          为前端代理客户端生成证书
  /etcd-ca                     生成自签名CA以为etcd配置标识
  /etcd-server                 生成 etcd 服务使用的的证书
  /etcd-peer                   为etcd节点生成证书以相互通信
  /etcd-healthcheck-client     生成liveness探针使用的证书 , 用于检查etcd 的 healtcheck 状态
  /apiserver-etcd-client       生成apiserver用于访问etcd的证书
  /sa                          生成用于对服务帐户令牌及其公钥进行签名的私钥
kubeconfig                     生成 control plane 和 admin 管理员相关的kubeconfig 文件
  /admin                       生成admin 管理员和kubeadm 自身使用的kubeconfig文件
  /kubelet                     生成kebelet使用的 , 仅用于引导集群(bootstrap)的kubeconfig 文件
  /controller-manager          生成 controller manager 使用的kubeconfig文件
  /scheduler                   生成 scheduler 使用的kubeconfig文件
etcd                           生成本地 ETCD的 static Pod manifest 文件
  /local                       生成单节点本地 ETCD static Pod manifest 文件
control-plane                  生成拉起 control plane(master)static Pod 的 manifest 文件
  /apiserver                   生成拉起 kube-apiserver 的 static Pod manifest
  /controller-manager          生成拉起 kube-controller-manager 的static Pod manifest
  /scheduler                   生成拉起 kube-scheduler 的 static Pod manifest
kubelet-start                  生成 kubelet 配置 , 并重启kubelet
upload-config                  上传kubeadm和kubelet配置为 ConfigMap
  /kubeadm                     上传 kubeadm ClusterConfiguration 为 ConfigMap
  /kubelet                     上传 kubelet component config 为 ConfigMap
upload-certs                   上传证书到 kubeadm-certs
mark-control-plane             标识节点为 control-plane
bootstrap-token                生成 bootstrap tokens 用于其他节点加入集群
kubelet-finalize               TLS引导后更新与kubelet相关的设置
  /experimental-cert-rotation  启用kubelet客户端证书轮换
addon                          安装所需的插件以通过一致性测试
  /coredns                     安装 CoreDNS 插件
  /kube-proxy                  安装 kube-proxy 插件
show-join-command 显示控制平面和辅助节点的联接命令各阶段还可由kubeadm init phase [PHASE]命令来分步 执行 , 或在必要时仅运行指定的阶段 , 例如kubeadm init phase preflight仅负责执行环境预检操作。此外 , kubeadm init命令还支持 众多选项设置其工作特性。
具体来说 , 针对各个阶段 , kubeadm init命令通过以下过程拉起Kubernetes的控制平面节点。
kubeadm init 命令通过执行下列步骤来启动一个 Kubernetes 控制平面节点。
在做出变更前运行一系列的预检项来验证系统状态。执行由众多步骤组成的环境预检操作 , 以确保节点配置能够满 足运行为
Master主机的条件。其中 , 有些错误仅触发警告 , 有些错误 则被判定为严重问题且必须纠正后才能继续。这些预检操作可能包括 如下内容探测并确定可用的CRI套接字以确定容器运行时环境
校验
Kubernetes和kubeadm的版本检查TCP端口
6443、10259和10257的可用性 ;检查
/etc/kubernetes/manifests目录下是否存在kube apiserver.yaml、kube-controller-manager.yaml、kube scheduler.yaml和etcd.yaml配置清单 ;检查
crictl是否存在且可执行 ;校验内核参数
net.bridge.bridge-nf-call-iptables和net.ipv4.ip_forward的值是否满足需求 ;检查
Swap设备是否处于启用状态检查
ip、iptables、mount、nsenter、ebtables、ethtool、socat、tc和touch等可执行程序是否存在 ;验证
kubelet的版本号以及服务是否处于启用(enable)和活动 (active)状态 ;验证TCP端口
10250、2379和2380是否可用 , 以及/var/lib/etcd目录是否存在与是否为空。
以上步骤出现任何一个严重错误都会导致
kubeadm init命令执行 过程提前中止 , 较为常见的严重错误有未禁用Swap设备、内核参数设 定不当、kubeadm和kubelet版本不匹配等。希望忽略特定类型的错误时 , 可以为该命令使用--ignore-preflight-errors选项进行指定生成一个自签名的
CA证书来为集群中的每一个组件建立身份标识。 用户可以通过将其放入--cert-dir配置的证书目录中(默认为/etc/kubernetes/pki) 来提供他们自己的CA证书以及/或者密钥。APIServer证书将为任何--apiserver-cert-extra-sans参数值提供附加的SAN条目 , 必要时将其小写。control-plane阶段将kubeconfig文件写入/etc/kubernetes/目录以便kubelet、控制器管理器和调度器用来连接到API服务器 , 它们每一个都有自己的身份标识。Kubernetes集群的各个组件以API Server为中心完成彼此间的协作 , 这些组件间通信时的身份认证和安全通信一般借助第2步中生成 的数字证书完成 , 但它们需要将相关的认证信息转换格式 , 并保存于kubeconfig配置文件中以便组件调用。kubeadm在kubeconfig步骤中生成如下4个kubeconfig文件。admin.conf: 由命令行客户端kubectl使用的配置文件 , 相应的用户(CN)会被识别为集群管理员。controller-manager.conf:kube-controller-manager专用的kubeconfig配置文件。kubelet.conf:当前节点上kubelet专用的kubeconfig配置文 件。scheduler.conf:kube-scheduler专用的kubeconfig配置文件。
为
API服务器、控制器管理器和调度器生成静态Pod的清单文件。假使没有提供一个外部的etcd服务的话 , 也会为etcd生成一份额外的静态Pod清单文件。静态
Pod的清单文件被写入到/etc/kubernetes/manifests目录 ; 当前主机上的kubelet服务会监视该目录中的配置清单的创建、 变动和删除等状态变动 , 并根据变动完成Pod创建、更新或删除操作。 因此 , 这两个阶段创建生成的各配置清单将会启动Master组件的相关Pod, 且kubeadm成功对localhost:6443/healthz这个URL进行健康状态 检查后才会进行后续的步骤。等到控制平面的各组件成功启动后 , 会进入
upload-config阶 段。这个阶段会将kubeadm和kubeconfig的配置存储为kube-system名称空间中的ConfigMap资源对象。而upload-certs阶段需要显式地由--upload-certs选项激活 , 它会将kubeadm的证书存储在Secret资源对象 中 , 以供后加入的其他Master节点使用。mark-control-plane阶段负责为当前主机打上node role.kubernetes.io/master=, 将其标记为Master, 并为该主机设置node-role.kubernetes.io/master:NoSchedule污点 , 以防止其他工作 负载Pod运行在当前主机上。对控制平面节点应用标签和污点标记以便不会在它上面运行其它的工作负载。bootstrap-token阶段会生成引导令牌 , 其他Node主机需要使 用该令牌在加入集群时与控制平面建立双向信任。换句话说 , 只要持 有Bootstrap Token, 任何节点都可使用kubeadm join命令加入该集 群。该令牌也可由kubeadm token命令进行查看、创建和删除等管理操 作。生成令牌 , 将来其他节点可使用该令牌向控制平面注册自己。如kubeadm token文档所述 , 用户可以选择通过--token提供令牌。kubelet-finalize阶段进行一些必要的配置 , 以允许节点通过Bootstrap Token或TLS Bootstrap机制加入集群中。这类配置包括: 生成ConfigMap, 设置RBAC以允许节点加入集群时能获取到必要的信息 ; 允许Bootstrap Token访问CSR签署API; 以及能够自动签署CSR请求等。最后一个阶段则是为集群添加必要的基本附件 , 如
CoreDNS和kube-proxy, 它们都以Pod形式托管运行在当前集群之上。通过API服务器安装一个DNS服务器 (CoreDNS) 和kube-proxy附加组件。 在Kubernetes v1.11和更高版本中 ,CoreDNS是默认的DNS服务器。 请注意 , 尽管已部署DNS服务器 , 但直到安装CNI时才调度它警告: 从
v1.18开始 , 在kubeadm中使用kube-dns的支持已被废弃 , 并已在v1.21版本中移除。
1.4 kubeadm join工作流程
由kubeadm init命令为构建的目标集群初始化第一个控制平面节 点之后即可在其他各主机上使用kubeadm join命令将其加入集群中。 根据用户的设定 , 新加入的主机可以成为新的Master主机(Master HA模式中的其他节点) , 也可以成为Worker主机(工作节点)。
preflight              预置检查
control-plane-prepare  为服务控制平面做好机器准备
  /download-certs        [实验]从kubeadm certs Secret下载控制平面节点之间共享的证书
  /certs                 生成新控制平面组件的证书
  /kubeconfig            为新的控制平面组件生成kubeconfig
  /control-plane         生成新控制平面组件的清单
kubelet-start          编写kubelet设置、证书并(重新)启动kubelet
control-plane-join     将计算机连接为控制平面实例
  /etcd                  添加新的本地etcd成员
  /update-status         将新的控制平面节点注册到kubeadm config ConfigMap中维护的ClusterStatus中(已弃用)
  /mark-control-plane    将节点标记为控制平面
kubeadm join命令也需要进行环境预检操作 , 以确定所在节点满 足可加入集群中的前提条件 , 这类关键检测的步骤包括:
探测并确定可用的CRI套接字以确定容器运行时环境 ;
检查
/etc/kubernetes/manifests目录下是否存在且是否为空 ;检查
/etc/kubernetes目录下kubelet.conf和bootstrap kubelet.conf文件是否存在 ;检查
crictl是否存在且可执行 ;校验内核参数
net.bridge.bridge-nf-call-iptables和net.ipv4.ip_forward的值是否满足需求 ;检查
Swap设备是否处于启用状态 ;检查
ip、iptables、mount、nsenter、ebtables、ethtool、socat、tc和touch等可执行程序是否存在 ;验证
kubelet的版本号以及服务是否处于启用和活动状态 ;检查TCP端口10250的可用性 ;
检查文件/etc/kubernetes/pki/ca.crt是否存在。
以上步骤出现任何一个严重错误都会导致kubeadm join命令执行 过程的中止 , 较为常见的严重错误有未禁用Swap设备和内核参数设定 不当等 , 不过--ignore-preflight-errors选项允许用户指定要忽略的 错误选项。
随后 , 同控制平面建立双向信任关系是新节点加入集群的关键一 步 , 这种双向信任可分为发现和TLS引导程序两个阶段。
发现阶段是让 新节点通过共享令牌(
Bootstrap Token)向指定的API Server发送请求以获取集群信息 ,Bootstrap Token可让节点确定API Server的身份 , 但无法确保信息传输过程的安全 , 因此还需要借助CA密钥哈希进 行数据真实性验证。TLS引导程序阶段是让控制平面借助TLS Bootstrap机制为新节点签发数字证书以信任请求加入的节点 , 具体过程是kubelet通过TLS Bootstrap使用共享令牌向API Server进行身份验证后提交证书并签署请求(CSR) , 随后在控制平面上自动签署该请 求从而生成数字证书
提示 : 发现阶段也可使用
kubeconfig格式的引导配置文件进行 , 该配置 文件可位于本地文件系统 , 也可通过URL获取。
接下来的过程会因新加入节点的不同角色而有所区别。kubeadm将为加入集群主机的工作节点基于接收到的数字证书生成kubelet.conf 配置文件 , 这样kubelet程序便能够以该配置文件接入到集群当中并进 行安全通信 , 再由kube-proxy的DaemonSet控制器为此节点启动kube proxy Pod , 至此 , 该过程完成。
若加入的是其他Master主机 , kubeadm join则会进行以下步骤。
从集群下载控制平面节点之间共享的数字证书 , 该证书在配置 第一个
Master的kubeadm init命令中的upload-certs阶段生成。运行
kubeadm init命令类型的预检操作 , 而后为新的控制平面 各组件生成静态Pod配置清单、证书和kubeconfig后 , 再由kubelet启动相应的静态Pod。更新
kubelet的配置信息并由其完成TLS Bootstrap。为本地运行的
etcd生成配置清单 , 由kubelet启动相应的静态Pod并将其添加为现有的etcd集群成员。将该节点的相关信息上传至
kube-system名称空间中的ConfigMap对象的kubeadm-config中。为该节点添加控制平面专用标签
node role.kubernetes.io/master=''和污点node role.kubernetes.io/master:NoSchedule。
在不同的节点上重复运行本节中描述的步骤 , 即可多次新增 Master或Node主机到集群中。
1.5 kubeadm配置文件
初始化集群的kubeadm init命令也可通过--config选项让配置文件接收配置信息 , 它支持InitConfiguration、 ClusterConfiguration、KubeProxyConfiguration和 KubeletConfiguration这4种配置类型 , 而且仅InitConfiguration或 ClusterConfiguration其中之一为强制要求提供的配置信息。
InitConfiguration提供运行时配置 , 用于配置Bootstrap Token及节点自身特有的设置 , 例如节点名称等。ClusterConfiguration定义集群配置 , 主要包括etcd、networking、kubernetesVersion、controlPlaneEndpoint、apiserver、controllerManager、scheduler、imageRepository和clusterName等。KubeProxyConfiguration定义要传递给kube-proxy的自定义配 置。KubeletConfiguration指定要传递给kubelet的自定义配置。 下面给出了一个完整的ClusterConfiguration的配置框架及各字 段的简要说明 , 为了节省篇幅 , 省略了controllerManager和scheduler中也可以额外配置的存储卷。
apiVersion: kubeadm.k8s.io/v1beta3
kind: InitConfiguration

apiVersion: kubeadm.k8s.io/v1beta3
kind: ClusterConfiguration

apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration

apiVersion: kubeproxy.config.k8s.io/v1alpha1
kind: KubeProxyConfiguration

apiVersion: kubeadm.k8s.io/v1beta3
kind: JoinConfiguration
版本参考链接: 配置 API | Kubernetes
要输出 "init" 和 "join" 动作的默认值 , 可以使用下面的命令:
kubeadm config print init-defaults
kubeadm config print join-defaultsInitConfiguration类型
InitConfiguration用来配置运行时设置 , 就kubeadm init命令而言 , 包括启动引导令牌以及所有与kubeadm所在节点相关的设置 , 包括:nodeRegistration:其中包含与向集群注册新节点相关的字段 ; 使用这个类型来定制节点名称、要使用的CRI套接字或者其他仅对当前节点起作用的设置 (例如节点 IP 地址)。localAPIEndpoint:代表的是要部署到此节点上的API服务器实例的端点 ; 使用这个类型可以完成定制 API 服务器公告地址这类操作。
apiVersion: kubeadm.k8s.io/v1beta3 kind: InitConfiguration bootstrapTokens: - token: "9a08jv.c0izixklcxtmnze7" description: "kubeadm bootstrap token" ttl: "24h" - token: "783bde.3f89s0fje9f38fhf" description: "another bootstrap token" usages: - authentication - signing groups: - system:bootstrappers:kubeadm:default-node-token nodeRegistration: name: "ec2-10-100-0-1" criSocket: "/var/run/dockershim.sock" taints: - key: "kubeadmNode" value: "someValue" effect: "NoSchedule" kubeletExtraArgs: v: 4 ignorePreflightErrors: - IsPrivilegedUser imagePullPolicy: "IfNotPresent" localAPIEndpoint: advertiseAddress: "10.100.0.1" bindPort: 6443 certificateKey: "e6a2eb8581237ab72a4f494f30285ec12a9694d750b9785706a83bfcbbbd2204" skipPhases: - addon/kube-proxyClusterConfiguration类型
ClusterConfiguration用来定制集群范围的设置 , 具体包括以下设置:networking:其中包含集群的网络拓扑配置。使用这一部分可以定制Pod的子网或者Service的子网。etcd:etcd 数据库的配置。例如使用这个部分可以定制本地 etcd 或者配置 API 服务器使用一个外部的 etcd 集群。kube-apiserver、kube-scheduler、kube-controller-manager配置:这些部分可以通过添加定制的设置或者重载kubeadm的默认设置来定制控制面组件。
apiVersion: kubeadm.k8s.io/v1beta3 kind: ClusterConfiguration etcd: # one of local or external local: imageRepository: "registry.k8s.io" imageTag: "3.2.24" dataDir: "/var/lib/etcd" extraArgs: listen-client-urls: "http://10.100.0.1:2379" serverCertSANs: - "ec2-10-100-0-1.compute-1.amazonaws.com" peerCertSANs: - "10.100.0.1" # external: # endpoints: # - "10.100.0.1:2379" # - "10.100.0.2:2379" # caFile: "/etcd/kubernetes/pki/etcd/etcd-ca.crt" # certFile: "/etcd/kubernetes/pki/etcd/etcd.crt" # keyFile: "/etcd/kubernetes/pki/etcd/etcd.key" networking: serviceSubnet: "10.96.0.0/16" podSubnet: "10.244.0.0/24" dnsDomain: "cluster.local" kubernetesVersion: "v1.21.0" controlPlaneEndpoint: "10.100.0.1:6443" apiServer: extraArgs: authorization-mode: "Node,RBAC" extraVolumes: - name: "some-volume" hostPath: "/etc/some-path" mountPath: "/etc/some-pod-path" readOnly: false pathType: File certSANs: - "10.100.1.1" - "ec2-10-100-0-1.compute-1.amazonaws.com" timeoutForControlPlane: 4m0s controllerManager: extraArgs: "node-cidr-mask-size": "20" extraVolumes: - name: "some-volume" hostPath: "/etc/some-path" mountPath: "/etc/some-pod-path" readOnly: false pathType: File scheduler: extraArgs: bind-address: "10.100.0.1" extraVolumes: - name: "some-volume" hostPath: "/etc/some-path" mountPath: "/etc/some-pod-path" readOnly: false pathType: File certificatesDir: "/etc/kubernetes/pki" imageRepository: "registry.k8s.io" clusterName: "example-cluster"KubeProxyConfigurationKubeProxyConfiguration类型用来更改传递给在集群中部署的kube-proxy实例的配置。 如果此对象没有提供 , 或者仅部分提供 ,kubeadm使用默认值。apiVersion: kubeproxy.config.k8s.io/v1alpha1 kind: KubeProxyConfiguration clusterCIDR: "10.244.0.0/16" # 启用 ipvs 模式 mode: "ipvs" ipvs: # 如果node提供lvs服务 , 排除以下CIDR 不受kube-proxy管理 , 避免刷掉lvs规则 excludeCIDRs: [1.1.1.0/24,2.2.2.0/24] minSyncPeriod: 5s syncPeriod: 5s # ipvs 负载策略 scheduler: "wrr"更多参考链接:
v1alpha1 package - k8s.io/kube-proxy/config/v1alpha1 - Go Packages
KubeleteCOnfigurationKubeletConfiguration类型用来更改传递给在集群中部署的kubelet实例的配置。 如果此对象没有提供 , 或者仅部分提供 ,kubeadm使用默认值。apiVersion: kubelet.config.k8s.io/v1beta1 kind: KubeletConfiguration failSwapOn: false #禁用swap检测 cgroupDriver: systemd #修改driver为systemd rotateCertificates: true # 开启证书轮询更多的配置参数查看官方文档:
v1beta1 package - k8s.io/kubelet/config/v1beta1 - Go Packages
init完整示例
apiVersion: kubeadm.k8s.io/v1beta3
kind: InitConfiguration
bootstrapTokens:
  - token: "9a08jv.c0izixklcxtmnze7"
    description: "kubeadm bootstrap token"
    ttl: "24h"
  - token: "783bde.3f89s0fje9f38fhf"
    description: "another bootstrap token"
    usages:
      - authentication
      - signing
    groups:
      - system:bootstrappers:kubeadm:default-node-token
nodeRegistration:
  name: "ec2-10-100-0-1"
  criSocket: "/var/run/dockershim.sock"
  taints:
    - key: "kubeadmNode"
      value: "someValue"
      effect: "NoSchedule"
  kubeletExtraArgs:
    v: 4
  ignorePreflightErrors:
    - IsPrivilegedUser
  imagePullPolicy: "IfNotPresent"
localAPIEndpoint:
  advertiseAddress: "10.100.0.1"
  bindPort: 6443
certificateKey: "e6a2eb8581237ab72a4f494f30285ec12a9694d750b9785706a83bfcbbbd2204"
skipPhases:
  - addon/kube-proxy
---
apiVersion: kubeadm.k8s.io/v1beta3
kind: ClusterConfiguration
etcd:
  # one of local or external
  local:
    imageRepository: "registry.k8s.io"
    imageTag: "3.2.24"
    dataDir: "/var/lib/etcd"
    extraArgs:
      listen-client-urls: "http://10.100.0.1:2379"
    serverCertSANs:
      -  "ec2-10-100-0-1.compute-1.amazonaws.com"
    peerCertSANs:
      - "10.100.0.1"
  # external:
    # endpoints:
    # - "10.100.0.1:2379"
    # - "10.100.0.2:2379"
    # caFile: "/etcd/kubernetes/pki/etcd/etcd-ca.crt"
    # certFile: "/etcd/kubernetes/pki/etcd/etcd.crt"
    # keyFile: "/etcd/kubernetes/pki/etcd/etcd.key"
networking:
  serviceSubnet: "10.96.0.0/16"
  podSubnet: "10.244.0.0/24"
  dnsDomain: "cluster.local"
kubernetesVersion: "v1.21.0"
controlPlaneEndpoint: "10.100.0.1:6443"
apiServer:
  extraArgs:
    authorization-mode: "Node,RBAC"
  extraVolumes:
    - name: "some-volume"
      hostPath: "/etc/some-path"
      mountPath: "/etc/some-pod-path"
      readOnly: false
      pathType: File
  certSANs:
    - "10.100.1.1"
    - "ec2-10-100-0-1.compute-1.amazonaws.com"
  timeoutForControlPlane: 4m0s
controllerManager:
  extraArgs:
    "node-cidr-mask-size": "20"
  extraVolumes:
    - name: "some-volume"
      hostPath: "/etc/some-path"
      mountPath: "/etc/some-pod-path"
      readOnly: false
      pathType: File
scheduler:
  extraArgs:
    bind-address: "10.100.0.1"
  extraVolumes:
    - name: "some-volume"
      hostPath: "/etc/some-path"
      mountPath: "/etc/some-pod-path"
      readOnly: false
      pathType: File
certificatesDir: "/etc/kubernetes/pki"
imageRepository: "registry.k8s.io"
clusterName: "example-cluster"
---
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
# kubelet specific options here
# 此配置保证了 kubelet 能在 swap 开启的情况下启动
failSwapOn: false
nodeStatusUpdateFrequency: 5s
# 一些驱逐阀值 , 具体自行查文档修改
evictionSoft:
  "imagefs.available": "15%"
  "memory.available": "512Mi"
  "nodefs.available": "15%"
  "nodefs.inodesFree": "10%"
evictionSoftGracePeriod:
  "imagefs.available": "3m"
  "memory.available": "1m"
  "nodefs.available": "3m"
  "nodefs.inodesFree": "1m"
evictionHard:
  "imagefs.available": "10%"
  "memory.available": "256Mi"
  "nodefs.available": "10%"
  "nodefs.inodesFree": "5%"
evictionMaxPodGracePeriod: 30
imageGCLowThresholdPercent: 70
imageGCHighThresholdPercent: 80
kubeReserved:
  "cpu": "500m"
  "memory": "512Mi"
  "ephemeral-storage": "1Gi"
rotateCertificates: true
---
apiVersion: kubeproxy.config.k8s.io/v1alpha1
kind: KubeProxyConfiguration
# kube-proxy specific options here
clusterCIDR: "10.244.0.0/16"
# 启用 ipvs 模式
mode: "ipvs"
ipvs:
  # 如果node提供lvs服务 , 排除以下CIDR 不受kube-proxy管理 , 避免kube-proxy刷掉lvs规则
  excludeCIDRs: [1.1.1.0/24,2.2.2.0/24]
  minSyncPeriod: 5s
  syncPeriod: 5s
  # ipvs 负载策略
  scheduler: "wrr"
2. 安装流程
kubeadm参考官网网站:
Creating a cluster with kubeadm | Kubernetes
使用 kubeadm , 你能创建一个符合最佳实践的最小化 Kubernetes 集群。 事实上 , 你可以使用 kubeadm 配置一个通过 Kubernetes 一致性测试的集群。 kubeadm 还支持其他集群生命周期功能 , 例如启动引导令牌和集群升级。
Kubeadm 是一个无需复杂配置即可设置最小可行 Kubernetes 集群的工具。此外 , Kubeadm 通过运行一系列预检查来简化整个过程 , 以确保服务器具有运行 Kubernetes 所需的所有基本组件和配置。它由官方 Kubernetes 社区开发和维护。还有其他部署工具 , 如 minikube、kind 等 , 它们非常容易部署
kubeadm 工具很棒 , 如果你需要:
一个尝试
Kubernetes的简单方法。一个现有用户可以自动设置集群并测试其应用程序的途径。
其他具有更大范围的生态系统和/或安装工具中的构建模块。
你可以在各种机器上安装和使用 kubeadm: 笔记本电脑、一组云服务器、Raspberry Pi 等。 无论是部署到云还是本地 , 你都可以将 kubeadm 集成到 Ansible 或 Terraform 这类预配置系统中。
先决条件
一台兼容的
Linux主机。Kubernetes项目为基于Debian和Red Hat的Linux发行版以及一些不提供包管理器的发行版提供通用的指令。每台机器
2 GB或更多的RAM(如果少于这个数字将会影响你应用的运行内存)。CPU 2核心及以上。集群中的所有机器的网络彼此均能相互连接(公网和内网都可以)。
节点之中不可以有重复的主机名、
MAC地址或product_uuid。你可以使用命令
ip link或ifconfig -a来获取网络接口的MAC地址可以使用
sudo cat /sys/class/dmi/id/product_uuid命令对product_uuid校验
开启机器上的某些端口。
控制面
尽管
etcd的端口也列举在控制面的部分 , 但你也可以在外部自己托管etcd集群或者自定义端口。工作节点
所有默认端口都可以重新配置。当使用自定义的端口时 , 你需要打开这些端口来代替这里提到的默认端口。
一个常见的例子是
API服务器的端口有时会配置为443。或者你也可以使用默认端口 , 把API服务器放到一个监听443端口的负载均衡器后面 , 并且路由所有请求到API服务器的默认端口。交换分区的配置。
kubelet的默认行为是在节点上检测到交换内存时无法启动。kubelet自v1.22起已开始支持交换分区。自v1.28起 , 仅针对cgroup v2支持交换分区 ;kubelet的NodeSwap特性门控处于Beta阶段 , 但默认被禁用。如果
kubelet未被正确配置使用交换分区 , 则你必须禁用交换分区。 例如 ,sudo swapoff -a将暂时禁用交换分区。要使此更改在重启后保持不变 , 请确保在如/etc/fstab、systemd.swap等配置文件中禁用交换分区 , 具体取决于你的系统如何配置。
部署架构图
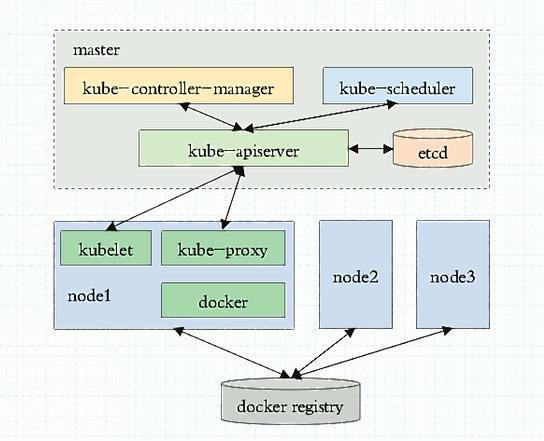
当前部署版本为当前次新版本 , 因为后面需要使用kubeadm做kubernetes版本升级演示。 目前官方最新版本为1.29.4 , 因此本次先以1.29.3版本kubernetes为例。
基础环境准备
部署
harbor及haproxy高可用反向代理在所有
master安装指定版本的kubeadm、kubelet、kubectl、docker在所有
node节点安装指定版本的kubeadm、kubelet、docker, 在node节点kubectl为 可选安装 , 看是否需要在node执行kubectl命令进行集群管理及pod管理等操作。master节点运行kubeadm init初始化命令验证
master节点状态在
node节点使用kubeadm命令将自己加入k8s master(需要使用master生成token认 证)验证
node节点状态创建
pod并测试网络通信部署
web服务Dashboardk8s集群升级
2.1 基础环境准备
服务器环境: 最小化安装基础系统 , 并关闭防火墙 selinux和swap , 更新软件源、时间同步、安装常用命令 , 重启后验证基础配置
修改这些节点主机名
加载桥接模块
修改
iptables内生的桥接相关功能 , 已经默认开启了 , 没开启的自行开启root@node03:~# lsmod | grep br_netfilter root@node03:~# modprobe br_netfilter root@node03:~# lsmod | grep br_netfilter br_netfilter 32768 0 bridge 307200 1 br_netfilter root@node03:~# cat /etc/sysctl.conf net.bridge.bridge-nf-call-ip6tables = 1 net.bridge.bridge-nf-call-iptables = 1 root@node03:~# sysctl -p net.bridge.bridge-nf-call-ip6tables = 1 net.bridge.bridge-nf-call-iptables = 1加载
ip_vs内核模块安装对应软件包
root@kubeadm-master1:/etc/kubernetes# apt install ipset ipvsadm如果
kube-proxy模式为ip_vs则必须加载modprobe ip_vs modprobe ip_vs_rr modprobe ip_vs_wrr modprobe ip_vs_sh modprobe nf_conntrack_ipv4设置下次开机自动加载
#ubuntu配置
cat > /etc/modules-load.d/ip_vs.conf << EOF
ip_vs
ip_vs_rr
ip_vs_wrr
ip_vs_sh
nf_conntrack_ipv4
EOF

#centos配置
cat > /etc/sysconfig/modules/ipvs.modules <<EOF
modprobe -- ip_vs
modprobe -- ip_vs_rr
modprobe -- ip_vs_wrr
modprobe -- ip_vs_sh
modprobe -- nf_conntrack_ipv4
EOF
所有节点修改hosts文件
cat  >> /etc/hosts << EOF
192.168.71.29 kubeadm-master1.cbear.top
192.168.71.30 kubeadm-master2.cbear.top
192.168.71.31 kubeadm-master3.cbear.top
192.168.71.32 ha1.cbear.top
192.168.71.33 ha2.cbear.top
192.168.71.34 harbor.cbear.top
192.168.71.35 node01.cbear.top
192.168.71.36 node02.cbear.top
192.168.71.37 node03.cbear.top
EOF
所有节点禁用
swap。如果开启了swap分区 ,kubelet会启动失败(可以通过将参数--fail-swap-on设置为false来忽略swap on) , 故需要在每台机器上关闭swap分区 :例如:
kubelet在1.8版本以后强制要求swap必须关闭否则会报错 :
Running with swap on is not supported, please disable swap! or set --fail-swap-on flag to false或者kubeadm init时会报错:
[ERROR Swap]: running with swap on is not supported. Please disable swap关闭操作如下:
#临时关闭swap
swapoff -a
为了防止开机自动挂载
swap分区 , 可以注释/etc/fstab中相应的条目:#centos注释命令 sudo sed -i '/ swap / s/^\(.*\)$/#\1/g' /etc/fstab #ubuntz注释命令 sed -i '/^#/! s/^\(.*swap.*\)/#\1/' /etc/fstab
2.2 harbor及反向代理
在
ha1,ha2节点上安装并配置keepalivedroot@ha1:~# apt install keepalived root@ha1:~# cat /etc/keepalived/keepalived.conf ! Configuration File for keepalived global_defs { notification_email { acassen@firewall.loc failover@firewall.loc sysadmin@firewall.loc } notification_email_from Alexandre.Cassen@firewall.loc smtp_server 192.168.200.1 smtp_connect_timeout 30 router_id LVS_DEVEL vrrp_skip_check_adv_addr } vrrp_instance VI_1 { state MASTER interface ens3 virtual_router_id 51 priority 100 advert_int 1 authentication { auth_type PASS auth_pass 1111 } virtual_ipaddress { 192.168.71.150 dev ens3 lable ens3:1 } } root@ha2:~# apt install keepalived root@ha2:~# cat /etc/keepalived/keepalived.conf ! Configuration File for keepalived global_defs { notification_email { acassen } notification_email_from Alexandre.Cassen@firewall.loc smtp_server 192.168.200.1 smtp_connect_timeout 30 router_id LVS_DEVEL vrrp_skip_check_adv_addr vrrp_garp_interval 0 vrrp_gna_interval 0 } vrrp_instance VI_1 { state SLAVE interface ens3 virtual_router_id 51 priority 100 advert_int 1 authentication { auth_type PASS auth_pass 1111 } virtual_ipaddress { 192.168.71.150 dev ens3 lable ens3:1 } } root@ha1:~# systemctl restart keepalived root@ha2:~# systemctl restart keepalived配置
haproxy,ha1和ha2的haproxy配置相同root@ha1:~# apt install haproxy root@ha2:~# apt install haproxy root@ha2:~# vi /etc/sysctl.conf net.ipv4.ip_nonlocal_bind = 1 root@ha2:~# sysctl -p net.ipv4.ip_nonlocal_bind = 1 root@ha2:~# cat /etc/haproxy/haproxy.cfg defaults log global mode http option httplog option dontlognull timeout connect 5000 timeout client 50000 timeout server 50000 errorfile 400 /etc/haproxy/errors/400.http errorfile 403 /etc/haproxy/errors/403.http errorfile 408 /etc/haproxy/errors/408.http errorfile 500 /etc/haproxy/errors/500.http errorfile 502 /etc/haproxy/errors/502.http errorfile 503 /etc/haproxy/errors/503.http errorfile 504 /etc/haproxy/errors/504.http listen stats mode http bind 0.0.0.0:9999 stats enable log global stats uri /haproxy-status stats auth haadmin:123456 listen k8s-6443 bind 192.168.71.150:6443 mode tcp balance roundrobin server 192.168.71.29 192.168.71.29:6443 check inter 2s fall 3 rise 5 server 192.168.71.30 192.168.71.30:6443 check inter 2s fall 3 rise 5 server 192.168.71.31 192.168.71.31:6443 check inter 2s fall 3 rise 5在
harbor节点上面配置harbor服务#最开始需要安装好docker环境 root@harbor:~# tar -xf harbor-offline-installer-v2.9.4.tgz -C /usr/local/ root@harbor:~# cd /usr/local/harbor/ root@harbor:/usr/local/harbor# cp harbor.yml.tmpl harbor.yml root@harbor:/usr/local/harbor# vi harbor.yml #修改hostname主机名和注释掉https配置 hostname: harbor.cbear.top # http related config http: # port for http, default is 80. If https enabled, this port will redirect to https port port: 80 # https related config #https: # https port for harbor, default is 443 # port: 443 # The path of cert and key files for nginx #certificate: /your/certificate/path #private_key: /your/private/key/path root@harbor:/usr/local/harbor# ./prepare root@harbor:/usr/local/harbor# ./install.sh
2.3 安装kubeadm组件
在master和node节点安装kubeadm 、kubelet、kubectl、docker等软件。
2.3.1 所有节点安装docker
直接使用阿里云默认安装配置
# step 1: 安装必要的一些系统工具
sudo apt-get update
sudo apt-get -y install apt-transport-https ca-certificates curl software-properties-common
# step 2: 安装GPG证书
curl -fsSL https://mirrors.aliyun.com/docker-ce/linux/ubuntu/gpg | sudo apt-key add -
# Step 3: 写入软件源信息
sudo add-apt-repository "deb [arch=amd64] https://mirrors.aliyun.com/docker-ce/linux/ubuntu $(lsb_release -cs) stable"
# Step 4: 更新并安装Docker-CE
sudo apt-get -y update
sudo apt-get -y install docker-ce

# 安装指定版本的Docker-CE:
# Step 1: 查找Docker-CE的版本:
# apt-cache madison docker-ce
#   docker-ce | 17.03.1~ce-0~ubuntu-xenial | https://mirrors.aliyun.com/docker-ce/linux/ubuntu xenial/stable amd64 Packages
#   docker-ce | 17.03.0~ce-0~ubuntu-xenial | https://mirrors.aliyun.com/docker-ce/linux/ubuntu xenial/stable amd64 Packages
# Step 2: 安装指定版本的Docker-CE: (VERSION例如上面的17.03.1~ce-0~ubuntu-xenial)
# sudo apt-get -y install docker-ce=[VERSION]
master节点配置docker加速器以及信任harbor镜像仓库
sudo mkdir -p /etc/docker
sudo tee /etc/docker/daemon.json <<-'EOF'

{
  "registry-mirrors": ["https://z3oy2xcw.mirror.aliyuncs.com"],
  "insecure-registries" : ["harbor.cbear.top"]
}

EOF
sudo systemctl daemon-reload
sudo systemctl restart docker
2.3.2 安装并配置cri-dockerd插件
从 k8s 1.24开始 , dockershim已经从kubelet中移除 , 但因为历史问题docker却不支持kubernetes主推的CRI(容器运行时接口)标准 , 所以docker不能再作为k8s的容器运行时了 , 即从k8s v1.24开始不再使用docker了 但是如果想继续使用docker的话 , 可以在kubelet和docker之间加上一个中间层cri-docker。cri-docker是一个支持CRI标准的shim(垫片)。一头通过CRI跟kubelet交互 , 另一头跟docker api交互 , 从而间接的实现了kubernetes以docker作为容器运行时。但是这种架构缺点也很明显 , 调用链更长 , 效率更低。 本文采用了cri-docker的使用 , 但是更推荐使用containerd作为k8s的容器运行时
Releases · Mirantis/cri-dockerd (github.com)
这里centos系统可以直接安装对应的rpm包
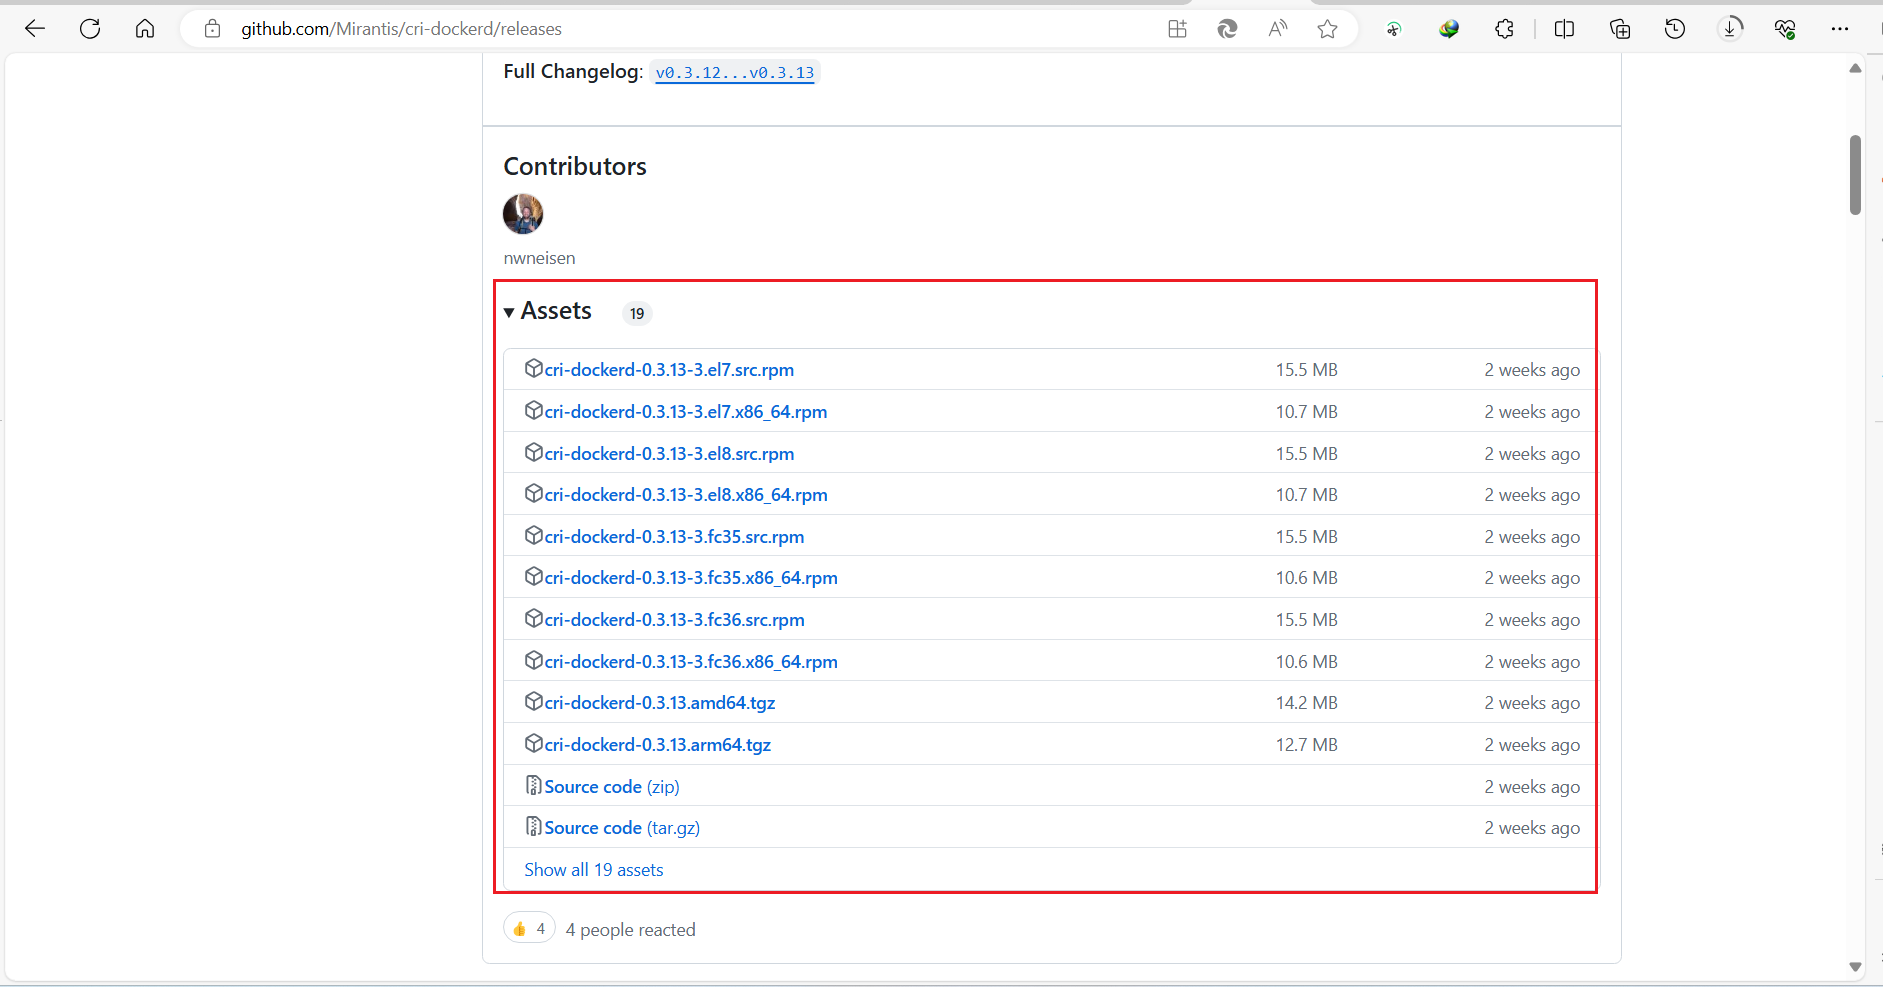
下载并解压对应
cir-dockerd文件root@kubeadm-master1:~# tar -xf cri-dockerd-0.3.13.amd64.tgz root@kubeadm-master1:~# ls cri-dockerd cri-dockerd-0.3.13.amd64.tgz install-kubeadm.sh install.sh pullimage.sh snap root@kubeadm-master1:~# ll cri-dockerd total 46852 drwxr-xr-x 2 1001 docker 4096 Apr 19 21:58 ./ drwx------ 7 root root 4096 May 3 09:06 ../ -rwxr-xr-x 1 1001 docker 47968256 Apr 19 21:58 cri-dockerd* root@kubeadm-master1:~# cp cri-dockerd/cri-dockerd /usr/local/bin/ root@kubeadm-master1:~# scp /usr/local/bin/cri-dockerd root@192.168.71.30:/usr/local/bin root@kubeadm-master1:~# scp /usr/local/bin/cri-dockerd root@192.168.71.31:/usr/local/bin root@kubeadm-master1:~# scp /usr/local/bin/cri-dockerd root@192.168.71.32:/usr/local/bin root@kubeadm-master1:~# scp /usr/local/bin/cri-dockerd root@192.168.71.35:/usr/local/bin root@kubeadm-master1:~# scp /usr/local/bin/cri-dockerd root@192.168.71.36:/usr/local/bin root@kubeadm-master1:~# scp /usr/local/bin/cri-dockerd root@192.168.71.37:/usr/local/bin手动配置对应的
systemd文件。具体的systemd文件可以通过对应的rpm软件包中获取对应systemd文件。cat > /lib/systemd/system/cri-docker.service <<EOF [Unit] Description=CRI Interface for Docker Application Container Engine Documentation=https://docs.mirantis.com After=network-online.target firewalld.service docker.service Wants=network-online.target Requires=cri-docker.socket [Service] Type=notify ExecStart=/usr/local/bin/cri-dockerd --network-plugin=cni --pod-infra-container-image=registry.aliyuncs.com/google_containers/pause:3.7 ExecReload=/bin/kill -s HUP $MAINPID TimeoutSec=0 RestartSec=2 Restart=always StartLimitBurst=3 StartLimitInterval=60s LimitNOFILE=infinity LimitNPROC=infinity LimitCORE=infinity TasksMax=infinity Delegate=yes KillMode=process [Install] WantedBy=multi-user.target EOF #所有节点配置cri-docker.socket文件 cat > /etc/systemd/system/cri-docker.socket <<EOF [Unit] Description=CRI Docker Socket for the API PartOf=cri-docker.service [Socket] ListenStream=%t/cri-dockerd.sock SocketMode=0660 SocketUser=root SocketGroup=docker [Install] WantedBy=sockets.target EOFcri-dockerd是Docker的CRI(Container Runtime Interface)实现 , 用于与Kubernetes集群交互。在使用Docker作为Kubernetes集群的容器运行时 ,cri-dockerd会处理来自kubelet的请求 , 创建和运行Pod以及容器。--pod-infra-container-image参数是cri-dockerd(或更准确地说 , 是Docker的CRI插件)的一个配置选项 , 它指定了用于每个 Pod 的基础设施容器(infra container)的镜像。基础设施容器是Kubernetes中的一个特殊容器 , 它为Pod提供网络和IPC命名空间 , 并且对于Pod中的其他容器来说是必需的。默认情况下 ,
Kubernetes使用官方的pause镜像 , 版本为3.9。这个镜像非常小 , 因为它不需要做任何事情 , 只是“暂停”(这就是它名字的由来)。这个容器通常不会对用户应用程序产生任何影响 , 但它对于Kubernetes管理网络和IPC命名空间是必要的。启动对应服务
root@node03:~# systemctl daemon-reload
root@node03:~# systemctl enable --now cri-docker cri-docker.socket
Created symlink /etc/systemd/system/multi-user.target.wants/cri-docker.service → /lib/systemd/system/cri-docker.service.
Created symlink /etc/systemd/system/sockets.target.wants/cri-docker.socket → /etc/systemd/system/cri-docker.socket.
2.3.3 安装kubeadm
所有节点配置阿里云仓库地址并安装相关组件 , node节点可选安装kubectl
配置镜像仓库
apt-get update && apt-get install -y apt-transport-https
curl -fsSL https://mirrors.aliyun.com/kubernetes-new/core/stable/v1.29/deb/Release.key |
    gpg --dearmor -o /etc/apt/keyrings/kubernetes-apt-keyring.gpg
echo "deb [signed-by=/etc/apt/keyrings/kubernetes-apt-keyring.gpg] https://mirrors.aliyun.com/kubernetes-new/core/stable/v1.29/deb/ /" |
    tee /etc/apt/sources.list.d/kubernetes.list
apt-get update
查看
kubeadm版本root@kubeadm-master3:~# apt-cache madison kubeadm kubeadm | 1.29.4-2.1 | https://mirrors.aliyun.com/kubernetes-new/core/stable/v1.29/deb Packages kubeadm | 1.29.3-1.1 | https://mirrors.aliyun.com/kubernetes-new/core/stable/v1.29/deb Packages kubeadm | 1.29.2-1.1 | https://mirrors.aliyun.com/kubernetes-new/core/stable/v1.29/deb Packages kubeadm | 1.29.1-1.1 | https://mirrors.aliyun.com/kubernetes-new/core/stable/v1.29/deb Packages kubeadm | 1.29.0-1.1 | https://mirrors.aliyun.com/kubernetes-new/core/stable/v1.29/deb Packages所有服务器点安装
kubeletkubeadmkubectl:root@kubeadm-master1:~# apt install kubeadm=1.29.3-1.1 kubectl=1.29.3-1.1 kubelet=1.29.3-1.1所有节点启动并验证
kubeletsystemctl enable --now kubelet验证
kubeadm版本root@kubeadm-master1:~# kubeadm version kubeadm version: &version.Info{Major:"1", Minor:"29", GitVersion:"v1.29.3", GitCommit:"6813625b7cd706db5bc7388921be03071e1a492d", GitTreeState:"clean", BuildDate:"2024-03-15T00:06:16Z", GoVersion:"go1.21.8", Compiler:"gc", Platform:"linux/amd64"}
2.3.4 master节点初始化
2.3.4.1 初始化环境准备
在三台master中任意一台master 进行集群初始化 , 而且集群初始化只需要初始化一次。
验证
kubeadm版本root@kubeadm-master1:~# kubeadm version kubeadm version: &version.Info{Major:"1", Minor:"29", GitVersion:"v1.29.3", GitCommit:"6813625b7cd706db5bc7388921be03071e1a492d", GitTreeState:"clean", BuildDate:"2024-03-15T00:06:16Z", GoVersion:"go1.21.8", Compiler:"gc", Platform:"linux/amd64"}准备镜像
root@kubeadm-master1:~# kubeadm config images list --kubernetes-version v1.29.3 registry.k8s.io/kube-apiserver:v1.29.3 registry.k8s.io/kube-controller-manager:v1.29.3 registry.k8s.io/kube-scheduler:v1.29.3 registry.k8s.io/kube-proxy:v1.29.3 registry.k8s.io/coredns/coredns:v1.11.1 registry.k8s.io/pause:3.9 registry.k8s.io/etcd:3.5.12-0master节点镜像下载推荐提前在
master节点下载镜像以减少安装等待时间 , 但是镜像默认使用Google的镜像仓 库 , 所以国内无法直接下载 , 但是可以通过阿里云的镜像仓库把镜像先提前下载下来 , 可以 避免后期因镜像下载异常而导致k8s部署异常。 之后将对应镜像上传至harbor本地镜像仓库中root@kubeadm-master1:~# cat pullimage.sh #!/bin/bash docker pull registry.cn-hangzhou.aliyuncs.com/google_containers/kube-apiserver:v1.29.3 docker pull registry.cn-hangzhou.aliyuncs.com/google_containers/kube-controller-manager:v1.29.3 docker pull registry.cn-hangzhou.aliyuncs.com/google_containers/kube-scheduler:v1.29.3 docker pull registry.cn-hangzhou.aliyuncs.com/google_containers/kube-proxy:v1.29.3 docker pull registry.cn-hangzhou.aliyuncs.com/google_containers/coredns:v1.11.1 docker pull registry.cn-hangzhou.aliyuncs.com/google_containers/pause:3.9 docker pull registry.cn-hangzhou.aliyuncs.com/google_containers/etcd:3.5.12-0 docker tag registry.cn-hangzhou.aliyuncs.com/google_containers/kube-apiserver:v1.29.3 harbor.cbear.top/google_containers/kube-apiserver:v1.29.3 docker tag registry.cn-hangzhou.aliyuncs.com/google_containers/kube-controller-manager:v1.29.3 harbor.cbear.top/google_containers/kube-controller-manager:v1.29.3 docker tag registry.cn-hangzhou.aliyuncs.com/google_containers/kube-scheduler:v1.29.3 harbor.cbear.top/google_containers/kube-scheduler:v1.29.3 docker tag registry.cn-hangzhou.aliyuncs.com/google_containers/kube-proxy:v1.29.3 harbor.cbear.top/google_containers/kube-proxy:v1.29.3 docker tag registry.cn-hangzhou.aliyuncs.com/google_containers/coredns:v1.11.1 harbor.cbear.top/google_containers/coredns:v1.11.1 docker tag registry.cn-hangzhou.aliyuncs.com/google_containers/pause:3.9 harbor.cbear.top/google_containers/pause:3.9 docker tag registry.cn-hangzhou.aliyuncs.com/google_containers/etcd:3.5.12-0 harbor.cbear.top/google_containers/etcd:3.5.12-0 docker push harbor.cbear.top/google_containers/kube-apiserver:v1.29.3 docker push harbor.cbear.top/google_containers/kube-controller-manager:v1.29.3 docker push harbor.cbear.top/google_containers/kube-scheduler:v1.29.3 docker push harbor.cbear.top/google_containers/kube-proxy:v1.29.3 docker push harbor.cbear.top/google_containers/coredns:v1.11.1 docker push harbor.cbear.top/google_containers/pause:3.9 docker push harbor.cbear.top/google_containers/etcd:3.5.12-0
2.3.4.2 单节点master初始化
单节点
master初始化 。这里--image-repository镜像仓库指定为阿里云镜像仓库registry.cn-hangzhou.aliyuncs.com/google_containers, 同时也可以指定本地刚上传的镜像仓库root@kubeadm-master1:~# kubeadm init --apiserver-advertise-address=192.168.71.29 --apiserver-bind-port=6443 --kubernetes-version=v1.29.3 --pod-network-cidr=10.10.0.0/16 --service-cidr=10.20.0.0/16 --service-dns-domain=cbear.local --image-repository=harbor.cbear.top/google_containers --ignore-preflight-errors=swap --cri-socket /var/run/cri-dockerd.sock--image-repository=registry.aliyuncs.com/google_containers # 将下载容器镜像源替换为阿里云 , 否则因为网络原因会导致镜像拉不下来 , 一定会执行不成功。 --cri-socket=unix:///var/run/cri-dockerd.sock # 这是指定容器运行时 , 因为containerd也是Docker的组件之一 , 下载Docker会一并将containerd下载下来 , 在执行初始化时当Kubernetes检测到有多个容器运行时环境 , 就必须要手动选择一个。这里也可以看出containerd实际上比Docker更轻量得多。 --apiserver-advertise-address=192.168.56.50 # 为API server设置广播地址 , 这里选择本机的ipv4地址 , 这里不希望API SERVER设置在其他node上的话就不要改为其他地址。 --pod-network-cidr=10.10.0.0/16 # 指明 pod 网络可以使用的 IP 地址段 , 暂时不清楚的可以先不管就用这个值。 --service-cidr=10.20.0.0/16 # 为服务的虚拟 IP 地址另外指定 IP 地址段 , 暂时不清楚的可以先不管就用这个值。由于新版无法直接使用
docker的container的runtime, 会直接提示如下内容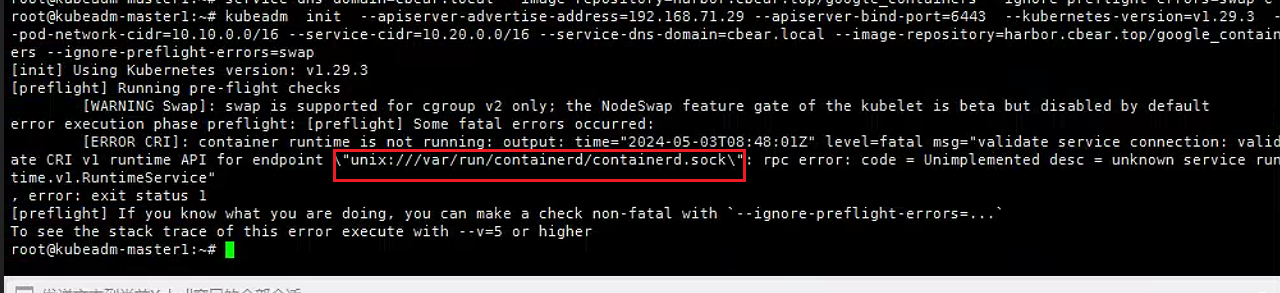
出现以下内容才算初始化成功 , 一定要记得将
swap进行关闭 , 否则初始化不成功!!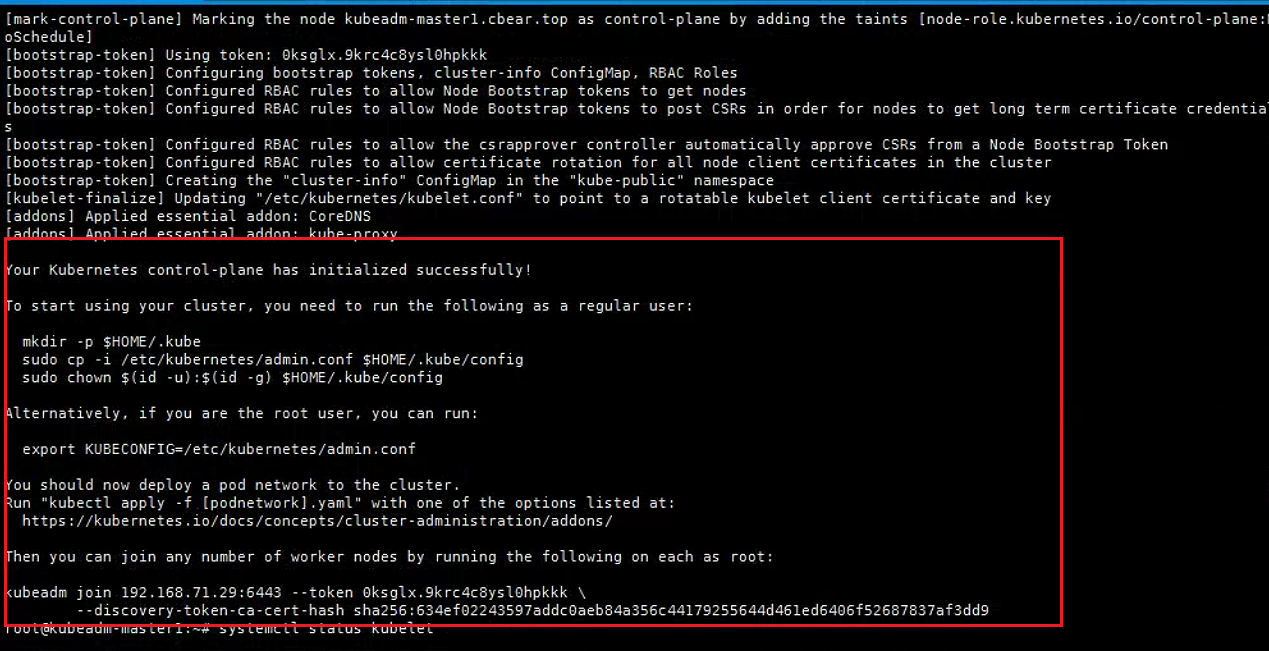
2.3.4.3 高可用 master 初始化
首先基于keepalived 实现高可用VIP , 然后实现三台 k8s master基于VIP实现高可用。
2.3.4.3.1 基于命令初始化高可用master方式
重置
master节点配置文件root@kubeadm-master1:~# kubeadm reset --cri-socket /var/run/cri-dockerd.sock通过
--control-plane-endpoint命令指定VIP的IP:192.168.71.150root@kubeadm-master1:~# kubeadm init --apiserver-advertise-address=192.168.71.29 --apiserver-bind-port=6443 --kubernetes-version=v1.29.3 --pod-network-cidr=10.10.0.0/16 --service-cidr=10.20.0.0/16 --service-dns-domain=cbear.local --image-repository=harbor.cbear.top/google_containers --ignore-preflight-errors=swap --cri-socket /var/run/cri-dockerd.sock --control-plane-endpoint=192.168.71.150初始化成功之后, 会出现如下内容
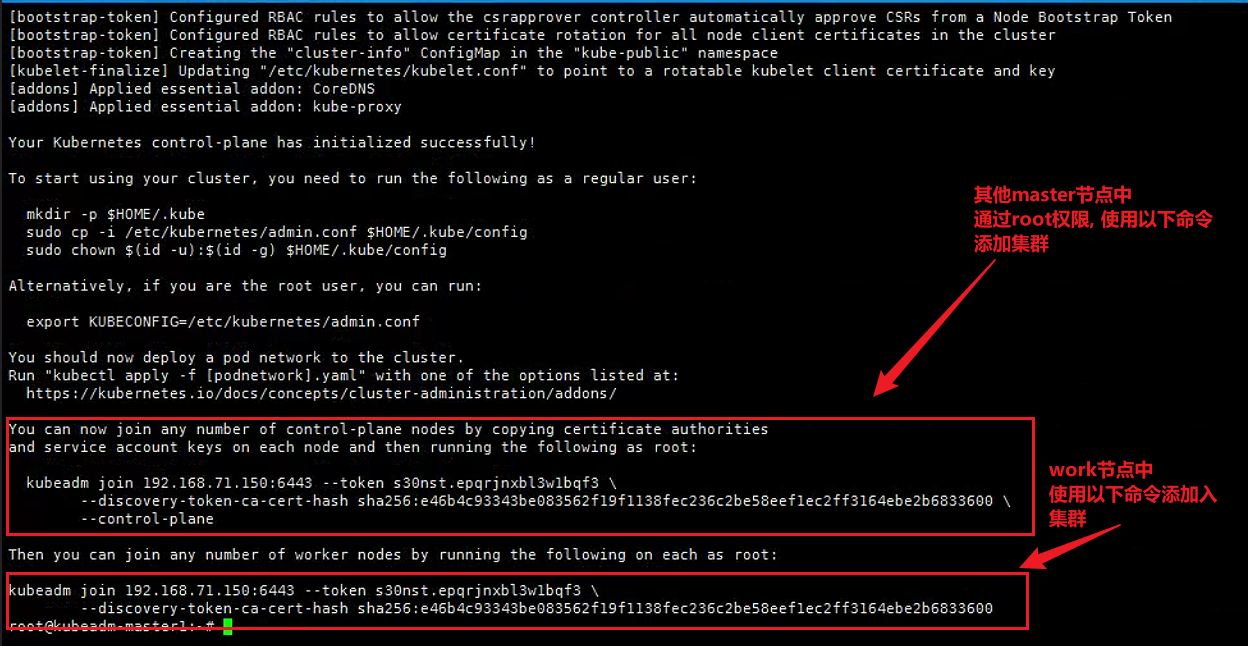
2.3.4.3.2 基于文件初始化高可用master方式 :
生成初始化默认配置文件
root@kubeadm-master1:~# kubeadm config print init-defaults
apiVersion: kubeadm.k8s.io/v1beta3
bootstrapTokens:
- groups:
  - system:bootstrappers:kubeadm:default-node-token
  token: abcdef.0123456789abcdef
  ttl: 24h0m0s
  usages:
  - signing
  - authentication
kind: InitConfiguration
localAPIEndpoint:
  advertiseAddress: 1.2.3.4
  bindPort: 6443
nodeRegistration:
  criSocket: unix:///var/run/containerd/containerd.sock
  imagePullPolicy: IfNotPresent
  name: node
  taints: null
---
apiServer:
  timeoutForControlPlane: 4m0s
apiVersion: kubeadm.k8s.io/v1beta3
certificatesDir: /etc/kubernetes/pki
clusterName: kubernetes
controllerManager: {}
dns: {}
etcd:
  local:
    dataDir: /var/lib/etcd
imageRepository: registry.k8s.io
kind: ClusterConfiguration
kubernetesVersion: 1.29.0
networking:
  dnsDomain: cluster.local
  serviceSubnet: 10.96.0.0/12
scheduler: {}
将默认配置输出至文件
root@kubeadm-master1:~# kubeadm config print init-defaults > kubeadm.yaml修改上一步输出文件, 配置好的文件如下
root@kubeadm-master1:~# cat kubeadm.yaml apiVersion: kubeadm.k8s.io/v1beta3 bootstrapTokens: - groups: - system:bootstrappers:kubeadm:default-node-token token: abcdef.0123456789abcdef ttl: 24h0m0s usages: - signing - authentication kind: InitConfiguration localAPIEndpoint: advertiseAddress: 192.168.71.29 #绑定本地主机IP地址 bindPort: 6443 nodeRegistration: criSocket: unix:///var/run/cri-dockerd.sock #指定容器运行时 imagePullPolicy: IfNotPresent name: kubeadm-master1.cbear.top #修改为本地主机名 taints: null --- apiServer: timeoutForControlPlane: 4m0s apiVersion: kubeadm.k8s.io/v1beta3 certificatesDir: /etc/kubernetes/pki clusterName: kubernetes controlPlaneEndpoint: 192.168.71.150:6443 #master IP和端口, 这里设置对应VIP或者域名 controllerManager: {} dns: {} etcd: local: dataDir: /var/lib/etcd imageRepository: registry.cn-hangzhou.aliyuncs.com/google_containers ## 仓库地址 , 访问不到时可以使用国内镜像仓库 kind: ClusterConfiguration kubernetesVersion: 1.29.3 #指定设置安装版本 networking: dnsDomain: cbear.local #设置DNS域解析 podSubnet: 10.10.0.0/16 #设置pod子网 serviceSubnet: 10.20.0.0/16 #设置service子网 scheduler: {} --- apiVersion: kubeproxy.config.k8s.io/v1alpha1 kind: KubeProxyConfiguration mode: ipvs #设置hubeproxy为ipvs模式 --- apiVersion: kubelet.config.k8s.io/v1beta1 kind: KubeletConfiguration cgroupDriver: systemdubuntu系统 ,debian系统 ,centos7系统 , 都是使用systemd初始化系统。systemd这边已经有一套cgroup管理器了 , 如果容器运行时和kubelet使用cgroupfs, 此时就会存在cgroups和systemd两种cgroup管理器。也就意味着操作系统里面存在两种资源分配的视图 , 当操作系统上存在CPU, 内存等等资源不足的时候 , 操作系统上的进程会变得不稳定。 因为这里kubelet配置cgroupDriver设置为systemd。另外可以通过修改对应的
kubelet参数文件, 实现这个功能cat <<EOF > /etc/sysconfig/kubelet KUBELET_EXTRA_ARGS="--cgroup-driver=systemd --fail-swap-on=false" KUBE_PROXY=MODE=ipvs EOF使用以下命令测试配置文件是否正常
root@kubeadm-master1:~# kubeadm init --config kubeadm.yaml --dry-run手动生成指定的文件之后, 可以通过以下命令从网上拉取需要的镜像
kubeadm config images pull --config kubeadm.yaml使用
kubeadm init通过文件,初始化master环境·root@kubeadm-master1:~# kubeadm init --config kubeadm.yaml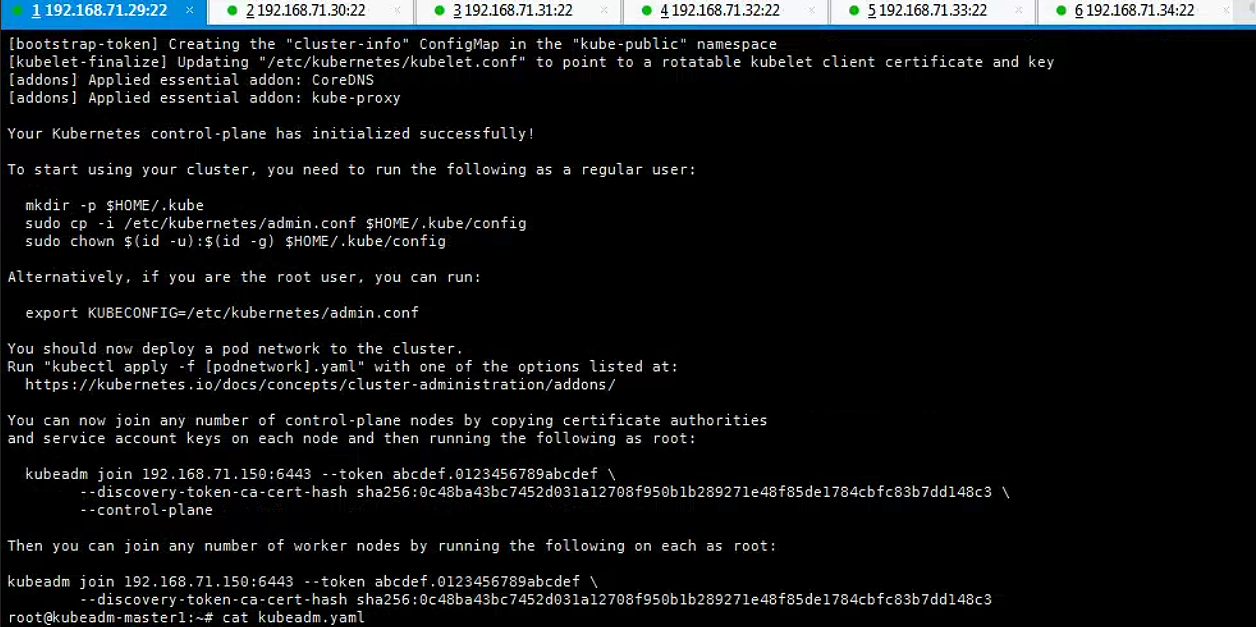
配置
kubectl的配置文件config, 相当于对kubectl进行授权 , 这样kubectl命令可以使用这个证书对k8s集群进行管理。root@kubeadm-master1:~# mkdir -p $HOME/.kube root@kubeadm-master1:~# sudo cp -i /etc/kubernetes/admin.conf $HOME/.kube/config root@kubeadm-master1:~# sudo chown $(id -u):$(id -g) $HOME/.kube/config root@kubeadm-master1:~# ll $HOME/.kube/config -rw------- 1 root root 5654 May 3 15:52 /root/.kube/configKube-config文件中包含kube-apiserver地址及相关认证信息此时可以看到
master1节点上的kubectl命令可以直接使用了root@kubeadm-master1:~# kubectl get node NAME STATUS ROLES AGE VERSION kubeadm-master1.cbear.top NotReady control-plane 27m v1.29.3这里状态显示
NotReady,是因为还没有部署集群的网络插件flannel/Calico
2.3.5 集群中加入新节点
上述步骤初始化完成之后 , 会出现这样一段提示:
You should now deploy a pod network to the cluster.
Run "kubectl apply -f [podnetwork].yaml" with one of the options listed at:
  https://kubernetes.io/docs/concepts/cluster-administration/addons/

You can now join any number of control-plane nodes by copying certificate authorities
and service account keys on each node and then running the following as root:

  kubeadm join 192.168.71.150:6443 --token abcdef.0123456789abcdef \
	--discovery-token-ca-cert-hash sha256:0c48ba43bc7452d031a12708f950b1b289271e48f85de1784cbfc83b7dd148c3 \
	--control-plane

Then you can join any number of worker nodes by running the following on each as root:

kubeadm join 192.168.71.150:6443 --token abcdef.0123456789abcdef \
--discovery-token-ca-cert-hash sha256:0c48ba43bc7452d031a12708f950b1b289271e48f85de1784cbfc83b7dd148c3 这里两个命令的区别主要在于Master节点会额外添加--control-plane参数
将控制平面证书上传到集群
通过将参数
--upload-certs添加到kubeadm init, 你可以将控制平面证书临时上传到集群中的Secret。 请注意 , 此Secret将在2小时后自动过期。这些证书使用 32 字节密钥加密 , 可以使用--certificate-key指定该密钥。 通过将--control-plane和--certificate-key传递给kubeadm join, 可以在添加其他控制平面节点时使用相同的密钥下载证书。以下阶段命令可用于证书到期后重新上传证书 :
kubeadm init phase upload-certs --upload-certs --config=SOME_YAML_FILEroot@kubeadm-master1:~# kubeadm init phase upload-certs --upload-certs I0503 16:44:40.003012 84893 version.go:256] remote version is much newer: v1.30.0; falling back to: stable-1.29 [upload-certs] Storing the certificates in Secret "kubeadm-certs" in the "kube-system" Namespace [upload-certs] Using certificate key: 307020d64abbe0f9609ac1786756b2b93588a8e43e7ad3b4cdf9abb06c586cbe如果未将预定义的证书密钥传递给
kubeadm init和kubeadm init phase upload-certs, 则会自动生成一个新密钥。以下命令可用于按需生成新密钥 :
kubeadm certs certificate-key使用以下命令创建并查看
tokenkubeadm token create --print-join-commandroot@kubeadm-master1:~# kubeadm token create --print-join-command kubeadm join 192.168.71.150:6443 --token p3iakd.1roxbn0wehe5lyn3 --discovery-token-ca-cert-hash sha256:0c48ba43bc7452d031a12708f950b1b289271e48f85de1784cbfc83b7dd148c3 root@kubeadm-master1:~# kubeadm token create --print-join-command --certificate-key 307020d64abbe0f9609ac1786756b2b93588a8e43e7ad3b4cdf9abb06c586cbe kubeadm join 192.168.71.150:6443 --token udct64.916q7atik1lc99o1 --discovery-token-ca-cert-hash sha256:0c48ba43bc7452d031a12708f950b1b289271e48f85de1784cbfc83b7dd148c3 --control-plane --certificate-key 307020d64abbe0f9609ac1786756b2b93588a8e43e7ad3b4cdf9abb06c586cbe会直接显示加入集群命令整体命令。这里因为生成和上传了新的密钥文件,所以需要在命令后面加
--certificate-key参数。生成的命令是加入master节点的命令。如果普通node节点加入集群,去掉--control-plane参数即可加入新的
master节点。因为docker的原因。需要在最后加入--cri-socket参数。加入新的两个master节点的命令直接使用相同的就可以了root@kubeadm-master2:~# kubeadm join 192.168.71.150:6443 --token udct64.916q7atik1lc99o1 --discovery-token-ca-cert-hash sha256:0c48ba43bc7452d031a12708f950b1b289271e48f85de1784cbfc83b7dd148c3 --control-plane --certificate-key 307020d64abbe0f9609ac1786756b2b93588a8e43e7ad3b4cdf9abb06c586cbe --cri-socket=unix:///var/run/cri-dockerd.sock root@kubeadm-master3:~# kubeadm join 192.168.71.150:6443 --token udct64.916q7atik1lc99o1 --discovery-token-ca-cert-hash sha256:0c48ba43bc7452d031a12708f950b1b289271e48f85de1784cbfc83b7dd148c3 --control-plane --certificate-key 307020d64abbe0f9609ac1786756b2b93588a8e43e7ad3b4cdf9abb06c586cbe --cri-socket=unix:///var/run/cri-dockerd.sock加入成功,如下图所示
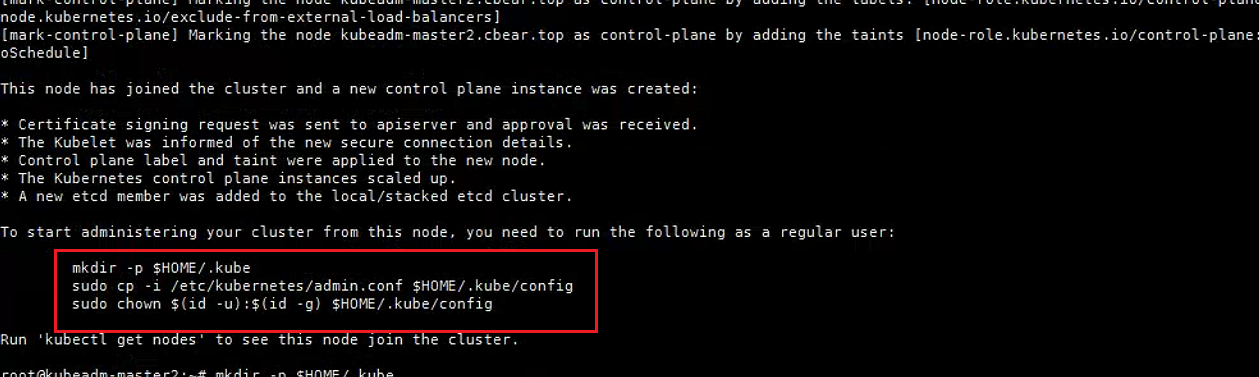
加入新的普通
node节点root@node01:~# kubeadm join 192.168.71.150:6443 --token spv5wl.98i1c6ej3cqs04vw --discovery-token-ca-cert-hash sha256:0c48ba43bc7452d031a12708f950b1b289271e48f85de1784cbfc83b7dd148c3 --certificate-key 307020d64abbe0f9609ac1786756b2b93588a8e43e7ad3b4cdf9abb06c586cbe --cri-socket=unix:///var/run/cri-dockerd.sock root@node02:~# kubeadm join 192.168.71.150:6443 --token spv5wl.98i1c6ej3cqs04vw --discovery-token-ca-cert-hash sha256:0c48ba43bc7452d031a12708f950b1b289271e48f85de1784cbfc83b7dd148c3 --certificate-key 307020d64abbe0f9609ac1786756b2b93588a8e43e7ad3b4cdf9abb06c586cbe --cri-socket=unix:///var/run/cri-dockerd.sock root@node03:~# kubeadm join 192.168.71.150:6443 --token spv5wl.98i1c6ej3cqs04vw --discovery-token-ca-cert-hash sha256:0c48ba43bc7452d031a12708f950b1b289271e48f85de1784cbfc83b7dd148c3 --certificate-key 307020d64abbe0f9609ac1786756b2b93588a8e43e7ad3b4cdf9abb06c586cbe --cri-socket=unix:///var/run/cri-dockerd.sock基本上加入新的
node的普通命令基本和master节点一致,只需要去掉--control-plane参数为新的
master节点配置kubectl运行环境root@kubeadm-master2:~# mkdir -p $HOME/.kube root@kubeadm-master2:~# sudo cp -i /etc/kubernetes/admin.conf $HOME/.kube/config root@kubeadm-master2:~# sudo chown $(id -u):$(id -g) $HOME/.kube/config root@kubeadm-master3:~# mkdir -p $HOME/.kube root@kubeadm-master3:~# sudo cp -i /etc/kubernetes/admin.conf $HOME/.kube/config root@kubeadm-master3:~# sudo chown $(id -u):$(id -g) $HOME/.kube/config检查节点状态
root@kubeadm-master2:~# kubectl get node
NAME                        STATUS     ROLES           AGE    VERSION
kubeadm-master1.cbear.top   NotReady   control-plane   90m    v1.29.3
kubeadm-master2.cbear.top   NotReady   control-plane   2m8s   v1.29.3
kubeadm-master3.cbear.top   NotReady   control-plane   60s    v1.29.3
node01.cbear.top            NotReady   <none>          56s    v1.29.3
node02.cbear.top            NotReady   <none>          42s    v1.29.3
node03.cbear.top            NotReady   <none>          37s    v1.29.3
2.3.6 安装网络组件
这里展示了三种网络组件:flannel、calico、underlay。选择安装其中一个组件即可
2.3.6.1 flannel
flannel下载地址: GitHub - flannel-io/flannel: flannel is a network fabric for containers, designed for Kubernetes
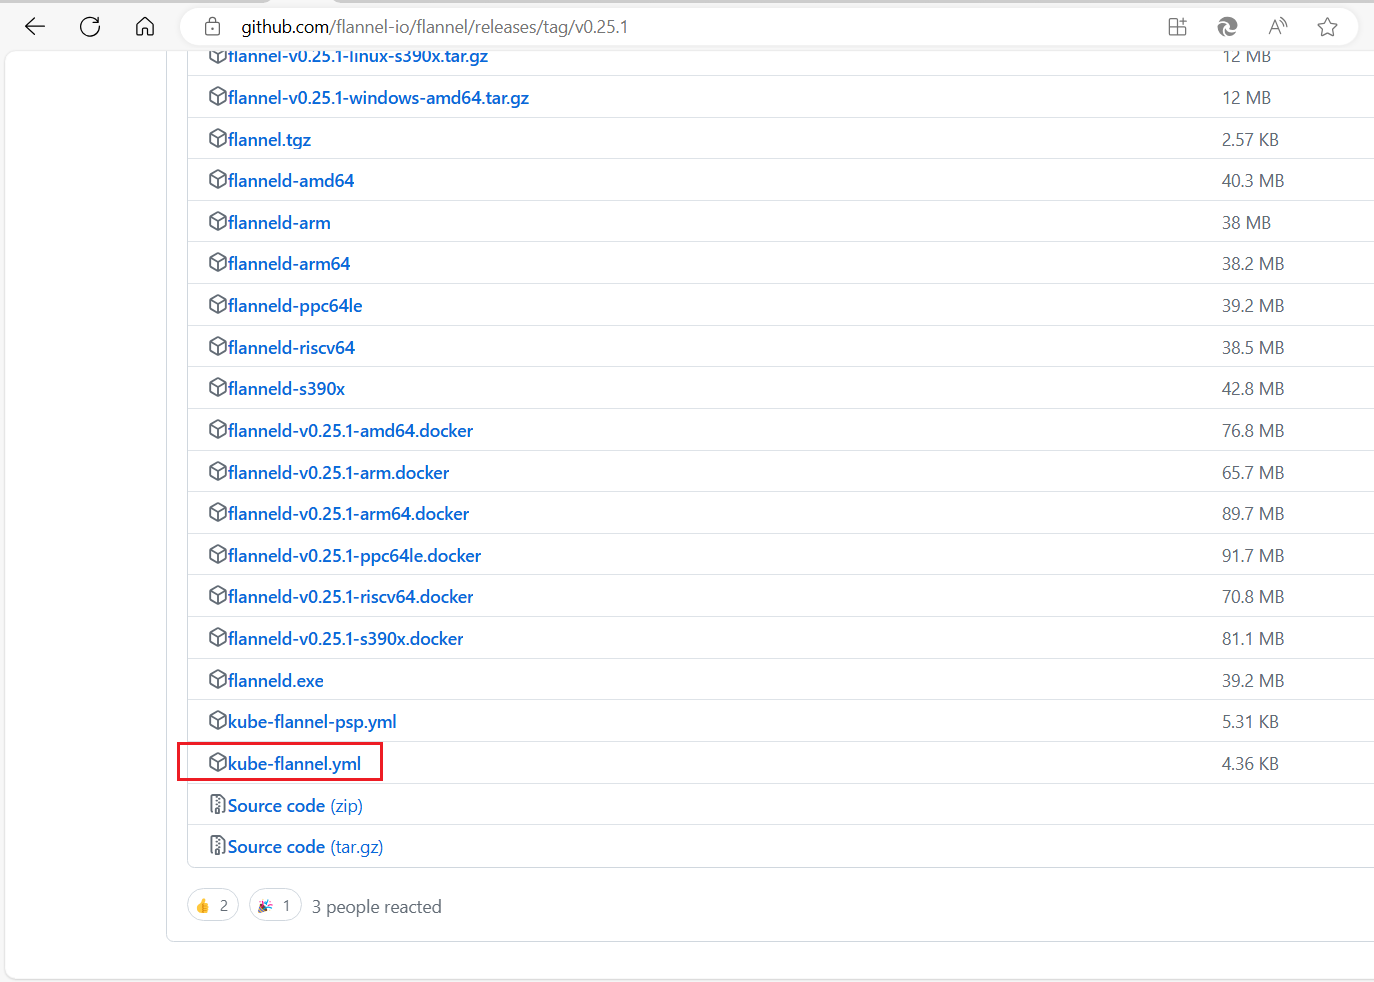
下载对应的
kube-flannel.yml文件root@kubeadm-master1:~# wget https://github.com/flannel-io/flannel/releases/download/v0.25.1/kube-flannel.yml修改对应的
yml配置文件root@kubeadm-master1:~# cat kube-flannel.yml .... net-conf.json: | { "Network": "10.10.0.0/16", "Backend": { "Type": "vxlan" } } ....部署对应的网络组件
root@kubeadm-master1:~# kubectl get node
NAME                        STATUS     ROLES           AGE    VERSION
kubeadm-master1.cbear.top   NotReady   control-plane   169m   v1.29.3
kubeadm-master2.cbear.top   NotReady   control-plane   80m    v1.29.3
kubeadm-master3.cbear.top   NotReady   control-plane   79m    v1.29.3
node01.cbear.top            NotReady   <none>          79m    v1.29.3
node02.cbear.top            NotReady   <none>          79m    v1.29.3
node03.cbear.top            NotReady   <none>          79m    v1.29.3
root@kubeadm-master1:~# kubectl apply -f kube-flannel.yml
namespace/kube-flannel created
serviceaccount/flannel created
clusterrole.rbac.authorization.k8s.io/flannel created
clusterrolebinding.rbac.authorization.k8s.io/flannel created
configmap/kube-flannel-cfg created
daemonset.apps/kube-flannel-ds created
部署完成之后等待几分钟再次检查节点状态
root@kubeadm-master1:~# kubectl get node
NAME                        STATUS   ROLES           AGE    VERSION
kubeadm-master1.cbear.top   Ready    control-plane   171m   v1.29.3
kubeadm-master2.cbear.top   Ready    control-plane   82m    v1.29.3
kubeadm-master3.cbear.top   Ready    control-plane   81m    v1.29.3
node01.cbear.top            Ready    <none>          81m    v1.29.3
node02.cbear.top            Ready    <none>          81m    v1.29.3
node03.cbear.top            Ready    <none>          81m    v1.29.3
遇见问题一
如果这里我们需要让flanneld包发到指定enp0s3去 , 数据包才能正常的经过flannel进行传送。那么具体怎么操作呢 : 需要修改kube-flannel.yml , 添加--iface=enp0s3进行指定。参数位置如下 :
container:
    ......
    command :
    -  /opt/bin/flanneld
    arg:
    - --ip-masq
    - --kube-subnet-mgr
    - --iface=enp0s3
遇见问题二
这里需要注意, 如果最开始没有将网段修改为指定的pod网段。对应的core-dns容器会一致显示创建中
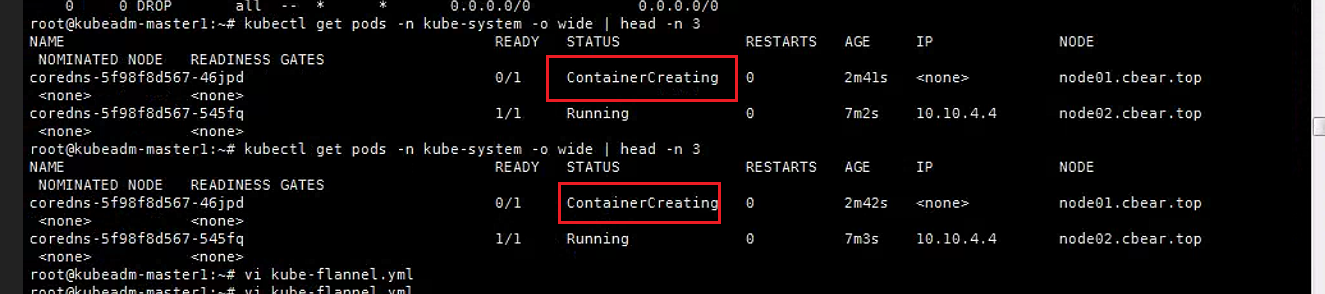
这里重新修改配置文件之后, 然后应用对应的flannel.yml文件
root@kubeadm-master1:~# kubectl apply -f kube-flannel.yml 删掉原本所有的flannel容器。删掉之后会自动重建对应flannel容器
root@kubeadm-master1:~# kubectl get pods --all-namespaces
NAMESPACE      NAME                                                READY   STATUS    RESTARTS         AGE
kube-flannel   kube-flannel-ds-54p7f                               1/1     Running   17 (7m14s ago)   65m
kube-flannel   kube-flannel-ds-7gz6z                               1/1     Running   13 (26m ago)     65m
kube-flannel   kube-flannel-ds-hrsxh                               1/1     Running   17 (7m35s ago)   65m
kube-flannel   kube-flannel-ds-lk4gf                               1/1     Running   17 (7m21s ago)   65m
kube-flannel   kube-flannel-ds-lpq9c                               1/1     Running   13 (27m ago)     65m
kube-flannel   kube-flannel-ds-qfkg2                               1/1     Running   13               65m
kube-system    coredns-5f98f8d567-6746f                            1/1     Running   0                3m15s
kube-system    coredns-5f98f8d567-lsqgr                            1/1     Running   0                3m30s
kube-system    etcd-kubeadm-master1.cbear.top                      1/1     Running   0                3h55m
kube-system    etcd-kubeadm-master2.cbear.top                      1/1     Running   0                146m
kube-system    etcd-kubeadm-master3.cbear.top                      1/1     Running   0                145m
kube-system    kube-apiserver-kubeadm-master1.cbear.top            1/1     Running   0                3h55m
kube-system    kube-apiserver-kubeadm-master2.cbear.top            1/1     Running   0                146m
kube-system    kube-apiserver-kubeadm-master3.cbear.top            1/1     Running   0                145m
kube-system    kube-controller-manager-kubeadm-master1.cbear.top   1/1     Running   0                3h55m
kube-system    kube-controller-manager-kubeadm-master2.cbear.top   1/1     Running   0                146m
kube-system    kube-controller-manager-kubeadm-master3.cbear.top   1/1     Running   0                145m
kube-system    kube-proxy-2wxq2                                    1/1     Running   0                3h54m
kube-system    kube-proxy-46fmn                                    1/1     Running   0                145m
kube-system    kube-proxy-7v287                                    1/1     Running   0                145m
kube-system    kube-proxy-jsfcc                                    1/1     Running   0                146m
kube-system    kube-proxy-m75zg                                    1/1     Running   0                145m
kube-system    kube-proxy-rd8wk                                    1/1     Running   0                145m
kube-system    kube-scheduler-kubeadm-master1.cbear.top            1/1     Running   0                3h55m
kube-system    kube-scheduler-kubeadm-master2.cbear.top            1/1     Running   0                146m
kube-system    kube-scheduler-kubeadm-master3.cbear.top            1/1     Running   0                145m
root@kubeadm-master1:~# kubectl delete pods -n kube-flannel   kube-flannel-ds-54p7f
pod "kube-flannel-ds-54p7f" deleted
root@kubeadm-master1:~# kubectl delete pods -n kube-flannel   kube-flannel-ds-7gz6z
pod "kube-flannel-ds-7gz6z" deleted
root@kubeadm-master1:~# kubectl delete pods -n kube-flannel   kube-flannel-ds-hrsxh
pod "kube-flannel-ds-hrsxh" deleted
root@kubeadm-master1:~# kubectl delete pods -n kube-flannel   kube-flannel-ds-lk4gf
pod "kube-flannel-ds-lk4gf" deleted
root@kubeadm-master1:~# kubectl delete pods -n kube-flannel   kube-flannel-ds-lpq9c
pod "kube-flannel-ds-lpq9c" deleted
root@kubeadm-master1:~# kubectl delete pods -n kube-flannel   kube-flannel-ds-qfkg2
pod "kube-flannel-ds-qfkg2" deleted然后删掉对应的coredns容器
root@kubeadm-master1:~# kubectl get pods -n kube-system -o wide | head -n 3
NAME                                                READY   STATUS              RESTARTS   AGE     IP              NODE                        NOMINATED NODE   READINESS GATES
coredns-5f98f8d567-46jpd                            0/1     ContainerCreating   0          83s     <none>          node01.cbear.top            <none>           <none>
coredns-5f98f8d567-545fq                            1/1     Running             0          5m44s   10.10.4.4       node02.cbear.top            <none>           <none>

root@kubeadm-master1:~# kubectl delete pods -n kube-system   coredns-5f98f8d567-46jpd
pod "coredns-5f98f8d567-46jpd" deleted
root@kubeadm-master1:~# kubectl delete pods -n kube-system   coredns-5f98f8d567-545fq
pod "coredns-5f98f8d567-545fq" deleted
之后就都恢复正常
2.3.6.2 calico
Calico在线文档地址 : https://docs.projectcalico.org/manifests/calico.yamlgithub网站: GitHub - projectcalico/calico: Cloud native networking and network security
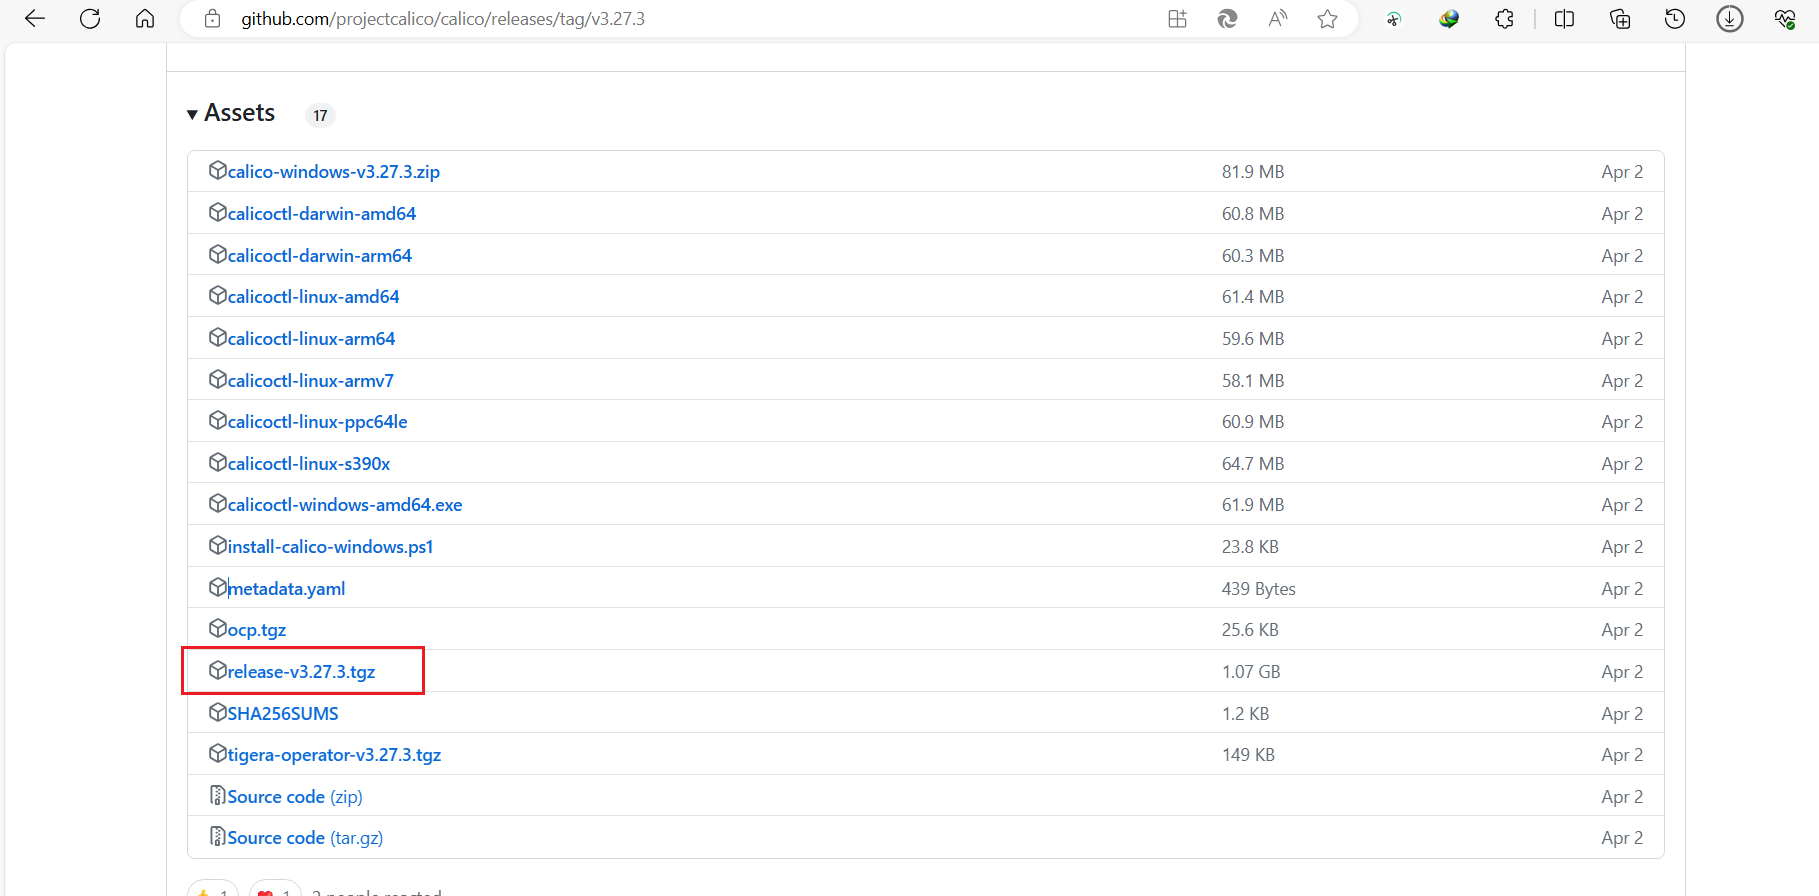
该压缩包中包含对应版本的所有客户端和镜像包以及配置文件。解压之后直接使用对应calico.yaml文件即可
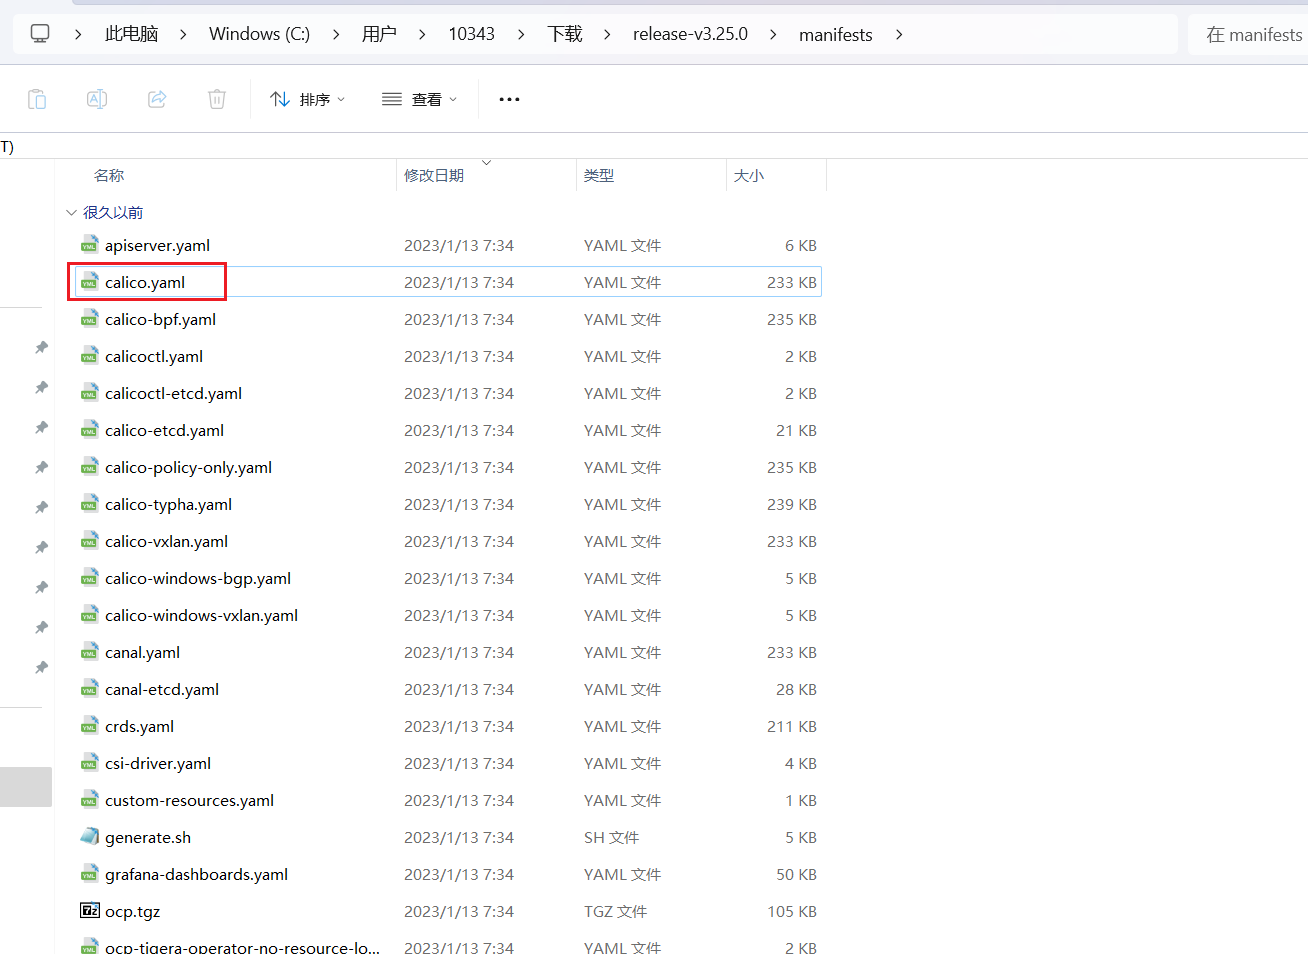
修改文件中的pod网段
vim calico.yaml
...
- name: CALICO_IPV4POOL_CIDR
  value: "10.244.0.0/16"
...上传calico.yaml文件到服务器中 , 下面提供calico.yaml文件内容 : 在master主机执行。
kubectl apply -f calico.yaml2.3.6.3 underlay
helm环境准备官网地址 : https://helm.sh/docs/intro/install/ https://github.com/helm/helm/releases [root@k8s-master-underlay-01 ~]# wget https://get.helm.sh/helm-v3.9.0-linux-amd64.tar.gz [root@k8s-master-underlay-01 ~]# tar xvf helm-v3.9.0-linux-amd64.tar.gz [root@k8s-master-underlay-01 ~]# mv linux-amd64/helm /usr/local/bin/ [root@k8s-master-underlay-01 ~]# helm version version.BuildInfo{Version:"v3.9.0", GitCommit:"7ceeda6c585217a19a1131663d8cd1f7d641b2a7", GitTreeState:"clean", GoVersion:"go1.17.5"} [root@k8s-master-underlay-01 ~]#部署
hybridnet[root@k8s-master-underlay-01 ~]# helm repo add hybridnet https://alibaba.github.io/hybridnet/ "hybridnet" has been added to your repositories [root@k8s-master-underlay-01 ~]# helm repo update Hang tight while we grab the latest from your chart repositories... ...Successfully got an update from the "hybridnet" chart repository Update Complete. ⎈Happy Helming!⎈ [root@k8s-master-underlay-01 ~]# helm install hybridnet hybridnet/hybridnet -n kube-system --set init.cidr=10.200.0.0/16 #配置overlay pod网络 , 如果不指定--set init.cidr=10.200.0.0/16默认会使用100.64.0.0/16 NAME: hybridnet LAST DEPLOYED: Fri Oct 28 01:01:18 2022 NAMESPACE: kube-system STATUS: deployed REVISION: 1 TEST SUITE: None [root@k8s-master-underlay-01 ~]# [root@k8s-master-underlay-01 ~]# kubectl get node -owide NAME STATUS ROLES AGE VERSION INTERNAL-IP EXTERNAL-IP OS-IMAGE KERNEL-VERSION CONTAINER-RUNTIME k8s-master-underlay-01 Ready control-plane 46m v1.25.3 192.168.247.71 <none> Ubuntu 20.04.3 LTS 5.4.0-122-generic docker://20.10.21 k8s-master-underlay-02 Ready control-plane 44m v1.25.3 192.168.247.72 <none> Ubuntu 20.04.3 LTS 5.4.0-122-generic docker://20.10.21 k8s-master-underlay-03 Ready control-plane 43m v1.25.3 192.168.247.73 <none> Ubuntu 20.04.3 LTS 5.4.0-122-generic docker://20.10.21 k8s-node-underlay-01 Ready <none> 22m v1.25.3 192.168.247.74 <none> Ubuntu 20.04.3 LTS 5.4.0-131-generic docker://20.10.21 [root@k8s-master-underlay-01 ~]# kubectl get pod -A NAMESPACE NAME READY STATUS RESTARTS AGE kube-system coredns-7f8cbcb969-tllgr 0/1 ContainerCreating 0 46m kube-system coredns-7f8cbcb969-xs56z 0/1 ContainerCreating 0 46m kube-system etcd-k8s-master-underlay-01 1/1 Running 0 46m kube-system etcd-k8s-master-underlay-02 1/1 Running 0 44m kube-system etcd-k8s-master-underlay-03 1/1 Running 0 43m kube-system hybridnet-daemon-956nw 2/2 Running 0 3m41s kube-system hybridnet-daemon-f86fj 2/2 Running 0 3m43s kube-system hybridnet-daemon-mvfbf 2/2 Running 0 3m48s kube-system hybridnet-daemon-p9jnd 2/2 Running 0 3m43s kube-system hybridnet-manager-5fcd869c59-bwwdc 0/1 Pending 0 3m43s kube-system hybridnet-manager-5fcd869c59-crdf8 0/1 Pending 0 3m41s kube-system hybridnet-manager-5fcd869c59-vpj7s 0/1 Pending 0 3m41s kube-system hybridnet-webhook-5dc9fc7d9d-8r5zp 0/1 Pending 0 3m48s kube-system hybridnet-webhook-5dc9fc7d9d-kwxz4 0/1 Pending 0 3m48s kube-system hybridnet-webhook-5dc9fc7d9d-rkvz4 0/1 Pending 0 3m48s kube-system kube-apiserver-k8s-master-underlay-01 1/1 Running 0 46m kube-system kube-apiserver-k8s-master-underlay-02 1/1 Running 0 43m kube-system kube-apiserver-k8s-master-underlay-03 1/1 Running 0 43m kube-system kube-controller-manager-k8s-master-underlay-01 1/1 Running 0 46m kube-system kube-controller-manager-k8s-master-underlay-02 1/1 Running 0 44m kube-system kube-controller-manager-k8s-master-underlay-03 1/1 Running 0 43m kube-system kube-proxy-4xq49 1/1 Running 0 43m kube-system kube-proxy-7kkgd 1/1 Running 0 46m kube-system kube-proxy-pnwxt 1/1 Running 0 22m kube-system kube-proxy-wnxpz 1/1 Running 0 44m kube-system kube-scheduler-k8s-master-underlay-01 1/1 Running 1 (44m ago) 46m kube-system kube-scheduler-k8s-master-underlay-02 1/1 Running 0 43m kube-system kube-scheduler-k8s-master-underlay-03 1/1 Running 0 43m [root@k8s-master-underlay-01 ~]#验证
underlay创建
underlay网络并与node节点关联[root@k8s-master-underlay-01 ~]# mkdir /root/hybridnet [root@k8s-master-underlay-01 ~]# cd hybridnet/ [root@k8s-master-underlay-01 hybridnet]# pwd /root/hybridnet [root@k8s-master-underlay-01 hybridnet]# [root@k8s-master-underlay-01 hybridnet]# kubectl label node k8s-master-underlay-01 network=underlay-nethost node/k8s-master-underlay-01 labeled [root@k8s-master-underlay-01 hybridnet]# kubectl label node k8s-master-underlay-02 network=underlay-nethost node/k8s-master-underlay-02 labeled [root@k8s-master-underlay-01 hybridnet]# kubectl label node k8s-master-underlay-03 network=underlay-nethost node/k8s-master-underlay-03 labeled [root@k8s-master-underlay-01 hybridnet]#
2.3.6.4 卸载网络组件
卸载 Flannel 网络插件通常涉及以下步骤 :
找到并删除 Flannel 的 DaemonSet : 找到之前用于部署
Flannel的YAML文件 , 并使用kubectl delete -f命令删除它。例如 , 如果该文件名为flannel.yaml, 则执行 :kubectl delete -f flannel.yaml删除 CNI 配置文件 : 删除
/etc/cni/net.d/目录下由 Flannel 创建的所有 CNI 配置文件。可以使用以下命令 :sudo rm -rf /etc/cni/net.d/*重启 kubelet : 重启 kubelet 服务以确保更改生效。这可以通过以下命令完成 :
sudo systemctl restart kubelet可选 - 清理残留网络配置 : 在每个节点上 , 如果存在由 Flannel 创建的任何残留网络接口(如
cni0或flannel.1) , 则需要将它们删除。可以使用ifconfig和ip命令来完成 :sudo ifconfig cni0 down sudo ip link delete cni0 sudo ifconfig flannel.1 down sudo ip link delete flannel.1验证卸载 : 检查 Flannel 是否已从集群中删除 , 可以使用以下命令 :
kubectl get pods -n kube-system确认列表中不再有
Flannel的Pod运行
2.3.7 测试网络通信
root@kubeadm-master1:~#  kubectl run net-test1  --image=alpine  sleep 360000
pod/net-test1 created
root@kubeadm-master1:~# kubectl exec -it net-test1 sh
kubectl exec [POD] [COMMAND] is DEPRECATED and will be removed in a future version. Use kubectl exec [POD] -- [COMMAND] instead.
/ # ip a
1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    inet 127.0.0.1/8 scope host lo
       valid_lft forever preferred_lft forever
    inet6 ::1/128 scope host
       valid_lft forever preferred_lft forever
2: eth0@if8: <BROADCAST,MULTICAST,UP,LOWER_UP,M-DOWN> mtu 1450 qdisc noqueue state UP
    link/ether a2:6a:35:a2:fe:43 brd ff:ff:ff:ff:ff:ff
    inet 10.10.3.3/24 brd 10.10.3.255 scope global eth0
       valid_lft forever preferred_lft forever
    inet6 fe80::a06a:35ff:fea2:fe43/64 scope link
       valid_lft forever preferred_lft forever
/ # ping 192.168.71.29
PING 192.168.71.29 (192.168.71.29): 56 data bytes
64 bytes from 192.168.71.29: seq=0 ttl=63 time=1.602 ms
64 bytes from 192.168.71.29: seq=1 ttl=63 time=0.762 ms
^C
--- 192.168.71.29 ping statistics ---
2 packets transmitted, 2 packets received, 0% packet loss
round-trip min/avg/max = 0.762/1.182/1.602 ms
3. kubeadm命令
命令使用 : Kubeadm | Kubernetes
Kubeadm 是一个提供了 kubeadm init 和 kubeadm join 的工具 , 作为创建 Kubernetes 集群的 “快捷途径” 的最佳实践。
kubeadm 通过执行必要的操作来启动和运行最小可用集群。 按照设计 , 它只关注启动引导 , 而非配置机器。同样的 , 安装各种 “锦上添花” 的扩展 , 例如 Kubernetes Dashboard、 监控方案、以及特定云平台的扩展 , 都不在讨论范围内。
相反 , 我们希望在 kubeadm 之上构建更高级别以及更加合规的工具 , 理想情况下 , 使用 kubeadm 作为所有部署工作的基准将会更加易于创建一致性集群。
kubeadm init: 用于搭建控制平面节点kubeadm join: 用于搭建工作节点并将其加入到集群中kubeadm completion:bash命令补全, 需要安装bash-completion。配置方式如下:root@kubeadm-master1:~# mkdir /data/scripts -p root@kubeadm-master1:~# kubeadm completion bash > /data/scripts/kubeadm_completion.sh root@kubeadm-master1:~# source /data/scripts/kubeadm_completion.sh root@kubeadm-master1:~# vi /etc/profile source /data/scripts/kubeadm_completion.shkubeadm upgrade: 用于升级Kubernetes集群到新版本kubeadm config: 如果你使用了v1.7.x或更低版本的kubeadm版本初始化你的集群 , 则使用kubeadm upgrade来配置你的集群kubeadm token: 用于管理kubeadm join使用的令牌kubeadm reset: 用于恢复通过kubeadm init或者kubeadm join命令对节点进行的任何变更kubeadm certs: 用于管理Kubernetes证书kubeadm kubeconfig: 用于管理kubeconfig文件kubeadm version: 用于打印kubeadm的版本信息kubeadm alpha: 用于预览一组可用于收集社区反馈的特性
3.1. kubeadm init
3.1.1 kubeadm init 参数说明
--apiserver-advertise-address string:K8S API Server将要监听的监听的本机IP--apiserver-bind-port int32:API Server绑定的端口,默认为6443--apiserver-cert-extra-sans stringSlice: 可选的证书额外信息 , 用于指定API Server的服务器证 书。可以是IP地址也可以是DNS名称。--cert-dir string: 证书的存储路径 , 缺省路径为/etc/kubernetes/pki--certificate-key string: 定义一个用于加密kubeadm-certs Secret中的控制平台证书的密钥--config string:kubeadm配置文件的路径--control-plane-endpoint string: 为控制平台指定一个稳定的IP地址或DNS名称 , 即配置一 个可以长期使用切是高可用的VIP或者域名 ,k8s多master高可用基于此参数实现--cri-socket string: 要连接的CRI(容器运行时接口 ,Container Runtime Interface, 简称CRI)套 接字的路径 , 如果为空 , 则kubeadm将尝试自动检测此值 , "仅当安装了多个CRI或具有非 标准CRI插槽时 , 才使用此选项"--dry-run: 不要应用任何更改 , 只是输出将要执行的操作 , 其实就是测试运行。--experimental-kustomize string: 用于存储kustomize为静态pod清单所提供的补丁的路径。--feature-gates string: 一组用来描述各种功能特性的键值(key=value)对 , 选项是:EtcdLearnerMode=true|false(ALPHA - 默认值=false)PublicKeysECDSA=true|false(ALPHA - 默认值=false)RootlessControlPlane=true|false(ALPHA - 默认值=false)UpgradeAddonsBeforeControlPlane=true|false: (DEPRECATED - 默认值=false)--ignore-preflight-errors strings: 可以忽略检查过程 中出现的错误信息 , 比如'IsPrivilegedUser,Swap', 如 果为all就忽略所有--image-repository string: 设置一个镜像仓库 , 默认为registry.k8s.io--kubernetes-version string: 指定安装k8s版本 , 默认为stable-1--node-name string: 指定node节点名称--pod-network-cidr: 设置pod ip地址范围。如果设置了这个参数 , 控制平面将会为每一个节点自动分配CIDR。--service-cidr: 设置service网络地址范围--service-dns-domain string: 设置k8s内部域名 , 默认为cluster.local, 会有相应的DNS服务 (kube-dns/coredns)解析生成的域名记录。--skip-certificate-key-print: 不打印用于加密的key信息--skip-phases strings: 要跳过哪些阶段--skip-token-print: 跳过打印token信息 , 生成的默认引导令牌--token: 指定token。这个令牌用于建立控制平面节点与工作节点间的双向通信。 格式为[a-z0-9]{6}.[a-z0-9]{16}- 示例:abcdef.0123456789abcdef--token-ttl: 指定token过期时间 , 默认为24小时 ,0为永不过期--upload-certs: 更新证书
全局选项
--add-dir-header: 如果为true, 在日志头部添加日志目录--log-file string: 如果不为空 , 将使用此日志文件--log-file-max-size uint: 设置日志文件的最大大小 , 单位为兆 , 默认为1800兆 , 0为没有限 制--rootfs: 宿主机的根路径 , 也就是绝对路径--skip-headers: 如果为true, 在log日志里面不显示标题前缀--skip-log-headers: 如果为true, 在log日志里里不显示标题
3.1.2 在 kubeadm 中使用 init 阶段
Kubeadm 允许你使用 kubeadm init phase 命令分阶段创建控制平面节点。
要查看阶段和子阶段的有序列表 , 可以调用 kubeadm init --help。 该列表将位于帮助屏幕的顶部 , 每个阶段旁边都有一个描述。 注意 , 通过调用 kubeadm init , 所有阶段和子阶段都将按照此确切顺序执行。
某些阶段具有唯一的标志 , 因此 , 如果要查看可用选项的列表 , 请添加 --help , 例如:
sudo kubeadm init phase control-plane controller-manager --help你也可以使用 --help 查看特定父阶段的子阶段列表:
sudo kubeadm init phase control-plane --helpkubeadm init 还公开了一个名为 --skip-phases 的参数 , 该参数可用于跳过某些阶段。 参数接受阶段名称列表 , 并且这些名称可以从上面的有序列表中获取。
例如:
sudo kubeadm init phase control-plane all --config=configfile.yaml
sudo kubeadm init phase etcd local --config=configfile.yaml
# 你现在可以修改控制平面和 etcd 清单文件
sudo kubeadm init --skip-phases=control-plane,etcd --config=configfile.yaml
该示例将执行的操作是基于 configfile.yaml 中的配置在 /etc/kubernetes/manifests 中写入控制平面和 etcd 的清单文件。 这允许你修改文件 , 然后使用 --skip-phases 跳过这些阶段。 通过调用最后一个命令 , 你将使用自定义清单文件创建一个控制平面节点。
特性状态: Kubernetes v1.22 [beta]
或者 , 你可以使用 InitConfiguration 下的 skipPhases 字段。
3.2 kubeadm join
此命令用来初始化 Kubernetes 工作节点并将其加入集群。
--apiserver-advertise-address string: 如果该节点托管一个新的控制平面实例 , 则API服务器将公布其正在侦听的IP地址。如果未设置 , 则使用默认网络接口。--apiserver-bind-port int32: 如果节点应该托管新的控制平面实例 , 则为 API 服务器要绑定的端口。 默认值:6443--certificate-key string: 使用此密钥可以解密由init上传的证书Secret。--config string:kubeadm配置文件的路径。--control-plane: 在此节点上创建一个新的控制平面实例。--cri-socket string: 要连接的CRI套接字的路径。如果为空 , 则kubeadm将尝试自动检测此值 ; 仅当安装了多个CRI或存在非标准的CRI套接字时 , 才使用此选项。--discovery-file string: 对于基于文件的发现 , 给出用于加载集群信息的文件或者URL。--discovery-token string: 对于基于令牌的发现 , 该令牌用于验证从API服务器获取的集群信息。--discovery-token-ca-cert-hash stringSlice: 对基于令牌的发现 , 验证根 CA 公钥是否与此哈希匹配 (格式:"<type>:<value>")。--discovery-token-unsafe-skip-ca-verification: 对于基于令牌的发现 , 允许在未关联--discovery-token-ca-cert-hash参数的情况下添加节点。--dry-run: 不做任何更改 ; 只输出将要执行的操作。-h,--help:join操作的帮助命令。--ignore-preflight-errors strings: 错误将显示为警告的检查列表 ; 例如:'IsPrivilegedUser,Swap'。取值为 'all' 时将忽略检查中的所有错误。--node-name string: 指定节点的名称。--patches string包含名为 "target[suffix][+patchtype].extension" 的文件的目录的路径。 例如 , "kube-apiserver0+merge.yaml" 或仅仅是 "etcd.json"。 "target" 可以是 “kube-apiserver”、“kube-controller-manager”、“kube-scheduler”、“etcd”、“kubeletconfiguration” 之一 , "patchtype" 可以是 "strategic"、"merge" 或 "json" 之一 , 并且它们与kubectl支持的补丁格式匹配。 默认的 "patchtype" 为 "strategic"。 "extension" 必须为 "json" 或 "yaml"。 "suffix" 是一个可选字符串 , 可用于确定首先按字母顺序应用哪些补丁。--skip-phases strings: 要跳过的阶段列表。--tls-bootstrap-token string: 指定在加入节点时用于临时通过Kubernetes控制平面进行身份验证的令牌。--token string: 如果未提供这些值 , 则将它们用于discovery-token令牌和tls-bootstrap令牌。
3.3 kubeadm upgrade
kubeadm upgrade 是一个对用户友好的命令 , 它将复杂的升级逻辑包装在一个命令后面 , 支持升级的规划和实际执行。
你可以使用 kubeadm upgrade diff 来查看将应用于静态 Pod 清单的更改。
在 Kubernetes v1.15.0 和更高版本中 , kubeadm upgrade apply 和 kubeadm upgrade node 也将自动续订该节点上的 kubeadm 托管证书 , 包括存储在 kubeconfig 文件中的证书。 要选择退出 , 可以传递参数 --certificate-renewal=false。
3.3.1 kubeadm upgrade plan
检查可升级到哪些版本 , 并验证你当前的集群是否可升级。
检查可升级到哪些版本 , 并验证你当前的集群是否可升级。 该命令只能在存在 kubeconfig 文件 admin.conf 的控制平面节点上运行。 要跳过互联网检查 , 请传入可选参数 [version]。
kubeadm upgrade plan [version] [flags]--allow-experimental-upgrades: 显示不稳定版本的Kubernetes作为升级替代方案 , 并允许升级到Kubernetes的Alpha、Beta或RC版本。--allow-missing-template-keys: 默认为true。如果为true, 则当模板中缺少字段或映射键时 , 忽略模板中的错误。仅适用于golang和jsonpath输出格式。--allow-release-candidate-upgrades: 显示Kubernetes的发行候选版本作为升级选择 , 并允许升级到Kubernetes的RC版本。--config string: 配置文件的路径。-o,--experimental-outputstring: 默认为text。 输出格式为text|json|yaml|go-template|go-template-file|template|templatefile|jsonpath|jsonpath-as-json|jsonpath-file其中一种。--feature-gates string: 一组描述各种特征特性门控的键值对。选项有:EtcdLearnerMode=true|false(BETA - 默认值=true)PublicKeysECDSA=true|false(DEPRECATED默认值=false)RootlessControlPlane=true|false(ALPHA- 默认值=false)UpgradeAddonsBeforeControlPlane=true|false(DEPRECATED- 默认值=false)WaitForAllControlPlaneComponents=true|false(ALPHA- 默认值=false)-h,--help:plan操作的帮助命令。--ignore-preflight-errors strings: 其错误将显示为警告的检查列表。例如:'IsPrivilegedUser,Swap'。值 'all' 忽略所有检查错误。--kubeconfig string: 默认值"/etc/kubernetes/admin.conf" 。 与集群通信时使用的kubeconfig文件。如果标志为未设置 , 则可以在一组标准位置中搜索现有的kubeconfig文件。-o,--output string: 默认值:"text"--print-config: 指定是否打印将在升级中使用的配置文件。--show-managed-fields: 如果开启 , 以JSON或YAML格式打印对象时会保留managedField。
3.3.2 kubeadm upgrade apply
将 Kubernetes 集群升级到指定版本。
kubeadm upgrade apply [version]--allow-experimental-upgrades: 显示Kubernetes的不稳定版本作为升级替代方案 , 并允许升级到Kubernetes的Alpha、Beta或RC版本。--allow-release-candidate-upgrades: 显示Kubernetes的候选版本作为升级替代方案 , 并允许升级到Kubernetes的RC版本。--certificate-renewal: 默认为true。 执行升级期间更改的组件所使用的证书的更新。--config string:kubeadm配置文件的路径。--dry-run: 不要更改任何状态 , 只输出要执行的操作。--etcd-upgrade: 默认值 ,true。 执行etcd的升级。--feature-gates string: 一组键值对 , 用于描述各种功能。选项包括:EtcdLearnerMode=true|false (ALPHA - 默认值=false) PublicKeysECDSA=true|false (ALPHA - 默认值=false) RootlessControlPlane=true|false (ALPHA - 默认值=false) UpgradeAddonsBeforeControlPlane=true|false (DEPRECATED - 默认值=false)-f,--force: 强制升级 , 但可能无法满足某些要求。这也意味着非交互模式。-h,--help:apply操作的帮助命令。-ignore-preflight-errors strings: 错误将显示为警告的检查列表 ; 例如: 'IsPrivilegedUser,Swap'。取值为 'all' 时将忽略检查中的所有错误。--kubeconfig string: 默认值 , "/etc/kubernetes/admin.conf"。与集群通信时使用的kubeconfig文件。如果未设置标志 , 则在相关目录下搜索以查找现有kubeconfig文件。--patches string: 包含名为 "target[suffix][+patchtype].extension" 的文件的目录的路径。 例如 , "kube-apiserver0+merge.yaml"或是简单的 "etcd.json"。 "target" 可以是 "kube-apiserver"、"kube-controller-manager"、"kube-scheduler"、"etcd"、"kubeletconfiguration" 之一。 "patchtype" 可以是 "strategic"、"merge" 或者 "json" 之一 , 并且它们与kubectl支持的补丁格式相同。 默认的 "patchtype" 是 "strategic"。 "extension" 必须是 "json" 或 "yaml"。 "suffix" 是一个可选字符串 , 可用于确定首先按字母顺序应用哪些补丁。--print-config: 指定是否应打印将在升级中使用的配置文件。-y,--yes: 执行升级 , 不提示确认(非交互模式)。
3.3.3 kubeadm upgrade diff
显示哪些差异将被应用于现有的静态 Pod 资源清单。参考:kubeadm upgrade apply --dry-run
kubeadm upgrade diff [version] [flags]--api-server-manifest string: 默认值:"/etc/kubernetes/manifests/kube-apiserver.yaml" ,API服务器清单的路径。--config string:kubeadm配置文件的路径。-c,--context-lines int: 默认值 为3,diff涉及了多少行上下文。--controller-manager-manifest string: 默认值, "/etc/kubernetes/manifests/kube-controller-manager.yaml"。控制器清单的路径。-h,--help:diff操作的帮助命令--kubeconfig string: 默认值"/etc/kubernetes/admin.conf"。 与集群通信时使用的kubeconfig文件 , 如果标志是未设置 , 则可以在一组标准位置中搜索现有的kubeconfig文件。--scheduler-manifest string: 默认值"/etc/kubernetes/manifests/kube-scheduler.yaml"。 调度程序清单的路径。
3.3.4 kubeadm upgrade node
升级集群中某个节点的命令。
"node" 命令执行以下阶段:
preflight       执行节点升级前检查
control-plane   如果存在的话 , 升级部署在该节点上的管理面实例
kubelet-config  更新该节点上的 kubelet 配置
kubeadm upgrade node [flags]--certificate-renewal: 默认值true。 对升级期间变化的组件所使用的证书执行续订。--config string: 到kubeadm配置文件的路径。--dry-run: 不更改任何状态 , 只输出将要执行的操作。--etcd-upgrade: 默认值true。执行etcd的升级。-h,--help:node操作的帮助命令。--ignore-preflight-errors strings: 其错误将显示为警告的检查列表。示例:'IsPrivilegedUser,Swap'。值 'all' 忽略所有检查中的错误。--kubeconfig string: 默认值"/etc/kubernetes/admin.conf"。 用于与集群交互的kubeconfig文件。如果参数未指定 , 将从一系列标准位置检索存在的 kubeconfig 文件。--patches string: 包含名为 "target[suffix][+patchtype].extension" 的文件的目录的路径。 例如 , "kube-apiserver0+merge.yaml"或是简单的 "etcd.json"。 "target" 可以是 "kube-apiserver"、"kube-controller-manager"、"kube-scheduler"、"etcd"、"kubeletconfiguration" 之一。 "patchtype" 可以是 "strategic"、"merge" 或者 "json" 之一 , 并且它们与kubectl支持的补丁格式相同。 默认的 "patchtype" 是 "strategic"。 "extension" 必须是 "json" 或 "yaml"。 "suffix" 是一个可选字符串 , 可用于确定首先按字母顺序应用哪些补丁。--skip-phases strings: 要跳过的阶段的列表。
3.4 kubeadm config
在 kubeadm init 执行期间 , kubeadm 将 ClusterConfiguration 对象上传 到你的集群的 kube-system 名字空间下名为 kubeadm-config 的 ConfigMap 对象中。 然后在 kubeadm join、kubeadm reset 和 kubeadm upgrade 执行期间读取此配置。
你可以使用 kubeadm config print 命令打印默认静态配置 , kubeadm 运行 kubeadm init and kubeadm join 时将使用此配置。
你可以使用 kubeadm config migrate 来转换旧配置文件 , 把其中已弃用的 API 版本更新为受支持的 API 版本。
kubeadm config validate 可用于验证配置文件。
kubeadm config images list 和 kubeadm config images pull 可以用来列出和拉取 kubeadm 所需的镜像。
3.4.1 kubeadm config print
打印配置
kubeadm config print [flags]kubeadm config print init-defaults: 打印用于 'kubeadm init' 的默认init配置。kubeadm config print join-defaults: 打印默认的节点添加配置 , 该配置可用于 'kubeadm join' 命令。
3.4.2 kubeadm config migrate
从文件中读取旧版本的 kubeadm 配置的 API 类型 , 并为新版本输出类似的配置对象
此命令允许你在 CLI 工具中将本地旧版本的配置对象转换为最新支持的版本 , 而无需变更集群中的任何内容。 在此版本的 kubeadm 中 , 支持以下 API 版本:
kubeadm.k8s.io/v1beta3
因此 , 无论你在此处传递 --old-config 参数的版本是什么 , 当写入到 stdout 或 --new-config (如果已指定)时 , 都会读取、反序列化、默认、转换、验证和重新序列化 API 对象。
换句话说 , 如果你将此文件传递给 "kubeadm init" , 则该命令的输出就是 kubeadm 实际上在内部读取的内容。
kubeadm config migrate [flags]--new-config string: 使用新的API版本生成的kubeadm配置文件的路径。这个路径是可选的。如果没有指定 , 输出将被写到stdout。--old-config string: 使用旧API版本且应转换的kubeadm配置文件的路径。此参数是必需的。
3.4.3 kubeadm config validate
读取包含 kubeadm 配置 API 的文件 , 并报告所有验证问题。
这个命令允许你验证 kubeadm 配置 API 文件并报告所有警告和错误。 如果没有错误 , 退出状态将为零 ; 否则 , 将为非零。 诸如未知 API 字段等任何解包问题都会触发错误。 未知的 API 版本和具有无效值的字段也会触发错误。 根据输入文件的内容 , 可能会报告任何其他错误或警告。
在这个版本的 kubeadm 中,支持以下 API 版本:
kubeadm.k8s.io/v1beta3
kubeadm config validate [flags]选项
--allow-experimental-api: 允许验证试验性的、未发布的API。--config string: 指向kubeadm配置文件的路径。
3.4.4 kubeadm config images list
打印 kubeadm 要使用的镜像列表。配置文件用于自定义镜像或镜像存储库。
kubeadm config images list [flags]--allow-missing-template-keys: 默认值true, 如果设置为true,则在模板中缺少字段或哈希表的键时忽略模板中的任何错误。 仅适用于golang和jsonpath输出格式。--config string:kubeadm配置文件的路径。-o,--experimental-output string: 默认值:"text"。 输出格式:text|json|yaml|go-template|go-template-file|template|templatefile|jsonpath|jsonpath-as-json|jsonpath-file其中之一。--feature-gates string: 一组键值对(key=value),用于描述各种特性。这些选项是:EtcdLearnerMode=true|false (ALPHA - 默认值=false) PublicKeysECDSA=true|false (ALPHA - 默认值=false) RootlessControlPlane=true|false (ALPHA - 默认值=false) UpgradeAddonsBeforeControlPlane=true|false (DEPRECATED - 默认值=false)--image-repository string: 默认值:"registry.k8s.io" ,选择要从中拉取控制平面镜像的容器仓库。--kubernetes-version string: 默认值:"stable-1" , 为控制平面选择一个特定的Kubernetes版本。--show-managed-fields: 如果为true,则在以JSON或YAML格式打印对象时保留managedFields。
3.4.5 kubeadm config images pull
拉取 kubeadm 使用的镜像。
kubeadm config images pull [flags]--config string:kubeadm配置文件的路径。--cri-socket string: 要连接的CRI套接字的路径。如果为空,则kubeadm将尝试自动检测此值;仅当安装了多个CRI或具有非标准CRI插槽时,才使用此选项。--feature-gates string: 一系列键值对(key=value),用于描述各种特性。可选项是:EtcdLearnerMode=true|false (ALPHA - 默认值=false) PublicKeysECDSA=true|false (ALPHA - 默认值=false) RootlessControlPlane=true|false (ALPHA - 默认值=false) UpgradeAddonsBeforeControlPlane=true|false (DEPRECATED - 默认值=false)--image-repository string: 默认值:"registry.k8s.io"。 选择用于拉取控制平面镜像的容器仓库。--kubernetes-version string: 默认值:"stable-1" 。为控制平面选择一个特定的 Kubernetes 版本。
3.5 kubeadm token
kubeadm init 创建了一个有效期为 24 小时的令牌,下面的命令允许你管理令牌,也可以创建和管理新的令牌。
3.5.1 kubeadm token create
在服务器上创建引导令牌。
这个命令将为你创建一个引导令牌。 你可以设置此令牌的用途,"有效时间" 和可选的人性化的描述。
这里的 [token] 是指将要生成的实际令牌。 该令牌应该是一个通过安全机制生成的随机令牌,形式为 "[a-z0-9]{6}.[a-z0-9]{16}"。 如果没有给出 [token],kubeadm 将生成一个随机令牌。
kubeadm token create [token]--certificate-key string: 当与 “--print-join-command” 一起使用时,打印作为控制平面加入集群时所需的所有 “kubeadm join” 标志。 要创建新的证书密钥,你必须使用 “kubeadm init phase upload-certs --upload-certs”。--config string:kubeadm配置文件的路径。--description string: 针对令牌用途的人性化的描述。--groups stringSlice: 默认值[system:bootstrappers:kubeadm:default-node-token]。此令牌用于身份验证时将对其他组进行身份验证。必须匹配 "\\Asystem:bootstrappers:[a-z0-9:-]{0,255}[a-z0-9]\\z"--print-join-command: 不仅仅打印令牌,而是打印使用令牌加入集群所需的完整 'kubeadm join' 参数。--ttl duration: 默认值24h0m0s。 令牌有效时间,超过该时间令牌被自动删除。(例如:1s,2m,3h)。如果设置为 '0',令牌将永远不过期。--usages stringSlice: 默认值[signing,authentication]描述可以使用此令牌的方式。你可以多次使用--usages或者提供一个以逗号分隔的选项列表。合法选项有:[signing,authentication]
3.5.2 kubeadm token delete
删除服务器上的引导令牌。
这个命令将为你删除指定的引导令牌列表。
[token-value] 是要删除的 "[a-z0-9]{6}.[a-z0-9]{16}" 形式的完整令牌或者是 "[a-z0-9]{6}" 形式的令牌 ID。
kubeadm token delete [token-value] ...3.5.3 kubeadm token generate
生成并打印一个引导令牌,但不要在服务器上创建它。
此命令将打印一个随机生成的可以被 "init" 和 "join" 命令使用的引导令牌。
你不必使用此命令来生成令牌。你可以自己设定,只要格式符合 "[a-z0-9]{6}.[a-z0-9]{16}"。 之所以提供这个命令是为了方便生成规定格式的令牌。
你也可以使用 "kubeadm init" 并且不指定令牌,该命令会生成一个令牌并打印出来。
kubeadm token generate [flags]3.5.4 kubeadm token list
列出服务器上的引导令牌。
此命令将为你列出所有的引导令牌。
kubeadm token list [flags]###
3.6 kubeadm reset
该命令尽力还原由 kubeadm init 或 kubeadm join 所做的更改。
尽最大努力还原通过 'kubeadm init' 或者 'kubeadm join' 操作对主机所作的更改。
"reset" 命令执行以下阶段:
preflight              Run reset pre-flight checks
remove-etcd-member     Remove a local etcd member.
cleanup-node           Run cleanup node.
kubeadm reset [flags]
--cert-dir string: 默认值:"/etc/kubernetes/pki" 。存储证书的目录路径。如果已指定,则需要清空此目录。--cleanup-tmp-dir: 清理 "/etc/kubernetes/tmp" 目录。--config string:kubeadm配置文件的路径。--cri-socket string: 要连接的CRI套接字的路径。如果为空,则kubeadm将尝试自动检测此值; 仅当安装了多个CRI或存在非标准的CRI套接字时,才使用此选项。--dry-run: 不做任何更改;只输出将要执行的操作。-f,--force: 在不提示确认的情况下重置节点。--ignore-preflight-errors strings: 错误将显示为警告的检查列表;例如:'IsPrivilegedUser,Swap'。取值为 'all' 时将忽略检查中的所有错误。--kubeconfig string: 默认值"/etc/kubernetes/admin.conf"。 与集群通信时使用的kubeconfig文件。如果未设置该标志,则可以在一组标准位置中搜索现有的kubeconfig文件。--skip-phases strings: 要跳过的阶段列表。
Reset 工作流程
kubeadm reset 负责从使用 kubeadm init 或 kubeadm join 命令创建的文件中清除节点本地文件系统。 对于控制平面节点,reset 还从 etcd 集群中删除该节点的本地 etcd Stacked 部署的成员。
kubeadm reset phase 可用于执行上述工作流程的各个阶段。 要跳过阶段列表,你可以使用 --skip-phases 参数,该参数的工作方式类似于 kubeadm join 和 kubeadm init 阶段运行器。
外部 etcd 清理
如果使用了外部 etcd,kubeadm reset 将不会删除任何 etcd 中的数据。这意味着,如果再次使用相同的 etcd 端点运行 kubeadm init,你将看到先前集群的状态。
要清理 etcd 中的数据,建议你使用 etcdctl 这样的客户端,例如:
etcdctl del "" --prefix3.7 kubeadm certs
kubeadm certs 提供管理证书的工具。
kubeadm certs [flags]3.7.1 kubeadm certs renew
kubeadm certs renew [flags]: 为Kubernetes集群更新证书kubeadm certs renew all [flags]: 续订运行控制平面所需的所有已知证书。续订是无条件进行的,与到期日期无关。续订也可以单独运行以进行更多控制。kubeadm certs renew admin.conf [flags]: 续订kubeconfig文件中嵌入的证书,供管理员和kubeadm自身使用kubeadm certs renew apiserver-etcd-client [flags]: 续订apiserver用于访问etcd的证书。kubeadm certs renew apiserver-kubelet-client [flags]: 续订apiserver用于连接kubelet的证书。kubeadm certs renew apiserver [flags]: 续订用于提供Kubernetes API的证书。kubeadm certs renew controller-manager.conf [flags]: 续订kubeconfig文件中嵌入的证书,以供控制器管理器(Controller Manager)使用。kubeadm certs renew etcd-healthcheck-client [flags]: 续订存活态探针的证书,用于对etcd执行健康检查。kubeadm certs renew etcd-peer [flags]: 续订etcd节点间用来相互通信的证书。kubeadm certs renew etcd-server [flags]: 续订用于提供etcd服务的证书。kubeadm certs renew front-proxy-client [flags]: 为前端代理客户端续订证书kubeadm certs renew scheduler.conf [flags]: 续订kubeconfig文件中嵌入的证书,以供调度管理器使用。
3.7.2 kubeadm certs certificate-key
此命令可用来生成一个新的控制面证书密钥。密钥可以作为 --certificate-key 标志的取值传递给 kubeadm init和 kubeadm join命令,从而在添加新的控制面节点时能够自动完成证书复制。
该命令将打印出可以与 "init" 命令一起使用的安全的随机生成的证书密钥。
你也可以使用 kubeadm init --upload-certs 而无需指定证书密钥; 此命令将为你生成并打印一个证书密钥。
kubeadm certs certificate-key [flags]3.7.3 kubeadm certs check-expiration
此命令检查 kubeadm 所管理的本地 PKI 中的证书是否以及何时过期。
为一个 Kubernetes 集群检查证书的到期时间。
检查 kubeadm 管理的本地 PKI 中证书的到期时间。
kubeadm certs check-expiration [flags]3.7.4 kubeadm certs generate-csr
此命令可用来为所有控制面证书和 kubeconfig 文件生成密钥和 CSR(签名请求)。 用户可以根据自身需要选择 CA 为 CSR 签名。
为运行控制平面所需的所有证书生成密钥和证书签名请求(CSR)。该命令会生成部分 kubeconfig 文件, 其中 "users > user > client-key-data" 字段包含私钥数据,并为每个 kubeconfig 文件创建一个随附的 ".csr" 文件。
此命令设计用于 Kubeadm 外部 CA 模式。 它生成你可以提交给外部证书颁发机构进行签名的 CSR。
你需要使用 ".crt" 作为文件扩展名将 PEM 编码的签名证书与密钥文件一起保存。 或者,对于 kubeconfig 文件,PEM 编码的签名证书应使用 base64 编码, 并添加到 "users > user > client-certificate-data" 字段。
kubeadm certs generate-csr [flags]# 以下命令将为所有控制平面证书和 kubeconfig 文件生成密钥和 CSR:
kubeadm certs generate-csr --kubeconfig-dir /tmp/etc-k8s --cert-dir /tmp/etc-k8s/pki3.8 kubeadm kubeconfig
kubeadm kubeconfig 提供用来管理 kubeconfig 文件的工具。
如果希望查看如何使用 kubeadm kubeconfig user 的示例
kubeadm kubeconfig:kubeconfig文件工具。kubeadm kubeconfig user: 此命令可用来为其他用户生成一个kubeconfig文件。kubeadm kubeconfig user [flags]# 为一个名为 foo 的其他用户输出 kubeconfig 文件 kubeadm kubeconfig user --client-name=foo # 使用 kubeadm 配置文件 bar 为另一个名为 foo 的用户输出 kubeconfig 文件 kubeadm alpha kubeconfig user --client-name=foo --config=bar--client-name string: 用户名。如果生成客户端证书,则用作其CN。--config string: 指向kubeadm配置文件的路径。--org strings: 客户端证书的组织。如果创建客户端证书,此值将用作其 O 字段值。--token string: 应该用此令牌做为kubeconfig的身份验证机制,而不是客户端证书。--validity-period duration默认为:8760h0m0s。 客户证书的合法期限。所设置值为相对当前时间的偏移
参考链接
Kubernetes最新版2023.07v1.27.4安装和集群搭建保姆级教程 (qq.com)
基于ubuntu 20.04与cri-docker 搭建部署高可用k8s 1.25.3_ubuntu 安装cri-dokerd-CSDN博客
kubernetes - 访问K8s Dashboard的几种方式 - 个人文章 - SegmentFault 思否