
1-1-kubernetes简介
1. kubernets简介
云原生是一种行为方式和设计理念 , 究其本质 , 凡是能够提高云上资源利用率和应用交付效率的行为或方式都是云原生的。云计算的发展史就是一部云原生化的历史。Kubernetes 开启了云原生的序幕 , 服务网格 Istio 的出现 , 引领了后 Kubernetes 时代的微服务 , Serverless 的兴起 , 使得云原生从基础设施层不断向应用架构层挺进 , 我们正处于一个云原生的新时代。
Kubernetes是 Google 于 2014 年 6 月基于其内部使用的 Borg系统开源出来的容器编排调度引擎 , Google 将其作为初始和核心项目贡献给CNCF(云原生计算基金会) , 近年来逐渐发展出了云原生生态。
Kubernetes 的目标不仅仅是一个编排系统 , 而是提供一个规范用以描述集群的架构 , 定义服务的最终状态 , 使系统自动地达到和维持该状态。Kubernetes 作为云原生应用的基石 , 相当于一个云原生操作系统 , 其重要性不言而喻。
云原生技术有利于各组织在公有云、私有云和混合云等新型动态环境中 , 构建和运行可弹性扩展的应用。云原生的代表技术包括 容器、服务网格、微服务、不可变基础设施 和 声明式 API。这些技术能够构建容错性好、易于管理和便于观察的松耦合系统。结合可靠的自动化手段 , 云原生技术使工程师能够轻松地对系统作出频繁和可预测的重大变更。——CNCF(云原生计算基金会)。
Kubernetes 最初源于谷歌内部的 Borg , 提供了面向应用的容器集群部署和管理系统。Kubernetes 的目标旨在消除编排物理 / 虚拟计算 , 网络和存储基础设施的负担 , 并使应用程序运营商和开发人员完全将重点放在以容器为中心的原语上进行自助运营。Kubernetes 也提供稳定、兼容的基础(平台) , 用于构建定制化的 workflows 和更高级的自动化任务。
Kubernetes 具备完善的集群管理能力 , 包括多层次的安全防护和准入机制、多租户应用支撑能力、透明的服务注册和服务发现机制、内建负载均衡器、故障发现和自我修复能力、服务滚动升级和在线扩容、可扩展的资源自动调度机制、多粒度的资源配额管理能力。Kubernetes 还提供完善的管理工具 , 涵盖开发、部署测试、运维监控等各个环节。
2. kubernets架构
Kubernetes 借鉴了 Borg 的设计理念 , 比如 Pod、Service、Label 和单 Pod 单 IP 等。Kubernetes 的整体架构跟 Borg 非常像 , 如下图所示。
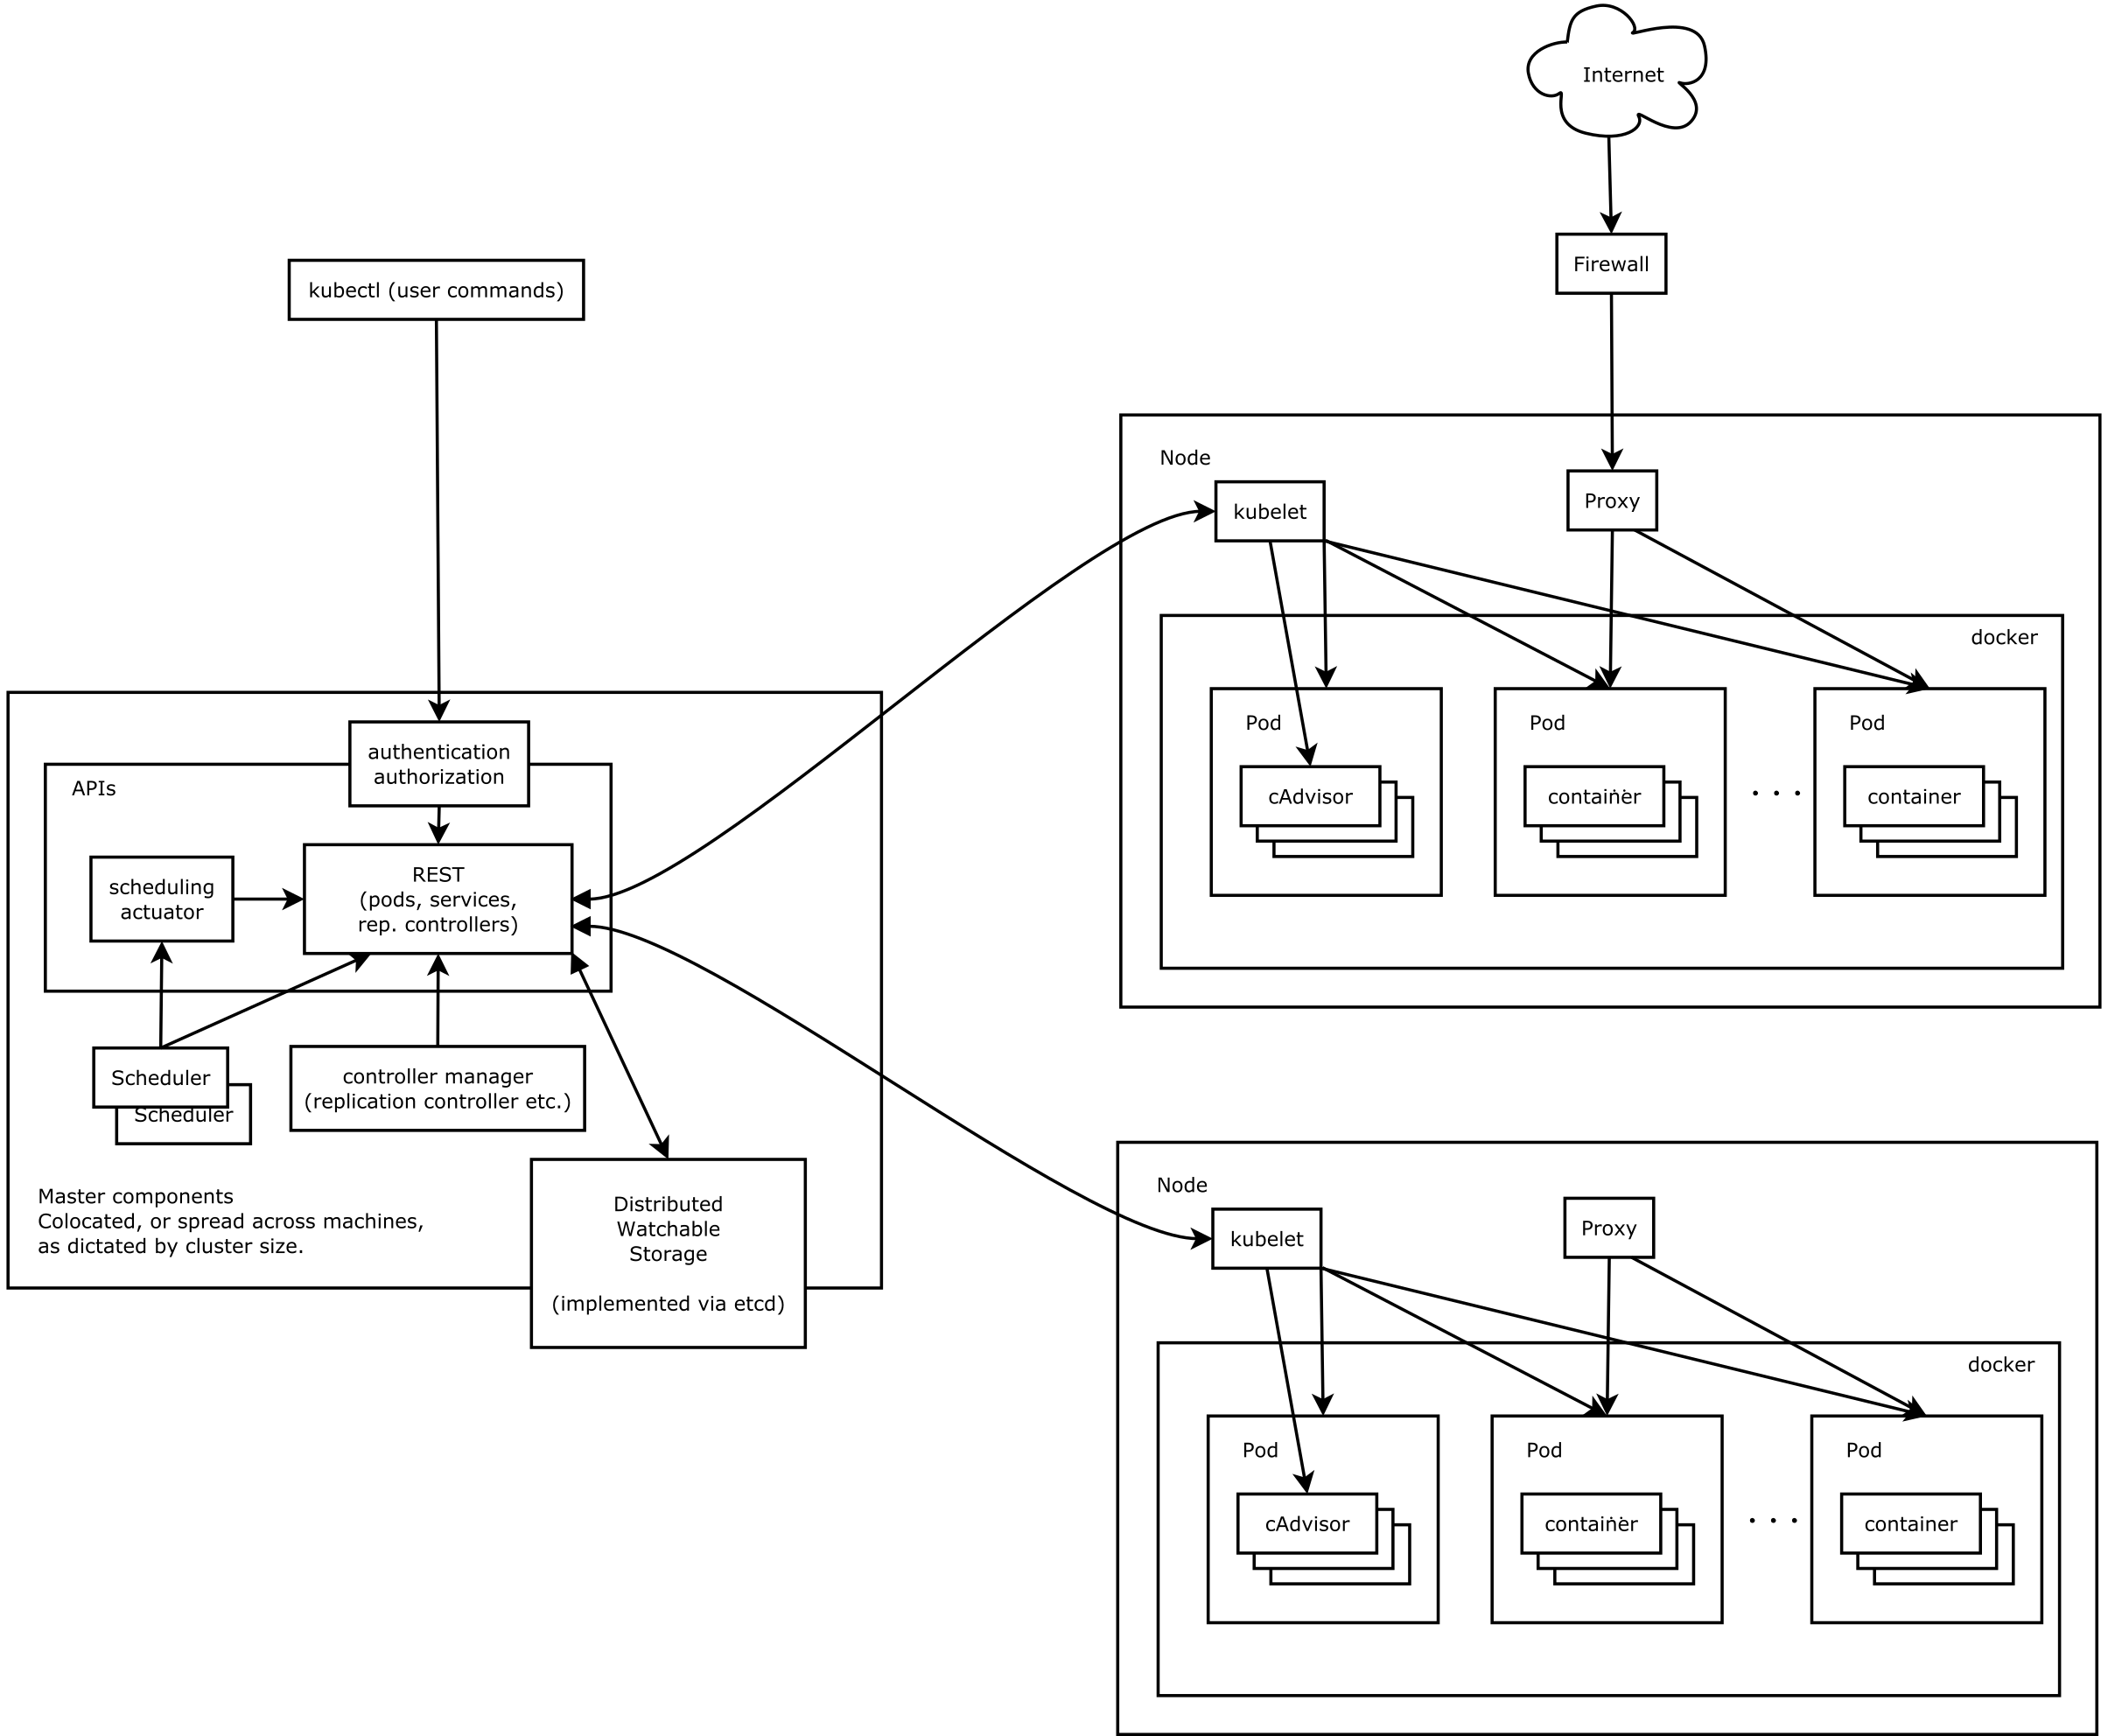
Kubernetes 主要由以下几个核心组件组成:
etcd保存了整个集群的状态 ;apiserver提供了资源操作的唯一入口 , 并提供认证、授权、访问控制、API 注册和发现等机制 ;controller manager负责维护集群的状态 , 比如故障检测、自动扩展、滚动更新等 ;scheduler负责资源的调度 , 按照预定的调度策略将Pod调度到相应的机器上 ;kubelet负责维护容器的生命周期 , 同时也负责Volume(CSI)和网络(CNI)的管理 ;Container runtime负责镜像管理以及Pod和容器的真正运行(CRI) ;kube-proxy负责为Service提供cluster内部的服务发现和负载均衡 ;
除了核心组件 , 还有一些推荐的插件 , 其中有的已经成为 CNCF 中的托管项目:
CoreDNS负责为整个集群提供DNS服务Ingress Controller为服务提供外网入口Prometheus提供资源监控Dashboard提供GUIFederation提供跨可用区的集群
2.1 整体架构
下图清晰表明了 Kubernetes 的架构设计以及组件之间的通信协议。
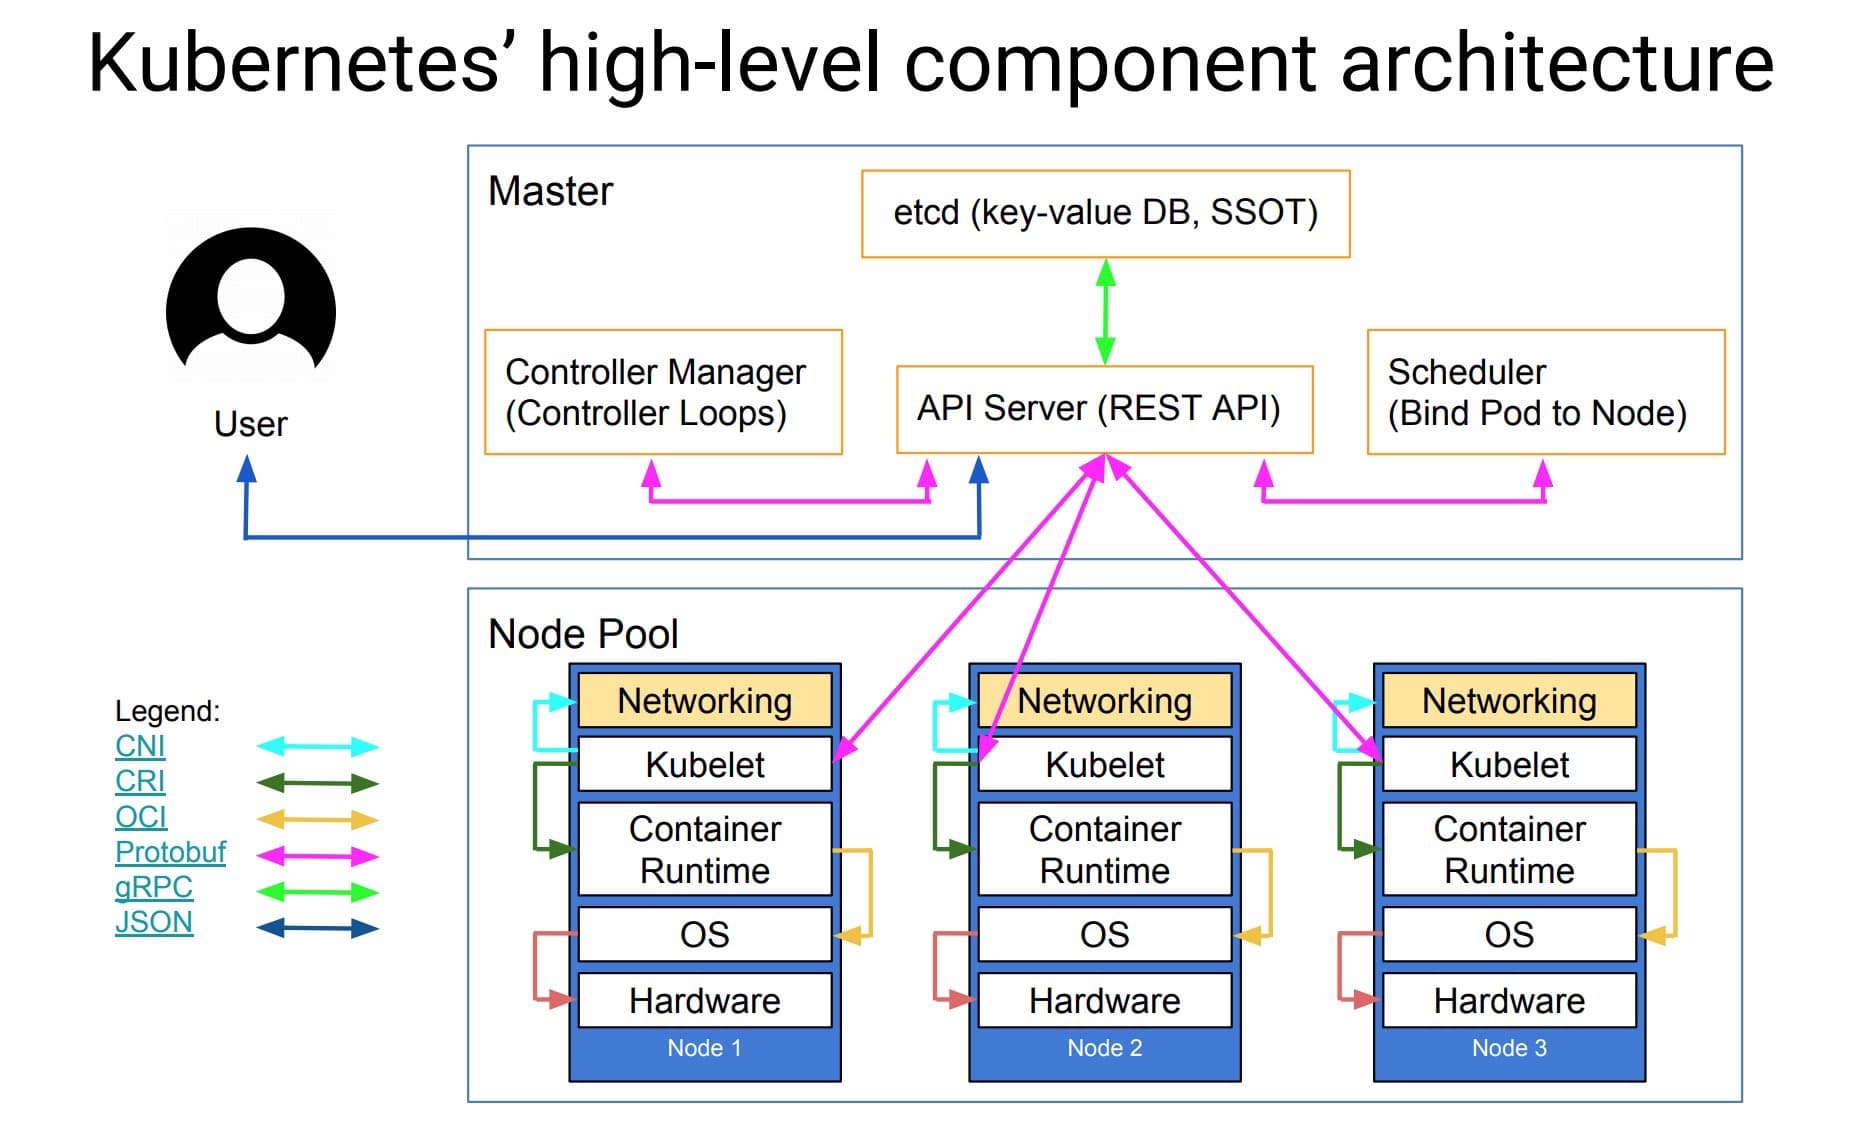
下面是更抽象的一个视图:
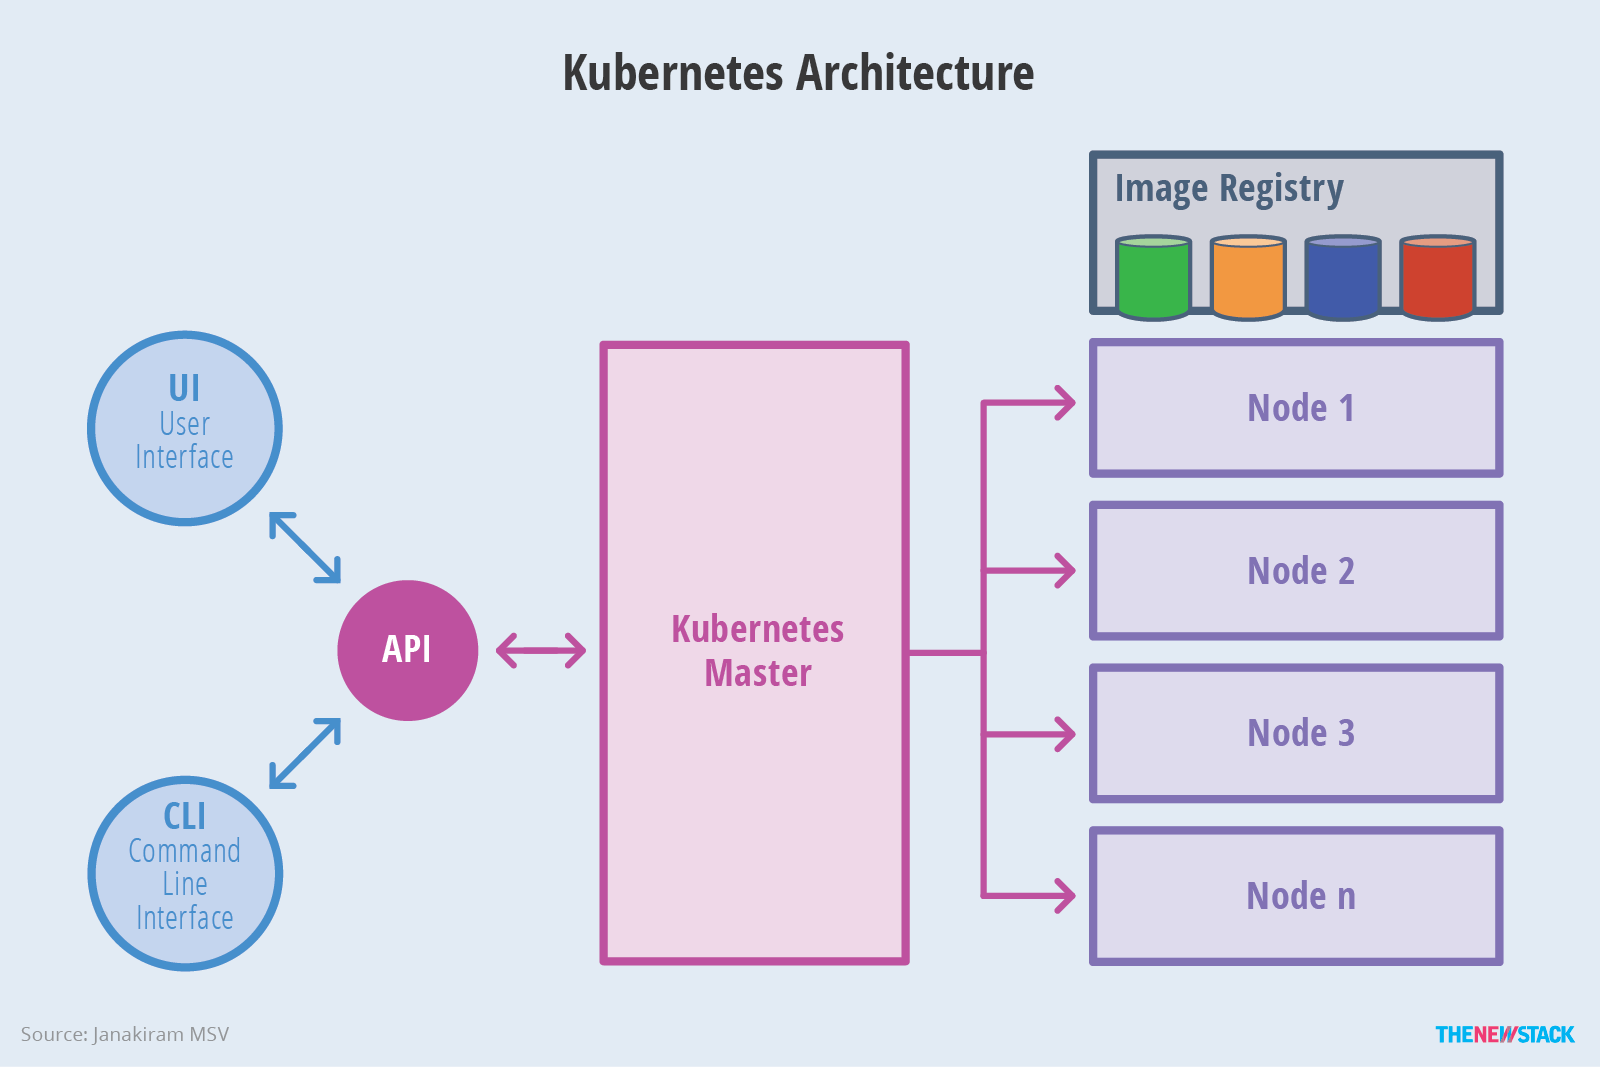
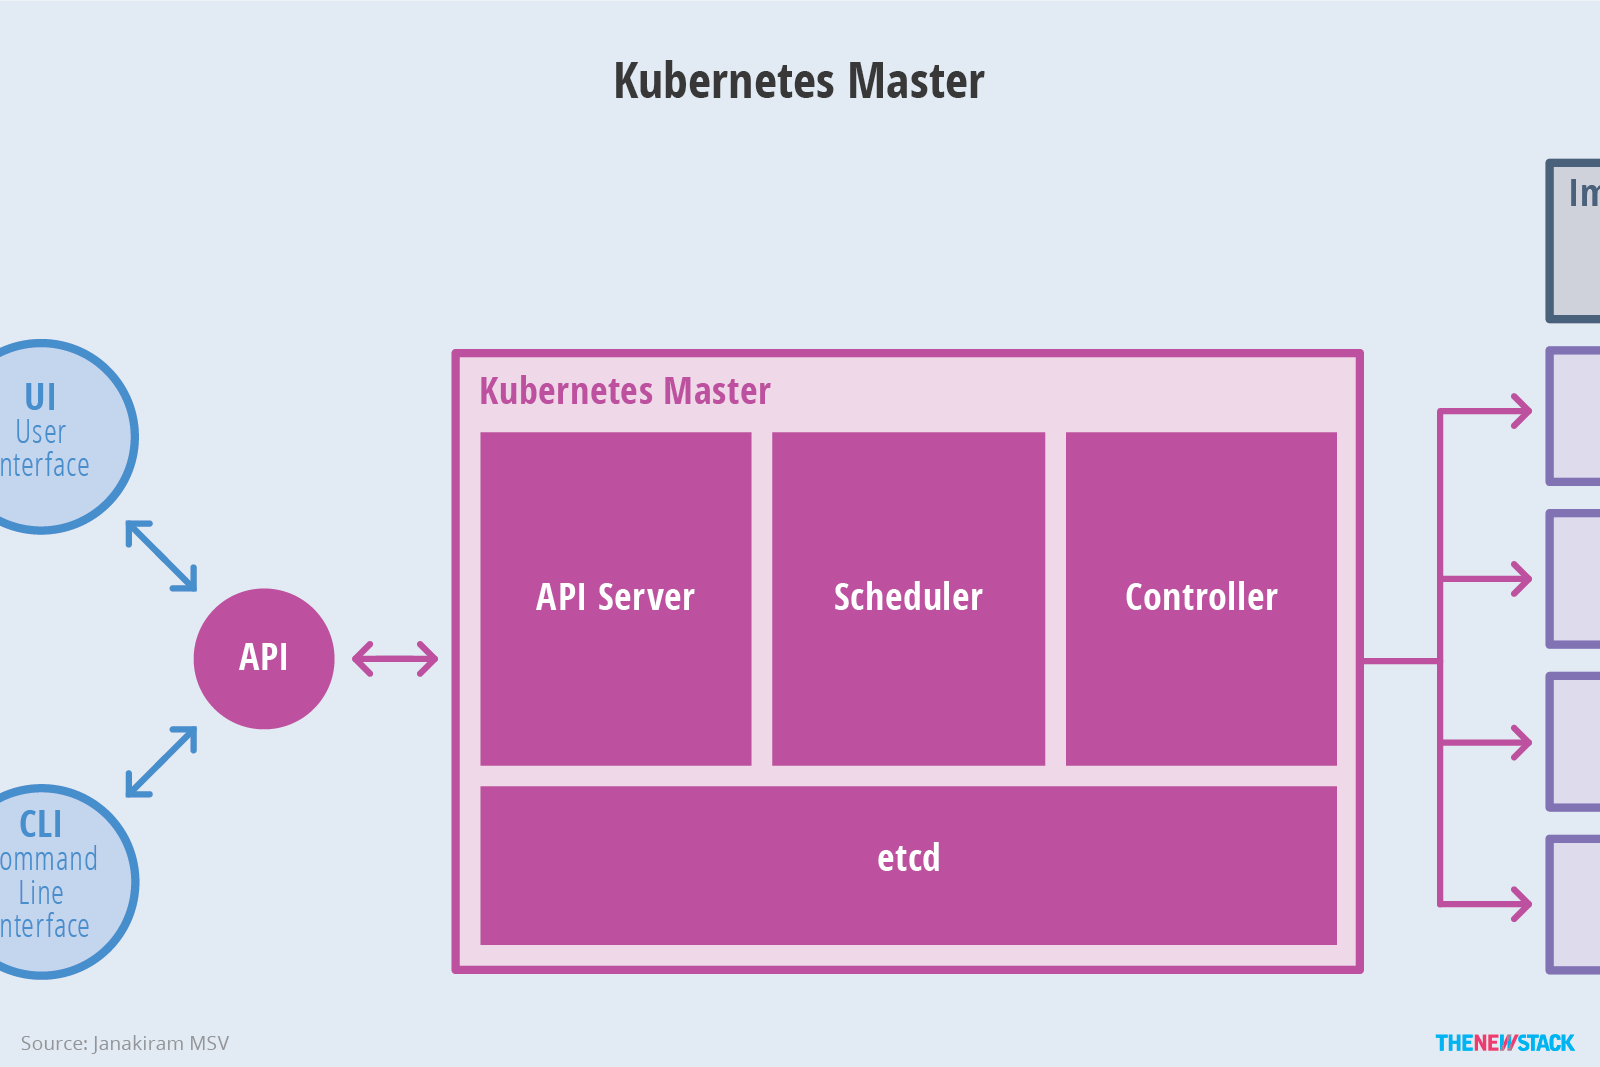
2.2 Master 架构
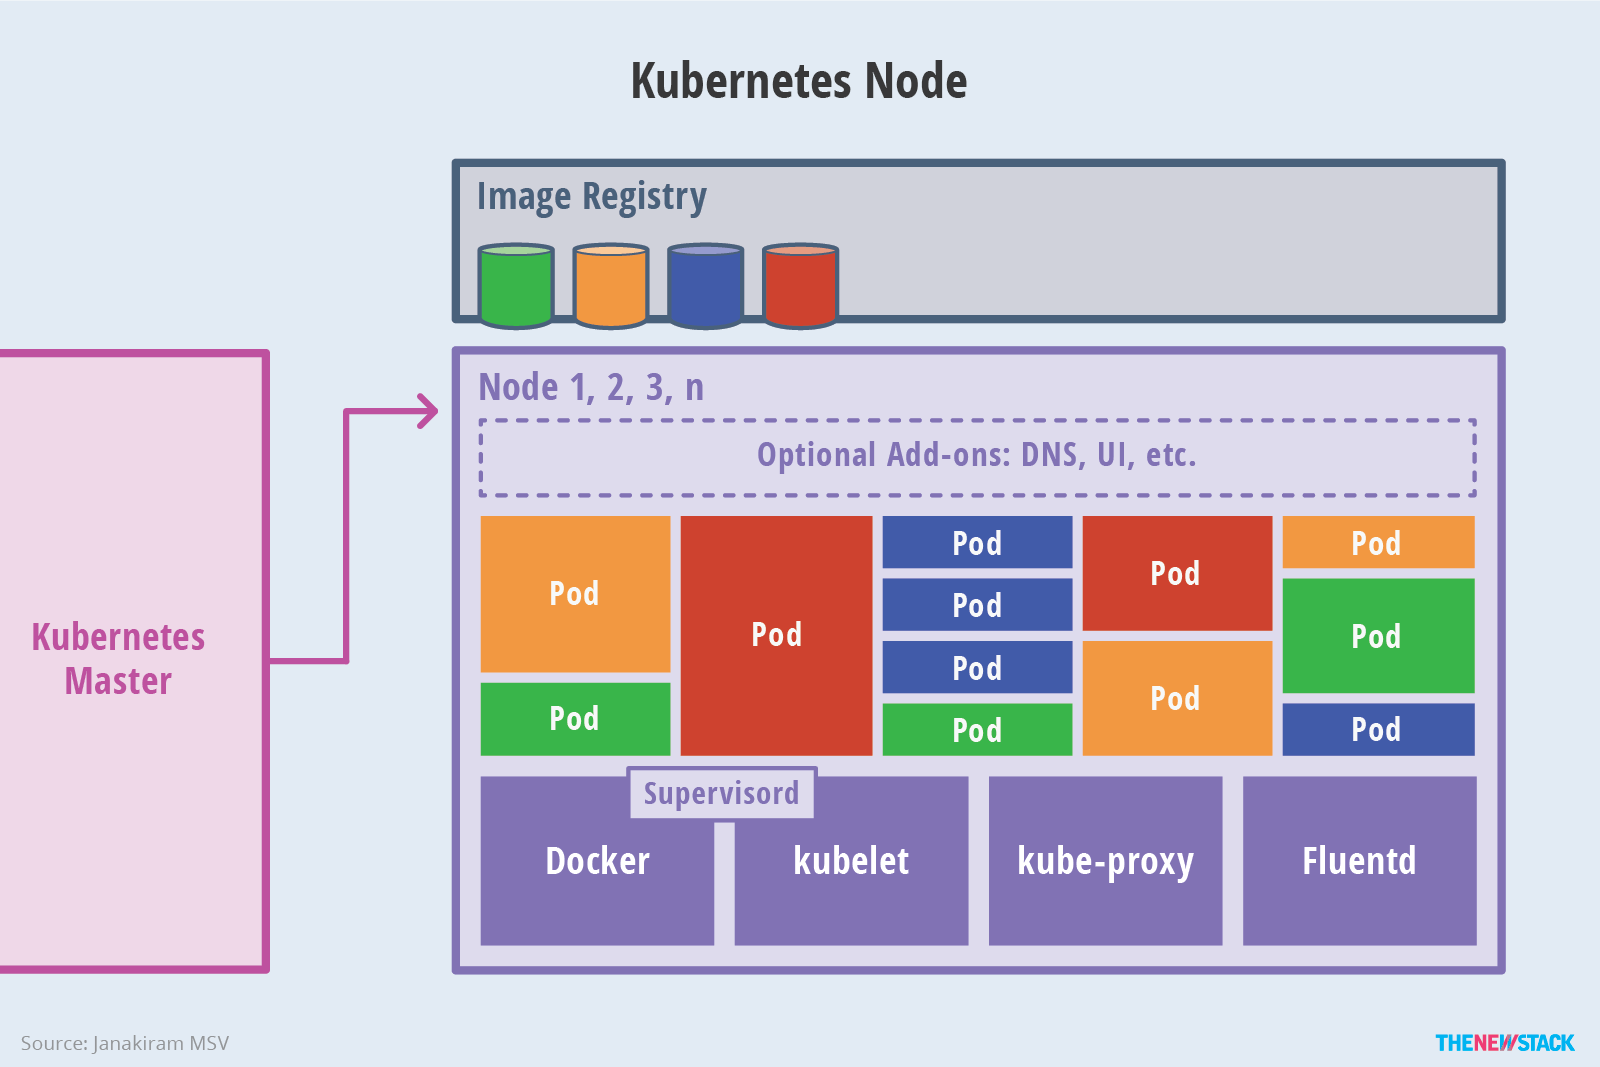
2.3 Node 架构
2.4 分层架构
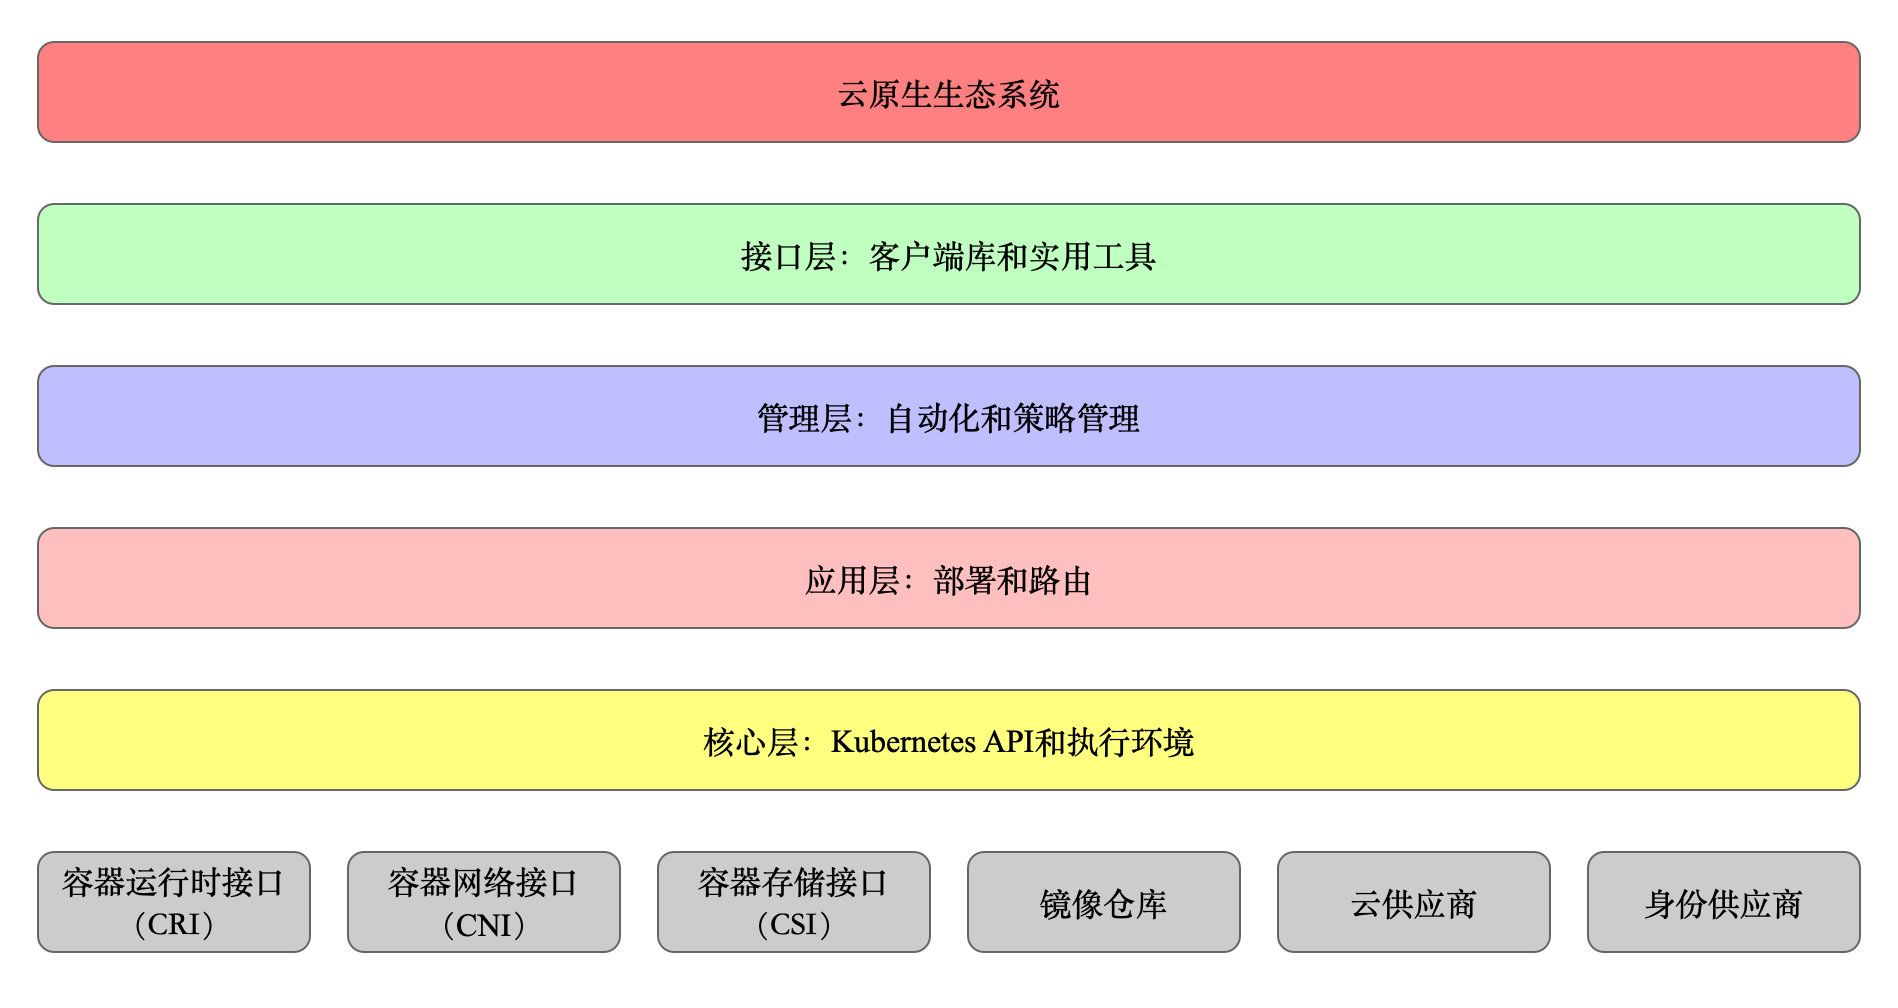
Kubernetes 设计理念和功能其实就是一个类似 Linux 的分层架构 , 如下图所示。
核心层:
Kubernetes最核心的功能 , 对外提供API构建高层的应用 , 对内提供插件式应用执行环境应用层: 部署(无状态应用、有状态应用、批处理任务、集群应用等)和路由(服务发现、
DNS解析等)、Service Mesh(部分位于应用层)管理层: 系统度量(如基础设施、容器和网络的度量) , 自动化(如自动扩展、动态
Provision等)以及策略管理(RBAC、Quota、PSP、NetworkPolicy等)、Service Mesh(部分位于管理层)接口层:
kubectl命令行工具、客户端SDK以及集群联邦生态系统: 在接口层之上的庞大容器集群管理调度的生态系统 , 可以划分为两个范畴
Kubernetes外部: 日志、监控、配置管理、CI/CD、Workflow、FaaS、OTS应用、ChatOps、GitOps、SecOps等Kubernetes内部:CRI、CNI、CSI、镜像仓库、Cloud Provider、集群自身的配置和管理等
2.5 架构原理
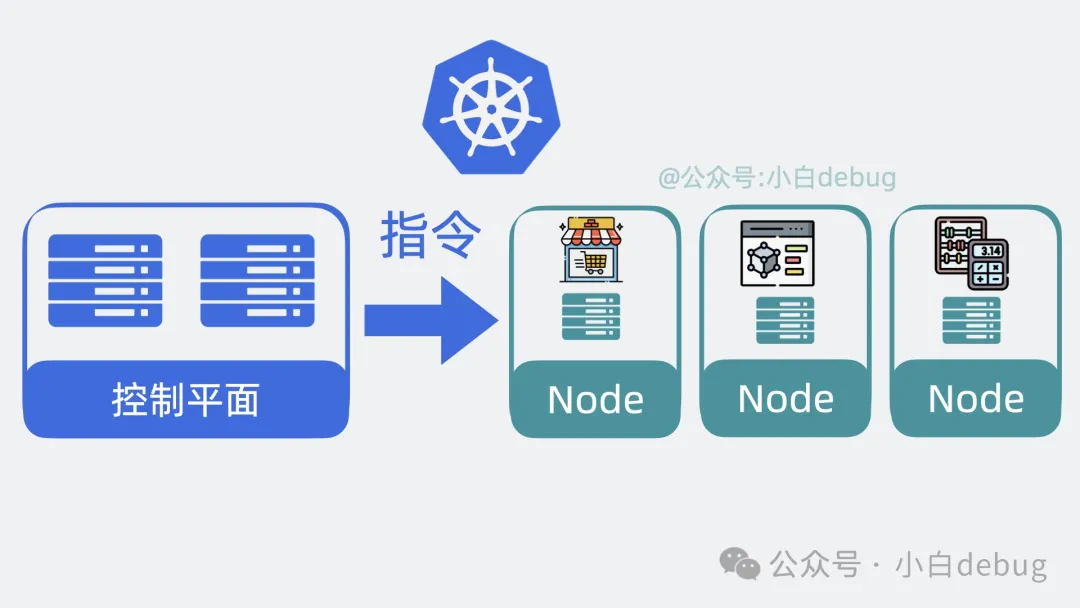
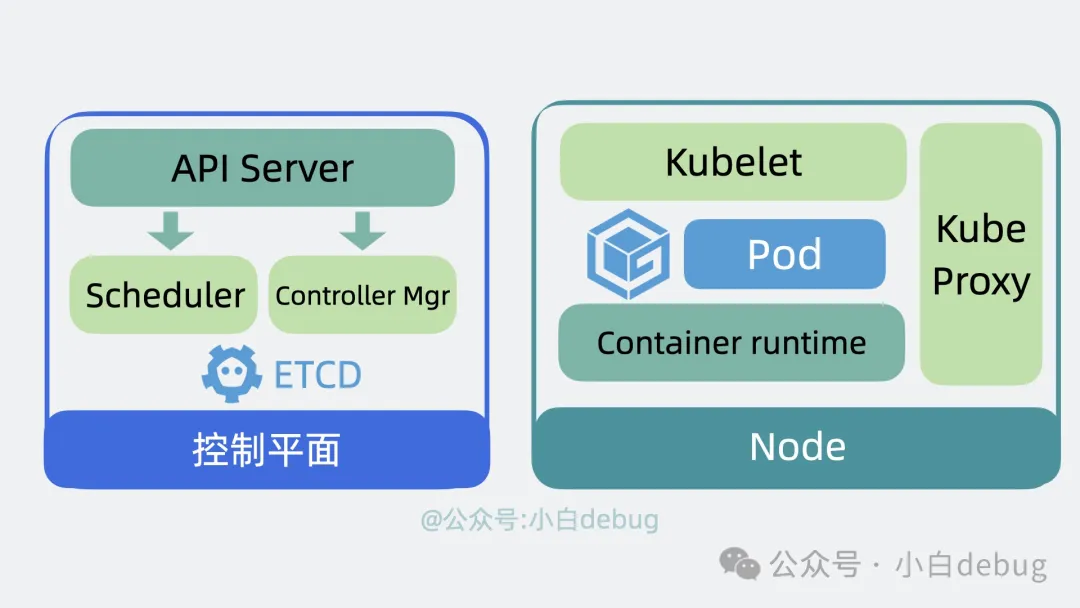
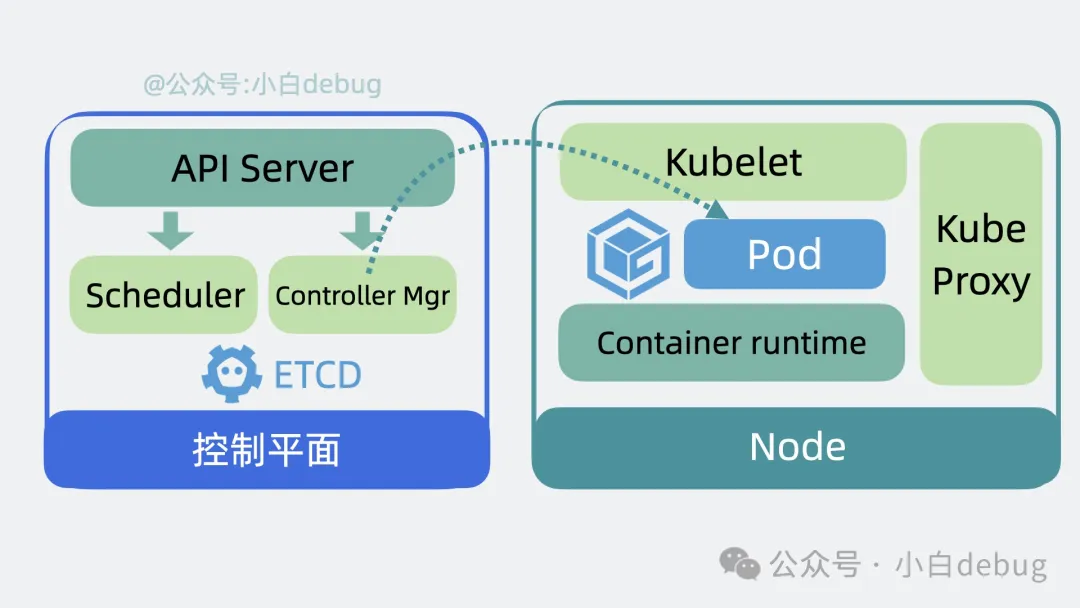
为了实现上面的功能 , Kubernetes 会将我们的服务器划为两部分 , 一部分叫控制平面(control plane , 以前叫master) , 另一部分叫工作节点 , 也就是 Node。简单来说它们的关系就是老板和打工人 。控制平面负责控制和管理各个 Node , 而 Node 则负责实际运行各个应用服务。
2.5.1 控制平面内部组件
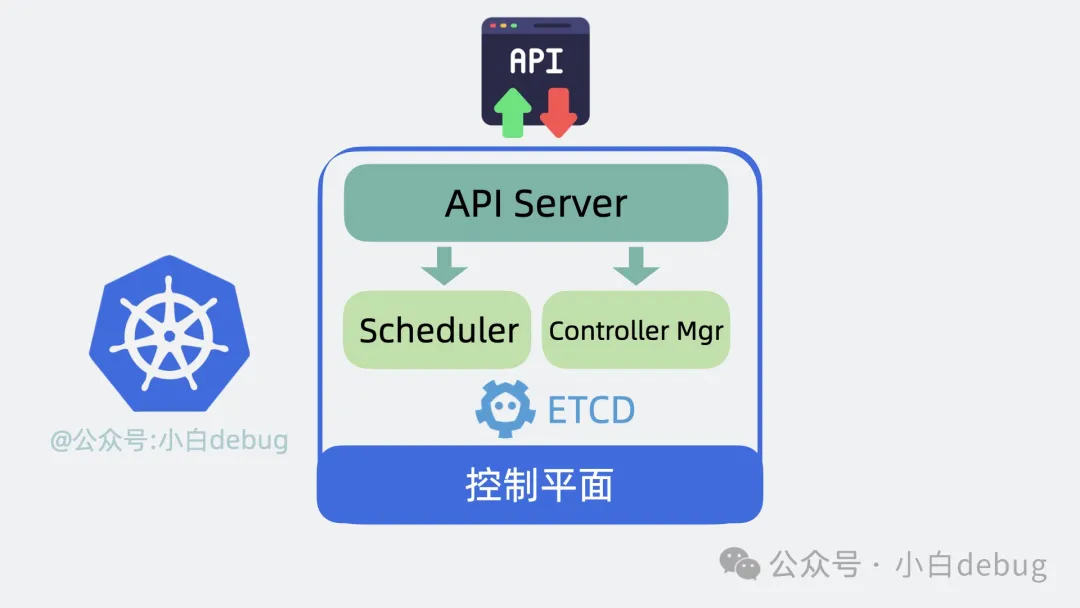
以前我们需要登录到每台服务器上 , 手动执行各种命令 , 现在我们只需要调用
k8s的提供的api接口 , 就能操作这些服务资源 , 这些接口都由API Server组件提供。以前我们需要到处看下哪台服务器
cpu和内存资源充足 , 然后才能部署应用 , 现在这部分决策逻辑由Scheduler(调度器)来完成。找到服务器后 , 以前我们会手动创建 , 关闭服务 , 现在这部分功能由
Controller Manager(控制器管理器)来负责。上面的功能都会产生一些数据 , 这些数据需要被保存起来 , 方便后续做逻辑 , 因此
k8s还会需要一个存储层 , 用来存放各种数据信息 , 目前是用的etcd, 这部分源码实现的很解耦 , 后续可能会扩展支持其他中间件。
以上就是控制平面内部的组件。
2.5.2 Node 内部组件
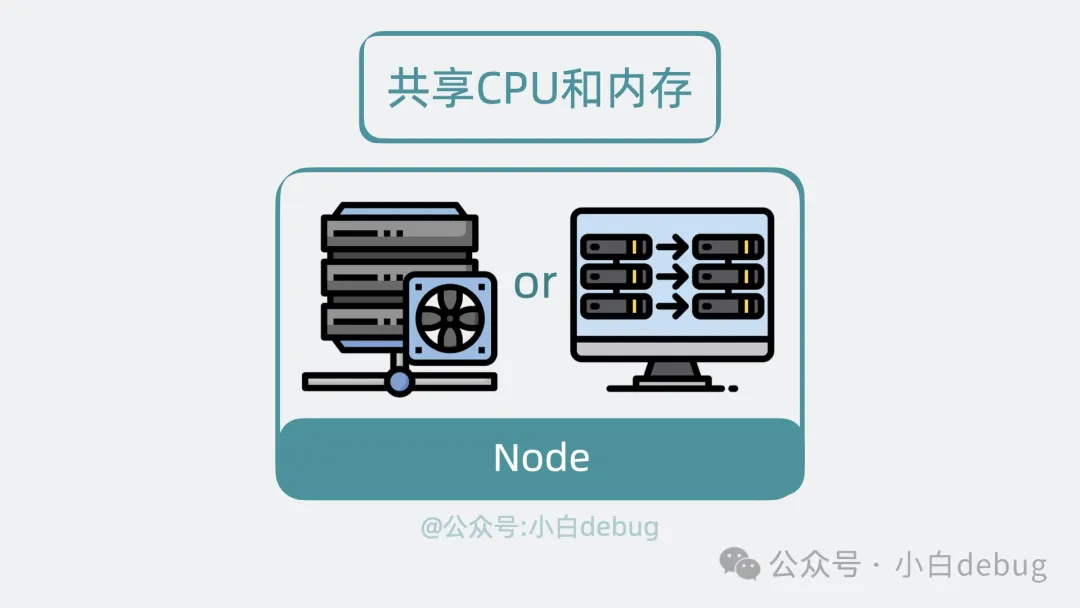
Node 是实际的工作节点 , 它既可以是裸机服务器 , 也可以是虚拟机。它会负责实际运行各个应用服务。多个应用服务共享一台 Node 上的内存和 CPU 等计算资源。
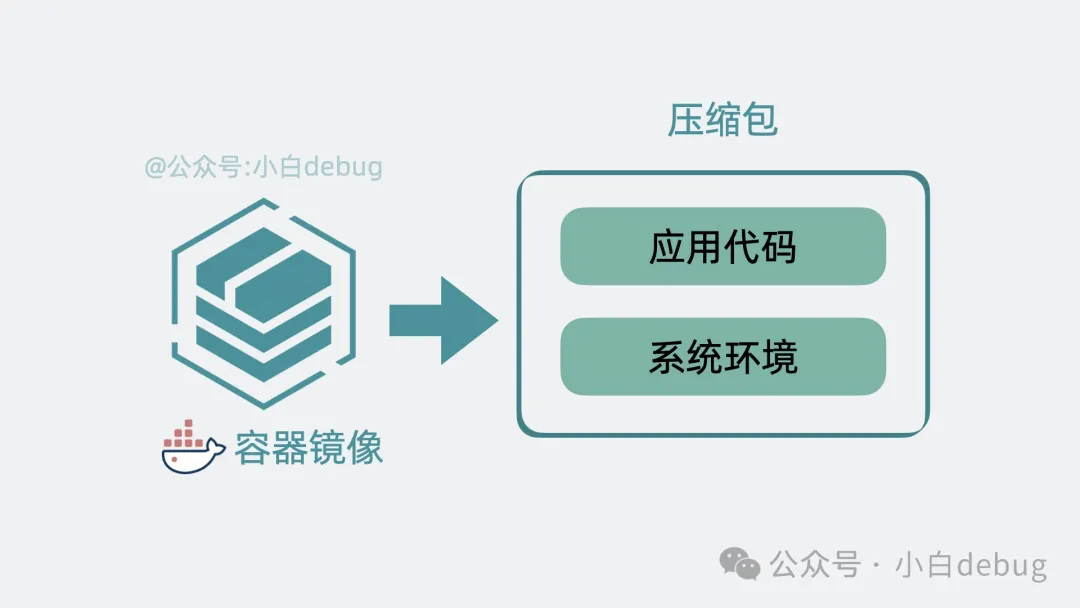
以前我们需要上传代码到服务器 , 而用了 k8s 之后 , 我们只需要将服务代码打包成Container Image(容器镜像) , 就能一行命令将它部署。
如果你不了解容器镜像的含义 , 你可以简单理解为它其实就是将应用代码和依赖的系统环境打了个压缩包 , 在任意一台机器上解压这个压缩包 , 就能正常运行服务。为了下载和部署镜像 , Node 中会有一个 Container runtime 组件。
每个应用服务都可以认为是一个 Container(容器), 并且大多数时候 , 我们还会为应用服务搭配一个日志收集器 Container 或监控收集器 Container , 多个 Container 共同组成一个一个 Pod , 它运行在 Node 上。
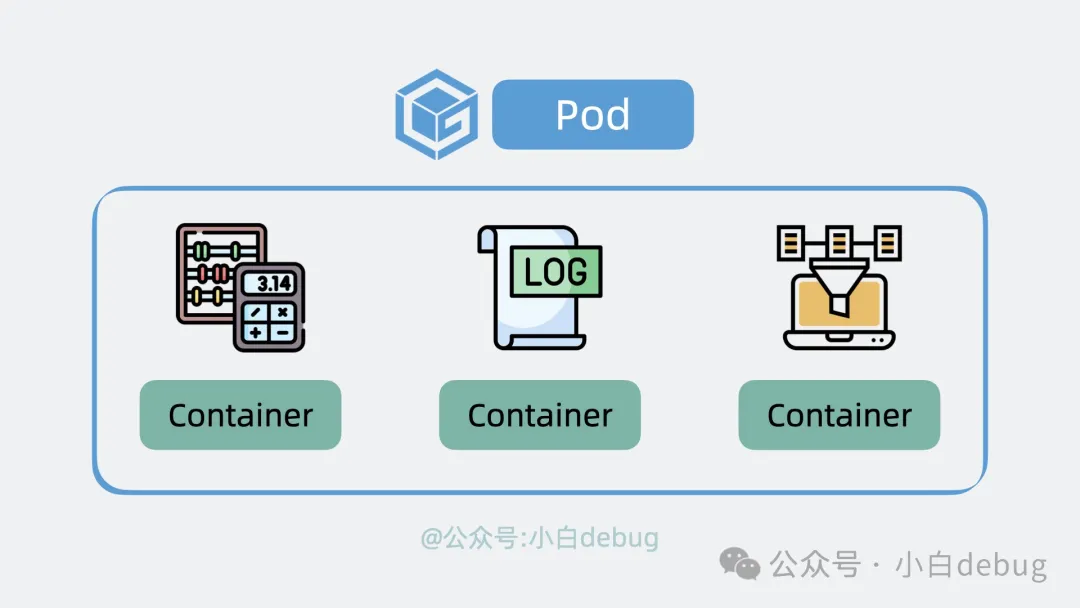
k8s 可以将 pod 从某个 Node 调度到另一个 Node , 还能以 pod 为单位去做重启和动态扩缩容的操作。 所以说 Pod 是 k8s 中最小的调度单位。
另外 , 前面提到控制平面会用 Controller Manager (通过API Server)控制 Node 创建和关闭服务 , 那 Node 也得有个组件能接收到这个命令才能去做这些动作 , 这个组件叫 kubelet , 它主要负责管理和监控 Pod。最后 , Node 中还有个 Kube Proxy , 它负责 Node 的网络通信功能 , 有了它 , 外部请求就能被转发到 Pod 内。
2.5.3 Cluster
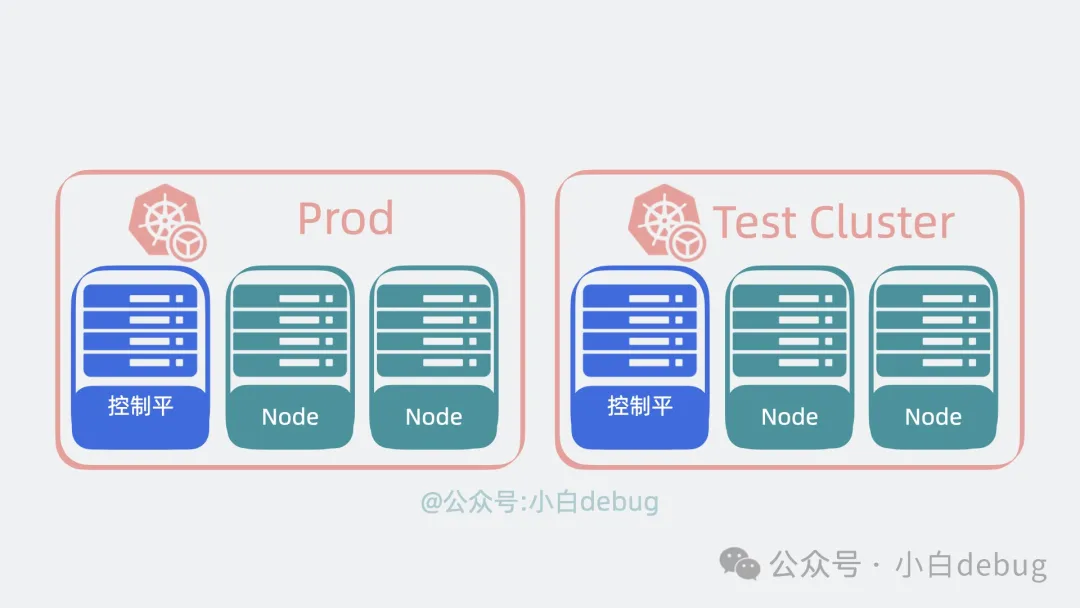
控制平面和Node 共同构成了一个 Cluster , 也就是集群。在公司里 , 我们一般会构建多个集群, 比如测试环境用一个集群 , 生产环境用另外一个集群。同时 , 为了将集群内部的服务暴露给外部用户使用 , 我们一般还会部署一个入口控制器 , 比如 Ingress 控制器(比如Nginx) , 它可以提供一个入口让外部用户访问集群内部服务。
2.5.4 kubectl 是什么
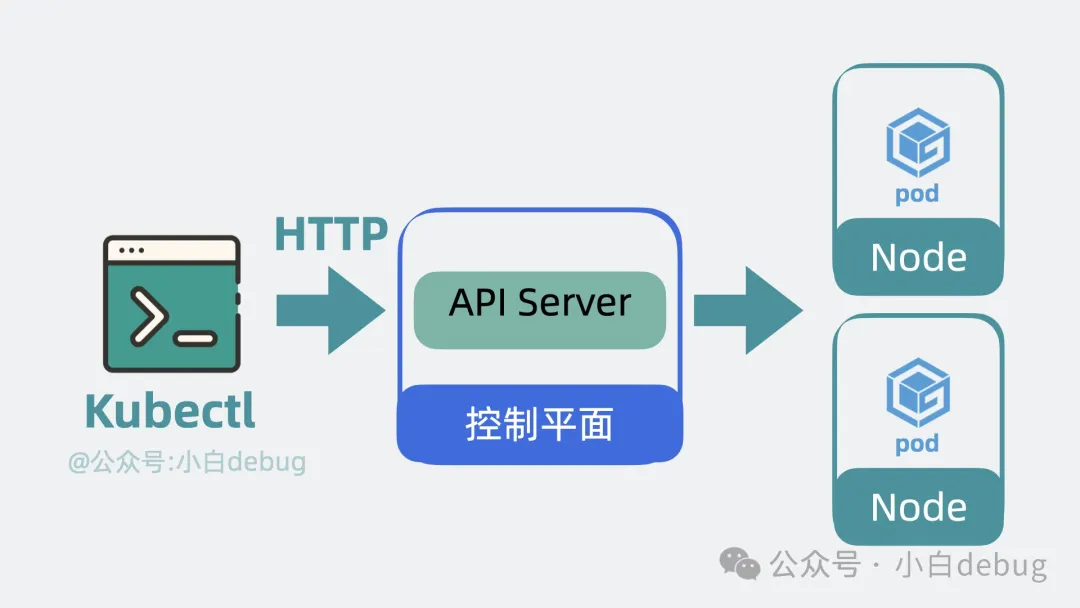
上面提到说我们可以使用 k8s 提供的 API 去创建服务 , 但问题就来了 , 这是需要我们自己写代码去调用这些 API 吗?答案是不需要 , k8s 为我们准备了一个命令行工具 kubectl , 我们只需要执行命令 , 它内部就会调用 k8s 的 API。
2.5.5 怎么部署服务?
首先我们需要编写 YAML 文件 , 在里面定义 Pod 里用到了哪些镜像 , 占用多少内存和 CPU 等信息。然后使用 kubectl 命令行工具执行 kubectl apply -f xx.yaml , 此时 kubectl 会读取和解析 YAML 文件 , 将解析后的对象通过 API 请求发送给 Kubernetes 控制平面内 的 API Server。API Server 会根据要求 , 驱使 Scheduler 通过 etcd 提供的数据寻找合适的 Node , Controller Manager 会通过 API Server 控制 Node 创建服务 , Node 内部的 kubelet 在收到命令后会开始基于 Container runtime 组件去拉取镜像创建容器 , 最终完成 Pod 的创建。
至此服务完成创建。
2.5.6 怎么调用服务?
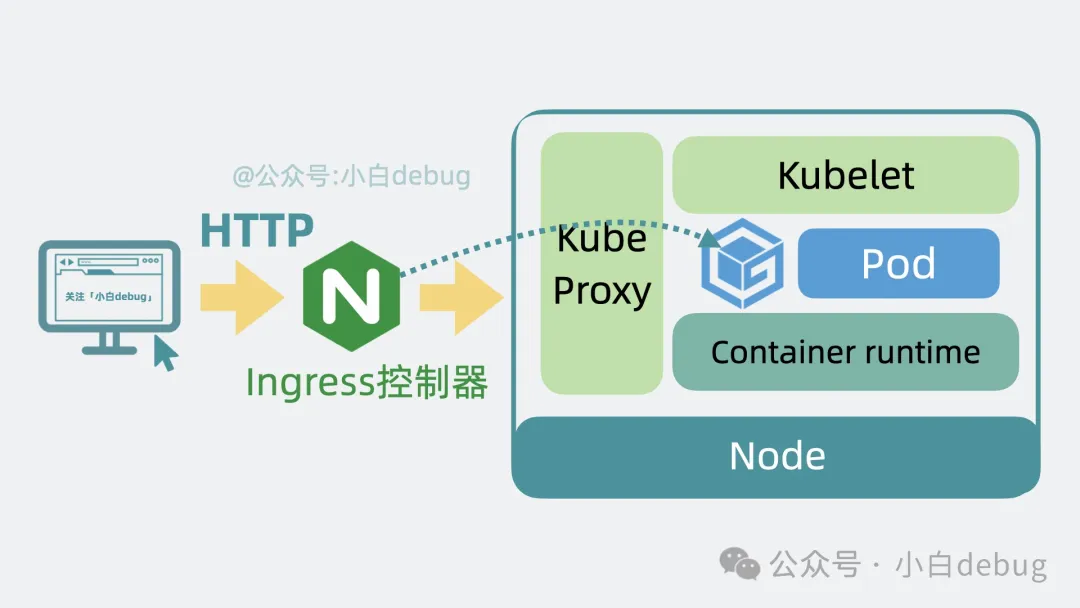
以前外部用户小明,直接在浏览器上发送 http 请求,就能打到我们服务器上的 Nginx,然后转发到部署的服务内。用了 k8s 之后,外部请求会先到达 Kubernetes 集群的 Ingress 控制器,然后请求会被转发到 Kubernetes 内部的某个 Node 的 Kube Proxy 上,再找到对应的 pod,然后才是转发到内部容器服务中,处理结果原路返回,到这就完成了一次服务调用。
3. kubernetes设计理念
3.1 API 设计原则
对于云计算系统 , 系统 API 实际上处于系统设计的统领地位 , 正如本文前面所说 , Kubernetes 集群系统每支持一项新功能 , 引入一项新技术 , 一定会新引入对应的 API 对象 , 支持对该功能的管理操作 , 理解掌握的 API , 就好比抓住了 Kubernetes 系统的牛鼻子。Kubernetes 系统 API 的设计有以下几条原则:
所有
API应该是声明式的。正如前文所说 , 声明式的操作 , 相对于命令式操作 , 对于重复操作的效果是稳定的 , 这对于容易出现数据丢失或重复的分布式环境来说是很重要的。另外 , 声明式操作更容易被用户使用 , 可以使系统向用户隐藏实现的细节 , 隐藏实现的细节的同时 , 也就保留了系统未来持续优化的可能性。此外 , 声明式的API, 同时隐含了所有的API对象都是名词性质的 , 例如Service、Volume这些API都是名词 , 这些名词描述了用户所期望得到的一个目标分布式对象。API对象是彼此互补而且可组合的。这里面实际是鼓励API对象尽量实现面向对象设计时的要求 , 即“高内聚 , 松耦合” , 对业务相关的概念有一个合适的分解 , 提高分解出来的对象的可重用性。事实上 ,Kubernetes这种分布式系统管理平台 , 也是一种业务系统 , 只不过它的业务就是调度和管理容器服务。高层
API以操作意图为基础设计。如何能够设计好API, 跟如何能用面向对象的方法设计好应用系统有相通的地方 , 高层设计一定是从业务出发 , 而不是过早的从技术实现出发。因此 , 针对Kubernetes的高层API设计 , 一定是以Kubernetes的业务为基础出发 , 也就是以系统调度管理容器的操作意图为基础设计。低层
API根据高层API的控制需要设计。设计实现低层API的目的 , 是为了被高层API使用 , 考虑减少冗余、提高重用性的目的 , 低层 ~的设计也要以需求为基础 , 要尽量抵抗受技术实现影响的诱惑。尽量避免简单封装 , 不要有在外部
API无法显式知道的内部隐藏的机制。简单的封装 , 实际没有提供新的功能 , 反而增加了对所封装API的依赖性。内部隐藏的机制也是非常不利于系统维护的设计方式 , 例如StatefulSet和ReplicaSet, 本来就是两种Pod集合 , 那么Kubernetes就用不同API对象来定义它们 , 而不会说只用同一个ReplicaSet, 内部通过特殊的算法再来区分这个ReplicaSet是有状态的还是无状态。API操作复杂度与对象数量成正比。这一条主要是从系统性能角度考虑 , 要保证整个系统随着系统规模的扩大 , 性能不会迅速变慢到无法使用 , 那么最低的限定就是API的操作复杂度不能超过O(N),N是对象的数量 , 否则系统就不具备水平伸缩性了。API对象状态不能依赖于网络连接状态。由于众所周知 , 在分布式环境下 , 网络连接断开是经常发生的事情 , 因此要保证API对象状态能应对网络的不稳定 ,API对象的状态就不能依赖于网络连接状态。尽量避免让操作机制依赖于全局状态 , 因为在分布式系统中要保证全局状态的同步是非常困难的。
3.2 控制机制设计原则
控制逻辑应该只依赖于当前状态。这是为了保证分布式系统的稳定可靠 , 对于经常出现局部错误的分布式系统 , 如果控制逻辑只依赖当前状态 , 那么就非常容易将一个暂时出现故障的系统恢复到正常状态 , 因为你只要将该系统重置到某个稳定状态 , 就可以自信的知道系统的所有控制逻辑会开始按照正常方式运行。
假设任何错误的可能 , 并做容错处理。在一个分布式系统中出现局部和临时错误是大概率事件。错误可能来自于物理系统故障 , 外部系统故障也可能来自于系统自身的代码错误 , 依靠自己实现的代码不会出错来保证系统稳定其实也是难以实现的 , 因此要设计对任何可能错误的容错处理。
尽量避免复杂状态机 , 控制逻辑不要依赖无法监控的内部状态。因为分布式系统各个子系统都是不能严格通过程序内部保持同步的 , 所以如果两个子系统的控制逻辑如果互相有影响 , 那么子系统就一定要能互相访问到影响控制逻辑的状态 , 否则 , 就等同于系统里存在不确定的控制逻辑。
假设任何操作都可能被任何操作对象拒绝 , 甚至被错误解析。由于分布式系统的复杂性以及各子系统的相对独立性 , 不同子系统经常来自不同的开发团队 , 所以不能奢望任何操作被另一个子系统以正确的方式处理 , 要保证出现错误的时候 , 操作级别的错误不会影响到系统稳定性。
每个模块都可以在出错后自动恢复。由于分布式系统中无法保证系统各个模块是始终连接的 , 因此每个模块要有自我修复的能力 , 保证不会因为连接不到其他模块而自我崩溃。
每个模块都可以在必要时优雅地降级服务。所谓优雅地降级服务 , 是对系统鲁棒性的要求 , 即要求在设计实现模块时划分清楚基本功能和高级功能 , 保证基本功能不会依赖高级功能 , 这样同时就保证了不会因为高级功能出现故障而导致整个模块崩溃。根据这种理念实现的系统 , 也更容易快速地增加新的高级功能 , 因为不必担心引入高级功能影响原有的基本功能。
3.3 Kubernetes 的核心技术概念和 API 对象
API 对象是 Kubernetes 集群中的管理操作单元。Kubernetes 集群系统每支持一项新功能,引入一项新技术,一定会新引入对应的 API 对象,支持对该功能的管理操作。例如副本集 Replica Set 对应的 API 对象是 RS 。
每个 API 对象都有 3 大类属性: 元数据 metadata、规范 spec 和状态 status。元数据是用来标识 API 对象的,每个对象都至少有 3 个元数据: namespace,name 和 uid ; 除此以外还有各种各样的标签 labels 用来标识和匹配不同的对象,例如用户可以用标签 env 来标识区分不同的服务部署环境,分别用 env=dev、env=testing、env=production 来标识开发、测试、生产的不同服务。规范描述了用户期望 Kubernetes 集群中的分布式系统达到的理想状态(Desired State),例如用户可以通过复制控制器 Replication Controller 设置期望的 Pod 副本数为 3 ; status 描述了系统实际当前达到的状态(Status),例如系统当前实际的 Pod 副本数为 2 ; 那么复制控制器当前的程序逻辑就是自动启动新的 Pod,争取达到副本数为 3。
Kubernetes 中所有的配置都是通过 API 对象的 spec 去设置的,也就是用户通过配置系统的理想状态来改变系统,这是 Kubernetes 重要设计理念之一 , 即所有的操作都是声明式(Declarative)的而不是命令式(Imperative)的。声明式操作在分布式系统中的好处是稳定,不怕丢操作或运行多次,例如设置副本数为 3 的操作运行多次也还是一个结果,而给副本数加 1 的操作就不是声明式的,运行多次结果就错了。
PodKubernetes有很多技术概念,同时对应很多API对象,最重要的也是最基础的是Pod。Pod是在Kubernetes集群中运行部署应用或服务的最小单元,它是可以支持多容器的。Pod的设计理念是支持多个容器在一个Pod中共享网络地址和文件系统,可以通过进程间通信和文件共享这种简单高效的方式组合完成服务。Pod对多容器的支持是K8最基础的设计理念。比如你运行一个操作系统发行版的软件仓库,一个Nginx容器用来发布软件,另一个容器专门用来从源仓库做同步,这两个容器的镜像不太可能是一个团队开发的,但是他们一块儿工作才能提供一个微服务;这种情况下,不同的团队各自开发构建自己的容器镜像,在部署的时候组合成一个微服务对外提供服务。Pod是Kubernetes集群中所有业务类型的基础,可以看作运行在Kubernetes集群中的小机器人,不同类型的业务就需要不同类型的小机器人去执行。目前Kubernetes中的业务主要可以分为长期伺服型(long-running)、批处理型(batch)、节点后台支撑型(node-daemon)和有状态应用型(stateful application);分别对应的小机器人控制器为Deployment、Job、DaemonSet和StatefulSet,本文后面会一一介绍。副本控制器(
Replication Controller,RC)RC是Kubernetes集群中最早的保证Pod高可用的API对象。通过监控运行中的Pod来保证集群中运行指定数目的Pod副本。指定的数目可以是多个也可以是1个;少于指定数目,RC就会启动运行新的Pod副本;多于指定数目,RC就会杀死多余的Pod副本。即使在指定数目为1的情况下,通过RC运行Pod也比直接运行Pod更明智,因为RC也可以发挥它高可用的能力,保证永远有1个Pod在运行。RC是Kubernetes较早期的技术概念,只适用于长期伺服型的业务类型,比如控制小机器人提供高可用的 Web 服务。副本集(
Replica Set,RS)RS是新一代RC,提供同样的高可用能力,区别主要在于RS后来居上,能支持更多种类的匹配模式。副本集对象一般不单独使用,而是作为Deployment的理想状态参数使用。部署(
Deployment)部署表示用户对
Kubernetes集群的一次更新操作。部署是一个比RS应用模式更广的API对象,可以是创建一个新的服务,更新一个新的服务,也可以是滚动升级一个服务。滚动升级一个服务,实际是创建一个新的RS,然后逐渐将新RS中副本数增加到理想状态,将旧RS中的副本数减小到0的复合操作;这样一个复合操作用一个RS是不太好描述的,所以用一个更通用的Deployment来描述。以Kubernetes的发展方向,未来对所有长期伺服型的的业务的管理,都会通过Deployment来管理。服务(
Service)RC、RS和Deployment只是保证了支撑服务的微服务Pod的数量,但是没有解决如何访问这些服务的问题。一个Pod只是一个运行服务的实例,随时可能在一个节点上停止,在另一个节点以一个新的IP启动一个新的Pod,因此不能以确定的IP和端口号提供服务。要稳定地提供服务需要服务发现和负载均衡能力。服务发现完成的工作,是针对客户端访问的服务,找到对应的的后端服务实例。在K8S集群中,客户端需要访问的服务就是Service对象。每个Service会对应一个集群内部有效的虚拟IP,集群内部通过虚拟 IP 访问一个服务。在Kubernetes集群中微服务的负载均衡是由Kube-proxy实现的。Kube-proxy是Kubernetes集群内部的负载均衡器。它是一个分布式代理服务器,在Kubernetes的每个节点上都有一个;这一设计体现了它的伸缩性优势,需要访问服务的节点越多,提供负载均衡能力的Kube-proxy就越多,高可用节点也随之增多。与之相比,我们平时在服务器端做个反向代理做负载均衡,还要进一步解决反向代理的负载均衡和高可用问题。任务(
Job)Job是Kubernetes用来控制批处理型任务的API对象。批处理业务与长期伺服业务的主要区别是批处理业务的运行有头有尾,而长期伺服业务在用户不停止的情况下永远运行。Job管理的Pod根据用户的设置把任务成功完成就自动退出了。成功完成的标志根据不同的spec.completions策略而不同: 单Pod型任务有一个Pod成功就标志完成;定数成功型任务保证有N个任务全部成功;工作队列型任务根据应用确认的全局成功而标志成功。后台支撑服务集(
DaemonSet)长期伺服型和批处理型服务的核心在业务应用,可能有些节点运行多个同类业务的
Pod,有些节点上又没有这类Pod运行;而后台支撑型服务的核心关注点在Kubernetes集群中的节点(物理机或虚拟机),要保证每个节点上都有一个此类Pod运行。节点可能是所有集群节点也可能是通过nodeSelector选定的一些特定节点。典型的后台支撑型服务包括,存储,日志和监控等在每个节点上支持Kubernetes集群运行的服务。有状态服务集(
StatefulSet)Kubernetes在1.3版本里发布了Alpha版的PetSet功能,在1.5版本里将PetSet功能升级到了Beta版本,并重新命名为StatefulSet, 最终在1.9版本里成为正式GA版本。在云原生应用的体系里,有下面两组近义词;第一组是无状态(stateless)、牲畜(cattle)、无名(nameless)、可丢弃(disposable);第二组是有状态(stateful)、宠物(pet)、有名(having name)、不可丢弃(non-disposable)。RC和RS主要是控制提供无状态服务的,其所控制的Pod的名字是随机设置的,一个Pod出故障了就被丢弃掉,在另一个地方重启一个新的Pod,名字变了。名字和启动在哪儿都不重要,重要的只是Pod总数;而StatefulSet是用来控制有状态服务,StatefulSet中的每个Pod的名字都是事先确定的,不能更改。StatefulSet中Pod的名字的作用,并不是《千与千寻》的人性原因,而是关联与该Pod对应的状态。对于
RC和RS中的Pod,一般不挂载存储或者挂载共享存储,保存的是所有Pod共享的状态,Pod像牲畜一样没有分别(这似乎也确实意味着失去了人性特征) ; 对于StatefulSet中的Pod,每个Pod挂载自己独立的存储,如果一个Pod出现故障,从其他节点启动一个同样名字的Pod,要挂载上原来Pod的存储继续以它的状态提供服务。适合于
StatefulSet的业务包括数据库服务MySQL和PostgreSQL,集群化管理服务ZooKeeper、etcd等有状态服务。StatefulSet的另一种典型应用场景是作为一种比普通容器更稳定可靠的模拟虚拟机的机制。传统的虚拟机正是一种有状态的宠物,运维人员需要不断地维护它,容器刚开始流行时,我们用容器来模拟虚拟机使用,所有状态都保存在容器里,而这已被证明是非常不安全、不可靠的。使用StatefulSet,Pod仍然可以通过漂移到不同节点提供高可用,而存储也可以通过外挂的存储来提供高可靠性,StatefulSet做的只是将确定的Pod与确定的存储关联起来保证状态的连续性。集群联邦(
Federation)Kubernetes在1.3版本里发布了beta版的Federation功能。在云计算环境中,服务的作用距离范围从近到远一般可以有: 同主机(Host,Node)、跨主机同可用区(Available Zone)、跨可用区同地区(Region)、跨地区同服务商(Cloud Service Provider)、跨云平台。Kubernetes的设计定位是单一集群在同一个地域内,因为同一个地区的网络性能才能满足Kubernetes的调度和计算存储连接要求。而联合集群服务就是为提供跨Region跨服务商Kubernetes集群服务而设计的。每个
Kubernetes Federation有自己的分布式存储、API Server和Controller Manager。用户可以通过Federation的API Server注册该Federation的成员Kubernetes Cluster。当用户通过Federation的API Server创建、更改API对象时,Federation API Server会在自己所有注册的子Kubernetes Cluster都创建一份对应的API对象。在提供业务请求服务时,Kubernetes Federation会先在自己的各个子Cluster之间做负载均衡,而对于发送到某个具体Kubernetes Cluster的业务请求,会依照这个Kubernetes Cluster独立提供服务时一样的调度模式去做Kubernetes Cluster内部的负载均衡。而Cluster之间的负载均衡是通过域名服务的负载均衡来实现的。Federation V1的设计是尽量不影响Kubernetes Cluster现有的工作机制,这样对于每个子Kubernetes集群来说,并不需要更外层的有一个Kubernetes Federation,也就是意味着所有现有的Kubernetes代码和机制不需要因为Federation功能有任何变化。目前正在开发的
Federation V2,在保留现有Kubernetes API的同时,会开发新的Federation专用的API接口,存储卷(
Volume)Kubernetes集群中的存储卷跟Docker的存储卷有些类似,只不过Docker的存储卷作用范围为一个容器,而Kubernetes的存储卷的生命周期和作用范围是一个Pod。每个Pod中声明的存储卷由Pod中的所有容器共享。Kubernetes支持非常多的存储卷类型,特别的,支持多种公有云平台的存储,包括AWS,Google和Azure云;支持多种分布式存储包括GlusterFS和Ceph;也支持较容易使用的主机本地目录emptyDir,hostPath和NFS。Kubernetes还支持使用Persistent Volume Claim即PVC这种逻辑存储,使用这种存储,使得存储的使用者可以忽略后台的实际存储技术(例如AWS,Google或GlusterFS和Ceph),而将有关存储实际技术的配置交给存储管理员通过Persistent Volume来配置。持久存储卷(
Persistent Volume,PV)和持久存储卷声明(Persistent Volume Claim,PVC)PV和PVC使得Kubernetes集群具备了存储的逻辑抽象能力,使得在配置Pod的逻辑里可以忽略对实际后台存储技术的配置,而把这项配置的工作交给PV的配置者,即集群的管理者。存储的PV和PVC的这种关系,跟计算的Node和Pod的关系是非常类似的;PV和Node是资源的提供者,根据集群的基础设施变化而变化,由Kubernetes集群管理员配置;而PVC和Pod是资源的使用者,根据业务服务的需求变化而变化,有Kubernetes集群的使用者即服务的管理员来配置。节点(
Node)Kubernetes集群中的计算能力由Node提供,最初Node称为服务节点Minion,后来改名为Node。kubernets集群中的Node也就等同于Mesos集群中的Slave节点,是所有Pod运行所在的工作主机,可以是物理机也可以是虚拟机。不论是物理机还是虚拟机,工作主机的统一特征是上面要运行kubelet管理节点上运行的容器。密钥对象(
Secret)Secret是用来保存和传递密码、密钥、认证凭证这些敏感信息的对象。使用Secret的好处是可以避免把敏感信息明文写在配置文件里。在Kubernetes集群中配置和使用服务不可避免的要用到各种敏感信息实现登录、认证等功能,例如访问AWS存储的用户名密码。为了避免将类似的敏感信息明文写在所有需要使用的配置文件中,可以将这些信息存入一个Secret对象,而在配置文件中通过Secret对象引用这些敏感信息。这种方式的好处包括 : 意图明确,避免重复,减少暴漏机会。用户帐户(
User Account)和服务帐户(Service Account)顾名思义,用户帐户为人提供账户标识,而服务账户为计算机进程和
Kubernetes集群中运行的Pod提供账户标识。用户帐户和服务帐户的一个区别是作用范围;用户帐户对应的是人的身份,人的身份与服务的namespace无关,所以用户账户是跨namespace的;而服务帐户对应的是一个运行中程序的身份,与特定namespace是相关的。命名空间(
Namespace)命名空间为
Kubernetes集群提供虚拟的隔离作用,Kubernetes集群初始有两个命名空间,分别是默认命名空间default和系统命名空间kube-system,除此以外,管理员可以可以创建新的命名空间满足需要。RBAC访问授权Kubernetes在1.3版本中发布了alpha版的基于角色的访问控制(Role-based Access Control,RBAC)的授权模式。相对于基于属性的访问控制(Attribute-based Access Control,ABAC),RBAC主要是引入了角色(Role)和角色绑定(RoleBinding)的抽象概念。在RBAC中,Kubernetes集群中的访问策略只能跟用户直接关联;而在RBAC中,访问策略可以跟某个角色关联,具体的用户在跟一个或多个角色相关联。显然,RBAC像其他新功能一样,每次引入新功能,都会引入新的API对象 , 从而引入新的概念抽象,而这一新的概念抽象一定会使集群服务管理和使用更容易扩展和重用。
4. 应用的运行与互联互通
4.1 pod与service
Pod本质上是共享Network、IPC和UTS名称空间以及存储资源的容 器集合 , 如图2-1所示。我们可以把每个Pod对象想象成一个逻辑主 机 , 它类似于现实世界中的物理主机或虚拟机 , 而运行于同一个Pod对象中多个进程则类似于物理机或虚拟机上独立运行的进程 , 不同的 是 , Pod中各进程运行于彼此隔离的容器中 , 并于各容器间共享网络和 存储两种关键资源。
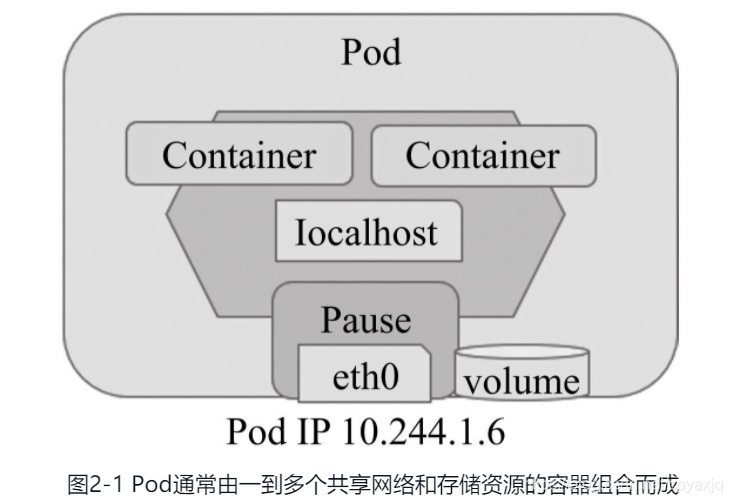
同一Pod内部的各容器具有“超亲密”关系 , 它们共享网络协议栈、网络设备、路由、IP地址和端口等网络资源 , 可以基于本地回环接口lo互相通信。每个Pod上还可附加一组“存储卷”(volume)资 源 , 它们同样可由内部所有容器使用而实现数据共享。持久类型的存储卷还能够确保在容器终止后被重启 , 甚至容器被删除后数据也不会丢失。
同时 , 这些以Pod形式运行于Kubernetes之上的应用通常以服务类程序居多 , 其客户端可能来自集群之外 , 例如现实中的用户 , 也可能 是当前集群中其他Pod中的应用。Kubernetes集群的网络模型要求其各Pod对象的IP地址位于同一网络平面内(同一IP网段) , 各Pod间可使用真实IP地址直接进行通信而无须NAT功能介入 , 无论它们运行于集群内的哪个工作节点之上 , 这些Pod对象就像是运行于同一局域网中的多个主机上。
Pod对象拥有生命周期 , 它会在自身故障或所在的工作节点故障时被替换为一个新的实例 , 其IP地址通常也会随之改变 , 这就给集群中的Pod应用间依赖关系的维护带来了麻烦: 前端Pod应用(依赖方)无法基于固定地址持续跟踪后端Pod应用(被依赖方)。为此 , Kubernetes设计了有着稳定可靠IP地址的Service资源 , 作为一组提供了相同服务的Pod对象的访问入口 , 由客户端Pod向目标Pod所属的 Service对象的IP地址发起访问请求 , 并由相关的Service对象调度并代理至后端的Pod对象。
Service是由基于匹配规则在集群中挑选出的一组Pod对象的集合、访问这组Pod集合的固定IP地址 , 以及对请求进行调度的方法等功 能所构成的一种API资源类型 , 是Pod资源的代理和负载均衡器。 Service匹配Pod对象的规则可用“标签选择器”进行体现 , 并根据标签来过滤符合条件的资源对象 , 如图所示。标签是附加在 Kubernetes API资源对象之上的具有辨识性的分类标识符 , 使用键值型数据表达 , 通常仅对用户具有特定意义。一个对象可以拥有多个标签 , 一个标签也可以附加于多个对象(通常是同一类对象)之上。
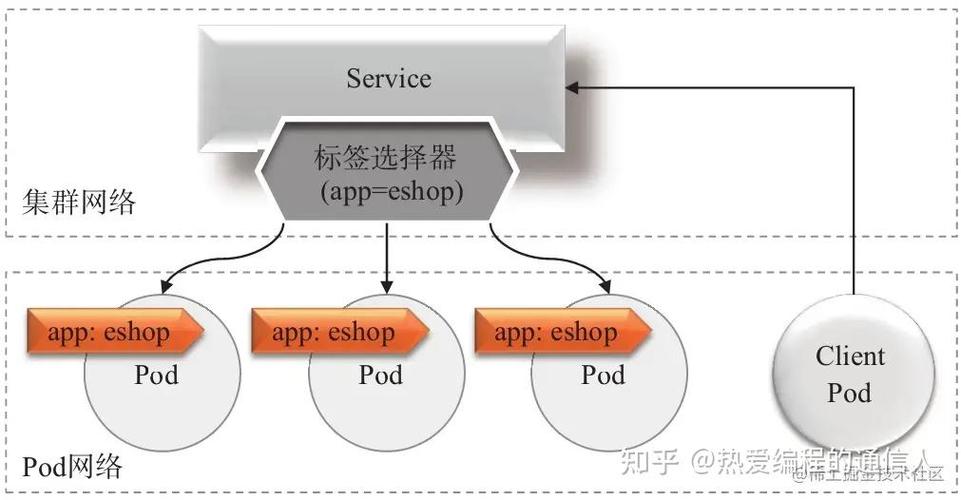
每个节点上运行的kube-proxy组件负责管理各Pod与Service之间 的网络连接 , 它并非Kubernetes内置的代理服务器 , 而是一个基于出站流量的负载均衡器组件。针对每个Service , kube-proxy都会在当前节点上转换并添加相应iptables DNAT规则或ipvs规则 , 从而将目标地址为某Service对象的ClusterIP的流量调度至该Service根据标签选择器匹配出的Pod对象之上。
即使Service有着固定的IP地址可用作服务访问入口 , 但现实中用户更容易记忆和使用的还是服务的名称 , Kubernetes使用定制的DNS服务为这类需求提供了自动的服务注册和服务发现功能。CoreDNS附件会为集群中的每个Service对象(包括DNS服务自身)生成唯一的DNS名称标识 , 以及相应的DNS资源记录 , 服务的DNS名称遵循标准的 svc.namespace.svc.cluster-domain格式。例如CoreDNS自身的服务名称为kube-dns.kube-system.svc.cluster.local. , 则它的ClusterIP 通常是10.96.0.10。
除非出于管理目的有意调整 , Service资源的名称和ClusterIP在 其整个生命周期内都不会发生变动。kubelet会在创建Pod容器时 , 自动在/etc/resolv.conf文件中配置Pod容器使用集群上CoreDNS服务的 ClusterIP作为DNS服务器 , 因而各Pod可针对任何Service的名称直接请求相应的服务。换句话说 , Pod可通过kube-dns.kube-system.svc.cluster.local.来访问集群DNS服务。
4.2 pod控制器
Pod有着生命周期 , 且非正常终止的Pod对象本身不具有“自愈” 功能 , 若kubelet在Pod监视周期中发现故障 , 将重启或创建新的Pod实 例来取代故障的实例以完成Pod实例恢复。但因kubelet程序或工作节点故障时导致的Pod实例故障却无从恢复。另外 , 因资源耗尽或节点故障导致的回收操作也会删除相关的Pod实例。因而 , 我们需要借助专用 于管控Pod对象的控制器资源来构建能够跨越工作节点生命周期的Pod 实例 , 例如Deployment或StatefulSet等控制器。
控制器是支撑Kubernetes声明式API的关键组件 , 它持续监视对 API Server上的API对象的添加、更新和删除等更改操作 , 并在发生此 类事件时执行目标对象相应的业务逻辑 , 从而将客户端的管理指令转 为对象管理所需要的真正的操作过程。简单来说 , 一个具体的控制器 对象是一个控制循环程序 , 它在单个API对象上创建一个控制循环以确 保该对象的状态符合预期。不同类型的Pod控制器在不同维度完成符合应用需求的管理模式 , 例如Deployment控制器资源可基于“Pod模板” 创建Pod实例 , 并确保实例数目精确反映期望的数量 ; 另外 , 控制器还支持应用规模中Pod实例的自动扩容、缩容、滚动更新和回滚 , 以及创建工作节点故障时的重建等运维管理操作。图中的Deployment就是这类控制器的代表实现 , 是目前最常用的用于管理无状态应用的Pod 控制器
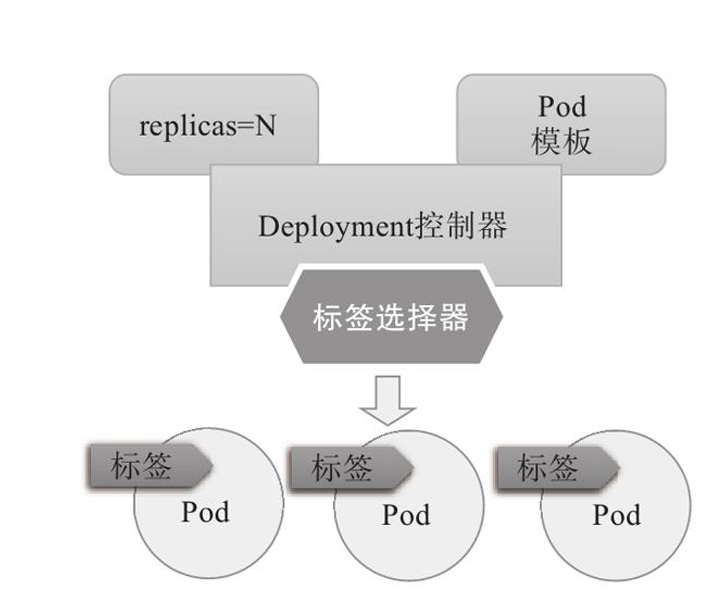
Deployment控制器的定义通常由期望的副本数量、Pod模板和标签选择器组成,它会根据标签选择器对Pod对象的标签进行匹配检查,所有满足选择条件的Pod对象都将受控于当前控制器并计入其副本总数, 以确保此数目能精确反映期望的副本数。
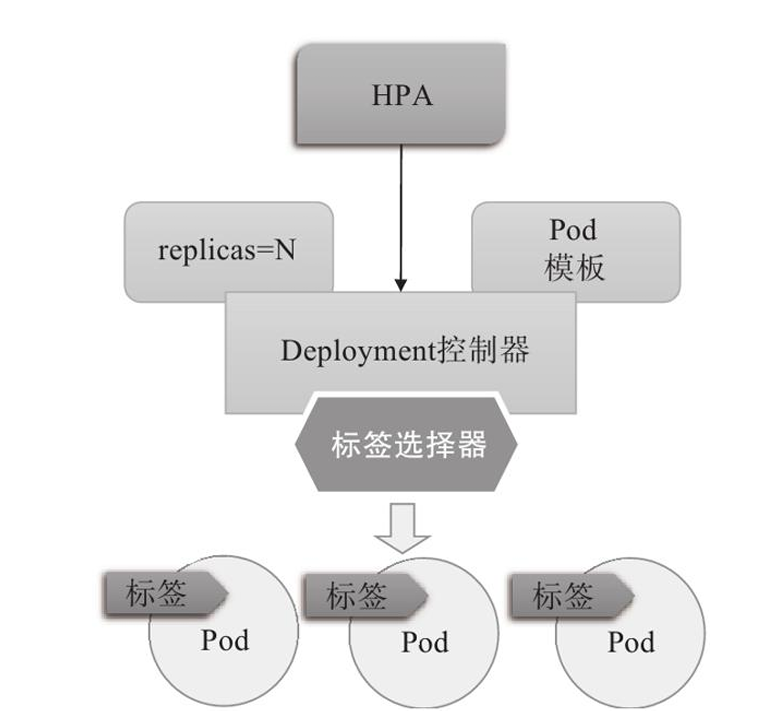
然而,在接收到的请求流量负载显著低于或接近已有Pod副本的整 体承载能力时,用户需要手动修改Deployment控制器中的期望副本数量以实现应用规模的扩容或缩容。不过,当集群中部署了Metrics Server或Prometheus一类的资源指标监控附件时,用户还可以使用 Horizontal Pod Autoscaler(HPA)根据Pod对象的CPU等资源占用率计算出合适的Pod副本数量 , 并自动修改Pod控制器中期望的副本数以实现应用规模的动态伸缩 , 提高集群资源利用率,如图所示。
另外,StatefulSet控制器专用于管理有状态应用的Pod实例,其 他常用的Pod控制器还有ReplicaSet、DaemonSet、Job和CronJob等, 分别用于不同控制模型的工作负载。
参考链接