15-Prometheus 高可用架构 Thanos 实践
前面文章中有简单提到 Prometheus 的高可用方案 , 尝试了联邦、Remote Write 之后 , 我们最终选择了 Thanos 作为监控配套组件 , 利用其全局视图来管理我们的多地域、300+集群的监控数据。
Prometheus 官方的高可用有几种方案 :
HA: 即两套Prometheus采集完全一样的数据 , 外边挂负载均衡HA + 远程存储: 除了基础的多副本Prometheus, 还通过Remote write写入到远程存储 , 解决存储持久化问题联邦集群 : 即
Federation, 按照功能进行分区 , 不同的Shard采集不同的数据 , 由Global节点来统一存放 , 解决监控数据规模的问题。
使用官方建议的多副本 + 联邦仍然会遇到一些问题 , 本质原因是 Prometheus 的本地存储没有数据同步能力 , 要在保证可用性的前提下再保持数据一致性是比较困难的 , 基本的多副本 Proxy 满足不了要求 , 比如 :
Prometheus集群的后端有A和B两个实例 ,A和B之间没有数据同步。A宕机一段时间 , 丢失了一部分数据 , 如果负载均衡正常轮询 , 请求打到A上时 , 数据就会异常。如果
A和B的启动时间不同 , 时钟不同 , 那么采集同样的数据时间戳也不同 , 就多副本的数据不相同。就算用了远程存储 ,A和B不能推送到同一个TSDB, 如果每人推送自己的TSDB, 数据查询走哪边就是问题官方建议数据做
Shard, 然后通过Federation来实现高可用 , 但是边缘节点和Global节点依然是单点 , 需要自行决定是否每一层都要使用双节点重复采集进行保活。也就是仍然会有单机瓶颈。另外部分敏感报警尽量不要通过
Global节点触发 , 毕竟从Shard节点到Global节点传输链路的稳定性会影响数据到达的效率 , 进而导致报警实效降低。
目前大多数的 Prometheus 的集群方案是在存储、查询两个角度上保证数据的一致:
存储角度 : 如果使用
Remote Write远程存储 ,A和B后面可以都加一个Adapter,Adapter做选主逻辑 , 只有一份数据能推送到TSDB, 这样可以保证一个异常 , 另一个也能推送成功 , 数据不丢 , 同时远程存储只有一份 , 是共享数据。存储角度 : 仍然使用
Remote Write远程存储 , 但是A和B分别写入TSDB1和TSDB2两个时序数据库 , 利用Sync的方式在TSDB1和TSDB2之间做数据同步 , 保证数据是全量的。查询角度 : 上边的方案需要自己实现 , 有侵入性且有一定风险 , 因此大多数开源方案是在查询层面做文章 , 比如
Thanos或者Victoriametrics, 仍然是两份数据 , 但是查询时做数据去重和join。只是Thanos是通过Sidecar把数据放在对象存储 ,Victoriametrics是把数据Remote Write到自己的Server实例 , 但查询层Thanos Query和Victor的Promxy的逻辑基本一致 , 都是为全局视图服务。
实际需求
随着我们的集群规模越来越大 , 监控数据的种类和数量也越来越多 : 如Master/Node 机器监控、进程监控、4 大核心组件的性能监控 , POD 资源监控、kube-stats-metrics、K8S events监控、插件监控等等。除了解决上面的高可用问题 , 我们还希望基于 Prometheus 构建全局视图 , 主要需求有 :
长期存储 :
1个月左右的数据存储 , 每天可能新增几十G, 希望存储的维护成本足够小 , 有容灾和迁移。考虑过使用Influxdb, 但Influxdb没有现成的集群方案 , 且需要人力维护。最好是存放在云上的TSDB或者对象存储、文件存储上。无限拓展 : 我们有
300+集群 , 几千节点 , 上万个服务 , 单机Prometheus无法满足 , 且为了隔离性 , 最好按功能做Shard, 如Master组件性能监控与POD资源等业务监控分开、主机监控与日志监控也分开。或者按租户、业务类型分开 ( 实时业务、离线业务 ) 。全局视图 : 按类型分开之后 , 虽然数据分散了 , 但监控视图需要整合在一起 , 一个
Grafana里n个面板就可以看到所有地域+集群 +POD的监控数据 , 操作更方便 , 不用多个Grafana切来切去 , 或者Grafana中多个Datasource切来切去。无侵入性 : 不要对已有的
Prometheus做过多的修改 , 因为Prometheus是开源项目 , 版本也在快速迭代 , 我们最早使用过1.x, 可1.x和2.x的版本升级也就不到一年时间 ,2.x的存储结构查询速度等都有了明显提升 ,1.x已经没人使用了。因此我们需要跟着社区走 , 及时迭代新版本。因此不能对Prometheus本身代码做修改 , 最好做封装 , 对最上层用户透明。
在调研了大量的开源方案(Cortex/Thanos/Victoria/StackDriver..)和商业产品之后 , 我们选择了 Thanos , 准确的说 Thanos 只是监控套件 , 与原生 Prometheus 结合 , 满足了长期存储 + 无限拓展 + 全局视图 + 无侵入性的需求。
1.Thanos 架构
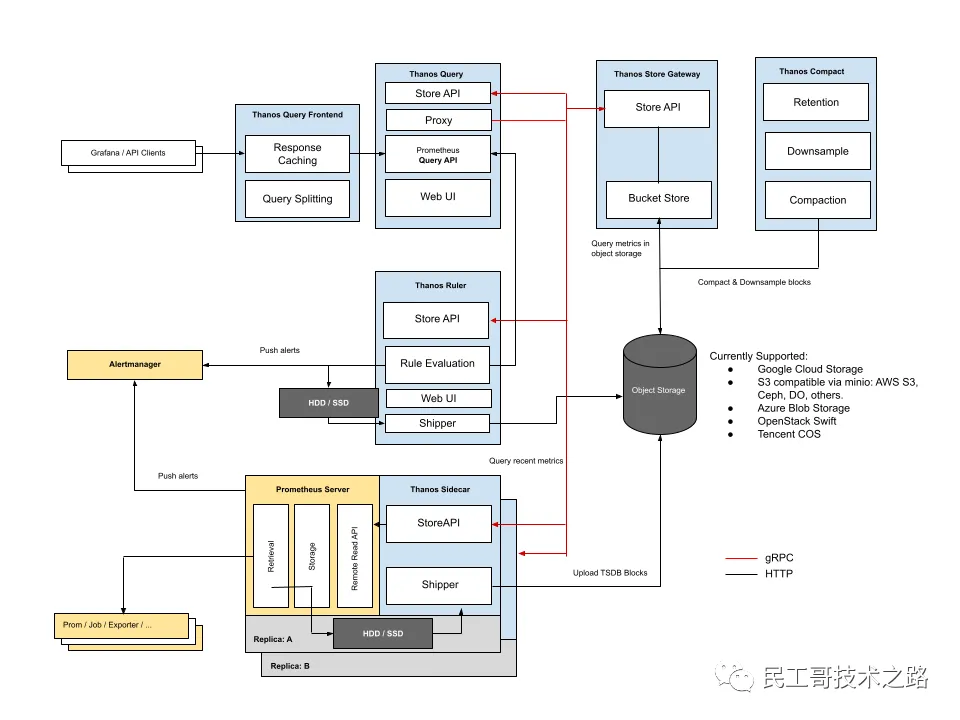
1.1 Sidecar模式
Thanos 的默认模式 : sidecar 方式。
绑定部署在Prometheus 实例上 , 当进行查询时 , 由thanos sidecar返回监控数据给Thanos QueryT对数据进行聚合与去重。最新的监控数据存放于Prometheus 本机 ( 适用于Sidecar数量少 , 单个prometheus集群 , 查询响应快的场景 ) 。
1.2 Receive模式
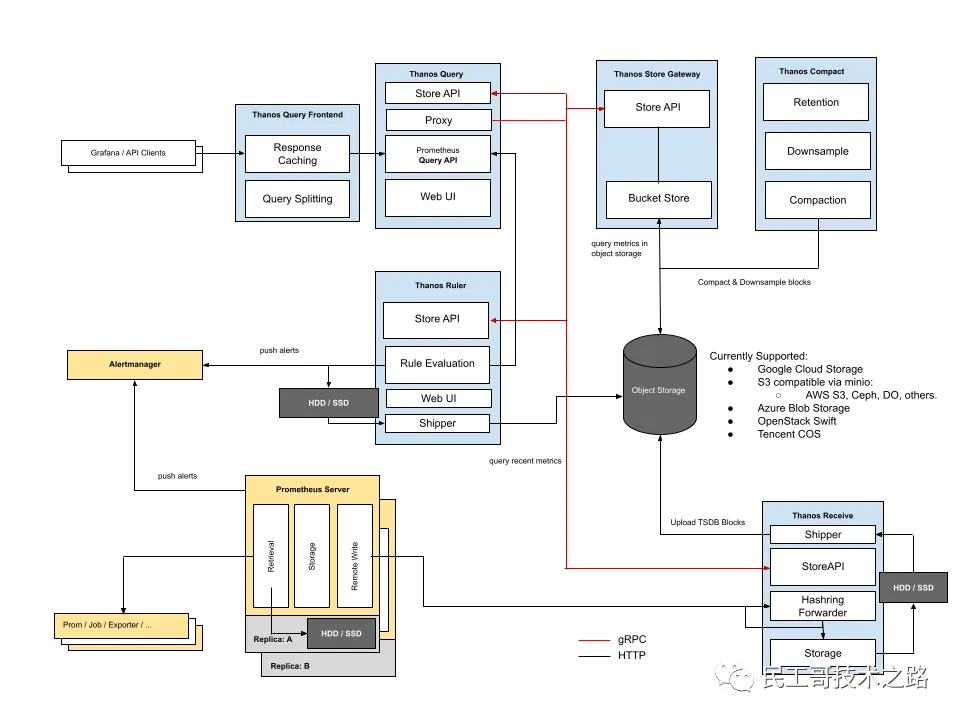
Prometheus 实例实时将数据 push 到 Thanos Receiver , 最新数据也得以集中起来 , 然后 Thanos Query 也不用去所有 Sidecar 查最新数据了 , 直接查 Thanos Receiver 即可 ( 适用于集群规模大 , 多个prometheus节点 , 跨集群查询响应慢的场景 ) 。
2. thanos组件
边车组件 (
Sidecar) : 连接Prometheus, 并把Prometheus暴露给查询网关 (Querier/Query) , 以供实时查询 , 并且可以上传Prometheus数据给云存储 , 以供长期保存查询网关 (
Querier/Query) : 实现了Prometheus API, 与汇集底层组件 ( 如边车组件Sidecar, 或是存储网关Store Gateway) 的数据存储网关 (
Store Gateway) : 将对象存储的数据暴露给Thanos Query去查询。压缩器 (
Compactor) : 将对象存储中的数据进行压缩和降低采样率 , 加速大时间区间监控数据查询的速度。接收器 (
Receiver) : 从Prometheus的remote-write WAL(Prometheus远程预写式日志 ) 获取数据 , 暴露出去或者上传到云存储规则组件 (
Ruler) : 对监控数据进行评估和告警 , 还可以计算出新的监控数据 , 将这些新数据提供给Thanos Query查询并且/或者上传到对象存储 , 以供长期存储。存储 (
Bucket) : 主要用于展示对象存储中历史数据的存储情况 , 查看每个指标源中数据块的压缩级别 , 解析度 , 存储时段和时间长度等信息。
3. Thanos 组件与配置
下面会介绍如何组合 Thanos 组件 , 来快速实现你的 Prometheus 高可用 , 因为是快速介绍 , 和官方的 quick start有一部分雷同 , 不过会给出推荐配置。
3.1 第1步 : 确认已有的 Prometheus
thanos 是无侵入的 , 只是上层套件 , 因此你还是需要部署你的 Prometheus , 这里不再赘述 , 默认你已经有一个单机的 Prometheus 在运行 , 可以是 pod 也可以是主机部署 , 取决于你的运行环境 , 我们是在 k8s 集群外 , 因此是主机部署。Prometheus 采集的是地域A的监控数据。你的 Prometheus 配置可以是。
启动配置 :
./prometheus
--config.file=prometheus.yml \
--log.level=info \
--storage.tsdb.path=data/prometheus \
--web.listen-address='0.0.0.0:9090' \
--storage.tsdb.max-block-duration=2h \
--storage.tsdb.min-block-duration=2h \
--storage.tsdb.wal-compression \
--storage.tsdb.retention.time=2h \
--web.enable-lifecycleweb.enable-lifecycle一定要开 , 用于热加载时 reload 你的配置 , retention 保留 2 小时 , Prometheus 默认 2 小时会生成一个 block , Thanos 会把这个 block 上传到对象存储。
采集配置 : prometheus.yml
global:
scrape_interval: 60s
evaluation_interval: 60s
external_labels:
region: 'A'
replica: 0
rule_files:
scrape_configs:
- job_name: 'prometheus'
static_configs:
- targets: ['0.0.0.0:9090']
- job_name: 'demo-scrape'
metrics_path: '/metrics'
params:
...这里需要声明 external_labels , 标注你的地域。如果你是多副本运行 , 需要声明你的副本标识 , 如 0号 , 1 , 2 三个副本采集一模一样的数据 , 另外2个 Prometheus 就可以同时运行 , 只是 replica 值不同而已。这里的配置和官方的 Federation方案差不多。
对 Prometheus 的要求 :
2.2.1版本以上声明你的
external_labels启用
–-web.enable-admin-api启用
-–web.enable-lifecycle
3.2 第2步 : 部署 Sidecar 组件
关键的步骤来了 , 最核心莫过于 sidecar 组件。sidecar是 k8s 中的一种模式。Sidecar 组件与 Prometheus server 部署于同一个 pod 中。他有两个作用 :
它使用
Prometheus的Remote Read API, 实现了Thanos的Store API。这使后面要介绍的Query组件可以将Prometheus服务器视为时间序列数据的另一个来源 , 而无需直接与Prometheus API交互 ( 这就是Sidecar的拦截作用 )可选配置 : 在
Prometheus每2小时生成一次TSDB块时 ,Sidecar将TSDB块上载到对象存储桶中。这使得Prometheus服务器可以以较低的保留时间运行 , 同时使历史数据持久且可通过对象存储查询。
当然 , 这不意味着 Prometheus 可以是完全无状态的 , 因为如果它崩溃并重新启动 , 您将丢失2个小时的指标 , 不过如果你的 Prometheus 也是多副本 , 可以减少这 2h 数据的风险。
sidecar配置 :
./thanos sidecar \
--Prometheus.url="http://localhost:8090" \
--objstore.config-file=./conf/bos.yaml \
--tsdb.path=/home/work/opdir/monitor/Prometheus/data/Prometheus/
配置很简单 , 只需要声明 Prometheus.url 和数据地址即可。objstore.config-file 是可选项。如果你要把数据存放在对象存储 ( 这也是推荐做法 ) , 就配置下对象存储的账号信息。
Thanos 默认支持谷歌云/AWS 等 , 以 谷歌云为例 , 配置如下 :
type: GCS
config:
  bucket: ""
  service_account: ""
因为 Thanos 默认还不支持我们的云存储 , 因此我们在 Thanos 代码中加入了相应的实现 , 并向官方提交了 PR。
需要注意的是 : 别忘了为你的另外两个副本 1号 和 2号 Prometheus 都搭配一个 sidecar。如果是 pod运行可以加一个 container , 127 访问 , 如果是主机部署 , 指定 Prometheus 端口就行。
另外 sidecar 是无状态的 , 也可以多副本 , 多个 sidecar 可以访问一份 Prometheus 数据 , 保证 sidecar 本身的拓展性 , 不过如果是 pod 运行也就没有这个必要了 , sidecar 和 Prometheus 同生共死就行了。
sidecar 会读取 Prometheus 每个 block 中的 meta.json 信息 , 然后扩展这个 json 文件 , 加入了 Thanos 所特有的 metadata 信息。而后上传到块存储上。上传后写入 thanos.shipper.json 中。
3.3 第3步 : 部署 query 组件
sidecar 部署完成了 , 也有了3个一样的数据副本 , 这个时候如果想直接展示数据 , 可以安装 query 组件。
Query 组件 ( 也称为“查询” ) 实现了 Prometheus 的 HTTP v1 API , 可以像 Prometheus 的 graph一样 , 通过 PromQL 查询 Thanos 集群中的数据。 简而言之 , sidecar 暴露了 StoreAPI , Query 从多个 StoreAPI 中收集数据 , 查询并返回结果。Query 是完全无状态的 , 可以水平扩展。
配置 :
./thanos query \
--http-address="0.0.0.0:8090" \
--store=relica0:10901 \
--store=relica1:10901 \
--store=relica2:10901 \
--store=127.0.0.1:19914 \
store 参数代表的就是刚刚启动的 sidecar 组件 , 启动了 3 份 , 就可以配置三个relica0、relica1、relica2 , 10901 是 sidecar 的默认端口。 http-address 代表 query 组件本身的端口 , 因为他是个 web 服务 , 启动后 , 页面是这样的 :
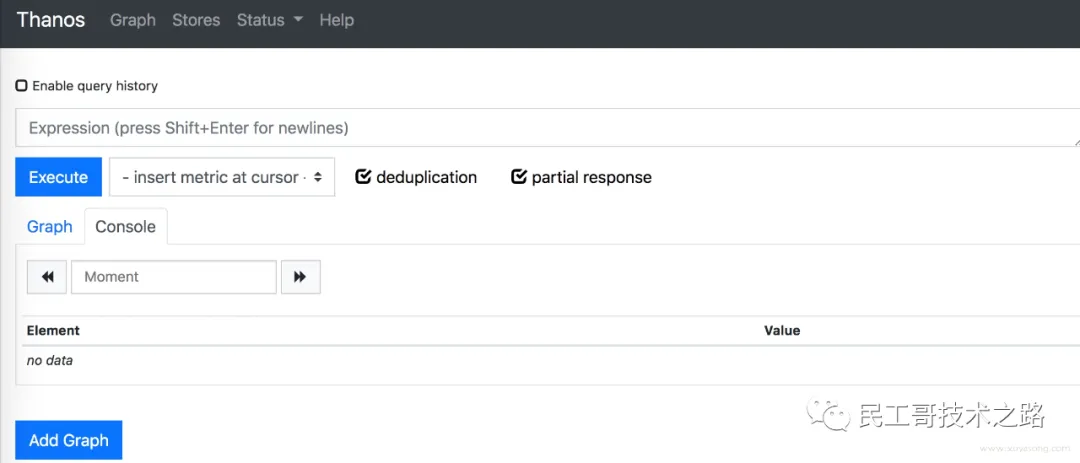
和 Prometheus 几乎一样对吧 , 有了这个页面你就不需要关心最初的 Prometheus 了 , 可以放在这里查询。
点击 store , 可以看到对接了哪些 sidecar。
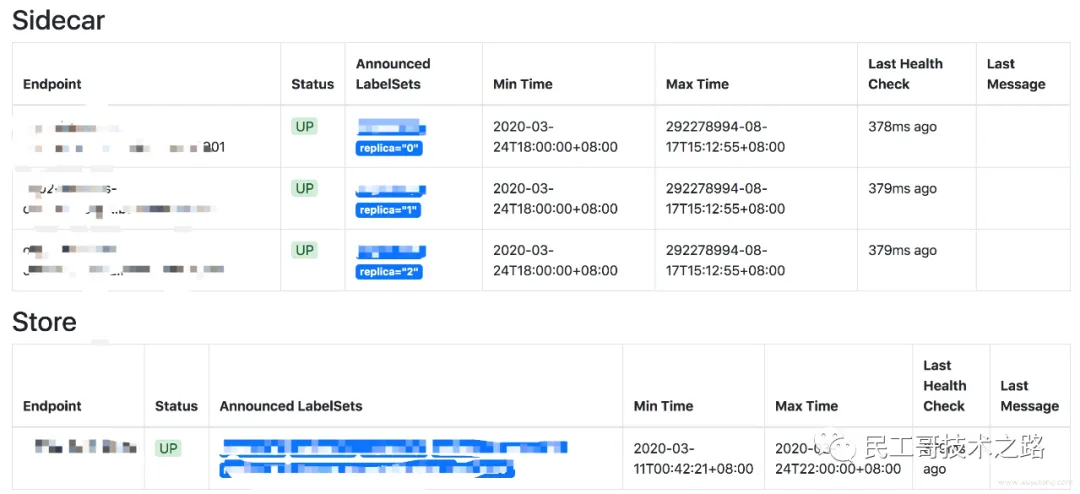
query 页面有两个勾选框 , 含义是 :
deduplication: 是否去重。默认勾选代表去重 , 同样的数据只会出现一条 , 否则replica0和1、2完全相同的数据会查出来3条。partial response: 是否允许部分响应 , 默认允许 , 这里有一致性的折中 , 比如0、1、2三副本有一个挂掉或者超时了 , 查询时就会有一个没有响应 , 如果允许返回用户剩下的2份 , 数据就没有很强的一致性 , 但因为一个超时就完全不返回 , 就丢掉了可用性 , 因此默认允许部分响应。
3.4 第4步 : 部署 store gateway 组件
你可能注意到了 , 在第 3 步里 , ./thanos query有一条–store是 xxx:19914 , 并不是一直提到的 3 副本 , 这个 19914 就是接下来要说的 store gateway组件。
在第 2 步的 sidecar 配置中 , 如果你配置了对象存储 objstore.config-file , 你的数据就会定时上传到 bucket 中 , 本地只留 2 小时 , 那么要想查询 2 小时前的数据怎么办呢?数据不被 Prometheus 控制了 , 应该如何从 bucket 中拿回来 , 并提供一模一样的查询呢?
Store gateway 组件 : store gateway 主要与对象存储交互 , 从对象存储获取已经持久化的数据。与sidecar一样 , store gateway也实现了 store api , query 组可以从 store gateway 查询历史数据。
配置如下 :
./thanos store \
--data-dir=./thanos-store-gateway/tmp/store \
--objstore.config-file=./thanos-store-gateway/conf/bos.yaml \
--http-address=0.0.0.0:19904 \
--grpc-address=0.0.0.0:19914 \
--index-cache-size=250MB \
--sync-block-duration=5m \
--min-time=-2w \
--max-time=-1h \
grpc-address 就是 store api 暴露的端口 , 也就是 query 中–store 是 xxx:19914的配置。
因为Store gateway需要从网络上拉取大量历史数据加载到内存 , 因此会大量消耗 cpu 和内存 , 这个组件也是 thanos 面世时被质疑过的组件 , 不过当前的性能还算可以 , 遇到的一些问题后面会提到。
Store gateway也可以无限拓展 , 拉取同一份 bucket 数据。 放个示意图 , 一个 Thanos 副本 , 挂了多个地域的 store 组件。
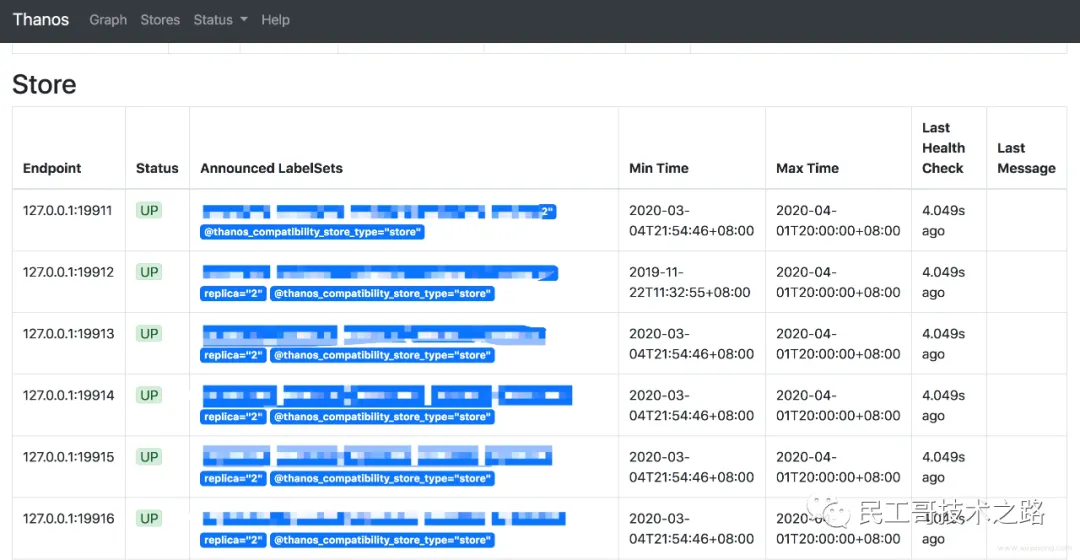
其中一个地域的数据统计 : 查询一个月历史数据速度还可以 , 主要是数据持久化没有运维压力 , 随意扩展 , 成本低。
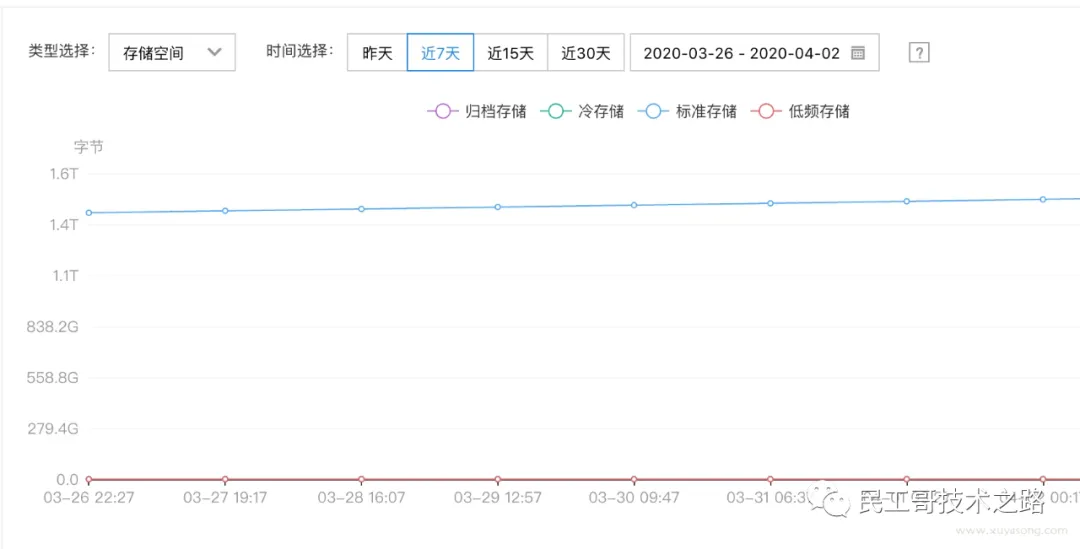
到这里 , Thanos 的基本使用就结束了 , 至于 compact 压缩和 bucket 校验 , 不是核心功能 , compact的资源消耗也特别大 , rule组件我们没有使用 , 就不做介绍了。
3.5 第5步 : 查看数据
有了多地域多副本的数据 , 就可以结合 Grafana 做全局视图了 , 比如 :
按地域和集群查看 ETCD 的性能指标 :
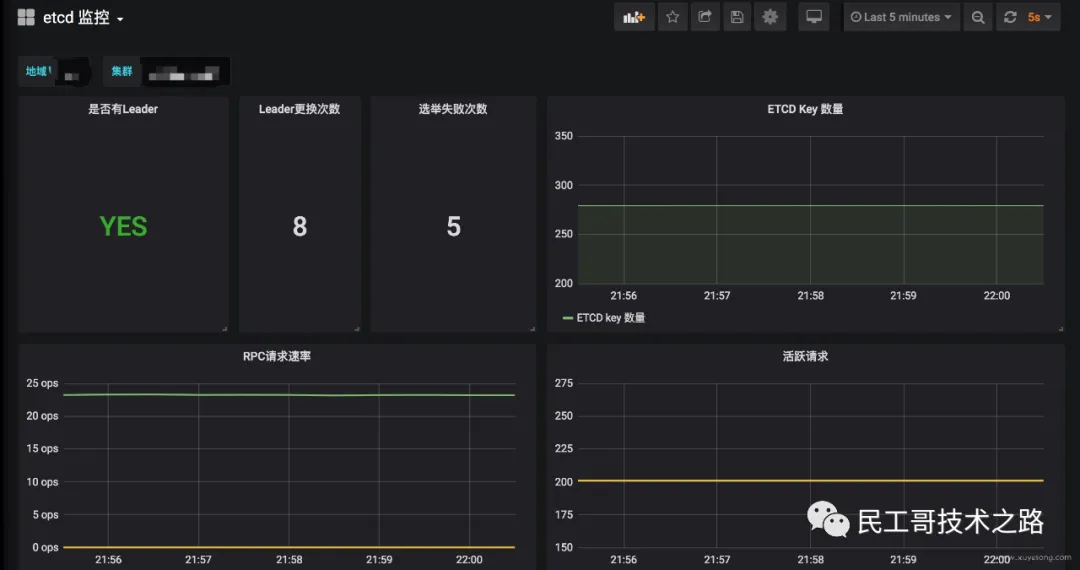
按地域、集群、机器查看核心组件监控 , 如多副本 Master 机器上的各种性能。
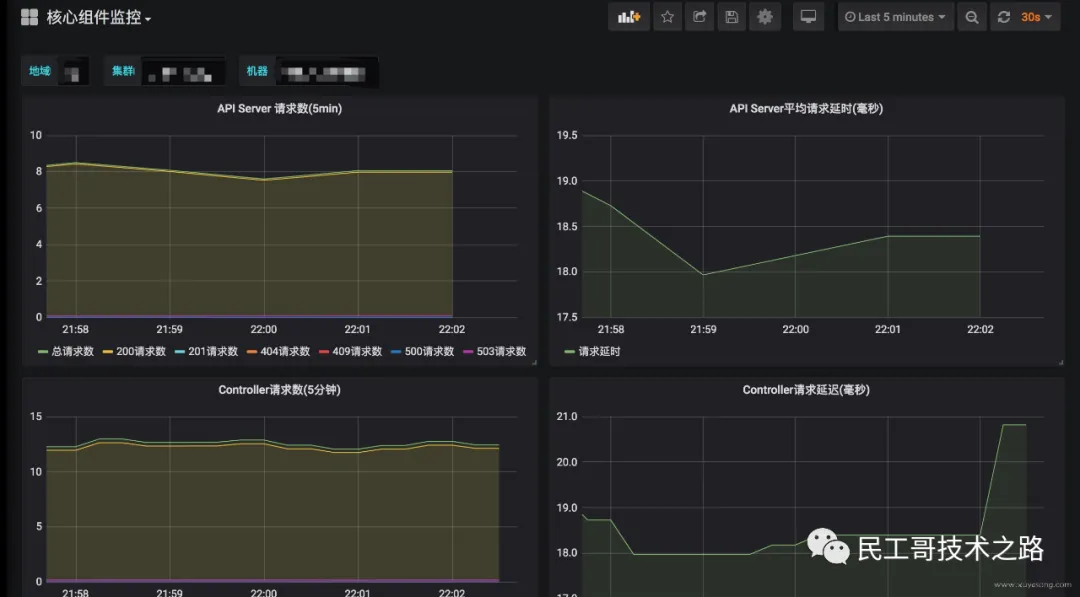
数据聚合在一起之后 , 可以将所有视图都集中展示 , 比如还有这些面板 :
机器监控 :
node-exporter、process-exporterPOD资源使用:CadvisorDocker、kube-proxy、kubelet监控scheduler、controller-manager、etcd、apiserver监控kube-state-metrics元信息K8S Eventsmtail等日志监控
4. 一些问题
4.1 Prometheus 压缩
压缩 : 官方文档有提到 , 使用 sidecar 时 , 需要将 Prometheus 的 --storage.tsdb.min-block-duration 和 --storage.tsdb.max-block-duration 这两个值设置为2h , 两个参数相等才能保证Prometheus 关闭了本地压缩 , 其实这两个参数在 Prometheus -help 中并没有体现 , Prometheus 作者也说明这只是为了开发测试才用的参数 , 不建议用户修改。而 Thanos 要求关闭压缩是因为 Prometheus 默认会以2 , 25 , 25*5的周期进行压缩 , 如果不关闭 , 可能会导致 thanos 刚要上传一个 block , 这个 block 却被压缩中 , 导致上传失败。
不过你也不必担心 , 因为在 sidecar 启动时 , 会检查这两个参数 , 如果不合适 , sidecar会启动失败。

4.2 store-gateway
store-gateway: store 组件资源消耗是最大的 , 毕竟他要拉取远程数据 , 并加载到本地供查询 , 如果你想控制历史数据和缓存周期 , 可以修改相应的配置 , 如:
--index-cache-size=250MB \
--sync-block-duration=5m \
--min-time=-2w \ 最大查询 1 周
--max-time=-1h \
store-gateway 默认支持索引缓存 , 来加快 TSDB 块的查找速度 , 但有时候启动会占用了大量的内存 , 在 0.11.0之后的版本做了修复。
Prometheus 2.0 已经对存储层进行了优化。例如按照时间和指标名字 , 连续的尽量放在一起。而 store gateway可以获取存储文件的结构 , 因此可以很好的将指标存储的请求翻译为最少的 object storage 请求。对于那种大查询 , 一次可以拿成百上千个 Chunks 数据。
而在 store 的本地 , 只有 Index 数据是放入 Cache 的 , Chunk 数据虽然也可以 , 但是就要大几个数量级了。目前 , 从对象存储获取 Chunk 数据只有很小的延时 , 因此也没什么动力去将 Chunk 数据给 Cache起来 , 毕竟这个对资源的需求很大。
store-gateway中的数据 :
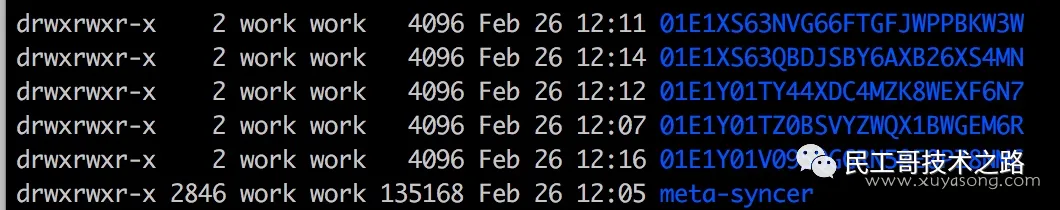
每个文件夹中其实是一个个的索引文件 index.cache.json。
4.3 compactor组件
Prometheus 数据越来越多 , 查询一定会越来越慢 , Thanos 提供了一个 compactor 组件来处理 , 他有两个功能。
一个是做压缩 , 就是把旧的数据不断的合并。
一个是降采样 , 他会把存储的数据 , 按照一定的时间 , 算出最大 , 最小等值 , 会根据查询的间隔 , 进行控制 , 返回采样的数据 , 而不是真实的点 , 在查询特别长的时间的数据的时候 , 看的主要是趋势 , 精度是可以选择下降的。
注意的是 Compactor 并不会减少磁盘占用 , 反而会增加磁盘占用 ( 做了更高维度的聚合 ) 。
thanos 组件的优化并不是万能的 , 因为业务数据总在增长 , 这时候可能要考虑业务拆分了。我们需要对业务有一定的划分 , 不同的业务监控放在不同bucket里 ( 需要改造或者多部署几个 sidecar ) 。例如有5个 bucket , 再准备5个 store gateway 进行代理查询。减少单个 store 数据过大的问题。
第二个方案是时间切片 , 也就是上面提到的 store gateway , 可以选择查询多长时间的数据。store gateway配置支持两种表达式 , 一种是基于相对时间的 , 例如–max-time 是3d前到5d前的。一种是基于绝对时间的 , 如19年3月1号到19年5月1号。例如想查询3个月的数据 , 一个 store 可以代理一个月的数据 , 那么就需要部署3个store来合作。
4.4 query 的去重
query 组件启动时 , 默认会根据 query.replica-label 字段做重复数据的去重 , 你也可以在页面上勾选deduplication 来决定。query 的结果会根据你的 query.replica-label的 label 选择副本中的一个进行展示。可如果 0 , 1 , 2 三个副本都返回了数据 , 且值不同 , query 会选择哪一个展示呢?
Thanos 会基于打分机制 , 选择更为稳定的 replica 数据, 具体逻辑在 : https://github.com/thanos-io/thanos/blob/55cb8ca38b3539381dc6a781e637df15c694e50a/pkg/query/iter.go。
5. thanos使用
Thanos Querier使用
thanos querier调试PromQL和prometheus上调试别无二致 , 最主要的一点是记得选择“Use Deldupication“ 删除重复数据。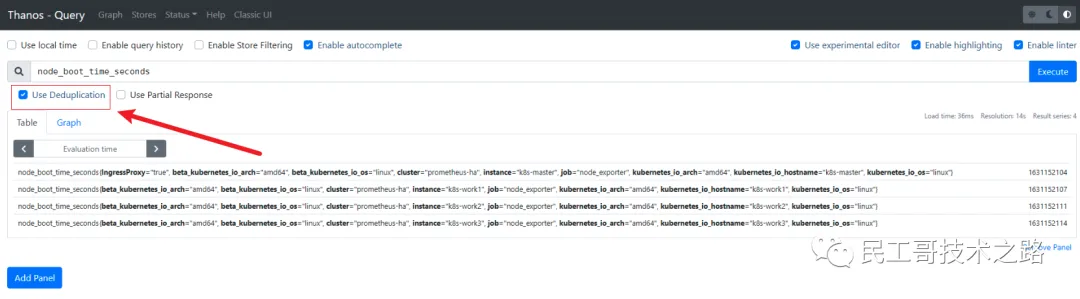
Grafanagrafana创建数据源时 , 由于thanos-query和grafana同属一个namespace, 所以url地址填写thanos-query:9090即可。如果位于不同namespace,url地址填写为 :http://(servicename).(namespace).svc.cluster.local:9090。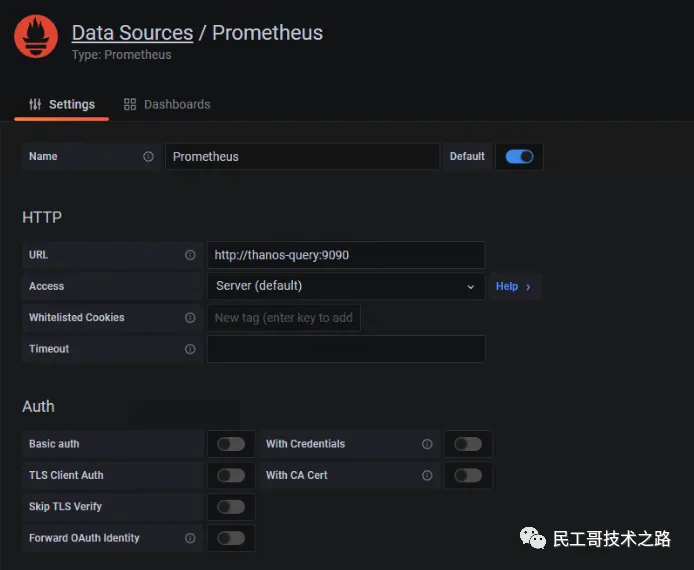
然后从
grafana官网dashboard导入对应的dashboard即可。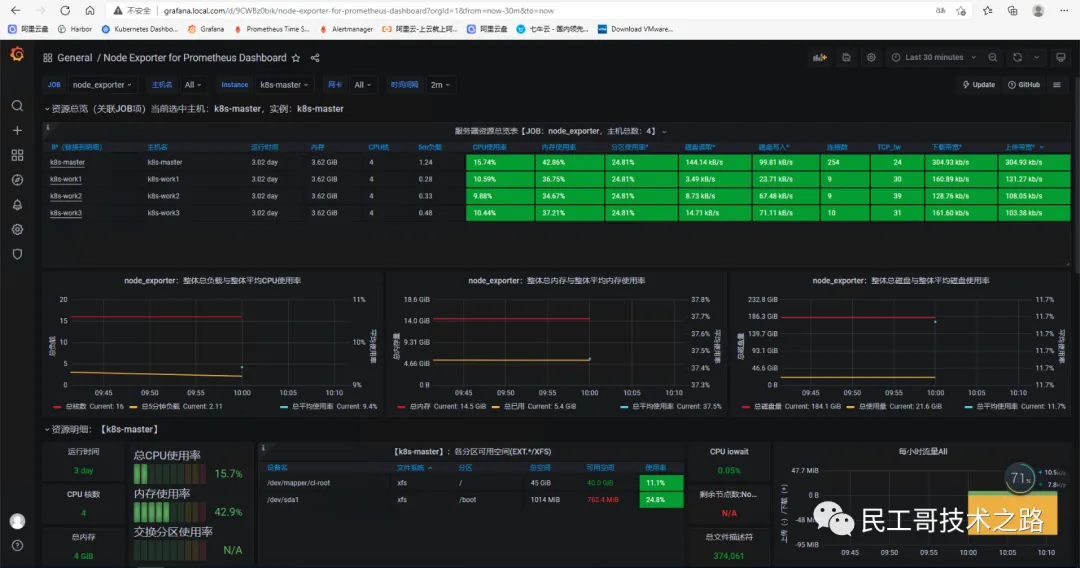
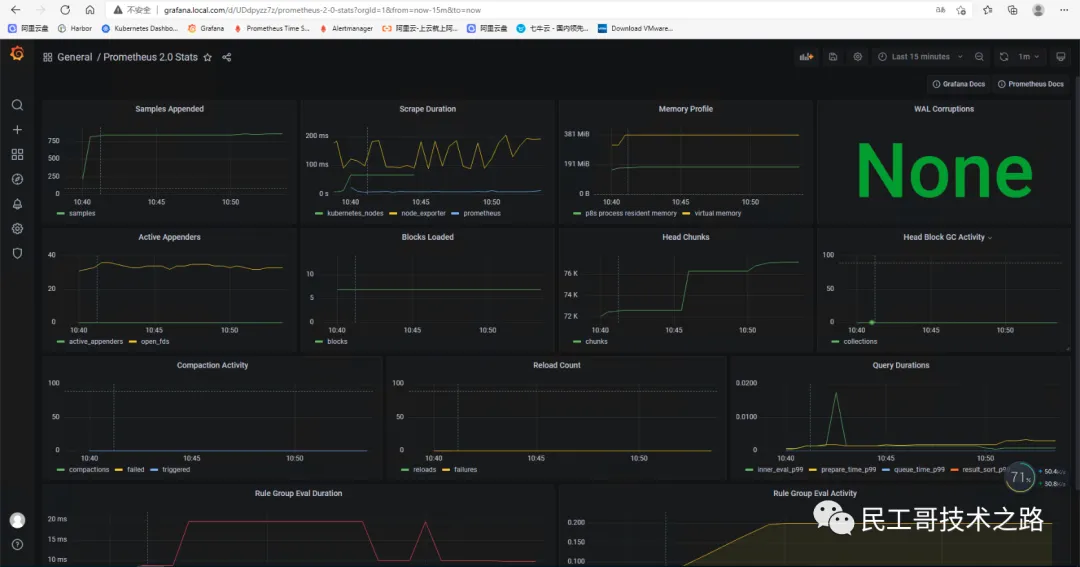
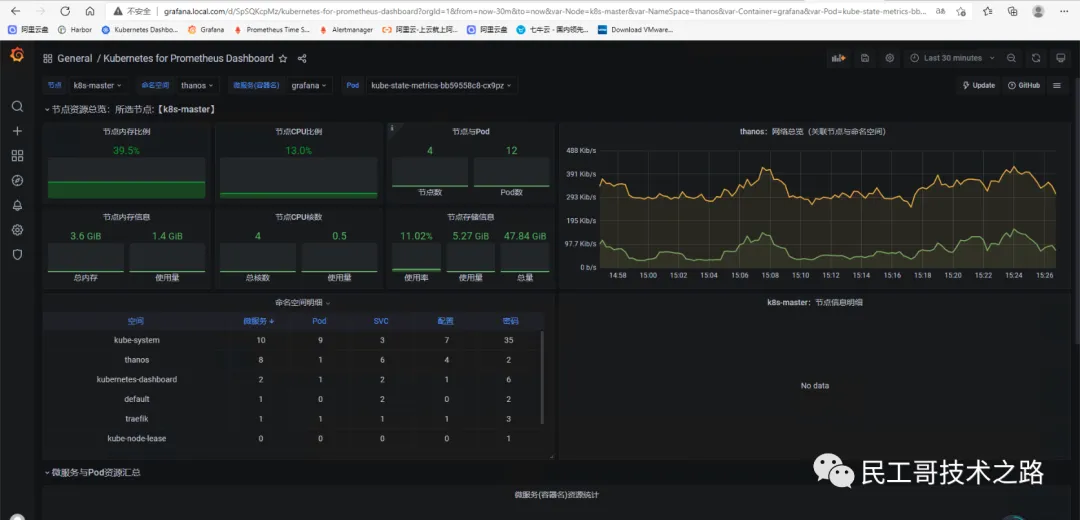
以上就是今天要讲解目前比较流行的方案 :
Thanos, 它完全兼容Prometheus API, 提供统一查询聚合分布式部署Prometheus数据的能力 , 同时也支持数据长期存储到各种对象存储 ( 比如S3、阿里云OSS等 ) 以及降低采样率来加速大时间范围的数据查询。
参考链接
构建企业级监控平台系列 ( 二十六 ) : Prometheus 高可用架构 Thanos 实践 (qq.com)