
3-12-1-资源监控与资源指标
1. 资源指标和资源监控
一个集群系统管理离不开监控 , 同样的Kubernetes也需要根据数据指标来采集相关数据 , 从而完成对集群系统的监控状况进行监测。这些指标总体上分为两个组成 : 监控集群本身和监控Pod对象 , 通常一个集群的衡量性指标包括以下几个部分 :
节点资源状态 : 主要包括网络带宽、磁盘空间、
CPU和内存使用率节点的数量 : 即时性了解集群的可用节点数量可以为用户计算服务器使用的费用支出提供参考。
运行的
Pod对象 : 正在运行的Pod对象数量可以评估可用节点数量是否足够 , 以及节点故障时是否能平衡负载。
另一个方面 , 对Pod资源对象的监控需求大概有以下三类 :
Kubernetes指标 : 监测特定应用程序相关的Pod对象的部署过程、副本数量、状态信息、健康状态、网络等等。容器指标 : 容器的资源需求、资源限制、
CPU、内存、磁盘空间、网络带宽的实际占用情况。应用程序指标 : 应用程序自身的内建指标 , 和业务规则相关
2. 核心指标监控之metrics-server
在最初的系统资源监控 , 是通过cAdvisor去收集单个节点以及相关Pod资源的指标数据 , 但是这一功能仅能够满足单个节点 , 在集群日益庞大的过程中 , 该功能就显得low爆了。于是将各个节点的指标数据进行汇聚并通过一个借口进行向外暴露传送是必要的。
Heapster就是这样的一种方式 , 通过为集群提供指标API和实现并进行监控 , 它是集群级别的监控和事件数据的聚合工具 , 但是一个完备的Heapster监控体系是需要进行数据存储的 , 为此其解决方案就是引入了Influxdb作为后端数据的持久存储 , Grafana作为可视化的接口。原理就是Heapster从各个节点上的cAdvisor采集数据并存储到Influxdb中 , 再由Grafana展示。原理图如下 :
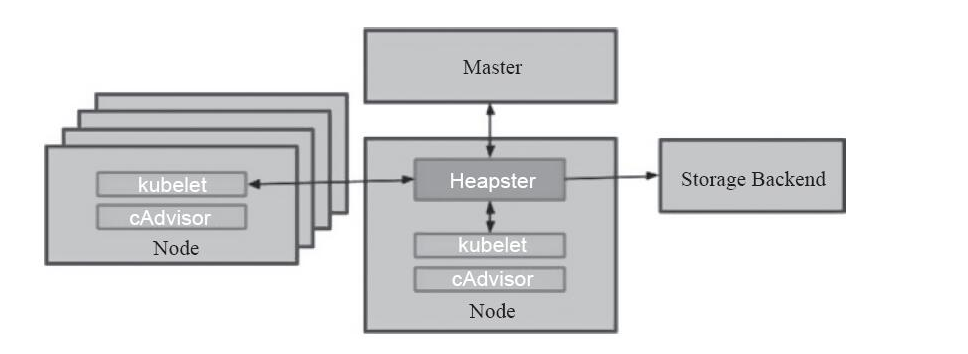
时代在变迁 , 陈旧的东西将会被淘汰 , 由于功能和系统发展的需求 , Heapster无法满足k8s系统监控的需求 , 为此在Kubernetes 1.7版本以后引入了自定义指标(custom metrics API) , 在1.8版本引入了资源指标(resource metrics API)。逐渐地Heapster用于提供核心指标API的功能也被聚合方式的指标API服务器metrics-server所替代。
在新一代的Kubernetes指标监控体系当中主要由核心指标流水线和监控指标流水线组成 :
核心指标流水线 : 是指由
kubelet、metrics-server以及由API server提供的api组成 , 它们可以为K8S系统提供核心指标 , 从而了解并操作集群内部组件和程序。其中相关的指标包括CPU的累积使用率、内存实时使用率 ,Pod资源占用率以及容器磁盘占用率等等。其中核心指标的获取原先是由heapster进行收集 , 但是在1.11版本之后已经被废弃 , 从而由新一代的metrics-server所代替对核心指标的汇聚。核心指标的收集是必要的。如下图 :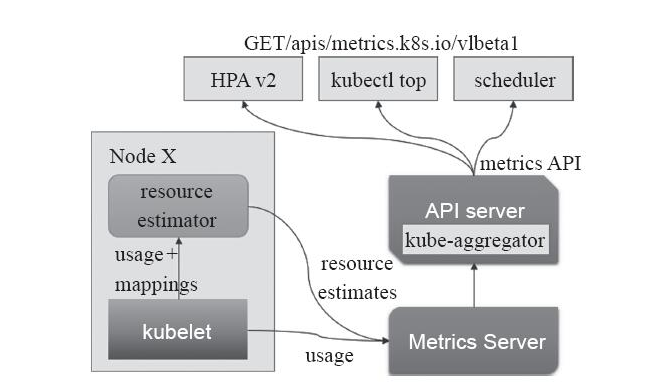
监控指标流水线 : 用于从系统收集各种指标数据并提供给终端用户、存储系统以及
HPA。它们包含核心指标以及许多非核心指标 , 其中由于非核心指标本身不能被Kubernetes所解析 , 此时就需要依赖于用户选择第三方解决方案。如下图: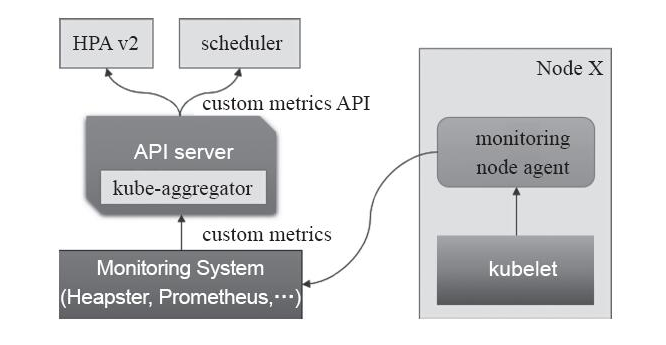
一个可以同时使用资源指标API和自定义指标API的组件是HPAv2 , 其实现了通过观察指标实现自动扩容和缩容。而目前资源指标API的实现主流是metrics-server。
自1.8版本后 , 容器的cpu和内存资源占用利用率都可以通过客户端指标API直接调用 , 从而获取资源使用情况 , 要知道的是API本身并不存储任何指标数据 , 仅仅提供资源占用率的实时监测数据。
资源指标和其他的API指标并没有啥区别 , 它是通过API Server的URL路径/apis/metrics.k8s.io/进行存取 , 只有在k8s集群内部署了metrics-server应用才能只用API , 其简单的结构图如下 :
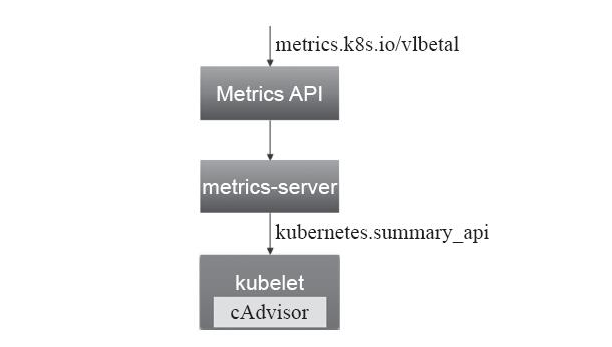
Heapster 、 Metrics Server通过 Kubernetes 聚合 器(kube- aggregator) 注册到主API Server之上 , 而后基于 kubelet 的 Summary API 收集每个节点上的指标数据 , 并将 它们存储于内存中然后以指标 API 格式提供 , 如下图 :
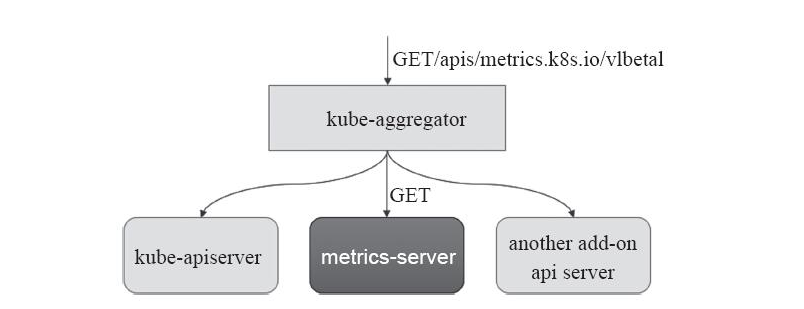
Metrics Server基于内存存储 , 重启后数据将全部丢失 , 而且它仅能留存最近收集到的指标数据 , 因此 , 如果用户期望访问历史数据 , 就不得不借助于第三方的监控系统 ( 如 Prometheus 等 ) 。
一般说来 , Metrics Server 在每个集群中仅会运行一个实例 , 启动时 , 它将自动初始化与各节点的连接 , 因此出于安全方面的考虑 , 它需要运行于普通节点而非Master主机之上。 直接使用项目本身提供的资源配置清单即能轻松完成 metrics- server 的部署。
如前所述 , 核心指标是Kubernetes多个核心组件的基础依赖 , 因此Metric Server应该在集群创建之初便作为核心组件部署运行在集群中。Metrics Server通常仅需要在集群中运行单个实例即可 , 它会在 启用时自动初始化与各节点的连接 , 因而出于安全方面的考虑 , 它仅 应该运行在普通节点之上 , 且需要根据目标Kubernetes集群的环境等因素定制几个配置选项。
--tls-cert-file和--tls-private-key-file:metrics-server服务进程使用的证书和私钥 , 未指定时将由程序自动生成自签证书 , 生产环境建议自行指定。--secure-port=:metrics-server服务进程对外提供服务 的端口 , 默认为443, 以非管理员账户运行时建议修改为1024及以上的 端口号 , 例如4443等。--metric-resolution=: 从kubelet抓取指标数据的 时间间隔 , 默认为60秒。--kubelet-insecure-tls: 不验证kubelet签发证书的CA, 对于kubelet使用自签证书的测试环境较为有用 , 但不建议在生产环境使用。--kubelet-preferred-address-types: 与kubelet通信时倾向于使用的地址类型顺序 , 默认为Hostname、InternalDNS、InternalIP、ExternalDNS和ExternalIP。--kubelet-port:kubelet监听的能够提供指标数据的端口号 , 默认为10250。
对于使用kubeadm部署的Kubernetes集群来说 , 若未指定签署节点 证书的CA , 也未给每个节点配置自定义证书 , 则各kubelet通常是在 Bootstrap过程中生成自签证书 , 这类证书无法由Metrics Server完成 CA验证 , 因此需要使用--kubelet-insecure-tls选项来禁用这种验证功能。
3. 安装配置
3.1 安装
metric-server安装过程主要是通过yaml文件实现。如果通过kubeasz安装, 默认就存在这个yaml文件。另外可以直接访问github的metric-server页面访问github页面。分为单机和高可用两个版本
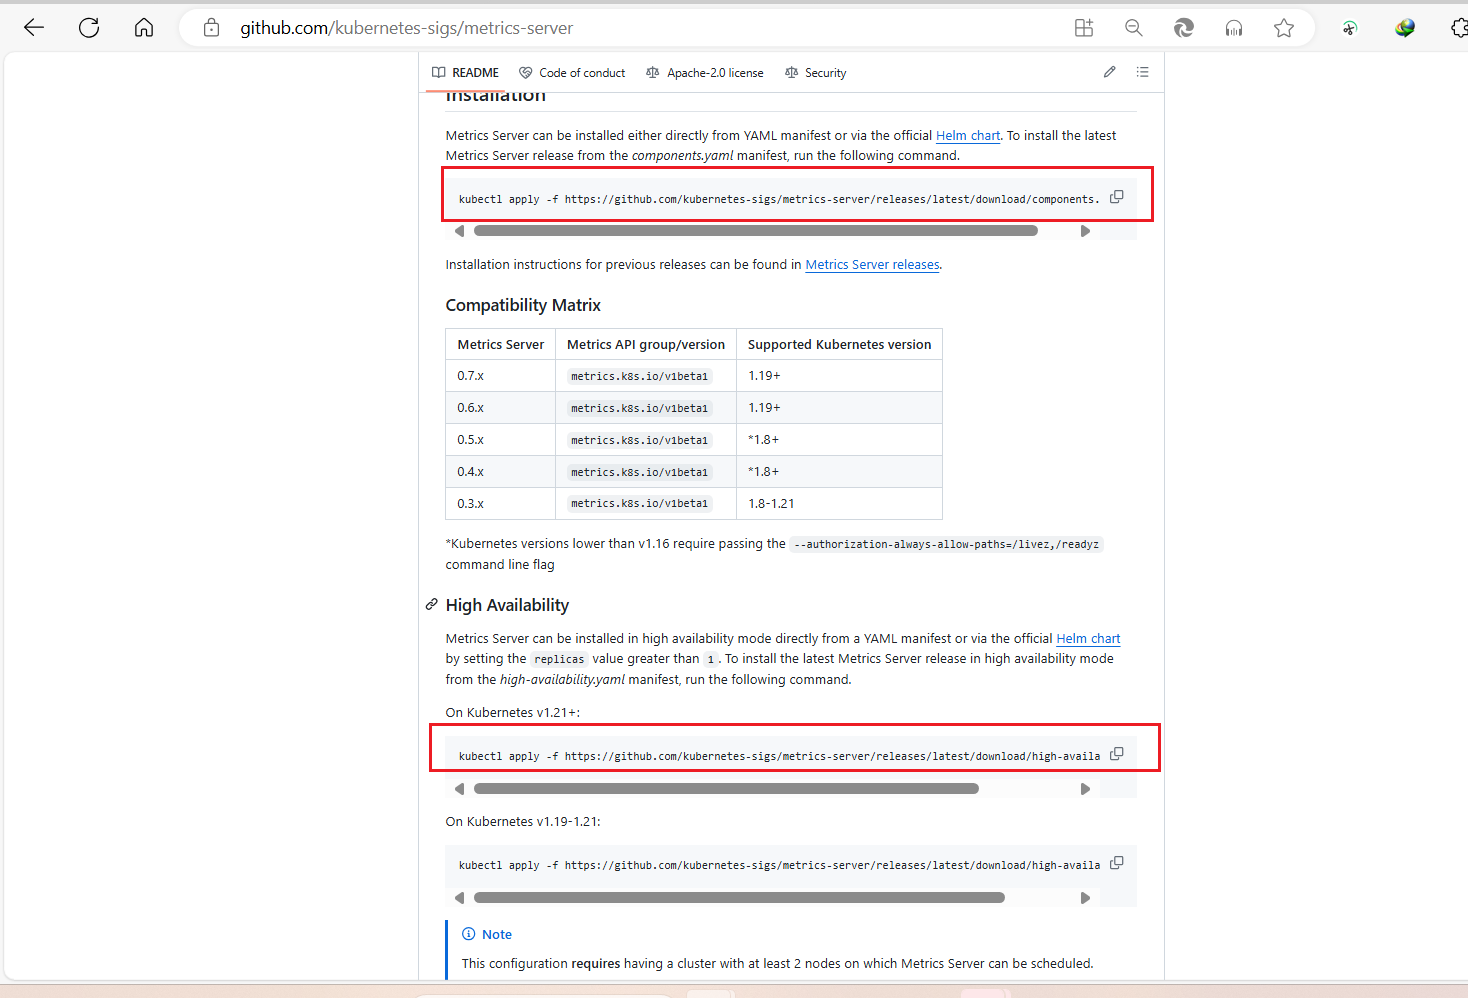
另外可以通过下载对应版本的kubernetes的二进制包
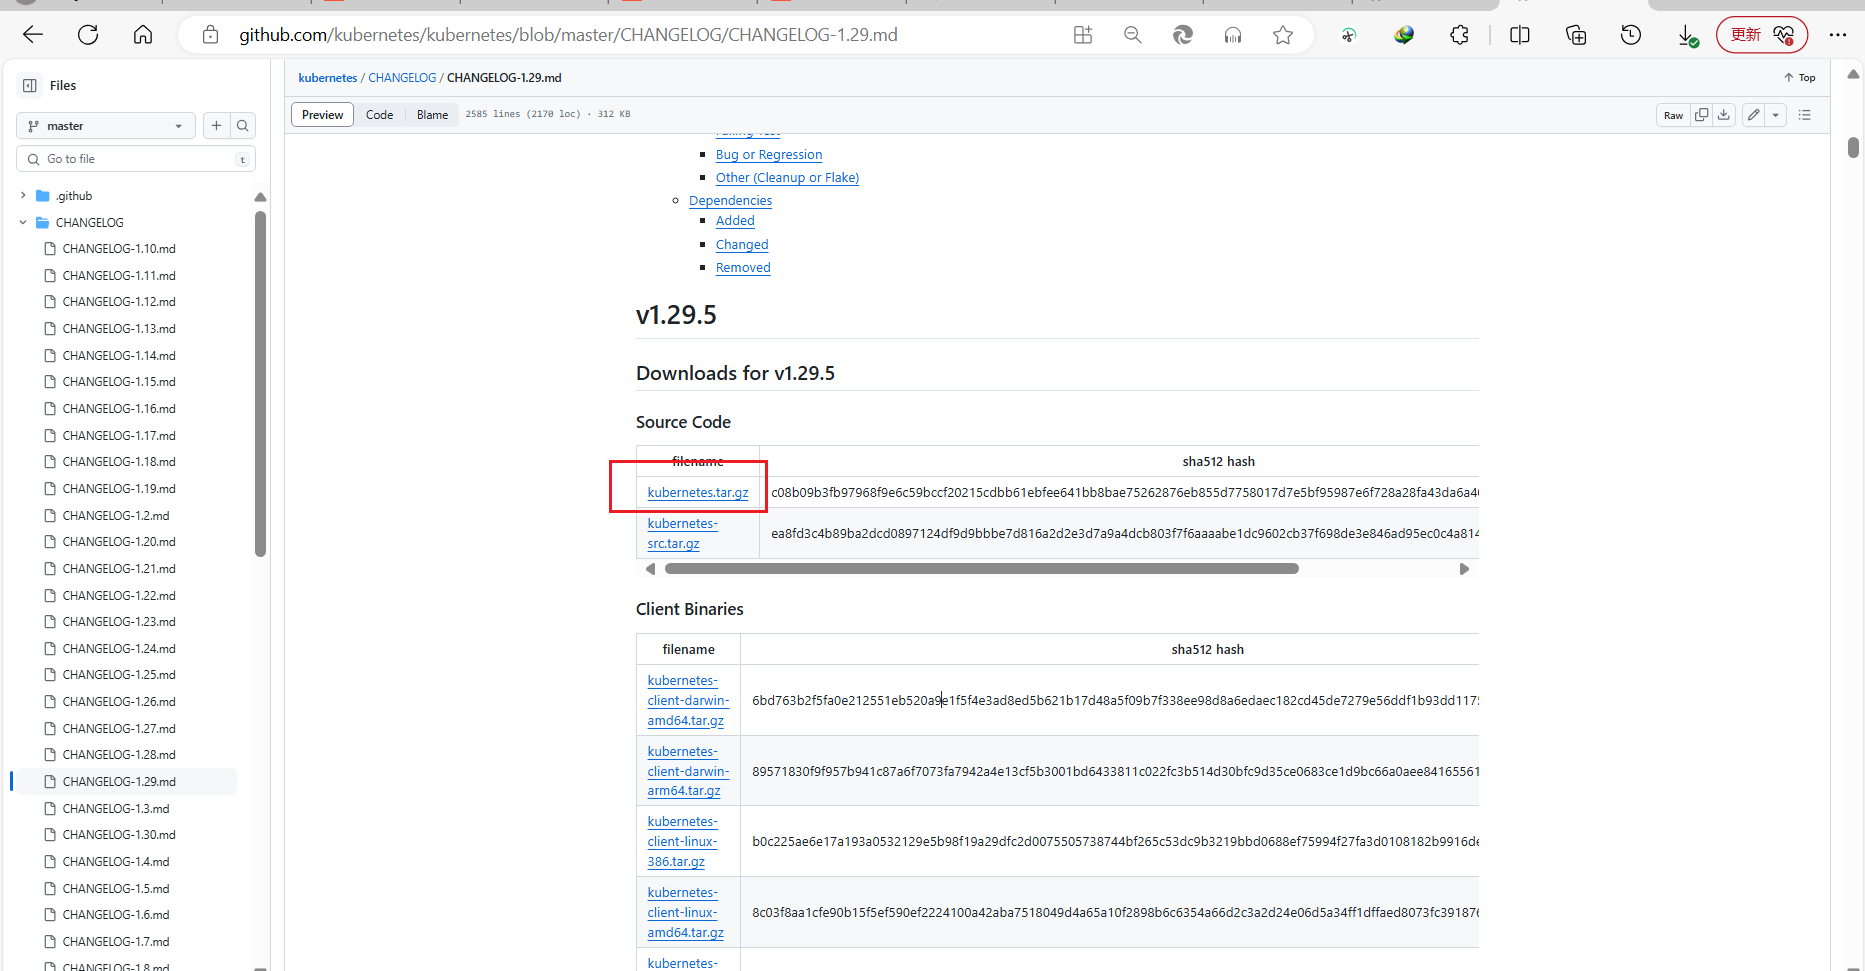
之后进入下面目录可以看到对应的metric-server的yaml文件
root@harbor:~# cd /root/kubernetes/cluster/addons/metrics-server/
root@harbor:~/kubernetes/cluster/addons/metrics-server# ls
auth-delegator.yaml metrics-apiservice.yaml metrics-server-service.yaml README.md
auth-reader.yaml metrics-server-deployment.yaml OWNERS resource-reader.yaml
root@harbor:~/kubernetes/cluster/addons/metrics-server# cd ..
root@harbor:~/kubernetes/cluster/addons# ls
addon-manager device-plugins ip-masq-agent metrics-server README.md
calico-policy-controller dns kube-proxy node-problem-detector storage-class
cloud-controller-manager dns-horizontal-autoscaler metadata-agent OWNERS volumesnapshots
cluster-loadbalancing fluentd-gcp metadata-proxy rbac
直接通过github的metric-server命令直接运行即可。
root@harbor:~# kubectl apply -f high-availability-1.21+.yaml 如果通过二进制包中的yaml文件配置metric-server。需要修改对应yaml文件中的变量值
root@harbor:~/kubernetes/cluster/addons/metrics-server# vi metrics-server-deployment.yaml
...
command:
- /pod_nanny
- --config-dir=/etc/config
- --cpu={{ base_metrics_server_cpu }}
- --extra-cpu=0.5m
- --memory={{ base_metrics_server_memory }}
- --extra-memory={{ metrics_server_memory_per_node }}Mi
- --threshold=5
- --deployment=metrics-server-v0.6.3
- --container=metrics-server
- --poll-period=30000
- --estimator=exponential
# Specifies the smallest cluster (defined in number of nodes)
# resources will be scaled to.
- --minClusterSize={{ metrics_server_min_cluster_size }}
# Use kube-apiserver metrics to avoid periodically listing nodes.
- --use-metrics=true
...
修改为如下内容.
主要修改每个容器的cpu ,每个容器的内存, metrics内存在每个节点的额外内存。以及 metrics server集群的最小数量
...
command:
- /pod_nanny
- --config-dir=/etc/config
- --cpu=50m
- --extra-cpu=0.5m
- --memory=200Mi
- --extra-memory=10Mi
- --threshold=5
- --deployment=metrics-server-v0.6.3
- --container=metrics-server
- --poll-period=30000
- --estimator=exponential
# Specifies the smallest cluster (defined in number of nodes)
# resources will be scaled to.
- --minClusterSize=2
# Use kube-apiserver metrics to avoid periodically listing nodes.
- --use-metrics=true
...之后直接应用即可
root@harbor:~/kubernetes/cluster/addons/metrics-server# kubectl apply -f ./运行kubectl top node 命令时提示如下报错
error: metrics not available yet需要加入如下报错信息
containers:
- args:
  - --cert-dir=/tmp
  - --secure-port=443
  - --kubelet-preferred-address-types=InternalIP,ExternalIP,Hostname
  - --kubelet-use-node-status-port
  - --metric-resolution=15s
  - --kubelet-insecure-tls # 加上该启动参数
之后直接应用即可
3.2 显示资源使用信息
kubectl top命令可显示节点和Pod对象的资源使用信息 , 它基于集群中的资源指标API来收集各项指标数据。它有node和pod两个子命令 , 分别用于显示Node对象和Pod对象的相关资源占用率。 列出Node资源占用率的命令语法格式为kubectl top node [-l label | NAME] , 例如下面命令结果显示了各节点累计CPU资源占用时长与百分比 , 以及内容空间占用量与占用比例。必要时 , 我们也可以在命令中直接给出要查看的特定节点的标识 , 并使用标签选择器进行节点过滤。
root@harbor:~# kubectl top nodes
NAME                     CPU(cores)   CPU%   MEMORY(bytes)   MEMORY%
k8s-master01.cbear.top   99m          1%     784Mi           10%
k8s-master02.cbear.top   68m          0%     655Mi           8%
k8s-master03.cbear.top   115m         1%     808Mi           10%
k8s-node01.cbear.top     39m          0%     622Mi           8%
k8s-node02.cbear.top     51m          0%     543Mi           7%
k8s-node03.cbear.top 53m 0% 605Mi 8% 而名称空间级别的Pod对象资源占用率的使用方式会略有不同 , 相 关命令会限定名称空间并使用标签选择器过滤出目标Pod对象。命令的 语法格式为kubectl top pod [NAME | -l label] [--all namespaces] [--containers=false|true] , 例如下面显示了kube-system名称空间中标签为app=flannel的所有Pod资源及其容器的资源占用状态 :
root@harbor:~# kubectl top pods -A -l app=flannel
NAMESPACE     NAME                    CPU(cores)   MEMORY(bytes)
kube-system   kube-flannel-ds-hzpsj   14m          12Mi
kube-system   kube-flannel-ds-m9b8k   12m          13Mi
kube-system   kube-flannel-ds-mfj42   13m          13Mi
kube-system   kube-flannel-ds-msd55   13m          13Mi
kube-system   kube-flannel-ds-rfmpf   12m          14Mi
kube-system   kube-flannel-ds-rkt24   16m          13Mi
由此可见 , kubectl top命令为用户提供了简洁、快速获取Node对象及Pod对象占用系统资源状况的接口 , 事实上它是集群日常维护中常用的命令之一
4. 自动弹性缩放
Deployment、ReplicaSet、Replication Controller或 StatefulSet控制器资源管控的Pod副本数量支持手动运行时调整 , 从 而可以更好地匹配业务规模的实际需求 , 但这种调整的方式需要用户深度参与监控容器应用的资源压力并计算出合理的值进行调整 , 存在 一定程度的滞后性。为此 , Kubernetes提供了多种自动弹性缩放工具
HPA: 一种支持控制器对象下Pod规模弹性缩放的工具 , 如图 15-15所示。目前 , HPA有两个版本的实现 : HPAv1和HPAv2 , HPAv1仅支 持把CPU指标数据作为评估基准 , 而新版本能够使用资源指标API、自 定义指标API和外部指标API中的指标。CA: 全称Cluster Autoscaler, 是集群规模自动弹性缩放工具 , 能自动增减GCP、AWS或Azure集群上部署的Kubernetes集群节点数量 ,GA版本自Kubernetes v1.8起可用。VPA: 是Pod应用垂直缩放工具 , 它通过调整Pod对象的CPU和内存资源需求量完成扩展或收缩。AR: 全称Addon Resizer, 是一个简化版本的Pod应用垂直缩放工具 , 它基于集群中的节点数量来调整附加组件的资源需求量。
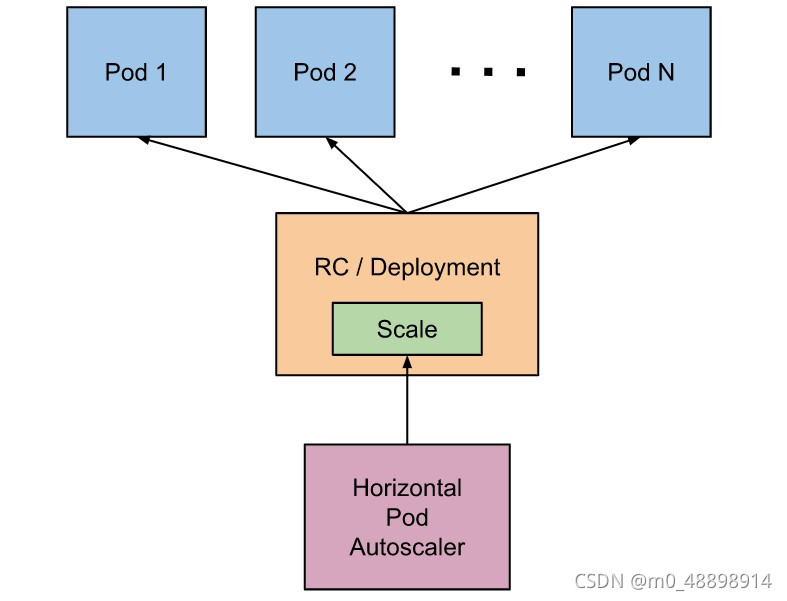
4.1 HPA控制器概述
HPA自身是控制循环的一个实现 , 其周期由kube-controller-manager守护进程的--horizontal-pod-autoscaler-sync-period选项定义 , 默认为15秒。在每个周期内 , Controller-Manager将根据每个 HPA对象定义中指定的指标查询相应的资源利用率 , 并根据用户定义的阈值自主进行应用规模缩放相关的决策。目前 , HPAv2支持资源指标 API(针对每个Pod资源指标)和自定义指标API(针对所有其他指标) , 而HPAv1仅支持前者。
对于每个资源指标 ( 例如
CPU) , 控制器将从HPA定位到的每个Pod的资源指标API中获取指标数据 ; 设置了目标利用率标准时 ,HPA控制器计算实际利用率(utilized/requests) , 而未设置标准的场景则直接使用其初始值。而后 , 控制器获取所有目标Pod对象的利用率或初始值的均值(取决于指定的目标类型) , 并生成一个用于缩放所需副本数的比例。对于那些未定义资源需求量的Pod对象 ,HPA控制器将无法定义该容器的CPU利用率 , 并且不会对该指标采取任何操作。针对每个
Pod对象的自定义指标 ,HPA控制器的处理逻辑与每个Pod资源指标处理机制类似 , 只是它仅能够处理初始值而非利用率。
由于指标的动态变动特性 , 使用HPA控制器管理Pod对象副本规模 时可能会导致副本数量频繁波动 , 这种现象有时也称为“抖动”。故此 , 从Kubernetes 1.6版本开始允许集群管理员通过调整kube-controller-manager的选项值定义副本数变动延迟时长来缓解此问 题。目前 , 默认的缩容延迟时长为5分钟 , 而扩容延迟时长为3分钟。
整体流程 : 15s/周期 -> 查询metrics.k8s.io API -> 算法计算 -> 调用scale调度 -> 特定的扩缩容策略执行。
注意: Pod的自动缩放不适用于无法缩放的对象。 HPA的API有三个版本:
[root@k8s001 ~]# kubectl api-versions | grep autoscal
autoscaling/v1
autoscaling/v2beta1
autoscaling/v2beta2autoscaling/v1: 只支持基于CPU指标的缩放。autoscaling/v2beta1: 支持Resource Metrics( 资源指标, 如pod的CPU) 和Custom Metrics( 自定义指标 ) 的缩放。autoscaling/v2beta2: 支持Resource Metrics( 资源指标, 如pod的CPU) 和Custom Metrics( 自定义指标 ) 和ExternalMetrics( 额外指标 ) 的缩放。
4.2 HPA 扩缩容算法
4.2.1 算法模型
在HPA控制器里, 针对不同类型的metrics和不同metrics下的target 类型, 都有独立的计算算法, 虽然有很多细节差异, 但是总的来说, 计算公式可以抽象为:
desiredReplicas = ceil[currentReplicas * ( currentMetricValue / desiredMetricValue )] 例如如果配置 target value 是100m, 当前从metrics接口读取到的 metrics value 是 200m, 说明最新的副本数应该是当前的 200m/100m=2.0倍, 如果当前副本数为 2, 则HPA计算后的期望副本数是2*2.0=4; 而如果当前从metrics接口读取到的 metrics value是 50m, 说明最新的副本数应该是当前的 50m/100m=0.5倍, 也就是最终scale的副本数将为1。 当然实际上当前的metrics value并不一定就只有一个值, 如果是 Resource或者Pods类型的metrics, 实际上 GetMetrics 会返回一批关联的Pods对应的metrics数据, 一般需要做一个平均后再与target的metrics的做比较。
此外, 为了保证结果尽量精确, metrics的计算都是浮点数计算, 但是最终的副本数肯定要是整数, 为了统一HPA控制器在最后, 都会对计算出的浮点数副本数向上取整, 也就是上面公式里最外层的ceil函数。
4.2.2 扩缩容threshold控制
当然上面的公式也只是纯数学模型 , 实际工程实现还要考虑很多现实细节问题: 比如监控数据可能会有一定的误差 , 如果GetMetrics里读到数据不稳定就会造成算出的期望副本数不稳定 , 导致deployment一会扩缩1个副本 , 一会又扩容1副本。所以为了避免这种问题kube-controller-manager里有个HPA的专属参数 horizontal-pod-autoscaler-tolerance 表示HPA可容忍的最小副本数变化比例 , 默认是0.1 , 如果期望变化的副本倍数在[0.9, 1.1] 之间就直接停止计算返回。那么如果相反 , 某个时间点开始metrics数据大幅增长 , 导致最后计算的副本数变化倍数很大 , 是否HPA控制器会一步扩容到位呢? 事实上HPA控制器为了避免副本倍增过快还加了个约束: 单次倍增的倍数不能超过2倍 , 而如果原副本数小于2 , 则可以一次性扩容到4副本 , 注意这里的速率是代码写死不可用配置的。(这个也是HPA controller默认的扩缩容速率控制 , autoscaling/v2beta2的HPA Behavior属性可以覆盖这里的全局默认速率)
注 : 容忍度是由
kube-controller-manager参数--horizontal-pod-autoscaler-tolerance决定 . 默认是0.1. 即 10%。
4.2.3 缩容冷却机制(cooldown delay)
虽然HPA同时支持扩容和缩容 , 但是在生产环境上扩容一般来说重要性更高 , 特别是流量突增的时候 , 能否快速扩容决定了系统的稳定性 , 所以HPA的算法里对扩容的时机是没有额外限制的 , 只要达到扩容条件就会在reconcile里执行扩容 ( 当前一次至少扩容到原来的1.1倍 ) 。但是为了避免过早缩导致来回波动 ( thrashing ) , 而容影响服务稳定性甚 , HPA的算法对缩容的要求比较严格 , 通过设置一个默认5min ( 可配置horizontal-pod-autoscaler-downscale-stabilization ) 的滑动窗口 , 来记录过去5分钟的期望副本数 , 只有连续5分钟计算出的期望副本数都比当前副本数小 , 才执行scale缩容操作 , 缩容的目标副本数取5分钟窗口的最大值。
总的来说k8s HPA算法的默认扩缩容原则是: 快速扩容 , 谨慎缩容。
4.2.4 Pod的metrics数据过滤检查机制
一般情况下HPA的数据指标都来自k8s的Pod里 , 但是实际上每次创建deployment、对deployment做扩缩容 , Pod的副本数和状态都会不断变化 , 这就导致HPA controller在reconcile里获取到的metrics的指标肯定会有一定的异常 , 比如Pod还没有Running、Pod刚刚启动还在预热期、或者Pod中间临时OOM恰逢采集时刻、或者Pod正处在删除中 , 这些都可能导致metrics指标缺失。如果有任何 pod 的指标缺失 , HPA控制器会采取最保守的方式重新计算平均值 , 在需要缩小时假设这些 pod 消耗了目标值的 100% , 在需要放大时假设这些 pod 消耗了0%目标值 , 这可以在一定程度上抑制伸缩的幅度。
具体来说 , HPA算法里把deployment下的所有Pod的metrics的指标数据分为三类:
ready pods list ,  deployment下处于Running状态的Pod且HPA controller成功通过GetMetrics获取的pod metrics的列表

ignore pods list ,  deployment下处于pending状态的Pods或者 ( 仅对Resouce类似的cpu metrics有效 ) 虽然pod running了但controller成功通过GetMetrics获取的pod metrics , 但是pod的启动时间在配置的initial-readiness-delay和cpu-initialization-period 保护期内。

missing pods list , deployment下处于running状态的pod ( 非pending、非failed、非deleted状态 ) 但是HPA controller通过GetMetrics无法获取的pod metrics的列表在计算pod的平均metrics值的时候 , 统一把 ignore pods的metrics设置为最小值0 , 如果HPA扩缩容的方向是扩容 , 把missing pods的metrics也设置为最小值0 , 如果是缩容方向则把missing pods的metrics也设置为最大值 ( 如果是Resouce类型 , 最大值是Pod的request值 , 否则最大值就是target value ) 。
4.3 HPA的scale速度控制
讲解完HPA的原理及具体算法后, 最后再重点介绍HPA在扩缩容的速率控制机制。在前面讲过HPA controller里默认扩缩容总原则是 : 快速扩容, 谨慎缩容, 扩容上虽然强调快, 但是速度却是固定的, 最大为当前副本数的2倍速度, 对于想设置其他倍数或者说想精确控制副本数增量的方式的需求都是不行的; 缩容上则仅仅只是靠设置一个集群全局的窗口时间, 窗口期过后也就失去控制能力。
为了能更精准灵活地控制HPA的autoscale速度, 从k8s v1.18( 依赖HPA autoscaling/v2beta2) 开始HPA的spec里新增了behavior结构( 如下定义) 扩展了HPA的scale速度控制策略, 该结构支持每个HPA实例独立配置扩缩容的速度, 而且还可以单独配置扩容scaleUp和缩容scaleDown使用不同的策略。
在扩容策略ScalingRules里, 有个StabilizationWindowSeconds用来记录最近计算的期望副本数, 效果跟上面缩容的cooldown delay机制一样, 每次都会选择窗口里所有推荐值的最大值, 保证结果的稳定性。stabilizationWindowSeconds 可以通过 kube-controller-manager 的 --horizontal-pod-autoscaler-downscale-stabilization 参数进行全局配置 , 该参数的默认值同样为 300 秒(5 分钟)
Policies是一个HPAScalingPolicy数组, 每个HPAScalingPolicy才是真正控制速度的部分 : 扩缩容计算周期和周期内扩缩容变化的最大幅度, PeriodSeconds周期单位是秒, Percent是设置副本数每次变化的百分比, 扩容后副本数是 : (1+PercentValue%)* currentReplicas, 缩容后副本数是 : ( 1-PercentValue%) * currentReplicas; Pods则是设置每次副本数变化的绝对值。
此外, 每个方向还可以设置多个策略, 多个策略会同时计算最终副本数, 最后结果则是通过SelectPolicy : Max/Min/Disabled做聚合, 注意在缩容时Max会选择计算副本数最小的那个, Min会选择计算的副本数最大的那个, Disabled表示禁止这个方向的扩缩容。
type HorizontalPodAutoscalerBehavior struct {
        // scaleUp is scaling policy for scaling Up.
        // If not set, the default value is the higher of:
        //   * increase no more than 4 pods per 60 seconds
        //   * double the number of pods per 60 seconds
        ScaleUp *HPAScalingRules
        // scaleDown is scaling policy for scaling Down.
        // If not set, the default value is to allow to scale down to minReplicas pods, with a
        // 300 second stabilization window (i.e., the highest recommendation for
        // the last 300sec is used).
        ScaleDown *HPAScalingRules
}

type HPAScalingRules struct {
        // StabilizationWindowSeconds is the number of seconds for which past recommendations should be
        // considered while scaling up or scaling down.
        StabilizationWindowSeconds *int32
        // selectPolicy is used to specify which policy should be used.
        // If not set, the default value MaxPolicySelect is used.
        SelectPolicy *ScalingPolicySelect
        // policies is a list of potential scaling polices which can used during scaling.
        // At least one policy must be specified, otherwise the HPAScalingRules will be discarded as invalid
        Policies []HPAScalingPolicy
}

// HPAScalingPolicyType is the type of the policy which could be used while making scaling decisions.
type HPAScalingPolicyType string
const (
        // PodsScalingPolicy is a policy used to specify a change in absolute number of pods.
        PodsScalingPolicy HPAScalingPolicyType = "Pods"
        // PercentScalingPolicy is a policy used to specify a relative amount of change with respect to
        // the current number of pods.
        PercentScalingPolicy HPAScalingPolicyType = "Percent"
)

// HPAScalingPolicy is a single policy which must hold true for a specified past interval.
type HPAScalingPolicy struct {
        // Type is used to specify the scaling policy.
        Type HPAScalingPolicyType
        // Value contains the amount of change which is permitted by the policy.
        Value int32
        // PeriodSeconds specifies the window of time for which the policy should hold true.
        // PeriodSeconds must be greater than zero and less than or equal to 1800 (30 min).
        PeriodSeconds int32
}HPA的Behavior如果不设置, k8s会自动设置扩缩容的默认配置, 具体内容如下 :
behavior:
  scaleDown:
    stabilizationWindowSeconds: 300         # 需要缩容时 . 先观察 5 分钟 . 如果一直持续需要缩容才执行缩容
    policies:
    - type: Percent
      value: 100                           # 允许全部缩掉
      periodSeconds: 15
  scaleUp:
    stabilizationWindowSeconds: 0          # 需要扩容时 . 立即扩容
    policies:
    - type: Percent
      value: 100
      periodSeconds: 15                   # 每 15s 最大允许扩容当前 1 倍数量的 Pod
    - type: Pods
      value: 4
      periodSeconds: 15                   # 每 15s 最大允许扩容 4 个 Pod
    selectPolicy: Max                     # 使用以上两种扩容策略中算出来扩容 Pod 数量最大的
默认配置里分别定义了扩容和缩容的速率策略, 缩容按照百分比, 每15秒最多减少currentReplicas*100%个副本( 但最终不可小于minReplicas) , 且缩容后的最终副本不得低于过去300s内计算的历史副本数的最大值;扩容则采用快速扩容, 不考虑历史计算值( 窗口时间为0) , 每15秒副本翻倍或者每15秒新增4个副本( 取最大值) , 即 : max(2*currentReplicas,4)。这个默认Behavior的默认配置是否有点似曾相似的感觉, 没错它跟HPA没有Behavior时的默认快速扩容, 缩容的策略是完全一致的。
periodSeconds 的最大值为1800
4.4 不同扩缩容速率需求场景下的behavior用法举例
场景1 : 扩容越快越好
如果业务希望能尽快的扩容, 可以配置大的
percent值, 可以按照如下配置 :behavior: scaleUp: policies: - type: Percent value: 900 periodSeconds: 60上面的配置表示扩容时最大一次性新增当前
9倍数量的副本数 . 当然也不能超过maxReplicas的限制。假如
deployment的副本数最开始是1, 那么每隔60s的的极限扩容副本数的变化如下 :1 -> 10 -> 100 -> 1000也就是每个扩容
period都是( 1+900%) =10倍的速度, 不过最大副本数依然不可用超过HPA的maxReplicas上界, 缩容则使用默认行为。当然Percent类型可能对资源消耗波动特别大, 如果希望资源消耗可控, 可以按绝对副本数来Pods类型来配置。没有配置缩容策略 . 将等待全局默认的缩容时间窗口 (默认5分钟) 后开始缩容。
场景 2: 扩容越快越好但要逐步缩容
如果流量高峰过了 . 并发量骤降 . 如果用默认的缩容策略 . 等几分钟后
Pod数量也会随之骤降 . 如果Pod缩容后突然又来一个流量高峰 . 虽然可以快速扩容 . 但扩容的过程毕竟还是需要一定时间的 . 如果流量高峰足够高 . 在这段时间内还是可能造成后端处理能力跟不上 . 导致部分请求失败。这时候我们可以为HPA加上缩容策略当业务希望能尽快的扩容, 但是缩容需要缓慢一些时, 可以使用如下配置 :
behavior: scaleUp: policies: - type: Percent value: 900 periodSeconds: 60 # 每 15s 最多允许扩容 9 倍于当前副本数 scaleDown: policies: - type: Pods value: 1 periodSeconds: 600 # 每 10 分钟最多只允许缩掉 1 个 Pod假如
pod最开始数量为1, 那么扩容路径如下 :1 -> 10 -> 100 -> 1000同时, 缩容路径如下 (每 10 分钟缩容一次, 每次减少一个 pod) :
1000 -> 1000 -> 1000 -> … (another 7 min) -> 999 ( 最小不低于minReplicas)这个可以让关键业务在可能有流量突发的情况下保持处理能力 , 避免流量高峰导致部分请求失败。
场景 3: 逐步扩容、正常的缩容
如果想要你的应用不太关键 , 希望扩容时不要太敏感 , 可以让它扩容平稳缓慢一点 , 为
HPA加入下面的behavior:当希望缓慢的扩容、正常的缩容, 可以使用如下配置
behavior:
  scaleUp:
    policies:
    - type: Pods
      value: 1
      periodSeconds: 600    # 每 10 分钟最多只允许扩容 1 个 Pod
场景 4: 正常扩容、不要缩容 如果希望能正常的扩容, 但是不要自动缩容, 可以使用如下配置 :
behavior:
  scaleDown:
    policies:
    - type: Percent 或 Pods
      value: 0
      periodSeconds: 600
把缩容的百分比或者
pod都置为0, 那么就永远不会缩容。 或者直接设置selectPolicy: Disabled。behavior: scaleDown: selectPolicy: Disabled场景 5: 延后缩容
缩容默认时间窗口是 5 分钟 , 如果我们需要延长时间窗口以避免一些流量毛刺造成的异常 , 可以指定下缩容的时间窗口 ,
behavior配置示例如下:behavior: scaleDown: stabilizationWindowSeconds: 600 # 等待 10 分钟再开始缩容 policies: - type: Pods value: 5 periodSeconds: 600 # 每 10 分钟最多只允许缩掉 5 个 Pod上面的示例表示当负载降下来时 , 会等待
600s(10分钟) 再缩容 , 每10分钟最多只允许缩掉5个Pod。场景 6: 延长扩容时间窗口
有些应用经常会有数据毛刺导致频繁扩容 , 而扩容出来的
Pod其实没太大必要 , 反而浪费资源。比如数据处理管道的场景 , 需要的副本数取决于队列中的事件数量 , 当队列中堆积了大量事件时 , 我们希望可以快速扩容 , 但又不希望太灵敏 , 因为可能只是短时间内的事件堆积 , 即使不扩容也可以很快处理掉。默认的扩容算法会在较短的时间内扩容 , 针对这种场景我们可以给扩容增加一个时间窗口以避免毛刺导致扩容带来的资源浪费 ,
behavior配置示例如下:behavior: scaleUp: stabilizationWindowSeconds: 300 # 扩容前等待 5 分钟的时间窗口 policies: - type: Pods value: 20 periodSeconds: 60 # 每分钟最多只允许扩容 20 个 Pod上面的示例表示扩容时 , 需要先等待
5分钟的时间窗口 , 如果在这段时间内指标又降下来了就不再扩容 , 如果一直持续超过阈值才扩容 , 并且每分钟最多只允许扩容20个Pod。
配置快速扩容 , 为什么快不起来?
比如这个配置 :
behavior:
  scaleUp:
    policies:
    - type: Percent
      value: 900
      periodSeconds: 10
含义是允许每
10秒最大允许扩出9倍于当前数量的Pod, 实测中可能发现压力已经很大了 , 但扩容却并不快。通常原因是计算周期与指标延时:
期望副本数的计算有个计算周期 , 默认是
15秒 (由kube-controller-manager的--horizontal-pod-autoscaler-sync-period参数决定)。每次计算时 , 都会通过相应的
metrics API去获取当前监控指标的值 , 这个返回的值通常不是实时的 , 对于腾讯云容器服务而言 , 监控数据是每分钟上报一次;对于自建的prometheus + prometheus-adapter而言 , 监控数据的更新取决于监控数据抓取间隔 ,prometheus-adapter的--metrics-relist-interval参数决定监控指标刷新周期(从 prometheus 中查询) , 这两部分时长之和为监控数据更新的最长时间。
通常都不需要
HPA极度的灵敏 , 有一定的延时一般都是可以接受的。如果实在有对灵敏度特别敏感的场景 , 可以考虑使用prometheus, 缩小监控指标抓取间隔和prometheus-adapter的--metrics-relist-interval。
4.5 度量指标详细说明
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: php-apache
  namespace: default
spec:
  # HPA的伸缩对象描述, HPA会动态修改该对象的pod数量
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: php-apache
  # HPA的最小pod数量和最大pod数量
  minReplicas: 1
  maxReplicas: 10
  # 监控的指标数组, 支持多种类型的指标共存
  metrics:
  # Object类型的指标
  #object 指描述单个 kubernetes 对象的度量(例如,Ingress 对象的每秒点击率)。
  - type: Object
    object:
      metric:
        # 指标名称
        name: requests-per-second
        #指定选择器 : selector	<LabelSelector>
        #selector	<LabelSelector>
      # 监控指标的对象描述, 指标数据来源于该对象
      describedObject:
        apiVersion: networking.k8s.io/v1beta1
        kind: Ingress
        name: main-route

      target:
        # target支持以下参数
        # averageUtilization	<integer>
        # value	<Quantity>
        # averageValue	<Quantity>
        # Value类型的目标值, Object类型的指标支持Utilization、AverageValue和value类型的目标值
        type: Value
        value: 10k
  # Resource类型的指标
  #resource 指的是 Kubernetes 已知的描述当前扩展目标中每个 pod 的资源度量(如请求和限制中指定的度量)(如 CPU 或内存)。此类指标是 Kubernetes 的内置指标,在使用 “pods ”源的普通每个 pod 指标的基础上,还有特殊的缩放选项。

  - type: Resource
    resource:
      name: cpu
      target:
        # target支持以下参数
        # averageUtilization	<integer>
        # value	<Quantity>
        # averageValue	<Quantity>
        # Utilization类型的目标值, Resource类型的指标支持Utilization、AverageValue和value类型的目标值
        type: Utilization
        averageUtilization: 50
  # Pods类型的指标
  #pods 指的是描述当前规模目标中每个 pod 的指标(例如,事务处理量-每秒)。 在与目标值进行比较之前,将对这些值进行平均。
  - type: Pods
    pods:
      metric:
        name: packets-per-second
        #metric下同时支持选择器
        #selector	<LabelSelector>
      # AverageValue类型的目标值, Pods指标类型下只支持AverageValue类型的目标值
      target:
        # target支持以下参数
        # averageUtilization	<integer>
        # value	<Quantity>
        # averageValue	<Quantity>
        # AverageValue类型的目标值, pods类型的指标支持Utilization、AverageValue和value类型的目标值
        type: AverageValue
        averageValue: 1k
  # External类型的指标
  #external指的是与任何 Kubernetes 对象相关联。它允许根据来自 它允许根据来自集群外部运行组件的信息(例如云消息服务中的队列长度,或来自集群外运行的负载平衡器的 QPS)。
  - type: External
    external:
      metric:
        name: queue_messages_ready
        # 该字段与第三方的指标标签相关联
        selector:
          matchLabels:
            env: "stage"
            app: "myapp"
      # External指标类型下只支持Value和AverageValue类型的目标值
      target:
        # target支持以下参数
        # averageUtilization	<integer>
        # value	<Quantity>
        # averageValue	<Quantity>
        # AverageValue类型的目标值, pods类型的指标支持Utilization、AverageValue和value类型的目标值
        type: AverageValue
        averageValue: 30
containerResource <ContainerResourceMetricSource> containerResource 指的是 Kubernetes 已知的资源度量(例如在 请求和限制中指定的)。当前规模目标(如 CPU 或内存)的每个 pod 中描述单个容器的已知资源指标(如请求和限制中指定的指标)。此类指标 内建在 Kubernetes 中,并在那些可用于普通每节点指标的" pods" 源提供的普通每 pod 指标之外,还有特殊的扩展选项。这是一个 可通过 HPAContainerMetrics 功能标志启用。
同时支持container、name 、target三个字段
参考链接
Kubernetes学习之路 ( 二十三 ) 之资源指标和集群监控 - 烟雨浮华 - 博客园 (cnblogs.com)
kubernetes之HPA详细介绍 - yuhaohao - 博客园 (cnblogs.com)
Kubernetes 的 HPA 原理详解 - 崧蓝 - 博客园 (cnblogs.com)
根据业务场景调节 HPA 扩缩容速率 | Kubernetes 实践指南 (imroc.cc)