
3-9-1-存储卷基础概念
以Docker为代表的容器运行时通常都支持配置容器使用“存储 卷”将数据持久存储于容器自身文件系统之外的存储空间中 , 这些存储空间可来自宿主机文件系统或网络存储系统。相应地 , Kubernetes 也支持类似的存储卷功能以实现短生命周期的容器应用数据的持久化 , 不过 , 其存储卷绑定于Pod对象而非容器级别 , 并可共享给内部的所有容器使用。本章主要介绍Kubernetes系统之上的主流存储卷类型 及其应用。
1. 存储卷基础
Pod本身有生命周期 , 其应用容器及生成的数据自身均无法独立于该生命周期之外持久存在 , 并且同一Pod中的容器可共享PID、 Network、IPC和UTS名称空间 , 但Mount和USER名称空间却各自独立 , 因而跨容器的进程彼此间默认无法基于共享的存储空间交换文件或数据。因而 , 借助特定的存储机制甚至是独立于Pod生命周期的存储设备完成数据持久化也是必然之需。
1.1 存储卷概述
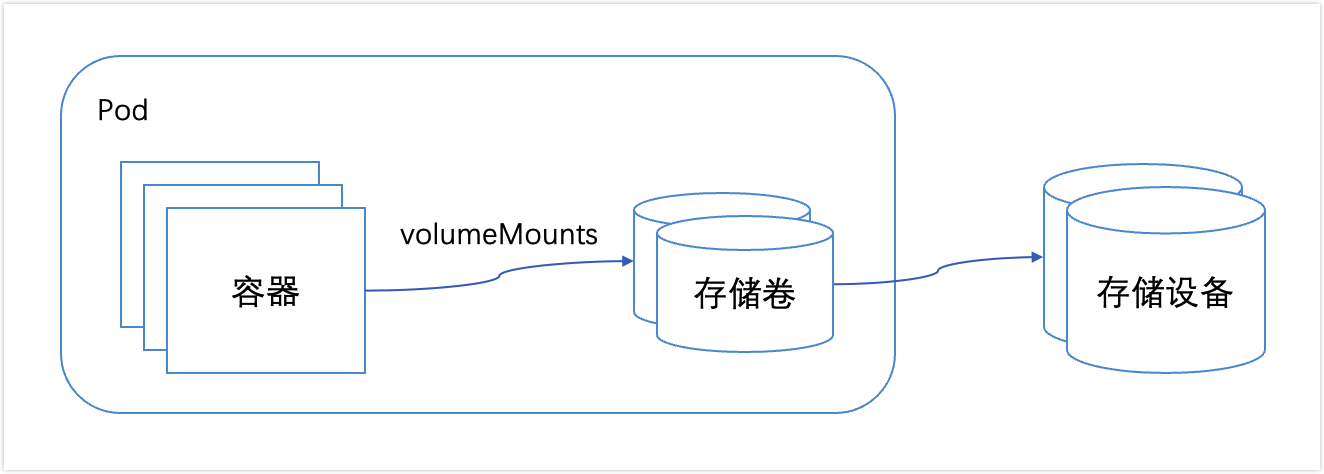
简单来说 , 存储卷是定义在Pod资源之上可被其内部的所有容器挂载的共享目录 , 该目录关联至宿主机或某外部的存储设备之上的存储空间 , 可由Pod内的多个容器同时挂载使用。Pod存储卷独立于容器自身的文件系统 , 因而也独立于容器的生命周期 , 它存储的数据可于容 器重启或重建后继续使用。图展示了Pod容器与存储卷之间的关系。
每个工作节点基于本地内存或目录向Pod提供存储空间 , 也能够使用借助驱动程序挂载的网络文件系统或附加的块设备 , 例如使用挂载至本地某路径上的NFS文件系统等。Kubernetes系统具体支持的存储卷类型要取决于存储卷插件的内置定义 , 如图所示 , 不过Kubernetes 也支持管理员基于扩展接口配置使用第三方存储。另外 , Kubernetes 甚至还支持一些有着特殊功用的存储卷 , 例如将外部信息投射至Pod之中的ConfigMap、Secret和Downward API等。
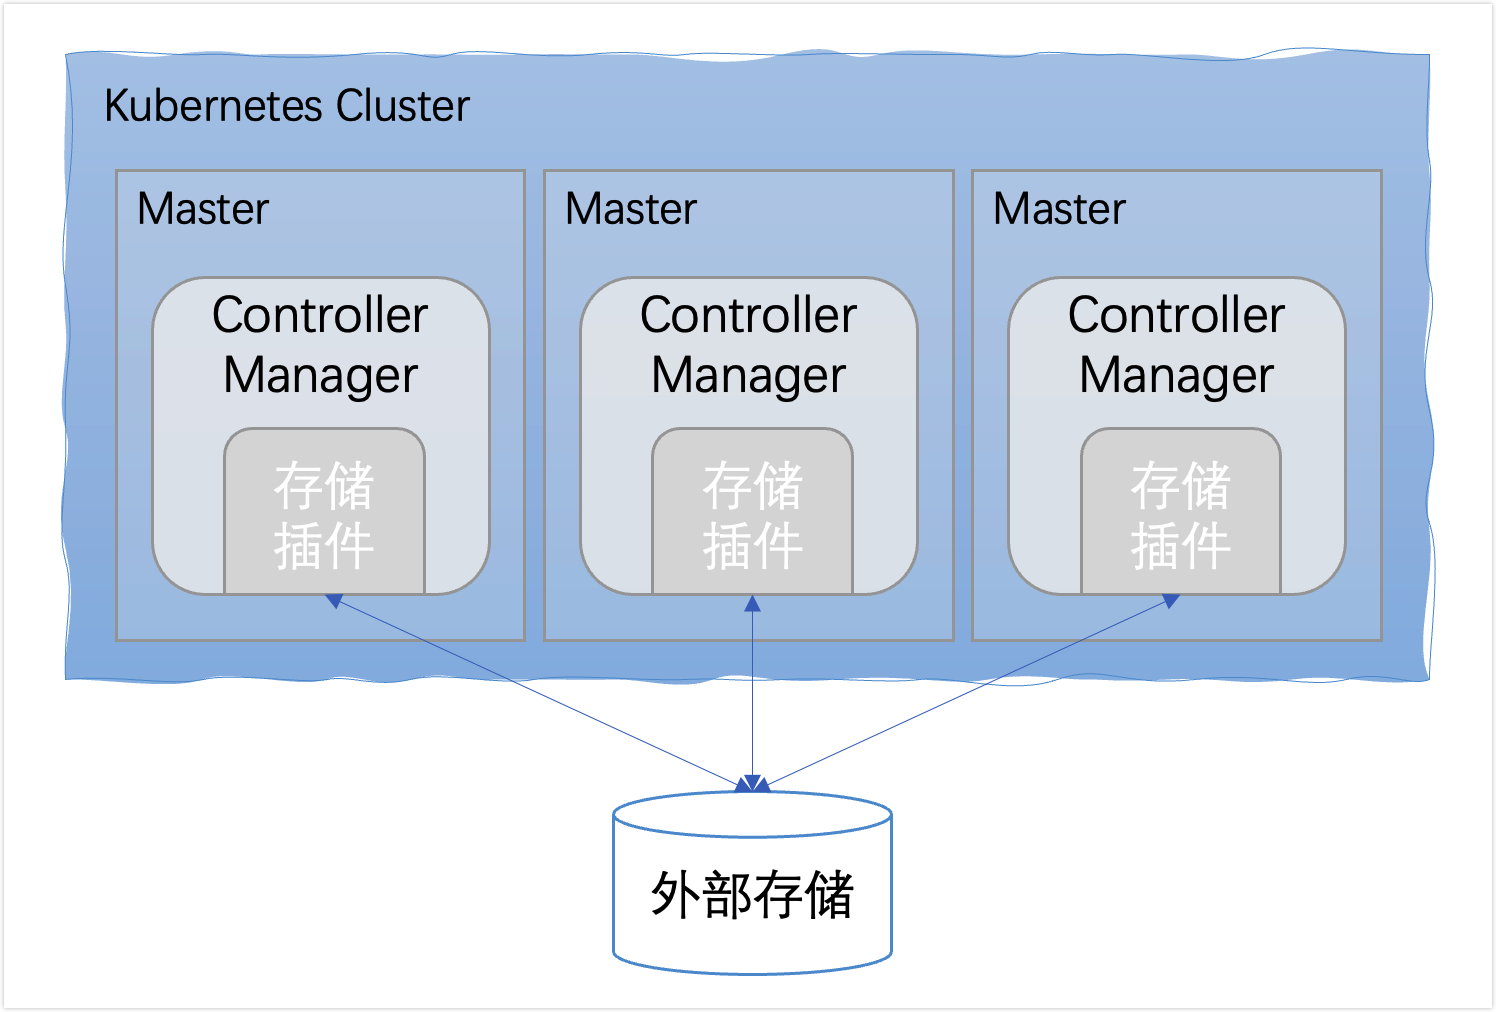
存储卷并非Kubernetes上一种独立的API资源类型 , 它隶属于Pod 资源 , 且与所属的特定Pod对象有着相同的生命周期 , 因而通过API Server管理声明了存储卷资源的Pod对象时也会相应触发存储卷的管理操作。在具体的执行过程中 , 首选由调度器将该Pod对象绑到一个工作节点之上 , 若该Pod定义存储卷尚未被挂载 , Controller Manager中的 AD控制器(Attach/Detach Controller) 会先借助相应的存储卷插件把远程的存储设备附加到该目标节点 , 而由内置在kubelet中的Pod管理器( Pod Manager) 触发本地的存储卷操作实现 , 它借助存储卷管理器( Volume Manager) 调用存储卷插件进行关联并驱动相应存储服务 , 并完成设备的挂载、格式化和卸载等操作。存储卷独立于Pod对象中容器的生命周期 , 从而使得容器重启或更新之后数据依然可用 , 但删除Pod对象时也必将删除其存储卷。
Kubernetes系统内置了多种类型的存储卷插件 , 因而能够直接支持多种类型存储系统( 即存储服务方) , 例如CephFS、NFS、RBD、 iscsi和vSphereVolume等。定义Pod资源时 , 用户可在其spec.volumes 字段中嵌套配置选定的存储卷插件 , 并结合相应的存储服务来使用特定类型的存储卷 , 甚至使用CS或flexVolume存储卷插件来扩展支持更多的存储服务系统。
对Pod对象来说 , 卷类型主要是为关联适配的存储系统时提供相关的配置参数。例如 , 关联节点本地的存储目录与关联GlusterFS存储系 统所需要的配置参数差异巨大 , 因此指定了存储卷类型也就限定了其 关联到的后端存储设备。目前 , Kubernetes支持的存储卷可简单归为以下类别 , 它们也各自有着不少的实现插件。
临时存储卷:
emptyDir。本地存储卷:
hostPath和local。网络存储卷:
云存储——
awsElasticBlockStore、gcePersistentDisk、azureDisk和azureFile。网络文件系统——
NFS、GlusterFS、CephFS和Cinder。网络块设备——
iscsi、FC、RBD和vSphereVolume。网络存储平台——
Quobyte、PortworxVolume、StorageOS和ScaleIO。
特殊存储卷 :
Secret、ConfigMap、DownwardAPI和Projected。扩展支持第三方存储的存储接口(
Out-of-Tree卷插件) :CSI和FlexVolume。
通常 , 这些Kubernetes内置提供的存储卷插件可归类为In-Tree类型 , 它们同Kubernetes源代码一同发布和迭代 , 而由存储服务商借助于CSI或FlexVolume接口扩展的独立于Kubernetes代码的存储卷插件则统称为Out-Of-Tree类型 , 集群管理员也可根据需要创建自定义的扩展 插件 , 目前CSI是较为推荐的扩展接口
尽管网络存储基本都具有持久存储能力 , 但它们都要求Pod资源清单的编写人员了解可用的真实网络存储的基础结构 , 并且能够准确配置用到的每一种存储服务。例如 , 要创建基于Ceph RBD的存储卷 , 用户必须要了解Ceph集群服务器( 尤其是Monitor服务器) 的地址 , 并且 能够理解接入Ceph集群的必要配置及其意义。
1.2 配置Pod存储卷
在Pod中定义使用存储卷的配置由两部分组成: 一部分通 过.spec.volumes字段定义在Pod之上的存储卷列表 , 它经由特定的存储卷插件并结合特定的存储系统的访问接口进行定义 ; 另一部分是嵌 套定义在容器的volumeMounts字段上的存储卷挂载列表 , 它只能挂载当前Pod对象中定义的存储卷。不过 , 定义了存储卷的Pod内的容器也 可以选择不挂载任何存储卷。
spec:
  volumes:
  - name <string>               # 存储卷名称标识 , 仅可使用DNS标签格式的字符 , 在当前Pod中必须唯一
     VOL_TYPE <Object>          # 存储卷插件及具体的目标存储系统的相关配置
  containers:
  - name: …
    image: …
    volumeMounts:
    - name <string>             # 要挂载的存储卷的名称 , 必须匹配存储卷列表中某项的定义
      mountPath <string>        # 容器文件系统上的挂载点路径
      readOnly <boolean>        # 是否挂载为只读模式 , 默认为“否”
      subPath <string>          # 挂载存储卷上的一个子目录至指定的挂载点
      subPathExpr <string>      # 挂载由指定模式匹配到的存储卷的文件或目录至挂载点
mountPropagation <string> # 挂载卷的传播模式Pod配置清单中的.spec.volumes字段的值是一个对象列表 , 每个 列表项定义一个存储卷 , 它由存储卷名称( .spec.volumes.name ) 和存储卷对象( .spec.volumes.VOL_TYPE <object>) 组成 , 其中VOL_TYPE是使用的存储卷类型名称 , 它的内嵌字段随类型的不同而不同 , 具体参数需要参阅Pod上各存储卷插件的相关文档说明。
定义好的存储卷可由当前Pod资源内的各容器进行挂载。Pod中仅有一个容器时 , 使用存储卷的目的通常在于数据持久化 , 以免重启时导致数据丢失 , 而只有多个容器挂载同一个存储卷时 , “共享”才有了具体的意义。挂载卷的传播模式( mountPropagation) 就是用于配置容器将其挂载卷上的数据变动传播给同一Pod中的其他容器 , 甚至是传播给同一个节点上的其他Pod的一个特性 , 该字段的可用值包括如下几项。
None: 该挂载卷不支持传播机制 , 当前容器不向其他容器或Pod传播自己的挂载操作 , 也不会感知主机后续在该挂载卷或其任何子目录上执行的挂载变动 ; 此为默认值。HostToContainer: 主机向容器的单向传播 , 即当前容器能感知主机后续对该挂载卷或其任何子目录上执行的挂载变动。Bidirectional: 主机和容器间的双向传播 , 当前容器创建的存储卷挂载操作会传播给主机及使用了同一存储卷的所有Pod的所有容 器 , 也能感知主机上后续对该挂载卷或其任何子目录上执行的挂载变 动 ; 该行为存在破坏主机操作系统的危险 , 因而仅可用于特权模式下的容器中。
除了配置参数的不同 , 各类型存储卷的大体使用格式基本相似
2. 临时存储卷
Kubernetes支持的存储卷类型中 , emptyDir存储卷的生命周期与其所属的Pod对象相同 , 它无法脱离Pod对象的生命周期提供数据存储功能 , 因此通常仅用于数据缓存或临时存储。不过 , 基于emptyDir构建的gitRepo存储卷可以在Pod对象的生命周期起始时 , 从相应的Git仓库中克隆相应的数据文件到底层的emptyDir中 , 也就使得它具有了一 定意义上的持久性。
2.1 emptyDir存储卷
emptyDir存储卷可以理解为Pod对象上的一个临时目录 , 类似于 Docker上的“Docker挂载卷” , 在Pod对象启动时即被创建 , 而在Pod 对象被移除时一并被删除。因此 , emptyDir存储卷只能用于某些特殊 场景中 , 例如同一Pod内的多个容器间的文件共享 , 或作为容器数据的 临时存储目录用于数据缓存系统等。
emptyDir存储卷嵌套定义在.spec.volumes.emptyDir字段中 , 可用字段主要有两个。
medium: 此目录所在的存储介质的类型 , 可用值为default或Memory, 默认为default, 表示使用节点的默认存储介质 ;Memory表示 使用基于RAM的临时文件系统tmpfs, 总体可用空间受限于内存 , 但性能非常好 , 通常用于为容器中的应用提供缓存存储。sizeLimit: 当前存储卷的空间限额 , 默认值为nil, 表示不限制 ; 不过 , 在medium字段值为Memory时 , 建议务必定义此限额。
下面是一个使用了emptyDir存储卷的简单示例 , 它保存在 volumes-emptydir-demo.yaml配置文件中。
apiVersion: v1
kind: Pod
metadata:
  name: volumes-emptydir-demo
  namespace: default
spec:
  initContainers:
  - name: config-file-downloader
    image: ikubernetes/admin-box
    imagePullPolicy: IfNotPresent
    command: ['/bin/sh','-c','wget -O /data/envoy.yaml https://raw.githubusercontent.com/iKubernetes/Kubernetes_Advanced_Practical_2rd/master/chapter4/envoy.yaml']
    volumeMounts:
    - name: config-file-store
      mountPath: /data
  containers:
  - name: envoy
    image: envoyproxy/envoy-alpine:v1.13.1
    command: ['/bin/sh','-c']
    args: ['envoy -c /etc/envoy/envoy.yaml']
    volumeMounts:
    - name: config-file-store
      mountPath: /etc/envoy
      readOnly: true
  volumes:
  - name: config-file-store
    emptyDir:
      medium: Memory
      sizeLimit: 16Mi
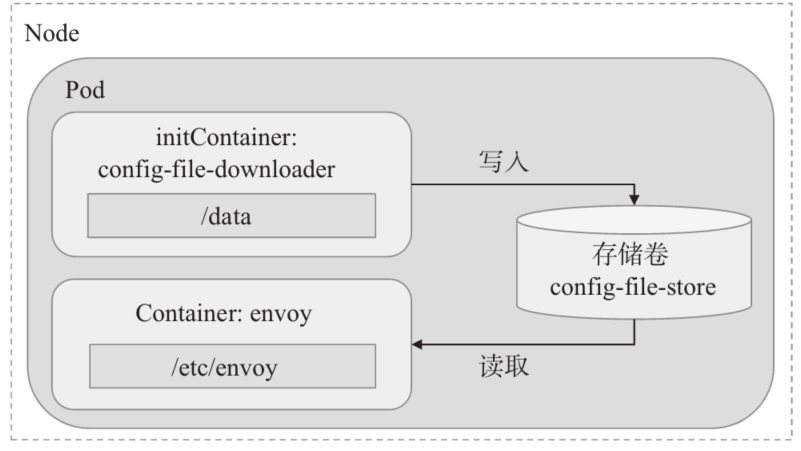
在该示例清单中 , 为Pod对象定义了一个名为config-file-store的、基于emptyDir存储插件的存储卷。初始化容器将该存储卷挂载 至/data目录后 , 下载envoy.yaml配置文件并保存于该挂载点目录下。 主容器将该存储卷挂载至/etc/envoy目录 , 再通过自定义命令让容器 应用在启动时加载的配置文件/etc/envoy/envoy.yaml上 , 如图所示。
Pod资源的详细信息中会显示存储卷的相关状态 , 包括其是否创建成功(Events字段中输出)、相关的类型及参数(Volumes字段中输出) , 以及容器中的挂载状态等信息(Containers字段中输出)。如下面的命令结果所示。
~$ kubectl describe pods volumes-emptydir-demo
....
Init Containers:
  config-file-downloader:
  ……
    Mounts:
      /data from config-file-store (rw)
  ……
Containers:
  envoy:
    Mounts:
      /etc/envoy from config-file-store (ro)
  ……
Volumes:
  config-file-store:
    Type:       EmptyDir (a temporary directory that shares a pod's lifetime)
    Medium:     Memory
    SizeLimit:  16Mi
……为Envoy下载的配置文件中定义了一个监听所有可用IP地址上TCP 80端口的Ingress侦听器 , 以及一个监听所有可用IP地址上TCP的9901 端口的Admin接口 , 这与Envoy镜像中默认配置文件中的定义均有不同。下面命令的结果显示它吻合自定义配置文件的内容。
~$ kubectl exec volumes-emptydir-demo -- netstat -tnl
Active Internet connections (only servers)
Proto Recv-Q Send-Q Local Address           Foreign Address        State
tcp        0      0 0.0.0.0:80              0.0.0.0:*              LISTEN
tcp        0      0 0.0.0.0:9901            0.0.0.0:*              LISTEN
~$ podIP=$(kubectl get pods/volumes-emptydir-demo -o jsonpath={.status.podIP})
~$ curl $podIP:9901/listeners
listener_0::0.0.0.0:80emptyDir卷简单易用 , 但仅能用于临时存储。另外存在一些类型的存储卷构建在emptyDir之上 , 并额外提供了它所没有功能 , 例如将于下一节介绍的gitRepo存储卷。
2.2 gitRepo存储卷
gitRepo存储卷可以看作是emptyDir存储卷的一种实际应用 , 使用该存储卷的Pod资源可以通过挂载目录访问指定的代码仓库中的数据。 使用gitRepo存储卷的Pod资源在创建时 , 会首先创建一个空目录 (emptyDir)并克隆(clone)一份指定的Git仓库中的数据至该目 录 , 而后再创建容器并挂载该存储卷。
定义gitRepo类型的存储卷时 , 其可嵌套使用字段有如下3个。
repository:Git仓库的URL, 必选字段。directory: 目标目录名称 , 但名称中不能包含".." 字符 ; "."表示将仓库中的数据直接克隆至存储卷映射的目录中 , 其他字符则表示将数据克隆至存储卷上以用户指定的字符串为名称的子 目录中。revision: 特定revision的提交哈希码。
注意 : 使用
gitRepo存储卷的Pod资源运行的工作节点上必须安装有Git程序 , 否则克隆仓库的操作将无法完成。
下面的配置清单示例(volumes-gitrepo-demo.yaml)中的Pod资源在创建时 , 会先创建一个空目录 , 将指定的Git仓库 https://github.com/iKubernetes/Kubernetes_Advanced_Practical_2rd.git中的数据克隆一份直接保存在此目录中 , 而后将此目录创建为 存储卷html , 再由容器nginx将此存储卷挂载到/usr/share/nginx/html目录上。
apiVersion: v1
kind: Pod
metadata:
  name: volumes-gitrepo-demo
spec:
  containers:
  - name: nginx
    image: nginx:alpine
    volumeMounts:
    - name: html
      mountPath: /usr/share/nginx/html
  volumes:
  - name: html
    gitRepo:
      repository:  https://github.com/iKubernetes/Kubernetes_Advanced_Practical_2rd.git
      directory: .
revision: "master"访问此Pod资源中的nginx服务 , 即可看到它来自Git仓库中的页面资源。不过 , gitRepo存储卷在其创建完成后不会再与指定的仓库执行同步操作 , 这意味着在Pod资源运行期间 , 如果仓库中的数据发生了变化 , gitRepo存储卷不会同步到这些内容。当然 , 此时可以为Pod资源创建一个Sidecar容器来执行此类的同步操作 , 尤其是数据来源于私有仓库时 , 通过Sidecar容器完成认证等必要步骤后再进行克隆操作就更为必要。
gitrRepo存储卷构建于emptyDir之上 , 其生命周期与Pod资源一 样 , 故使用中不应在此类存储卷中保存由容器生成的重要数据。另 外 , gitRepo存储插件即将废弃 , 建议在初始化容器或Sidecar容器中 运行git命令来完成相应的功能。
3. hostPath存储卷
hostPath存储卷插件是将工作节点上某文件系统的目录或文件关联到Pod上的一种存储卷类型 , 其数据具有同工作节点生命周期一样的持久性。hostPath存储卷使用的是工作节点本地的存储空间 , 所以仅适用于特定情况下的存储卷使用需求 , 例如将工作节点上的文件系统 关联为Pod的存储卷 , 从而让容器访问节点文件系统上的数据 , 或者排布分布式存储系统的存储设备等。hostPath存储卷在运行有管理任务的系统级Pod资源 , 以及Pod资源需要访问节点上的文件时尤为有用。
配置hostPath存储卷的嵌套字段有两个: 一个用于指定工作节点 上的目录路径的必选字段path ; 另一个用于指定节点之上存储类型的 type。hostPath支持使用的节点存储类型有如下几种。
DirectoryOrCreate: 指定的路径不存在时 , 自动将其创建为0755权限的空目录 , 属主和属组均为kubelet。Directory: 事先必须存在的目录路径。FileOrCreate: 指定的路径不存在时 , 自动将其创建为0644权限的空文件 , 属主和属组均为kubelet。File: 事先必须存在的文件路径。Socket: 事先必须存在的Socket文件路径。CharDevice: 事先必须存在的字符设备文件路径。BlockDevice: 事先必须存在的块设备文件路径。"": 空字符串 , 默认配置 , 在关联hostPath存储卷之前不进行任何检查。
这类Pod对象通常受控于DaemonSet类型的Pod控制器 , 它运行在集群中的每个工作节点上 , 负责收集工作节点上系统级的相关数据 , 因 此使用hostPath存储卷也理所应当。然而 , 基于同一个模板创建Pod对象仍可能会因节点上文件的不同而存在着不同的行为 , 而且在节点上创建的文件或目录默认仅root用户可写 , 若期望容器内的进程拥有写 权限 , 则需要将该容器运行于特权模式 , 不过这存在潜在的安全风 险。
下面是定义在配置清单volumes-hostpath-demo.yaml中的Pod对象 , 容器中的filebeat进程负责收集工作节点及容器相关的日志信息 并发往Redis服务器 , 它使用了3个hostPath类型的存储卷 , 第一个指向了宿主机的日志文件目录/var/logs , 后面两个则与宿主机上的 Docker运行时环境有关。
apiVersion: v1
kind: Pod
metadata:
  name: vol-hostpath-pod
spec:
  containers:
  - name: filebeat
    image: ikubernetes/filebeat:5.6.7-alpine
    env:
    - name: REDIS_HOST
      value: redis.ilinux.io:6379
    - name: LOG_LEVEL
      value: info
    volumeMounts:
    - name: varlog
      mountPath: /var/log
    - name: socket
      mountPath: /var/run/docker.sock
    - name: varlibdockercontainers
      mountPath: /var/lib/docker/containers
      readOnly: true
  terminationGracePeriodSeconds: 30
  volumes:
  - name: varlog
    hostPath:
      path: /var/log
  - name: varlibdockercontainers
    hostPath:
      path: /var/lib/docker/containers
  - name: socket
    hostPath:
path: /var/run/docker.sock上面配置清单中Pod对象的正确运行要依赖于REDIS_HOST和 LOG_LEVEL环境变量 , 它们分别用于定义日志缓冲队列服务和日志级别。如果有可用的Redis服务器 , 我们就可通过环境变量REDIS_HOST将其对应的主机名或IP地址传递给Pod对象 , 待Pod对象准备好之后即可通过Redis服务器查看到由该Pod发送的日志信息。测试时 , 我们仅需要给REDIS_HOST环境变量传递一个任意值(例如清单中的 redis.ilinux.io )便可直接创建Pod对象 , 只不过该Pod中容器的日志会报出无法解析指定主机名的错误 , 但这并不影响存储卷的配置和使用。
提示 :在
Filebeat的应用架构中 , 这些日志信息可能会由Logstash收集后发往集中式日志存储系统Elasticsearch, 并通过Kibana进行展 示。
对于由Deployment或StatefulSet等一类控制器管控的、使用了 hostPath存储卷的Pod对象来说 , 需要注意在基于资源可用状态的调度器调度Pod对象时 , 并不支持参考目标节点之上hostPath类型的存储 卷 , 在Pod对象被重新调度至其他节点时 , 容器进程此前创建的文件或目录则大多不会存在。一个常用的解决办法是通过在Pod对象上使用 nodeSelector或者nodeAffinity赋予该Pod对象指定要绑定到的具体节点来影响调度器的决策 , 但即便如此 , 管理员仍然不得不手动管理涉及的多个节点之上的目录 , 低效且易错。因此 , hostPath存储卷虽然能持久保存数据 , 但对于由调度器按需调度的应用来说并不适用。
4. 网络存储卷
如前所述 , Kubernetes内置了多种类型的网络存储卷插件 , 它们支持的存储服务包括传统的NAS或SAN设备(例如NFS、iscsi和FC 等)、分布式存储(例如GlusterFS、CephFS和RBD等) 、云存储(例如gcePersistentDisk、azureDisk、Cinder和awsElasticBlockStore 等 ) 以及构建在各类存储系统之上的抽象管理层(例如flocker、 portworxVolume和vSphereVolume等) 。这类服务通常都是独立运行的存储系统 , 因相应的存储卷可以支持超越节点生命周期的数据持久 性。
4.1 NFS存储卷
NFS即网络文件系统(Network File System) , 它是一种分布式文件系统协议 , 最初是由Sun Microsystems公司开发的类UNIX操作系 统之上的经典网络存储方案 , 其功能旨在允许客户端主机可以像访问 本地存储一样通过网络访问服务器端文件。作为一种由内核原生支持 的网络文件系统 , 具有Linux系统使用经验的读者多数都应该有NFS使 用经验。
Kubernetes的NFS存储卷用于关联某事先存在的NFS服务器上导出 的存储空间到Pod对象中以供容器使用 , 该类型的存储卷在Pod对象终止后仅是被卸载而非被删除。而且 , NFS是文件系统级共享服务 , 它支持同时存在的多路挂载请求 , 可由多个Pod对象同时关联使用。定义 NFS存储卷时支持嵌套使用以下几个字段。
server:NFS服务器的IP地址或主机名 , 必选字段。path:NFS服务器导出(共享)的文件系统路径 , 必选字段。readOnly: 是否以只读方式挂载 , 默认为false。
下面的配置清单示例中以Redis为例来说明NFS存储卷的功能与用法。Redis是一个著名的高性能键值存储系统 , 应用非常广泛。它基于内存存储运行 , 数据持久化存储的需求通过周期性地将数据同步到主机磁盘之上完成 , 因此将Redis抽象为Pod对象部署运行于Kubernetes 系统之上时 , 需要考虑节点级或网络级的持久化存储卷的支持 , 本示例就是以NFS存储卷为例 , 为Redis进程提供跨Pod对象生命周期的数据持久化功能。
apiVersion: v1
kind: Pod
metadata:
  name: volumes-nfs-demo
  labels:
    app: redis
spec:
  containers:
  - name: redis
    image: redis:alpine
    ports:
    - containerPort: 6379
      name: redisport
    securityContext:
      runAsUser: 999
    volumeMounts:
    - mountPath: /data
      name: redisdata
  volumes:
    - name: redisdata
      nfs:   # NFS存储卷插件
        server: nfs.ilinux.io
        path: /data/redis
readOnly: false上面的示例定义在名为volumes-nfs-demo.yaml资源清单文件中 , 容器镜像文件redis:alpine默认会以redis用户(UID是999)运行 redis-server进程 , 并将数据持久保存在容器文件系统上的/data目录 中 , 因而需要确保UID为999的用户有权限读写该目录。与此对应 , NFS 服务器上用于该Pod对象的存储卷的导出目录(本示例中为/data/redis目录)也需要确保让UID为999的用户拥有读写权限 , 因而需要在nfs.ilinux.io服务器上创建该用户 , 将该用户设置为/data/redis目录的属主 , 或通过facl设置该用户拥有读写权限
以Ubuntu Server18.04为例 , 在一个专用的主机 (nfs.ilinux.io)上以root用户设定所需的NFS服务器的步骤如下。
安装
NFS Server程序包 ,Ubuntu 18.04上的程序包名为nfs-kernel-server。~# apt -y install nfs-kernel-server设定基础环境 , 包括用户、数据目录及相应授权。
~# mkdir /data/redis
~# useradd -u 999 redis
~# chown redis /data/redis
编辑
/etc/exports配置文件 , 填入类似如下内容:/data/redis 172.29.0.0/16(rw,no_root_squash) 10.244.0.0/16(rw,no_root_squash)启动
NFS服务器 :~# systemctl start nfs-server在各工作节点安装
NFS服务客户端程序包 ,Ubuntu 18.04上的程序包名为nfs-common。~# apt install -y nfs-common
待上述步骤执行完成后 , 切换回Kubernetes集群可运行kubectl命令的主机之上 , 运行命令创建配置清单中的Pod对象 :
~$ kubectl apply -f volumes-nfs-demo.yaml
pod/volumes-nfs-demo created
资源创建完成后 , 可通过其命令客户端redis-cli创建测试数据 , 并手动触发其与存储系统同步 , 下面加粗部分的字体为要执行的Redis 命令。
~$ kubectl exec -it volumes-nfs-demo -- redis-cli
127.0.0.1:6379> set mykey "hello ilinux.io"
OK
127.0.0.1:6379> get mykey
"hello ilinux.io"
127.0.0.1:6379> BGSAVE
Background saving started
127.0.0.1:6379> exit
为了测试其数据持久化效果 , 下面先删除此前创建的Pod对象vol-nfs-pod , 而后待重建该Pod对象后检测数据是否依然能够访问。
~$ kubectl delete pods/volumes-nfs-demo
pod "volumes-nfs-demo" deleted
~$ kubectl apply -f volumes-nfs-demo.yaml
pod/volumes-nfs-demo created
待其重建完成后 , 通过再次创建的Pod资源的详细描述信息可以观察到它挂载使用NFS存储卷的相关状态 , 也可通过下面的命令来检查 redis-server中是否还保存有此前存储的数据。
~$ kubectl exec -it volumes-nfs-demo -- redis-cli
127.0.0.1:6379> get mykey
"hello ilinux.io"
127.0.0.1:6379>上面的命令结果显示出此前创建的键mykey及其数据在Pod对象删除并重建后依然存在 , 这表明删除Pod对象后 , 其关联的外部存储设备 及数据并不会被一同删除 , 因而才具有了跨Pod生命周期的数据持久性。若需要在删除Pod后清除具有持久存储功能的存储设备上的数据 , 则需要用户或管理员通过存储系统的管理接口手动进行。
4.2 RBD存储卷
Ceph是一个专注于分布式的、弹性可扩展的、高可靠的、性能优异的存储系统平台 , 同时支持提供块设备、文件系统和对象存储3种存储接口。它是个高度可配置的系统 , 并提供了一个命令行界面用于监 视和控制其存储集群。Kubernetes支持通过RBD卷插件和CephFS卷插件 , 基于Ceph存储系统为Pod提供存储卷。要配置Pod对象使用RBD存储卷 , 需要事先满足以下前提条件。
存在某可用的
Ceph RBD存储集群 , 否则需要创建一个。在
Ceph RBD集群中创建一个能满足Pod资源数据存储需要的存储映像。在
Kubernetes集群内的各节点上安装Ceph客户端程序包)ceph common)。
定义RBD类型的存储卷时需要指定要连接的目标服务器和认证信息等配置 , 它们依赖如下几个可用的嵌套字段。
monitors <[]string>:Ceph存储监视器 , 逗号分隔的字符串列表 ; 必选字段。image:rados image(映像)的名称 , 必选字段。pool:Ceph存储池名称 , 默认为rbd。user:Ceph用户名 , 默认为admin。keyring: 用户认证到Ceph集群时使用的keyring文件路径 , 默认为/etc/ceph/keyring。secretRef: 用户认证到Ceph集群时使用的保存有相应认证信息的Secret资源对象 , 该字段会覆盖由keyring字段提供的密钥信息。readOnly: 是否以只读方式访问。fsType: 要挂载的存储卷的文件系统类型 , 至少应该是节点操作 系统支持的文件系统 , 例如Ext4、xfs、NTFS等 , 默认为Ext4。 下面提供的RBD存储卷插件使用示例定义在volumes-rbd-demo.yaml配置清单文件中 , 它使用kube用户认证到Ceph集群中 , 并关联RDB存储池kube中的存储映像redis-img1为Pod对象volumes-rbd-demo的存储卷 , 由容器进程挂载至/data目录进行数据存取。
apiVersion: v1
kind: Pod
metadata:
  name: volumes-rbd-demo
spec:
  containers:
  - name: redis
    image: redis:alpine
    ports:
    - containerPort: 6379
      name: redisport
    volumeMounts:
    - mountPath: /data
      name: redis-rbd-vol
  volumes:
    - name: redis-rbd-vol
      rbd:
        monitors:
        - '172.29.200.1:6789'
        - '172.29.200.2:6789'
        - '172.29.200.3:6789'
        pool: kube
        image: redis-img1
        fsType: xfs
        readOnly: false
        user: kube
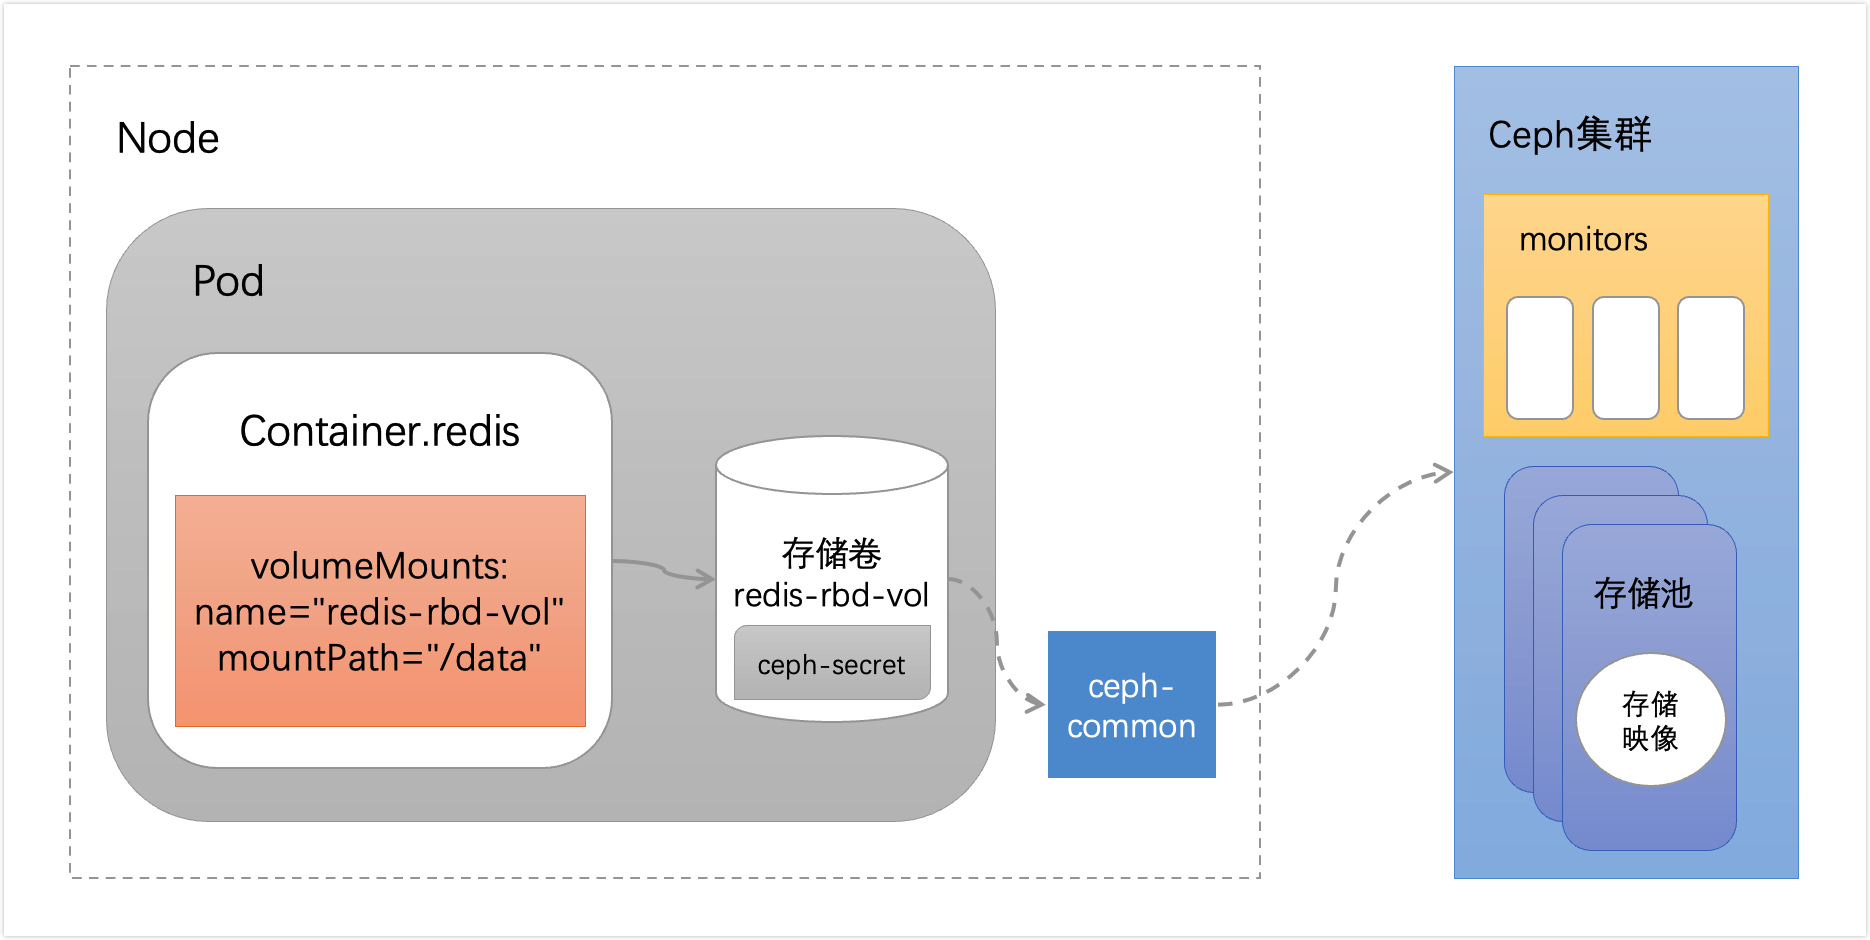
keyring: /etc/ceph/ceph.client.kube.keyring RBD存储卷插件依赖Ceph存储集群作为存储系统 , 这里假设其监视器(MON)的地址为172.29.200.1、172.29.200.2和172.29.200.3 , 集群上的存储池kube中需要有事先创建好的存储映像redis-img1。客户端访问集群时要事先认证到Ceph集群并获得相应授权才能进行后续的访问操作 , 该示例使用了用户的keyring文件。该示例实现的逻辑架构 如图所示。
4.3 CephFS存储卷
CephFS(Ceph文件系统)是在分布式对象存储RADOS之上构建的 POSIX兼容的文件系统 , 它致力于为各种应用程序提供多用途、高可用 和高性能的文件存储。CephFS将文件元数据和文件数据分别存储在各自专用的RADOS存储池中 , 其中MDS通过元数据子树分区等支持高吞吐量的工作负载 , 而数据则由客户端直接相关的存储池直接进行读写操作 , 其扩展能跟随底层RADOS存储的大小进行线性扩展。Kubernetes的 CephFS存储卷插件以CephFS为存储方案为Pod提供存储卷 , 因而可受益于CephFS的存储扩展和性能优势。
CephFS存储卷插件嵌套定义于Pod资源的spec.volumes.cephfs字段中 , 它支持通过如下字段的定义接入到存储预配服务中。
monitors <[]string>:Ceph存储监视器 , 为逗号分隔的字符串列表 ; 必选字段。user:Ceph集群用户名 , 默认为admin。secretFile: 用户认证到Ceph集群时使用的Base64格式的密钥文件(非keyring文件) , 默认为/etc/ceph/user.secret。secretRef: 用户认证到Ceph集群过程中加载其密钥时使用的Kubernetes Secret资源对象。path: 挂载的文件系统路径 , 默认为CephFS文件系统的根(/) , 可以使用CephFS文件系统上的子路径 , 例如/kube/namespaces/default/redis1等。readOnly: 是否挂载为只读模式 , 默认为false。
下面提供的CephFS存储卷插件使用示例定义在volumes-cephfs-demo.yaml配置清单文件中 , 它使用fsclient用户认证到Ceph集群中 , 并关联CephFS上的子路径/kube/namespaces/default/redis1 , 作为 Pod对象volumes-cephfs-demo的存储卷 , 并由容器进程挂载至/data目录进行数据存取。
apiVersion: v1
kind: Pod
metadata:
  name: volumes-cephfs-demo
spec:
  containers:
  - name: redis
    image: redis:alpine
    volumeMounts:
    - mountPath: "/data"
      name: redis-cephfs-vol
  volumes:
  - name: redis-cephfs-vol
    cephfs:
      monitors:
      - 172.29.200.1:6789
      - 172.29.200.2:6789
      - 172.29.200.3:6789
      path: /kube/namespaces/default/redis1
      user: fsclient
      secretFile: "/etc/ceph/fsclient.key"
readOnly: false Kubernetes集群上需要启用了CephFS , 并提供了满足条件的用户 账号及授权才能使用CephFS存储卷插件。客户端访问集群时需要事先认证到Ceph集群并获得相应授权才能进行后续的访问操作 , 该示例使用了保存在/etc/ceph/fsclient.key文件中的CephFS专用用户认证信息。要完成示例清单中定义的资源的测试 , 需要事先完成如下几个步 骤。
将授权访问
CephFS的用户fsclient的Secret文件fsclient.key复制到Kubernetes集群的各工作节点 , 以便kubelet可加载并使用它。 在生成fsclient.key的Ceph节点上执行如下命令以复制必要的文件。~# for kubehost in k8s-node01 k8s-node02 k8s-node03; do \ scp -p /etc/ceph/fsclient.key /etc/ceph/ceph.conf ${kubehost}:/etc/ceph/; done在
Kubernetes集群的各工作节点上执行如下命令 , 以安装Ceph客户端库。~# wget -q -O - https://mirrors.aliyun.com/ceph/keys/release.asc | apt-key add - ~# echo deb https://mirrors.aliyun.com/ceph/debian-nautilus/ $(lsb_release -sc) main \ | tee /etc/apt/sources.list.d/ceph.list ~# apt update && apt install ceph-common提示 : 若已经在
Kubernetes集群的各节点上安装过ceph-common, 则无 须重复执行该步骤。在
Kubernetes的某工作节点上手动挂载CephFS, 以创建由Pod 对象使用的数据目录。~# mount -t ceph ceph01:6789:/ /mnt -o name=fsclient,secretfile=/etc/ceph/fsclient.key ~# mkdir -p /mnt/kube/namespaces/default/redis1上述准备步骤执行完成后即可运行如下命令创建清单
volumes-cephfs-demo.yaml中定义的Pod资源 , 并进行测试:~$ kubectl apply -f volumes-cephfs-demo.yaml pod/volumes-cephfs-demo created随后通过
Pod对象volumes-cephfs-demo的详细描述了解其创建及运行状态 , 若一切无误 , 则相应的存储卷会显示出类似如下的描述信息:Volumes: redis-cephfs-vol: Type: CephFS (a CephFS mount on the host that shares a pod's lifetime) Monitors: [172.29.200.1:6789 172.29.200.2:6789 172.29.200.3:6789] Path: /kube/namespaces/default/redis1 User: fsclient SecretFile: /etc/ceph/fsclient.key SecretRef: nil ReadOnly: false
4.4 GlusterFS存储卷
GlusterFS(Gluster File System)是一个开源的分布式文件系统 , 是水平扩展存储解决方案Gluster的核心 , 它具有强大的横向扩展能力 , 通过扩展能够支持PB级的存储容量和数千个客户端。GlusterFS 借助TCP/IP或InfiniBand RDMA网络将物理分布的存储资源聚集在一起 , 使用单一全局命名空间来管理数据 , 它基于可堆叠的用户空间设计 , 可为各种不同的数据负载提供优异的性能 , 是另一种流行的分布 式存储解决方案。Kubernetes的GlusterFS存储卷插件依赖于 GlusterFS存储集群作为存储方案。要配置Pod资源使用GlusterFS存储卷 , 需要事先满足以下前提条件:
存在某可用的
GlusterFS存储集群 , 否则要创建一个。在
GlusterFS集群中创建一个能满足Pod资源数据存储需要的卷。在
Kubernetes集群内的各节点上安装GlusterFS客户端程序包 (glusterfs和glusterfs-fuse)。
GlusterFS存储卷嵌套定义在Pod资源的spec.volumes.glusterfs字段中 , 它常用的配置字段有如下几个。
endpoints:Endpoints资源的名称 , 此资源需要事先存在 , 用于提供Gluster集群的部分节点信息作为其访问入口 ; 必选字段。path: 用到的GlusterFS集群的卷路径 , 例如kube-redis; 必选字段。readOnly: 是否为只读卷。
下面提供的GlusterFS存储卷插件使用示例定义在volumes-glusterfs-demo.yaml配置清单文件中 , 它通过glusterfs-endpoints 资源中定义的GlusterFS集群节点信息接入集群 , 并以kube-redis卷作为Pod资源的存储卷。glusterfs-endpoints资源需要在Kubernetes 集群中事先创建 , 而kube-redis则需要先于Gluster集群创建。
apiVersion: v1
kind: Pod
metadata:
  name: volumes-glusterfs-demo
  labels:
    app: redis
spec:
  containers:
  - name: redis
    image: redis:alpine
    ports:
    - containerPort: 6379
      name: redisport
    volumeMounts:
    - mountPath: /data
      name: redisdata
  volumes:
    - name: redisdata
      glusterfs:
        endpoints: glusterfs-endpoints
        path: kube-redis
readOnly: false用于访问Gluster集群的相关节点信息要事先保存在某特定的 Endpoint资源中 , 例如上面示例中调用的glusterfs-endpoints。此类的Endpoint资源依赖用户根据实际需求手动创建 , 例如 , 下面保存在 glusterfs-endpoints.yaml文件中的资源示例定义了3个接入相关的 Gluster存储集群的节点 : gfs01.ilinux.io、gfs02.ilinux.io和 gfs03.ilinux.io , 其中的端口信息仅为满足Endpoint资源的必选字段要求 , 因此其值可以随意填写。
apiVersion: v1
kind: Endpoints
metadata:
  name: glusterfs-endpoints
subsets:
  - addresses:
    - ip: gfs01.ilinux.io
    ports:
    - port: 24007
      name: glusterd
  - addresses:
    - ip: gfs02.ilinux.io
    ports:
    - port: 24007
      name: glusterd
  - addresses:
    - ip: gfs03.ilinux.io
    ports:
    - port: 24007
      name: glusterd
准备好必要的存储供给条件后 , 先创建Endpoint资源glusterfs-endpoints , 之后创建Pod资源vol-glusterfs-pod , 即可测试其数据持久存储的效果。感兴趣的读者可自行完成测试过程 , 这里不再给出具 体的实现步骤。
5. 持久存储卷
通过4节网络存储卷及使用示例可知 , 用户必须要清晰了解用到的网络存储系统的访问细节才能完成存储卷相关的配置任务 , 例如RBD 存储卷插件配置中的监视器(monitor)、存储池(pool)、存储映像 (image)和密钥环(keyring)等来自于Ceph存储系统中的概念 , 这就要求用户对该类存储系统有着一定的了解才能够顺利使用。这与 Kubernetes向用户和开发隐藏底层架构的目标有所背离 , 最好对存储资源的使用也能像计算资源一样 , 用户和开发人员既无须了解Pod资源究竟运行在哪个节点 , 也不用了解存储系统是什么设备、位于何处以及如何访问。
PV(PersistentVolume)与PVC(PersistentVolumeClaim)就是在用户与存储服务之间添加的一个中间层 , 管理员事先根据PV支持的存储卷插件及适配的存储方案(目标存储系统)细节定义好可以支撑存储卷的底层存储空间 , 而后由用户通过PVC声明要使用的存储特性来绑定符合条件的最佳PV定义存储卷 , 从而实现存储系统的使用与管理职能的解耦 , 大大简化了用户使用存储的方式。
PV和PVC的生命周期由Controller Manager中专用的PV控制器(PV Controller)独立管理 , 这种机制的存储卷不再依附并受限于Pod对象的生命周期 , 从而实现了用户和集群管理员的职责相分离 , 也充分体现出Kubernetes把简单留给用户 , 把复杂留给自己的管理理念。
5.1 PV与PVC基础
PV是由集群管理员于全局级别配置的预挂载存储空间 , 它通过支持的存储卷插件及给定的配置参数关联至某个存储系统上可用数据存储的一段空间 , 这段存储空间可能是Ceph存储系统上的一个存储映像、一个文件系统(CephFS)或其子目录 , 也可能是NFS存储系统上的 一个导出目录等。PV将存储系统之上的存储空间抽象为Kubernetes系统全局级别的API资源 , 由集群管理员负责管理和维护。
将PV提供的存储空间用于Pod对象的存储卷时 , 用户需要事先使用 PVC在名称空间级别声明所需要的存储空间大小及访问模式并提交给 Kubernetes API Server , 接下来由PV控制器负责查找与之匹配的PV资源并完成绑定。随后 , 用户在Pod资源中使用persistentVolumeClaim 类型的存储卷插件指明要使用的PVC对象的名称即可使用其绑定到的PV 所指向的存储空间 , 如图所示。
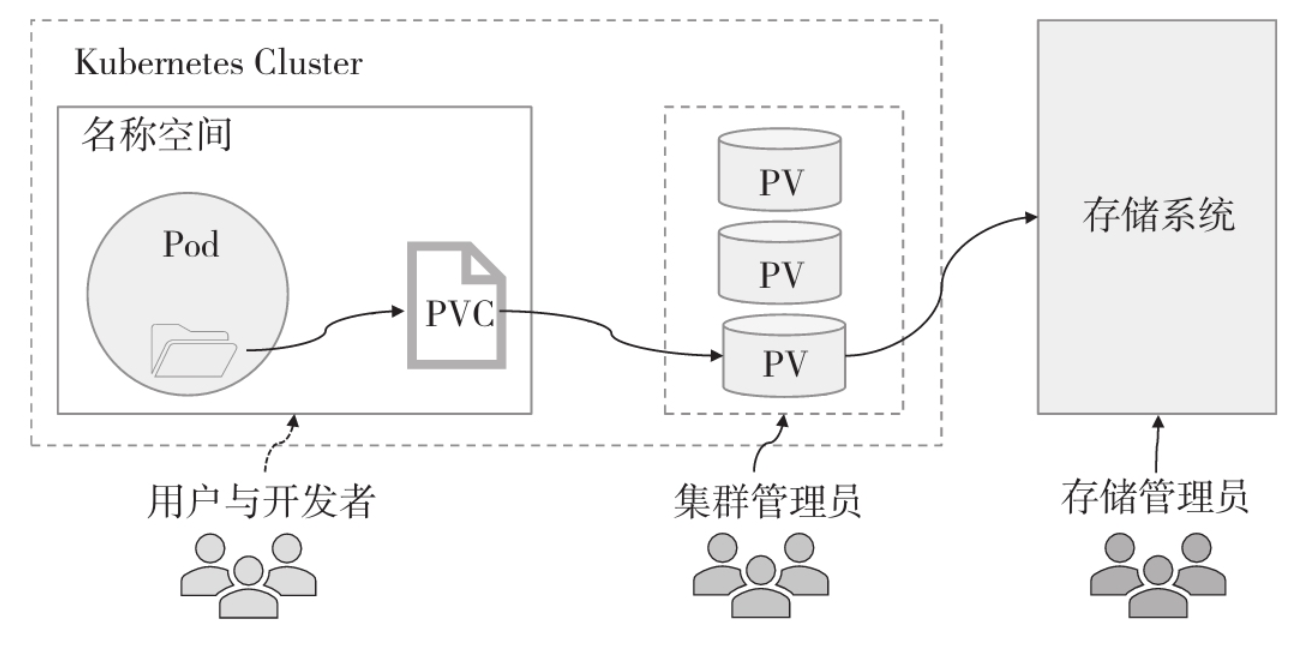
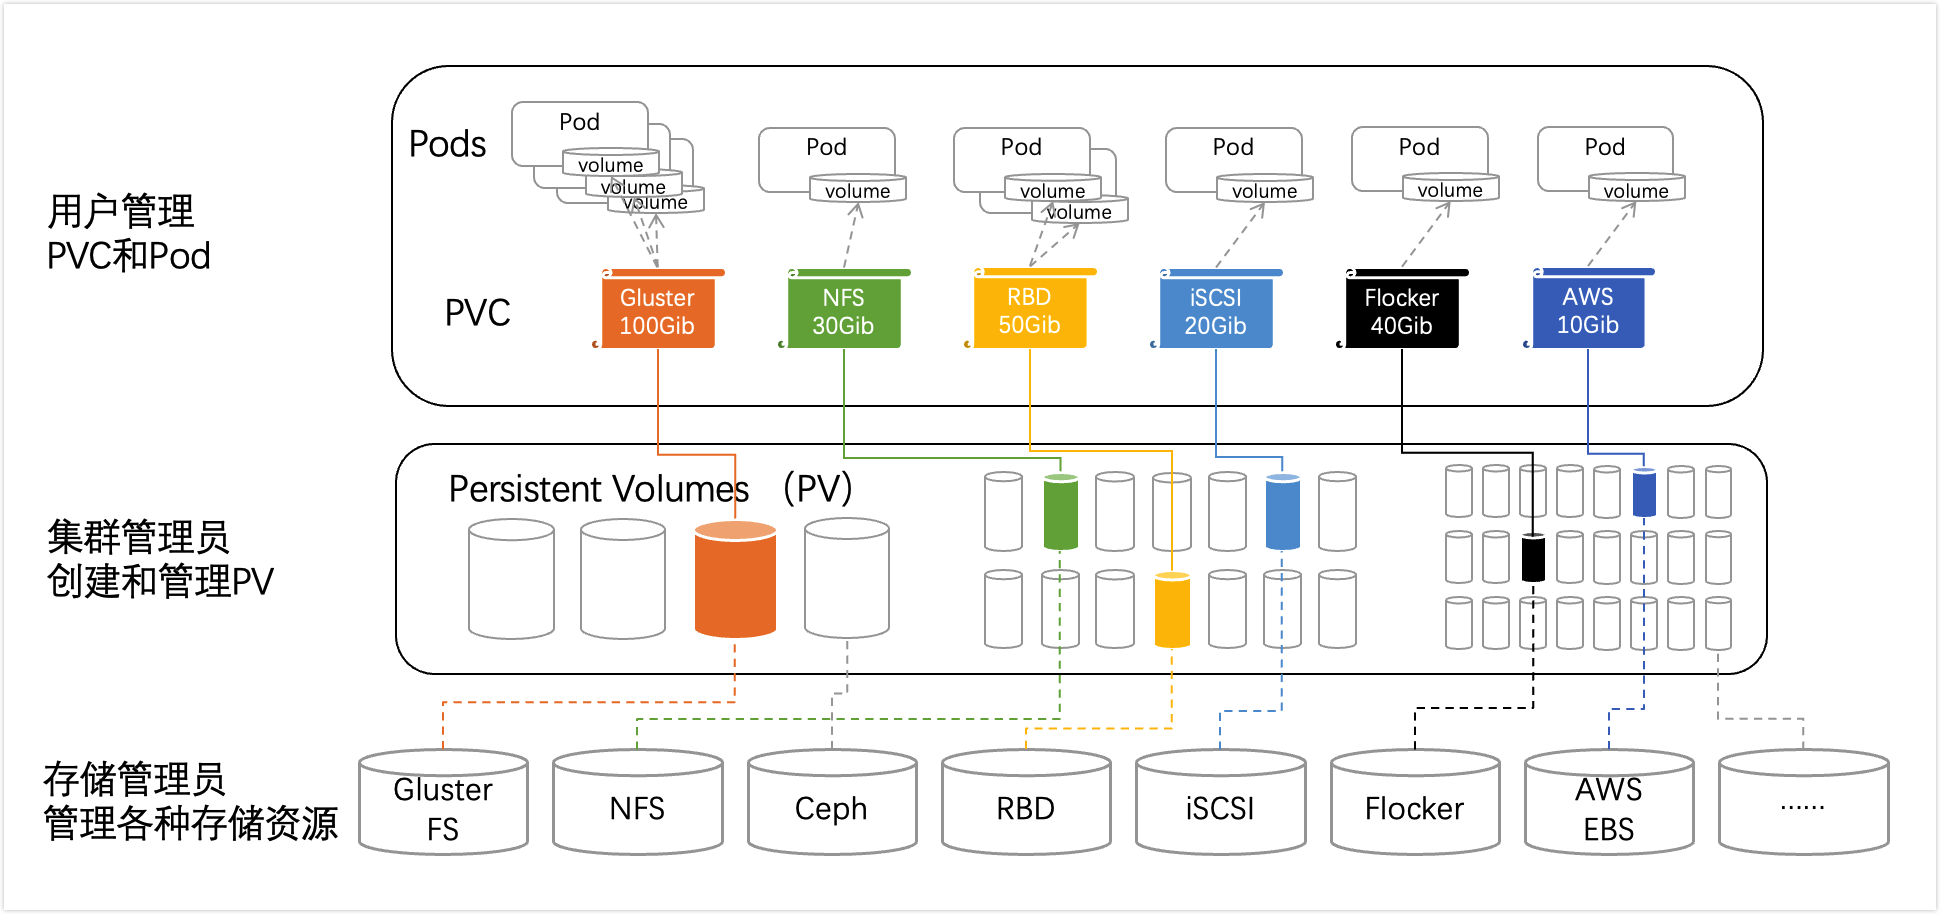
由此可见 , 尽管PVC及PV将存储资源管理与使用的职责分离至用户和集群管理员两类不同的人群之上 , 简化了用户对存储资源的使用机制 , 但也对二者之间的协同能力提出了要求。管理员需要精心预测和规划集群用户的存储使用需求 , 提前创建出多种规格的PV , 以便于在用户声明PVC后能够由PV控制器在集群中找寻到合适的甚至是最佳匹配的PV进行绑定。
不难揣测 , 这种通过管理员手动创建PV来满足PVC需求的静态预配 (static provisioning)存在着不少的问题。
第一 , 集群管理员难以预测出用户的真实需求 , 很容易导致某些类型的PVC无法匹配到PV而被挂起 , 直到管理员参与到问题的解决过程 中。
第二 , 那些能够匹配到PV的PVC也很有可能存在资源利用率不佳的状况 , 例如一个声明使用5G存储空间的PVC绑定到一个20GB的PV之上。
更好的解决方案是一种称为动态预配、按需创建PV的机制。集群管理员要做的仅是事先借助存储类(StorageClass)的API资源创建出 一到多个“PV模板” , 并在模板中定义好基于某个存储系统创建PV所依赖的存储组件(例如Ceph RBD存储映像或CephfFS文件系统等)时需要用到的配置参数。创建PVC时 , 用户需要为其指定要使用PV模板 (StorageClass资源) , 而后PV控制器会自动连接相应存储类上定义的目标存储系统的管理接口 , 请求创建匹配该PVC需求的存储组件 , 并将该存储组件创建为Kubernetes集群上可由该PVC绑定的PV资源。
需要说明的是 , 静态预配的PV可能属于某存储类 , 也可能没有存储类 , 这取决于管理员的设定。但动态PV预配依赖存储类的辅助 , PVC 必须向一个事先存在的存储类发起动态分配PV的请求 , 没有指定存储类的PVC不支持使用动态预配PV的方式。
PV( Persistent Volume)是持久化卷的意思 , 是对底层的共享存储的一种抽象 , 一般情况下PV由Kubernetes管理员进行创建和配置 , 它与底层具体的共享存储技术有关 , 并通过插件完成与其共享存储的对接PVC( Persistent Volume Claim)是持久化卷声明的意思 , 是用户对于存储需求的一种声明 , 换句话说 ,PVC其实就是用户向Kubernetes系统发出的一种资源需求申请
PV和PVC是一对一的关系: 一个PVC仅能绑定一个PV , 而一个PV在 某一时刻也仅可被一个PVC所绑定。为了能够让用户更精细地表达存储需求 , PV资源对象的定义支持存储容量、存储类、卷模型和访问模式等属性维度的约束。相应地 , PVC资源能够从访问模式、数据源、存储资源容量需求和限制、标签选择器、存储类名称、卷模型和卷名称等多个不同的维度向PV资源发起匹配请求并完成筛选。
5.2 PV的生命周期
从较为高级的实现上来讲 , Kubernetes系统与存储相关的组件主要有存储卷插件、存储卷管理器、PV/PVC控制器和AD控制器 (Attach/Detach Controller)这4种 , 如图所示。
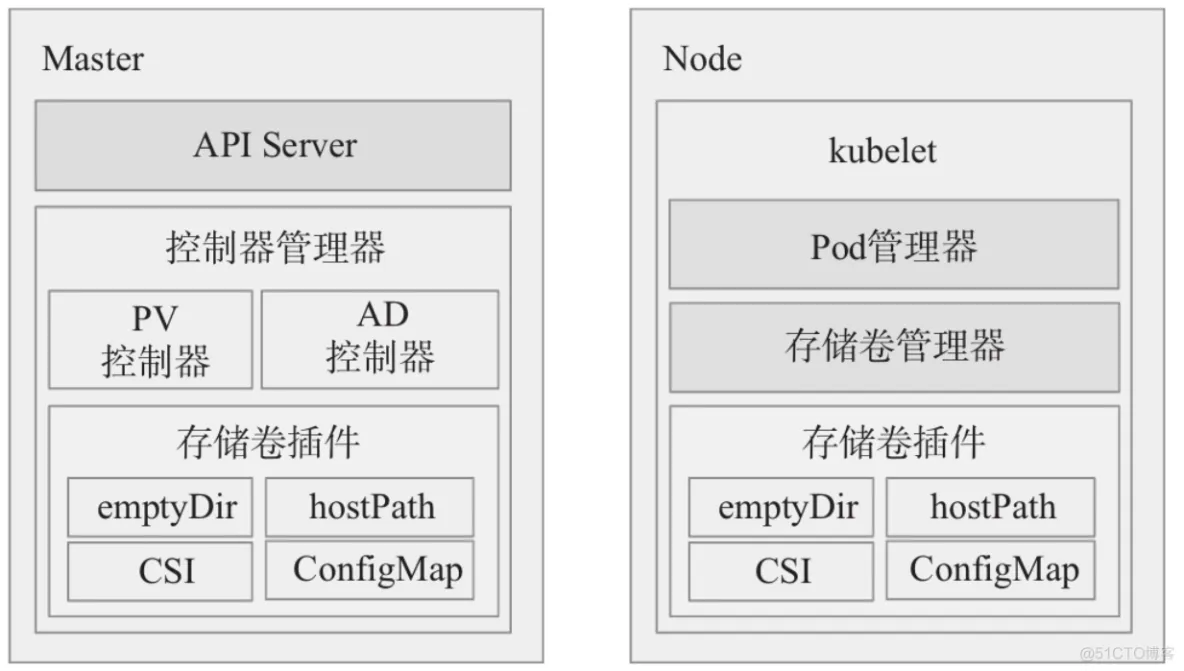
存储卷插件:
Kubernetes存储卷功能的基础设施 , 是存储任务相 关操作的执行方 ; 它是存储相关的扩展接口 , 用于对接各类存储设 备。存储卷管理器:
kubelet内置管理器组件之一 , 用于在当前节点 上执行存储设备的挂载(mount) 、卸载(unmount) 和格式化(format) 等操作 ; 另外 , 存储卷管理器也可执行节点级别设备的附加(attach) 及拆除(detach) 操作。PV控制器: 负责PV及PVC的绑定和生命周期管理 , 并根据需求进行存储卷的预配和删除操作 ;AD控制器: 专用于存储设备的附加和拆除操作的组件 , 能够将存储设备关联(attach) 至目标节点或从目标节点之上剥离 (detach) 。
这4个组件中 , 存储卷插件是其他3个组件的基础库 , 换句话说 , PV控制器、AD控制器和存储卷管理器均构建于存储卷插件之上 , 以提供不同维度管理功能的接口 , 具体的实现逻辑均由存储卷插件完成。
除了创建、删除PV对象 , 以及完成PV和PVC的状态迁移等生命周期管理之外 , PV控制器还要负责绑定PVC与PV对象 , 而且PVC只能在绑定到PV之后方可由Pod作为存储卷使用。创建后未能正确关联到存储设备的PV将处于Pending状态 , 直到成功关联后转为Available状态。而后一旦该PV被某个PVC请求并成功绑定 , 其状态也就顺应转为Bound , 直到相应的PVC删除后而自动解除绑定 , PV才会再次发生状态转换 , 此时 的状态为( Released) , 随后PV的去向将由其“回收策略”( reclaim policy) 所决定 , 具体如下。
Retain(保留) : 删除PVC后将保留其绑定的PV及存储的数据 , 但会把该PV置为Released状态 , 它不可再被其他PVC所绑定 , 且需要由管理员手动进行后续的回收操作: 首先删除PV, 接着手动清理其关联的外部存储组件上的数据 , 最后手动删除该存储组件或者基于该组件重新创建PV。Delete( 删除) : 对于支持该回收策略的卷插件 , 删除一个PVC将同时删除其绑定的PV资源以及该PV关联的外部存储组件 ; 动态的PV回收策略继承自StorageClass资源 , 默认为Delete。多数情况下 , 管理员都需要根据用户的期望修改此默认策略 , 以免导致数据非计划内的删除。Recycle( 回收) : 对于支持该回收策略的卷插件 , 删除PVC时 , 其绑定的PV所关联的外部存储组件上的数据会被清空 , 随后 , 该PV将转为Available状态 , 可再次接受其他PVC的绑定请求。不过 , 该策略已被废弃
相应地 , 创建后的PVC也将处于Pending状态 , 仅在遇到条件匹配、状态为Available的PV , 且PVC请求绑定成功才会转为Bound状态。 PV和PVC的状态迁移如图所示。总结起来 , PV和PVC的生命周期存在以几个关键阶段。
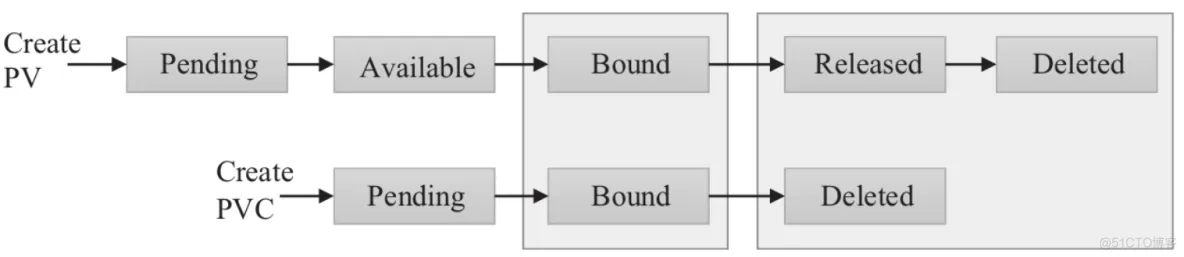
存储预配(
provision) : 存储预配是指为PVC准备PV的途径 ,Kubernetes支持静态和动态两种PV预配方式 , 前者是指由管理员以手动方式创建PV的操作 , 而后者则是由PVC基于StorageClass定义的模板 , 按需请求创建PV的机制。存储绑定 : 用户基于一系列存储需求和访问模式定义好
PVC后 ,PV控制器即会为其查找匹配的PV, 完成关联后它们二者同时转为已绑定状态 , 而且动态预配的PV与PVC之间存在强关联关系。无法找到可满足条件的PV的PVC将一直处于Pending状态 , 直到有符合条件的PV出现并完成绑定为止。存储使用:
Pod资源基于persistenVolumeClaim存储卷插件的定义 , 可将选定的PVC关联为存储卷并用于内部容器应用的数据存取。存储释放 : 用户删除
PVC来回收存储资源,PV将变成“released”状态。由于还保留着之前的数据,这些数据要根据不同的策略来处理,否则这些存储资源无法被其它PVC使用存储回收 : 存储卷的使用目标完成之后 , 删除
PVC对象可使得 此前绑定的PV资源进入Released状态 , 并由PV控制器根据PV回收策略对PV作出相应的处置。目前 , 可用的回收策略有Retaine、Delete和Recycle这3种。
如前所述 , 处于绑定状态的PVC删除后 , 相应的PV将转为Released 状态 , 之后的处理机制依赖于其回收策略。而处于绑定状态的PV将会导致相应的PVC转为Lost状态 , 而无法再由Pod正常使用 , 除非PVC再绑定至其他Available状态的PV之上 , 但应用是否能正常运行 , 则取决于对此前数据的依赖度。另一方面 , 为了避免使用中的存储卷被移除而导致数据丢失 , Kubernetes自1.9版引入了“PVC保护机制” , 其目的在于 , 用户删除了仍被某Pod对象使用中的PVC时 , Kubernetes不会立即移除该PVC , 而是会推迟到它不再被任何Pod对象使用后方才真正执行删除操作。处于保护阶段的PVC资源的status字段值为 Termination , 并且其Finalizers字段值中包含有kubernetes.io/pvc-protection。
5.3 静态PV资源
PersistentVolume是隶属于Kubernetes核心API群组中的标准资源类型 , 它的目标在于通过存储卷插件机制 , 将支持的外部存储系统上 的存储组件定义为可被PVC声明所绑定的资源对象。但PV资源隶属于Kubernetes集群级别 , 因而它只能由集群管理员进行创建。这种由管 理员手动定义和创建的PV被人们习惯地称为静态PV资源。
PV支持的存储卷插件类型是Pod对象支持的存储卷插件类型的一个子集 , 它仅涵盖Pod支持的网络存储卷类别中的所有存储插件以及 local卷插件。除了存储卷插件之外 , PersistentVolume资源规范Spec 字段主要支持嵌套以下几个通用字段 , 它们用于定义PV的容量、访问模式和回收策略等属性。
capacity: 指定PV的容量 ; 目前 ,Capacity仅支持存储容量设定 , 将来应该还可以指定IOPS和吞吐量 (throughput) 。accessModes <[]string>: 指定当前PV支持的访问模式 ; 存储系统支持的存取能力大体可分为ReadWriteOnce(单路读写) 、ReadOnlyMany(多路只读) 和ReadWrite-Many(多路读写)3种类型 , 某个特定的存储系统可能会支持其中的部分或全部的能力。persistentVolumeReclaimPolicy:PV空间被释放时的处理机制 ; 可用类型仅为Retain( 默认) 、Recycle或Delete。目前 , 仅NFS和hostPath支持Recycle策略 , 也仅有部分存储系统支持Delete策略volumeMode: 该PV的卷模型 , 用于指定此存储卷被格式化为文件系统使用还是直接使用裸格式的块设备 ; 默认值为Filesystem, 仅块设备接口的存储系统支持该功能。storageClassName: 当前PV所属的StorageClass资源的名称 , 指定的存储类需要事先存在 ; 默认为空值 , 即不属于任何存储类。mountOptions: 挂载选项组成的列表 , 例如ro、soft和hard等。nodeAffinity: 节点亲和性 , 用于限制能够访问该PV的节点 , 进而会影响与该PV关联的PVC的Pod的调度结果。
需要注意的是 , PV的访问模式用于反映它关联的存储系统所支持 的某个或全部存取能力 , 例如NFS存储系统支持以上3种存取能力 , 于是NFS PV可以仅支持ReadWriteOnce访问模式。需要注意的是 , PV在某个特定时刻仅可基于一种模式进行存取 , 哪怕它同时支持多种模式。
5.3.1. NFS PV示例
下面的配置示例来自于pv-nfs-demo.yaml资源清单 , 它定义了一 个使用NFS存储系统的PV资源 , 它将空间大小限制为5GB , 并支持多路 的读写操作。
apiVersion: v1
kind: PersistentVolume
metadata:
  name: pv-nfs-demo
spec:
  capacity:
    storage: 5Gi
  volumeMode: Filesystem
  accessModes:
    - ReadWriteMany
  persistentVolumeReclaimPolicy: Retain
  mountOptions:
    - hard
    - nfsvers=4.1
  nfs:
    path:  "/data/redis002"
server: nfs.ilinux.io在NFS服务器nfs.ilinux.io上导出/data/redis002目录后 , 便可使用如下命令创建该PV资源。
~$ kubectl apply -f pv-nfs-demo.yaml
persistentvolume/pv-nfs-demo created
若能够正确关联到指定的后端存储 , 该PV对象的状态将显示为 Available , 否则其状态为Pending , 直至能够正确完成存储资源关联或者被删除。我们同样可使用describe命令来获取PV资源的详细描述信息。
~$ kubectl describe pv/pv-nfs-demo
Name:            pv-nfs-demo

Status:          Available
……
Source:
    Type:      NFS (an NFS mount that lasts the lifetime of a
pod)
    Server:    nfs.ilinux.io
    Path:      /data/redis002
    ReadOnly:  false
Events: <none>描述信息中的Available表明该PV已经可以接受PVC的绑定请求 , 并在绑定完成后转变其状态至Bound。
5.3.2 RBD PV示例
下面是另一个PV资源的配置清单( pv-rbd-demo.yaml) , 它使用 了RBD存储后端 , 空间大小等同于指定的RBD存储映像的大小(这里为 2GB) , 并限定支持的访问模式为RWO , 回收策略为Retain。除此之 外 , 该PV资源还拥有一个名为usedof的资源标签 , 该标签可被PVC的标签选择器作为筛选PV资源的标准之一。
apiVersion: v1
kind: PersistentVolume
metadata:
  name: pv-rbd-demo
  labels:
    usedof: redisdata
spec:
  capacity:
    storage: 2Gi
  accessModes:
    - ReadWriteOnce
  rbd:
    monitors:
    - ceph01.ilinux.io
    - ceph02.ilinux.io
    - ceph03.ilinux.io
    pool: kube
    image: pv-test
    user: kube
    keyring: /etc/ceph/ceph.client.kube.keyring
    fsType: xfs
    readOnly: false
persistentVolumeReclaimPolicy: Retain将RBD卷插件内嵌字段相关属性值设定为Ceph存储系统的实际的环境 , 包括监视器地址、存储池、存储映像、用户名和认证信息 ( keyring或secretRef) 等。测试时 , 请事先部署好Ceph集群 , 参考 4.2节中设定专用用户账号和Kubernetes集群工作节点的方式 , 准备好基础环境 , 并在Ceph集群的管理节点运行如下命令创建用到的存储 映像:
~$ rbd create pv-test --size 2G --pool kube
~$ rbd feature disable -p kube pv-test object-map fast-diff deep
flatten
待所有准备工作就绪后 , 即可运行如下命令创建示例清单中定义 的PV资源pv-rbd-demo:
$ kubectl apply -f pv-rbd-demo.yaml
persistentvolume/pv-rbd-demo created我们同样可以使用describe命令了解pv-rbd-demo的详细描述 , 若 处于Pending状态则需要详细检查存储卷插件的定义是否能吻合存储系 统的真实环境。
5.4 PVC资源
PersistentVolumeClaim也是Kubernetes系统上标准的API资源类型之一 , 它位于核心API群组 , 属于名称空间级别。用户提交新建的 PVC资源最初处于Pending状态 , 由PV控制器找寻最佳匹配的PV并完成 二者绑定后 , 两者都将转入Bound状态 , 随后Pod对象便可基于 persistentVolumeClaim存储卷插件配置使用该PVC对应的持久存储卷。
定义PVC时 , 用户可通过访问模式( accessModes) 、数据源 ( dataSource) 、存储资源空间需求和限制( resources) 、存储类、 标签选择器、卷模型和卷名称等匹配标准来筛选集群上的PV资源 , 其中 , resources和accessModes是最重要的筛选标准。PVC的Spec字段的 可嵌套字段有如下几个。
accessModes <[]string>:PVC的访问模式 ; 它同样支持RWO、RWX和ROX这3种模式。dataSrouces: 用于从指定的数据源恢复该PVC卷 , 它目前支持的数据源包括一个现存的卷快照对象 (snapshot.storage.k8s.io/VolumeSnapshot) 、一个既有的PVC对象 (PersistentVolumeClaim) 或一个既有的用于数据转存的自定义资源对象(resource/object) 。resources: 声明使用的存储空间的最小值和最大值 ; 目前 ,PVC的资源限定仅支持空间大小一个维度。selector: 筛选PV时额外使用的标签选择器 (matchLabels) 或匹配条件表达式(matchExpressions) 。storageClassName: 该PVC资源隶属的存储类资源名称 ; 指定了存储类资源的PVC仅能在同一个存储类下筛选PV资源 , 否则就只能从所有不具有存储类的PV中进行筛选。volumeMode: 卷模型 , 用于指定此卷可被用作文件系统还是裸格式的块设备 ; 默认值为Filesystem。volumeName: 直接指定要绑定的PV资源的名称。
下面通过匹配前一节中创建的PV资源的两个具体示例来说明PVC资 源的配置方法 , 两个PV资源目前的状态如下所示 , 它仅截取了命令结果中的一部分。
~$kubectl get pv
NAME        CAPACITY  ACCESS MODES  RECLAIM POLICY       STATUS    CLAIM
pv-nfs-demo   5Gi        RWX            Retain           Available
pv-rbd-demo   2Gi        RWO            Retain           Available
5.4.1 NFS PVC示例
下面的配置清单( pvc-demo-0001.yaml) 定义了一个名为pvc-nfs-demo的PVC资源示例 , 它仅定义了期望的存储空间范围、访问模式 和卷模式以筛选集群上的PV资源。
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: pvc-demo-0001
  namespace: default
spec:
  accessModes: ["ReadWriteMany"]
  volumeMode: Filesystem
  resources:
    requests:
      storage: 3Gi
    limits:
      storage: 10Gi
显然 , 此前创建的两个PV资源中 , pv-nfs-demo能够完全满足该 PVC的筛选条件 , 因而创建示例清单中的资源后 , 它能够迅速绑定至PV 之上 , 如下面的创建和资源查看命令结果所示。
~$ kubectl apply -f pvc-demo-0001.yaml
persistentvolumeclaim/pvc-demo-0001 created
~$ kubectl get pvc pvc-nfs-0001
NAME   STATUS  VOLUME  CAPACITY  ACCESS MODES  STORAGECLASS  AGE
pvc-demo-0001 Bound pv-nfs-demo 5Gi RWX 3s被PVC资源pvc-demo-0001绑定的PV资源pv-nfs-demo的状态也将从 Available转为Bound , 如下面的命令结果所示。
~$ kubectl get pv/pv-nfs-demo -o jsonpath={.status.phase}
Bound集群上的PV资源数量很多时 , 用户可通过指定多维度的过滤条件来缩小PV资源的筛选范围 , 以获取到最佳匹配。
5.4.2 RBD PVC示例
下面这个定义在pvc-demo-0002.yaml中的配置清单定义了一个PVC 资源 , 除了期望的访问模式、卷模型和存储空间容量边界之外 , 它使用了标签选择器来匹配PV资源的标签。
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: pvc-demo-0002
  namespace: default
spec:
  accessModes: ["ReadWriteOnce"]
  volumeMode: Filesystem
  resources:
    requests:
      storage: 2Gi
    limits:
      storage: 5Gi
  selector:
    matchLabels:
usedof: "redisdata"配置清单中的资源PVC/pvc-demo-0002特地为绑定此前创建的资源 PV/pv-rbd-demo而创建 , 其筛选条件可由该PV完全满足 , 因而创建配置清单中的PVC/pvc-demo-0002资源后会即刻绑定于PV/pv-rbd-demo之上 , 如下面命令的结果所示。
~$ kubectl apply -f pvc-demo-0002.yaml
persistentvolumeclaim/pvc-demo-0002 created
~$ kubectl get pvc/pvc-demo-0002
NAME   STATUS  VOLUME  CAPACITY   ACCESS MODES  STORAGECLASS  AGE
pvc-demo-0002 Bound pv-rbd-demo 2Gi RWO 10s删除一个PVC将导致其绑定的PV资源转入Released状态 , 并由相应的回收策略完成资源回收。反过来 , 直接删除一个仍由某PVC绑定的PV 资源 , 会由PVC保护机制延迟该删除操作至相关的PVC资源被删除。
5.5 在Pod中使用PVC
需要特别说明的是 , PVC资源隶属名称空间级别 , 它仅可被同一名称空间中的Pod对象通过persistentVolumeClaim插件所引用并作为存储卷使用 , 该存储卷插件可嵌套使用如下两个字段。
claimName: 要调用的PVC存储卷的名称 ,PVC卷要与Pod在同一名称空间中。readOnly: 是否强制将存储卷挂载为只读模式 , 默认为false。
下面的配置清单( volumes-pvc-demo.yaml) 定义了一个Pod资源 , 该配置清单将5.2节中直接使用RBD存储的Pod资源改为了调用指定的PVC存储卷。
apiVersion: v1
kind: Pod
metadata:
  name: volumes-pvc-demo
  namespace: default
spec:
  containers:
  - name: redis
    image: redis:alpine
    imagePullPolicy: IfNotPresent
    ports:
    - containerPort: 6379
      name: redisport
    volumeMounts:
    - mountPath: /data
      name: redis-rbd-vol
  volumes:
  - name: redis-rbd-vol
    persistentVolumeClaim:
claimName: pvc-demo-0002示例清单中的Pod资源创建完成后 , 我们即可通过类似于此前 5.2节示例中的方式完成数据持久性测试 , 这里不再给出具体的测试 步骤。
5.6 存储类
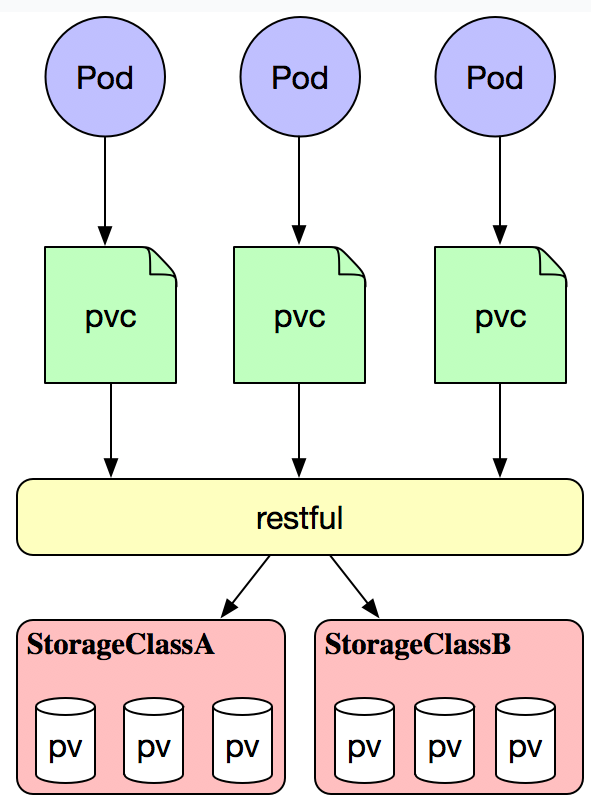
在pv和pvc使用过程中存在的问题, 在pvc申请存储空间时, 未必就有现成的pv符合pvc申请的需求, 上面nfs在做pvc可以成功的因素是因为我们做了指定的需求处理。那么当PVC申请的存储空间不一定有满足PVC要求的PV事, 又该如何处理呢???为此, Kubernetes为管理员提供了描述存储"class(类)"的方法(StorageClass)。举个例子, 在存储系统中划分一个1TB的存储空间提供给Kubernetes使用, 当用户需要一个10G的PVC时, 会立即通过restful发送请求, 从而让存储空间创建一个10G的image, 之后在我们的集群中定义成10G的PV供给给当前的PVC作为挂载使用。在此之前我们的存储系统必须支持restful接口, 比如ceph分布式存储, 而glusterfs则需要借助第三方接口完成这样的请求。如图:
[root@k8s-master ~]# kubectl explain storageclass  #storageclass也是k8s上的资源
KIND:     StorageClass
VERSION:  storage.k8s.io/v1
FIELDS:
   allowVolumeExpansion	<boolean>
   allowedTopologies	<[]Object>
   apiVersion	<string>
   kind	<string>
   metadata	<Object>
   mountOptions	<[]string>    #挂载选项
   parameters	<map[string]string>  #参数,取决于分配器,可以接受不同的参数。 例如,参数 type 的值 io1 和参数 iopsPerGB 特定于 EBS PV。当参数被省略时,会使用默认值。
   provisioner	<string> -required-  #存储分配器,用来决定使用哪个卷插件分配 PV。该字段必须指定。
   reclaimPolicy	<string>   #回收策略,可以是 Delete 或者 Retain。如果 StorageClass 对象被创建时没有指定 reclaimPolicy ,它将默认为 Delete。
volumeBindingMode <string> #卷的绑定模式StorageClass中包含 provisioner、parameters 和 reclaimPolicy 字段,当 class 需要动态分配 PersistentVolume 时会使用到。由于StorageClass需要一个独立的存储系统,此处就不再演示。从其他资料查看定义StorageClass的方式如下:
kind: StorageClass
apiVersion: storage.k8s.io/v1
metadata:
  name: standard
provisioner: kubernetes.io/aws-ebs
parameters:
  type: gp2
reclaimPolicy: Retain
mountOptions:
- debug存储类也是Kubernetes系统上的API资源类型之一 , 它位于 storage.k8s.io群组中。存储类通常由集群管理员为管理PV资源之便而按需创建的存储资源类别( 逻辑组) , 例如可将存储系统按照其性能高低或者综合服务质量级别分类( 见图) 、依照备份策略分类 , 甚至直接按管理员自定义的标准分类等。存储类也是PVC筛选PV时的过滤条件之一 , 这意味着PVC仅能在其隶属的存储类之下找寻匹配的PV资源。不过 , Kubernetes系统自身无法理解“类别”到底意味着什么 , 它仅仅把存储类中的信息当作PV资源的特性描述使用。
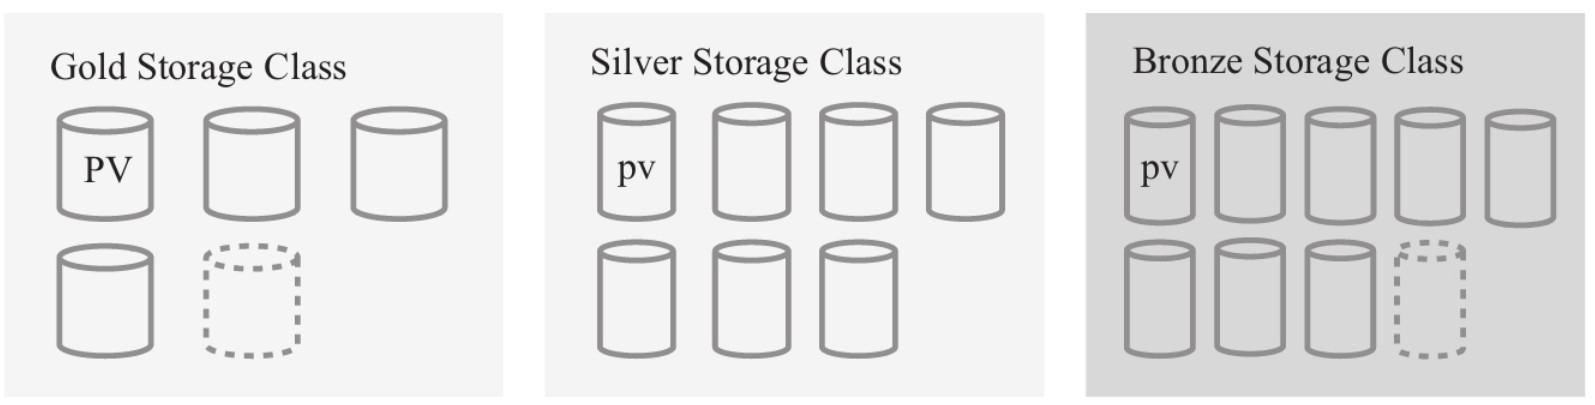
存储类的最重要功能之一便是对PV资源动态预配机制的支持 , 它可被视作动态PV资源的创建模板 , 能够让集群管理员从维护PVC和PV资源之间的耦合关系的束缚中解脱出来。需要用到具有持久化功能的存 储卷资源时 , 用户只需要向满足其存储特性要求的存储类声明一个PVC 资源 , 存储类将会根据该声明创建恰好匹配其需求的PV对象。
5.6.1 StorageClass资源
StorageClass资源的期望状态直接与apiVersion、kind和 metadata定义在同一级别而无须嵌套在spec字段中 , 它支持使用的字段包括如下几个。
allowVolumeExpansion: 是否支持存储卷空间扩展功能。allowedTopologies <[]Object>: 定义可以动态配置存储卷的节点拓扑 , 仅启用了卷调度功能的服务器才会用到该字段 ; 每个卷插件都有自己支持的拓扑规范 , 空的拓扑选择器表示无拓扑限制。provisioner: 必选字段 , 用于指定存储服务方 (provisioner, 或称为预配器) , 存储类要基于该字段值来判定要使用的存储插件 , 以便适配到目标存储系统 ;Kubernetes内置支持许多的provisioner, 它们的名字都以kubernetes.io/为前缀 , 例如kubernetes.io/glusterfs等。parameters: 定义连接至指定的provisioner类别下的某特定存储时需要使用的各相关参数 ; 不同provisioner的可用参数各不相同。reclaimPolicy: 由当前存储类动态创建的PV资源的默认回收策略 , 可用值为Delete( 默认) 和Retain两个 ; 但那些静态PV的回收策略则取决于它们自身的定义。volumeBindingMode: 定义如何为PVC完成预配和绑定 , 默认值为Volume-BindingImmediate; 该字段仅在启用了存储卷调度功能时才能生效。mountOptions <[]string>: 由当前类动态创建的PV资源的默认挂载选项列表。
下面是一个定义在storageclass-rbd-demo.yaml配置文件中的 StorageClass资源清单 , 它定义了一个以Ceph存储系统的RBD接口为后端存储的StorageClass资源fast-rbd , 因此 , 其存储预配标识为 kubernetes.io/rbd。
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fast-rbd
provisioner: kubernetes.io/rbd
parameters:
  monitors: ceph01.ilinux.io:6789,ceph02.ilinux.io:6789
  adminId: admin
  adminSecretName: ceph-admin-secret
  adminSecretNamespace: kube-system
  pool: kube
  userId: kube
  userSecretName: ceph-kube-secret
  userSecretNamespace: kube-system
  fsType: ext4
  imageFormat: "2"
  imageFeatures: "layering"
reclaimPolicy: Retain不同的provisioner的parameters字段中可嵌套使用的字段各有不同 , 上面示例中Ceph RBD存储服务可使用的各字段及意义如下。
monitors:Ceph存储系统的监视器访问接口 , 多个套接字间以逗号分隔。adminId: 有权限在指定的存储池中创建image的管理员用户名 , 默认为admin。adminSecretName: 存储有管理员账号认证密钥的 Secret资源名称。adminSecretNamespace: 管理员账号相关的Secret资源所在的名称空间。pool:Ceph存储系统的RBD存储池名称 , 默认为rbd。userId: 用于映射RBD镜像的Ceph用户账号 , 默认同adminId字段。userSecretName: 存储有用户账号认证密钥的Secret 资源名称。userSecretNamespace: 用户账号相关的Secret资源所在的名称空间。fsType: 存储映像格式化的文件系统类型 , 默认为ext4。imageFormat: 存储映像的格式 , 其可用值仅有“1” 和“2” , 默认值为“2”。imageFeatures: “2”格式的存储映像支持的特性 , 目前仅支持layering, 默认为空值 , 并且不支持任何功能。
提示 : 存储类接入其他存储系统时使用的参数请参考 https://kubernetes.io/docs/concepts/storage/storage_classes/。
与Pod或PV资源上的RBD卷插件配置格式不同的是 , StorageClass 上的RBD供给者参数不支持使用keyring直接认证到Ceph , 它仅能引用 Secret资源中存储的认证密钥完成认证操作。因而 , 我们需要先将 Ceph用户admin和kube的认证密钥分别创建为Secret资源对象。
在
Ceph管理节点上分别获取admin和kube的认证密钥 , 不同Ceph集群上的输出结果应该有所不同:~$ ceph auth get-key client.admin AQAl+Ite/2/cBBAA8yRfa6p1VwLKcywcEMS7YA== ~$ ceph auth get-key client.kube AQB9+4teoywxFxAAr2d63xPmV3Yl/E2ohfgOxA=.在
Kubernetes集群管理客户端上使用kubectl命令分别将二者创建为Secret资源 , 在具体测试操作中 , 需要将其中的密钥分别替换为前一步中的命令输出结果:~$ kubectl create secret generic ceph-admin-secret - type="kubernetes.io/rbd" \ --from-literal=key='AQAl+Ite/2/cBBAA8yRfa6p1VwLKcywcEMS7YA==' \ --namespace=kube-system ~$ kubectl create secret generic ceph-kube-secret - type="kubernetes.io/rbd" \ --from-literal=key='AQB9+4teoywxFxAAr2d63xPmV3Yl/E2ohfgOxA==' \ --namespace=kube-system
示例中使用的账号及存储池的管理方式请参考5.4节和5.5节给出 的步骤。待相关Secret资源准备完成后 , 将示例清单中的 StorageClass资源创建在集群上 , 即可由PVC或PV资源将其作为存储 类。
~$ kubectl apply -f storageclass-rbd-demo.yaml
storageclass.storage.k8s.io/fast-rbd created我们还可以使用kubectl get sc/NAME命令打印存储类的相关信 息 , 或者使用kubectl describe sc NAME命令获取详细描述来进一步 了解其状态。
5.6.2 PV动态预配
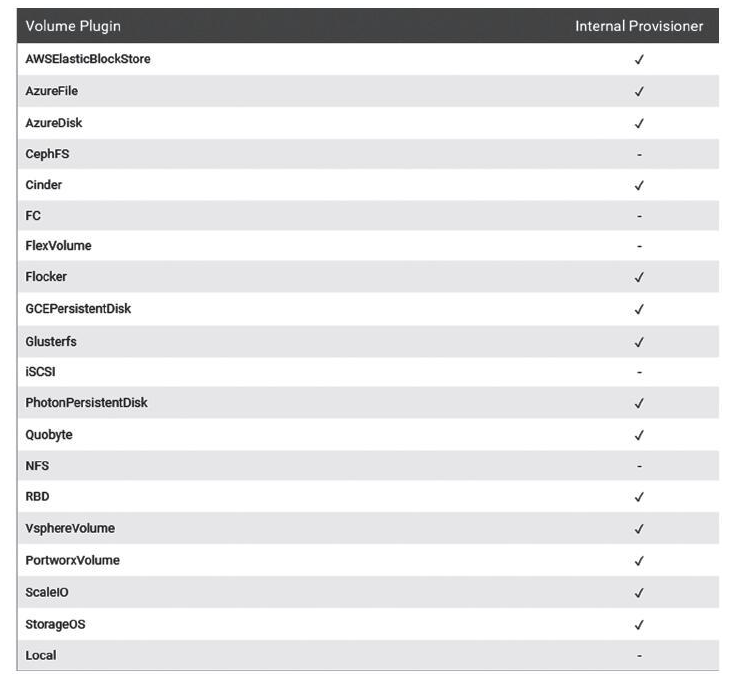
动态PV预配功能的使用有两个前提条件: 支持动态PV创建功能的卷插件 , 以及一个使用了对应于该存储卷插件的后端存储系统的 StorageClass资源。不过 , Kubernetes并非内置支持所有的存储卷插件的PV动态预配功能 , 具体信息如图所示。
RBD存储卷插件 , 结合5.4节中定义关联至Ceph RBD存储系统接口的存储类资源fast-rbd就能实现PV的动态预配功能 , 用户于该存储 类中创建PVC资源后 , 运行于kube-controller-manager守护进程中的 PV控制器会根据fast-rbd存储类的定义接入Ceph存储系统创建出相应的存储映像 , 并在自动创建一个关联至该存储映像的PV资源后 , 将其绑定至PVC资源
动态PV预配的过程中 , PVC控制器会调用相关存储系统的管理接口 API或专用的客户端工具来完成后端存储系统上的存储组件管理。以 Ceph RBD为例 , PV控制器会以存储类参数adminId中指定的用户身份调用rbd命令创建存储映像。然而 , 以kubeadm部署且运行为静态Pod资源的kube-controller-manager容器并未自行附带此类工具 , 如ceph common程序包。常见的解决方案有3种: 在Kubernetes系统上部署 kubernetes-incubator/external-storage中的rbd-provisioner , 从而以外置的方式提供相关工具程序 , 或基于CSI卷插件使用ceph-csi项目来支持更加丰富的卷功能 , 或定制kube-controller-manager的容器镜像 , 为其安装ceph-common程序包。本节将给出第三种方式的实现过程。
提示 若以二进制程序包部署
Kubernetes集群 , 则直接在Master节点安 装ceph-common就能解决问题。
首先 , 我们使用如下的Dockerfile文件 , 并基于现有kube controller-manager镜像文件为其额外安装ceph-common程序包 , 随后重新打包为容器镜像。
ARG KUBE_VERSION="v1.19.0"

FROM registry.aliyuncs.com/google_containers/kube-controller
manager:${KUBE_VERSION}

RUN apt update && apt install -y wget  gnupg lsb-release

ARG CEPH_VERSION="octopus"
RUN wget -q -O -
https://mirrors.aliyun.com/ceph/keys/release.asc | apt-key
add - && \
     echo deb
https://mirrors.aliyun.com/ceph/debian-${CEPH_VERSION}/ $(lsb_
     release -sc) main > /etc/apt/sources.list.d/ceph.list && \
     apt update && \
     apt install -y ceph-common ceph-fuse

RUN rm -rf /var/lib/apt/lists/* /var/cache/apt/archives/*
将上面的内容保存于某专用目录下( 例如kube-controller-manager) 的名为Dockerfile的文件中 , 而后使用如下命令将其打包为 镜像即可。其中 , 构建时参数KUBE_VERSION和CEPH_VERSION可分别修改为适用的版本。
~$ cd kube-controller-manager
~$ docker image build . --build-args KUBE_VERSION= "v1.19.0" \
    --build-args CEPH_VERSION=“octopus”\
    -t ikubernetes/kube-controller-manager:v1.19.0
而后 , 将该镜像分发至各Master节点 , 并分别修改它们的/etc/kubernetes/manifests/kube-controller-manager.yaml配置清单中的容器镜像为定制的镜像ikubernetes/kube-controller-manager:v1.19.0 , 待Controller Manager相关的Pod自动重启后即可进行动态PV的创建测试。下面是定义于pvc-dyn-rbd-demo.yaml配置清单中的PVC资源 , 它向存储类fast-rbd声明了需要的存储空间及访问模式。
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: pvc-dyn-rbd-demo
  namespace: default
spec:
  accessModes: ["ReadWriteOnce"]
  volumeMode: Filesystem
  resources:
    requests:
      storage: 3Gi
    limits:
      storage: 10Gi
storageClassName: fast-rbd将示例清单中的PVC资源创建至Kubernetes集群之上 , 便会触发PV 控制器在指定的存储类中自动创建匹配的PV资源。
~$ kubectl apply -f pvc-dyn-rbd-demo.yaml
persistentvolumeclaim/pvc-dyn-rbd-demo created下面的命令显示出该PVC资源已经绑定到了一个名为pvc-6c4b09cd-a74b-4b53-b106-7b16a98cf8ce的PV之上。
~$ kubectl get pvc/pvc-dyn-rbd-demo -o jsonpath={.spec.volumeName}
pvc-6c4b09cd-a74b-4b53-b106-7b16a98cf8ce如下命令输出的该PV的详细描述之中 , Annotations中的 kubernetes.io/createdby: rbd-dynamic-provisioner表示它是由 rbd-dynamic-provisioner动态创建 , 而Source段中的信息更能印证这种结论。
~$ kubectl describe pv pvc-6c4b09cd-a74b-4b53-b106-7b16a98cf8ce
Name:            pvc-6c4b09cd-a74b-4b53-b106-7b16a98cf8ce
Labels:          <none>
Annotations:     kubernetes.io/createdby: rbd-dynamic-provisioner
                 pv.kubernetes.io/bound-by-controller: yes
                 pv.kubernetes.io/provisioned-by:
kubernetes.io/rbd
Finalizers:      [kubernetes.io/pv-protection]
StorageClass:    fast-rbd
Status:          Bound
Claim:           default/pvc-sc-rbd-demo
Reclaim Policy:  Delete      # 回收策略
Access Modes:    RWO         # 访问模式
VolumeMode:      Filesystem  # 卷模式
Capacity:        3Gi         # 卷空间容量
Node Affinity:   <none>
Message:
Source:  # 数据源标识
    Type:          RBD (a Rados Block Device mount on the host
that shares a
    pod's lifetime)
    CephMonitors:  [ceph01.ilinux.io:6789 ceph02.ilinux.io:6789
ceph03.ilinux.
    io:6789]
    RBDImage:      kubernetes-dynamic-pvc-9a016d53-df1b-4118
9cf4-545ac058441e
    FSType:        ext4
    RBDPool:       kube
    RadosUser:     kube
    Keyring:       /etc/ceph/keyring
    SecretRef:     &SecretReference{Name:ceph-kube
secret,Namespace:kube-system,}
    ReadOnly:      false
Events:            <none>
上面命令结果中显示出 , 该PV的容量、访问模式和卷模式均符合 PVC所声明的要求 , 并且能够通过下面的命令验证相关的存储映像已经 存在于Ceph存储集群之上:
~$ rbd ls -p kube
kubernetes-dynamic-pvc-9a016d53-df1b-4118-9cf4-545ac058441e
另外 , 该PV继承自存储类fast-rbd中的回收策略为Delete , 这也 是存储类默认使用的回收策略 , 因此 , 删除其绑定的PVC对象也将删除该PV对象。对于多数持久存储场景而言 , 这可能是存在着一定风险的策略 , 建议定义存储类时手动修改该策略。感兴趣的读者可自行测试 这种级联删除的效果。
6. 容器存储接口CSI
存储卷管理器通过调用存储卷插件实现当前节点上存储卷相关的 附加、分离、挂载/卸载等操作 , 对于未被Kubernetes内置( In Tree) 的卷插件所支持的存储系统或服务来说 , 扩展定义新的卷插件 是解决问题的唯一途径。但将存储供应商提供的第三方存储代码打包 到Kubernetes的核心代码可能会导致可靠性及安全性方面的问题 , 因 而这就需要一种简单、便捷的、外置于Kubernetes代码树( Out-Of Tree)的扩展方式 , FlexVolume和CSI( 容器存储接口) 就是这样的存 储卷插件 , 换句话说 , 它们自身是内置的存储卷插件 , 但实现的却是第三方存储卷的扩展接口。
6.1 CSI基础
FlexVolume是Kubernetes自v1.8版本进入GA( 高可用) 阶段的一 种存储插件扩展方式 , 它要求将外部插件的二进制文件部署在预先配 置的路径中( 例如/usr/libexec/kubernetes/kubelet-plugins/volume/exec/) , 并设定系统环境满足其正常运行所需要的 全部依赖关系。事实上 , 一个FlexVolume类型的插件就是一款可被 kubelet驱动的可执行文件 , 它实现了特定存储的挂载、卸载等存储插件接口 , 而对该类插件的调用相当于请求运行该程序文件 , 并要求返回JSON格式的响应内容。
而自Kubernetes的v1.13版进入GA阶段的CSI是一种更加开放的存储卷插件接口标准 , 它独立于Kubernetes , 由CSI社区制定 , 可被 Mesos和CloudFoundry等编排系统共同支持 , 而且能够以容器化形式部 署 , 更加符合云原生的要义。除了允许第三方供应商外置实现存储插件之外 , CSI支持使用存储类、PV和PVC等组件 , 因而它们与内置的存储卷插件具有一脉相承的功能和特性。
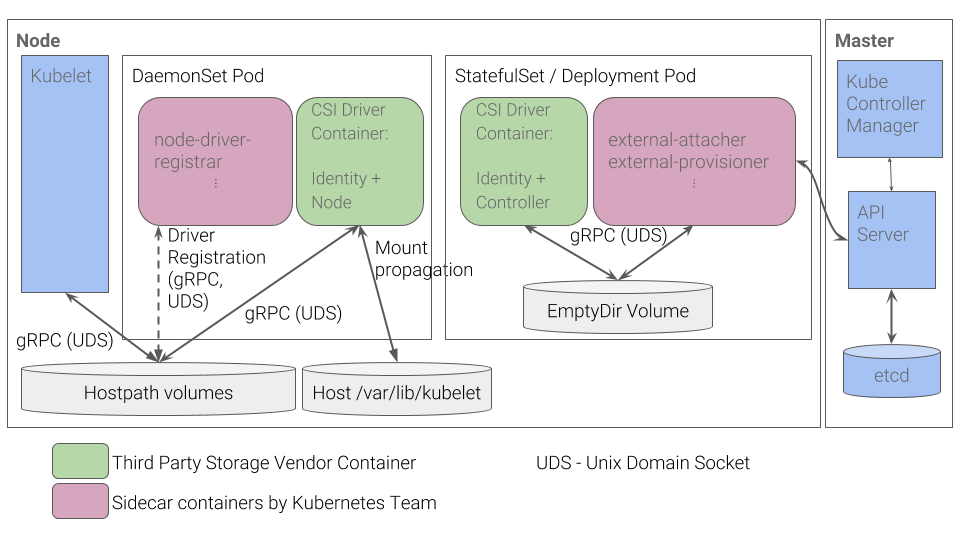
第三方需要提供的CSI组件主要是两个CSI存储卷驱动程序 , 一个是节点插件( Identity+Node) , 用于同kubelet交互实现存储卷的挂载和卸载等功能 , 另一个是自定义控制器( Identity+Controller) , 负责处理来自API Server的存储卷管理请求 , 例如创建和删除等 , 它的功能类似于控制器管理器中的PV控制器 , 如图中实线的圆角方框所示。
提示 : 关于
DaemonSet、Deployment、StatefulSet控制器资源 , 自定义资源类型CRD与自定义资源CR, 以及自定义控制器的概念将会在后续章节中展开说明。
kubelet对存储卷的挂载和卸载操作将通过UNIX Socket调用在同一主机上运行的外部CSI卷驱动程序完成。初始化外部CSI卷驱动程序时 , kubelet必须调用CSI方法NodeGetInfo才能将Kubernetes的节点名称映射为CSI的节点标识( NodeID) 。于是 , 为了降低部署外部容器化的CSI卷驱动程序时的复杂度 , Kubernetes团队提供了一个以Sidecar 容器运行的应用——Kubernetes CSI Helper , 以辅助自动完成UNIX Sock套接字注册及NodeID的初始化 , 如图中的node-driver-registrar容器所示。
不受Kubernetes信任的第三方卷驱动程序运行为独立的容器 , 它无法直接同控制器管理器通信 , 而是要借助于Kubernetes API Server 进行 ; 换句话说 , CSI存储卷驱动需要注册监视( watch) API Server 上的特定资源并针对存储卷管理器面向其存储卷的请求执行预配、删除、附加和分离等操作。同样为了降低外部容器化CSI卷驱动及控制器程序部署的复杂度 , Kubernetes团队提供了一到多个以Sidecar容器运行的代理应用Kubernetes to CSI来负责监视Kubernetes API , 并触发针对CSI卷驱动程序容器的相应操作 , 如图中的external-attacher和external-privisioner等 , 它们各自的简要功能如下所示。
external-privisioner:CSI存储卷的创建和删除。external-attacher:CSI存储卷的附加和分离。external-resizer:CSI存储卷的容量调整( 扩缩容) 。external-snapshotter:CSI存储卷的快照管理( 创建和删除等) 。
尽管Kubernetes并未指定CSI卷驱动程序的打包标准 , 但它提供了以下建议 , 以简化容器化CSI卷驱动程序的部署。
创建一个独立
CSI卷驱动容器镜像 , 由其实现存储卷插件的标准行为 , 并在运行时通过UNIX Socket公开其API。将控制器级别的各辅助容器(
external-privisioner和external-attacher等) 以Sidecar的形式同带有自定义控制器功能的CSI卷驱动程序容器运行在同一个Pod中 , 而后借助StatefulSet或Deployment控制器资源确保各辅助容器可正常运行相应数目的实例副本 , 将负责各容器间通信的UNIX Socket存储到共享的emptyDir存储卷 上。将节点上需要的辅助容器
node-driver-registrar以Sidecar的形式与运行CSI卷驱动程序的容器运行在同一Pod中 , 而后借助DaemonSet控制器资源确保辅助容器可在每个节点上运行一个实例。
下一节将以Longhorn存储系统为例简单说明CSI卷插件解决方案的 部署及简单使用方式。
6.2 Longhorn存储系统
Longhorn是由Rancher实验室创建的一款云原生的、轻量级、可靠且易用的开源分布式块存储系统 , 后来由CNCF孵化。它借助CSI存储卷插件以外置的存储解决方案形式运行。Longhorn遵循微服务的原则 , 利用容器将小型独立组件构建为分布式块存储 , 并使用编排工具来协调这些组件 , 从而形成弹性分布式系统。部署到Kubernetes集群上之后 , Longhorn会自动将集群中所有节点上可用的本地存储( 默认为/var/lib/longhorn/目录所在的设备) 聚集为存储集群 , 而后利用这些存储管理分布式、带有复制功能的块存储 , 且支持快照及数据备份操作。
面向现代云环境设计的存储系统的控制器随着待编排存储卷数量的急速增加也变得高度复杂。为了摆脱这种困境 , Longhorn充分利用了近年来关于如何编排大量容器的关键技术 , 采用微服务的设计模式 , 将大型复杂的存储控制器切分为每个存储卷一个专用的、小型存储控制器 , 而后借助现代编排工具来管理这些控制器 , 从而将每个CSI 卷构建为一个独立的微服务。如图所示的存储架构中 , 3个Pod分别使用了一个Longhorn存储卷 , 每个卷有一个专用的控制器 ( Engine) 资源和两个副本( Replica) 资源 , 它们都是为了便于描述 其应用而由Longhorn引入的自定义资源类型。
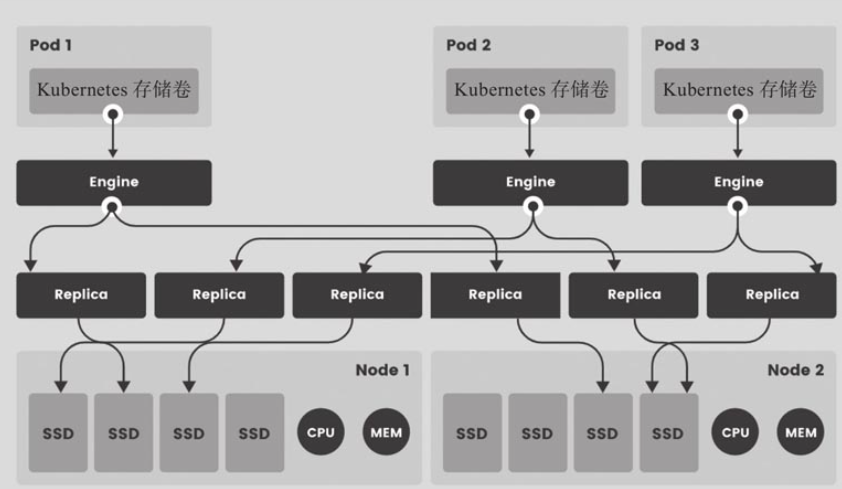
Engine容器仅负责单个存储卷的管理 , 其生命周期与存储卷相同 , 因而它并非真正的CSI插件级别的卷控制器或节点插件。Longhorn 上负责处理来自Kubernetes CSI卷插件的API调用 , 以及完成存储卷管理的组件是Longhorn Manager( node-driver-registrar) , 它是一个容器化应用且受DaemonSet控制器资源编排 , 在Kubernetes集群的每个节点上运行一个副本。Longhorn Manager持续监视Kubernetes API上 与Longhorn存储卷相关的资源变动 , 一旦发现新的资源创建 , 它负责在该卷附加的节点( 即Pod被Kubernetes调度器绑定的目标节点) 上创建一个Engine资源对象 , 并在副本相关的每个目标节点上相应创建一 个Replica资源对象。
Kubernetes集群内部通过CSI插件接口调用Longhorn插件以管理相关类型的存储卷 , 而Longhorn存储插件则基于Longhorn API与 Longhorn Manager 进行通信 , 卷管理之外的其他功能则要依赖 Longhorn UI完成 , 例如快照、备份、节点和磁盘的管理等。另外 , Longhorn的块设备存储卷的实现建立在iSCSI协议之上 , 因而需要调用 Longhorn存储卷的Pod所在节点必须部署了相关的程序包 , 例如open iscsi或iscsiadm等。
目前版本( v1.0.1) 的Longhorn要求运行于v.1.13或更高版本的 Docker环境下 , 以及v.1.4或更高版本的Kubernetes之上 , 并且要求各节点部署了open-iscsi、curl、findmnT、grep、awk、blkid和lsblk等程序包。基础环境准备完成后 , 我们使用类似如下的命令即能完成Longhorn应用的部署。
~$ kubectl apply -f \
https://raw.githubusercontent.com/longhorn/longhorn/master/deploy/longhorn.yaml该部署清单会在默认的longhorn-system名称空间下部署csi-attacher、csi-provisioner、csi-resizer、engine-image-ei、 longhorn-csi-plugin和longhorn-manager等应用相关的Pod对象 , 待 这些Pod对象成功转为Running状态之后即可测试使用Longhorn CSI插 件。
该部署清单还会默认创建如下面资源清单中定义的名为longhorn 的StorageClass资源 , 它以部署好的Longhorn为后端存储系统 , 支持存储卷动态预配机制。我们也能够以类似的方式定义基于该存储系统的、使用了不同配置的其他StorageClass资源 , 例如仅有一个副本以 用于测试场景或对数据可靠性要求并非特别高的应用等。
kind: StorageClass               # 资源类型
apiVersion: storage.k8s.io/v1    # API群组及版本
metadata:
  name: longhorn
provisioner: driver.longhorn.io  # 存储供给驱动
allowVolumeExpansion: true       # 是否支持存储卷弹性扩缩容
parameters:
  numberOfReplicas: "3"          # 副本数量
  staleReplicaTimeout: "2880"    # 过期副本超时时长
  fromBackup: ""
随后 , 我们随时可以按需创建基于该存储类的PVC资源来使用 Longhorn存储系统上的持久存储卷提供的存储空间。下面的示例资源 清单( pvc-dyn-longhorn-demo.yaml) 便定义了一个基于Longhorn存储类的PVC , 它请求使用2GB的空间。
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: pvc-dyn-longhorn-demo
  namespace: default
spec:
  accessModes: ["ReadWriteOnce"]
  volumeMode: Filesystem
  resources:
    requests:
      storage: 2Gi
  storageClassName: longhorn
如前所述 , Longhorn存储设备支持动态预配 , 于是以默认创建的存储类Longhorn为模板的PVC在无满足其请求条件的PV时 , 可由控制器自动创建出适配的PV卷来。下面两条命令及结果也反映了这种预配机制。
~$ kubectl apply -f pvc-dyn-longhorn-demo.yaml
persistentvolumeclaim/pvc-dyn-longhorn-demo created
~$ kubectl get pvc/pvc-dyn-longhorn-demo
NAME                    STATUS  VOLUME                                   CAPACITY…
pvc-dyn-longhorn-demo   Bound   pvc-c67415ae-560b-49c7-85153467f4160794   2Gi…
对于每个存储卷 , Longhorn存储系统都会使用自定义的Volumes类型资源对象维持及跟踪其运行状态 , 每个Volumes资源都会有一个 Engines资源对象作为其存储控制器 , 如下面的两个命令及结果所示。
~$ kubectl get volumes -n longhorn-system
NAME                                  AGE
pvc-c67415ae-560b-49c7-8515-3467f4160794   90s
~$ kubectl get engines -n longhorn-system
NAME                                            AGE
pvc-c67415ae-560b-49c7-8515-3467f4160794-e-eb822204 2m10sEngines资源对象的详细描述或资源规范中的spec和status字段记 录有当前资源的详细信息 , 包括关联的副本、purge状态、恢复状态和快照信息等 , 为了节约篇幅 , 下面的命令仅给出了部分运行结果。
~$ kubectl describe engines pvc-c67415ae-560b-49c7-8515
3467f4160794-e-eb822204 \
          -n longhorn-system
……
Spec:
  Backup Volume:
  Desire State:      stopped
  Disable Frontend:  false
  Engine Image:      longhornio/longhorn-engine:v1.0.1
  Frontend:          blockdev
  Log Requested:     false
  Node ID:               # 绑定的节点 , 它必须与调用了该存储卷的Pod运行于同一节点
  Replica Address Map:   # 关联的存储卷副本
    pvc-c67415ae-560b-49c7-8515-3467f4160794-r-4e2755e3:
10.244.3.58:10000
    pvc-c67415ae-560b-49c7-8515-3467f4160794-r-ba483050:
10.244.2.53:10000
    pvc-c67415ae-560b-49c7-8515-3467f4160794-r-daccc0db:
10.244.1.61:10000
  Volume Name:  pvc-c67415ae-560b-49c7-8515-3467f4160794
Volume Size: 2147483648 Replicas也是Longhorn提供的一个独立资源类型 , 每个资源对象对应着一个存储卷副本 , 如下面的命令结果所示。
~$ kubectl get replicas -n longhorn-system
NAME                                         AGE
pvc-c67415ae-560b-49c7-8515-3467f4160794-r-4e2755e3   2m36s
pvc-c67415ae-560b-49c7-8515-3467f4160794-r-ba483050   2m36s
pvc-c67415ae-560b-49c7-8515-3467f4160794-r-daccc0db 2m36s基于Longhorn存储卷的PVC被Pod引用后 , Pod所在的节点便是该存储卷Engine对象运行所在的节点 , Engine的状态也才会由Stopped转为 Running。示例清单volumes-pvc-longhorn-demo.yaml定义了一个调用 pvc/pvc-dyn-longhorn-demo资源的Pod资源 , 因而该Pod所在的节点便是该PVC后端PV相关的Engine绑定的节点 , 如下面3个命令及其结果所 示。
~$ kubectl apply -f volumes-pvc-longhorn-demo.yaml
pod/volumes-pvc-longhorn-demo created
~$ kubectl get pods/volumes-pvc-longhorn-demo -o jsonpath='{.spec.nodeName}'
k8s-node03.ilinux.io
~$ kubectl get engines/pvc-c67415ae-560b-49c7-8515-3467f4160794e-eb822204 \
    -n longhorn-system -o jsonpath='{.spec.nodeID}'
k8s-node03.ilinux.io由以上Longhorn存储系统的部署及测试结果可知 , 该存储系统不依赖于任何外部存储设备 , 仅基于Kubernetes集群工作节点本地的存 储即能正常提供存储卷服务 , 且支持动态预配等功能。但应用于生产环境时 , 还是有许多步骤需要优化 , 例如将数据存储与操作系统等分 离到不同的磁盘设备 , 是否可以考虑关闭底层的RAID设备等 , 具体请 参考Longhorn文档中的最佳实践。
为了便于通过Kubernetes集群外部的浏览器访问该用户接口 , 我 们需要把相关的Service对象的类型修改为NodePort。
~$ kubectl patch svc/longhorn-frontend -p '{"spec":
 {"type":"NodePort"}}' -n longhorn-system
service/longhorn-frontend patched
~$ kubectl get svc/longhorn-frontend -n longhorn-system -o
jsonpath='{.spec.ports[0].nodePort}'
30180
随后 , 我们经由任意一个节点的IP地址节点端口( 例如上面命令 中自动分配而来的30180) 即可访问该UI 。节点、存储卷、备份和系统设置导航标签各自给出了相关功能的配置入口 , 感兴趣的读者可自行探索其使用细节。
需要注意的是 , 考虑到该UI并没有内嵌用户认证机制 , 如此将其 发布到集群外部可能会带来安全风险 。另外 , 从以上基于Longhorn存储系统的CSI插件存储卷的使用方式来看 , 它与Kubernetes内置支持的PV存储卷在使用上并无本质区别。