
3-7-service和服务发现
运行于Pod中的容器化应用绝大多数是服务类的守护进程 , 例如 envoy和demoapp等 , 它们受控于控制器资源对象 , 在自愿或非自愿中 断后只能由重构的、具有同样功能的新Pod对象所取代 , 属非可再生类组件。在Kubernetes应用编排的动态、弹性管理模型下 , Service资源用于为此类Pod对象提供一个固定、统一的访问接口及负载均衡能力 , 并支持新一代DNS系统的服务发现功能, 解决了客户端发现并访问容器化应用的难题。
然而 , Service对象的IP地址都仅在Kubernetes集群内可达 , 它们无法接入集群外部的访问流量。在解决此类问题时 , 除了可以在单一 节点上做端口(hostPort)暴露及让Pod资源共享使用工作节点的网络名称空间(hostNetwork)之外 , 更推荐用户使用NodePort或 LoadBalancer类型的Service资源 , 或者是有七层负载均衡能力的 Ingress资源。
1. Service资源及其实现模型
Service是Kubernetes的核心资源类型之一 , 通常被看作微服务的 一种实现。它事实上是一种抽象: 通过规则定义出由多个Pod对象组合而成的逻辑集合 , 以及访问这组Pod的策略。Service关联Pod资源的规则要借助标签选择器完成。
1.1 Service资源概述
作为一款容器编排系统 , 托管在Kubernetes之上、以Pod形式运行的应用进程的生命周期通常受控于Deployment或StatefulSet一类的控制器 , 由于节点故障或驱离等原因导致Pod对象中断后 , 会由控制器自动创建的新对象所取代 , 而扩缩容或更新操作更是会带来Pod对象的群体变动。因为编排系统需要确保服务在编排操作导致的应用Pod动态变动的过程中始终可访问 , 所以Kubernetes提出了满足这一关键需求的解决方案 , 即核心资源类型——Service。
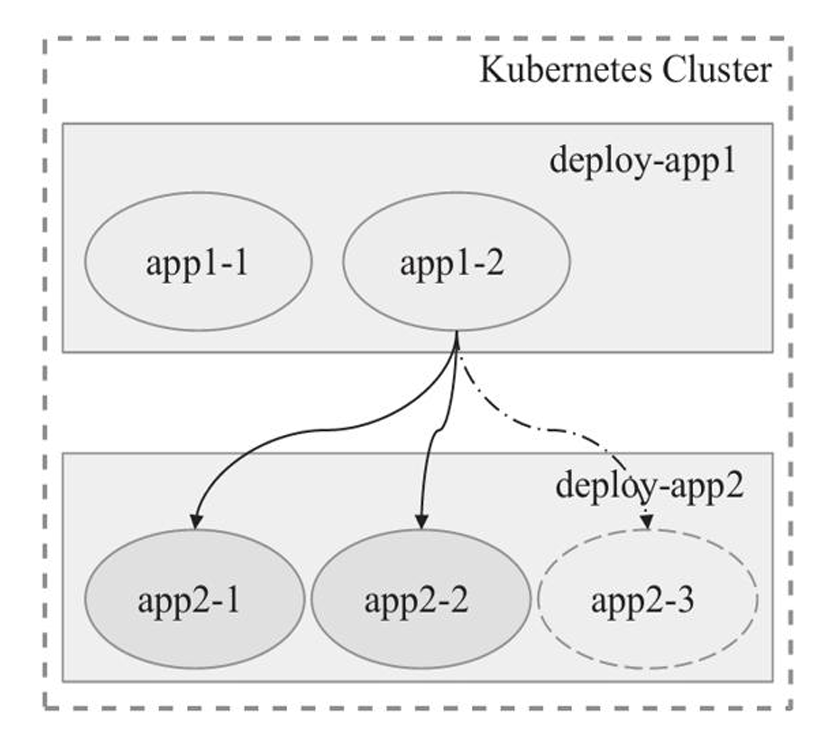
例如图中app1的Pod作为客户端访问app2相关的Pod应用时 , IP 的变动或应用规模的缩减会导致客户端访问错误 , 而Pod规模的扩容又会使客户端无法有效使用新增的Pod对象 , 影响达成规模扩展的目的。
Service资源基于标签选择器把筛选出的一组Pod对象定义成一个逻辑组合 , 并通过自己的IP地址和端口将请求分发给该组内的Pod对 象 , 如图所示。Service向客户端隐藏了真实的处理用户请求的Pod 资源 , 使得客户端的请求看上去是由Service直接处理并进行响应。
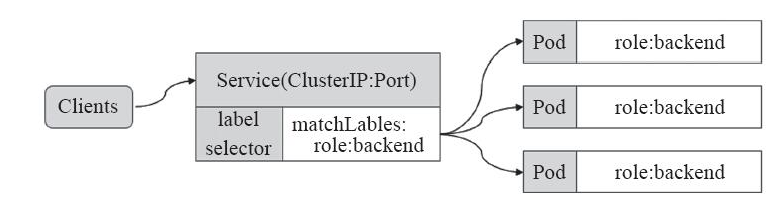
Service对象的IP地址(可称为ClusterIP或ServiceIP)是虚拟IP 地址 , 由Kubernetes系统在Service对象创建时在专用网络(Service Network) 地址中自动分配或由用户手动指定 , 并且在Service对象的生命周期中保持不变。Service基于端口过滤到达其IP地址的客户端请求 , 并根据定义将请求转发至其后端的Pod对象的相应端口之上 , 因此这种代理机制也称为“端口代理”或四层代理 , 工作于TCP/IP协议栈 的传输层。
Service对象会通过API Server持续监视(watch)标签选择器匹配到的后端Pod对象 , 并实时跟踪这些Pod对象的变动情况 , 例如IP地址变动以及Pod对象的增加或删除等。不过 , Service并不直接连接至 Pod对象 , 它们之间还有一个中间层——Endpoints资源对象 , 该资源对象是一个由IP地址和端口组成的列表 , 这些IP地址和端口则来自由 Service的标签选择器匹配到的Pod对象。这也是很多场景中会使用 “Service的后端端点”这一术语的原因。默认情况下 , 创建Service 资源对象时 , 其关联的Endpoints对象会被自动创建。
1.2 kube-proxy代理模型
本质上来讲 , 一个Service对象对应于工作节点内核之中的一组 iptables或/和ipvs规则 , 这些规则能够将到达Service对象的 ClusterIP的流量调度转发至相应Endpoint对象指向的IP地址和端口之上。内核中的iptables或ipvs规则的作用域仅为其所在工作节点的一个主机 , 因而生效于集群范围内的Service对象就需要在每个工作节点上都生成相关规则 , 从而确保任一节点上发往该Service对象请求的流量都能被正确转发。
每个工作节点的kube-proxy组件通过API Server持续监控着各 Service及其关联的Pod对象 , 并将Service对象的创建或变动实时反映至当前工作节点上相应的iptables或ipvs规则上。客户端、Service及 Pod对象的关系如图所示。
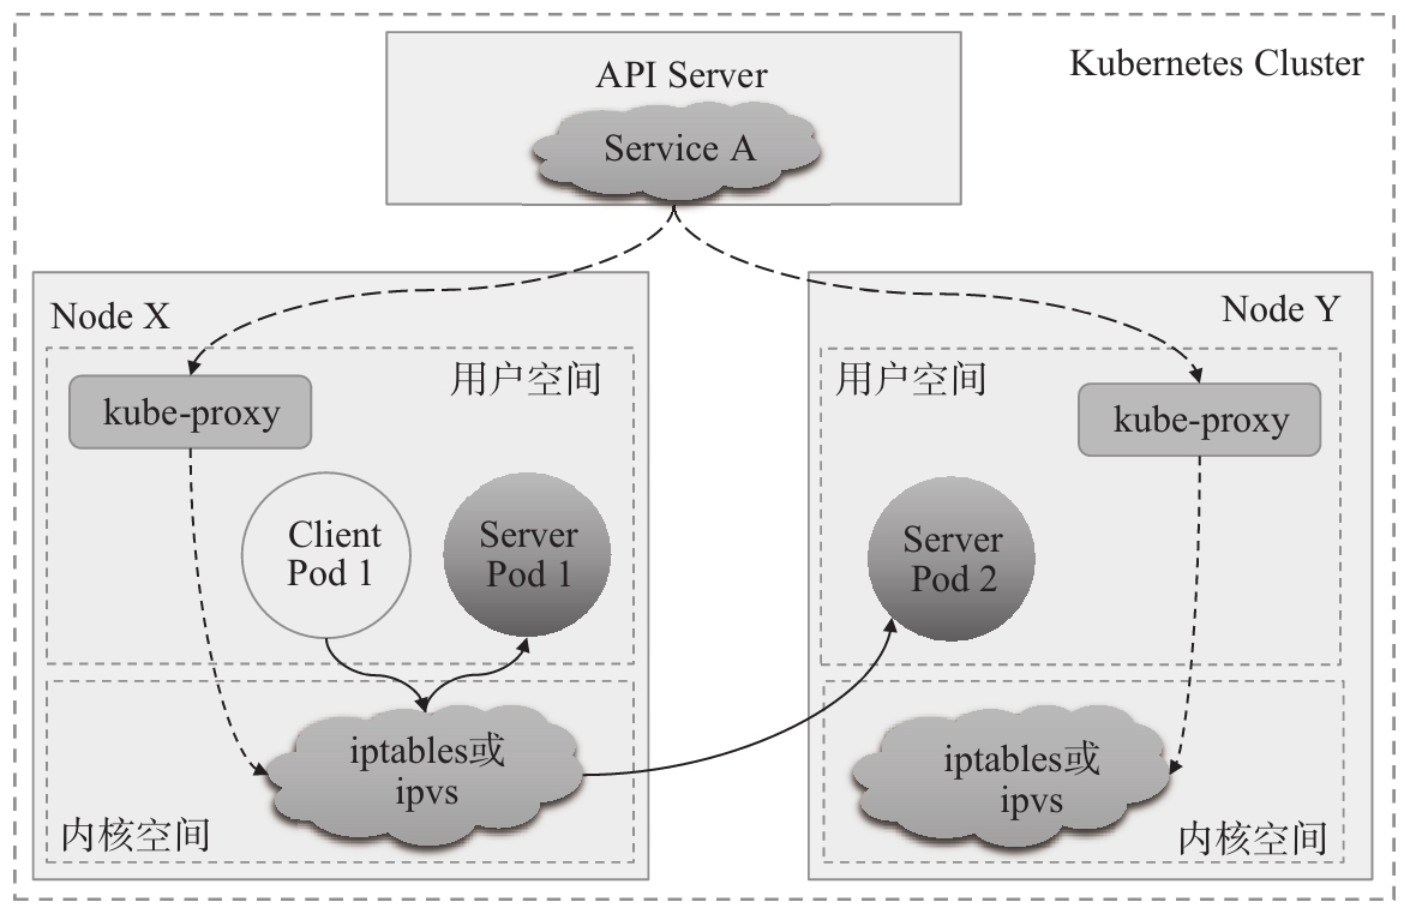
Netfilter是Linux内核中用于管理网络报文的框架 , 它具有网络地址转换(NAT)、报文改动和报文过滤等防火墙功能 , 用户可借助用户空间的iptables等工具按需自由定制规则使用其各项功能。ipvs 是借助于Netfilter实现的网络请求报文调度框架 , 支持rr、wrr、 lc、wlc、sh、sed和nq等10余种调度算法 , 用户空间的命令行工具是 ipvsadm , 用于管理工作于ipvs之上的调度规则。
Service对象的ClusterIP事实上是用于生成iptables或ipvs规则时使用的IP地址 , 它仅用于实现Kubernetes集群网络内部通信 , 且仅能够以规则中定义的转发服务的请求作为目标地址予以响应 , 这也是它之所以被称作虚拟IP的原因之一。kube-proxy把请求代理至相应端 点的方式有3种: userspace、iptables和ipvs。
userspace代理模型此处的
userspace是指Linux操作系统的用户空间。在这种模型中 ,kube-proxy负责跟踪API Server上Service和Endpoints对象的变动(创建或移除) , 并据此调整Service资源的定义。对于每个Service对象 , 它会随机打开一个本地端口(运行于用户空间的kube proxy进程负责监听) , 任何到达此代理端口的连接请求都将被代理至当前Service资源后端的各Pod对象 , 至于哪个Pod对象会被选中则取决于当前Service资源的调度方式 , 默认调度算法是轮询(round-robin)。userspace代理模型工作逻辑如图所示。另外 , 此类Service对象还会创建iptables规则以捕获任何到达ClusterIP和端口的流量。在Kubernetes 1.1版本之前 ,userspace是默认的代理模型。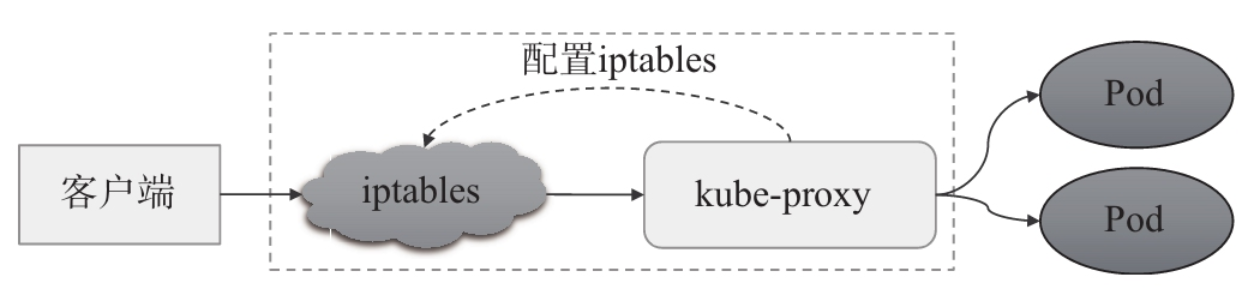
在这种代理模型中 , 请求流量到达内核空间后经由套接字送往用户空间中的
kube-proxy进程 , 而后由该进程送回内核空间 , 发往调度 分配的目标后端Pod对象。因请求报文在内核空间和用户空间来回转发 , 所以必然导致模型效率不高。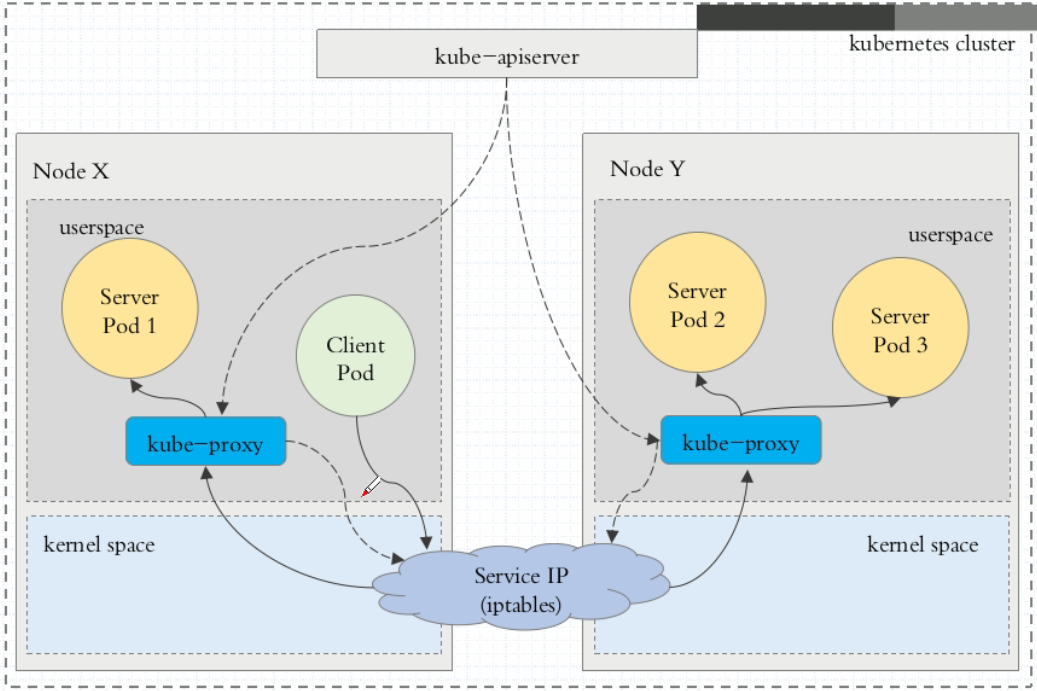
iptables代理模型创建
Service对象的操作会触发集群中的每个kube-proxy并将其转换为定义在所属节点上的iptables规则 , 用于转发工作接口接收到的、与此Service资源ClusterIP和端口相关的流量。客户端发来请求将直接由相关的iptables规则进行目标地址转换(DNAT)后根据算法调度并转发至集群内的Pod对象之上 , 而无须再经由kube-proxy进程进行处理 , 因而称为iptables代理模型 , 如图所示。对于每个Endpoints对象 ,Service资源会为其创建iptables规则并指向其iptables地址和端口 , 而流量转发到多个Endpoint对象之上的默认调 度机制是随机算法。iptables代理模型由Kubernetes v1.1版本引入 , 并于v1.2版本成为默认的类型。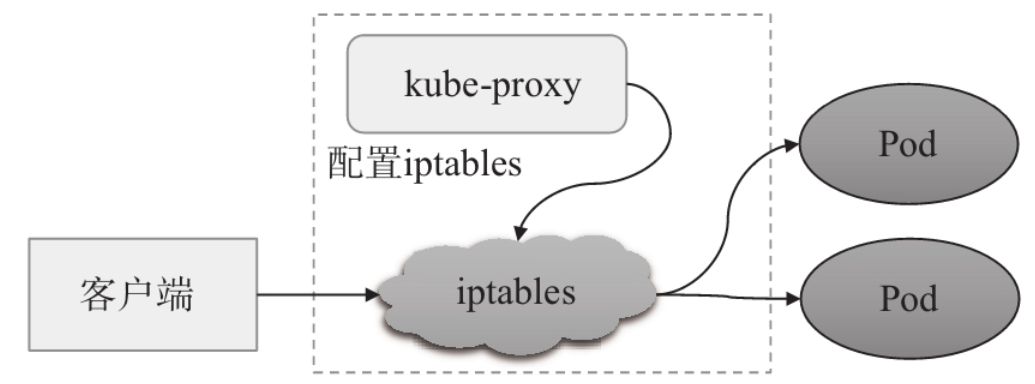
在
iptables代理模型中 ,Service的服务发现和负载均衡功能都使用iptables规则实现 , 而无须将流量在用户空间和内核空间来回切换 , 因此更为高效和可靠 , 但是性能一般 , 而且受规模影响较大 , 仅 适用于少量Service规模的集群。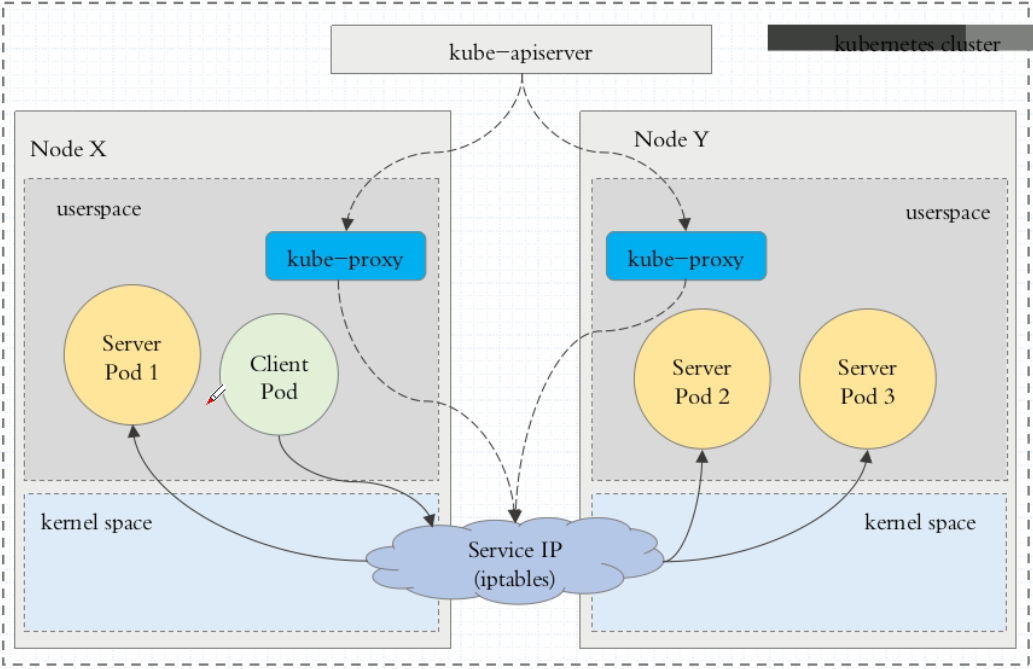
ipvs代理模型Kubernetes自v1.9版本起引入ipvs代理模型 , 且自v1.11版本起成为默认设置。在此种模型中 ,kube-proxy跟踪API Server上Service和Endpoints对象的变动 , 并据此来调用netlink接口创建或变更ipvs(NAT)规则 , 如图所示。它与iptables规则的不同之处仅在于客户端请求流量的调度功能由ipvs实现 , 余下的其他功能仍由iptables完成。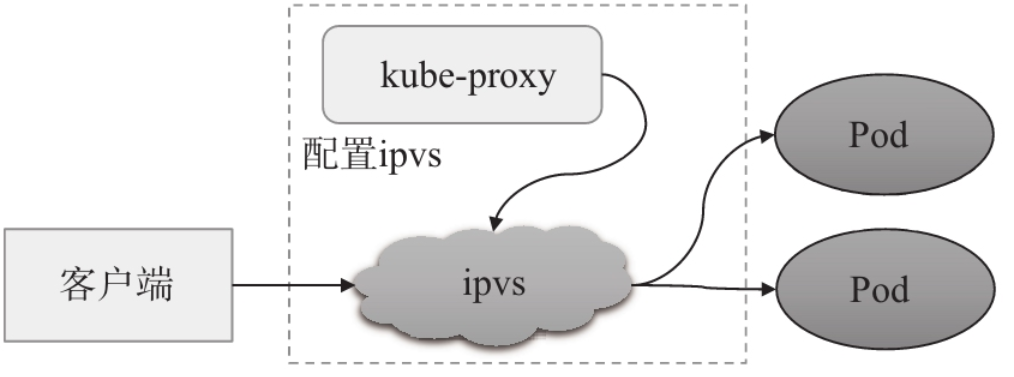
ipvs代理模型中Service的服务发现和负载均衡功能均基于内核中的ipvs规则实现。类似于iptables,ipvs也构建于内核中的netfilter之上 , 但它使用hash表作为底层数据结构且工作于内核空间 , 因此具有流量转发速度快、规则同步性能好的特性 , 适用于存在大量Service资源且对性能要求较高的场景。ipvs代理模型支持rr、lc、dh、sh、sed和nq等多种调度算法。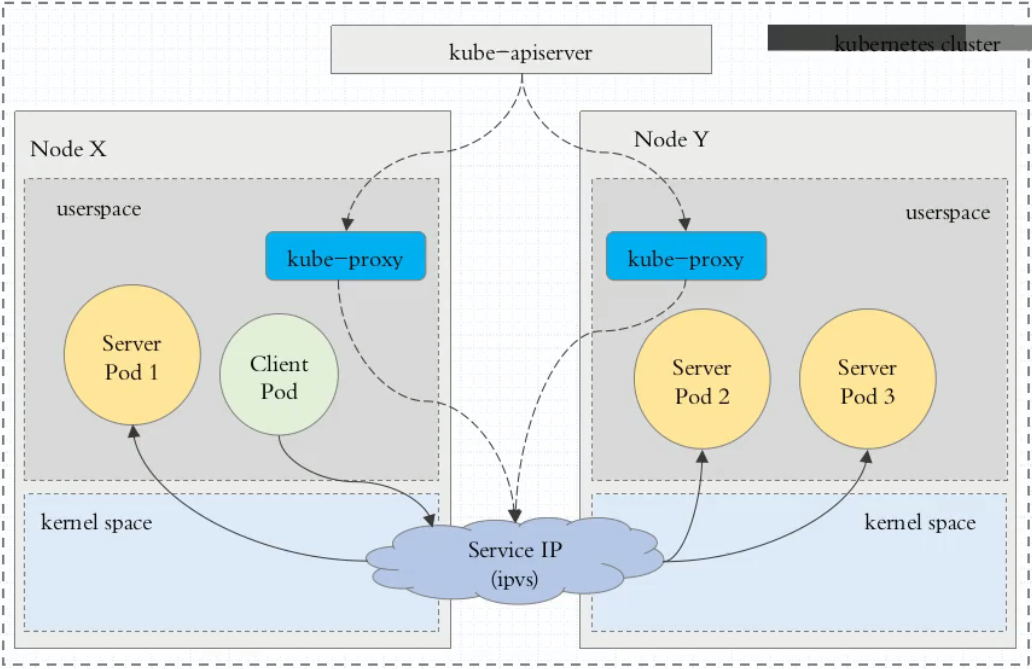
1.3 Service资源类型
无论哪一种代理模型 , Service资源都可统一根据其工作逻辑分为 ClusterIP、NodePort、LoadBalancer和ExternalName这4种类型。
ClusterIP通过集群内部
IP地址暴露服务 ,ClusterIP地址仅在集群内部可达 , 因而无法被集群外部的客户端访问。此为默认的Service类型。NodePortNodePort类型是对ClusterIP类型Service资源的扩展 , 它支持通过特定的节点端口接入集群外部的请求流量 , 并分发给后端的Server Pod处理和响应。因此 , 这种类型的Service既可以被集群内部客户端通过ClusterIP直接访问 , 也可以通过套接字<NodeIP>:<NodePort>与集群外部客户端进行通信 , 如图所示。显然 , 若集群外部的请求报文首先到的节点并非Service调度的目标Server Pod所在的节点 , 该请求必然因需要额外的转发过程(跃点)和更多的处理步骤而产生更多延迟。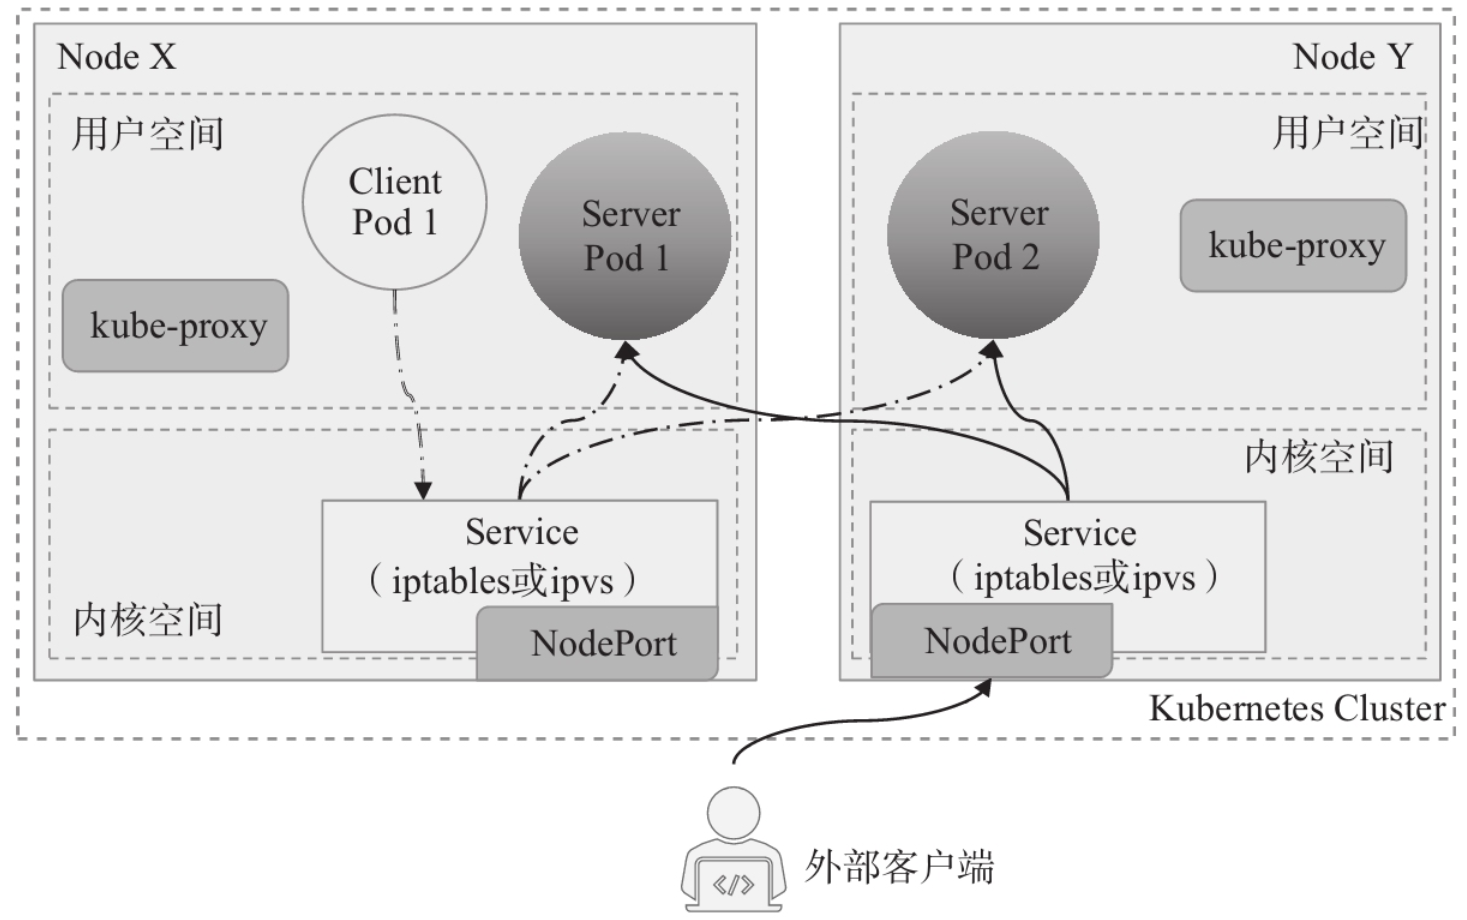
另外 , 集群外部客户端对
NodePort发起的请求报文源地址并非集群内部地址 , 而请求报文又可能被收到报文的节点(例如图中的Y节点)转发至集群中的另一个节点(例如图中的X节点)上的Pod对象(例如图中的Server Pod 1) , 因此 , 为避免X节点直接将响应报文发送给外部客户端 ,Y节点需要先将收到的报文的源地址转为请求报文的目标IP(自身的节点IP)后再进行后续处理过程。LoadBalancer这种类型的
Service依赖于部署在IaaS云计算服务之上并且能够调用其API接口创建软件负载均衡器的Kubernetes集群环境。LoadBalancer Service构建在NodePort类型的基础上 , 通过云服务商提供的软负载均衡器将服务暴露到集群外部 , 因此它也会具有NodePort和ClusterIP。简言之 , 创建LoadBalancer类型的Service对象时会在集群上创建一个NodePort类型的Service, 并额外触发Kubernetes调用底层的IaaS服务的API创建一个软件负载均衡器 , 而集群外部的请求流量会先路由至该负载均衡器 , 并由该负载均衡器调度至各节点上该Service对象的NodePort, 如图所示。该Service类型的优势在于 , 它能够把来自集群外部客户端的请求调度至所有节点(或部分节点)的NodePort之上 , 而不是让客户端自行决定连接哪个节点 , 也避免了因客户端指定的节点故障而导致的服务不可用。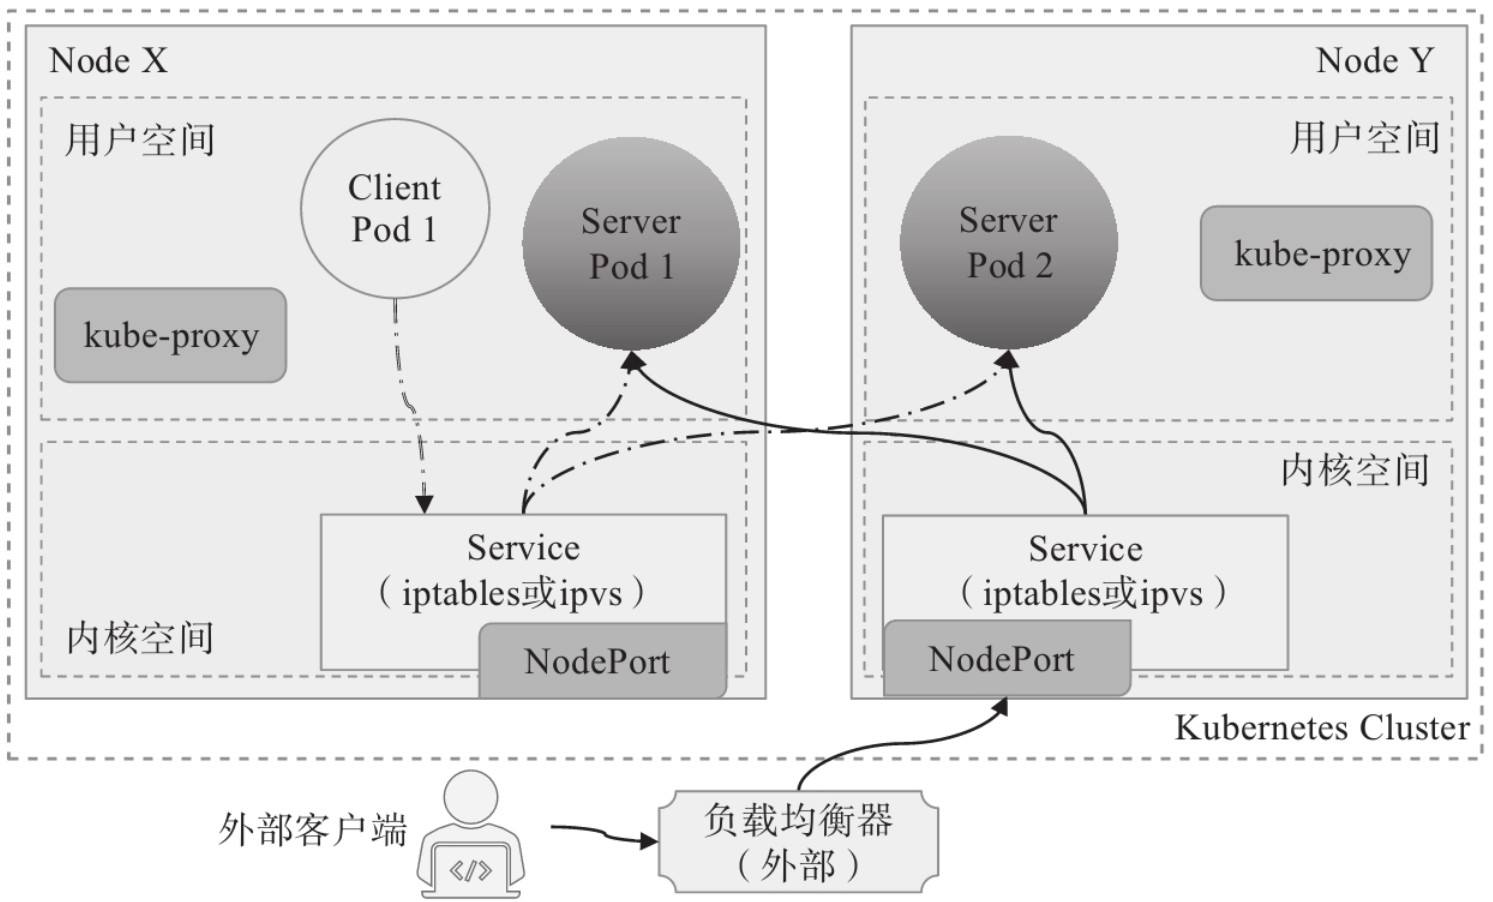
通过将
Service映射至由externalName字段的内容指定的主机名来暴露服务 , 此主机名需要被DNS服务解析至CNAME类型的记录中。换言之 , 此种类型不是定义由Kubernetes集群提供的服务 , 而是把集群外部的某服务以DNS CNAME记录的方式映射到集群内 , 从而让集群内的Pod资源能够访问外部服务的一种实现方式 , 如图所示。因此 , 这种类型的Service没有ClusterIP和NodePort, 没有标签选择器用于选择Pod资源 , 也不会有Endpoints存在。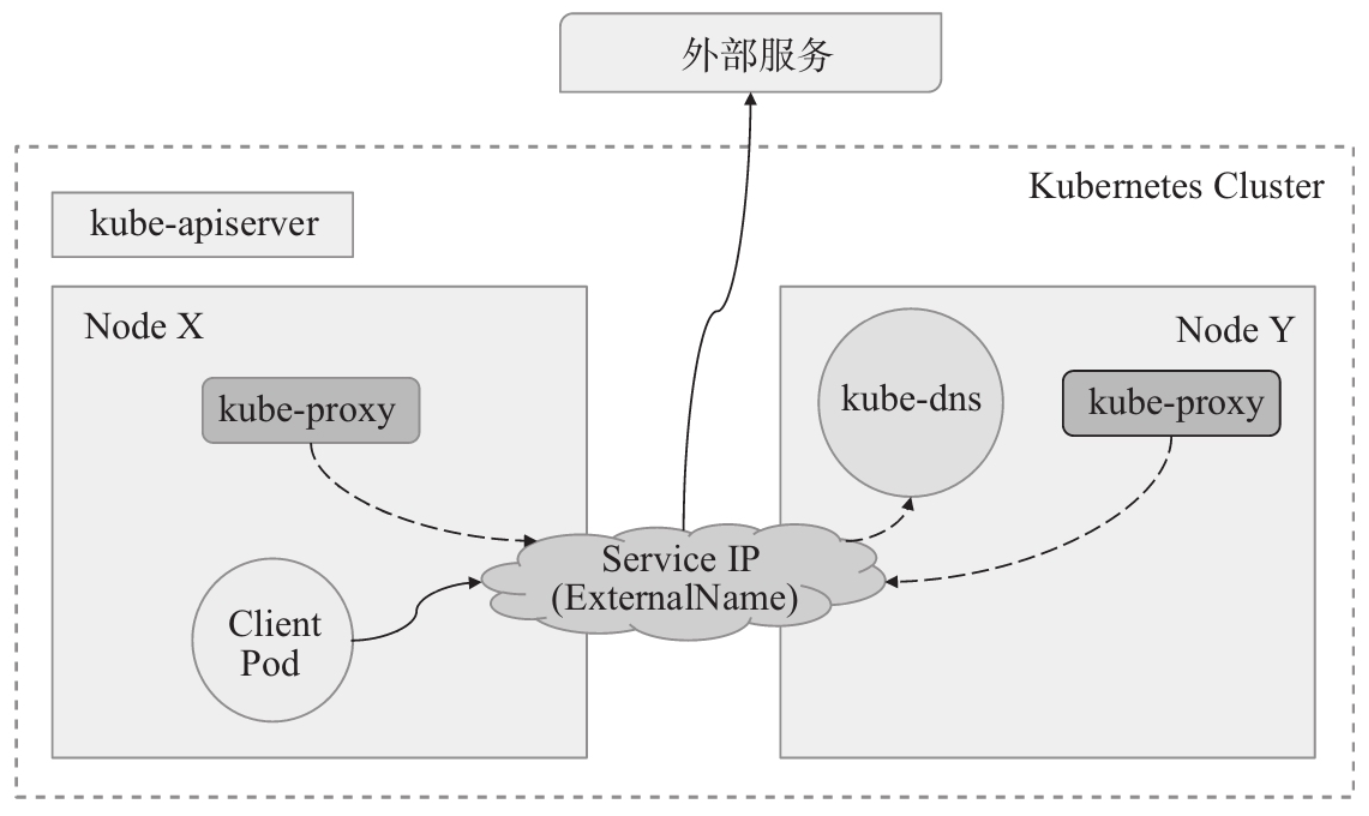
总体来说 , 若需要将Service资源发布至集群外部 , 应该将其配置为NodePort或Load-Balancer类型 , 而若要把外部的服务发布于集群内部供Pod对象使用 , 则需要定义一个ExternalName类型的Service资源 , 只是这种类型的实现要依赖于v1.7及更高版本的Kubernetes。
2. 应用Service资源
Service是Kubernetes核心API群组(core)中的标准资源类型之 一 , 其管理操作的基本逻辑类似于Namespace和ConfigMap等资源 , 支持基于命令行和配置清单的管理方式。Service资源配置规范中常用的字段及意义如下所示。
apiVersion: v1
kind: Service
metadata:
  name: …
  namespace: …
spec:
  type <string>                 # Service类型 , 默认为ClusterIP
  selector <map[string]string>  # 等值类型的标签选择器 , 内含“与”逻辑
  ports:                        # Service的端口对象列表
  - name <string>               # 端口名称
    protocol <string>           # 协议 , 目前仅支持TCP、UDP和SCTP , 默认为TCP
    port <integer>              # Service的端口号
    targetPort  <string>        # 后端目标进程的端口号或名称 , 名称需由Pod规范定义
    nodePort <integer>          # 节点端口号 , 仅适用于NodePort和
LoadBalancer类型
  clusterIP  <string>             # Service的集群IP , 建议由系统自动分配
  externalTrafficPolicy  <string> # 外部流量策略处理方式 , Local表示由当前节点处理 ,
                                  # Cluster表示向集群范围内调度
  loadBalancerIP  <string>        # 外部负载均衡器使用的IP地址 , 仅适用于LoadBlancer
externalName <string> # 外部服务名称 , 该名称将作为Service的DNS CNAME值不同Service类型所支持使用的配置字段有着明显的区别 , 具体使用 时应该根据计划使用的类型进行选择。
2.1 应用ClusterIP Service资源
创建Service对象的常用方法有两种 : 一是利用此前曾使用过的 kubectl create service命令创建 , 另一个则是利用资源配置清单创建。Service资源对象的期望状态定义在spec字段中 , 较为常用的内嵌字段为selector和ports , 用于定义标签选择器和服务端口。下面的配置清单是定义在services-clusterip-demo.yaml中的一个Service资源示例:
kind: Service
apiVersion: v1
metadata:
  name: demoapp-svc
  namespace: default
spec:
  selector:
    app: demoapp
  ports:
  - name: http       # 端口名称标识
    protocol: TCP    # 协议 , 支持TCP、UDP和SCTP
    port: 80         # Service自身的端口号
targetPort: 80 # 目标端口号 , 即Endpoint上定义的端口号Service资源的spec.selector仅支持以映射(字典)格式定义的等值类型的标签选择器 , 例如上面示例中的app: demoapp。定义服务端口的字段spec.ports的值则是一个对象列表 , 它主要定义Service对象自身的端口与目标后端端口的映射关系。我们可以将示例中的Service对象创建于集群中 , 通过其详细描述了解其特性 , 如下面的命令及结果所示。
root@kubeadm-master1:~# kubectl apply -f services-clusterip-demo.yaml
service/demoapp-svc created
root@kubeadm-master1:~# kubectl describe services/demoapp-svc
Name:              demoapp-svc
Namespace:         default
Labels:            <none>
Annotations:       <none>
Selector:          app=demoapp
Type:              ClusterIP
IP Family Policy:  SingleStack
IP Families:       IPv4
IP:                10.20.105.179
IPs:               10.20.105.179
Port:              http  80/TCP
TargetPort:        80/TCP
Endpoints:         <none>
Session Affinity:  None
Events:            <none>
上面命令中的结果显示 , demoapp-svc默认设定为ClusterIP类型 , 并得到一个自动分配的IP地址10.20.105.179。创建Service对象的同时会创建一个与之同名且拥有相同标签选择器的Endpoint对象 , 若该标签选择器无法匹配到任何Pod对象的标签 , 则Endpoint对象无任何可用端点数据 , 于是Service对象的Endpoints字段值便成了。
我们知道 , Service对象自身只是iptables或ipvs规则 , 它并不能处理客户端的服务请求 , 而是需要把请求报文通过目标地址转换(DNAT) 后转发至后端某个Server Pod , 这意味着没有可用的后端端点的Service 对象是无法响应客户端任何服务请求的 , 如下面从集群节点上发起的请求命令结果所示。
root@kubeadm-master1:~# curl 10.20.105.179
curl: (7) Failed to connect to 10.20.105.179 port 80 after 0 ms: Connection refused下面使用命令式命令手动创建一个与该Service对象具有相同标签选择器的Deployment对象demoapp , 它默认会自动创建一个拥有标签app: demoapp的Pod对象。
root@kubeadm-master1:~# kubectl create deploy demoapp --image=ikubernetes/demoapp:v1.0
deployment.apps/demoapp created
root@kubeadm-master1:~# kubectl get pods -l app=demoapp
NAME                      READY   STATUS    RESTARTS   AGE
demoapp-7c58cd6bb-xsvgg 1/1 Running 0 59sService对象demoapp-svc通过API Server获知这种匹配变动后 , 会立即创建一个以该Pod对象的IP和端口为列表项的名为demoapp-svc的 Endpoints对象 , 而该Service对象详细描述信息中的Endpoint字段便以 此列表项为值 , 如下面的命令结果所示。
root@kubeadm-master1:~# kubectl get endpoints/demoapp-svc
NAME          ENDPOINTS       AGE
demoapp-svc   10.10.8.37:80   16m
root@kubeadm-master1:~# kubectl describe services/demoapp-svc | grep -i endpoints
Endpoints: 10.10.8.37:80扩展Deployment对象demoapp的应用规模引起的变动也将立即反映到相关的Endpoint和Service对象之上 , 例如将deployments/demoapp对象的副本扩展至3个 , 再来验证services/demoapp-svc的端点信息 , 如下面 的命令及结果所示。
root@kubeadm-master1:~# kubectl scale deployments/demoapp --replicas=3
deployment.apps/demoapp scaled
root@kubeadm-master1:~# kubectl get endpoints/demoapp-svc
NAME          ENDPOINTS                                   AGE
demoapp-svc   10.10.6.88:80,10.10.7.90:80,10.10.8.37:80   20m
root@kubeadm-master1:~# kubectl describe services/demoapp-svc | grep -i endpoints
Endpoints: 10.10.6.88:80,10.10.7.90:80,10.10.8.37:80接下来可于集群中的某节点上再次向服务对象demoapp-svc发起访问 请求以进行测试 , 多次的访问请求还可评估负载均衡算法的调度效果 , 如下面的命令及结果所示。
root@kubeadm-master1:~# while true ; do curl -s 10.20.105.179/hostname; sleep 1 ; done
ServerName: demoapp-7c58cd6bb-ksvzh
ServerName: demoapp-7c58cd6bb-s6hvg
ServerName: demoapp-7c58cd6bb-xsvgg
ServerName: demoapp-7c58cd6bb-ksvzh
ServerName: demoapp-7c58cd6bb-s6hvg
ServerName: demoapp-7c58cd6bb-xsvgg kubeadm部署的Kubernetes集群的Service代理模型默认为 iptables , 它使用随机调度算法 , 因此Service会把客户端请求随机调度 至其关联的某个后端Pod对象。请求取样次数越多 , 其调度效果也越接近 算法的目标效果。
2.2 应用NodePort Service资源
部署Kubernetes集群系统时会预留一个端口范围 , 专用于分配给需要用到NodePort的Service对象 , 该端口范围默认为30000~32767。与 Cluster类型的Service资源的一个显著不同之处在于 , NodePort类型的Service资源需要显式定义.spec.type字段值为NodePort , 必要时还可以手动指定具体的节点端口号。例如下面的配置清单(services-nodeport-demo.yaml)中定义的Service资源对象demoapp-nodeport-svc , 它使用了NodePort类型 , 且人为指定了32223这个节点端口。
kind: Service
apiVersion: v1
metadata:
  name: demoapp-nodeport-svc
spec:
  type: NodePort
  selector:
    app: demoapp
  ports:
  - name: http
    protocol: TCP
    port: 80
    targetPort: 80
    nodePort: 32223
实践中 , 并不鼓励用户自定义节点端口 , 除非能事先确定它不会与 某个现存的Service资源产生冲突。无论如何 , 只要没有特别需要 , 留给系统自动配置总是较好的选择。将配置清单中定义的Service对象 demoapp-nodeport-svc创建于集群之上 , 以便通过详细描述了解其状态细节
root@kubeadm-master1:~# kubectl apply -f services-nodeport-demo.yaml
service/demoapp-nodeport-svc created
root@kubeadm-master1:~# kubectl describe service  demoapp-nodeport-svc
Name:                     demoapp-nodeport-svc
Namespace:                default
Labels:                   <none>
Annotations:              <none>
Selector:                 app=demoapp
Type:                     NodePort
IP Family Policy:         SingleStack
IP Families:              IPv4
IP:                       10.20.6.64
IPs:                      10.20.6.64
Port:                     http  80/TCP
TargetPort:               80/TCP
NodePort:                 http  32223/TCP
Endpoints:                10.10.6.88:80,10.10.7.90:80,10.10.8.37:80
Session Affinity:         None
External Traffic Policy:  Cluster
Events:                   <none>
命令结果显示 , 该Service对象用于调度集群外部流量时使用默认的 Cluster策略 , 该策略优先考虑负载均衡效果 , 哪怕目标Pod对象位于另外的节点之上而带来额外的网络跃点 , 因而针对该NodePort的请求将会 被分散调度至该Serivce对象关联的所有端点之上。可以在集群外的某节点上对任一工作节点的NodePort端口发起HTTP请求以进行测试。以节点 node03.cbear.top为例 , 我们以如下命令向它的IP地址192.168.71.37 的32223端口发起多次请求。
root@kubeadm-master1:~# while true ; do curl -s 192.168.71.37:32223 ; sleep 1 ; done;
iKubernetes demoapp v1.0 !! ClientIP: 10.10.6.0, ServerName: demoapp-7c58cd6bb-xsvgg, ServerIP: 10.10.8.37!
iKubernetes demoapp v1.0 !! ClientIP: 10.10.6.0, ServerName: demoapp-7c58cd6bb-ksvzh, ServerIP: 10.10.7.90!
iKubernetes demoapp v1.0 !! ClientIP: 10.10.6.1, ServerName: demoapp-7c58cd6bb-s6hvg, ServerIP: 10.10.6.88!
上面命令的结果显示出外部客户端的请求被调度至该Service对象的 每一个后端Pod之上 , 而这些Pod对象可能会分散于集群中的不同节点。 命令结果还显示 , 请求报文的客户端IP地址是最先接收到请求报文的节点上用于集群内部通信的IP地址 , 而非外部客户端地址 , 这也能够在 Pod对象的应用访问日志中得到进一步验证 , 如下所示。
root@kubeadm-master1:~# kubectl logs demoapp-7c58cd6bb-ksvzh | tail -n 1
10.10.6.0 - - [11/May/2024 10:48:57] "GET / HTTP/1.1" 200 -出现这种现象的原因在1.3节解释过了。这样才能确保Server Pod 的响应报文必须由最先接收到请求报文的节点进行响应 , 因此NodePort 类型的Service对象会对请求报文同时进行源地址转换(SNAT)和目标地址转换(DNAT)操作。
另一个外部流量策略Local则仅会将流量调度至请求的目标节点本地运行的Pod对象之上 , 以减少网络跃点 , 降低网络延迟 , 但当请求报文指 向的节点本地不存在目标Service相关的Pod对象时将直接丢弃该报文。 下面先把demoapp-nodeport-svc的外部流量策略修改为Local , 而后再进行访问测试。简单起见 , 这里使用kubectl patch命令来修改Service对象的流量策略。
root@kubeadm-master1:~# kubectl patch services/demoapp-nodeport-svc -p '{"spec": {"externalTrafficPolicy": "Local"}}'
service/demoapp-nodeport-svc patched-p选项中指定的补丁是一个JSON格式的配置清单片段 , 它引用了 spec.externalTrafficPolicy字段 , 并为其赋一个新的值。配置完成后 , 我们再次发起测试请求时会看到 , 请求都被调度给了目标节点本地运行的Pod对象。另外 , Local策略下无须在集群中转发流量至其他节点 , 也就不用再对请求报文进行源地址转换 , Server Pod所看到的客户端IP就是外部客户端的真实地址。
root@kubeadm-master1:~# while true ; do curl -s 192.168.71.37:32223 ; sleep 1 ; done;
iKubernetes demoapp v1.0 !! ClientIP: 192.168.71.29, ServerName: demoapp-7c58cd6bb-s6hvg, ServerIP: 10.10.6.88!
iKubernetes demoapp v1.0 !! ClientIP: 192.168.71.29, ServerName: demoapp-7c58cd6bb-s6hvg, ServerIP: 10.10.6.88!
iKubernetes demoapp v1.0 !! ClientIP: 192.168.71.29, ServerName: demoapp-7c58cd6bb-s6hvg, ServerIP: 10.10.6.88!
iKubernetes demoapp v1.0 !! ClientIP: 192.168.71.29, ServerName: demoapp-7c58cd6bb-s6hvg, ServerIP: 10.10.6.88!
iKubernetes demoapp v1.0 !! ClientIP: 192.168.71.29, ServerName: demoapp-7c58cd6bb-s6hvg, ServerIP: 10.10.6.88!NodePort类型的Service资源同样会被配置ClusterIP , 以确保集群内的客户端对该服务的访问请求可在集群范围的通信中完成。
2.3 应用LoadBalancer Service资源
NodePort类型的Service资源虽然能够在集群外部访问 , 但外部客户端必须事先得知NodePort和集群中至少一个节点IP地址 , 一旦被选定的节点发生故障 , 客户端还得自行选择请求访问其他的节点 , 因而一个有着固定IP地址的固定接入端点将是更好的选择。此外 , 集群节点很可能是某IaaS云环境中仅具有私有IP地址的虚拟主机 , 这类地址对互联网客 户端不可达 , 为此类节点接入流量也要依赖于集群外部具有公网IP地址的负载均衡器 , 由其负责接入并调度外部客户端的服务请求至集群节点相应的NodePort之上。
IaaS云计算环境通常提供了LBaaS(Load Balancer as a Service) 服务 , 它允许租户动态地在自己的网络创建一个负载均衡设备。部署在 此类环境之上的Kubernetes集群可借助于CCM(Cloud Controller Manager)在创建LoadBalancer类型的Service资源时调用IaaS的相应 API , 按需创建出一个软件负载均衡器。但CCM不会为那些非 LoadBalancer类型的Service对象创建负载均衡器 , 而且当用户将 LoadBalancer类型的Service调整为其他类型时也将删除此前创建的负载均衡器。
注意 :
kubeadm在部署Kubernetes集群时并不会默认部署CCM, 有需要的用户需要自行部署。
对于没有此类API可用的Kubernetes集群 , 管理员也可以为NodePort 类型的Service手动部署一个外部的负载均衡器(推荐使用HA配置模型) , 并配置将请求流量调度至各节点的NodePort之上 , 这种方式的缺 点是管理员需要手动维护从外部负载均衡器到内部服务的映射关系。
从实现方式上来说 , LoadBalancer类型的Service就是在NodePort类型的基础上请求外部管理系统的API , 并在Kubernetes集群外部额外创建 一个负载均衡器 , 将流量调度至该NodePort Service之上。Kubernetes 以异步方式请求创建负载均衡器 , 并将有关配置保存在Service对象的.status.loadBalancer字段中。下面是定义在services-loadbalancer-demo.yam配置清单中的LoadBalancer类型Service资源 , 在最简单的配置模型中 , 用户仅需要修改NodePort Service服务定义中 type字段的值为LoadBalancer即可。
kind: Service
apiVersion: v1
metadata:
  name: demoapp-loadbalancer-svc
spec:
  type: LoadBalancer
  selector:
    app: demoapp
  ports:
  - name: http
    protocol: TCP
    port: 80
targetPort: 80 Service对象的loadBalancerIP负责承接外部发来的流量 , 该IP地址 通常由云服务商系统动态配置 , 或者借助.spec.loadBalancerIP字段显式指定 , 但有些云服务商不支持用户设定该IP地址 , 这种情况下 , 即便提供了也会被忽略。外部负载均衡器的流量会直接调度至Service后端的 Pod对象之上 , 而如何调度流量则取决于云服务商 , 有些环境可能还需要为Service资源的配置定义添加注解 , 必要时请自行参考云服务商文档说 明。另外 , LoadBalancer Service还支持使用.spec.loadBalancerSourceRanges字段指定负载均衡器允许的客户端来源的地址范围。
2.4 外部IP
若集群中部分或全部节点除了有用于集群通信的节点IP地址之外 , 还有可用于外部通信的IP地址 , 如图中的EIP-1和EIP-2 , 那么我们 还可以在Service资源上启用spec.externalIPs字段来基于这些外部IP地址向外发布服务。所有路由到指定的外部IP(externalIP)地址某端口的请求流量都可由该Service代理到后端Pod对象之上 , 如图所示。 从这个角度来说 , 请求流量到达外部IP与节点IP并没有本质区别 , 但外部IP却可能仅存在于一部分的集群节点之上 , 而且它不受Kubernetes集群管理 , 需要管理员手动介入其配置和回收等操作任务中。
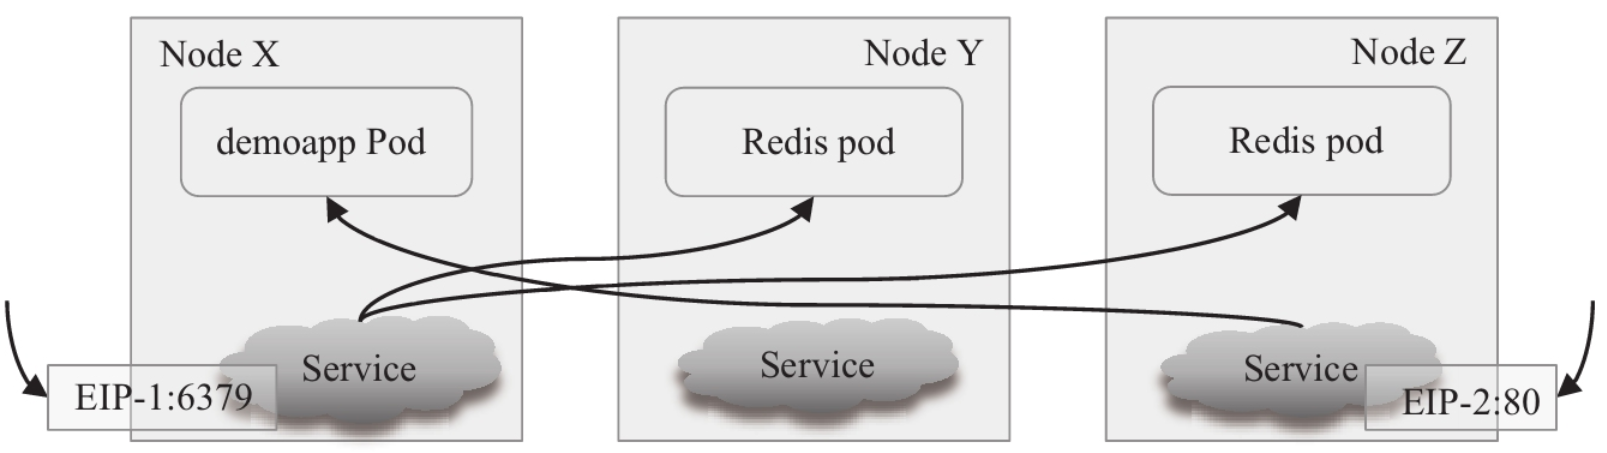
外部IP地址可结合ClusterIP、NodePort或LoadBalancer任一类型的 Service资源使用 , 而到达外部IP的请求流量会直接由相关联的Service 调度转发至相应的后端Pod对象进行处理。假设示例Kubernetes集群中的node01节点上拥有一个可被路由到的IP地址192.168.71.40 , 我们期望能够将demoapp的服务通过该外部IP地址发布到集群外部 , 则可以使用下列配置清单(services-externalip-demo.yaml)中的Service资源实现。
kind: Service
apiVersion: v1
metadata:
  name: demoapp-externalip-svc
  namespace: default
spec:
  type: ClusterIP
  selector:
    app: demoapp
  ports:
  - name: http
    protocol: TCP
    port: 80
    targetPort: 80
  externalIPs:
  - 192.168.71.40
不难猜测 , 节点node01故障也必然导致该外部IP上公开的服务不再可达 , 除非该IP地址可以浮动到其他节点上。如今 , 大多数云服务 商都支持浮动IP的功能 , 该IP地址可绑定在某个主机 , 并在其故障时通 过某种触发机制自动迁移至其他主机。在不具有浮动IP功能的环境中进 行测试之前 , 需要先在node01上(或根据规划的其他的节点上)手动配置172.29.9.26这个外部IP地址。而且 , 在模拟节点故障并手动将外 部IP地址配置在其他节点进行浮动IP测试时 , 还需要清理之前的ARP地址 缓存。感兴趣的读者可自行测试。
3. Service与Endpoint资源
在信息技术领域 , 端点是指通过LAN或WAN连接的能够用于网络通信的硬件设备 , 它在广义上可以指代任何与网络连接的设备。在 Kubernetes语境中 , 端点通常代表Pod或节点上能够建立网络通信的套接字 , 并由专用的资源类型Endpoint进行定义和跟踪。
3.1 Endpoint与容器探针
Service对象借助于Endpoint资源来跟踪其关联的后端端点 , 但 Endpoint是“二等公民” , Service对象可根据标签选择器直接创建同名的Endpoint对象 , 不过用户几乎很少有直接使用该类型资源的需求。例如 , 创建下面配置清单中名为services-readiness-demo的 Service对象时就会自动创建一个同名的Endpoint对象。
kind: Service
apiVersion: v1
metadata:
  name: services-readiness-demo
  namespace: default
spec:
  selector:
    app: demoapp-with-readiness
  ports:
  - name: http
    protocol: TCP
    port: 80
    targetPort: 80

---
apiVersion: apps/v1
kind: Deployment      # 定义Deployment对象 , 它使用Pod模板创建Pod对象
metadata:
  name: demoapp2
spec:
  replicas: 2         # 该Deployment对象要求满足的Pod对象数量
  selector:           # Deployment对象的标签选择器 , 用于筛选Pod对象并完成计数
    matchLabels:
      app: demoapp-with-readiness
  template:           # 由Deployment对象使用的Pod模板 , 用于创建足额的Pod对象
    metadata:
      creationTimestamp: null
      labels:
        app: demoapp-with-readiness
    spec:
      containers:
      - image: ikubernetes/demoapp:v1.0
        name: demoapp
        imagePullPolicy: IfNotPresent
        readinessProbe:
          httpGet:    # 定义探针类型和探测方式
            path: '/readyz'
            port: 80
          initialDelaySeconds: 15   # 初次检测延迟时长
periodSeconds: 10 # 检测周期Endpoint对象会根据就绪状态把同名Service对象标签选择器筛选出的后端端点的IP地址分别保存在subsets.addresses字段和 subsets.notReadyAddresses字段中 , 它通过API Server持续、动态跟踪每个端点的状态变动 , 并即时反映到端点IP所属的字段。仅那些位于subsets.addresses字段的端点地址可由相关的Service用作后端端点。此外 , 相关Service对象标签选择器筛选出的Pod对象数量的变动也将会导致Endpoint对象上的端点数量变动。
上面配置清单中定义Endpoint对象services-readiness-demo会筛选出Deployment对象demoapp2创建的两个Pod对象 , 将它们的IP地址和服务端口创建为端点对象。但延迟15秒启动的容器探针会导致这两个 Pod对象至少要在15秒以后才能转为“就绪”状态 , 这意味着在上面配 置清单中的Service资源创建后至少15秒之内无可用后端端点 , 例如下面的资源创建和Endpoint资源监视命令结果中 , 在20秒之后 , Endpoint资源services-readiness-demo才得到第一个可用的后端端点 IP。
root@kubeadm-master1:~# kubectl apply -f services-readiness-demo.yaml
service/services-readiness-demo created
deployment.apps/demoapp2 created
root@kubeadm-master1:~#  kubectl get endpoints/services-readiness-demo -w
NAME                      ENDPOINTS   AGE
services-readiness-demo               26s
services-readiness-demo   10.10.8.38:80   40s
services-readiness-demo   10.10.7.91:80,10.10.8.38:80   40s
因任何原因导致的后端端点就绪状态检测失败 , 都会触发 Endpoint对象将该端点的IP地址从subsets.addresses字段移至 subsets.notReadyAddresses字段。例如 , 我们使用如下命令人为地将 地址10.10.8.38的Pod对象中的容器就绪状态检测设置为失败 , 以进行验证。
root@kubeadm-master1:~# curl -s -X POST -d 'readyz=FAIL' 10.10.8.38/readyz等待至少3个检测周期共30秒之后 , 获取Endpoint对象services-readiness-demo的资源清单的命令将返回类似如下信息。
root@kubeadm-master2:~# kubectl get endpoints/services-readiness-demo -o yaml
apiVersion: v1
kind: Endpoints
metadata:
  annotations:
    endpoints.kubernetes.io/last-change-trigger-time: "2024-05-11T12:16:05Z"
  creationTimestamp: "2024-05-11T12:09:05Z"
  name: services-readiness-demo
  namespace: default
  resourceVersion: "741578"
  uid: 707c9f58-ea4b-422c-bbf8-8b0d6cef374e
subsets:
- addresses:
  - ip: 10.10.7.91
    nodeName: node02.cbear.top
    targetRef:
      kind: Pod
      name: demoapp2-598df58cc9-lxb9z
      namespace: default
      uid: 52f897fa-930a-4c94-bfe1-2e5e6d78c9ce
  notReadyAddresses:
  - ip: 10.10.8.38
    nodeName: node01.cbear.top
    targetRef:
      kind: Pod
      name: demoapp2-598df58cc9-2km2p
      namespace: default
      uid: 5dda8f49-4d14-4a25-966f-21e9e9bce688
  ports:
  - name: http
    port: 80
    protocol: TCP
该故障端点重新转回就绪状态后 , Endpoints对象会将其移回 subsets.addresses字段中。这种处理机制确保了Service对象不会将 客户端请求流量调度给那些处于运行状态但服务未就绪(notReady) 的端点。
3.2 自定义Endpoint资源
除了借助Service对象的标签选择器自动关联后端端点外 , Kubernetes也支持自定义Endpoint对象 , 用户可通过配置清单创建具有固定数量端点的Endpoint对象 , 而调用这类Endpoint对象的同名 Service对象无须再使用标签选择器。Endpoint资源的API规范如下。
apiVersion: v1
kind: Endpoint
metadata:                  # 对象元数据
  name:
  namespace:
subsets:                   # 端点对象的列表
- addresses:               # 处于“就绪”状态的端点地址对象列表
  - hostname  <string>     # 端点主机名
    ip <string>            # 端点的IP地址 , 必选字段
    nodeName <string>      # 节点主机名
    targetRef:             # 提供了该端点的对象引用
      apiVersion <string>  # 被引用对象所属的API群组及版本
      kind <string>        # 被引用对象的资源类型 , 多为Pod
      name <string>        # 对象名称
      namespace <string>   # 对象所属的名称空间
      fieldPath <string>   # 被引用的对象的字段 , 在未引用整个对象时使用 , 通常仅引用
                           # 指定Pod对象中的单容器 , 例如spec.containers[1]
      uid <string>         # 对象的标识符
  notReadyAddresses:       # 处于“未就绪”状态的端点地址对象列表 , 格式与address相同
  ports:                   # 端口对象列表
  - name <string>          # 端口名称
    port <integer>         # 端口号 , 必选字段
    protocol <string>      # 协议类型 , 仅支持UDP、TCP和SCTP , 默认为TCP
appProtocol <string> # 应用层协议自定义Endpoint常将那些不是由编排程序编排的应用定义为 Kubernetes系统的Service对象 , 从而让客户端像访问集群上的Pod应 用一样请求外部服务。例如 , 假设要把Kubernetes集群外部一个可经由172.29.9.51:3306或172.29.9.52:3306任一端点访问的MySQL数据库 服务引入集群中 , 便可使用如下清单中的配置完成。
apiVersion: v1
kind: Endpoints
metadata:
  name: mysql-external
  namespace: default
subsets:
- addresses:
  - ip: 172.29.9.51
  - ip: 172.29.9.52
  ports:
  - name: mysql
    port: 3306
    protocol: TCP
---
apiVersion: v1
kind: Service
metadata:
  name: mysql-external
  namespace: default
spec:
  type: ClusterIP
  ports:
  - name: mysql
    port: 3306
    targetPort: 3306
    protocol: TCP
显然 , 非经Kubernetes管理的端点 , 其就绪状态难以由Endpoint通过注册监视特定的API资源对象进行跟踪 , 因而用户需要手动维护这种调用关系的正确性。
Endpoint资源提供了在Kubernetes集群上跟踪端点的简单途径 , 但对于有着大量端点的Service来说 , 将所有的网络端点信息都存储在 单个Endpoint资源中 , 会对Kubernetes控制平面组件产生较大的负面影响 , 且每次端点资源变动也会导致大量的网络流量。 EndpointSlice(端点切片)通过将一个服务相关的所有端点按固定大小(默认为100个)切割为多个分片 , 提供了一种更具伸缩性和可扩展 性的端点替代方案。
EndpointSlice由引用的端点资源组成 , 类似于Endpoint , 它可由用户手动创建 , 也可由EndpointSlice控制器根据用户在创建Service 资源时指定的标签选择器筛选集群上的Pod对象自动创建。单个 EndpointSlice资源默认不能超过100个端点 , 小于该数量时 , EndpointSlice与Endpoint存在1:1的映射关系且性能相同。 EndpointSlice控制器会尽可能地填满每一个EndpointSlice资源 , 但 不会主动进行重新平衡 , 新增的端点会尝试添加到现有的 EndpointSlice资源上 , 若超出现有任何EndpointSlice对象的可用的 空余空间 , 则将创建新的EndpointSlice , 而非分散填充。
EndpointSlice自Kubernetes 1.17版本开始升级为Beta版 , 隶属 于discovery.k8s.io这一API群组。EndpointSlice控制器会为每个 Endpoint资源自动生成一个EndpointSlice资源。例如 , 下面的命令列 出了kube-system名称空间中的所有EndpointSlice资源 , kube-dns mbdj5来自于对kube-dns这一Endpoint资源的自动转换。
~$ kubectl get endpointslice -n kube-system
NAME             ADDRESSTYPE        PORTS            ENDPOINTS               AGE
kube-dns-mbdj5 IPv4 53,9153,53 10.244.0.6,10.244.0.7 13d EndpointSlice资源根据其关联的Service与端口划分成组 , 每个 组隶属于同一个Service。更具体的使用方式请参考Kubernetes的相关文档。
4. 深入理解Service资源
本质上 , Service对象代表着由kube-proxy借助于自身的程序逻辑 (userspace) 、iptables或ipvs , 甚至是某种形式的组合所构建出的流量代理和调度转发机制 , 每个Service对象的创建、更新与删除都会经由 kube-proxy反映为程序配置、iptables规则或ipvs规则的相应操作。
4.1 iptables代理模型
如前所述 , iptables类型的Service对象本质上是由集群中每个节点上的kube-proxy进程将Service定义、转换且配置于节点内核上的iptables规则。每个Service的定义主要由Service流量匹配规则、流量调度规则和以每个后端Endpoint为单位的DNAT规则组成 , 这些规则负责完成Service资源的核心功能。此外 , iptables代理模型还会额外在filter表和mangle表上 使用一些辅助类的规则。
4.1.1 ClusterIP Service
ClusterIP类型Service资源的请求流量是指以某个特定Service对象的 ClusterIP(或称为Service_IP)为目标地址 , 同时以Service_Port为目标端口的报文 , 它们可能源自Kubernetes集群中某个特定节点上的Pod、独立容器(非托管至Kubernetes集群)或进程 , 也可能源自节点之外。通常 , 源自独立容器或节点外部的请求报文的源IP地址为Pod网络(例如Flannel 默认的10.244.0.0/16)之外的IP地址。
Cluster类型Service对象的相关规则主要位于KUBE-SERVICES、KUBE MARQ-MASK和KUBE-POSTROUTING这3个自定义链 , 以及那些以KUBE-SVC或 KUBE-SEP为前缀的各个自定义链上 , 用于实现Service流量筛选、分发和目标地址转换(端点地址) , 以及为非源自Pod网络的请求报文进行源地址转换。各相关的规则链及调用关系如图所示。
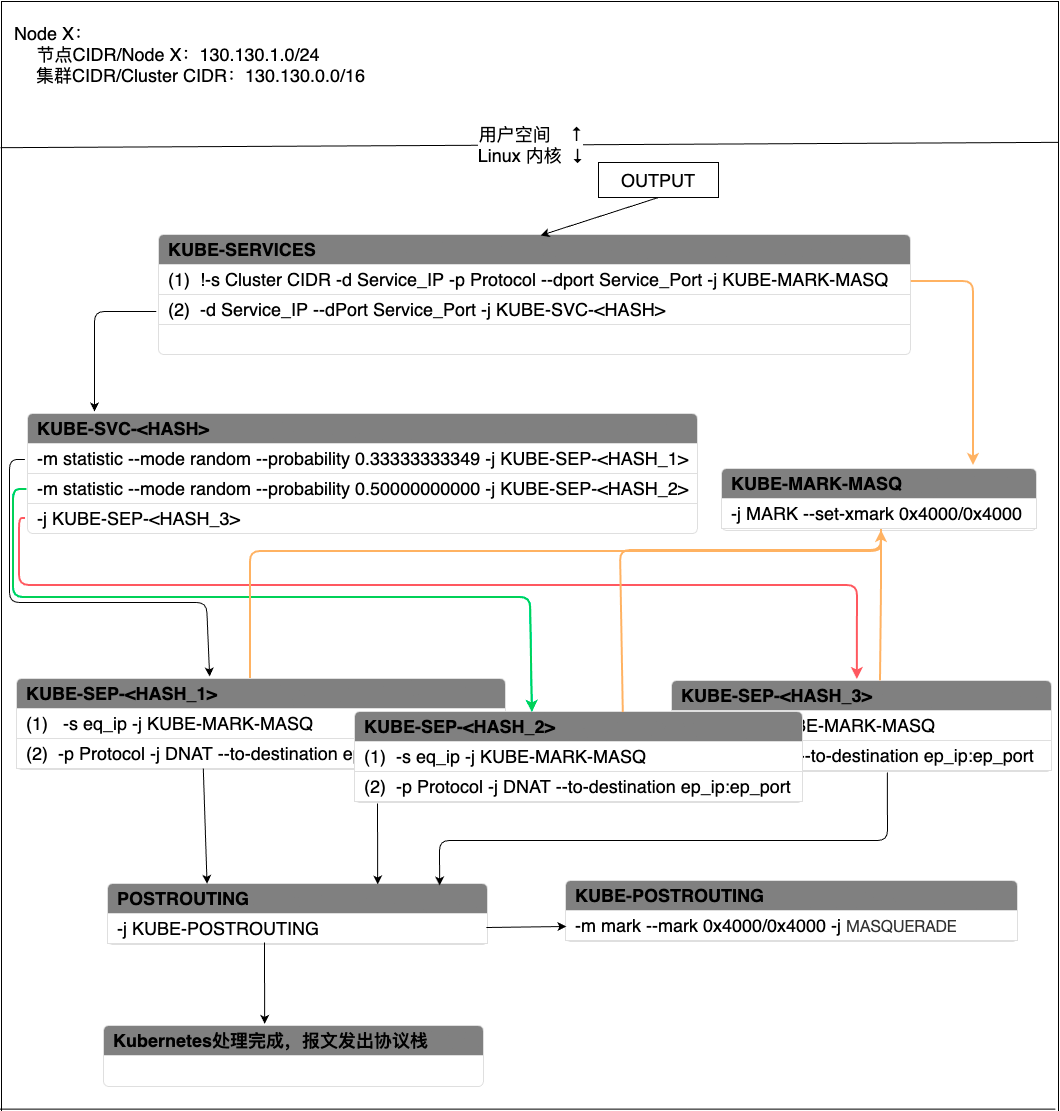
KUBE-SERVICES: 包含所有ClusterIP类型Service的流量匹配规则 , 由PREROUTING和OUTPUT两个内置链直接调用。每个Service对象包含两条规则定义 , 对于所有发往该Service( 目标IP为Service_IP且目标端口为Service_Port)的请求报文: 前一条规则用于为非源自Pod网络(! -s 130.130.0.0/16) 中的请求报文打上特有的防火墙标记 , 而打标签的操作则要借助KUBE-MARQ-MASK自定义链中的规则 , 后一条规则负责将所有报文转至专用的以KUBE-SVC为名称前缀的自定义链 , 后缀是Service信息的HASH值KUBE-MARQ-MASK: 专用目的自定义链 , 所有转至该自定义链的报文 都将被打上特有的防火墙标记(0x4000) , 以便于将特定类型的报文定义为单独的分类 , 进而在将该类报文转发到目标端点之前由POSTROUTING规则链进行源地址转换。KUBE-SVC-<HASH>: 定义一个服务的流量调度规则 , 它通过随机调度 算法将请求分发给该Service的所有后端端点 , 每个后端端点定义在以KUBE-SEP为前缀名称的自定义链上 , 后缀是端点信息的hash值。KUBE-SEP-<HASH>: 定义一个端点相关的流量处理规则。它通常包含两条规则: 前一条用于为那些源自该端点自身(-s ep_ip)的流量请求调用自定义链KUBE-MARQ-MASK, 打上特有的防火墙标记 ; 后一条负责对发往 该端点的所有流量进行目标IP地址和端口转换 , 新目标为该端点的IP和端 口(-j DNAT --to-destination ep_ip:ep_port)。KUBE-POSTROUTING: 专用的自定义链 , 由内置链POSTROUTING无条件调用 , 负责对带特有防火墙标记0x4000的请求报文进行源地址转换或地址伪装(MASQUERADE) , 新的源地址为报文离开协议栈时流经接口的主IP地址
整体处理流程如下:
【Note】: 某些链条的名字中含有
<HASH>字样 , 这是运用SHA256算法对“namespace + name + portname+协议名”生成哈希值 , 然后通过base32对该哈希值编码 , 最后取编码值的前16位的值
报文会首先进入
KUBE-SERVICES链条。KUBE-SERVICE针对每个Service会产生两条匹配规则 , 规则(1)表示如果报文的源地址不是集群内IP地址 , 同时 , 报文匹配了请求Service的协议和端口 , 那么就跳转到(-j)KUBE-MARK-MASQ链条 , 在报文中加入一个特殊的防火墙标识 , 打上这个标识的报文会在POSTROUTING阶段执行SNAT(Source Network Address Translation)。如果确实命中了规则(1) , 那么在打完标记后会继续检查规则(2) , 规则(2) 会将报文带入下一个链条—KUBE-SVC-<HASH>。KUBE-SVC-<HASH>包含了当前提供Service的后端Pod、负载均衡模式等消息。kube-proxy默认采用的随机负载算法 , 因此在这种算法下会为每个Pod分配一个命中概率。在图中 , 三个Pod被命中的概率都是三分之一。当选中一个Pod后 , 就会跳转到和Pod相对应的KUBE-SEP-<HASH>上。每个
KUBE-SEP-<HASH>和一个Pod相对应 , 且每个KUBE-SEP-<HASH>均有两条规则。规则(2) 表示对请求做DNAT, 将请求的目的地址由原来的ClusterIP:Port转换成Pod_IP:Port。这样就将Pod访问Service变成了Pod和Pod之间的访问。规则(1) 的目的是为了应对Hairpinning发夹问题而设计的:Service A的后端Pod中有可能会有某个Pod访问Service A, 然后经过iptables时又恰好选中了自己作为服务的提供方。换句话说 ,Pod要为自己发出去的服务请求做出响应。在Kubernetes中这样会造成访问失败 , 如果当出现这种场景时就跳转到KUBE-MARK-MASQ链条执行SNAT, 将请求的源地址由Pod自身变成节点的node IP, 这样就又变成了正常的服务请求和响应模式。如图所示 , 左边是没有做SNAT的场景 ,Pod A收到了一个自己发出的服务请求 , 请求的源和目的地址都是自己 , 当发送响应给自己时会导致失败。右边是借助SNAT解决Hairpinning问题的场景 ,Pod A访问自己所属服务的请求到达Linux内核时会通过SNAT将源地址由Pod A的IP变成节点的Node IP。当Pod A发送响应报文时 , 报文先发送给Node IP, 然后在Linux内核中再次进行NAT, 将源IP由Pod A的IP改成Service的IP, 目的IP由Node节点的IP改为Pod A的IP, 这样就可以正常工作了。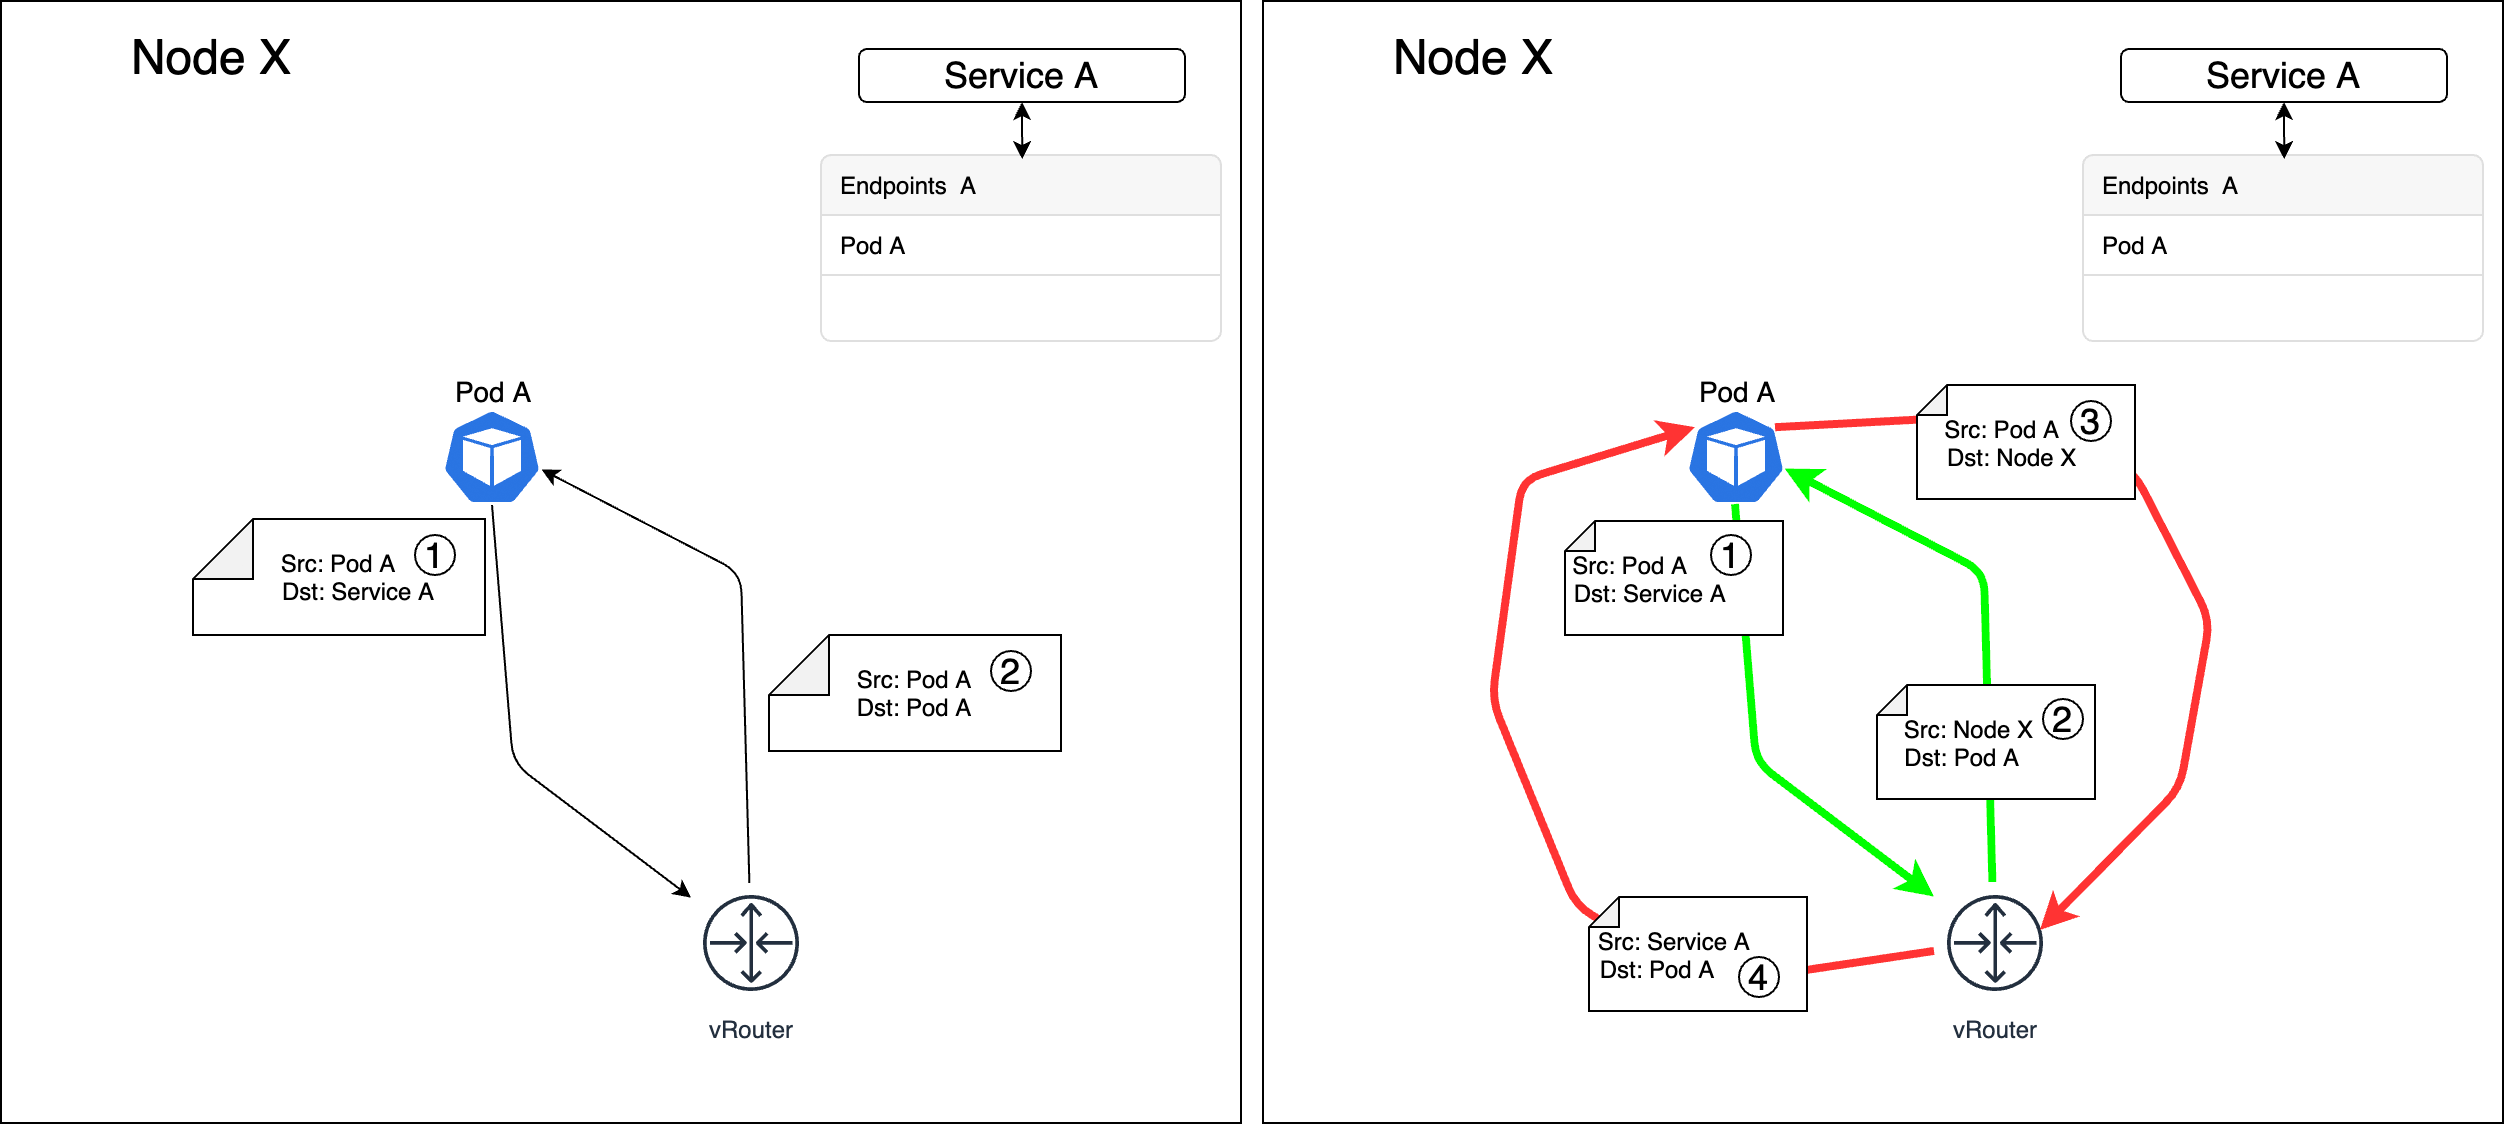
执行完
DNAT后 , 会跳转到POSTROUTING链条。POSTROUTING会无条件跳转到KUBE-POSTROUTING链条 , 这个链条会检查报文是否有跳转到KUBE-MARK-MASQ链条被打上防火墙标识 , 如果有的话就会执行SNAT, 将报文的源地址变为节点的node IP。最后由
POSTROUTING将报文发出协议栈。
我们可通过实际存在的Service对象来验证这些设定 , 以2.1节创建 的demoapp-svc为例 , 在集群中的任何一个工作节点上使用iptables -t nat -vnL或iptables -t nat -S命令打印与它相关的iptables规则。下面的命令打印了该Service对象用于流量匹配的相关规则 , 它定义在KUBE-SERVICES自定义链上。
root@k8s-node01:~# iptables -t nat -S KUBE-SERVICES | grep  "default/demoapp-svc"
-A KUBE-SERVICES ! -s 10.244.0.0/16 -d 10.97.72.1/32 -p tcp -m comment --comment "default/demoapp-svc:http cluster IP" -m tcp -dport 80 -j KUBE-MARK-MASQ
-A KUBE-SERVICES -d 10.97.72.1/32 -p tcp -m comment --comment "default/demoapp-svc:http cluster IP" -m tcp --dport 80 -j KUBE-SVC-ZAGXFVDPX7HH4UMW第一条规则用于将那些发往demoapp-svc的、来自10.244.0.0/16网络之外的请求报文交由自定义链KUBE-MARK-MASQ上的规则添加专用标记 0x4000 , 该条规则如下所示。
root@k8s-node01:~# iptables -t nat -S KUBE-MARK-MASQ | grep "^-A"
-A KUBE-MARK-MASQ -j MARK --set-xmark 0x4000/0x4添加标记的处理并不会短路iptables规则链KUBE-SERVICES对流量的处理 , 因此所有发往demoapp-svc的流量还会继续由后一条规则指向的、以KUBE-SVC为名称前缀的自定义链KUBE-SVC-ZAGXFVDPX7HH4UMW中的规则处理。该自定义链专用于为demoapp-svc中的所有可用端点定义流量调度规则 , 它包含如下3条规则:
root@k8s-node01:~# iptables -t nat -S KUBE-SVC-ZAGXFVDPX7HH4UMW | grep "^-A"
-A KUBE-SVC-ZAGXFVDPX7HH4UMW -m comment --comment "default/demoapp-svc:http" -m statistic --mode random --probability 0.33333333349 -j KUBE-SEP-HDIVJIPCJU2JBJVX
-A KUBE-SVC-ZAGXFVDPX7HH4UMW -m comment --comment "default/demoapp-svc:http" -m statistic --mode random --probability 0.50000000000 -j KUBE-SEP-ZAFCYSF77K72PY72
-A KUBE-SVC-ZAGXFVDPX7HH4UMW -m comment --comment "default/demoapp-svc:http" -j KUBE-SEP-FUO5ALUGHUE426HZ
注意 : 所有以
KUBE-SEP和KUBE-SVC为前缀的自定义链的名称在重新创建Service或重启Kubernetes集群后都有可能发生改变 , 但它们的引用关系 不变
这3条规则的处理目标分别为3个以KUBE-SEP为名称前缀的自定义链 , 每个链上定义了一个端点的流量处理规则 , 因而意味着该Service对象共有 3个Endpoint对象 , 所有流量将在这3个Endpoint之间随机(--mode random)分配。到达KUBE-SVC-ZAGXFVDPX7HH4UMW的流量将由这3条规则以 “短路”方式进行匹配检查和处理 , 任何一条规则处理后都不会再匹配后 续的其他规则。第一条规则将处理大约1/3(--probability 0.33333333349)的流量 , 余下的所有流量(即由第一条规则处理后余下的 2/3)将由第二条规则处理一半(--probability 0.50000000000), 再余下的所有流量都将由第三条规则处理 , 因此3个Endpoint将各自得到大约 1/3的流量。
每个Endpoint专用的自定义链以KUBE-SEP为名称前缀 , 它包含某单点端点相关的流量处理规则。以专用IP地址为10.244.1.11的Endpoint对象为 例 , 它对应于自定义链KUBE-SEP-HZPGLN57HG6GZW4O , 该链下包含两个 iptables规则 , 如下面的命令结果所示:
root@k8s-node01:~#  iptables -t nat -S KUBE-SEP-HDIVJIPCJU2JBJVX | grep "^-A"
-A KUBE-SEP-HDIVJIPCJU2JBJVX -s 10.244.1.11/32 -m comment --comment "default/demoapp-svc:http" -j KUBE-MARK-MASQ
-A KUBE-SEP-HDIVJIPCJU2JBJVX -p tcp -m comment --comment "default/demoapp-svc:http" -m tcp -j DNAT --to-destination 10.244.1.11:80 Pod对象也可能会向自己所属的Service对象发起访问请求 , 而且该请求经由OUTPUT链到达KUBE-SERVICES链后存在被调度回当前Pod对象的可能 性。第一条规则就是为该类报文添加专有的流量标记。第二条规则将接收到的所有流量进行目标地址转换(DNAT) , 新的目标为10.244.1.11:80 , 它对应Kubernetes集群上由Service对象demoapp-svc匹配到的一个特定Pod 对象。
不难猜测 , 特定节点(例如前面示例中的k8s-node01)接收到的请求报文的源地址为Pod网络中的IP地地址的 , 必然源自该节点或节点上的Pod 对象。它们的IP地址位于该节点的PodCIDR之中 , 这些流量离开节点之前无 须进行源地址转换 , 因而目标端点直接响应给客户端IP就能够正确到达请求方。而请求报文的源地址并非为Pod网络中的IP地址的 , 例如请求方为该节点上的某独立容器 , 则Service必须在其离开本节点之前 , 将请求报文的源地址转换为该节点上报文离开时要经由接口的IP地址(例如cni0上的 10.244.1.0) , 以确保响应报文可正确回送至该节点 , 并由该节点响应给相应的客户端 , 由内置链POSTROUTING所调用的自定义链KUBE-POSTROUTING 上的规则便用于实现此类功能。
root@k8s-node01:~# iptables -t nat -S KUBE-POSTROUTING | grep "^-A"
-A KUBE-POSTROUTING -m comment --comment "kubernetes service traffic requiring SNAT" -m mark --mark 0x4000/0x4000 -j MASQUERADE
由此可见 , 对于集群内部的后端端点来说 , 它们收到的请求报文的源 地址 , 要么是Pod的IP地址 , 要么是节点IP地址 , 因而直接发送响应报文给 请求方即可。但那些本身并非源自Pod或节点的请求的响应报文 , 还需要由节点自动执行一次目标地址转换 , 以便把报文送达真正的请求方。
注意:
kube-proxy也支持在iptables代理模型上使用masquerade all, 从而 对通过ClusterIP地址访问的所有请求进行源地址转换 , 但在大多数场景 中 , 这都不是必要的选择。
4.1.2 NodePort Service
相较于ClusterIP类型来说 , 所有发往NodePort类型的Service对象的请求流量的目标IP和端口分别是节点IP和NodePort , 这类报文无法由KUBE-SERVICES自定义链上那些基于Service IP和Service Port定义的流量匹配 规则所匹配 , 但会由该自定义链上的最后一条规则转给KUBE-NODEPORTS自定义链。
root@k8s-node01:~# iptables -t nat -S KUBE-SERVICES | tail -n 1
-A KUBE-SERVICES -m comment --comment "kubernetes service nodeports; NOTE: this must be the last rule in this chain" -m addrtype --dst type LOCAL -j KUBE-NODEPORTSKUBE-NODEPORTS链以类似ClusterIP Service拦截规则的方式定义了 NodePort Service对象的拦截规则 , 其中每个Service对象包含两条规则定 义。对于所有发往该Service(目标IP为该NodeIP , 目标端口为NodePort)的请求报文: 前一条规则为发往该Service对象的所有请求报文 , 基于 KUBE-MARQ-MASK自定义链中的规则打上特有的防火墙标记 ; 后一条规则负责将这些报文转至专用的、以KUBE-SVC为前缀的自定义链。以前面创建的 demoapp-nodeport-svc为例 , 它拥有以下两条iptables规则。
root@k8s-node01:~#  iptables -t nat -S KUBE-NODEPORTS | grep "default/demoapp-nodeport-svc"
-A KUBE-NODEPORTS -p tcp -m comment --comment "default/demoapp nodeport-svc:http" -m tcp --dport 31398 -j KUBE-MARK-MASQ
-A KUBE-NODEPORTS -p tcp -m comment --comment "default/demoapp nodeport-svc:http" -m tcp --dport 31398 -j KUBE-SVC-HCTPASJ7WVWOBYLM
我们已经知道 , Service对象的专用自定义链定义了一组调度规则 , 以调度发往该Service对象匹配的所有后端端点的相关流量 , 而其中的每一个后端端点又有自己专用的自定义链 , 用于对请求报文进行目标地址转换。 另外 , NodePort类型的Service为所有从NodePort进入的请求报文都打了特有防火墙标记 , 因此这些请求报文会按照POSTROUTING和KUBE-POSTROUTING 链上的规则将源地址转换为该报文离开节点时所经由的接口的IP地址。这些处理步骤与ClusterIP类型的Service对象几乎完全相同。完整的处理流程如图所示
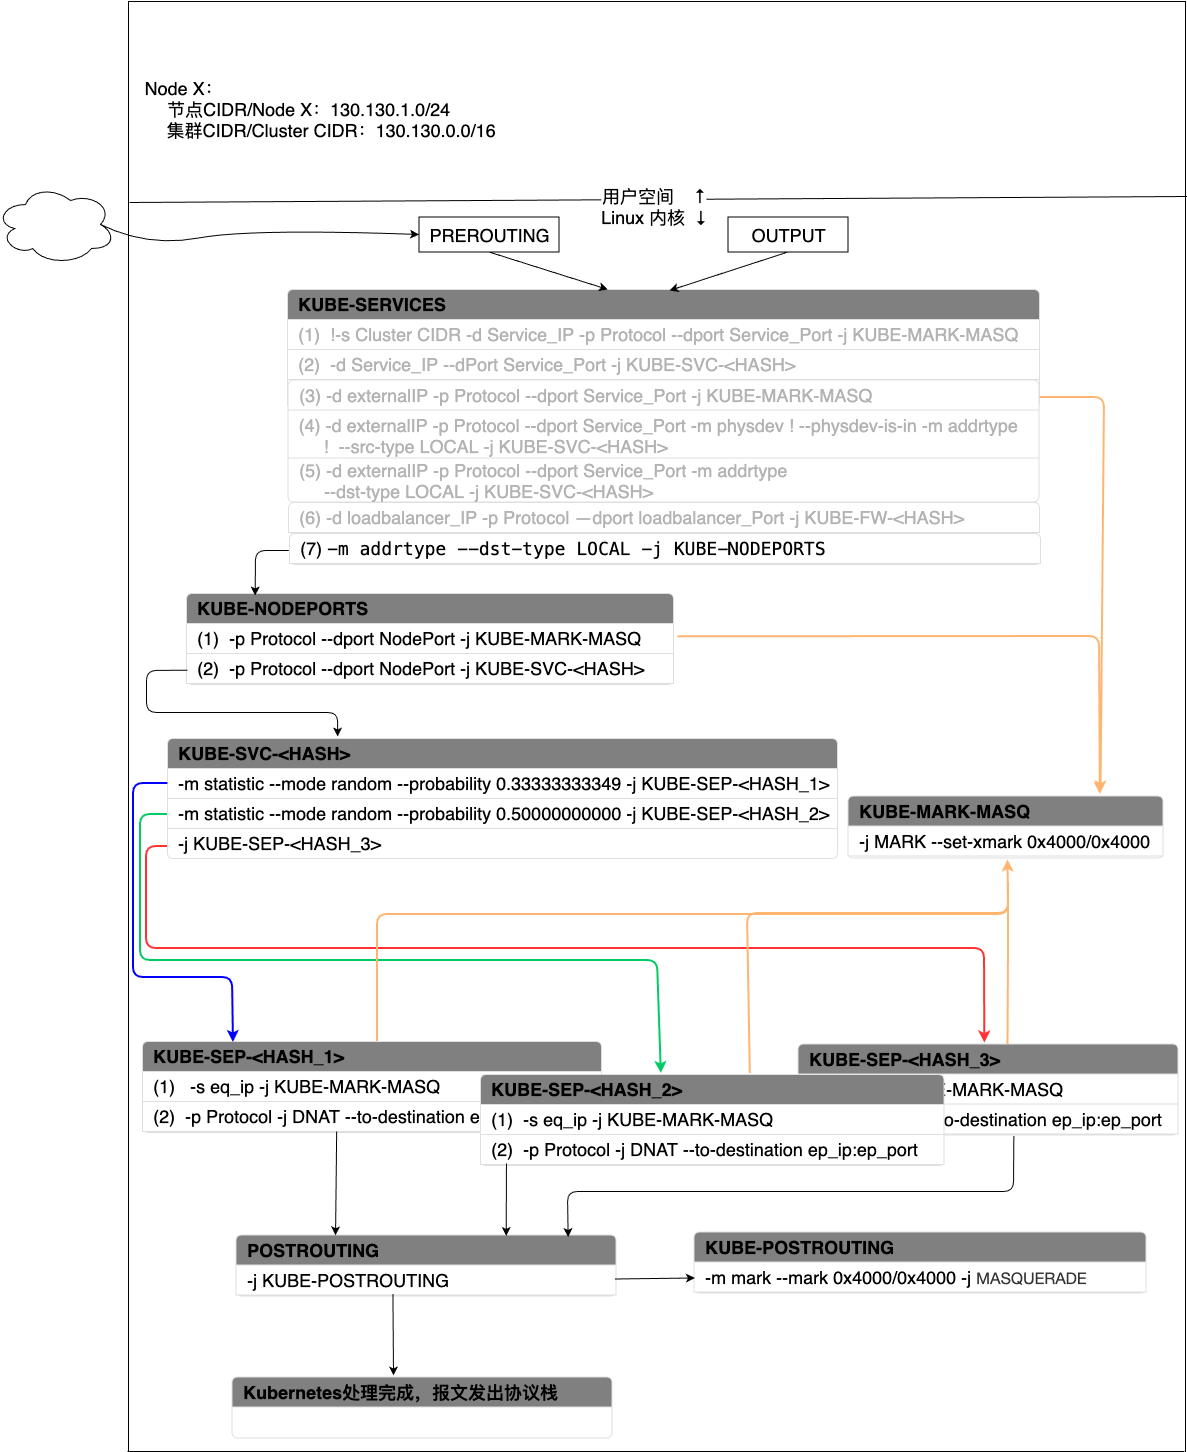
如果流量是通过
NodePort流入集群 , 且目的地址是当前节点上地址范围内的地址 , 那么就命中了KUBE-SERVICE的规则(7), 流量被转入到KUBE-NODEPORTS。当流量进入
KUBE-NODEPORTS中后 , 首先跳转到KUBE-MARK-MASQ, 为该报文打上执行SNAT的标记。之后会将流量转入到KUBE-SVC-<HASH>。之后就按照
Cluster IP模式进行流量转发、处理和响应。
对于集群内部的后端端点来说 , 它们收到的请求报文的源地址都是节点IP地址。以Flannel插件环境中10.244.1.0/24这个Pod CIDR为例 , 该IP 地址可能是flannel.1接口上的10.244.1.0/24 , 也可能是cni0上的 10.244.1.1/24。于是 , 后端端点会把报文响应给请求报文进入时的节点 , 再由该节点将目标地址转换为客户端IP后发送。
但是 , 对于将外部流量策略定义为Local的NodePort Service对象来说 , 由于流量报文不会在集群内跨节点转发 , 也就没有必要对请求报文进 行SNAT操作 , 所以后端端点可以看到真实的客户端IP。它的具体处理流程如图所示
当externalTrafficPolicy=Local时 , 会通过KUBE-XLB-<HASH>将流量转发到Pod上。此时KUBE-XLB-<HASH>中只会有当前节点上部署的提供特定Service的Pod规则信息 , 如果当前节点没有满足条件的Pod , 会生成KUBE-MARK-DROP规则将流量丢弃。流量匹配过程如图所示
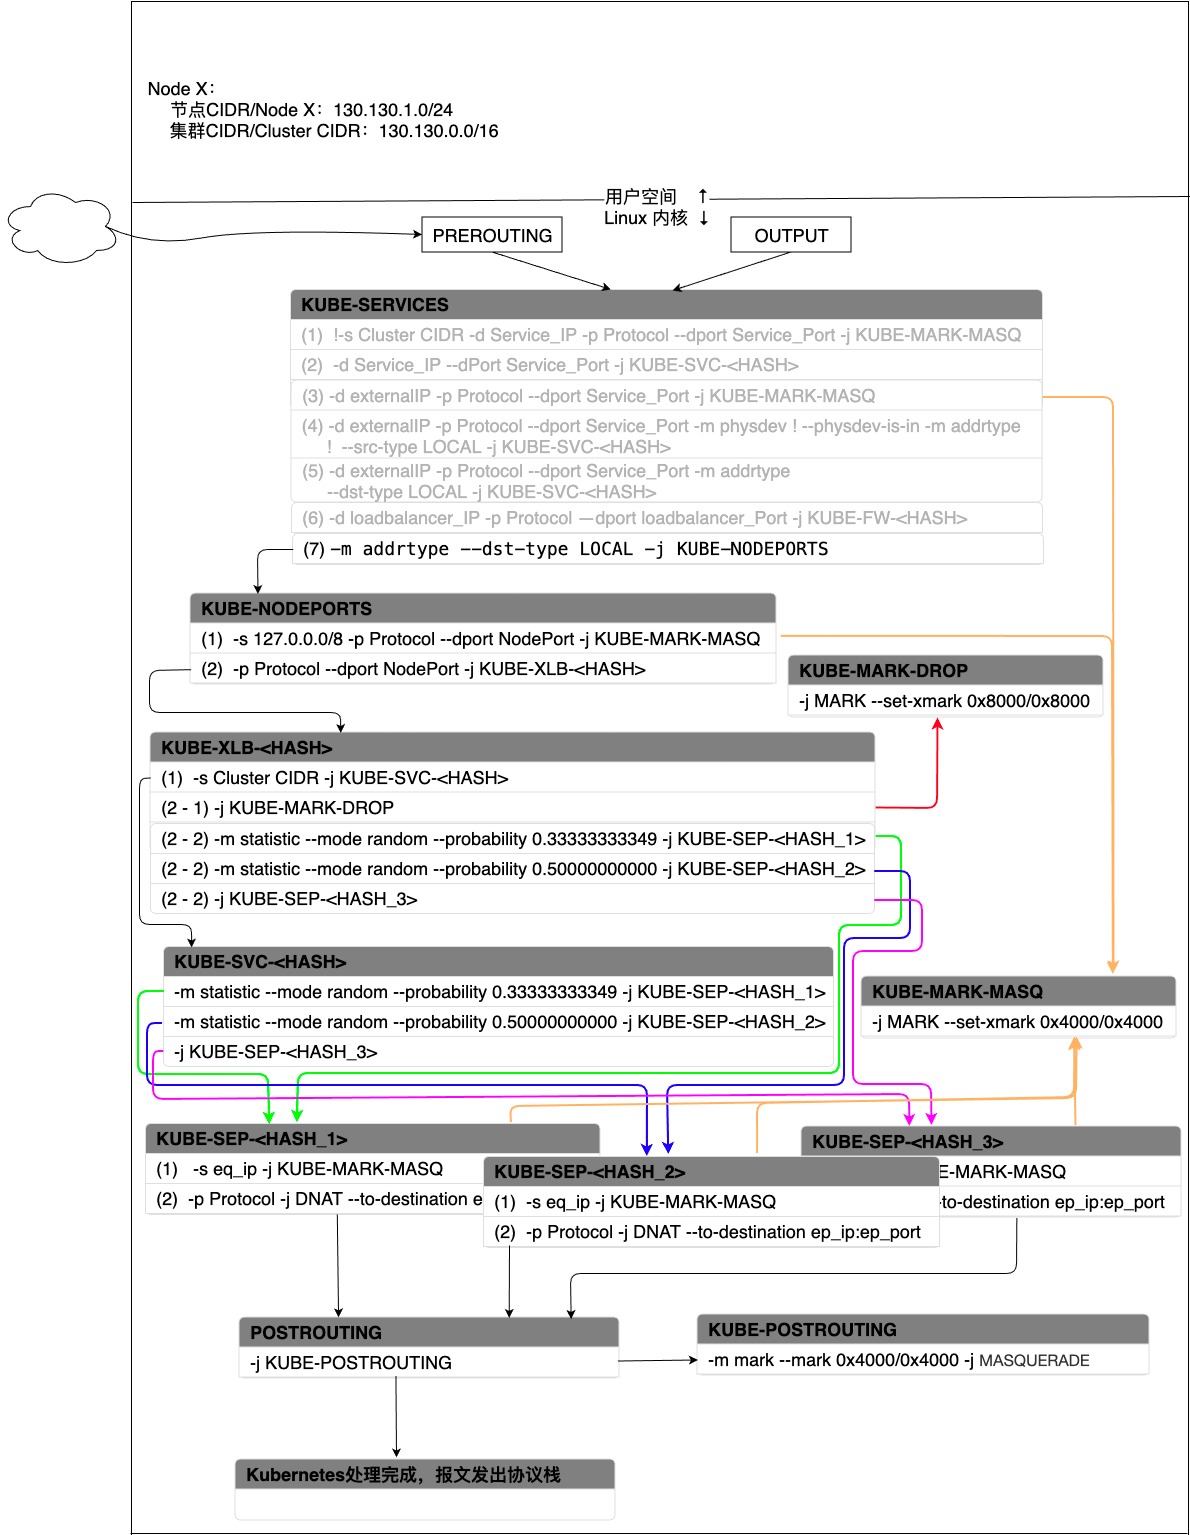
KUBE-SERVICES链把目标地址指向当前节点的报文 , 并转给KUBE NODEPORTS处理。对于一个
Local策略的NodePort Service来说 ,KUBE-NODEPORTS会 定义两条规则 : 前一条负则将源地址位于127.0.0.0/8网络的请求报文借助KUBE-MARK-MASQ打上0x4000防火墙标记 ; 后一条则将报文转给该Service专用的KUBE-XLB-自定义链。KUBE-XLB-自定义链将源自Pod网络(10.244.0.0/16)的请求报文以类似ClusterIP Service使用的方式进行处理 , 只转换请求报文目 标地址 ; 将源自当前节点所处的本地网络中的请求报文 , 按照常规的NodePort Service使用的方式进行处理 , 并同时转换源地址和目标地址 ; 而将其他类型的请求报文直接转交给指定的本地后端端点处理 , 这也体现 了本地流量策略的真正意义。
显然 , 若某节点自身未运行NodePort Service后端Pod , 则本地策略类型的请求将得到失败的响应结果。
提示: 未配置外部
IP地址的LoadBalancer类型的Service对象的工作方式与NodePort类型几乎完全相同 , 这里不再专门描述。
4.1.3 External IP
在iptables中 , 外部IP表现为一种专有的Service访问入口。在KUBE_SERVICES自定义链上 , 每个外部IP都有3条相关的iptables规则 : 第1条用 于为发往该外部IP的服务端口的请求流量 , 借助KUBE-MARK-MASQ自定义链打上特有的防火墙标记0x4000 ; 第2条将这些请求流量中从非物理接口进入 且源地址类型不是本地地址的流量 , 交由相应Service的专用自定义链进行 流量分发 ; 第3条用于将这些流量中目标地址类型是本地地址的请求报文 , 也交由相应Service的专用自定义链进行流量分发。具体的处理过程如图所示。
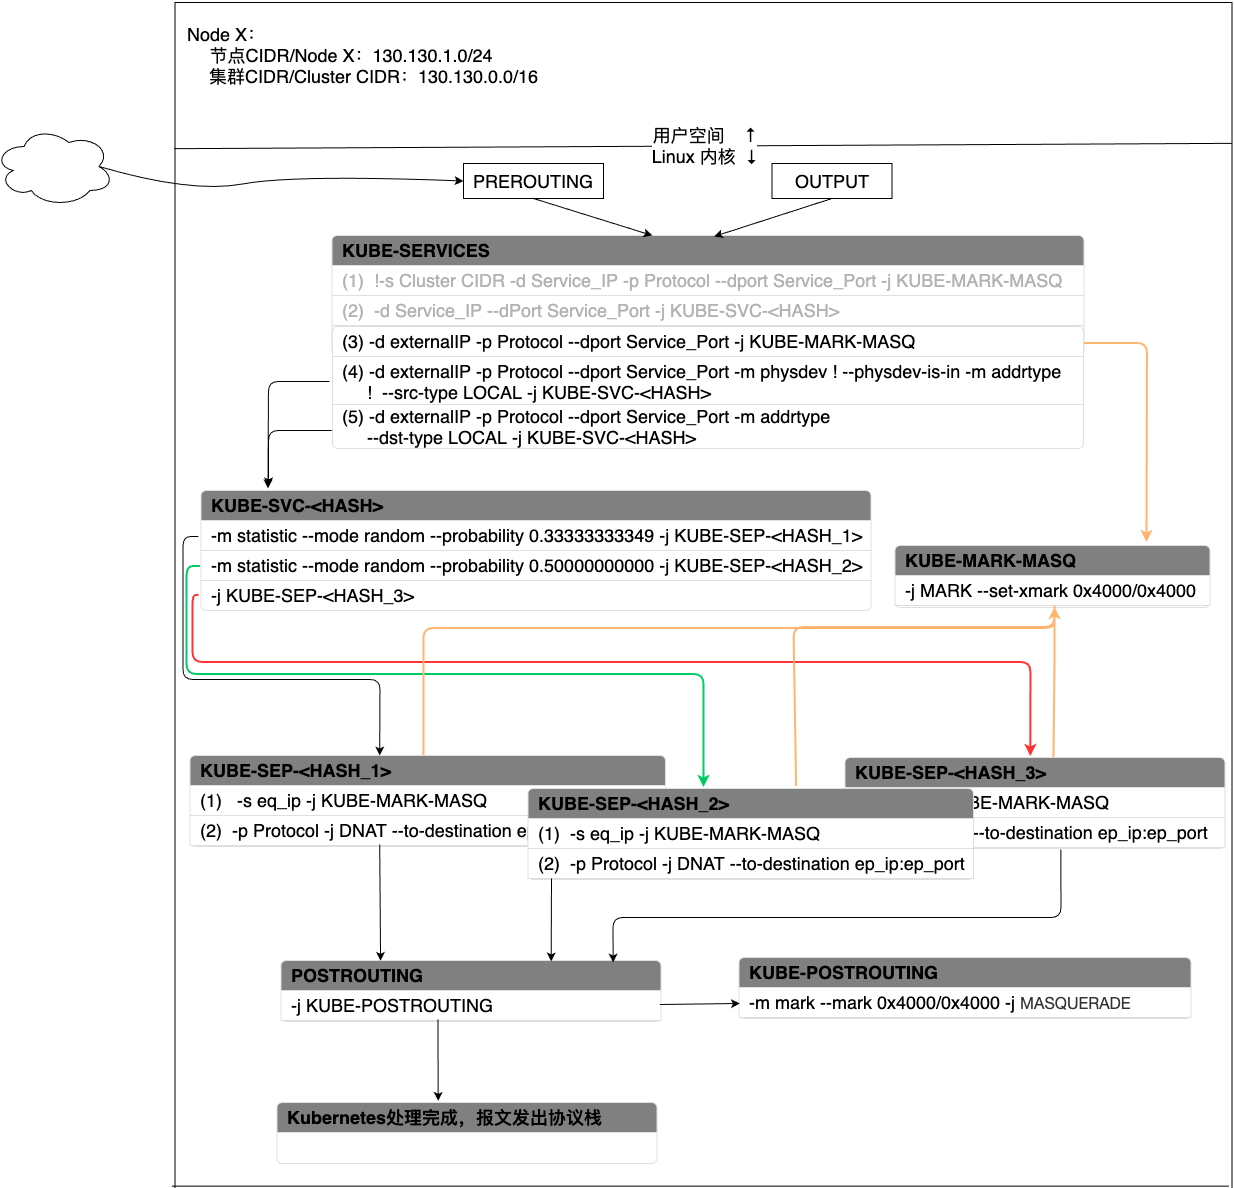
以前面定义的default/demoapp-externalip-svc中使用的外部IP 172.29.9.26为例 , 下面的命令可以在KUBE-SERVICES获取到相应的专用规则。
root@k8s-node01:~# iptables -t nat -S KUBE-SERVICES | grep  "172.29.9.26"
-A KUBE-SERVICES -d 172.29.9.26/32 -p tcp -m comment --comment  "default/demoapp-externalip-svc:http external IP" -m tcp --dport 80  -j KUBE-MARK-MASQ
-A KUBE-SERVICES -d 172.29.9.26/32 -p tcp -m comment --comment "default/demoapp-externalip-svc:http external IP" -m tcp --dport 80 m physdev ! --physdev-is-in -m addrtype ! --src-type LOCAL -j KUBE-SVC-PX62EIGZ4HAB6Y56
-A KUBE-SERVICES -d 172.29.9.26/32 -p tcp -m comment --comment "default/demoapp-externalip-svc:http external IP" -m tcp --dport 80 -m addrtype --dst-type LOCAL -j KUBE-SVC-PX62EIGZ4HAB6Y56
由此可见 , 尽管外部IP需要结合ClusterIP、NodePort或LoadBalancer 中任一类型的Service对象使用 , 但到达外部IP的服务请求流量却有着专用的拦截规则 , 请求报文也是交由相应Service的专用自定义链直接进行向后分发。
4.2 ipvs代理模型
由前一节的介绍可知 , 单个Service对象的iptables数量与后端端点的数量正相关 , 对于拥有较多Service对象和大规模Pod对象的Kubernetes集群 , 每个节点的内核上将充斥着大量的iptables规则。Service对象的变动会导致所有节点刷新netfilter上的iptables规则 , 而且每次的Service请求也都将经历多次的规则匹配检测和处理过程 , 这会占用节点上相当比例的系统资源。因此 , iptables代理模型不适用于Service和Pod数量较多的集群。ipvs代理模型通过将流量匹配和分发功能配置为少量ipvs规则 , 有效降低了对系统资源的占用 , 从而能够承载更大规模的Kubernetes集群。
4.2.1 调整kube-proxy代理模型
kube-proxy使用的代理模型定义在配置文件中 , kubeadm部署的 Kubernetes集群以DaemonSet控制器编排kube-proxy在每个节点上运行一个实例 , 配置文件则以kube-system名称空间中名为kube-proxy的ConfigMap 对象的形式提供 , 默认使用iptables代理模型。在测试集群环境中 , 可直接使用kubectl edit configmaps/kube-proxy -n kube-system命令编辑该 ConfigMap对象 , 将代理模型修改为ipvs , 配置要点如下所示。
data:
  config.conf: |-
    apiVersion: kubeproxy.config.k8s.io/v1alpha1
    bindAddress: 0.0.0.0
    ……
    iptables:                 # iptables配置细节
      masqueradeAll: false    # 是否将通过ClusterIP访问的流量全部进行
SNAT
      masqueradeBit: null
      minSyncPeriod: 0s
      syncPeriod: 0s
    ipvs:                     # ipvs配置细节
      excludeCIDRs: null
      minSyncPeriod: 0s
      scheduler: ""           # 调度算法 , 默认为rr
      strictARP: false
      syncPeriod: 0s
      tcpFinTimeout: 0s
      tcpTimeout: 0s
      udpTimeout: 0s
    kind: KubeProxyConfiguration
    metricsBindAddress: ""
    mode: "ipvs"              # 代理模型 , 空值代表是iptables
    nodePortAddresses: null
    ……
配置完成后 , 以灰度模式手动逐个或分批次删除kube-system名称空间中kube-proxy旧版本的Pod实例 , 全部更新完成后便切换到了ipvs代理模型。或者 , 在测试环境中 , 可以直接使用如下命令一次性完成所有实例的 强制更新。
~$ kubectl delete pods -l k8s-app=kube-proxy -n kube-system提示: 用于生产环境时 , 建议在部署
Kubernetes集群时直接选定要使用的代理模型 , 或在集群部署完成后立即调整代理模型 , 而后再部署其他应用。
4.2.2 ipvs代理模型下的Service资源
相较于iptables代理模型的复杂表示逻辑 , ipvs的代理逻辑也较为简 单 , 它仅有两个关键配置要素。首先 , kube-proxy会在每个节点上创建一 个名为kube-ipvs0的虚拟网络接口 , 并将集群上所有Service对象的 ClusterIP和ExternalIP配置到该接口 , 使相应IP地址的流量都可被当前节点捕获。其次 , kube-proxy会为每个Service生成相关的ipvs虚拟服务器 (Virtual Server)定义 , 该虚拟服务器的真实服务器(Real Server)是由相应Service对象的后端端点组成 , 到达虚拟服务器VIP(虚拟IP地址)上的服务端口的请求流量由默认或指定的调度算法分发至相关的各真实服务器。
但kube-proxy对ClusterIP和NodePort类型Service对象的虚拟服务定 义方式略有不同。对于每个ClusterIP类型的Service , kube-proxy仅针对 Service_IP生成单个虚拟服务 , 协议和端口遵循Service的定义。以前面创 建的demoapp-svc为例 , 它的ClusterIP是10.97.72.1 , 它的虚拟服务定义如下 , 这些可以通过ipvsadm -Ln命令在集群中的任意一个节点上获取。
root@k8s-node01:~# ipvsadm -Ln | grep -A 3 "10.97.72.1"
TCP  10.97.72.1:80 rr
  -> 10.244.1.11:80              Masq    1      0          0
  -> 10.244.2.7:80               Masq    1      0          0
-> 10.244.3.9:80 Masq 1 0 0而对于NodePort类型Service , kube-proxy会针对kube-ipvs0上的 Service_IP:Service_Port , 以及当前节点上的所有活动接口的主IP地址的 NodePort各定义一个虚拟服务 , 下面的命令用于获取前面创建的NodePort 类型Service对象的demoapp-nodeport-svc的相关虚拟服务的定义。
root@k8s-node01:~# ipvsadm -Ln | grep -E "31398|10.97.56.1"
TCP  172.29.9.11:31398 rr     # 节点IP
TCP  10.97.56.1:80 rr         # ClusterIP
TCP  10.244.1.0:31398 rr      # flannel.1接口IP
TCP  10.244.1.1:31398 rr      # cni0接口IP
TCP  127.0.0.1:31398 rr       # lo接口IP
TCP 172.17.0.1:31398 rr # docker0接口IP LoadBalancer类型Service的配置方式与NodePort类型相似 , 这里不再单独说明。另外 , 对于每个ExternalI , kube-proxy也会根据每个ExternalIP:Service_Port的组合生成一个虚拟服务 , 下面的命令及结果显 示出前面创建的外部IP地址172.29.9.26相关的虚拟服务。
root@k8s-node01:~# ipvsadm -Ln | grep  "172.29.9.26"
TCP 172.29.9.26:80 rr上述每种Service类型对应的所有虚拟服务内部同样都使用NAT模式进行请求代理 , 除了更加多样的调度算法选择外 , 它的转发性能并没有显著 提升 , 不过因为避免了使用大量的iptables规则 , 所以系统资源开销显著 降低。ipvs仅实现了代理和调度机制 , Service资源中的报文过滤和源地址 转换等功能 , 依旧要由iptables完成 , 但相应的规则数量较少且较为固定。
5. Kubernetes服务发现
通常 , 稍有规模的系统架构都需要抽象出相当数量的服务 , 这些服务间可能存在复杂的依赖关系和通信模型 , 考虑到容器编排环境的动态特性 , 让客户端获知服务端的地址便成了难题之一。Kubernetes 系统上的Service为Pod中的服务类应用提供了一个固定的访问入口 , 但Pod客户端中的应用还需要借助服务发现机制获取特定服务的IP和端口。
5.1 服务发现概述
简单来说 , 服务发现就是服务或者应用之间互相定位的过程 , 它 并非什么新概念 , 传统的单体应用动态性不强 , 更新和重新发布频度 较低 , 通常以月甚至以年计 , 几乎无须进行自动伸缩 , 因此服务发现 的概念无须显性强调。通常 , 传统的单体应用网络位置发生变化时 , 由IT运维人员手工更新一下相关的配置文件基本就能解决问题。但在 遵循微服务架构设计理念的场景中 , 应用被拆分成众多小服务 , 各服务实例按需创建且变动频繁 , 配置信息基本无法事先写入配置文件中 并及时跟踪反映动态变化 , 服务发现的重要性便随之凸显。
服务发现机制的基本实现 , 一般是事先部署好一个网络位置较为稳定的服务注册中心(也称为服务总线) , 由服务提供者(服务端)向注册中心注册自己的位置信息 , 并在变动后及时予以更新 , 相应地 , 服务消费方周期性地从注册中心获取服务提供者的最新位置信 息 , 从而“发现”要访问的目标服务资源。复杂的服务发现机制还会让服务提供者提供其描述信息、状态信息及资源使用信息等 , 以供消费者实现更为复杂的服务选择逻辑。
实践中 , 根据其发现过程的实现方式 , 服务发现还可分为两种类型 : 客户端发现和服务端发现。
客户端发现 : 由客户端到服务注册中心发现其依赖的服务的相关信息 , 因此 , 它需要内置特定的服务发现程序和发现逻辑。
服务端发现 : 这种方式额外要用到一个称为中央路由器或服务均衡器的组件 ; 服务消费者将请求发往中央路由器或者负载均衡器 , 由它们负责查询服务注册中心获取服务提供者的位置信息 , 并将服务消费者的请求转发给服务提供者。
由此可见 , 服务注册中心是服务发现得以落地的核心组件。事实上 , DNS可以算是最为原始的服务发现系统之一 , 但在服务的动态性很 强的场景中 , DNS记录的传播速度可能会跟不上服务的变更速度 , 因此它并不适用于微服务环境。
在传统实践中 , 常见的服务注册中心是ZooKeeper和etcd等分布式键值存储系统 , 它们可提供基本的数据存储功能 , 但距离实现完整的 服务发现机制还有大量的二次开发任务需要完成。而且 , 它们更注重数据一致性而不得不弱化可用性(分布式系统的CAP理论) , 这背离了微服务发现场景中更注重服务可用性的需求。
Netflix的Eureka是专用于服务发现的分布式系统 , 遵从“存在少量的错误数据 , 总比完全不可用要好”的设计原则 , 服务发现和可用性是其核心目标 , 能够在多种故障期间保持服务发现和服务注册的功能。另一个同级别的实现是Consul , 它于服务发现的基础功能之外还 提供了多数据中心的部署等一众出色的特性。Consul是由HashiCorp公司提供的商业产品 , 同时提供了一个开源基础版本。
尽管传统的DNS系统不适于微服务环境中的服务发现 , 但SkyDNS项目结合古老的DNS技术和时髦的Go语言、Raft算法 , 并构建于etcd存储系统之上 , 为Kubernetes系统实现了一种独特且实用的服务发现机制。Kubernetes在v1.3版本引入的KubeDNS由kubedns、dnsmasq和 sidecar这3个部分组合而成。第一个部分包含kubedns和skydns两个组件 , 前者负责将Service和Endpoint转换为SkyDNS可以理解的格式 ; 第二部分用于增强解析功能 ; 第三部分为前两者添加健康状态检查机 制 , 因而我们可以把KubeDNS视为SkyDNS的增强版。
而另一个基于DNS较新的服务发现项目是由CNCF(Cloud Native Computing Foundation)孵化的CoreDNS , 它基于Go语言开发 , 通过串接一组实现DNS功能的插件的插件链实现所有功能 , 也允许用户自行开 发和添加必要的插件 , 但所有功能运行在单个容器之中。另外 , CoreDNS使用Caddy作为底层的Web Server , 可以支持以UDP、TLS、 gRPC和HTTPS等方式对外提供DNS服务。自Kubernetes 1.11版本起 , CoreDNS取代kubeDNS成为默认的DNS附件。
5.2 基于环境变量的服务发现
创建Pod资源时 , kubelet会将其所属名称空间内的每个活动的 Service对象以一系列环境变量的形式注入其中。它支持使用 Kubernetes Service环境变量以及与Docker的Link兼容的变量。
Kubernetes Service环境变量Kubernetes为每个Service资源生成包括以下形式的环境变量在内的一系列环境变量 , 在同一名称空间中创建的Pod对象都会自动拥有这 些变量 :{SVCNAME}_SERVICE_HOST{SVCNAME}_SERVICE_PORT
注意 : 如果
SVCNAME中使用了连接线 ,Kubernetes会在定义环境变量时将其转换为下划线。Docker Link形式的环境变量Docker使用--link选项实现容器连接时所设置的环境变量形式 , 具体使用方式请参考Docker的相关文档。在创建Pod对象时 ,Kubernetes也会把与此形式兼容的一系列环境变量注入Pod对象中。例如 , 在
Service资源demoapp-svc创建后创建的Pod对象中查看可用的环境变量 , 其中以DEMOAPP_SVC_SERVICE开头的为Kubernetes Service环境变量 , 名称中不包含SERVICE字符串的环境变量为Docker Link形式的环境变量。下面的命令创建了一个临时Pod对象 , 并在其命 令行列出与demoapp-svc的相关环境变量。~$ kubectl run client-pod --image=ikubernetes/admin-toolbox:v1.0 -it --command -- /bin/sh [root@client-pod /]# printenv | grep DEMOAPP_SVC DEMOAPP_SVC_SERVICE_PORT_HTTP=80 DEMOAPP_SVC_SERVICE_HOST=10.97.72.1 DEMOAPP_SVC_SERVICE_PORT=80 DEMOAPP_SVC_PORT=tcp://10.97.72.1:80 DEMOAPP_SVC_PORT_80_TCP_ADDR=10.97.72.1 DEMOAPP_SVC_PORT_80_TCP_PORT=80 DEMOAPP_SVC_PORT_80_TCP_PROTO=tcp DEMOAPP_SVC_PORT_80_TCP=tcp://10.97.72.1:80基于环境变量的服务发现功能简单、易用 , 但存在一定局限 , 例如只有那些与新建
Pod对象在同一名称空间中且事先存在的Service对 象的信息才会以环境变量形式注入 , 而那些不在同一名称空间 , 或者在Pod资源创建之后才创建的Service对象的相关环境变量则不会被添加。
5.3 基于DNS的服务发现
名称解析和服务发现是Kubernetes系统许多功能得以实现的基础 服务 , ClusterDNS通常是集群安装完成后应该立即部署的附加组件。 Kubernetes集群上的每个Service资源对象在创建时都会被自动指派一 个遵循<service>.<ns>.svc.<zone>格式的名称 , 并由ClusterDNS为该名称自动生成资源记录 , service、ns和zone分别代表服务的名称、名称空间的名称和集群的域名。例如demoapp-svc的DNS名称为demoapp-svc.default.svc.cluster.local. , 其中cluster.local.是未明确指定域名后缀的集群默认使用的域名。
无论使用kubeDNS还是CoreDNS , 它们提供的基于DNS的服务发现解决方案都会负责为该DNS名称解析相应的资源记录类型以实现服务发现。以拥有ClusterIP的多种Service资源类型(ClusterIP、NodePort和LoadBalancer)为例 , 每个Service对象都会具有以下3个类型的DNS 资源记录。
根据
ClusterIP的地址类型 , 为IPv4生成A记录 , 为IPv6生成AAAA记录。<service>.<ns>.svc.<zone>. <ttl> IN A <cluster-ip><service>.<ns>.svc.<zone>. <ttl> IN AAAA <cluster-ip>
为每个定义了名称的端口生成一个
SRV记录 , 未命名的端口号则不具有该记录。_<port>._<proto>.<service>.<ns>.svc.<zone>. <ttl> IN SRV <weight> <priority> <port-number> <service>.<ns>.svc.<zone>.
对于每个给定的
A记录(例如a.b.c.d)或AAAA记录(例如a1a2a3a4:b1b2b3b4:c1c2c3c4:d1d2d3d4:e1e2e3e4:f1f2f3f4:g1g2g3g 4:h1h2h3h4)都要生成PTR记录 , 它们各自的格式如下所示 :<d>.<c>.<b>.<a>.in-addr.arpa. <ttl> IN PTR <service>.<ns>.svc.<zone>.h4.h3.h2.h1.g4.g3.g2.g1.f4.f3.f2.f1.e4.e3.e2.e1.d4.d3.d2.d1.c4.c3.c2.c1.b4.b3.b2.b1.a4.a3.a2.a1.ip6.arpa IN PTR <service>.<ns>.svc.<zone>.
例如 , 前面在default名称空间中创建的Service对象demoapp-svc 的地址为10.97.72.1 , 且为TCP协议的80端口取名http , 对于默认的 cluster.local域名来说 , 它会拥有如下3个DNS资源记录。
A记录 :demoapp-svc.default.svc.cluster.local. 30 IN A 10.97.72.1SRV记录 :_http._tcp.demoapp svc.default.svc.cluster.local. 30 IN SRV 0 100 80 demoapp svc.default.svc.cluster.local.PTR记录 :1.72.97.10.in-addr.arpa. 30 IN PTR demoapp svc.default.svc.cluster.local。
kubelet会为创建的每一个容器在/etc/resolv.conf配置文件中生成DNS查询客户端依赖的必要配置 , 相关的配置信息源自kubelet的配置参数。各容器的DNS服务器由clusterDNS参数的值设定 , 它的取值为 kube-system名称空间中的Service对象kube-dns的ClusterIP , 默认为 10.96.0.10 , 而DNS搜索域的值由clusterDomain参数的值设定 , 若部署Kubernetes集群时未特别指定 , 其值将为cluster.local、svc.cluster.local和NAMESPACENAME.svc.cluster.local。下面的示例取自集群上一个随机选择的Pod中的容器。
nameserver 10.96.0.10
search default.svc.cluster.local svc.cluster.local
cluster.local
options ndots:5上述search参数中指定的DNS各搜索域 , 是以次序指定的几个域名后缀 , 它们各自的域名如下所示。
<ns>.svc.<zone>: 附带有特定名称空间的域名 , 例如default.svc.cluster.local。svc.<zone>: 附带了Kubernetes标识Service专用子域svc的域 名 , 例如svc.cluster.local。<zone>: 集群本地域名 , 例如cluster.local。
各容器能够直接向集群上的ClusterDNS发起服务名称和端口名称 解析请求完成服务发现 , 各名称也支持短格式 , 由搜索域自动补全相 关的后缀。我们可以在Kubernetes集群上通过任意一个有nslookup等 DNS测试工具的容器进行测试。下面基于此前创建专用于测试的客户端 Pod对象client-pod的交互式接口完成后续测试操作。
~$ kubectl exec -it client-pod -- /bin/sh
[root@client-pod /]#
接下来便可以进行名称解析测试。例如 , 下面的命令用于请求同 一名称空间(default)中的服务名称demoapp-svc的解析结果 , 并获得了正确的返回值。
[root@client-pod /]# nslookup -query=A demoapp-svc
Server:         10.96.0.10
Address:        10.96.0.10#53
Name:   demoapp-svc.default.svc.cluster.local
Address: 10.97.72.1ClusterDNS解析demoapp-svc服务名称的搜索次序依次是 default.svc.cluster.local、svc.cluster.local和cluster.local , 因此基于DNS的服务发现不受Service资源所在名称空间和创建时间的限制。上面的解析结果也正是默认的default名称空间中创建的 demoapp-svc服务的IP地址。
SRV记录中的端口名称的格式_<port>._<proto>.<service>.ns.svc.<zone> , 同样可使用短格式名称。下面的命令用于请求解析 demoapp-svc上的http端口 , 它返回的结果为80。
[root@client-pod ~]# nslookup -query=SRV _http._tcp.demoapp-svc
Server:         10.96.0.10
Address:        10.96.0.10#53
_http._tcp.demoapp-svc.default.svc.cluster.local        service
= 0 100 80 demoapp-svc.default.svc.cluster.local.请求解析其他名称空间中的Service对象名称时需要明确指定服务 名称和名称空间 , 下面以kube-dns.kube-system为例进行解析请求。
[root@client-pod /]# nslookup -query=A kube-dns.kube-system
Server:         10.96.0.10
Address:        10.96.0.10#53
Name:   kube-dns.kube-system.svc.cluster.local
Address: 10.96.0.10端口名称解析时同样需要指定Service名称及其所在的名称空间 , 下面的命令用于请求解析kube-dns.kube-system上的metrics端口 , 它返回了9153的端口号。
[root@client-pod /]# nslookup -query=SRV _metrics._tcp.kube
dns.kube-system
Server:         10.96.0.10
Address:        10.96.0.10#53
_metrics._tcp.kube-dns.kube-system.svc.cluster.local    service
= 0 100 9153 kube-dns.kube-system.svc.cluster.local.
为了减少搜索次数 , 无论是否处于同一名称空间 , 客户端都可以 直接使用FQDN格式的名称解析Service名称和端口名称 , 这也是在某应用的配置文件中引用其他服务时建议遵循的方式。
5.4 Pod的DNS解析策略与配置
Kubernetes还支持在单个Pod资源规范上自定义DNS解析策略和配 置 , 它们分别使用spec.dnsPolicy和spec.dnsConfig进行定义 , 并组合生效。目前 , Kubernetes支持如下DNS解析策略 , 它们定义在 spec.dnsPolicy字段上。
Default: 从运行所在的节点继承DNS名称解析相关的配置。ClusterFirst: 在集群DNS服务器上解析集群域内的名称 , 其他域名的解析则交由从节点继承而来的上游名称服务器。ClusterFirstWithHostNet: 专用于在设置了hostNetwork的Pod对象上使用的ClusterFirst策略 , 任何配置了hostNetwork的Pod对象 都应该显式使用该策略。None: 用于忽略Kubernetes集群的默认设定 , 而仅使用由dnsConfig自定义的配置。
Pod资源的自定义DNS配置要通过嵌套在spec.dnsConfig字段中的 如下几个字段进行 , 它们的最终生效结果要结合dnsPolicy的定义生成。
nameservers <[]string>:DNS名称服务器列表 , 它附加在由dnsPolicy生成的DNS名称服务器之后。searches <[]string>:DNS名称解析时的搜索域 , 它附加在dnsPolicy生成的搜索域之后。options <[]Object>:DNS解析选项列表 , 它将会同dnsPolicy生成的解析选项合并成最终生效的定义。
下面配置清单示例(pod-with-dnspolicy.yaml)中定义的Pod资源完全使用自定义的配置 , 它通过将dnsPolicy设置为None而拒绝从节点继承DNS配置信息 , 并在dnsConfig中自定义了要使用的DNS服务、搜索域和DNS选项。
apiVersion: v1
kind: Pod
metadata:
  name: pod-with-dnspolicy
  namespace: default
spec:
  containers:
  - name: demo
    image: ikubernetes/demoapp:v1.0
    imagePullPolicy: IfNotPresent
  dnsPolicy: None
  dnsConfig:
    nameservers:
    - 10.96.0.10
    - 223.5.5.5
    - 223.6.6.6
    searches:
    - svc.cluster.local
    - cluster.local
    - ilinux.io
    options:
    - name: ndots
value: "5"将上述配置清单中定义的Pod资源创建到集群之上 , 它最终会生成类似如下内容的/etc/resolv.conf配置文件。
nameserver 10.96.0.10
nameserver 223.5.5.5
nameserver 223.6.6.6
search svc.cluster.local cluster.local ilinux.io
options ndots:5
上面配置中的搜索域要求 , 即便是客户端与目标服务位于同一名 称空间 , 也要求在短格式的服务名称上显式指定其所处的名称空间。 感兴趣的读者可自行测试其效果。
5.5 配置CoreDNS
CoreDNS是高度模块化的DNS服务器 , 几乎全部功能均由可插拔的插件实现。CoreDNS调用的插件及相关的配置定义在称为Corefile的配置文件中。CoreDNS主要用于定义各服务器监听地址和端口、授权解析的区域以及加载的插件等 , 配置格式如下 :
ZONE:[PORT] {
    [PLUGIN]...
}
参数说明如下。
ZONE: 定义该服务器授权解析的区域 , 它监听由PORT指定的端 口。PLUGIN: 定义要加载的插件 , 每个插件可能存在一系列属性 , 而每个属性还可能存在可配置的参数。
由kubeadm在部署Kubernetes集群时自动部署的CoreDNS的 Corefile存储为kube-system名称空间中名为coredns的ConfigMap对象 , 定义了一个监听53号端口授权解析根区域的服务器 , 详细的配置 信息及各插件的简单说明如下所示。
apiVersion: v1
kind: ConfigMap
metadata:
  name: coredns
  namespace: kube-system
data:
  Corefile: |
    .:53 {
        errors  # 将错误日志发往标准输出stdout
        health {
           lameduck 5s
        }       # 通过http://localhost:8080/health报告健康状态
        ready   # 待所有插件就绪后通过8181端口响应“200 OK”以报告就绪状态
        kubernetes cluster.local in-addr.arpa ip6.arpa {
           pods insecure
           fallthrough in-addr.arpa ip6.arpa
           ttl 30
        }       # Kubernetes系统的本地区域及专用的名称解析配置
        prometheus :9153  # 通过http://localhost:9153/metrics输出指标数据
        forward . /etc/resolv.conf  # 非Kubernetes本地域名的解析转发逻辑
        cache 30     # 缓存时长
        loop         # 探测转发循环并终止其过程
        reload       # Corefile内容改变时自动重载配置信息
        loadbalance  # A、AAAA或MX记录的负载均衡器 , 使用roundrobin算法
    }
在该配置文件中 , 专用于Kubernetes系统上的名称解析服务由名为kubernetes的插件进行定义 , 该插件负责处理指定的权威区域中的 所有查询 , 例如上面示例中的正向解析区域cluster.local , 以及反向 解析区域in-addr.arpa和ip6.arpa。该插件支持多个配置参数 , 例如 endpoint、tls、kubeconfig、namespaces、labels、pods、ttl和 fallthrough等 , 上面示例中用到的3个参数的功能如下。
pods POD-MODE: 设置用于处理基于Pod IP地址的A记录的工作 模式 , 以便在直接同Pod建立SSL通信时验证证书信息 ; 默认值为disabled, 表示不处理Pod请求 , 总是响应NXDOMAIN; 在其他可用值中 ,insecure表示直接响应A记录而无须向Kubernetes进行校验 , 目标 在于兼容kube-dns; 而verified表示仅在指定的名称空间中存在一个 与A记录中的IP地址相匹配的Pod对象时才会将结果响应给客户端。fallthrough [ZONES...]: 常规情况下 , 该插件的权威区域解 析结果为NXDOMAIN时即为最终结果 , 而该参数允许将该响应的请求继 续转给后续的其他插件处理 ; 省略指定目标区域时表示生效于所有区域 , 否则 , 将仅生效于指定的区域。ttl: 自定义响应结果的可缓存时长 , 默认为5秒 , 可用值范围 为[0,3600]。
那些非由kubernetes插件所负责解析的本地匹配的名称 , 将由 forward插件定义的方式转发给其他DNS服务器进行解析 , 示例中的配 置表示将根区域的解析请求转发给主机配置文件/etc/resolv.conf中 指定的DNS服务器进行。若要将请求直接转发给指定的DNS服务器 , 则 将该文件路径替换为目标DNS服务器的IP地址即可 , 多个IP地址之间以 空白字符分隔。例如 , 下面的配置示例表示将除了ilinux.io区域之外 的其他请求转给223.5.5.5或223.6.6.6进行解析。
. {
  forward . 223.5.5.5 223.6.6.6 {
    except ilinux.io
  }
} CoreDNS的各插件与相关的配置属性、参数及详细使用方式请参考 官方文档中的介绍 : https://coredns.io/plugins/。
6. Headless Service资源解析
我们已经知道 , 常规的ClusterIP、NodePort和LoadBalancer类型的Service对象可通过不同的入口来接收和分发客户端请求 , 且它们都拥有集群IP地址(ClusterIP)。 然而 , 个别场景也可能不必或无须使用Service对象的负载均衡功能以及集群IP地址 , 而是借助ClusterDNS服务来代替实现这部分功能。Kubernetes把这类不具有ClusterIP 的Service资源形象地称为Headless Service , 该Service的请求流量无须kube-proxy处理 , 也不会有负载均衡和路由相关的iptables或ipvs规则。至于ClusterDNS如何自动配 置Headless Service , 则取决于Service标签选择器的定义。
有标签选择器 : 由端点控制器自动创建与
Service同名的Endpoint资源 , 而ClusterDNS则将Service名称的A记录直接解析为后端各端点的IP而非ClusterIP。无标签选择器 :
ClusterDNS的配置分为两种情形 , 为ExternalName类型的服务 (配置了spec.externalName字段)创建CNAME记录 , 而为与该Service同名的Endpoint对象上的每个端点创建一个A记录。
显然 , ClusterDNS对待无标签选择器的第二种情形的Headless Service与对待有标签选择器的Headless Service的方式相同 , 区别仅在于相应的Endpoint资源是否由端点控制器基于标签选择器自动创建。通常 , 我们把无标签选择器的第一种情形(使用 CNAME记录)的Headless Service当作一种独立的Service类型使用 , 即ExternalName Service , 而将那些把Service名称使用A记录解析为端点IP地址的类型统一称为 Headless Service。
6.1 ExternalName Service
ExternalName Service是一种特殊类型的Service资源 , 它不需要使用标签选择器关联任何Pod对象 , 也无须定义任何端口或Endpoints , 但必须要使用 spec.externalName属性定义一个CNAME记录 , 用于返回真正提供服务的服务名称的别名。ClusterDNS会为这种类型的Service资源自动生成<service>.<ns>.svc.<zone>. <ttl> IN CNAME <extname>.格式的DNS资源记录。
下面配置清单示例(externalname-redis-svc.yaml)中定义了一个名为 externalname-redis-svc的Service资源 , 它使用DNS CNAME记录指向集群外部的 redis.ik8s.io这一FQDN。
kind: Service
apiVersion: v1
metadata:
  name: externalname-redis-svc
  namespace: default
spec:
  type: ExternalName
  externalName: redis.ik8s.io
  ports:
  - protocol: TCP
    port: 6379
    targetPort: 6379
    nodePort: 0
selector: {}待Service资源externalname-redis-svc创建完成后 , 各Pod对象即可通过短格式或 FQDN格式的Service名称访问相应的服务。ClusterDNS会把该名称以CNAME格式解析为.spec.externalName字段中的名称 , 而后通过DNS服务将其解析为相应主机的IP地址。我们可通过此前Pod对象client-pod对该名称进行解析测试。
~$ kubectl exec -it client -- /bin/sh
[root@client-pod /]#
未指定解析类型的 , nslookup命令会对解析得到的CNAME结果自动进行更进一步的解析。例如下面命令中 , 请求解析externalname-redis-svc.default.svc.cluster.local名称得到CNAME格式的结果redis.ik8s.io将被进一步解析为A记录格式的结果。
[root@client-pod /]# nslookup externalname-redis-svc
Server:         10.96.0.10
Address:        10.96.0.10#53
externalname-redis-svc.default.svc.cluster.local    canonical name = redis.ik8s.io.
Name:   redis.ik8s.io
Address: 1.2.3.4 ExternalName用于通过DNS别名将外部服务发布到Kubernetes集群上 , 这类的DNS别名同本地服务的DNS名称具有相同的形式。因而Pod对象可像发现和访问集群内部服务一样来访问这些发布到集群之上的外部服务 , 这样隐藏了服务的位置信息 , 使得各工作负载能够以相同的方式调用本地和外部服务。等到了能够或者需要把该外部服务引入到 Kubernetes集群上之时 , 管理员只需要修改相应ExternalName Service对象的类型为集群本地服务即可。
6.2 Headless Service
除了为每个Service资源对象在创建时自动指派一个遵循<service>.<ns>.svc.<zone>格式的DNS名称 , ClusterDNS还会为Headless Service中的每个端点指派一个遵循<hostname>.<service>.<ns>.svc.<zone>格式的DNS名称 , 因此 , 每个Headless Service资源对象的名称都会由ClusterDNS自动生成以下几种类型的资源记录。
根据端点
IP地址的类型 , 在Service名称上为每个IPv4地址的端点生成A记录 , 为IPv6地址的端点生成AAAA记录。<service>.<ns>.svc.<zone>. <ttl> IN A <endpoint-ip><service>.<ns>.svc.<zone>. <ttl> IN AAAA <endpoint-ip>
根据端点
IP地址的类型 , 在端点自身的hostname名称上为每个IPv4地址的端点生成A记录 , 为IPv6地址的端点生成AAAA记录。<hostname>.<service>.<ns>.svc.<zone>. <ttl> IN A <endpoint-ip><hostname>.<service>.<ns>.svc.<zone>. <ttl> IN AAAA <endpoint-ip>
为每个定义了名称的端口生成一个
SRV记录 , 未命名的端口号则不具有该记录。_<port>._<proto>.<service>.<ns>.svc.<zone>. <ttl> IN SRV <weight> <priority> <port-number> <service>.<ns>.svc.<zone>.
对于每个给定的每个端点的主机名称的
A记录(例如a.b.c.d)或AAAA记录(例如a1a2a3a4:b1b2b3b4:c1c2c3c4:d1d2d3d4:e1e2e3e4:f1f2f3f4:g1g2g3g4:h1h2h3h4) , 都要生成PTR记录 , 它们各自的格式如下所示。<d>.<c>.<b>.<a>.in-addr.arpa. <ttl> IN PTR <hostname>.<service>.<ns>.svc.<zone>.h4.h3.h2.h1.g4.g3.g2.g1.f4.f3.f2.f1.e4.e3.e2.e1.d4.d3.d2.d1.c4.c3.c2.c1.b4.b3.b2.b1.a4.a3.a2.a1.ip6.arpa IN PTR <hostname>.<service>.<ns>.svc.<zone>.
定义Service资源时 , 只需要将其ClusterIP字段的值显式设置为None即可将其定义 为Headless类型。下面是一个Headless Service资源配置示例 , 它拥有标签选择器 , 因 而能够自动创建同名的Endpoint资源。
kind: Service
apiVersion: v1
metadata:
  name: demoapp-headless-svc
spec:
clusterIP: None
  selector:
    app: demoapp
  ports:
  - port: 80
    targetPort: 80
name: http将上面定义的Headless Service资源创建到集群上 , 我们从其资源详细描述中可以 看出 , demoapp-headless-svc没有ClusterIP , 但因标签选择器能够匹配到Pod资源 , 因此它拥有端点记录。
~$ kubectl apply -f demoapp-headless-svc.yaml
service/demoapp-headless-svc created
~$ kubectl describe svc demoapp-headless-svc
Name:              demoapp-headless-svc
Namespace:         default
Labels:            <none>
Annotations:       Selector:  app=demoapp
Type:              ClusterIP
IP:                None
Port:              http  80/TCP
TargetPort:        80/TCP
Endpoints: 10.244.1.16:80,10.244.2.10:80,10.244.3.11:80 根据Headless Service的工作特性可知 , 它记录在ClusterDNS的A记录的相关解析结果是后端端点的IP地址 , 这就意味着客户端通过此Service资源的名称发现的是各Pod 资源。下面依然通过Pod对象client-pod的交互式接口进行测试 :
~$ kubectl exec -it client-pod -- /bin/sh
[root@client-pod /]# nslookup -query=A demoapp-headless-svc
Server:         10.96.0.10
Address:        10.96.0.10#53
Name:   demoapp-headless-svc.default.svc.cluster.local
Address: 10.244.3.11
Name:   demoapp-headless-svc.default.svc.cluster.local
Address: 10.244.1.16
Name:   demoapp-headless-svc.default.svc.cluster.local
Address: 10.244.2.10其解析结果正是Headless Service通过标签选择器关联到的所有Pod资源的IP地址。于是 , 客户端向此Service对象发起的请求将直接接入Pod资源中的应用之上 , 而不 再由Service资源进行代理转发 , 它每次接入的Pod资源是由DNS服务器接收到查询请求 时以轮询方式返回的IP地址。
另一方面 , 每个IP地址的反向解析记录(PTR)对应的FQDN名称是相应端点所在主 机的主机名称。对于Kubernetes上的容器来说 , 其所在主机的主机名是指Pod对象上的 主机名称 , 它由Pod资源的spec.hostname字段和spec.subdomain组合定义 , 格式为 <hostname>.subdomain>.<service>.<ns>.svc.<zone> , 其中的<subdomain>可省略。若 此两者都未定义 , 则<hostname>值取自IP地址 , IP地址a.b.c.d对应的主机名为a-b-c-d , 如下面命令的解析结果所示。
[root@client-pod /]# nslookup -query=PTR 10.244.3.11
Server:         10.96.0.10
Address:        10.96.0.10#53
11.3.244.10.in-addr.arpa        name = 10-244-3-11.demoapp-headless-svc.default.svc.cluster.local.
参考链接
K8s network之五: Kubernetes集群Pod和Service之间通信的实现原理 | Mr.Muzi (marcuseddie.github.io)