
3-6-4-StatefulSet控制器
1. statefulset 控制器
statefulset控制器主要用来在k8s上管理有状态应用pod ; 我们经常运维的一些应用主要可以分为4类 , 分别从是否有状态和是否有存储两个维度去描述 , 我们可以将应用分为有状态无存储 , 有状态有存储 , 无状态无存储和无状态有存储这四种 ;
大部份应用都是有状态有存储或无状态无存储的应用 , 只有少数应用是有状态无存储或无状态有存储 ; 比如mysql的主从复制集群就是一个有状态有存储的应用 ; 又比如一些http服务 , 如nginx,apache这些服务它就是无状态无存储( 没有用户上传数据) ; 有状态和无状态的最本质区别是有状态应用用户的每次请求对应状态都不一样 , 状态是随时发生变化的 , 这种应用如果运行在k8s上 , 一旦对应pod崩溃 , 此时重建一个pod来替代之前的pod就必须满足 , 重建的pod必须和之前的pod上的数据保持一致 , 其次重建的pod要和现有集群的框架适配 ; 比如mysql主从复制集群 , 当一个从发生故障 , 重建的pod必须满足能够正常挂在之前pod的pvc存储卷 , 以保证两者数据的一致 ; 其次就是新建的pod要适配到当前mysql主从复制的架构 。
从上述描述来看 , 在k8s上托管有状态服务我们必须解决上述问题才能够让一个有状态服务在k8s上正常跑起来为用户提供服务 ; 为此k8s专门弄了一个statefulset控制器来管理有状态pod , 但是k8s上的statefulset控制器它不是帮我们把上述的问题全部解决 , 它只负责帮启动对应数量的pod , 并且把每个pod的名称序列化 , 如果对应pod崩溃 , 重建后的pod名称和原来的pod名称是一样的 ;
所谓序列化是指pod名称不再是pod控制名称加随机生成的字符串 , 而是pod控制器名称加一个顺序的数字 ; 比如statefulset控制器的名称为web-demo , 那么对应控制器启动的pod就是web-demo-0、web-demo-1类似这样的逻辑命名 ; 其次statefulset它还会把之前pod的pvc存储卷自动挂载到重建后的pod上 ( 这取决pvc回收策略必须为Retain , 即删除对应pod后端pvc存储卷保持不变) , 从而实现新建pod持有数据和之前的pod相同 。
简单讲statefulset控制器只是帮助我们在k8s上启动对应数量的pod , 每个pod分配一个固定不变的名称 , 不管pod怎么调度 , 对应pod的名称是一直不变的 ; 即便把对应pod删除再重建 , 重建后的pod的名称还是和之前的pod名称一样 ; 其次就是自动帮我们把对应pod的pvc挂载到重建后的pod上 , 以保证两者数据的相同 。
statefulset控制器只帮我们做这些事 , 至于pod内部跑的容器应用怎么去适配对应的集群架构 , 类似业务逻辑的问题需要我们用户手动去写代码解决 , 因为对于不同的应用其集群逻辑架构和组织方式都不同 , statefulset控制器不能做到以某种机制去适配所有的有状态应用的逻辑架构和组织方式 ;
2. statefulset控制器示意图
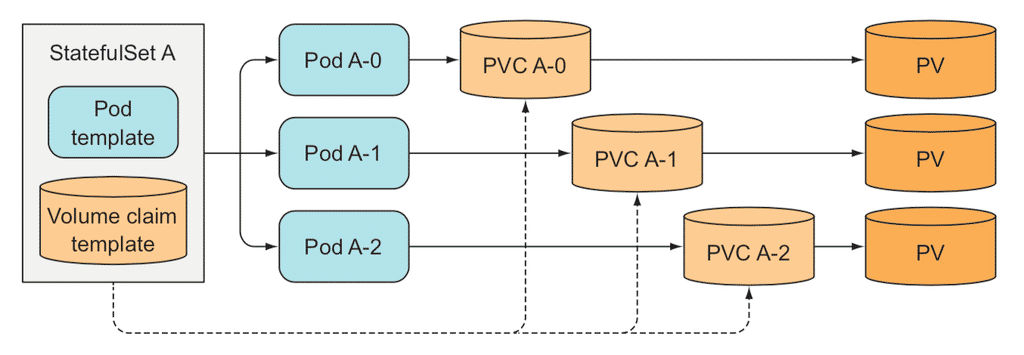
statefulset控制器主要由pod模版和pvc模版组成 ; 其中pod模版主要定义pod相关属性信息 , 对应pvc模版主要用来为对应pod提供存储卷 , 该存储卷可以使用sc资源来动态创建并关联pv , 也可以管理员手动创建并关联对应的pv ;
3. statefulset控制器的创建和使用
3.1 创建statefulset
root@k8s-master01:/opt/k8s-data/yaml/statesetful# cat statesetful.demo.yaml
apiVersion: v1
kind: Service
metadata:
  name: nginx
  labels:
    app: nginx
spec:
  ports:
  - port: 80
    name: web
  clusterIP: None
  selector:
    app: nginx
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: web
spec:
  selector:
    matchLabels:
      app: nginx
  serviceName: nginx
  replicas: 3
  template:
    metadata:
      labels:
        app: nginx
    spec:
      terminationGracePeriodSeconds: 10
      containers:
      - name: nginx
        image: nginx:1.14-alpine
        ports:
        - containerPort: 80
          name: web
        volumeMounts:
        - name: www
          mountPath: /usr/share/nginx/html
  volumeClaimTemplates:
  - metadata:
      name: www
    spec:
      accessModes: [ "ReadWriteOnce" ]
      resources:
        requests:
storage: 1Gistatefulset控制器依赖handless类型service来管理pod的访问 ; statefulset控制器会根据定义的副本数量和定义的pod模板和pvc模板来启动pod , 并给每个pod分配一个固定不变的名称 , 一般这个名称都是statefulset名称加上一个索引id , 如上述清单 , 它会创建3个pod , 这三个pod的名称分别是web-0、web-1、web-2。
pod名称会结合handless service为其每个pod分配一个dns子域 , 访问对应pod就可以直接用这个子域名访问即可 ; 子域名格式为$(pod_name).$(service_name).namespace_name.svc.集群域名(如果在初始化为指定默认集群域名为cluster.local);上述清单定义了一个handless服务 , 以及一个statefulset控制器 , 对应控制器下定义了一个pod模板 , 和一个pvc模板 ; 其中在pod模板中的terminationGracePeriodSeconds字段用来指定终止容器的宽限期时长 , 默认不指定为30秒 ; 定义pvc模板需要用到volumeClaimTemplates字段 , 该字段的值为一个对象列表 ; 其内部我们可以定义pvc模板 ; 如果后端存储支持动态供给pv , 还可以在此模板中直接调用对应的sc资源 ;
在nfs服务器上导出共享目录
root@harbor:/data# exportfs -rv
exporting *:/data/statefulset-3
exporting *:/data/statefulset-2
exporting *:/data/statefulset-1手动创建PV
root@k8s-master01:/opt/k8s-data/yaml/statesetful# cat pv-demo.yaml
apiVersion: v1
kind: PersistentVolume
metadata:
name: nfs-pv-v1
labels:
storsystem: nfs
rel: stable
spec:
capacity:
storage: 1Gi
volumeMode: Filesystem
accessModes: ["ReadWriteOnce","ReadWriteMany","ReadOnlyMany"]
persistentVolumeReclaimPolicy: Retain
mountOptions:
- hard
- nfsvers=4.1
nfs:
path: /data/statefulset-1
server: 192.168.71.34
---
apiVersion: v1
kind: PersistentVolume
metadata:
name: nfs-pv-v2
labels:
storsystem: nfs
rel: stable
spec:
capacity:
storage: 1Gi
volumeMode: Filesystem
accessModes: ["ReadWriteOnce","ReadWriteMany","ReadOnlyMany"]
persistentVolumeReclaimPolicy: Retain
mountOptions:
- hard
- nfsvers=4.1
nfs:
path: /data/statefulset-2
server: 192.168.71.34
---
apiVersion: v1
kind: PersistentVolume
metadata:
name: nfs-pv-v3
labels:
storsystem: nfs
rel: stable
spec:
capacity:
storage: 1Gi
volumeMode: Filesystem
accessModes: ["ReadWriteOnce","ReadWriteMany","ReadOnlyMany"]
persistentVolumeReclaimPolicy: Retain
mountOptions:
- hard
- nfsvers=4.1
nfs:
path: /data/statefulset-3
server: 192.168.71.34
手动创建pv需要将其pv回收策略设置为Retain , 以免对应pod删除以后 , 对应pv变成release状态而导致不可用 ;
应用配置清单
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl apply -f pv-demo.yaml
persistentvolume/nfs-pv-v1 created
persistentvolume/nfs-pv-v2 created
persistentvolume/nfs-pv-v3 created
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get pv
NAME                                       CAPACITY   ACCESS MODES   RECLAIM POLICY   STATUS      CLAIM                           STORAGECLASS          VOLUMEATTRIBUTESCLASS   REASON   AGE
nfs-pv-v1                                  1Gi        RWO,ROX,RWX    Retain           Available                                                         <unset>                          8s
nfs-pv-v2                                  1Gi        RWO,ROX,RWX    Retain           Available                                                         <unset>                          8s
nfs-pv-v3 1Gi RWO,ROX,RWX Retain Available 如果后端存储支持动态供给pv , 此步骤可以省略 ; 直接创建sc资源对象 , 然后在statefulset资源清单中的pvc模板中引用对应的sc对象名称就可以实现动态供给pv并绑定对应的pvc ;
应用statefulset资源清单
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl apply -f statesetful.demo.yaml
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get pv
NAME CAPACITY ACCESS MODES RECLAIM POLICY STATUS CLAIM STORAGECLASS VOLUMEATTRIBUTESCLASS REASON AGE
nfs-pv-v1 1Gi RWO,ROX,RWX Retain Bound default/www-web-0 <unset> 13s
nfs-pv-v2 1Gi RWO,ROX,RWX Retain Bound default/www-web-1 <unset> 13s
nfs-pv-v3 1Gi RWO,ROX,RWX Retain Bound default/www-web-2 <unset> 13s
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get pvc
NAME STATUS VOLUME CAPACITY ACCESS MODES STORAGECLASS VOLUMEATTRIBUTESCLASS AGE
www-web-0 Bound nfs-pv-v1 1Gi RWO,ROX,RWX <unset> 16s
www-web-1 Bound nfs-pv-v2 1Gi RWO,ROX,RWX <unset> 13s
www-web-2 Bound nfs-pv-v3 1Gi RWO,ROX,RWX <unset> 9s
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get sts
NAME READY AGE
web 3/3 12m
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get pods
NAME READY STATUS RESTARTS AGE
web-0 1/1 Running 0 13m
web-1 1/1 Running 0 13m
web-2 1/1 Running 0 13m
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get svc
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
kubernetes ClusterIP 10.68.0.1 <none> 443/TCP 8d
nginx ClusterIP None <none> 80/TCP 13m
可以看到应用statefulset资源清单以后 , 对应的pv从available状态变为了bound状态 , 并且自动创建了3个pvc , 对应pod的名称不再是控制器名称加一串随机字符串 , 而是statefulset控制器名称加一个有序的数字 ; 通常这个数字从0开始 , 依次向上加 , 我们把这个数字叫做对应pod的索引 ;
查看statefulset控制器详细信息
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl describe sts web
Name: web
Namespace: default
CreationTimestamp: Wed, 05 Jun 2024 09:54:17 +0000
Selector: app=nginx
Labels: <none>
Annotations: <none>
Replicas: 3 desired | 3 total
Update Strategy: RollingUpdate
Partition: 0
Pods Status: 3 Running / 0 Waiting / 0 Succeeded / 0 Failed
Pod Template:
Labels: app=nginx
Containers:
nginx:
Image: nginx:1.14-alpine
Port: 80/TCP
Host Port: 0/TCP
Environment: <none>
Mounts:
/usr/share/nginx/html from www (rw)
Volumes: <none>
Volume Claims:
Name: www
StorageClass:
Labels: <none>
Annotations: <none>
Capacity: 1Gi
Access Modes: [ReadWriteOnce]
Events:
Type Reason Age From Message
---- ------ ---- ---- -------
Normal SuccessfulCreate 17m statefulset-controller create Claim www-web-0 Pod web-0 in StatefulSet web success
Normal SuccessfulCreate 17m statefulset-controller create Pod web-0 in StatefulSet web successful
Normal SuccessfulCreate 17m statefulset-controller create Claim www-web-1 Pod web-1 in StatefulSet web success
Normal SuccessfulCreate 17m statefulset-controller create Pod web-1 in StatefulSet web successful
Normal SuccessfulCreate 17m statefulset-controller create Claim www-web-2 Pod web-2 in StatefulSet web success
Normal SuccessfulCreate 17m statefulset-controller create Pod web-2 in StatefulSet web successful
从上面的详细信息中可以了解到 , 对应statefulset控制器是创建一个pvc , 然后在创建一个pod ; 只有当第一个pod和pvc都成功并就绪以后 , 对应才会进行下一个pvc和pod的创建和挂载 ; 简单讲它里面是有序串行进行的 ;
验证: 在k8s集群上任意节点查看对应nginx服务名称 , 看看是否能够查到对应服务名称域名下的pod记录
root@k8s-master01:/opt/k8s-data/yaml/statesetful# dig nginx.default.svc.cbear.local @169.254.20.10
; <<>> DiG 9.18.18-0ubuntu0.22.04.2-Ubuntu <<>> nginx.default.svc.cbear.local @169.254.20.10
;; global options: +cmd
;; Got answer:
;; WARNING: .local is reserved for Multicast DNS
;; You are currently testing what happens when an mDNS query is leaked to DNS
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 11649
;; flags: qr aa rd; QUERY: 1, ANSWER: 3, AUTHORITY: 0, ADDITIONAL: 1
;; WARNING: recursion requested but not available
;; OPT PSEUDOSECTION:
; EDNS: version: 0, flags:; udp: 1232
; COOKIE: e6b87d54c784229d (echoed)
;; QUESTION SECTION:
;nginx.default.svc.cbear.local. IN A
;; ANSWER SECTION:
nginx.default.svc.cbear.local. 30 IN A 172.20.4.145
nginx.default.svc.cbear.local. 30 IN A 172.20.3.170
nginx.default.svc.cbear.local. 30 IN A 172.20.5.132
;; Query time: 8 msec
;; SERVER: 169.254.20.10#53(169.254.20.10) (UDP)
;; WHEN: Wed Jun 05 10:22:50 UTC 2024
;; MSG SIZE rcvd: 205
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get pods -o wide
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES
web-0 1/1 Running 0 30m 172.20.3.170 k8s-node01.cbear.top <none> <none>
web-1 1/1 Running 0 29m 172.20.5.132 k8s-node03.cbear.top <none> <none>
web-2 1/1 Running 0 29m 172.20.4.145 k8s-node02.cbear.top <none> <none>
从上面的查询结果可以看到 , 对应default名称空间下nginx服务名称 , 对应在coredns上的记录有3条 ; 并且对应的解析记录就是对应服务后端的podip地址 ;
验证: 查询web-0的记录是否是对应的web-0这个pod的ip地址
root@k8s-master01:/opt/k8s-data/yaml/statesetful# dig web-0.nginx.default.svc.cbear.local @169.254.20.10
; <<>> DiG 9.18.18-0ubuntu0.22.04.2-Ubuntu <<>> web-0.nginx.default.svc.cbear.local @169.254.20.10
;; global options: +cmd
;; Got answer:
;; WARNING: .local is reserved for Multicast DNS
;; You are currently testing what happens when an mDNS query is leaked to DNS
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 43046
;; flags: qr aa rd; QUERY: 1, ANSWER: 1, AUTHORITY: 0, ADDITIONAL: 1
;; WARNING: recursion requested but not available
;; OPT PSEUDOSECTION:
; EDNS: version: 0, flags:; udp: 1232
; COOKIE: 4b837913ad1afc61 (echoed)
;; QUESTION SECTION:
;web-0.nginx.default.svc.cbear.local. IN A
;; ANSWER SECTION:
web-0.nginx.default.svc.cbear.local. 30 IN A 172.20.3.170
;; Query time: 4 msec
;; SERVER: 169.254.20.10#53(169.254.20.10) (UDP)
;; WHEN: Wed Jun 05 10:25:56 UTC 2024
;; MSG SIZE rcvd: 127
可以看到在对应查询服务名称域名前加上对应的pod名称 , 在coredns上能够查询到对应pod的ip记录 , 这说明 , 后续访问我们可以直接通过pod名称加服务名称直接访问到对应pod ;
验证: 把集群节点的dns服务器更改为coredns服务ip , 然后使用pod名称加服务名称域名的方式访问pod , 看看是否能够访问到pod
root@k8s-master01:/opt/k8s-data/yaml/statesetful# curl  web-0.nginx.default.svc.cbear.local
<html>
<head><title>403 Forbidden</title></head>
<body bgcolor="white">
<center><h1>403 Forbidden</h1></center>
<hr><center>nginx/1.14.2</center>
</body>
</html>这里能够响应403 , 说明pod能够正常访问 , 只不过对应pod没有主页 , 所以提示403 ;
验证: 进入对应pod里面 , 提供主页页面 , 再次访问 , 看看是否能够访问到对应的页面内容呢
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl exec -it web-0 -- /bin/sh
/ # cd /usr/share/nginx/html/
/usr/share/nginx/html # ls
/usr/share/nginx/html # echo "this web-0 pod index" > index.html
/usr/share/nginx/html # cat index.html
this web-0 pod index
/usr/share/nginx/html # exit
root@k8s-master01:/opt/k8s-data/yaml/statesetful# curl  web-0.nginx.default.svc.cbear.local
this web-0 pod index
提示 : 可以看到对应pod能够被访问到 ;
删除web-0 , 看看对应pod是否自动重建?
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get pods -o wide
NAME    READY   STATUS    RESTARTS   AGE   IP             NODE                   NOMINATED NODE   READINESS GATES
web-0   1/1     Running   0          46m   172.20.3.170   k8s-node01.cbear.top   <none>           <none>
web-1   1/1     Running   0          46m   172.20.5.132   k8s-node03.cbear.top   <none>           <none>
web-2   1/1     Running   0          46m   172.20.4.145   k8s-node02.cbear.top   <none>           <none>
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl delete pod web-0
pod "web-0" deleted

root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get pods -o wide
NAME    READY   STATUS    RESTARTS   AGE   IP             NODE                   NOMINATED NODE   READINESS GATES
web-0   1/1     Running   0          5s    172.20.3.171   k8s-node01.cbear.top   <none>           <none>
web-1   1/1     Running   0          46m   172.20.5.132   k8s-node03.cbear.top   <none>           <none>
web-2 1/1 Running 0 46m 172.20.4.145 k8s-node02.cbear.top <none> <none>可以看到手动删除web-0以后 , 对应控制器会自动根据pod模板 , 重建一个名称为web-0的pod运行起来 ;
验证: 访问新建后的pod , 看看是否能够访问到对应的主页呢
root@k8s-master01:/opt/k8s-data/yaml/statesetful# curl  web-0.nginx.default.svc.cbear.local
this web-0 pod index可以看到使用pod名称加服务名称域名 , 能够正常访问到对应pod的主页 , 这意味着新建的pod能够自动将之前删除的pod的pvc存储卷挂载到自己对一个的目录下 ;
3.2 扩展pod副本
在nfs服务器上创建共享目录 , 并导出对应的目录
root@harbor:/data# mkdir statefulset-{4,5,6}

root@harbor:/data# cat /etc/exports
/data/statefulset-1 *(rw,no_root_squash,no_subtree_check)
/data/statefulset-2 *(rw,no_root_squash,no_subtree_check)
/data/statefulset-3 *(rw,no_root_squash,no_subtree_check)
/data/statefulset-4 *(rw,no_root_squash,no_subtree_check)
/data/statefulset-5 *(rw,no_root_squash,no_subtree_check)
/data/statefulset-6 *(rw,no_root_squash,no_subtree_check)

root@harbor:/data# exportfs  -rv
exporting *:/data/statefulset-6
exporting *:/data/statefulset-5
exporting *:/data/statefulset-4
exporting *:/data/statefulset-3
exporting *:/data/statefulset-2
exporting *:/data/statefulset-1
复制创建pv的资源清单 , 更改为要创建pv对应的配置
root@k8s-master01:/opt/k8s-data/yaml/statesetful# cat pv-demo2.yaml
apiVersion: v1
kind: PersistentVolume
metadata:
  name: nfs-pv-v4
  labels:
    storsystem: nfs
    rel: stable
spec:
  capacity:
    storage: 1Gi
  volumeMode: Filesystem
  accessModes: ["ReadWriteOnce","ReadWriteMany","ReadOnlyMany"]
  persistentVolumeReclaimPolicy: Retain
  mountOptions:
  - hard
  - nfsvers=4.1
  nfs:
    path: /data/statefulset-4
    server: 192.168.71.34
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: nfs-pv-v5
  labels:
    storsystem: nfs
    rel: stable
spec:
  capacity:
    storage: 1Gi
  volumeMode: Filesystem
  accessModes: ["ReadWriteOnce","ReadWriteMany","ReadOnlyMany"]
  persistentVolumeReclaimPolicy: Retain
  mountOptions:
  - hard
  - nfsvers=4.1
  nfs:
    path: /data/statefulset-5
    server: 192.168.71.34
---

apiVersion: v1
kind: PersistentVolume
metadata:
  name: nfs-pv-v6
  labels:
    storsystem: nfs
    rel: stable
spec:
  capacity:
    storage: 1Gi
  volumeMode: Filesystem
  accessModes: ["ReadWriteOnce","ReadWriteMany","ReadOnlyMany"]
  persistentVolumeReclaimPolicy: Retain
  mountOptions:
  - hard
  - nfsvers=4.1
  nfs:
    path: /data/statefulset-6
    server: 192.168.71.34
应用配置清单 , 创建pv
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl apply -f pv-demo2.yaml
persistentvolume/nfs-pv-v4 created
persistentvolume/nfs-pv-v5 created
persistentvolume/nfs-pv-v6 created
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get pv
NAME        CAPACITY   ACCESS MODES   RECLAIM POLICY   STATUS      CLAIM               STORAGECLASS   VOLUMEATTRIBUTESCLASS   REASON   AGE
nfs-pv-v1   1Gi        RWO,ROX,RWX    Retain           Bound       default/www-web-0                  <unset>                          75m
nfs-pv-v2   1Gi        RWO,ROX,RWX    Retain           Bound       default/www-web-1                  <unset>                          75m
nfs-pv-v3   1Gi        RWO,ROX,RWX    Retain           Bound       default/www-web-2                  <unset>                          75m
nfs-pv-v4   1Gi        RWO,ROX,RWX    Retain           Available                                      <unset>                          5s
nfs-pv-v5   1Gi        RWO,ROX,RWX    Retain           Available                                      <unset>                          5s
nfs-pv-v6 1Gi RWO,ROX,RWX Retain Available <unset> 5s 扩展sts副本数为6个
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get sts
NAME   READY   AGE
web    3/3     75m
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl scale sts web --replicas=6
statefulset.apps/web scaled查看对应的pod扩展过程
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get pods -w
NAME    READY   STATUS              RESTARTS   AGE
web-0   1/1     Running             0          32m
web-1   1/1     Running             0          79m
web-2   1/1     Running             0          78m
web-3   0/1     ContainerCreating   0          1s
web-3   1/1     Running             0          1s
web-4   0/1     Pending             0          0s
web-4   0/1     Pending             0          0s
web-4   0/1     ContainerCreating   0          0s
web-4   1/1     Running             0          1s
web-5   0/1     Pending             0          0s
web-5   0/1     Pending             0          0s
web-5   0/1     ContainerCreating   0          0s
web-5 1/1 Running 0 2s上面的扩展过程可以看到对应pod是串行扩展 , 当web-3就绪running以后 , 才会进行web-4 , 依次类推 ;
查看pv和pvc
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get pv
NAME        CAPACITY   ACCESS MODES   RECLAIM POLICY   STATUS   CLAIM               STORAGECLASS   VOLUMEATTRIBUTESCLASS   REASON   AGE
nfs-pv-v1   1Gi        RWO,ROX,RWX    Retain           Bound    default/www-web-0                  <unset>                          76m
nfs-pv-v2   1Gi        RWO,ROX,RWX    Retain           Bound    default/www-web-1                  <unset>                          76m
nfs-pv-v3   1Gi        RWO,ROX,RWX    Retain           Bound    default/www-web-2                  <unset>                          76m
nfs-pv-v4   1Gi        RWO,ROX,RWX    Retain           Bound    default/www-web-3                  <unset>                          106s
nfs-pv-v5   1Gi        RWO,ROX,RWX    Retain           Bound    default/www-web-4                  <unset>                          106s
nfs-pv-v6   1Gi        RWO,ROX,RWX    Retain           Bound    default/www-web-5                  <unset>                          106s
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get pvc
NAME        STATUS   VOLUME      CAPACITY   ACCESS MODES   STORAGECLASS   VOLUMEATTRIBUTESCLASS   AGE
www-web-0   Bound    nfs-pv-v1   1Gi        RWO,ROX,RWX                   <unset>                 76m
www-web-1   Bound    nfs-pv-v2   1Gi        RWO,ROX,RWX                   <unset>                 76m
www-web-2   Bound    nfs-pv-v3   1Gi        RWO,ROX,RWX                   <unset>                 76m
www-web-3   Bound    nfs-pv-v4   1Gi        RWO,ROX,RWX                   <unset>                 27s
www-web-4   Bound    nfs-pv-v5   1Gi        RWO,ROX,RWX                   <unset>                 24s
www-web-5 Bound nfs-pv-v6 1Gi RWO,ROX,RWX <unset> 22s从上面的结果可以看到pv和pvc都处于bound状态 ;
缩减pod数量为4个
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl scale sts web --replicas=4
statefulset.apps/web scaled
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get pods
NAME    READY   STATUS    RESTARTS   AGE
web-0   1/1     Running   0          34m
web-1   1/1     Running   0          80m
web-2   1/1     Running   0          80m
web-3   1/1     Running   0          93s
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get pv
NAME        CAPACITY   ACCESS MODES   RECLAIM POLICY   STATUS   CLAIM               STORAGECLASS   VOLUMEATTRIBUTESCLASS   REASON   AGE
nfs-pv-v1   1Gi        RWO,ROX,RWX    Retain           Bound    default/www-web-0                  <unset>                          80m
nfs-pv-v2   1Gi        RWO,ROX,RWX    Retain           Bound    default/www-web-1                  <unset>                          80m
nfs-pv-v3   1Gi        RWO,ROX,RWX    Retain           Bound    default/www-web-2                  <unset>                          80m
nfs-pv-v4   1Gi        RWO,ROX,RWX    Retain           Bound    default/www-web-3                  <unset>                          5m45s
nfs-pv-v5   1Gi        RWO,ROX,RWX    Retain           Bound    default/www-web-4                  <unset>                          5m45s
nfs-pv-v6   1Gi        RWO,ROX,RWX    Retain           Bound    default/www-web-5                  <unset>                          5m45s
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get pvc
NAME        STATUS   VOLUME      CAPACITY   ACCESS MODES   STORAGECLASS   VOLUMEATTRIBUTESCLASS   AGE
www-web-0   Bound    nfs-pv-v1   1Gi        RWO,ROX,RWX                   <unset>                 80m
www-web-1   Bound    nfs-pv-v2   1Gi        RWO,ROX,RWX                   <unset>                 80m
www-web-2   Bound    nfs-pv-v3   1Gi        RWO,ROX,RWX                   <unset>                 80m
www-web-3   Bound    nfs-pv-v4   1Gi        RWO,ROX,RWX                   <unset>                 4m25s
www-web-4   Bound    nfs-pv-v5   1Gi        RWO,ROX,RWX                   <unset>                 4m22s
www-web-5 Bound nfs-pv-v6 1Gi RWO,ROX,RWX <unset> 4m20s可以看到缩减pod它会从索引号最大的pod逆序缩减 , 缩减以后对应pv和pvc的状态依旧是bound状态 ; 扩缩减pod副本过程如下图所示
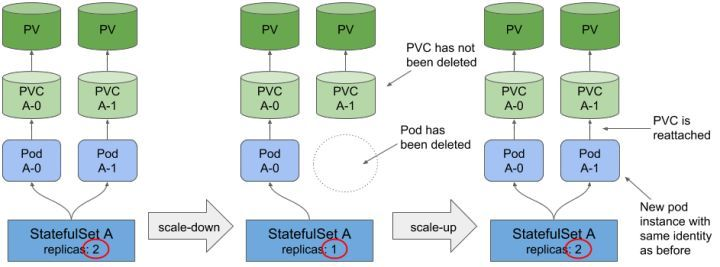
上图主要描述了sts控制器上的pod缩减-->扩展pod副本的过程 ; 缩减pod副本数量 , 对应后端的pvc和pv的状态都是不变的 , 后续再增加pod副本数量 , 对应pvc能够根据pod名称自动的关联到对应的pod上 , 使得扩展后对应名称的pod和之前缩减pod的数据保存一致 ;
3.3 滚动更新pod版本
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl set image sts web nginx=nginx:1.16-alpine
statefulset.apps/web image updatedstatefulset控制器滚动更新是从索引号最大的pod开始更新 , 并且它一次更新一个pod , 只有等到上一个pod更新完毕 , 并且其状态为running以后 , 才开始更新第二个 , 依次类推 ;
验证:查看对应sts信息 , 看看对应版本是否更新为我们指定的镜像版本
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get sts -o wide
NAME   READY   AGE   CONTAINERS   IMAGES
web 4/4 90m nginx nginx:1.16-alpine回滚pod版本为上一个版本
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl rollout undo sts/web
statefulset.apps/web rolled back
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get pods
NAME    READY   STATUS              RESTARTS   AGE
web-0   1/1     Running             0          4m2s
web-1   1/1     Running             0          4m4s
web-2   0/1     ContainerCreating   0          1s
web-3   1/1     Running             0          3s
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get pods
NAME    READY   STATUS    RESTARTS   AGE
web-0   1/1     Running   0          38s
web-1   1/1     Running   0          39s
web-2   1/1     Running   0          42s
web-3 1/1 Running 0 44s使用partition字段控制更新pod数量 , 实现金丝雀效果更新pod版本
sts控制器默认的更新策略是依次从索引最大的pod开始逆序更新 , 先删除一个pod等待对应pod更新完毕以后 , 状态处于running以后 , 接着更新第二个依次更新完所有的pod , 要想实现金丝雀更新pod版本的效果 , 我们需要告诉sts更新在那个位置 ; 在deploy控制器中我们使用的是kubectl rollout pause命令来暂停更新 , 从而实现金丝雀更新pod版本的效果 , 当然在sts中也可以 ; 除此之外 , sts还支持通过sts.spec.updateStrategy.rollingUpdate.partition字段的值来控制器更新数量 ; 默认partition的值为0 , 表示更新到索引大于0的pod位置 , 即全部更新 ; 如下图所示
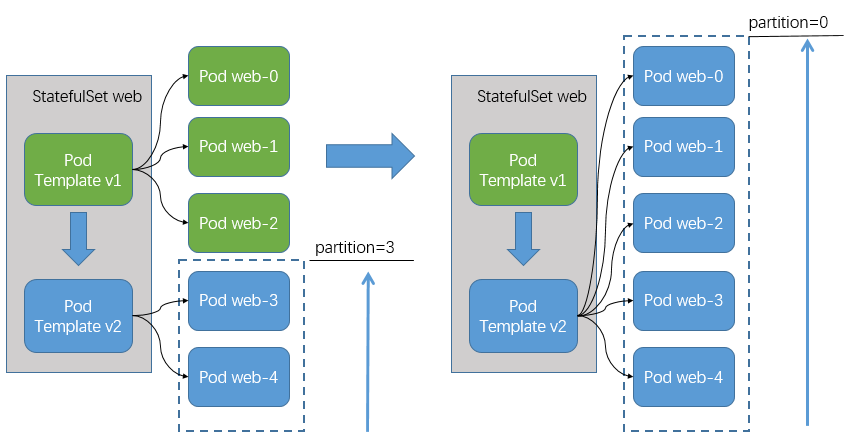
在sts控制器中更新pod模板的镜像版本 , 可以使用partition这个字段来控制更新到那个位置 , partition=3表示更新索引大于等于3的pod , 小于3的pod就不更新 ; partition=0表示全部更新 ;
示例 : 在线更改sts控制器的partition字段的值为3
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl edit sts/web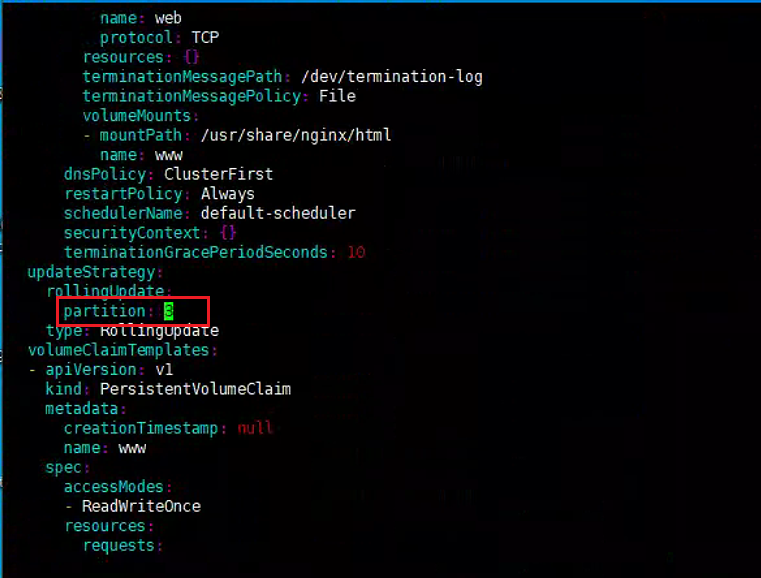
在线修改sts的配置 , 使用kubectl edit命令指定类型和对应控制器实例 , 就可以进入编辑对应配置文件的界面 , 找到updateStrategy字段下的rollingUpdate字段下的partition字段 , 把原有的0更改为3 , 保存退出即可生效 ; 当然我们也可以直接更改配置清单 , 然后再重新应用一下也行 ; 如果配置清单中没有定义 , 可以加上对应的字段即可 ;
再次更新pod版本 , 看看它是否只更新索引于等3的pod
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get sts -o wide
NAME   READY   AGE    CONTAINERS   IMAGES
web    4/4     106m   nginx        nginx:1.14-alpine
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl set image sts web nginx=nginx:1.16-alpine
statefulset.apps/web image updated

root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl get sts -o wide
NAME   READY   AGE    CONTAINERS   IMAGES
web 4/4 107m nginx nginx:1.16-alpine对应sts控制器此时更新只是更新了web-3 , 其余索引小于3的pod并没有发生更新操作
root@k8s-master01:/opt/k8s-data/yaml/statesetful# kubectl edit sts/web
statefulset.apps/web edited我们把对应的控制器中的partition字段的值从3更改为0以后 , 对应更新操作就理解开始执行 ;
以上就是sts控制器的相关使用说明 , 其实我上面使用nginx来演示sts控制器的相关操作 , 在生产环境中我们部署的是一个真正有状态的服务 , 还要考虑怎么去适配对应的集群 , 每个pod怎么加入到集群 , 扩缩容怎么做等等一系列运维操作都需要在pod模板中定义出来 ;
4. 实际使用
示例: 在k8s上使用sts控制器部署zk集群
apiVersion: v1
kind: Service
metadata:
  name: zk-hs
  labels:
    app: zk
spec:
  ports:
  - port: 2888
    name: server
  - port: 3888
    name: leader-election
  clusterIP: None
  selector:
    app: zk
---
apiVersion: v1
kind: Service
metadata:
  name: zk-cs
  labels:
    app: zk
spec:
  ports:
  - port: 2181
    name: client
  selector:
    app: zk
---
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: zk-pdb
spec:
  selector:
    matchLabels:
      app: zk
  maxUnavailable: 1
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: zk
spec:
  selector:
    matchLabels:
      app: zk
  serviceName: zk-hs
  replicas: 3
  updateStrategy:
    type: RollingUpdate
  podManagementPolicy: Parallel
  template:
    metadata:
      labels:
        app: zk
    spec:
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            - labelSelector:
                matchExpressions:
                  - key: "app"
                    operator: In
                    values:
                    - zk-hs
              topologyKey: "kubernetes.io/hostname"
      containers:
      - name: kubernetes-zookeeper
        image: gcr.io/google-containers/kubernetes-zookeeper:1.0-3.4.10
        resources:
          requests:
            memory: "1Gi"
            cpu: "0.5"
        ports:
        - containerPort: 2181
          name: client
        - containerPort: 2888
          name: server
        - containerPort: 3888
          name: leader-election
        command:
        - sh
        - -c
        - "start-zookeeper \
          --servers=3 \
          --data_dir=/var/lib/zookeeper/data \
          --data_log_dir=/var/lib/zookeeper/data/log \
          --conf_dir=/opt/zookeeper/conf \
          --client_port=2181 \
          --election_port=3888 \
          --server_port=2888 \
          --tick_time=2000 \
          --init_limit=10 \
          --sync_limit=5 \
          --heap=512M \
          --max_client_cnxns=60 \
          --snap_retain_count=3 \
          --purge_interval=12 \
          --max_session_timeout=40000 \
          --min_session_timeout=4000 \
          --log_level=INFO"
        readinessProbe:
          exec:
            command:
            - sh
            - -c
            - "zookeeper-ready 2181"
          initialDelaySeconds: 10
          timeoutSeconds: 5
        livenessProbe:
          exec:
            command:
            - sh
            - -c
            - "zookeeper-ready 2181"
          initialDelaySeconds: 10
          timeoutSeconds: 5
        volumeMounts:
        - name: data
          mountPath: /var/lib/zookeeper
      securityContext:
        runAsUser: 1000
        fsGroup: 1000
  volumeClaimTemplates:
  - metadata:
      name: data
    spec:
      accessModes: [ "ReadWriteOnce" ]
      storageClassName: gluster-dynamic
      resources:
        requests:
          storage: 5Gi
示例 : 在k8s上使用sts控制器部署etcd集群
apiVersion: v1
kind: Service
metadata:
  name: etcd
  labels:
    app: etcd
  annotations:
    # Create endpoints also if the related pod isn't ready
    service.alpha.kubernetes.io/tolerate-unready-endpoints: "true"
spec:
  ports:
  - port: 2379
    name: client
  - port: 2380
    name: peer
  clusterIP: None
  selector:
    app: etcd-member
---
apiVersion: v1
kind: Service
metadata:
  name: etcd-client
  labels:
    app: etcd
spec:
  ports:
  - name: etcd-client
    port: 2379
    protocol: TCP
    targetPort: 2379
  selector:
    app: etcd-member
  type: NodePort
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: etcd
  labels:
    app: etcd
spec:
  serviceName: etcd
  # changing replicas value will require a manual etcdctl member remove/add
  #   # command (remove before decreasing and add after increasing)
  replicas: 3
  selector:
    matchLabels:
      app: etcd-member
  template:
    metadata:
      name: etcd
      labels:
        app: etcd-member
    spec:
      containers:
      - name: etcd
        image: "quay.io/coreos/etcd:v3.2.16"
        ports:
        - containerPort: 2379
          name: client
        - containerPort: 2380
          name: peer
        env:
        - name: CLUSTER_SIZE
          value: "3"
        - name: SET_NAME
          value: "etcd"
        volumeMounts:
        - name: data
          mountPath: /var/run/etcd
        command:
          - "/bin/sh"
          - "-ecx"
          - |
            IP=$(hostname -i)
            PEERS=""
            for i in $(seq 0 $((${CLUSTER_SIZE} - 1))); do
                PEERS="${PEERS}${PEERS:+,}${SET_NAME}-${i}=http://${SET_NAME}-${i}.${SET_NAME}:2380"
            done
            # start etcd. If cluster is already initialized the `--initial-*` options will be ignored.
            exec etcd --name ${HOSTNAME} \
              --listen-peer-urls http://${IP}:2380 \
              --listen-client-urls http://${IP}:2379,http://127.0.0.1:2379 \
              --advertise-client-urls http://${HOSTNAME}.${SET_NAME}:2379 \
              --initial-advertise-peer-urls http://${HOSTNAME}.${SET_NAME}:2380 \
              --initial-cluster-token etcd-cluster-1 \
              --initial-cluster ${PEERS} \
              --initial-cluster-state new \
              --data-dir /var/run/etcd/default.etcd
  volumeClaimTemplates:
  - metadata:
      name: data
    spec:
      storageClassName: gluster-dynamic
      accessModes:
        - "ReadWriteOnce"
      resources:
        requests:
storage: 1Gi以上示例都是使用的sc资源对象自动创建pv并关联pvc , 在运行前请先准备好对应的存储和创建好sc对象 ; 如果不使用pv自动供给 , 可以先创建pv在应用资源清单(手动创建pv需要将其pvc模板中的storageClassName字段删除) ;
最后再来说一下k8s operator
从上述sts示例来看 , 我们要在k8s上部署一个真正意义上的有状态服务 , 最重要的就是定义好pod模板 , 这个模板通常就是指定对应的镜像内部怎么加入集群 , 对应pod扩缩容怎么处理等等 ; 根据不同的服务逻辑定义的方式各有不同 , 这样一来使得在k8s上跑有状态的服务就显得格外的吃力 ; 为此coreos想了个办法 , 它把在k8s上跑有状态应用的绝大部分运维操作 , 做成了一个sdk , 这个sdk叫operator , 用户只需要针对这个sdk来开发一些适合自己业务需要用到的对应服务的运维操作程序 ; 然后把此程序跑到k8s上 ; 这样一来针对专有服务就有专有的operator , 用户如果要在k8s上跑对应服务 , 只需要告诉对应的operator跑一个某某服务即可 ; 简单讲operator就是一个针对某有状态服务的全能运维 , 用户需要在k8s上创建一个对应服务的集群 , 就告诉对应的“运维”创建一个集群 , 需要扩展/缩减集群pod数量 , 告诉运维“扩展/缩减集群”即可 ; 至于该”运维“有哪些能力 , 取决开发此程序的程序员赋予了该operator哪些能力 ; 这样一来我们在k8s上跑有状态的应用程序 , 只需要把对应的operator部署到k8s集群 , 然后根据此operator来编写对应的资源配置清单应用即可 ; 在哪里找operator呢?https://github.com/operator-framework/awesome-operators ; 该地址是一个operator的列表 , 里面有很多服务的operator的网站地址 ; 可以找到对应的服务 , 进入到对应网站查看相关文档部署使用即可 ;
参考链接
容器编排系统K8s之StatefulSet控制器 - Linux-1874 - 博客园 (cnblogs.com)