
3-6-1-控制器
部署、扩展、更新和回滚是应用维护的核心编排任务。传统的应 用部署方案中 , 横向扩展(scale out)是应对单主机资源局限性时具 有普适性的选择 , 以Pod形式托管在Kubernetes集群上运行的应用面临着同样的可用资源阈值问题 , 容器化应用的可用资源受限于用户定义 的资源(CPU和内存)限制或节点的资源边界 , 因此用户需要根据特定 应用的单个Pod应用实例的访问支撑能力和实际的请求峰值来规划与设 定合理的Pod实例数量。应用程序版本升级时的在线应用更新操作也在实践中形成了灰度更新、蓝绿部署和金丝雀部署等解决方案。但这类 的编排任务由传统的人工或工具化编排进化到了由ReplicaSet、 Deployment或ReplicaSet控制器实现的半自动化编排机制 , 而 HPA(Horizontal Pod Autoscaler)和VPA(Vertical Pod Autoscaler)控制器更是让这类任务彻底走向完全自动化。本章着重于介绍无状态应用控制器ReplicaSet和Deployment、系统应用控制器 DaemonSet、单次任务控制器Job和定时作业控制器CronJob等。
1. Kubernetes控制器基础
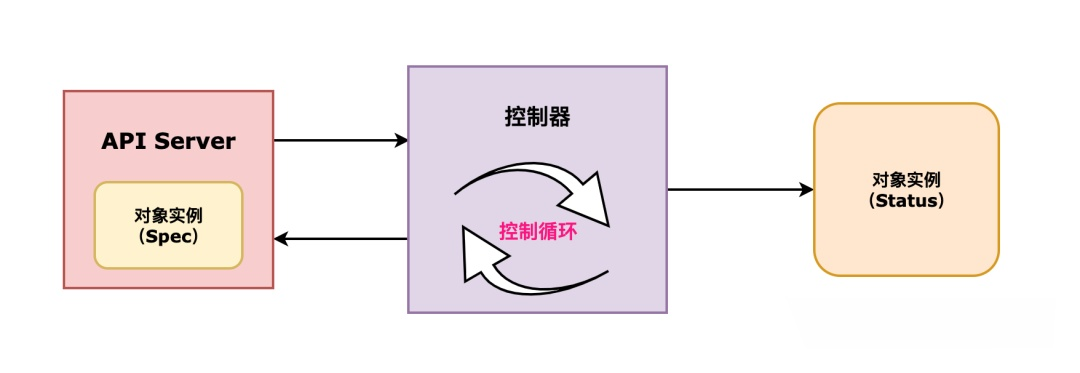
我们可以把API Server想象成存储Kubernetes资源对象的数据库系统 , 它仅支持预置的数据存储方案 , 每个方案对应于一种资源类 型 , 客户端将API创建的、符合数据存储方案的数据项称为资源对象。 但这些基于数据方案创建并存储于API Server中的仅是对象的定义。 例如 , 一个Pod对象的定义并不代表某个以容器形式运行的应用 , 它仅停留在“纸面上” , 我们还需要某个程序以特定的步骤调用容器运行时接口 , 按照Pod对象的定义创建出具体的应用容器来。这一类负责把 API Server上存储的对象定义实例化到集群上的程序就是控制器。控制器需要运行为守护进程: 一方面 , 注册监视API Server上隶属该控制器类型的对象定义(spec)的变动 , 及时将变动反映到集群中的对象实例之上 ; 另一方面 , 通过控制循环(control loop , 也可称为控制回路)持续监视集群上由其负责管控的对象实例的实际状态 , 在因故障、更新或其他原因导致当前状态(Status)发生变化而与期望状态(spec)时 , 通过实时运行相应的程序代码尝试让对象的真实状态向期望状态迁移和逼近。图展示了控制器与控制循环的交互。
1.1 控制器与Pod资源
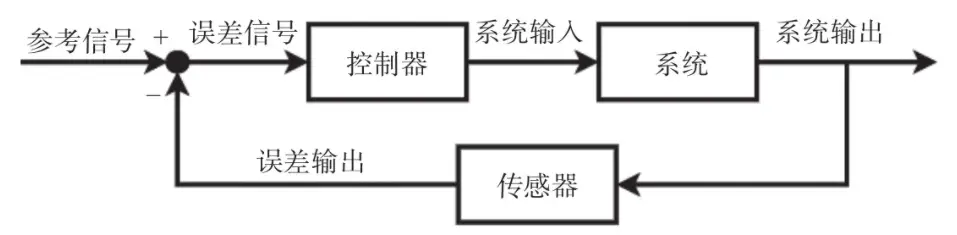
从本质上讲 , Kubernetes的核心就是控制理论 , 控制器中实现的 控制回路是一种闭环(反馈)控制系统 , 该类型的控制系统基于反馈回路将目标系统的当前状态与预定义的期望状态相比较 , 二者之间的差异作为误差信号产生一个控制输出作为控制器的输入 , 以减少或消 除目标系统当前状态与期望状态的误差 , 如图所示。这种控制循环在Kubernetes上也称为调谐循环(reconciliation loop)。
对Kubernetes来说 , 无论控制器的具体实现有多么简单或多么复杂 , 它基本都是通过定期重复执行如下3个步骤来完成控制任务。
从
API Server读取资源对象的期望状态和当前状态。比较二者的差异 , 而后运行控制器中的必要代码操作现实中的资源对象 , 将资源对象的真实状态修正为
Spec中定义的期望状态 , 例 如创建或删除Pod对象 , 以及发起一个云服务API请求等。变动操作执行成功后 , 将结果状态存储在
API Server上的目标资源对象的status字段中。
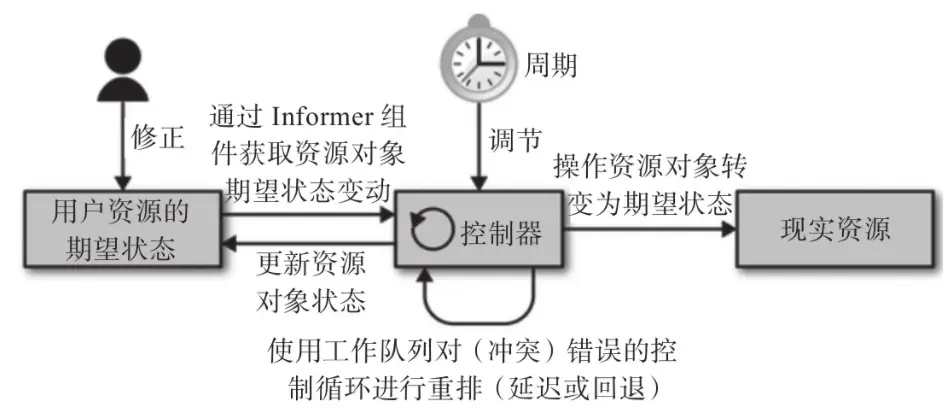
任务繁重的Kubernetes集群上同时运行着数量巨大的控制循环 , 每个循环都有一组特定的任务要处理 , 为了避免API Server被请求淹没 , 需设定控制回路以较低的频率运行 , 默认每5分钟一次。同时 , 为 了能及时触发由客户端提交的期望状态的更改 , 控制器向API Server 注册监视受控资源对象 , 这些资源对象期望状态的任何变动都会由 Informer组件通知给控制器立即执行而无须等到下一轮的控制循环。 控制器使用工作队列将需要运行的控制循环进行排队 , 从而确保在受控对象众多或资源对象变动频繁的场景中尽量少地错过控制任务。
出于简化管理的目的 , Kubernetes将数十种内置的控制器程序整合成了名为kube-controller-manager的单个应用程序 , 并运行为独立的单体守护进程 , 它是控制平面的重要组件 , 也整个Kubernetes集群 的控制中心。
提示:
Kubernetes可用的控制器有attachdetach、bootstrapsigner、clusterrole-aggregation、cronjob、csrapproving、csrcleaner、csrsigning、daemonset、deployment、disruption、endpoint、garbagecollector、horizontalpodautoscaling、job、namespace、node、persistentvolume-binder、persistentvolume-expander、podgc、pvc-protection、replicaset、replicationcontroller、resourcequota、route、service、serviceaccount、serviceaccount-token、statefulset、tokencleaner和ttl等数十 种。
工作负载范畴的控制器资源类型包括ReplicationController、 ReplicaSet、Deployment、DaemonSet、StatefulSet、Job和CronJob 等 , 它们各自代表一种类型的Pod控制器资源 , 分别实现不同的应用编排机制。
几乎所有的工作负载型控制器资源对象都是通过持续性地监控集群中运行着的Pod资源对象来确保受其管控的资源严格符合用户期望的 状态 , 例如确保资源副本的数量要精确符合期望等。通常 , 一个工作负载控制器资源通常应该包含3个基本的组成部分。
标签选择器 : 匹配并关联
Pod对象 , 并据此完成受其管控的Pod对象的计数。期望的副本数: 期望在集群中精确运行受控的
Pod对象数量。Pod模板: 用于新建Pod对象使用的模板资源。
注意:
DaemonSet控制器用于确保集群中每个工作节点或符合条件的每个节点上都运行着一个Pod副本 , 而非某个预设的精确数量值 , 因而不具有上面组成部分中的第二项。
例如 , 如图所示的Deployment控制器eshop-deploy对象使用 app=eshop为标签选择器 , 以过滤当前名称空间中的Pod对象 , 它期望能够匹配到的Pod对象副本数量精确为4个。
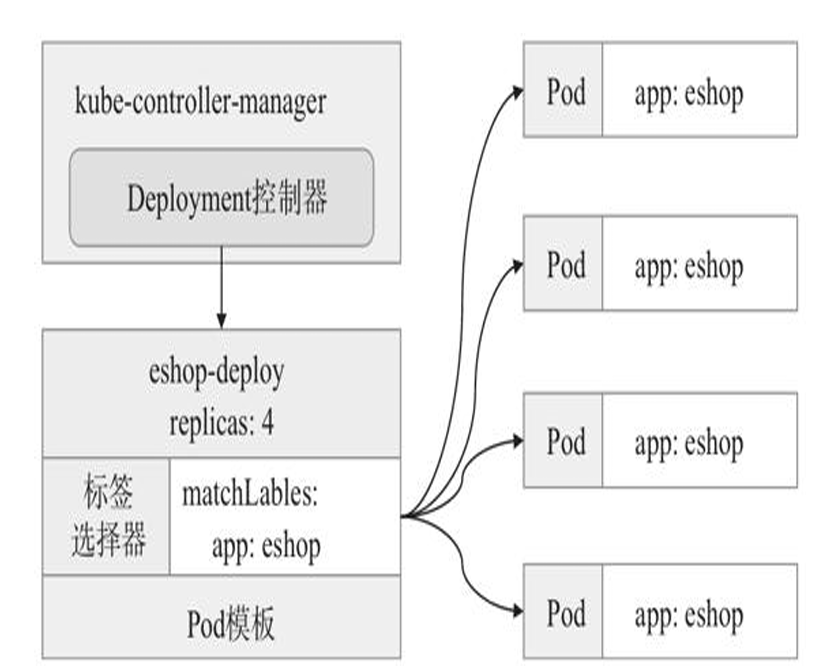
将eshop-deploy对象创建到集群上之后 , Deployment控制器将根 据该对象的定义标签选择器过滤符合条件的Pod对象并对其进行计数 , 少于指定数量的缺失部分将由控制器通过Pod模板予以创建 , 而多出的 副本也将由控制器请求终止及删除。
通常 , 对于那些以Deployment、DaemonSet或StatefulSet控制器编排的且需要长期运行的容器应用 , 其应用更新、回滚和扩缩容也是编排操作的核心任务。但这类任务所导致的Pod对象的变动势必会影响透过Service来访问应用服务的客户端 , 如图所示。
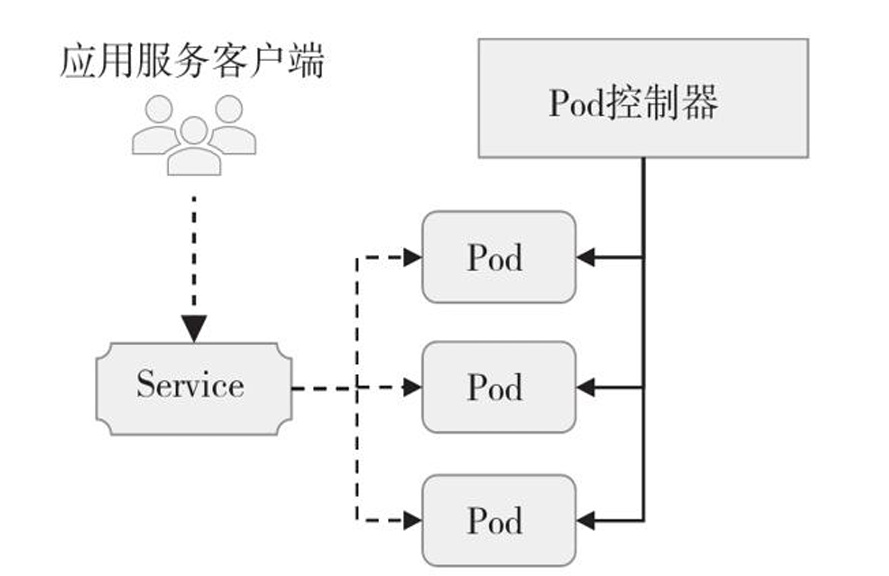
显然 , 生产环境中的应用编排过程通常不能影响或过度影响当前正在获取服务的用户体验 , 达成该类目标也是应用程序控制器的核心功能之一 , 事实上 , Deployment等甚至允许用户自定义更新策略来自 定义应用升级过程。
1.2 Pod模板资源
Pod模板资源是Kubernetes API的常用资源类型 , 常用于为控制器指定自动创建Pod资源对象时所需的配置信息。内嵌于控制器的Pod模板的配置信息中不需要apiVersion和kind字段 , 除此之外的其他内容跟定义自主式Pod对象所支持的字段几乎完全相同 , 这包括metadata和 spec及其内嵌的其他各字段。
工作负载控制器类的资源的spec字段通常都要内嵌replicas、 selector和template字段 , 其中template便是用于定义Pod模板。下面 是一个定义在ReplicaSet资源中的模板资源示例 , 它基于 ikubernetes/demoapp:v1.0镜像简单定义了一个应用 , 并同时配置了存活探针和就绪探针。
apiVersion: apps/v1
kind: ReplicaSet
metadata:
  name: replicaset-demo
spec:
  minReadySeconds: 3
  replicas: 2
  selector:
    matchLabels:
      app: demoapp
      release: stable
  template:
    metadata:
      labels:
        app: demoapp
        release: stable
    spec:
      containers:
      - name: demoapp
        image: ikubernetes/demoapp:v1.0
        ports:
        - name: http
          containerPort: 80
        livenessProbe:
          httpGet:
            path: '/livez'
            port: 80
          initialDelaySeconds: 5
        readinessProbe:
          httpGet:
            path: '/readyz'
            port: 80
          initialDelaySeconds: 15
如上示例中 , spec.template字段在定义时仅给出了metadata和 spec两个字段 , 它的使用方法与自主式Pod资源几乎完全相同。一个特别的建议是 , 生产环境中运行的Pod对象务必要添加存活探针和就绪探针 , 否则Kubernetes无法准确判定应用的存活状态和就绪状态 , 而只能把处于运行中的容器进程一律视为在健康运行 , 而健康运行的容器进程则一律视为就绪。显然 , 定义在Pod模板中的存储卷资源将由当前模板创建出的所有Pod实例共享使用 , 因此定义时务必要确保该存储卷允许多路客户端同时访问 , 以及多路写操作时的数据安全性 。
应用编排是Kubernetes的核心功能 , 因而控制器资源及其使用的 Pod模板也随之成为最常用的两种资源类型。
2. ReplicaSet控制器
Kubernetes较早期的版本中仅有ReplicationController一种类型 的Pod控制器 , 后来又陆续引入了更多的控制器实现 , 这其中就包括用来取代ReplicationController的新一代实现ReplicaSet。事实上 , ReplicaSet除了支持基于集合的标签选择器 , 以及它的滚动更新 (RollingUpdate)机制要基于更高级的Deployment控制器实现之外 , 目前ReplicaSet的其余功能基本与ReplicationController相同。考虑 到Kubernetes强烈推荐使用ReplicaSet控制器 , 且表示 ReplicationController不久后即将废弃 , 因而本节重点介绍 ReplicaSet控制器。
2.1 功能分析
ReplicaSet(简称RS)是工作负载控制器类型的一种实现 , 隶属于名称空间级别 , 主要用于编排无状态应用 , 核心目标在于确保集群上运行有指定数量的、符合其标签选择器的Pod副本。ReplicaSet规范由标签选择器、期望的副本数和Pod模板3个主要因素所定义 , 它在控制循环中持续监视同一名称空间中运行的Pod对象 , 并在每个循环中将标签选择器筛选出的Pod数量与期望的数量相比较 , 通过删除多余的Pod副本或借助于模板创建出新的Pod来确保该类Pod对象数量能始终吻合所期望的数量。
由此可见 , 标签选择器是ReplicaSet判断一个Pod对象是否处于其作用域的唯一标准 , Pod模板仅在补足缺失数量的Pod对象时使用 , 这意味着由其他Pod规范所创建的Pod对象也存在进入某个ReplicaSet作用域的可能性。因而 , 我们要精心设计同一名称空间中使用的标签选择器 , 以竭力避免它们以相同的条件出现在不同的控制器对象之上 , 这种原则同样交叉适用于其他类型的控制器对象。
ReplicaSet规范中的副本数量、标签选择器 , 甚至是Pod模板都可以在对象创建后随时按需进行修改。降低期望的Pod副本数量会导致删除现有的Pod对象 , 而增加该数量值会促使ReplicaSet控制器根据模板 创建出新的Pod对象。修改标签选择器会导致ReplicaSet在当前名称空间中匹配Pod标签 , 这可能会让它无法再匹配到现有Pod副本的标签 , 进而触发必要的删除或创建操作。另外 , ReplicaSet不会关注筛选到的现存Pod对象或者由其自身创建的Pod对象中的实际内容 , 因此Pod模板的改动也仅会对后来新建的Pod副本有影响。事实上 , ReplicaSet所支持的更新机制也正是建立在Pod模板更新后以“删除后的自动重建” 机制之上。
总结起来 , 相较于手动创建和管理Pod对象来说 , ReplicaSet控制器能够实现以下功能。
确保
Pod对象的数量精确反映期望期:ReplicaSet对象需要确保 由其控制运行的Pod副本数量精确吻合配置中定义的期望值 , 否则会自动补足所缺或终止所余。确保
Pod健康运行: 探测到由其管控的Pod对象健康状态检查失败 或因其所在的工作节点故障而不可用时 , 自动请求控制平面在其他工作节点创建缺失的Pod副本。弹性伸缩 : 应用程序业务规模因各种原因时常存在明显波动 , 如波峰或波谷期间 , 可以通过改动
ReplicaSet控制器规范中的副本数量 动态调整相关Pod资源对象的数量 , 甚至是借助HPA控制器实现Pod资源规模的自动伸缩。
但ReplicaSet并非是用户使用无状态应用控制器的最终形态 , Deployment控制器基于ReplicaSet实现了滚动更新、自动回滚、金丝 雀部署甚至是蓝绿部署等更为高级和自动化的任务编排功能 , 因而成为用户在编排无状态应用时更高级的选择。本节独立介绍ReplicaSet 只是帮助读者更好地理解Deployment控制器的基础功能。
2.2 ReplicaSet基础应用
ReplicaSet由kind、apiVersion、metadata、spec和status这5个 一级字段组成 , 它的基本配置框架如下面的配置规范所示。
apiVersion: apps/v1
kind: ReplicaSet
metadata:
  name: …
  namespace: …
spec:
  minReadySeconds <integer>  # Pod就绪后多少秒内 , 任一容器无崩溃方可视为“就绪”
  replicas <integer> # 期望的Pod副本数 , 默认为1
  selector:    # 标签选择器 , 必须匹配template字段中Pod模板中的标签
    matchExpressions <[]Object>     # 标签选择器表达式列表 , 多个列表项之间为“与”关系
    matchLabels <map[string]string> # map格式的标签选择器
  template:    # Pod模板对象
    metadata:  # Pod对象元数据
      labels:  # 由模板创建出的Pod对象所拥有的标签 , 必须要能够匹配前面定义的标签选择器
    spec:      # Pod规范 , 格式同自主式Pod
……ReplicaSet规范中用于定义标签选择器的selector字段为必先字段 , 它支持matchLabels和matchExpressions两种表示格式。前者使用字符串映射格式 , 以key:value形式表达要匹配的标签 ; 后者支持复杂的表达式格式 , 支持基于"等值(运算符=和!=)"和基于"集合" ( 运算符为in和notin等)的表示方法 , 同时定义二者时的内生逻辑为 “与”关系。Pod模板中定义的标签必须要能匹配到其所属ReplicaSet 对象的标签选择器 , 否则 , ReplicaSet将因始终不具有足额的Pod副本数而无限创建下去 , 这相当于程序代码中无终止条件的死循环。另 外 , minReadySeconds字段用于指定在Pod对象启动后的多长时间内其容器未发生崩溃等异常情况即被视为“就绪” , 默认为值0秒 , 表示一 旦就绪性探测成功 , 即被视作可用。
将“1.2 Pod模板资源”一节中的示例保存于资源清单文件中 , 例如 replicaset-demo.yaml , 而后即可使用类似如下命令将其创建到集群上来观察其运行特性。
~$ kubectl apply -f replicaset-demo.yaml
replicaset.apps/replicaset-demo created ReplicaSet对象的详细描述信息会输出对象的重点信息 , 例如标签选择器、Pod状态、Pod模板和相关的事件等。ReplicaSet控制器会追踪作用域的各Pod的运行状态 , 并把它们归类到Running、Waiting、 Succeeded和Failed这4种状态之中。default名称空间中并未存在使用 app: replicaset-demo这一标签的Pod对象 , 因此replicaset-demo需要根据指定的Pod模板创建出replicas字段指定数量的Pod实例 , 它们的名称以其所属的ReplicaSet对象的名称为前缀。如下的命令输出中可知 , replicaset-demo成功创建出的两个Pod实例均处于健康运行状态。
root@kubeadm-master1:~# kubectl describe replicasets/replicaset-demo
Name:         replicaset-demo
Namespace:    default
Selector:     app=demoapp,release=stable
Labels:       <none>
Annotations:  <none>
Replicas:     2 current / 2 desired
Pods Status:  2 Running / 0 Waiting / 0 Succeeded / 0 Failed
Pod Template:
  Labels:  app=demoapp
           release=stable
  Containers:
   demoapp:
    Image:        ikubernetes/demoapp:v1.0
    Port:         80/TCP
    Host Port:    0/TCP
    Liveness:     http-get http://:80/livez delay=5s timeout=1s period=10s #success=1 #failure=3
    Readiness:    http-get http://:80/readyz delay=15s timeout=1s period=10s #success=1 #failure=3
    Environment:  <none>
    Mounts:       <none>
  Volumes:        <none>
Events:
  Type    Reason            Age   From                   Message
  ----    ------            ----  ----                   -------
  Normal  SuccessfulCreate  39s   replicaset-controller  Created pod: replicaset-demo-dqjn9
Normal SuccessfulCreate 39s replicaset-controller Created pod: replicaset-demo-6jnd4我们也可以单独打印ReplicaSet对象的简要及扩展信息来了解其运行状态 , 例如期望的Pod副本数(DESIRED)、当前副本数 (CURRENT)和就绪的副本数(READY) , 以及使用的镜像和标签选择器等 , 如下面的命令及结果所示
root@kubeadm-master1:~# kubectl get  replicasets/replicaset-demo -o wide
NAME              DESIRED   CURRENT   READY   AGE    CONTAINERS   IMAGES                     SELECTOR
replicaset-demo   2         2         2       2m3s   demoapp      ikubernetes/demoapp:v1.0   app=demoapp,release=stable
通常 , 就绪的副本数量与期望的副本数量相同便意味着该 ReplicaSet控制器以符合期望的状态运行于集群之上 , 由其编排的容器应用可正常借助专用的Service对象向客户端提供服务。
经由ReplicaSet控制器创建与用户自主创建的Pod对象的功能并没有显著区别 , 但其自动调谐功能在很大程度上能为用户省去不少管理 精力 , 这也是Kubernetes系统之上的应用程序变得拥有自愈能力的主要保障。
长期运行中的Kubernetes系统环境存在着不少导致Pod对象数目与期望值不符合的可能因素 , 例如作用域内Pod对象的意外删除、Pod对象标签的变动、ReplicaSet控制器的标签选择器变动 , 甚至是作用域内Pod对象所在的工作节点故障等。ReplicaSet控制器的调谐循环能实时监控到这类异常 , 并及时启动调谐操作。
任何原因导致的标签选择器匹配Pod对象缺失 , 都会由ReplicaSet 控制器自动补足 , 常见的该类场景包括发生在作用域内的Pod对象之上的意外删除、标签变动或所在的节点故障等。例如 , 我们可通过手动 修改replicaset-demo标签选择器作用域内任一现有Pod对象标签 , 使得匹配失败 , 则该控制器的标签选择器会触发控制器的Pod对象副本缺失补足机制 , 其操作步骤如下。
步骤1: 获取replicaset-demo标签选择器作用域内的一个Pod对象:
~$ pod=$(kubectl get pods -l app=demoapp,release=stable -o jsonpath={.items[1].metadata.name})
~$ echo $pod
replicaset-demo-z6bqt
步骤2: 删除该Pod对象的任意一个标签 , 例如app , 使其无法再匹 配到replicaset-demo的标签选择器:
~$ kubectl label pod $pod app-
pod/replicaset-demo-z6bqt labeled
步骤3: 验证replicaset-demo是否将此前的Pod对象替换为了新建 的Pod对象:
~$ kubectl get pods -l app=demoapp,release=stable
NAME                       READY   STATUS   RESTARTS   AGE
replicaset-demo-fcrkl      0/1     Running   0          4s
replicaset-demo-vwb5g      1/1     Running   0          5m49s
步骤4: 可以看到此前的Pod对象依然存在 , 但它成为自主式Pod对象 , 而代表上级引用关系的metadata.ownerReferences字段变成空值 , 于是下面的命令便不再有返回值。
~$ kubectl get pods $pod -o jsonpath={.metadata.ownerReferences}由此可见 , 通过修改Pod资源的标签即可将其从控制器的管控之下 移出 , 若修改后的标签又能被其他控制器资源的标签选择器命中 , 则 该Pod对象又成为隶属另一控制器的副本。若修改其标签后的Pod对象不再隶属于任何控制器 , 它就成了自主式Pod。
另一方面 , 一旦被标签选择器匹配到的Pod对象数量因任何原因超 出期望值 , 多余的部分也将被控制器自动删除。例如 , 我们可以为此前移出作用域的Pod对象重新添加app标签 , 让其能够再次匹配到 replicaset-demo的标签选择器 , 这将触发控制器删除多余的Pod对象 , 如下面的命令结果所示。
~$ kubectl label pods $pod app=demoapp
pod/replicaset-demo-z6bqt labeled
~$ kubectl get pods -l app=demoapp,release=stable
NAME                     READY    STATUS        RESTARTS   AGE
replicaset-demo-fcrkl    1/1     Terminating   0          2m17s
replicaset-demo-vwb5g    1/1     Running       0          8m2s
replicaset-demo-z6bqt    1/1     Running       0          8m2s
测试结果表明 , 同一名称空间下的不同的控制器一定不能使用相同的标签选择器。节点自身故障而导致的Pod对象丢失 , ReplicaSet同样使用补足资源的方式进行处理 , 这里不再详细说明其过程 , 感兴趣 的读者可直接关掉类似上面Pod对象运行所在的某一个节点来验证其处 理过程。
ReplicaSet资源的删除操作同其他标准的API资源一样使用 kubectl delete命令即可完成 , 但删除ReplicaSet对象时默认会一并删除其作用域内的各Pod对象。偶尔 , 考虑到这些Pod资源未必由该 ReplicaSet对象创建 , 或者即便由其创建也并非是其自身的组成部分时 , 也可以在删除命令上使用--cascade=false选项关闭级联删除功 能 , 而保留相关的Pod对象。
2.3 应用更新与回滚
敏捷开发和DevOps文化日益盛行的今天 , 应用更新的周期不断地缩短 , 多的甚至可达一天数次。更新过程自身出现故障 , 或者更新完成后触发新版本应用程序各种未知问题 , 都需要回滚应用程序至更新前的版本。ReplicaSet不会校验作用域内处于活动状态的Pod对象的内 容 , 改动Pod模板的定义对已经创建完成的活动对象无效 , 但在用户手 动删除其旧版本的Pod对象后能够自动以新代旧 , 实现控制器下的应用更新。通过修改Pod中某容器的镜像文件版本进行应用程序的版本升级是最常见的应用更新场景。
尽管ReplicaSet资源的Pod模板可随时按需修改 , 但它仅影响其后 新建的Pod对象 , 对已有的Pod副本不产生作用 , 因此 , ReplicaSet自身并不会自动触发更新机制 , 它依赖于用户的手动触发机制。
提示:
Deployment控制器是建立在ReplicaSet之上的 , 专用于支持声明式更新功能的更高级实现。
在配置清单replicaset-demo.yaml中定义的replicaset-demo资源中 , 修改Pod模板中的容器使用的镜像文件为更高的版本 , 例如下面示 例性配置片段中的ikubernetes/demoapp: v1.1 , 而后将变动的配置清 单重新应用到集群上便可完成ReplicaSet控制器资源的更新。
containers: - name: demoapp
image: ikubernetes/demoapp:v1.1
  ports:
  - name: http
    containerPort: 80
将更新后的配置清单应用到集群之中 , 可以发现 , 现有各Pod对象 中demoapp容器的镜像版本与replicaset-demo的Pod模板中的镜像版本 存在差异。
~$ kubectl apply -f replicaset-demo.yaml
replicaset.apps/replicaset-demo configured
首先 , 我们可以使用如下命令获取活动对象replicaset-demo的 Pod模板中定义的镜像文件及版本信息:
~$ kubectl get replicasets/replicaset-demo -o jsonpath={.spec.template.spec.containers[0].image}
ikubernetes/demoapp:v1.1
接着 , 通过如下命令获取replicaset-demo控制下的所有Pod对象中的demoapp容器的镜像文件及版本信息:
$ kubectl get pods -l app=demoapp,release=stable  -o jsonpath='{range .items[*]}[{.metadata.name}, {.spec.containers[0].image}]{"\n"}{end}' [0].image}]{"\n"}{end}'
[replicaset-demo-vwb5g, ikubernetes/demoapp:v1.0]
[replicaset-demo-z6bqt, ikubernetes/demoapp:v1.0]上面两个命令及返回结果证实了“更新Pod模板不会对现在的Pod 对象产生实质影响”的结论。另一方面 , Pod中定义的容器及镜像的字段是不可变字段 , 我们无法在Pod创建完成后动态更新其容器镜像 , 因 而接下来只有手动将replicaset-demo的现有Pod对象移出其标签选择器作用域(修改标签或删除Pod对象)来触发基于新的Pod模板新建Pod 对象 , 以完成应用的版本更新。
2.3.1 常见更新机制
常见的更新机制有如下两种。
单批次替换 , 一次性替换所有
Pod对象(见图): 也称为重建式更新(recreate) , 是最为简单、高效的更新方式 , 但会导致相应的服务在一段时间内(至少一个Pod对象更新完成并就绪)完全不可用 , 因而一般不会用在对服务可用性有较高要求的生产环境中。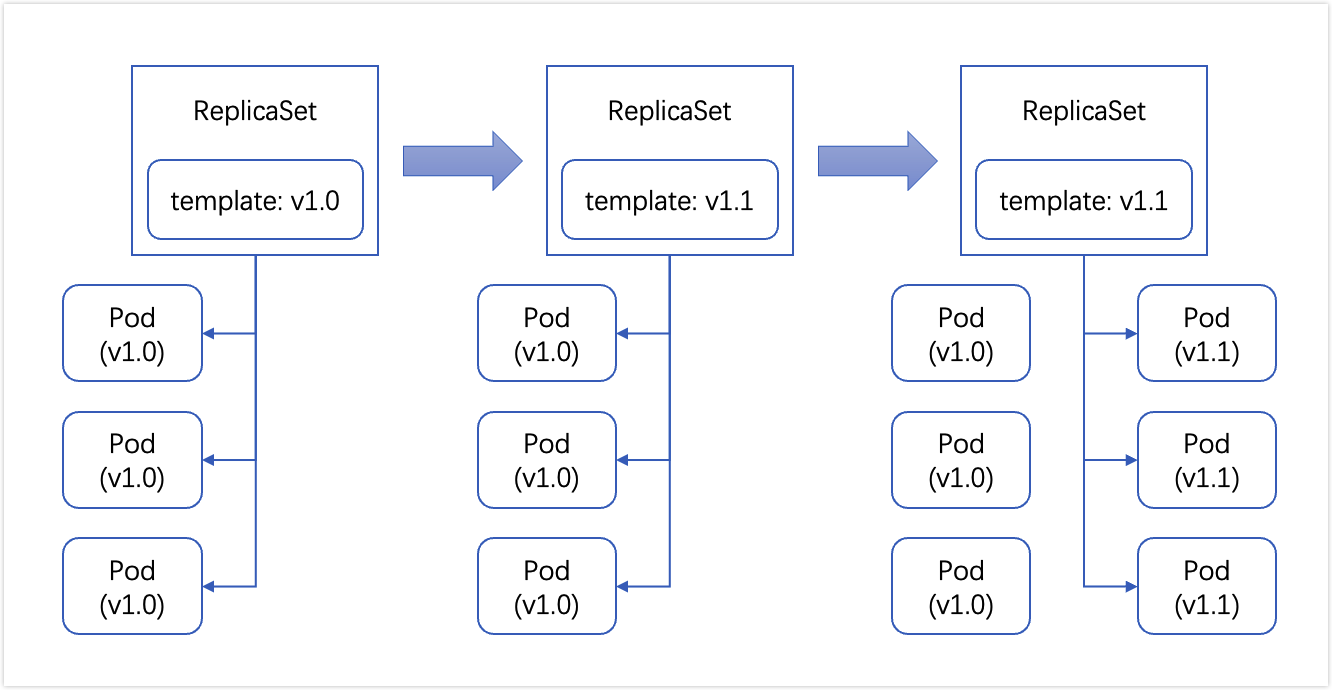
多批次替换: 一次仅替换一批
Pod对象(见图),也称为滚动更新 , 是一种略复杂的更新方式 , 需要根据实时业务量和Pod对象的总体承载力做好批次规划 , 而后待一批Pod对象就绪后再更新另一批 , 直到全部完成为止 ; 该策略实现了不间断服务的目标 , 但更新过程中会出现不同的应用版本并存且同时提供服务的状况。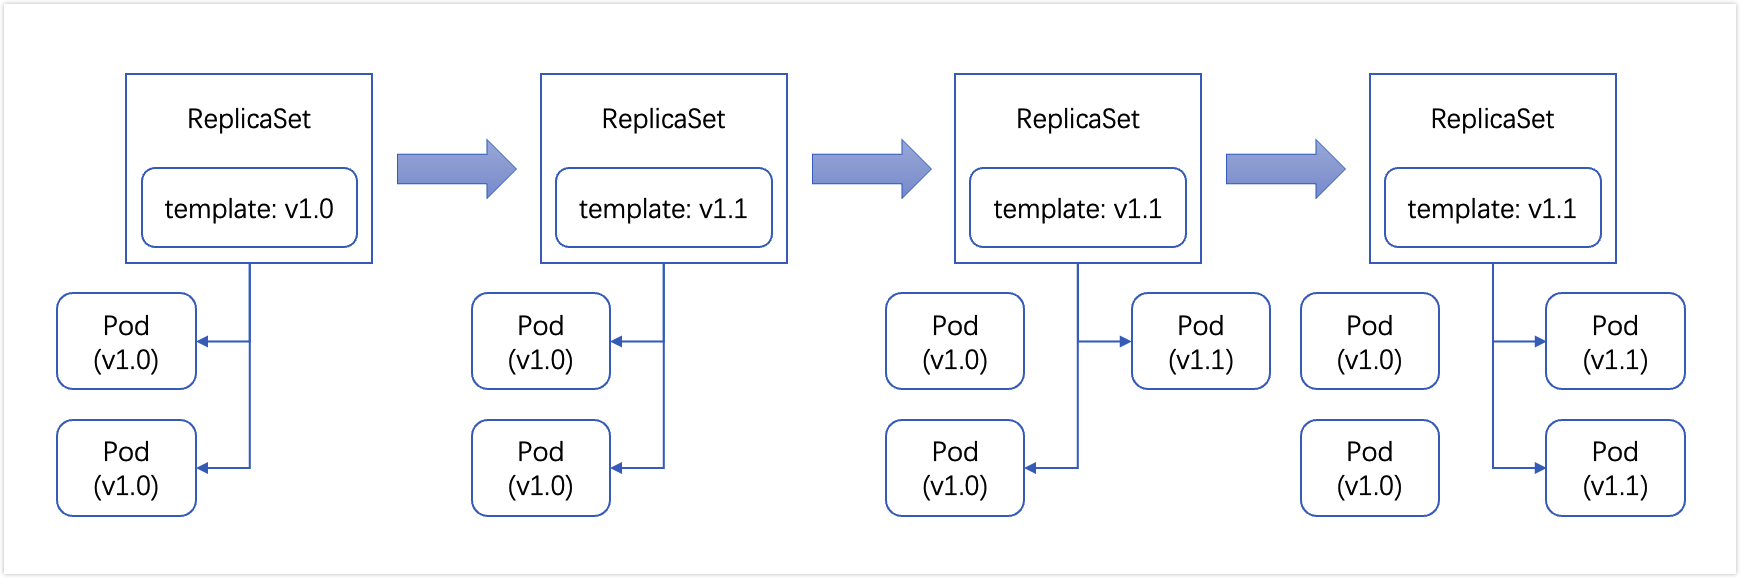
接下来 , 我们在
replicaset-demo之上分别进行更新测试来验证这两种方式的更新效果。我们先为replicaset-demo作用域内的各Pod对象创建一个ClusterIP类型的Service对象 , 以方便客户端在更新过程 中进行请求测试 , 以下配置保存于service-for-replicaset-demo.yaml清单文件中。apiVersion: v1 kind: Service metadata: name: demoapp namespace: default spec: type: ClusterIP selector: app: demoapp release: stable ports: - name: http port: 80 protocol: TCP targetPort: 80接下来 , 将上面配置清单中的
Service对象demoapp通过如下命令 创建到集群之上 , 随后的应用测试将以之作为访问入口。~$ kubectl apply -f service-for-replicaset-demo.yaml service/demoapp created
2.3.2 重建式更新测试
在管理节点上打开一个新的终端 , 创建一个临时的客户端
Pod并发起持续性的请求测试 , 以验证单批次更新过程中是否会发生服务中断。~$ kubectl run pod-$RANDOM --image=ikubernetes/admin-toolbox:v1.0 -it --rm --command -- /bin/sh [root@pod-28426 /]#此时 , 在临时
Pod的交互式接口中运行如下循环进行请求测试 , 立即可以看到v1.0版本的demoapp的响应结果 ;[root@pod-28426 /]# while true; do curl --connect-timeout 1 demoapp.default.svc; sleep 1; done删除
replicaset-demo作用域内的所有Pod对象 , 而后观察其更新结果。~$ kubectl delete pods -l app=demoapp,release=stable pod "replicaset-demo-vwb5g" deleted pod "replicaset-demo-z6bqt" deleted使用如下命令查看是否生成具有同样标签的新Pod对象。 在如下命令结果中的任何一个新
Pod对象就绪之前 ,curl命令返回结果 会出现一定数量的请求超时 , 这是单批次更新的必然结果 ; 验证完成 后 , 应该停止测试循环。~$ kubectl get pods -l app=demoapp,release=stable NAME READY STATUS RESTARTS AGE replicaset-demo-mjc5x 0/1 Running 0 10s replicaset-demo-w5lxw 0/1 Running 0 10s验证这些新的
Pod对象中demoapp容器是否更新为指定的新镜像文件及版本。~$ kubectl get pods -l app=demoapp,release=stable -o jsonpath='{range .items[*]}[{.metadata.name},{.spec.containers[0].image}]{"\n"}{end}' [replicaset-demo-mjc5x, ikubernetes/demoapp:v1.1] [replicaset-demo-w5lxw, ikubernetes/demoapp:v1.1]
事实上 , 修改Pod模板时 , 不仅能替换镜像文件的版本 , 甚至可以 将其替换为其他应用程序的镜像 , 只不过此类需求并不多见。若同时改动的还有Pod模板中的其他字段 , 在新旧更替的过程中 , 它们也将随 之被应用。
2.3.3 滚动式更新测试
同前一节中的测试方式相似 , 我们需要在管理节点上打开 一个新的终端 , 创建一个临时的客户端
Pod以发起持续性的请求测试 , 以验证滚动更新过程中是否会发生服务中断。~$ kubectl run pod-$RANDOM --image=ikubernetes/admin-toolbox:v1.0 -it \ --rm --command -- /bin/sh [root@pod-10196 /]#此时 , 在临时
Pod的交互式接口中运行如下循环进行请求测试 , 立即可以看到v1.0版本的demoapp的响应结果 ;[root@pod-10196 /]# while true; do curl --connect-timeout 1 \ demoapp.default.svc; sleep 1; done更新
replicaset-demo的Pod模板中demoapp容器使用ikubernetes/demoapp:v1.2镜像。本次 , 我们使用更便捷的kubectl set image命令。~$ kubectl set image replicasets/replicaset-demo demoapp="ikubernetes/demoapp:v1.2" replicaset.apps/replicaset-demo image updated将
replicaset-demo作用域的仅有的两个Pod对象分成两个批次进行更新。为了便于识别待删除对象 , 下面的命令获取现有的相关两个Pod对象的名称保存在数组中 , 并打印出相关的Pod对象名称。~$ pods=($(kubectl get pods -l app=demoapp,release=stable -o jsonpath="{range .items[*]}{.metadata.name}{'\t'}{end}")) ~$ echo ${pods[@]} replicaset-demo-l857r replicaset-demo-r9t8f尝试删除一个
Pod对象 , 以触发启动更新操作。随后 , 立 即运行一个交互式的监视命令持续监视replicaset-demo作用域内各Pod对象的状态变动 , 可以看到旧版本Pod对象的删除及新Pod创建过程中的事件。~$ kubectl delete pods ${pods[1]} pod "replicaset-demo-r9t8f" deleted ~$ kubectl get pods -l app=demoapp,release=stable -w NAME READY STATUS RESTARTS AGE replicaset-demo-l857r 1/1 Running 0 143m replicaset-demo-r9t8f 1/1 Terminating 0 143m replicaset-demo-zxsh7 0/1 Running 0 8s replicaset-demo-zxsh7 1/1 Running 0 20s在删除命令执行后的新建
Pod对象replicaset-demo-zxsh7就绪之 前 , 客户端持续发出访问请求的所有响应均应该来自未删除的旧版本Pod对象。新Pod就绪后才能由相应的Service对象demoapp识别为Ready状态的后端端点 , 并路由请求报文至该端点 , 此时响应报文来自一新一旧两个版本的Pod对象 , 下面的内容就截取自相关测试命令的返回结果iKubernetes demoapp v1.2 !!……, ServerName: replicaset-demo-zxsh7, ServerIP: 10.244.3.16! iKubernetes demoapp v1.1 !!……, ServerName: replicaset-demo-l857r, ServerIP: 10.244.1.41!再删除另一个旧版本的
Pod对象 , 待替换的新Pod就绪后 , 测试命令的响应内容均来自于新版本的Pod对象 , 滚动更新也就全部完 成了。~$ kubectl delete pods ${pods[0]} pod "replicaset-demo-l857r" deleted
由以上测试过程可知 , 滚动更新过程不会导致服务中断 , 唯一的问题在于两个版本有短暂的共存期 , 若两个版本使用了不同的数据库格式 , 则需要禁止新版本执行写操作 , 以免数据异常。必要时 , 用户 还可以将Pod模板改回旧的版本进行应用的“降级”或“回滚” , 它的操作过程与上述过程类似 , 不同之处仅是将镜像文件改为过去曾使用 过的历史版本。
2.4 应用扩容与缩容
改动ReplicaSet控制器对象配置中期望的Pod副本数量(replicas字段)会由控制器实时做出响应 , 从而实现应用规模的水平伸缩。 replicas的修改及应用方式同Pod模板 , 不过 , kubectl提供了一个专用的子命令scale用于实现应用规模的伸缩 , 它支持从资源清单文件中获取新的目标副本数量 , 也可以直接在命令行通过--replicas选项读取 , 例如将replicaset-demo控制器的Pod副本数量提升至4个:
~$ kubectl scale replicasets/replicaset-demo --replicas=4
replicaset.apps/replicaset-demo scaled由下面显示的rs-example资源的状态可以看出 , 将其Pod资源副本扩展至5个的操作已经成功完成:
~$ kubectl get replicasets/replicaset-demo
NAME              DESIRED   CURRENT   READY   AGE
replicaset-demo 4 4 4 3hReplicaSet缩容的方式与扩容方式相同 , 我们只需要明确指定目标副本数量即可。例如:
~$ kubectl scale replicasets/replicaset-demo --replicas=1
replicaset.apps/replicaset-demo scaled
~$ kubectl get replicasets/replicaset-demo
NAME              DESIRED   CURRENT   READY   AGE
replicaset-demo   1         1         1       3h
另外 , kubectl scale命令还支持在现有Pod副本数量符合指定值 时才执行扩展操作 , 这仅需要为命令使用--current-replicas选项即 可。例如 , 下面的命令表示如果replicaset-demo目前的Pod副本数量 为2 , 就将其扩展至3个:
~$ kubectl scale replicasets/replicaset-demo --current-replicas=2 --replicas=3
error: Expected replicas to be 2, was 1但由于replicaset-demo控制器现存的副本数量是1个 , 上面的扩容操作不会真正执行 , 而是仅返回了错误提示。
2.5 高级更新策略
除联合使用多个ReplicaSet外 , 我们还能为应用更新功能模拟实现更加灵活和更易于维护的滚动更新、金丝雀部署和蓝绿部署等。
2.5.1 滚动更新
ReplicaSet上的应用更新也能够不改变现有资源(简称为rs old)的定义 , 而是借助创建一个有着新版本Pod模板的新ReplicaSet 资源(简称为rs-new)实现。新旧版本的ReplicaSet使用了不同的标签选择器 , 它们筛选相同的Pod标签 , 但至少会有一个标签匹配到不同的值 , 余下的标签各自匹配相同值 , 相关的Service对象的标签选择器会匹配这些拥有相同值的标签。
我们可以设计用rs-old和rs-new共同筛选app、release和version 标签 , 其中app和release分别匹配相同值 , 例如app=demoapp、 release=stable , 而version则匹配不同值 , 如rs-old匹配 version=v1.0 , 而rs-new匹配version=v1.1。同时 , Service的标签选择器则筛选app=demoapp和release=stable , 以便能匹配到更新期间两个不同ReplicaSet作用域内不同版本的Pod对象。具体如图所示。
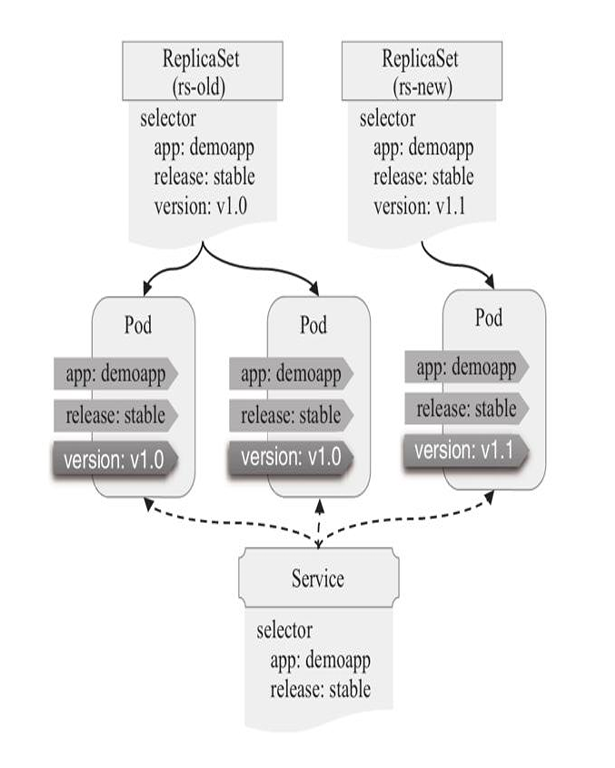
rs-new的初始副本数为0 , 在更新过程中 , 我们以特定的分批(每个批次简称1个单位或步长) 策略逐步增加rs-new的replicas字段值 , 并同步降低rs-old的replicas字段值 , 直到rs-new副本数为期望的数 量 , 而rs-old的副本数为0时更新过程结束 , 如图所示。
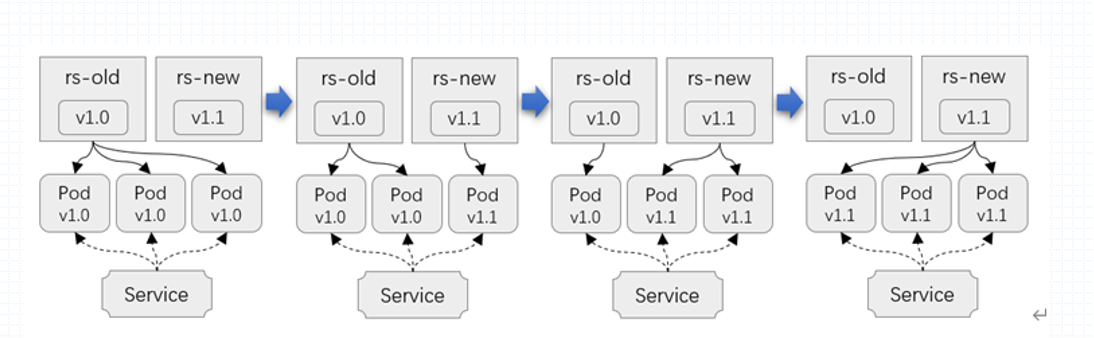
具体操作时 , 我们可以采取如下3种不同的策略进行整个滚动更新过程:
先于
rs-new上增加1个单位的Pod副本 , 待全部就绪后再于rs-old上降低1个单位的副本数 , 待所有旧Pod成功终止后进行下一批次 ;先于
rs-old上降低1个单位的Pod副本 , 待所有旧Pod成功终止后再于rs-new上增加1个单位的副本数 , 再待所有新Pod对象就绪后进行 下一批次 ;以同步的方式进行 ,
rs-new上新增1个单位的Pod对象 , 与此同 时 ,rs-old上降低1个单位的副本数 , 等新Pod全部就绪且旧Pod全部成功终止后进行下一批次。
由此可见 , 第一和第三种策略会导致更新过程中 , 新旧两个 ReplicaSet资源作用域内的Pod对象总和超出用户期望的副本数 , 而第 二种和第三种策略会使得更新过程中Service的可用后端端点数缺少1 个单位 , 但第三种策略能够更快地完成更新过程。因而 , 选择更新策 略就存在两种重要的判断标准: 一是Kubernetes集群资源是否可承载 短时间内Pod数量的增加 ; 另一个是支撑相应服务请求总量所依赖的 Pod实例数。
无论采取哪种滚动策略 , 我们都可以让更新过程在完成第一批次后暂停一段时长 , 根据新版本发现的问题以及路由到新版本应用上的 用户体验和反馈 , 来判断是继续完成余下批次的更新操作 , 还是撤回 此前一个批次的更新操作。显然 , 这种方式能够降低更新过程中的风 险 , 它通过放出的一只“金丝雀”( canary) 避免了更大范围的更新 故障。
另外 , 我们可保留最近一个范围内的副本数为0的旧版本的 ReplicaSet资源于更新历史中 , 以便按需对比历史更新中所做出的改动 , 随时按需以类似于“回滚”的更新策略应用至历史中的任一版本。但显然上述的这些操作步骤过于烦琐 , 以手动方式操作极易出错 , 幸运的是 , 更高级别的Pod控制器Deployment能自动实现滚动更新 和回滚 , 并为用户提供了自定义更新策略的接口 。
2.5.2 蓝绿部署
滚动更新过程中 , 会存在两个不同版本的应用同时向客户端提供服务 , 且更新和回滚过程耗时较长。另一种更为妥帖的更新方式是 , 在旧版本ReplicaSet资源运行的同时直接创建一个全Pod副本的新版本 ReplicaSet , 待所有的新Pod就绪后一次性地将客户端流量全部迁至新版本之上 , 这种更新策略也称为蓝绿部署(Blue-Green Deployment)。
显然 , 为了避免更新过程中新旧版本ReplicaSet资源的Pod完全并存时Service将流量发往不同版本的Pod对象 , 我们需要设定Service使用的标签选择器仅能匹配到其中一个版本的Pod对象。最简单的实现方式是让Service与ReplicaSet使用完全相同的标签选择器 , 但每次更新过程中 , 在新版本所有Pod就绪之后 , 修改其标签选择器与新版本的 ReplicaSet的标签选择器相同 , 如图所示
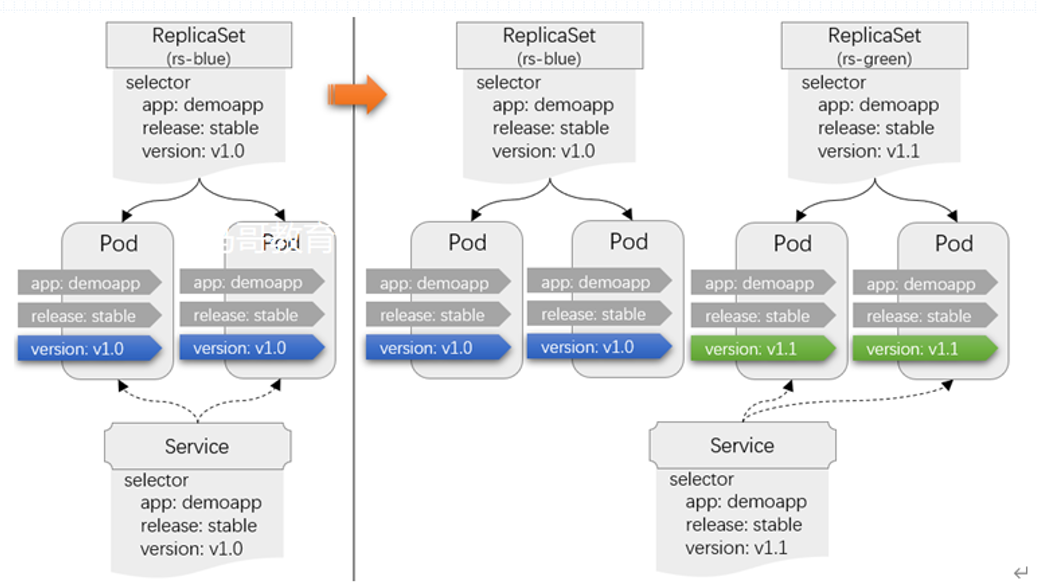
Service将所有客户端流量代理至新版本的Pod上运行一段时长之 后 , 若确定运行正常 , 即可将旧版本ReplicaSet的副本数置零后保存到历史版本序列中。相较于滚动更新来说 , 蓝绿部署实现步骤要简单很多 , 用户完全能够以手动方式完成。
例如 , 下面的配置清单通过环境变量的方式定义了一个可复用的 ReplicaSet资源规范 , 其中的DEPLOY代表部署类型blue或green , 而 VERSION则用于表示demoapp的程序版本号 , 它保存在replicaset blue-green.yaml文件中。
apiVersion: apps/v1
kind: ReplicaSet
metadata:
  name: rs-${DEPLOY}
spec:
  minReadySeconds: 3
  replicas: 2
  selector:
    matchLabels:
      app: demoapp
      ctr: rs-${DEPLOY}
      version: ${VERSION}
  template:
    metadata:
      labels:
        app: demoapp
        ctr: rs-${DEPLOY}
        version: ${VERSION}
    spec:
      containers:
      - name: demoapp
        image: ikubernetes/demoapp:${VERSION}
        ports:
        - name: http
containerPort: 80而下面的这个配置清单以类似的方式定义了一个方便复用的Service资源规范 , 其中的环境变量的作用与前一个配置清单中的环境变量相同 , 该配置保存在service-blue-green.yaml文件中。
apiVersion: v1
kind: Service
metadata:
  name: demoapp-svc
  namespace: default
spec:
  type: ClusterIP
  selector:
    app: demoapp
    ctr: rs-${DEPLOY}
    version: ${VERSION}
  ports:
  - name: http
    port: 80
    protocol: TCP
    targetPort: 80
为了测试蓝绿部署的效果 , 我们先将replicaset-blue-green.yaml配置清单中的ReplicaSet资源以rs-blue的名称部署为待更新的老版本 , 它使用1.0的demoapp镜像 , 创建的Pod对象名称均以rs-blue为前缀。
~$ DEPLOY='blue' VERSION='v1.0' envsubst < replicaset-blue-green.yaml | kubectl apply -f -
replicaset.apps/rs-blue created提示:
envsubst是一个shell命令 , 能够从标准输入接收文本 , 完成环境变量替换。
接下来 , 将service-blue-green.yaml配置清单中的Service资源 demoapp-svc部署到集群上 , 它使用同rs-blue对象相同的标签选择器 , 等rs-blue作用域内的至少一个Pod就绪后即可接受客户端请求。
~$ DEPLOY='blue' VERSION='v1.0' envsubst < service-blue-green.yaml | kubectl apply -f -
service/demoapp-svc created
随后 , 在新终端中启动一个用于测试的临时Pod对象 , 在其接口使用curl命令发起持续性访问请求。
~$ kubectl run pod-$RANDOM --image=ikubernetes/admin-toolbox:v1.0 -it  --rm --command -- /bin/sh
[root@pod-30411 /]#
[root@pod-30411 /]# while true; do curl --connect-timeout 1 demoapp-svc; sleep 1; done待rs-blue期望的两个Pod对象均能正常提供服务后 , 即可假设需要更新到新的demoapp版本。此时 , 我们需要先基于replicaset-blue green.yaml配置清单创建名为rs-green的新版本ReplicaSet。
~$ DEPLOY='green' VERSION='v1.1' envsubst < replicaset-blue-green.yaml | kubectl apply -f - replicaset.apps/rs-green created随后 , 等到rs-green的两个Pod均就绪后 , 将Service对象 demoapp-svc的标签选择器修改为匹配新版本ReplicaSet对象rs-green 作用域内的所有Pod , 可通过如下命令完成。
~$ DEPLOY='green' VERSION='v1.1' envsubst < service-blue-green.yaml | kubectl apply -f -
service/demoapp-svc configured
这时 , 我们可以在专用于发起请求测试的终端上看到所有的响应报文均来自新版本的Pod中的容器应用demoapp。最后 , 将rs-blue的 Pod副本数设置为0即可。
~$ kubectl scale replicasets/rs-blue --replicas=0
replicaset.apps/rs-blue scaled
显然 , 由于蓝绿部署要求两个及以上版本应用的Pod同时在线 , 对于应用规模较大而集群资源较为紧张的场景就成为“不可能”任务 , 而滚动更新则不具有这方面的问题。下面我们将着力介绍可用于声明式更新功能的Deployment控制器。
3. Deployment控制器
Deployment(简写为deploy)是Kubernetes控制器的一种高级别实现, 它构建于ReplicaSet控制器之上, 如图所示。它可用于为 Pod和ReplicaSet资源提供声明式更新, 并能够以自动方式实现2节 中介绍的跨多个ReplicaSet对象的滚动更新功能。相比较来说, Pod和 ReplicaSet是较低级别的资源, 以至于很少被直接使用。
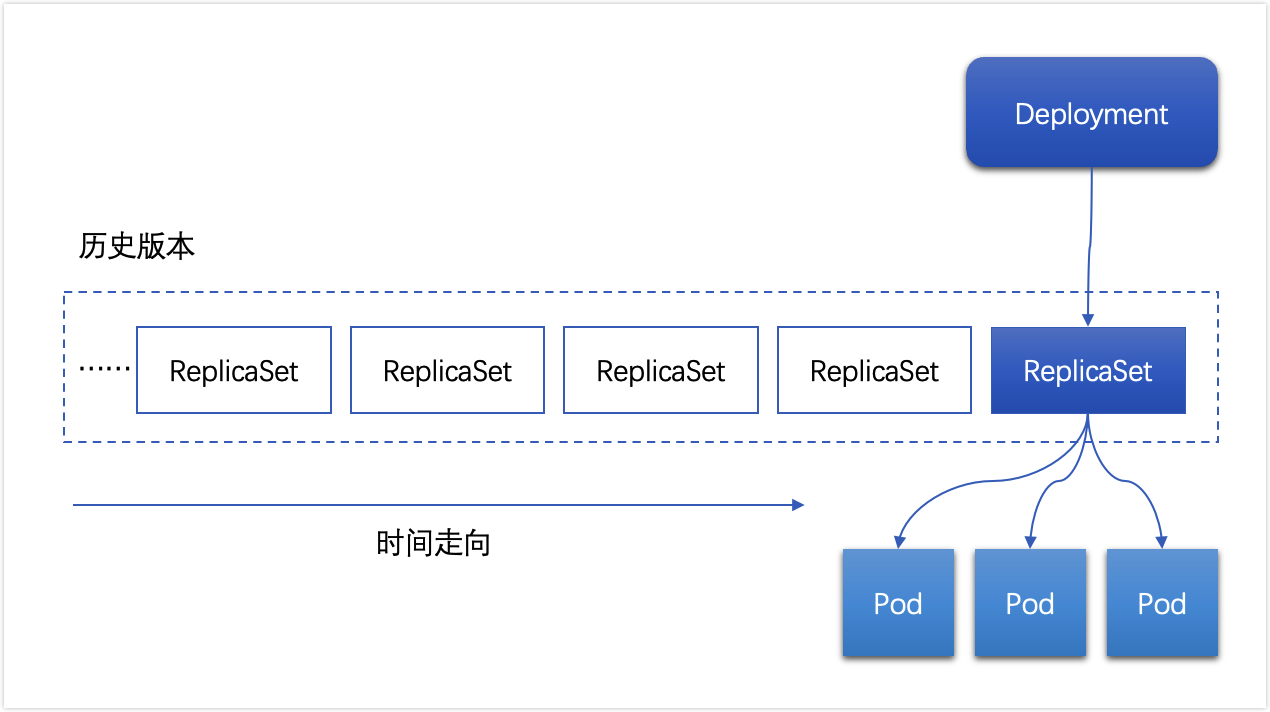
Deployment控制器资源的主要职责同样是为了保证Pod资源健康运行, 其大部分功能通过调用ReplicaSet控制器实现, 并增添了部分特性。
事件和状态查看: 必要时可以查看
Deployment对象的更新进度和 状态。版本记录: 将
Deployment对象的更新操作予以保存, 以便后续可能执行的回滚操作使用。回滚: 更新操作启动后的任一时刻(包括完成后)发现问题, 都可以通过回滚机制将应用返回到前一个或由用户指定的历史记录中的版本。
暂停和启动: 更新过程中能够随时暂停和继续完成后面的步骤。
多种更新方案: 一是
Recreate, 即重建更新机制, 单批次更新所有Pod对象 ; 另一个是RollingUpdate, 即滚动更新机制, 多批次逐步替换旧有的Pod至新的版本。
Deployment资源的扩缩容机制与ReplicaSet相同, 修改.spec.replicas即能实时触发其规模变动操作。另外, kubectl scale是专用于扩展特定控制器类型的应用规模的命令, 包括 Deployment、ReplicaSet和StatefulSet等。
3.1 Deployment基础应用
Deployment是标准的API资源类型, 它以ReplicaSet资源为基础资源进行应用编排, 并能够自动实现策略式滚动更新或单批次重建式更 新, 因而它的spec字段中嵌套使用的字段包含了ReplicaSet控制器支持的所有字段, 而Deployment也正是利用这些信息完成其二级资源 ReplicaSet对象的创建。另外, Deployment还支持几个专用于定义部署及相关策略的字段, 具体使用说明如下。
apiVersion: apps/v1           # API群组及版本
kind: Deployment              # 资源类型特有标识
metadata:
  name <string>               # 资源名称, 在作用域中要唯一
  namespace <string>          # 名称空间 ; Deployment隶属名称空间级别
spec:
  minReadySeconds <integer>   # Pod就绪后多少秒内任一容器无崩溃方可视为“就绪”
  replicas <integer>          # 期望的Pod副本数, 默认为1
  selector <object>           # 标签选择器, 必须匹配template字段中Pod模板的标签
  template <object>           # Pod模板对象
  revisionHistoryLimit <integer> # 滚动更新历史记录数量, 默认为10
  strategy <Object>           # 滚动更新策略
    type <string>             # 滚动更新类型, 可用值有Recreate和Rollingupdate
    rollingUpdate <Object>    # 滚动更新参数, 专用于RollingUpdate类型
      maxSurge <string>       # 更新期间可比期望的Pod数量多出的数量或比例
      maxUnavailable <string> # 更新期间可比期望的Pod数量缺少的数量或比例
  progressDeadlineSeconds <integer> # 滚动更新故障超时时长, 默认为600秒
  paused <boolean>            # 是否暂停部署过程
若无须自定义更新策略等相关配置, 除了资源类型之外, Deployment资源的基础配置格式几乎与ReplicaSet完全相同。下面是 一个配置清单示例, 它定了一个名为deployment-demo的Deployment资源, 为了便于复用, 我们把镜像标签以环境变量VERSION进行标识。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: deployment-demo
spec:
  replicas: 4
  selector:
    matchLabels:
      app: demoapp
      release: stable
  template:
    metadata:
      labels:
        app: demoapp
        release: stable
    spec:
      containers:
      - name: demoapp
        image: ikubernetes/demoapp:${VERSION}
        ports:
        - containerPort: 80
          name: http
        livenessProbe:
          httpGet:
            path: '/livez'
            port: 80
          initialDelaySeconds: 5
        readinessProbe:
          httpGet:
            path: '/readyz'
            port: 80
          initialDelaySeconds: 15
同其他类型资源的创建方式类似, Deployment资源规范同样使用 kubectl apply或kubectl create命令进行创建, 但为了真正、全面地体现Deployment的声明式配置功能, 建议统一使用声明式的管理机制 创建和更新Deployment资源。
~$ VERSION='v1.0' envsubst < deployment-demo.yaml | kubectl apply --record -f -
deployment.apps/deployment-demo created
kubectl get deployments命令可以列出创建的Deployment对象的简要状态信息, 下面命令结果显示出的字段中, UP-TO-DATE表示已经满足期望状态的Pod副本数量, 而AVAILABLE则表示当前处于就绪状态 并已然可向客户端提供服务的副本数量。
~$ kubectl get deployments/deployment-demo
NAME             READY   UP-TO-DATE     AVAILABLE       AGE
deployment-demo 4/4 4 4 36sDeployment资源会由控制器自动创建下级ReplicaSet资源, 并自动为其生成一个遵循[DEPLOYMENT-NAME]-[POD-TEMPLATE-HASH-VALUE] 格式的名称, 其中的hash值由Deployment控制器根据Pod模板计算生成。另外, Deployment还会将用户定义在Pod模板上的标签应用到下级 ReplicaSet资源之上, 并附加一个pod-template-hash的标签, 标签值即Pod模板的hash值。
root@kubeadm-master1:~# kubectl get replicasets -l app=demoapp,release=stable --show-labels
NAME                         DESIRED   CURRENT   READY   AGE   LABELS
deployment-demo-6c48dd6779 4 4 4 25m app=demoapp,pod-template-hash=6c48dd6779,release=stablePod对象则使用同上级ReplicaSet资源一样的标签, 包括pod-template-hash, 而各Pod对象的名称同样遵循ReplicaSet对象对Pod命 名的格式 , 它以ReplicaSet对象的名称为前缀, 后跟5位随机字符。下 面使用awk过滤出了get pods命令结果中的以deployment-demo开头的所有Pod资源, 并显示了它们的标签。
root@kubeadm-master1:~# kubectl get pods --show-labels | awk '/^deployment-demo-/{print $1,$NF}'
deployment-demo-6c48dd6779-b9m2k app=demoapp,pod-template-hash=6c48dd6779,release=stable
deployment-demo-6c48dd6779-mxw86 app=demoapp,pod-template-hash=6c48dd6779,release=stable
deployment-demo-6c48dd6779-n7xgn app=demoapp,pod-template-hash=6c48dd6779,release=stable
deployment-demo-6c48dd6779-p6pw2 app=demoapp,pod-template-hash=6c48dd6779,release=stable
事实上, Deployment及下级ReplicaSet真正使用的标签选择器也包含pod-template-hash标签, 这正是确保Deployment通过多 ReplicaSet资源进行滚动更新时, 确保各ReplicaSet不会交叉引用同一组Pod对象的一种途径。
3.2 Deployment更新策略
如前所述, ReplicaSet控制器的应用更新需要手动分成多步并以特定的次序进行, 过程繁杂且容易出错, 而Deployment却只需要由用户指定在Pod模板中要改动的内容, 例如容器镜像文件的版本, 余下的步骤可交由Deployment控制器自动完成。未定义更新策略的 Deployment 资源, 将以默认方式配置更新策略, 资源详细描述能够输出更新策略的相关配置信息, 下面以deployment-demo资源为例来了解默认的更新策略。
root@kubeadm-master1:~# kubectl describe deployments/deployment-demo
Name:                   deployment-demo
....
Annotations:            deployment.kubernetes.io/revision: 1
                        kubernetes.io/change-cause: kubectl apply --record=true --filename=-
Selector:               app=demoapp,release=stable
Replicas:               4 desired | 4 updated | 4 total | 4 available | 0 unavailable
StrategyType:           RollingUpdate
MinReadySeconds:        0
RollingUpdateStrategy:  25% max unavailable, 25% max surge
......
OldReplicaSets:  <none>
NewReplicaSet:   deployment-demo-6c48dd6779 (4/4 replicas created)
Events:
  Type    Reason             Age   From                   Message
  ----    ------             ----  ----                   -------
Normal ScalingReplicaSet 39m deployment-controller Scaled up replica set deployment-demo-6c48dd6779 to 4 Deployment控制器支持滚动更新(rolling updates)和重新创建 (recreate)两种更新策略, 默认使用滚动更新策略。重建式更新类同前文中ReplicaSet的第一种更新方式 , 即先删除现存的Pod对象 , 而后由控制器基于新模板重新创建出新版本资源对象。通常, 只有当应用的新旧版本不兼容(例如依赖的后端数据库的格式不同且无法兼容)时才会使用recreate策略。但重建策略会导致应用在更新期间不可用, 因而建议用户使用蓝绿部署的方式进行, 除非系统资源不足以支撑蓝绿部署的实现。
Deployment控制器的滚动更新操作并非在同一个ReplicaSet控制器对象下删除并创建Pod资源, 而是将它们分置于两个不同的控制器之 下, 当前ReplicaSet对象的Pod副本数量不断减少的同时, 新 ReplicaSet对象的Pod对象数量不断增加, 直到现有ReplicaSet对象的 Pod副本数为0, 而新控制器的副本数量变得完全符合期望值。新旧版本之间区别彼此Pod对象的关键标签为pod-template-hash。
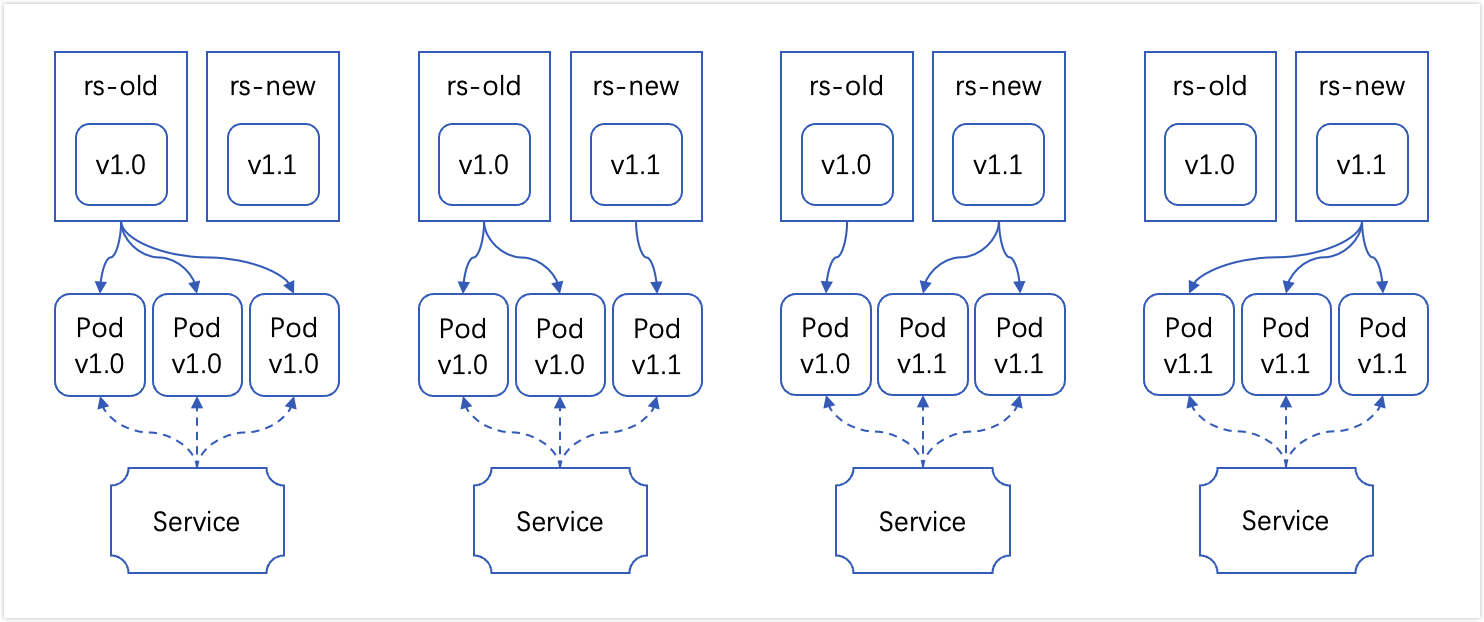
多批次更新模式的默认间隔标准是前一批次的所有Pod对象均已就绪, 方可启动后一批次的更新。而Deployment还提供了两个配置滚动 更新批次的字段 , 以允许用户自定义更新过程的滚动速率, 这两个字段分别用于定义滚动更新期间的Pod总数可向上或向下偏离期望值的幅度。
spec.strategy.rollingUpdate.maxSurge: 指定升级期间存在的总Pod对象数量最多可超出期望值的个数, 其值可以是0或正整数, 也可以是相对于期望值的一个百分比 ; 例如, 如果期望值为10,maxSurge属性值为2, 则表示Pod对象总数至多不能超过12个。spec.strategy.rollingUpdate.maxUnavailable: 升级期间正常可用的Pod副本数(包括新旧版本)最多不能低于期望值的个数, 其值 可以是0或正整数, 也可以是相对于期望值的一个百分比 ; 默认值为1, 这意味着如果期望值是10, 则升级期间至少要有9个Pod对象处于正常提供服务的状态。
如2.5节中的描述, 我们通过组织maxSurge和maxUnavailable两个属性协同工作, 可组合定义出3种不同的策略完成多批次的应用更 新。
先增新, 后减旧: 将
maxSurge设定为小于等于期望值的正整数或相对于期望值的一个百分比, 而maxUnavailable的值为0。先减旧, 后增新: 将
maxUnavailable设定为小于等于期望值的正整数或相对于期望值的一个百分比, 而maxSurge的值为0。同时增减(少减多增) : 将
maxSurge和maxUnavailabe字段的值同时设定为小于等于期望值的正整数或相对于期望值的一个百分比, 二者可以使用不同值。
注意 :
maxSurge和maxUnavailable属性的值不可同时为0, 否则Pod对象 的副本数量在符合用户期望的数量后无法做出合理变动以进行滚动更新操作。
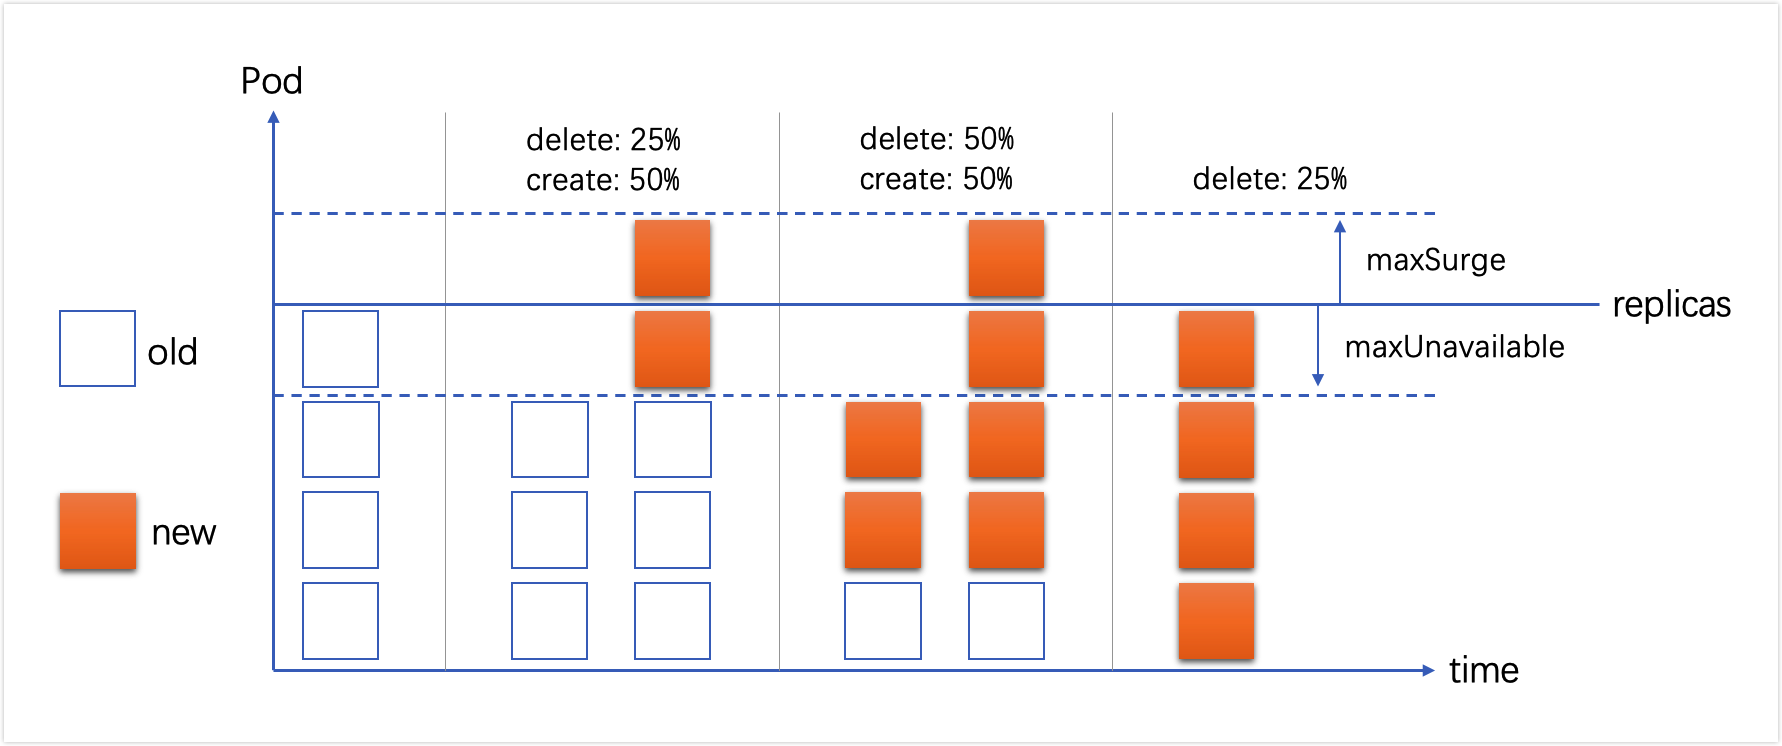
显然, deployment-demo的详细描述显示出, Deployment默认为滚动更新设置了同时增减的策略, 增减的幅度为期望值的25%, 它通过两 个批次的创建和3个批次的删除即能完成整个应用的更新, 具体过程如图所示。不过, 若Pod对象的整体副本数小于4的话, 就只能按一 次1个Pod对象的方式进行。
Deployment还支持使用spec.minReadySeconds字段来控制滚动更新的速度, 其默认值为0, 表示新建的Pod对象一旦“就绪”将立即被 视作可用, 随后即可开始下一轮更新过程。而为该字段指定一个正整数值能够定义新建的Pod对象至少要成功运行多久才会被视作可用, 即就绪之后还要等待minReadySeconds指定的时长才能开始下一批次的更新。在一个批次内新建的所有Pod就绪后但转为可用状态前, 更新操作会被阻塞, 并且任何一个Pod就绪探测失败, 都会导致滚动更新被终止。因此为minReadySeconds赋予一个合理的正整数值, 不仅能够减 缓滚动更新的速度, 还能够让Deployment提前发现一部分程序Bug导致的升级故障。
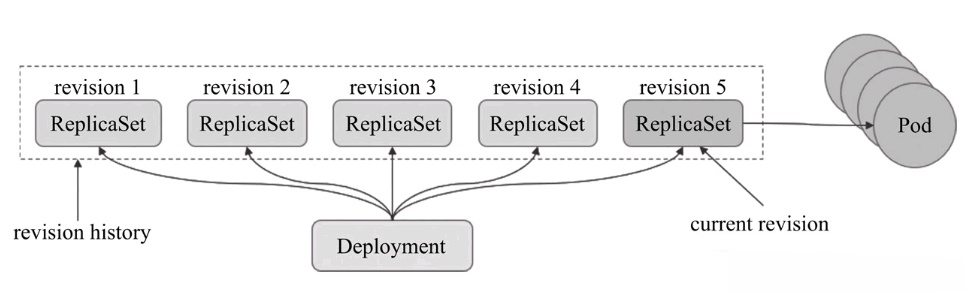
Deployment可保留一部分滚动更新历史(修订记录)中旧版本的 ReplicaSet对象, 如图所示。Deployment资源可保存的历史版本数量由spec.revisionHistoryLimit属性进行定义。
注意 : 为了保存升级历史, 需要在创建
Deployment对象时为命令使用--record选项。为了保存升级历史,后续新版本您不再需要使用--record标志。相反,您可以直接使用kubectl apply命令,Kubernetes会自动记录对资源的更改。这是Kubernetes 1.8版本引入的一个特性,它会自动记录kubectl apply命令的执行历史,无需使用--record标志。
尽管滚动更新以节约系统资源著称, 但它也存在着一些劣势。直接改动现有环境, 会为系统引入不确定性风险, 而且一旦在更新过程中遇到问题, 回滚操作的过程会较为缓慢。有鉴于此, 金丝雀部署可能是较为理想的实现方式。当然, 如果不考虑系统资源的可用性, 那 么传统的蓝绿部署将是更好的选择
3.3 应用更新与回滚
Pod模板内容的变动是触发Deployment执行更新操作的必要条件。 对于声明式配置的Deployment来说, Pod模板的修改尤其适合使用 apply和patch命令进行, 不过, 若仅是修改容器镜像, set image命令则更为易用。
接下来通过更新此前创建的deployment-demo资源来了解 Deployment更新操作过程的执行细节。为了使得升级过程更易于观测, 这里先使用kubectl patch命令为Deployment的 spec.minReadySeconds字段定义一个等待时长, 例如30秒:
~$ kubectl patch deployments/deployment-demo -p '{"spec":{"minReadySeconds":30}}'
deployment.apps/deployment-demo patched注意: 修改
Deployment控制器的minReadySeconds、replicas和strategy等字段的值并不会触发Pod资源的更新操作, 因为它们不属于template的内嵌字段, 对现存的Pod对象不产生任何影响。
接下来, 我们让Pod模板中的demoapp容器使用 ikubernetes/demoapp:v1.1镜像文件, 以触发deployment-demo启动滚 动更新, 下面先尝试使用kubectl apply命令完成更新操作:
~ $ VERSION='v1.1' envsubst < deployment-demo.yaml | kubectl apply --record -f -
deployment.apps/deployment-demo configured
kubectl rollout status命令可用于打印滚动更新过程中的状态 信息:
~$ kubectl rollout status deployments/deployment-demo另外, 我们还可以使用kubectl get deployments -w命令监控其 更新过程中Pod对象的变动过程:
~$ kubectl get deployments/deployment-demo -w滚动更新时, deployment-demo会创建一个新的ReplicaSet控制器 对象来管控新版本的Pod对象, 升级完成后, 旧版本的ReplicaSet会保留在历史记录中, 但它的Pod副本数被降为0。
~$ kubectl get replicasets -l app=demoapp,release=stable
NAME                      DESIRED   CURRENT    READY     AGE
deployment-demo-59d9f4475b   4         4         4       1m32s
deployment-demo-b479b6f9f 0 0 0 12m deployment-demo标签选择器作用域内的Pod资源对象也随之更新为以新版本ReplicaSet名称deployment-demo-59d9f4475b为前缀的Pod 副本。
另一方面, 因各种原因导致滚动更新无法正常进行, 例如镜像文件获取失败等, 或者更新后遇到的应用程序级故障, 例如新版本Pod中的应用触发了未知Bug等, 都应该将应用回滚至之前版本用户指定的历 史记录中的版本。我们此前曾分别执行了deployment-demo资源的一次 部署和一次更新操作, 因此修订记录(revision history)分别记录 有这两次操作, 它们各有一个修订标识符, 最大标识符为当前使用的 版本。kubectl rollout history命令能够打印Deployment资源的修订历史:
~$ kubectl rollout history deployments/deployment-demo
deployment.apps/deployment-demo
REVISION  CHANGE-CAUSE
1         kubectl apply --record=true --filename=-
2         kubectl apply --record=true --filename=-
从某种意义上说, 回滚亦是更新操作。因而, 在deployment-demo 之上执行回滚操作意味着将当前版本切换回前一个版本, 但历史记录 中, 其REVISION记录也将随之变动, 回滚操作会被当作一次滚动更新追加到历史记录中, 而被回滚的条目则会被删除。因而, deployment demo回滚后修订标识符将从1变为3。回滚操作可使用kubectl rollout undo命令完成:
~$ kubectl rollout undo deployments/deployment-demo
deployment.apps/deployment-demo rolled back
回滚完成后, 我们可根据客户端的访问结果来验证deployment demo是否回滚完成, 或者根据当前ReplicaSet对象是否恢复到指定的 历史版本进行验证。
~$ kubectl get replicasets | grep "^deployment-demo"
deployment-demo-59d9f4475b   0         0         0       11m
deployment-demo-b479b6f9f    4         4         4       13m
另外, 在kubectl rollout undo命令上使用--to-revision选项指定revision号码还可回滚到历史记录中的特定版本。需要注意的是, 如果此前的滚动更新过程处于“暂停”状态, 回滚操作就需要先将Pod 模板的版本改回之前, 然后“继续”更新, 否则, 其将一直处于暂停 状态而无法回滚。
3.4 金丝雀发布
Deployment资源允许用户控制更新过程中的滚动节奏, 例如“暂停”或“继续”更新操作, 尤其是借助于前文讲到的maxSurge和 maxUnavailable属性还能实现更为精巧的过程控制。例如, 在第一批新的Pod资源创建完成后立即暂停更新过程, 此时, 仅有一小部分新版本的应用存在, 主体部分还是旧的版本。然后, 通过应用层路由机制 根据请求特征精心筛选出小部分用户的请求路由至新版本的Pod应用, 并持续观察其是否能稳定地按期望方式运行。默认, Service只会随机或轮询地将用户请求分发给所有的Pod对象。确定没有问题后再继续进行完余下的所有Pod资源的滚动更新, 否则便立即回滚至第一步更新操 作。这便是所谓的金丝雀部署, 如图所示。
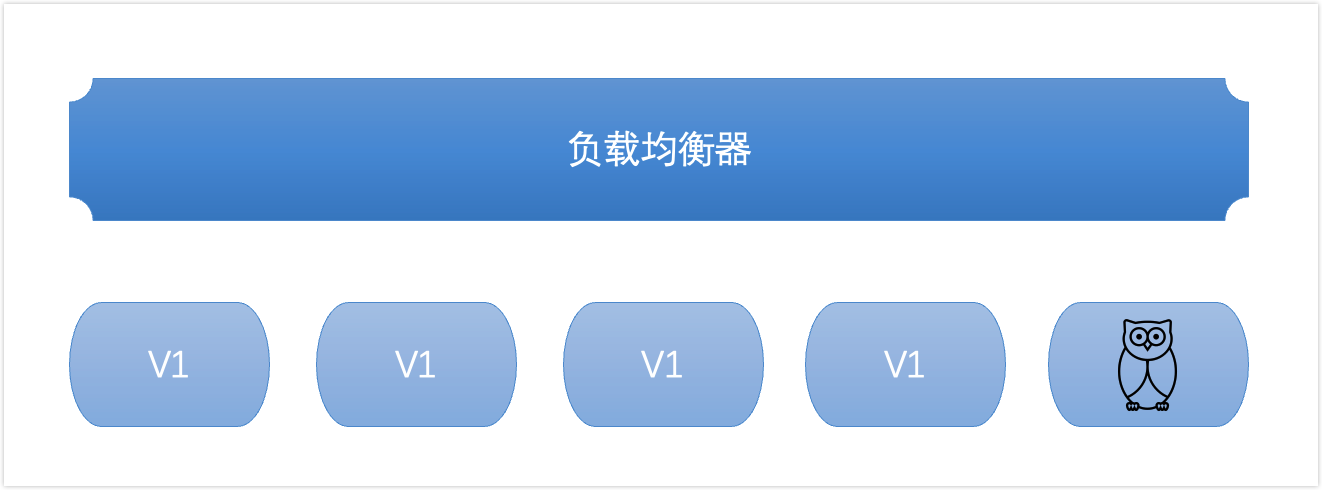
为了尽可能降低对现有系统及其容量的影响, 基于Deployment的 金丝雀发布过程通常建议采用“先增后减且可用Pod对象总数不低于期望值”的方式进行。首次添加的Pod对象数量取决于其接入的第一批请求的规则及单个Pod的承载能力, 视具体需求而定
为了能更简单地说明问题, 接下来采用首批添加1个Pod资源的方式。我们将Deployment 控制器的maxSurge属性的值设置为1, 并将maxUnavailable属性的值设置为0就能完成设定:
~]$ kubectl patch deployments/deployment-demo  -p '{"spec": {"strategy":{"rollingUpdate": {"maxSurge": 1,  "maxUnavailable": 0}}}}'
deployment.apps/deployment-demo patched
随后, 修改Pod模板触发deployment-demo资源的更新过程, 进行第一批次更新后立即暂停该部署操作, 则新生成的第一批Pod对象便是 “金丝雀”, 如图所示。暂停Deployment资源的更新过程, 需要 将其spec.pause字段的值从false修改为true , 这可通过修改资源规范后再次应用(apply)完成, 也可通过kubectl rollout pause命令进行。例如, 下面将deployment-demo资源的Pod模板中的容器镜像进行 了修改以触发其更新, 但同时使用shell操作符&&随后立即执行了暂停 命令:
~$ VERSION='v1.2' envsubst < deployment-demo.yaml | kubectl apply --record -f - &&  kubectl rollout pause deployments/deployment-demo
deployment.apps/deployment-demo configured
deployment.apps/deployment-demo paused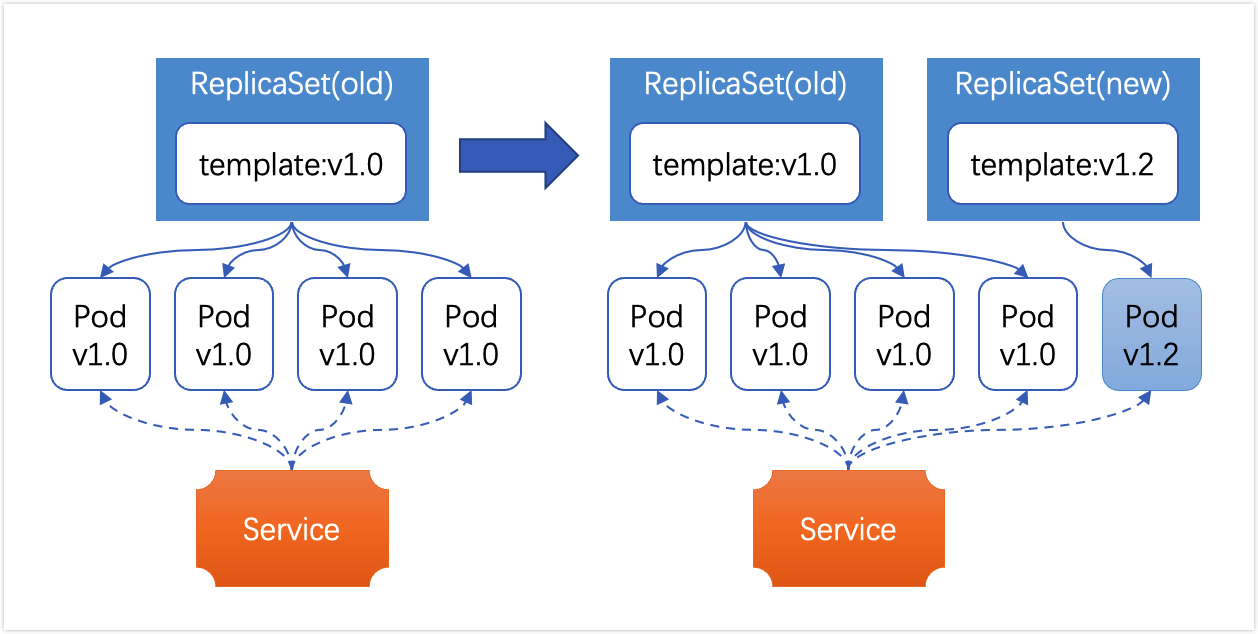
处于“暂停”状态中的Deployment资源的滚动状态也会暂停于某 一批更新操作中, 我们可以通过状态查看命令打印相关的信息:
~ $ kubectl rollout status deployments/deployment-demo
Waiting for deployment "deployment-demo" rollout to finish: 1 out
of 4 new replicas have been updated... 相关的Pod列表也能够显示出旧版本ReplicaSet的所有Pod副本仍在正常运行, 而同时新版本ReplicaSet对象也有了一个Pod实例, 相关 Service对象能够在其就绪后将一定比例的客户端流量引入到该Pod之上。运行足够长的一段时间后, 若确认新版本应用没有必须通过回滚才能解决的问题, 随后即可使用kubectl rollout resume命令继续后续更新步骤, 以完成滚动更新过程。
~ $ kubectl rollout resume deployments/deployment-demo
deployment.apps/deployment-demo resumed
kubectl rollout status命令监控到滚动更新过程完成后, 即可通过deployment-demo资源及其作用域内的ReplicaSet和Pod对象的相关信息来了解其结果状态。然而, 如果“金丝雀”遇险, 回滚操作便成了接下来的紧要任务。
4. StatefulSet控制器
无状态应用进程客户端的每次连接均可独立地处理, 一次请求和响应即构成一个完整的事务, 它们不受已完成的连接或现有其他连接的影响, 且意外中断或关闭时仅需要重新建立连接 即可, 因而, 无状态应用的Pod对象可随时由其他由同一模板创建的Pod平滑替代, 这也正是 Deployment控制器编排应用的方式。
另一方面, 有状态应用进程客户端的每次连接都在先前事务的上下文中执行, 并可能会受到该上下文的影响, 事务意外中断时其上下文和历史行为会被进程予以存储, 从而能支持客户端恢复该连接。这种处理方式表明, 有状态应用进程对同一个客户端的请求处理应该始终由同 一服务器进行。多实例场景中, 管理员或代理服务器需要独立标识每个客户端及每个后端服务 器, 并为一个特定的客户端建立到后端某服务器的固定映射关系。于是, 有状态应用的编排模型也就必然要求控制器能独立识别每个Pod对象, 确保每个Pod对象故障时的替代者仍能具有相同的标识且拥有先前实例特有的上下文, 而这种上下文数据在先后实例间的传递通常要借助每 个Pod自身专用的存储卷完成。
事实上, 在云原生应用的体系里有两组常用的近义词: 第一组是无状态(stateless)、 牲畜(cattle)、无名(nameless)和可丢弃(disposable) , 它们都可用于表述无状态应用 ; 另一组是有状态(stateful)、宠物(pet)、具名(having name)和不可丢弃(non disposable), 它们都可用于表示有状态应用。
4.1 功能分析
Kubernetes系统使用专用的StatefulSet控制器编排有状态应用。StatefulSet表示一组具 有唯一持久身份和稳定主机名的Pod对象, 任何指定该类型Pod的状态信息和其他弹性数据都存 放在与该StatefulSet相关联的永久性磁盘存储空间中。StatefulSet旨在部署有状态应用和集群化应用, 这些应用会将数据保存到永久性存储空间, 它适合部署Kafka、MySQL、Redis、 ZooKeeper以及其他需要唯一持久身份和稳定主机名的应用。
一般说来, 一个典型的、完整可用的StatefulSet资源通常由两个组件构成: Headless Service和StatefulSet资源。Headless Service用于为各Pod资源固定、唯一的标识符生成可解析的DNS资源记录, StatefulSet用于编排Pod对象, 并借助volumeClaimTemplate 以静态或动态的PV供给方式为各Pod资源提供专有且固定的存储资源。
对于拥有N 个副本的StatefulSet资源来说, 它会以{0..N–1}依次对各Pod对象进行编号及顺序创建, 当前Pod对象就绪后才会创建下一个, 删除则以相反的顺序进行, 每个Pod删除完成后才会继续删除前一个。Pod资源的名称格式为$(statefulset name)-$(ordinal), 例如名称为web的StatefulSet资源生成的Pod对象的名称依次为db-0、db-1、db-2等, 其域名后缀则由相关的Headless Service资源给出, 格式为$(service name).$(namespace).svc.cluster.local。
注意 :
Kubernetes 1.7及其之后的版本也支持StatefulSet并行管理Pod对象。
配置了volumeClaimTemplate的StatefulSet资源会为每个Pod对象基于存储卷申请配置一个专用的PV, 动静供给机制都支持, 只是静态供给依赖于管理员的事前配置, 如图所示。 而删除Pod对象甚至是StatefulSet控制器, 并不会删除其相关的PV资源以确保数据可用性, 因而Pod对象由节点故障或被驱逐等原因被重新调度至其他节点时, 先前同名Pod实例专用的PV及其数据可安全复用。
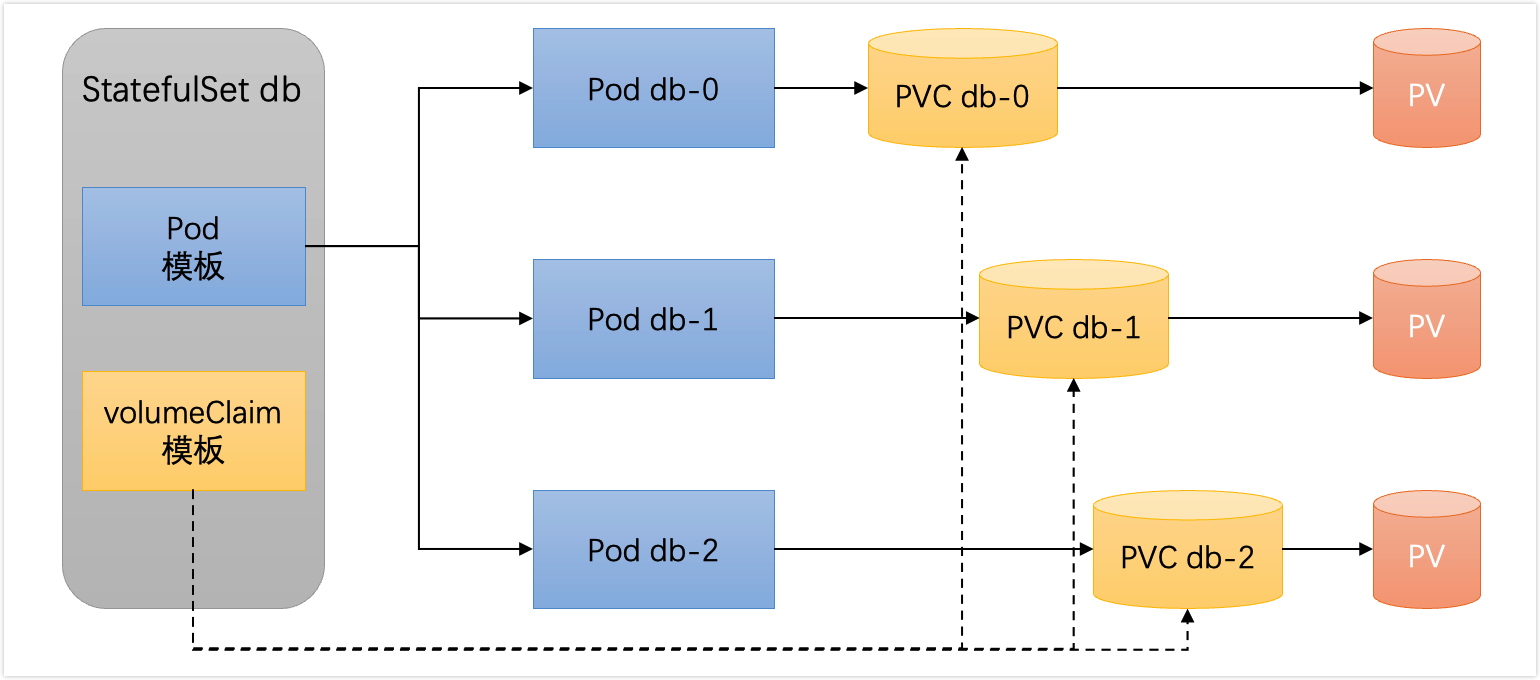
与Deployment略有不同的是, StatefulSet对应用规模的扩容意味着按索引顺序增加更多的Pod资源, 而缩容则表示按逆序依次删除索引号最大的Pod资源, 直到规模数量满足目标设定 值为止。需要特别说明的, 多数有状态应用都不支持规模性安全、快速的缩减操作, 因此 StatefulSet控制器不支持并行缩容机制, 而是要严格遵守一次仅能终止一个Pod资源的法则, 以免导致数据讹误。这通常也意味着, 存在错误且未恢复的Pod资源时, StatefulSet资源会拒绝启动缩容操作。此外, 缩容操作导致的Pod资源终止同样不会删除其相关的PV, 以确保数据可用。
StatefulSet也支持用户自定义的更新策略, 它兼容支持之前版本中的OnDelete策略, 以及新的RollingUpdate策略。RollingUpdate是默认的更新策略, 更新过程中, 更新顺序与终止 Pod资源的顺序相同, 由索引号最大的开始, 终止一个Pod对象并完成其更新后继续进行前一 个。此外, StatefulSet资源的滚动更新还支持分区(partition)机制, 用户可基于某个用于分区的索引号对Pod资源进行分区, 所有大于等于此索引号的Pod对象会被滚动更新, 如图 所示, 而小于此索引号的则不会被更新, 而且, 即便在此期间该范围内的某Pod对象被删除, 它也一样会被基于旧版本的Pod模板重建。
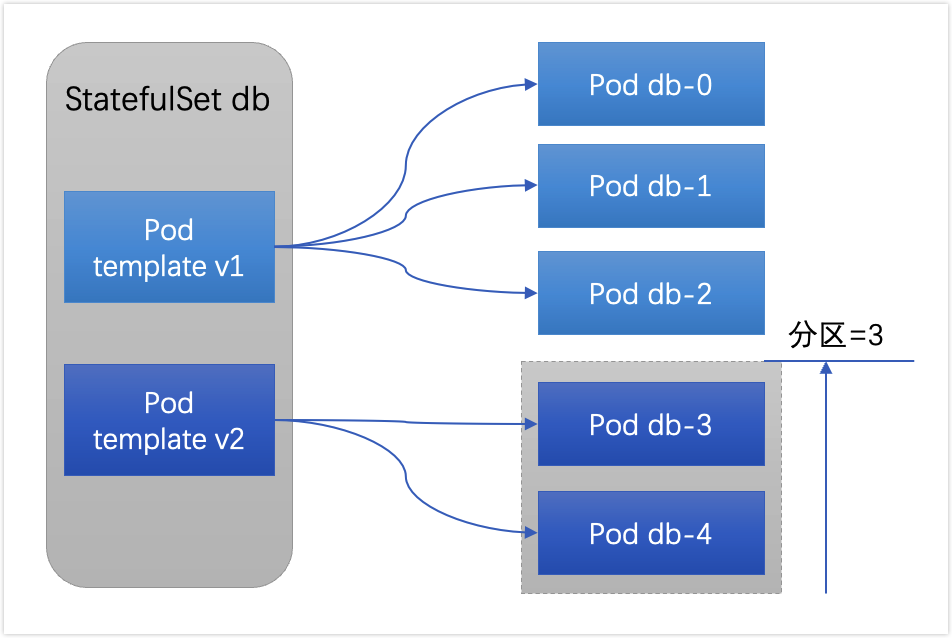
若给定的分区号大于副本数量, 意味着不存在大于此分区号的Pod资源索引号, 因此, 所 有的Pod对象均不会被更新, 这对于期望暂存发布、金丝雀发布或分段发布来说是有用的设定。
4.2 StatefulSet基础应用
如前所述, 完整的StatefulSet资源需要由Headless Service和StatefulSet共同构成, StatefulSet资源规范中通过必选字段spec.serviceName指定关联的Headless类型的Service对象名称, 但管理该Service是用户的责任, StatefulSet仅是强依赖于它, 而不会自动管理它。 下面是StatefulSet资源的规范格式及简要说明。
apiVersion: apps/v1               # API群组及版本
kind: StatefulSet                 # 资源类型的特有标识
metadata:
  name <string>                   # 资源名称, 在作用域中要唯一
  namespace <string>              # 名称空间 ; StatefulSet隶属名称空间级别
spec:
  replicas <integer>              # 期望的Pod副本数, 默认为1
  selector <object>               # 标签选择器, 需匹配Pod模板中的标签, 必选字段
  template <object>               # Pod模板对象, 必选字段
  revisionHistoryLimit <integer>  # 滚动更新历史记录数量, 默认为10
  updateStrategy <Object>         # 滚动更新策略
    type <string>                 # 滚动更新类型, 可用值有OnDelete和Rollingupdate
    rollingUpdate <Object>        # 滚动更新参数, 专用于RollingUpdate类型
      partition <integer>         # 分区指示索引值, 默认为0
  serviceName  <string>           # 相关的Headless Service的名称, 必选字段
  volumeClaimTemplates <[]Object> # 存储卷申请模板
    apiVersion <string>           # PVC资源所属的API群组及版本, 可省略
    kind <string>                 # PVC资源类型标识, 可省略
    metadata <Object>             # 卷申请模板元数据
    spec <Object>                 # 期望的状态, 可用字段同PVC
podManagementPolicy <string> # Pod管理策略, 默认的OrderedReady表示顺序创建并逆序删除, 另一可用值Parallel表示并行模下面的配置清单示例中定义了一个名为demodb的Headless Service, 以及一个同样名为 demodb的StatefulSet资源, 后者使用了存储卷申请模板, 为Pod对象从fast-rbd存储类中请求 动态供给并绑定PV。
apiVersion: v1
kind: Service
metadata:
  name: demodb
  namespace: default
  labels:
    app: demodb
spec:
  clusterIP: None
  ports:
  - port: 9907
  selector:
    app: demodb
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: demodb
  namespace: default
spec:
  selector:
    matchLabels:
      app: demodb
  serviceName: "demodb"
  replicas: 2
  template:
    metadata:
      labels:
        app: demodb
    spec:
      containers:
      - name: demodb
        image: ikubernetes/demodb:v0.1
        ports:
        - containerPort: 9907
          name: db
        env:
        - name: DEMODB_DATADIR
          value: "/demodb/data"
        livenessProbe:
          initialDelaySeconds: 5
          periodSeconds: 10
          httpGet:
            path: /status
            port: db
        readinessProbe:
          initialDelaySeconds: 15
          periodSeconds: 30
          httpGet:
            path: /status?level=full
            port: db
        volumeMounts:
        - name: data
          mountPath: /demodb/data
  volumeClaimTemplates:
  - metadata:
      name: data
    spec:
      accessModes: [ "ReadWriteOnce" ]
      storageClassName: "rbd"
      resources:
        requests:
storage: 1Gi示例中用到的demodb是一个仅用于测试的分布式键值存储系统, 支持持久化数据存储, 它 由一个Leader和一到多个Followers组成, Followers定期从Leader查询并请求同步数据。 Leader支持读写请求, 而各Followers节点仅支持只读操作, 它们会把接收到的写请求通过307 响应码重定向给Leader节点。用于读写请求的URI分别为/get/KEY和/set/KEY, /status则用于 输出状态, /status?level=full能够以200响应码返回持有的键数量, 否则响应以500状态码返 回。
注意 :
demodb仅可由StatefulSet控制器编排运行, 并且在程序中将Leader的名称固定为demodb-0, 依赖的Headless Service的名称也固定为demodb, 因此StatefulSet和Headless Service资源的名称必须要使用demodb。
默认情况下, StatefulSet资源使用OrderedReady这一Pod管理策略, 它以串行的方式逐一 创建各Pod实例及相关的PV, 下面在创建后打印的statefulsets/demodb资源详细描述中的各事件的时间点也反映了这种事实。
~$ kubectl apply -f demodb.yaml
service/demodb created
statefulset.apps/demodb created
~$ kubectl describe statefulsets/demodb
Name:               demodb
Namespace:          default
Selector:           app=demodb
Labels:             <none>
Annotations:        Replicas:  2 desired | 2 total
Update Strategy:    RollingUpdate
  Partition:        0
Pods Status:        2 Running / 0 Waiting / 0 Succeeded / 0 Failed
……
Events:
  Type    Reason            Age    From                    Message
  ----    ------            ----   ----                    -------
  Normal  SuccessfulCreate  2m22s  statefulset-controller  create Claim data-demodb-0
Pod demodb-0 in StatefulSet demodb success
  Normal  SuccessfulCreate  2m22s  statefulset-controller  create Pod demodb-0 in
StatefulSet demodb successful
  Normal  SuccessfulCreate  97s    statefulset-controller  create Claim data-demodb-1
Pod demodb-1 in StatefulSet demodb success
  Normal  SuccessfulCreate  97s    statefulset-controller  create Pod demodb-1 in
StatefulSet demodb successful
如前所述, 由StatefulSet资源创建的Pod对象拥有固定且唯一的标识符, 它们基于唯一的索引序号及相关的StatefulSet对象的名称生成, 格式为<statefulset name>-<ordinalindex>, 例如上面事件信息中显示出由statefuls/demodb所创建的demodb-0和demodb-1两个 Pod对象的名称即遵循该格式。事实上, 这类Pod对象的主机名也与其资源名称相同, 以 demodb-0为例, 下面的命令打出的主机名称正是Pod资源的名称标识。
~$ kubectl exec demodb-0 -- hostname
demodb-0
我们已经知道, Headless Service的DNS名称解析会由ClusterDNS以该Service对象关联各 Pod对象的IP地址加以响应。而StatefulSet创建的各Pod对象的名称则以相关Headless Service资源的DNS名称为后缀, 具体格式为(svc_name).$(namespace).svc.cluster.local, 例如demodb-0和demodb-1的资源名称分别为demodb-0.demodb.default.svc.cluster.local和demodb 1.demodb.default.svc.cluster.local。下面在一个新的专用终端创建一个临时的、基于Pod 对象的交互客户端进行测试。
~$ kubectl run client --image=ikubernetes/admin-toolbox:v1.0 -it --rm --command -- /bin/sh首先, 请求解析Pod的FQDN格式主机名称, 它会返回相应Pod对象的IP地址 ;
[root@client /]# nslookup -query=A demodb-0.demodb
Server:         10.96.0.10
Address:        10.96.0.10#53
Name:   demodb-0.demodb.default.svc.cluster.local
Address: 10.244.1.208
接着, 创建一个测试文件, 将之存储到demodb存储服务以发起数据存储测试。我们知道, CoreDNS默认以roundrobin的方式响应对同一个名称的解析请求, 因而以名称方式发往demodb 这一Headless Service的请求会轮询到demodb-0和demodb-1之上。
[root@client /]# echo "Advanced Kubernetes Practices" > /tmp/mydata
[root@client /]# curl -L -XPUT -T /tmp/mydata http://demodb:9907/set/mydata
WRITE completed
调度至从节点( demodb-1) 的写请求会自动重定向给主节点( demodb-0) , 且主节点数据 存储完成后将自动同步至各个从节点 ; 我们可从服务请求读取数据, 或者直接从demodb-1读取数据, 以进行测试。
[root@client /]# curl http://demodb:9907/get/mydata
Advanced Kubernetes Practices
[root@client /]# curl http://demodb-1.demodb:9907/get/mydata
Advanced Kubernetes Practices demodb的所有节点会将数据存储在/demodb/data目录下, 每个键被映射为一个子目录, 数据存储在该子目录下的content文件中。
~$ kubectl exec demodb-0 -- cat /demodb/data/mydata/content
Advanced Kubernetes Practices而各Pod对象的/demodb/data目录挂载到一个由statefulset/demodb存储卷申请模板创建的PVC之上, 每个PVC又绑定在由存储类fast-rbd动态供给的PV之上。各PVC的名称由 volumeClaimTemplate对象的名称与Pod对象的名称组合而成, 格式为$(volume ClaimTemplate_name).(Pod_name), 如下面的命令结果所示。
~$ kubectl get pvc -l app=demodb
NAME           STATUS  VOLUME   CAPACITY   ACCESS MODES  STORAGECLASS  AGE
data-demodb-0  Bound   pvc-de6e81c1-…   2Gi      RWO     fast-rbd       4m50s
data-demodb-1 Bound pvc-e95d67ca-… 2Gi RWO fast-rbd 4m5s StatefulSet资源作用域内的Pod资源因被节点驱逐, 或因节点故障、应用规模缩容被删 除, 甚至是手动误删除时, 它挂载的由存储卷申请模板创建的PVC卷并不会被删除。因而, 经 StatefulSet资源重建或规模扩容回原来的规模后, 每个Pod对象依然有固定的标识符并可关联 到此前的PVC存储卷上。
4.3 扩缩容与滚动更新
StatefulSet资源也支持类似于Deployment资源的应用规模的扩容、缩容以及更新机制。 扩缩容通过简单地修改StatefulSet资源的副本数来改动期望的Pod资源数量就能完成, 例如, 下面的命令能将statefulsets/demodb中的Pod副本数量扩展至4个。
~$ kubectl scale statefulsets/demodb --replicas=4
statefulset.apps/demodb scaledStatefulSet资源的扩容过程与创建过程管理Pod对象的策略相同, 默认为顺次进行, 而且 其名称中的序号也将以现有Pod资源的最后一个序号为基准向后进行。若定义了存储卷申请模 板, 扩容操作所创建的每个Pod对象也会各自关联所需要的PVC存储卷。与扩容操作相对, 将其副本数量调低即能完成缩容操作, 例如, 下面的命令能够将StatefulSet资源demodb的副本数量缩减至3个。
~$ kubectl patch statefulsets/demodb -p '{"spec":{"replicas":3}}'
statefulset.apps/demodb patched缩容过程中终止Pod资源的默认策略与删除机制相似, 它会根据Pod对象的可用索引号逆序逐一进行, 直到余下的数量满足期望的值为止。因缩容而终止的Pod资源的存储卷并不会被删除, 因此, 如果缩减规模后再将其扩展回来, 此前的数据依然可用, 且Pod资源名称不变。
如前所述, 在应用更新方面, StatefulSet资源自Kubernetes 1.7版本开始支持自动更新机制, 其更新策略则由spec.updateStrategy字段定义, 默认为RollingUpdate, 即滚动更新。 kubectl set image命令也支持修改StatefulSet资源上Pod模板中的容器镜像, 因而, 触发 statefulsets/demodb上的应用升级可使用类似如下一条命令完成。
~$ kubectl set image statefulsets/demodb demodb-shard="ikubernetes/demodb:v0.2"
statefulset.apps/demodb image updated滚动更新StatefulSet资源的Pod对象以逆序的方式从其最大索引编号逐一进行, 滚动条件为当前更新循环中的各个新Pod资源已然就绪。通常, 对于主从复制类的集群应用来说, 这种方式能保证担当主节点的Pod资源在最后进行更新, 以确保其兼容性。例如, 触发 statefulsets/demodb更新后, 可以看到类似如下命令中首先更新索引编号最大的Pod对象 demodb-1的操作。
~$ kubectl get pods -l app=demodb
NAME       READY   STATUS           RESTARTS      AGE
demodb-0   1/1     Running             0          5m42s
demodb-1   1/1     Running             0          4m42s
demodb-2 0/1 ContainerCreating 0 5s StatefulSet资源滚动更新过程中的状态同样可以使用kubectl rollout history命令获取。更新完成后, 我们可使用如下命令, 确认相关Pod对象使用的容器镜像都已经变更为指定的新版本。
~$ kubectl get pods -l app=demodb -o \
    jsonpath='{range .items[*]}{.metadata.name}: {.spec.containers[0].image}{"\n"} {end}'
demodb-0: ikubernetes/demodb:v0.2
demodb-1: ikubernetes/demodb:v0.2
demodb-2: ikubernetes/demodb:v0.2
滚动更新过程不会影响相应的数据服务, 此前的生成的数据键mydata及其数据在更新过程中同样可以正常访问, 这在4.2节的交互式客户端测试结果中能够得到验证。但是, 更新 demodb-0期间写操作会有短暂的不可用区间。
[root@client /]# curl http://demodb:9907/get/mydata
Advanced Kubernetes Practices
进一步地, StatefulSet资源支持使用分区编号 ( .spec.updateStrategy.rollingUpdate.partition字段值) 将其Pod对象分为两个部分, 仅那些索引号大于等于分区编号的Pod对象会被更新, 默认的分区编号为0, 因而滚动更新时, 所有的Pod对象都是待更新目标。于是, 在更新操作之前, 将partition字段的值置为Pod资源的副本数量N (或大于该值) 会使得所有的Pod资源( 索引号区间为0到N–1) 都不再处于可直接更新的分区之内, 那么这之后设定的更新操作不会真正执行而是被“暂存”起来, 直到降低分区编号至现有Pod资源索引号范围内, 才开始触发真正的滚动更新操作。来看下面的例子。
首先, 将statefulsets/demodb的分区别编号设置为现有的Pod数量值3:
~$ kubectl patch statefulsets/demodb -p \
       '{"spec":{"updateStrategy":{"rollingUpdate":{"partition":3}}}}'
statefulset.apps/demodb patched
而后, 更新statefulsets/demodb的Pod模板中的容器镜像为ikubernetes/demodb:v0.3。
~$ kubectl set image statefulsets/demodb demodb-shard='ikubernetes/demodb:v0.3'
statefulset.apps/demodb image updated
接下来, 我们验证出最大编号的Pod对象demodb-2的容器镜像并未因执行更新而发生变化, 根据更新策略来说, 这意味着其他更小索引号的Pod对象更不会发生任何变动:
~$ kubectl get pods/demodb-2 -o jsonpath='{.spec.containers[0].image}'
ikubernetes/demodb:v0.2
再接着, 将分区编号降为statefulsets/demodb上的最大索引编号2之后可以验证, 仅 demodb-2执行了更新操作 ; 如下第二条命令可于分区编号更改后, 略等一段时间后再执行:
~$ kubectl patch statefulsets/demodb -p \
      '{"spec":{"updateStrategy":{"rollingUpdate":{"partition":2}}}}'
statefulset.apps/demodb patched
~$ kubectl get pods -l app=demodb -o \
      jsonpath='{range .items[*]}{.metadata.name}: {.spec.containers[0].image}
      {"\n"}{end}'
demodb-0: ikubernetes/demodb:v0.2
demodb-1: ikubernetes/demodb:v0.2
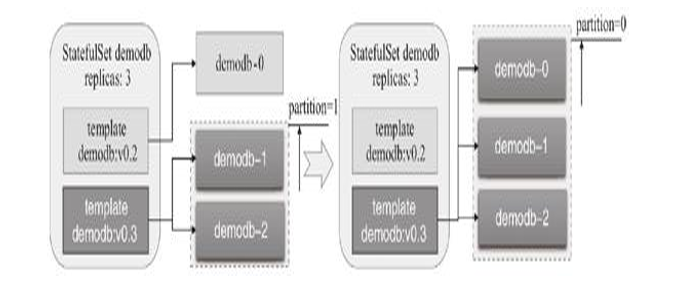
demodb-2: ikubernetes/demodb:v0.3 demodb-2就像是一只“金丝雀”, 安然渡过一定时长的测试期间后, 我们便可继续其他 Pod资源的更新操作。若后续待更新的Pod资源数量较少, 我们可直接将partition字段的值设置为0, 从而让StatefulSet逆序完成后续所有Pod资源的更新。而待更新的Pod资源较多时, 也可以将Pod资源以线性或指数级增长的方式来分阶段完成更新操作, 操作过程仅仅是分多次更改partition字段值, 例如将statefulsets/demodb控制器的分区号以较慢的节奏依次设置为1 和0来完成剩余Pod资源的线性分步更新, 如图所示。
StatefulSet支持的另一更新策略是OnDelete, 这类似于手动更新机制, 它以用户的手动删除操作为触发时间点完成应用更新。
4.4 StatefulSet的局限性
应用于生产环境的分布式有状态应用的各实例间的关系并非像本节示例中的demodb那样简单, 它们在拓扑上通常是基于复杂分布式协议的成员关系, 例如ZooKeeper集群成员基于ZAB协议的Leader/Follower关系以及etcd集群成员基于Raft协议的对等(peer) 关系等。这些分布式有状态应用的内生拓扑结构存在区别, 对持久存储的依赖需求也有所不同, 并且集群成员的增加、减少以及在故障后的恢复操作通常都会依赖一系列复杂且精细的步骤才能完成, 于是 StatefulSet控制器无法为其封装统一、标准的管理操作。于是, 用户就不得不配置某个特定的有状态应用, 在其YAML配置清单中通过“复杂的运维代码”手动编写相关的运维逻辑, 例如 下面的这段代码便是以StatefuSet资源来编排etcd应用时, 在其Pod模板中编写的仅实现了简单功能的运维代码。这看上去既奇怪又低效——每个用户不得不学习相关应用的运维知识并重复“造轮子”, 而StatefulSet对此却也爱莫能助。
command: - "/bin/sh" - "-ecx" - |
   IP=$(hostname -i)
   PEERS=""
   for i in $(seq 0 $((${CLUSTER_SIZE} - 1))); do
PEERS="${PEERS}${PEERS:+,}${SET_NAME}-${i}=http://${SET_NAME}-${i}.${SET_
NAME}:2380"
   done
   # start etcd. If cluster is already initialized the `--initial-*` options
   will be ignored.
   exec etcd --name ${HOSTNAME} \
     --listen-peer-urls http://${IP}:2380 \
     --listen-client-urls http://${IP}:2379,http://127.0.0.1:2379 \
     --advertise-client-urls http://${HOSTNAME}.${SET_NAME}:2379 \
     --initial-advertise-peer-urls http://${HOSTNAME}.${SET_NAME}:2380 \
     --initial-cluster-token etcd-cluster-1 \
     --initial-cluster ${PEERS} \
     --initial-cluster-state new \
      --data-dir /var/run/etcd/default.etcd
面对这种境况, CoreOS为Kubernetes引入了一个称为Operator的新概念和新组件, 它借助 CRD( Customed Resource Definition) 创建自定义资源类型来完整描述某个有状态应用集群, 并相应创建自定义的控制器来编排这些自定义资源类型所创建的各个资源对象。简单来 讲, Operator就是一个开发规范和SDK, 它合理地利用Kubernetes API的CRD功能扩展出二级抽 象, 又巧妙地回归到Kubernetes的“控制器”逻辑, 从而提供了一个有状态应用的实现接口, 用户可利用它开发专用于管理某个特定有状态应用的运维控制器, 并按需回馈给社区
目前, Operator社区中涌现了大量的特定实现, 例如coreos/etcd-operator、 oracle/mysql-operator和jenkinsci/jenkins-operator等, 有些分布式应用的可用Operator 实现甚至不止一种。Operator官方维护着etcd、Rook、Prometheus和Vault几个Operator, 并 通过https://github.com/operator-framework/awesome-operators维护着主流的Operator项目列表。这意味着, 在Kubernetes系统上部署分布式有状态应用的常用方式是使用Operator, 而非自定义StatefulSet资源,
5. DaemonSet控制器
Deployment仅用于保证在集群上精确运行多少个工作负载的实例, 但有些系统级应用却需要在集群中的每个节点上精确运行单个实例, 这就是DaemonSet控制器的核心功用所在。系统级工作负载的副本数量取决于集群中的节点数, 而非由用户通过replicas进行定义, 更 重要的是, 后续新加入集群的工作节点也会由DaemonSet对象自动创建并运行为一个相关Pod, 而从集群移除节点时, 该类Pod对象也将被自 动回收且无须重建。此外, 管理员也可以使用节点选择器或节点标签指定仅在部分具有特定特征的节点上运行指定的Pod对象。
简单来说, DaemonSet就是一种特殊的控制器, 它有着特定的应用场景, 通常用于运行那些执行系统级操作任务的应用, 例如:
运行集群存储的守护进程, 例如在每个节点上运行的
glusterd可用于接入Gluster集群 ;在每个节点上运行日志收集守护进程, 例如
fluentd、filebeat和logstash等 ;在每个节点上运行监控系统的代理守护进程, 例如
Prometheus Node Exporter、collectd、Datadog agent、New Relic agent, 或Ganglia gmond等。
提示 : 以
kubeadm部署的Kubernetes集群上,kube-proxy便是由DaemonSet控制器所编排 ; 另外,Flannel网络插件运行在各节点之上 的代理程序也使用了该类型的控制器。
既然是需要在集群内的每个节点或部分节点运行工作负载的单个实例, 那么, 也就可以把应用直接运行为工作节点上的系统级守护进程, 只是这么一来也就失去了托管给Kubernetes所带来的便捷性。另外, 当必须把Pod对象以单实例运行在固定的几个节点并且需要先于其 他Pod启动时, 才有必要使用DaemonSet控制器, 否则就应该使用 Deployment控制器。
5.1 DaemonSet资源基础应用
DaemonSet是标准的API资源类型, 它的spec字段中嵌套使用的字 段也需要使用selector、template和minReadySeconds, 并且它们各自 的功能和用法基本相同, 但DaemonSet不支持使用replicas, 毕竟 DaemonSet不是基于期望的副本数, 而是基于节点数量来控制Pod资源数量, 但template是必选字段。另外, DaemonSet也支持策略式更新, 它支持OnDelete和RollingUpdate两种策略, 也能够为滚动更新保存修订记录。DaemonSet资源的简要配置规范如下。
apiVersion: apps/v1              # API群组及版本
kind: DaemonSet                  # 资源类型特有标识
metadata:
  name <string>                  # 资源名称, 在作用域中要唯一
  namespace <string>             # 名称空间 ; DaemonSet资源隶属名称空间级别
spec:
  minReadySeconds <integer>      # Pod就绪后多少秒内任一容器无崩溃方可视为“就绪”
  selector <object>              # 标签选择器, 必须匹配template字段中Pod模板的标签
  template <object>              # Pod模板对象
  revisionHistoryLimit <integer> # 滚动更新历史记录数量, 默认为10
  updateStrategy <Object>        # 滚动更新策略
    type <string>                # 滚动更新类型, 可用值有OnDelete和Rollingupdate
    rollingUpdate <Object>       # 滚动更新参数, 专用于RollingUpdate类型
      maxUnavailable <string>    # 更新期间可比期望的Pod数量缺少的数量或比例
下面的资源清单( daemonset-demo.yaml) 示例中定义了一个 DaemonSet资源, 用于在每个节点运行一个Prometheus node_exporter 进程以收集节点级别的监控数据, 该进程共享节点的Network和PID名称空间。
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: daemonset-demo
  namespace: default
  labels:
    app: prometheus
    component: node-exporter
spec:
  selector:
    matchLabels:
      app: prometheus
      component: node-exporter
  template:
    metadata:
      name: prometheus-node-exporter
      labels:
        app: prometheus
        component: node-exporter
    spec:
      containers:
      - image: prom/node-exporter:v0.18.0
        name: prometheus-node-exporter
        ports:
        - name: prom-node-exp
          containerPort: 9100
          hostPort: 9100
        livenessProbe:
          tcpSocket:
            port: prom-node-exp
          initialDelaySeconds: 3
        readinessProbe:
          httpGet:
            path: '/metrics'
            port: prom-node-exp
            scheme: HTTP
          initialDelaySeconds: 5
      hostNetwork: true
      hostPID: true
Prometheus node_exporter默认监听TCP协议的9100端口, 基于 HTTP协议及/metrics输出指标数据, 我们可以将daemonset-demo创建到集群之上后, 向任一节点IP发起访问, 进行测试来验证。
~$ kubectl apply -f daemonset-demo.yaml
daemonset.apps/daemonset-demo created
~$ curl -s 172.29.9.11:9100/metrics
# HELP go_gc_duration_seconds A summary of the GC invocation durations.
# TYPE go_gc_duration_seconds summary
go_gc_duration_seconds{quantile="0"} 8.729e-06
go_gc_duration_seconds{quantile="0.25"} 3.1308e-05
…… DaemonSet资源在其详细描述信息输出了相关Pod对象的状态, 包括应该在集群上运行的副本数和实际运行的副本数及相关的状态等。
Desired Number of Nodes Scheduled: 3
Current Number of Nodes Scheduled: 3
Number of Nodes Scheduled with Up-to-date Pods: 3
Number of Nodes Scheduled with Available Pods: 3
Number of Nodes Misscheduled: 0
Pods Status: 3 Running / 0 Waiting / 0 Succeeded / 0 Failed偶尔也存在需要将Pod对象以单一实例形式运行在集群中的部分工 作节点, 例如有些拥有特殊硬件节点需要运行特定的监控代理程序等。这仅需要在Pod模板的spec字段中嵌套使用nodeSelector字段, 并确保其值定义的标签选择器与部分特定工作节点的标签匹配即可。
另外, 考虑到大多数系统级应用的特殊性, DaemonSet资源的各 Pod实例通常需要被单独访问而不能隐藏在某个Service对象之后, 例如无论是监控代理程序或日志采集代理程序所在的节点都需要由其服务器端各自识别并单独进行通信。因此, 各节点上的Pod应用推送数据 至服务端, 使用Headless Service或者直接让Pod应用共享节点的网络名称空间, 并监听一个端口( 例如node_exporter的9100端口) 是满足这种需求的常见做法。
5.2 DaemonSet更新策略
DaemonSet自Kubernetes 1.6版本起也开始支持更新机制, 相关配置定义在spec.update-Strategy嵌套字段中。目前, 它支持 RollingUpdate和OnDelete两种更新策略。
RollingUpdate为默认的策略, 工作逻辑类似于Deployment控制器上的同名策略, 不过节点难以临时弹性增设, 因而DaemonSet仅能支持使用maxUnavailabe属性定义最大不可用Pod资源副本数( 默认值为1) 。Ondelete是在相应节点的Pod资源被删除后重建为新版本, 从而允许用户手动编排更新过程。
将此前创建的daemonset-demo中Pod模板的容器镜像修改为 prom/node-exporter:v0.18.1便能测试其更新过程:
~$ kubectl set image daemonsets/daemonset-demo \
          prometheus-node-exporter="prom/node-exporter:v0.18.1"
daemonset.apps/daemonset-demo image updated按照默认的RollingUpdate策略, daemonset-demo资源将采用一次 更新一个Pod对象, 待新建Pod对象就绪后再更新下一个Pod对象的方式 进行, 资源相关的事件中会详细展示出其更新过程。
~$ kubectl describe daemonsets daemonsets/daemonset-demo
……
Events:
  Type    Reason            Age    From                  Message
  ----    ------            ----   ----                  -------
  Normal  SuccessfulDelete  7m44s  daemonset-controller  Deleted pod: daemonset-demo-btl8x
  Normal  SuccessfulCreate  7m39s  daemonset-controller  Created pod: daemonset-demo-5z8q8
  Normal  SuccessfulDelete  6m6s   daemonset-controller  Deleted pod: daemonset-demo-hf9lv
  Normal  SuccessfulCreate  6m3s   daemonset-controller  Created pod: daemonset-demo-bw5qp
  Normal  SuccessfulDelete  4m34s  daemonset-controller  Deleted pod: daemonset-demo-gzxd2
  Normal  SuccessfulCreate  4m27s  daemonset-controller  Created pod: daemonset-demo-l9qgg
规模较大的集群中, 我们也可以增大RollingUpdate策略中 maxUnavailable属性的值来加快其滚动过程, 例如设置为20%、25%甚至是50%等。DaemonSet控制器的滚动更新机制同样支持借助 minReadySeconds来自定义Pod对象必须处于“就绪”状态多少时长才能视作“可用”。另外, DaemonSet资源的更新操作也支持回滚, 包括 回滚至REVISION历史记录中的任何一个指定的版本等。
而对于需要精心组织每个实例更新过程才能确保其升级过程可靠 进行的应用来说, 我们就不得不使用OnDelete策略来替换默认的 RollingUpdate策略。OnDelete策略的实施逻辑较为简单, 这里就不再给出具体操作过程。
6. Job控制器
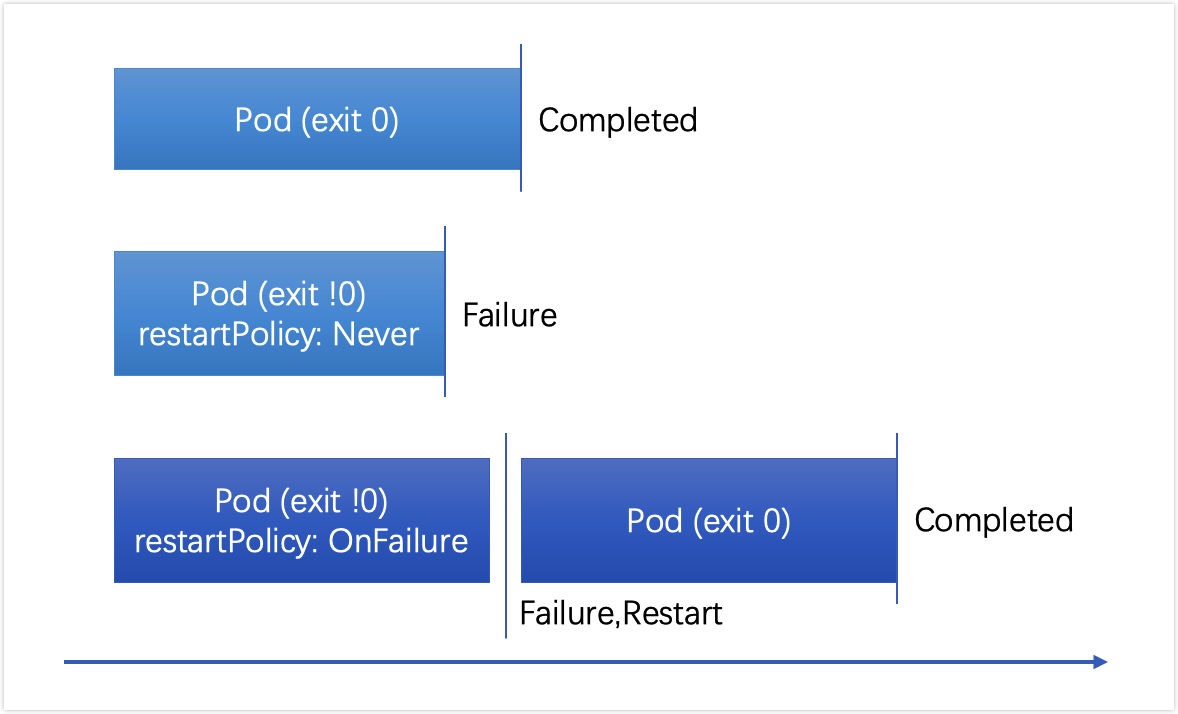
与Deployment及DaemonSet控制器管理的守护进程类的服务应用所不同的是, Job控制器常用于管理那些运行一段时间就能够“完成”的任 务, 例如计算或备份操作。容器中的进程正常运行完成而结束后不需要 再重启, 而是由控制器把该Pod对象置于Completed(完成) 状态, 并能够在超过用户指定的生存周期后由系统自行删除。但是, 若容器中的进程因“错误”(而非完成) 而终止, 则需要依据配置来确定其重启与否, 通常, 未运行完成的Pod对象因其所在的节点故障而意外终止后会被重新创建。Job控制器的Pod对象的状态转换如图所示。
实践中, 有的作业任务可能需要运行不止一次, 用户可以配置它们以串行或并行方式运行。总结起来, 这种类型的Job资源对象主要有两 种。
单工作队列的串行式
Job: 将一个作业串行执行多次直到满足期望 的次数, 如图所示 ; 这种Job也可理解为并行度为1的作业执行方 式, 在某个时刻仅有一个Pod资源对象存在。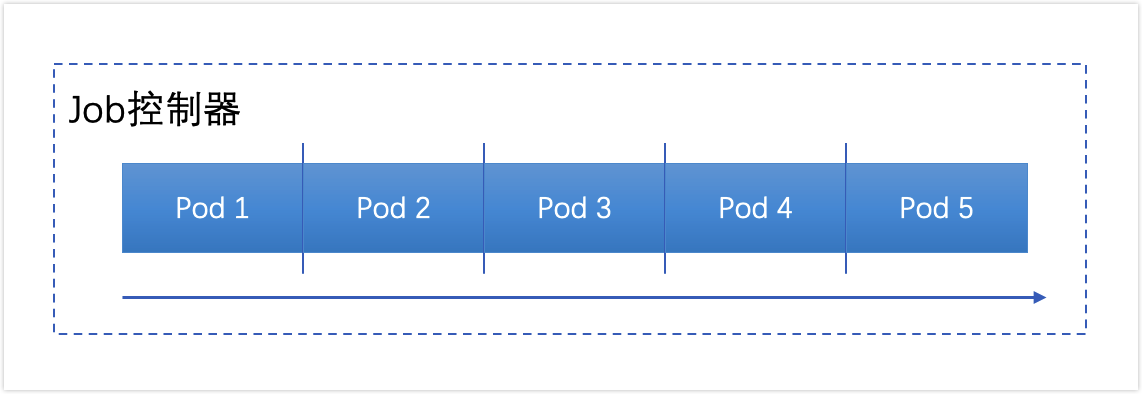
多工作队列的并行
Job: 这种方式中, 可以设置工作队列数( 即作业数) , 每个队列仅负责运行一个作业, 如图中的左图所示 ; 也可以用有限的工作队列运行较多的作业, 即工作队列数少于总作业数, 它相当于运行着多个串行作业队列。如图中的右图所示, 工作队列数即同时可运行的Pod资源数。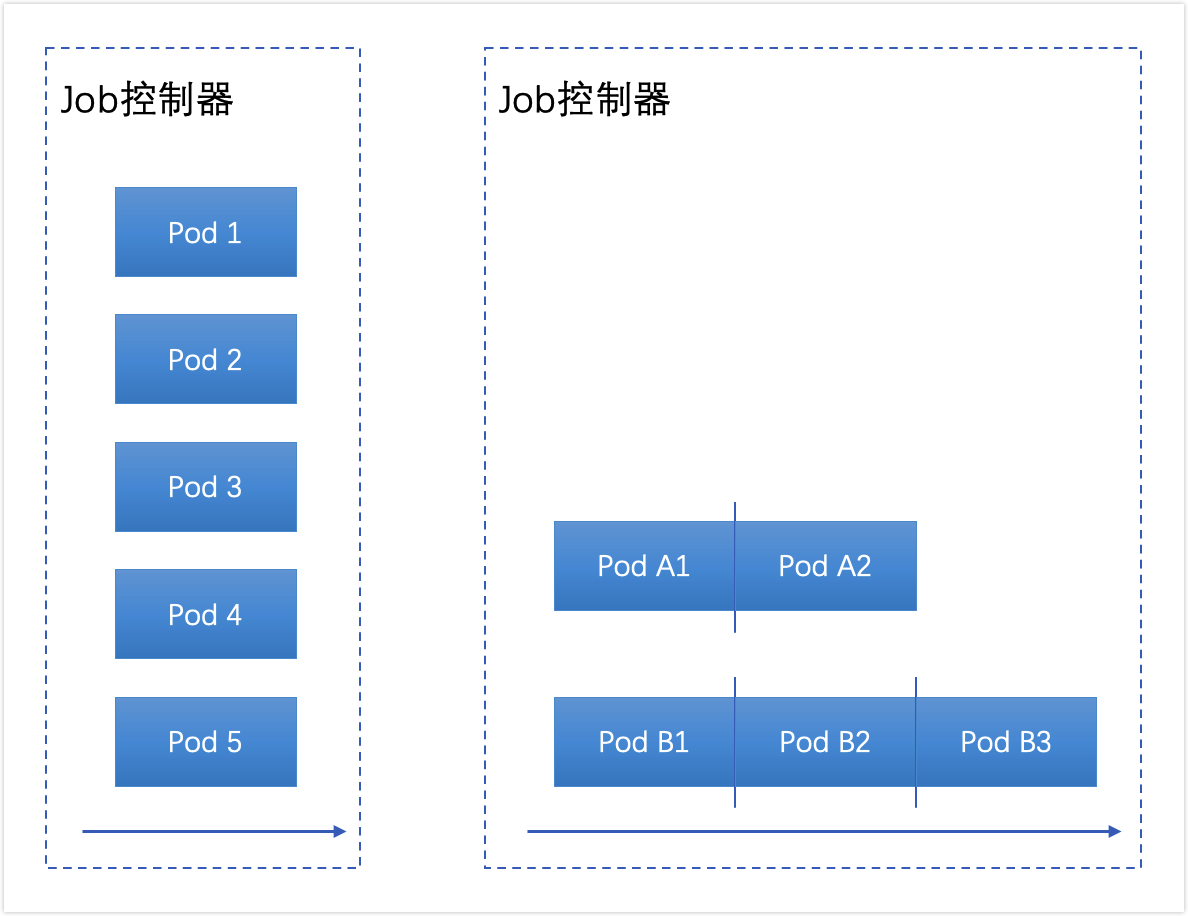
具体运行中, 我们需要根据作业的特性来选择合适的并行度及编排 策略, 对于有严格次序要求或者拥有“层进”特性的作业, 单工作队列 串行执行是其唯一可行的选择, 反之, 适度的并行能够提升作业运行速 度。
6.1 Job资源基础应用
作为标准的API资源类型之一, Job规范同样由apiVersion、kind、 metadata和spec等字段组成, 由系统自行维护的status字段用于保存资源的当前状态, 该资源的基本定义格式如下。
apiVersion: batch/v1      # API群组及版本
kind: Job                  # 资源类型特有标识
metadata:
  name <string>            # 资源名称, 在作用域中要唯一
  namespace <string>       # 名称空间 ; Job资源隶属名称空间级别
spec:
  selector <object>        # 标签选择器, 必须匹配template字段中Pod模板的标签
  template <object>        # Pod模板对象
  completions <integer>    # 期望的成功完成的作业次数, 成功运行结束的Pod数量
  ttlSecondsAfterFinished  <integer>  # 终止状态作业的生存时长, 超期将被删除
  parallelism  <integer>   # 作业的最大并行度, 默认为1
  backoffLimit <integer>   # 将作业标记为Failed之前的重试次数, 默认为6
activeDeadlineSeconds <integer> # 作业启动后可处于活动状态的时长定义Job资源时, spec字段内嵌的必要字段仅有template一个, Job 会为其Pod对象自动添加job-name=JOB_NAME和controller-uid=UID标签, 并使用标签选择器完成对controller-uid标签的关联。例如, 下面的资源清单( job-example.yaml) 中定义了一个名为job-demo的Job资源:
apiVersion: batch/v1
kind: Job
metadata:
  name: job-demo
spec:
  template:
    spec:
      containers:
      - name: myjob
        image: alpine:3.11
        imagePullPolicy: IfNotPresent
        command: ["/bin/sh", "-c", "sleep 60"]
      restartPolicy: Never
  completions: 3
  ttlSecondsAfterFinished: 3600
  backoffLimit: 3
  activeDeadlineSeconds: 300
注意 :
Pod模板中的spec.restartPolicy默认为Always, 这对Job控制器来 说并不适用, 因此必须在Pod模板中显式设定restartPolicy属性的值为Never或OnFailure
出于运行一段时长后可终止的目的, 该示例中的Pod模板通过借助 alpine镜像运行一个睡眠60秒( sleep 60) 的应用来模拟该功能。将 job-demo资源创建到集群之上便可查看相关的任务状态, 如下第二条命令显示的简要状态信息中, COMPLETIONS字段( m/n) 表示期望完成的作业数( n) 和已经完成的作业数( m) , DURATION为作业完成所运行的时长。
~$ kubectl apply -f job-demo.yaml
job.batch/job-demo created
~$ kubectl get jobs/job-demo
NAME     COMPLETIONS      DURATION     AGE
job-demo 1/2 66s 66s相关的Pod资源能够以Job资源的名称为标签进行筛选, 对于串行运行的作业来说, 不同时刻能筛选出的Pod数量可能存在差异。下面的显示命令运行于第一次作业完成后, 而第二次作业刚启动之时:
~$ kubectl get pods -l job-name=job-demo
NAME            READY    STATUS        RESTARTS   AGE
job-demo-lb4vw   0/1     Completed     0          68s
job-demo-xn7zq 1/1 Running 0 6s Job资源的详细描述中能够获得进一步的信息, 包括为Pod自动添加的标签、使用的标签选择器、作业并行度、各Pod的相关状态及相应事件等。
~$ kubectl describe jobs/job-demo
Name:                     job-demo
Namespace:                default
Selector:                 controller-uid=42101d29-8a2b-45bf-b003
13af317c1300
Labels:                   controller-uid=42101d29-8a2b-45bf-b003
13af317c1300
                          job-name=job-demo
Annotations:              Parallelism:  1
Completions:              2
Start Time:               Sun, 20 Sep 2020 12:00:33 +0800
Completed At:             Sun, 20 Sep 2020 12:02:37 +0800
Duration:                 2m4s
Active Deadline Seconds:  300s
Pods Statuses:            0 Running / 2 Succeeded / 0 Failed
Pod Template:
  Labels:  controller-uid=42101d29-8a2b-45bf-b003-13af317c1300
           job-name=job-demo
  Containers:
   ……
Events:
 Type    Reason            Age    From            Message
  ----    ------            ----   ----            -------
  Normal  SuccessfulCreate  3m51s  job-controller  Created pod: job-demo-lb4vw
  Normal  SuccessfulCreate  2m49s  job-controller  Created pod: job-demo-xn7zq
  Normal  Completed         107s   job-controller  Job completed
由上面命令结果可知, Job的默认使用的并行度为1, 这也是为什么上面示例中的两个作业要先后执行而非同时执行的原因, 这意味着多次 作业需要以串行方式运行, 作业的总时长至少要相当于各任务各自的执行时长之和。
Job资源运行完成后便不再占用系统资源, 用户可将其按需保留、手动删除或者设置相应属性执行自动删除操作。job-demo资源留给用户检查相关资源信息的时间窗口为3600秒 ( spec.ttlSecondsAfterFinished) , 超出该时长后, 该作业将由控制器自行删除, 而未定义该字段的作业将会一直保留。
现实中的作业未必能有精确的运行时长, 若某Job资源的Pod程序因存在Bug或其他原因导致的作业无法“完成”并退出, 而其restatPolicy 又定义为了重启, 则该Pod可能会一直处于重启和错误的循环当中。为 此, Job控制器提供了两个属性用于抑制这种情况的发生:
.spec.activeDeadlineSeconds: 用于为Job指定最大活动时间长度, 超出此时长的作业将被终止并标记为失败 ;.spec.backoffLimit: 将作业标记为失败状态之前的重试次数, 默认值为6。
由此可见, 任务的总体可运行时长( activeDeadlineSeconds) 也必须足够容纳作业的预测的总体运行时长。另外, 不存在严格意义上先后 次序的多次作业, 适度的并行将能够显著提升其运行速度。
6.2 并行式Job与扩容机制
将并行度属性.spec.parallelism设置为大于1的值, 并设置总任务数.spec.completion属性大于并行度, 便能够让Job资源以并行方式运行多任务。下面示例中定义了一个2路并行且总体运行10次任务的Job资源规范:
apiVersion: batch/v1
kind: Job
metadata:
  name: job-para-demo
spec:
  template:
    spec:
      containers:
      - name: myjob
        image: alpine:3.11
        imagePullPolicy: IfNotPresent
        command: ["/bin/sh", "-c", "sleep 60"]
      restartPolicy: OnFailure
  completions: 10
  parallelism: 2
  ttlSecondsAfterFinished: 3600
  backoffLimit: 3
activeDeadlineSeconds: 1200按照并行Job的运行法则, job-para-demo资源将允许最多同时运行两个Pod, 这相当于存在两路虚拟作业管道, 每个虚拟管道串行运行分配而来的Job。
~$ kubectl apply -f job-para-demo.yaml
job.batch/job-para-demo created
~$ kubectl get pods -l job-name=job-para-demo
NAME                 READY    STATUS     RESTARTS    AGE
job-para-demo-8fxj2   1/1     Running     0          10s
job-para-demo-mblzj 1/1 Running 0 10sJob资源的作业并行度支持运行时修改, 因而, 我们还能够通过修改 parallelism属性的值来动态提升作业并行度以实现Job资源扩容之目 的。例如, 下面的命令将尚未完成的job-para-demo并行度从2提升到了 5:
~$ kubectl patch jobs/job-para-demo -p '{"spec":{"parallelism":5}}'
job.batch/job-para-demo patched
于是, pod-para-demo资源的并行度提升为5, Kubernetes系统为 job-para-demo资源同时运行的Pod资源数量也随之提升到了5个, 例如, 对于刚启动不久的job-para-demo资源执行如下面的命令可生成类似如下 运行于5个Pod作业的结果。
~$ kubectl get pods -l job-name=job-para-demo -w
NAME                  READY   STATUS      RESTARTS   AGE
job-para-demo-8fxj2   0/1     Completed   0          82s
job-para-demo-d6z98   1/1     Running     0          7s
job-para-demo-hbh99   1/1     Running     0          20s
job-para-demo-lfvj5   1/1     Running     0          7s
job-para-demo-mblzj   0/1     Completed   0          82s
job-para-demo-nq8h7   1/1     Running     0          7s
job-para-demo-ss9t4   1/1     Running     0          20s
另外, Job资源详细描述中, 相关事件的发生时间点也是辅助了解 Pod对象并行运行状态的有效辅助信息。
7. CronJob控制器
CronJob资源用于管理Job资源的运行时间, 它允许用户在特定的 时间或以指定的间隔运行Job, 它适合自动执行特定的任务, 例如备份、报告、发送电子邮件或清理类的任务等。换句话说, CronJob能够以类似于Linux操作系统的周期性任务作业计划( crontab) 的方式控 制其运行的时间点及周期性运行的方式:
仅在未来某时间点将指定的作业运行一次 ;
在指定的周期性时间点重复运行指定的作业。
CronJob资源使用的时间格式类似于Linux系统上的crontab , 稍具不同之处是, CronJob资源在指定时间点时, 通配符“?”和“*”的意 义相同, 它们都表示任何可用的有效值。
CronJob资源使用Job对象来完成任务, 它每次运行时都会创建一 个Job对象, 并使用类似于Job资源的创建、管理和扩容方式。Cronjob也是Kubernetes系统标准的API资源, 其资源规范的基本格式如下。
apiVersion: batch/v1beta1                # API群组及版本
kind: CronJob                            # 资源类型特有标识
metadata:
  name <string>                          # 资源名称, 在作用域中要唯一
  namespace <string>                     # 名称空间 ; CronJob资源隶属名称空间级别
spec:
  jobTemplate  <Object>                  # Job作业模板, 必选字段
    metadata <object>                    # 模板元数据
    spec <object>                        # 作业的期望状态
  schedule <string>                      # 调度时间设定, 必选字段
  concurrencyPolicy  <string>            # 并发策略, 可用值有Allow、Forbid和Replace
  failedJobsHistoryLimit <integer>       # 失败作业的历史记录数, 默认为1
  successfulJobsHistoryLimit  <integer>  # 成功作业的历史记录数, 默认为3
  startingDeadlineSeconds  <integer>     # 因错过时间点而未执行的作业的可超期时长
  suspend  <boolean>                     # 是否挂起后续的作业, 不影响当前作业, 默认为false
下面资源清单( cronjob-demo.yaml) 定义了一个名为cronjob demo的CronJob资源示例, 它每隔2分钟运行一次由jobTemplate定义的 示例任务, 每次任务以单路并行的方式执行1次, 每个任务的执行不超过60秒, 且完成后600秒的Job将会被删除。
apiVersion: batch/v1beta1
kind: CronJob
metadata:
  name: cronjob-demo
  namespace: default
spec:
  schedule: "*/2 * * * *"
  jobTemplate:
    metadata:
      labels:
        app: mycronjob-jobs
    spec:
      parallelism: 1
      completions: 1
      ttlSecondsAfterFinished: 3600
      backoffLimit: 3
      activeDeadlineSeconds: 60
      template:
        spec:
          containers:
          - name: myjob
            image: alpine
            command:
            - /bin/sh
            - -c
            - date; echo Hello from CronJob, sleep a while…; sleep 10;
          restartPolicy: OnFailure
startingDeadlineSeconds: 300将cronjob-demo资源创建到集群上后便可通过资源对象的相关信 息了解运行状态。下面第二条命令结果中的SCHEDULE是指其调度时间点, SUSPEND表示后续任务是否处于挂起状态, 即暂停任务的调度及运行, ACTIVE表示活动状态的Job对象的数量, 而LAST SCHEDULE则表示前一次调度运行至此刻的时长。
~$ kubectl apply -f cronjob-demo.yaml
cronjob.batch/cronjob-demo created
~$ kubectl get cronjobs/cronjob-demo
NAME           SCHEDULE      SUSPEND   ACTIVE   LAST SCHEDULE   AGE
cronjob-demo */2 * * * * False 1 6s 69s我们可借助示例中Job模板上定义的标签过滤出名称空间中相关的 Job对象。一段时长后, cronjob-demo创建的Job对象可能会存在多个, 但示例中Job模板的配置会使得Job控制器自动删除那些完成后超过3600秒的、由cronjob-demo生成的Job对象。另外, CronJob资源默认仅会在历史记录中保留最近运行成功的3个以及运行失败的1个Job, 因此, 最终保留多少个Job也取决于CronJob中的历史记录定义, 而历史记录中保存的Job数也支持由用户自定义其配置。
~$ kubectl get jobs -l controller=cronjob-demo
NAME                   COMPLETIONS      DURATION   AGE
cronjob-demo-1589970720   1/1           24s        6m28s
cronjob-demo-1589970840   1/1           27s        4m28s
cronjob-demo-1589970960   1/1           20s        2m28s
cronjob-demo-1589971080 0/1 27s 27s CroJob在Pod中运行, 并会保留处于Completed状态的Pod日志。由 CronJob资源通过模板创建的Job对象的名称以CronJob自身的名称为前缀, 以Job创建时的时间戳为后缀, 而各Job对象相关的Pod对象的名称则随机生成。已完成的CronJob资源相关Pod的状态为Completed , 而失败的作业状态则存在RunContainerError、CrashLoopBackOff或其他表示失败的状态。
可选的spec.startingDeadlineSeconds字段指示当CronJob由于某种原因错过了计划时间的情况下而允许延迟启动的最长时间( 以秒为 单位) , 错过的CronJob将被视为处于Failed状态。而未定义该字段值, 则意味着CronJob永远不会超时, 这将会导致CronJob资源存在同时运行多个实例的可能性。
CronJob资源的Job对象可能不支持同时运行多个实例, 用户可基于.spec.concurrencyPolicy属性来控制多个CronJob并存的机制, 它 的默认值为Allow, 即允许不同时间点的多个CronJob实例同时运行。 其他两个可用值中, Forbid用于禁止前后两个CronJob同时运行, 如果前一个尚未结束, 则后一个不能启动( 跳过) , Replace用于让后一个 CronJob取代前一个, 即终止前一个并启动后一个
8. Pod中断预算
尽管Deployment等一类的控制器能确保相应Pod对象的副本数量不断逼近期望的数量, 但它却无法保证在某一时刻一定存在指定数量或 一定百分比的Pod对象, 然而这种需求在某些强调服务可用性的场景中是必备的。于是, Kubernetes自1.4版本起引入了 PDB( PodDisruptionBudget , Pod中断预算) 类型的资源, 用于为那些自愿的中断做好预算方案, 限制可自愿中断的最大Pod副本数或确保最少可用的Pod副本数, 以确保服务的高可用性。
Pod对象创建后会一直存在, 除非用户有意将其销毁, 或者出现了 不可避免的硬件或系统软件错误。非自愿中断是指那些由不可控的外界因素导致的Pod中止而退出的情形, 例如硬件或系统内核故障、网络故障以及节点资源不足导致Pod对象被驱逐等 ; 而那些由用户特地执行 的管理操作导致的Pod中断则称为自愿中断, 例如排空节点、人为删除 Pod对象、由更新操作触发的Pod对象重建等。用户可以为那些部署在 Kubernetes的任何应用程序创建一个对应PDB对象以限制自愿中断时最大可以中断的副本数或者最少应该保持可用的副本数, 从而保证应用自身的可用性。
PDB资源的核心目标在于保护由控制器管理的应用, 这必然意味着 PDB将使用等同于相关控制器对象的标签选择器以精确关联至目标Pod 对象。PDB支持的控制器类型包括Deployment、ReplicaSet和StatefulSet等。同时, PDB对象也可以用来保护那些纯粹是由定制的 标签选择器自由选择的Pod对象。
并非所有的自愿中断都会受到PDB的约束, 例如, 删除Deployment 或者Pod的操作就会绕过PDB。另外, 尽管那些因删除或更新操作导致不可用的Pod也会计入预算, 但是控制器( 例如Deployment) 滚动更新时并不会真的被相关联的PDB资源所限制。因此, 用户应当明确遵守 PDB的限制法则, 而不能直接删除PDB相关的Pod或者控制器资源。但管理员在维护集群时对节点执行的排空操作会受到PDB的限制。
PDB也是标准的API资源类型, 其资源规范如下所示。
apiVersion: batch/v1beta1 # API群组及版本
kind: PodDisruptionBudget # 资源类型特有标识
metadata:
  name <string>           # 资源名称, 在作用域中要唯一
  namespace <string>      # 名称空间 ; CronJob资源隶属名称空间级别
spec:
  selector <Object>       # 标签选择器, 通常要与目标控制器资源相同
  minAvailable <string>   # 至少可用的Pod对象百分比, 100%意味着不支持自愿中断
  maxUnavailable <string> # 至多不可用的Pod对象百分比, 0意味着不支持自愿中断 ;
# minAvailable和maxUnavailable互斥, 不能同时定义下面的配置清单示例定义了名为pdb-demo的PDB资源, 它对3.1节中由Deployment资源deployment-demo创建的Pod对象设置了PDB限制, 要求其最少可用Pod对象数量为3个。
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: pdb-demo
  namespace: default
spec:
  maxUnAvailable: 1
  selector:
    matchLabels:
      app: demoapp
release: stable pdb-demo资源对象创建完成后, 我们能够从其YAML格式的资源规范状态信息中了解到该资源的当前状态。
~$ kubectl apply -f pdb-demo.yaml
poddisruptionbudget.policy/pdb-demo created
~$ kubectl get pdb/pdb-demo -o yaml
……
status:
  currentHealthy: 4
  desiredHealthy: 3
  disruptionsAllowed: 1
  expectedPods: 4
  observedGeneration: 1
接下来, 我们可通过在1~2个节点上模拟驱逐deployment-demo资源作用域内的两个或以上数量的Pod对象模拟自愿中断过程, 并监控各 Pod对象被终止的过程来验证PDB资源对象的控制功效。
首先, 我们先了解deployment-demo作用域内各Pod对象在集群节点上的分布状态, 下面的命令结果显示出, 它有两个Pod对象同时运行在节点k8s-node02.ilinux.io之上:
~$ kubectl get pods -l app=demoapp,release=stable -o wide | awk '{print $1,$7}'
NAME                              NODE
deployment-demo-b479b6f9f-dn8cc   k8s-node02.ilinux.io
deployment-demo-b479b6f9f-ndt8t   k8s-node03.ilinux.io
deployment-demo-b479b6f9f-pm994   k8s-node03.ilinux.io
deployment-demo-b479b6f9f-qcwj4   k8s-node02.ilinux.io
接下来, 我们使用命令排空该节点以使得该deployment-demo资源作用域内的Pod对象有两个同时被中止, 从而查看其触发pdb-demo的状态:
$ kubectl drain k8s-node02.ilinux.io --ignore-daemonsets node/k8s-node02.ilinux.io already cordoned
evicting pod default/deployment-demo-b479b6f9f-dn8cc
evicting pod default/deployment-demo-b479b6f9f-qcwj4
error when evicting pod "deployment-demo-b479b6f9f-dn8cc" (will retry after 5s): Cannot evict pod as it would violate the pod's disruption budget.
……
error when evicting pod "deployment-demo-b479b6f9f-dn8cc" (will retry after 5s): Cannot evict pod as it would violate the pod's disruption budget.
evicting pod default/deployment-demo-b479b6f9f-dn8cc
pod/deployment-demo-b479b6f9f-qcwj4 evicted
pod/deployment-demo-b479b6f9f-dn8cc evicted
node/k8s-node02.ilinux.io evicted
测试完成后, 关闭节点k8s-node02.ilinux.io的 SchedulingDisabled状态:
~$ kubectl uncordon k8s-node02.ilinux.io
node/k8s-node02.ilinux.io uncordoned
从测试中排空命令的返回结果可以看出, 同时执行驱逐 deployment-demo作用域内的两个Pod对象的操作时, 一个Pod能立即完成驱逐, 但另一个Pod的驱逐操作被pdb-demo所阻塞, 直到 deployment-demo请求补足该Pod副本的请求在其他节点创建完成并就 绪后, 第二个Pod的驱逐操作才能得以完成。
事实上, PDB资源对多实例的有状态应用来说尤为有用, 如 Consul、ZooKeeper或etcd等, 用户可借助PDB资源来防止自愿中断场 景中将实例的数量减少到低于法定数量( quorum) , 以避免错误的写操作。
参考链接 :
6.5 StatefulSet · Document (yanjieli.cn)