
3-5-节点资源
Kubernetes把工作节点也抽象成了名为Node的API资源 , 但在现实中 , 工作节点是指需要运行kubelet、kube-proxy和以docker或 containerd为代表的容器运行时这3个关键组件的物理服务器或虚拟机 , 其核心任务在于以Pod形式运行工作负载 , 而这些工作负载将消耗节点上的计算资源(CPU和内存) , 必要时还会占用一定的存储资源。 显然 , 在创建一个Node资源对象时 , Kubernetes内部无法真正构建出 这个主机设备来 , 而是仅创建了一个资源对象来代表该主机 , 真正的 主机设备需要由集群外部的云服务商创建或由管理员手动创建。
1. 节点心跳与节点租约
节点控制器负责Node对象生命周期中的多个管理任务 , 包括节点注册到集群时的CIDR分配、与服务器交互以维护可用节点列表 , 以及监控节点的健康状态等。对于每一个Node对象 , 节点控制器都会根据 其元数据字段metadata.name执行健康状态检查 , 以验证节点是否可 用。可用的节点意味着它已经运行kubelet、kube-proxy和容器运行时 , 满足了运行Pod的基本条件。对于那些不可用的节点 , Kubernetes将持续对其进行健康状态检测 , 直到变为可用节点或由管理员手动删 除相应的Node对象为止。
kubelet是运行于节点之上的主代理程序 , 它负责从API Server接收并执行由自身承载的Pod管理任务 , 并需要向Master上报自身运行状态(心跳消息)以维持集群正常运行。在Kubernetes 1.13版本之前 , 节点心跳通过NodeStatus信息每10秒发送一次。如果在参数node monitor-grace-period指定的时长内(默认为40秒)没有收到心跳信息 , 节点控制器将把相应节点标记为NotReady , 而如果在参数pod eviction-timeout指定的时长内仍然没有收到节点的心跳信息 , 则节点控制器将开始从该节点驱逐Pod对象。 考虑到节点之上维持的容器镜像和存储卷等信息 , NodeStatus信息在节点上有着较多镜像和存储卷的场景中可能会变得较大 , 进而也必将影响到etcd的存储效率 , 因此Kubernetes 1.13版本引入了与 NodeStatus协同工作的更加轻便且可扩展的心跳指示器——节点租约 (node lease)。每个节点的kubelet负责在专用的名称空间kube node-lease中创建一个与节点同名的Lease对象以表示心跳信息 , 该资源隶属于名为coordination.k8s.io的新内置API群组。
root@kubeadm-master1:~# kubectl get leases -n kube-node-lease
NAME HOLDER AGE
kubeadm-master1.cbear.top kubeadm-master1.cbear.top 44h
kubeadm-master2.cbear.top kubeadm-master2.cbear.top 44h
kubeadm-master3.cbear.top kubeadm-master3.cbear.top 44h
node01.cbear.top node01.cbear.top 44h
node02.cbear.top node02.cbear.top 44h
node03.cbear.top node03.cbear.top 44h
节点租约与NodeStatus协同工作的逻辑如下:
Kubelet定期更新自己的Lease对象 , 默认为10秒钟;Kubelet定期(默认为10秒)计算一次NodeStatus, 但并不直接上报给Master;仅
NodeStatus发生变动 , 或者已经超过了由参数node-status update-period指定的时长(默认为5分钟)时 ,kubelet将发送NodeStatus心跳给Master。
无论是NodeStatus还是Lease对象的更新 , 都会被节点控制器视为给定的kubelet健康状态信息 , 但承载节点信息的NodeStatus的平均频次被大大降低 , 从而显著降低了etcd存储数据的压力 , 有效改善了系统性能。
2. 节点状态
节点状态信息可使用kubectl describe nodes [NODE]命令予以打印 , 它通常包括节点地址(Addresses)、系统属性(System Info)、租约(Lease)、污点(Taints)、不可调度性(Unschedulable)、状况(Conditions)、系统容量(Capacity)、 已分资源量(Allocated resources)、可分配容量(Allocatable) 和Pod的可用地址池(PodCIDR和PodCIDRs)等。
节点地址包括节点IP地址和主机名 , 其中节点地址包括 InternalIP和ExternalIP , 前者用于集群内部通信 , 后者是能够从集群外部路由并访问的IP地址。Pod可用地址池则是指为当前节点中运行的Pod对象分配IP地址的CIDR格式的网络 , 若存在多个可用CIDR网络 , 则将其保存在PodCIDRs属性中。系统信息用于描述主机ID、主机操作系统及标识(UUID)、内核版本、平台架构、kubelet程序版本、 kube-proxy程序版本和容器运行时及版本等节点通用信息 , 它们由 kubelet从其所在的节点收集而来。
System Info:
  Machine ID:                 291a5aa6f0f9469cad208d285eadf11d
  System UUID:                a3719830-e1c0-44ad-bae1-250d7fe08e8b
  Boot ID:                    8525459f-1851-42ec-8efe-5749e76b2507
  Kernel Version:             5.15.0-101-generic
  OS Image:                   Ubuntu 22.04.4 LTS
  Operating System:           linux
  Architecture:               amd64
  Container Runtime Version:  docker://26.1.1
  Kubelet Version:            v1.29.4
  Kube-Proxy Version:         v1.29.4
PodCIDR:                      10.10.8.0/24
PodCIDRs:                     10.10.8.0/24
Non-terminated Pods: (7 in total) 系统容量用于描述节点上的总体可用资源:CPU、临时存储(指节点本地可被容器作为存储卷使用的存储空间)、大内存页、内存空间 , 以及可以调度到节点上的Pod对象的最大数量等 , 可分配容量则描述这些资源剩余总量。为了便于同Kubernetes上的“资源”区分开来 , CPU和内存通常被称为计算资源 , 而临时存储空间则被称为存储资源。
root@kubeadm-master1:~# kubectl describe node node01.cbear.top
...
Capacity:
cpu: 8
ephemeral-storage: 204484028Ki
hugepages-1Gi: 0
hugepages-2Mi: 0
memory: 7983612Ki
pods: 110
Allocatable:
cpu: 8
ephemeral-storage: 188452479893
hugepages-1Gi: 0
hugepages-2Mi: 0
memory: 7881212Ki
pods: 110
....已分配资源量用于描述当前节点上CPU、内存和临时存储资源的已分配比例。Kubernetes系统上的每个Pod在创建时可分别声明其计算资源及存储资源的需求量(request)和限制量(limit) , 需求量表示 运行时一个Pod必须确保的某项最小资源 , 而限制量表示该Pod能够申请占用的某项资源的上限。在已分配资源量中 , Requests代表所有Pod 对象声明的资源需求量之和所占节点资源的比例 , 而Limits则表示所有Pod对象声明的资源限制量之和所占节点资源的比例。
Allocated resources:
(Total limits may be over 100 percent, i.e., overcommitted.)
Resource Requests Limits
-------- -------- ------
cpu 300m (3%) 250m (3%)
memory 320Mi (4%) 570Mi (7%)
ephemeral-storage 0 (0%) 0 (0%)
hugepages-1Gi 0 (0%) 0 (0%)
hugepages-2Mi 0 (0%) 0 (0%)
Events: <none>
Kubernetes调度器负责确保每个节点上所有Pod对象的总容量需求不会超过节点拥有容量 , 它计算已有的资源占用量时包括所有由 Scheduler调度以及kubelet自身启动的Pod对象 , 但不包括由容器运行时自行启动的容器 , 也不包括容器外运行的任何进程。若需要为非Pod进程显式保留资源 , 需要使用--system-reserved和--reserved-cpus 等选项进行定义。
Conditions字段则用于描述节点当前所处的“境况”或者“条件” , 每个条件都需要用布尔型值来表达其满足与否的状态 ,
节点Conditions字段说明
一旦Ready条件的值不为True的时长超过kube-controller-manager程序的--pod-eviction-timeout选项指定的值(默认为5分 钟) , 则该节点上的所有Pod对象都将被节点控制器计算删除。不过 , 当kubelet无法同Master通信时 , 必然无法接收到删除Pod对象的指令 , 但调度器可能已经将这些Pod的替代实例指派到了其他健康的节点之上运行。
3. 手动管理Node资源与节点
借助kubconfig配置文件连接并认证到API Server后 , kubelet默认会主动将自身注册到API Server , 创建Node对象 , 并报告自身的CPU 资源和内存资源的容量。若管理员希望手动创建Node对象 , 则应该将--register-node选项的值设定为False , 同时需要手动设置节点的 CPU、内存和临时存储等资源的容量。
下面的配置清单定义了名为temp-node.ilinux.io的Node对象 , 定 义中仅给出了Pod可用地址池 , 并未明确定义节点的容量及其他属性 值。
apiVersion: v1
kind: Node
metadata:
  name: temp-node.ilinux.io
spec:
  podCIDR: 10.244.6.0/24
  podCIDRs: [10.244.6.0/24]
使用命令式对象配置或声明式对象配置即可把该资源创建于集群 之上 , 那些未明确定义的字段通常会以默认值填充。命令及响应结果 如下所示
~$ kubectl create -f node-demo.yaml
node/temp-node.ilinux.io created随后可运行get命令打印该Node对象的状态信息 , 若主机名temp-node.ilinux.io无法正常解析 , 或解析结果对应的地址不可达 , 则其 STATUS为Unknow , 且1分钟之后变为NotReady。
~$ kubectl get nodes/temp-node.ilinux.io
NAME                  STATUS    ROLES    AGE   VERSION
temp-node.ilinux.io Unknown <none> 11s通过describe命令打印出的详细描述信息可以看出 , 该节点并不存在Capacity和Allocable状态信息 , Conditions中的各条件均为 Unknown , 未设置Lease对象 , 且System Info的各属性值亦为空值。限于篇幅 , 下面的命令只给出部分结果。
~ $ kubectl describe node/temp-node.ilinux.io
……
Lease:
  HolderIdentity:  <unset>
  AcquireTime:     <unset>
  RenewTime:       <unset>
…管理员随后部署一个名为temp-node.ilinux.io的工作节点 , 该名称可被集群正确解析到该节点的IP地址 , 关闭kubelet的自动注册功 能 , 将其连接、认证到API Server之上即可将该工作节点以手动创建 Node对象的方式加入集群中。若不打算加入对应的工作节点 , 就需要在测试完成之后将对象删除 , 以避免节点控制器持续对其进行健康状态监测
~$ kubectl delete node/temp-node.ilinux.io
node "temp-node.ilinux.io" deleted
考虑到系统维护或硬件升级等原因 , 管理员有时候需要手动重启或下线某个工作节点 , 安全的操作步骤是先手动禁止调度器继续向该节点调度新的Pod对象以封锁(cordon)该节点 , 但封锁操作并不会影响节点上现有的Pod对象 , 接下来还需要正常逐出该节点上运行着的工 作负载以“排空”(drain)该节点。
封锁节点的命令是kubectl cordon , 它专用于Node对象 , 因此命令中无须指明资源类型。例如 , 下面的命令可封锁k8s-node03节点。 被封锁的节点的状态会在Ready后多一个SchedulingDisabled。
~$ kubectl cordon k8s-node03.ilinux.io
node/k8s-node03.ilinux.io cordoned
~$ kubectl get nodes/k8s-node03.ilinux.io
NAME                     STATUS                   ROLES    AGE   VERSION
k8s-node03.ilinux.io Ready,SchedulingDisabled <none> 24d v1.17.3提示: 封锁工作节点对
DaemonSet控制器创建的Pod对象无效。
排空节点的目的是确保正常终止Pod对象 , 因此容器应该处理 SIGTERM信号以关闭与客户端的活动连接 , 并干净彻底地提交或回滚数据库事务等 , 随后才能安全地由其他工作节点启动的同类实例所替代。
~$ kubectl drain nodes/k8s-node03.ilinux.io
node/k8s-node03.ilinux.io already cordoned
node/k8s-node03.ilinux.io drained
由命令结果可以看出 , 排空命令自身也会先封锁目标节点而后再进行排空操作 , 即完成封锁和排空两个步骤 , 故而不必事先进行单独的封锁操作。不过 , 仅期望封锁工作节点时 , cordon命令显然更适用。随后 , 无论是运行cordon还是drain命令 , 若期望工作节点回归正 常工作状态 , 都需要使用uncordo命令对节点进行解封。
~$ kubectl uncordon nodes/k8s-node03.ilinux.io
node/k8s-node03.ilinux.io uncordoned
需要注意的是 , drain默认只能排空受控制器(如Deployment、 DaemonSet或StatefulSet等)管理的Pod对象 , 而不受控于控制器的Pod(例如静态Pod)则会阻止命令的运行。如果要忽略这种阻止操 作 , 可以为drain附加--force选项 , 以清理系统级Pod对象。
4. 系统守护进程预留计算资源
Kubernetes 的节点可以按照 Capacity 调度。默认情况下 pod 能够使用节点全部可用容量。 这是个问题,因为节点自己通常运行了不少驱动 OS 和 Kubernetes 的系统守护进程。 除非为这些系统守护进程留出资源,否则它们将与 Pod 争夺资源并导致节点资源短缺问题。
kubelet 公开了一个名为 'Node Allocatable' 的特性,有助于为系统守护进程预留计算资源。 Kubernetes 推荐集群管理员按照每个节点上的工作负载密度配置 'Node Allocatable'。
4.1 节点可分配资源
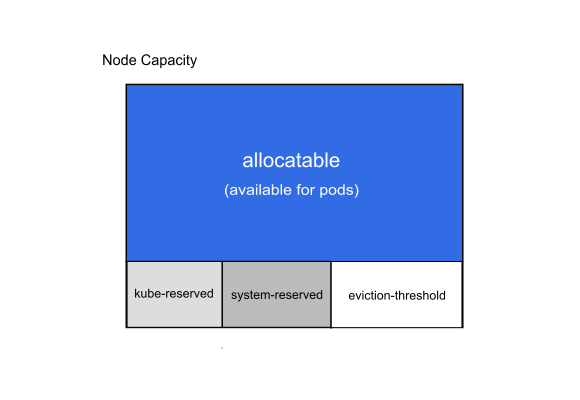
Kubernetes 节点上的 'Allocatable' 被定义为 Pod 可用计算资源量。 调度器不会超额申请 'Allocatable'。 目前支持 'CPU'、'memory' 和 'ephemeral-storage' 这几个参数。
可分配的节点暴露为 API 中 v1.Node 对象的一部分,也是 CLI 中 kubectl describe node 的一部分。
在 kubelet 中,可以为两类系统守护进程预留资源。
4.1.1 启用 QoS 和 Pod 级别的 cgroups
为了恰当地在节点范围实施节点可分配约束,你必须通过 --cgroups-per-qos 标志启用新的 cgroup 层次结构。这个标志是默认启用的。 启用后,kubelet 将在其管理的 cgroup 层次结构中创建所有终端用户的 Pod。
4.1.2 配置 cgroup 驱动
kubelet 支持在主机上使用 cgroup 驱动操作 cgroup 层次结构。 该驱动通过 --cgroup-driver 标志进行配置。
支持的参数值如下:
cgroupfs是默认的驱动,在主机上直接操作cgroup文件系统以对cgroup沙箱进行管理。systemd是可选的驱动,使用init系统支持的资源的瞬时切片管理cgroup沙箱。
取决于相关容器运行时的配置,操作员可能需要选择一个特定的 cgroup 驱动来保证系统正常运行。 例如,如果操作员使用 containerd 运行时提供的 systemd cgroup 驱动时, 必须配置 kubelet 使用 systemd cgroup 驱动。
4.1.3 Kube 预留值
Kubelet 标志:
--kube-reserved=[cpu=100m][,][memory=100Mi][,][ephemeral-storage=1Gi][,][pid=1000]Kubelet 标志:
--kube-reserved-cgroup=
kube-reserved 用来给诸如 kubelet、容器运行时、节点问题监测器等 Kubernetes 系统守护进程记述其资源预留值。 该配置并非用来给以 Pod 形式运行的系统守护进程预留资源。kube-reserved 通常是节点上 Pod 密度 的函数。
除了 cpu、内存 和 ephemeral-storage 之外,pid 可用来指定为 Kubernetes 系统守护进程预留指定数量的进程 ID。
要选择性地对 Kubernetes 系统守护进程上执行 kube-reserved 保护,需要把 kubelet 的 --kube-reserved-cgroup 标志的值设置为 kube 守护进程的父控制组。
推荐将 Kubernetes 系统守护进程放置于顶级控制组之下(例如 systemd 机器上的 runtime.slice)。 理想情况下每个系统守护进程都应该在其自己的子控制组中运行。
请注意,如果 --kube-reserved-cgroup 不存在,Kubelet 将 不会 创建它。 如果指定了一个无效的 cgroup,Kubelet 将会无法启动。就 systemd cgroup 驱动而言, 你要为所定义的 cgroup 设置名称时要遵循特定的模式: 所设置的名字应该是你为 --kube-reserved-cgroup 所给的参数值加上 .slice 后缀。
4.1.4 显式预留的 CPU 列表
Kubelet 标志: --reserved-cpus=0-3
KubeletConfiguration 标志:reservedSystemCPUs: 0-3
reserved-cpus 旨在为操作系统守护程序和 Kubernetes 系统守护程序预留一组明确指定编号的 CPU。 reserved-cpus 适用于不打算针对 cpuset 资源为操作系统守护程序和 Kubernetes 系统守护程序定义独立的顶级 cgroups 的系统。 如果 Kubelet 没有 指定参数 --system-reserved-cgroup 和 --kube-reserved-cgroup, 则 reserved-cpus 的设置将优先于 --kube-reserved 和 --system-reserved 选项。
此选项是专门为电信/NFV 用例设计的,在这些用例中不受控制的中断或计时器可能会影响其工作负载性能。 你可以使用此选项为系统或 Kubernetes 守护程序以及中断或计时器显式定义 cpuset, 这样系统上的其余 CPU 可以专门用于工作负载,因不受控制的中断或计时器的影响得以降低。 要将系统守护程序、Kubernetes 守护程序和中断或计时器移动到此选项定义的显式 cpuset 上,应使用 Kubernetes 之外的其他机制。 例如:在 CentOS 系统中,可以使用 tuned 工具集来执行此操作。
4.1.5 驱逐阈值
Kubelet 标志:--eviction-hard=[memory.available<500Mi]
节点级别的内存压力将导致系统内存不足,这将影响到整个节点及其上运行的所有 Pod。 节点可以暂时离线直到内存已经回收为止。为了防止系统内存不足(或减少系统内存不足的可能性), kubelet 提供了资源不足管理。 驱逐操作只支持 memory 和 ephemeral-storage。 通过 --eviction-hard 标志预留一些内存后,当节点上的可用内存降至预留值以下时, kubelet 将尝试驱逐 Pod。 如果节点上不存在系统守护进程,Pod 将不能使用超过 capacity-eviction-hard 所指定的资源量。 因此,为驱逐而预留的资源对 Pod 是不可用的。
4.1.6 实施节点可分配约束
Kubelet 标志:--enforce-node-allocatable=pods[,][system-reserved][,][kube-reserved]
调度器将 'Allocatable' 视为 Pod 可用的 capacity(资源容量)。
kubelet 默认对 Pod 执行 'Allocatable' 约束。 无论何时,如果所有 Pod 的总用量超过了 'Allocatable',驱逐 Pod 的措施将被执行。 有关驱逐策略的更多细节可以在节点压力驱逐页找到。 可通过设置 kubelet --enforce-node-allocatable 标志值为 pods 控制这个措施。
可选地,通过在同一标志中同时指定 kube-reserved 和 system-reserved 值, 可以使 kubelet 强制实施 kube-reserved 和 system-reserved 约束。 请注意,要想执行 kube-reserved 或者 system-reserved 约束, 需要对应设置 --kube-reserved-cgroup 或者 --system-reserved-cgroup。
4.2 一般原则
系统守护进程一般会被按照类似 Guaranteed 的 Pod 一样对待。 系统守护进程可以在与其对应的控制组中出现突发资源用量,这一行为要作为 Kubernetes 部署的一部分进行管理。 例如,kubelet 应该有它自己的控制组并和容器运行时共享 kube-reserved 资源。 不过,如果执行了 kube-reserved 约束,则 kubelet 不可出现突发负载并用光节点的所有可用资源。
在执行 system-reserved 预留策略时请加倍小心,因为它可能导致节点上的关键系统服务出现 CPU 资源短缺、 因为内存不足而被终止或者无法在节点上创建进程。 建议只有当用户详尽地描述了他们的节点以得出精确的估计值, 并且对该组中进程因内存不足而被杀死时,有足够的信心将其恢复时, 才可以强制执行 system-reserved 策略。
作为起步,可以先针对
pods上执行 'Allocatable' 约束。一旦用于追踪系统守护进程的监控和告警的机制到位,可尝试基于用量估计的方式执行
kube-reserved策略。随着时间推进,在绝对必要的时候可以执行
system-reserved策略。
随着时间推进和越来越多特性被加入,kube 系统守护进程对资源的需求可能也会增加。 以后 Kubernetes 项目将尝试减少对节点系统守护进程的利用,但目前这件事的优先级并不是最高。 所以,将来的发布版本中 Allocatable 容量是有可能降低的。
4.3示例场景
这是一个用于说明节点可分配(Node Allocatable)计算方式的示例:
节点拥有
32Gimemory、16 CPU和100GiStorage资源--kube-reserved被设置为cpu=1,memory=2Gi,ephemeral-storage=1Gi--system-reserved被设置为cpu=500m,memory=1Gi,ephemeral-storage=1Gi--eviction-hard被设置为memory.available<500Mi,nodefs.available<10%
在这个场景下,'Allocatable' 将会是 14.5 CPUs、28.5Gi 内存以及 88Gi 本地存储。 调度器保证这个节点上的所有 Pod 的内存 requests 总量不超过 28.5Gi,存储不超过 '88Gi'。 当 Pod 的内存使用总量超过 28.5Gi 或者磁盘使用总量超过 88Gi 时,kubelet 将会驱逐它们。 如果节点上的所有进程都尽可能多地使用 CPU,则 Pod 加起来不能使用超过 14.5 CPUs 的资源。
当没有执行 kube-reserved 和/或 system-reserved 策略且系统守护进程使用量超过其预留时, 如果节点内存用量高于 31.5Gi 或 storage 大于 90Gi,kubelet 将会驱逐 Pod。
参考链接