1-容器
1. 发展简史
1.1 背景
云原生技术有利于各组织在公有云、私有云和混合云等新型动态环境中, 构建和运行可弹性扩展的应用。云原生的代表技术包括容器、服务网格、微服务、不可变基础设施和声明式API。
聊容器技术避不开云原生 , 聊云原生也避不开容器技术。容器技术和云原生就是一对双螺旋体 , 容器技术催生了云原生思潮 , 云原生生态推动了容器技术发展。从2013年docker ( container) 技术诞生 , 到2015年CNCF这个云原生领域重量级联盟便成立 , 这不是历史的巧合而是历史的必然。作为云原生关键技术之一的容器 , 从2013年诞生以来一直是行业关注的焦点之一。借用一张业界广泛引用的云原生容器技术进阶图来了解一下容器技术和云原生诞生的历史背景。
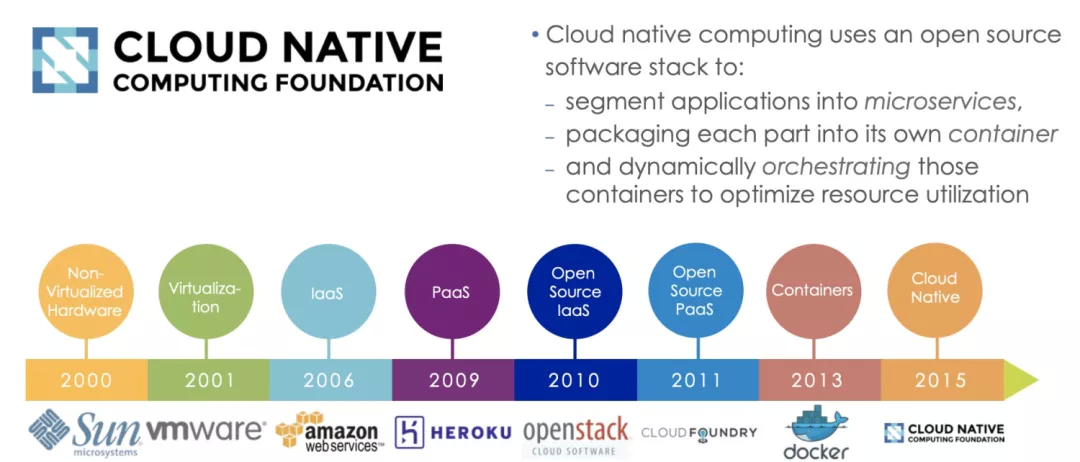
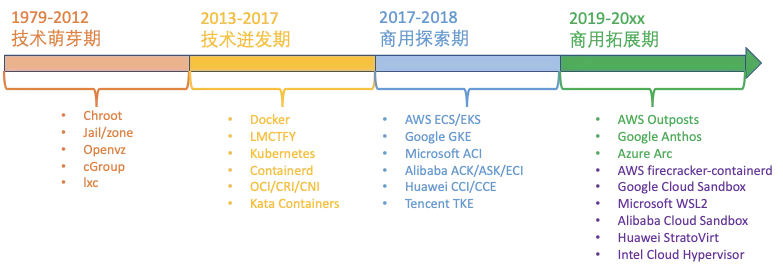
先让我们一起来看看容器技术发展的历史纪年表 , 先直观感受一下这片如火如荼的热土吧!
1979年 ,Unix v7系统支持chroot, 为应用构建一个独立的虚拟文件系统视图。1999年 ,FreeBSD 4.0支持jail, 第一个商用化的OS虚拟化技术。2004年 ,Solaris 10支持Solaris Zone, 第二个商用化的OS虚拟化技术。2005年 ,OpenVZ发布 , 非常重要的Linux OS虚拟化技术先行者。2004年 ~2007年,Google内部大规模使用Cgroups等的OS虚拟化技术。2006年,Google开源内部使用的process container技术 , 后续更名为cgroup。2008年 ,Cgroups进入了Linux内核主线。2008年 ,LXC(Linux Container) 项目具备了Linux容器的雏型。2011年 ,CloudFoundry开发Warden系统 , 一个完整的容器管理系统雏型。2013年 ,Google通过Let Me Contain That For You(LMCTFY) 开源内部容器系统。2013年 ,Docker项目正式发布 , 让Linux容器技术逐步席卷天下。2014年 ,Kubernetes项目正式发布 , 容器技术开始和编排系统起头并进。2015年 , 由Google,Redhat、Microsoft及一些大型云厂商共同创立了CNCF,云原生浪潮启动。2016年-2017年 , 容器生态开始模块化、规范化。CNCF接受Containerd、rkt项目 ,OCI发布1.0,CRI/CNI得到广泛支持。2017年-2018年 , 容器服务商业化。AWS ECS,Google EKS,Alibaba ACK/ASK/ECI, 华为CCI,Oracle Container Engine for Kubernetes;VMware,Redhat和Rancher开始提供基于Kubernetes的商业服务产品。2017年-2019年 , 容器引擎技术飞速发展 , 新技术不断涌现。2017年底Kata Containers社区成立 ,2018年5月Google开源gVisor代码 , 2018年11月AWS开源firecracker, 阿里云发布安全沙箱1.0。2020年-202x年 , 容器引擎技术升级 ,Kata Containers开始2.0架构 , 阿里云发布沙箱容器2.0....
整理容器技术近20年的发展历史 , 大致可以将其分为四个历史阶段 , 下文将详细介绍这四个历史阶段。
1.2 技术萌芽
每个单独运行进程的用户空间,叫做容器。使得容器中的进程与其他用户空间中的进程彼此不互相干扰。一个用户空间只运行一个进程和其子进程 , 当进程终止时,整个用户空间就会被销毁。
容器技术需要解决的核心问题之一运行时的环境隔离。容器的运行时环境隔离 , 目标是给容器构造一个无差别的运行时环境 , 用以在任意时间、任意位置运行容器镜像。由于docker的布道 , 大家习惯性认为容器的运行时环境隔离就是OS虚拟化 , 或者容器等于namespace + cgroup + 安全防护机制。我不太赞同这种看法 , 这个只是一段历史时期、一种容器运行时的实现技术 , 还有很多种其它可能的技术方案来实现容器运行环境。所以 , 回到需求的本源 : 容器需要运行时隔离技术来保证容器的运行环境符合预期。习惯上 , 大家把这种实现容器隔离技术的组件叫做容器运行时。
从另外一个角度看 , 容器隔离技术解决的是资源供给问题。为啥需要容器隔离技术来解决资源供给问题呢?成也萧何 , 败也萧何!摩尔定律实在太过强大 , 它让我们有了越来越多的计算资源可以使用。10年前做小型机时 , 小型机的典型规格是32路8核CPU , 现在一台4路PC服务器计算能力都超过10年前的小型机服务器。小型机的典型用法是把整机切分为多个分区使用。观察当下云服务硬件发展趋势 , 越来越有熟悉的感觉 , 我们在把小型机相关技术 " 军转民 " 。现在我们一台PC服务器拥有了非常强大的、能和十年前小型机媲美的计算能力 , 巧合的是当下PC服务器的典型用法也和十年前的小型机用法类似 , 切割为1-8vCPU的虚拟机/容器使用。
为什么人们总是习惯于把一个大的服务器资源切分为小的分区使用而不是研发能够充分发挥大型服务器整机计算能力的软件呢?个人认为背后有两个制约因素 :
待解决问题本身内在的并行度有限。随着多核多处理器系统的日益普及 , IT行业从
2004年开始进行串行编程到并行编程的升级改造。开始阶段针对特定行业应用的并行化改造效果非常明显 , 但是后来发现随着并行度提高改造成本越来越大、收益却越来越低。受阿姆达尔定律制约 , 解决特定问题的并行度超过一定临界点之后收益将逐渐变小。所以一味提高系统并行度并不是经济的做法。人类智力有限。受人类智力限制 , 系统越复杂、并行度越高 , 软件越容易出故障 , 软件维护代价成指数级增长。所以 , 从软件工程看 , 大家也趋向于接口化、模块化、单元化的软件架构设计 , 尽量控制软件的复杂度 , 降低工程成本。
从经验看, 1-8个CPU的并行度是软件工程的舒适区 , 这个也是容器化、微服务等技术背后的驱动因素之一。
总之 , 基于隔离的资源供给不是伪需求。对于软件运行环境的隔离要求 , 从操作系统出现之初就有了。多任务分时操作系统和进程虚拟地址都是为了解决多个任务运行在同一台主机上的资源共享问题 , 让每个进程都以为自己独占主机。当然仅仅是进程隔离是远远不够的。纵观当前的资源隔离技术 , 我们大致可以将资源隔离技术分成5类:
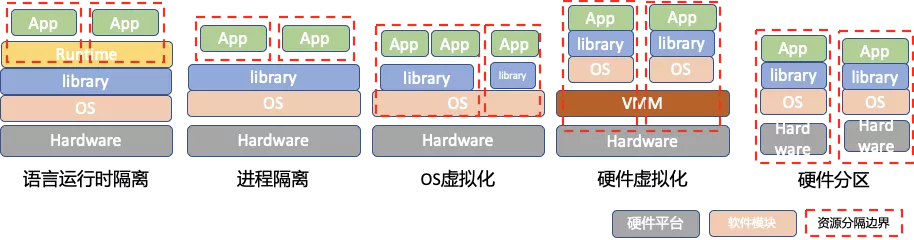
语言运行时隔离。对于
Java、nodejs等需要language runtime的managed language, 我们还有一个选项 , 就是在language runtime里实现隔离。针对函数计算等云原生服务 , 理论上在语言运行时实现隔离机制是最优路径。但是这条路线目前实现上还有不少现实的制约 , 所以目前多数函数计算还是采用的容器/VM技术来实现的隔离。
进程隔离。
OS以进程作为Task运行过程的抽象 , 进程拥有独立的地址空间和执行上下文 , 本质上OS对进程进行了CPU和内存虚拟化。但是进程之间还共享了文件系统、网络协议栈、IPC通信空间等多种资源 , 进程之间因为资源争抢导致的干扰很严重。这个层级的隔离适合在不同的主机上运行单个用户的不同程序 , 由用户通过系统管理手段来保证资源分配与安全防护等问题。OS虚拟化。
OS隔离 , 也就是大家常说的操作系统虚拟化 (OS virtualization) , 是进程隔离的升华版。进程隔离是为每个进程实现了单独的地址空间及CPU上下文 ,OS隔离则是利用操作系统分身术为每一组进程实例构造出一个独立的OS环境 , 以进一步虚拟化文件系统、网络协议栈、IPC通信空间、进程ID、用户ID等OS资源。OS隔离需要解决三个核心问题 : 独立视图、访问控制及安全防护。Chroot、Linux namespace机制为进程组实现独立视图 ,cgroup对进程组进行访问控制 , 而Capabilities、Apparmor、seccomp等机制则实现安全防护。当然 ,OS是一个非常复杂、动态变化的系统 ,OS分身术虽然让进程组感觉有了独立的OS, 但是真实实现还是一个OS实例 , 所以整体防护能力还是堪忧。硬件虚拟化。
OS虚拟化是实现OS内核的分身术 , 而硬件虚拟化则是实现硬件设备的分身术。硬件虚拟化技术的出现 , 让同一个物理服务器上能够同时运行多个操作系统 , 每个操作系统都认为自己在管理一台完整的服务器。不同操作系统之间是严格隔离的 ,Guest操作系统对硬件的访问都是受VMM或CPU的严格监管的。硬件虚拟化既有很好的安全性 , 也有很好的隔离性 , 缺点就是引入的硬件虚拟化层导致了额外的性能开销。硬件分区。这个是传统小型机体系采用的资源分隔技术 , 就是从硬件或固件层彻底把一台大型服务器分隔为多个硬件单元 , 从而获得最高等级的安全性和隔离性。但是小型机作为一个逐步没落的技术路线 , 其不足之处还是显而易见的 : 资源分隔粒度不灵活、系统成本偏高、系统可扩展性受限。
在OS虚拟化这条技术路线上 , 最大的技术贡献来源于Google。2003-2006年, Google陆续发布的 " 三驾马车 " , 奠定了大数据计算的框架 , 随后进一步创造了 " 云 " 的概念。也是从这时期开始 , 进程隔离技术进入了一个更高级的阶段。在Google提出的云计算框架下 , 被隔离的进程不仅仅是一个与外界隔绝但本身却巍然不动的Jail , 它们更需要像一个个轻便的容器 , 除了能够与外界隔离之外 , 还要能够被控制与调配 , 从而实现分布式应用场景下的跨平台、高可用、可扩展等特性。2006年 , Google推出Process Containers , 用来对一组进程进行限制、记账、隔离资源 ( CPU、内存、磁盘I/O、网络等 ) 。由于技术更加成熟 , Process Container在2006年正式推出后 , 第二年就进入了Linux内核主干 , 并正式更名为Cgroups , 标志着Linux阵营中 " 容器 " 的概念开始被重新审视和实现。在 2008 年 , 通过将 Cgroups 的资源管理能力和 Linux Namespace ( 命名空间 ) 的视图隔离能力组合在一起 , 一项完整的容器技术 LXC ( Linux Container ) 出现在了 Linux 内核中 , 这就是如今被广泛应用的容器技术的实现基础。
总体看 , 在2013年docker被发明以前 , Linux操作系统已经大体上解决了容器核心技术之一的运行环境隔离技术 , 或者说Linux OS虚拟化技术已经基本上成型了。虽然容器运行环境隔离技术已经基本就位 , 我们仍需等待另外一项关键技术才能迎来容器技术的腾飞时刻。
1.3 技术迸发期
2013年之前 , 云计算行业一直在为云原生的正确打开姿势而操心。Platform as a Service(PaaS)看起来是个有前途的方向。2006年Fotango公司发布的Zimi服务 , 可以说是PaaS行业的鼻祖 , 具有按使用付费、免运维(Serverless) 、API化配置和服务等典型云原生的特征 ; 2008年Google推出GAE ; 2011年Pivotal发布Cloud Foundry。这些早期的PaaS平台进行了非常有益的探索 , 推动了云计算生态的健康发展 , 但是这些早期探索技术并没有形成大的行业趋势 , 而是局限在一些的特定的领域。直到Docker开源 , 大家才如梦方醒 , 原来不是方向不对 , 而是应用分发和交付的手段不行。
Docker真正核心的创新是容器镜像 ( docker image ) , 一种新型的应用打包、分发和运行机制。容器镜像将应用运行环境 , 包括代码、依赖库、工具、资源文件和元信息等 , 打包成一种操作系统发行版无关的不可变更软件包。
容器镜像打包了整个容器运行依赖的环境 , 以避免依赖运行容器的服务器的操作系统 , 从而实现 "build once , run anywhere" 。
容器镜像一但构建完成 , 就变成read only , 成为不可变基础设施的一份子。
操作系统发行版无关 , 核心解决的是容器进程对操作系统包含的库、工具、配置的依赖 , 但是容器镜像无法解决容器进程对内核特性的特殊依赖。这个在实际使用容器的过程中也经常跳进这个大坑;
Docker的宣传口号是"Build , Ship and Run Any App , Anywhere"。我们已经理解了docker通过container image解决"Run Anywhere"的机制 , 那么"Run Any App"是如何实现的呢?其实也是依赖container image ,用户可以打包任何容器进程所依赖的环境 , 而不用改造应用来适配PaaS定义的运行环境。真是"Run Any App"一举打破了PaaS行业面临的困境 , 创造出了无限的可能性 , 大力推动了云原生的发展。
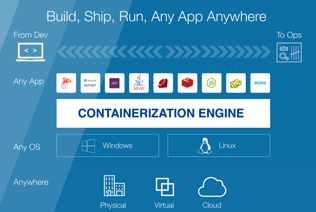
至此 , 容器技术体系已经解决了最核心的两个问题 : 如何发布软件和如何运行软件。
Docker作为一个单机软件打包、发布、运行系统 , 其价值是非常巨大的; 但是仅仅将docker技术局限在单机范围不能发挥这个创新技术的最大价值 , 自然下一步业界希望基于docker技术构建一个云化的集群系统 , 来对业务容器进行编排管理。
聊到容器编排系统 , 我们需要从Google聊起。2008年 , Google基于LXC推出首款应用托管平台GAE(Google App Engine),首次把开发平台当做一种服务来提供。GAE是一种分布式平台服务 , Google通过虚拟化技术为用户提供开发环境、服务器平台、硬件资源等服务 , 用户可以在平台基础上定制开发自己的应用程序并通过Google的服务器和互联网资源进行分发。Google在GAE中使用了一个能够对LXC进行编排和调度的工具 ---Borg(Kubernetes 的前身)。Borg是 Google内部使用的大规模集群管理系统, 可以承载十万级的任务、数千个不同的应用、同时管理数万台机器。Borg通过权限管理、资源共享、性能隔离等来达到高资源利用率。它能够支持高可用应用 , 并通过调度策略减少出现故障的概率 , 提供了任务描述语言、实时任务监控、分析工具等。如果说一个个隔离的容器是集装箱 , 那么Borg可以说是最早的港口系统 , 而 LXC + Borg 就是最早的容器编排框架。
2013年docker推出之后迅速席卷全球 , 2014年Google基于内部使用的Borg系统创建了开源项目Kubernetes(简称K8S) , 用于解决大规模集群的容器部署、运行、管理等问题。Kubernetes在容器的基础上增加了一层的新的管理抽象Pod , 以便更好地利用容器进行应用的功能模块切分。得益于Google在大规模集群基础设施建设的强大积累 , 脱胎于 Borg 的 K8S 很快成为了行业的标准应用 , 堪称容器编排的必备工具。
作为回应 , Docker公司在2015年发布的Docker 1.12版本中也加入了一个容器集群管理系统Docker swarm ,以及配套的Docker machine、Docker Compose等工具 , 力图构建完善的容器编排系统 , 和Kubernetes展开正面竞争。从此 , 容器江湖分为两大阵营 : Google派和Docker派 ; 而容器编排系统则是Kubernetes , Docker Swarm和Apache Mesos三国并立。各大派系的竞争愈演愈烈 , 逐渐延伸到行业标准的建立之争。让我们一起来回忆一下这段风起云涌的江湖历史吧!
2013年Docker公司推出docker之后 , 紧接着CoreOS应运而生。CoreOS是一个基于Linux内核的轻量级操作系统 , 专为云计算时代计算机集群的基础设施建设而设计, 拥有自动化、易部署、安全可靠、规模化等特性。其在当时有一个非常显眼的标签 : 专为容器设计的操作系统。借着Docker的东风 , CoreOS迅速在云计算领域蹿红 , 一时间 , Docker + CoreOS成为业内容器部署的黄金搭档。同时 , CoreOS也为Docker的推广与社区建设做出了巨大的贡献。然而 , 日渐壮大的Docker似乎有着更大的"野心"。不甘于只做"一种简单的基础单元"的Docker, 自行开发了一系列相关的容器组件 , 同时收购了一些容器化技术的公司 , 开始打造属于自己的容器生态平台。显然 , 这对于CoreOS来说形成了直接的竞争关系。2014 年末 , CoreOS推出了自己的容器引擎Rocket(简称 rkt) , 试图与 Docker分庭抗礼。rkt和 Docker类似 , 都能帮助开发者打包应用和依赖包到可移植容器中 , 简化搭环境等部署工作。rkt 和Docker不同的地方在于 , rkt 没有Docker那些为企业用户提供的"友好功能" , 比如云服务加速工具、集群系统等。反过来说 , rkt想做的 , 是一个更纯粹的业界标准。
这里面最关键的脉络是由于技术公司之间的商业竞争 , 在竞争合作之间寻找平衡从而导致了标准规范的诞生 , 而标准规范的诞生是整个云原生生态最重要的基石。
容器引擎(docker vs rocket)、容器编排(Docker swarm vs Kubernetes vs Apache Mesos)的相互竞争的结果就是大家坐下来谈接口标准。2015年6月 , Docker带头成立OCI ,旨在"制定并维护容器镜像格式和容器运行时的正式规范(OCI Specifications)" , 其核心产出是OCI Runtime Spec(容器运行时规范) 、OCI Image Spec(镜像格式规范) 、OCI Distribution Spec(镜像分发规范 ) 。所以OCI组织解决的是容器的构建、分发和运行问题。一个月之后 , Google带头成立了Cloud Native Computing Foundation(CNCF) , 旨在 " 构建云原生计算 —— 一种围绕着微服务、容器和应用动态调度的、以基础设施为中心的架构 , 并促进其广泛使用 " 。所以CNCF组织解决的是应用管理及容器编排问题。这两个围绕容器的基金会对云原生生态的发展发挥了非常重要的作用 , 二者不是竞争而是相辅相成 , 共同制定了一系列行业事实标准。这些行业事实标准的确立 , 各行业注入了无限活力 , 基于接口的标准的具体实现不断涌现 , 呈现出一片百花齐放的景象。
其中 , 与容器相关的最为重要的几个规范包括 : CRI、CNI、CSI、OCI Distribution Spec、OCI Image Spec、OCI Runtime Spec和Shimv2。其中的CRI、OCI Image Spec、OCI Runtime和Shimv2规范和阿里云沙箱容器关系非常密切。
1.4 商用探索期
经过5年的技术发展期 , 容器技术基本成熟 , 云原生体系也具雏型。从2017年开始 , 各大云厂商开始试水容器服务及进步的云原生服务。从目前的商业形态看 , 容器相关的公共云服务大致可以划分为三种形态 :
通用容器编排服务。在容器编排系统三国杀结果出来以前 , 基于多方下注策略构建的容器编排服务系统。其中
AWS是自研的编排系统 ,Azure的ACS同时支持Docker Swarm、DC/OS和Kubernetes, 阿里云ACS则是支持Docker swarm和Kubernetes。Google和华为则是坚定支持Kubernetes而未推出支持其它容器编排系统的容器服务。随着Kubernetes一统容器编排江湖 , 这条路线的容器服务日渐式微 , Azure更是在今年初直接终止了ACS服务。Kubernetes容器编排服务。
Google是理所当然最早试水Kubernetes容器编排服务的大厂 , 也较早开展了K8S容器编排服务。随着2017年各大厂在CNCF这张谈判桌上达成了Kubernetes兼容性认证流程,Kubernetes编排服务市场迎来一轮大爆发, 到2018年各大云厂商的K8S容器编排服务就完整就位了。Serverless容器实例服务。从
2017年开始 , 行业开始试水Serverless容器实例服务 , 把用户从维护容器基础设施的繁重任务中解放出来从而聚焦业务本身。Google Cloud Run核心目标是支持Knative, 所以其使用形态上附加了不少约束条件。
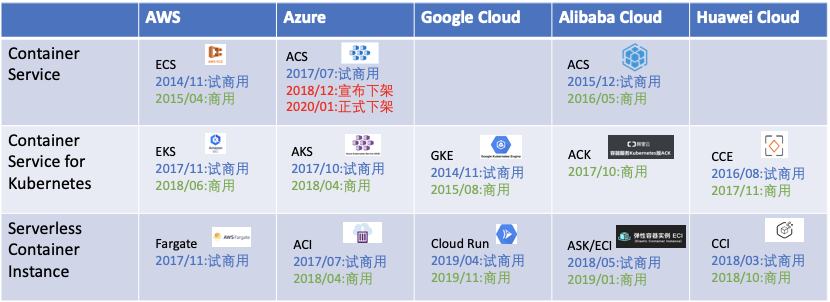
从上图可以看出 , 从2014年开始探索公共云容器服务 , 特别是经过2017-2018年这两年的抢跑期 , 容器服务的基本商业形态已经比较明晰了。发展态势可以概括为:
行业对容器化的接受程度已经很高 , 容器化普及率也是逐年提升。
容器编排系统已经一战定江山 , K8S成为事实上的容器编排之王。
Serverless容器实例服务受到市场的欢迎 , 客户群体日益扩大。长期看托管容器编排服务和
Serverless容器实例服务将长期共存 , 协同满足客户对服务成本和弹性能力的需求。
商用模式探索期间 , 核心目标是快速试错引导和确认客户需求 , 构建适用的产品形态。这个期间的产品技术架构的构建思路是利用现有成熟技术快速搭建商用形态 , 在试错过程中不断前行。
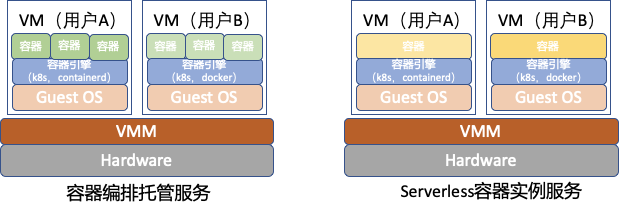
其中 , 容器编排托管服务节点级的典型架构是利用IaaS系统生成VM , 然后在VM里面部署kubelet、docker、containerd、runC等容器服务组件 , 也就是VM + 容器的技术架构。一个VM可以承载同一个用户的多个容器/Pod实例。而Serverless容器实例服务的节点级架构更直接 , 在一个VM里面只部署一个容器/Pod实例 , 从而实现Serverless。这种短平快的打法快速推进了商用模型的探索 , 起到了非常重要的历史作用 , 但是其在弹性能力、部署密度、资源成本方面的历史局限性还是很大的。
1.5 商用拓展期
到2019年 , 容器服务的商业形态以及市场趋势已经很明显了 , 行业整体进入了商业拓展阶段 , 对外宣传吸引更多的客户群体 , 对内苦练内功提升产品技术竞争力 , 行业正在经历从"有"到"优"的技术升级。行业正在经历这个技术升级的历史阶段 , 还谈不上结论 , 只能一起来聊聊趋势及预判。我们大体上可以把容器引擎技术划分为两代 :
Container on VM。也就是按照分层设计思路 , 通过
IaaS + PaaS的架构构建容器服务 , 这个是商用探索阶段的典型架构。基于各大云厂商成熟的IaaS基础设施生产虚拟机 , 在虚拟机里面部署容器服务组件。这种架构采用的是lift and shift策略 , 把容器服务的运维责任从用户转移到云厂商。采用和用户相同的软件组件 , 只是转移运维责任 , 有利于引导客户逐步上云、接受云原生思维。但是这个时期云厂商提供的服务是单纯的运维托管 , 相对用户自建容器服务并没有太明显的技术优势 , 甚至受多租户隔离的限制部分使用体验还不如用户自建容器服务。Container with hardware virtualization。如果沿用Container on VM的分层设计架构 , 云厂商很难构建独有的技术优势。对于Serverless容器实例服务 , 服务交付平面已经从IaaS的硬件接口上移到OS Syscall , 所以不要遵循VM + 容器的分层设计思路。我们需要从需求本源出发 , 容器服务需要高性能、强隔离、够安全和低成本的容器引擎。当前行业研发热点之一就是如何构建这样一个容器引擎 , 具体技术思路请留意后续系列文章。
2. 容器引擎
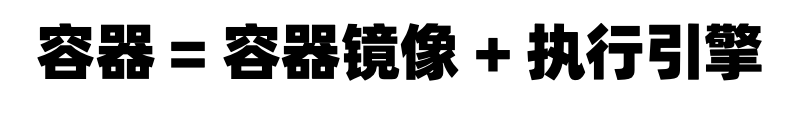
容器技术恒等式:
2.1 从集装箱革命说起
容器技术需要解决的核心问题之一运行时的环境隔离。
有一本非常有名的书 , 叫《集装箱改变世界》 , 说的是看起来平淡无奇的铁箱子 , 如何从二十世纪起永久性的改变了这个世界 , 并促进了全球化和全球分工。集装箱的出现和发展是实体货物包装、运输、交付方式的一次革命。
《经济学家》杂志曾经评价说 " 没有集装箱 , 不可能有全球化 " 。集装箱为什么具有革命性?经济全球化的基础就是现代运输体系,而一个高度自动化、低成本和低复杂性的货物运输系统的核心就是集装箱。集装箱最大的成功在于其产品的标准化及由此建立的一整套运输体系。能够让一个载重几十吨的庞然大物实现标准化 , 并且以此为基础逐步实现全球范围内的船舶、港口、航线、公路、中转站、桥梁、隧道、多试联运相配套的物流系统 , 这的确堪称人类有史以来创造的伟大奇迹之一 , 而撬动这个系统的理念就是标准化和系统化。
改变世界的不仅仅是集装箱本身 , 还有一整套货物处理的新方法 , 包括港口、货船、起重机、卡车 , 还有发货人的自身操作方式等。容器技术对于IT领域的意义非常类似于集装箱 , 只是里面装载的不再是实体货物 , 而是虚拟世界的二进制代码和软件。
制作集装箱可以采用不同的材料与工艺流程 , 只需要符合相应的标准。同理 , 容器技术也有不同架构和实现 , 只要遵循相应的技术规范 , 就是合格的容器技术。
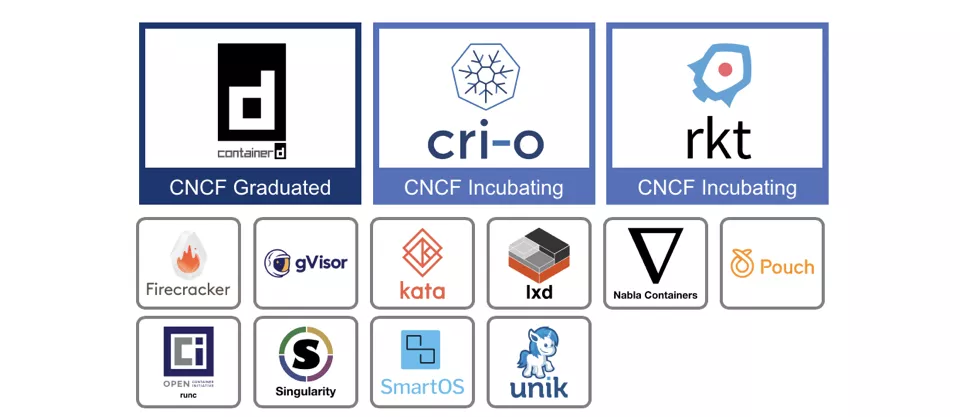
提到容器引擎(Container Engine)、容器运行时(Container Runtime)这些名称 , 总是有点容易让人犯晕。为了让事情简化一些 , 我们关注在云原生、K8S场景下的定义吧。从CNCF Cloud Native Interactive Landscape可以发现 , 容器引擎领域是一个很活跃的技术领域 , 该领域的大致发展史如下图。
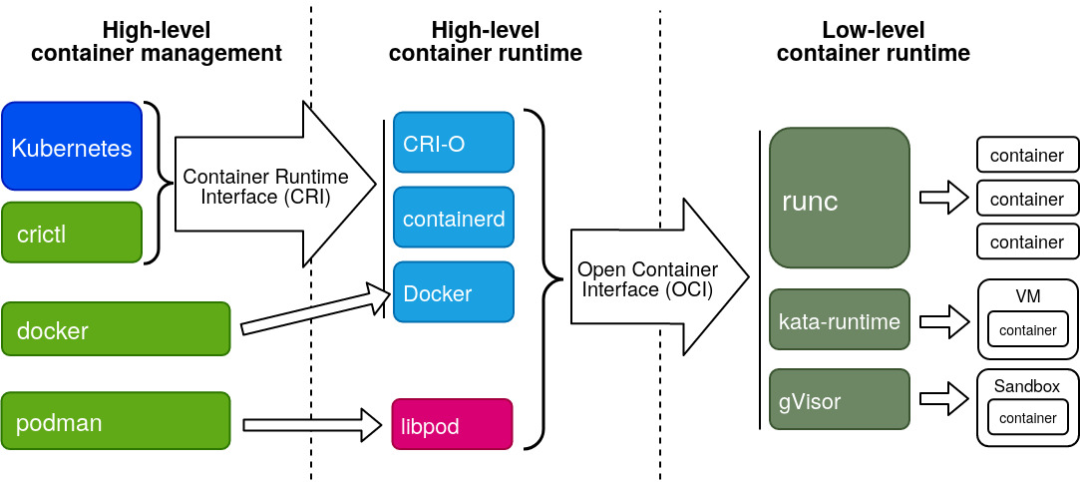
相对较为正式的术语定义如下图 , 可以把容器管理系统分为三层 :
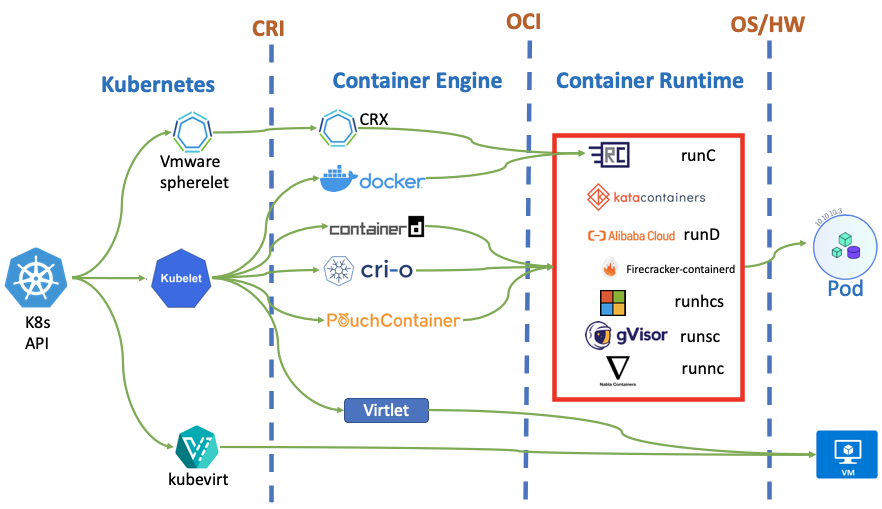
High-level Container Management: 容器管控的UI层。直接实现容器的管控和使用界面 , 也是用户最熟悉的子系统。High-level Container Runtime: 容器状态及资源供给。包括镜像管理、网络接入、容器状态、调用Low Level Runtime执行容器等功能。习惯上这层称之为容器引擎(Container Engine)。Low-level Container Runtime: 容器执行层。负责具体构建容器运行环境并执行容器进程。习惯上这层直接简称为容器运行时(Container Runtime)。
High-level Container Management和Container Engine之间的接口规范是CRI , Container Engine和Container Runtime之间的接口规范是OCI。
2.2 容器引擎
容器引擎的核心是准备运行容器所需要的资源以及管理容器生命周期。在K8S生态圈中 , 容器编排系统通过CRI接口来调用容器引擎。支持CRI接口的容器引擎主要有docker、rkt、pouch、containerd和cri-o等 , 其中活跃度比较高的是containerd和CRI-O。
2.2.1 containerd
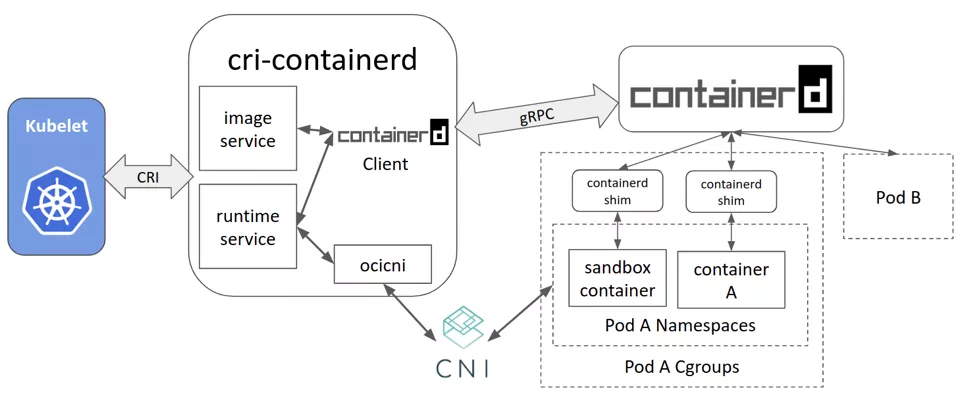
Containerd是从dockerd中抽离出来的容器管理的核心功能 , 是在社区影响下dockerd模块化的结果 , 也是现在最热门的容器引擎。由于containerd是从dockerd演化出来的 , 使用接口是针对容器管理而设计 , 内置管理对象是Image和Container。K8S CRI的管控对象是Image/Pod/Container , 为了让containerd支持Pod对象以及实现CRI接口 , 引入了CRI-containerd组件来粘合Kubelet和containerd两个子系统。现在cri-containerd组件已经作为一个功能模块内置到containerd。Containerd依赖后端container runtime来具体管理容器 , 最常见的container runtime是runC。
2.2.2 CRI-O
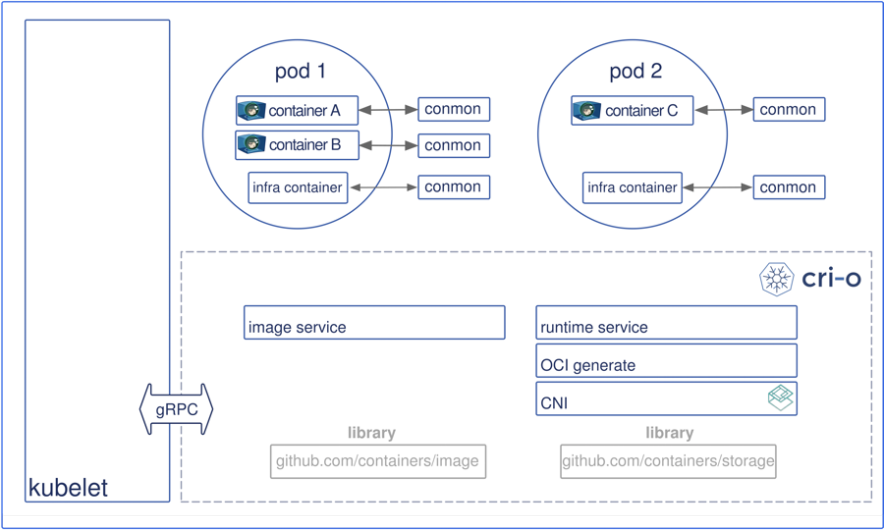
而CRI-O则是专门支持K8S CRI接口而设计实现的容器引擎 , 它抛弃了对docker的支持而专注于支持K8S CRI , 所以架构相对containerd要简洁不少。但是 , 虽然架构简洁优雅 , 但是从实际使用体验看CRI-O在成熟度、可扩展性方面相对cantainerd还是有一定差距。今年CRI-O也增加了对shimv2接口的支持 , 从而可以支持runC之外其它容器运行时 , 但是实际测试发现功能还不成熟。
进一步看CRI-O的架构 , 一个CRI实现需要实现的核心功能包括 : 镜像管理 ( Image service ) 、运行管理(runtime service , 管理Pod、container生命周期)、容器网络(CNI)和对接OCI兼容的容器运行时。这儿有一个非常重要的细节 , 虽然cri-containerd和CRI-O都是同时实现CRI的image service和runtime service , 但是CRI规范其实允许用不同的组件来分别实现image service和runtime service。
2.3 容器运行时
runC是目前使用最广泛的容器运行时 , 但是runC也不是完美的。业界对runC的担心主要集中在runC的隔离能力 , 众所周知runC容器共享一个host内核 , 利用cgroup和namespace机制来构建相互隔离的容器执行环境。Docker、LXC、RKT和runC这类原生容器都是基于共享主机操作系统的 , 这些技术的优点是资源利用率高、弹性能力强 , 缺点则是受攻击面大和攻击后果严重。特别是在多租户的云环境中 , 不同客户的容器会被编排部署到同一个服务器系统 , 这种威胁就变得尤其明显了。
其实 , 容器引擎技术领域也存在类似CAP理论的三边关系 : 资源效率、安全隔离和标准通用。目前所有的容器运行时技术最多都只能满足资源效率、安全隔离和标准通用中的两项 , 还没有一个技术能做到同时满足三项。比如 : runC在资源效率和标准通用方面最强 , 但是在安全隔离方面却最弱。Kata containers/firecracker-containerd/runD在安全隔离和标准通用上有优势 , 但是在资源效率方面却有不足。
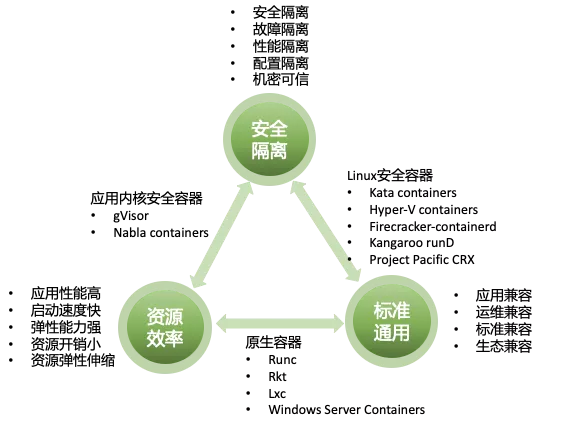
基于共享内核的OS虚拟化技术总是让人不放心, "安全容器"便应运而生了。安全容器的核心思路是摒弃共享内核 , 为每个Pod/Container实例配置一个专用的容器OS , 再辅以硬件虚拟化、应用内核等技术以获得更好的隔离性。我们可以按是否使用共享内核、是否使用硬件虚拟化、是否使用Linux Kernel作为容器内核几个纬度来对容器运行时进行分类。从下面的分类表可以看出 , 基于硬件虚拟化+Linux分离内核是目前行业的主流技术路线。
2.3.1 runC
2.3.1.1 runC 是什么
Docker、Google、CoreOS和其他供应商创建了开放容器计划 (OCI) , 目前主要有两个标准文档 : 容器运行时标准 ( runtime spec ) 和 容器镜像标准 ( image spec ) 。
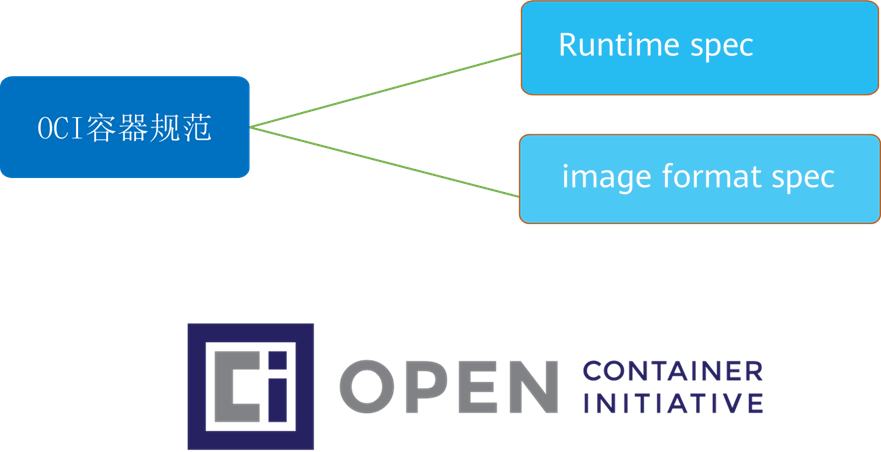
RunC是从 Docker 的 libcontainer 中迁移而来的 , 实现了容器启停、资源隔离等功能。Docker将RunC捐赠给OCI作为OCI容器运行时标准的参考实现。Docker默认提供了docker-runc实现。事实上 , 通过containerd的封装 , 可以在Docker Daemon启动的时候指定RunC的实现。最初 , 人们对Docker对OCI的贡献感到困惑。他们贡献的是一种"运行"容器的标准方式 , 仅此而已。它们不包括镜像格式或注册表推/拉格式。当你运行一个Docker容器时 , 这些是 Docker 实际经历的步骤 :
下载镜像
将镜像文件解开为
bundle文件 , 将一个文件系统拆分成多层从
bundle文件运行容器
Docker标准化的仅仅是第三步。在此之前 , 每个人都认为容器运行时支持Docker支持的所有功能。最终 , Docker方面澄清 : 原始OCI规范指出 , 只有“运行容器”的部分组成了runtime。这种“概念失联”一直持续到今天 , 并使“容器运行时”成为一个令人困惑的话题。希望我能证明双方都不是完全错误的 , 并且在本文中将广泛使用该术语。RunC就可以按照这个OCI文档来创建一个符合规范的容器 , 既然是标准肯定就有其他OCI实现 , 比如Kata、gVisor这些容器运行时都是符合OCI标准的。
runc是一个轻量级、可移植的容器运行时 , 它负责根据OCI容器规范创建、运行和管理容器。它提供了一套命令行工具 , 供用户和上层容器管理工具 ( 如Docker、Kubernetes等 ) 调用。作为容器生态中的基础组件 , runc提供了对容器生命周期的底层管理 , 包括创建、启动、停止和删除等。
2.3.1.2 runc 架构与组件
runc的架构与组件 , 包括基本架构、命令行接口、libcontainer库、命名空间与cgroups、rootfs与镜像层以及配置文件。
基本架构
runc的基本架构分为两个主要部分 : 命令行接口(CLI) 和libcontainer库。命令行接口负责处理用户输入的命令和参数 , 而libcontainer库则实现了底层的容器管理功能。这种设计使得runc可以作为一个独立的命令行工具使用 , 也可以被其他项目作为库引用。命令行接口 (
CLI)runc提供了一套简单易用的命令行接口 , 用于与用户或其他容器管理工具进行交互。CLI包括一系列命令 , 如create、start、exec、kill、delete等 , 用于管理容器的生命周期。用户可以通过这些命令来创建、启动、运行、停止或删除容器。libcontainer库libcontainer是runc的核心组件 , 负责实现底层的容器管理功能。libcontainer提供了一套高度可配置的API, 支持对容器的命名空间、cgroups、网络、存储等各个方面进行灵活的管理。通过这些API,runc能够根据用户指定的配置文件为每个容器创建独立的运行环境。命名空间与
cgroupsrunc使用Linux命名空间和cgroups技术来实现容器的隔离和资源限制。命名空间用于在进程间提供独立的视图 , 从而实现容器之间的隔离 , 如PID命名空间、网络命名空间、用户命名空间等。cgroups则用于限制和监控容器使用的系统资源 , 如CPU、内存、磁盘 I/O 等。rootfs与镜像层rootfs( 根文件系统 ) 是容器运行时的基本文件系统结构 , 包含了容器运行所需的所有文件和目录。runc使用OCI镜像规范定义的镜像层来构建容器的rootfs。镜像层是一种分层的文件系统结构 , 使得容器镜像更加轻量化、易于分发和复用。配置文件
runc使用一个名为config.json的配置文件来描述容器的运行时配置。这个配置文件遵循OCI运行时规范 , 并包含了关于容器的所有详细信息 , 如容器的rootfs、环境变量、挂载点、命名空间、cgroups参数等。网络配置
runc本身不提供容器网络管理功能 , 但它允许通过插件或外部工具来实现容器网络配置。这种设计提供了极大的灵活性 , 使得用户可以根据需求选择不同的网络方案 , 如桥接模式、Overlay网络、点对点连接等。同时 , 这也使得runc能够更好地与现有的容器编排工具(如Kubernetes、Docker Swarm等 ) 以及网络插件 ( 如CNI、CNM等 ) 集成。存储驱动
虽然
runc不直接处理容器镜像的存储和分发 , 但它支持通过各种存储驱动来挂载容器的rootfs。这些存储驱动可以是基于文件系统的 ( 如AUFS、OverlayFS等 ) 或基于块设备的 ( 如DeviceMapper、Btrfs等 ) 。通过支持多种存储驱动 ,runc能够充分利用不同底层存储技术的优势 , 以满足不同用户的需求。集成与扩展性
由于
runc遵循OCI规范 , 并提供了丰富的API, 它具有很好的集成性和扩展性。这使得runc可以与各种容器管理工具 ( 如Docker、Kubernetes、Podman等 ) 无缝集成 , 同时也方便用户开发自定义的容器管理解决方案。此外 ,runc支持通过插件、钩子 (hooks) 等机制来扩展其功能 , 使得用户可以根据需求为runc添加自定义的功能。
2.3.1.3 runC工作原理
容器创建
容器创建过程是
runc根据config.json配置文件为容器设置运行时环境的过程。这一过程包括以下几个步骤 :读取
config.json文件 :runc首先读取用户提供的config.json文件 , 获取容器的配置信息。设置命名空间与
cgroups: 根据配置文件中的信息 ,runc为容器设置相应的Linux命名空间和cgroups, 实现容器的隔离和资源限制。构建
rootfs:runc根据配置文件中的rootfs设置 , 使用OCI镜像规范定义的镜像层构建容器的根文件系统。挂载文件系统 : 根据配置文件中的挂载点信息 ,
runc将指定的宿主机目录或设备挂载到容器内部。
容器启动
容器启动过程是
runc将容器进程与其运行时环境关联的过程。这一过程包括以下几个步骤 :创建容器进程 :
runc使用配置文件中的信息 ( 如Entrypoint和Cmd) 创建容器主进程。关联命名空间与
cgroups:runc将容器进程与之前创建的命名空间和cgroups关联 , 确保进程在指定的隔离和资源限制环境下运行。启动容器进程 :
runc启动容器主进程 , 使其在容器内运行。
执行进程
执行进程是在已经创建并启动的容器中运行一个新进程的过程。这一过程包括以下几个步骤 :
创建新进程 :
runc根据用户提供的命令创建一个新进程。关联命名空间与
cgroups:runc将新进程与容器已有的命名空间和cgroups关联 , 确保进程在相同的隔离和资源限制环境下运行。启动新进程 :
runc启动新进程 , 使其在容器内运行。
容器停止
容器停止过程是
runc终止容器内所有进程的过程。这一过程包括以下两个步骤 :发送信号 :
runc向容器主进程发送指定的信号 ( 如SIGTERM或SIGKILL) , 通知进程准备终止。终止进程 : 容器主进程在收到信号后 , 会依次终止其子进程 , 然后自身退出。
容器删除
容器删除过程是
runc清理容器运行时环境并释放相关资源的过程。这一过程包括以下几个步骤 :卸载文件系统 :
runc首先卸载容器内挂载的文件系统 , 包括rootfs和其他挂载点。清理命名空间与
cgroups:runc接下来清理与容器关联的命名空间和cgroups, 以释放系统资源。移除容器状态文件 : 最后 ,
runc删除容器的状态文件 , 包括容器的PID、状态信息等。
2.3.1.4 runC 实际应用
使用
runc运行一个简单的容器我们将通过以下几个步骤演示这个过程 :
安装
runc首先 , 需要安装
runc。在大多数Linux发行版中 , 可以使用包管理器来安装runc。例如 , 在基于Debian的系统中 , 可以使用以下命令安装runc:sudo apt-get update sudo apt-get install runc准备容器文件系统(
rootfs)接下来 , 需要准备容器的文件系统 , 即
rootfs。可以从现有的容器镜像中提取rootfs, 或者手动创建一个简单的rootfs。在这里 , 我们将演示如何从Docker镜像中提取rootfs:mkdir mycontainer cd mycontainer mkdir rootfs docker export $(docker create busybox) | tar -C rootfs -xvf -这将会创建一个名为
mycontainer的目录 , 其中包含从busybox镜像导出的rootfs。创建容器配置文件
接下来 , 我们需要创建一个容器配置文件。可以使用
runc spec命令生成一个默认的配置文件config.json:cd mycontainer runc spec可以根据需要修改
config.json文件 , 例如更改容器的主机名、启动命令等。在这个例子中 , 我们将使用默认的配置。运行容器
现在 , 我们准备好运行容器了。在
mycontainer目录中执行以下命令来启动容器 :runc run mycontainerid这将启动一个名为
mycontainerid的容器。容器会以默认的配置运行 , 执行/bin/sh命令。此时 , 我们进入了容器的shell。停止和删除容器
要停止并删除容器 , 首先需要退出容器的
shell, 然后使用以下命令停止和删除容器 :runc kill mycontainerid runc delete mycontainerid
至此 , 我们已经完成了使用runc运行一个简单容器的过程。在实际应用中 , 可以根据需要对容器配置和文件系统进行更复杂的定制。
 create the bundle
$ mkdir -p /mycontainer/rootfs

# [ab]use Docker to copy a root fs into the bundle
$ docker export $(docker create busybox) | tar -C /mycontainer/rootfs -xvf -

# create the specification, by default sh will be the entrypoint of the container
$ cd /mycontainer
$ runc spec

# launch the container
$ sudo -i
$ cd /mycontainer
$ runc run mycontainerid

# list containers
$ runc list

# stop the container
$ runc kill mycontainerid

# cleanup
$ runc delete mycontainerid
2.3.2 Kata Containers
出于对传统容器安全性的担忧 , Intel在 2015 年启动了它们以虚拟机为基础的容器技术 : Clear Container。Clear Container 依赖Intel VT 的硬件虚拟化技术以及高度定制的QEMU-KVM(qemu-lite)来提供高性能的基于虚拟机的容器。在 2017 年 , Clear container 项目加入了 Hyper RunV ,这是一个基于hypervisor的OCI运行时 , 从而启动了Kata容器项目 ( https://clearlinux.org/news-blogs/kata-containers-next-evolution-clear-containers?spm=ata.13261165.0.0.217a57c62rMc0r ) 。
Kata containers的核心思路是 :
操作系统本身的容器机制没办法解决安全性问题 , 需要一个隔离层 ;
虚拟机是一个现成的隔离层 , 云服务已经让全世界相信 , 对户来说 , "
secure of VM" 是可以满足需求的 ;虚机里面只要有个内核 , 就可以支持
OCI规范的语义 , 在内核上跑个Linux应用这并不太难实现 ;虚机可能不够快 , 阻碍了它在容器环境的应用 , 那么可不可以拥有 "
speed of container" 呢?
所以 , Kata containers核心之一是把VM变得轻快稳 , 使之能满足容器高密弹性的需求。同时 , 作为一个容器运行时 , 必须深度融入生态 , 支持相关规范。
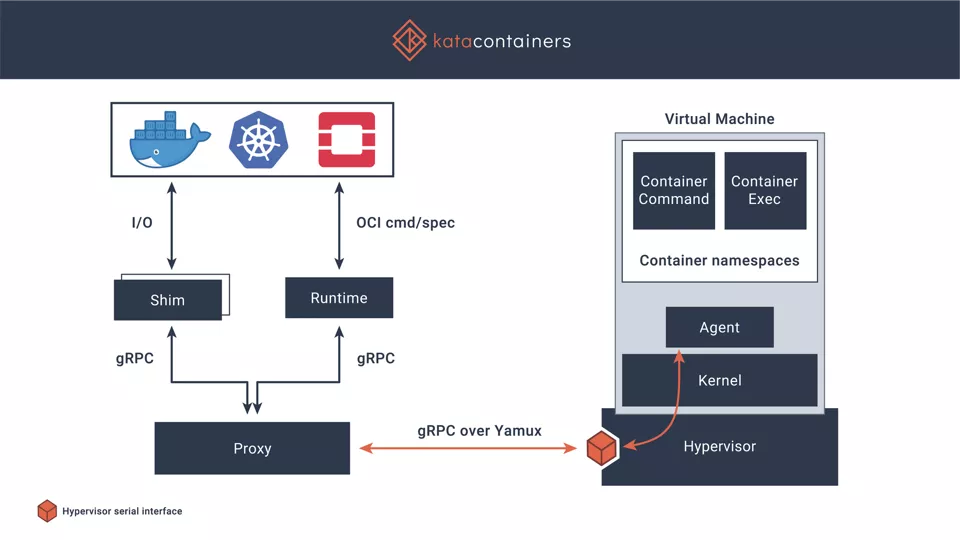
Kata containers 最大的特点是它专注于实现一个开放的符合OCI标准的安全容器runtime实现 , 对于对接什么样的虚拟化方案 , 它抽象了一套hypervisor接口 , 如今已经对接了多种虚拟化实现 , 比如qemu、nemu、firecracker、cloud-hypervisor等。
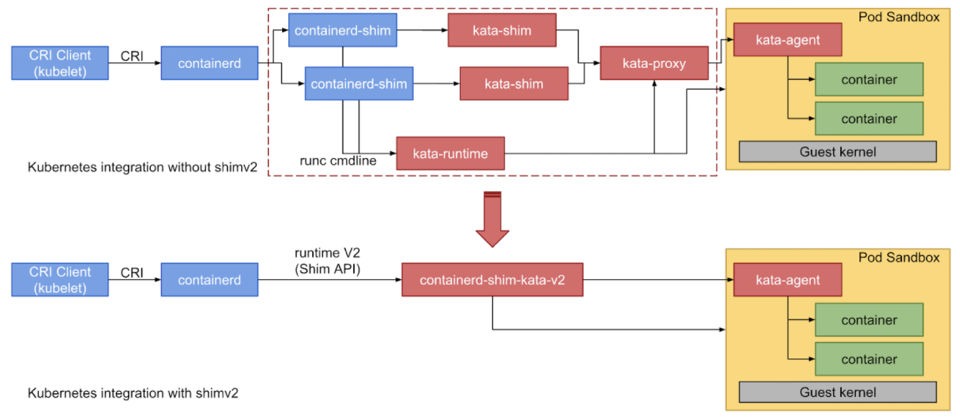
2019年 , Kata containers有个非常重要的技术进步 , 和containerd社区共同制定了shimv2接口规范 , 并率先在Kata containers支持了该规范。通过containerd-shim-v2和vsock技术 , kata精简了大量的组件 , 配合轻量级hypervisor和精简内核 , kata可以大幅降低内存开销和容器启动时间。更关键的是 , 降低系统部署复杂度还大幅提高了稳定性 , 特别是在系统重载情况下的稳定性。从实际使用体感看 , 阿里云沙箱容器1.0从shimv1升级到shimv2后 , 稳定性得到大幅提升 , 缺陷数量大幅下降。一个技术 , 同时服务于" 轻 " 、 " 快 " 、 " 稳 "三个目标 , 当之无愧重要的技术进步!
第二个热点则是Kata containers 2.0架构。从2019年8月开始 , 阿里云、蚂蚁和intel三方共同推动Kata containers 2.0架构定义及设计 , 核心是进一步提升多租隔离能力及可观测性。现在蚂蚁可信原生团队、阿里云容器团队和阿里云操作系统团队三方正在合力推进Kata containers 2.0架构。
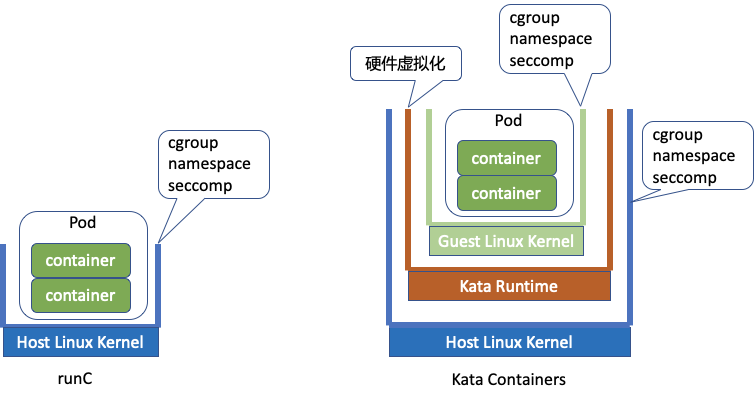
Kata Containers和runC不是替代与被替代 , 而是青出于蓝而胜于蓝。Kata Containers把runC一层基于OS虚拟化的隔离机制扩展为三层隔离 : Guest OS 虚拟化 ( 等效于runC ) , 硬件虚拟化和Host OS虚拟化。所以Kata Containers通过引入更多的间接层来提升系统的隔离能力 , 但是需要付出 " 更多间接层 " 的代价。
2.3.3 Firecracker-containerd
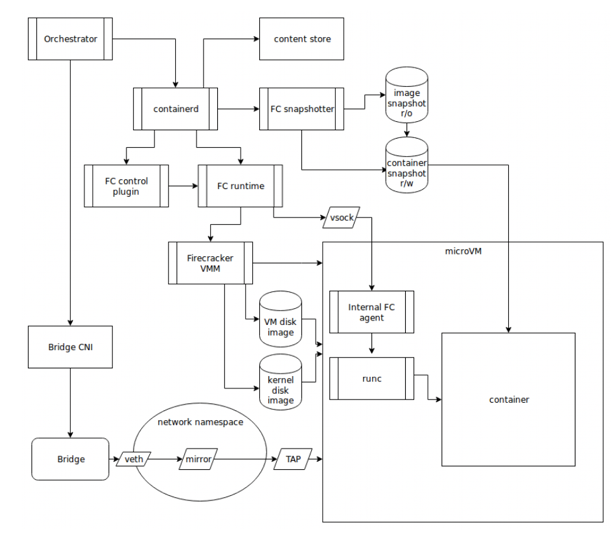
Firecracker-containerd是firecracker和containerd的合体。Firecracker是AWS基于Google crosvm开发的、配合KVM使用的一个轻量级安全VMM , 用以支持和实现MicroVM。Firecracker MicroVM 同时具备传统虚拟机的安全性和工作负载隔离能力以及容器的速度和资源利用率。Firecracker具有如下一些特色 :
抛弃
QEMU使用的C语言 , 选择内存安全的Rust作为开发语言。基于
crosvm使用极简设备模型 , 模拟尽可能少的必要设备 , 减小暴露的攻击面。高性能和低开销 : 得益于极简的设备模型 ,
Firecracker取消了SeaBIOS( 开源的X86 BIOS) , 移除了PCI总线 , 取消了VGA显示等等硬件模拟 , 严格的说它甚至不是一台完整的虚拟计算机。而Firecracker运行的GuestOS使用的也是AWS定制过的精简Linux内核 , 同样裁剪掉了对应的设备驱动程序、子系统等等。因此叫它MicroVM,其启动步骤和加载项要远远少于传统虚拟机。因此Firecracker目前已经能提供小于125ms的MircroVM启动速度 , 每秒150台的启动能力 , 小于5MiB 的内存开销 , 并发运行4000台的极限承载容量 ( AWS i3.metal EC2 作为宿主机 ) , 以及热升级能力等。这些都是传统虚拟机所遥不可及 , 但现代化弹性工作负载又有强烈需求的性能指标。
但是 , Firecracker毕竟只是一个VMM , 还必须配合上containerd才能支持容器生态。所以 , AWS又开源了firecracker-containerd项目 , 用于对接K8S生态。本质上Firecracker-containerd是另外一个私有化、定制化的Kata containers , 整体架构和Kata containers类似 , 只是放弃了一些兼容性换取更简化的实现。
2.3.4 gVisor
Google gVisor 是GCP App Engine、Cloud Functions Cloud Run和 CloudML 中使用的沙箱技术 , 正式商用名称是Google Sandbox。Google 意识到在公有云基础设施中运行不受信容器的风险 , 以及虚拟机沙箱的低效 , 因此开发了用户空间的内核作为沙箱来运行不受信应用。gVisor是沿着libdune的系统调用拦截思路发展而来的用户态内核或进程虚拟化技术。gVisor 通过拦截所有从应用到主机内核的系统调用 , 并使用用户空间中 gVisor 的内核实现来处理这些调用。
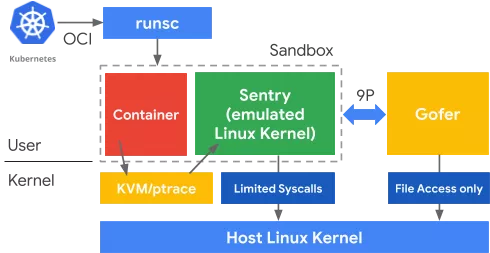
本质上来说 , gVisor 是VMM和客户内核的组合 , 或者说gVisor是syscall虚拟化。基于lock-in-pop理论 , 假设Linux内核被高频访问的syscall是安全的 , 这部分可以开放给容器进程直接使用而不会导致严重的安全风险 ; 对于冷僻Linux syscall则需单独处理 , 要不就是sentry模拟实现 , 要不就是在一个专用受限环境中执行(gofer)。sentry实现了多数的 Linux 系统调用 , 尤其是内核功能 , 例如信号分发、内存管理、网络栈以及线程模型。gVisor 和Nabla有很相似的策略 : 保护主机。它们都使用了不到 10%的系统调用来和主机内核通信。gVisor 创建通用内核 , 而Nabla依赖的是Unikernel , 它们都是在用户空间运行特定的客户内核来支持沙箱应用的运行。
gVisor 还在婴儿期 , 也一样有一些限制。gVisor 要拦截和处理沙箱应用中的系统调用, 总要有一定开销 , 因此不适合系统调用繁重的应用。gVisor 没有直接的硬件访问(透传) ,所以如果应用需要硬件(例如 GPU)访问 , 就无法在gVisor上运行。最后 , gVisor 没有实现所有的系统调用, 因此使用了未实现系统调用的应用是无法在gVisor上运行的。
出于对使用C语言开发系统软件导致的安全风险和软件缺陷的担忧 , Google开创了使用安全语言开发系统软件的先河。2013年开发的gVisor选择了Golang , 2017年开源的crosvm则使用Rust。从目前状态看 ,Rust更适合开发底层系统软件 , Golang则更适合开发上层便应用管理的系统软件。 也许Rust早成熟几年gVisor就会有不同的选择啦!
2.3.5 Nabla Containers
Nabla Containers的核心思想是用libOS作为容器运行时的隔离机制。通过增加一个隔离层 , libOS kernel , 把容器应用和host OS给隔离开来。nabla是继承于unikernel的隔离方式 , 应用采用rumprun打包成一个unikernel镜像 , 直接运行在一个专为运行unikernel定制虚拟机(ukvm)中。应用直接打包首先可以降低很多内核态和用户态转换的开销 , 另外通过ukvm暴露非常有限的主机上的syscall(只剩7个) , 可以大大缩小主机的攻击面。它是这些安全容器实现中 ,最安全的。
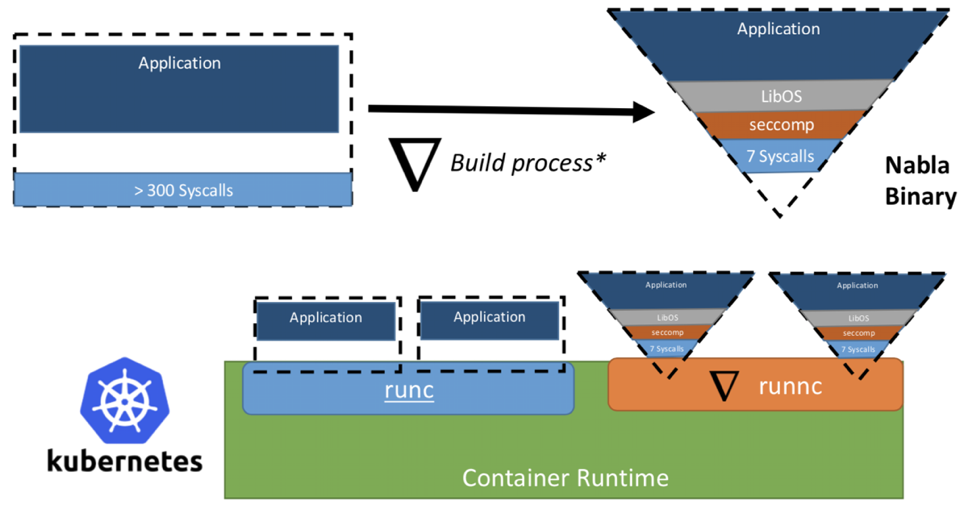
这条技术路径从学术理论角度看是很好的路线 , 但是libOS一二十年发展不起来是有原因的。它要求应用打包成unikernel镜像 , 因此和当前docker的镜像标准是不兼容的。另外 , unikernel应用在诸如支持创建子进程等一些常规操作上都有很难解决的问题。核心原因是应用侵入性没法解决 , 需要修改应用来适配容器运行时 , 和K8S部分语义也是冲突。
最近Nabla containers项目发生了一个有意思的转变 , 从采用rumpkernel切换到user model linux。估计背后的原因是rumpkernel已经有6年没有更新了 , 背后的NetBSD活跃度也不高 , Linux compatibility layer的质量有限。但是 , 即使切换到UML解决部分syscall ABI兼容兼容问题 , 这条路前途也很渺茫。
2.3.6 Windows 容器
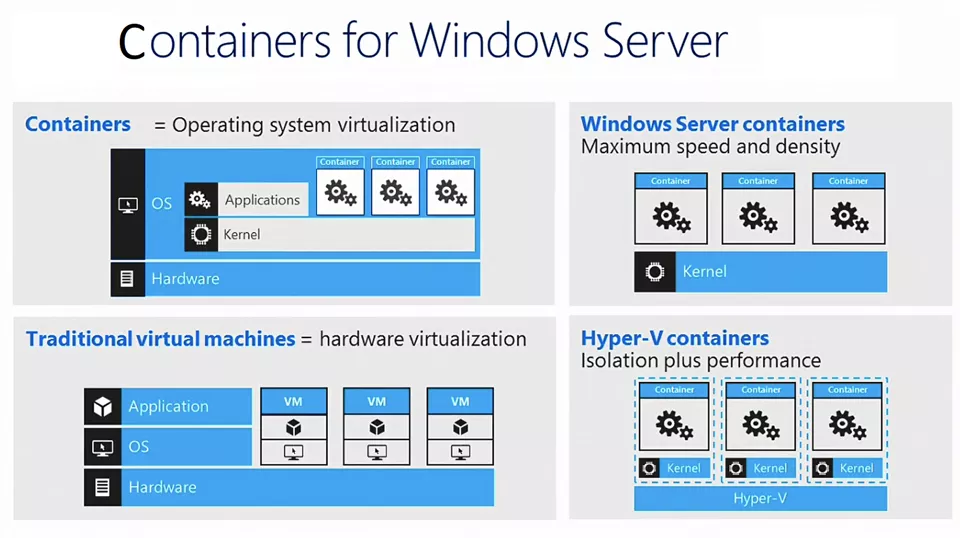
受Windows操作系统的限制导致Windows容器天然有臃肿及生态的问题 , 所以Windows容器一直相对比较小众。但是从软件架构上看, Windows容器架构反而是一个非常优秀的案例 , 值得探讨一番。Windows 2016开始支持Windows Containers , 具有两种形态: Windows Server Containers和Hyper-v Containers ,其具体架构如下图。
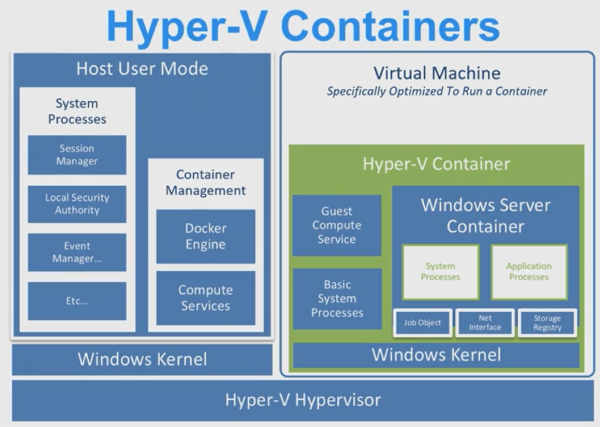
直观的理解 , Windows Server Container相当于runC ,而Hypver-V Containers则相当于Kata Containers。也就是从诞生的一天开始 , Windows就提供了两种不同的Container Runtime , 以提供不同的特性来满足不同场景的需求。
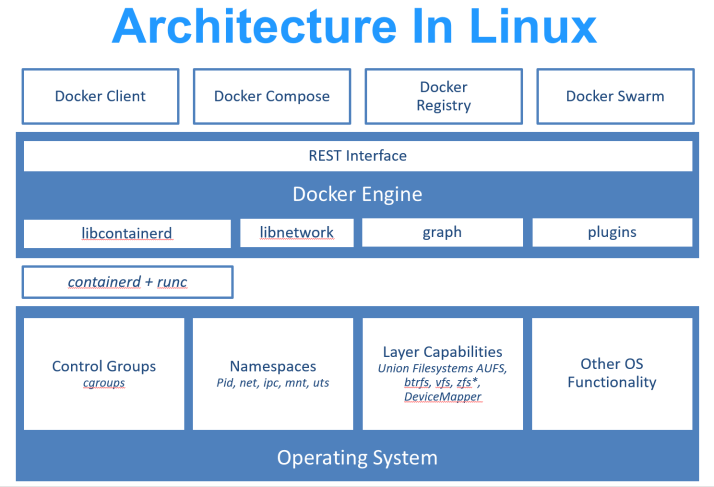
具体到Windows Server Containers的架构细节 , 基本上和Linux容器技术类似 ,没有太多的惊喜。内核支持容器技术的关键子系统名称都是一致的 : Control Groups、Namespaces、Layer Capabilities。比较特殊的是Windows内核子系统Host Compute Service实现了containerd + runc的能力 , 也就是说Windows内核内置支持容器对象。
为了更好地与K8S生态融合 , Windows 2019在docker之外增加了对Containerd/CRI的支持 , 以及相关组件runhcs(run Host Computer Service , 对应Linux runC)。Windows 容器技术整体架构升级为下图的架构。至此 , Windows容器通过支持OCI规范基本无缝融入了K8S生态。
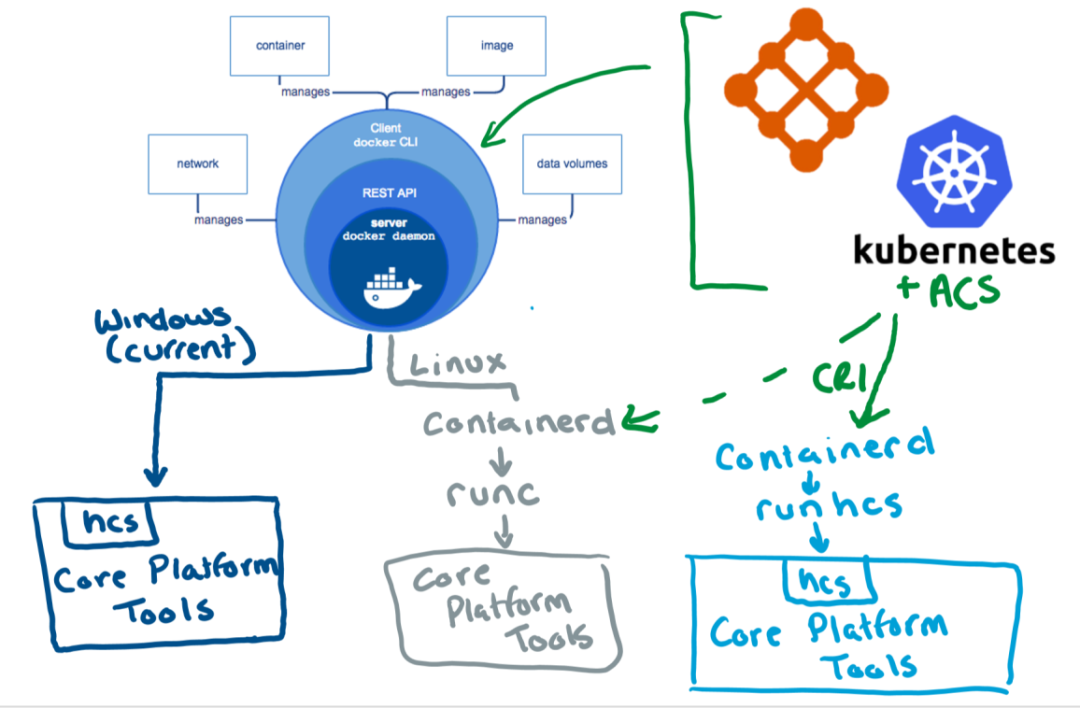
Windows容器技术架构中有两个很有意思的组件。一是Host Compute Service(hcs) , 这个是专门为容器服务的service。相对Linux直接暴露支撑容器的底层技术(cgroup , namespace , seccomp等) , Windows选择了对底层基础技术进行一层封装由内核直接容器暴露容器兑现而不暴露底层技术。阿里云操作系统团队内部也进行过类似的技术探讨 , Linux kernel是否应该内置支持container object 目前还没结论。二是轻量化的Hyper-V虚拟机 , Microsoft基于轻量化的Hyper-V虚拟机长出了Hyper-V container , Windows Subsystem for Linux 2和Windows Sandbox三个技术。最近Redhat基于rust-vmm搞的runK类似Windows Sandbox的思路 , 值得关注。
2.3.7 VMware Project Pacific
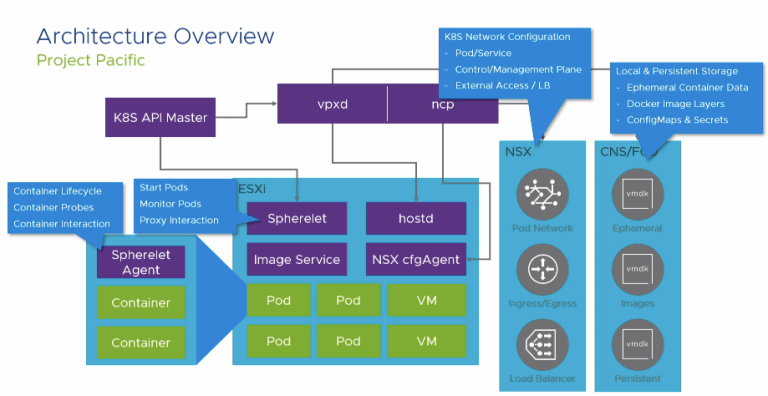
相对其它家的技术路线 ,VMware Project Pacific走了一条与众不同的路线来融入K8S生态。Project Pacific没有采用常规路线实现一个runP之类的容器运行时 , 而是选择了全链路技术改造。Project Pacific通过spherelet、CRX等组件完全重构kubelet、containerd、runc等组件 , 直接对接到K8S API server。从下图的架构可以看出 , Project Pacific核心是在节点上实现容器和虚拟机的混合部署 , 同时支持虚拟机管理系统vCenter和容器编排系统K8S。
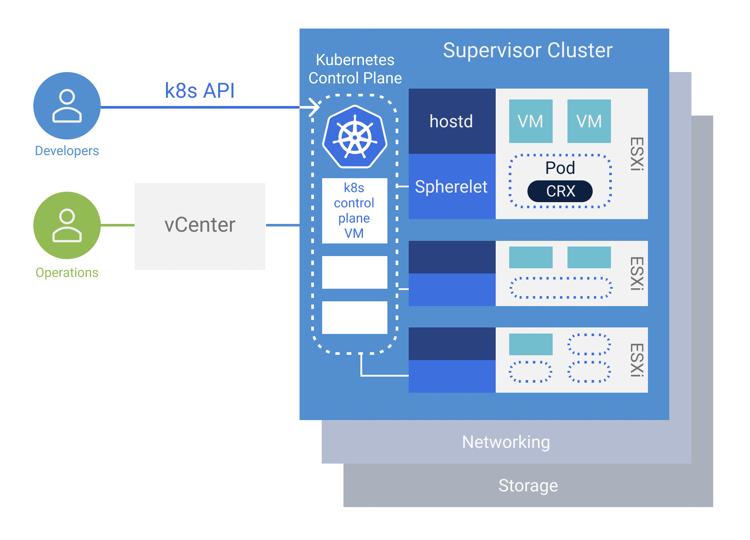
进一步展开Project Pacific节点级的架构细节。为了支持K8S容器生态 , ESXi节点上增加了Spherelet、Image Service、Spherelet Agent等组件。ESXi上同时部署了hostd(相当于pync + libvirt)和Spherelet(相当于Kubelet)两种管控系统以支持容器虚拟机混合部署 , 同时还为容器专门部署了Image Service用以管理容器镜像。
3. 运行环境隔离技术
容器其实本质上就是一个进程 , 只不过容器的进程是比较特殊的。
容器技术的核心功能 , 就是通过约束和修改进程的动态表现 , 创造出一个 " 边界 " , 通过 " 障眼法 " 让人觉得它是一个独立的系统。大多数容器都是使用 Cgroups 技术来约束进程 , 通过 Namespace 技术来修改进程的视图。
3.1 namespace
namespace是Linux系统的底层概念 ,在内核层实现 , 即有一些不同类型的命名空间被部署在核内 , 各个docker容器运行在同一个docker主进程并且共用同一个宿主机系统内核 , 各docker容器运行在宿主机的用户空间 , 每个容器都要有类似于虚拟机一样的相互隔离的运行空间 , 但是容器技术是在一个进程内实现运行指定服务的运行环境 , 并且还可以保护宿主机内核不受其他进程的干扰和影响 , 如文件系统空间、网络空间、进程空间等 , 目前主要通过以下技术实现容器运行空间的相互隔离 :
我们通过一个案例来讲解 , 这里我们使用 Docker 运行一个busybox的容器:
# docker run -it busybox /bin/sh
/ # ps
PID   USER     TIME  COMMAND
    1 root      0:00 /bin/sh
    6 root      0:00 ps
/ #
我们可以看到在容器中 , 只有 2 个进程在运行, 一个 PID 为 1 的进程 , 它就是我们的 sh 程序。
我们再重新打开一个窗口执行执行 ps aux | grep docker :
# ps aux | grep docker
root      3490  0.0  5.7 843208 58032 ?        Ssl  Aug14   0:22 /usr/bin/dockerd -H fd:// --containerd=/run/containerd/containerd.sock
root     14669  0.0  6.3 709900 63612 pts/0    Sl+  14:36   0:00 docker run -it busybox /bin/sh
可以看到进程 14669 正在执行docker run -it busybox /bin/sh , 事实上这个14669才是这个 Docker 容器的真正 PID。
那它是如何做到在我们 exec 进入容器之后把进程 ID 改成1 的呢?事实上进程 ID=1 正是操作系统的第一号进程 , 它是所有进程的父进程。我们可以通过ps aux | grep systemd 查看会发现systemd 为 1 号进行 :
ps aux | grep systemd
root 1 0.0 0.7 225308 7828 ? Ss Jun20 3:12 /lib/systemd/systemd --system --deserialize 39现在Docker 把这个/bin/sh 的程序运行在容器中 , 就需要给这个ID=14669的进程做一些手脚 ,把它自己变成1号进程来骗过其他进程。这种机制就是对隔离应用的进程空间做了手脚 , 使得这些进程只能看到重新计算过的进程ID , 可是实际上它还是宿主机的14669 号进程。
这种技术被称为Namespace。
Namespace 其实是在创建新进程时候加了一个可选参数 , 它利用 Linux 的系统调用 clone() 为新创建的进程指定一个 CLONE_NEWPID 的参数 , 那么新创建的进程就会看到一个全新的进程空间 , 在这个进程空间里面它的PID就是 1。
Namespace除了可以模拟PID 之外 , 还提供了 mount、UTS、IPC、Network 和User 等 , 在不同的进程上下文做隔离操作。
而这些就是Linux容器的基本实现原理。
3.1.1 MNT Namespace
每个容器都要有独立的根文件系统有独立的用户空间 , 以实现在容器里面启动服务并且使用容器的运行环境 , 即一个宿主机是ubuntu的服务器 , 可以在里面启动一个centos运行环境的容器并且在容器里面启动一个Nginx服务 , 此Nginx运行时使用的运行环境就是centos系统目录的运行环境 , 但是在容器里面是不能访问宿主机的资源 , 宿主机是使用了chroot技术把容器锁定到一个指定的运行目录里面。
例如 : /var/lib/containerd/io.containerd.runtime.v1.linux/moby/容器ID
#通过命令确定容器根目录位置
[root@centos7 ~]# docker inspect a8e1f1ee9cbb
...
        "GraphDriver": {
            "Data": {
                "LowerDir": "/var/lib/docker/overlay2/95c07e6d4f6e6eddd61d47d20ad72ada91cdfd4bddc6fb98bd2bb7420aa9d9ae-init/diff:/var/lib/docker/overlay2/8105b56fe16f020f97d68515794c378465365d61e8805bd556ff04370a835b8d/diff:/var/lib/docker/overlay2/f8f7e6cc5bec08ebf1902dda920dbf39d3d542bc0ca2ec08d45e3fd999575d30/diff:/var/lib/docker/overlay2/e3aaca266e2c8229ba909449b12a0d2e64ba15079a662640710be4dccdbf1e56/diff",
                "MergedDir": "/var/lib/docker/overlay2/95c07e6d4f6e6eddd61d47d20ad72ada91cdfd4bddc6fb98bd2bb7420aa9d9ae/merged",
                "UpperDir": "/var/lib/docker/overlay2/95c07e6d4f6e6eddd61d47d20ad72ada91cdfd4bddc6fb98bd2bb7420aa9d9ae/diff",
                "WorkDir": "/var/lib/docker/overlay2/95c07e6d4f6e6eddd61d47d20ad72ada91cdfd4bddc6fb98bd2bb7420aa9d9ae/work"
            },
            "Name": "overlay2"
        },
...

#查看容器根目录位置
[root@centos7 ~]# ls /var/lib/docker/overlay2/95c07e6d4f6e6eddd61d47d20ad72ada91cdfd4bddc6fb98bd2bb7420aa9d9ae/merged
bin  boot  dev  etc  home  lib  lib64  media  mnt  opt  proc  root  run  sbin  srv  sys  tmp  usr  var


#查看容器ID
[root@centos7 ~]# ls /var/lib/containerd/io.containerd.runtime.v2.task/moby/
4c083892d0326ca5ff58497f42df1424ff3c4795da9dbcf71930aa4ed3848e6b  a8e1f1ee9cbb6783d2d81dd7da1d33353d14284e404fb945ee9c288a224e29f0

#运行命令查看docker容器内部的目录信息
[root@centos7 ~]# docker ps
CONTAINER ID   IMAGE          COMMAND                  CREATED        STATUS      PORTS                               NAMES
a8e1f1ee9cbb   nginx:1.16.1   "nginx -g 'daemon of…"   3 months ago   Up 2 days   0.0.0.0:80->80/tcp, :::80->80/tcp   epic_hertz
[root@centos7 ~]# docker exec a8e1f1ee9cbb cat /etc/issue
Debian GNU/Linux 10 \n \l

[root@centos7 ~]# docker exec a8e1f1ee9cbb ls /
bin
boot
dev
etc
home
lib
lib64
media
mnt
opt
proc
root
run
sbin
srv
sys
tmp
usr
var
和宿主机共享内核
[root@centos7 ~]# docker exec a8e1f1ee9cbb uname -r
3.10.0-1160.el7.x86_64
[root@centos7 ~]# uname -r
3.10.0-1160.el7.x86_64
3.1.2 IPC Namespace
一个容器内的进程间通信 , 允许一个容器内的不同进程的(内存、缓存等)数据访问 , 但是不能跨容器直接访问其他容器的数据
3.1.3 UTS Namespace
UTS namespace ( UNIX Timesharing System包含了运行内核的名称、版本、底层体系结构类型等信息 ) 用于系统标识 , 其中包含了主机名hostname和域名domainname , 它使得一个容器拥有属于自己hostname标识 , 这个主机名标识独立于宿主机系统和其上的其他容器。
测试过程中,Debian系统安装基础命令 :
# apt update
# apt install procps (top命令)
# apt install iputils-ping (ping命令)
# apt install net-tools (网络工具)
范例
[root@centos7 ~]# docker exec -it a8e1f1ee9cbb  bash
root@a8e1f1ee9cbb:/# ip a
bash: ip: command not found
root@a8e1f1ee9cbb:/# ifconfig
eth0: flags=4163<UP,BROADCAST,RUNNING,MULTICAST>  mtu 1500
        inet 172.17.0.2  netmask 255.255.0.0  broadcast 172.17.255.255
        ether 02:42:ac:11:00:02  txqueuelen 0  (Ethernet)
        RX packets 657  bytes 2034654 (1.9 MiB)
        RX errors 0  dropped 0  overruns 0  frame 0
        TX packets 599  bytes 37950 (37.0 KiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0

lo: flags=73<UP,LOOPBACK,RUNNING>  mtu 65536
        inet 127.0.0.1  netmask 255.0.0.0
        loop  txqueuelen 1000  (Local Loopback)
        RX packets 0  bytes 0 (0.0 B)
        RX errors 0  dropped 0  overruns 0  frame 0
        TX packets 0  bytes 0 (0.0 B)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0

root@a8e1f1ee9cbb:/# uname -r
3.10.0-1160.el7.x86_64
root@a8e1f1ee9cbb:/# free -h
              total        used        free      shared  buff/cache   available
Mem:          1.8Gi       303Mi       1.0Gi       9.0Mi       495Mi       1.3Gi
Swap:         2.0Gi          0B       2.0Gi
root@a8e1f1ee9cbb:/# lscpu
Architecture:        x86_64
CPU op-mode(s):      32-bit, 64-bit
Byte Order:          Little Endian
Address sizes:       45 bits physical, 48 bits virtual
CPU(s):              2
On-line CPU(s) list: 0,1
Thread(s) per core:  1
Core(s) per socket:  1
Socket(s):           2
NUMA node(s):        1
Vendor ID:           GenuineIntel
CPU family:          6
Model:               158
Model name:          Intel(R) Core(TM) i7-8750H CPU @ 2.20GHz
Stepping:            10
CPU MHz:             2208.001
BogoMIPS:            4416.00
Hypervisor vendor:   VMware
Virtualization type: full
L1d cache:           32K
L1i cache:           32K
L2 cache:            256K
L3 cache:            9216K
NUMA node0 CPU(s):   0,1
Flags:               fpu vme de pse tsc msr pae mce cx8 apic sep mtrr pge mca cmov pat pse36 clflush mmx fxsr sse sse2 ss syscall nx pdpe1gb rdtscp lm constant_tsc arch_perfmon nopl xtopology tsc_reliable nonstop_tsc eagerfpu pni pclmulqdq ssse3 fma cx16 pcid sse4_1 sse4_2 x2apic movbe popcnt tsc_deadline_timer aes xsave avx f16c rdrand hypervisor lahf_lm abm 3dnowprefetch invpcid_single ssbd ibrs ibpb stibp fsgsbase tsc_adjust bmi1 avx2 smep bmi2 invpcid rdseed adx smap clflushopt xsaveopt xsavec xgetbv1 arat md_clear spec_ctrl intel_stibp flush_l1d arch_capabilities
root@a8e1f1ee9cbb:/# uname -r
3.10.0-1160.el7.x86_64
[root@centos7 ~]# uname -r
3.10.0-1160.el7.x86_64
3.1.4 PID Namespace
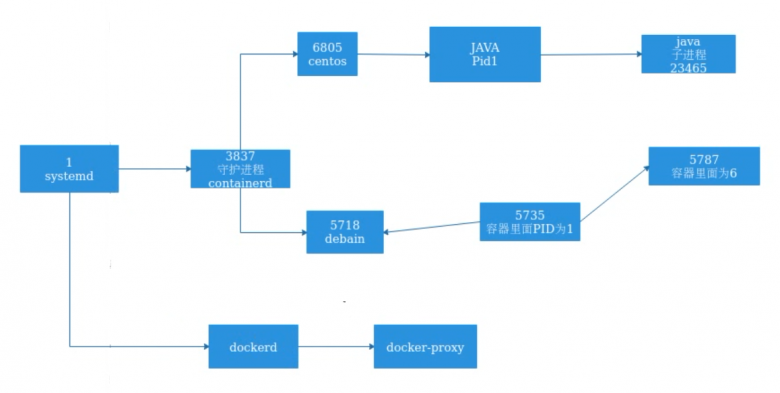
Linux系统中 , 有一个PID为1的进程(init/systemd)是其他所有进程的父进程 , 那么在每个容器内也要有一个父进程来管理其下属的子进程 , 那么多个容器的进程通PID namespace进程隔离(比如PID编号重复、器内的主进程生成与回收子进程等)。
[root@centos7 ~]# docker exec -it a8e1f1ee9cbb  bash

root@a8e1f1ee9cbb:/# ping 127.0.0.1
PING 127.0.0.1 (127.0.0.1) 56(84) bytes of data.
64 bytes from 127.0.0.1: icmp_seq=1 ttl=64 time=0.102 ms
64 bytes from 127.0.0.1: icmp_seq=2 ttl=64 time=0.027 ms
64 bytes from 127.0.0.1: icmp_seq=3 ttl=64 time=0.028 ms
^Z
[1]+  Stopped                 ping 127.0.0.1
root@a8e1f1ee9cbb:/# ps aux
USER        PID %CPU %MEM    VSZ   RSS TTY      STAT START   TIME COMMAND
root          1  0.0  0.1  10612  3424 ?        Ss   Sep22   0:00 nginx: master process nginx -g daemon off;
nginx         7  0.0  0.0  11084  1496 ?        S    Sep22   0:00 nginx: worker process
root        486  0.0  0.1   3856  2020 pts/0    Ss   01:35   0:00 bash
root        493  0.0  0.0   6056   964 pts/0    T    01:36   0:00 ping 127.0.0.1
root        494  0.0  0.0   7628  1400 pts/0    R+   01:36   0:00 ps aux


[root@centos7 ~]# pstree -p
systemd(1)─┬─NetworkManager(685)─┬─dhclient(4098)
           │                     ├─{NetworkManager}(733)
           │                     └─{NetworkManager}(735)
           ├─VGAuthService(666)
           ├─agetty(695)
           ├─auditd(643)───{auditd}(644)
           ├─containerd(1480)─┬─{containerd}(1482)
           │                  ├─{containerd}(1483)
           │                  ├─{containerd}(1484)
           │                  ├─{containerd}(1485)
           │                  ├─{containerd}(1486)
           │                  ├─{containerd}(1487)
           │                  ├─{containerd}(1490)
           │                  └─{containerd}(1500)
           ├─containerd-shim(1724)─┬─bash(8910)───ping(9070)
           │                       ├─nginx(1743)───nginx(1763)
           │                       ├─{containerd-shim}(1725)
           │                       ├─{containerd-shim}(1726)
           │                       ├─{containerd-shim}(1727)
           │                       ├─{containerd-shim}(1728)
           │                       ├─{containerd-shim}(1729)
           │                       ├─{containerd-shim}(1730)
           │                       ├─{containerd-shim}(1731)
           │                       ├─{containerd-shim}(1732)
           │                       ├─{containerd-shim}(1756)
           │                       └─{containerd-shim}(1803)
           ├─crond(690)
           ├─dbus-daemon(674)
           ├─dockerd(1489)─┬─docker-proxy(1703)─┬─{docker-proxy}(1704)
           │               │                    ├─{docker-proxy}(1705)
           │               │                    ├─{docker-proxy}(1706)
           │               │                    ├─{docker-proxy}(1707)
           │               │                    ├─{docker-proxy}(1709)
           │               │                    └─{docker-proxy}(1710)
           │               ├─docker-proxy(1708)─┬─{docker-proxy}(1711)
           │               │                    ├─{docker-proxy}(1712)
           │               │                    ├─{docker-proxy}(1713)
           │               │                    ├─{docker-proxy}(1714)
           │               │                    └─{docker-proxy}(1715)
           │               ├─{dockerd}(1491)
           │               ├─{dockerd}(1492)
           │               ├─{dockerd}(1493)
           │               ├─{dockerd}(1494)
           │               ├─{dockerd}(1495)
           │               ├─{dockerd}(1496)
           │               ├─{dockerd}(1497)
           │               ├─{dockerd}(1498)
           │               ├─{dockerd}(1499)
           │               ├─{dockerd}(1717)
           │               └─{dockerd}(8353)
           ├─irqbalance(684)
           ├─lvmetad(524)
           ├─master(1103)─┬─pickup(9118)
           │              └─qmgr(1143)
           ├─polkitd(665)─┬─{polkitd}(681)
           │              ├─{polkitd}(682)
           │              ├─{polkitd}(683)
           │              ├─{polkitd}(696)
           │              ├─{polkitd}(700)
           │              └─{polkitd}(702)
           ├─rsyslogd(946)─┬─{rsyslogd}(1442)
           │               └─{rsyslogd}(1445)
           ├─sshd(949)───sshd(1449)─┬─bash(1451)
           │                        ├─bash(8224)───docker(8895)─┬─{docker}(8896)
           │                        │                           ├─{docker}(8897)
           │                        │                           ├─{docker}(8898)
           │                        │                           ├─{docker}(8899)
           │                        │                           ├─{docker}(8916)
           │                        │                           ├─{docker}(8920)
           │                        │                           └─{docker}(8928)
           │                        └─bash(9026)───pstree(9132)
           ├─systemd-journal(496)
           ├─systemd-logind(672)
           ├─systemd-udevd(527)
           ├─tuned(948)─┬─{tuned}(1435)
           │            ├─{tuned}(1436)
           │            ├─{tuned}(1438)
           │            └─{tuned}(1439)
           └─vmtoolsd(667)─┬─{vmtoolsd}(687)
                           └─{vmtoolsd}(698)
3.1.5 Net Namespace
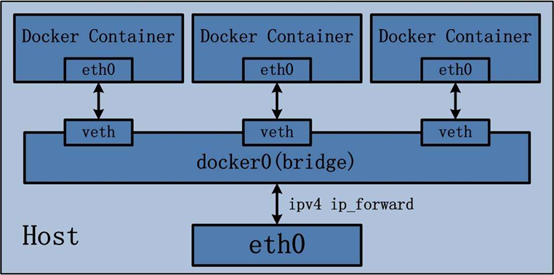
每一个容器都类似于虚拟机一样有自己的网卡、监听端口、TCP/IP协议栈等 ,
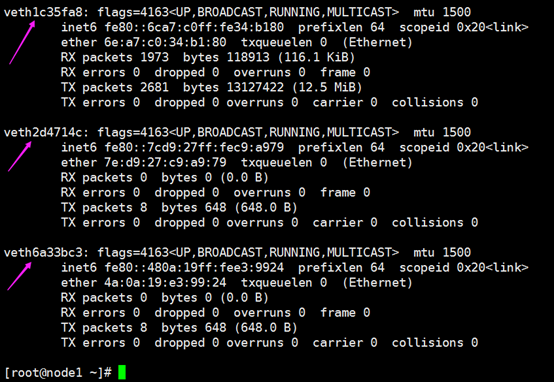
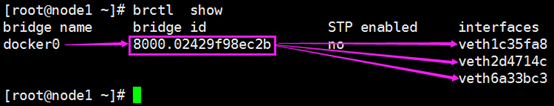
Docker使用network namespace启动一个vethX接口 , 这样你的容器将拥有它自己的桥接ip地址 , 通常是docker0 , 而docker0实质就是Linux的虚拟网桥,网桥是在OSI七层模型的数据链路层的网络设备 , 通过mac地址对网络进行划分 , 并且在不同网络直接传递数据。
查看宿主机的网卡信息:
查看宿主机桥接设备 :
通过brctl show命令查看桥接设备 :
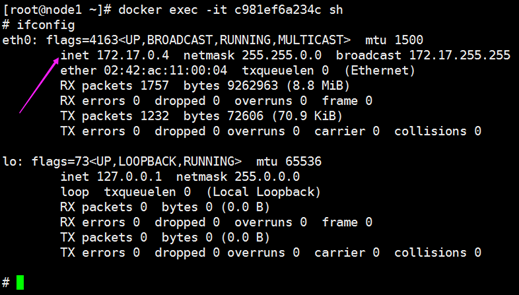
逻辑网络图 :
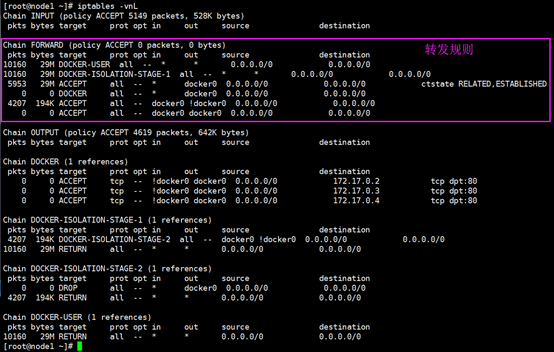
宿主机iptables规则 :
3.1.6 User Namespace
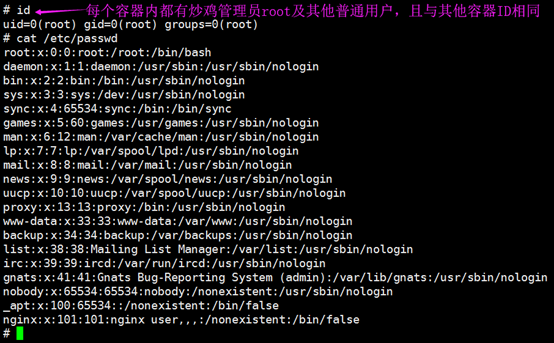
各个容器内可能会出现重名的用户和用户组名称 , 或重复的用户UID或者GID , 那么怎么隔离各个容器内的用户空间呢?
User Namespace允许在各个宿主机的各个容器空间内创建相同的用户名以及相同的用户UID和GID , 只是会把用户的作用范围限制在每个容器内 , 即A容器和B容器可以有相同的用户名称和ID的账户 , 但是此用户的有效范围仅是当前容器内 , 不能访问另外一个容器内的文件系统 , 即相互隔离、互补影响、永不相见。
3.2 Cgroup
在一个容器 , 如果不对其做任何资源限制 , 则宿主机会允许其占用无限大的内存空间 ,有时候会因为代码bug程序会一直申请内存 , 直到把宿主机内存占完 , 为了避免此类的问题出现 ,宿主机有必要对容器进行资源分配限制 , 比如CPU、内存等 , Linux Cgroups的全称是Linux Control Groups ,它最主要的作用 , 就是限制一个进程组能够使用的资源上限 , 包括CPU、内存、磁盘、网络带宽等等。此外 , 还能够对进程进行优先级设置 , 以及将进程挂起和恢复等操作。
3.2.1 子系统
典型的子系统介绍如下 :
cpu子系统 : 主要限制进程的CPU使用率。cpuacct子系统 : 统计Cgroups中的进程的CPU资源使用报告。cpuset子系统: 为Cgroups中的进程分配单独的CPU节点或者内存节点。如果是多核心的cpu, 这个子系统会为cgroup任务分配单独的cpu和内存memory子系统 : 限制进程的memory使用量以及产生内存资源报告blkio子系统 : 限制进程的块设备IO。devices子系统 : 控制进程能够访问某些设备。net_cls子系统 : 标记Cgroups中进程的网络数据包 , 然后可以使用tc模块 (traffic control) 对数据包进行控制。freezer子系统 : 挂起或者恢复Cgroups中的进程。ns子系统 : 使不同Cgroups下面的进程使用不同的Namespace。perf_event: 增加了对每group的监测跟踪的能力 , 可以监测属于某个特定的group的所有线程以及运行在特定CPU上的线程
查看系统cgroups
[root@ubuntu1804 ~]#ll  /sys/fs/cgroup/
total 0
drwxr-xr-x 15 root root 380 Jan 22 16:20 ./
drwxr-xr-x 10 root root   0 Jan 22 16:20 ../
dr-xr-xr-x  5 root root   0 Jan 22 16:20 blkio/
lrwxrwxrwx  1 root root  11 Jan 22 16:20 cpu -> cpu,cpuacct/
lrwxrwxrwx  1 root root  11 Jan 22 16:20 cpuacct -> cpu,cpuacct/
dr-xr-xr-x  5 root root   0 Jan 22 16:20 cpu,cpuacct/
dr-xr-xr-x  3 root root   0 Jan 22 16:20 cpuset/
dr-xr-xr-x  5 root root   0 Jan 22 16:20 devices/
dr-xr-xr-x  3 root root   0 Jan 22 16:20 freezer/
dr-xr-xr-x  3 root root   0 Jan 22 16:20 hugetlb/
dr-xr-xr-x  5 root root   0 Jan 22 16:20 memory/
lrwxrwxrwx  1 root root  16 Jan 22 16:20 net_cls -> net_cls,net_prio/
dr-xr-xr-x  3 root root   0 Jan 22 16:20 net_cls,net_prio/
lrwxrwxrwx  1 root root  16 Jan 22 16:20 net_prio -> net_cls,net_prio/
dr-xr-xr-x  3 root root   0 Jan 22 16:20 perf_event/
dr-xr-xr-x  5 root root   0 Jan 22 16:20 pids/
dr-xr-xr-x  2 root root   0 Jan 22 16:20 rdma/
dr-xr-xr-x  6 root root   0 Jan 22 16:20 systemd/
dr-xr-xr-x  5 root root   0 Jan 22 16:20 unified/

[root@ubuntu1804 ~]#cat /sys/fs/cgroup/cpu/docker/5dee9be9afdbab8c2f6c4c5eb0f956c9579efe93110daf638f8fd15f43d961e2/cpuacct.usage
4751336886
[root@ubuntu1804 ~]#cat /sys/fs/cgroup/memory/docker/5dee9be9afdbab8c2f6c4c5eb0f956c9579efe93110daf638f8fd15f43d961e2/cpuacct.usage
cat: /sys/fs/cgroup/memory/docker/5dee9be9afdbab8c2f6c4c5eb0f956c9579efe93110daf638f8fd15f43d961e2/cpuacct.usage: No such file or directory

[root@ubuntu1804 ~]#cat /sys/fs/cgroup/memory/docker/5dee9be9afdbab8c2f6c4c5eb0f956c9579efe93110daf638f8fd15f43d961e2/memory.limit_in_bytes
9223372036854771712
[root@ubuntu1804 ~]#cat /sys/fs/cgroup/memory/docker/5dee9be9afdbab8c2f6c4c5eb0f956c9579efe93110daf638f8fd15f43d961e2/memory.max_usage_in_bytes
79278080
3.2.2 验证系统cgroups
Cgroups在内核层默认已经开启 , 从centos和ubuntu 对比结果来看 , 显然内核较新的ubuntu 支持的功能更多。
Centos 8.1 cgroups :
[root@centos8 ~]#cat /etc/redhat-release
CentOS Linux release 8.1.1911 (Core)
[root@centos8 ~]#grep CGROUP /boot/config-4.18.0-147.el8.x86_64
CONFIG_CGROUPS=y
CONFIG_BLK_CGROUP=y
# CONFIG_DEBUG_BLK_CGROUP is not set
CONFIG_CGROUP_WRITEBACK=y
CONFIG_CGROUP_SCHED=y
CONFIG_CGROUP_PIDS=y
CONFIG_CGROUP_RDMA=y
CONFIG_CGROUP_FREEZER=y
CONFIG_CGROUP_HUGETLB=y
CONFIG_CGROUP_DEVICE=y
CONFIG_CGROUP_CPUACCT=y
CONFIG_CGROUP_PERF=y
CONFIG_CGROUP_BPF=y
# CONFIG_CGROUP_DEBUG is not set
CONFIG_SOCK_CGROUP_DATA=y
# CONFIG_BLK_CGROUP_IOLATENCY is not set
CONFIG_NETFILTER_XT_MATCH_CGROUP=m
CONFIG_NET_CLS_CGROUP=y
CONFIG_CGROUP_NET_PRIO=y
CONFIG_CGROUP_NET_CLASSID=y
[root@centos8 ~]#
Centos 7.6 cgroups :
[root@centos7 ~]#cat /etc/redhat-release
CentOS Linux release 7.6.1810 (Core)
[root@centos7 ~]#grep CGROUP /boot/config-3.10.0-957.el7.x86_64
CONFIG_CGROUPS=y
# CONFIG_CGROUP_DEBUG is not set
CONFIG_CGROUP_FREEZER=y
CONFIG_CGROUP_PIDS=y
CONFIG_CGROUP_DEVICE=y
CONFIG_CGROUP_CPUACCT=y
CONFIG_CGROUP_HUGETLB=y
CONFIG_CGROUP_PERF=y
CONFIG_CGROUP_SCHED=y
CONFIG_BLK_CGROUP=y
# CONFIG_DEBUG_BLK_CGROUP is not set
CONFIG_NETFILTER_XT_MATCH_CGROUP=m
CONFIG_NET_CLS_CGROUP=y
CONFIG_NETPRIO_CGROUP=y
ubuntu cgroups :
[root@ubuntu1804 ~]#grep CGROUP  /boot/config-4.15.0-29-generic
CONFIG_CGROUPS=y
CONFIG_BLK_CGROUP=y
# CONFIG_DEBUG_BLK_CGROUP is not set
CONFIG_CGROUP_WRITEBACK=y
CONFIG_CGROUP_SCHED=y
CONFIG_CGROUP_PIDS=y
CONFIG_CGROUP_RDMA=y
CONFIG_CGROUP_FREEZER=y
CONFIG_CGROUP_HUGETLB=y
CONFIG_CGROUP_DEVICE=y
CONFIG_CGROUP_CPUACCT=y
CONFIG_CGROUP_PERF=y
CONFIG_CGROUP_BPF=y
# CONFIG_CGROUP_DEBUG is not set
CONFIG_SOCK_CGROUP_DATA=y
CONFIG_NETFILTER_XT_MATCH_CGROUP=m
CONFIG_NET_CLS_CGROUP=m
CONFIG_CGROUP_NET_PRIO=y
CONFIG_CGROUP_NET_CLASSID=y
cgroups 中内存模块 :
[root@ubuntu1804 ~]#grep MEMCG  /boot/config-4.15.0-29-generic
CONFIG_MEMCG=y
CONFIG_MEMCG_SWAP=y
# CONFIG_MEMCG_SWAP_ENABLED is not set
CONFIG_SLUB_MEMCG_SYSFS_ON=y
4. 联合文件系统
Docker 底层有三驾马车 , Namespace、CGroup 和UnionFS(联合文件系统) , UnionFS 是Docker 镜像的基础。
联合文件系统(UnionFS ) 是一种分层、轻量级并且高性能的文件系统 , 它支持对文件系统的修改作为一次提交来一层层的叠加 , 同时可以将不同目录挂载到同一个虚拟文件系统下(unite several directories into a single virtual filesystem)。
联合文件系统是Docker镜像的基础。镜像可以通过分层来进行继承 , 基于基础镜像(没有父镜像) , 可以制作各种具体的应用镜像。另外 , 不同Docker容器就可以共享一些基础的文件系统层 , 同时再加上自己独有的改动层 , 大大提高了存储的效率。
Docker 中使用的 AUFS(Advanced Multi-Layered Unification Filesystem)就是一种联合文件系统。 AUFS 支持为每一个成员目录(类似 Git 的分支)设定只读(readonly)、读写(readwrite)和写出(whiteout-able)权限, 同时 AUFS 里有一个类似分层的概念, 对只读权限的分支可以逻辑上进行增量地修改(不影响只读部分的)。
Docker 正是利用AUFS分层技术来实现对Container的快速更新和大规模部署 , 并且在Docker中引入了Storage Driver技术 ,实现对外置存储的良好支持。
Docker 目前支持的联合文件系统包括OverlayFS, AUFS, Btrfs, VFS, ZFS 和 Device Mapper。
各Linux发行版Docker推荐使用的存储驱动如下表。
在可能的情况下 ,推荐使用 overlay2 存储驱动 , overlay2 是目前 Docker 默认的存储驱动 , 以前则是 aufs。你可以通过配置来使用以上提到的其他类型的存储驱动。
4.1 overlay2
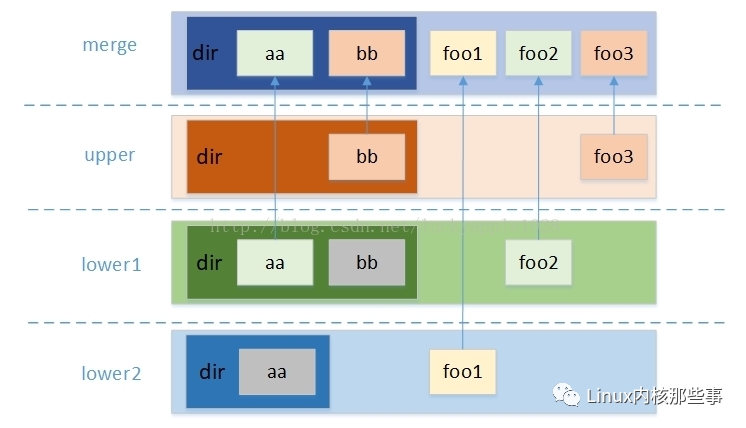
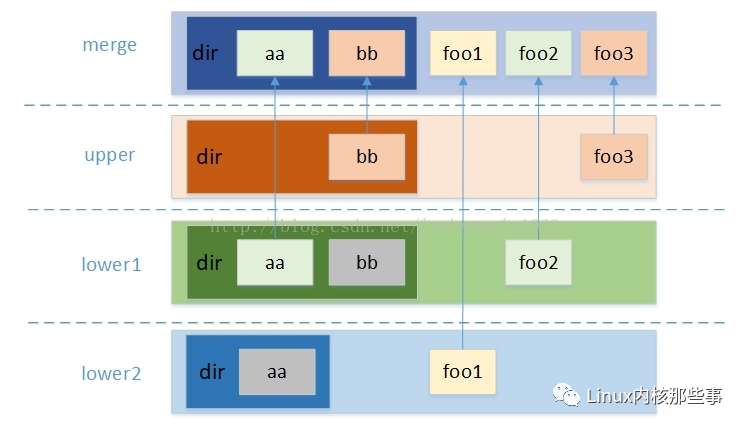
从上图可知 ,OverlayFS 文件系统主要有三个角色 , lowerdir、upperdir 和 merged。lowerdir 是只读层 , 用户不能修改这个层的文件 ; upperdir 是可读写层 , 用户能够修改这个层的文件 ; 而merged 是合并层 , 把lowerdir 层和 upperdir 层的文件合并展示。使用 OverlayFS 前需要进行挂载操作 , 挂载 OverlayFS 文件系统的基本命令如下 :
使用 OverlayFS 前需要进行挂载操作 , 挂载 OverlayFS 文件系统的基本命令如下:
$ mount -t overlay overlay -o lowerdir=lower1:lower2,upperdir=upper,workdir=work merged参数 -t 表示挂载的文件系统类型 , 这里设置为 overlay 表示文件系统类型为 OverlayFS , 而参数 -o 指定的是 lowerdir、upperdir 和 workdir , 最后的 merged 目录就是最终的挂载点目录。下面说明一下 -o 参数几个目录的作用 :
lowerdir: 指定用户需要挂载的lower层目录 , 指定多个目录可以使用:来分隔 ( 最大支持500层 ) 。upperdir: 指定用户需要挂载的upper层目录。workdir: 指定文件系统的工作基础目录 , 挂载后内容会被清空 , 且在使用过程中其内容用户不可见。
OverlayFS 文件系统的作用是合并 upper 目录和 lower 目录的中的内容 , 如果 upper 目录与 lower 目录同时存在同一文件或目录 , 那么 OverlayFS 文件系统怎么处理呢?
如果
upper和lower目录下同时存在同一文件 , 那么按upper目录的文件为准。比如upper与lower目录下同时存在文件a.txt, 那么按upper目录的a.txt文件为准。如果
upper和lower目录下同时存在同一目录 , 那么把upper目录与lower目录的内容合并起来。比如upper与lower目录下同时存在目录test, 那么把upper目录下的test目录中的内容与lower目录下的test目录中的内容合并起来。
为了简单起见 , 本文使用的是 Linux 3.18.3 版本 , 此版本的 OverlayFS 文件系统只支持一层的 lower 目录 , 所以简化了多层 lower 合并的逻辑。
4.2 aufs
AUFS(Another Union File System/Advanced Multilayered Unification File System)不仅可以对每一个目录设定只读(Readonly)、读写(Readwrite)和写(Witeout-able)权限 , 同时AUFS也可以支持分层的机制 , 例如 , 可以对只读权限部分逻辑上进行增量地修改而不影响只读部分。
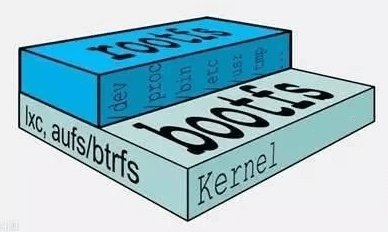
典型的Linux启动到运行需要两个FileSystem ,BootFS 和RootFS。
BootFS 主要包含BootLoader 和Kernel , BootLoader主要是引导加载Kernel , 当Boot成功后 , Kernel被加载到内存中BootFS就被Umount了。
RootFS包含的就是典型Linux 系统中的/dev、/proc、/bin 等标准目录和文件。
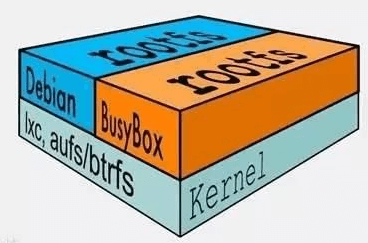
不同的linux发行版 , BootFS基本是一致的, RootFS会有差别 , 因此不同的发行版可以共享BootFS。
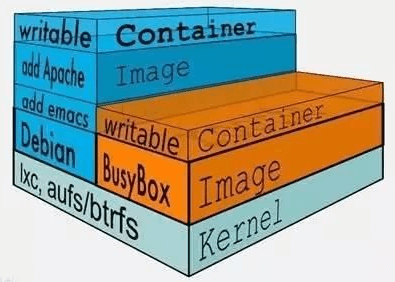
Linux在启动后 , 首先将RootFS置为Readonly , 进行一系列检查后将其切换为Readwrite供用户使用。在Docker中 , 也是利用该技术 , 然后利用Union Mount在Readonly的RootFS文件系统之上挂载Readwrite文件系统。并且向上叠加, 使得一组Readonly和一个Readwrite的结构构成一个Container的运行目录、每一个被称作一个文件系统Layer。
AUFS的特性, 使得每一个对Readonly层文件/目录的修改都只会存在于上层的Writeable层中。这样由于不存在竞争、而且多个Container可以共享Readonly文件系统层。在Docker中 , 将Readonly的层称作 "image" 镜像。对于Container整体而言 , 整个RootFS变得是read-write的 , 但事实上所有的修改都写入最上层的writeable层中 , image不保存用户状态 , 可以用于模板、重建和复制。
在Docker中 , 上层的Image依赖下层的Image , 因此Docker中把下层的Image称作父Image , 没有父Image的Image称作Base Image。因此 , 想要从一个Image启动一个Container , Docker会先逐次加载其父Image直到Base Image ,用户的进程运行在Writeable的文件系统层中。所有父Image中的数据信息以及ID、网络和LXC管理的资源限制、具体container的配置等 , 构成一个Docker概念上的Container。
采用AUFS作为Docker的Container的文件系统 , 能够提供的优势只要有以下几点。
多个
Container可以共享父Image存储 , 节省存储空间。快速部署 – 如果要部署多个
Container,Base Image可以避免多次拷贝 , 实现快速部署。因为多个
Container共享Image, 提高多个Container中的进程命中缓存内容的几率。相比于
Copy-on-write类型的FS ,Base Image也是可以挂载为可Writeable的 , 可以通过更新Base Image而一次性更新其之上的Container。
5. 镜像
常言道 , startup有startup的好 , 大厂有大厂的好 , 那么大厂究竟好在哪呢?拿硅谷老牌大厂们FLG来说 , 如果要问最令人怀念的是什么?Free food和基础设施(Infrastructure)一定是会上榜的 , 两者均极大提升了广大应用开发者的幸福指数。那么能不能"让天下没有难做的应用"呢?请大家把目光投向正在兴起的云原生生态。
在云原生生态中 , 容器服务包括了镜像和容器引擎两个部分。其中容器镜像作为核心的云原生应用制品 , 打包了完整的操作系统和应用运行环境 , 应用的迭代也因为使用了这种不可变架构而变得更简单 , 更频繁。
本文将围绕着容器镜像这一核心 , 分享它的相关知识和业界的思考与实践。
5.1 容器镜像的概念
容器镜像
容器镜像有一个官方的类比 , "生活中常见的集装箱" , 虽然拥有不同的规格 , 但箱子本身是不可变的(
Immutable) , 只是其中装的内容不同。对于镜像来说 , 不变的部分包含了运行一个应用软件(如
mysql)所需要的所有元素。开发者可以使用一些工具(如Dockerfile)构建出自己的容器镜像 , 签名并上传到互联网上 , 然后需要运行这些软件的人可以通过指定名称 ( 如_example.com/my-app_) 下载、验证和运行这些容器。OCI标准镜像规范
在
OCI标准镜像规范出台之前 , 其实有两套广泛使用的镜像规范 , 分别是appc和docker v2.2, 但“合久必分 , 分久必合” , 有意思的是两者的内容已经在各自的发展中逐步同化了 , 所以OCI组织顺水推舟地在docker v2.2的基础上推出了oci image format spec, 规定了对于符合规范的镜像 , 允许开发者只要对容器打包和签名一次 , 就可以在所有的容器引擎上运行该容器。这份规范给出了
OCI image的定义 :This specification defines an OCI Image, consisting of a manifest, an image index (optional), a set of filesystem layers, and a configuration.容器的工作流程
一个典型的容器工作流程是从由
developers制作容器镜像开始的(build) , 然后上传到镜像存储中心(ship) , 最后部署在集群中(run)。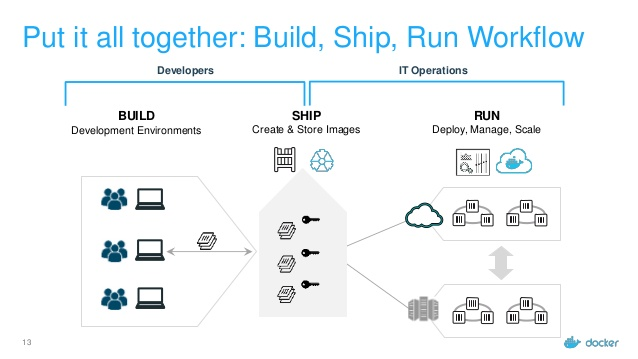
5.2 容器镜像技术发展中遇到的问题
不得不说 , 容器镜像的设计是很出彩的 , 首先它蕴含了“完整的操作系统就是一个包”的优秀思想 , 带着大家跳出了安装包的思路 , 又提出了诸如dockerfile这样的提升开发者体验的killer features , 还能利用分层结构来节约时间空间。
不过 , "金无足赤 , 人无完人" , 优秀的设计并不等于优秀的实践 , 下面来聊一聊问题具体出在哪。
5.2.1 容器镜像使用者
问题一 : 启动容器慢
容器启动慢的情况普遍发生在当用户启动一个很大
size的容器镜像时 , 由于在容器准备阶段需要三步 ( 以overlayfs为例 ) :download镜像 ;unpack镜像 ;使用
overlayfs将容器可写层和镜像中的只读层聚合起来提供容器运行环境。
其中 ,
download镜像时需要download整个镜像 , 不能实现文件数据按需加载。再加上download镜像本身受限于网络带宽的影响 , 当容器镜像size在到几个G时 , 下载时间会较长 , 破坏了容器原本优秀的用户体验。问题二 : 较高的本地存储成本
不同镜像之间可以共享的最小单位是镜像中的层 , 它的缺点之一是在
deduplication上的效率是较低的 , 原因是 :首先 , 层内部存在重复的数据 ;
其次 , 层与层之间可能存在大量重复的数据 , 但即使有微小的差别 , 也会被作为不同的层 ;
再次 , 根据
OCI image spec对删除文件和hardlink的设计 , 一个镜像内部可能存在已经被上层删除的文件仍然存在于下层中 , 并包含在镜像中。
所以 , 当不同镜像的容器被调度到同一台机器上运行时 , 镜像本身在本地文件系统中所占的存储空间是一笔不可忽视的成本开销。
5.2.2 镜像提供者侧
这里的提供者主要指容器服务的镜像中心。
问题一 : 巨大的存储浪费
存在大量相似镜像 造成这种情况有两个原因 :
首先 , 上面提到的层的缺点 , 在容器镜像中心会产生许多相似镜像 ;
其次 ,
OCI image使用了tar+gzip格式来表达镜像中的层 , 而tar格式并不区分tar archive entries ordering, 这带来一个问题 , 即如果用户在不同机器上build去同一个镜像 , 最终可能会因为使用了不同的文件系统而得到不同的镜像 , 然后用户上传之后 , 镜像中心中会存在若干不同镜像的实质内容是完全相同的情况。
镜像去重效率低
虽然镜像中心有垃圾回收来实现去重功能 , 但其仍然以层为单位 , 所以只能在有完全相同
hash value的层之间去重。问题二 : 云原生软件供应链带来的新需求
随着时间推移 , 和软件供应链一起发展的还有对软件供应链环节的多样性攻击手段。安全防护是软件供应链中非常重要的组成 , 不光体现在对软件本身的安全增强 , 也体现在对供应链本身的安全增强。而因为应用运行环境被前置到了容器镜像中 , 所以对容器镜像的安全 , 包括对镜像的漏洞扫描和签名成为了容器服务提供者的必要能力。
5.3 对容器镜像的思考和讨论
5.3.1 业界尝试
针对前面所述的问题 , 业界大小厂也是集思广益 , 各显神通 , 下面提几个典型的项目 :
CernVM-FS使用了
fuse按需从远程加载需要的数据Slacker通过设计一个镜像的
benchmark贡献了几个有意思的理论基础 :事实上 , 容器启动时间很长 ;
启动时数据读写放大系数很大 ( 启动时中只使用
6%的数据 ) ;分析了
57个docker image的layer数量发现一半以上的image的layer数量大于9。
Slacker最终使用了按需加载和减少镜像层数将启动速度提高了5-20倍。SquashFsOracle使用Linux SquashFS来替代targz存储容器image layer的内容 , 去掉了unpack tar的环节。
5.3.2 OCI社区中的讨论
自2019年开始 , 对于镜像本身的吐槽慢慢多了起来 , 发酵了一年多 , OCI 社区觉得时机成熟了 , 从2020年6月开始 , 花了一个多月时间密集讨论了当前 OCI 镜像规范的缺陷 , 以及 OCIv2 镜像格式 (*) 需要满足哪些要求。
(* ) OCIv2 在这里只是一个宣传命名 , 实际上OCIv2 是当前OCI镜像规范的改进 , 而不会是一个全新的镜像规范。
5.3.2.1 OCI镜像规范的缺陷
经过讨论得出目前的缺陷主要有两点 :
tar格式标准tar格式并不区分tar archive entries ordering, 这带来一个问题 , 即如果用户在不同机器上build去同一个镜像 , 最终可能会因为使用了不同的文件系统而得到不同的镜像 , 比如在文件系统A上的order是foo在bar之前进入tar, 在文件系统B上的order是bar在foo之前进入tar, 那么这两个镜像是不同的。当
tar被gzip压缩过之后不支持seek, 导致run container之前必须先下载并解压targz的image layers, 而不能实现文件数据按需加载。
以层为镜像的基本单位
内容冗余 : 不同层之间相同信息在传输和存储时都是冗余内容 , 在不读取内容的时候无法判断到这些冗余的存在 ;
无法并行 : 单一层是一个整体 , 对同一个层既无法并行传输 , 也不能并行提取 ;
无法进行小块数据的校验 , 只有完整的层下载完成之后 , 才能对整个层的数据做完整性校验 ;
其他一些问题 : 比如 , 跨层数据删除难以完美处理。
5.3.2.2 下一代镜像格式的要求
这次镜像格式大讨论从一个邮件和一份共享文档开始 , 并促成了多次在线的OCI社区讨论会议。最后的结论也很鼓舞人心 , 在这份共享文档中可以找到对OCIv2镜像格式需要满足的要求的详细描述。我们可以将这些要求分类为 :
(*) : 诸如file timestamp等只在一个特定机器上有意义的metadata是没有必要存在于镜像中的。
可以看出 , 上面这些要求明确了容器镜像的下一步重点在易用、效率、安全三个方面 , 达到在"build - ship - run" 这三个阶段协同优化的目的。
5.3.3 阿里云在容器镜像上的思考
阿里云一直积极地推动和发展云原生生态 , 提供了基础设施""阿里云容器镜像服务(ACR ) "作为用户云原生容器化的第一站 , 负责提供容器镜像、Helm Chart等OCI Artifacts管理和分发服务。同时我们也在结合容器业务现状深化对容器镜像格式的理解 , 不断地总结什么是满足发展需求的容器镜像格式 , 这里可以概括为以下几点 , 新的镜像格式需要 :
满足容器"
build once, run anywhere"的理念实现在镜像中心和容器运行结点上存储资源上的高效使用
在容器镜像的全链路上 (
build, ship, run) 比现有的OCI镜像格式速度更快能够扩展在安全上的能力
最大程度兼容已有基础设施 , 普惠大多数用户
5.4 阿里云沙箱容器的镜像加速
相比于社区的讨论重点放在了新的镜像格式的设计上 , 阿里云更关心如何设计出一套优化全链路的镜像方案 , 为客户带来能够应用在生产中的价值。
在明确以上在技术发展过程中产生的需求之后 , 我们为阿里云沙箱容器 ( https://help.aliyun.com/document_detail/142151.html?spm=ata.13261165.0.0.2a4e67ed3sP1VA ) 设计了新的镜像格式Rafs , 并为CNCF下的Dragonfly项目引入了容器镜像服务 , 它能够极大缩短镜像下载时间 , 并提供端到端的镜像数据一致性校验 , 从而让用户能够更安全快捷地管理容器应用。
5.4.1 Rafs: 镜像格式
Rafs 把一个容器镜像只分成元数据和数据两层。其中 ,
元数据层 : 元数据层是一颗自校验的哈希树。每个文件和目录都是哈希树中的一个附带哈希值的节点。一个文件节点的哈希值是由文件的数据确定 , 一个目录节点的哈希值则是由该目录下所有文件和目录的哈希值确定。
数据层 : 每个文件的数据被按照固定大小切片并保存到数据层中。数据切片可以在不同文件以及不同镜像中的不同文件共享。
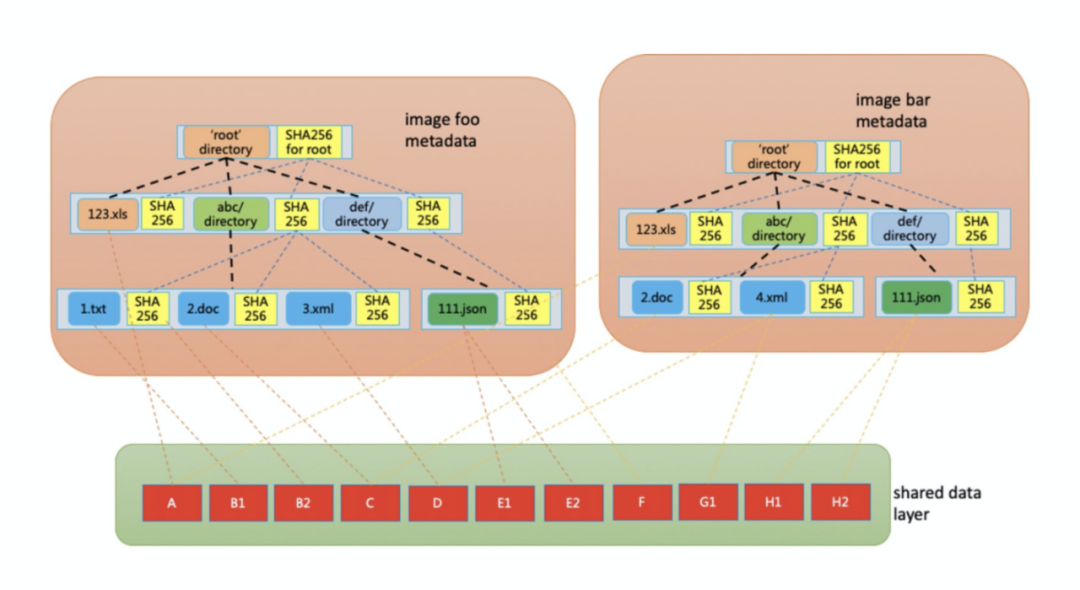
5.4.2 Nydus: Dragonfly的容器镜像服务
除了使用上面的镜像格式Rafs , Nydus还包含一个负责解析容器镜像的FUSE用户态文件系统进程。
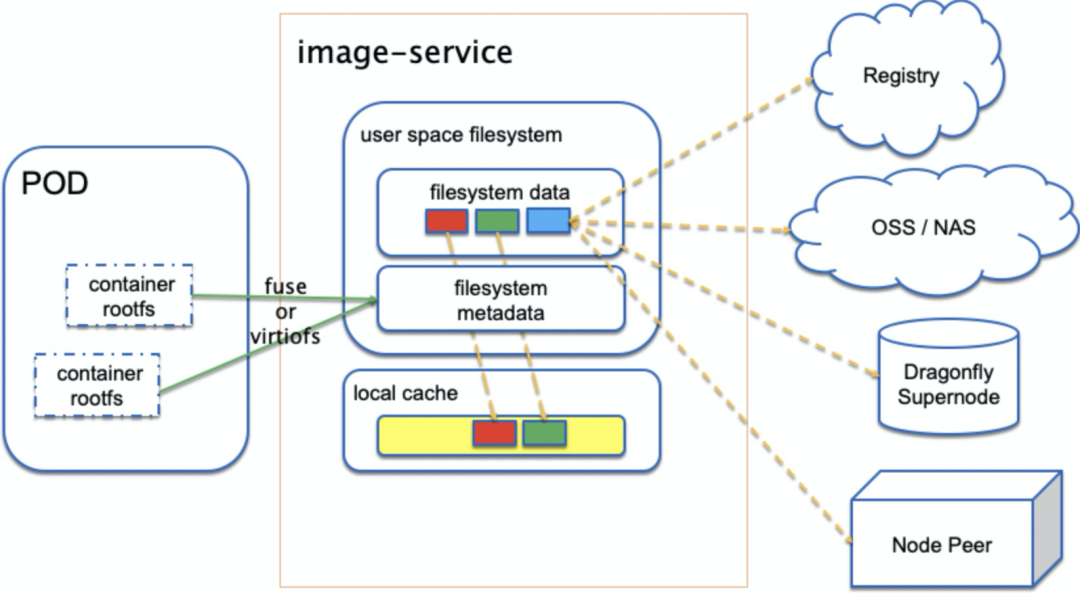
nydus能够解析FUSE或者virtiofs (https://virtio-fs.gitlab.io/?spm=ata.13261165.0.0.2a4e67ed3sP1VA)协议来支持传统的runc容器 (https://github.com/opencontainers/runc?spm=ata.13261165.0.0.2a4e67ed3sP1VA)或者阿里云沙箱容器。容器仓库 ,OSS对象存储( https://www.alibabacloud.com/zh/product/oss ) , NAS , 以及Dragonfly的超级节点和peer节点都可以作为nydus的镜像数据源。同时 , nydus还可以配置一个本地缓存 , 从而避免每次启动都从远端数据源拉取数据。
基于这个设计架构 , nydus分别在build, ship, run 和兼容性方面提供下面这些优化 :
5.4.3 为什么选择基于文件的设计
在设计之初 , Nydus选择了基于文件的设计而不是基于块的设计 , 为什么这样做呢?
主要的原因是 , 我们想在镜像加速的基础上做基于容器特点的附加能力 , 这一切都建立在能够获取到镜像中的文件元数据 ; 而基于块的设计只使用disk LBA , 天然地无法获取其上层 ( 即文件系统 ) 中的信息。
有了文件元数据之后 , 我们轻松地实现了以下几个增值功能 :
镜像优化建议 : 在
build container环节 , 提示用户有哪些文件是根本没有访问过的 , 可以考虑借此来优化镜像 ;预读 : 在
run container环节预加载 , 猜到用户要读文件 , 那就预先在读操作发生之前送过去 , 从而优化访问速度 ;安全审计 : 在
run container环节 , 如果一个容器访问镜像内容的模式和其他容器产生了明显差异 , 那么 , 这有可能是一个安全性风险 ;变更风险发现 : 在
run container环节 , 如果一个镜像升级之后 , 发现它访问内容的模式和之前发生了明显差异 , 那么 , 要么是程序自己有意变了 , 要么就可能是引入bug了 , 这时可以考虑提醒开发者这个变化。
5.5 总结
OCI image分层镜像机制虽然极大地方便了开发 , 但在大规模集群运行时 , 也有颇多不足 , 对此 , OCI镜像社区也在寻求着如何利用镜像内容可感知性 , 让它更加快速、节省资源 , 也更加安全。阿里云在这个基础上本着为客户带来价值的原则 , 提出了公有云上对镜像的稳定性、预读等需求 , 并为阿里云沙箱容器研发出了相应的的镜像加速方案 , 实现"`build-ship-run``"整个镜像链路上的统一优化 , 让用户不光听着热闹 , 也能用着开心 , 切实得到云原生基础设施发展的红利。
6. 容器管理工具
6.1 lxc
LXC是Linux containers的简称, 是一种基于容器的操作系统层级的虚拟化技术。目前主要是使用docker , 早期有使用lxc。
官方网站 : https://linuxcontainers.org/
示例:Ubuntu安装 和使用LXC
[root@ubuntu1804 ~]#apt install lxc lxd
Reading package lists... Done
Building dependency tree
Reading state information... Done
lxd is already the newest version (3.0.3-0ubuntu1~18.04.1).
lxc is already the newest version (3.0.3-0ubuntu1~18.04.1).
......

[root@ubuntu1804 ~]#lxc-checkconfig   #检查内核对lcx的支持状况, 必须全部为lcx
Kernel configuration not found at /proc/config.gz; searching...
Kernel configuration found at /boot/config-4.15.0-29-generic
--- Namespaces ---
Namespaces: enabled
Utsname namespace: enabled
Ipc namespace: enabled
Pid namespace: enabled
User namespace: enabled
Network namespace: enabled
......

[root@ubuntu1804 ~]#lxc-create -t download --name alpine12 --  --dist alpine  --release 3.9 --arch amd64
Setting up the GPG keyring
Downloading the image index
Downloading the rootfs
Downloading the metadata
The image cache is now ready
Unpacking the rootfs

---
You just created an Alpinelinux 3.9 x86_64 (20200121_13:00) container.
[root@ubuntu1804 ~]#lxc-start alpine12    #启动lxc容器
[root@ubuntu1804 ~]#lxc-attach alpine12   #进入lxc容器
~ # ifconfig
eth0      Link encap:Ethernet  HWaddr 00:16:3E:DF:9E:45
          inet addr:10.0.1.51  Bcast:10.0.1.255  Mask:255.255.255.0
          inet6 addr: fe80::216:3eff:fedf:9e45/64 Scope:Link
          UP BROADCAST RUNNING MULTICAST  MTU:1500  Metric:1
          RX packets:23 errors:0 dropped:0 overruns:0 frame:0
          TX packets:12 errors:0 dropped:0 overruns:0 carrier:0
          collisions:0 txqueuelen:1000
          RX bytes:2484 (2.4 KiB)  TX bytes:1726 (1.6 KiB)

lo        Link encap:Local Loopback
          inet addr:127.0.0.1  Mask:255.0.0.0
          inet6 addr: ::1/128 Scope:Host
          UP LOOPBACK RUNNING  MTU:65536  Metric:1
          RX packets:0 errors:0 dropped:0 overruns:0 frame:0
          TX packets:0 errors:0 dropped:0 overruns:0 carrier:0
          collisions:0 txqueuelen:1000
          RX bytes:0 (0.0 B)  TX bytes:0 (0.0 B)

~ # uname -r
4.15.0-29-generic
~ # uname -a
Linux alpine12 4.15.0-29-generic #31-Ubuntu SMP Tue Jul 17 15:39:52 UTC 2018 x86_64 Linux
~ # cat /etc/issue
Welcome to Alpine Linux 3.9
Kernel \r on an \m (\l)

~ # exit
[root@ubuntu1804 ~]#
命令备注 :
-t 模板: -t 选项后面跟的是模板, 模式可以认为是一个原型, 用来说明我们需要一个什么样的容器(比如容器里面需不需要有vim, apache等软件).模板实际上就是一个脚本文件(位于/usr/share/lxc/templates目录), 我们这里指定download模板(lxc-create会调用lxc-download脚本, 该脚本位于刚说的模板目录中)是说明我们目前没有自己模板, 需要下载官方的模板

--name 容器名称 :  为创建的容器命名

-- : --用来说明后面的参数是传递给download脚本的, 告诉脚本需要下载什么样的模板

--dist 操作系统名称 : 指定操作系统

--release 操作系统: 指定操作系统, 可以是各种Linux的变种

--arch 架构 : 指定架构, 是x86还是arm, 是32位还是64位
lxc启动容器依赖于模板, 清华模板源 : https://mirrors.tuna.tsinghua.edu.cn/help/lxc-images/, 但是做模板相对较难, 需要手动一步步创构建文件系统、准备基础目录及可执行程序等, 而且在大规模使用容器的场景很难横向扩展, 另外后期代码升级也需要重新从头构建模板, 基于以上种种原因便有了docker
6.2 docker
Docker启动一个容器也需要一个外部模板 , 也称为镜像 , docker的镜像可以保存在一个公共的地方共享使用 , 只要把镜像下载下来就可以使用 , 最主要的是可以在镜像基础之上做自定义配置并且可以再把其提交为一个镜像 , 一个镜像可以被启动为多个容器。
Docker的镜像是分层的 , 镜像底层为库文件且只读层即不能写入也不能删除数据 , 从镜像加载启动为一个容器后会生成一个可写层 ,其写入的数据会复制到宿主机上对应容器的目录 ,但是容器内的数据在删除容器后也会被随之删除。
6.3 pouch
项目网点 : https://github.com/alibaba/pouch
Pouch (小袋子)起源于 2011 年 , 并于2017年11月19日上午 , 在中国开源年会现场 , 阿里巴巴正式开源了基于 Apache 2.0 协议的容器技术 Pouch。Pouch 是一款轻量级的容器技术 , 拥有快速高效、可移植性高、资源占用少等特性 , 主要帮助阿里更快的做到内部业务的交付 , 同时提高超大规模下数据中心的物理资源利用率
目前的容器方案大多基于 Linux 内核提供的 cgroup和 namespace 来实现隔离 , 然后这样轻量级方案存在弊端 :
容器间 , 容器与宿主间 , 共享同一个内核
内核实现的隔离资源 , 维度不足
面对如此的内核现状 , 阿里巴巴采取了三个方面的工作 , 来解决容器的安全问题 :
用户态增强容器的隔离维度, 比如网络带宽、磁盘使用量等
给内核提交
patch, 修复容器的资源可见性问题 ,cgroup方面的bug实现基于
Hypervisor的容器 ,通过创建新内核来实现容器隔离
6.4 podman
虽然目前 Docker 是管理 Linux 容器最好的工具, 注意没有之一, 但是podman的横空出现即将改变这一点
什么是Podman?
Podman即Pod Manager tool, 从名称上可以看出和kubernets的pod的密切联系, 不过就其功能来说, 简而言之:
alias docker = podman是CentOS 8 新集成的功能, 或许不久的未来会代替docker
Podman是一个 为 Kubernetes 而生的开源的容器管理工具, 原来是 CRI-O(即容器运行时接口CRI 和开放容器计划OCI) 项目的一部分, 后来被分离成一个单独的项目叫 libpod。其可在大多数Linux平台上使用, 它是一种无守护程序的容器引擎 , 用于在Linux系统上开发, 管理和运行任何符合Open Container Initiative(OCI)标准的容器和容器镜像。
Podman 提供了一个与Docker兼容的命令行前端 , Podman 里面87%的指令都和Docker CLI 相同 , 因此可以简单地为Docker CLI别名, 即alias docker = podman , 事实上 , podman使用的一些库也是docker的一部分。
官网地址 : https://podman.io/
项目地址 : https://github.com/containers/libpod
6.5 Podman 和docker不同之处
docker需要在我们的系统上运行一个守护进程(docker daemon), 这会产生一定的开销, 而podman不需要启动容器的方式不同 :
docker cli命令通过API跟Docker Engine(引擎)交互告诉它我想创建一个container, 然后docker Engine才会调用OCI container runtime(runc)来启动一个container。这代表container的process(进程)不会是Docker CLI的child process(子进程), 而是Docker Engine的child process。Podman是直接给OCI containner runtime(runc)进行交互来创建container的, 所以container process直接是podman的child process。因为
docker有docker daemon, 所以docker启动的容器支持--restart策略, 但是podman不支持docker需要使用root用户来创建容器。 这可能会产生安全风险 , 尤其是当用户知道docker run命令的–privileged选项时。podman既可以由root用户运行, 也可以由非特权用户运行docker在Linux上作为守护进程运行扼杀了容器社区的创新。 如果要更改容器的工作方式, 则需要更改docker守护程序并将这些更改推送到上游。 没有守护进程 , 容器基础结构更加模块化, 更容易进行更改。podman的无守护进程架构更加灵活和安全。
参考链接 :
运维派:docker教程:名称空间 Namespace 技术
微信公众号:Linux内核那些事:songsong001Docker原理之 - OverlayFS设计与实现
Docker联合文件系统Union File System-DockerInfo
Docker-名称空间Namespace技术 - 运维派 (yunweipai.com)