
7-3-Elasticsearch 跨集群数据迁移方案总结
1. 准备集群源数据
创建 mapping:
PUT dumpindex
{
  "mappings": {
    "properties": {
      "name": {
        "type": "text"
      },
      "age": {
        "type": "integer"
      }
    }
  }
}
插入数据:
POST _bulk
{"index":{"_index":"dumpindex"}}
{"name":"tom","age":18}
{"index":{"_index":"dumpindex"}}
{"name":"jack","age":19}
{"index":{"_index":"dumpindex"}}
{"name":"bob","age":20}
2. elasticsearch-dump
elasticsearch-dump是一款开源的ES数据迁移工具 , github地址: https://github.com/taskrabbit/elasticsearch-dump
2.1安装 elasticsearch-dump
方式一
elasticsearch-dump使用node.js开发 , 可使用npm包管理工具直接安装:npm install elasticdump -g方式二
也可以之间通过启动制作好的
elasticsearch-dump docker容器来运行 , 需要通过-v参数挂载宿主机的目录到容器中docker run --rm -ti -v /root/elasticsearch-dump:/tmp elasticdump/elasticsearch-dump \ 加上命令例如:
docker run --rm -ti -v /root/elasticsearch-dump:/tmp elasticdump/elasticsearch-dump \
  --input=/tmp/dumpindex.json \  #这里input的文件是容器中的文件路径 , 宿主机上对应的就是/root/elasticsearch-dump/dumpindex.json文件
  --output=http://192.168.1.67:9200/dumpindex \
  --type=data
2.2 JSON 文件导入导出
2.2.1 将 Elasticsearch 数据导出到 JSON 文件
通过以下命令将 Elasticsearch 中的数据导出到 dumpindex_data.json 文件中。
docker run --rm -ti -v /root/elasticsearch-dump:/tmp elasticdump/elasticsearch-dump \
  --input=http://192.168.1.171:9200/dumpindex \
  --output=/tmp/dumpindex_data.json \
  --type=data
查看文件内容 , 包含了索引的数据信息:
[root@elastic1]# cat /root/elasticsearch-dump/dumpindex_data.json
{"_index":"dumpindex","_type":"_doc","_id":"q28kPngB8Nd5nYNvOgHd","_score":1,"_source":{"name":"tom","age":18}}
{"_index":"dumpindex","_type":"_doc","_id":"rG8kPngB8Nd5nYNvOgHd","_score":1,"_source":{"name":"jack","age":19}}
{"_index":"dumpindex","_type":"_doc","_id":"rW8kPngB8Nd5nYNvOgHd","_score":1,"_source":{"name":"bob","age":20}}
另外还需要导出索引的 mapping , 如果直接将前面的数据到新的 Elasticsearch 集群 , 新集群会根据数据自动生成 mapping , 有可能和源集群的 mapping 不一致:
docker run --rm -ti -v /root/elasticsearch-dump:/tmp elasticdump/elasticsearch-dump \
  --input=http://192.168.1.171:9200/dumpindex \
  --output=/tmp/dumpindex_mapping.json \
   --type=mapping
查看导出的 mapping 文件内容:
[root@elastic1 ~]# cat /root/elasticsearch-dump/dumpindex_mapping.json
{"dumpindex":{"mappings":{"properties":{"age":{"type":"integer"},"name":{"type":"text"}}}}}
2.2.2 将 JSON 文件数据导入 Elasticsearch
首先导入 mapping 信息:
docker run --rm -ti -v /root/elasticsearch-dump:/tmp elasticdump/elasticsearch-dump \
  --input=/tmp/dumpindex_mapping.json \
  --output=http://192.168.1.67:9200/dumpindex \
   --type=mapping
然后导入数据:
docker run --rm -ti -v /root/elasticsearch-dump:/tmp elasticdump/elasticsearch-dump \
  --input=/tmp/dumpindex_data.json \
  --output=http://192.168.1.67:9200/dumpindex \
--type=data查看新集群上该索引的mapping信息 , 和源集群的一致:
GET dumpindex/_mapping

#输出结果
{
  "dumpindex" : {
    "mappings" : {
      "properties" : {
        "age" : {
          "type" : "integer"
        },
        "name" : {
          "type" : "text"
        }
      }
    }
  }
}
查看新集群的数据 , 也和源集群的一致:
GET dumpindex/_search

#输出结果
{
  "took" : 3,
  "timed_out" : false,
  "_shards" : {
    "total" : 1,
    "successful" : 1,
    "skipped" : 0,
    "failed" : 0
  },
  "hits" : {
    "total" : {
      "value" : 3,
      "relation" : "eq"
    },
    "max_score" : 1.0,
    "hits" : [
      {
        "_index" : "dumpindex",
        "_type" : "_doc",
        "_id" : "rW8kPngB8Nd5nYNvOgHd",
        "_score" : 1.0,
        "_source" : {
          "name" : "bob",
          "age" : 20
        }
      },
      {
        "_index" : "dumpindex",
        "_type" : "_doc",
        "_id" : "rG8kPngB8Nd5nYNvOgHd",
        "_score" : 1.0,
        "_source" : {
          "name" : "jack",
          "age" : 19
        }
      },
      {
        "_index" : "dumpindex",
        "_type" : "_doc",
        "_id" : "q28kPngB8Nd5nYNvOgHd",
        "_score" : 1.0,
        "_source" : {
          "name" : "tom",
          "age" : 18
        }
      }
    ]
  }
}
2.3 CSV 文件导入导出
2.3.1 将 Elasticsearch 数据导出到 CSV 文件
2.3.1.1 方式一
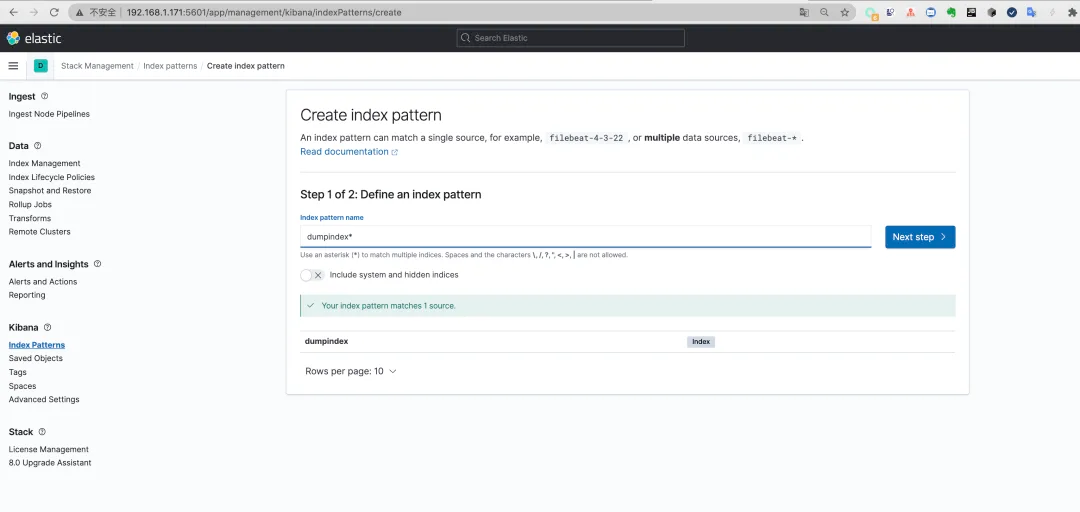
打开 Kibana 界面 , 创建 Index Pattern , 然后在 Discover 中就可以看到该索引。
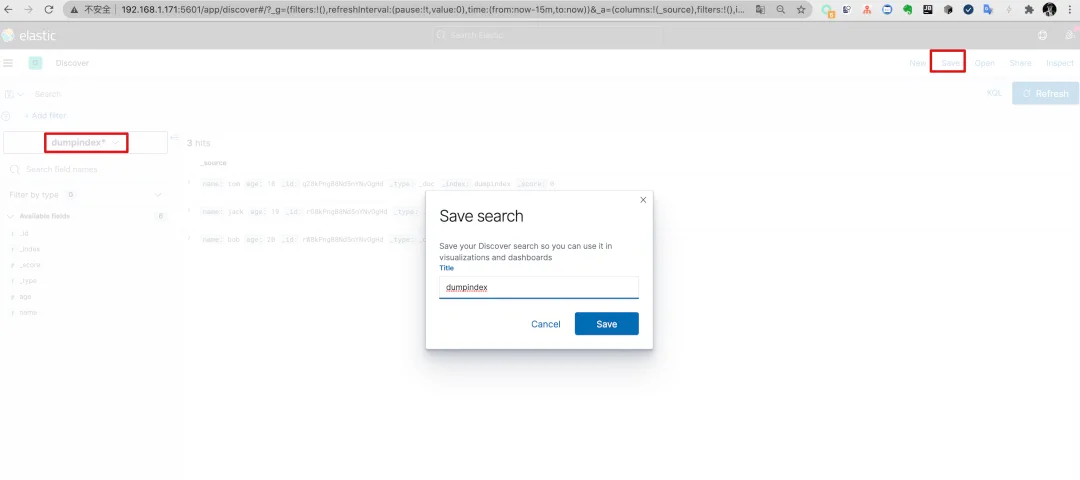
然后创建一个 Save Search 任务:
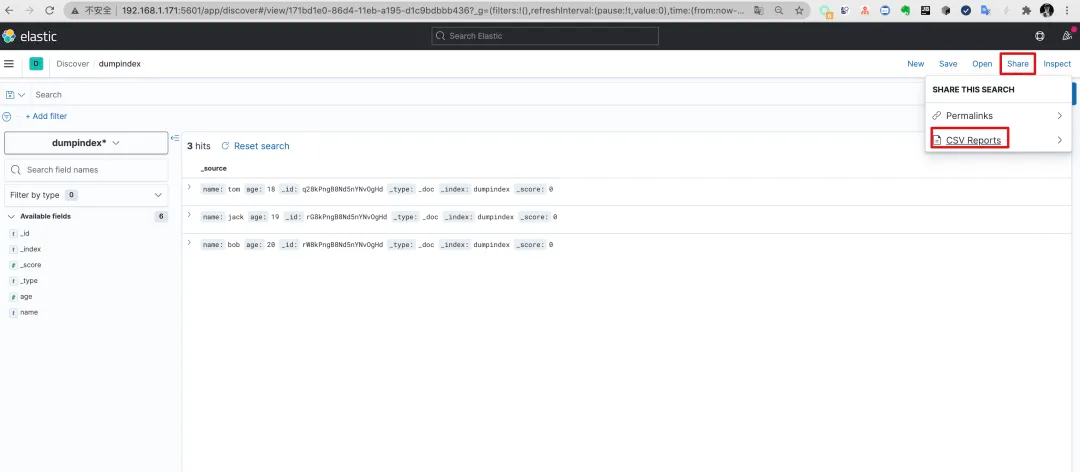
创建完任务后 , 选择生成 CSV 文件:
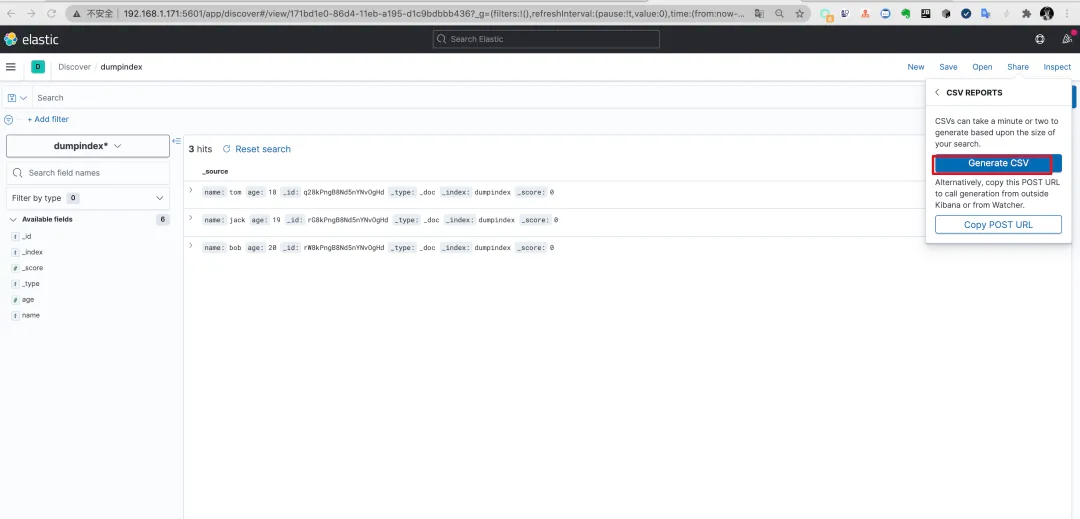
可以在 Reports 中下载生成的 CSV 文件:
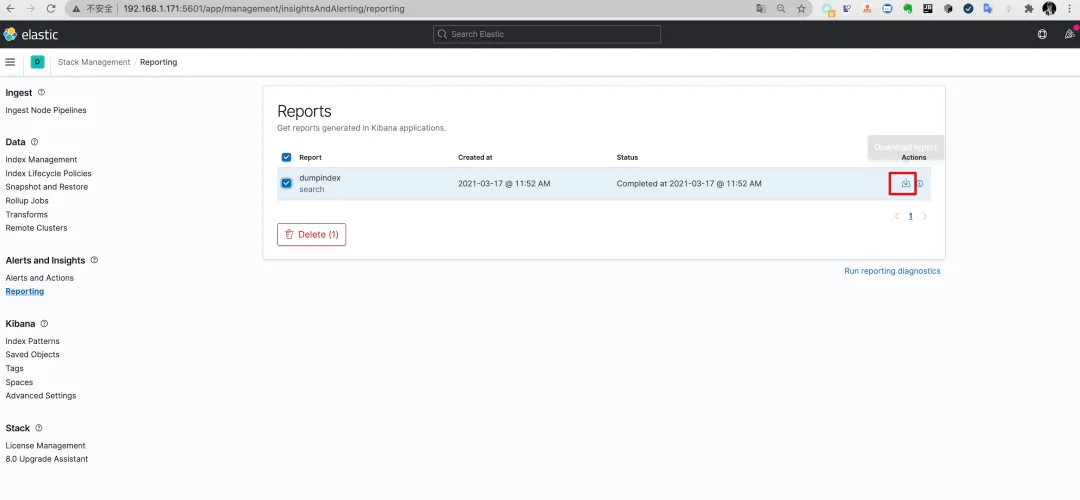
查看导出的 CSV 文件:
❯ cat dumpindex.csv
"_id","_index","_score","_type",age,name
q28kPngB8Nd5nYNvOgHd,dumpindex,0,"_doc",18,tom
rG8kPngB8Nd5nYNvOgHd,dumpindex,0,"_doc",19,jack
rW8kPngB8Nd5nYNvOgHd,dumpindex,0,"_doc",20,bob
2.3.1.2 方式二
通过 elasticsearch-dump 命令导出成 CSV 文件:
docker run --rm -ti -v /root/elasticsearch-dump:/tmp elasticdump/elasticsearch-dump \
  --input=http://192.168.1.171:9200/dumpindex \
  --output="csv:///tmp/dumpindex.csv"
查看导出的 CSV 文件:
[root@elastic1 ~]# cat /root/elasticsearch-dump/dumpindex.csv
name,age,@id,@index,@type
tom,18,q28kPngB8Nd5nYNvOgHd,dumpindex,_doc
jack,19,rG8kPngB8Nd5nYNvOgHd,dumpindex,_doc
bob,20,rW8kPngB8Nd5nYNvOgHd,dumpindex,_doc
2.3.2 将 CSV 文件数据导入 Elasticsearch
这里需要注意的是 , 通过 elasticsearch-dump 命令导出的 CSV 文件可以直接用该命令导入 Elasticsearch。但是通过 Kibana 导出的 CSV 文件需要先将第一行(表头)的 "_id","_index","_score","_type" 修改成自定义的其他字段(elasticsearch-dump是改成了@开头)才可以进行导入(因为这些字段是Elasticsearch内置的字段)。
docker run --rm -ti -v /root/elasticsearch-dump:/tmp elasticdump/elasticsearch-dump \
  --input "csv:///tmp/dumpindex.csv" \
  --output=http://192.168.1.67:9200/dumpindex \
  --csvSkipRows 1    #第一行(表头)不作为数据导入
查看导入后的数据 , 可以看到之前的 _id 等字段 , 其实变成了 @id , 索引真正的 _id 是改变了的。因此不推荐使用通过 CSV 的方式导入导出数据。
GET dumpindex/_search

#输出结果
{
  "took" : 0,
  "timed_out" : false,
  "_shards" : {
    "total" : 1,
    "successful" : 1,
    "skipped" : 0,
    "failed" : 0
  },
  "hits" : {
    "total" : {
      "value" : 2,
      "relation" : "eq"
    },
    "max_score" : 1.0,
    "hits" : [
      {
        "_index" : "dumpindex",
        "_type" : "_doc",
        "_id" : "W9OmPngBcQzbxUdL_4fB",
        "_score" : 1.0,
        "_source" : {
          "name" : "bob",
          "age" : "20",
          "@id" : "rW8kPngB8Nd5nYNvOgHd",
          "@index" : "dumpindex",
          "@type" : "_doc"
        }
      },
      {
        "_index" : "dumpindex",
        "_type" : "_doc",
        "_id" : "XNOmPngBcQzbxUdL_4fB",
        "_score" : 1.0,
        "_source" : {
          "name" : "jack",
          "age" : "19",
          "@id" : "rG8kPngB8Nd5nYNvOgHd",
          "@index" : "dumpindex",
          "@type" : "_doc"
        }
      }
    ]
  }
}
2.4 Elasticsearch 集群间互导数据
前面将 Elasticsearch 集群中的数据导出文件 , 然后再通过文件将数据导入新的 Elasticsearch 集群的做法适合两个集群间网络不通的情况。如果两个集群的网络相通 , 可以通过下面更简便的方式直接在两个集群间互导数据:
先导出mapping到新集群
docker run --rm -ti elasticdump/elasticsearch-dump \
  --input=http://192.168.1.171:9200/dumpindex \
  --output=http://192.168.1.67:9200/dumpindex \
  --type=mapping
然后导出数据到新集群:
docker run --rm -ti elasticdump/elasticsearch-dump \
  --input=http://192.168.1.171:9200/dumpindex \
  --output=http://192.168.1.67:9200/dumpindex \
  --type=data
2.5 查询过滤导入导出数据
可以通过查询语句过滤要迁移的数据:
docker run --rm -ti elasticdump/elasticsearch-dump \
  --input=http://192.168.1.171:9200/dumpindex \
  --output=http://192.168.1.67:9200/dumpindex \
  --searchBody="{\"query\":{\"match\":{\"name\": \"tom\"}}}"
查看新集群的数据:
GET dumpindex/_search

#输出结果
{
  "took" : 2,
  "timed_out" : false,
  "_shards" : {
    "total" : 1,
    "successful" : 1,
    "skipped" : 0,
    "failed" : 0
  },
  "hits" : {
    "total" : {
      "value" : 1,
      "relation" : "eq"
    },
    "max_score" : 1.0,
    "hits" : [
      {
        "_index" : "dumpindex",
        "_type" : "_doc",
        "_id" : "q28kPngB8Nd5nYNvOgHd",
        "_score" : 1.0,
        "_source" : {
          "name" : "tom",
          "age" : 18
        }
      }
    ]
  }
}
2.6 MultiElasticDump
multielasticdump 在 elasticdump 的基础上做了一层封装 , 可以同时 fork 出多个子线程(默认情况下是主机的CPU数量)并行对多个索引进行操作。
--input必须是URL , --output必须是文件名 , 也就是说只能将数据从 Elasticsearch 导出到文件中。导出的文件默认包含索引的 data , mapping , setting , template。
正则表达式匹配并导出 Elasticsearch 中 dumpindex.* 的索引:
docker run --rm -ti -v /root/elasticsearch-dump:/tmp elasticdump/elasticsearch-dump \
multielasticdump \
  --direction=dump \
  --match='dumpindex.*' \  #支持通过正则表达式匹配索引
  --input=http://192.168.1.171:9200 \
  --output=/tmp
查看导出的文件:
[root@elastic1 ~]# ll elasticsearch-dump/total 32
-rw-r--r--. 1 root root  343 Mar 17 13:35 dumpindex2.json
-rw-r--r--. 1 root root  149 Mar 17 13:35 dumpindex2.mapping.json
-rw-r--r--. 1 root root  187 Mar 17 13:35 dumpindex2.settings.json
-rw-r--r--. 1 root root 1581 Mar 17 13:35 dumpindex2.template.json
-rw-r--r--. 1 root root  337 Mar 17 13:35 dumpindex.json
-rw-r--r--. 1 root root   92 Mar 17 13:35 dumpindex.mapping.json
-rw-r--r--. 1 root root  186 Mar 17 13:35 dumpindex.settings.json
-rw-r--r--. 1 root root 1581 Mar 17 13:35 dumpindex.template.json
可以通过 elasticdump 将文件数据导入 Elasticsearch 中。
2.7. 用户认证
如果 Elasticsearch 需要认证用户名密码 , 可以通过如下方式指定:
--input=http://username:password@192.168.1.171:9200/my_index3. Reindex
首先需要在目标 Elasticsearch 集群中配置白名单 , 编辑 elasticsearch.yml 文件 , 然后重新启动集群:
reindex.remote.whitelist: 192.168.1.171:9200在目标集群上执行 reindex 命令:
POST _reindex
{
  "source": {
    "remote": {
      "host": "http://192.168.1.171:9200"
      #如果需要用户认证
      #"username": "user",
      #"password": "pass",
    },
    "index": "kibana_sample_data_flights"
    # 也支持通过查询语句过滤
  },
  "dest": {
    "index": "kibana_sample_data_flights"
  }
}
筛选出 reindex 任务:
GET _tasks?actions=*reindex查询具体 reindex 任务的执行情况:
GET _tasks/pMrJwVGSQcSgeTZdh61QRw:14134. Snapshot
Snapshot API 是 Elasticsearch 用于对数据进行备份和恢复的一组 API 接口 , 可以通过 Snapshot API 进行跨集群的数据迁移 , 原理就是从源 Elasticsearch 集群创建数据快照 , 然后在目标 Elasticsearch 集群中进行恢复。
4.1 第一步: 在源集群注册 Repository
创建快照前先要注册 Repository , 一个 Repository 可以包含多份快照文件 , Repository 主要有以下几种类型:
fs: 共享文件系统 , 将快照文件存放于文件系统中
url: 指定文件系统的URL路径 , 支持协议: http,https,ftp,file,jar
s3: AWS S3对象存储,快照存放于S3中 , 以插件形式支持
hdfs: 快照存放于hdfs中 , 以插件形式支持
azure: 快照存放于azure对象存储中 , 以插件形式支持
gcs: 快照存放于google cloud对象存储中 , 以插件形式支持
4.1.1 搭建 NFS 服务器
我们这里选择共享文件系统的方式作为 Repository , 首先部署一台 NFS 服务器 , 用于文件共享。
安装 NFS:
yum install -y nfs-utils
systemctlenable nfs.service --now
创建相关目录:
mkdir /home/elasticsearch/snapshot
chmod 777 /home/elasticsearch/snapshot
编辑
NFS配置文件/etc/exports:# rw 读写权限 , sync 同步写入硬盘 /home/elasticsearch/snapshot 192.168.1.0/24(rw,sync)修改完成后重新
NFS服务:systemctl restart nfs
4.1.2 Elasticsearch 集群主机挂载 NFS 文件系统
编辑
/etc/fstab文件 , 添加如下内容:192.168.1.65:/home/elasticsearch/snapshot /home/elasticsearch/snapshot/ nfs defaults 0 0编辑完成后执行
mount命令挂载:[root@elastic1 ~]# mount -a # 查看挂载点 [root@elastic1 ~]# df -hT Filesystem Type Size Used Avail Use% Mounted on ... 192.168.1.65:/home/elasticsearch/snapshot nfs 142G 39M 142G 1% /home/elasticsearch/snapshot
4.1.3 修改 Elasticsearch 配置文件
编辑
elasticsearch.yml文件 , 添加如下内容:path.repo: ["/home/elasticsearch/snapshot"]添加完成后重启
Elasticsearch, 然后通过如下命令可以验证是否添加repo目录成功:GET _cluster/settings?include_defaults&filter_path=*.path.repo # 输出结果 { "defaults" : { "path" : { "repo" : [ "/home/elasticsearch/snapshot" ] } } }
4.1.4 注册 Repository
注册一个名为
dumpindex的Repository:PUT /_snapshot/my_fs_backup { "type": "fs", "settings": { "location": "/home/elasticsearch/snapshot/dumpindex", #可以就写dumpindex , 相对路径 "compress": true } }查看
Repository在各个节点上的注册情况:POST _snapshot/my_fs_backup/_verify #输出结果 { "nodes" : { "MjS0guiLSMq3Oouh008uSg" : { "name" : "elastic3" }, "V-UXoQMkQYWi5RvkjcO_yw" : { "name" : "elastic2" }, "9NPH3gJoQAWfgEovS8ww4w" : { "name" : "elastic4" }, "gdUSuXuhQ7GvPogi0RqvDw" : { "name" : "elastic1" } } }
4.2 第二步: 在源集群注册创建快照
indices: 做快照的索引。wait_for_completion=true: 是否等待完成快照后再响应 , 如果为true会等快照完成后才响应。(默认为false, 不等快照完成立即响应)ignore_unavailable: 设置为true时 , 当创建快照时忽略不存在的索引。include_global_state: 设置为false时 , 当某个索引所有的主分片不是全部的都可用时 , 可以完成快照。
通过如下命令指定对 dumpindex 索引做快照:
PUT _snapshot/my_fs_backup/snapshot_1?wait_for_completion=true
{
  "indices": "dumpindex",
   "ignore_unavailable": true,
   "include_global_state": false
}

# 输出结果
{
  "snapshot" : {
    "snapshot" : "snapshot_1",
    "uuid" : "cTvmz15pQzedDE-fHbzsCQ",
    "version_id" : 7110199,
    "version" : "7.11.1",
    "indices" : [
      "dumpindex"
    ],
    "data_streams" : [ ],
    "include_global_state" : false,
    "state" : "SUCCESS",
    "start_time" : "2021-03-17T14:33:20.866Z",
    "start_time_in_millis" : 1615991600866,
    "end_time" : "2021-03-17T14:33:21.067Z",
    "end_time_in_millis" : 1615991601067,
    "duration_in_millis" : 201,
    "failures" : [ ],
    "shards" : {
      "total" : 1,
      "failed" : 0,
      "successful" : 1
    }
  }
}
在前面注册 Repository 的目录下可以看到生成了相关的快照文件:
[elasticsearch@elastic1 ~]$ ll /home/elasticsearch/snapshot/dumpindex/
total 16
-rw-rw-r--. 1 elasticsearch elasticsearch 439 Mar 17 22:18 index-0
-rw-rw-r--. 1 elasticsearch elasticsearch   8 Mar 17 22:18 index.latest
drwxrwxr-x. 3 elasticsearch elasticsearch  36 Mar 17 22:18 indices
-rw-rw-r--. 1 elasticsearch elasticsearch 193 Mar 17 22:18 meta-cTvmz15pQzedDE-fHbzsCQ.dat
-rw-rw-r--. 1 elasticsearch elasticsearch 252 Mar 17 22:18 snap-cTvmz15pQzedDE-fHbzsCQ.dat
4.3 第三步: 在目标集群注册 Repository
和在源集群注册的方式一样 , 修改 elasicsearch.yml 配置文件 , 并且通过下面命令注册 Repository:
PUT _snapshot/my_fs_backup
{
    "type": "fs",
    "settings": {
        "location": "/home/elasticsearch/snapshot/dumpindex",
        "compress": true
    }
}
将源集群生成的快照文件拷贝到目标集群的 Repository 目录下:
[elasticsearch@elastic1 ~]$ scp -r /home/elasticsearch/snapshot/dumpindex/* elasticsearch@192.168.1.67:/home/elasticsearch/snapshot/dumpindex/4.4 第四步: 在目标集群上将快照导入索引
在目标集群上查看快照信息:
GET _snapshot/my_fs_backup/snapshot_1

# 输出结果
{
  "snapshots" : [
    {
      "snapshot" : "snapshot_1",
      "uuid" : "cTvmz15pQzedDE-fHbzsCQ",
      "version_id" : 7110199,
      "version" : "7.11.1",
      "indices" : [
        "dumpindex"
      ],
      "data_streams" : [ ],
      "include_global_state" : false,
      "state" : "SUCCESS",
      "start_time" : "2021-03-17T14:33:20.866Z",
      "start_time_in_millis" : 1615991600866,
      "end_time" : "2021-03-17T14:33:21.067Z",
      "end_time_in_millis" : 1615991601067,
      "duration_in_millis" : 201,
      "failures" : [ ],
      "shards" : {
        "total" : 1,
        "failed" : 0,
        "successful" : 1
      }
    }
  ]
}
将快照导入目标集群的 dumpindex 索引中:
POST _snapshot/my_fs_backup/snapshot_1/_restore
{
  "indices": "dumpindex"
}
查看索引数据 , 可以看到和源集群的一致:
{
  "took" : 3,
  "timed_out" : false,
  "_shards" : {
    "total" : 1,
    "successful" : 1,
    "skipped" : 0,
    "failed" : 0
  },
  "hits" : {
    "total" : {
      "value" : 3,
      "relation" : "eq"
    },
    "max_score" : 1.0,
    "hits" : [
      {
        "_index" : "dumpindex",
        "_type" : "_doc",
        "_id" : "q28kPngB8Nd5nYNvOgHd",
        "_score" : 1.0,
        "_source" : {
          "name" : "tom",
          "age" : 18
        }
      },
      {
        "_index" : "dumpindex",
        "_type" : "_doc",
        "_id" : "rG8kPngB8Nd5nYNvOgHd",
        "_score" : 1.0,
        "_source" : {
          "name" : "jack",
          "age" : 19
        }
      },
      {
        "_index" : "dumpindex",
        "_type" : "_doc",
        "_id" : "rW8kPngB8Nd5nYNvOgHd",
        "_score" : 1.0,
        "_source" : {
          "name" : "bob",
          "age" : 20
        }
      }
    ]
  }
}
5. Logstash
Logstash支持从一个 Elasticsearch 集群中读取数据然后写入到另一个 Elasticsearch 集群:
编辑 conf/logstash.conf文件:
input {
    elasticsearch {
        hosts => ["http://192.168.1.171:9200"]
        index => "dumpindex"
        #如果需要用户认证
        #user => "username"
        #password => "password"
    }
}
output {
    elasticsearch {
        hosts => ["http://192.168.1.67:9200"]
        index => "dumpindex"
    }
}
启动 Logstash:
[elasticsearch@es1 logstash-7.11.1]$ bin/logstash -f config/logstash.conf 在目标集群上查看 dumpindex 索引数据 , 可以看到和源集群一致:
GET dumpindex/_search

# 输出结果
{
  "took" : 3,
  "timed_out" : false,
  "_shards" : {
    "total" : 1,
    "successful" : 1,
    "skipped" : 0,
    "failed" : 0
  },
  "hits" : {
    "total" : {
      "value" : 3,
      "relation" : "eq"
    },
    "max_score" : 1.0,
    "hits" : [
      {
        "_index" : "dumpindex",
        "_type" : "_doc",
        "_id" : "jrfpQHgBERNPF_kwE-Jk",
        "_score" : 1.0,
        "_source" : {
          "@version" : "1",
          "name" : "tom",
          "@timestamp" : "2021-03-17T15:58:39.423Z",
          "age" : 18
        }
      },
      {
        "_index" : "dumpindex",
        "_type" : "_doc",
        "_id" : "j7fpQHgBERNPF_kwE-Jk",
        "_score" : 1.0,
        "_source" : {
          "@version" : "1",
          "name" : "jack",
          "@timestamp" : "2021-03-17T15:58:39.440Z",
          "age" : 19
        }
      },
      {
        "_index" : "dumpindex",
        "_type" : "_doc",
        "_id" : "kLfpQHgBERNPF_kwE-Jk",
        "_score" : 1.0,
        "_source" : {
          "@version" : "1",
          "name" : "bob",
          "@timestamp" : "2021-03-17T15:58:39.440Z",
          "age" : 20
        }
      }
    ]
  }
}
参考链接
Elasticsearch 跨集群数据迁移方案总结 (qq.com)