4-Prometheus Operator原理与实践
1. Prometheus介绍
为了在Kubernetes中能够方便管理和部署Prometheus , 我们使用ConfigMap管理Prometheus配置文件。每次对Prometheus配置文件进行升级时 , 我们需要手动移除已经运行的Pod实例 , 从而让Kubernetes可以使用最新的配置文件创建Prometheus。而如果当应用实例的数量更多时 , 通过手动的方式部署和升级Prometheus过程繁琐并且效率低下。
从本质上来讲Prometheus属于是典型的有状态应用 , 而其有包含了一些自身特有的运维管理和配置管理方式。而这些都无法通过Kubernetes原生提供的应用管理概念实现自动化。为了简化这类应用程序的管理复杂度 , CoreOS率先引入了Operator的概念 , 并且首先推出了针对在Kubernetes下运行和管理Etcd的Etcd Operator。并随后推出了Prometheus Operator。
从概念上来讲Operator就是针对管理特定应用程序的 , 在Kubernetes基本的Resource和Controller的概念上 , 以扩展Kubernetes api的形式。帮助用户创建 , 配置和管理复杂的有状态应用程序。从而实现特定应用程序的常见操作以及运维自动化。
在Kubernetes中我们使用Deployment、DamenSet , StatefulSet来管理应用Workload , 使用Service , Ingress来管理应用的访问方式 , 使用ConfigMap和Secret来管理应用配置。
我们在集群中对这些资源的创建 , 更新 , 删除的动作都会被转换为事件(Event) , Kubernetes的Controller Manager负责监听这些事件并触发相应的任务来满足用户的期望。这种方式我们成为声明式 , 用户只需要关心应用程序的最终状态 , 其它的都通过Kubernetes来帮助我们完成 , 通过这种方式可以大大简化应用的配置管理复杂度。
而除了这些原生的Resource资源以外 , Kubernetes还允许用户添加自己的自定义资源(Custom Resource)。并且通过实现自定义Controller来实现对Kubernetes的扩展。
如下所示 , 是Prometheus Operator的架构示意图 :
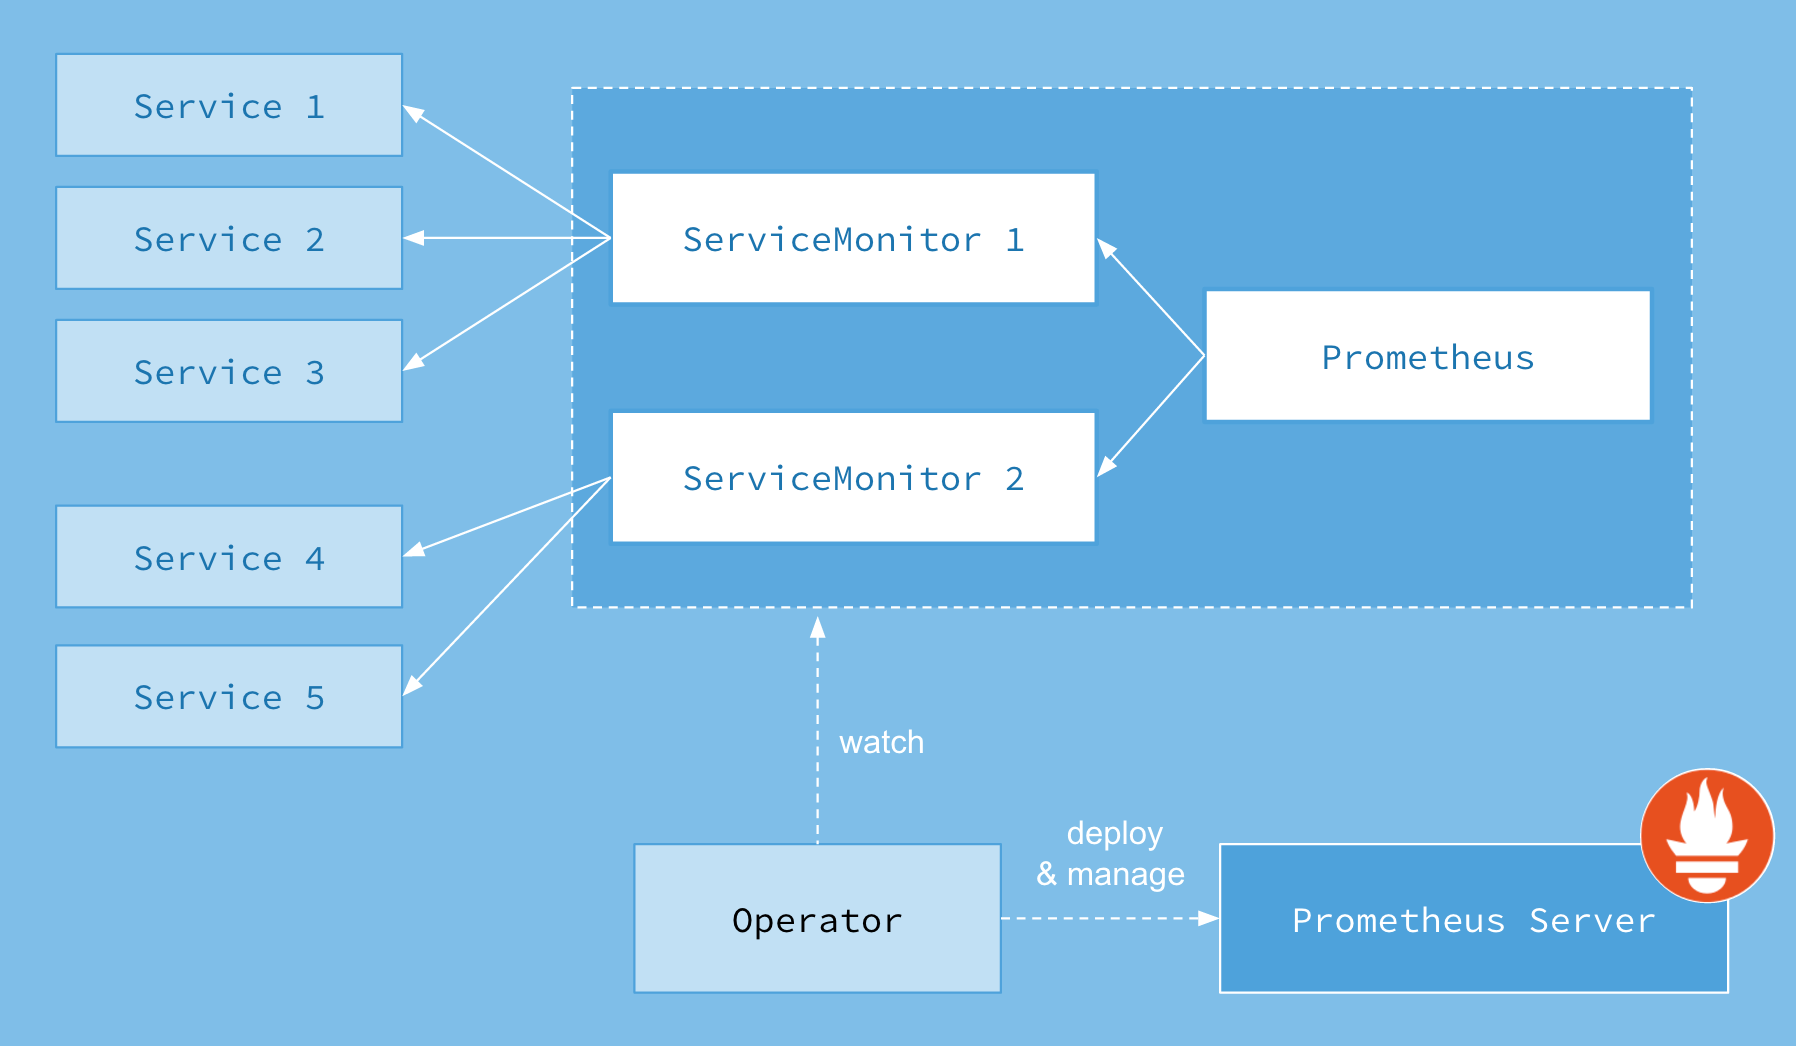
Prometheus的本职就是一组用户自定义的CRD资源以及Controller的实现 , Prometheus Operator负责监听这些自定义资源的变化 , 并且根据这些资源的定义自动化的完成如Prometheus Server自身以及配置的自动化管理工作。
要了解Prometheus Operator能做什么 , 其实就是要了解Prometheus Operator为我们提供了哪些自定义的Kubernetes资源 , 在最新版本的 Operator 中提供了一下几个 CRD 资源对象 :
Prometheus( 和我们之前的Prometheus不一样 , 之前的Prometheus是deployment部署的应用 , 这个地方是对象 )AlertmanagerServiceMonitor( 关联一些对应的service ,service后面就是endpoint, 它会将具有监控服务的关联到servicemonitor这边来 , 当你去创建 , 修改 , 删除的时候 ,operator就会watch到 ,watch到之后就会将目标重新更新到Prometheus里面去 , 这样就可以对数据抓取 , 监控 )PodMonitor( 有些pod未必有对应的service, 比如Job和cronjob这些 , 如果你想监控job管理的pod那么你可以使用这个 )Probe( 黑盒监控 )ThanosRulerPrometheusRule( 报警规则 )AlertmanagerConfig
Prometheus
该 CRD 声明定义了 Prometheus 期望在 Kubernetes 集群中运行的配置 , 提供了配置选项来配置副本、持久化、报警实例等。
对于每个 Prometheus CRD 资源 , Operator 都会以 StatefulSet 形式在相同的命名空间下部署对应配置的资源 , Prometheus Pod 的配置是通过一个包含 Prometheus 配置的名为 <prometheus-name> 的 Secret 对象声明挂载的。 ( 它的配置是以secret形式自动生成挂载进去的 ) 。
该 CRD 根据标签选择来指定部署的 Prometheus 实例应该覆盖哪些 ServiceMonitors ( 能够监听哪些servicemonitor ) , 然后 Operator 会根据包含的 ServiceMonitors 生成配置 , 并在包含配置的 Secret 中进行更新。 ( 如果没有生效 , 那么很有可能Prometheus没有和servicemonitor关联上 ) 。
如果未提供对 ServiceMonitor 的选择 , 则 Operator 会将 Secret 的管理留给用户 , 这样就可以提供自定义配置 , 同时还能享受 Operator 管理 Operator 的设置能力。
Alertmanager
该 CRD 定义了在 Kubernetes 集群中运行的 Alertmanager 的配置 , 同样提供了多种配置 , 包括持久化存储。
对于每个 Alertmanager 资源 , Operator 都会在相同的命名空间中部署一个对应配置的 StatefulSet , Alertmanager Pods 被配置为包含一个名为 <alertmanager-name> 的 Secret , 该 Secret 以 alertmanager.yaml 为 key 的方式保存使用的配置文件。
当有两个或更多配置的副本时 , Operator 会在高可用模式下运行 Alertmanager 实例。
ThanosRuler
该 CRD 定义了一个 Thanos Ruler 组件的配置 , 以方便在 Kubernetes 集群中运行。通过 Thanos Ruler , 可以跨多个 Prometheus 实例处理记录和警报规则。
一个 ThanosRuler 实例至少需要一个 queryEndpoint , 它指向 Thanos Queriers 或 Prometheus 实例的位置。queryEndpoints 用于配置 Thanos 运行时的 --query 参数 , 更多信息也可以在 Thanos 文档中找到。
ServiceMonitor
该 CRD 定义了如何监控一组动态的服务 , 使用标签选择来定义哪些 Service 被选择进行监控。这可以让团队制定一个如何暴露监控指标的规范 , 然后按照这些规范自动发现新的服务 , 而无需重新配置。
为了让 Prometheus 监控 Kubernetes 内的任何应用 , 需要存在一个 Endpoints 对象 , Endpoints 对象本质上是 IP 地址的列表 , 通常 Endpoints 对象是由 Service 对象来自动填充的 , Service 对象通过标签选择器匹配 Pod , 并将其添加到 Endpoints 对象中。一个 Service 可以暴露一个或多个端口 , 这些端口由多个 Endpoints 列表支持 , 这些端点一般情况下都是指向一个 Pod。
Prometheus Operator 引入的这个 ServiceMonitor 对象就会发现这些 Endpoints 对象 , 并配置 Prometheus 监控这些 Pod。ServiceMonitorSpec 的 endpoints 部分就是用于配置这些 Endpoints 的哪些端口将被 scrape 指标的。
注意 : endpoints ( 小写 ) 是 ServiceMonitor CRD 中的字段 , 而 Endpoints ( 大写 ) 是 Kubernetes 的一种对象。
ServiceMonitors 以及被发现的目标都可以来自任何命名空间 , 这对于允许跨命名空间监控的场景非常重要。使用 PrometheusSpec 的 ServiceMonitorNamespaceSelector , 可以限制各自的 Prometheus 服务器选择的 ServiceMonitors 的命名空间。使用 ServiceMonitorSpec 的 namespaceSelector , 可以限制 Endpoints 对象被允许从哪些命名空间中发现 , 要在所有命名空间中发现目标 , namespaceSelector 必须为空 :
spec: namespaceSelector: any: truePodMonitor
该 CRD 用于定义如何监控一组动态 pods , 使用标签选择来定义哪些 pods 被选择进行监控。同样团队中可以制定一些规范来暴露监控的指标。
Pod 是一个或多个容器的集合 , 可以在一些端口上暴露 Prometheus 指标。由 Prometheus Operator 引入的 PodMonitor 对象会发现这些 Pod , 并为 Prometheus 服务器生成相关配置 , 以便监控它们。
PodMonitorSpec 中的 PodMetricsEndpoints 部分 , 用于配置 Pod 的哪些端口将被 scrape 指标 , 以及使用哪些参数。
PodMonitors 和发现的目标可以来自任何命名空间 , 这同样对于允许跨命名空间的监控用例是很重要的。使用 PodMonitorSpec 的 namespaceSelector , 可以限制 Pod 被允许发现的命名空间 , 要在所有命名空间中发现目标 , namespaceSelector 必须为空 :
spec: namespaceSelector: any: truePodMonitor 和 ServieMonitor 最大的区别就是不需要有对应的 Service。
Probe
该 CRD 用于定义如何监控一组 Ingress 和静态目标。除了 target 之外 , Probe 对象还需要一个 prober , 它是监控的目标并为 Prometheus 提供指标的服务。例如可以通过使用 blackbox-exporter来提供这个服务。
PrometheusRule
用于配置 Prometheus 的 Rule 规则文件 , 包括 recording rules 和 alerting , 可以自动被 Prometheus 加载。 ( 以前我们创建了之后 , 需要重新加载Prometheus , 现在直接使用这个对象就可以 )
AlertmanagerConfig
在以前的版本中要配置 Alertmanager 都是通过 Configmap 来完成的 , 在 v0.43 版本后新增该 CRD , 可以将 Alertmanager 的配置分割成不同的子对象进行配置 , 允许将报警路由到自定义 Receiver 上 , 并配置抑制规则。
AlertmanagerConfig 可以在命名空间级别上定义 , 为 Alertmanager 提供一个聚合的配置。不过需要注意这个 CRD 还不稳定。
这样我们要在集群中监控什么数据 , 就变成了直接去操作 Kubernetes 集群的资源对象了 , 是这样比之前手动的方式就方便很多了。 ( 之前都是去管理configmap , 管理我们配置 , 现在直接管理我们的crd对象 )
简言之 , Prometheus Operator 能够帮助用户自动化的创建以及管理Prometheus Server以及其相应的配置。
2. 部署Prometheus Operator
以下步骤均在k8s的master节点操作
在Kubernetes中安装Prometheus Operator非常简单 , 用户可以从以下地址中过去Prometheus Operator的源码 :
git clone https://github.com/prometheus-operator/prometheus-operator.git这里 , 我们为Promethues Operator创建一个单独的命名空间monitoring :
kubectl create namespace monitoring由于需要对Prometheus Operator进行RBAC授权 , 而默认的bundle.yaml中使用了default命名空间 , 因此 , 在安装Prometheus Operator之前需要先替换一下bundle.yaml文件中所有namespace定义 , 由default修改为monitoring。通过运行一下命令安装Prometheus Operator的Deployment实例 :
cd prometheus-operator/
sed -i.bak -E  's/(namespace: )default/\1monitoring/' bundle.yaml
kubectl create -f bundle.yaml这里如果使用kubectl apply -f bundle.yaml时, 可能会出现如下错误, 这里直接替换为上面命令中的kubectl create -f bundle.yaml即可
Error from server (Invalid): error when creating "bundle.yaml": CustomResourceDefinition.apiextensions.k8s.io "alertmanagers.monitoring.coreos.com" is invalid: metadata.annotations: Too long: must have at most 262144 bytes
Error from server (Invalid): error when creating "bundle.yaml": CustomResourceDefinition.apiextensions.k8s.io "prometheusagents.monitoring.coreos.com" is invalid: metadata.annotations: Too long: must have at most 262144 bytes
Error from server (Invalid): error when creating "bundle.yaml": CustomResourceDefinition.apiextensions.k8s.io "prometheuses.monitoring.coreos.com" is invalid: metadata.annotations: Too long: must have at most 262144 bytes
Error from server (Invalid): error when creating "bundle.yaml": CustomResourceDefinition.apiextensions.k8s.io "thanosrulers.monitoring.coreos.com" is invalid: metadata.annotations: Too long: must have at most 262144 bytes
使用以下命令查看
root@k8s-master01:/opt/k8s-data/yaml/cbear/promethues/prometheus-operator/prometheus-operator# kubectl get pods -n monitoring
NAME READY STATUS RESTARTS AGE
prometheus-operator-69cbc6f76c-qfgkw 1/1 Running 0 12s
root@k8s-master01:/opt/k8s-data/yaml/cbear/promethues/prometheus-operator/prometheus-operator# kubectl get all -n monitoring
NAME READY STATUS RESTARTS AGE
pod/prometheus-operator-69cbc6f76c-qfgkw 1/1 Running 0 5m31s
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
service/prometheus-operator ClusterIP None <none> 8080/TCP 5m31s
NAME READY UP-TO-DATE AVAILABLE AGE
deployment.apps/prometheus-operator 1/1 1 1 5m31s
NAME DESIRED CURRENT READY AGE
replicaset.apps/prometheus-operator-69cbc6f76c 1 1 1 5m31s
可以看到prometheus-operator就部署成功了。
3.创建Prometheus实例
当集群中已经安装Prometheus Operator之后 , 对于部署Prometheus Server实例就变成了声明一个Prometheus资源 , 如下所示 , 我们在Monitoring命名空间下创建一个Prometheus实例 :
root@k8s-master01:/opt/k8s-data/yaml/cbear/promethues/prometheus-operator/prometheus-operator# cat prometheus-inst.yaml
apiVersion: monitoring.coreos.com/v1
kind: Prometheus
metadata:
  name: inst
  namespace: monitoring
spec:
  resources:
    requests:
memory: 400Mi将以上内容保存到prometheus-inst.yaml文件 , 并通过kubectl进行创建 :
root@k8s-master01:/opt/k8s-data/yaml/cbear/promethues/prometheus-operator/prometheus-operator# kubectl apply -f prometheus-inst.yaml
prometheus.monitoring.coreos.com/inst created
此时 , 查看monitoring命名空间下的statefulsets资源 , 可以看到Prometheus Operator自动通过Statefulset创建的Prometheus实例 :
root@k8s-master01:/opt/k8s-data/yaml/cbear/promethues/prometheus-operator/prometheus-operator# kubectl -n monitoring get statefulset
NAME              READY   AGE
prometheus-inst 1/1 3m27s查看pod实例 :
root@k8s-master01:/opt/k8s-data/yaml/cbear/promethues/prometheus-operator/prometheus-operator# kubectl -n monitoring get pods
NAME                                   READY   STATUS    RESTARTS   AGE
prometheus-inst-0                      2/2     Running   0          4m9s
prometheus-operator-69cbc6f76c-qfgkw 1/1 Running 0 13m为prometheus实例创建service , 以便在浏览器访问 : cat prometheus-service.yaml
root@k8s-master01:/opt/k8s-data/yaml/cbear/promethues/prometheus-operator/prometheus-operator# cat prometheus-service.yaml
apiVersion: v1
kind: Service
metadata:
  labels:
    app: prometheus-operator
  name: prometheus-operator-svc
  namespace: monitoring
spec:
  ports:
  - name: operator
    port: 9090
    protocol: TCP
    targetPort: 9090
  selector:
    prometheus: inst
  sessionAffinity: None
type: NodePort更新yaml文件 :
kubectl apply -f prometheus-service.yaml查看service详细信息 :
root@k8s-master01:/opt/k8s-data/yaml/cbear/promethues/prometheus-operator/prometheus-operator# kubectl get svc -n monitoring
NAME                      TYPE        CLUSTER-IP    EXTERNAL-IP   PORT(S)          AGE
prometheus-operated       ClusterIP   None          <none>        9090/TCP         20m
prometheus-operator       ClusterIP   None          <none>        8080/TCP         29m
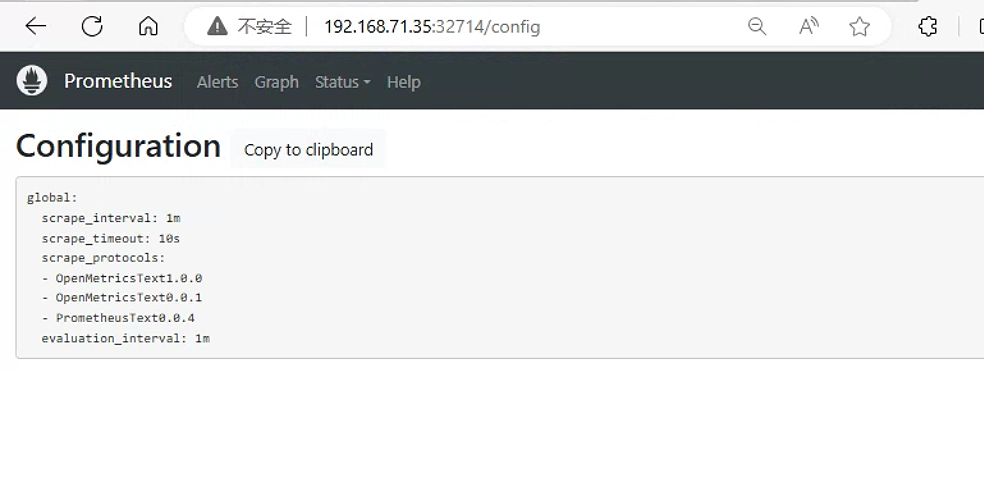
prometheus-operator-svc NodePort 10.68.38.46 <none> 9090:32714/TCP 4m55s看到最后一行prometheus-operator-svc的type类型是NodePort , 在宿主机暴露的端口是32714 , 我们通过浏览器访问k8s的master ip:32714即可访问到prometheus ui界面 , 我这里k8s的master节点ip是192.168.71.35 , 所以在浏览器访问http://192.168.71.35:32714/config , 可以看到目前Operator创建了只包含基本配置的Prometheus实例 :
参考链接
构建企业级监控平台系列(十四) : Prometheus Operator 原理与实践 (qq.com)