1. 介绍
GlusterFS 是一个开源的分布式文件系统, 旨在提供高性能、可扩展性和可靠性, 适用于现代数据中心和云环境。它以横向扩展的方式设计, 可以在多台服务器之间共享文件系统, 为应用程序提供统一的文件存储服务。
GlusterFS 的核心理念是将多台普通的服务器组合成一个高性能的分布式存储系统。它采用了分布式哈希表来管理数据存储和访问, 通过将文件划分为小块并存储在不同服务器上, 实现了数据的分布式存储和负载均衡。这种分布式存储模式不仅提高了存储容量和性能, 还提高了系统的可靠性, 因为数据的冗余备份可以在服务器故障时保证数据的可用性。
GlusterFS 提供了简单而灵活的管理接口, 使得管理员可以轻松地管理存储集群并对其进行扩展。它支持多种存储协议, 包括标准的网络文件系统 ( NFS ) 、Server Message Block ( SMB ) 和本地 POSIX 文件系统, 使得应用程序可以通过不同的协议访问存储集群。
由于其高性能、可扩展性和易用性, GlusterFS 在大规模的数据存储和处理场景中被广泛应用, 包括云计算、大数据分析、内容交付网络 ( CDN ) 等领域。它是一个强大而灵活的分布式文件系统解决方案, 可以帮助用户构建可靠的存储基础设施, 满足不断增长的存储需求。
Glusterfs总体框架如下:
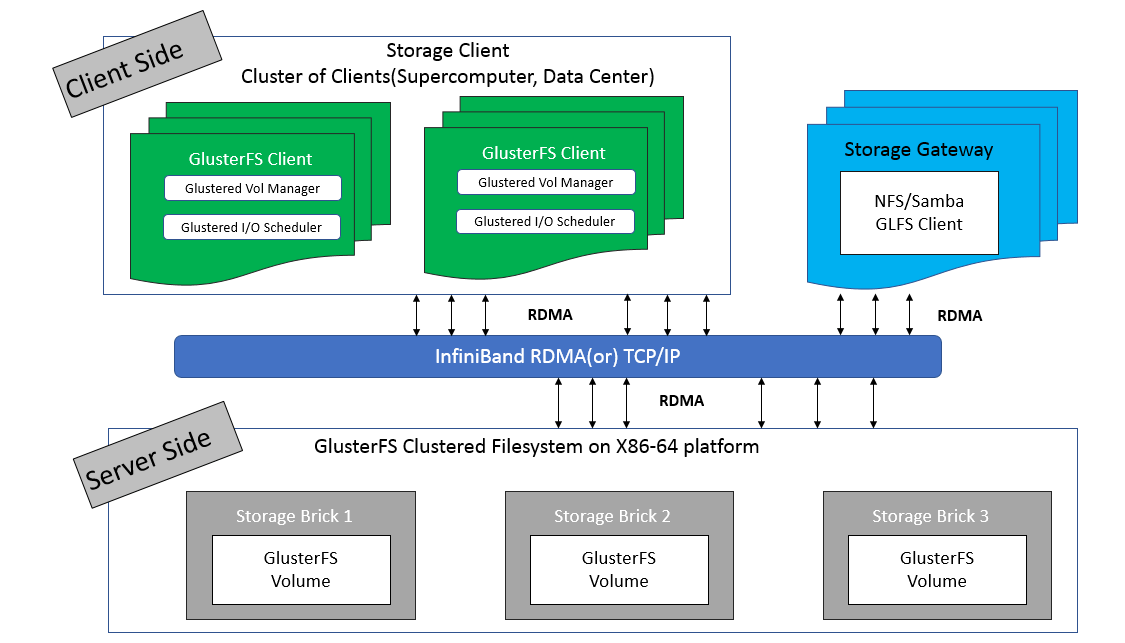
图中 GlusterFS 有非常多的术语, 理解这些术语对理解 GlusterFS 的动作机理是非常重要的, 表1给出了 GlusterFS 常见的名称及其解释。
2. GlusterFS架构特性
从这个图中 , 我们可以得到如下的信息:
无元数据设计
元数据是用来描述一个文件或给定区块在分布式文件系统中所在的位置 , 简而言之就是某个文件或某个区块存储的位置。传统分布式文件系统大都会设置元数据服务器或者功能相近的管理服务器 , 主要作用就是用来管理文件与数据区块之间的存储位置关系。相较其他分布式文件系统而言 ,
GlusterFS并没有集中或者分布式的元数据的概念 , 取而代之的是弹性哈希算法。集群中的任何服务器和客户端都可以利用哈希算法、路径及文件名进行计算 , 就可以对数据进行定位 , 并执行读写访问操作。这种设计带来的好处是极大的提高了扩展性 , 同时也提高了系统的性能和可靠性;另一显著的特点是如果给定确定的文件名 , 查找文件位置会非常快。但是如果要列出文件或者目录 , 性能会大幅下降 , 因为列出文件或者目录时 , 需要查询所在节点并对各节点中的信息进行聚合。此时有元数据服务的分布式文件系统的查询效率反而会提高许多。
client和 服务器之间可以通过RDMA来进行数据通讯。InfiniBand将是需要重点考虑和采用的方案 , 他可以有效提高数据的传输效率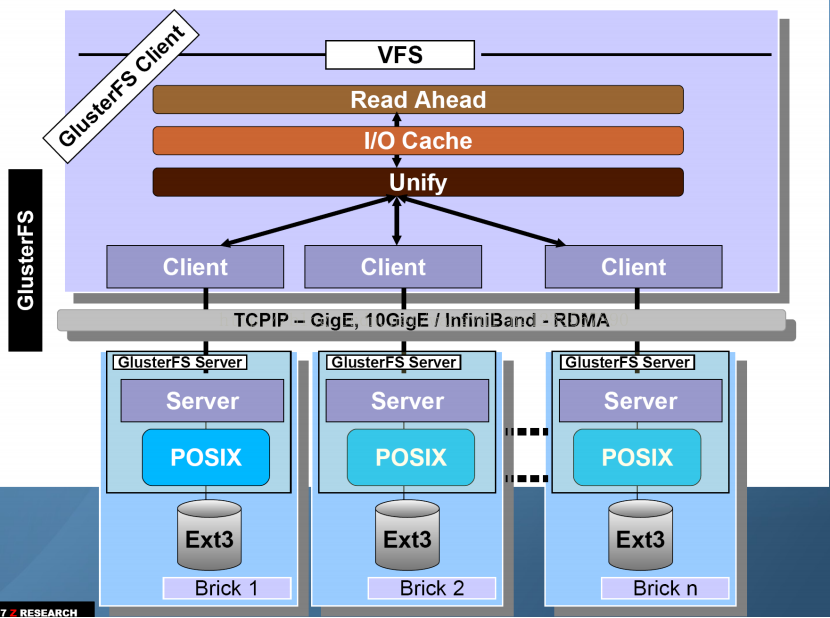
从中我们可以知道:
client and server的设计是高度模块化的client的复杂度比server要大 , 客户端需要考虑的问题很多 , 比如Read Ahead,I/O Cache,Stripe,Unify,Replicate(AFR)等。
服务器间的部署
在之前的版本中服务器间的关系是对等的 , 也就是说每个节点服务器都掌握了集群的配置信息 , 这样做的好处是每个节点度拥有节点的配置信息 , 高度自治 , 所有信息都可以在本地查询。每个节点的信息更新都会向其他节点通告 , 保证节点间信息的一致性。但如果集群规模较大 , 节点众多时 , 信息同步的效率就会下降 , 节点信息的非一致性概率就会大大提高。因此
GlusterFS未来的版本有向集中式管理变化的趋势。
3. 客户端访问流程
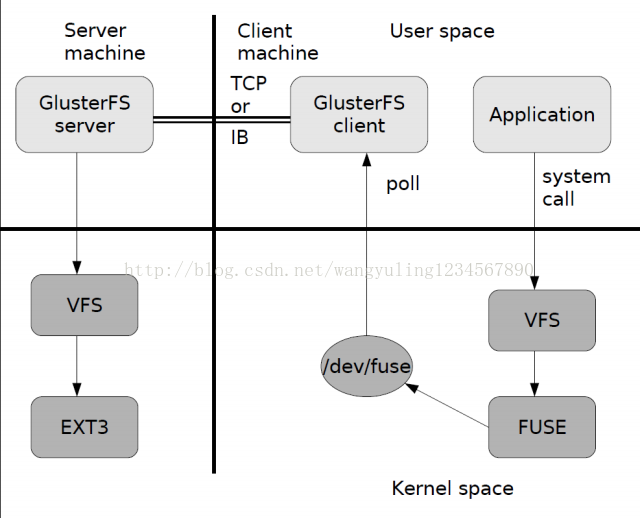
首先是在客户端 , 用户通过
glusterfs的mount point来读写数据 , 对于用户来说 , 集群系统的存在对用户是完全透明的 , 用户感觉不到是操作本地系统还是远端的集群系统。用户的这个操作被递交给 本地
linux系统的VFS来处理。VFS将数据递交给FUSE内核文件系统:在启动glusterfs客户端以前 , 需要想系统注册一个实际的文件系统FUSE,如上图所示 , 该文件系统与ext3在同一个层次上面 ,ext3是对实际的磁盘进行处理 , 而fuse文件系统则是将数据通过/dev/fuse这个设备文件递交给了glusterfs client端。所以 , 我们可以将fuse文件系统理解为一个代理。数据被
fuse递交给Glusterfs client后 ,client对数据进行一些指定的处理 ( 所谓的指定 , 是按照client配置文件据来进行的一系列处理 , 我们在启动glusterfs client时需要指定这个文 件 , 其 默认位置 :/etc/glusterfs/client.vol)。在
glusterfs client的处理末端 , 通过网络将数据递交给Glusterfs Server, 并且将数据写入到服务器所控制的存储设备上。
这样 , 整个数据流的处理就完成了。
4. GlusterFS卷类型
为了满足不同应用对高性能、高可用的需求, GlusterFS 支持 9 种卷, 即 distribute 卷、stripe 卷、replica 卷、Dispersed卷、distribute stripe 卷、distribute replica 卷、stripe Replica 卷、distribute stripe replica 卷、Distributed Dispersed卷。其实不难看出, GlusterFS 卷类型实际上可以分为 4 种基本卷和 5 种复合卷, 每种类型的卷都有其自身的特点和适用场景。虽然glusterfs已经弃用了stripe这个功能。但是这里还是会介绍stripe volume相关卷
需要注意的是GlusterFS的stripe条带卷功能在GlusterFS 6.0及更高版本种已经被弃用了。所以相关的复合卷(distribute stripe 卷、stripe Replica 卷、distribute stripe replica 卷)也无法被创建。条带卷功能已经被分片shared功能替代。分片功能通过将大文件分割成更小分片Shared来提高存储效率和性能。要启用分片功能可以对现有卷设置features.shard选项
gluster volume set <volumename> features.shard enable 4.1 基本卷
4.1.1 分布式卷(Distributed Volume)
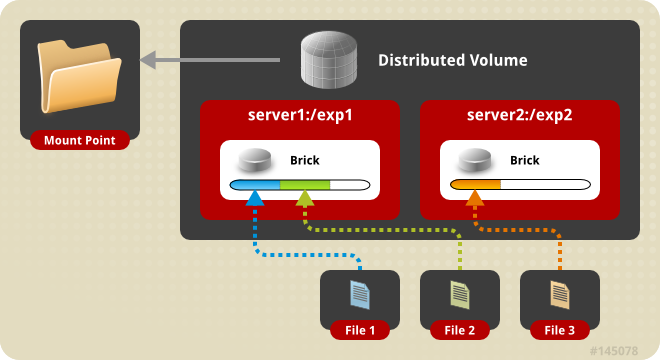
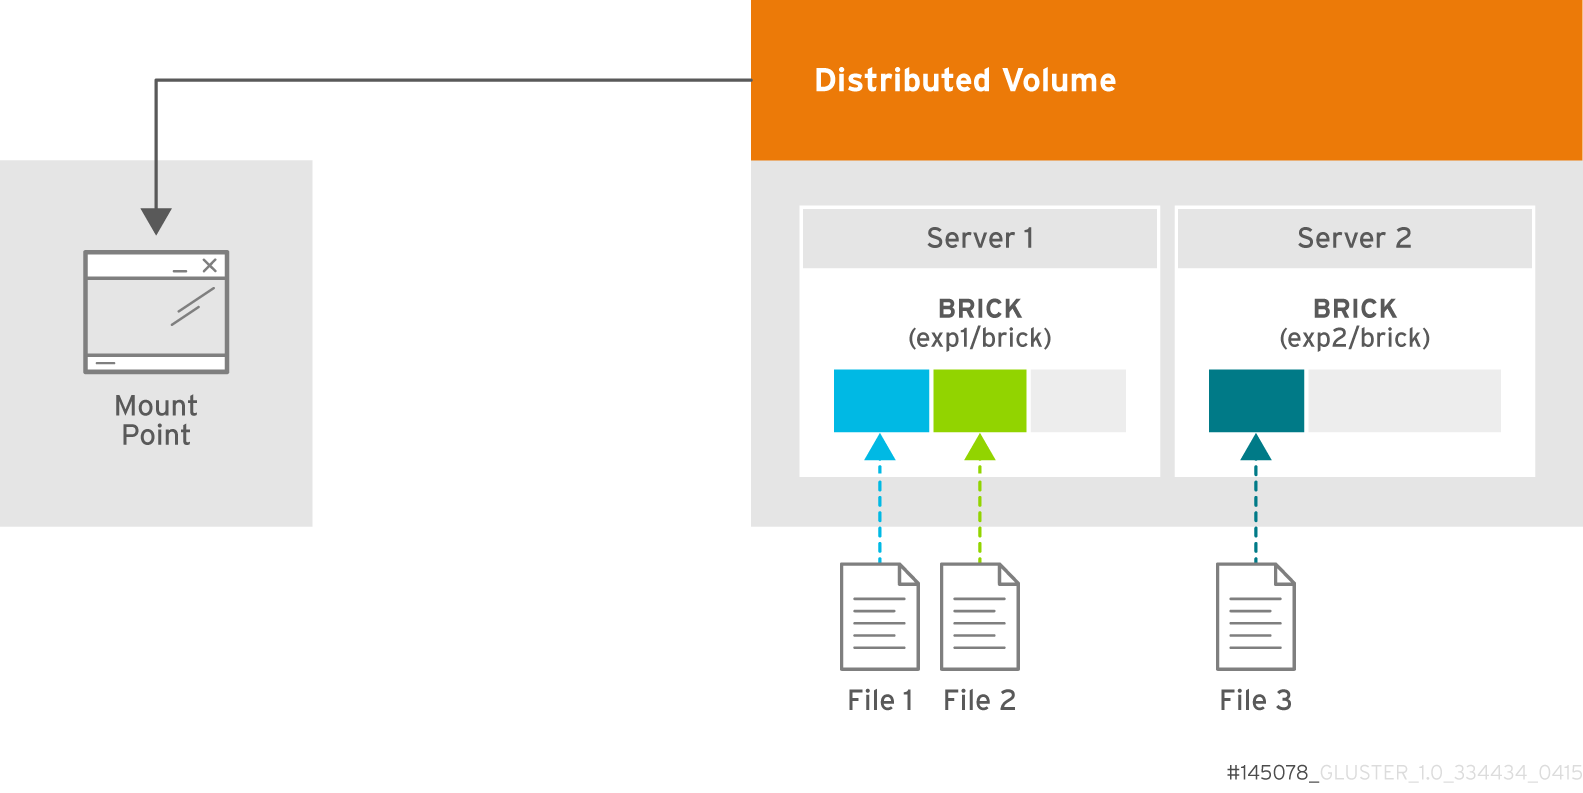
分布式卷(Distributed Volume):基于 Hash 算法将文件分布到所有 brick server, 只是扩大了磁盘空间, 不具备容错能力。由于distribute volume 使用本地文件系统, 因此存取效率并没有提高, 相反会因为网络通信的原因使用效率有所降低, 另外本地存储设备的容量有限制, 因此支持超大型文件会有一定难度。
4.1.2 复制卷(Replicated Volume)
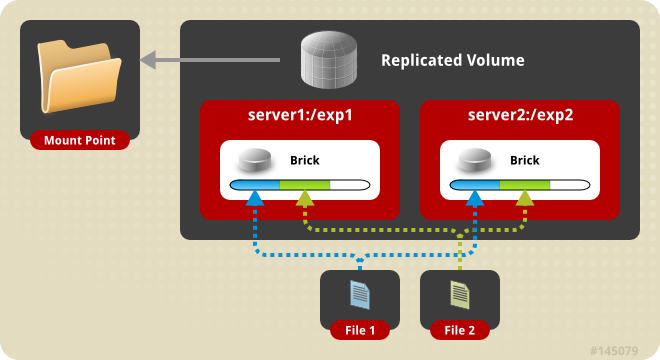
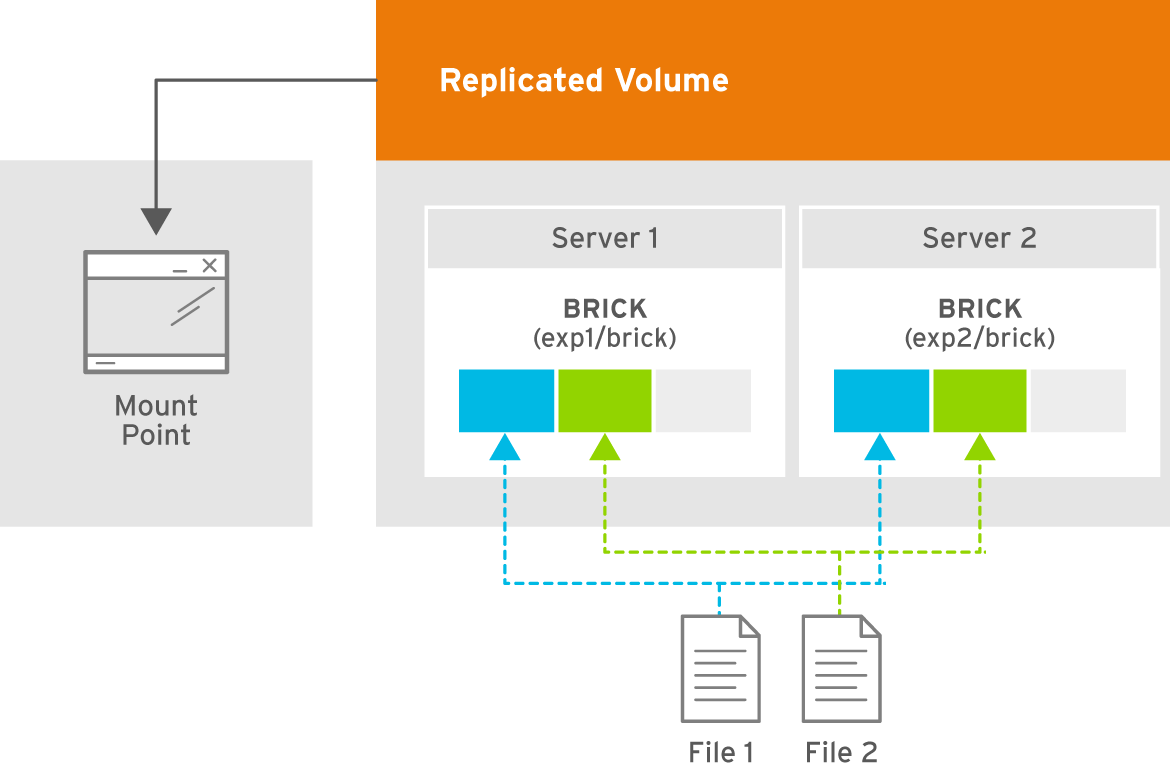
文件同步复制到多个 brick 上, 文件级 RAID1, 具有容错能力, 写性能下降, 读性能提升。Replicated 模式, 也称作 AFR(Auto File Replication) , 相当于 RAID1, 即同一文件在多个镜像存储节点上保存多份, 每个 replicated 子节点有着相同的目录结构和文件, replica volume 也是在容器存储中较为推崇的一种。
每个文件同步复制镜像到多个
brick, 相当于文件级raid1;副本数量通常设置为
2或3, 设置的副本数量需要是brick数量 ( 至少为2) 的倍数 ( 如2台brick server, 可设置副本数为2/4/6/…;如3台brick server, 可设置副本数为3/6/9/…;依次类推 ) , 且每个brick的容量相等;读性能提升 , 写性能下降 , 因为
glusterfs的复制是同步事务操作 , 即写文件时 , 先把这个文件锁住 , 然后同时写两个或多个副本 , 写完后解锁 , 操作结束 (ceph采用异步写副本 , 即写到一个主OSD便返回 , 这个OSD再通过内部网络异步写到其余OSD) ;通常与分布式卷或条带卷组合使用 , 解决前两者的冗余问题;
提升数据可靠性 , 但磁盘利用率低;
副本数设置为
2时 , 可能会有脑裂 (Split-brain) 的风险 ( 风险提示 , 但可配置 ) , 主要因在两个副本不一致时 , 无法仲裁以哪个副本为准 , 解决方案是加入仲裁或者设置3副本。
4.1.3 分散卷(dispersed volume)
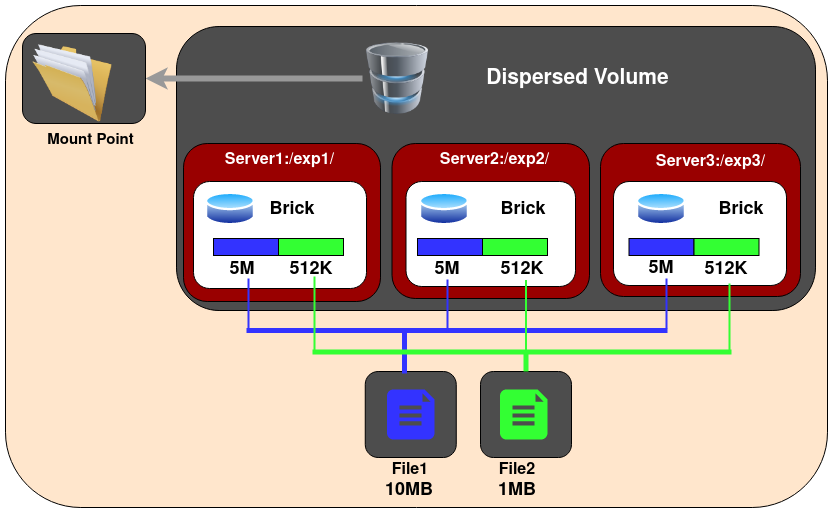
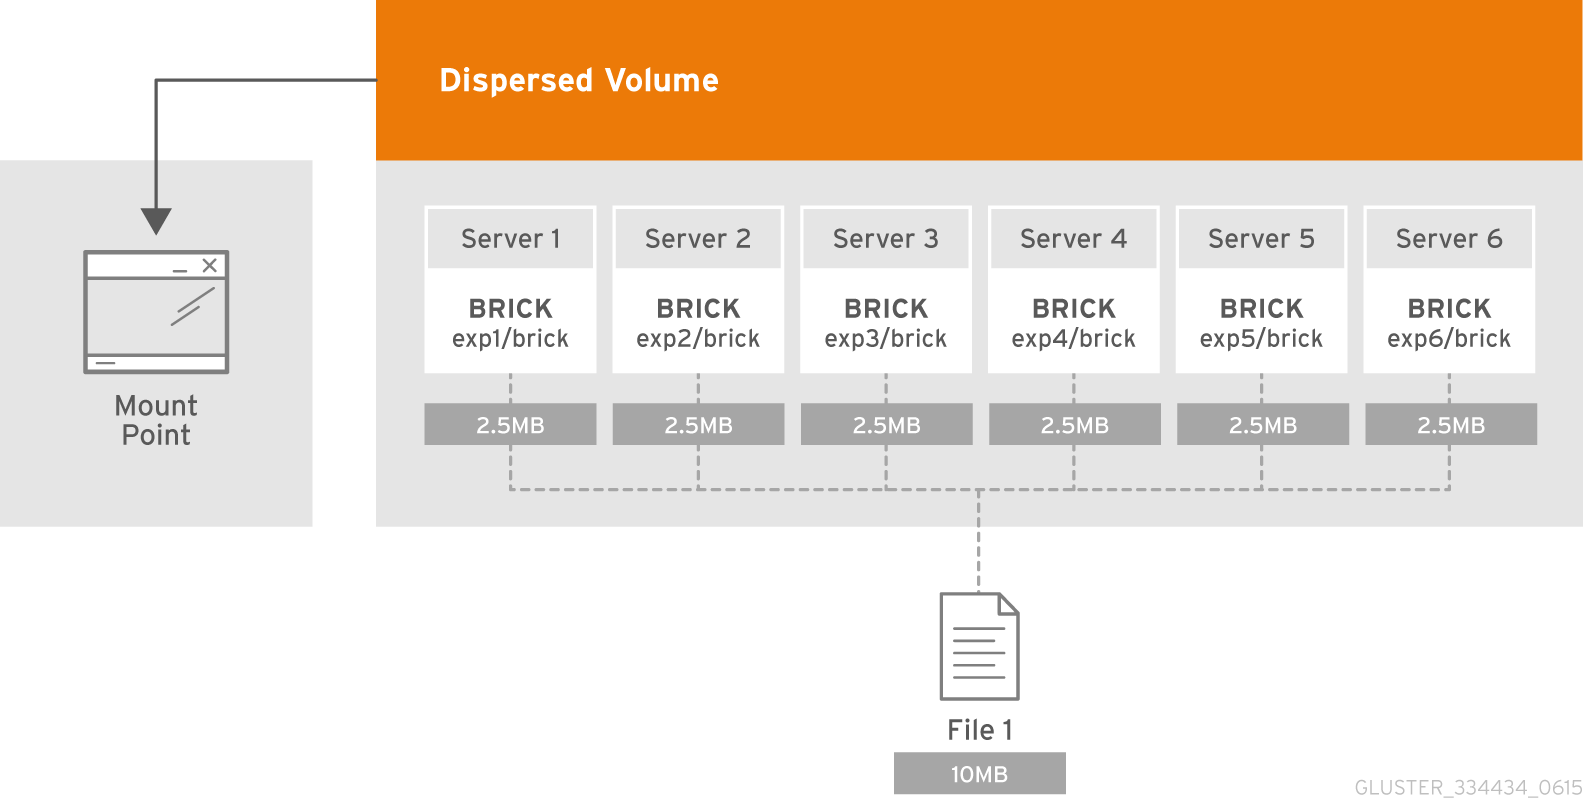
基于ErasureCodes(纠错码)的一种新类型的Volume(3.6版本正式发布该特性)类似于RAID5/6 , 分散卷基于纠删码。通过配置Redundancy(冗余)级别提高可靠性 , 在保证较高的可靠性同时 , 可以提升物理存储空间的利用率。redundancy 必须大于0 , 并且bricks的总数必须大于2 *redundancy 。 这意味着dispersed卷必须至少包含3个bricks。类似raid5/raid6 , 防止单点故障(HA),提升IO性能(LB)。
4.1.4 条带卷(stripe volume/弃用)
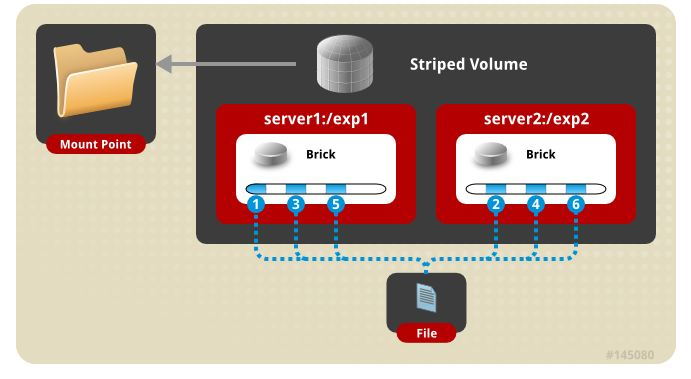
条带化卷将文件分割成固定大小的块 , 并将这些块分别存储在不同的服务器上 。类似 RAID0 , 文件分成数据块以 Round Robin 方式分布到 brick server 上 , 并发粒度是数据块 , 支持超大文件 , 大文件的读写性能高。这样可以提高读写性能 , 因为数据可以并行地从多个服务器上读取和写入。适用于需要高吞吐量和低延迟的场景 , 如大规模数据处理、科学计算等。
虽然glusterfs已经弃用了这个功能。但是这里还是会介绍stripe volume相关卷
4.2 复合卷
4.2.1 分布式复制卷(Distributed Replicated Volume)
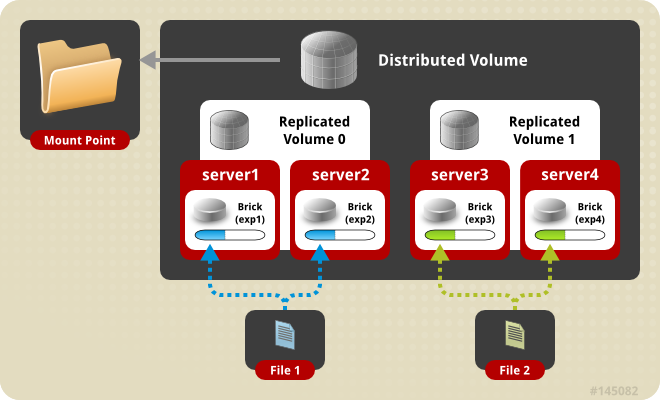
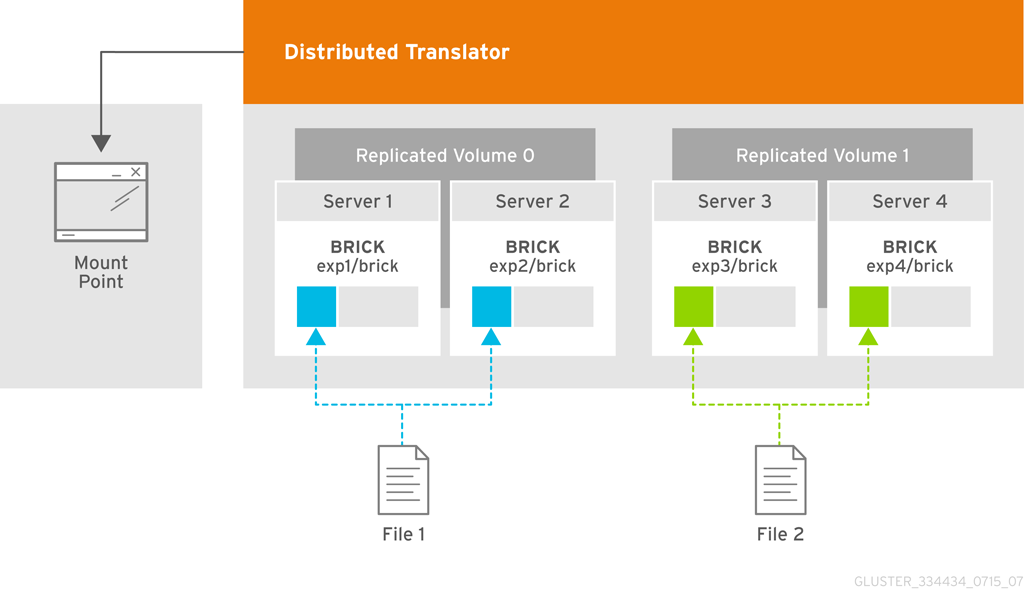
分布式复制卷结合了分布式卷和复制卷的特点 , 既实现了数据的横向扩展和负载均衡 , 又提高了数据的可靠性和容错能力。分布式复制卷 ( Distributed Replicated Volumes ) 将文件分布在卷中的复制存储块(Replicated Bricks)上。在需要扩展存储容量且高可靠性至关重要的环境中 , 可以使用分布式复制卷。此外 , 分布式复制卷在大多数环境中还能提供更好的读取性能。
Brick server 数量是镜像数的倍数 , 兼具 distribute 和 replica 卷的特点,可以在 2 个或多个节点之间复制数据。分布式的复制卷 , volume 中 brick 所包含的存储服务器数必须是 replica 的倍数(>=2倍) , 兼顾分布式和复制式的功能。
若干
brick组成1个复制卷 , 另外若干brick组成其他复制卷;单个文件在复制卷内数据保持副本 , 不同文件在不同复制卷之间进行哈希分布;即分布式卷跨复制卷集 (replicated sets) ;brick server数量是副本数量的倍数 , 且>=2倍 , 即最少需要4台brick server, 同时组建复制卷集的brick容量相等。
4.2.2 分布式纠删码卷(Distributed Dsipersed Volume)
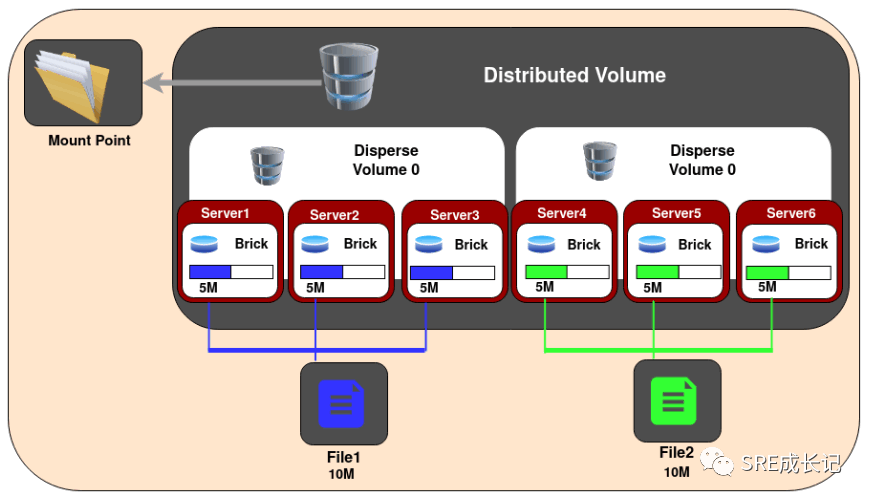
分布式分散卷 ( Distributed Dispersed Volumes ) 是GlusterFS中一种结合了分布式存储和纠删码 ( Erasure Codes ) 技术的卷类型。它通过将文件分割成多个数据片段和冗余片段 , 并将这些片段分布在不同的存储砖块 ( Bricks ) 上 , 从而实现高效的数据存储和容错能力。
分布式分散卷基于纠删码技术 , 类似于RAID5/6 , 但更加灵活和高效。文件被分割成大小相同的块 ( Chunks ) , 每个块进一步分割成片段 ( Fragments ) , 同时生成冗余信息片段。这些片段被均匀分布到不同的存储砖块上。Brick的数量必须是第一个子卷的倍数 , 且必须至少有3个Brick。这种卷能支持方便扩缩容卷的大小并将负载分布在各个Brick上。
冗余级别 ( Redundancy Level ) 决定了在多少个存储砖块丢失的情况下仍能恢复数据。例如 , 一个包含6个存储砖块的卷 , 冗余级别为2 , 意味着即使丢失2个存储砖块 , 数据仍然可以完整恢复。存储卷的可用空间计算公式为:
<Usable size> = <Brick size> * (#Bricks - Redundancy)分布式分散卷 ( Distributed Dispersed Volumes ) 支持与分散卷 ( Dispersed Volumes ) 相同的纠删码 ( Erasure Coding ) 配置。分布式分散卷中的存储砖块 ( Bricks ) 数量必须是 ( K+M ) 的倍数。在当前版本中 , 支持以下配置
包含
6个存储砖块的多个分散集 , 冗余级别为2。包含
11个存储砖块的多个分散集 , 冗余级别为3。包含
12个存储砖块的多个分散集 , 冗余级别为4。
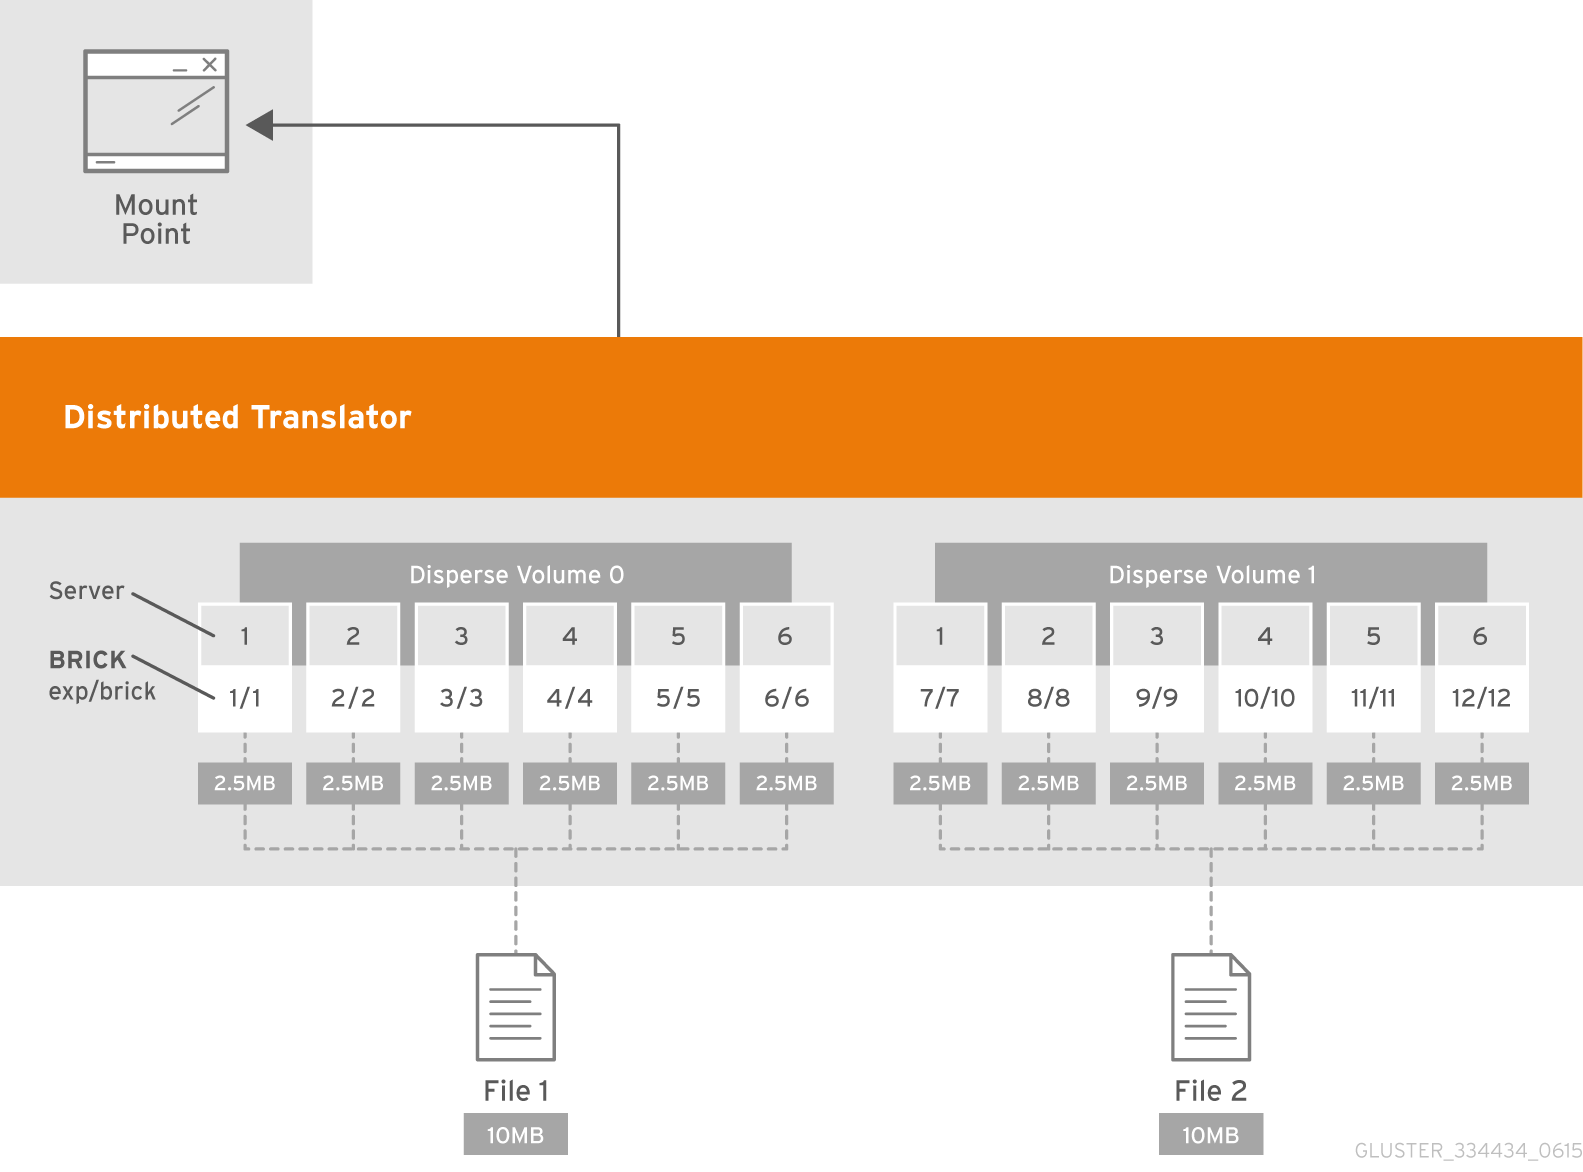
这里就会有一个疑问,已经存在了分散卷(Dispersed Volumes)为什么还需要分布式分散卷(Distributed Dispersed Volumes)
扩展性需求
分散卷(
Dispersed Volumes) :分散卷通过纠删码技术将文件分割成多个数据片段和冗余片段 , 并存储在单个分散卷的存储砖块(
Bricks)中。分散卷的存储砖块数量是固定的 , 通常是
K+M( 其中K是数据片段数量 , M是冗余片段数量 ) 。例如 , 一个6个存储砖块的分散卷(4+2配置)只能存储固定数量的数据。当存储需求超过单个分散卷的容量时 , 需要重新配置卷或增加更多的存储砖块 , 这可能会导致复杂的重新平衡和数据迁移。
分布式分散卷 (
Distributed Dispersed Volumes) :分布式分散卷将文件分布在多个分散子卷(
Dispersed Subvolumes)中 , 每个子卷本身是一个分散卷。存储砖块数量必须是
(K+M)×n的倍数 ( 其中n>1) 。例如 , 一个2×(4+2)的分布式分散卷包含12个存储砖块。这种结构允许通过增加分散子卷的数量来轻松扩展存储容量 , 而无需重新配置现有卷。
性能优化
分散卷 (
Dispersed Volumes) :分散卷在写入时需要生成冗余信息 , 写入性能相对较低。
读取性能较好 , 但当存储砖块数量增加时 , 读取操作的复杂性也会增加。
分布式分散卷 (
Distributed Dispersed Volumes) :分布式分散卷通过将文件分布在多个分散子卷中 , 减少了单个存储砖块的负载 , 从而提高了整体性能。
在读取操作中 , 分布式分散卷可以并行访问多个分散子卷 , 进一步提升读取性能。
容错能力
分散卷 (
Dispersed Volumes) :分散卷通过纠删码技术提供了较高的容错能力 , 允许在部分存储砖块丢失的情况下恢复数据。
但其容错能力受限于单个分散卷的存储砖块数量。
分布式分散卷 (
Distributed Dispersed Volumes) :分布式分散卷不仅继承了分散卷的容错能力 , 还通过分布式存储进一步增强了容错能力。
即使某个分散子卷中的部分存储砖块丢失 , 其他子卷中的数据仍然可以保证数据的完整性和可用性。
适用场景
分散卷 (
Dispersed Volumes) :适用于对存储空间利用率要求高且需要一定容错能力的场景。
例如 , 存储中等规模的数据集 , 且对写入性能要求不高。
分布式分散卷 (
Distributed Dispersed Volumes) :适用于需要大规模存储且对数据可靠性要求较高的场景。
例如 , 在分布式存储环境中 , 需要存储大量数据并保证高可用性。
总结
分布式分散卷 ( Distributed Dispersed Volumes ) 在扩展性、性能和容错能力方面都优于分散卷 ( Dispersed Volumes ) 。它通过将文件分布在多个分散子卷中 , 不仅提高了存储容量的可扩展性 , 还优化了读写性能 , 并进一步增强了容错能力。因此 , 在需要大规模存储且对可靠性要求较高的场景中 , 分布式分散卷是更合适的选择。
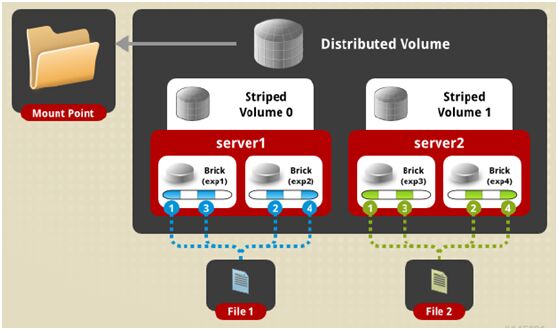
4.2.3 分布式条带化卷(Distributed Striped Volume/弃用)
分布式条带化卷结合了分布式卷和条带化卷的特点 , 既实现了数据的横向扩展和负载均衡 , 又提高了读写性能。每个文件会被分割成固定大小的块 , 并分别存储在多个服务器上。适用于需要高性能和横向扩展的场景 , 如大规模并行计算、大数据处理等。
若干
brick组成1个条带卷 , 另外若干brick组成其他条带卷 ; 单个文件在条带卷内数据以条带的形式存储 , 不同文件在不同条带卷之间进行哈希分布 ; 即分布式卷跨条带卷 ;brick server数量是条带数的倍数 , 且>=2倍 , 即最少需要4台brick server。
4.2.4 条带复制卷(stripe replica volume/弃用)
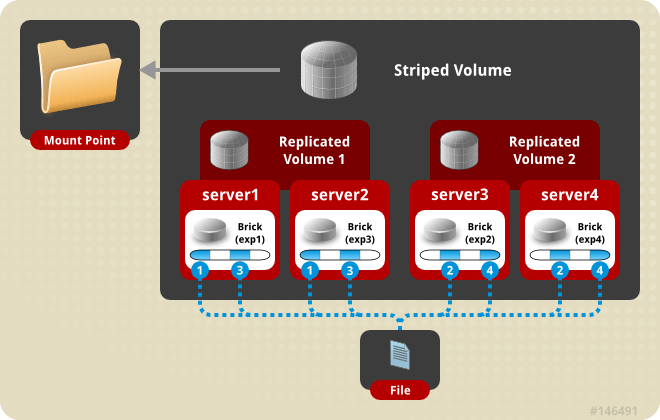
类似 RAID 10 , 同时具有条带卷和复制卷的特点。条带复制卷 ( STRIPE REPLICA Volume ) , 是条带与复制卷的组合 , 兼具两者的功能 , 特点如下:
若干
brick组成1个复制卷 , 另外若干brick组成其他复制卷;单个文件以条带的形式存储在2个或多个复制集(replicated sets) , 复制集内文件分片以副本的形式保存;相当于文件级raid01;brick server数量是副本数的倍数 , 且>=2倍 , 即最少需要4台brick server。
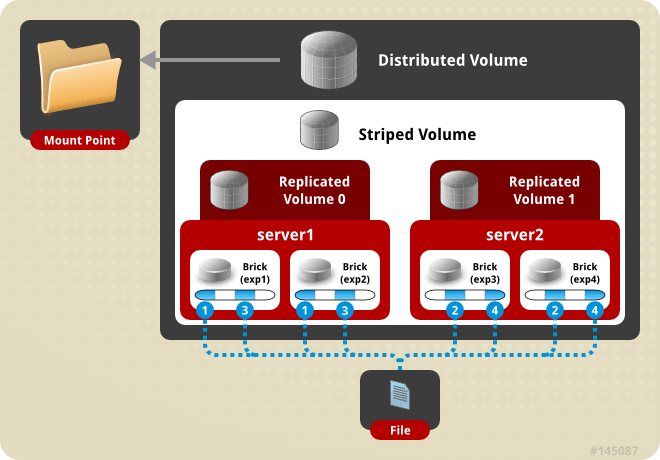
4.2.5 分布式条带化复制卷(Distributed Striped Replicated Volume/弃用)
三种基本卷的复合卷 , 通常用于类 Map Reduce 应用。分布式条带复制卷(DISTRIBUTE STRIPE REPLICA VOLUME) , 是分布式卷 , 条带与复制卷的组合 , 兼具三者的功能 , 特点如下:
多个文件哈希分布到到多个条带集中 , 单个文件在条带集中以条带的形式存储在
2个或多个复制集(replicated sets) , 复制集内文件分片以副本的形式保存;brick server数量是副本数的倍数 , 且>=2倍 , 即最少需要4台brick server。
参考链接
基于 GlusterFS 实现 Docker 集群的分布式存储 | 鱼喃
GlusterFS 分布式文件系统 搭建及使用-CSDN博客
GlusterFS分布式存储集群-2. 使用 - Netonline - 博客园
GlusterFS学习之路 ( 一)GlusterFS初识 - 烟雨浮华 - 博客园
