
5-1-网络模型及插件
Kubertnetes集群上运行的所有Pod资源默认都会从同 一平面网络得到一个IP地址 , 无论是否处于同一名称空间 , 各Pod彼此之间都可使用各自的地址直接通信 , 另一方面 , Pod网络的管理却非 Kubernetes系统内置的功能 , 而是由第三方项目以CNI插件方式完成。 进一步来说 , 除了Pod网络管理 , 有相当一部分CNI网络插件还实现了 网络策略 , 这些插件赋予管理员和用户通过自定义NetworkPolicy资源 来管控Pod通信的能力。本章主要讲述Kubernetes的网络模型、常用的网络插件Flannel、Canal和Calico的基本应用 , 以及使用网络策略加强Pod通信安全等相关话题。
1.容器网络模型
Network、IPC和UTS名称空间隔离技术是容器能够使用独立网络栈的根本 , 而操作系统的网络设备虚拟化技术是打通各容器间通信并构 建起多样化网络拓扑的至关重要因素 , 在Linux系统上 , 这类的虚拟化 设备类型有VETH、Bridge、VLAN、MAC VLAN、IP VLAN、VXLAN、MACTV 和TAP/IPVTAP等。这些网络虚拟化相关的技术是支撑容器与容器编排系统网络的基础。
1.1 容器网络通信模型
在Host模式中 , 各容器共享宿主机的根网络名称空间 , 它们使用同一个接口设备和网络协议栈 , 因此 , 用户必须精心管理共享同一网络端口空间容器的应用与宿主机应用 , 以避免端口冲突。
Bridge模式对host模式进行了一定程度的改进 , 在该模式中 , 容器从一个或多个专用网络 ( 地址池 ) 中获取IP地址 , 并将该IP地址配置在自己的网络名称空间中的网络端口设备上。于是 , 拥有独立、隔离的网络名称空间中的网络端口设备上。于是 , 拥有独立、隔离的网络名称空间的各容器有自己独占的端口空间 , 而不必再担心各容器及宿主机间的端口冲突。
这里提到的Bridge是指Linux内核支持的虚拟网桥设备 , 它模拟的是物理网桥设备 , 工作与数据链路层 , 根据习得的MAC地址表向设备端口转发数据帧。虚拟以太网接口设备对 ( veth pair ) 是连接虚拟网桥和容器的网络媒介: 一端插入到容器的网络栈中 , 表现为通信接口 ( 例如eth0等 ) , 另一端则于宿主机上关联虚拟网桥并降级为当前网桥的" 从设备" , 失去调用网络协议栈处理数据包的资格 , 从而表现为桥设备的一个端口。如下图所示。
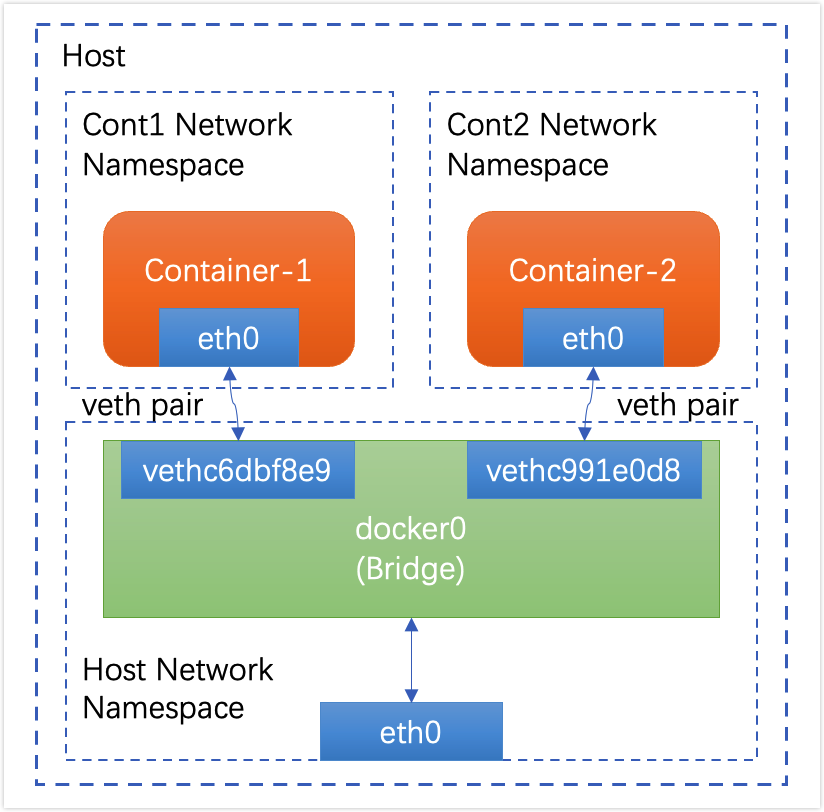
Linux网桥提供的是宿主机内部的网络 , 同一主机上的各容器可基于网桥和ARP协议完成本地通信 , 而在宿主机上 , 网桥表现为一个网络接口可拥有IP地址 , 如上图中的docker0会在docker daemon进程启动后被自动配置172.17.0.1/16的地址。于是 , 由宿主机发出的网络包可以通过此桥接口送往连接至同一桥上的其它容器 , 如图中的Container-1或Container-2 , 这些容器通常需要由某种地址分配组件 ( IPAM ) 自动配置一个相关网络 ( 例如172.17.0.0/16 ) 中的IP地址。
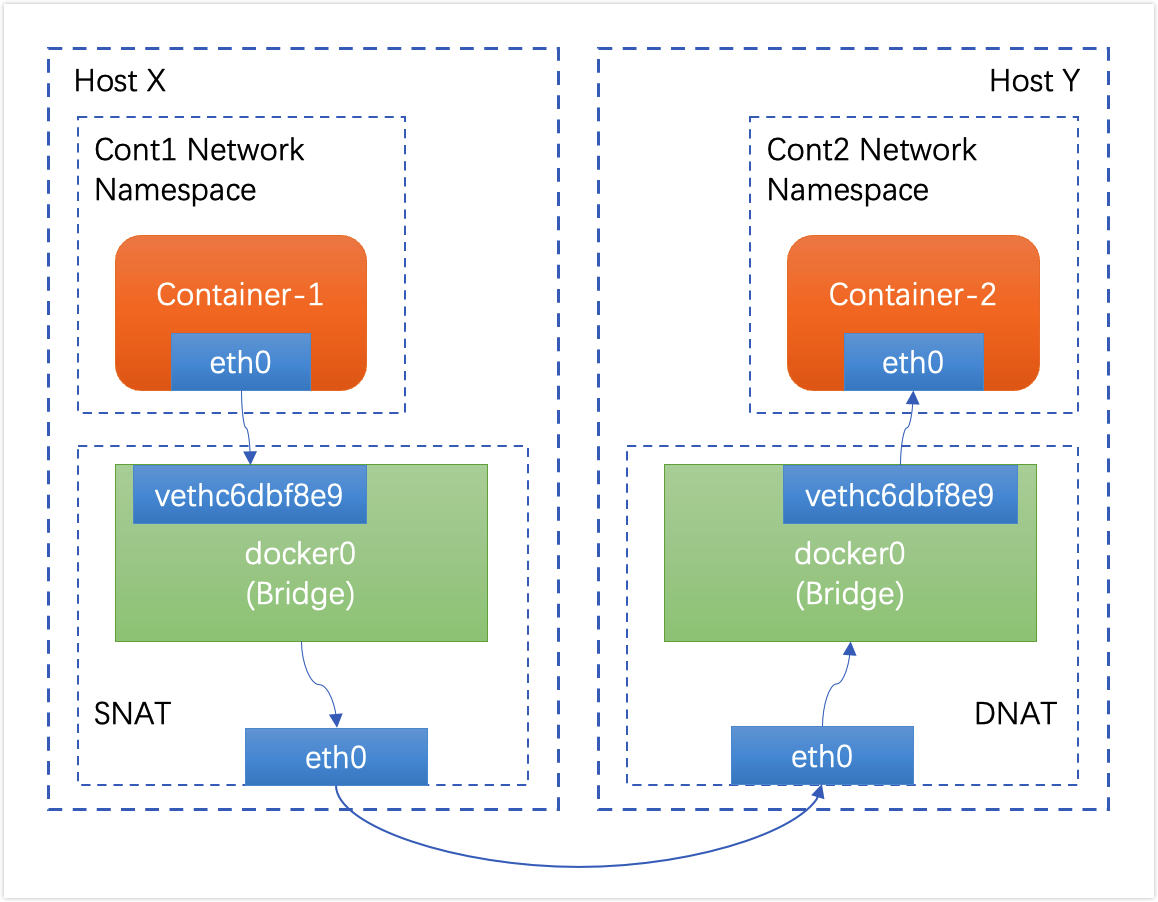
但此私有网络中的容器却无法直接与宿主机之外的其他主机或容器进行通信 , 通常作为请求方 , 这些容器需要由宿主机上的iptables 借助SNAT机制实现报文转发 , 而作为服务方时 , 它们的服务需要宿主机借助于iptables的DNAT规则进行服务暴露。因而 , 总结起来 , 配置容器使用Bridge网络的步骤大体有如下几个:
若不存在 , 则需要先在宿主机上添加一个虚拟网桥 ;
为每个容器配置一个独占的网络名称空间 ;
生成一对虚拟以太网接口 ( 如
veth pair) , 将一端插入容器网络名称空间 , 一端关联至宿主机上的网桥 ;为容器分配
IP地址 , 并按需生成必要的NAT规则。
尽管Bridge模型下各容器使用独立且隔离的网络名称空间 , 且彼此间能够互连互通 , 但跨主机的容器间通信时 , 请求报文会首先由源宿主机进行一次SNAT ( 源地址转换 ) 处理 , 而后由目标宿主机进行一次DNAT ( 目标地址转换 ) 处理方可送到目标容器 , 如下图所示。这种复杂的NAT机制将会使得网络通信管理的复杂度随容器规模增呈成几何倍数上升 , 而且基于ipables实现的NAT规则 , 也限制了解决方案的规模和性能。
Kubernetes系统依然面临着类似的问题 , 只不过 , 跨节点的容器通信问题变成了更抽象的Pod资源问题。我们知道 , Kubernetes将具有亲密关系的容器整合成Pod作为基础单元 , 并设计了专用的网络模型来支撑Kubernetes组件间以及与其他应用程序的通信。这种网络模型基于扁平网络结构 , 无须将主机端口映射到容器端口便能完成分布式环境中的容器间通信 , 并负责解决4类通信需求: 同一Pod内容器间的通信、Pod间的通信、Service到Pod间的通信以及集群外部与Service之间的通信。
1.1.1 Pod内容器通信
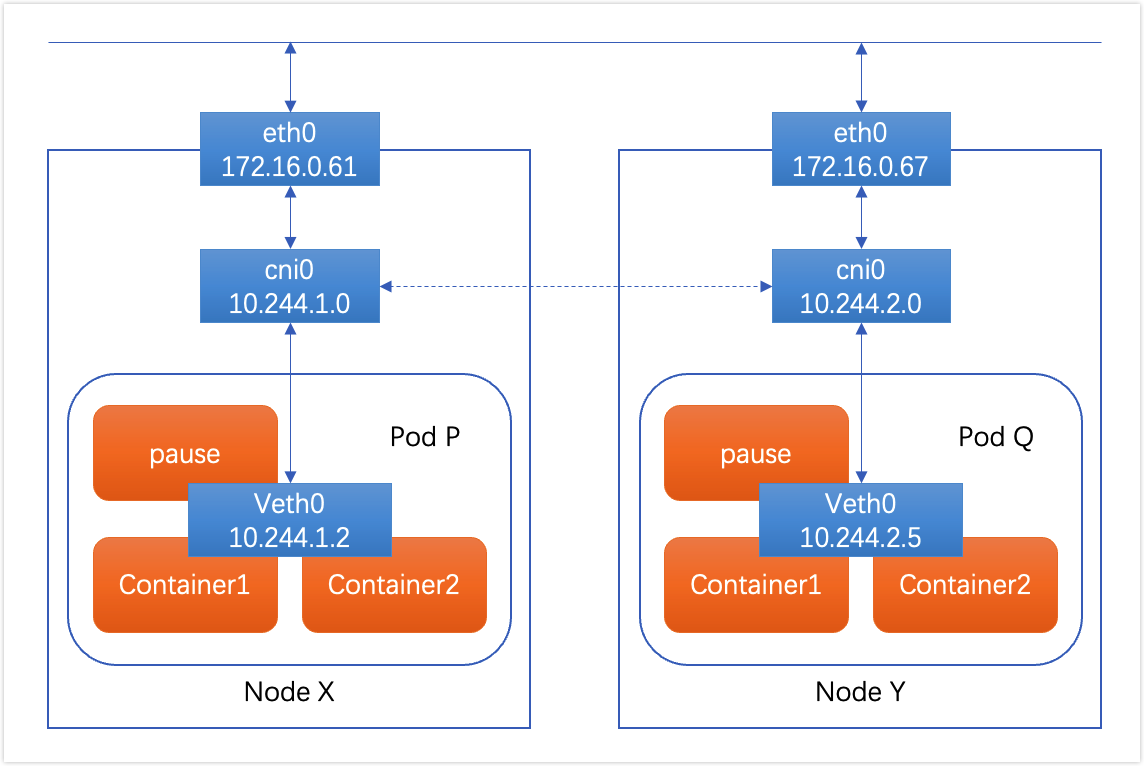
Pod是Kubernetes调度的原子单元 , 其内部的各容器必须运行在同一节点之上。一个Pod资源内的各容器共享同一网络名称空间 , 它通常由构建Pod对象的基础架构容器pause所提供。因而 , 同一个Pod内运行的多个容器通过lo接口即可在本地内核协议栈上完成交互 , 如下图Pod网络中的Pod P内的Container1和Container2之间的通信 , 这类似于同一主机上的多个进程间的本地通信。
1.1.2 分布式Pod间通信
各Pod对象需要运行在同一个平面网络中 , 每个Pod对象拥有一个虚拟网络接口和集群全局唯一的地址 , 该IP地址可用于直接与其他Pod进行通信 , 例如下面Service与Pod间的通信示意图中的Pod P和Pod Q之间的通信。另外 , 运行Pod的各节点也会通过桥接设备等持有此平面网络中的一个IP地址 , 如图中的cni0接口 , 这意味着Node到Pod间的通信也可直接在此网络进行。因此 , Pod间的通信或Pod到Node间的通信类似于同一IP网络中的主机间进行的通信。
Kubernetes设计了Pod通信模型 , 却把相关功能及编排机制的实现通过kubenet或CNI插件API开放给第三方来实现。这些第三方插件要负各种任务 , 以实现Pod间的直接通信。目前 , 流行的CNI网络插件有数十种之多 , 例如Flannel , 以及Calico、Canal和 WeaveNet等。责为各Pod设置虚拟网络接口、分配IP地址并将其接入到容器网络中等。
1.1.3 Service与Pod间的通信
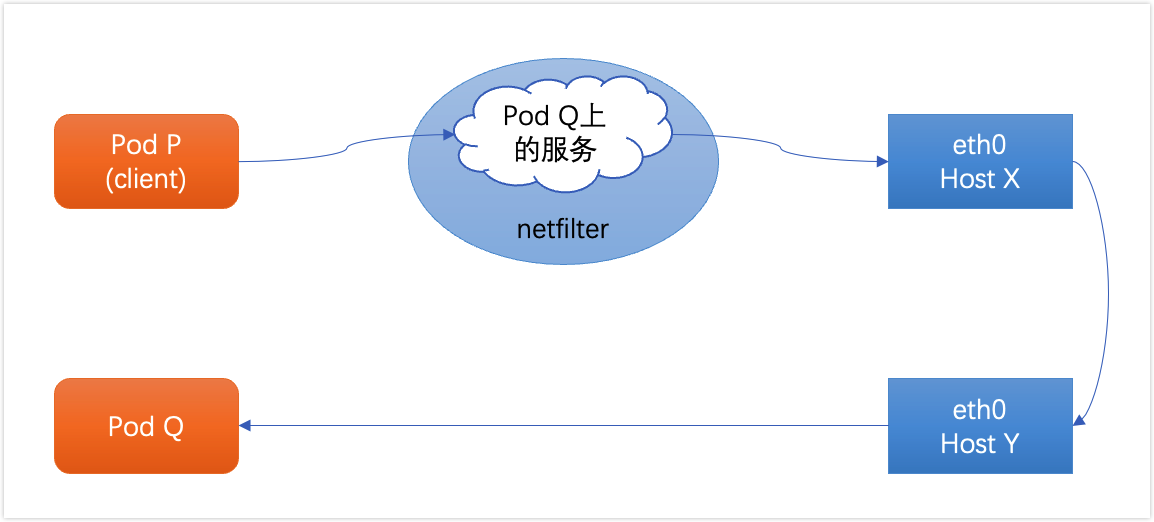
Service资源的专用网络也称为集群网络 , 需要在启动kube-apiserver时由--service-cluster-ip-range选项进行指定 , 例如默认的10.96.0.0/12 , 每个Service对象在此网络中拥有一个称为ClusterIP的固定地址。管理员或用户对Service对象的创建或更改操作 , 会由API Server存储完成后触发各节点上的kube-proxy , 并根据代理模式的不同将该Service对象定义为相应节点上的iptables规则或ipvs规则 , Pod或节点客户端对Service对象的IP地址的访问请求将由这些iptables或ipvs规则进行调度和转发 , 从而完成Pod与Service之间的通信 , 如上面Pod网络图所示。
1.1.4 集群外部客户端与Pod对象的通信
引入集群外部流量到达Pod对象有4种方式 , 有两种是基于本地节点的端口 ( nodePort ) 或根网络名称空间 ( hostNetwork ) , 另外两种则是基于工作在集群级别的NodePort或LoadBalancer类型的Service对象。不过 , 即便是四层代理的模式也要经由两级转发才能到达目标Pod 资源: 请求流量首先到达外部负载均衡器 , 由其调度至某个工作节点之上 , 而后再由工作节点的netfilter ( kube-proxy ) 组件上的规则 ( iptables或ipvs ) 调度至某个目标Pod对象。
我们知道 , 集群内的Pod间通信 , 即便通过Service进行" 代理" 和" 调度" , 但绝大部分都无须使用NAT , 而是Pod间的直接通信。由此可见 , 上面的4种通信模型中 , 仅" 分布式Pod间通信" 是负责解决跨节点间容器通信的核心所在 , 但Kubernetes从v1.0之前的版本起就把这个问题通过kubenet插件API开放给了社区 , 把网络栈的管理从容器运行时中分离出来 , 这种抽象有助于将容器管理和网络管理分开 , 也为不同的组织独立解决容器编排和容器网络编排的问题提供了空间。任何遵循该API开发的容器网络编排插件都可以同Kubernetes系统一起协同工作 , 这其中以CoreOS维护的Flannel项目为最具代表性。
kubenet是一个非常基础、简单的网络插件 , 它本身并未实现任何跨节点网络和网络策略一类更高级的功能 , 且仅适用于Linux系统 , 于是 , Kubernetes试图寻求一个更开放的网络插件接口标准来替代它。 分别由Docker与CoreOS设计的CNM ( Container Network Model ) 和CNI 是两个主流的竞争模型 , 但CNM在设计上做了很多与Kubernetes不兼容的假设 , 而CNI却有着与Kubernetes非常一致的设计哲学 , 它远比CNM简单 , 不需要守护进程 , 并且能够跨多个容器运行时平台。于是 , CNM 因" 专为Docker容器引擎设计且很难分离" 而落选 , 而CNI就成了目前Kubernetes系统上标准的网络插件接口规范。目前 , 绝大多数为 Kubernetes解决Pod网络通信问题的插件都是遵循CNI规范的实现。
1.2 CNI网络插件基础
CNI是容器引擎与遵循该规范网络插件的中间层 , 专用于为容器配 置网络子系统 , 目前由RKT、Docker、Kubernetes、OpenShift和Mesos 等相关的容器运行时环境所运行。
通常 , 遵循CNI规范的网络插件是一个可执行程序文件 , 它们可由 容器编排系统 ( 例如Kubernetes等 ) 调用 , 负责向容器的网络名称空 间插入一个网络接口并在宿主机上执行必要的任务以完成虚拟网络配置 , 因而通常被称为网络管理插件 , 即NetPlugin。随后 , NetPlugin 还需要借助IPAM插件为容器的网络接口分配IP地址 , 这意味着CNI允许将核心网络管理功能与IP地址分配等功能相分离 , 并通过插件组合的方式堆叠出一个完整的解决方案。简单来说 , 目前的CNI规范主要由 NetPlugin和IPAM两个插件API组成 , 如图所示。
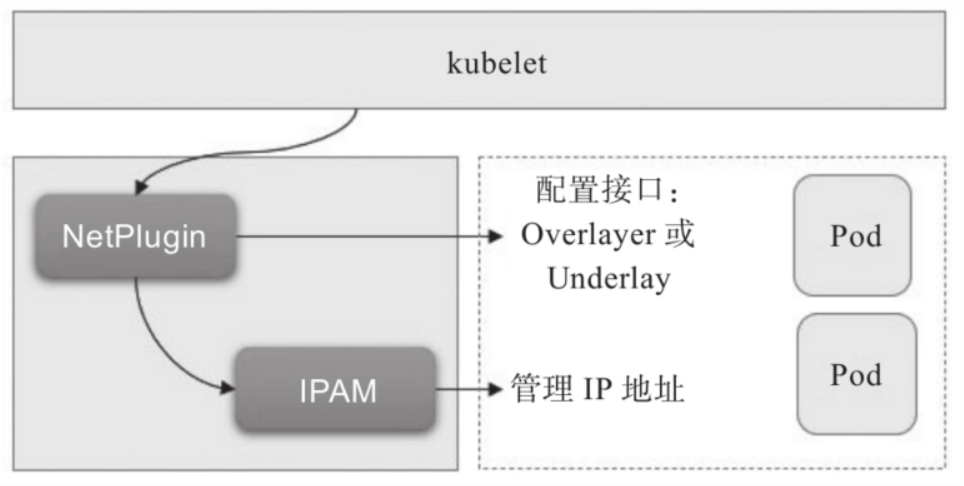
以下是对两个插件的简要说明。
网络插件(
NetPlugin)也称Main插件 , 负责创建/删除网络以及向网络添加/删除容器 , 它专注于连通容器与容器之间以及容器与宿主机之间的通信 , 同容器相关的网络设备通常都由该类插件所创建 , 例如Bridge、IP VLAN、MAC VLAN、loopback、PTP、VETH以及VLAN等虚拟设备。IPAM(IP Address Management) , 该类插件负责创建/删除地址池以及分配/回收容器的IP地址 ; 目前 , 该类型插件的实现主要有host-local和dhcp两个 , 前一个基于预置的地址范围进行地址分配 , 而后一个通过DHCP协议获取地址。
显然 , NetPlugin是CNI中最重要的组成部分 , 它才是执行创建虚拟网络、为Pod生成网络接口设备 , 以及将Pod接入网络中等核心任务的插件。为了能够满足分布式Pod通信模型中要求的所有Pod必须在同一平面网络中的要求 , NetPlugin目前常用的实现方案有Overlay网络(Overlay Network)和Underlay网络(Underlay Network)两类。
Overlay网络借助VXLAN、UDP、IPIP或GRE等隧道协议 , 通过隧道协议报文封装Pod间的通信报文(IP报文或以太网帧)来构建虚拟网络。Underlay网络通常使用direct routing(直接路由)技术在Pod的各子网间路由Pod的IP报文 , 或使用Bridge、MAC VLAN或IP VLAN等技术直接将容器暴露给外部网络。
其实 , Overlay网络的底层网络也就是承载网络 , 因此 , Underlay网络的解决方案也就是一类非借助隧道协议而构建的容器通信网络。相较于承载网络 , Overlay网络由于存在额外的隧道报文封装 , 会存在一定程度的性能开销。然而 , 用户在不少场景中可能会希望创建跨越多个L2或L3的逻辑网络子网 , 这就只能借助Overlay封装协议实现。
为Pod配置网络接口是NetPlugin的核心功能之一 , 但不同的容器虚拟化网络解决方案中 , 为Pod的网络名称空间创建虚拟接口设备的方式也会有所不同 , 目前 , 较为注流的实现方式有veth(虚拟以太网)设备、多路复用及硬件交换3种。
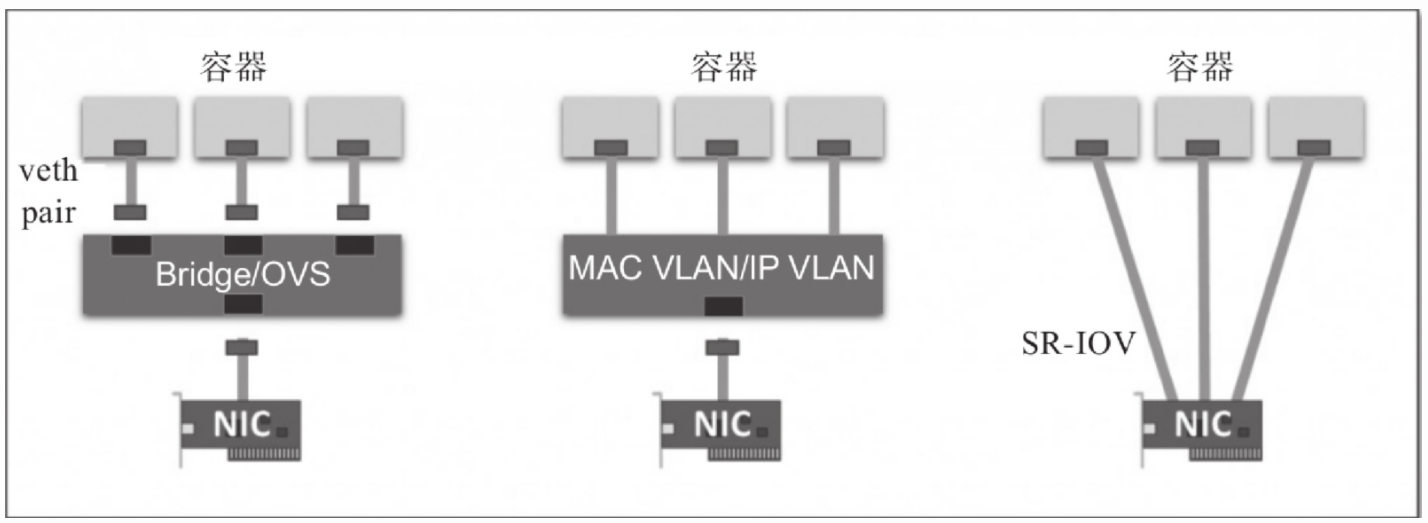
veth设备 : 创建一个网桥 , 并为每个容器创建一对虚拟以太网接口 , 一个接入容器内部 , 另一个留置于根名称空间内添加为Linux内核桥接功能或OpenvSwitch(OVS)网桥的从设备。多路复用 : 多路复用可以由一个中间网络设备组成 , 它暴露多个虚拟接口 , 使用数据包转发规则来控制每个数据包转到的目标接口 ;
MAC VLAN技术为每个虚拟接口配置一个MAC地址并基于此地址完成二层报文收发 ,IP VLAN则是分配一个IP地址并共享单个MAC, 并根据目标IP完成容器报文转发。硬件交换 : 现今市面上有相当数量的
NIC都支持SR-IOV(单根I/O虚拟化) ,SR-IOV是创建虚拟设备的一种实现方式 , 每个虚拟设备自身表现为一个独立的PCI设备 , 并有着自己的VLAN及硬件强制关联的QoS;SR-IOV提供了接近硬件级别的性能。
基于VXLAN Overlay网络的虚拟容器网络中 , NetPlugin会使用虚拟以太网内核模块为每个Pod创建一对虚拟网卡 ; 基于MAC VLAN/IP VLAN Underlay网络的虚拟容器网络中 , NetPlugin 会基于多路复用模式中的MAC VLAN/IP VLAN内核模块为每个Pod创建虚拟网络接口设备 ; 而基于IP报文路由技术的Underlay网络中 , 各Pod接口设备通常也是借助veth设备完成。
相比较来说 , IPAM插件的功能则要简单得多 , 目前可用的实现方 案中 , host-local从本地主机可用的地址空间范围中分配IP地址 , 它 没有地址租约 , 属于静态分配机制 ; 而dhcp插件则需要一个特殊的客户端守护进程(通常是dhcp插件的子组件)运行在宿主机之上 , 它充当本地主机上各容器中的DHCP客户端与网络中的DHCP服务器之间的代理 , 并适当地续定租约。
Kubernetes借助CNI插件体系来组合需要的网络插件完成容器网络编排功能。每次初始倾化或删除Pod对象时 , kubelet都会调用默认的CNI插件创建一个虚拟设备接口附加到相关的底层网络 , 为其设置IP地址、路由信息并将其映射到Pod对象的网络名称空间。具体过程是 , kubelet首先在默认的/etc/cni/net.d/目录中查找JSON格式的CNI配置文件 , 接着基于该配置文件中各插件的type属性到/opt/cni/bin/中查找相关的插件二进制文件 , 由该二进制程序基于提供的配置信息完成相应的操作。
kubelet基于包含命令参数CNI_ARGS、CNI_COMMAND、CNI_IFNAME、CNI_NETNS、CNI_CONTAINERID、CNI_PATH的环境变量调用CNI插件 , 而被调用的插件同样使用JSON格式的文本信息进行响应 , 描述操作结果和状态。Pod对象的名称和名称空间将作为CNI_ARGS变量的一部分进行传递(例如K8S_POD_NAMESPACE=default; K8S_POD_NAME=myapp-6d9f48c5d9-n77qp; ) 。它可以定义每个Pod对象或Pod网络名称空间的网络配置(例如 , 将每个网络名称空间放在不同的子网中)。
1.3 Overlay网络模型
物理网络模型中 , 连通多个物理网桥上的主机的一个简单办法是 通过媒介直接连接这些网桥设备 , 各个主机处于同一个局域网(LAN) 之中 , 管理员只需要确保各个网桥上每个主机的IP地址不相互冲突即 可。类似地 , 若能够直接连接宿主机上的虚拟网桥形成一个大的局域 网 , 就能在数据链路层打通各宿主机上的内部网络 , 让容器可通过自 有IP地址直接通信。为避免各容器间的IP地址冲突 , 一个常见的解决方案是将每个宿主机分配到同一网络中的不同子网 , 各主机基于自有子网向其容器分配IP地址。
显然 , 主机间的网络通信只能经由主机上可对外通信的网络接口 进行 , 跨主机在数据链路层直接连接虚拟网桥的需求必然难以实现 , 除非借助宿主机间的通信网络构建的通信" 隧道 " 进行数据帧转发。 这种于某个通信网络之上构建出的另一个逻辑通信网络通常即1.2节提及的Overlay网络或Underlay网络。图为Overlay网络功能示意图。
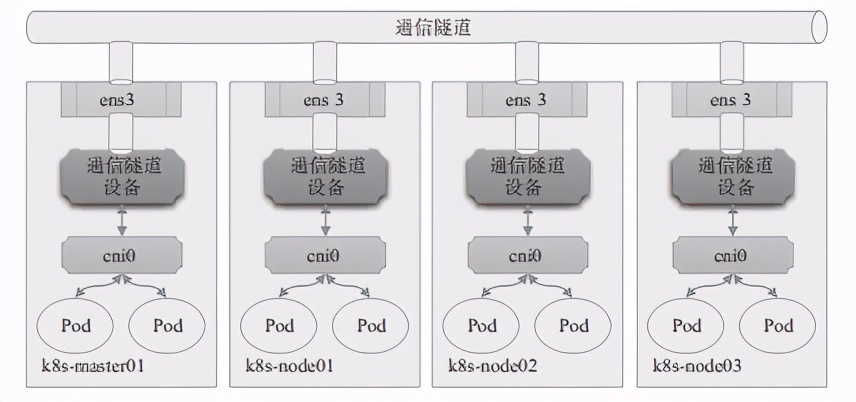
隧道转发的本质是将容器双方的通信报文分别封装成各自宿主机 之间的报文 , 借助宿主机的网络" 隧道 " 完成数据交换。这种虚拟网 络的基本要求是各宿主机只需支持隧道协议即可 , 对于底层网络没有 特殊要求。
VXLAN协议是目前最流行的Overlay网络隧道协议之一 , 它也是由 IETF定义的NVO3(Network Virtualization over Layer 3)标准技术之一 , 采用L2 over L4 ( MAC-in-UDP ) 的报文封装模式 , 将二层报文用三层协议进行封装 , 可实现二层网络在三层范围内进行扩展 , 将 " 二层域 " 突破规模限制形成" 大二层域 " 。那么 , 同一大二层域就 类似于传统网络中VLAN ( 虚拟局域网 ) 的概念 , 只不过在VXLAN网络中 , 它被称作Bridge-Domain , 以下简称为BD。类似于不同的VLAN需要通过VLAN ID进行区分 , 各BD要通过VNI加以标识。但是 , 为了确保 VXLAN机制通信过程的正确性 , 涉及VXLAN通信的IP报文一律不能分片 , 这就要求物理网络的链路层实现中必须提供足够大的MTU值 , 或修改其MTU值以保证VXLAN报文的顺利传输。不过 , 降低默认MTU值 , 以及额外的头部开销 , 必然会影响到报文传输性能。
VXLAN的显著的优势之一是对底层网络没有侵入性 , 管理员只需要 在原有网络之上添加一些额外设备即可构建出虚拟的逻辑网络来。这 个额外添加的设备称为VTEP ( VXLAN Tunnel Endpoints ) , 它工作于VXLAN网络的边缘 , 负责相关协议报文的封包和解包等操作 , 从作用来说相当于VXLAN隧道的出入口设备。
VTEP代表着一类支持VXLAN协议的交换机 , 而支持VXLAN协议的操 作系统也可将一台主机模拟为VTEP , Linux内核自3.7版本开始通过 vxlan内核模块原生支持此协议。于是 , 各主机上由虚拟网桥构建的 LAN便可借助vxlan内核模块模拟的VTEP设备与其他主机上的VTEP设备 进行对接 , 形成隧道网络。同一个二层域内的各VTEP之间都需要建立 VXLAN隧道 , 因此跨主机的容器间直接进行二层通信的VXLAN隧道是各 VTEP之间的点对点隧道 , 如图所示。对于Flannel来说 , 这个VTEP 设备就是各节点上生成flannel.1网络接口 , 其中的" 1 " 是VXLAN中的 BD标识VNI , 因而同一Kubernetes集群上所有节点的VTEP设备属于VNI 为1的同一个BD。
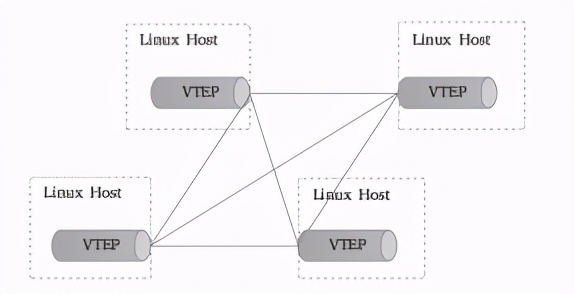
类似VLAN的工作机制 , 相同VXLAN VNI在不同VTEP之间的通信要借 助二层网关来完成 , 而不同VXLAN之间 , 或者VXLAN同非VXLAN之间的通 信则需经由三层网关实现。VXLAN支持使用集中式和分布式两种形式的网关 : 前者支持流量的集中管理 , 配置和维护较为简单 , 但转发效率不高 , 且容易出现瓶颈和网关可用性问题 ; 后者以各节点为二层或三 层网关 , 消除了瓶颈。
然而 , VXLAN网络中的容器在首次通信之前 , 源VTEP又如何得知目 标服务器在哪一个VTEP , 并选择正确的路径传输通信报文呢?常见的解决思路一般有两种 : 多播和控制中心。多播是指同一个BD内的各 VTEP加入同一个多播域中 , 通过多播报文查询目标容器所在的目标 VTEP。而控制中心则在某个共享的存储服务上保存所有容器子网及相 关VTEP的映射信息 , 各主机上运行着相关的守护进程 , 并通过与控制 中心的通信获取相关的映射信息。Flannel默认的VXLAN后端采用的是后一种方式 , 它把网络配置信息存储在etcd系统上。
Linux内核自3.7版本开始支持vxlan模块 , 此前的内核版本可以使用UDP、IPIP或GRE隧道技术。事实上 , 考虑到当今公有云底层网络的功能限制 , Overlay网络反倒是一种最为可行的容器网络解决方案 , 仅 那些更注重网络性能的场景才会选择Underlay网络。
1.4 Underlay
Underlay网络就是传统IT基础设施网络 , 由交换机和路由器等设 备组成 , 借助以太网协议、路由协议和VLAN协议等驱动 , 它还是 Overlay网络的底层网络 , 为Overlay网络提供数据通信服务。容器网络中的Underlay网络是指借助驱动程序将宿主机的底层网络接口直接 暴露给容器使用的一种网络构建技术 , 较为常见的解决方案有MAC VLAN、IP VLAN和直接路由等。
1.4.1 MAC VLAN
MAC VLAN支持在同一个以太网接口上虚拟出多个网络接口 , 每个虚拟接口都拥有唯一的MAC地址 , 并可按需配置IP地址。通常这类虚拟接口被称作子接口 , 但在MAC VLAN中更常用上层或下层接口来表述。与Bridge模式相比 , MAC VLAN不再依赖虚拟网桥、NAT和端口映射 , 它允许容器以虚拟接口方式直接连接物理接口。下图给出了Bridge与MAC VLAN网络对比示意图。
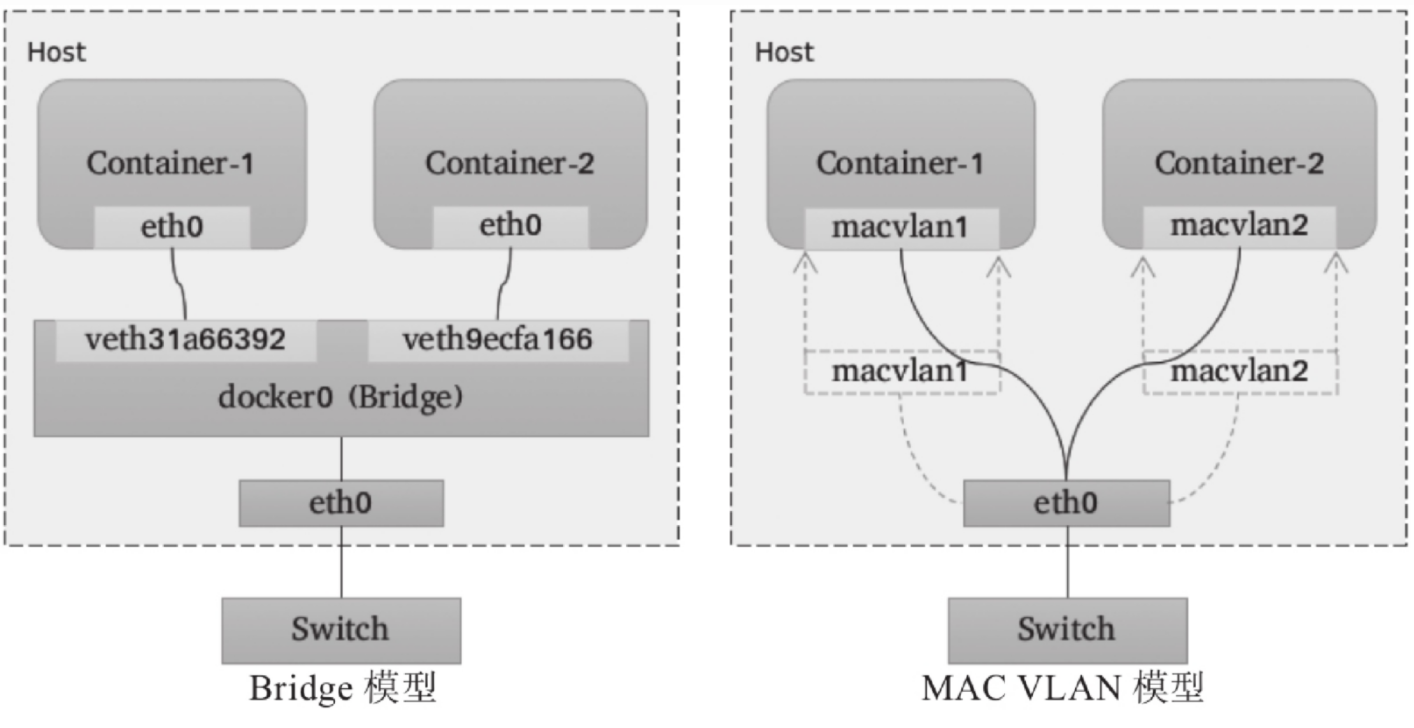
MAC VLAN有Private、VEPA、Bridge和Passthru几种工作模式 , 它们各自的工作特性如下
Private: 禁止构建在同一物理接口上的多个MAC VLAN实例 ( 容器接口 ) 彼此间的通信 , 即便外部的物理交换机支持" 发夹模式 " 也不行简单来说 : 同一父接口下的子接口之间彼此隔离 , 不能通信 , 及时通过外部交换机转发也不行
VPEA: 允许构建在同一物理接口上的多个MAC VLAN实例 ( 容器接口 ) 彼此间的通信 , 但需要外部交换机启用发夹模式 , 或者存在报文转发功能的路由器设备简单来说 :
vepa模式下 , 子接口之间的通信流量需要导到外部支持802.1Qbg/VPEA功能的交换机上 ( 可以是物理的或者虚拟的 ) , 经由外部交换机转发 , 再绕回来Bridge: 将物理接口配置为网桥 , 从而允许同一物理接口上的多个MAC VLAN实例基于此网桥直接通信 , 而无须依赖外部的物理交换机来交换报文 ; 此为最常用的模式 , 甚至还是Docker容器唯一支持的模式简单来说 :
bridge模式下 , 模拟的是Linux bridge的功能 , 但比bridge要好的一点是每个接口的MAC 地址是已知的 , 不用学习 , 所以这种模式下 , 子接口之间就是直接可以通信的Passthru: 允许其中一个MAC VLAN实例直接连接物理接口简单来说 :
passthru模式 , 只允许单个子接口连接父接口source mode: 这种模式 , 只接收源mac为指定的mac地址的报文
由上述工作模式可知 , 除了Passthru模式外的容器流量将被MAC VLAN过滤而无法与底层主机通信 , 从而将主机与其运行的容器完全隔离 , 其隔离级别甚至高于网桥式网络模型 , 这对于有多租户需求的场景尤为有用。由于各实例都有专用的MAC地址 , 因此MAC VLAN允许传输广播和多播流量 , 但它要求物理接口工作于混杂模式 , 考虑到很多公有云环境中并不允许使用混杂模式 , 这意味着MAC VLAN更适用于本地网络环境。 需要注意的是 , MAC VLAN为每个容器使用一个唯一的MAC地址 , 这可能会导致具有安全策略以防止MAC欺骗的交换机出现问题 , 因为这类交换机的每个接口只允许连接一个MAC地址。另外 , 有些物理网卡存在可支撑的MAC地址数量上限
需要注意的是 , MAC VLAN为每个容器使用一个唯一的MAC地址 , 这 可能会导致具有安全策略以防止MAC欺骗的交换机出现问题 , 因为这类交换机的每个接口只允许连接一个MAC地址。另外 , 有些物理网卡存在 可支撑的MAC地址数量上限。
1.4.2 IP VLAN
IP VLAN类似于MAC VLAN , 它同样创建新的虚拟网络接口并为每个接口分配唯一的IP地址 , 不同之处在于 , 每个虚拟接口将共享使用物理接口的MAC地址 , 从而不再违反防止MAC欺骗的交换机的安全策略 , 且不要求在物理接口上启用混杂模式。
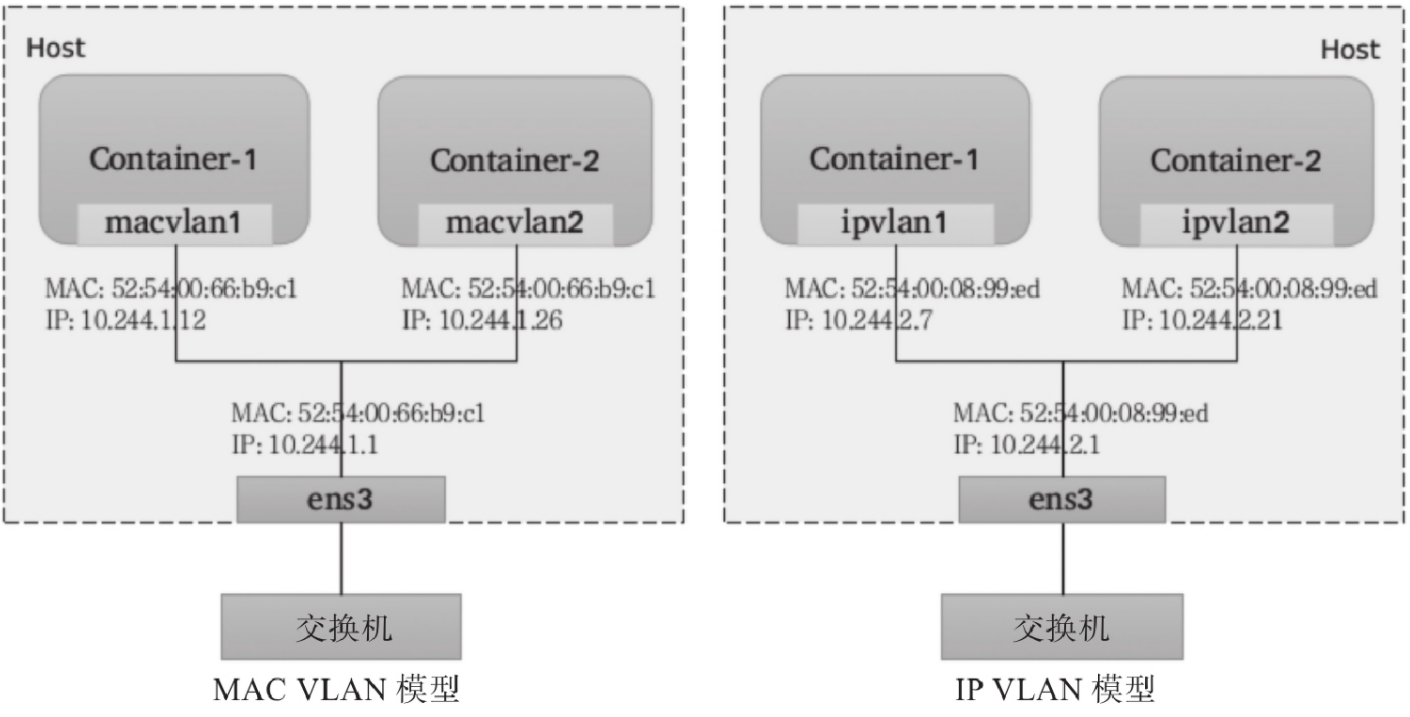
IP VLAN有L2和L3两种模型 , 其中IP VLAN L2的工作模式类似于MAC VLAN Bridge模式 , 上层接口(物理接口)被用作网桥或交换机 , 负责为下层接口交换报文 ; 而IP VLAN L3模式中 , 上层接口扮演路由器的角色 , 负责为各下层接口路由报文 , 如下图所示。
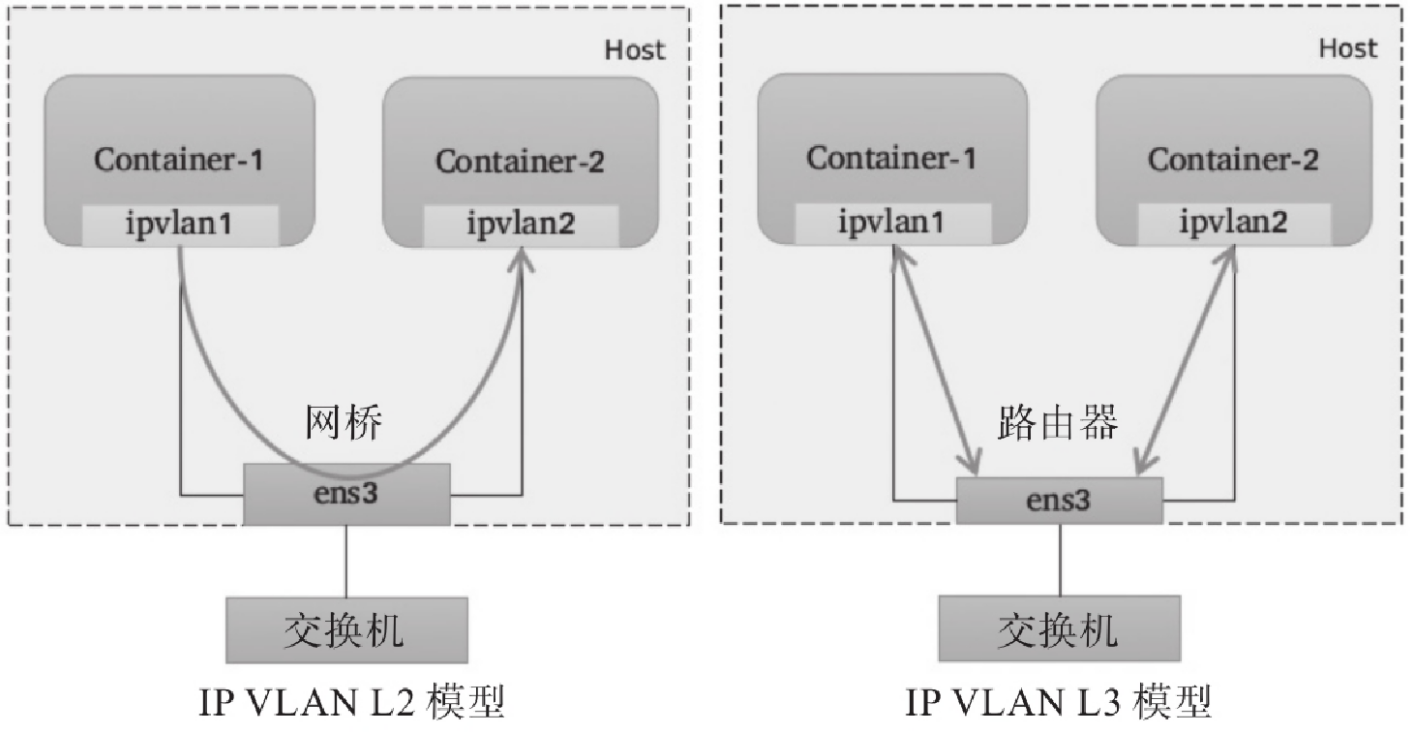
IP VLAN L2模型与MAC VLAN Bridge模型都支持ARP协议和广播流量 , 它们拥有直接接入网桥设备的网络接口 , 能够通过802.1d数据包进行泛洪和MAC地址学习。但IP VLAN L3模式下 , 网络栈在容器内处理 , 不支持多播或广播流量 , 从这个意义上讲 , 它的运行模式与路由器的报文处理机制相同。
虽然支持多种网络模型 , 但MAC VLAN和IP VLAN不能同时在同一物理接口上使用。Linux内核文档中强调 , MAC VLAN和IP VLAN具有较高的相似度 , 因此 , 通常仅在必须使用IP VLAN的场景中才不使用MAC VLAN。一般说来 , 强依赖于IP VLAN的场景有如下几个 :
Linux主机连接到的外部交换机或路由器启用了防止MAC地址欺骗的安全策略 ;虚拟接口的需求数量超出物理接口能够支撑的容量上限 , 并且将接口置于混杂模式会给性能带来较大的负面影响 ;
将虚拟接口放入不受信任的网络名称空间中可能会导致恶意的滥用。
需要注意的是 , Linux内核自4.2版本后才支持IP VLAN网络驱动 , 且在Linux主机上使用ip link命令创建的802.1q配置接口不具有持久性 , 因此需依赖管理员通过网络启动脚本保持配置。
1.4.3 直接路由
" 直接路由 " 模型放弃了跨主机容器在L2的连通性 , 而专注于通过路由协议提供容器在L3的通信方案。这种解决方案因为更易于集成到现在的数据中心的基础设施之上 , 便捷地连接容器和主机 , 并在报文过滤和隔离方面有着更好的扩展能力及更精细的控制模型 , 因而成为容器化网络较为流行的解决方案之一。
一个常用的直接路由解决方案如下图所示 , 每个主机上的各容器在二层通过网桥连通 , 网关指向当前主机上的网桥接口地址。跨主机的容器间通信 , 需要依据主机上的路由表指示完成报文路由 , 因此每个主机的物理接口地址都有可能成为另一个主机路由报文中的" 下一跳" , 这就要求各主机的物理接口必须位于同一个L2网络中。
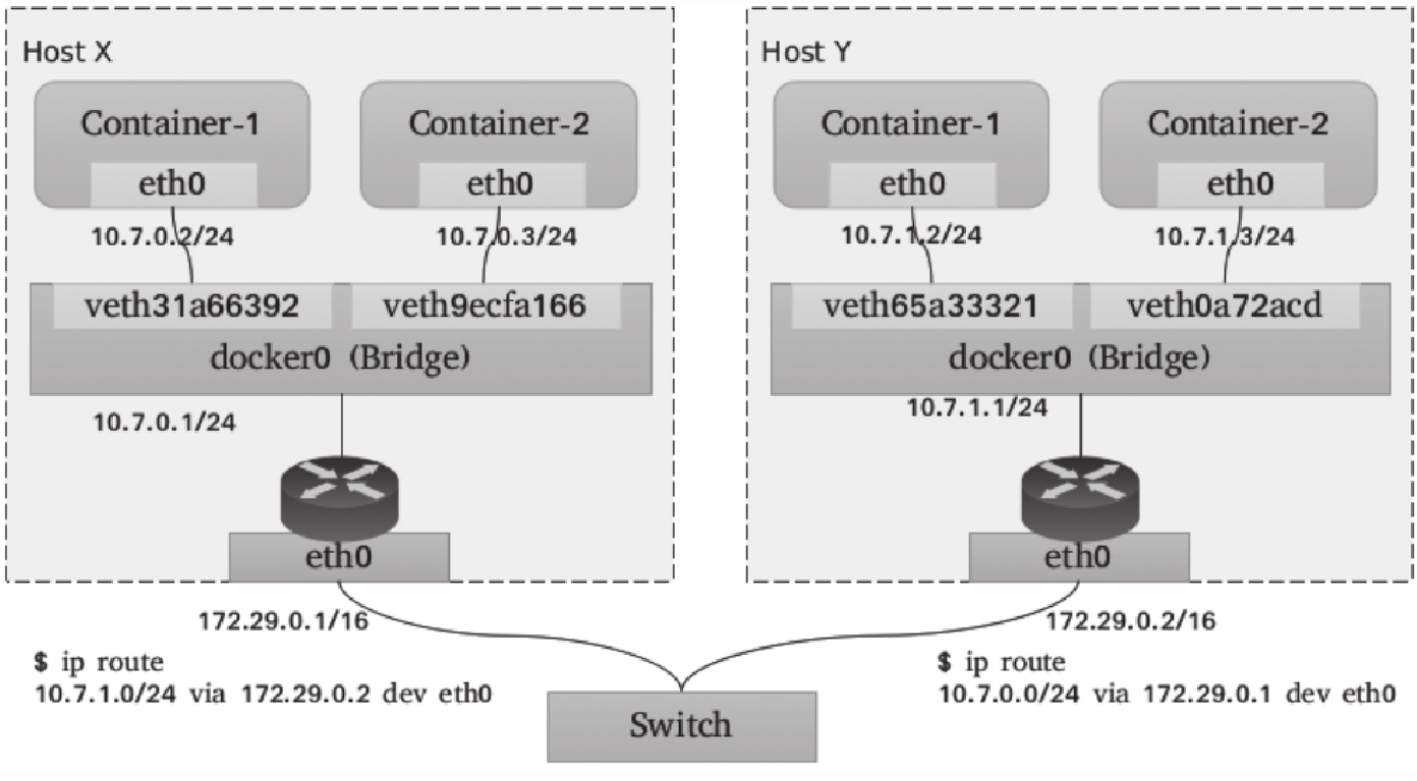
直接路由的宿主机必须在同一个网段 , 不能跨网段访问。
在较大规模的主机集群中 , 问题的关键是如何更好地为每个主机维护路由表信息。常见的解决方案有 :
Flannel host-gw使用存储总线etcd和工作在每个节点上的flanneld进程动态维护路由 ;Calico使用BGP(Border Gateway Protocol) 协议在主机集群中自动分发和学习路由信息。与Flannel不同的是 ,Calico并不会为容器在主机上使用网桥 , 而是仅为每个容器生成一对veth设备 , 留在主机上的那一端会在主机上生成目标地址 , 作为当前容器的路由条目 , 如下图所示。
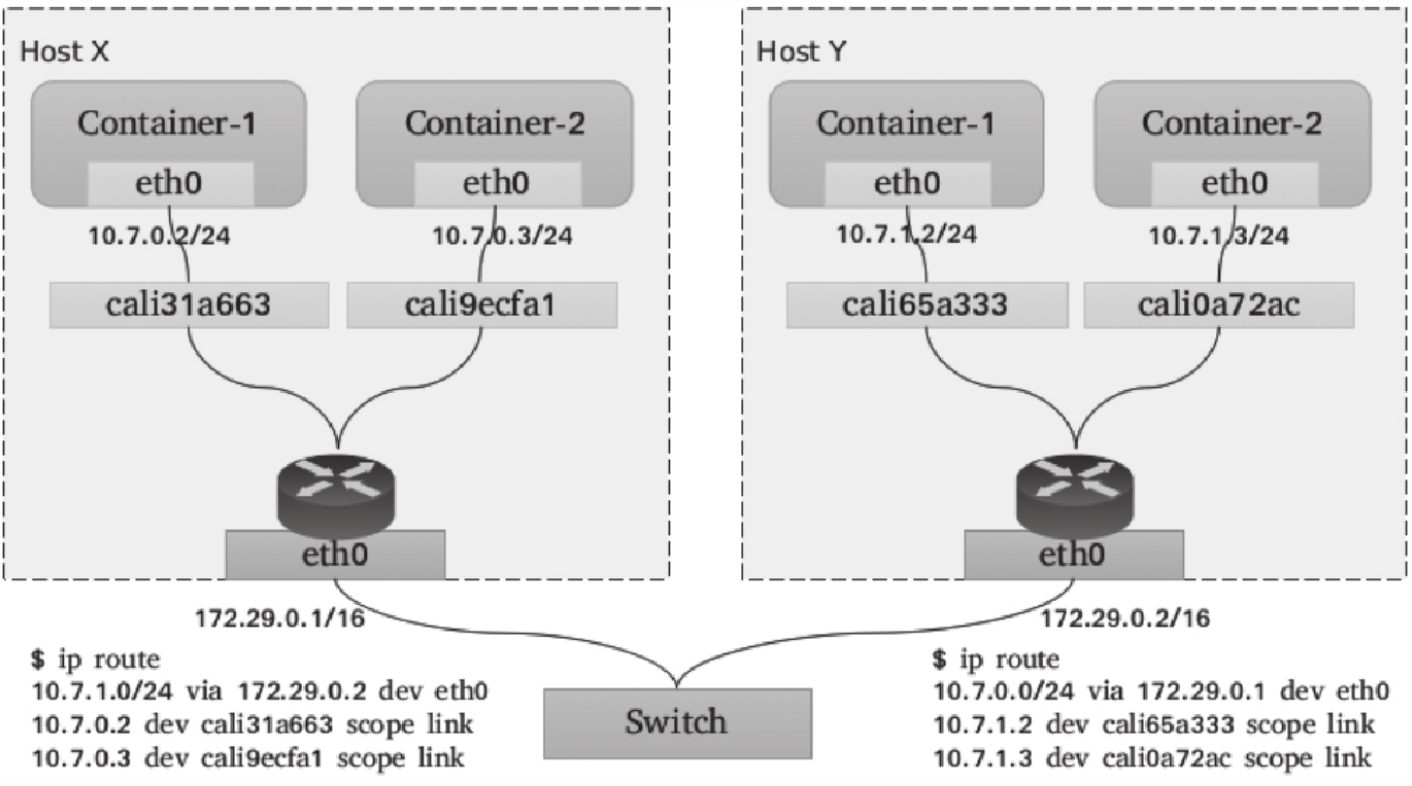
显然 , 较Overlay来说 , 无论是MAC VLAN、IP VLAN还是直接路由机制的Underlay网络模型的实现 , 它们因无须额外的报文开销而通常有着更好的性能表现 , 但对底层网络有着更多的限制条件。
1.5 配置CNI插件
CNI具有很强的扩展性和灵活性 , 例如 , 如果用户对某个插件有特殊的需求 , 可以通过输入中的args和环境变量CNI_ARGS传递 , 然后在 插件中实现自定义的功能 , 这大大增加了它的扩展性。CNI插件把main 和ipam分开 , 为用户提供了自由组合它们的机制 , 甚至一个CNI插件也 可以直接调用另外一个插件。
CNI项目中有两个代码仓库 : 一个是提供用于开发CNI网络插件的 库文件libcni , 以及命令行工具cnitool的 containernetworking/cni ; 另一个是CNI内置的插件程序 containernetworking/plugins , 它目前附带了如下几类网络插件。
main类别中 , 各插件主要用于创建容器和容器接口 , 内置的实现有如下几个。bridge: 创建一个虚拟网桥 , 并将宿主机和每个Pod接入该网桥。ipvlan: 向容器中添加一个IP VLAN网络接口。macvlan: 向容器中添加一个MAC VLAN网络接口 , 创建一个新MAC地址 , 并基于该地址向容器转发报文。loopback: 设置容器lo接口的状态。ptp: 创建一对veth设备。vlan: 分配一个VLAN设备。host-device: 将宿主机现有的某网络接口移入Pod中。
ipam类别中 , 各插件用于为容器分配IP地址 , 内置的实现包括host-local、dhcp和static。dhcp: 在每个节点上运行一个dhcp守护进程 , 它负责代理该节点 上的所有容器中的dhcp客户端向dhcp服务发起请求。host-local: 基于本地的IP地址分配数据库 , 完成地址分配。static: 为容器接口直接指定一个静态IP地址 , 仅应该用于调试目的。
meta类别的网络插件不实现任何网络功能 , 它们调用其他网络 工具或插件完成管理功能 , 内置的实现有如下几个。flannel: 根据Flannel配置文件生成网络接口。tuning: 调整现存某接口的sysctl参数值。portmap: 使用iptables将宿主机的端口映射至容器端口 , 实现hostPort功能。bandwidth: 基于流量控制工具tbf进行带宽限制。sbr: 为接口配置基于源IP地址的路由。firewall: 防火墙插件 , 使用iptables或firewalld规则管理进出的流量。
具体操作方面 , CNI网络插件通常应该支持添加 ( ADD ) 、删除 ( DEL ) 、检验 ( CHECK ) 和报告版本信息 ( VERSION ) 几个管理操作。 除了VERSION外 , 其他3个操作通常都需要用到以下几个方面的配置信息。
Container ID: 容器标识 , 用于引用容器网络名称空间。网络名称空间 (
netns) 路径 : 即配置的目标网络名称空间的访 问路径 , 例如/proc/[pid]/ns/net等 ; 通常指定引用的容器ID后 , 其 网络名称空间路径可通过容器的相关属性获取。网络配置参数 : 一个
JSON格式的配置文件 , 描述了配置容器网络 的各相关参数 , 例如/etc/cin/net.d/10-mynet.json。其他配置参数 : 用于在容器级别为每个容器提供一个简单的配置方式 , 以取代统一配置机制。
容器内的网络接口名称 : 网络插件配置的目标接口 , 需要是遵循
Linux系统网络插件命名规范的接口名称。
在含有网络配置参数的JSON格式的配置文件中 , type属性用于指 定要调用的网络插件的名称 , 调用者 ( 例如Kubernetes或OpenShift 等) 可从预定义的目标列表中查找相关网络插件的可执行文件 , 并通 过如下几个变量向其传递参数。
CNI_COMMAND: 需要执行的网络管理操作 , 例如ADD、DEL、CHECK或VERSION。CNI_CONTAINERID: 容器ID。CNI_NETNS: 网络名称空间相关的文件路径。CNI_IFNAME: 目标网络接口的名称 , 如果插件无法使用此接口 , 则必须返回错误。CNI_ARGS: 额外传入的参数。CNI_PATH: 搜索CNI插件时使用的目标路径列表。CNI_CONF_NAME: 使用的网络配置文件。
插件的相关管理操作执行成功时以0为返回码 , 其中ADD操作成功 时的返回结果是一个JSON格式的输出 , 它通常包含cniVersion、 interfaces、ips、routes和dns几个数据段。
如前所述 , kubelet中的CNI网络插件的配置文件以JSON格式表 达 , 它可以以静态格式存储于磁盘上 , 也可以由容器管理系统从其他 源动态生成 , 下面是配置文件中的常用字段:
cniVersion <string> # CNI配置文件的语义版本
name <string> # 网络的名称 , 在当前主机上必须唯一
type <string>:  # CNI插件的可执行文件名
args <map[string]string> # 由容器管理系统提供的附加参数 , 可选配置
ipMasq <Boolean> # 是否启用IP伪装 , 可选参数
ipam <map[string]string> # IP地址分配插件 , 主要有host-local和dhcp
 type <string> # 能够完成IP地址分配的插件的名称
 subnet <string> # 分配IP地址时使用的子网地址
 routes <string> # 路由信息
 dst <string> # 目标主机或网络
 gw <string> # 网关地址
dns <map[string]string> # 配置容器的DNS属性
 nameservers <[]string> # DNS名称服务器列表 , 其值为ipv4或ipv6格式的地址
 domain <[]string> # 用于短格式主机查找的本地域
 search <[]string> # 用于短格式主机查找的优先级排序的搜索域列表
 options <[]string> # 传递给解析程序的选项列表
作为基本功能的一个组成部分 , CNI插件需要为接口分配和维护IP 地址 , 并负责为IP地址生成必要的路由信息。这为CNI插件提供了极大的灵活性的同时也引入了较大负担 , 并且众多CNI插件可能需要重复提 供相同的代码以完成此类功能。于是 , IP地址分配通常由独立的IP地址管理(IPAM)插件负责 , 并由CNI插件进行调用以完成代码复用 , 常用的IP地址分配类型有host-local和dhcp两个 , 它们负责分配地址并将结果返回给调用者。
IPAM插件同CNI插件一样 , 都是通过运行相关的可执行文件进行调 用 , 调用者在由CNI_PATH变量预定义的路径列表中搜索目标IPAM的可 执行文件。IPAM插件必须接收所有传递给CNI插件的相同环境变量 , 类 似于CNI插件 , IPAM插件也通过标准输入(stdin)接收网络配置信息。
下面是一个示例配置 , 它使用Bridge插件 , ipam调用类型为hostlocal , 它通过在一个地址范围内挑选一个未使用的IP完成地址分配:
{
 "cniVersion": "0.4.0",
 "name": "mynet",
 "type": "bridge",
 // 插件类型专有的配置
 "bridge": "cni0",
 "ipam": {
 "type": "host-local",
 // ipam专有的配置
 "subnet": "10.1.0.0/16",
 "gateway": "10.1.0.1"
 },
 "dns": {
 "nameservers": [ "10.1.0.1" ]
 }
}CNI还支持使用plugins字段组合多个CNI网络插件依次进行网络配置 , 以实现将核心网络管理插件和meta插件等相组合 , 以堆叠出一个 完整的解决方案。各插件以列表形式依次定义 , 前一个插件的配置结果将传递给后一个插件 , 直到列表中的所有插件都成功配置完成。下 面是摘自Flannel自行提供给CNI的网络配置 , 它使用网络配置列表 , 分别调用了Flannel插件和PortMap插件来配置容器网络。
{
    "name": "cbr0",
   "plugins": [
   {
      "type": "flannel",
      "delegate": {
      "hairpinMode": true,
      "isDefaultGateway": true
      }
   },
   {
      "type": "portmap",
      "capabilities": {
      "portMappings": true
      }
    }
    ]
}delegate是指将网络配置 " 委派 " 给某个指定的CNI内置插件来完 成 , 对于Flannel插件来说 , 它通过delegate调用的插件是Bridge , 因 此容器网络配置实质上是由Bridge插件完成 , Flannel不过是借助 delegate向Bridge插件传递部分配置参数 , 例如网络地址 10.244.0.0/16等信息。
另外 , delegate配置段中的haripinMode参数用于定义是否启用发 夹模式 , 在容器中的应用通过宿主机的端口映射(NAT)访问自己提供 的服务时 , 此模式必须要置于启用状态 , 因为默认情况下 , 网桥设备不允许一个数据报文从同一端口进行收发操作 , 而发夹模式正是用于 取消限制。例如 , 某Pod作为客户端访问自己所属Service对象又碰巧 被算法调度回自身时 , 就必须要启用发夹模式。
1.6 CNI插件与选型
CNI规范负责连接容器管理系统和网络插件两类组件 , 它们之间通过JSON格式的文件进行通信 , 以完成容器网络管理。具体的管理操作均由插件来实现 , 包括创建容器netns ( 网络名称空间) 、关联网络接口到对应的netns , 以及给网络接口分配IP等。CNI的基本思想是为容器运行时环境在创建容器时 , 先创建好netns , 然后调用CNI插件为这个netns配置网络 , 而后启动容器内的进程。
CNI本身只是规范 , 付诸生产还需要有特定的实现。如前所述 , 目前CNI提供的插件分为main、ipam和meta , 各类别中都有不少内置实现。另外 , 可用的第三方实现的CNI插件也有数十种之多 , 它们多数都是用于提供NetPlugin功能 , 隶属main插件类型 , 主要用于配置容器接口和容器网络 , 这其中 , 也有不少实现能够支持Kubernetes的网络策略。下面是较为流行的部分网络插件项目。
Flannel: 由CoreOS提供的CNI网络插件 , 也是最简单、最受欢迎的网络插件 ; 它使用VXLAN或UDP协议封装IP报文来创建Overlay网络 , 并借助etcd维护网络的分配信息 , 同一节点上的Pod间通信可基于本地虚拟网桥(cni0)进行 , 而跨节点的Pod间通信则要由flanneld守护进程封装隧道协议报文后 , 通过查询etcd路由到目的地 ;Flannel也支持host-gw路由模型。Calico: 同Flannel一样广为流行的CNI网络插件 , 以灵活、良好的性能和网络策略所著称。Calico是路由型CNI网络插件 , 它在每台机器上运行一个vRouter, 并基于BGP路由协议在节点之间路由数据包。Calico支持网络策略 , 它借助iptables实现访问控制功能。另外 ,Calico也支持IPIP型的Overlay网络。Canal: 由Flannel和Calico联合发布的一款统一网络插件 , 它试图将二者的功能集成在一起 , 由前者提供CNI网络插件 , 由后者提供网络策略。WeaveNet: 由Weaveworks提供的CNI网络插件 , 支持网络策略。WeaveNet需要在每个节点上部署vRouter路由组件以构建起一个网格化的TCP连接 , 并通过Gossip协议来同步控制信息。在数据平面上 ,WeaveNet通过UDP封装实现L2隧道报文 , 报文封装支持两种模式: 一种是运行在用户空间的sleeve(套筒)模式 , 另一种是运行在内核空间的fastpath(快速路径)模式 , 当网络拓扑不适合fastpath模式时 ,Weave将自动切换至sleeve模式。Multus CNI: 多CNI插件 , 实现了CNI规范的所有参考类插件 ( 例如Flannel、MAC VLAN、IPVLAN和DHCP等) 和第三方插件 ( 例如Calico、Weave和Contiv等) , 也支持Kubernetes中的SR-IOV、DPDK、OVS-DPDK和VPP工作负载 , 以及Kubernetes中的云原生应用程序和基于NFV的应用程序 , 是需要为Pod创建多网络接口时的常用选择。Antrea: 一款致力于成为Kubernetes原生网络解决方案的CNI网络插件 , 它使用OpenvSwitch构建数据平面 , 基于Overlay网络模型完成Pod间的报文交换 , 支持网络策略 , 支持使用IPSec ESP加密GRE隧道流量。DAMM: 由诺基亚发布的电信级的CNI网络插件 , 支持具有高级功能的IP VLAN模式 , 内置IPAM模块 , 可管理多个集群范围内的不连续三层网络 ; 支持通过CNI meta插件将网络管理功能委派给任何其他网络插件。kube-router:kube-router是Kubernetes网络的一体化解决方案 , 它可取代kube-proxy实现基于ipvs的Service, 能为Pod提供网络 , 支持网络策略以及拥有完美兼容BGP协议的高级特性。
尽管人们倾向于把Overlay网络作为解决跨主机容器网络的主要解决方案 , 但可用的容器网络插件在功能和类型上差别巨大: 某些解决方案与容器引擎无关 , 而也有些解决方案作用后 , 容易被特定的供应商或引擎锁定 ; 有些专注于简单易用 , 而另一些的主要目标则是更丰富的功能特性等 , 至于哪一个解决方案更适用 , 通常取决于应用程序自身的需求 , 例如性能需求、负载位置编排机制等。通常来说 , 选择网络插件时应该基于底层系统环境限制、容器网络的功能需求和性能需求3个重要的评估标准来衡量插件的适用性。
底层系统环境限制: 公有云环境多有自己专有的实现 , 例如
Google GCE、Azure CNI、AWS VPC CNI和Aliyun Terway等 , 它们通常是相应环境上较佳的选择。若虚拟化环境限制较多 , 除Overlay网络模型别无选择 , 则可用的方案有Flannel VXLAN、Calico IPIP、Weave和Antrea等。物理机环境几乎支持任何类型的网络插件 , 此时一般应该选择性能较好的Calico BGP、Flannel host-gw或DAMM IP VLAN等。容器网络功能需求 : 支持
NetworkPolicy的解决方案以Calico、WeaveNet和Antrea为代表 , 而且后两个支持节点到节点间的通信加密。而大量Pod需要与集群外部资源互联互通时 , 应该选择Underlay网络模型一类的解决方案。容器网络性能需求:
Overlay网络中的协议报文有隧道开销 , 性能略差 , 而Underlay网络则几乎不存这方面的问题 , 但Overlay或Underlay路由模型的网络插件支持较快的Pod创建速度 , 而Underlay模型中的IP VLAN或MAC VLAN模式则较慢。
2. Flannel网络插件
Flannel是用于解决容器跨节点通信问题的解决方案 , 兼容CNI插件API , 支持Kubernetes、OpenShift、Cloud Foundry、Mesos、 Amazon ECS、Singularity和OpenSVC等平台。它使用 " 虚拟网桥和veth设备 " 的方式为Pod创建虚拟网络接口 , 通过可配置的 " 后端 " 定义Pod间的通信网络 , 支持基于VXLAN和UDP的Overlay网络 , 以及基于三层路由的Underlay网络。在IP地址分配方面 , 它将预留的一个专用网络 (默认为10.244.0.0/16) 切分成多个子网后作为每个节点的Pod CIDR , 而后由节点以IPAM插件的host-local形式进行地址分配 , 并将子网分配信息保存于etcd之中。
2.1 Flannel配置基础
Flannel在每个主机上运行一个名为flanneld的二进制代理程序 , 它负责从预留的网络中按照指定或默认的掩码长度为当前节点申请分配一个子网 , 并将网络配置、已分配的子网和辅助数据 ( 例如主机的公网IP等) 存储在Kubernetes API或etcd之中。Flannel使用称为后端的容器网络机制转发跨节点的Pod报文 , 它目前支持的主流后端如下。
vxlan: 使用Linux内核中的vxlan模块封装隧道报文 , 以Overlay网络模型支持跨节点的Pod间互联互通 ; 同时 , 该后端类型支持直接路由模式 , 在该模式下 , 位于同一二层网络内节点之上的Pod间通信可通过路由模式直接发送 , 而跨网络的节点之上的Pod间通信仍要使用VXLAN隧道协议转发 ; 因而 ,VXLAN隶属于Overlay网络模型 , 或混合网络模型 ;vxlan后端模式中 ,flanneld监听UDP的8472端口发送的封装数据包。host-gw: 即Host GateWay, 它类似于VXLAN中的直接路由模式 , 但不支持跨网络的节点 , 因此这种方式强制要求各节点本身必须在同一个二层网络中 , 不太适用于较大的网络规模 ;host-gw有着较好的转发性能 , 且易于设定 , 推荐对报文转发性能要求较高的场景使用。udp: 使用常规UDP报文封装完成隧道转发 , 性能较前两种方式低很多 , 它仅在不支持前两种后端的环境中使用 ;UDP后端模式中 ,flanneld监听UDP的8285端口发送的封装报文。
Flannel初创的一段时期 , 不少环境中使用的主流Linux发行版的内核尚且不支持VXLAN , 而host-gw模式有着略高的网络技术门槛 , 多数部署场景只好采用了UDP后端 , Flannel也就不幸地被冠以性能不好的声名。好在 , 随着各主流Linux发行版内核版本内置支持vxlan模块 , Flannel默认使用的后端也进化为VXLAN , 再启用直接路由特性后会有着相当不错的性能表现。另外 , 除了这3种后端之外 , Flannel还实验性地支持IPIP、IPSec、AliVPC、AWS VPC、Alloc和GCE几种后端。
为了跟踪各子网分配信息等 , Flannel使用etcd来存储虚拟IP和主机IP之间的映射 , 每个节点上运行的flanneld守护进程负责监视etcd 中的信息并完成报文路由。默认情况下 , Flannel的配置信息保存在 etcd存储系统的键名/coreos.com/network/config之下 , 我们可以使用etcd服务的客户端工具来设定或修改其可用的相关配置。config的值是一个JSON格式的字典数据结构 , 它可以使用的键包含以下几个。
Network:Flannel在全局使用CIDR格式的IPv4网络 , 字符串格式 , 此为必选键 , 余下的均为可选。SubnetLen: 为全局使用的IPv4网络基于多少位的掩码切割供各节点使用的子网 , 在全局网络的掩码小于24( 例如16) 时默认为24位。SubnetMin: 分配给节点使用的起始子网 , 默认为切分完成后的第一个子网 ; 字符串格式。SubnetMax: 分配给节点使用的最大子网 , 默认为切分完成后的最大一个子网 ; 字符串格式。Backend:Flannel要使用的后端类型 , 以及后端相关的配置 , 字典格式 ; 不同的后端通常会有专用的配置参数。
Flannel项目官方给出的在线配置清单中默认使用的VXLAN后端 , 相关的配置定义在kube-system名称空间ConfigMap资源kube-flannel-cfg中 , 配置内容如下所示。
  net-conf.json: |
    {
      "Network": "10.244.0.0/16",
      "Backend": {
        "Type": "vxlan"
      }
    }
上面的配置示例可以看出 , Flannel预留使用的网络为默认的 10.244.0.0/16 , 默认使用24位长度的子网掩码为各节点分配切分的子网 , 因而 , 它将有10.244.0.0/24~10.244.255.0/24范围内的256个子网可用 , 每个节点最多支持为254个Pod对象各分配一个IP地址。它使用的后端是VXLAN类型 , flanneld将监听UDP的8472端口。
2.2 VXLAN后端
Flannel会在集群中每个运行flanneld的节点之上创建一个名为flannel.1的虚拟网桥作为本节点隧道出入口的VTEP设备 , 其中的1表示VNI , 因而所有节点上的VTEP均属于同一VXLAN , 或者属于同一个大二层域 ( BD) , 它们依赖于二层网关进行通信。Flannel采用了分布式的网关模型 , 它把每个节点都视为到达该节点Pod子网的二层网关 , 相应的路由信息由flanneld自动生成。
Flannel需要在每个节点运行一个flanneld守护进程 , 启动时 , 该进程从etcd加载JSON格式的网络配置等信息 , 它会基于网络配置获取适用于当前节点的子网租约 , 还要根据其他节点的租约生成路由信息 , 以正确地路由数据报文等。与Kubernetes结合使用时 , flanneld也可托管给集群之上的DeamonSet控制器。Flannel项目仓库中的在线配置清单通过名为kube-flannel-ds的DaemonSet控制器资源 , 在每个节点运行一个Flannel相关的Pod对象 , Pod模板中使用hostNetwork: true进行网络配置 , 让每个节点上的Pod资源直接共享节点的网络名称空间 , 因而配置结果直接在节点的根网络名称空间生效。
在VXLAN模式下 , flanneld从etcd获取子网并配置了后端之后会生成一个环境变量文件 ( 默认为/run/flannel/subnet.env) , 其中包含本节点使用的子网 , 以及为了承载隧道报文而设置的MTU的定义等 , 如下面的配置示例所示。随后 , flanneld还将持续监视etcd中相应配置租约信息的变动 , 并实时反映到本地路由信息之上。
FLANNEL_NETWORK=10.244.0.0/16
FLANNEL_SUBNET=10.244.0.1/24
FLANNEL_MTU=1450
FLANNEL_IPMASQ=true为了确保VXLAN机制通信过程的正确性 , 通常涉及VXLAN通信的IP报文一律不能分片 , 这就要求物理网络的链路层实现中必须提供足够大的MTU值 , 或修改各节点的MTU值以保证VXLAN报文的顺利传输 , 如上面配置示例中使用的1450字节。降低默认MTU值 , 以及额外的头部开销 , 必然会影响到报文传输过程中的数据交换效率。
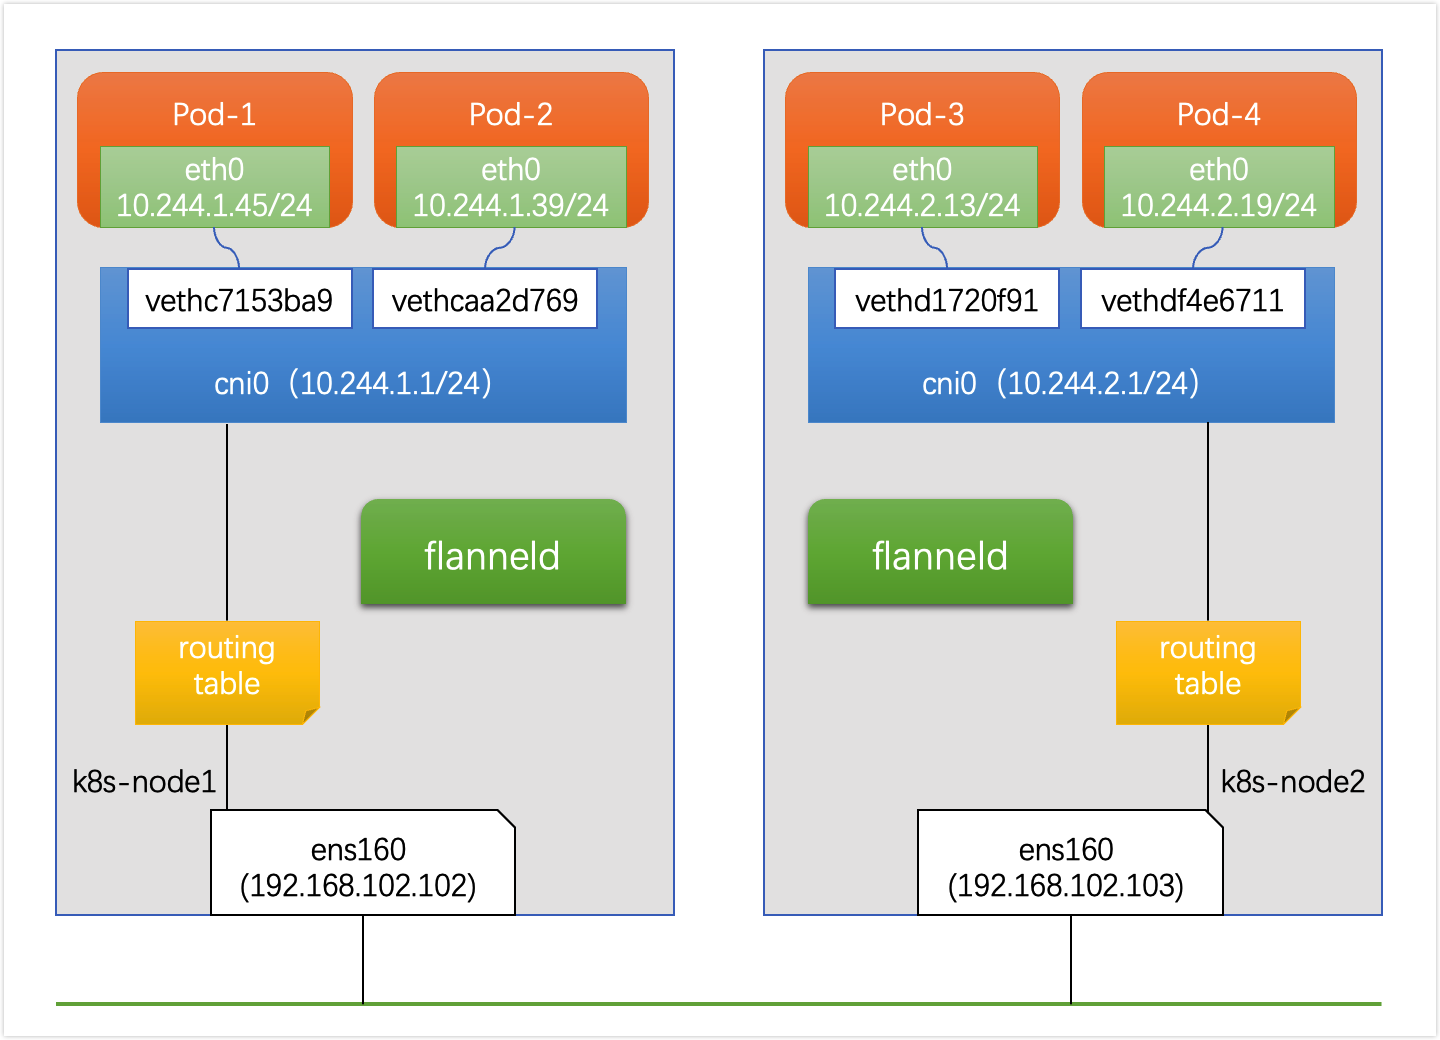
使用kubeadm部署Kubernetes集群之后 , 基于Flannel项目的在线配置清单部署了默认VXLAN后端的Flannel网络插件 , 因而默认的跨节点Pod间均是通过Overlay网络进行通信 , 如下图中的Pod-1和Pod-4 , 而同节点的Pod对象关联在同一个虚拟网桥cni0之上 , 彼此间可无须隧道而直接进行通信 , 如下图中的Pod-1和Pod-2。
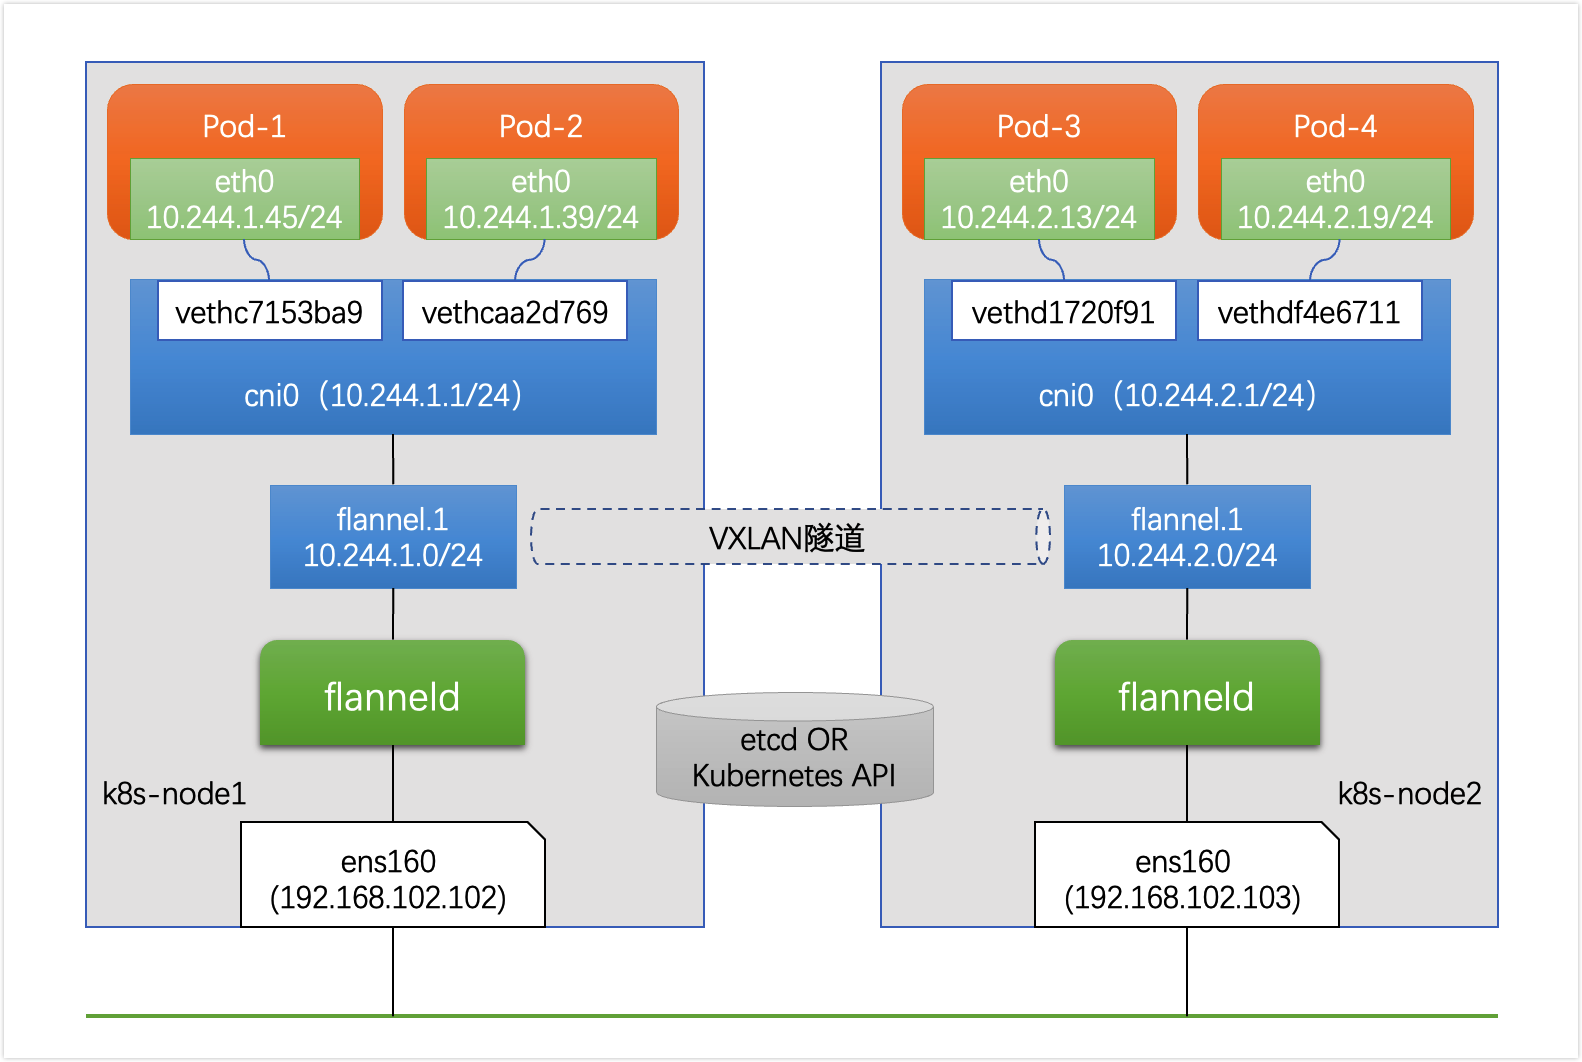
下面的路由信息取自k8s-node1节点 , 它由该节点上的flanneld根据集群中各节点获得的子网信息生成。
10.244.0.0/24 via 10.244.0.0 dev flannel.1 onlink
10.244.1.0/24 dev cni0 proto kernel scope link src 10.244.1.1
10.244.2.0/24 via 10.244.2.0 dev flannel.1 onlink
其中 , 10.244.0.0/24有k8s-master使用 , 10.244.1.0/24由k8s-node1节点使用 , 10.244.2.0/24由k8s-node2节点使用。这些路由条目恰恰反映了同节点Pod间通信时经由cni0虚拟网桥转发 , 而跨节点Pod间通信时 , 报文将由当前节点(k8s-node1)的flannel.1隧道入口 ( VTEP设备) 外发 , 隧道出口由 " 下一跳 " 信息指定 , 例如到达10.244.2.0/24网络的报文隧道出口是10.244.2.0指向的接口 , 它配置在k8s-node2的 flannel.1接口之上 , 该接口正是k8s-node2上的隧道出入口 ( VTEP设备) 。
VXLAN网络将各VTEP设备作为同一个二层网络上的接口 , 这些接口设备组成一个虚拟的二层网络。因而 , 上图中的Pod-1发往Pod-4的IP报文将在流经其所在节点的flannel.1接口时封装成数据帧 , 源MAC是k8s-node1节点上的flannel.1接口的MAC地址 , 而目标MAC则是k8s-node2节点上flannel.1接口的MAC地址。但Flannel并非依赖ARP进行 MAC地址学习 , 而是由节点上的flanneld进程启动时将本地flannel.1接口IP与MAC地址的映射信息上报到etcd中 , 并由其他各节点上的 flanneld来动态生成相应的解析记录。下面的解析记录取自k8s-node1节点 , 它们分别指明了集群中的其他节点上的flannel.1接口各自对应的MAC地址 , PERMANENT属性表明这些记录均永久有效。
[root@k8s-node1 ~]# ip neighbour show | awk '$3=="flannel.1"{print $0}'
10.244.2.0 dev flannel.1 lladdr 5e:5f:7e:bd:65:ea PERMANENT
10.244.0.0 dev flannel.1 lladdr 76:7d:9c:b5:29:9d PERMANENTVXLAN协议使用UDP报文封装隧道内层数据帧 , Pod发出的报文经隧道入口flannel.1封装成数据帧 , 再由flanneld进程 ( 客户端) 封装成 UDP报文 , 之后发往目标Pod对象所在节点的flanneld进程 ( 服务端) 。该UDP报文就是所谓的VXLAN隧道 , 它会在已经生成的帧报文之外再封装一组协议头部 , 如下图所示为VXLAN头部、外层UDP头部、 外层IP头部和外层帧头部。
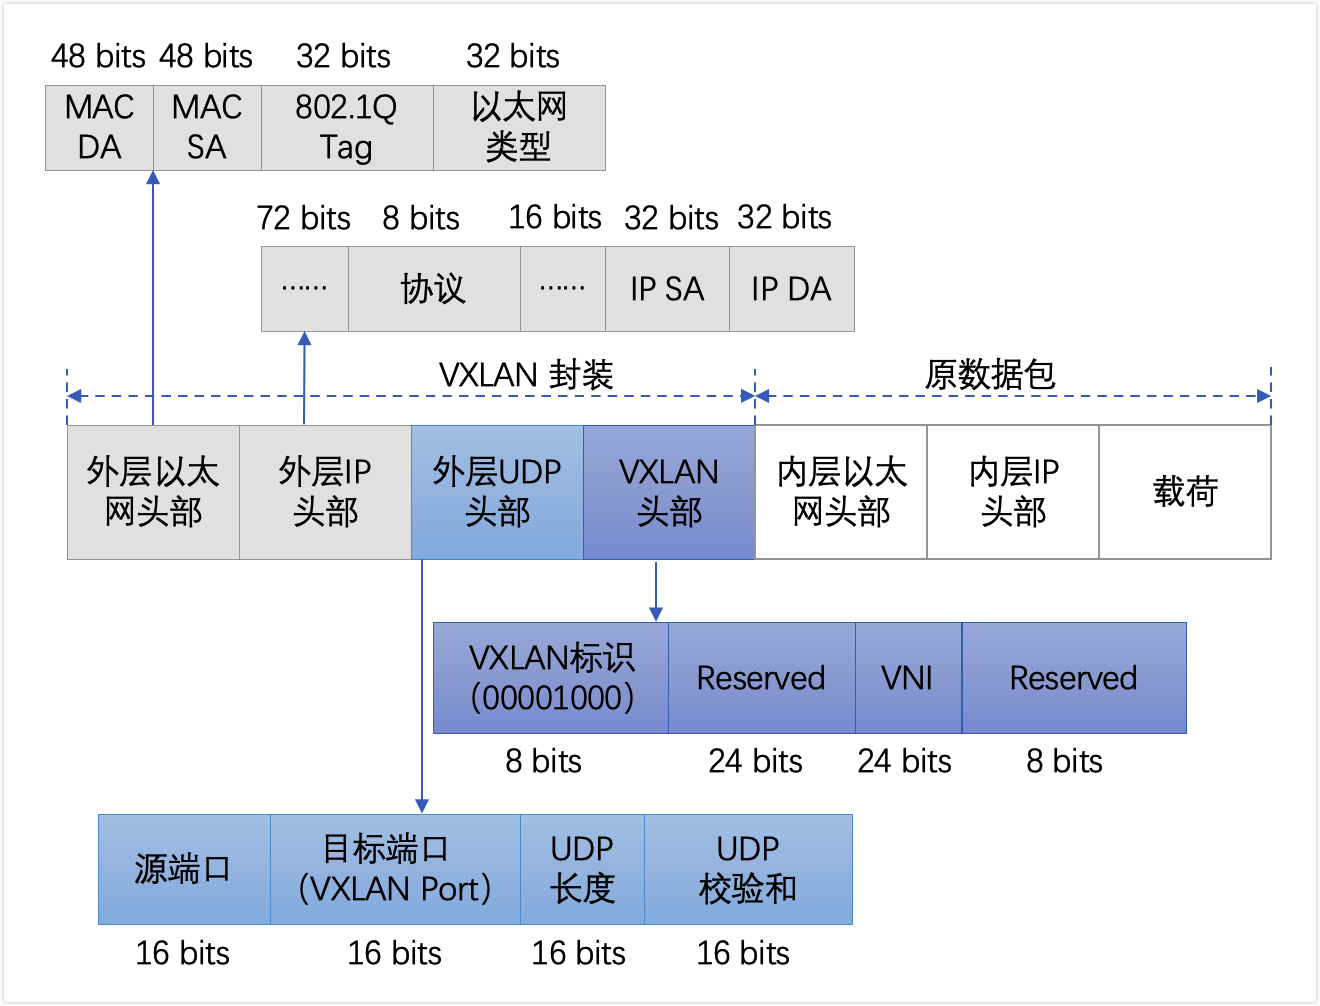
显然 , 该UDP报文的IP头部中 , 源地址为当前节点某接口的IP地址 , 目标地址应该为目标Pod所在节点的某接口的IP地址。但本地节点之上并没有任何路由信息帮助指向目标节点 , 由flanneld生成的路由中仅指明了到达目标Pod时的隧道出口的flannel.1接口的IP地址。事实上 , Flannel把flannel.1接口也作为网桥设备使用 , 该设备上附加了一个同样由flanneld维护的、称为FDB ( Forwarding Database) 的转发数据库。该数据库指明了到达目标节点flannel.1接口需要经由的下一跳IP , 该IP是目标Pod所在节点的IP地址 , 即外部IP头部中的目标IP。下面的转发条目取自k8s-node1节点 , 各条目的功能做了简单注释 , 这些条目分别指明了到达集群中不同的节点的flannel.1接口时需要经过的下一跳IP地址。
# bridge fdb show flannel.1 |awk '$3=="flannel.1"{print $0}'
26:22:89:97:04:e8 dev flannel.1 dst 192.168.102.103 self permanent    # 转发至k8s-node2节点
76:7d:9c:b5:29:9d dev flannel.1 dst 192.168.102.101 self permanent # 转发至k8s-master节点假设上图中的Pod-4运行在demoapp应用 , 下面的命令运行在k8s-node1之上 , 它抓取了Pod-1通过HTTP协议访问Pod-4中由demoapp 运行的Web服务的一次请求/响应事务。其中的MAC地址00:0c:29:9a:39:0f与62:3a:b1:98:53:b4分别是k8s-node1的ens160和flannel.1接口的地址 , 而00:0c:29:33:fd:0e与5e:5f:7e:bd:65:ea分别是k8s-node2的ens160和flannel.1接口的地址。
[root@k8s-node1 ~]# tcpdump -i ens160 -en udp port 8472
tcpdump: verbose output suppressed, use -v or -vv for full protocol decode
listening on ens160, link-type EN10MB (Ethernet), capture size 262144 bytes
07:29:36.789573 00:0c:29:9a:39:0f > 00:0c:29:33:fd:0e, ethertype IPv4 (0x0800), length 124: 192.168.102.102.44896 > 192.168.102.103.otv: OTV, flags [I] (0x08), overlay 0, instance 1    # 请求报文隧道头部
62:3a:b1:98:53:b4 > 5e:5f:7e:bd:65:ea, ethertype IPv4 (0x0800), length 141: 10.244.1.45.54892 > 10.244.2.19.http: Flags [P.], seq 1:76, ack 1, win 507, options [nop,nop,TS val 1453985543 ecr 1856165077], length 75: HTTP: GET / HTTP/1.1      # 请求报文内层头部

07:29:36.792221 00:0c:29:33:fd:0e > 00:0c:29:9a:39:0f, ethertype IPv4 (0x0800), length 133: 192.168.102.103.50547 > 192.168.102.102.otv: OTV, flags [I] (0x08), overlay 0, instance 1    # 响应报文隧道头部
5e:5f:7e:bd:65:ea > 62:3a:b1:98:53:b4, ethertype IPv4 (0x0800), length 83: 10.244.2.19.http > 10.244.1.45.54892: Flags [P.], seq 1:18, ack 76, win 502, options [nop,nop,TS val 1856165079 ecr 1453985543], length 17: HTTP: HTTP/1.0 200 OK # 响应报文内层头部这种外层封装后的报文就是常规的UDP报文 , 只是为了避免数据帧超过标准的MTU大小 , 内层数据帧不得不减小至1450字节。因此 , VXLAN Overlay网络可正常运行在任何能够传输常规UDP报文的环境中 , 包括存在很多底层限制的公有云环境。代价是 , 牺牲了网络报文的一小部分载荷能力 , 降低了性能。
我们也不难想到 , 依赖于flanneld维护的、由各VTEP设备flannel.1接口组成的二层网络中的各设备的ARP解析记录 , flannel.1 虚拟网桥上的FDB转发数据库 , 甚至不在同一IP网络中的集群各节点 , 只要它们彼此间经由路由互相可达 , 这种外层转发依然能够成功达成。于是 , VXLAN Overlay网络并不要求所有节点都处于同一个二层网络 , 这有利于在更复杂的网络环境下组建Kubernetes集群。
另外 , VXLAN后端的可用配置参数除了Type之外还有如下几个 , 它们都有默认值 , 用户可以按需进行自定义配置。
VNI:VXLAN的标识符 , 默认为1; 数值型数据。Port: 用于发送封装的报文的UDP端口 , 默认为8472; 数值型数GBP: 全称为Group Based Policy, 配置是否启用VXLAN的基于组的策略机制 , 默认为否 ; 布尔型数据。DirectRouting: 是否为同一个二层网络中的节点启用直接路由机制 , 类似于host-gw后端的功能 ; 此种场景下 ,VXLAN仅为不在同一个二层网络中的节点封装并转发VXLAN隧道报文 ; 布尔型数据。
其中 , 直接路由参数能够配置Flannel实现三层转发式的容器网关 , 该网关能够以直接路由方式在Pod间转发通信报文。
2.3 直接路由
为了提升性能 , Flannel的VXLAN后端还支持DirectRouting模式 , 即在集群中的各节点上添加必要的路由信息 , 让Pod间的IP报文通过节点的二层网络直接传送 , 如下图所示。仅在通信双方的Pod对象所在的节点跨IP网络时 , 才启用传统的VXLAN隧道方式转发通信流量。若Kubernetes集群节点全部位于单个二层网络中 , 则DirectRouting模式下的Pod间通信流量基本接近于直接使用二层网络。即便节点分布在有限的几个可互相通信的网络中的Kubernetes集群来说 , 合理的应用部署拓扑也能省去相当一部分的隧道开销。
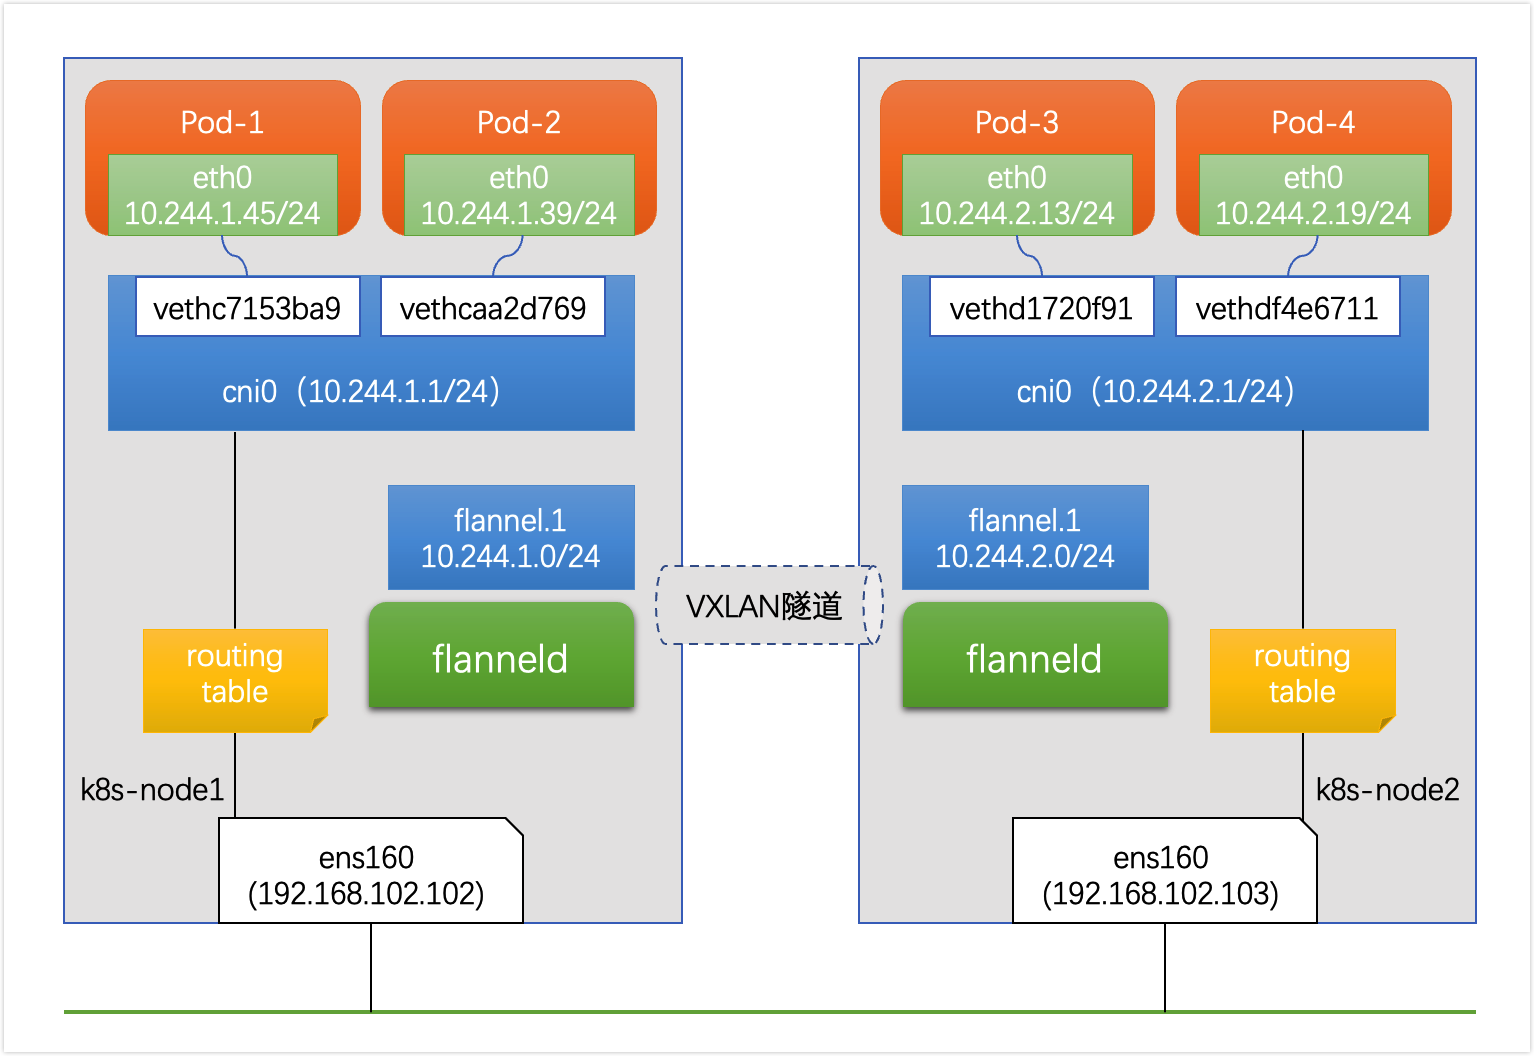
对于托管部署在Kubernetes上的Flannel来说 , 修改kube-system名称空间下的configmaps/kube-flannel-cfg资源 , 为VXLAN后端添加 DirectRouting子键 , 并设置其值为true即可 , 如下面的配置示例。
# kubectl edit configmap/kube-flannel-cfg -n kube-system
  net-conf.json: |
    {
      "Network": "10.244.0.0/16",
      "Backend": {
        "Type": "vxlan",
        "Directrouting": true
      }
}可以直接编辑活动状态的configmaps/kube-flannel-cfg资源 , 也可基于配置清单修改后再次应用到集群上。修改完成后 , 新版本会自动重启各节点的Flannel Pod资源 , 老版本需要以某种策略让各节点上的Flannel Pod重载生效新配置 , 比如手动删除以触发Pod重建的方式进行滚动更新等。更新完成后 , 节点上的路由规则也会相应发生变动 , 到达与本地节点位于同一二层网络中的其他节点 , Pod子网的下一跳地址由对端flannel.1接口地址变为了宿主机物理接口的地址 , 本地用于发出报文的接口从flannel.1变成了本地的物理接口。仍然以k8s-node1节点为例 , 修改VXLAN后端支持DirectRouting模式 , 则该节点上的路由信息变动为如下结果 :
[root@k8s-node1 ~]# ip route show
10.244.0.0/24 via 192.168.102.101 dev ens160
10.244.1.0/24 dev cni0 proto kernel scope link src 10.244.1.1
10.244.2.0/24 via 192.168.102.103 dev ens160
注意 : 为了所有Pod均能得到正确的网络配置 , 建议在创建Pod资源之前事先配置好网络插件 , 甚至是事先了解并根据自身业务需求测试完成中意的目标网络插件 , 在选型完成后再部署Kubernetes集群 , 而尽量避免中途修改 , 否则有些Pod资源可能需要重建。
我们知道 , Pod与节点通常不在同一网络。Pod间的通信报文需要经由宿主机的物理接口发出 , 必然会经过iptables/netfilter的 forward钩子 , 为了避免该类报文被防火墙拦截 , Flannel必须为其设定必要的放行规则。这里示例集群中的每个节点上iptables filter表 的FORWARD链上都会生成如下两条转发规则 , 以确保由物理接口接收或发送的目标地址或源地址为10.244.0.0/16网络的所有报文能够正常通过。
target     prot opt source               destination
ACCEPT     all  --  10.244.0.0/16        anywhere             /* flanneld forward */
ACCEPT all -- anywhere 10.244.0.0/16 /* flanneld forward */假设上图中的Pod-4运行在demoapp应用 , 下面的命令运行在k8s-node1之上 , 它抓取了Pod-1通过HTTP协议访问Pod-4中由demoapp运行的Web服务的一次请求/响应事务。命令结果显示 : 跨节点的Pod-1和Pod-4借助内核中的路由规则正常完成了通信过程。
[root@k8s-node1 ~]# tcpdump -i ens160 -en tcp port 80
08:10:19.039467 00:0c:29:9a:39:0f > 00:0c:29:33:fd:0e, ethertype IPv4 (0x0800), length 141: 10.244.1.45.38568 > 10.244.2.19.http: Flags [P.], seq 1:76, ack 1, win 507, options [nop,nop,TS val 1456427792 ecr 1858607326], length 75: HTTP: GET / HTTP/1.1
......
08:10:19.040500 00:0c:29:33:fd:0e > 00:0c:29:9a:39:0f, ethertype IPv4 (0x0800), length 83: 10.244.2.19.http > 10.244.1.45.38568: Flags [P.], seq 1:18, ack 76, win 502, options [nop,nop,TS val 1858607327 ecr 1456427792], length 17: HTTP: HTTP/1.0 200 OK
显然 , 这种路由规则无法表达跨二层网络的节点上Pod间通信的诉求 , 因为到达目标网络 ( 某Pod子网) 的下一跳地址无法指向另一个网络中的节点地址。因而 , 集群中的每个节点上依然保留有VXLAN隧道相关的flannel.1设备 , 以支持那些跨IP网络的节点上的Pod间通信。
2.4 host-gw后端
Flannel的host-gw后端通过添加必要的路由信息 , 并使用节点的二层网络直接发送Pod间的通信报文 , 其工作方式类似于VXLAN后端中的直接路由功能 , 但不包括该后端支持的隧道转发能力 , 这意味着host-gw后端要求各节点必须位于同一个二层网络中。其工作模型示意图如下图所示。因完全不会用到VXLAN隧道 , 所以使用了host-gw后端的Flannel网络也就无须用到VTEP设备flannel.1。
host-gw后端没有多余的配置参数 , 直接设定配置文件中的Backend.Type键的值为host-gw关键字即可。同样 , 直接修改kubesystem名称空间中的configmaps/kube-flannel.cfg配置文件 , 类似下面配置示例中的内容即可。
# kubectl edit configmap/kube-flannel-cfg -n kube-system
  net-conf.json: |
    {
      "Network": "10.244.0.0/16",
      "Backend": {
        "Type": "host-gw"
      }
    }
配置完成后 , 集群中的各节点会生成类似VXLAN后端的 DirectRouting路由及iptables规则 , 以转发Pod网络的通信报文 , 它完全省去了隧道转发模式的额外开销。代价是 , 对于非同一个二层网络的报文转发 , host-gw完全无能为力。相对而言 , VXLAN的 DirectRouting后端转发模式兼具VXLAN后端和host-gw后端的优势 , 既保证了传输性能 , 又具备跨二层网络转发报文的能力。
像host-gw或VXLAN后端的直接路由模式这种使用静态路由实现Pod间通信报文的转发 , 虽然较之VXLAN Overlay网络有着更低的资源开销和更好的性能表现 , 但当Kubernetes集群规模较大时 , 其路由信息的规模也将变得庞大且不易维护。相比较来说 , Calico通过BGP协议自动维护路由条目 , 较之Flannel以etcd为总线以上报、查询和更新配置的工作逻辑更加高效和易于维护 , 因而更适用于大型网络。
此外 , Flannel自身并不具备为Pod网络实施网络策略以实现其网络通信控制的能力 , 它只能借助Calico这类支持网络策略的插件实现该功能 , 独立的项目Calico正为此目的而设立。
3. Calico网络插件
Calico是另一款主流的开源虚拟化网络方案 , 用于为云原生应用实现互联与策略控制 , 可以整合进大多数主流的编排系统 , 例如 Kubernetes、Apache Mesos、Docker和OpenStack等。与Flannel相比 , Calico的一个显著优势是对网络策略的支持 , 它允许用户动态定义访问控制规则以管控进出容器的数据报文 , 从而为Pod间通信按需施加安全策略。
Calico是一个三层的虚拟网络解决方案 , 它把每个节点都当作虚拟路由器 ( vRouter) , 并把每个节点上的Pod都当作是 " 节点路由器 " 后的一个终端设备并为其分配一个IP地址。各节点路由器通过BGP协议学习生成路由规则 , 从而实现不同节点上Pod间的互联互通 , 如下图所示。
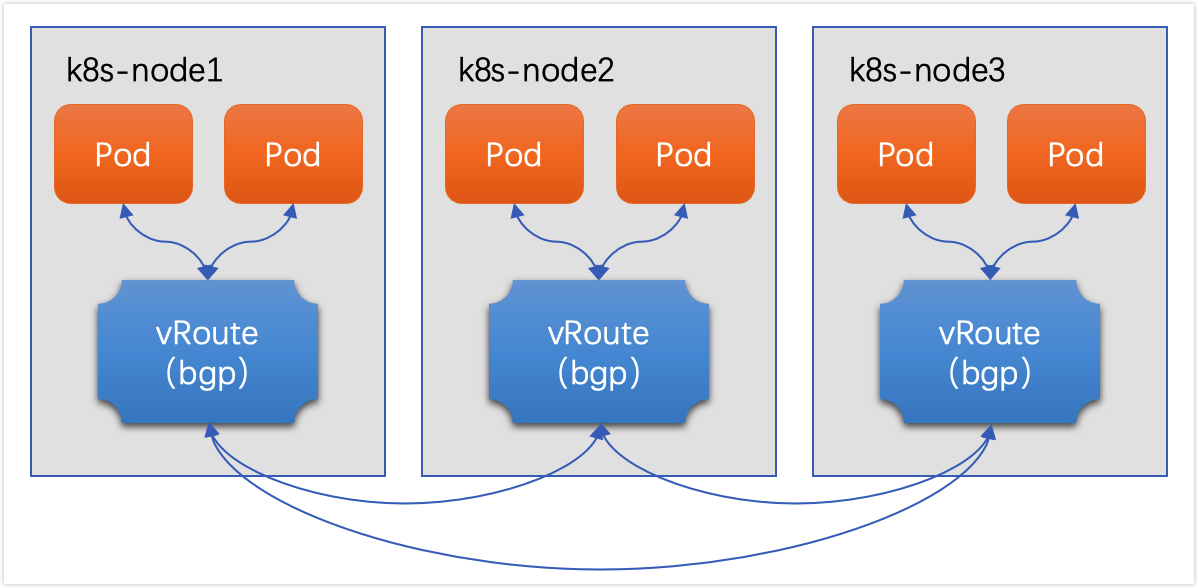
BGP是互联网上一个核心的去中心化自治路由协议 , 它通过维护IP路由表或 " 前缀 " 表来实现自治系统 ( AS) 之间的可达性 , 通常作为大规模数据中心维护不同的自治系统之间路由信息的矢量路由协议。 Linux内核原生支持BGP , 因而我们可轻易把一台Linux主机配置成为边界网关。
Calico把Kubernetes集群环境中的每个节点上的Pod所组成的网络视为一个自治系统 , 而每个节点也就自然由各自的Pod对象组成虚拟网络 , 进而形成自治系统的边界网关。各节点间通过BGP协议交换路由信息并生成路由规则。但考虑到并非所有网络都能支持BGP , 而且BGP路由模型要求所有节点必须要位于同一个二层网络 , 所以Calico还支持基于IPIP和VXLAN的Overlay网络模型 , 它们的工作模式与Flannel的VXLAN和IPIP模型并无显著不同。
类似Flannel在VXLAN后端启用DirectRouting时的网络模型 , Calico也支持混合使用路由和Overlay网络模型 , BGP路由模型用于二层网络的高性能通信 , IP-IP或VXLAN用于跨子网的节点间报文转发 , 如下图所示。IP-IP协议包头非常小 , 理论上它的速度要比VXLAN稍快一点 , 但安全性更差。
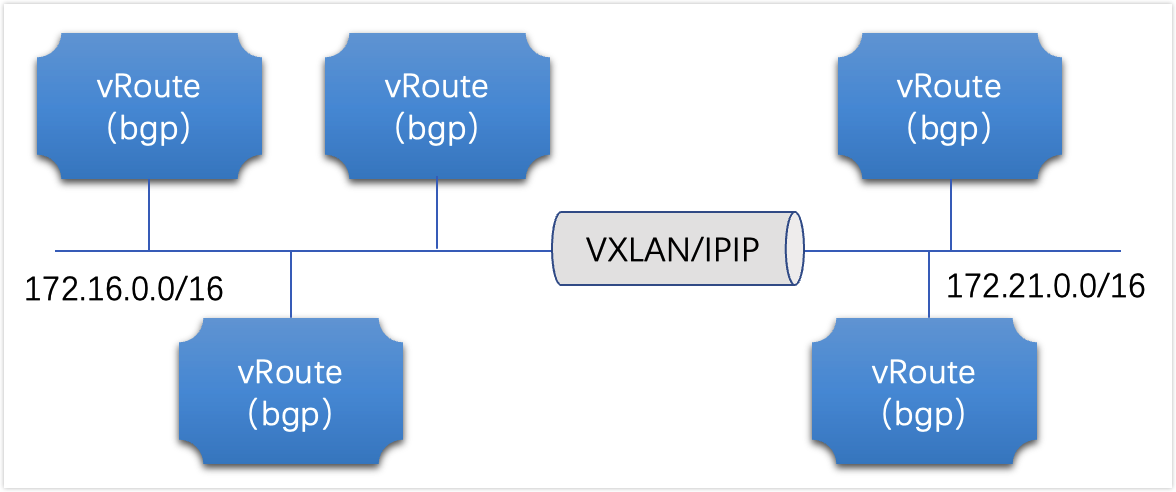
需要注意的是 , Calico网络提供的在线部署清单中默认使用的是IPIP隧道网络 , 而非BGP或者混合模型 , 因为它假设节点的底层网络不支持BGP协议。明确需要使用BGP或混合模型时 , 需要事先将清单下载至本地 , 按需修改后方可部署在Kubernetes集群之上。
3.1 Calico架构
Calico的系统组件主要有Felix、BGP路由反射器、编排系统插件、BIRD和etcd存储系统等 , 各组件间的关系如下图所示。
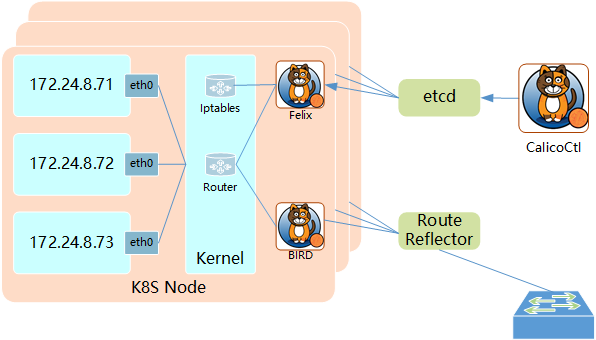
BGP模式下的Calico所承载的各Pod资源直接基于vRouter经由基础网络进行互联 , 它非叠加、无隧道、不使用VRF表 , 也不依赖于NAT , 因此每个工作负载都可以直接配置使用公网IP接入互联网 , 当然 , 也可以按需使用网络策略控制它的网络连通性。
FelixFelix是运行于各节点上守护进程 , 它主要负责完成接口管理、路由规划、ACL规划和状态报告几个核心任务 , 从而为各端点 (VM或Container) 生成连接机制。接口管理 , 负责创建网络接口、生成必要信息并送往内核 , 以确保内核能正确处理各端点的流量 , 尤其是要确保目标节点
MAC能响应当前节点上各工作负载的MAC地址的ARP请求 , 以及为Felix管理的接口打开转发功能。另外 , 接口管理还要监控各接口的变动以确保规则能得到正确应用。路由规划 , 负责为当前节点上运行的各端点在内核
FIB(Forwarding Information Base) 中生成路由信息 , 以保证到达当前节点的报文可正确转发给端点。ACL规划 , 负责在Linux内核中生成ACL, 实现仅放行端点间的合规流量 , 并确保流量不能绕过Calico等安全措施。状态报告 , 负责提供网络健康状态的相关数据 , 尤其是报告由
Felix管理的节点上的错误和问题。这些报告数据会存储在etcd, 供其他组件或网络管理员使用。
编排系统插件
编排系统插件的主要功能是将
Calico整合进所在的编排系统中 , 例如Kubernetes或OpenStack等。它主要负责完成API转换 , 从而让管理员和用户能够无差别地使用Calico的网络功能。换句话说 , 编排系统通常有自己的网络管理API, 相应的插件要负责将对这些API的调用转换为Calico的数据模型 , 并存储到Calico的存储系统中。因而 , 编排插件的具体实现依赖于底层编排系统 , 不同的编排系统有各自专用的插件。etcd存储系统利用
etcd,Calico网络可实现为有明确状态 ( 正常或故障) 的系统 , 且易于通过扩展应对访问压力的提升 , 避免自身成为系统瓶颈。 另外 ,etcd也是Calico各组件的通信总线。BGP客户端Calico要求在每个运行着Felix的节点上同时运行一个称为BIRD的守护进程 , 它是BGP协议的客户端 , 负责将Felix生成的路由信息载入内核并通告给整个网络中。BGP路由反射器Calico在每一个计算节点利用Linux内核实现了一个高效的vRouter( 虚拟路由器) 进行报文转发。每个vRouter通过BGP协议将自身所属节点运行的Pod资源的IP地址信息 , 基于节点上的专用代理程序 (Felix) 生成路由规则向整个Calico网络内传播。尽管小规模部署能够直接使用BGP网格模型 , 但随着节点数量 ( 假设为连接的数量就会以的规模快速增长 , 从而给集群网络带来巨大的压力。因此 , 一般建议大规模的节点网络使用BGP路由反射器进行路由学习 ,BGP的点到点通信也就转为与中心点的单路通信模型。另外 , 出于冗余考虑 , 生产实践中应该部署多个BGP路由反射器。而对于Calico来说 ,BGP客户端程序除了作为客户端使用外 , 也可以配置为路由反射器。
另外 , Calico可将关键配置抽象成资源类型 , 并允许用户按需定义资源对象以完成系统配置 , 这些资源对象保存在Datastore中 , Datastore可以是独立管理的etcd存储系统 , 也可以是Kubernetes API 封装的集群状态存储系统 ( 即Kubernetes使用的etcd存储系统) 。 Calico专有的资源类型有十几种 , 包括IPPool ( IP地址池) 、 NetworkPolicy ( 网络策略) 、BGPConfiguration ( BGP配置参数) 和 FelixConfiguration ( Felix配置参数) 等。类似于Kubernetes API资源的定义 , 这些资源的配置格式同样以JSON使用apiVersion、kind、metadata和spec等一级字段进行定义 , 并能够使用calicoctl客户端工具进行管理 , 也支持由kublet借助CRD进行这类资源的管理。
3.2 Calico配置基础
与Kubernetes集群整合时 , Calico需要配置calico-node和calico-kube-controllers两个重要组件 , 各组件通过Datastore读取与自身相关的资源定义完成配置。
calico/node:Calico在Kubernetes集群每个节点运行的节点代理 , 负责提供felix、bird4、bird6和confd等守护进程。calico/kube-controllers:Calico运行在Kubernetes之上的自定义控制器 , 也是Calico协同Kubernetes的插件。
Calico有两种部署方式 :
一种是让
calico/node独立运行在Kubernetes集群之外 , 但calico/kube-controllers依然需要以Pod资源形式运行在集群之上 ;另一种是以
CNI插件方式配置Calico, 使Calico完全托管运行在Kubernetes集群之上 , 类似于前面曾经部署托管Flannel网络插件的方式。
对于后一种方式 , Calico提供了在线的部署清单 , 它分别为50节点及以下规模和50节点以上规模的Kubernetes 集群使用Kubernetes API作为Dabastore提供了不同的配置清单 , 也为使用独立的etcd集群提供了专用配置清单。但这3种类型的配置清单中 , Calico默认启用的是基于IPIP隧道的Overlay网络 , 因而它会在所有流量上使用IPIP隧道而不是BGP路由。以下配置定义在部署清单中DaemonSet/calico-node资源的Pod模板中的calico-node容器之上。
# 设置在IPv4类型的地址池上启用的IP-IP及其类型 , 支持3种可用值
# Always (全局流量) 、Cross-SubNet (跨子网流量) 和Never
- name: CALICO_IPV4POOL_IPIP
  value: "Always"

# 是否在IPV4地址池上启用VXLAN隧道协议 , 取值及意义与Flannel的VXLAN后端相同 ,
# 但在全局流量启用VXLAN时将完全不再需要BGP网络 , 建议将相关的组件禁用
- name: CALICO_IPV4POOL_VXLAN
value: "Never"我们可以将环境变量CALICO_IPV4POOL_IPIP的值设置为Cross-SubNet (不区分大小写) 来启用混合网络模型 , 它将启用BGP路由网络 , 且仅会在跨节点子网的流量间启用隧道封装。想要启用VXLAN隧道 , 只需要把环境变量CALICO_IPV4POOL_VXLAN的值设置为Always或Cross-SubNet即可 , 但在全局流量上使用VXLAN隧道时建议将 ConfigMap/calico-node中calico-backend键的值设置为vxlan以禁用BIRD , 并在DaemonSet/calico-node资源的Pod模型中禁用calico-node容器的存活探针和就绪探针对bird的检测 , 相关的配置要点如下所示。
livenessProbe:
  exec:
    command:
    - /bin/calico-node
    - -felix-live
    # - -bird-live
readinessProbe:
  exec:
    command:
    - /bin/calico-node
    # - -bird-ready
    - -felix-ready
需要注意的是 , Calico分配的地址池需要与Kubernetes集群的Pod网络的定义保持一致。Pod网络通常由kubeadm init初始化集群时使用--pod-network-cidr选项指定的 , 而Calico在其默认的配置清单中默认使用192.168.0.0/16作为Pod网络 , 因而部署Kubernetes集群时应该规划好要使用的网络地址 , 并设定此二者相匹配。对使用了Flannel的10.244.0.0/16网络环境而言 , 可以修改资源清单中的定义 , 从而将其修改为其他网络地址。以下配置片段取自Calico的部署清单 , 它定义在DaemonSet/calico-node资源的Pod模板中的calico-node容器之上。
# IPV4地址池的定义 , value值需要与kube-controller-manager的-cluster-network选项的值保持一致 , 以下环境变量默认处于注释状态
- name: CALICO_IPV4POOL_CIDR
  value: "192.168.0.0/16"

# Calico默认以26位子网掩码切分地址池并将各子网配置给集群中的节点 , 若需要使用其他的掩码长度 , 则需要定义如下环境变量
- name: CALICO_IPV4POOL_BLOCK_SIZE
  value: "24"

# Calico默认并不会从Node.Spec.PodCIDR中分配地址 , 但可通过将如下变量设置为true并结合host-local这一IPAM插件来强制从PodCIDR中分配地址
- name: USE_POD_CIDR
  value: "false"
不过 , 目前版本的Calico已经能够自动检测由kubeadm部署的Kubernetes集群中的Pod网络 , 并自动将类似上面配置清单中 CALICO_IPV4POOL_CIDR和CALICO_IPV4POOL_BLOCK_SIZE环境变量的值适配到该Pod网络 , 但其他方式部署的Kubernetes集群仍需管理员自行核验这种适配机制是否能得以满足。
在地址分配方面 , Calico在JSON格式的CNI插件配置文件中使用专有的calico-ipam插件 , 该插件并不会使用Node.Spec.PodCIDR中定义的子网作为节点本地为Pod分配地址的地址池 , 而是根据Calico插件为各节点配置的地址池进行地址分配。若期望为节点真正使用地址池 , 吻合PodCIDR的定义 , 则需要将部署清单中DaemonSet/calico-node资源的Pod模板的calico-node容器的USE_POD_CIDR环境变量值设置为true , 并修改ConfigMap/calico-config资源中cni_network_config键的plugins.ipam.type值为host-local , 且使用podCIDR为子网 , 具体配置如下所示。
"ipam": {
  "type": "host-local",
  "subnet": "usePodCidr"
},
3.3 IPIP隧道网络
kubenet通过/etc/cni/net.d/目录下的CNI配置文件加载要使用的网络插件完成Pod网络配置 , 为了避免冲突 , 通常不应该也没必要同时提供多个CNI解决方案。因此 , 在我们进行初始化集群的部署网络插件前 , 就应该规划好此环境中准备用哪一个网络插件 , 来进行部署。这里以刚安装完kubernetes集群进行初始化开始为例。
初始化集群 , 这里由于宿主机的网络为
192.168.102.0/24段 , 这里给pod就分配使用了172.16.0.0/16端 , 所以后面部署calico时候 , 也同意配置为172.16.0.0/16段。# kubeadm init --image-repository registry.aliyuncs.com/google_containers --kubernetes-version 1.23.1 --pod-network-cidr 172.16.0.0/16 --apiserver-advertise-address 192.168.102.101 --service-cidr 10.96.0.0/12 # mkdir -p $HOME/.kube # sudo cp -i /etc/kubernetes/admin.conf $HOME/.kube/config # sudo chown $(id -u):$(id -g) $HOME/.kube/config下载
calico资源清单# curl https://projectcalico.docs.tigera.io/manifests/calico.yaml -O修改资源清单文件 , 这里保持和上面初始化指定的
Pod网络一个段。# vim calico.yaml ...... # The default IPv4 pool to create on startup if none exists. Pod IPs will be # chosen from this range. Changing this value after installation will have # no effect. This should fall within `--cluster-cidr`. - name: CALICO_IPV4POOL_CIDR value: "172.16.0.0/16" # Disable file logging so `kubectl logs` works. - name: CALICO_DISABLE_FILE_LOGGING value: "true" ......应用该资源清单
# kubectl apply -f calico.yaml查看创建的
Pod资源 ,Calico的所有资源默认都部署在kube-system名称空间之中 , 待calico-node与kube-controllers相关的Pod进入就绪状态之后即可验证和使用相应的网络功能。[root@k8s-master ~]# kubectl get pods -n kube-system -o wide |awk '/^calico-(node|kube-controller)/{print}' calico-kube-controllers-6b77fff45-zzm6t 1/1 Running 0 2m6s 172.16.235.195 k8s-master <none> <none> calico-node-rldfq 1/1 Running 0 2m6s 192.168.102.101 k8s-master <none> <none>
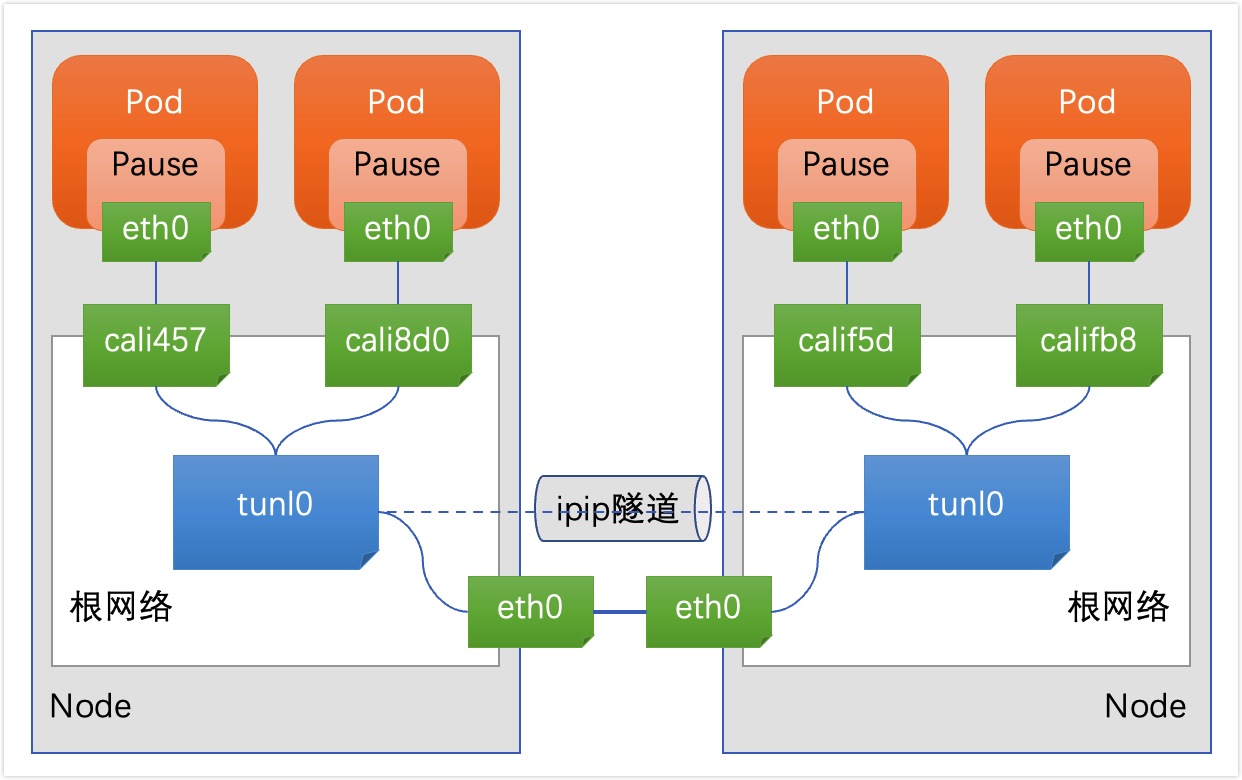
工作在IPIP模式的Calico会在每个节点上创建一个tunl0接口作为隧道出入口来封装IPIP隧道报文。Calico会为每一个Pod资源创建一对 veth设备 , 其中一端作为Pod的网络接口 , 另一端 ( 名称以cali为前缀 , 后跟随机字串) 留置在节点的根网络名称空间 , 它未使用风格模式 , 因而并未关联成为任何虚拟网桥设备的从接口 , 如下图所示。
IPIP隧道网络仍需依赖于BGP维护节点间的可达性。部署完成后 , Calico会通过BGP协议在每个节点上生成到达Kubernetes集群中其他各节点的Pod子网路由信息。下面的路由条件截取自k8s-node1主机 , 它们是由各节点上的BIRD以点对点的方式 ( node-to-node mesh) 向网络中的其他节点进行通告并学习其他节点的通告而得。
[root@k8s-node1 ~]# ip route show
blackhole 172.16.36.64/26 proto bird
172.16.169.128/26 via 192.168.102.103 dev tunl0 proto bird onlink
172.16.235.192/26 via 192.168.102.101 dev tunl0 proto bird onlink对于创建的每个常规Pod资源 , Calico CNI插件需要在节点的根网络名称空间中生成一个专用路由条目 , 用于确保以Pod IP为目标地址的报文能够经由相应的留置在根网络名称空间中的一端设备送达 , 如下面的命令 , 创建一个Deployment , 查看相关的路由条目格式类似如下所示。这是因为Calico没有在节点上为本地的所有Pod资源使用一个虚拟网桥进行报文转发所致。
# VERSION=v1.0 envsubst < deployment-demo.yaml  |kubectl apply -f -

// 查看当前的Pod分配信息
# kubectl get pods -o wide
NAME                              READY   STATUS    RESTARTS   AGE   IP               NODE        NOMINATED NODE   READINESS GATES
deployment-demo-cb69c57b7-76f7b   1/1     Running   0          5s    172.16.169.130   k8s-node2   <none>           <none>
deployment-demo-cb69c57b7-8qgj4   1/1     Running   0          5s    172.16.169.129   k8s-node2   <none>           <none>
deployment-demo-cb69c57b7-chsqb   1/1     Running   0          5s    172.16.36.66     k8s-node1   <none>           <none>
deployment-demo-cb69c57b7-mhplt   1/1     Running   0          5s    172.16.36.65     k8s-node1   <none>           <none>

// 去到k8s-node1节点查看路由信息
[root@k8s-node1 ~]# ip route show
172.16.36.65 dev cali45717cbf5d0 scope link     # 到达172.16.36.65的报文经cali45717cbf5d0接口送达。
172.16.36.66 dev cali8d0fb8fd4e1 scope link在集群中部署一些Pod资源即可完成集群网络连接测试。假设在k8s-node1上存在一个IP地址为172.16.36.65的Pod A , 以及在k8s-node2上存在一个IP地址为172.16.169.129且运行有demoapp应用的Pod B。通过curl命令在Pod A的交互式接口对Pod B发起HTTP请求 , 而后在k8s-node1的物理接口上抓取通信报文即可分析IPIP隧道报文通信格式 , 示例如下。
首先在
k8s-node1节点进行抓包 , 抓取k8s-node1节点的物理网卡到k8s-node2节点的IP报文。[root@k8s-node1 ~]# tcpdump -i ens160 -nn ip host 192.168.102.102 and host 192.168.102.103在
Pod A(172.16.36.65) 发起请求# kubectl exec -it deployment-demo-cb69c57b7-mhplt -- curl 172.16.169.129 vvoo demoapp v1.0 !! ClientIP: 172.16.36.65, ServerName: deployment-demo-cb69c57b7-8qgj4, ServerIP: 172.16.169.129!查看上
k8s-node1节点的抓包信息如下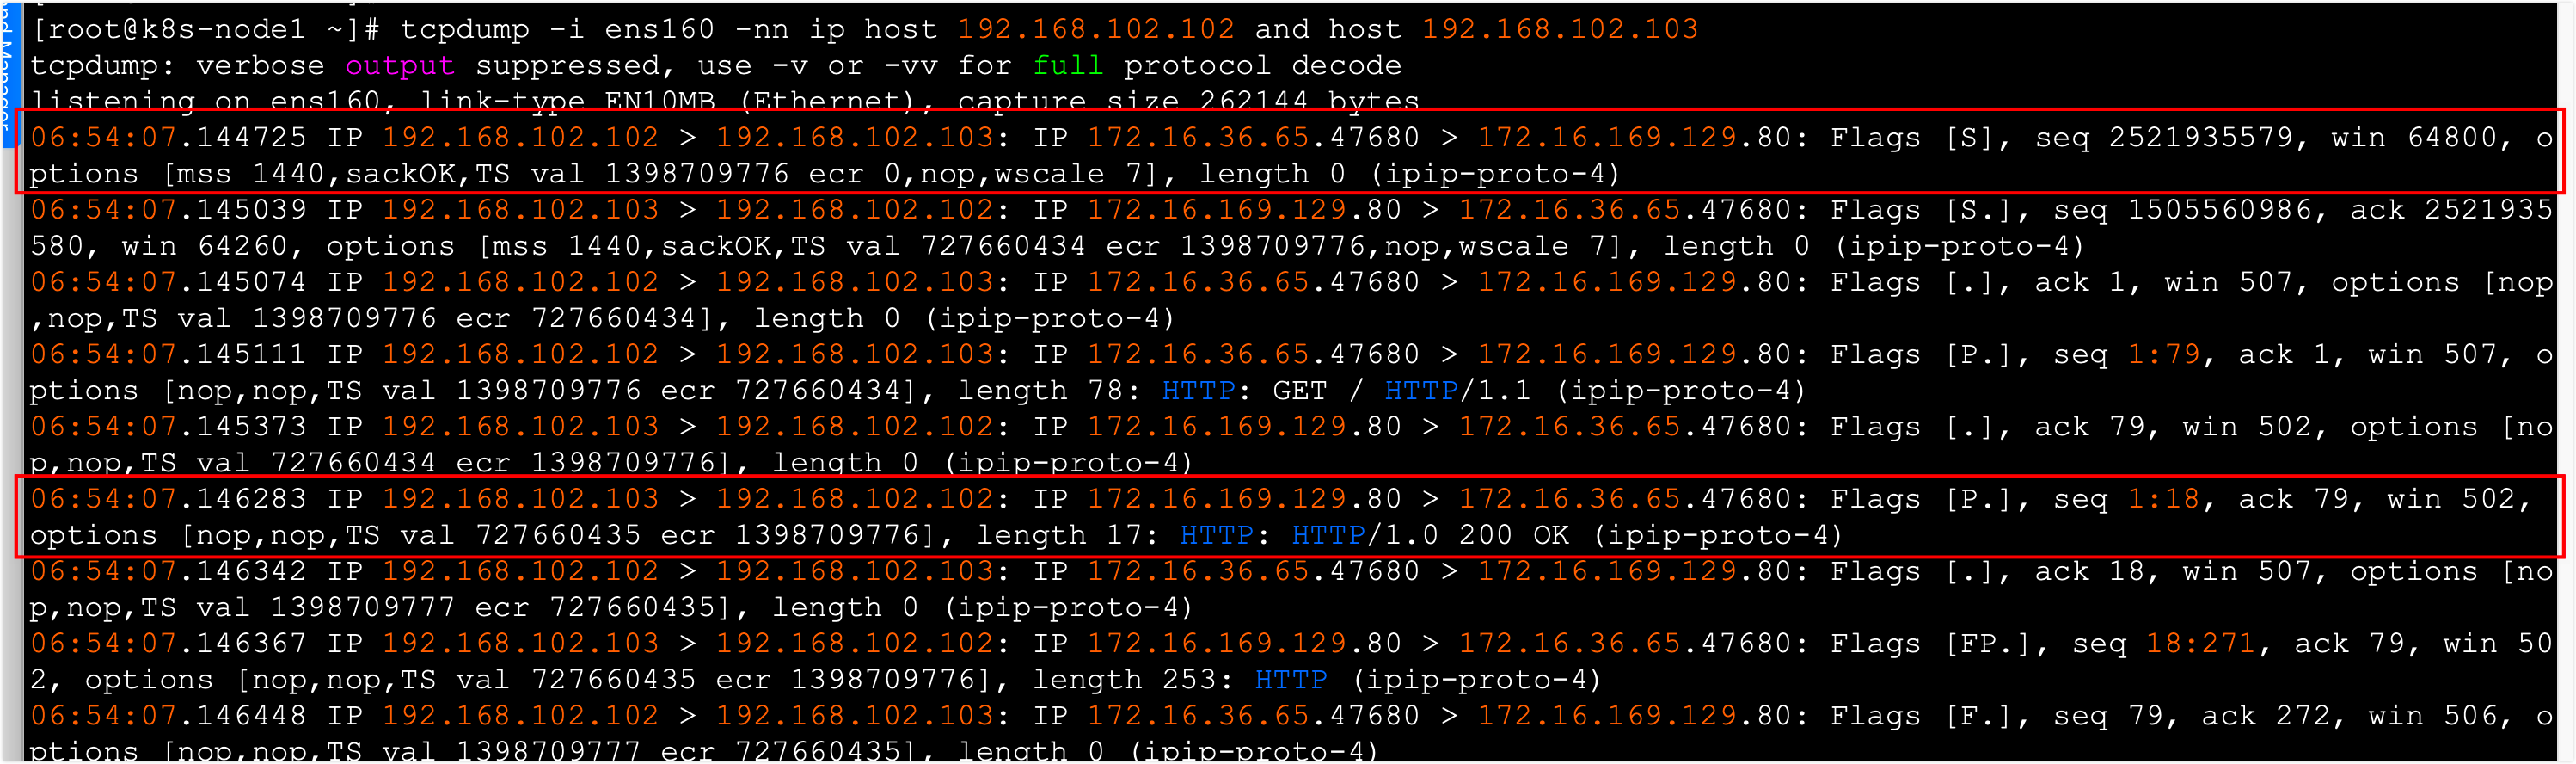
命令结果显示出 , 跨节点Pod间通信经由IPIP协议的三层隧道转发 , 外层IP首部中的IP地址为通信双方的节点IP ( 192.168.102.102和192.168.102.103) , 内层IP头部为通信双方的Pod IP ( 172.16.36.65和172.16.169.129) 。需要注意的是 , Calico CNI设置的tunl0接口的MTU默认为1440 , 这种设置主要是为适配Google的GCE环境 , 非GCE的物理环境中 , 其最佳值为1480。部署前 , 修改配置清单中的ConfigMap/calico-config资源的veith_mtu键的值为1480即可。
另外 , 对50个节点以上规模的集群来说 , 所有Calico节点基于 Kubernetes API存取数据会给API Server带去不小的通信压力 , 解决办法是使用calico-typha进程将所有Calico的通信集中起来 , 统一与 API Server进行交互。Calico为该应用场景提供了专用的在线配置清单 https://projectcalico.docs.tigera.io/manifests/calico-typha.yaml , 它主要添加了Deployment/calico-typha和Service/calico-typha两个资源。需要自定义的话 , 基本评估标准是每个calico-typha Pod资源可承载100~200个 ( 上限) Calico Node的连接请求 , 而整个集群中的calico-typha Pod资源总数尽量不要超过20个。
3.4 客户端工具calicoctl
Calico项目提供的专用客户端工具calicoctl能够直接与Calico Datastore进行交互 , 用于管理Calico系统抽象出的各种资源 , 通过资源管理实现查看、修改或配置Calico系统特性。我们可以基于特定的Pod来提供calicoctl工具程序 , 也可直接将相关的二进制程序部署在管理节点之上 , 例如管理员运行kubectl工具的主机等。下面在k8s-master上直接下载编译后的calicoctl文件 , 并将其保存在/usr/bin/目录中 :
# curl -L https://github.com/projectcalico/calico/releases/download/v3.23.1/calicoctl-linux-arm64 -o calicoctl

# mv calicoctl /usr/bin/

# chmod +x /usr/bin/calicoctlcalicoctl成功认证到Calico的数据存储系统 ( Datastore) 上之后才能查看或进行各类管理操作 , 所需要的认证方式也就取决于Datastore的类型。以Kubernetes API为数据存储时 , calicoctl需要使用类似kubectl的认证信息完成认证 , 常用的实现方式有环境变量和配置文件两种。环境变量DATASTORE_TYPE用于指定存储类型 , 而KUBECONFIG则用于指定配置文件kubeconfig的认证文件路径 , 例如以如下命令格式运行calicoctl命令 , 测试读取Calico系统的节点信息。
# DATASTORE_TYPE=kubernetes KUBECONFIG=~/.kube/config calicoctl get nodes
NAME
k8s-master
k8s-node1
k8s-node2
为了更方便的使用 , 我们也可以直接将认证信息等保存在配置文件中 , calicoctl默认加载的配置文件是/etc/calico/calicoctl.cfg , 配置信息已YAML格式进行组织 , 语法类似于Kubernetes的资源配置清单。官网文档
apiVersion: projectcalico.org/v3
kind: CalicoAPIConfig
metadata:
spec:
  datastoreType: "kubernetes"
  kubeconfig: "/etc/kubernetes/admin.conf"
配置完成后 , 就可以直接使用calicoctl命令进行管理 , calicoctl的通用语法格式为calicoctl [options] <command> [<args>...]。它支持apply、delete、get、patch、replace、node和ipam等子命令 , 分别用于增、删、改、查相应的资源配置或打印相关状态信息等。
例如 , 下面命令列出Datastore中所有的ipPool资源对象。ipPool是常用的资源类型之一 , 它代表当前Calico系统可用的地址池资源。默认部署生成的地址池资源名称为default-ipv4-ippool。
# calicoctl get ipPool
NAME                  CIDR            SELECTOR
default-ipv4-ippool 172.16.0.0/16 all()calicoctl同样支持资源的多种输出格式 , 例如yaml、json、wide、go-template和custom-columns等 , 其功能完全类似kubectl中的用法。例如下面的命令以YAML格式输出了默认的地址池的详细定义。
# calicoctl get ipPool default-ipv4-ippool -o yaml
apiVersion: projectcalico.org/v3
kind: IPPool
metadata:
  creationTimestamp: "2022-06-21T15:21:30Z"
  name: default-ipv4-ippool
  resourceVersion: "821"
  uid: 015e2bb2-828a-4e3d-a946-455267aff810
spec:
  allowedUses:
  - Workload
  - Tunnel
  blockSize: 26
  cidr: 172.16.0.0/16
  ipipMode: Always
  natOutgoing: true
  nodeSelector: all()
  vxlanMode: Never
我们可将上面命令输出的结果保存于本地文件中 , 修改其特定属性值后 , 再重新应用(apply)到Datastore从而完成配置更新 , 例如添加disabled: true以禁用指定的地址池等 ; 也可同时修改资源名称和特定属性值后再应用到Datastore上以创建新的资源。
再如 , 下面的命令打印了地址池中相关地址块与IP地址的分配状态 , 包括地址池及各地址块中的IP总数、已分配数量和可用数量等。
# calicoctl ipam show --show-blocks
+----------+-------------------+-----------+------------+--------------+
| GROUPING |       CIDR        | IPS TOTAL | IPS IN USE |   IPS FREE   |
+----------+-------------------+-----------+------------+--------------+
| IP Pool  | 172.16.0.0/16     |     65536 | 10 (0%)    | 65526 (100%) |
| Block    | 172.16.169.128/26 |        64 | 3 (5%)     | 61 (95%)     |
| Block    | 172.16.235.192/26 |        64 | 4 (6%)     | 60 (94%)     |
| Block    | 172.16.36.64/26   |        64 | 3 (5%)     | 61 (95%)     |
+----------+-------------------+-----------+------------+--------------+
另外 , 直接以ectd为Datastore的场景中 , calicoctl则要使用由etcd信任的CA所签发的数字证书认证到etcd , 主流的配置方式同样有环境变量和配置文件两种。无论使用哪种Datastore , calicoctl可执行的管理操作及相关命令的用法并无不同之处。
calicoctl还可以通过插件的方式进行安装 , 直接嵌合在kubectl命令之上。安装方式其实一样 , 只是下载下来重命名为kubectl-calico即可。如下 :
// 下载安装
# curl -L https://github.com/projectcalico/calico/releases/download/v3.23.1/calicoctl-linux-arm64 -o kubectl-calico

# mv kubectl-calico /usr/bin/

# chmod +x /usr/bin/kubectl-calico

// 使用示例
# kubectl calico ipam show --show-blocks
+----------+-------------------+-----------+------------+--------------+
| GROUPING |       CIDR        | IPS TOTAL | IPS IN USE |   IPS FREE   |
+----------+-------------------+-----------+------------+--------------+
| IP Pool  | 172.16.0.0/16     |     65536 | 10 (0%)    | 65526 (100%) |
| Block    | 172.16.169.128/26 |        64 | 3 (5%)     | 61 (95%)     |
| Block    | 172.16.235.192/26 |        64 | 4 (6%)     | 60 (94%)     |
| Block    | 172.16.36.64/26   |        64 | 3 (5%)     | 61 (95%)     |
+----------+-------------------+-----------+------------+--------------+
3.5 BGP网络与BGP Reflector
3.5.1 BGP网络
一般来说 , 仅在那些不支持用户自定义BGP配置的网络中才会完全使用IPIP或VXLAN隧道网络 , 对于自主可控且规模较大的网络环境 , 非常有必要启用BGP降低网络开销以提升传输性能。对于Calico来说 , 修改ipPool属性相应的配置便可调整使用的网络类型。以此前部署的 Calico系统默认使用的地址池default-ipv4-ippool为例 , 获取该资源的配置清单并保存为本地文件 , 修改ipipMode ( 或vxlanMode ) 的属性值为CrossSubnet或Never便能启用直接路由网络。
示例 :
编写配置清单 , (
default-ipv4-ippool.yaml)将spec.ipipMode的属性值从Never修改为CrossSubnet, 表示仅在跨IP网络节点上的Pod间通信才使用IPIP隧道 , 同一网络节点上的Pod间通信则使用路由方式直接进行。apiVersion: projectcalico.org/v3 kind: IPPool metadata: name: default-ipv4-ippool spec: allowedUses: - Workload - Tunnel blockSize: 26 cidr: 172.16.0.0/16 ipipMode: CrossSubnet natOutgoing: true nodeSelector: all() vxlanMode: Never将编写的配置清单使用
calicoctl apply命令重新应用到Calico Dstastore上后便可立即生效。 ( 显然 , 这种变动会影响现有的通信流量 , 不建议在生产环境随意变动)# calicoctl apply -f default-ipv4-ippool.yaml Successfully applied 1 'IPPool' resource(s)查看节点路由信息 , 等
BGP信息传播完成后 , 节点将同一网络内其他节点相关的路由条目经由IPIP模型的tunl0接口传输 , 变为节点上的某物理接口 , 如ens160, 下面的路由信息取自k8s-node1节点。[root@k8s-node1 ~]# ip route show blackhole 172.16.36.64/26 proto bird 172.16.169.128/26 via 192.168.102.103 dev ens160 proto bird 172.16.235.192/26 via 192.168.102.101 dev ens160 proto bird在集群中部署一些
Pod资源即可完成集群网络连接测试。假设在k8s-node1上存在一个IP地址为172.16.36.65的Pod A, 以及在k8s-node2上存在一个IP地址为172.16.169.129且运行有demoapp应用的Pod B。通过curl命令在Pod A的交互式接口对Pod B发起HTTP请求 , 而后在k8s-node1的物理接口上抓取通信报文即可分析报文通信格式 , 示例如下。首先在
k8s-node1节点进行抓包 , 抓取tcp协议的80端口报文。[root@k8s-node1 ~]# tcpdump -i ens160 -nn tcp port 80在
Pod A(172.16.36.65) 发起请求# kubectl exec -it deployment-demo-cb69c57b7-mhplt -- curl 172.16.169.129 vvoo demoapp v1.0 !! ClientIP: 172.16.36.65, ServerName: deployment-demo-cb69c57b7-8qgj4, ServerIP: 172.16.169.129!查看上
k8s-node1节点的抓包信息如下 , 从结果可以看出Pod之间直接基于底层网络完成了彼此间的通信。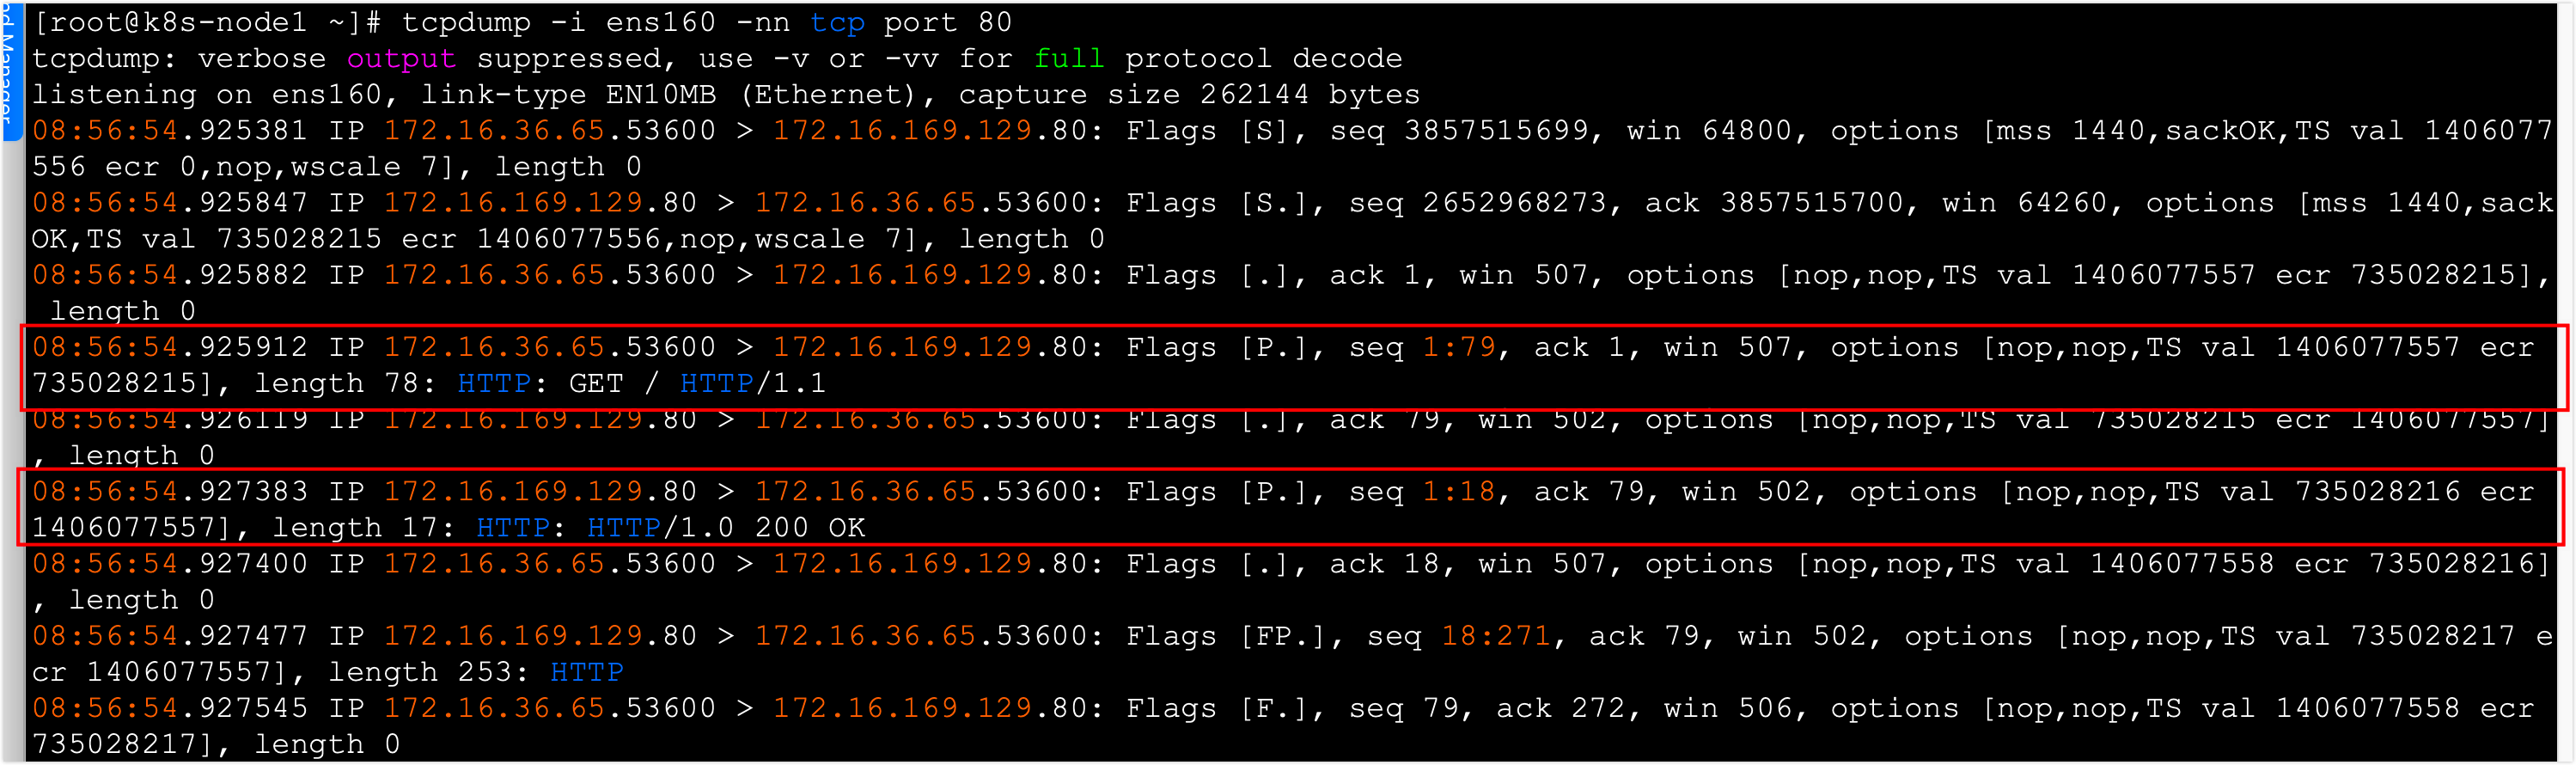
3.5.2 BGP Reflector
默认情况下 , Calico的BGP网络工作在节点网格 ( node-to-node mesh) 模型下 , 各节点间以对等方式广播路由 , 它仅适用于规模较小的集群环境。下面命令的结果显示的便是当前节点 ( k8s-master) 要对等广播路由的其他节点 , 各节点打印的结果都会有所不同。随着节点数量的增多 , 这种对等广播的规模和数量将以指数级别上升。
# calicoctl node status
Calico process is running.
IPv4 BGP status
+-----------------+-------------------+-------+----------+-------------+
|  PEER ADDRESS   |     PEER TYPE     | STATE |  SINCE   |    INFO     |
+-----------------+-------------------+-------+----------+-------------+
| 192.168.102.102 | node-to-node mesh | up    | 15:27:42 | Established |
| 192.168.102.103 | node-to-node mesh | up    | 15:27:44 | Established |
+-----------------+-------------------+-------+----------+-------------+中级集群环境应该使用全局对等BGP ( global BGP peers) 模型 ,通过在同一个二层网络中使用一个或一组BGP反射器构建BGP网络环境 , 大型集群环境甚至可以使用每节点对等BGP模型 ( per-node BGP peers) , 即分布式BGP反射器模型。Calico的节点代理calico/node自身就能够充当BGP路由反射器 , 我们可以在Kubernetes集群外部的专用主机上部署calico/node作为路由反射器 , 也可以在集群中选择专用的几个节点进行配置。
示例 :
这里仅处于测试目的 , 将集群中的k8s-master部署为集群中的路由反射器 , 来说明其配置过程。通常来说 , 配置集群节点成为路由反射器大体有3个步骤 : 配置选定的Node作为BGP路由反射器、配置所有节点作为BGP对等节点 ( BGPPeer) 向路由反射器发送路由信息 , 以及禁用节点网格。
配置路由反射器
编写资源清单
reflector-node.yaml, 定义Calico Node资源对象k8s-master成为路由反射器 , 其中的spec.bgp.routeReflectorClusterID字段以IP地址格式的值为BGP路由器集群提供标识符 , 而特地添加的route-reflector标签则于配置BGPPeer时筛选节点。apiVersion: projectcalico.org/v3 kind: Node metadata: labels: route-reflector: true name: k8s-master spec: bgp: ipv4Address: 192.168.102.101/24 ipv4IPIPTunnelAddr: 172.16.235.192 routeReflectorClusterID: 1.1.1.1将上面的配置清单中定义的资源配置应用 ( 打补丁) 到
Datastore之上以完成路由反射器的配置。# calicoctl apply -f reflector-node.yaml Successfully applied 1 'Node' resource(s)
配置
BGP对等节点编写资源清单
bgppeer-demo.yaml, 同一BGP路由器集群中的各节点都需要成为Reflector的BGP对等节点以交换路由信息。k8s-master自身同样运行于Pod资源 , 因而它自身同样需样成为Reflector的BGP对等节点。下面的配置清单示例 (bgppeer-demo.yaml) 定义集群所有节点同符合标签选择器route-reflector=="true"节点 ( 路由反射器) 进行 " 对等 " 。apiVersion: projectcalico.org/v3 kind: BGPPeer metadata: name: bgppeer-demo spec: nodeSelector: all() peerSelector: route-reflector=="true"将
BGPPeer/bgppeer-demo资源创建到Datastore之上 , 相关的 " 对等 " 关系便当即生效。# calicoctl apply -f bgppeer-demo.yaml Successfully applied 1 'BGPPeer' resource(s)新的
BGPPeer资源定义了并非Node-to-Node的对等关系 , 因而在路由反射器节点和其他节点所看到的结果相差较大 , 因为路由反射器同集群中的所有节点对等 , 但其他节点仅会同路由反射器节点对等。下面命令运行在路由反射器 (k8s-master) 之上 , 它已然能够与集群中的节点建立对等关系 ( 自我对等的关系不会显示在命令结果中) 。# calicoctl node status Calico process is running. IPv4 BGP status +-----------------+---------------+-------+----------+-------------+ | PEER ADDRESS | PEER TYPE | STATE | SINCE | INFO | +-----------------+---------------+-------+----------+-------------+ | 192.168.102.102 | node specific | up | 01:23:08 | Established | | 192.168.102.103 | node specific | up | 01:23:10 | Established | +-----------------+---------------+-------+----------+-------------+
禁用节点网格
因原有的
Node-to-Node网络的对等关系尚未禁用,上面命令的输 出结果显示,BGP的路由传播仍然以对等网格的方式进行。下面的资源 清单(default-bgpconfiguration.yaml)定义的BGPConfiguration/default资源就用于禁用这种BGP网格。apiVersion: projectcalico.org/v3 kind: BGPConfiguration metadata: name: default spec: logSeverityScreen: Info nodeToNodeMeshEnabled: false asNumber: 63400 # BGP对等通信时使用的默认AS号需要特别说明的,禁用
BGP网格的配置参数nodeToNodeMeshEnabled,以及BGP会话中使用的默认AS号码仅能够定 义在名为default的全局BGPConfiguration资源中。~$ calicoctl apply -f bgpconfiguration-demo.yaml Successfully applied 1 'BGPConfiguration' resource(s)随后,由
BGPPeer/bgppeer-demo资源定义的各Calico/Node与BGP路由反射器对等关系便会生效,下面的命令仍然是在路由反射器节点 之上运行。~$ sudo calicoctl node status
4. 网络策略
网络策略是控制Pod资源组间以及与其他网络端点间如何进行通信的规范 , 它使用标签来分组Pod , 并在该组Pod之上定义规则来管控其流量 , 从而为Kubernetes提供更为精细的流量控制以及租户隔离机制。NetworkPolicy资源是Kubernetes API的一等公民 , 管理员或用户可使用NetworkPolicy这一标准资源类型按需定义网络访问控制策略。
4.1 网络策略与配置基础
Kubernetes自身仅实现了NetworkPolicy API的规范 , 具体的策略实施要靠CNI网络插件完成 , 例如 , Calico、Antrea、Canal和Weave 等 , 但Flannel并不支持。因而 , 仅在使用支持网络策略功能的网络插件时才能够生效自定义的策略。实现了NetworkPolicy API的各网络插件都有其特定的策略实现方式 , 它们或依赖节点自身的某个组件 , 或借助Hypervisor的特性 , 也可能是网络自身的功能。
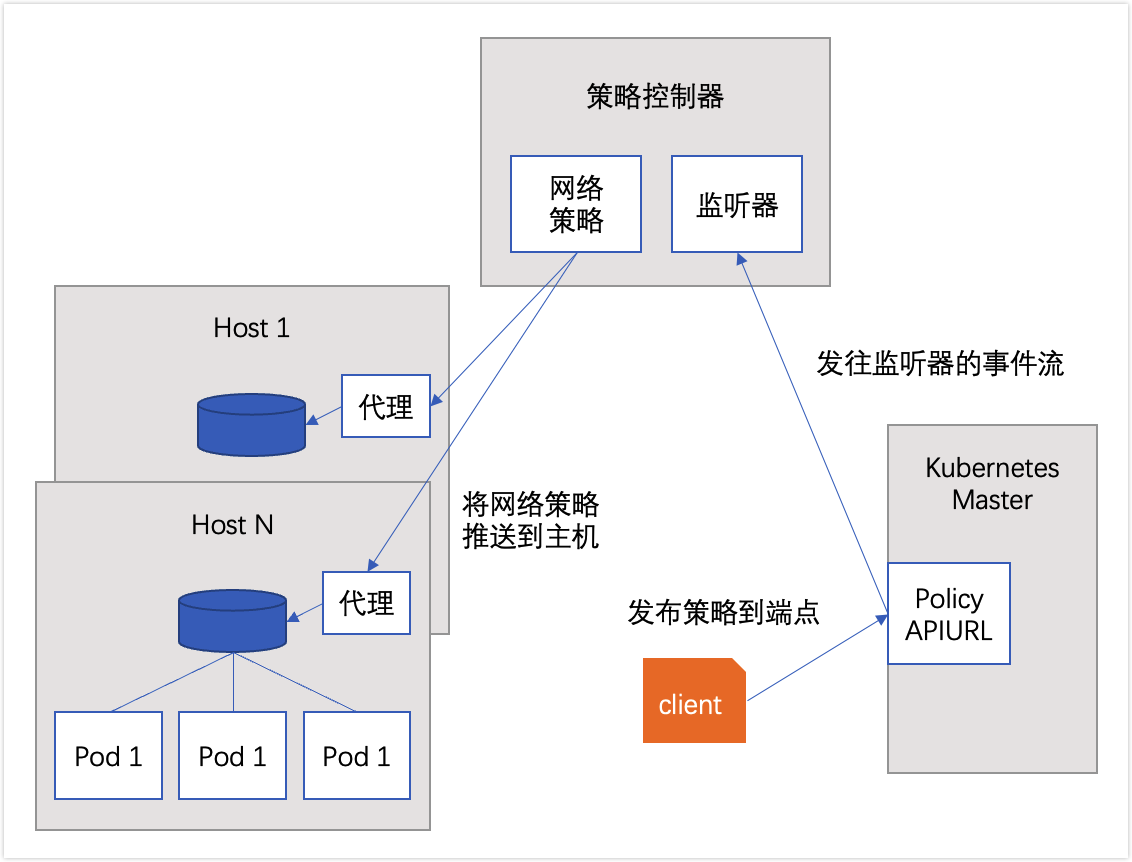
Calico的calico/kube-controllers是该项目中用于将用户定义的网络策略予以实现的组件 , 它主要依赖于在节点上构建iptables规则实现访问控制功能 , 如下图所示。其他支持网络策略的插件也有类似的将网络策略加以实现的 " 策略控制器 " 或 " 策略引擎 " , 它们通过API监听创建Pod时生成的新端点 , 并负责按需为其附加相关的网络策略。
Kubernetes默认并未对Pod之上的流量作为任何限制 , Pod对象能够与集群上的其他任何Pod通信 , 也能够与集群外部的网络端点交互。NetworkPolicy是名称空间级别的资源 , 允许用户使用标签选择器在筛选出的一组Pod对象上分别管理Ingress和Egress流量。一旦将Network Policy引入到名称空间中 , 则被标签选择器 " 选中 " 的Pod将默认拒绝所有流量 , 而仅放行由特定的NetworlPolicy资源明确 " 允许 " 的流量。然而 , 未被任何NetworkPolicy资源的标签选择器选中的Pod对象的流量则不受影响。
Pod之间能否通信可通过如下三种组合进行确认 :
其他被允许的
Pods( 例如 :Pod无法限制对自身的访问)被允许访问的
namespaceIP CIDR( 例如 : 与Pod运行所在节点的通信总是被允许的)
在定义基于 Pod 或namespace的 NetworkPolicy 时 , 可以使用标签选择器来设定哪些流量可以进入或离开 Pod。同时 , 当创建基于 IP 的 NetworkPolicy 时 , 可以基于 IP CIDR 来定义策略。
NetworkPolicy其实就是定义在一组Pod资源上的Ingress规或Egress规则 , 或二者的组合定义 , 具体生效的范围则由 " 策略类 型 " ( policyType) 进行指定。Ingress和Egress规则的基本配置要素如下图所示。
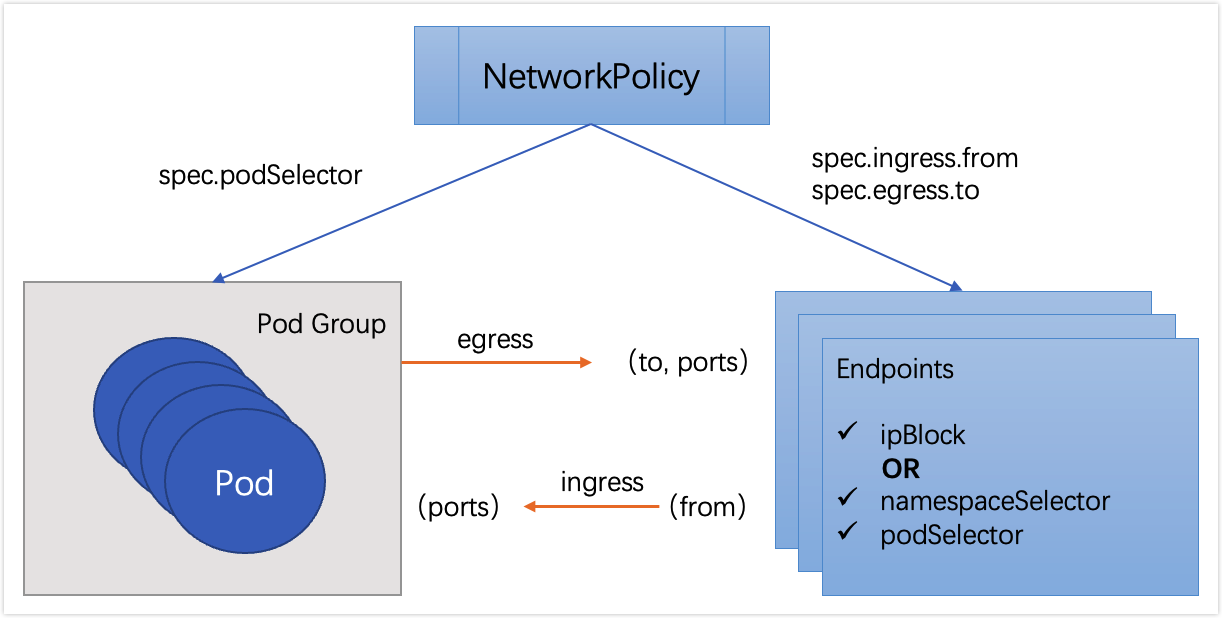
NetworkPolicy是Kubernetes API中标准的资源类型 , 它同样由apiVersion、kind、metadata和spec等字段所定义 , 如下给出了其基本配置框架和简要注释信息。
apiVersion: networking.k8s.io/v1 # 资源隶属的API群组及版本号
kind: NetworkPolicy              # 资源类型的名称
metadata:                        # 资源元数据
  name <string>                  # 资源名称标识
  namespace    <string>          # NetworkPolicy是名称空间级别的资源
spec:                            # 期望的状态
  podSelector  <Object>          # 当前规则生效的同一名称空间中的一组目标Pod对象 , 必选字段
  policyTypes  <[]string>        # Ingress表示生效ingress字段 , Egress表示生效egress字段 , 同时提供表示二者均有效
  ingress      <[]Object>        # 入站流量源端点对象列表 , 即白名单 , 空值表示 " 所有 "
    - from <[]Object>            # 具体的端点对象列表 , 空值表示所有合法端点
        - ipBlock      <Object>  # IP地址范围范围内的端点
        - namespaceSelector   <Object> # 匹配的名称空间内的端点
        - podSelector  <Object>  # 由Pod标签选择器匹配到的端点 , 空值表示<none>
      ports  <[]Object>          # 具体的端口对象列表 , 空值表示所有合法端口
  egress    <[]Object>           # 出站流量目标端点对象列表 , 即白名单 , 空值表示 " 所有 "
    - to <[]Object>              # 具体的端点对象列表 , 空值表示所有合法端点 , 格式同 ingress.from
ports <[]Object> # 具体的端口对象列表 , 空值表示所有合法端口为了方便描述NetworkPolicy资源及其功能 , 常用到以下几个术语。
Pod组 : 由NetworkPolicy资源通过Pod标签选择器 (spec.podSelector) 动态选出的一组Pod资源集合 , 它们也是该网络策略规则管控的目标 , 可通过macthLabel或matchExpression类型的标签选择器选定。Egress规则 : 出站流量的相关规则 , 负责管控由选定的Pod组发往其他网络端点的流量 , 可由流量的目标网络端点 (spec.egress.to) 和端口 (spec.egress.ports) 来定义。Ingress规则 : 入站流量的相关规则 , 负责管控可由选定的Pod组所接收的流量 , 它能够由流量发出的源端点(spec.ingress.from) 和流量的目标端口 (spec.ingress.ports) 来定义。对端端点 (
to,from) : 与选定的Pod组交互的对端主机 , 它可由CIDR格式的IP地址块 (ipBlock) 、网络名称空间选择器 (namespaceSelector) 来匹配名称空间内的所有Pod对象 , 甚至也可以是由Pod选择器 (podSelector) 在指定名称空间中选出的一组特定Pod对象等。
在Ingress规则中 , 由from指定的网络端点也称为 "源端点" ; 而在Egress规则中 , 网络端点也称为 " 目标端点 " , 它们用to字段标识。对于未启用Ingress或Egress规则的Pod组 , 流量方向默认均为 "允许" , 即默认为非隔离状态。而一旦在networkpolicy.spec中明确给出了ingress或egress字段 , 则它们的from或to字段的值就成了白名单列表 ; 空值意味着选定所有端点 , 即允许相应方向上的所有流量通过 , 此时ingress和egress字段作用与未启用流量方向设置时相同。
Ingress或Egress规则的生效机制略复杂 , 以Ingress为例 , 明确定义spec.policyType为Ingress , 但却未定义spec.ingress字段 , 则它无法匹配任何流量 , 因而选出的Pod组将不接受任何端点的访问 , 而使用了空值的spec.ingress字段或者spec.ingress.from字段 , 表示匹配所有合法端点 , 因而选出的Pod组可被任意端点访问。另一方面 , 即便Egress规则拒绝了所有流量 , 但由Ingress规则放行的请求流量的响应报文依然能够正常出站 , 它并不受限于Egress规则的定义 , 反之亦然。
尽管功能上日渐丰富 , 但NetworkPolicy资源仍然具有相当的局限性 , 例如它没有明确的拒绝规则、缺乏对选择器高级表达式的支持、不支持应用层规则 , 以及没有集群范围的网络策略等。为了解决这些限制 , Calico等提供了自有的策略CRD , 包括NetworkPolicy和GlobalNetworkPolicy等 , 其中的NetworkPolicy CRD比Kubernetes NetworkPolicy API提供了更大的功能集 , 包括拒绝规则、规则解析以及应用层规则等 , 但相关的规则需要由calicoctl创建。
Calico项目既能独立地为Kubernetes集群提供网络插件和网络策略 , 也能与Flannel结合在一起 , 由Flannel提供网络解决方案 , 而Calico仅用于提供网络策略 , 这种解决方案就是独立的Canal项目。不过 , Canal目前直接使用Calico和Flannel项目 , 代码本身并没有任何修改 , 因此Canal仅是一种部署模式 , 用于安装和配置项目 , 从用户和编排系统的角度无缝地作为单一网络解决方案协同工作。
下面是一个 NetworkPolicy 示例 :
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: test-network-policy
  namespace: default
spec:
  podSelector:
    matchLabels:
      role: db
  policyTypes:
    - Ingress
    - Egress
  ingress:
    - from:
        - ipBlock:
            cidr: 172.17.0.0/16
            except:
              - 172.17.1.0/24
        - namespaceSelector:
            matchLabels:
              project: myproject
        - podSelector:
            matchLabels:
              role: frontend
      ports:
        - protocol: TCP
          port: 6379
  egress:
    - to:
        - ipBlock:
            cidr: 10.0.0.0/24
      ports:
        - protocol: TCP
          port: 5978
必需字段 : 与所有其他的
Kubernetes配置一样 ,NetworkPolicy需要apiVersion、kind和metadata字段。
spec:NetworkPolicy规约中包含了在名字空间中定义特定网络策略所需的所有信息。
podSelector: 每个NetworkPolicy都包括一个podSelector, 它选择适用该该策略的Pod。示例中的策略选择带有"role=db" 标签的Pod。若podSelector为空的 , 则选择名字空间下所有Pod。
policyTypes: 每个NetworkPolicy都包含一个policyTypes列表 , 其中包含Ingress或Egress或 ( 两者亦可) 。policyTypes字段表示给定的策略是应用于所选Pod的入口流量还是来出口流量 ( 两者亦可) 。如果NetworkPolicy未指定policyTypes则默认情况下始终设置Ingress; 如果NetworkPolicy有任何出口规则的话则设置Egress。ingress: 每个
NetworkPolicy可包含一个ingress规则的白名单列表。每个规则都允许同时匹配from和ports部分的流量。示例策略中包含一条 简单的规则 : 它匹配某个特定端口 , 第一个通过ipBlock指定 , 第二个通过namespaceSelector指定 , 第三个通过podSelector指定。egress: 每个
NetworkPolicy可包含一个egress规则的白名单列表。每个规则都允许匹配to和port部分的流量。该示例策略包含一条规则 , 该规则指定端口上的流量匹配到10.0.0.0/24中的任何目的地。
该网络策略总结如下:
隔离
default名字空间下role=db的Pod。出口限制:允许符合以下条件的
Pod连接到default名字空间下标签为role=db的所有Pod的6379 TCP端口 :default名字空间下带有role=frontend标签的所有Pod带有
project=myproject标签的所有名字空间中的PodIP地址范围为172.17.0.0–172.17.0.255和172.17.2.0–172.17.255.255( 即除了172.17.1.0/24之外的所有172.17.0.0/16)
入口限制 : 允许从带有
role=db标签的名字空间下的任何Pod到CIDR 10.0.0.0/24下5978 TCP端口。
4.2. 管控入站流量
服务类型的Pod对象通常是流量请求的目标对象 , 但它们的服务未必应该公开给所有网络端点访问 , 这就有必要对它们的访问许可施加控制。在待管控流量Pod对象所处的名称空间创建一个NetworkPolicy 对象 , 使用spec.podSelector选中这组Pod , 并在spec.ingress字段中嵌套管理规则 , 便能定向放行入站的访问流量。
ingress字段可嵌套使用的from和ports均为可选字段 , 空值意味着授权任意端点访问本地Pod组的任意端口 , 即放行所有入站流量。当仅定义了from字段时会隐含本地Pod组上的所有端口 , 而仅定义ports 则隐含所有的源端点。from ( 源端点) 和ports (目标端口) 定义在同一个列表项中会隐含 " 逻辑与 " 关系 , 它匹配那些同时满足from和 ports定义的入站流量。
ingress.from字段from字段的值是一个对象列表 , 用于界定访问目标Pod组的一到多个流量来源 , 可嵌套使用ipBlock、namespaceSelector和podSelector这3个可选字段。这3个字段匹配Pod资源的方式各有不同 , 且ipBloc与另外两个字段互斥 , 而同时使用namespaceSelector和podSelector字段时隐含 " 逻辑与 " 关系 , 而多个列表项彼此间隐含 " 逻辑或 " 关系。ipBlock <Object>: 根据IP地址或网络地址块匹配流量源端点。namespaceSelector <Object>: 使用标签选择器挑选名称空间 , 它将匹配由此标签选择器选出的相关名称空间内的所有Pod对象 ; 空值表示匹配所有的名称空间 , 即源端点可为集群上的任意Pod对象。podSelector <Object>: 于NetworkPolicy资源所在的当前名称空间内基于标签选择器挑选Pod对象 , 空值表示挑选当前名称空间内的所有Pod对象 ; 与namespaceSelector字段同时使用时 , 作用域为挑选出的名称空间 , 而非当前名称空间。
ingress.ports字段ports字段的值也是一个对象列表 , 用于界定可被源端点访问的目标端口 , 它嵌套port和protocol来定义流量的目标端口 , 即由NetworkPolicy资源匹配到的当前名称空间内的Pod组上的端口。port <string>: 端口号或在container上定义的端口名称 , 未定义时匹配所有端口。protocol <string>: 传输层协议名称 ,TCP或UDP, 默认为TCP。
入站流量示例 :
准备工作 : 这里先创建一个dev名称空间 , 再在里面创建一些pod , 方便下面的测试 , 且这里的pod内部都运行demoapp服务 , 监听80端口。 Pod信息如下 :
# kubectl get pods -n dev -o wide  --show-labels
NAME                              READY   STATUS    RESTARTS   AGE     IP               NODE        NOMINATED NODE   READINESS GATES   LABELS
deployment-demo-cb69c57b7-22bbk   1/1     Running   0          2m21s   172.16.169.133   k8s-node2   <none>           <none>            app=demoapp,pod-template-hash=cb69c57b7,release=stable
deployment-demo-cb69c57b7-dsbpq   1/1     Running   0          2m21s   172.16.169.134   k8s-node2   <none>           <none>            app=demoapp,pod-template-hash=cb69c57b7,release=stable
deployment-demo-cb69c57b7-nbkxh   1/1     Running   0          2m21s   172.16.36.70     k8s-node1   <none>           <none>            app=demoapp,pod-template-hash=cb69c57b7,release=stable
deployment-demo-cb69c57b7-pk5p6   1/1     Running   0          2m21s   172.16.36.69     k8s-node1   <none>           <none>            app=demoapp,pod-template-hash=cb69c57b7,release=stable
编写资源清单文件
netpol-dev-demoapp-ingress.yaml, 这里资源清单中的NetworkPolicy资源将dev名称空间中满足标签选择器app=demoapp的所有Pod对象定义的Pod组 , 通过Ingress规则定义了该Pod组上入站流量规则。apiVersion: networking.k8s.io/v1 kind: NetworkPolicy metadata: name: demoapp-ingress namespace: dev # 网络策略生效的名称空间 spec: podSelector: # 定义本地Pod组的标签选择器 matchLabels: app: demoapp policyTypes: ["Ingress"] # 仅生效Ingress规则 ingress: - from: # 规则1 : 可访问Pod组上任意端口的流量源 - namespaceSelector: # 指定名称空间中的所有端点,这里表示只有namespace具有标签kubernetes.io/metadata.name=dev,kubernetes.io/metadata.name=kube-system等几个名称空间内的资源可以访问 matchExpressions: - key: kubernetes.io/metadata.name operator: In values: [dev, kube-system, logs, monitoring, kubernetes-dashboard] - from: # 规则2 : 可访问Pod组的80端口的流量源 - namespaceSelector: # 流量源 , 这里表示除了default名称空间之外的其他所有名称空间中的端点 matchExpressions: - {key: kubernetes.io/metadata.name, operator: NotIn, values: ["default"]} ports: - protocol: TCP port: 80创建上面资源清单中的
NetworkPolicy# kubectl apply -f netpol-dev-demoapp-ingress.yaml networkpolicy.networking.k8s.io/demoapp-ingress created查看
NetworkPolicy资源详细信息 , 可以清晰看出对应的规则等。# kubectl get networkpolicy/demoapp-ingress -n dev NAME POD-SELECTOR AGE demoapp-ingress app=demoapp 50s # kubectl describe netpol demoapp-ingress -n dev Name: demoapp-ingress Namespace: dev ...... Annotations: <none> Spec: PodSelector: app=demoapp Allowing ingress traffic: To Port: <any> (traffic allowed to all ports) From: NamespaceSelector: kubernetes.io/metadata.name in (dev,kube-system,kubernetes-dashboard,logs,monitoring) ---------- To Port: 80/TCP From: NamespaceSelector: kubernetes.io/metadata.name notin (default) Not affecting egress traffic Policy Types: Ingress
测试 :
这里仅对
80端口进行测试 , 首先在default名称空间对dev名称空间的Pod的80端口服务发起请求测试。# kubectl run client-$RANDOM --image="vvoo/demoapp:v1.0" -n default --rm -it --command -- /bin/sh If you don't see a command prompt, try pressing enter. [root@client-17796 /]$ curl --connect-timeout 5 172.16.36.70 curl: (28) Connection timeout after 5002 ms上面的测试结果可以看出 ,
default名称空间中的Pod对象发往dev名称空间特定Pod组的请求因未明确设置放行规则而被拒绝。接着 , 再换到未限定的端口的名称空间列表中的某一个进行测试 , 例如
prod, 以确保该请求能被第2个规则所匹配。# kubectl run client-$RANDOM --image="vvoo/demoapp:v1.0" -n prod --rm -it --command -- /bin/sh If you don't see a command prompt, try pressing enter. [root@client-7520 /]$ curl --connect-timeout 5 172.16.36.70 vvoo demoapp v1.0 !! ClientIP: 172.16.36.74, ServerName: deployment-demo-cb69c57b7-nbkxh, ServerIP: 172.16.36.70!上面的测试结果可以看出 , 在
prod名称空间访问dev名称空间特定Pod组的80端口请求被通过 , 这表示被第2个规则匹配了。在集群之外通过节点向目标服务发起请求 , 以测试非名称空间中端点的请求放行状态。
# curl --connect-timeout 5 172.16.36.70
curl: (28) Connection timed out after 5002 milliseconds
上面的测试结果可以看出 , 因为没有任何规则可匹配到集群外部的端点 , 因而请求会被拒绝。这也表明 , 在namespaceSelector中使用排除法时 , 最后的限定是集群上被排除的端点之外的其他端点。若要放行集群外部的端点 , 我们应该使用没有任何限制的流量源 , 例如from: {}。
4.3. 管控出站流量
除非是在当前名称空间中即可完成所有目标功能 , 否则大多数情况下 , 一个名称空间中的Pod资源总是有对外请求的需求 , 例如向CoreDNS请求解析名称等。因此 , 通常应该将出站流量的默认策略设置为准许通过。但如果要对流量实施精细管理 , 仅放行有对外请求必要的Pod对象的出站流量 , 可使用同Ingress规则相似的逻辑来定义Egress规则。
networkpolicy.spec中嵌套的egress字段用于定义出站流量规则 , 就特定的Pod集合来说 , 出站流量一样默认处于放行状态 , 但只要有一个NetworkPolicy资源的标签选择器可以匹配到该Pod集合 , 则默认策略将转为拒绝。与Ingress规则不同的之外在于 , egress字段嵌套使用to和ports字段 , 前者用于定义本地Pod组的请求流量可发往的目标端点 , 其格式与逻辑都与ingres.from相同 , 后者同样用于限定可访问的目标端口 , 不过是指被访问的对端端点上的服务端口。
出站流量示例 :
准备工作 : 这里先创建一个dev名称空间 , 再在里面创建一些deployment , 且创建一个Service进行关联 , 方便下面的测试 , 且这下面的pod内部都运行demoapp服务 , 监听80端口。Pod、deployment、service信息如下 :
# kubectl get deployment -n dev
NAME              READY   UP-TO-DATE   AVAILABLE   AGE
deployment-demo   4/4     4            4           76m

# kubectl get pods -n dev  --show-labels -o wide
NAME                              READY   STATUS    RESTARTS   AGE   IP               NODE        NOMINATED NODE   READINESS GATES   LABELS
deployment-demo-cb69c57b7-22bbk   1/1     Running   0          79m   172.16.169.133   k8s-node2   <none>           <none>            app=demoapp,pod-template-hash=cb69c57b7,release=stable
deployment-demo-cb69c57b7-dsbpq   1/1     Running   0          79m   172.16.169.134   k8s-node2   <none>           <none>            app=demoapp,pod-template-hash=cb69c57b7,release=stable
deployment-demo-cb69c57b7-nbkxh   1/1     Running   0          79m   172.16.36.70     k8s-node1   <none>           <none>            app=demoapp,pod-template-hash=cb69c57b7,release=stable
deployment-demo-cb69c57b7-pk5p6   1/1     Running   0          79m   172.16.36.69     k8s-node1   <none>           <none>            app=demoapp,pod-template-hash=cb69c57b7,release=stable

# kubectl describe svc demoapp-deploy -n dev
Name:              demoapp-deploy
Namespace:         dev
Labels:            <none>
Annotations:       <none>
Selector:          app=demoapp,release=stable
Type:              ClusterIP
IP Family Policy:  SingleStack
IP Families:       IPv4
IP:                10.111.183.6
IPs:               10.111.183.6
Port:              http  80/TCP
TargetPort:        80/TCP
Endpoints:         172.16.169.133:80,172.16.169.134:80,172.16.36.69:80 + 1 more...
Session Affinity:  None
Events:            <none>
编写资源清单
netpol-dev-egress.yaml, 这里资源清单中的NetworkPolicy资源为匹配标签app=demoapp的Pod组通过Egress规则限制了可外发请求流量的白名单 , 它仅能访问指定端点的特定服务端口。apiVersion: networking.k8s.io/v1 kind: NetworkPolicy metadata: name: demoapp-egress namespace: dev spec: podSelector: # 定义本地Pod组的标签选择器 matchLabels: app: demoapp policyTypes: ["Egress"] # 仅生效Egress规则 egress: - to: # 规则1 , 仅生效于UDP协议的53号端口 , 不限制流量目标 ports: - protocol: UDP port: 53 - to: # 规则2 , 仅生效于TCP协议的6379端口 - podSelector: # 流量目标 : 当前名称空间中匹配指定标签的Pod对象 matchLabels: app: redis ports: - protocol: TCP port: 6379 - to: # 规则3 : 仅生效于TCP协议的80端口 - podSelector: # 流量目标 : 当前名称空间中匹配指定标签的Pod对象 matchLabels: app: demoapp # 同一组Pod内彼此间可互相访问 ports: - protocol: TCP port: 80
创建上面资源清单中的
NetworkPolicy# kubectl apply -f netpol-dev-egress.yaml networkpolicy.networking.k8s.io/demoapp-egress created查看
NetworkPolicy资源详细信息 , 可以清晰看出对应的规则等。# kubectl describe netpol demoapp-egress -n dev Name: demoapp-egress Namespace: dev ...... Annotations: <none> Spec: PodSelector: app=demoapp Not affecting ingress traffic Allowing egress traffic: To Port: 53/UDP To: <any> (traffic not restricted by destination) ---------- To Port: 6379/TCP To: PodSelector: app=redis ---------- To Port: 80/TCP To: PodSelector: app=demoapp Policy Types: Egress
测试 :
在
Service对象demoapp-deploy.dev.svc关联到的任意一个Pod之上对该服务对象自身发起访问请求 , 即可同时测试DNS名称解析服务请求和组内demoapp应用服务的请求结果状态。# POD=$(kubectl get pods -l app=demoapp -o jsonpath='{.items[0].metadata.name}' -n dev) # kubectl exec $POD -n dev -- curl -s demoapp-deploy.dev.svc vvoo demoapp v1.0 !! ClientIP: 192.168.102.103, ServerName: deployment-demo-cb69c57b7-22bbk, ServerIP: 172.16.169.133!上面的测试结果可以看出 , 可以正常通过
CronDNS进行解析 , 也就是能访问UDP的53端口。访问
kubernetes-dashboard名称空间中的服务。# kubectl exec $POD -n dev -- curl -s -k https://kubernetes-dashboard.kubernetes-dashboard.svc command terminated with exit code 28
上面的测试结果可以看出 , 访问kubernetes-dashboard服务的最后结果就是因为请求超时而退出。
事实上 , 同一组Pod上的Ingress和Egress规则通常应该定义在同一个NetworkPolicy资源之上 , 这里只是为了分开说明其用法而刻意放置在了不同的资源之上进行定义。另外需要再次说明的是 , Ingress规则放行的请求响应报文不受Egress规则的限制 , 同理 , Egress规则放行的出站请求而得到的入站响应报文也不受Ingress规则的限制。
4.4. 隔离名称空间
实践中 , 以名称空间分隔的多租户甚至是多项目的Kubernetes集群上 , 通常应该设定彼此间的通信隔离 , 以提升系统整体安全性。但这些名称空间通常应该允许内部各Pod间的通信 , 以及允许来自集群上管理类应用专用名称空间的请求 , 包括kube-system和kubernetes-dashboard , 以及集群式日志收集系统专用的名称空间 ( 例如logs) 和监控系统专用的名称空间 ( 例如monitoring) 等。同时 , 这些名称空间通常会请求DNS服务 , 以及Kubernetes的API等。下面的配置清单示例 ( netpol-dev-default.yaml) 为dev名称空间创建了一个名为default的NetworkPolicy资源 , 它大体实现了上述要求。
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default
  namespace: dev
spec:
  podSelector: {}                     # 当前名称空间中的所有Pod对象
  policyTypes: ["Ingress","Egress"]   # Ingress和Egress规则同时生效
  ingress:
  - from:                             # 入站规则1 : 开放所有端口
    - namespaceSelector:              # 流量源 : 来自指定名称空间中的所有源端点
        matchExpressions:
        - key: kubernetes.io/metadata.name
          operator: In
          values: [stage,kube-system,logs,monitoring,kubernetes-dashboard]
  egress:
  - to:      # 出站规则1 : 开放对任意外部端点上UDP协议53端口的访问
    ports:
    - protocol: UDP
      port: 53
  - to:       # 出站规则2 : 仅生效于TCP协议的443端口
    - namespaceSelector:    # 流量目标 : 指定名称空间内的指定Pod对象
        matchLabels:
          kubernetes.io/metadata.name: kube-system
      podSelector:
        matchLabels:
          component: kube-apiserver
    ports:      # 端口列表
    - protocol: TCP
      port: 443
  - to:      # 出站规则3 : 生效的所有端口
    - namespaceSelector:      # 流量目标 : 当前名称空间中的所有端点
        matchLabels:
kubernetes.io/metadata.name: dev若不希望完全放行当前名称空间中所有Pod对象彼此间的流量 , 可以从Ingress和Egress规则中将适配当前名称空间的部分移除 , 而后由其他规则显式放行必要的内部流量。
显然 , 每个名称空间都需要以当前名称空间为中心设置如上NetworkPolicy资源才能完成彼此间隔离 , 但Kubernetes不支持集群级别的NetworkPolicy , 因而只能逐个名称空间进行定义 , 且需要确保各名称空间中的用户不能轻易删除该NetworkPolicy资源。
4.5. Calico的网络策略
Calico支持GlobalNetworkPolicy和NetworkPolicy两种资源 , 前者用于定义集群全局网络策略 , 而后者大致可看作Kubernetes NetworkPolicy的一个超集。
GlobalNetworkPolicy支持使用selector、 serviceAccountSelector或namespaceSelector来选定网络策略的生效范围 , 默认为all() , 即集群上的所有端点。
Calico全局网络策略示例 :
编写资源清单文件
calico-globalnetworkpolicy-demo.yaml, 该资源清单文件为非系统类名称空间定义了一个通用的网络策略。apiVersion: projectcalico.org/v3 kind: GlobalNetworkPolicy metadata: name: namespaces-default spec: order: 0.0 # 策略叠加时的应用次序 , 数字越小越先应用 , 冲突时 , 后者会覆盖前者 # 策略应用目标为非指定名称空间中的所有端点 namespaceSelector: kubernetes.io/metadata.name not in {"kube-system","kubernetes-dashboard","logs","monitoring"} types: ["Ingress", "Egress"] ingress: # 入站流量规则 - action: Allow # 白名单 # 可由下面系统名称空间中每个源端点访问策略生效目标中端点的任意端口 source: namespaceSelector: kubernetes.io/metadata.name in {"kube-system","kubernetes-dashboard","logs","monitoring"} egress: # 出站流量规则 - action: Allow # 允许所有示例中 , 非系统名称空间中的
Pod资源不允许非系统名称空间中的任何端点访问 , 包括同一名称空间中的其他端点。以dev为例 , 指定的4个系统名称空间中的端点可访问dev内的任意端点 , 但dev内的各端点彼此间并不能互相访问 , 也不能访问其他非系统名称空间中的端点。但各名称空间内的出站流量不受任何限制。应用上面的资源清单 , 这里需要使用
calicoctl来进行应用 , 因为该资源类型是calico所管理。 ( 注意 : 需确保资源清单中的几个名称空间拥有相应的标签)# calicoctl apply -f calico-globalnetworkpolicy-demo.yaml Successfully applied 1 'GlobalNetworkPolicy' resource(s)查看策略详细信息
# calicoctl get globalNetworkPolicy -o yaml
apiVersion: projectcalico.org/v3
items:
- apiVersion: projectcalico.org/v3
  kind: GlobalNetworkPolicy
  metadata:
    name: namespaces-default
    resourceVersion: "103978"
  spec:
    egress:
    - action: Allow
      destination: {}
      source: {}
    ingress:
    - action: Allow
      destination: {}
      source:
        namespaceSelector: kubernetes.io/metadata.name in {"kube-system","kubernetes-dashboard","logs","monitoring"}
    namespaceSelector: kubernetes.io/metadata.name not in {"kube-system","kubernetes-dashboard","logs","monitoring"}
    order: 0
    types:
    - Ingress
    - Egress
kind: GlobalNetworkPolicyList
metadata:
  resourceVersion: "104043"
测试 :
按照全局网络策略的定义 , dev名称空间的网络端点可以外发任何请求 , 包括请求kube-system中的kube-dns服务等 , 但这些网络端点彼此间无法访问 , 也不允许其他非系统名称空间中的端点访问。
以前面在该名称空间中创建的
Deployment/demoapp中的任意一个Pod为客户端进行测试。# POD=$(kubectl get pods -l app=demoapp -o jsonpath='{.items[0].metadata.name}' -n dev) # kubectl exec -it $POD -n dev -- /bin/sh测试
DNS名称解析 , 成功完成。[root@deployment-demo-cb69c57b7-22bbk /]$ host -t A demoapp-deploy.dev.svc demoapp-deploy.dev.svc.cluster.local has address 10.111.183.6测试访问当前名称空间中的服务 , 失败。
[root@deployment-demo-cb69c57b7-22bbk /]$ curl --connect-timeout 5 demoapp-deploy.dev.svc
curl: (28) Connection timeout after 5001 ms
测试访问集群外部服务 , 成功。
[root@deployment-demo-cb69c57b7-22bbk /]$ curl -I https://www.baidu.com
HTTP/1.1 200 OK
......
另一方面 , dev名称空间中的各Pod允许接收指定的4个系统名称空间中任意端点发来的请求 , 并接受除此之外的其他名称空间中端点的访问请求。下面以monitoring和default名称空间为例 , 使用其内部的端点向dev名称空间中的demoapp服务进行请求测试。
若不存在 , 则先创建名称空间 , 并为其打上标签。
# kubectl create namespace monitoring
namespace/monitoring created

# kubectl get namespaces monitoring --show-labels
NAME         STATUS   AGE   LABELS
monitoring   Active   29s   kubernetes.io/metadata.name=monitoring
在
monitoring名称空间创建一个Pod, 以之为客户端进行测试 , 可成功完成访问。# kubectl run client-$RANDOM --image="vvoo/admin-toolbox:v1.0" --rm -it --command -n monitoring -- /bin/sh If you don't see a command prompt, try pressing enter. [root@client-3527 /]# [root@client-3527 /]# curl demoapp-deploy.dev.svc vvoo demoapp v1.0 !! ClientIP: 172.16.36.76, ServerName: deployment-demo-cb69c57b7-22bbk, ServerIP: 172.16.169.133!在
default名称空间创建一个Pod, 以之为客户端进行测试 ,# kubectl run client-$RANDOM --image="vvoo/admin-toolbox:v1.0" --rm -it --command -n default -- /bin/shIf you don't see a command prompt, try pressing enter. [root@client-6444 /] [root@client-6444 /]# curl --connect-timeout 5 demoapp-deploy.dev.svc curl: (28) Connection timeout after 5001 ms
定义好使用的全局网络策略 , 名称空间管理员便可按需使用NetworkPolicy资源组合定义本地入站流量的白名单 , 来设置端点的访问控制机制。GlobalNetworkPolicy和NetworkPolicy更详细的用法 , 参考官网文档
部署Calico时 , GlobalNetworkPolicy和NetworkPolicy都以CRD的形式分别映射到了Kubernetes API之上 , 只不过它们隶属于自定义的crd.projectcalico.org/v1这一API群组和版本 , 管理员亦可使用该CRD来定义Calico的全局网络策略和名称空间级别的网络策略 , 其格式和意义基本与原生格式相同。