
4-4-k8s组件-calico
Calico是一种容器之间互通的网络方案 , 在虚拟化平台中 , 比如OpenStack、Docker等都需要实现workloads之间互连 , 但同时也需要对容器做隔离控制 , 就像在Internet中的服务仅开放80端口、公有云的多租户一样 , 提供隔离和管控机制。而在多数的虚拟化平台实现中 , 通常都使用二层隔离技术来实现容器的网络 , 这些二层技术有一些弊端 , 比如需要依赖VLAN、Bridge和隧道技术。其中Bridge带来了复杂性 , Vlan隔离和Tunnel隧道则消耗等多的资源并对物理环境有要求。随着网络规模的增大 , 整体会变得更加复杂。我们尝试把Host当做Internet中的路由器 , 使用BGP同步路由 , 并使用Iptables来做安全访问策略 , 最终设计出了Calico方案。
设计思想 : Calico不使用隧道或者NAT来实现转发 , 而是巧妙的把所有二三层流量转换成三层流量 , 并通过host上路由配置完成跨host转发。
Calico是一个纯三层的虚拟网络解决方案 , 它把每个节点都当作虚拟路由器 (vRouter) , 并把每个节点上的Pod都当作是“节点路由器”后的一个终端设备并为其分配一个IP地址。各节点路由器通过BGP协议学习生成路由规则 , 从而实现不同节点上Pod间的互联互通。
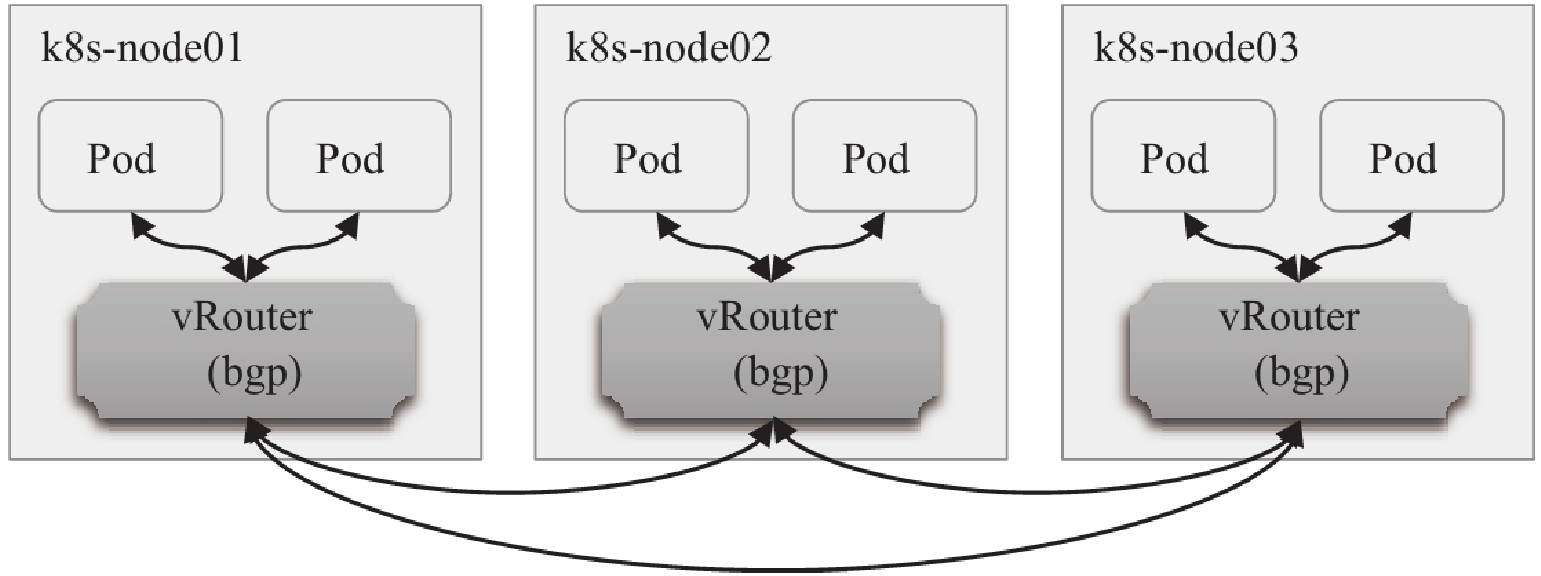
BGP是互联网上一个核心的去中心化自治路由协议 , 它通过维护IP路由表或“前缀”表来实现自治系统(AS)之间的可达性 , 通常作为大规模数据中心维护不同的自治系统之间路由信息的矢量路由协议。Linux内核原生支持BGP , 因而我们可轻易把一台Linux主机配置成为边界网关。
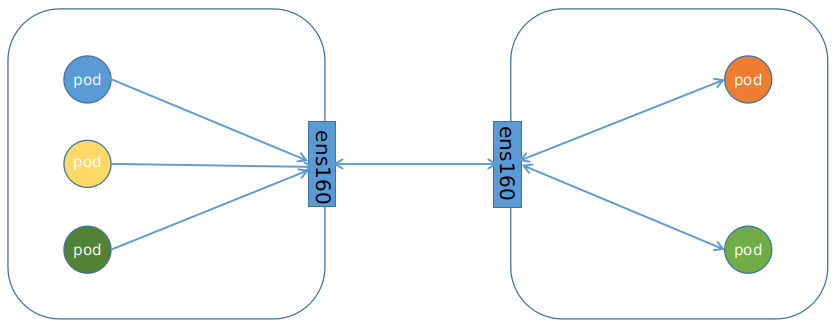
Calico把Kubernetes集群环境中的每个节点上的Pod所组成的网络视为一个自治系统 , 而每个节点也就自然由各自的Pod对象组成虚拟网络 , 进而形成自治系统的边界网关。各节点间通过BGP协议交换路由信息并生成路由规则。但考虑到并非所有网络都能支持BGP , 而且BGP路由模型要求所有节点必须要位于同一个二层网络 , 所以Calico还支持基于IPIP和VXLAN的Overlay网络模型 , 它们的工作模式与Flannel的VXLAN和IPIP模型并无显著不同。
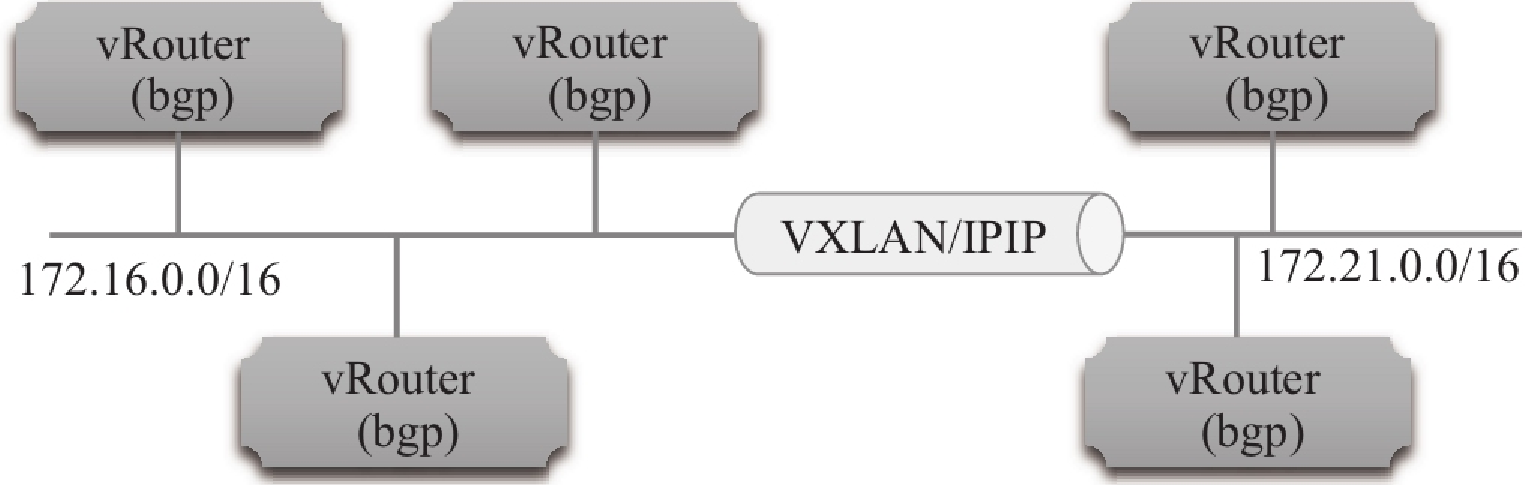
类似Flannel在VXLAN后端启用DirectRouting时的网络模型 , Calico也支持混合使用路由和Overlay网络模型 , BGP路由模型用于二层网络的高性能通信 , IP-IP或VXLAN用于跨子网的节点间报文转发 , 如下所示。IP-IP协议包头非常小 , 理论上它的速度要比VXLAN稍快一点 , 但安全性更差。
Calico网络提供的在线部署清单中默认使用的是IPIP隧道网络 , 而非BGP或者混合模型 , 因为它假设节点的底层网络不支持BGP协议。明确需要使用BGP或混合模型时 , 需要事先修改calico的yaml清单文件 , 按需修改后方可部署在Kubernetes集群之上。
1. Calico架构
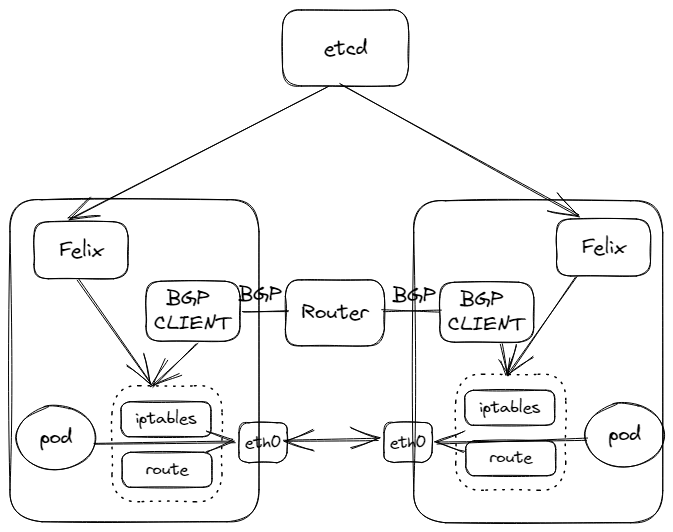
BGP模式下的Calico所承载的各Pod资源直接基于vRouter经由基础网络进行互联 , 它非叠加、无隧道、不使用VRF表 , 也不依赖于NAT , 因此每个工作负载都可以直接配置使用公网IP接入互联网 , 当然 , 也可以按需使用网络策略控制它的网络连通性。
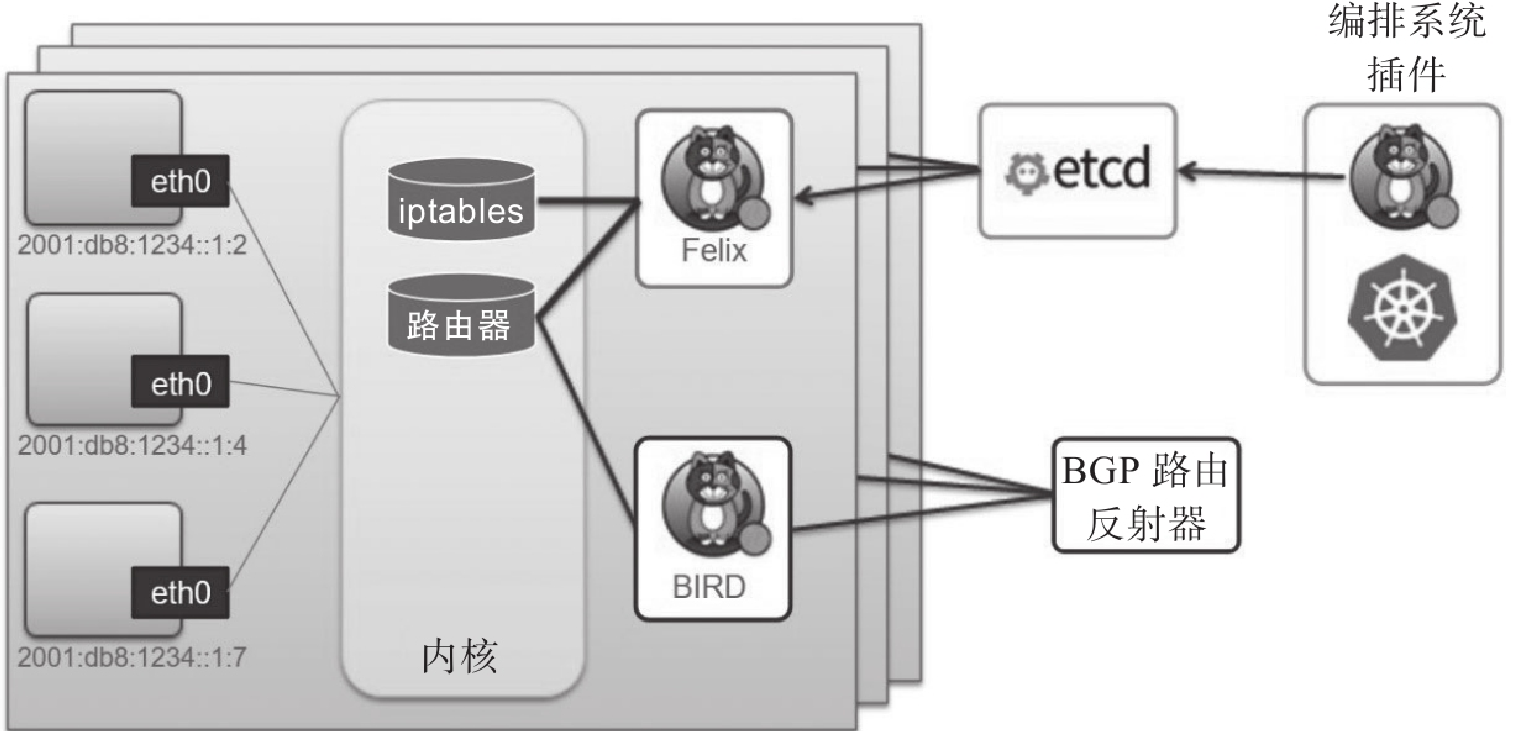
Calico的系统组件主要有Felix、BGP路由反射器、编排系统插件、BIRD和etcd存储系统等。
FelixFelix是运行于各节点上守护进程 , 它主要负责完成接口管理、路由规划、ACL规划和状态报告几个核心任务 , 从而为各端点(VM或Container) 生成连接机制。作为agent运行在托管容器或虚拟机的Calico节点上。Felix负责刷新主机路由和ACL规则等 , 以便为该主机上的Endpoint正常运行提供所需的网络连接和管理。进出容器、虚拟机和物理主机的所有流量都会遍历Calico, 利用Linux内核原生的路由和iptables生成的规则。接口管理 , 负责创建网络接口、生成必要信息并送往内核 , 以确保内核能正确处理各端点的流量 , 尤其是要确保目标节点
MAC能响应当前节点上各工作负载的MAC地址的ARP请求 , 以及为Felix管理的接口打开转发功能。另外 , 接口管理还要监控各接口的变动以确保规则能得到正确应用。路由规划 , 负责为当前节点上运行的各端点在内核
FIB(Forwarding Information Base) 中生成路由信息 , 以保证到达当前节点的报文可正确转发给端点。ACL规划 , 负责在Linux内核中生成ACL, 实现仅放行端点间的合规流量 , 并确保流量不能绕过Calico等安全措施。状态报告 , 负责提供网络健康状态的相关数据 , 尤其是报告由
Felix管理的节点上的错误和问题。这些报告数据会存储在etcd, 供其他组件或网络管理员使用。
编排系统插件
编排系统插件的主要功能是将
Calico整合进所在的编排系统中 , 例如Kubernetes或OpenStack等。它主要负责完成API转换 , 从而让管理员和用户能够无差别地使用Calico的网络功能。换句话说 , 编排系 统通常有自己的网络管理API, 相应的插件要负责将对这些API的调用 转换为Calico的数据模型 , 并存储到Calico的存储系统中。因而 , 编 排插件的具体实现依赖于底层编排系统 , 不同的编排系统有各自专用 的插件。etcd存储系统利用
etcd,Calico网络可实现为有明确状态( 正常或故障) 的系 统 , 且易于通过扩展应对访问压力的提升 , 避免自身成为系统瓶颈。 另外 ,etcd也是Calico各组件的通信总线。BGP客户端Calico要求在每个运行着Felix的节点上同时运行一个称为BIRD的守护进程 , 它是BGP协议的客户端 , 负责将Felix生成的路由信息载入内核并通告给整个网络中。BGP客户端的作用是读取Felix编写到内核中的路由信息 , 由BGP客户端对这些路由信息进行分发。当Felix将路由插入Linux内核时 ,BGP客户端将接收它们 , 并将它们分发到集群中的其他工作节点。BGP Client运行在每一台node节点 , 负责监听node节点上由felix生成的路由信息 , 然后通过BGP协议广播至其他剩余的node节点 , 从而相互学习路由实现pod通信。Node-to-Node Mesh该模式为默认模式 , 在
BGP下 , 集群中的每一个节点的BGP Client都需要和其他所有节点的BGP Client进行通信来交换路由。 但随着节点数量增加 , 连接数会以N^2规模增加 , 给集群网络带来巨大的压力。BGP路由反射器Calico在每一个计算节点利用Linux内核实现了一个高效的vRouter(虚拟路由器) 进行报文转发。每个vRouter通过BGP协议将自身所属节点运行的Pod资源的IP地址信息 , 基于节点上的专用代理程序(Felix) 生成路由规则向整个Calico网络内传播。尽管小规模部署能够直接使用BGP网格模型 , 但随着节点数量(假设为N) 的增加 , 这些连接的数量就会以N2的规模快速增长 , 从而给集群网络带来巨大的压力。因此 , 一般建议大规模的节点网络使用BGP路由反射器进行路由学习 ,BGP的点到点通信也就转为与中心点的单路通信模型。另外 , 出于冗余考虑 , 生产实践中应该部署多个BGP路由反射器。而对于Calico来说 ,BGP客户端程序除了作为客户端使用外 , 也可以配置为路由反射器。Route Reflector: 集中式的路由反射器 ,calico v3.3开始支持 , 当calico BGP客户端将路由从其FIB(Forward Information DataBase, 转发信息库) 通告到Route Reflector时 ,Route Reflector会将这些路由通告给部署集群中的其他节点 ,Route Reflector专门用于管理BGP网络路由规则 , 不会产生pod数据通信。Calico会指定几个节点负责专门跟其他所有节点进行连接并交换路由信息 , 从而学习到全局的路由信息。而其他节点也只需要跟这几个节点进行通信来获取到整个集群的规则信息。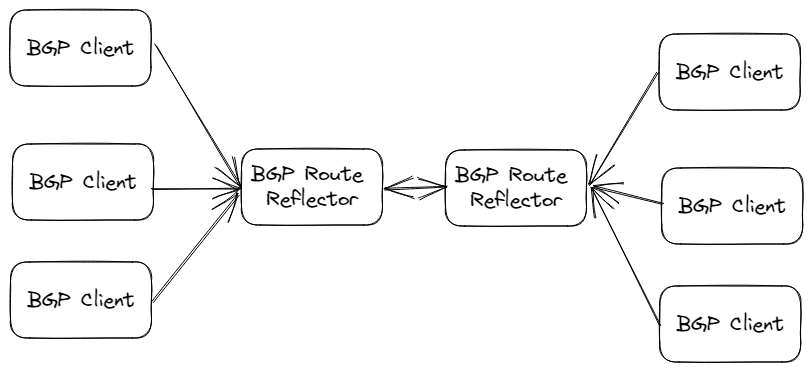
2. Calico网络模式
Calico 一般区分为 Overlay 和 Underlay 两种网络模式。Overlay 是指在物理网络或现有的网络架构之上构建的虚拟网络, 是一种隧道技术。Underlay 是指物理网络或现有的网络链路
Calico Overlay 网络模式
Calico Overlay 模式采用 IPIP 或 VXLAN 协议封装底层网络, 在原始报文中封装一个新的 IP/UDP 报头, 然后通过上层物理覆盖网络通信, 一般也称为 Calico IPIP 或 VXLAN 模式。
Calico 对于 Overlay 网络模式的封装类型(工作模式)有:
IPIP: 使用IPIP(IP-in-IP) 隧道协议封装, 需要开启BGP, 这也是Calico默认的工作模式 ;VXLAN: 使用VXLAN(MAC-in-UDP) 隧道协议封装, 需要关闭BGP;IPIPCrossSubnet: 混合网络模式, 当Node节点跨子网时使用Calico IPIP模式, 同一个子网时使用Calico BGP路由模式;VXLANCrossSubnet: 混合网络模式, 当Node节点跨子网时使用VXLAN模式, 同一个子网时使用Calico BGP路由模式;None: 不使用Calico IPIP或VXLAN工作模式;
Calico BGP 网络模式
将 Node 节点作为虚拟路由器, 通过 BGP 路由协议交换路由信息, 来实现集群内网络工作负载。
数据面
Calico 数据面支持 Iptables 与 eBPF 模式。eBPF 模式除了性能优势外, 原生支持 Kubernetes(不需要 kube-proxy), 不需要设置 spec.externalTrafficPolicy: Local 也可以保留客户端源 IP 地址等特性。
值得注意的是, eBPF 模式下不推荐 Calico Overlay 模式, 因为没有 Overlay 模式的路由效率会更高。如果必须使用 Calico Overlay 模式, 推荐使用 VXLAN, 因为由于内核限制, IPIP 在 eBPF 模式下表现不佳。
两种模式对比
IPIP网络:
流量:
tunl0设备封装数据 , 形成隧道 , 承载流量适用网络类型: 适用于互相访问的
Pod不在同一个网段中 , 跨网段访问的场景 , 外层封装的IP能够解决跨网段的路由问题。效率: 流量需要
tunl0设备封装 , 效率略低
BGP网络:
流量: 使用路由信息导向流量
使用网络类型: 适用于互相访问的
Pod在同一个网段。效率: 原生
hostGW, 效率高
2.1. IPIP隧道模式
从字面上理解 , 就是把一个IP数据包又套在一个IP包里 , 即把IP层封装到IP层的一个Tunnel。它的作用其实基本上就相当于一个基于IP层的网桥。一般来说 , 普通的网桥是基于MAC层的 , 不需要IP , 而这个IP则是通过两端的路由做一个Tunnel , 把两个本来不通的网络通过点对点连接起来。
该模式的解决方式是在物理机A和物理机B之间打一个隧道, 这个隧道有两个端点, 在端点上进行封装, 将容器的IP作为乘客协议放在隧道里面, 而物理主机的IP放在外面作为承载协议。这样不管外层的IP通过传统的物理网络, 走多少跳到达目标物理机, 从隧道两端看起来, 物理机A的下一跳就是物理机B。
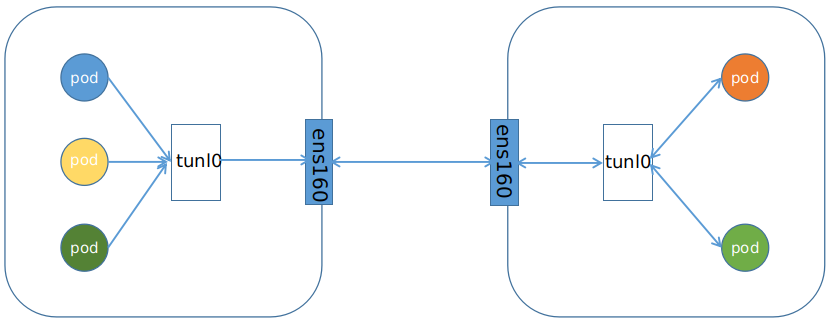
顾名思义 , IPIP网络就是将IP网络封装在IP网络里。IPIP网络的特点是所有pod的数据流量都从隧道tunl0发送 , 并且在tunl0这增加了一层传输层的封包。
从字面来理解 , 就是把一个
IP数据包又套在一个IP包里 , 即把IP层封装到IP层的一个tunnel, 看起来似乎是浪费 , 实则不然。它的作用其实基本上就相当于一个基于
IP层的网桥!一般来说 , 普通的网桥是基于
mac层的 , 根本不需IP, 而这个ipip则是通过两端的路由做一个tunnel, 把两个本来不通的网络通过点对点连接起来。ipip的源代码在内核net/ipv4/ipip.c中可以找到。
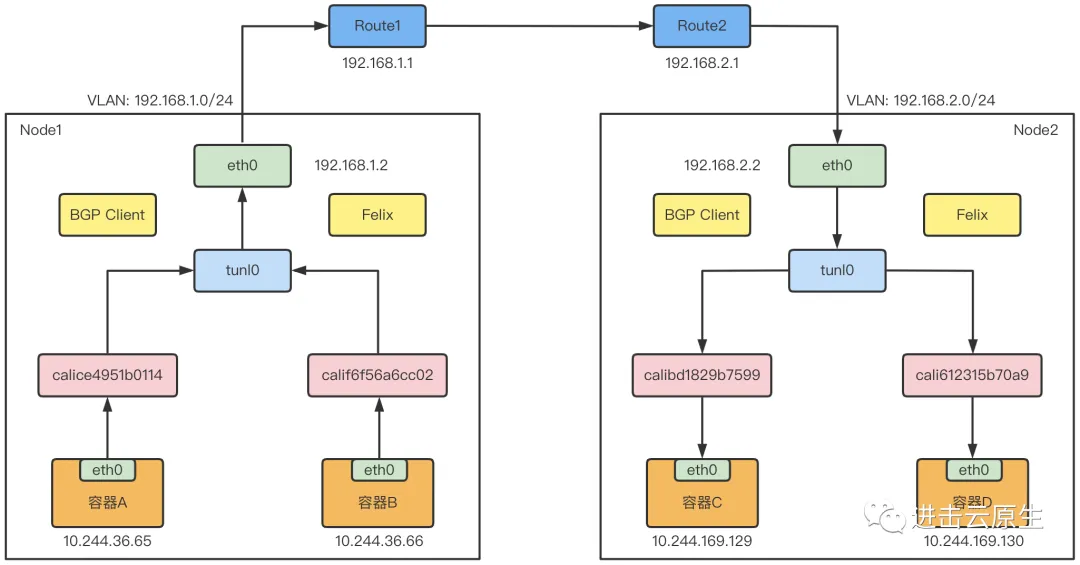
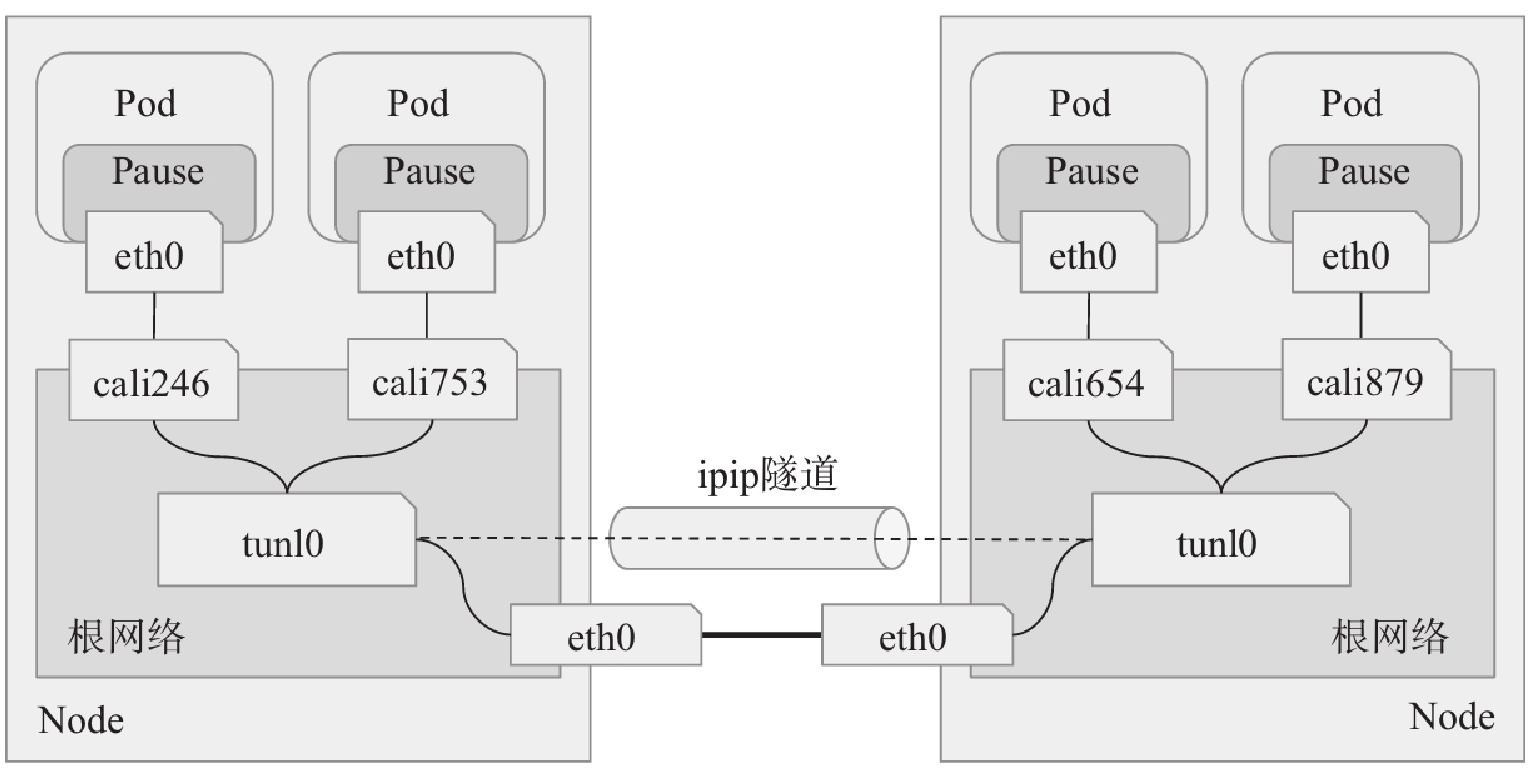
Calico 的 IPIP 模式工作原理如下图:
注 :
Calico使用的这个tunl0设备 , 是一个IP隧道(IP tunnel)设备
在上面的例子中 , IP 包进入 IP 隧道设备之后 , 就会被 Linux 内核的 IPIP 驱动接管。IPIP 驱动会将这个 IP 包直接封装在一个宿主机网络的 IP 包中 , 如下所示:
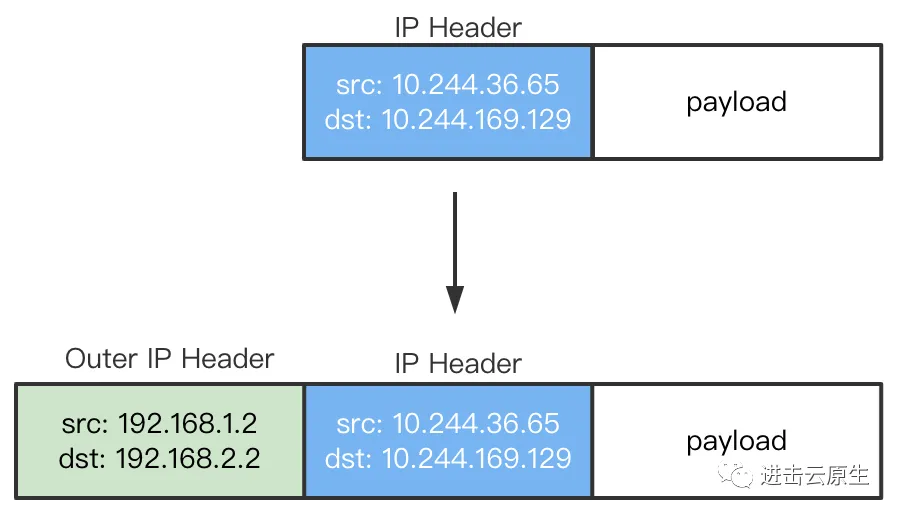
kubenet通过/etc/cni/net.d/目录下的CNI配置文件加载要使用的网络插件完成Pod网络配置 , 为了避免冲突 , 通常不应该也没必要同时 提供多个CNI解决方案。因此 , 在部署Calico之前 , 需要先移除此前使用的Flannel插件 , 最便捷的方式是基于部署清单完成。
~$ kubectl delete -f https://raw.githubusercontent.com/coreos/flannel/master/Documentation/kube-flannel.ymlCalico 3目前仅支持Kubernetes 1.8及其以上版本 , 并且它要求使用一个能够被各组件访问的键值存储系统 , 在Kubernetes环境中 , 可用的选择有etcd v3或Kubernetes API数据存储。本部署示例会把 Kubernetes API作为Calico的数据存储取代etcd , 这也是截至本书写 作时最新稳定版本Calico 3中推荐的配置。若无须改动默认配置 , 则 直接基于在线资源清单创建相关资源即可。但我们这里为了吻合此 Flannel的使用习惯 , 需要自定义设置Pod网络为10.244.0.0/16 , 切分 子网时的掩码长度为24 , 并设置在PodCIDR中为工作负载分配IP地址 , 但在全局流量上默认使用的网络模型是IPIP隧道。下面首先将在线资 源清单下载至本地。
~$ curl https://docs.projectcalico.org/manifests/calico.yaml -O注 : 使用
host-local IPAM插件时 ,Calico的部分功能将变得不可用。例如 , 以节点或名称空间为组 , 分别从不同地址池分配IP地址 等。
而后修改calico.yaml文件。配置完成后 , 使用 如下命令将资源部署到集群之上即可。
~$ kubectl apply -f calico.yaml 该资源清单将Calico的所有资源部署在kube-system名称空间之 中 , 待calico-node与kube-controllers相关的Pod进入就绪状态之后 即可验证和使用相应的网络功能 , 如下面的命令及结果所示。
~$ kubectl get pods -n kube-system -o wide | awk '/^calico (node|kube-controller)/{print}' 工作在IPIP模式的Calico会在每个节点上创建一个tunl0接口作为 隧道出入口来封装IPIP隧道报文。Calico会为每一个Pod资源创建一对 veth设备 , 其中一端作为Pod的网络接口 , 另一端( 名称以cali为前缀 , 后跟随机字串) 留置在节点的根网络名称空间 , 它未使用风格模式 , 因而并未关联成为任何虚拟网桥设备的从接口 , 如图所示。
IPIP隧道网络仍需依赖于BGP维护节点间的可达性。部署完成后 , Calico会通过BGP协议在每个节点上生成到达Kubernetes集群中其他各节点的Pod子网路由信息。下面的路由条件截取自k8s-node01主机 , 它们是由各节点上的BIRD以点对点的方式( node-to-node-mesh) 向网络中的其他节点进行通告并学习其他节点的通告而得。
10.244.0.0/24 via 172.29.9.1 dev tunl0 proto bird onlink
blackhole 10.244.1.0/24 proto bird
10.244.2.0/24 via 172.29.9.12 dev tunl0 proto bird onlink
10.244.3.0/24 via 172.29.9.13 dev tunl0 proto bird onlink对于创建的每个常规Pod资源 , Calico CNI插件需要在节点的根网络名称空间中生成一个专用路由条目 , 用于确保以Pod IP为目标地址的报文能够经由相应的留置在根网络名称空间中的一端设备送达 , 相关的路由条目格式类似如下所示。这是因为Calico没有在节点上为本地的所有Pod资源使用一个虚拟网桥进行报文转发所致。
10.244.1.2 dev cali584bb1c9fa8 scope link  # 到达10.244.1.2的报文经cali584bb1c9fa8接口送达 ;
10.244.1.3 dev cali8747614b74b scope link  #
10.244.1.4 dev cali8a15ed22215 scope link #在集群中部署一些Pod资源即可完成集群网络连接测试。假设在 k8s-node01上存在一个IP地址为10.244.1.3的Pod A , 以及在k8s-node02上存在一个IP地址为10.244.2.2且运行有demoapp应用的Pod B。通过curl命令在Pod A的交互式接口对Pod B发起HTTP请求 , 而后在 k8s-node01的物理接口上抓取通信报文即可分析IPIP隧道报文通信格式 , 相关命令及截取的一次通信的往返结果示例如下。
~# tcpdump -i ens3 -nn ip host 172.29.9.11 and host 172.29.9.12
14:28:30.881146 IP 172.29.9.11 > 172.29.9.12: IP 10.244.1.3.37576
> 10.244.2.2.80: Flags [P.], seq 1:75, ack 1, win 504, options
[nop,nop,TS val 3996121466 ecr 257294088], length 74: HTTP: GET /
HTTP/1.1 (ipip-proto-4)
14:28:30.882290 IP 172.29.9.12 > 172.29.9.11: IP 10.244.2.2.80 >
10.244.1.3.37576: Flags [P.], seq 1:18, ack 75, win 510, options
[nop,nop,TS val 257294089 ecr 3996121466], length 17: HTTP:
HTTP/1.0 200 OK (ipip-proto-4)
命令结果显示出 , 跨节点Pod间通信经由IPIP协议的三层隧道转发 , 外层IP首部中的IP地址为通信双方的节点IP( 172.29.9.11和 172.29.9.12), 内层IP头部为通信双方的Pod IP( 10.244.1.3和 10.244.2.2) 。需要注意的是 , Calico CNI设置的tunl0接口的MTU默认为1440 , 这种设置主要是为适配Google的GCE环境 , 非GCE的物理环 境中 , 其最佳值为1480。部署前 , 修改配置清单中ConfigMap/calico-config资源的veith_mtu键的值为1480即可。
另外 , 对50个节点以上规模的集群来说 , 所有Calico节点基于 Kubernetes API存取数据会给API Server带去不小的通信压力 , 解决办法是使用calico-typha进程将所有Calico的通信集中起来 , 统一与 API Server进行交互。Calico为该应用场景提供了专用的在线配置清单https://docs.projectcalico.org/manifests/calico-typha.yaml , 它主要添加了Deployment/calico-typha和 Service/calico-typha两个资源。需要自定义的话 , 基本评估标准是 每个calico-typha Pod资源可承载100~200个( 上限) Calico Node的连接请求 , 而整个集群中的calico-typha Pod资源总数尽量不要超过 20个。
2.2 BGP
边界网关协议( Border Gateway Protocol, BGP) 是互联网上一个核心的去中心化自治路由协议。它通过维护IP路由表或‘前缀’表来实现自治系统( AS) 之间的可达性 , 属于矢量路由协议。BGP不使用传统的内部网关协议( IGP) 的指标 , 而使用基于路径、网络策略或规则集来决定路由。因此 , 它更适合被称为矢量性协议 , 而不是路由协议。BGP , 通俗的讲就是讲接入到机房的多条线路( 如电信、联通、移动等) 融合为一体 , 实现多线单IP , BGP 机房的优点: 服务器只需要设置一个IP地址 , 最佳访问路由是由网络上的骨干路由器根据路由跳数与其它技术指标来确定的 , 不会占用服务器的任何系统。
BGP是路由器之间的通信协议 , 主要用于AS(AutonomousSystem,自治系统)之间的互联。AS内部有多个BGP speaker, 分为ibgp、ebgp,ebgp与其它AS中的ebgp建立BGP连接。AS内部的BGP speaker通过BGP协议交换路由信息 , 最终每一个BGP speaker拥有整个AS的路由信息
注 : 可以把
calico中的node节点当成一个AS, 而node节点中的容器是AS中的router,calico通过BGP解析 , 将整个网络中容器地址的路由表绘制出来。
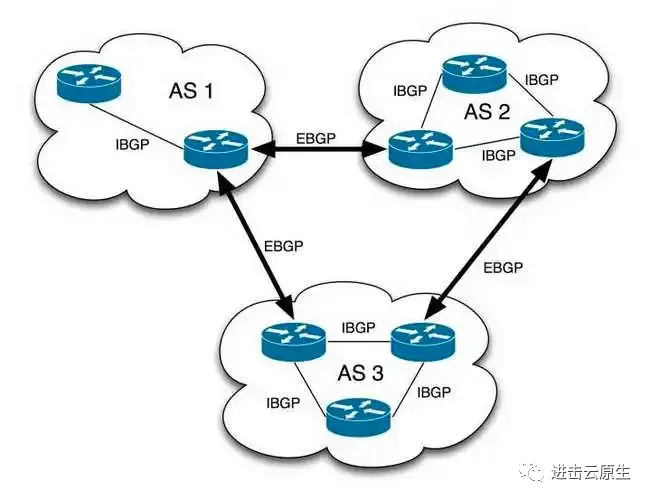
IBGP(Internal BGP) : 当BGP运行于同一自治系统内部时 , 被称为IBGP。EBGP(External BGP) : 当BGP运行于不同自治系统之间时 , 称为EBGP。
BGP 两种模式 :
全互联模式(
node-to-node mesh): 全互联模式 , 每一个BGP Speaker都需要和其他BGP Speaker建立 BGP 连接 , 这样 BGP 连接总数就是 N^2 , 如果数量过大会消耗大量连接。如果集群数量超过100台官方不建议使用此种模式。路由反射模式
Router Reflection(RR) : RR 模式中会指定一个或多个BGP Speaker为RouterReflection, 它与网络中其他Speaker建立连接 , 每个Speaker只要与Router Reflection建立BGP就可以获得全网的路由信息。在calico中可以通过Global Peer实现RR模式。
2.2.1 BGP基础
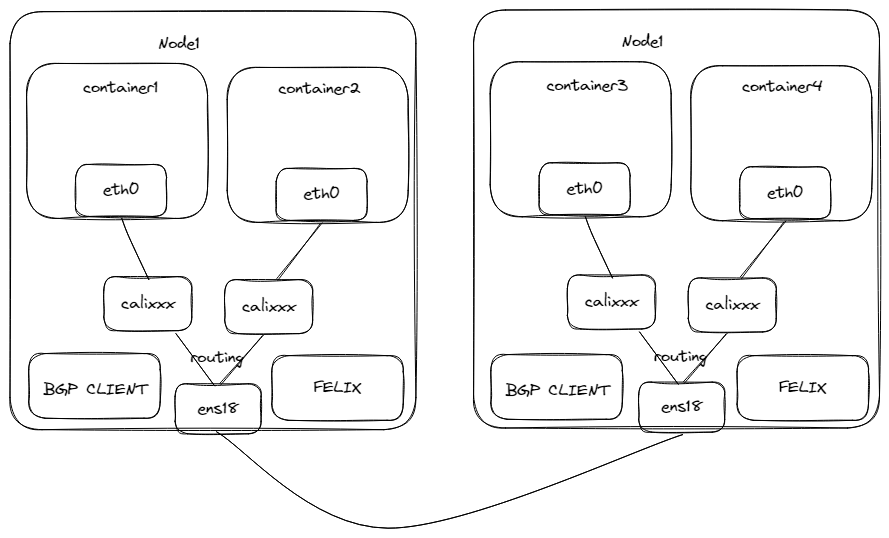
每个容器都会创建一对veth pair网卡 , 一端放在容器内部 , 另一端放在宿主机中 , 容器中发送的IP包通过veth pair网卡可以达到宿主机的网络协议栈中。
Felix会通过监听etcd来获取其他节点的相关信息 , 然后添加本地路由:
通往其他节点容器的
IP包下一条到其节点物理网卡中。通过本机节点容器的
IP包到calixxx网卡中 , 然后进入到容器中。
BGP Client会读取Felix写入到本地的路由 , 再通过进行分发到网络中。
边界网关协议(
Border Gateway Protocol, BGP) 是互联网上一个核心的去中心化自治路由协议。它通过维护
IP路由表或‘前缀’表来实现自治系统(AS) 之间的可达性 , 属于矢量路由协议。BGP不使用传统的内部网关协议(IGP) 的指标 , 而使用基于路径、网络策略或规则集来决定路由。因此 , 它更适合被称为矢量性协议 , 而不是路由协议。BGP, 通俗的讲就是讲接入到机房的多条线路( 如电信、联通、移动等 ) 融合为一体 , 实现多线单IP,BGP机房的优点: 服务器只需要设置一个IP地址 , 最佳访问路由是由网络上的骨干路由器根据路由跳数与其它技术指标来确定的 , 不会占用服务器的任何系统。BGP网络相比较IPIP网络 , 最大的不同之处就是没有了隧道设备tunl0。前面介绍过IPIP网络pod之间的流量发送tunl0, 然后tunl0发送对端设备。BGP网络中 ,pod之间的流量直接从网卡发送目的地 , 减少了tunl0这个环节。
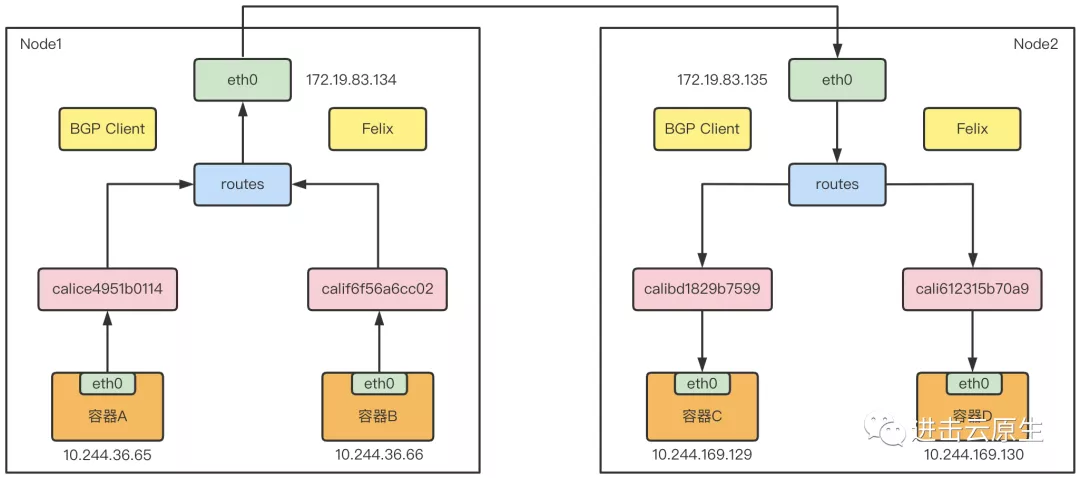
一般来说 , 仅在那些不支持用户自定义BGP配置的网络中才会完全使用IPIP或VXLAN隧道网络 , 对于自主可控且规模较大的网络环境 , 非 常有必要启用BGP降低网络开销以提升传输性能。对于Calico来说 , 修改ipPool属性相应的配置便可调整使用的网络类型。以此前部署的 Calico系统默认使用的地址池default-ipv4-ippool为例 , 获取该资源的配置清单并保存为本地文件 , 修改ipipMode(或vxlanMode) 的属性值为CrossSubnet或Never便能启用直接路由网络。
下面的配置清单示例( default-ipv4-ippool.yaml) 将 spec.ipipMode的属性值从Never修改为CrossSubnet , 表示仅在跨IP网络节点上的Pod间通信才使用IPIP隧道 , 同一网络节点上的Pod间通信则使用路由方式直接进行。
apiVersion: projectcalico.org/v3
kind: IPPool
metadata:
  name: default-ipv4-ippool
spec:
  blockSize: 24
  cidr: 10.244.0.0/16
  ipipMode: CrossSubnet
  natOutgoing: true
  nodeSelector: all()
vxlanMode: Never将上面配置清单的定义使用calicoctl apply命令重新应用到 Calico Datastore上后便可立即生效。显然,这种变动会影响现有的 通信流量 , 不建议在生产环境中随意变动。
~$ calicoctl apply -f default-ipv4-ippool.yaml
Successfully applied 1 'IPPool' resource(s)
随后 , 等BGP信息传播完成后 , 节点将同一网络内其他节点相关的 路由条目经由IPIP模型的tunl0接口传输 , 变为节点上的某物理接口 , 如ens3等。下面的路由信息片段截取自k8s-node01主机之上。
10.244.0.0/24 via 172.29.9.1 dev ens3 proto bird
blackhole 10.244.1.0/24 proto bird
10.244.2.0/24 via 172.29.9.12 dev ens3 proto bird
10.244.3.0/24 via 172.29.9.13 dev ens3 proto bird在集群中部署一些Pod资源即可完成集群网络连接测试。假设在 k8s-node01上存在一个IP地址为10.244.1.3的Pod A , 以及在k8s-node02上存在一个IP地址为10.244.2.2的运行有demoapp应用的Pod B。通过curl命令在Pod A的交互式接口对Pod B发起HTTP请求 , 而后在 k8s-node01的物理接口上抓取通信报文即可分析IPIP隧道报文通信格式 , 相关命令及截取的一次通信的往返结果示例如下 , 它显示出Pod之间直接基于底层网络完成了彼此间的通信。
root@k8s-node01:~# tcpdump -i ens3 -nn tcp port 80
19:22:00.940398 IP 10.244.1.3.41522 > 10.244.2.2.80: Flags [P.], seq 1:75, ack 1, win 504, options [nop,nop,TS val 1533673122 ecr 1404645777], length 74: HTTP: GET / HTTP/1.1
19:22:00.943548 IP 10.244.2.2.80 > 10.244.1.3.41522: Flags [P.], seq 1:18, ack 75, win 510, options [nop,nop,TS val 1404645781 ecr 1533673122], length 17: HTTP: HTTP/1.0 200 OK
默认情况下 , Calico的BGP网络工作在节点网格 ( node-to-node mesh ) 模型下 , 各节点间以对等方式广播路由 , 它仅适用于规模较小 的集群环境。下面命令的结果显示的便是当前节点 ( k8s-master01 ) 要对等广播路由的其他节点 , 各节点打印的结果都会有所不同。随着节点数量的增多 , 这种对等广播的规模和数量将以指数级别上升。
mageedu@k8s-master01:~$ sudo calicoctl node status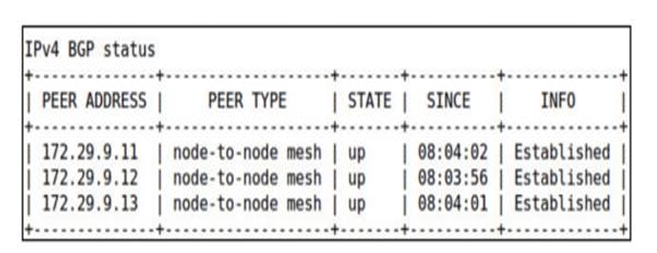
中级集群环境应该使用全局对等BGP ( global BGP peers ) 模型 , 通过在同一个二层网络中使用一个或一组BGP反射器构建BGP网络环境 , 大型集群环境甚至可以使用每节点对等BGP模型 ( per-node BGP peers ) , 即分布式BGP反射器模型。Calico的节点代理calico/node自身就能够充当BGP路由反射器 , 我们可以在Kubernetes集群外部的专用 主机上部署calico/node作为路由反射器 , 也可以在集群中选择专用的几个节点进行配置。
下面我们仅出于测试目的 , 将集群中的k8s-master01部署为集群 中的路由反射器 , 来说明其配置过程。通常来说 , 配置集群节点成为 路由反射器大体有3个步骤: 配置选定的Node作为BGP路由反射器、配置所有节点作为BGP对等节点 ( BGPPeer ) 向路由反射器发送路由信 息 , 以及禁用节点网格。
配置路由反射器
下面的配置清单示例 (
reflector-node.yaml) 定义Calico Node资源对象k8s-master01.ilinux.io成为路由反射器 , 其中的spec.bgp.routeReflectorClusterID字段以IP地址格式的值为BGP路由 器集群提供标识符 , 而特地添加的route-reflector标签则于配置BGPPeer时筛选节点。apiVersion: projectcalico.org/v3 kind: Node metadata: labels: route-reflector: true name: k8s-master01.ilinux.io spec: bgp: ipv4Address: 172.29.9.1/16 ipv4IPIPTunnelAddr: 10.244.0.1 routeReflectorClusterID: 1.1.1.1运行如下命令将配置清单示例中的定义的资源配置应用 ( 打补丁 ) 到
Datastore之上以完成路由反射器的配置。~$ calicoctl apply -f reflector-node.yaml Successfully applied 1 'Node' resource(s)配置
BGP对等节点同一BGP路由器集群中的各节点都需要成为Reflector的BGP对等节点以交换路由信息。k8s-master01.ilinux.io自身同样运行于Pod资源 , 因而它自身同样需样成为Reflector的BGP对等节点。下面的配置 清单示例 (bgppeer-demo.yaml) 定义集群所有节点同符合标签选择器route-reflector=="true"节点 ( 路由反射器 ) 进行“对等”。apiVersion: projectcalico.org/v3 kind: BGPPeer metadata: name: bgppeer-demo spec: nodeSelector: all() peerSelector: route-reflector=="true"基于如下命令将
BGPPeer/bgppeer-demo资源创建到Datastore之上 , 相关的“对等”关系便当即生效。~$ calicoctl apply -f bgppeer-demo.yaml Successfully applied 1 'BGPPeer' resource(s)新的
BGPPeer资源定义了并非Node-to-Node的对等关系 , 因而在路由反射器节点和其他节点所看到的结果相差较大 , 因为路由反射器同集群中的所有节点对等 , 但其他节点仅会同路由反射器节点对等。下面命令运行在路由反射器 (k8s-master01) 之上 , 它已然能够与集群 中的节点建立对等关系 ( 自我对等的关系不会显示在命令结果中 ) 。mageedu@k8s-master01:~ $ sudo calicoctl node status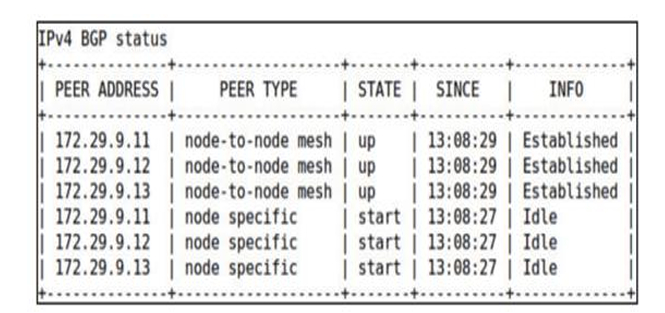
其中 , 输出结果中的
PEER TYPE显示了对等通信的类型 , 常见的值有node-to-node mesh、node specific和global等 ,node specific表示与特定的节点对等 , 而省略node和nodeSelector字段时出现的global则表示全局对等。禁用节点网格
因原有的
Node-to-Node网络的对等关系尚未禁用 , 上面命令的输出结果显示 ,BGP的路由传播仍然以对等网格的方式进行。下面的资源 清单 (default-bgpconfiguration.yaml) 定义的BGPConfiguration/default资源就用于禁用这种BGP网格。apiVersion: projectcalico.org/v3 kind: BGPConfiguration metadata: name: default spec: logSeverityScreen: Info nodeToNodeMeshEnabled: false asNumber: 63400 # BGP对等通信时使用的默认AS号需要特别说明的 , 禁用
BGP网格的配置参数nodeToNodeMeshEnabled, 以及BGP会话中使用的默认AS号码仅能够定义在名为default的全局BGPConfiguration资源中~$ calicoctl apply -f bgpconfiguration-demo.yaml Successfully applied 1 'BGPConfiguration' resource(s)随后 , 由
BGPPeer/bgppeer-demo资源定义的各Calico/Node与BGP路由反射器对等关系便会生效 , 下面的命令仍然是在路由反射器节点之上运行。~$ sudo calicoctl node status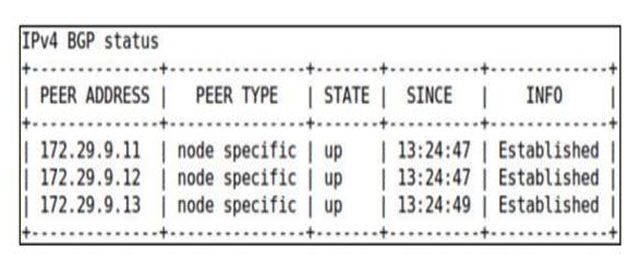
命令结果显示 , 由
BGPPeer/bgppeer-demo资源定义的对等关系已 然生效。我们可人为地关闭一个节点来模拟BGP对等节点故障 , 以验证 其动态路由的管理能力。首先 , 我们关闭k8s-node03.ilinux.io主 机 , 随后在路由反射器节点上重新获取对等节点的状态 , 可看到相应的故障信息。mageedu@k8s-master01:~ $ sudo calicoctl node status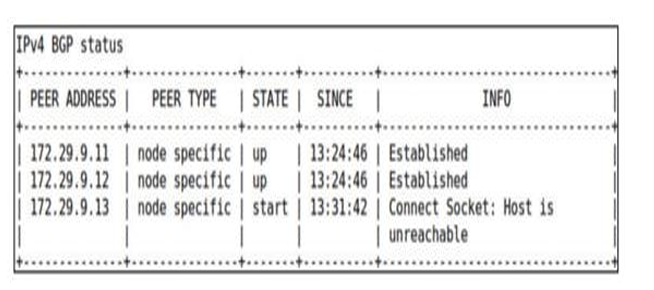
随后 , 我们可以在任意节点上验证与
k8s-node03.ilinux.io相关 的路由条目被移除的结果。若该节点恢复后 , 相关路由条目会重新添加回来 , 则证明BGP路由反射器能够正确工作。考虑到可用性 , 建议在生产环境中配置多个路由反射器节点。
2.2.2 手动模拟BGP模式实验
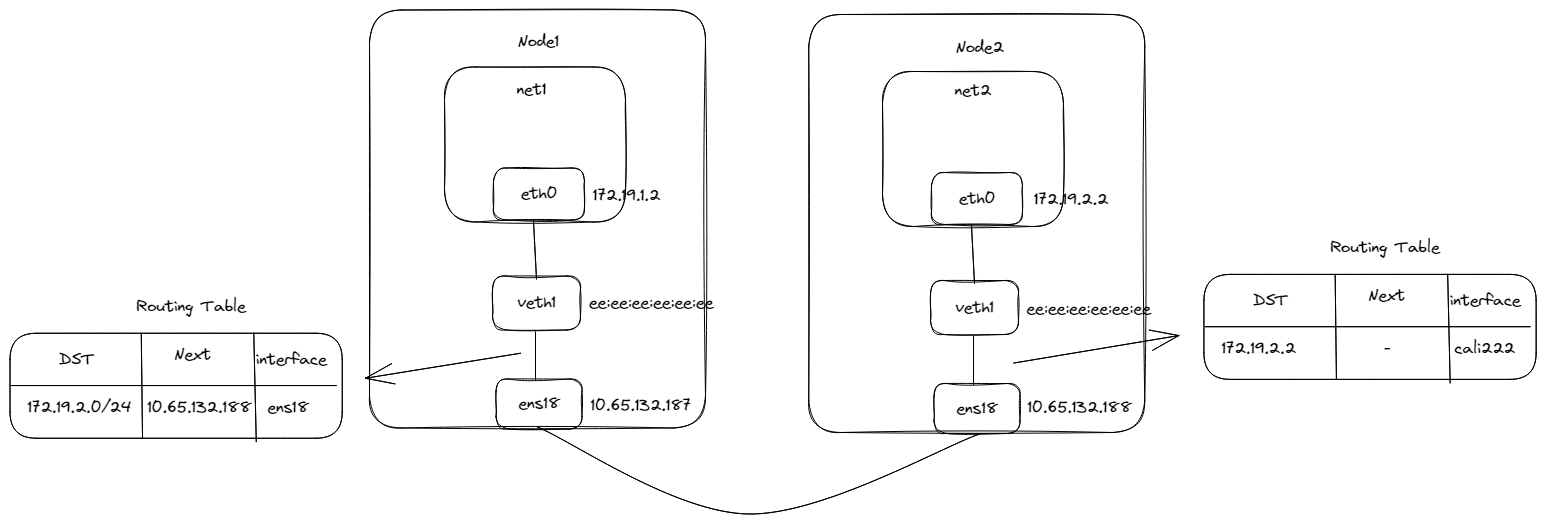
2.2.2.1 操作
首先在Node1中创建Network Namespace命名为net1
ip netns add net1然后创建一对veth pair设备veth0和veth1 , 将veth0放到net1中 , 拉起并设置好ip地址172.19.1.2/24 , veth1也拉取但不用设置IP地址 , 但需要设置默认的MAC地址为ee:ee:ee:ee:ee:ee
ip link add veth0 type veth peer name veth1
ip link set dev veth0 netns net1
ip netns exec net1 ip link set veth0 up
ip netns exec net1 ip addr add 172.19.1.2/24 dev veth0

ip link set dev veth1 up
ip link set dev veth1 address ee:ee:ee:ee:ee:eenet1配置的路由有点意思 , 和一般配置的路由不同 , 所有的报文都需要通过veth0设备发送到下一跳的地址为169.254.1.1 , 而这个地址在整个平台找是不存在的 , 这是一个默认的网关 , 那如何达到该地址呢?
ip netns exec net1 ip r a 169.254.1.1 dev veth0
ip netns exec net1 ip r a default via 169.254.1.1 dev veth0 通过设置veth1设备proxy_arp , 可以对于任何ARP请求到达veth1时 , 都响应自己的Mac地址 , 也就是ee:ee:ee:ee:ee:ee
当访问网关的时候 , 首先是需要进行ARP请求 , 请求通过veth0设备达到了veth1中, 因为设置proxy_arp , 会将自身的mac地址ee:ee:ee:ee:ee:ee作为arp回复。
而容器的后续报文目的IP地址是目的容器的IP地址, 而mac地址变成了网关MAC地址ee:ee:ee:ee:ee:ee , 而网关的IP地址并不会出现在任何的数据包中 , 也没人关心这个具体的地址是什么 , 只要能找到arp就行。
echo 1 > /proc/sys/net/ipv4/conf/veth1/proxy_arp数据包已经从net1中通过veth1作为网关达到宿主机的网络协议栈中 , 再通过设置宿主机路由表 , 将目的地址为Node2容器网段的数据包通过Node2 ens18网卡地址作为下一跳地址。
ip r add 172.19.2.0/24 via 10.65.132.188 dev ens18目的地址为Node1的net1时 , 需要配置通过路由表到达veth1网卡 , 然后再进入到net1中。
ip r add 172.19.1.2 dev veth1再在Node2中重复Node1的操作创建Network Namespace net2 , 并初始化网络配置。
ip netns add net2
ip link add veth0 type veth peer name veth1
ip link set dev veth0 netns net2
ip netns exec net2 ip addr add 172.19.2.2/24 dev veth0
ip netns exec net2 ip link set veth0 up

ip link set dev veth1 up
ip link set dev veth1 address ee:ee:ee:ee:ee:ee

ip netns exec net2 ip r a 169.254.1.1 dev veth0
ip netns exec net2 ip r a default via 169.254.1.1 dev veth0
ip r add 172.19.1.0/24 via 10.65.132.187 dev ens18
ip r add 172.19.2.2/32 dev veth1
2.2.2.2 分析
在Node1 net1中ping Node2 net2 , 然后使用tcpdump监听Node1的veth1 , 结果如下 :
# tcpdump -i veth1 -ne
dropped privs to tcpdump
tcpdump: verbose output suppressed, use -v or -vv for full protocol decode
listening on veth1, link-type EN10MB (Ethernet), capture size 262144 bytes
10:38:29.713322 02:1c:9c:83:87:f2 > Broadcast, ethertype ARP (0x0806), length 42: Request who-has 169.254.1.1 tell 172.19.1.2, length 28
10:38:30.205862 ee:ee:ee:ee:ee:ee > 02:1c:9c:83:87:f2, ethertype ARP (0x0806), length 42: Reply 169.254.1.1 is-at ee:ee:ee:ee:ee:ee, length 28
10:38:30.205922 02:1c:9c:83:87:f2 > ee:ee:ee:ee:ee:ee, ethertype IPv4 (0x0800), length 98: 172.19.1.2 > 172.19.2.2: ICMP echo request, id 37475, seq 1, length 64
10:38:30.206393 ee:ee:ee:ee:ee:ee > 02:1c:9c:83:87:f2, ethertype IPv4 (0x0800), length 98: 172.19.2.2 > 172.19.1.2: ICMP echo reply, id 37475, seq 1, length 64
可以看到 , 先是发送arp请求获取172.19.1.2的mac地址 , 因为设置了proxy_arp , 所以会将自身的Mac地址进行回复 , 在后面的ICMP包中 , 目的IP地址为目的容器IP地址172.19.2.2 , 而目的Mac地址为veth1的Mac地址ee:ee:ee:ee:ee:ee
再使用tcpdump监听Node2的ens18网卡 , 结果如下:
# tcpdump -i ens18 host 172.19.2.2 -en
dropped privs to tcpdump
tcpdump: verbose output suppressed, use -v or -vv for full protocol decode
listening on ens18, link-type EN10MB (Ethernet), capture size 262144 bytes
10:52:43.993140 fa:16:3e:d3:f6:3a > fa:16:3e:b1:9a:65, ethertype IPv4 (0x0800), length 98: 172.19.1.2 > 172.19.2.2: ICMP echo request, id 4349, seq 1, length 64
10:52:43.993291 fa:16:3e:b1:9a:65 > fa:16:3e:d3:f6:3a, ethertype IPv4 (0x0800), length 98: 172.19.2.2 > 172.19.1.2: ICMP echo reply, id 4349, seq 1, length 64数据包从Node1中到达了Node2 ens18网卡 , 源IP和目的IP分别为net1和net2的IP地址 , 而mac地址是Node1和Node2的物理网卡ens18 Mac地址.
使用tcpdump监听veth1网卡 , 结果如下:
# tcpdump -i veth1 -en
dropped privs to tcpdump
tcpdump: verbose output suppressed, use -v or -vv for full protocol decode
listening on veth1, link-type EN10MB (Ethernet), capture size 262144 bytes
10:58:13.780247 ee:ee:ee:ee:ee:ee > fa:63:d4:dc:25:01, ethertype IPv4 (0x0800), length 98: 172.19.1.2 > 172.19.2.2: ICMP echo request, id 41971, seq 1, length 64
10:58:13.780288 fa:63:d4:dc:25:01 > ee:ee:ee:ee:ee:ee, ethertype IPv4 (0x0800), length 98: 172.19.2.2 > 172.19.1.2: ICMP echo reply, id 41971, seq 1, length 64查看Node2的路由
# ip r
...
172.19.2.2 dev veth1 scope link
...数据包达到Node2 ens18网卡后 , 解开mac头 , 到达网络协议栈中 , 通过路由 , 将目的地址为172.19.2.2的数据包都进入到veth1网卡中 , 最终进入到net2中
3. Calico配置基础
与Kubernetes集群整合时 , Calico需要配置calico-node和 calico-kube-controllers两个重要组件 , 各组件通 过Datastore读取与自身相关的资源定义完成配置。
calico/node:Calico在Kubernetes集群每个节点运行的节点代理, 负责提供felix、bird4、bird6和confd等守护进程。calico/kube-controllers:Calico运行在Kubernetes之上的自定义控制器, 也是Calico协同Kubernetes的插件。
Calico有两种部署方式 : 一种是让calico/node独立运行在 Kubernetes集群之外, 但calico/kube-controllers依然需要以Pod资源形式运行在集群之上 ; 另一种是以CNI插件方式配置Calico, 使 Calico完全托管运行在Kubernetes集群之上, 类似于前面曾经部署托管Flannel网络插件的方式。对于后一种方式, Calico提供了在线的部署清单, 它分别为50节点及以下规模和50节点以上规模的Kubernetes 集群使用Kubernetes API作为Dabastore提供了不同的配置清单, 也为 使用独立的etcd集群提供了专用配置清单。但这3种类型的配置清单中, Calico默认启用的是基于IPIP隧道的Overlay网络, 因而它会在所有流量上使用IPIP隧道而不是BGP路由。以下配置定义在部署清单中 DaemonSet/calico-node资源的Pod模板中的calico-node容器之上。
# 设置在IPv4类型的地址池上启用的IP-IP及其类型 , 支持3种可用值
# Always( 全局流量) 、Cross-SubNet( 跨子网流量) 和Never
- name: CALICO_IPV4POOL_IPIP
  value: "Always"
# 是否在IPV4地址池上启用VXLAN隧道协议 , 取值及意义与Flannel的VXLAN后端相
同 ,
# 但在全局流量启用VXLAN时将完全不再需要BGP网络 , 建议将相关的组件禁用
- name: CALICO_IPV4POOL_VXLAN
value: "Never我们可以将环境变量CALICO_IPV4POOL_IPIP的值设置为Cross SubNet(不区分大小写)来启用混合网络模型 , 它将启用BGP路由网络 , 且仅会在跨节点子网的流量间启用隧道封装。想要启用VXLAN隧道 , 只需要把环境变量CALICO_IPV4POOL_VXLAN的值设置为Always或 Cross-SubNet即可 , 但在全局流量上使用VXLAN隧道时建议将 ConfigMap/calico-node中calico-backend键的值设置为vxlan以禁用 BIRD , 并在DaemonSet/calico-node资源的Pod模型中禁用calico-node 容器的存活探针和就绪探针对bird的检测 , 相关的配置要点如下所示。
livenessProbe:
  exec:
    command:
    - /bin/calico-node
    - -felix-live
    # - -bird-live
  readinessProbe:
    exec:
    command:
    - /bin/calico-node
    # - -bird-ready
    - -felix-ready
需要注意的是 , Calico分配的地址池需要与Kubernetes集群的Pod 网络的定义保持一致。Pod网络通常由kubeadm init初始化集群时使用--pod-network-cidr选项指定的 , 而Calico在其默认的配置清单中默认使用192.168.0.0/16作为Pod网络 , 因而部署Kubernetes集群时应 该规划好要使用的网络地址 , 并设定此二者相匹配。对使用了Flannel 的10.244.0.0/16网络环境而言 , 可以修改资源清单中的定义 , 从而将其修改为其他网络地址。以下配置片段取自Calico的部署清单 , 它定义在DaemonSet/calico-node资源的Pod模板中的calico-node容器之上。
# IPV4地址池的定义 , value值需要与kube-controller-manager的--cluster-network
# 选项的值保持一致 , 以下环境变量默认处于注释状态
- name: CALICO_IPV4POOL_CIDR
  value: "192.168.0.0/16"
# Calico默认以26位子网掩码切分地址池并将各子网配置给集群中的节点 , 若需要
使用其他
# 的掩码长度 , 则需要定义如下环境变量
- name: CALICO_IPV4POOL_BLOCK_SIZE
  value: "24"
# Calico默认并不会从Node.Spec.PodCIDR中分配地址 , 但可通过将如下变量
# 设置为true并结合host-local这一IPAM插件来强制从PodCIDR中分配地址
- name: USE_POD_CIDR
  value: "false"
不过 , 目前版本的Calico已经能够自动检测由kubeadm部署的 Kubernetes集群中的Pod网络 , 并自动将类似上面配置清单中 CALICO_IPV4POOL_CIDR和CALICO_IPV4POOL_BLOCK_SIZE环境变量的值适配到该Pod网络 , 但其他方式部署的Kubernetes集群仍需管理员自行核验这种适配机制是否能得以满足。
在地址分配方面 , Calico在JSON格式的CNI插件配置文件中使用专有的calico-ipam插件 , 该插件并不会使用Node.Spec.PodCIDR中定义 的子网作为节点本地为Pod分配地址的地址池 , 而是根据Calico插件为各节点配置的地址池进行地址分配。若期望为节点真正使用地址池 , 吻合PodCIDR的定义 , 则需要将部署清单中DaemonSet/calico-node资源的Pod模板的calico-node容器的USE_POD_CIDR环境变量值设置为 true , 并修改ConfigMap/calico-config资源中cni_network_config键的plugins.ipam.type值为host-local , 且使用podCIDR为子网 , 具体配置如下所示。
"ipam": {
    "type": "host-local",
    "subnet": "usePodCidr"
},
3.1 calico安装方式
3.1.1 通过 helm 安装 Calico
官方文档: https://projectcalico.docs.tigera.io/getting-started/kubernetes/helm
# 添加源
helm repo add projectcalico https://projectcalico.docs.tigera.io/charts

# helm repo update

# 下载
helm pull  projectcalico/tigera-operator --version v3.24.5
# 解压
tar -xf tigera-operator-v3.24.5.tgz

# 安装, 默认命名空间: calico-system
helm install calico ./tigera-operator  --namespace tigera-operator --create-namespace

# 检查tigera-operator所有资源
kubectl get all -n tigera-operator
3.1.2 通过 yaml 文件安装
wget https://docs.projectcalico.org/manifests/calico.yaml
kubectl apply -f calico.yaml

# 查看
kubectl get all -n kube-system|grep calico
3.1.3 k8s flannel 网络切换 calico
3.1.3.1 卸载 flannel 插件
### 1、查看已安装flannel信息
cat /etc/cni/net.d/10-flannel.conflist

### 2、删除flannel布署资源
kubectl delete -f kube-flannel.yml

### 3、清除flannel遗留信息, 在集群各节点清理flannel网络的残留文件
ifconfig cni0 down
ip link delete cni0
ifconfig flannel.1 down
ip link delete flannel.1
rm -rf /var/lib/cni
rm -rf /etc/cni/net.d
3.1.3.2 开始安装 Calico 插件
# 下载
wget https://docs.projectcalico.org/manifests/calico.yaml

# 安装
kubectl apply -f calico.yaml

# 查看
kubectl get all -n kube-system|grep calico

# 如果节点NotReady, 重启以下容器或者kubelet试试
systemctl restart containerd docker
3.2 calico安装流程
3.2.1 BGP
3.2.1.1 部署calico
官网主要给出了两种部署方式,分别是通过Calico operator和Calico manifests来进行部署和管理calico,operator是通过deployment的方式部署一个calico的operator到集群中,再用其来管理calico的安装升级等生命周期操作。manifests则是将相关都使用yaml的配置文件进行管理,这种方式管理起来相对前者比较麻烦,但是对于高度自定义的K8S集群有一定的优势。
这里我们使用operator的方式进行部署。
首先我们把需要用到的两个部署文件下载到本地。
curl https://raw.githubusercontent.com/projectcalico/calico/v3.24.5/manifests/tigera-operator.yaml -O
curl https://raw.githubusercontent.com/projectcalico/calico/v3.24.5/manifests/custom-resources.yaml -O随后我们修改custom-resources.yaml里面的pod ip段信息和划分子网的大小。
# cat custom-resources.yaml
# This section includes base Calico installation configuration.
# For more information, see: https://projectcalico.docs.tigera.io/master/reference/installation/api#operator.tigera.io/v1.Installation
apiVersion: operator.tigera.io/v1
kind: Installation
metadata:
  name: default
spec:
  # Configures Calico networking.
  calicoNetwork:
    # Note: The ipPools section cannot be modified post-install.
    ipPools:
    - blockSize: 24
      cidr: 10.33.0.0/17
      encapsulation: VXLANCrossSubnet
      natOutgoing: Enabled
      nodeSelector: all()

---

# This section configures the Calico API server.
# For more information, see: https://projectcalico.docs.tigera.io/master/reference/installation/api#operator.tigera.io/v1.APIServer
apiVersion: operator.tigera.io/v1
kind: APIServer
metadata:
  name: default
spec: {}
最后我们直接部署
kubectl create -f tigera-operator.yaml
kubectl create -f custom-resources.yaml此时部署完成之后我们应该可以看到所有的pod和node都已经处于正常工作状态。接下来我们进入高级配置阶段
3.2.1.2 BGP
一般来说,calico的BGP拓扑可以分为三种配置:
Full-mesh( 全网状连接) :启用BGP后,Calico的默认行为是创建内部BGP(iBGP) 连接的全网状连接,其中每个节点相互对等。这允许Calico在任何L2网络上运行,无论是公共云还是私有云,或者是配置了基于IPIP的overlays网络。Calico 不将 BGP 用于 VXLAN overlays网络。全网状结构非常适合100个或更少节点的中小型部署,但在规模明显更大的情况下,全网状结构的效率会降低,calico建议使用路由反射器(Route reflectors) 。Route reflectors( 路由反射器) :要构建大型内部
BGP(iBGP) 集群,可以使用BGP 路由反射器来减少每个节点上使用的BGP对等体的数量。在这个模型中,一些节点充当路由反射器,并被配置为在它们之间建立一个完整的网格。然后将其他节点配置为与这些路由反射器的子集对等( 通常为2个用于冗余) ,与全网状相比减少了 BGP 对等连接的总数。Top of Rack (ToR):在本地部署中,我们可以直接让
calico和物理网络基础设施建立BGP连接,一般来说这需要先把calico默认自带的Full-mesh配置禁用掉,然后将calico和本地的L3 ToR路由建立连接。当整个自建集群的规模很大的时候( 通常仅当每个L2域中的节点数大于100时) ,还可以考虑在每个机架内使用BGP的路由反射器(Route reflectors) 。要深入了解常见的本地部署模型,请参阅Calico over IP Fabrics。
我们这里只是一个小规模的测试集群( 6节点) ,暂时用不上路由反射器这类复杂的配置,因此我们参考第三种TOR的模式,让node直接和我们测试网络内的L3路由器建立BGP连接即可。
在刚初始化的情况下,我们的calico是还没有创建BGPConfiguration,此时我们需要先手动创建,并且禁用nodeToNodeMesh配置,同时还需要借助calico将集群的ClusterIP和ExternalIP都发布出去。
$ cat calico-bgp-configuration.yaml
apiVersion: projectcalico.org/v3
kind: BGPConfiguration
metadata:
  name: default
spec:
  logSeverityScreen: Info
  nodeToNodeMeshEnabled: false
  asNumber: 64517
  serviceClusterIPs:
  - cidr: 10.33.128.0/18
  serviceExternalIPs:
  - cidr: 10.33.192.0/18
  listenPort: 179
  bindMode: NodeIP
  communities:
  - name: bgp-large-community
    value: 64517:300:100
  prefixAdvertisements:
  - cidr: 10.33.0.0/17
    communities:
    - bgp-large-community
    - 64517:120
另一个就是需要准备BGPPeer的配置,可以同时配置一个或者多个,下面的示例配置了两个BGPPeer,并且ASN号各不相同。其中keepOriginalNextHop默认是不配置的,这里特别配置为true,确保通过BGP宣发pod IP段路由的时候只宣发对应的node,而不是针对podIP也开启ECMP功能。详细的配置可以参考官方文档
$ cat calico-bgp-peer.yaml
apiVersion: projectcalico.org/v3
kind: BGPPeer
metadata:
  name: openwrt-peer
spec:
  peerIP: 10.31.254.253
  keepOriginalNextHop: true
  asNumber: 64512
---
apiVersion: projectcalico.org/v3
kind: BGPPeer
metadata:
  name: tiny-unraid-peer
spec:
  peerIP: 10.31.100.100
  keepOriginalNextHop: true
  asNumber: 64516
配置完成之后我们直接部署即可,这时候集群默认的node-to-node-mesh就已经被我们禁用,此外还可以看到我们配置的两个BGPPeer已经顺利建立连接并发布路由了。
$ kubectl create -f calico-bgp-configuration.yaml
$ kubectl create -f calico-bgp-peer.yaml


$ calicoctl node status
Calico process is running.

IPv4 BGP status
+---------------+-----------+-------+----------+-------------+
| PEER ADDRESS  | PEER TYPE | STATE |  SINCE   |    INFO     |
+---------------+-----------+-------+----------+-------------+
| 10.31.254.253 | global    | up    | 08:03:49 | Established |
| 10.31.100.100 | global    | up    | 08:12:01 | Established |
+---------------+-----------+-------+----------+-------------+

IPv6 BGP status
No IPv6 peers found.
3.2.2 IPIP
3.2.2.1 安装流程
挂载 BPF 文件系统 , Ubuntu 默认挂载
root@dev-k8s-01:~# mount | grep /sys/fs/bpf
none on /sys/fs/bpf type bpf (rw,nosuid,nodev,noexec,relatime,mode=700)
如果您的操作系统没有挂载 , 可以使用 systemd 的方式挂载
cat <<EOF | tee /etc/systemd/system/sys-fs-bpf.mount
[Unit]
Description=Calico BPF mounts
DefaultDependencies=no
Before=local-fs.target umount.target

[Mount]
What=bpffs
Where=/sys/fs/bpf
Type=bpf
Options=rw,nosuid,nodev,noexec,relatime,mode=700

[Install]
WantedBy=multi-user.target
EOF

systemctl daemon-reload
systemctl enable sys-fs-bpf.mount
在 eBPF 模式下 , Calico 会替换 kube-proxy , 两者同时运行会浪费资源并降低性能 , 所以需要关闭 kube-proxy。
关闭正在运行集群的 kube-proxy (以 kubeadm 为例)
kubectl patch ds -n kube-system kube-proxy -p '{"spec":{"template":{"spec":{"nodeSelector":{"non-calico": "true"}}}}}' 如果是新创建的集群 (以 kubeadm 为例)
kubeadm init --skip-phases=addon/kube-proxy
# 配置文件的方式
cat <<EOF | tee kubeadm.conf
---
apiVersion: kubeadm.k8s.io/v1beta3
kind: InitConfiguration
skipPhases:
  - addon/kube-proxy
---
EOF

kubeadm init --config kubeadm.conf
禁用 kube-proxy 后 , Calico 无法与 kube-apiserver 通信 , 需要创建直接通信的配置
cat <<EOF | tee kubernetes-services-endpoint.yaml
kind: ConfigMap
apiVersion: v1
metadata:
  name: kubernetes-services-endpoint
  namespace: tigera-operator
data:
  KUBERNETES_SERVICE_HOST: "172.31.6.176"
  KUBERNETES_SERVICE_PORT: "6443"
EOF

kubectl create ns tigera-operator
kubectl create -f kubernetes-services-endpoint.yaml
安装 Operator
kubectl create -f https://raw.githubusercontent.com/projectcalico/calico/v3.24.0/manifests/tigeraoperator.yaml 部署 IPIP 网络模式 , 并开启 eBPF 数据面
cat <<EOF | tee ipip.yaml
# This section includes base Calico installation configuration.
# For more information, see: https://projectcalico.docs.tigera.io/master/reference/installation/api#operator.tigera.io/v1.Installation
apiVersion: operator.tigera.io/v1
kind: Installation
metadata:
  name: default
spec:
  # Configures Calico networking.
  calicoNetwork:
    linuxDataplane: BPF # Iptables, BPF
    bgp: Enabled
    hostPorts: Disabled # is not supported with the eBPF dataplane
    # Note: The ipPools section cannot be modified post-install.
    ipPools:
    - blockSize: 26
      cidr: 192.168.0.0/16
      encapsulation: IPIP
      natOutgoing: Enabled
      nodeSelector: all()
---
# This section configures the Calico API server.
# For more information, see: https://projectcalico.docs.tigera.io/master/reference/installation/api#operator.tigera.io/v1.APIServer
apiVersion: operator.tigera.io/v1
kind: APIServer
metadata:
  name: default
spec: {}
EOF

kubectl create -f ipip.yaml
3.2.2.2 Calico 路由信息
如果前面一切正常 , 我们可以使用 calicoctl 获取到 calico node 的状态
root@dev-k8s-01:~# calicoctl node status
Calico process is running.

IPv4 BGP status
+--------------+-------------------+-------+----------+-------------+
| PEER ADDRESS |     PEER TYPE     | STATE |  SINCE   |    INFO     |
+--------------+-------------------+-------+----------+-------------+
| 172.31.6.174 | node-to-node mesh | up    | 02:21:33 | Established |
| 172.31.6.175 | node-to-node mesh | up    | 02:21:33 | Established |
| 172.31.6.177 | node-to-node mesh | up    | 02:21:32 | Established |
+--------------+-------------------+-------+----------+-------------+

IPv6 BGP status
No IPv6 peers found.
IPIP 模式会默认创建一个名 tunl0 的虚拟网卡接口
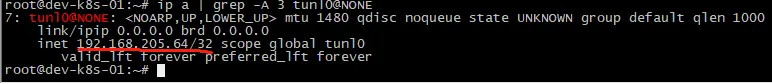
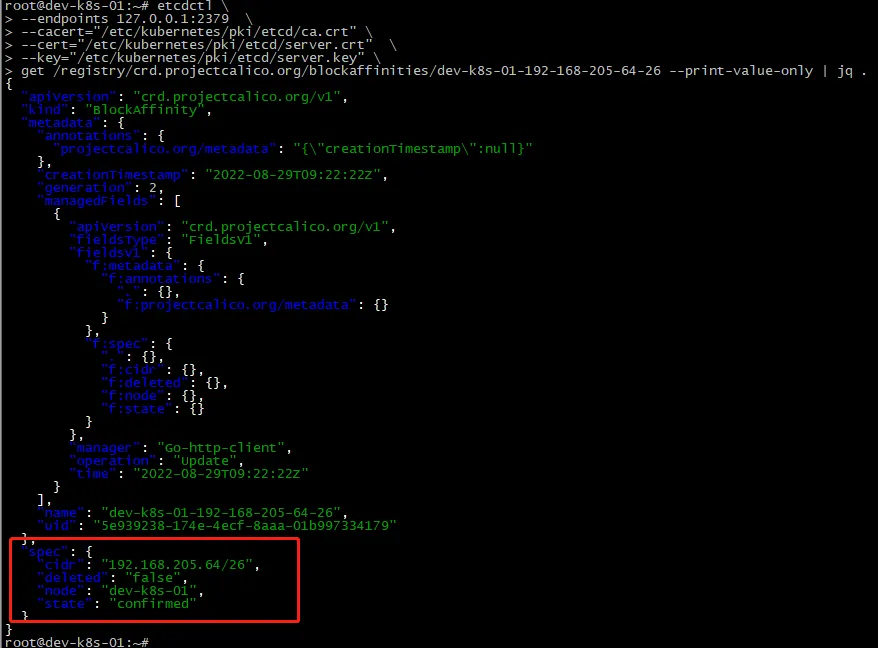
运行 Calico Node 的 Kubernetes Node 节点都将获得一个 /26 子网 , 这是 Kubernetes 网络的标准模型。即便使用了 Kubernetes API 存储 , 本质上 Calico 的数据还是在 ETCD 中 , 我们可以通过查看 etcd 来验证这一点
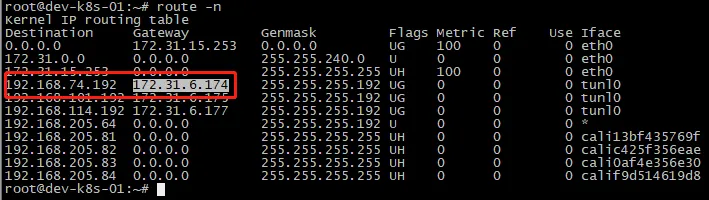
列出当前 Node 节点的路由表 , 可以发现有一条很特别的 blackhole 路由。
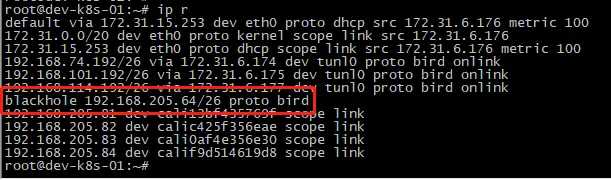
这条路由表示发往 192.168.205.64/26 网段的报文都会被丢弃且不会回复源端 , 至于这条配置这规则的原因是:
当有 2 个 pod 正在相互发送数据 , 当其中一个 pod 被删除时 , veth (虚拟网卡接口)和相关的规则也会被删除 , 但另一个 pod 并不知道而且仍然向这个不存在的 IP 地址发送数据 , 那么当 Node 节点收到一个目的 IP 已经不存在的数据包该怎么办呢?它会根据最佳匹配规则发送 , 通常我们不希望这样。当 pod 的规则删除后 , 按照最佳匹配原则会匹配到这条blackhole 黑洞规则 , 所以这条规则的存在 , 是为了丢弃这些数据包。
回到 Node 节点路由表 , 可以看到一些以 cali 开头的 veth
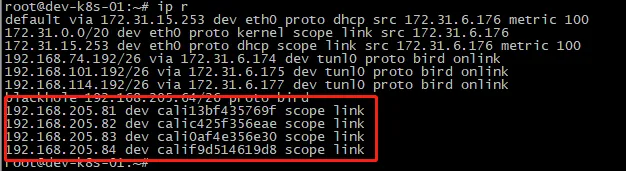
以 calif9d514619d8 为例 , 这条路由将目的地址为 192.168.205.84 的请求导向 calif9d514619d8 veth , 进而让请求指向到容器。

从这里我们也可以知道 , 当一个新的 pod 启动时 , Calico node 查询 kube-apiserver 以确定 pod 是否存在并且运行在自己的节点上 , 然后从其 IPAM 中为 pod 分配一个 IP , 并在主机上创建一个 veth 接口。
再次回到 Node 节点路由表 , 还可以看到一些 onlink 的路由
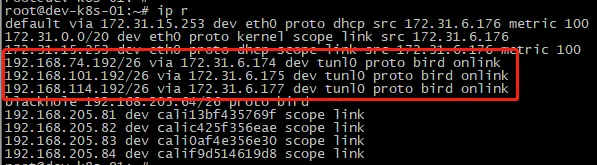
比如 192.168.74.192/26 的网络可以通过 172.31.6.174 到达 , 发送到 192.168.74.192/26 的数据包将被路由到 172.31.6.174 , 172.31.6.174 是另一端 Node 节点的 IP 。可以理解成 IPIP 隧道的另一端网关。
Calico 的 eBPF 模式提供链路跟踪等可观测功能 , 也可以查看到 bpf 的路由信息。
root@dev-k8s-01:~# kubectl exec -n calico-system -c calico-node calico-node-nlzl5 -- calico-node -bpf routes dump
172.31.6.174/32: remote host
172.31.6.175/32: remote host
172.31.6.176/32: local host
172.31.6.177/32: remote host
 192.168.0.0/16: remote in-pool nat-out
192.168.74.192/26: remote workload in-pool nat-out tunneled nh 172.31.6.174
192.168.101.192/26: remote workload in-pool nat-out tunneled nh 172.31.6.175
192.168.114.192/26: remote workload in-pool nat-out tunneled nh 172.31.6.177
192.168.205.64/32: local host
192.168.205.81/32: local workload in-pool nat-out idx 3
192.168.205.82/32: local workload in-pool nat-out idx 4
192.168.205.83/32: local workload in-pool nat-out idx 5
192.168.205.84/32: local workload in-pool nat-out idx 6
3.2.2.3 Calico IPIP 模式
现在我们来看看 Calico IPIP 模式下 , 容器之间跨节点是如何通信的。以 nginx 为例。

网络链路示例
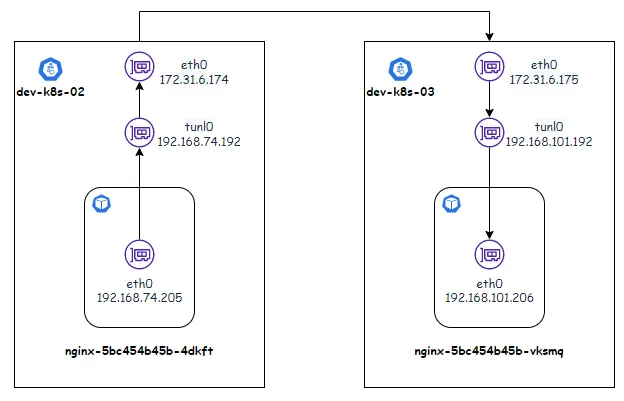
在
nginx-5bc454b45b-4dkft通过curl ip请求nginx-5bc454b45b-vksmq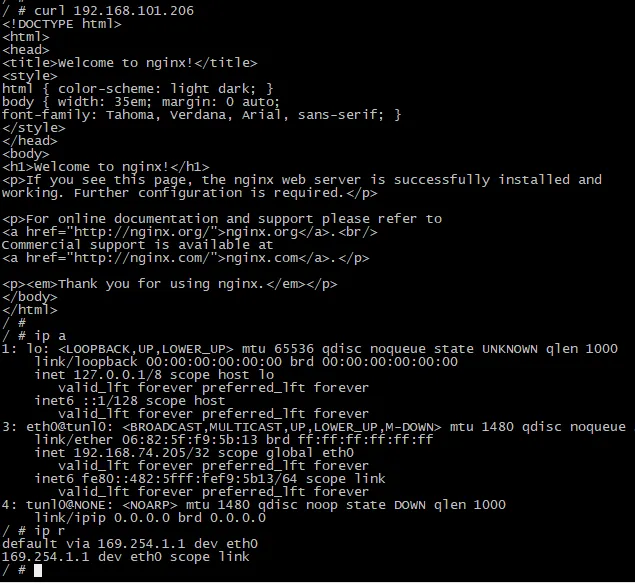
容器中只有
eth0网卡 , 请求是通过容器的eth0发出 , 所以报文的源IP是192.168.74.205, 目的IP是192.168.101.206容器网卡对于的是宿主机的
veth网卡 , 容器里网卡发的数据包 , 由veth网卡发出。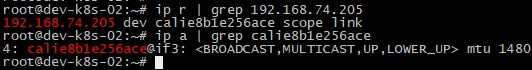
现在网络报文就在宿主机的网络中 , 受宿主机的这个条路由影响 , 报文从
tunl0发出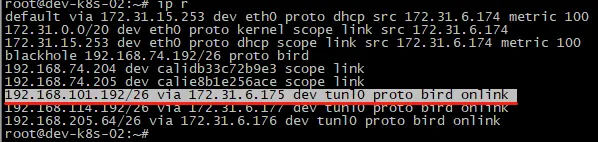
这时
tunl0会对报文进行封装 , 在原始报文中封装一个新的IP报头 , 新的IP报头源IP是宿主机的IP(172.31.6.174) , 目的IP是从上图路由识别的对端宿主机IP(172.31.6.175) , 而且封装后的报文带有IPIP协议的ipip-proto-4标记。请求从宿主机的
eth0(172.31.6.174) 网卡发出。对端宿主机的
eth0(172.31.6.175) 网卡接收报文后 , 对带有IPIP协议的标志报文进行解封装 , 然后得到真实的报文 ;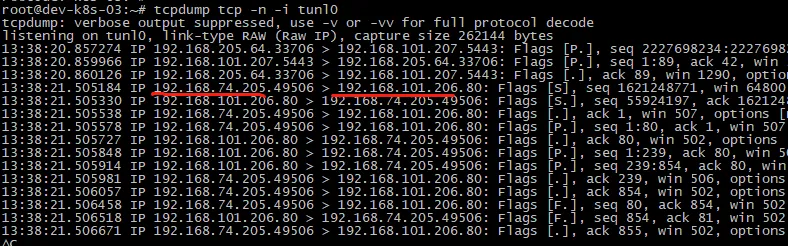
受到宿主机这条路由的影响 , 请求被路由到
cali788fd0c65b9 veth网卡 , 从而被目的容器内的eth0接收。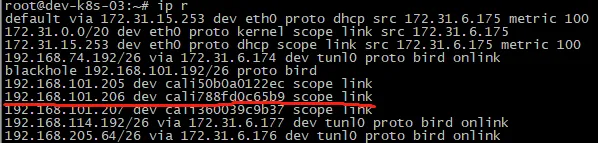
3.2.2.4 Calico VXLAN模式
删除 IPIP 模式的配置 , 重启所有服务器
kubectl delete -f ipip.yaml
kubectl delete -f https://raw.githubusercontent.com/projectcalico/calico/v3.24.0/manifests/tigera-operator.yaml
部署 VXLAN 网络模式 , 并开启 eBPF 数据面
cat <<EOF | tee vxlan.yaml
# This section includes base Calico installation configuration.
# For more information, see: https://projectcalico.docs.tigera.io/master/reference/installation/api#operator.tigera.io/v1.Installation
apiVersion: operator.tigera.io/v1
kind: Installation
metadata:
  name: default
spec:
  # Configures Calico networking.
  calicoNetwork:
    linuxDataplane: BPF # Iptables, BPF
    bgp: Disabled
    hostPorts: Disabled # is not supported with the eBPF dataplane
    # Note: The ipPools section cannot be modified post-install.
    ipPools:
    - blockSize: 26
      cidr: 192.168.0.0/16
      encapsulation: VXLAN
      natOutgoing: Enabled
      nodeSelector: all()
---
# This section configures the Calico API server.
# For more information, see: https://projectcalico.docs.tigera.io/master/reference/installation/api#operator.tigera.io/v1.APIServer
apiVersion: operator.tigera.io/v1
kind: APIServer
metadata:
  name: default
spec: {}
EOF


kubectl create ns tigera-operator
kubectl create -f kubernetes-services-endpoint.yaml
kubectl create -f https://raw.githubusercontent.com/projectcalico/calico/v3.24.0/manifests/tigera-operator.yaml
kubectl create -f vxlan.yaml
跟 IPIP 模式不同的是 , VXLAN 模式默认创建的虚拟网卡接口是 vxlan.calico
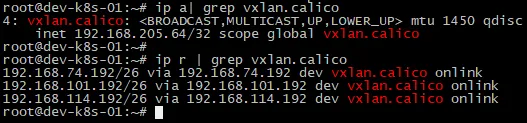
VXLAN 模式下 , 容器之间跨节点通信的过程与 Calico IPIP 模式基本一致。还是以 nginx-5bc454b45b-4dkft 通过 curl ip 请求 nginx-5bc454b45b-vksmq 为例
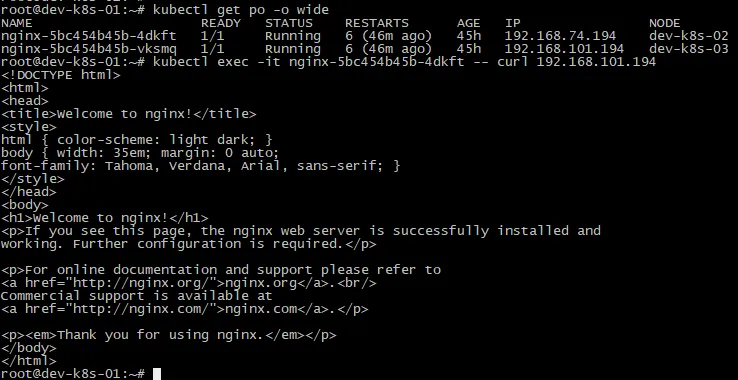
nginx-5bc454b45b-4dkft发出请求 , 源地址:192.168.74.194, 目的地址:192.168.101.194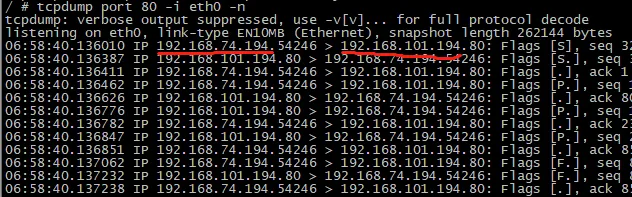
与
IPIP模式一样 , 容器网卡对应的是宿主机的veth网卡 , 报文路由到vxlan.calico, 这时vxlan.calico会对报文进行封装 , 使用Linux内核vxlan模块在原始报文加上外层UDP报头 , 源IP是宿主机的IP(172.31.6.174) , 目的IP是从路由识别到的对端宿主机IP(172.31.6.175)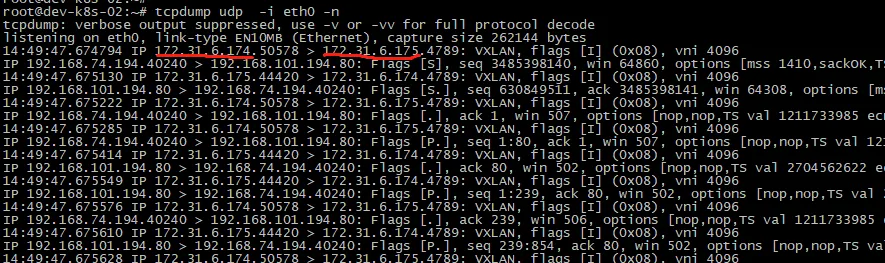
请求从宿主机的
eth0(172.31.6.174) 网卡发出。对端宿主机的
eth0(172.31.6.175) 网卡接收报文后 , 内核发现是vxlan报文 , 去除外层的UDP报头 , 得到真实的报文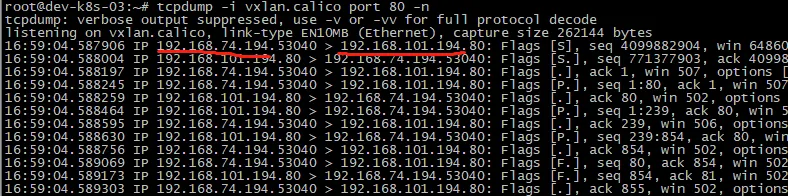
受到宿主机这条路由的影响 , 请求被路由到
cali360039c9b37 veth网卡 , 从而被目的容器内的eth0接收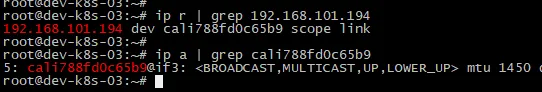
因为
VXLAN模式封装的报头稍大 , 所以性能比IPIP模式略差。
3.2.2.5 Calico IP RR模式
Calico IPIP 默认是全互联模式(node-to-node mesh)模式 , 集群中的所有节点之间都会相互建立 BGP 连接。
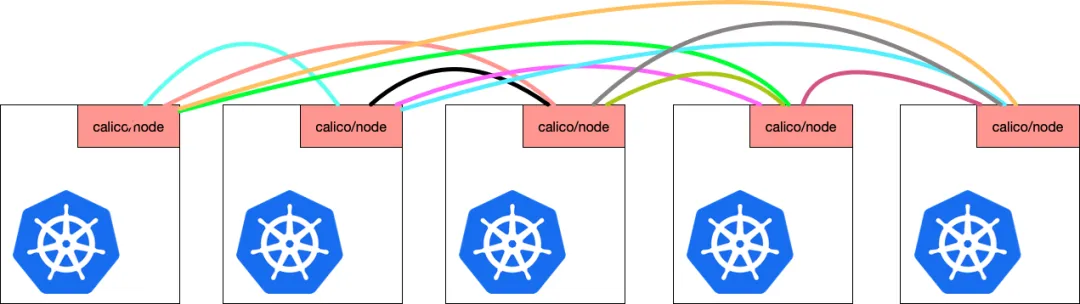
在这种模式下 , 一旦集群增长到数百个节点 , 将形成一个巨大服务网格 , 每个节点都会有 n-1 个 BGP 连接 , AS 从而需要维护大量的 BGP 连接 , 会影响网络性能。
root@dev-k8s-01:~# calicoctl node status
Calico process is running.

IPv4 BGP status
+--------------+-------------------+-------+----------+-------------+
| PEER ADDRESS |     PEER TYPE     | STATE |  SINCE   |    INFO     |
+--------------+-------------------+-------+----------+-------------+
| 172.31.6.174 | node-to-node mesh | up    | 08:04:11 | Established |
| 172.31.6.175 | node-to-node mesh | up    | 08:04:11 | Established |
| 172.31.6.177 | node-to-node mesh | up    | 08:04:11 | Established |
+--------------+-------------------+-------+----------+-------------+

IPv6 BGP status
No IPv6 peers found.
一般情况下 , 当集群规模超过百 , 我们会选择 Calico IPIP 路由反射器(Route Reflector)模式。例如 , 把其中的 2 个 Calico 节点当做路由反射器 , 其他节点只需要把这 2 个节点当做对等体建立 BGP 连接 , 路由器反射器会把传递过来的路由 , 再传递给其他节点 , 来实现路由交换。
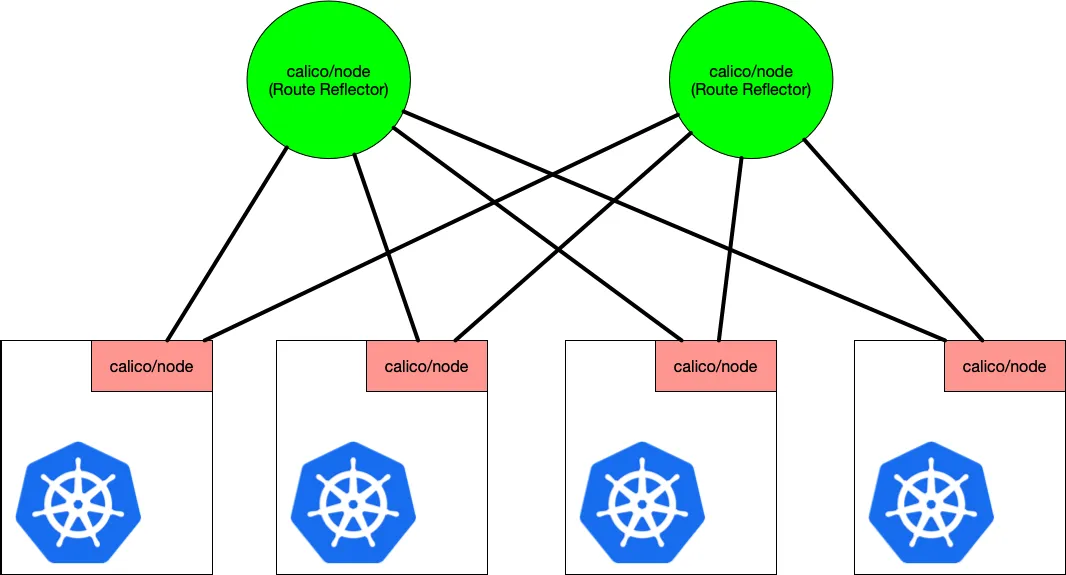
关闭默认的节点到节点全互连模式
cat > bgp-config.yaml <<EOF
apiVersion: projectcalico.org/v3
kind: BGPConfiguration
metadata:
  name: default
spec:
  logSeverityScreen: Info
  nodeToNodeMeshEnabled: false
  asNumber: 64512
EOF

calicoctl apply -f  bgp-config.yaml
将 dev-k8s-02 节点配置为第一个路由反射器
root@dev-k8s-01:~# calicoctl get nodes -o wide
NAME         ASN       IPV4              IPV6
dev-k8s-01   (64512)   172.31.6.176/20
dev-k8s-02   (64512)   172.31.6.174/20
dev-k8s-03   (64512)   172.31.6.175/20
dev-k8s-04   (64512)   172.31.6.177/20
配置 dev-k8s-02 节点的路由反射器集群 ID 并打上标签 , 让 BGPPeer 资源选择它
calicoctl patch node dev-k8s-02 -p '{"spec": {"bgp": {"routeReflectorClusterID": "244.0.0.1"}}}'

kubectl label node dev-k8s-02 route-reflector=true
配置 BGP对等体 , 让其他节点连接到 dev-k8s-02 路由反射器
cat >peer-route-reflectors.yaml  <<EOF
kind: BGPPeer
apiVersion: projectcalico.org/v3
metadata:
  name: peer-route-reflectors
spec:
  nodeSelector: "!has(calico-route-reflector)"
  peerSelector: route-reflector == 'true'
EOF

calicoctl apply -f peer-route-reflectors.yaml
在路由反射器节点 , 可以看到其他节点的连接
root@dev-k8s-02:~# calicoctl node status
Calico process is running.

IPv4 BGP status
+--------------+---------------+-------+----------+-------------+
| PEER ADDRESS |   PEER TYPE   | STATE |  SINCE   |    INFO     |
+--------------+---------------+-------+----------+-------------+
| 172.31.6.175 | node specific | up    | 03:14:47 | Established |
| 172.31.6.176 | node specific | up    | 03:14:47 | Established |
| 172.31.6.177 | node specific | up    | 03:14:47 | Established |
+--------------+---------------+-------+----------+-------------+

IPv6 BGP status
No IPv6 peers found
在非路由反射器节点 , 只有一个与路由反射器建立的连接。
root@dev-k8s-01:~# calicoctl node status
Calico process is running.

IPv4 BGP status
+--------------+---------------+-------+----------+-------------+
| PEER ADDRESS |   PEER TYPE   | STATE |  SINCE   |    INFO     |
+--------------+---------------+-------+----------+-------------+
| 172.31.6.174 | node specific | up    | 03:14:48 | Established |
+--------------+---------------+-------+----------+-------------+

IPv6 BGP status
No IPv6 peers found.
再添加 dev-k8s-03 节点为路由器反射器 , 避免单点故障导致整个集群的网络中断。
cat > peer-with-route-reflectors.yaml <<EOF
kind: BGPPeer
apiVersion: projectcalico.org/v3
metadata:
  name: peer-with-route-reflectors
spec:
  nodeSelector: all()
  peerSelector: route-reflector == 'true'
EOF

kubectl label node dev-k8s-03 route-reflector=true

calicoctl create -f peer-with-route-reflectors.yaml
在非路由反射节点 , 可以看到有两个与路由反射器建立的连接。
root@dev-k8s-01:~# calicoctl node status
Calico process is running.

IPv4 BGP status
+--------------+---------------+-------+----------+-------------+
| PEER ADDRESS |   PEER TYPE   | STATE |  SINCE   |    INFO     |
+--------------+---------------+-------+----------+-------------+
| 172.31.6.174 | node specific | up    | 03:14:47 | Established |
| 172.31.6.175 | node specific | up    | 03:22:26 | Established |
+--------------+---------------+-------+----------+-------------+

IPv6 BGP status
Calico IPIP RR 模式还是 Overlay 网络,虽然 IPIP 模式也是需要建立 BGP 连接的,但是 Calico BGP 模式(Underlay 网络) 建立的 BGP 连接目标比较清晰,原生 host-gw,Pod 之间的流量直接从网卡发送到对端 Pod,没有经过 tunl0 设备的封包和解包环节,效率会高很多。
3.3 安装 Calicoctl
下载 calicoctl
curl -L https://github.com/projectcalico/calico/releases/download/v3.24.0/calicoctl-linux-amd64 -o calicoctl
chmod +x calicoctl
mv calicoctl /usr/local/bin/
创建 calicoctl 配置 , 存储模式是 kubernetes API
cat <<EOF | tee /etc/calico/calicoctl.cfg
apiVersion: projectcalico.org/v3
kind: CalicoAPIConfig
metadata:
spec:
  datastoreType: "kubernetes"
  kubeconfig: "/root/.kube/config"
EOF

root@k8s-master01:~# cat /etc/calico/calicoctl.cfg
apiVersion: projectcalico.org/v3
kind: CalicoAPIConfig
metadata:
spec:
  datastoreType: "etcdv3"
  etcdEndpoints: https://192.168.71.42:2379,https://192.168.71.43:2379,https://192.168.71.44:2379
  etcdKeyFile: /etc/calico/ssl/calico-key.pem
  etcdCertFile: /etc/calico/ssl/calico.pem
  etcdCACertFile: /etc/kubernetes/ssl/ca.pem
4. 客户端工具calicoctl
calicoctl 是 Calico 客户端管理工具。可以方便的管理 calico 网络 , 配置和安全策略 , calicoctl 命令行提供了许多资源管理命令 , 允许您创建 , 修改 , 删除和查看不同的 Calico 资源 , 网络资源包含: node , bgpPeer , hostEndpoint , workloadEndpoint , ipPool , policy , profile等。
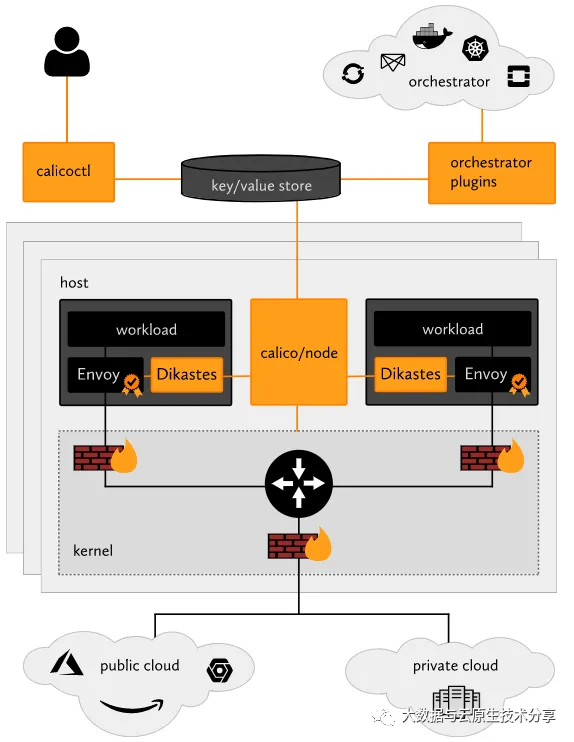
Calico项目提供的专用客户端工具calicoctl能够直接与Calico Datastore进行交互 , 用于管理Calico系统抽象出的各种资源 , 通过资 源管理实现查看、修改或配置Calico系统特性。我们可以基于特定的 Pod来提供calicoctl工具程序 , 也可直接将相关的二进制程序部署在 管理节点之上 , 例如管理员运行kubectl工具的主机等。下面在k8s-master01上直接下载编译后的calicoctl文件 , 并将其保存在/usr/bin/目录中:
~$ wget
https://github.com/projectcalico/calicoctl/releases/download/v3.14.1/calicoctl
~$ sudo mv calicoctl /usr/bin/
~$ sudo chmod +x /usr/bin/calicoctl calicoctl成功认证到Calico的数据存储系统(Datastore)上之 后才能查看或进行各类管理操作 , 所需要的认证方式也就取决于 Datastore的类型。以Kubernetes API为数据存储时 , calicoctl需要使用类似kubectl的认证信息完成认证 , 常用的实现方式有环境变量和 配置文件两种。环境变量DATASTORE_TYPE用于指定存储类型 , 而KUBECONFIG则用于指定配置文件kubeconfig的认证文件路径 , 例如以如下命令格式运行calicoctl命令 , 测试读取Calico系统的节点信息。
~$ DATASTORE_TYPE=kubernetes KUBECONFIG=~/.kube/config calicoctl
get nodes -o wide
NAME                ASN       IPV4          PV6
k8s-master01.ilinux.io    (64512)   172.29.9.1/16
k8s-node01.ilinux.io     (64512)   172.29.9.11/16
k8s-node02.ilinux.io     (64512)   172.29.9.12/16
k8s-node03.ilinux.io     (64512)   172.29.9.13/16
为了更方便使用 , 我们也可以直接将认证信息等保存在配置文件中 , calicoctl默认加载的配置文件是/etc/calico/calicoctl.cfg , 配置信息以YAML格式进行组织 , 语法格式类似于Kubernetes的资源配置清单。
apiVersion: projectcalico.org/v3
kind: CalicoAPIConfig
metadata:
spec:
  datastoreType: "kubernetes"
kubeconfig: "/path/to/.kube/config"将上面示例配置中的/PATH/TO路径修改为相应的用户主目录即 可 , 例如/home/ik8s/。当然 , 也可以是用户自定义的其他kubeconfig 配置文件的存放路径。
calicoctl的通用语法格式为calicoctl [options] <command> [<args>...]。它支持apply、delete、get、patch、replace、node和 ipam等子命令 , 分别用于增、删、改、查相应的资源配置或打印相关状态信息等。
例如 , 下面命令列出Datastore中所有的ipPool资源对象。ipPool 是常用的资源类型之一 , 它代表当前Calico系统可用的地址池资源。 默认部署生成的地址池资源名称为default-ipv4-ippool。
~$ calicoctl get ipPool
NAME                  CIDR            SELECTOR
default-ipv4-ippool 10.244.0.0/16 all()calicoctl同样支持资源的多种输出格式 , 例如yaml、json、 wide、go-template和custom-columns等 , 其功能完全类似kubectl中的用法。例如 , 下面的命令以YAML格式输出了默认地址池的详细定义。
~$ calicoctl get ipPool default-ipv4-ippool -o yaml
apiVersion: projectcalico.org/v3
kind: IPPool
metadata:
  name: default-ipv4-ippool
spec:
  blockSize: 24
  cidr: 10.244.0.0/16
  ipipMode: Always
  natOutgoing: true
  nodeSelector: all()
  vxlanMode: Never
我们可将上面命令输出的结果保存于本地文件中 , 修改其特定属性值后 , 再重新应用(apply)到Datastore从而完成配置更新 , 例如 添加disabled: true以禁用指定的地址池等 ; 也可同时修改资源名称 和特定属性值后再应用到Datastore上以创建新的资源。
再如 , 下面的命令打印了地址池中相关地址块与IP地址的分配状态 , 包括地址池及各地址块中的IP总数、已分配数量和可用数量等。
~$ calicoctl ipam show --show-blocks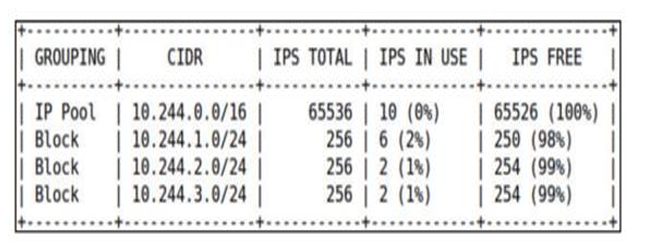
另外 , 直接以ectd为Datastore的场景中 , calicoctl则要使用由 etcd信任的CA所签发的数字证书认证到etcd , 主流的配置方式同样有环境变量和配置文件两种。无论使用哪种Datastore , calicoctl可执 行的管理操作及相关命令的用法并无不同之处。
5. 简单使用
5.1 基本使用
查看
IP资源池calicoctl get ipPools calicoctl get ipPool -o yaml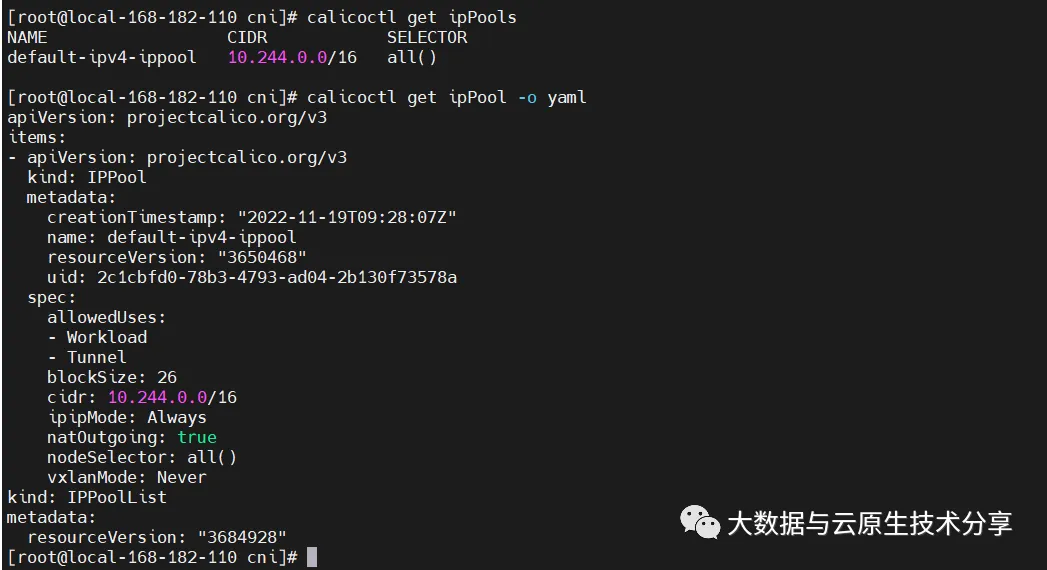
配置
IP池IP池 是Calico使用的IP地址范围 工作负载终端节点。定义两个在此群集中使用的
IP池。您可以仅使用一个 池 , 但我们定义了两个 , 编排操作如下:cat > pool1.yaml <<EOF apiVersion: projectcalico.org/v3 kind: IPPool metadata: name: pool1 spec: cidr: 10.245.1.0/24 ipipMode: Never natOutgoing: true disabled: false nodeSelector: all() EOF cat > pool2.yaml <<EOF apiVersion: projectcalico.org/v3 kind: IPPool metadata: name: pool2 spec: cidr: 10.245.2.0/24 ipipMode: Never natOutgoing: true disabled: true nodeSelector: all() EOF执行并查看
# 先查看IP资源池
calicoctl get ipPools

# 创建两个IP资源池
calicoctl create -f pool1.yaml
calicoctl create -f pool2.yaml

# 查看
calicoctl get ipPools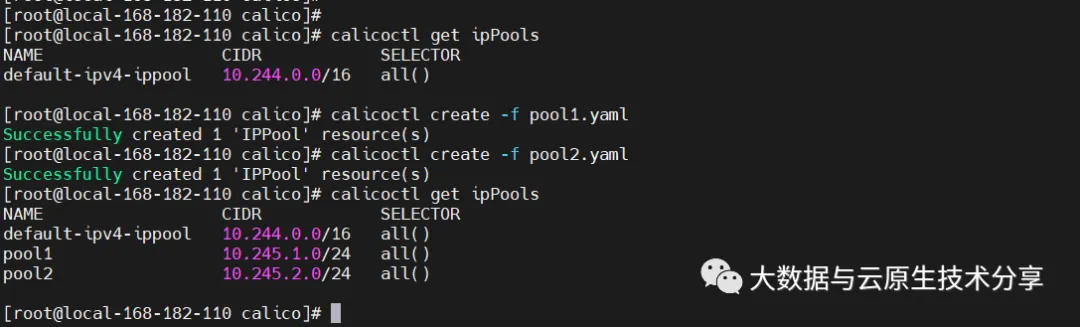
如果使用
kubectl创建,就必须查询apiVersion和kind# 先删除上面新建的两个ip资源池 calicoctl delete -f pool1.yaml calicoctl delete -f pool2.yaml calicoctl get ipPools # 未修改前执行,发现是无法匹配对应的kind kubectl create -f pool1.yaml # 查看apiVersion kubectl api-versions|grep calico # 查看kind kubectl api-resources -o wide|grep calico|grep IPPool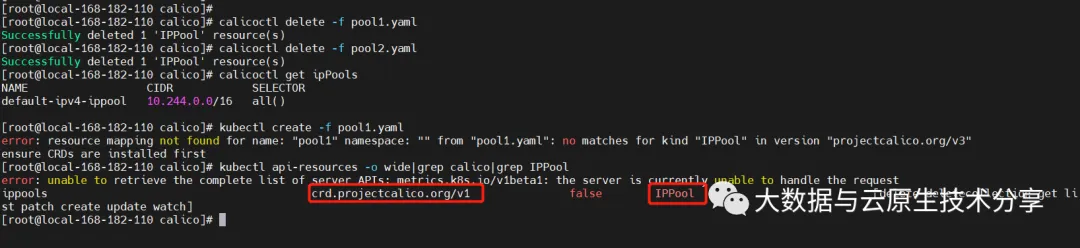
修改
# 这里只需要把apiVersion换掉既可
cat > pool3.yaml <<EOF
apiVersion: crd.projectcalico.org/v1
kind: IPPool
metadata:
  name: pool3
spec:
  cidr: 10.245.3.0/24
  ipipMode: Never
  natOutgoing: true
  disabled: false
  nodeSelector: all()
EOF

cat > pool4.yaml <<EOF
apiVersion: crd.projectcalico.org/v1
kind: IPPool
metadata:
  name: pool4
spec:
  cidr: 10.245.4.0/24
  ipipMode: Never
  natOutgoing: true
  disabled: true
  nodeSelector: all()
EOF

# 先查看ip资源池
calicoctl get ipPools

# 执行
kubectl create -f pool3.yaml
kubectl create -f pool4.yaml
5.1 网络策略示例
网络策略资源 (NetworkPolicy) 表示应用的一组有序规则 到与 标签选择器。NetworkPolicy 是命名空间资源。NetworkPolicy 在特定命名空间中 仅适用于工作负载终端节点资源 在该命名空间中。两个资源位于同一命名空间中,如果 namespace 两者上的值设置相同。看 全局网络策略资源 对于非命名空间网络策略。
【示例】此示例策略允许来自 TCP 流量 frontend 端口 6379 的终结点 database 端点。
# vim networkpolicy-test.yaml
apiVersion: projectcalico.org/v3
kind: NetworkPolicy
metadata:
  name: allow-tcp-6379
  namespace: production
spec:
  selector: role == 'database'
  types:
  - Ingress
  - Egress
  ingress:
  - action: Allow
    metadata:
      annotations:
        from: frontend
        to: database
    protocol: TCP
    source:
      selector: role == 'frontend'
    destination:
      ports:
      - 6379
  egress:
  - action: Allow
执行
kubectl create ns production
calicoctl create -f networkpolicy-test.yaml
# 查看
calicoctl get networkPolicy --namespace=production -oyaml
允许来自同一命名空间中的 Pod 的入口流量
允许来自同一命名空间中的
Pod的入口流量 , 在以下示例中 , 传入带有标签的Pod的labelcolor: red, 仅当它们来自pod带有labelcolor: red, 才被允许转到80端口。kind: NetworkPolicy apiVersion: networking.k8s.io/v1 metadata: name: allow-same-namespace namespace: default spec: podSelector: matchLabels: color: blue ingress: - from: - podSelector: matchLabels: color: red ports: - port: 80允许来自不同命名空间中的
Pod的入口流量在以下示例中, 仅当传入流量来自带有标签
color: red的Pod时, 才允许传入流量, 在带有标签的命名空间中带有标签shape: square, 在端口上80kind: NetworkPolicy apiVersion: networking.k8s.io/v1 metadata: name: allow-same-namespace namespace: default spec: podSelector: matchLabels: color: blue ingress: - from: - podSelector: matchLabels: color: red namespaceSelector: matchLabels: shape: square ports: - port: 80
5.2 固定 Pod IP
【示例 1】pod 利用注解
cni.projectcalico.org/ipAddrs# vi fixed-ip-test-pod.yaml --- apiVersion: v1 kind: Pod metadata: name: myapp-pod labels: app: myapp annotations: cni.projectcalico.org/ipAddrs: "[\"10.244.1.200\"]" spec: containers: - name: myapp-container image: busybox command: ['sh', '-c', 'echo Hello Kubernetes! && sleep 3600']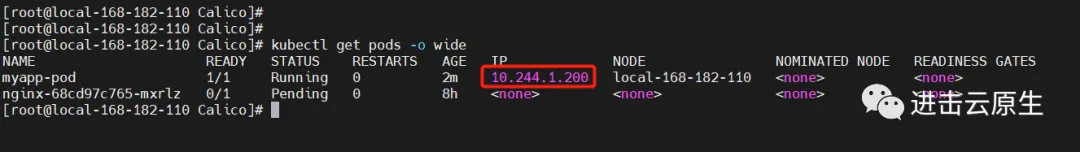
【示例 2】控制器 单 pod 利用注解
cni.projectcalico.org/ipAddrs# vi fixed-ip-test-deployment.yaml --- apiVersion: apps/v1 kind: Deployment metadata: name: fixed-ip-test namespace: default labels: k8s-app: cloudnativer-test spec: replicas: 1 strategy: type: RollingUpdate rollingUpdate: maxUnavailable: 1 selector: matchLabels: k8s-app: cloudnativer-test template: metadata: labels: k8s-app: cloudnativer-test annotations: cni.projectcalico.org/ipAddrs: "[\"10.244.1.220\"]" spec: containers: - name: fixed-ip-test image: nginx:1.7.9 imagePullPolicy: IfNotPresent ports: - name: http containerPort: 80【示例 3】控制器 多
pod固定 IP 池需要创建额外
IP池( 除了默认IP池) , 利用注解cni.projectcalico.org/ipv4pools。这里先安装一个客户端工具
calicoctlwget https://github.com/projectcalico/calico/releases/download/v3.24.5/calicoctl-linux-amd64 mv calicoctl-linux-amd64 /usr/local/bin/calicoctl chmod +x /usr/local/bin/calicoctl编排
# vi fixed-ip-test-deployment2.yaml
# apiVersion: projectcalico.org/v3
apiVersion: crd.projectcalico.org/v1
kind: IPPool
metadata:
  name: new-pool1
spec:
  blockSize: 31
  cidr: 10.244.3.220/24
  ipipMode: Never
  natOutgoing: true
---
# apiVersion: projectcalico.org/v3
apiVersion: crd.projectcalico.org/v1
kind: IPPool
metadata:
  name: new-pool2
spec:
  blockSize: 31
  cidr: 10.244.4.221/24
  ipipMode: Never
  natOutgoing: true
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: fixed-ip-test2
  namespace: default
  labels:
    k8s-app: cloudnativer-test
spec:
  replicas: 3
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxUnavailable: 1
  selector:
    matchLabels:
      k8s-app: cloudnativer-test
  template:
    metadata:
      labels:
        k8s-app: cloudnativer-test
      annotations:
        # 【注意】不能使用单引号
        "cni.projectcalico.org/ipv4pools": "[\"new-pool1\",\"new-pool2\"]"
    spec:
      containers:
      - name: fixed-ip-test
        image: nginx:1.7.9
        imagePullPolicy: IfNotPresent
        ports:
        - name: http
          containerPort: 80
查看
# 查看ip池
calicoctl get ippool
kubectl get pods -owide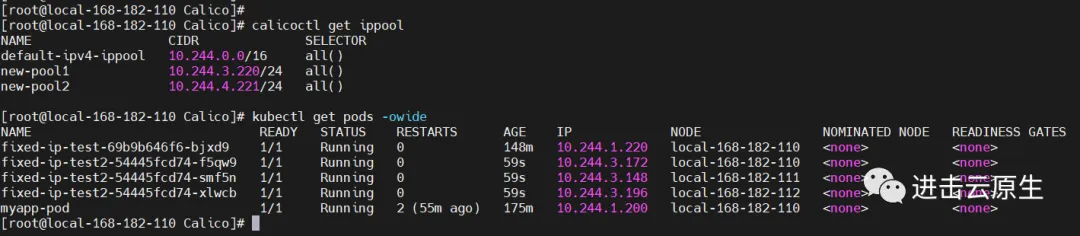
【温馨提示】: 要更改用于
Pod的默认IP范围, 请修改calico.yaml清单文件中CALICO_IPV4POOL_CIDR部分。
6. Kube-ipam
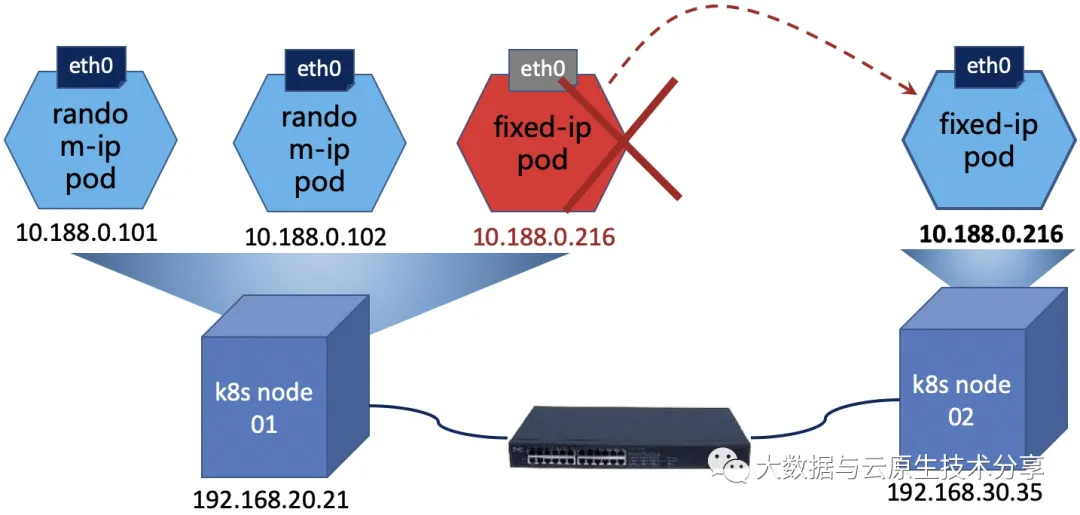
Kube-ipam 基于etcd分布式存储实现kubernetes动态IP网络分配管理,确保集群中IP地址的唯一性。Kube-ipam支持给kubernetes集群中的Pod固定IP地址,同时支持resolv.conf的DNS配置。这个需要基于网络插件( 例如:macvlan、ipvlan、kube-router、bridge、calico等) ,这里就使用calico网络插件来实现。
一些场景往往对IP地址有依赖,需要使用固定IP地址的Pod,可以使用kube-ipam轻松解决这类问题。例如,mysql主从架构的时候,主database与从database之间的同步 ; 例如keepalived做集群HA的时候,两个节点之间检测通信等 ; 例如某些安全防护设备,需要基于IP地址进行网络安全访问策略限制的场景等。
GitHub地址:https://github.com/cloudnativer/kube-ipam
6.1 安装kube-ipam
请确保你的kubelet正确的配置了network-plugin、cni-conf-dir 和 cni-bin-dir 参数。下面给出一个kubelet的配置示例供你参考:
# vi /usr/lib/systemd/system/kubelet.service
# ...
ExecStart=/usr/local/bin/kubelet \
--network-plugin=cni \
--cni-conf-dir=/etc/cni/net.d \
--cni-bin-dir=/opt/cni/bin/ \

# 重启kubelet
systemctl daemon-reload
systemctl restart kubelet
下载安装 kube-ipam
wget https://github.com/cloudnativer/kube-ipam/releases/download/v0.2.0/kube-ipam-v0.2.0-x86.tgz
tar -zxvf kube-ipam-v0.2.0-x86.tgz
mv kube-ipam/kube-ipam /opt/cni/bin/kube-ipam
6.2 子网和etcd配置
你可以通过 subnet 参数设置IP子网信息,通过 gateway 设置网关信息。你可以通过 etcdConfig 配置etcd的证书和endpoint地址。编辑所有kubernetes node主机的 /etc/cni/net.d/1-kube-ipam.conf 文件。
# 类型
#"type": "calico",
# 主网卡名称
#"master": "ens33",
# cat /etc/cni/net.d/1-kube-ipam.conf
{
        "cniVersion":"0.3.1",
        "name": "k8snetwork",
        "type": "calico",
        "master": "ens33",
        "ipam": {
                "name": "kube-subnet",
                "type": "kube-ipam",
                "kubeConfig": "/etc/kubernetes/pki/kubectl.kubeconfig"
                "etcdConfig": {
                        "etcdURL": "https://192.168.1.50:2379,https://192.168.1.58:2379,https://192.168.1.63:2379",
                        "etcdCertFile": "/etc/kubernetes/pki/etcd.pem",
                        "etcdKeyFile": "/etc/kubernetes/pki/etcd-key.pem",
                        "etcdTrustedCAFileFile": "/etc/kubernetes/pki/ca.pem"
                },
                "subnet": "10.188.0.0/16",
                "fixedStart": "10.188.0.10",
                "fixedEnd": "10.188.0.255",
                "rangeStart": "10.188.1.0",
                "rangeEnd": "10.188.255.254",
                "gateway": "10.188.0.1",
                "routes": [{
                        "dst": "0.0.0.0/0"
                }],
                "resolvConf": "/etc/resolv.conf"
        }
}
6.3 固定IP示例演示
# cat fixed-ip-test-Deployment.yaml
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: fixed-ip-test
  namespace: default
  labels:
    k8s-app: cloudnativer-test
spec:
  replicas: 1
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxUnavailable: 1
  selector:
    matchLabels:
      k8s-app: cloudnativer-test
  template:
    metadata:
      labels:
        k8s-app: cloudnativer-test
      annotations:
        kube-ipam.ip: "10.188.0.216"
        kube-ipam.netmask: "255.255.0.0"
        kube-ipam.gateway: "10.188.0.1"
    spec:
      containers:
      - name: fixed-ip-test
        image: nginx:1.7.9
        imagePullPolicy: IfNotPresent
        ports:
        - name: http
          containerPort: 80
---
参考链接
理解calico容器网络通信方案原理 | 郑文峰的博客 (zhengwenfeng.com)
kubernetes网络组件calico详解 - yuhaohao - 博客园 (cnblogs.com)
10 张图解 K8S CNI Calico 网络模型原理与功能实战 (qq.com)
Kubernetes 网络 — Calico (上) (qq.com)
Kubernetes 网络 — Calico (下) (qq.com)
【云原生】Kubernetes( k8s) Calico 客户端工具 calicoctl (qq.com)
k8s系列13-calico部署BGP模式的高可用k8s集群 (qq.com)