
4-3-1-k8s组件-flannel
CNI , 它的全称是 Container Network Interface , 即容器网络的 API 接口。kubernetes 网络的发展方向是希望通过插件的方式来集成不同的网络方案 , CNI 就是这一努力的结果。CNI 只专注解决容器网络连接和容器销毁时的资源释放 , 提供一套框架 , 所以 CNI 可以支持大量不同的网络模式 , 并且容易实现。
1. 从网络模型到 CNI
在理解 CNI 机制以及 Flannel 等具体实现方案之前 , 首先要理解问题的背景 , 这里从 kubernetes 网络模型开始回顾。
从底层网络来看 , kubernetes 的网络通信可以分为三层去看待 :
Pod内部容器通信;同主机
Pod间容器通信;跨主机
Pod间容器通信;
对于前两点 , 其网络通信原理其实不难理解。
对于
Pod内部容器通信 , 由于Pod内部的容器处于同一个Network Namespace下( 通过Pause容器实现) , 即共享同一网卡 , 因此可以直接通信。对于同主机
Pod间容器通信 ,Docker会在每个主机上创建一个Docker0网桥 , 主机上面所有Pod内的容器全部接到网桥上 , 因此可以互通。
而对于第三点 , 跨主机 Pod 间容器通信 , Docker 并没有给出很好的解决方案 , 而对于 Kubernetes 而言 , 跨主机 Pod 间容器通信是非常重要的一项工作 , 但是有意思的是 , Kubernetes 并没有自己去解决这个问题 , 而是专注于容器编排问题 , 对于跨主机的容器通信则是交给了第三方实现 , 这就是 CNI 机制。
CNI , 它的全称是 Container Network Interface , 即容器网络的 API 接口。kubernetes 网络的发展方向是希望通过插件的方式来集成不同的网络方案 , CNI 就是这一努力的结果。CNI 只专注解决容器网络连接和容器销毁时的资源释放 , 提供一套框架 , 所以 CNI 可以支持大量不同的网络模式 , 并且容易实现。平时比较常用的 CNI 实现有 Flannel、Calico、Weave 等。
CNI 插件通常有三种实现模式 :
Overlay: 靠隧道打通 , 不依赖底层网络;路由 : 靠路由打通 , 部分依赖底层网络;
Underlay: 靠底层网络打通 , 强依赖底层网络;
在选择 CNI 插件时是要根据自己实际的需求进行考量 , 比如考虑 NetworkPolicy 是否要支持 Pod 网络间的访问策略 , 可以考虑 Calico、Weave;Pod 的创建速度 , Overlay 或路由模式的 CNI 插件在创建 Pod 时比较快 , Underlay 较慢;网络性能 , Overlay 性能相对较差 , Underlay 及路由模式相对较快。
2. Flannel 工作原理
CNI 中经常见到的解决方案是 Flannel , 由CoreOS推出 , Flannel 采用的便是上面讲到的 Overlay 网络模式。
2.1 Overlay 网络简介
Overlay 网络 (overlay network) 属于应用层网络 , 它是面向应用层的 , 不考虑网络层 , 物理层的问题。
具体而言 , Overlay 网络是指建立在另一个网络上的网络。该网络中的结点可以看作通过虚拟或逻辑链路而连接起来的。虽然在底层有很多条物理链路 , 但是这些虚拟或逻辑链路都与路径一 一对应。例如: 许多P2P网络就是 Overlay 网络 , 因为它运行在互连网的上层。 Overlay 网络允许对没有IP地址标识的目的主机路由信息 , 例如: Freenet 和DHT( 分布式哈希表) 可以路由信息到一个存储特定文件的结点 , 而这个结点的IP地址事先并不知道。
Overlay 网络被认为是一条用来改善互连网路由的途径 , 让二层网络在三层网络中传递 , 既解决了二层的缺点 , 又解决了三层的不灵活。
2.2 Flannel的工作原理
Flannel 实质上就是一种 Overlay 网络 , 也就是将 TCP 数据包装在另一种网络包里面进行路由转发和通信 , 目前已经支持 UDP、VxLAN、AWS VPC 和 GCE 路由等数据转发方式。
Flannel会在每一个宿主机上运行名为 flanneld 代理 , 其负责为宿主机预先分配一个子网 , 并为 Pod 分配IP地址。Flannel 使用Kubernetes 或 etcd 来存储网络配置、分配的子网和主机公共IP等信息。数据包则通过 VXLAN、UDP 或 host-gw 这些类型的后端机制进行转发。
Flannel 规定宿主机下各个Pod属于同一个子网 , 不同宿主机下的Pod属于不同的子网。
2.3 Flannel 工作模式
支持3种实现: UDP、VxLAN、host-gw
UDP模式: 使用设备flannel.0进行封包解包 , 不是内核原生支持 , 频繁地内核态用户态切换 , 性能非常差;VxLAN模式: 使用flannel.1进行封包解包 , 内核原生支持 , 性能较强;host-gw模式: 无需flannel.1这样的中间设备 , 直接宿主机当作子网的下一跳地址 , 性能最强;
host-gw的性能损失大约在10%左右 , 而其他所有基于VxLAN“隧道”机制的网络方案 , 性能损失在20%~30%左右。
2.3.1 UDP 模式
官方已经不推荐使用 UDP 模式 , 性能相对较差。
UDP 模式的核心就是通过 TUN 设备 flannel0 实现。TUN设备是工作在三层的虚拟网络设备 , 功能是: 在操作系统内核和用户应用程序之间传递IP包。 相比两台宿主机直接通信 , 多出了 flanneld 的处理过程 , 这个过程 , 使用了 flannel0 这个TUN设备 , 仅在发出 IP包的过程中经过多次用户态到内核态的数据拷贝(linux的上下文切换代价比较大) , 所以性能非常差原理如下 :
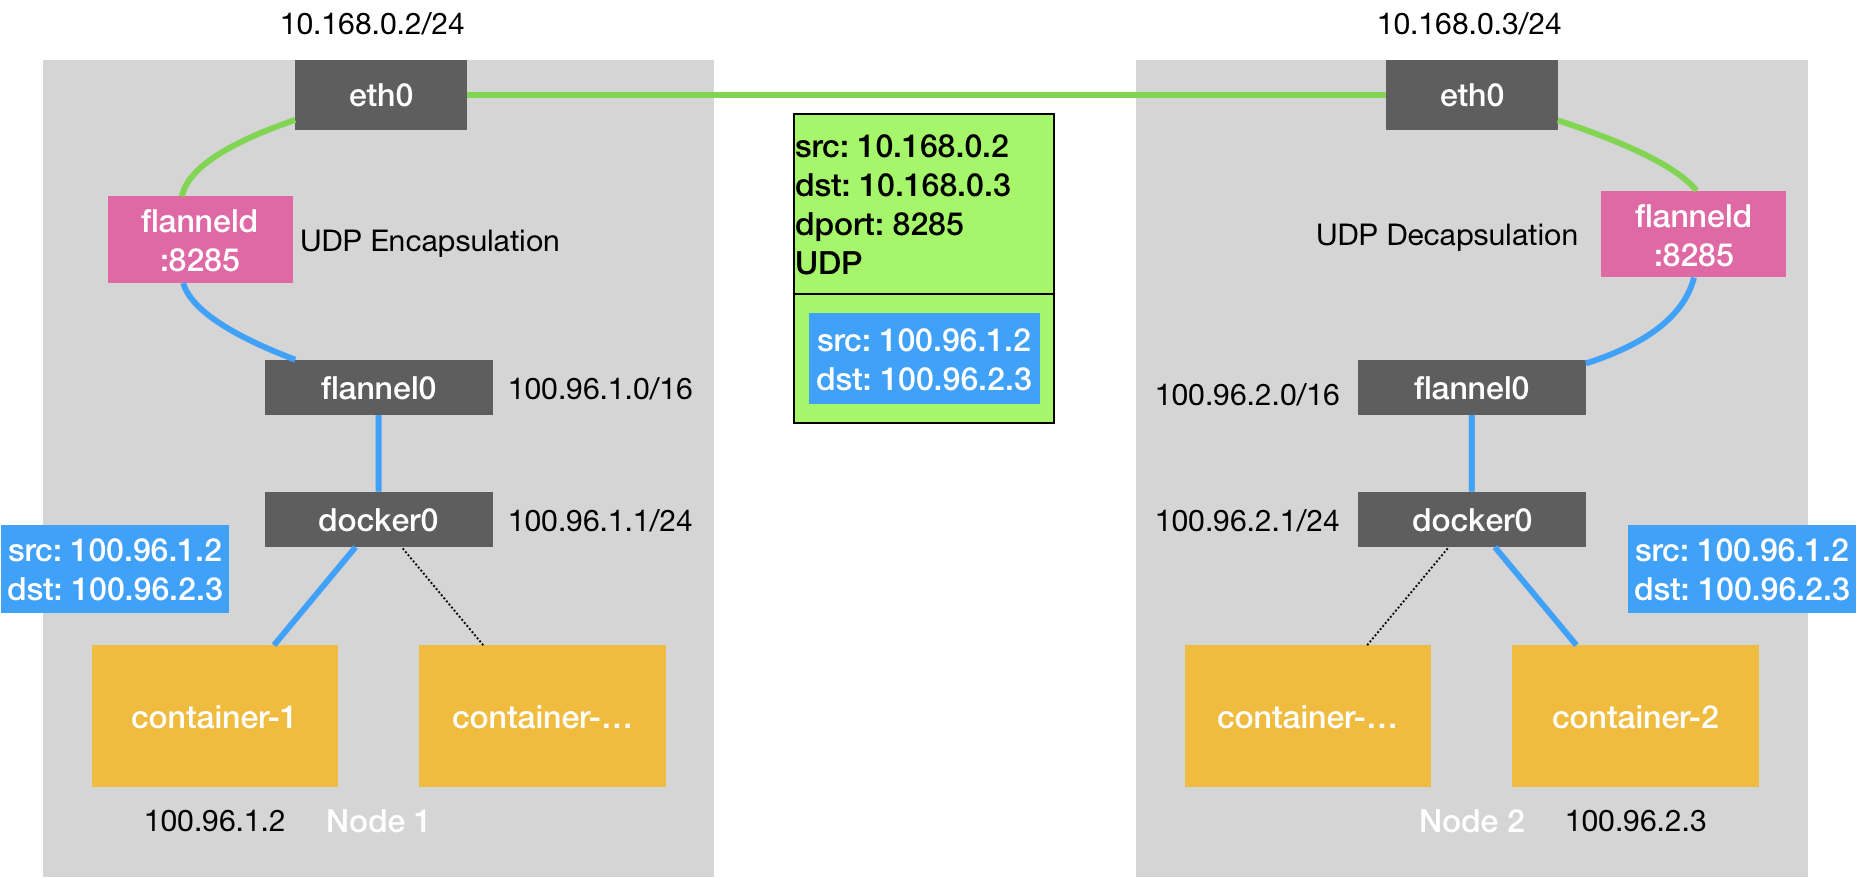
以flannel0为例 , 操作系统将一个IP包发给flannel0 , flannel0把IP包发给创建这个设备的应用程序: flannel进程 ( 内核态->用户态) 相反 , flannel进程向flannel0发送一个IP包 , IP包会出现在宿主机的网络栈中 , 然后根据宿主机的路由表进行下一步处理( 用户态->内核态) 当IP包从容器经过docker0出现在宿主机 , 又根据路由表进入flannel0设备后 , 宿主机上的flanneld进程就会收到这个IP包
flannel管理的容器网络里 , 一台宿主机上的所有容器 , 都属于该宿主机被分配的“子网” , 子网与宿主机的对应关系 , 存在Etcd中( 例如Node1的子网是100.96.1.0/24 , container-1的IP地址是100.96.1.2)
当flanneld进程处理flannel0传入的IP包时 , 就可以根据目的IP地址( 如100.96.2.3) , 匹配到对应的子网( 比如100.96.2.0/24) , 从Etcd中找到这个子网对应的宿主机的IP地址( 10.168.0.3)
然后 flanneld 在收到container-1给container-2的包后 , 把这个包直接封装在UDP包里 , 发送给Node2( UDP包的源地址 , 就是Node1 , 目的地址是Node2)
每台宿主机的flanneld都监听着8285端口 , 所以flanneld只要把UDP发给Node2的8285端口就行了。然后Node2的flanneld再把IP包发送给它所管理的TUN设备flannel0 , flannel0设备再发给docker0
2.3.2 VxLAN模式
VxLAN , 即Virtual Extensible LAN( 虚拟可扩展局域网) , 是Linux本身支持的一网种网络虚拟化技术。VxLAN可以完全在内核态实现封装和解封装工作 , 从而通过“隧道”机制 , 构建出 Overlay 网络( Overlay Network)
VxLAN的设计思想是 : 在现有的三层网络之上 , “覆盖”一层虚拟的、由内核VxLAN模块负责维护的二层网络 , 使得连接在这个VxLAN二层网络上的“主机”( 虚拟机或容器都可以) , 可以像在同一个局域网( LAN) 里那样自由通信。 为了能够在二层网络上打通“隧道” , VxLAN会在宿主机上设置一个特殊的网络设备作为“隧道”的两端 , 叫VTEP: VxLAN Tunnel End Point( 虚拟隧道端点) 原理如下:
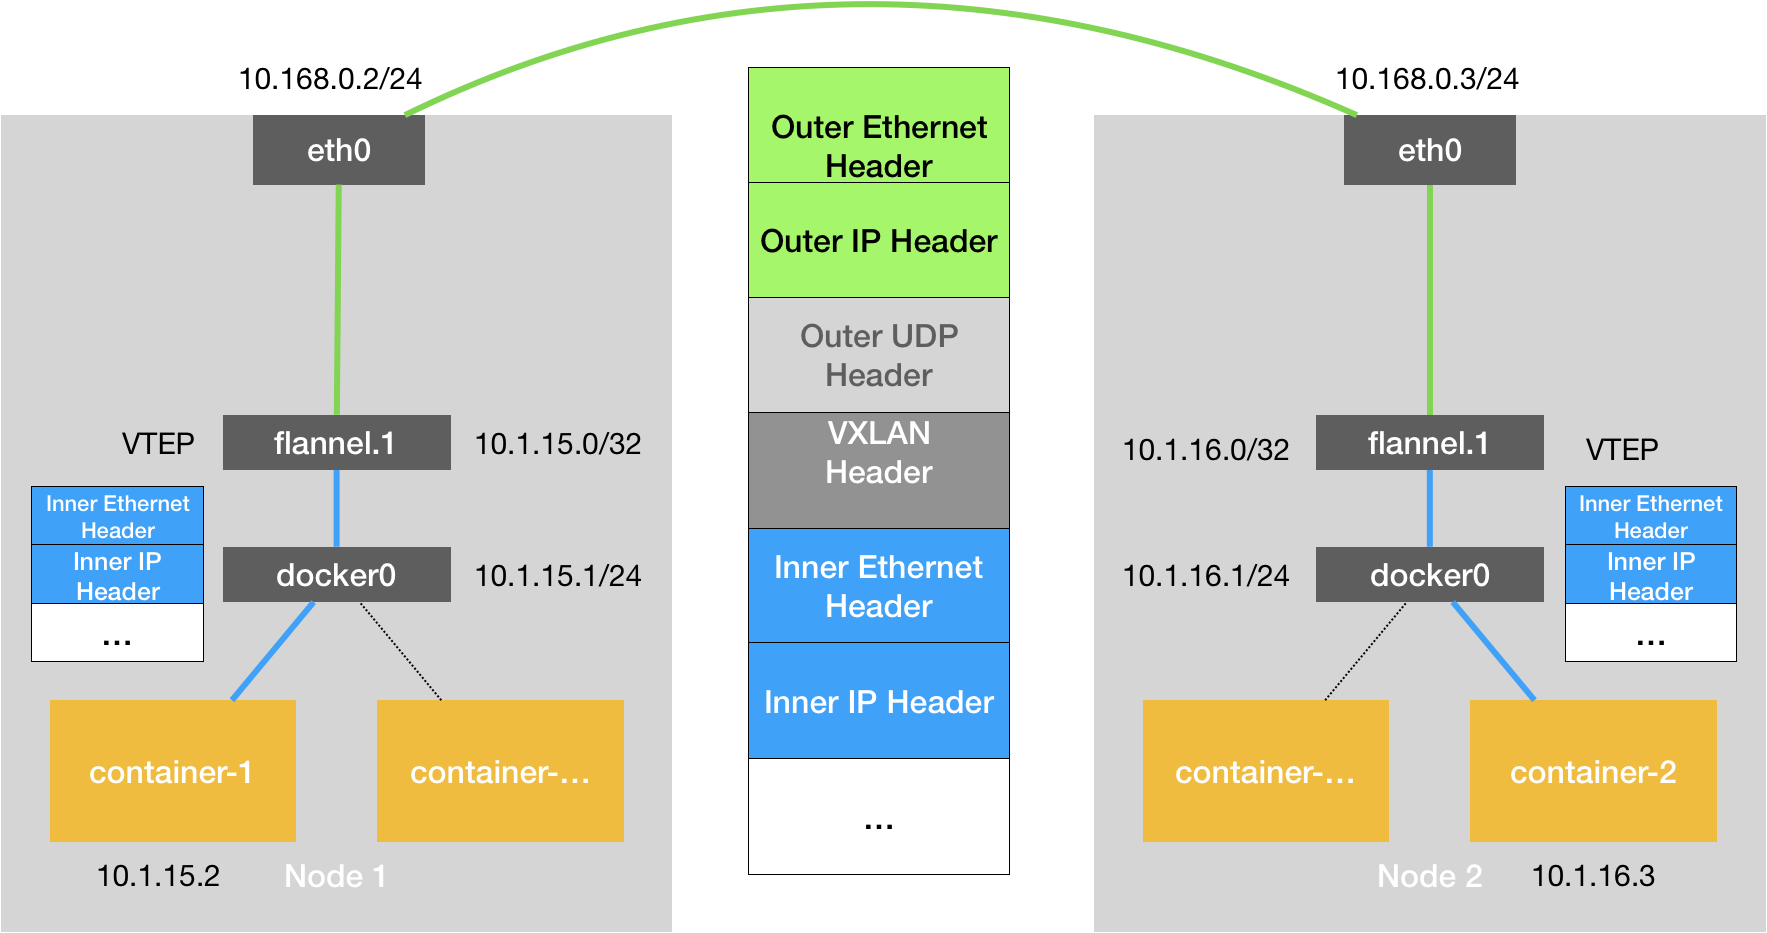
flannel.1设备 , 就是VxLAN的VTEP , 即有IP地址 , 也有MAC地址 与UDP模式类似 , 当container-2发出请求后 , 其上的地址10.1.16.3的IP包 , 会先出现在docker网桥 , 再路由到本机的flannel.1设备进行处理 ( 进站 ) , 为了能够将“原始IP包”封装并发送到正常的主机 , VxLAN需要找到隧道的出口 : 宿主机的VTEP设备 , 这个设备信息 , 由宿主机的flanneld进程维护
VTEP设备之间通过二层数据桢进行通信源VTEP设备收到原始IP包后 , 在上面加上一个目的MAC地址 , 封装成一个导去数据帧 , 发送给目的VTEP设备( 获取 MAC地址需要通过三层IP地址查询 , 这是ARP表的功能)
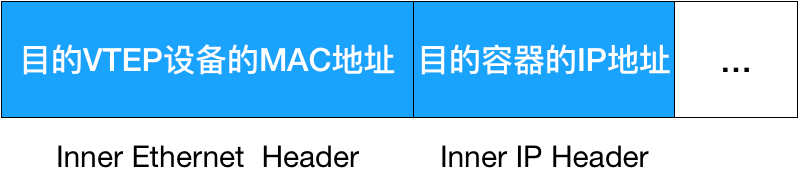
封装过程只是加了一个二层头 , 不会改变“原始IP包”的内容 这些VTEP设备的MAC地址 , 对宿主机网络来说没什么实际意义 , 称为内部数据桢 , 并不能在宿主机的二层网络传输 , Linux内核还需要把它进一步封装成为宿主机的一个普通的数据桢 , 好让它带着“内部数据桢”通过宿主机的eth0进行传输 , Linux会在内部数据桢前面 , 加上一个伪装的VxLAN头 , VxLAN头里有一个重要的标志叫VNI , 它是VTEP识别某个数据帧是不是应该归自己处理的重要标识。 在Flannel中 , VNI的默认值是1 , 这也是为什么宿主机的VTEP设备都叫flannel.1的原因
一个flannel.1设备只知道另一端flannel.1设备的MAC地址 , 却不知道对应的宿主机地址是什么。 在linux内核里面 , 网络设备进行转发的依据 , 来自FDB的转发数据库 , 这个flannel.1网桥对应的FDB信息 , 是由flanneld进程维护的 linux内核再在IP包前面加上二层数据桢头 , 把Node2的MAC地址填进去。这个MAC地址本身 , 是Node1的ARP表要学习的 , 需 Flannel维护 , 这时候Linux封装的“外部数据桢”的格式如下
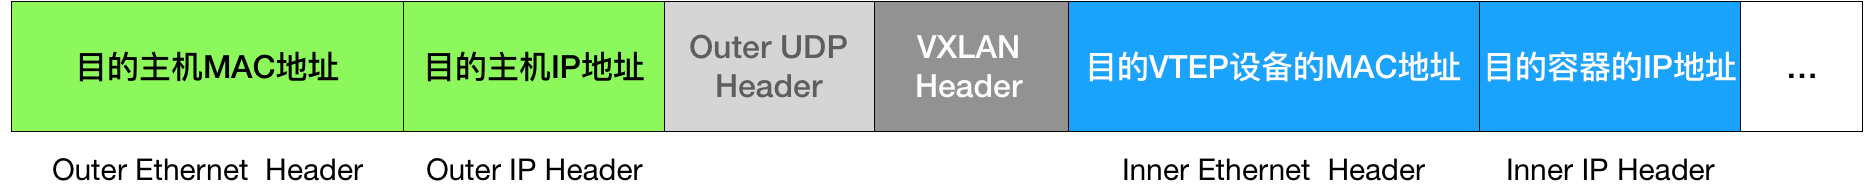
然后Node1的flannel.1设备就可以把这个数据桢从eth0发出去 , 再经过宿主机网络来到Node2的eth0 Node2的内核网络栈会发现这个数据桢有VxLAN Header , 并且VNI为1 , Linux内核会对它进行拆包 , 拿到内部数据桢 , 根据VNI的值 , 所它交给Node2的flannel.1设备
2.3.3 host-gw模式
Flannel 第三种协议叫 host-gw (host gateway) , 这是一种纯三层网络的方案 , 性能最高 , 即 Node 节点把自己的网络接口当做 pod 的网关使用 , 从而使不同节点上的 node 进行通信 , 这个性能比 VxLAN 高 , 因为它没有额外开销。不过他有个缺点 , 就是各 node 节点必须在同一个网段中 。
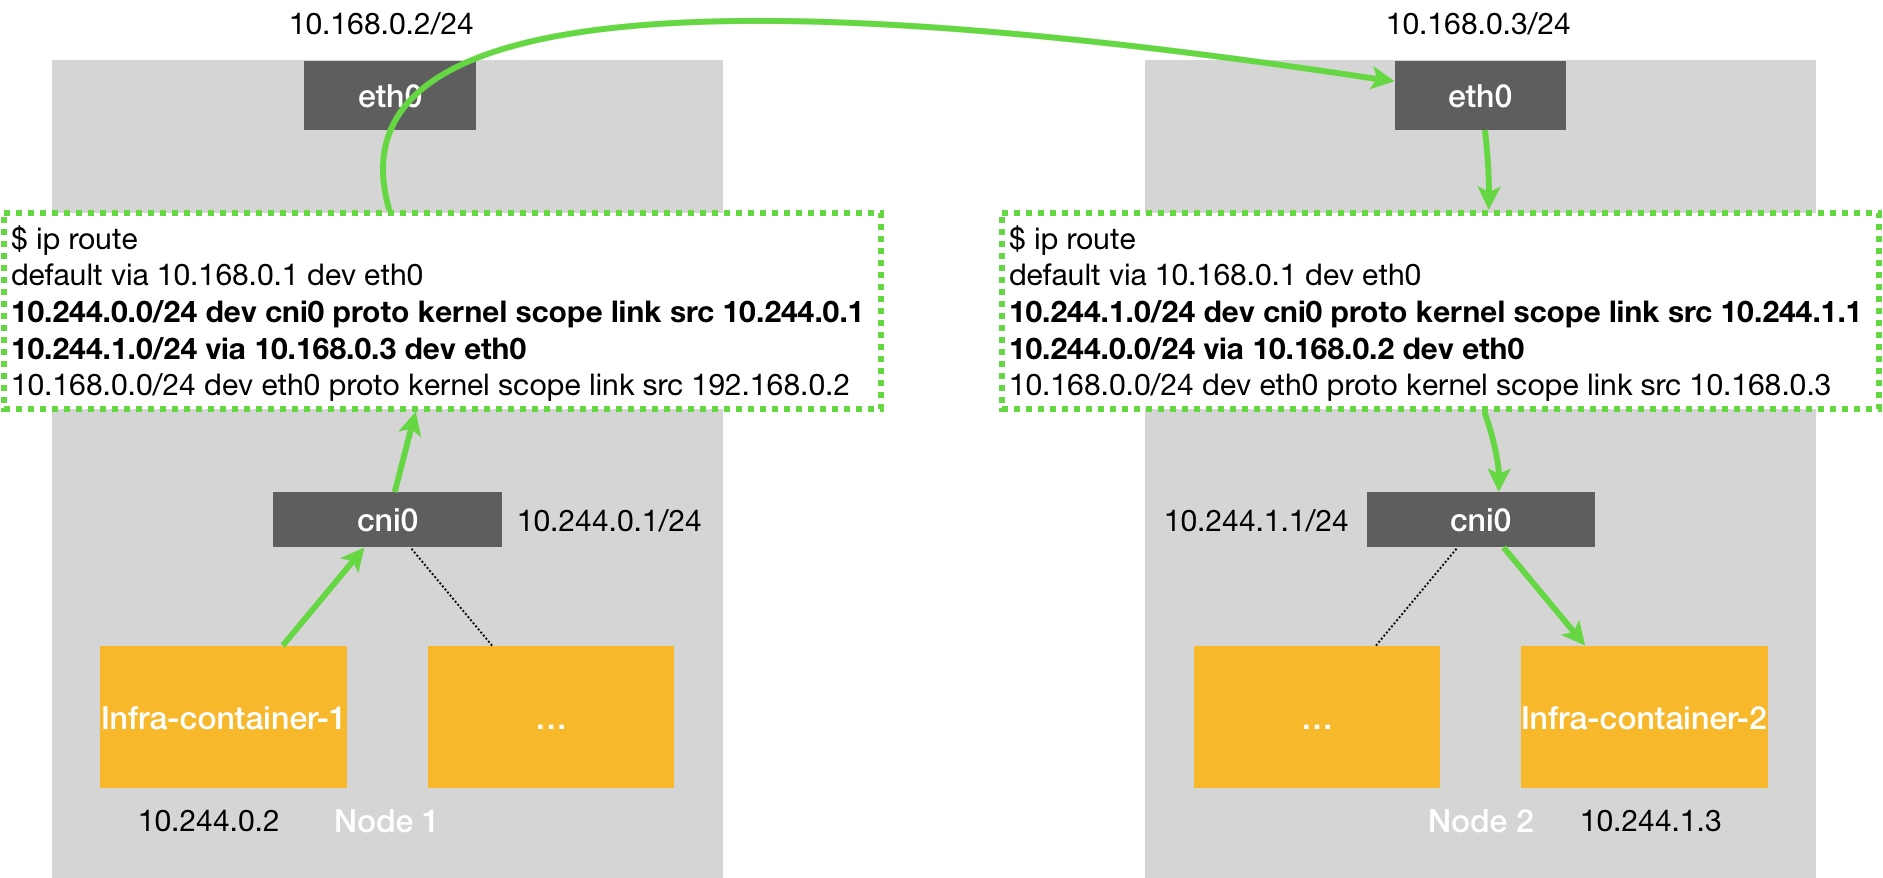
host-gw 模式的工作原理 , 就是将每个Flannel子网的下一跳 , 设置成了该子网对应的宿主机的 IP 地址 , 也就是说 , 宿主机( host) 充当了这条容器通信路径的“网关”( Gateway) , 这正是 host-gw 的含义 所有的子网和主机的信息 , 都保存在 Etcd 中 , flanneld 只需要 watch 这些数据的变化 , 实时更新路由表就行了。 核心是IP包在封装成桢的时候 , 使用路由表的“下一跳”设置上的MAC地址 , 这样可以经过二层网络到达目的宿主机。
另外 , 如果两个 pod 所在节点在同一个网段中 , 可以让 VxLAN 也支持 host-gw 的功能 , 即直接通过物理网卡的网关路由转发 , 而不用隧道~叠加 , 从而提高了 VxLAN 的性能 , 这种 flannel 的功能叫 directrouting。
2.4 Flannel 通信过程描述
以 UDP 模式为例 , 跨主机容器间通信过程如下图所示:
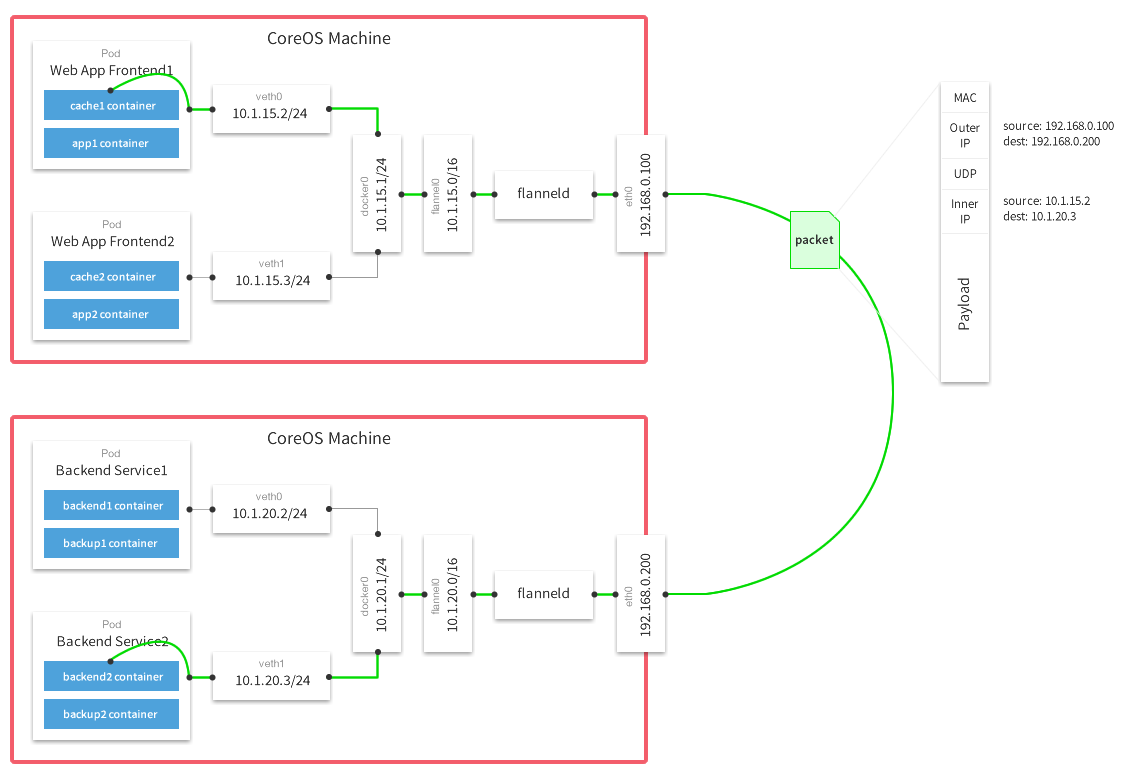
上图是 Flannel 官网提供的在 UDP 模式下一个数据包经过封包、传输以及拆包的示意图 , 从这个图片中可以看出两台机器的 docker0 分别处于不同的段: 10.1.20.1/24 和 10.1.15.1/24 , 如果从 Web App Frontend1 pod( 10.1.15.2) 去连接另一台主机上的 Backend Service2 pod( 10.1.20.3) , 网络包从宿主机 192.168.0.100 发往 192.168.0.200 , 内层容器的数据包被封装到宿主机的 UDP 里面 , 并且在外层包装了宿主机的 IP 和 mac 地址。这就是一个经典的 ~ 网络 , 因为容器的 IP 是一个内部 IP , 无法从跨宿主机通信 , 所以容器的网络互通 , 需要承载到宿主机的网络之上。
以 VxLAN 模式为例。
在源容器宿主机中的数据传递过程:
源容器向目标容器发送数据 , 数据首先发送给
docker0网桥在源容器内容查看路由信息 :
$ kubectl exec -it -p {Podid} -c {ContainerId} -- ip routedocker0网桥接受到数据后 , 将其转交给flannel.1虚拟网卡处理docker0收到数据包后 ,docker0的内核栈处理程序会读取这个数据包的目标地址 , 根据目标地址将数据包发送给下一个路由节点: 查看源容器所在Node的路由信息:$ ip routeflannel.1接受到数据后 , 对数据进行封装 , 并发给宿主机的eth0flannel.1收到数据后 ,flannel id会将数据包封装成二层以太包。Ethernet Header的信息:From: {源容器flannel.1虚拟网卡的MAC地址}To: {目录容器flannel.1虚拟网卡的MAC地址}
对在
flannel路由节点封装后的数据 , 进行再封装后 , 转发给目标容器Node的eth0;由于目前的数据包只是
vxlan tunnel上的数据包 , 因此还不能在物理网络上进行传输。因此 , 需要将上述数据包再次进行封装 , 才能源容器节点传输到目标容器节点 , 这项工作在由linux内核来完成。Ethernet Header的信息:From:{源容器Node节点网卡的MAC地址}To:{目录容器Node节点网卡的MAC地址}
IP Header的信息:From:{源容器Node节点网卡的IP地址}To:{目录容器Node节点网卡的IP地址}
通过此次封装 , 就可以通过物理网络发送数据包。
在目标容器宿主机中的数据传递过程:
目标容器宿主机的
eth0接收到数据后 , 对数据包进行拆封 , 并转发给flannel.1虚拟网卡;
flannel.1虚拟网卡接受到数据 , 将数据发送给docker0网桥;最后 , 数据到达目标容器 , 完成容器之间的数据通信。
3. Container Runtime 与 CNI 插件的交互
每个 network provider 都有一个 CNI 插件 , container runtime 会调用该插件 , 在 Pod 启动时配置网络。使用容器化作为 container runtime , 容器化 CRI 插件将调用 CNI 插件。每个 network provider 都在每个 Kubernetes 节点上安装了一个代理 , 以配置 Pod 网络。安装 network provider agent 后 , 它会随 CNI 一起配置或者在节点上创建 , CRI 插件会使用它来确定要调用哪个 CNI 插件。
CNI 配置文件的位置是可配置的 , 默认值为 /etc/cni/net.d/<config-file>。集群管理员需要在每个节点上交付 CNI 插件。CNI 插件的位置也是可配置的 , 默认值为 /opt/cni/bin。
如果使用 containerd 作为 container runtime , 则可以在 containerd config 部分下 [plugins."io.containerd.grpc.v1.cri".cni] 指定 CNI 配置和 CNI 插件的路径。
本文中我们将 Flannel 作为 network provider , 这里简单介绍一下 Flannel 的设置。Flanneld 是 Flannel 守护程序 , 通常 install-cni 作为带有初始化容器的守护程序安装在 Kubernetes 集群上。install-cni 容器创建 CNI 配置文件在每个节点上 /etc/cni/net.d/10-flannel.conflist。Flanneld 创建一个 vxlan 设备 , 从 apiserver 获取网络元数据 , 并监控 Pod 上的更新。创建 Pod 时 , 它将在整个集群中为所有 Pod 分配路由 , 这些路由允许 Pod 通过 IP 地址相互连接。
Containerd CRI 插件和 CNI 插件之间的交互可以如下所示 :
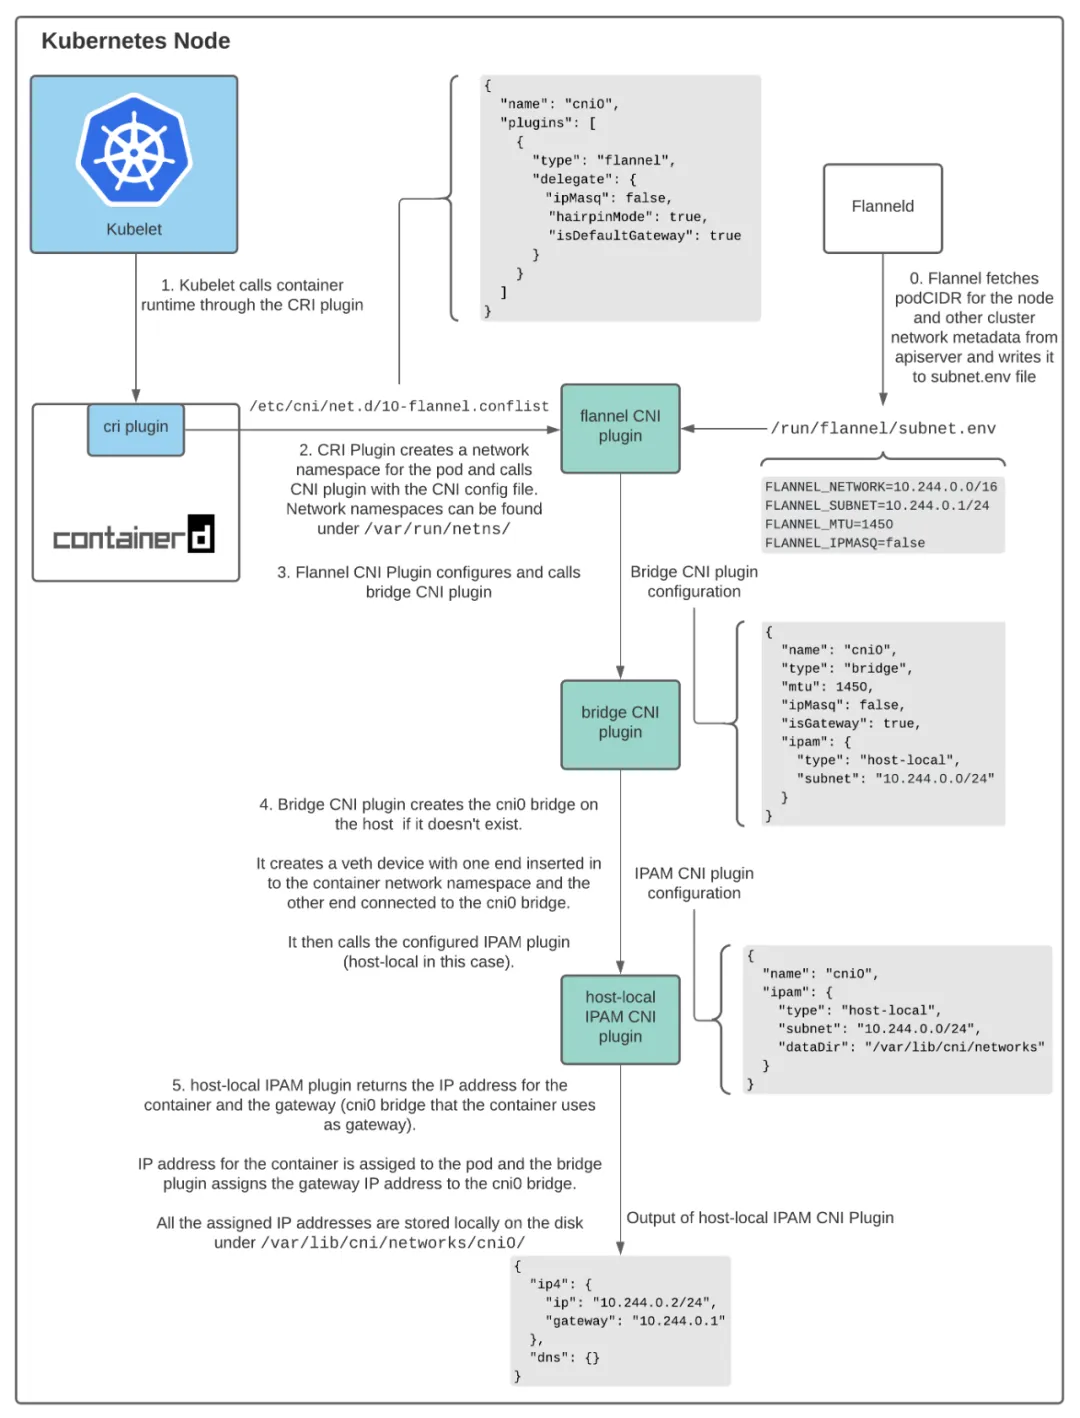
有多种 CNI 插件可帮助配置主机上容器之间的网络 , 本文主要讨论以下 3 个插件。
3.1 Flannel CNI 插件
当使用 Flannel 作为 network provider 时 , Containered CRI 插件使用 CNI 配置文件 , 调用 Flannel CNI 插件:/etc/cni/net.d/10-flannel.conflist。
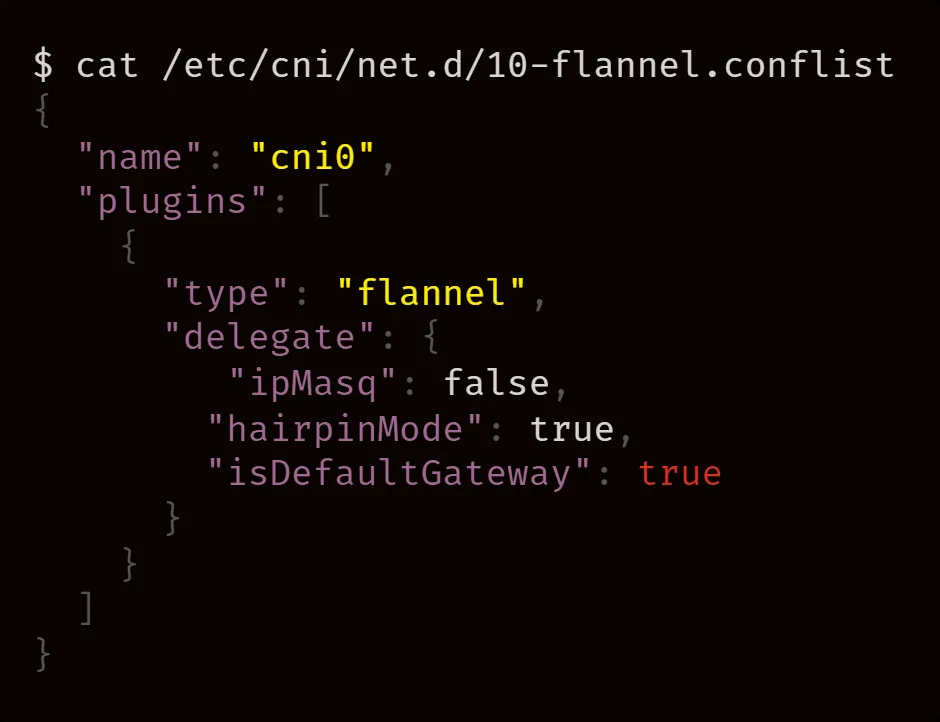
Fannel CNI 插件与 Flanneld 结合使用 , 当 Flanneld 启动时 , 它将从 apiserver 中获取 podCIDR 和其他与网络相关的详细信息 , 并将它们存储在文件中/run/flannel/subnet.env。
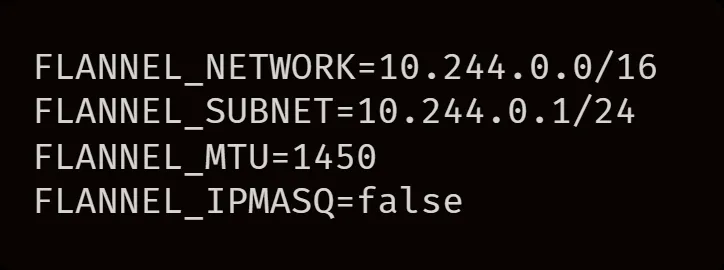
Flannel CNI 插件使用 /run/flannel/subnet.env 的信息来配置和调用 Bridge CNI 插件。
3.2 Bridge CNI 插件
Flannel CNI 插件使用以下配置调用 Bridge CNI 插件 :
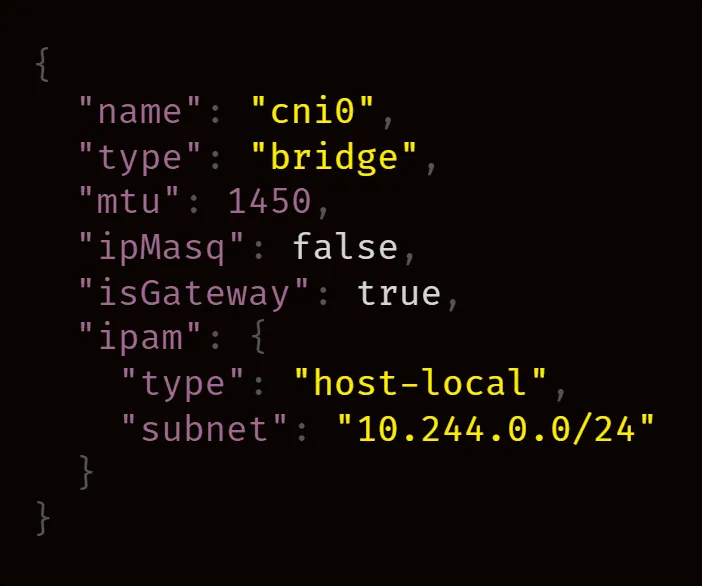
当 Bridge CNI 插件第一次调用时 , 它会创建一个 Linux Bridge "name": "cni0" 在配置文件中 , 然后为每个 Pod 创建 veth pair , 其一端在容器的网络命名空间中 , 另一端连接到主机网络上的 Linux Bridge。使用 Bridge CNI 插件 , 主机上的所有容器都连接到主机网络上的 Linux Bridge。
配置完 veth pair 后 , Bridge 插件将调用主机本地 IPAM CNI 插件。我们可以在 CNI config 中配置要使用的 IPAM 插件 , CRI 插件用于调用 Flannel CNI插件。
3.2 主机本地 IPAM CNI 插件
Bridge CNI 插件使用以下配置调用主机本地 IPAM CNI 插件:
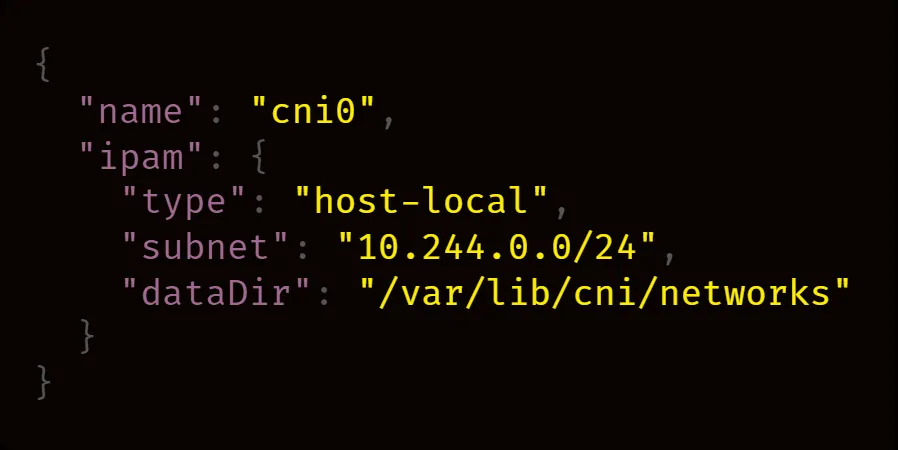
主机本地 IPAM( IP 地址管理) 插件从中返回容器的 IP 地址 , subnet将分配的 IP 本地存储在主机下dataDir指定的目录中/var/lib/cni/networks/<network-name=cni0>/<ip>
/var/lib/cni/networks/<network-name=cni0>/<ip>文件包含 IP 分配到的容器 ID。
调用时 , 主机本地 IPAM 插件返回以下有效负载:
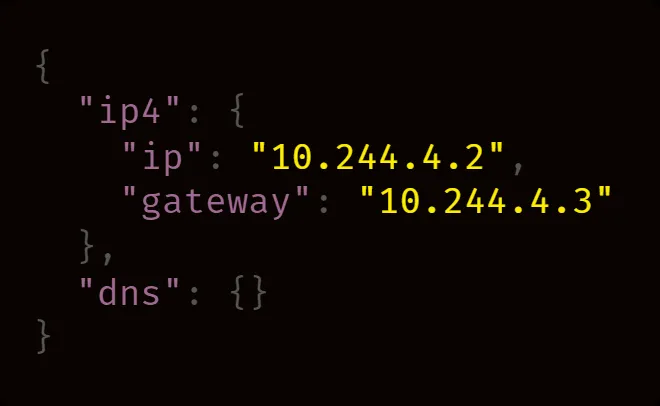
Kube-controller-manager 为每个节点分配一个 podCIDR。从 podCIDR 中的子网值为节点上的 Pod 分配了 IP 地址。由于所有节点上的 podCIDR 是不相交的子网 , 因此它允许为每个 pod 分配唯一的IP地址。
Kubernetes 集群管理员可配置和安装 kubelet、container runtime、network provider , 并在每个节点上分发 CNI 插件。Network provider agent 启动时 , 将生成 CNI 配置。在节点上调度 Pod 后 , kubelet 会调用 CRI 插件来创建 Pod。在容器情况下 , 容器的 CRI 插件调用 CNI 配置中指定的 CNI 插件来配置 Pod 网络。所有这些都会影响 Pod 获取 IP地址。
4. Flannel配置
4.1 环境搭建
Kubernetes 集群使用 k8s 发行版 , 但在安装集群的时候 , 禁用 k8s 集成的 flannel , 使用独立安装的 flannel 进行验证。
安装 CNI 的 plugin , 需要在所有的 node 节点上执行下面的命令 , 下载 CNI 的官方 bin。
sudo mkdir -p /opt/cni/bin
curl -sSL https://github.com/containernetworking/plugins/releases/download/v1.1.1/cni-plugins-linux-amd64-v1.1.1.tgz | sudo tar -zxf - -C /opt/cni/bin
安装 k3s 的控制平面。
export INSTALL_K3S_VERSION=v1.23.8+k3s2
curl -sfL https://get.k3s.io | sh -s - --disable traefik --flannel-backend=none --write-kubeconfig-mode 644 --write-kubeconfig ~/.kube/config
安装 Flannel。这里注意 , Flannel 默认的 Pod CIRD 是 10.244.0.0/16 , 我们将其修改为 k3s 默认的 10.42.0.0/16。
curl -s https://raw.githubusercontent.com/flannel-io/flannel/master/Documentation/kube-flannel.yml | sed 's|10.244.0.0/16|10.42.0.0/16|g' | kubectl apply -f -添加另一个节点到集群。
export INSTALL_K3S_VERSION=v1.23.8+k3s2
export MASTER_IP=<MASTER_IP>
export NODE_TOKEN=<TOKEN>
curl -sfL https://get.k3s.io | K3S_URL=https://${MASTER_IP}:6443 K3S_TOKEN=${NODE_TOKEN} sh -
查看节点状态。
kubectl get node
NAME          STATUS   ROLES                  AGE   VERSION
ubuntu-dev3   Ready    <none>                 13m   v1.23.8+k3s2
ubuntu-dev2   Ready    control-plane,master   17m   v1.23.8+k3s2
运行两个 pod:curl 和 httpbin , 为了探寻
NODE1=ubuntu-dev2
NODE2=ubuntu-dev3
kubectl apply -n default -f - <<EOF
apiVersion: v1
kind: Pod
metadata:
  labels:
    app: curl
  name: curl
spec:
  containers:
  - image: curlimages/curl
    name: curl
    command: ["sleep", "365d"]
  nodeName: $NODE1
---
apiVersion: v1
kind: Pod
metadata:
  labels:
    app: httpbin
  name: httpbin
spec:
  containers:
  - image: kennethreitz/httpbin
    name: httpbin
  nodeName: $NODE2
EOF
4.2 网络配置
接下来 , 一起看下 CNI 插件如何配置 pod 网络。
4.2.1 初始化
Flannel 是通过 Daemonset 的方式部署的 , 每台节点上都会运行一个 flannel 的 pod。通过挂载本地磁盘的方式 , 在 Pod 启动时会通过初始化容器将二进制文件和 CNI 的配置复制到本地磁盘中 , 分别位于 /opt/cni/bin/flannel 和 /etc/cni/net.d/10-flannel.conflist。
通过查看 kube-flannel.yml 中的 ConfigMap , 可以找到 CNI 配置 , flannel 默认委托( 见 flannel-cni 源码 flannel_linux.go#L78) 给 bridge 插件 进行网络配置 , 网络名称为 cbr0;IP 地址的管理 , 默认委托( 见 flannel-cni 源码 flannel_linux.go#L40) host-local 插件完成。
#cni-conf.json 复制到 /etc/cni/net.d/10-flannel.conflist
{
  "name": "cbr0",
  "cniVersion": "0.3.1",
  "plugins": [
    {
      "type": "flannel",
      "delegate": {
        "hairpinMode": true,
        "isDefaultGateway": true
      }
    },
    {
      "type": "portmap",
      "capabilities": {
        "portMappings": true
      }
    }
  ]
}
还有 Flannel 的网络配置 , 配置中有我们设置的 Pod CIDR 10.42.0.0/16 以及后端( backend) 的类型 vxlan。这也是 flannel 默认的类型 , 此外还有 多种后端类型可选 , 如 host-gw、wireguard、udp、Alloc、IPIP、IPSec。
#net-conf.json 挂载到 pod 的 /etc/kube-flannel/net-conf.json
{
  "Network": "10.42.0.0/16",
  "Backend": {
    "Type": "vxlan"
  }
}

root@k8s-node01:~# cat /var/lib/kubelet/pods/61fc0ae8-b432-4290-9ab7-8ab78f249281/volumes/kubernetes.io~configmap/flannel-cfg/net-conf.json
{
  "Network": "172.20.0.0/16",
  "Backend": {
    "Type": "vxlan"
  }
}
Flannel Pod 运行启动 flanneld 进程 , 指定了参数 --ip-masq 和 --kube-subnet-mgr , 后者开启了 kube subnet manager 模式。
这里通过修改net-conf.json配置文件, 调整flannel协议
{
      "Network": "10.244.0.0/16",
      "Backend": {
        "Type": "vxlan",
        "Directrouting": true #加一行这个
      }
    }
4.2.2 运行
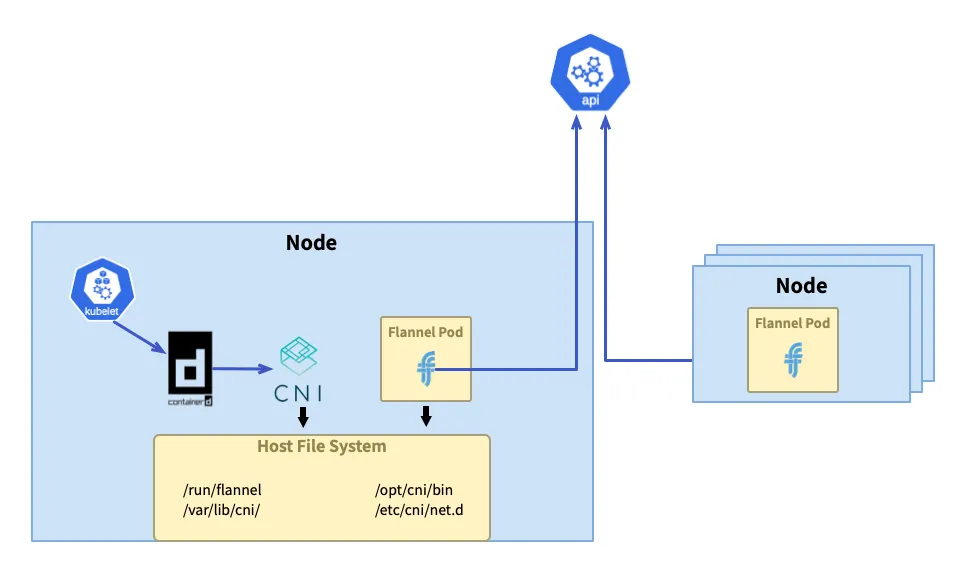
集群初始化时使用了默认的 Pod CIDR 10.42.0.0/16,当有节点加入集群,集群会从该网段上为节点分配 属于节点的 Pod CIDR 10.42.X.1/24。
flannel 在 kube subnet manager 模式下,连接到 apiserver 监听节点更新的事件,从节点信息中获取节点的 Pod CIDR。
kubectl get no ubuntu-dev2 -o jsonpath={.spec} | jq
{
  "podCIDR": "10.42.0.0/24",
  "podCIDRs": [
    "10.42.0.0/24"
  ],
  "providerID": "k8s://ubuntu-dev2"
}
然后在主机上写子网配置文件,下面展示的是其中一个节点的子网配置文件的内容。另一个节点的内容差异在 FLANNEL_SUBNET=10.42.1.1/24,使用的是对应节点的 Pod CIDR。
#node 192.168.1.12
cat /run/flannel/subnet.env
FLANNEL_NETWORK=10.42.0.0/16
FLANNEL_SUBNET=10.42.0.1/24
FLANNEL_MTU=1450
FLANNEL_IPMASQ=true
4.3 CNI插件执行
CNI 插件的执行是由容器运行时触发的
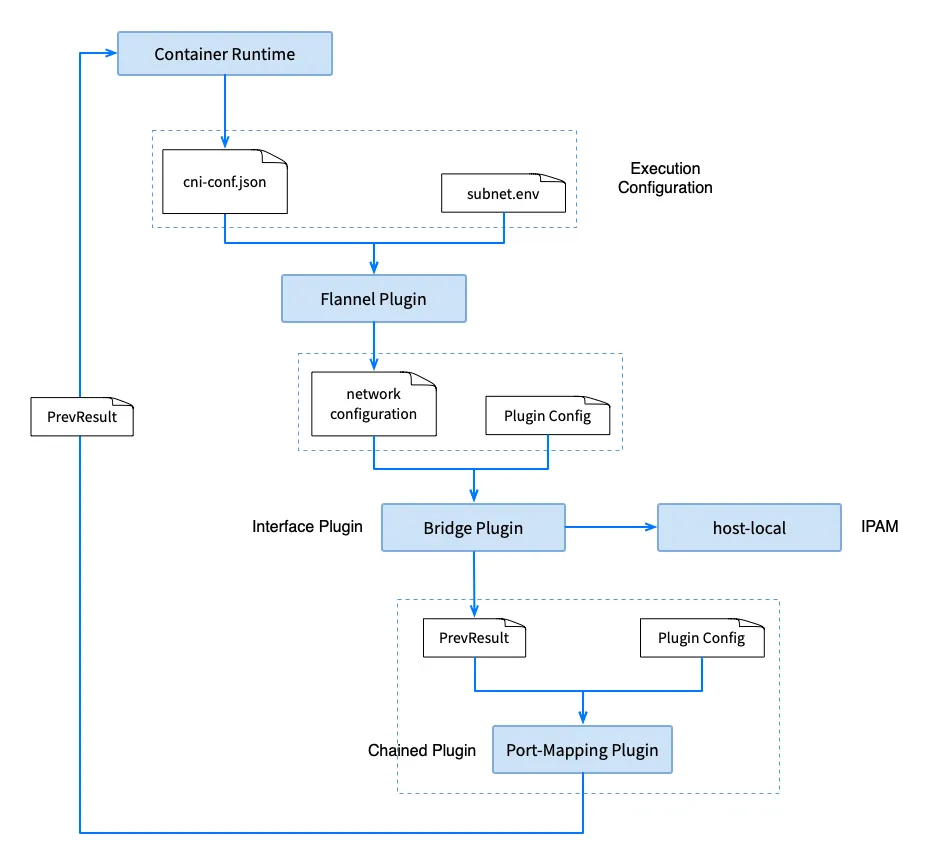
flannel CNI 插件( /opt/cni/bin/flannel) 执行的时候,接收传入的 cni-conf.json,读取上面初始化好的 subnet.env 的配置,输出结果,委托给 bridge 进行下一步。
cat /var/lib/cni/flannel/e4239ab2706ed9191543a5c7f1ef06fc1f0a56346b0c3f2c742d52607ea271f0 | jq
{
  "cniVersion": "0.3.1",
  "hairpinMode": true,
  "ipMasq": false,
  "ipam": {
    "ranges": [
      [
        {
          "subnet": "10.42.0.0/24"
        }
      ]
    ],
    "routes": [
      {
        "dst": "10.42.0.0/16"
      }
    ],
    "type": "host-local"
  },
  "isDefaultGateway": true,
  "isGateway": true,
  "mtu": 1450,
  "name": "cbr0",
  "type": "bridge"
}
4.3.1 bridge 插件
bridge 使用上面的输出连同参数一起作为输入,根据配置完成如下操作:
创建网桥
cni0( 节点的根网络命名空间)创建容器网络接口
eth0(pod网络命名空间)创建主机上的虚拟网络接口
vethX( 节点的根网络命名空间)将
vethX连接到网桥cni0委托
ipam插件分配IP地址、DNS、路由将
IP地址绑定到pod网络命名空间的接口eth0上检查网桥状态
设置路由
设置
DNS
最后输出如下的结果:
cat /var/li/cni/results/cbr0-a34bb3dc268e99e6e1ef83c732f5619ca89924b646766d1ef352de90dbd1c750-eth0 | jq .result
{
  "cniVersion": "0.3.1",
  "dns": {},
  "interfaces": [
    {
      "mac": "6a:0f:94:28:9b:e7",
      "name": "cni0"
    },
    {
      "mac": "ca:b4:a9:83:0f:d4",
      "name": "veth38b50fb4"
    },
    {
      "mac": "0a:01:c5:6f:57:67",
      "name": "eth0",
      "sandbox": "/var/run/netns/cni-44bb41bd-7c41-4860-3c55-4323bc279628"
    }
  ],
  "ips": [
    {
      "address": "10.42.0.5/24",
      "gateway": "10.42.0.1",
      "interface": 2,
      "version": "4"
    }
  ],
  "routes": [
    {
      "dst": "10.42.0.0/16"
    },
    {
      "dst": "0.0.0.0/0",
      "gw": "10.42.0.1"
    }
  ]
}
4.3.2 port-mapping 插件
该插件会将来自主机上一个或多个端口的流量转发到容器。
4.4 Debug
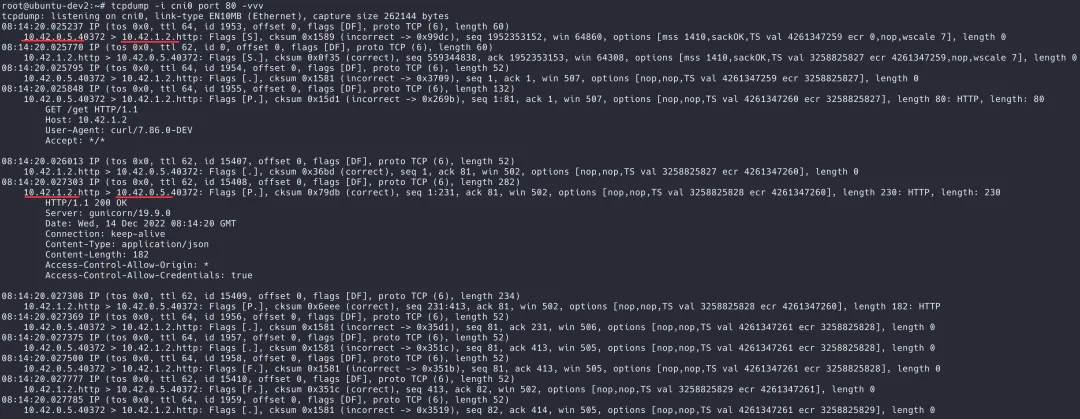
让我们在第一个节点上,使用 tcpdump 对接口 cni0 进行抓包。
tcpdump -i cni0 port 80 -vvv从 pod curl 中使用 pod httpbin 的 IP 地址 10.42.1.2 发送请求:
kubectl exec curl -n default -- curl -s 10.42.1.2/get4.4.1 cni0
从在 cni0 上的抓包结果来看,第三层的 IP 地址均为 Pod 的 IP 地址,看起来就像是两个 pod 都在同一个网段。
4.4.2 host eth0
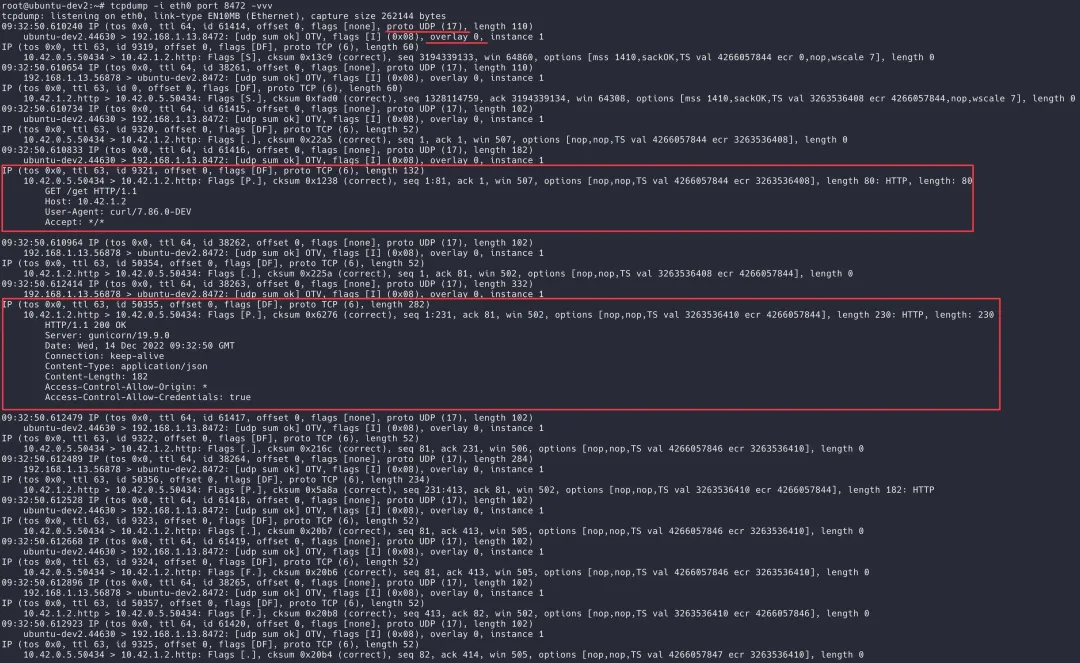
文章开头提到 flanneld 监听 udp 8472 端口。
netstat -tupln | grep 8472
udp        0      0 0.0.0.0:8472            0.0.0.0:*                           -
我们直接在以太网接口上抓取 UDP 的包:
tcpdump -i eth0 port 8472 -vvv再次发送请求,可以看到抓取到 UDP 数据包,传输的负载是二层的封包。
参考链接
循序渐进理解CNI机制与Flannel工作原理 :: Yingchi Blog
Kubernetes Pod 是如何获取 IP 地址的? (qq.com)