
3-14-1-kubernetes系统扩展
Kubernetes功能强大且原生支持多种扩展机制 : 一是内部组件API Server支持基于Webhook的认证、授权和准入控制扩展、CRD、自定义控制器 , 甚至是自定义的API Server ; 二是kubelet支持的CNI、CRI、 CSI和Device Plugins ; 三是调度器基于调度框架支持的调度插件扩展 等 , 另外还及Service Catalog , 以及自定义控制器和Operator等 , 这 类扩展可概括为能够与Kubernetes深度集成且扩展了其功能的软件程 序。另一方面 , 消除集群的单点以实现集群高可用是将Kubernetes部 署到生产环境时必然要求。本章主要介绍CRD、自定义控制器及控制平 面高可用等相关的话题。
1. CRD
尽管Kubernetes API内置的众多功能性基础资源类型能解决多数场景中的应用编排需求 , 但也存在需要专用或更高级别资源抽象的需求 , 例如将特定应用的管理逻辑转换为与Kubernetes API兼容的资源格式 , 或者把Kubernetes的多个标准资源对象合并为一个单一、原子 的、更高级别的资源抽象等。这类的API扩展抽象需要兼容Kubernetes API的基本特性 , 例如支持kubectl管理工具、CRUD及watch机制、标签、etcd存储、认证、授权、RBAC及审计等 , 从而为用户提供一个风格一致的管理接口 , 使得用户可将精力集中在构建业务逻辑本身。
目前 , 扩展Kubernetes API的常用方式有3种 : 使用CRD自定义资源类型、开发自定义的API Server并聚合至主API Server , 以及定制 扩展API Server源码。其中 , CRD最为易用但限制颇多 , 自定义API Server更富于弹性但代码工作量偏大 , 仅在必须添加新的核心类型才 能确保专用的Kubernetes集群功能正常 , 才应该定制系统源码。
我们可以把Kubernetes API Server看作是一个 JSON方案的数据库存储系统 ,它内置了众多数据模式(资源类型)。从这个角度进行类比 , CRD就像是由用户为Kubernetes存储系统提供的 自定义数据模式 , 用户可基于这些模式实例化数据项 , 且从用户的角度来看 , 它们与内置的数据模式几乎没有区别。
CRD并非用来取代Kubernetes的原生资源类型 , 而是作为一种更为 灵活、高级、简单易用的自定义API资源的补充方式。虽然目前在功能 上仍存在着不少的局限 , 但对于大多数的需求场景而言 , CRD的表现已经足够好 , 因此在满足需求的前提下是首选的API资源类型扩展方式。
1.1 CRD基础应用
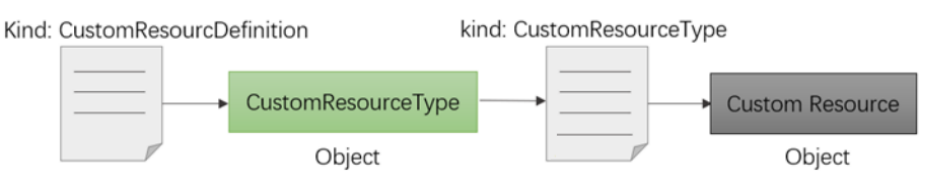
CRD自Kubernetes v1.7版引入 , 并自v1.8版本起完全取代其前身 TPR(ThirdParty-Resources) , 它的设计目标是无须修改Kubernetes 源代码即可使用新的自定义API资源类型。CRD自身也是一种资源类 型 , 但该资源类型实例化出的资源对象会被视作一种新的自定义资源类型(可隶属于集群或名称空间级别) , 并会在API上注册生成GVR类型URL端点。因而 , 对于CRD规范创建出新的资源类型(CR)来说 , 用户可根据该资源类型规范再创建出资源对象 , 如图所示。只不过 , 前者通常由集群管理员或某特定项目进行维护 , 而后者则由集群 用户使用 , 例如此前部署的CNI项目Calico就通过CRD将其API映射为 Kubernetes的API资源。
Kubernetes自1.9版本起支持为CRD定义验证机制 , 以定义CRD可用有效字段等 , 这在将设计的自定义资源公开应用时非常重要。自定义 资源使用OpenAPI模式声明验证规则 , 该模式是JSON模式的子集 , 这说明 , OpenAPI规范并不能支持JSON规范的所有功能 , 而CRD验证也不能支持OpenAPI规范的所有功能 , 但对大多数情况来说已经足够使用。
CRD隶属于集群级别 , 创建出来的自定义资源类型的作用域 (scope)可属于集群级别 , 也可仅作用于名称空间。下面是CRD资源规范v1版本的基础格式和简要说明
apiVersion: apiextensions.k8s.io/v1 # API群组和版本
kind: CustomResourceDefinition # 资源类别
metadata:
 name <string> # 资源名称
spec:
  conversion <Object> # 定义不同版本间的格式转换方式
    strategy <string> # 不同版本间的自定义资源转换策略 , 有None和Webhook两种取值
    webhook <Object> # 设置如何调用Webhook
group <string> # 资源所属的API群组
names <Object> # 自定义资源的类型 , 即该CRD创建资源规范时使用的kind
  categories <[]string> # 资源所属的类别编目 , 例如kubectl get all中的all
  kind <string> # kind名称 , 必选字段
  listKind <string> # 资源列表名称 , 默认为"'kind'List"
  plural <string> # 复数形式 , 用于设置API路径'/apis/<group>/<version>/.../<plural>'
  shortNames <[]string> # 该资源的kind的缩写格式
  singular <string> # 资源kind的单数形式 , 必须使用全小写字母 , 默认为小写的kind名称
preserveUnknownFields <boolean> # 预留的非知名字段 , kind等都是知名的预留字段
scope <string> # 作用域 , 可用值为Cluster和Namespaced
versions <[]Object> # 版本号定义
  additionalPrinterColumns <[]Object> # 需要返回的额外信息
  name <string> # 形如vM[alphaN|betaN]格式的版本名称 , 例如v1或v1alpha2等
  schema <Object> # 该资源的数据格式 ( schema ) 定义 , 必选字段
    openAPIV3Schema <Object> # 用于校验字段的schema对象 , 格式请参考相关手册
  served <boolean> # 是否允许通过RESTful API调用该版本 , 必选字段
  storage <boolean> # 将自定义资源存储在etcd中时是不是使用该版本
  subresources <Object> # 子资源定义
    scale <Object> # 启用scale子资源 , 通过
autoscaling/v1.Scale发送负荷
  status <map[string]> # 启用status子资源 , 为资源生成/status端点
下面的示例清单 ( crd-v1-user.yaml ) 定义了一个名为 users.auth.ilinux.io的CRD资源对象 , 它隶属于auth.ilinux.io群 组 , 仅支持v1alpha1一个版本 , 作用域为名称空间 , 资源类型名称为 User , 支持users这一复数形式和u这一简写形式。
apiVersion: apiextensions.k8s.io/v1
kind: CustomResourceDefinition
metadata:
name: users.auth.ilinux.io
spec:
group: auth.ilinux.io
names:
kind: User # 资源类型标识符
plural: users # 复数形式
singular: user # 单数形式
shortNames: # 简写格式
- u
scope: Namespaced
versions:
- served: true
storage: true
name: v1alpha1
schema: # 该自定义资源类型下的数据格式定义
openAPIV3Schema:
type: object # 仅要注册其数据为对象格式 , 并未限制具体可用的字段及取值等
properties: # 支持的字段 , 仅定义了一个spec字段
spec: # 该CRD支持的spec字段的定义
type: object # spec的数据类型
properties: # spec可内嵌的字段
userID: # 内嵌字段1
type: integer # 字段的数据类型
minimum: 1
maximum: 65535
groups: # 内嵌字段2
type: array
items: # 列表项格式定义
type: string # 列表项的数据类型
email: # 内嵌字段3
type: string
password: # 内嵌字段4
type: string
format: password # 密码格式的数据
required: ["userID","groups"] # 指定上述字段中的必选字段
将清单中的CRD资源创建到集群中便会生成一个CRD格式的自定义 资源对象 , 该自定义资源对象同时代表着一种新的资源类型 , 它的类 型(kind)标识为User。
~$ kubectl apply -f crd-v1-user.yaml
customresourcedefinition.apiextensions.k8s.io/users.auth.ilinux.io created
~$ kubectl get users -n default
No resources found in default namespace.
显然 , User已然是一个名称空间级别的可用资源类型 , 它位于API 群组auth.ilinux.io/v1alpha1之中 , 用户可根据该资源类型的数据方案(schema)创建出任意数量的User类型资源对象。下面就是一个 User资源清单 , 它定义了一个名为admin的User对象。
apiVersion: auth.ilinux.io/v1alpha1
kind: User
metadata:
  name: admin
  namespace: default
spec:
  userID: 1
  email: mage@magedu.com
  groups:
  - superusers
  - adminstrators
password: ikubernetes.io资源创建完成后即可使用User作为类型标识 , 并使用kubectl命令 进行资源对象的管理 , 包括查看、删除、修改等操作。例如 , 将清单 中的自定义资源创建到名称空间中 , 而后使用类似如下命令获取相关 状态信息 :
~$ kubectl apply -f user-crd-demo.yaml
user.auth.ilinux.io/admin created
~$ kubectl get users/admin
NAME      AGE
admin 3s根据API对象GVR格式的URL规范 , 它的对象在API上的URL路径前缀为/apis/auth.ilinux.io/v1beta1/namespace/NS_NAME/users/ , 因此 User资源对象admin的引用路径 为/apis/auth.ilinux.io/v1beta1/namespaces/default/users/admin , 如下面的命令结果所示。
~$ kubectl get users/admin -o jsonpath={.metadata.selfLink}
/apis/auth.ilinux.io/v1alpha1/namespaces/default/users/admin
由此可见 , 基于CRD创建的自定义资源类型下的自定义资源与API Server内置资源类型在使用和管理接口上保持了一致的使用体验。
1.2 打印字段与资源类别
自从Kubernetes 1.11版本开始 , kubectl应用了服务器侧对象信 息打印机制 , 这意味着将由API Server决定kubectl get命令结果会显 示哪些字段。定义CRD资源规范时 , 我们可在 spec.additionalPrinterColumns中嵌套定义计划在对象的详细信息中要打印的字段列表。下面的配置清单片段定义了要为User类型的对象 显示相关的4个字段。
spec:
  versions:
  - ……
    additionalPrinterColumns:
    - name: userID
      type: integer
      description: The user ID.
      jsonPath: .spec.userID
    - name: groups
      type: string
      description: The groups of the user.
      jsonPath: .spec.groups
    - name: email
      type: string
      description: The email address of the user.
jsonPath: .spec.email将上面的资源清单片段合并至前面定义的CRD对象User配置清单的 spec.versions[0]字段中 , 重新应用到集群中并确保其生效即可 , 通 过kubeclt get命令测试生效结果。
~$ kubectl get users
NAME       USERID     GROUPS                     EMAIL
admin      1          [superusers adminstrators] mage@magedu.com
显然 , 让用户在自定义的User资源中使用password字段以明文格 式保存敏感的密码信息并非好的选择 , 生产实践中 , 敏感信息应该使 用Secret对象保存密钥信息 , 并在自定义资源对象中进行引用。
而资源类别是Kubernetes自v1.10版本引入的一种以分组形式组织 自定义资源的方法 , 在定义CRD对象时为其指定一个或多个类别 , 便能 够通过kubectl get 命令列出该类别中的所有自定义资源对象 , all是一个常用的内置资源类别。例如 , 为前面定义的CRD 对象users的spec.names字段中额外内嵌如下配置 , 便能使得users资源类型下的所有对象隶属于all类别。
spec:
  names:
    categories:
- allcategories字段的值是自定义资源所属的分组资源列表。而后 , 创建的所有users对象都能够通过kubectl get all命令获取。
~$ kubectl get all
……
NAME                       USERID           GROUPS                      EMAIL
user.auth.ilinux.io/admin  1                [superusers administrators] mage@magedu.com
1.3 CRD子资源
可能有读者已经注意到 , 前面自定义资源User/admin在其详细状态信息输出中没有类似核心资源的status字段 , 该字段是一种用于保 存对象当前状态的子资源。我们知道 , 在Kubernetes系统的声明式API 中 , status字段由Kubernetes系统自行维护 , 相关的控制器在调谐循 环中持续与API Server进行通信 , 并负责确保status字段中的实际状态匹配spec字段中定义的期望状态。
Kubernetes在v1.10版本之前 , 自定义资源的API端点并不区分 spec和status字段 , 而自v1.10版本起 , 自定义资源开始支持通 过/status子资源的方式提供对象的当前状态 , 虽然它仍然不会直接将 获取的状态信息显示在命令结果输出中 , 但客户端可通过对象的子URL 路径来获取状态信息。此特性在v1.16版本中已经升级至stable级别。
在CRD中为自定义资源启用status字段的方式非常简单 , 我们只需 要在相应的versions中内嵌空值的subresources.status字段即可 , 内部相关的字段则由系统自行维护 , 用户无须提供任何额外配置。它的 使用格式如下 :
spec:
  versions:
  - ……
    subresources:
status: {}完整的代码保存在crd-v1-user-with-status.yaml文件中 , 以 kubectl apply命令将其合并至集群上的CRD对象users之上以完成活动对象的修改 , 如此即可在其实例化出的对象上通过/status获取状态信 息。以User/admin资源为例 , 它的状态信息无法直接通过资源规范中的.status字段获取 , 但能够通过子资源的URL路径/apis/auth.ilinux.io/v1alpha1/namespaces/default/users/admin/status加以引用 , 如下面的命令及结果所示。
~$ kubectl get --
raw="/apis/auth.ilinux.io/v1alpha1/namespaces/default/users/admin
/status" | jq .
{
 "apiVersion": "auth.ilinux.io/v1alpha1",
 "kind": "User",
 ……
}
我们知道 , Kubernetes的声明式API上业务逻辑的实现依赖资源相 关的控制器代码 , 而当前集群上并没有任何控制器负责通过调谐循环 获取各users资源的实时状态并存储在status字段中 , 因而 , users活动对象状态的非计划内变动既不能实时反映到其status中 , 也不会自动向spec定义的期望状态逼近。
事实上 , 如果有相应的资源控制器维护自定义资源类型时 , 我们 还可在配置自定义资源对象时通过scale子资源和status子资源协同 , 实现类似Deployment或StatefulSet等控制器作用下的对象规模自动伸 缩功能。scale子资源的定义格式如下 :
spec:
  versions:
  - ……
    subresources:
      status: {}
      scale:
        labelSelectorPath <string> # 自定义资源中用于判断资源规模的标签选择器字段
        specReplicasPath <string> # 用于定义资源副本数的字段
        statusReplicasPath <string> # 保存在当前副本数的字段
需要注意的是 , scale字段必须与status字段一起使用 , 由控制器 通过status获取对象当前的副本数量 , 并与spec字段内嵌套的用于指 定副本数量的字段(例如常用的replicas)进行比较来确定其所需要执行的伸缩操作 , 而后将伸缩操作的结果更新至status字段中。上面配置格式中 , scale的各内嵌字段的详细功用说明如下。
labelSelectorPath: 可选字段 , 但若要与HPA结合使 用则是必选字段 , 用于引用status中的标签选择器字段 ,jsonPath格式 , 例如.status.labelSelector;specReplicasPath: 引用定义在spec中表示期望的副本数量的字段 ,jsonPath格式 , 例如.spec.replicas。statusReplicasPath: 引用保存在status中表示对象当前副本数量的字段 ,jsonPath格式 , 例如.status.replicas。
为某CRD资源定义scale子资源后 , 即可实例化出支持规模伸缩的 自定义资源对象。但必须存在一个相应的资源控制器来持续维护相应 自定义资源对象 , 以确保其当前状态匹配期望的状态。满足条后 , 使用kubectl scale命令就能完成对自定义资源对象的扩缩容操作。
1.4 CRD v1beta1版本
CRD API目前仍支持v1beta1版本 , 该版本同v1有着不小的差异 , 其中显著区别是v1beta1可使用version字段直接给定单个版本号标 识 , 也可使用versions定义支持多版本 , 但v1beta1版本并不强制要求明确指定自定义资源规范中的各字段 , 即便要定义 , 它也是通过独立的.spec.validation字段进行。下面的示例是以v1beta1 API重新定义的crd/users资源 , 其中的validation和additionalPrinterColumns为可选字段。
apiVersion: apiextensions.k8s.io/v1beta1
kind: CustomResourceDefinition
metadata:
  name: users.auth.ilinux.io
spec:
  group: auth.ilinux.io
  version: v1alpha1 # 单一版本标识
  versions: # 多版本标识
  - name: v1alpha1
    served: true
    storage: true
  names:
    kind: User
    plural: users
    singular: user
    shortNames:
    - u
  scope: Namespaced
  validation: # 由version标识的版本数据方案
    openAPIV3Schema:
      properties:
        spec:
          properties:
            userID:
              type: integer
              minimum: 1
              maximum: 65535
            groups:
              type: array
            email:
              type: string
            password:
              type: string
              format: password
          required: ["userID","groups"]
  additionalPrinterColumns: # 可由kubectl get打印的其他字段
    - name: userID
      type: integer
      description: The user ID.
      JSONPath: .spec.userID
    - name: groups
      type: string
      description: The groups of the user.
      JSONPath: .spec.groups
    - name: email
      type: string
      description: The email address of the user.
      JSONPath: .spec.email
  subresources: # 子资源定义
    status: {}
截至目前 , 大多数应用在其内置的部署清单中仍然使用 apiextensions.k8s.io这一API群组的v1beta1版本 , 包括Calico项目 等。
2. 自定义API Server
扩展Kubernetes系统API资源类型的另一种常用办法是自定义API Server。相比CRD来说 , 自定义API Server更加灵活 , 例如可以自定义资源类型和子资源、自定义验证及其他逻辑 , 甚至在Kubernetes主API Server中实现的任何功能也都能在自定义API Server中实现。
2.1 自定义API Server运行机制
自定义API Server完全可以独立运行 , 客户端通过其服务端点即可直接进行访问 , 但最为方便的方式是将它与主API Server(kubeapiserver)聚合在一起 , 这样既能使得构建出的API接口更加规范整齐 , 从而利用Kubernetes原生的认证、授权和准入控制机制 , 集群中 的多个API Server看起来好像是由单个服务器提供服务 , 而且无须特 殊逻辑来发现不同的API Server。自Kubernetes v1.7版本起 , kubeapiserver提供了聚合自定义API Server的组件kube-aggregator , 并内置在主API Server之中 , 作为其进程的一部分运行 , 如图所示。
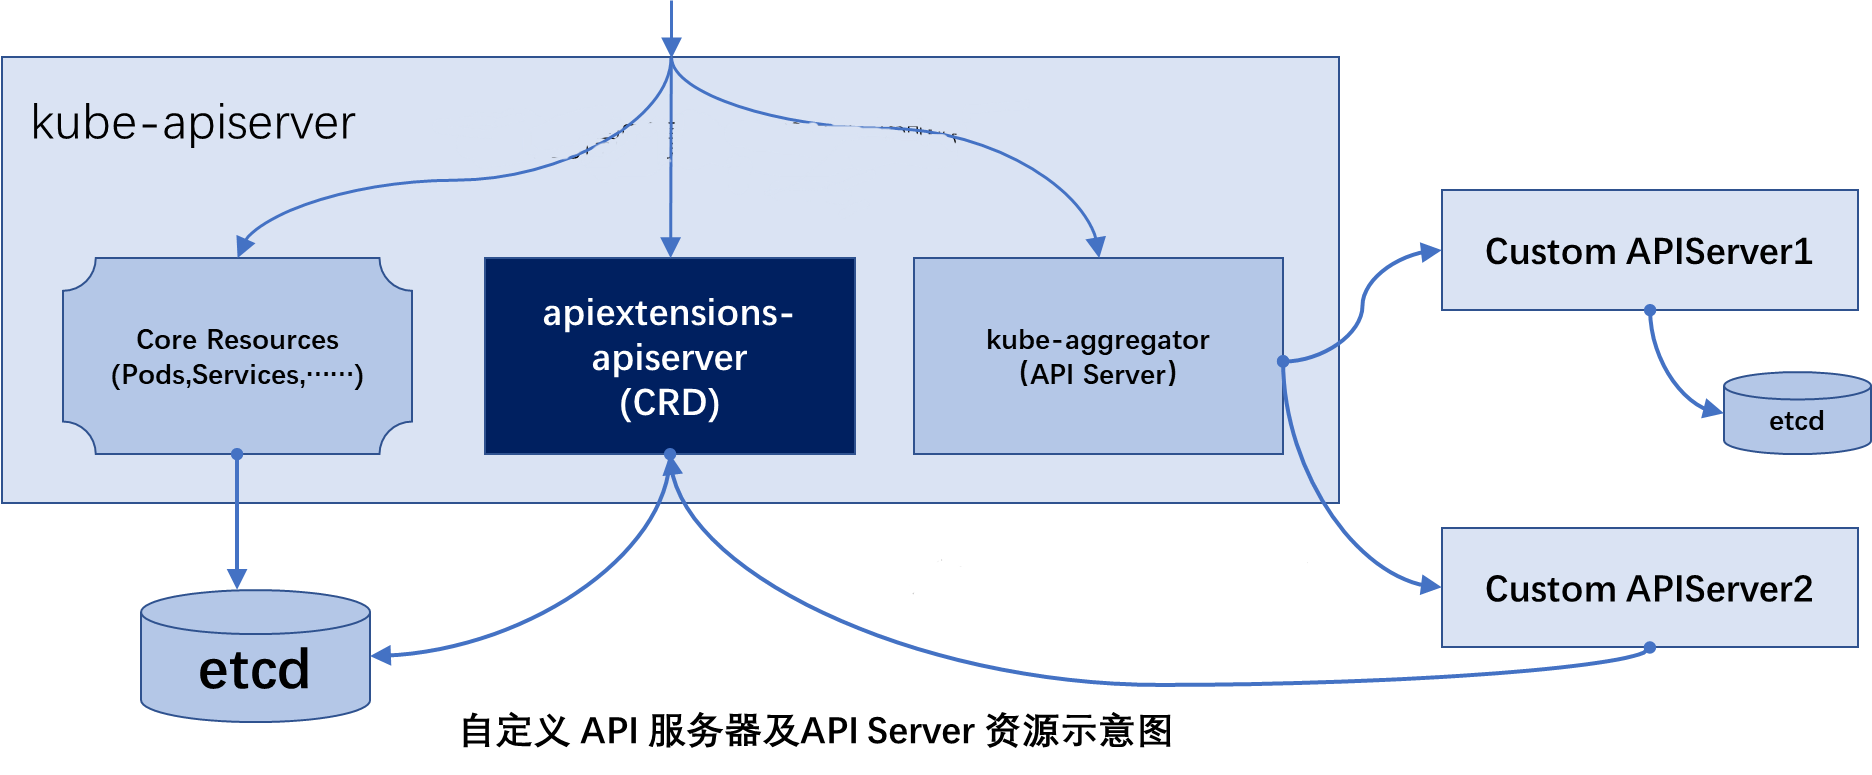
开发自定义API Server相对于CRD和自定义控制器来说要复杂得多 , Kubernetes为此提供了构建、聚合API Server的通用库 apiserver , 它包含了用于创建Kubernetes聚合服务器的基础代码 , 其中包含委派的authentication和authorization , 以及与kubectl兼容 的发现机制、可选的许可控制链 ( admission chain ) 和版本化类型 ( versioned type ) 等。因而 , Kubernetes提供了一个示例性的项目的sample-apiserver , 同时提供了一个名为Apiserver Builder的完整开发框架。
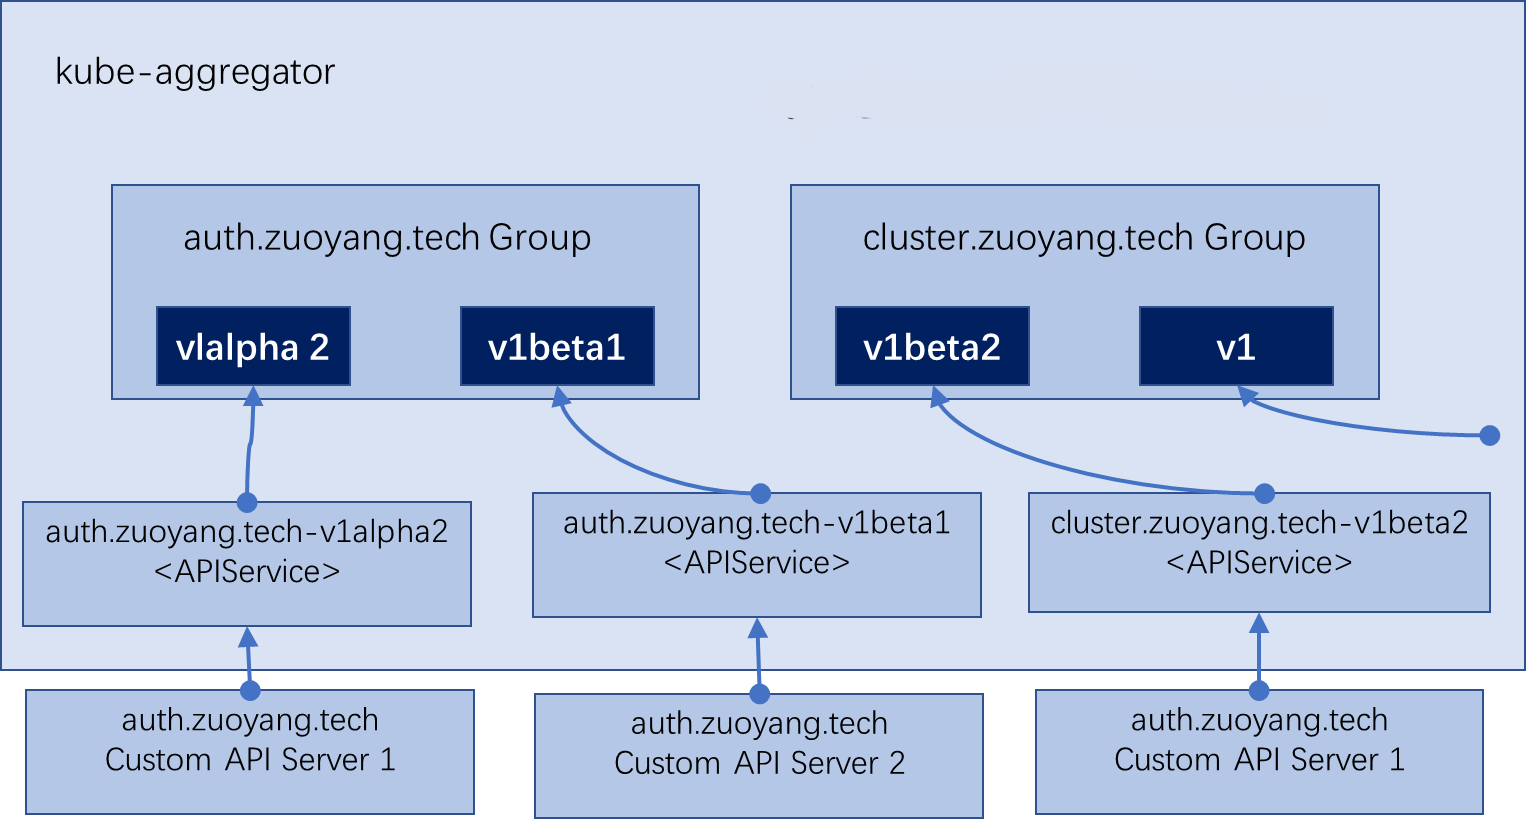
APIService资源对象是将自定义API Server聚合到主API Server 的接口 , 它负责在主API Server上注册一个URL路径 , 例 如/apis/auth.ilinux.io/v1alpha1/等 , 从而使得kube-aggregator将 发往这个路径的请求代理至相应的自定义API Server。每个 APIService对应一个API群组版本 , 而群组不同版本的API可以由不同的APIService对象支持 , 如图所示。
但创建自定义API Server需要编写大量代码 , 而且每个自定义的 API Server需要自行管理使用存储系统 , 如图所示 , 自定义API Server可使用自有的etcd存储服务 , 也可通过CRD将资源数据存储在主 API Server的存储系统中 , 但这种场景需要事先创建依赖到的所有自定义资源。除非特别需要创建自定义的API Server , 否则建议读者还 是选择使用Kubebuilder , 直接基于CRD和自定义控制器进行系统扩展。
2.2 APIService资源与应用
APIService资源类型的最初设计目标是将庞大的主API Server分解成多个小型但彼此独立的单元 , 但它也支持将任何遵循Kubernetes API接口设计规范的自定义API Server聚合进主API Server中。 APIService是标准的API资源类型 , 它隶属于apiregistration.k8s.io 资源群组 , Spec规范中可嵌套使用如下字段。
group: 注册使用的API群组名称。groupPriorityMinimum:API群组的最低优先级 , 较高优先级的群组将优先被客户端使用 ; 数值越大优选级越高 , 数值相 同时按名称字符排序。version: 注册的API群组的版本。versionPriority: 当前版本在其所属的API群组内的 优先级 ; 必须使用正整数数值 , 数值越大优先级越高 , 数值相同时按名称字符排序。service: 自定义API Server相关的Service对象 , 是 真正提供API服务的后端 , 它必须通过443端口进行通信。caBundle:PEM编码的CA打包信息 , 用于验证APIService的服务证书。insecureSkipTLSVerify: 与此服务通信时是否禁止TLS证书认证。
下面的配置清单示例取自sample-apiserver项目 , 它定义了一个 名为v1alpha1.wardle.example.com的APIService对象 , 它负责将运行在wardle名称空间中的自定义API Server进行聚合 , 该API Server的固定访问入口由名为api的Service对象进行定义。
apiVersion: apiregistration.k8s.io/v1
kind: APIService
metadata:
  name: v1alpha1.wardle.example.com
spec:
  insecureSkipTLSVerify: true
  group: wardle.example.com
  groupPriorityMinimum: 1000
  versionPriority: 15
  service:
    name: api
    namespace: wardle
version: v1alpha1APIService仅用于将API Server进行聚合 , 真正提供服务的是相应的外部API服务器 , 这个自定义服务器通常以Pod形式托管运行在当前Kubernetes集群之上。于是 , 在Kubernetes集群上部署自定义API Server主要有两步 : 将服务器应用以Pod形式运行在集群之上并为其创建Service对象 , 而后创建一个专用的APIService对象与主API Server 完成聚合。
以sample-apiserver为例 , 它以wardle名称空间为基础 , 使用 Deployment控制器编排自定义的API Server应用 , 并由名为api的 Service向外提供服务的固定访问端点 , 以便于APIService对象加以引 用 , 完成API聚合。相应的部署清单示例位于sample-apiserver项目仓库的artifacts/example/目录下 , 我们将sample-apiserver项目的仓 库克隆至本地 , 直接将该目录中的部署清单应用到本地集群之上即可进行测试。
~$ git clone https://github.com/kubernetes/sample-apiserver.git
~$ kubectl apply -f sample-apiserver/artifacts/example/待wardle名称空间下名为wardle-server的Pod就绪后 , 即可通过如下命令验证由sample-apiserver提供的新API群组 wardle.example.com中的可用资源列表。
~$ kubectl api-resources --api-group=wardle.example.com
NAME SHORTNAMES APIGROUP NAMESPACED KIND
fischers wardle.example.com false
Fischer
flunders wardle.example.com true
Flunder这些由自定义API Server添加的资源类型的使用方式与内置的资源类型并无区别 , 但具体实现的功能和配置格式则取决于程序的定 义。上面的部署示例中 , wardle-server将自身提供的资源的相关数据保存在etcd中 , 这两个应用同时运行在单个Pod之中。但生产实践中 , 建议使用独立的外置etcd集群来提供数据存储服务。
事实上 , sample-server是一个较为重量级的实现 , 可完全运行为 独立的API服务器 , 支持认证、授权和准入控制等功能。若仅希望构建 一个用于扩展目的的API Server , 则建议使用apiserver-builder项目 来完成 , 它是一款用于生成apiserver、客户端库和安装程序的完整框 架。另外 , 如果仅是为Kubernetes添加一些新的资源类型 , 强烈建议 使用Kubebuilder项目 , 以CRD和自定义控制器的形式进行。
3. 控制器与Operator
仅借助CRD或自定义API Server自定义出资源类型通常并不能为用户带来太多价值 , 因为资源类型本身仅提供了JSON格式的数据范式及存取相关数据的能力 , 至于如何执行数据相关的业务逻辑 , 时刻确保 将资源对象Status中的实际状态接近Spec中的期望状态 , 则是由封装在控制器中的代码实现。相应地 , 为自定义资源提供业务逻辑代码的控制器通常需要由用户自行开发 , 因而也被称作自定义控制器。进一步来说 , 封装了相关资源复杂运维逻辑的控制器通常被称为 Operator , 是由CoreOS于2016年引入到Kubernetes中的概念。
3.1 自定义控制器的工作机制
我们知道 , 控制器注册并持续监视资源状态的变动 , 必要时还会 执行相应的业务代码以确保资源对象的实际状态与期望状态相吻合 , 自定义控制器同样担负着类似的职责。但是 , 一个特定的控制器通常 仅负责管理特定的一部分资源类型 , 并执行专有管理逻辑。下面的一 段伪代码给出了最简单的控制循环实现。
for {
   desired := getDesiredState() # 获取资源对象的期望状态
   current := getCurrentState() # 获取当前的实际状态
   makeChanges(desired, current) # 执行操作 , 让当前状态符合期望状态
}Kubernetes系统内置了许多控制器 , 例如NodeController、 Deployment、DaemonSet和ServiceController等 , 它们打包成单个二进制程序kube-controller-manager并统一运行在同一个守护进程中。 结合Kubernetes的声明式API , 这些控制器基本都遵循同一种机制完成资源管理操作 , 该处理机制通常可由声明式API、异步处理模式和水平触发3种特性进行描述。
声明式
API: 用户定义期望的状态而非要执行的特定操作 , 具体的业务逻辑由控制器通过相应的业务代码完成。异步处理 : 客户端的请求在
API Server存储完成即返回成功信息 , 而无须等待控制器运行调谐循环。水平触发 (
level trigger) : 同一对象有多次变动事件待处理 时 , 控制器仅需要处理其最新一次变动 , 即仅依赖当前状态。
提示 : 与水平触发对应的是“边缘触发” (
edge trigger) , 该触发模 式中 , 系统既依赖资源的当前状态 , 也依赖过去的状态 ; 若系统错过 了某个事件 ( 即“边缘” ) , 则必须重新执行该事件才能恢复系统。
为了完成水平触发机制 , 控制器通过Informer注册监视目标资源 类型下所有对象的实际状态 , 并与相关对象各自期望的状态相比较 , 创建、删除或更新等相关的事件会发往控制器的Workqueue , 再由控制 器中相关事件类型的函数进行处理。换句话说 , 控制器主要包含 Informer/SharedInformer和Workqueue两个重要组件 , 前者负责注册 监视资源对象当前状态的变动 , 并将相应事件发送至后者 , 最后由控 制器的worker从Workqueue中取出事件交给控制器中业务逻辑相关的代 码进行处理 , 如图所示。
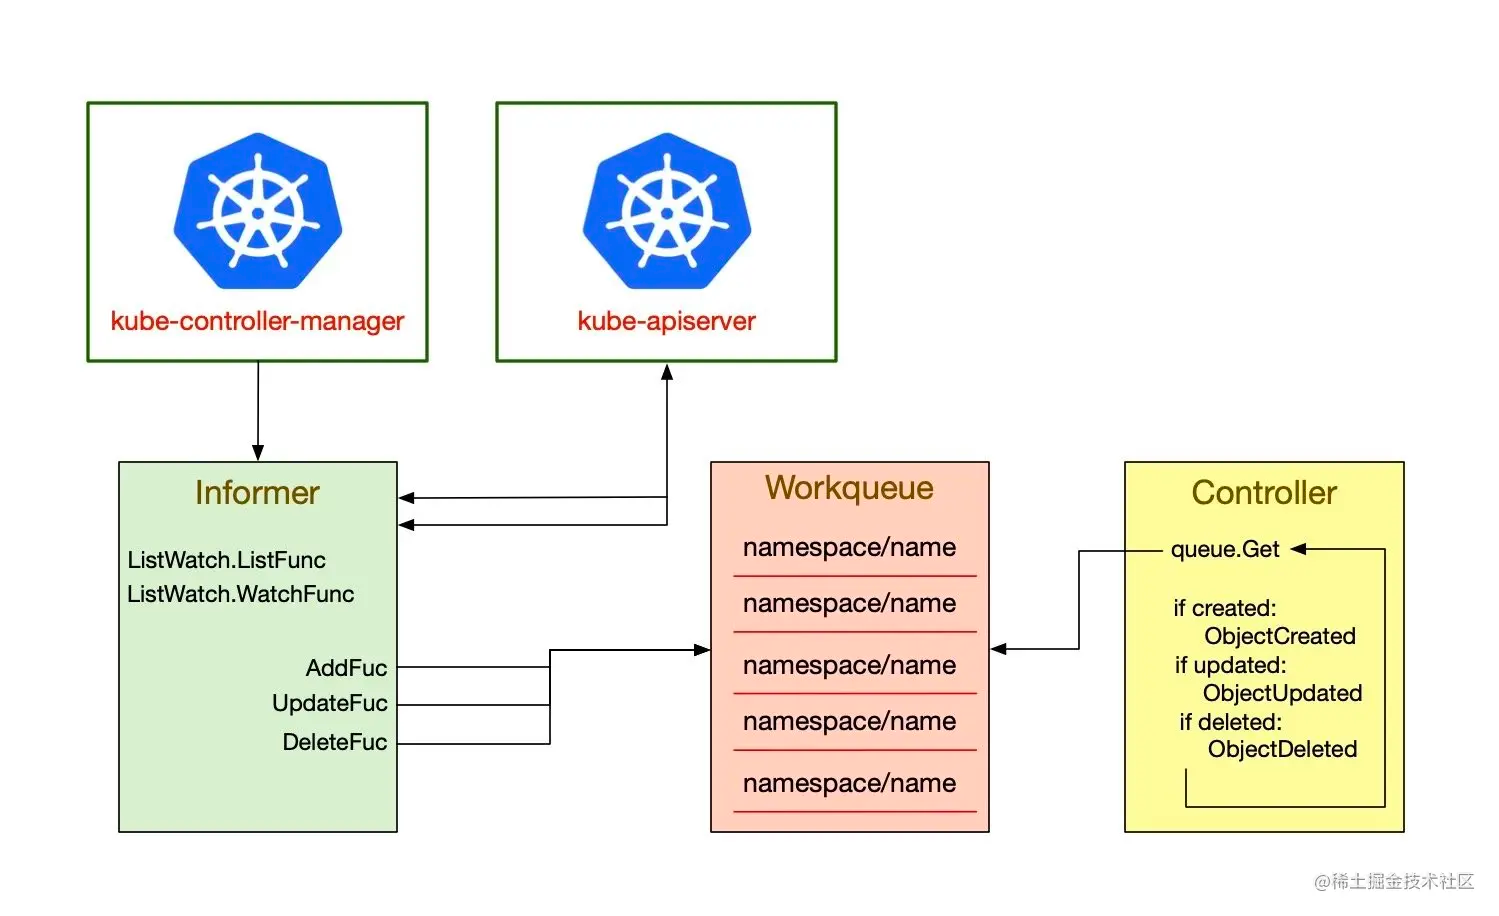
自定义控制器实现自定义资源管理行为的最佳方法同样是遵循此 类控制器模式进行程序开发 , Kubernetes为此提供了一个专用的开发 库client-go。目前 , 该开发库中的大部分开发接口都是基于Go语言实 现 , Informer和Workqueue相关代码分别位于客户端库的clientgo/go/tools/cache和client-go/util/workqueue目录中。图中显示了客户端库中的各组件如何工作 , 以及各组件与自定义控制器代码的 相关交互点。
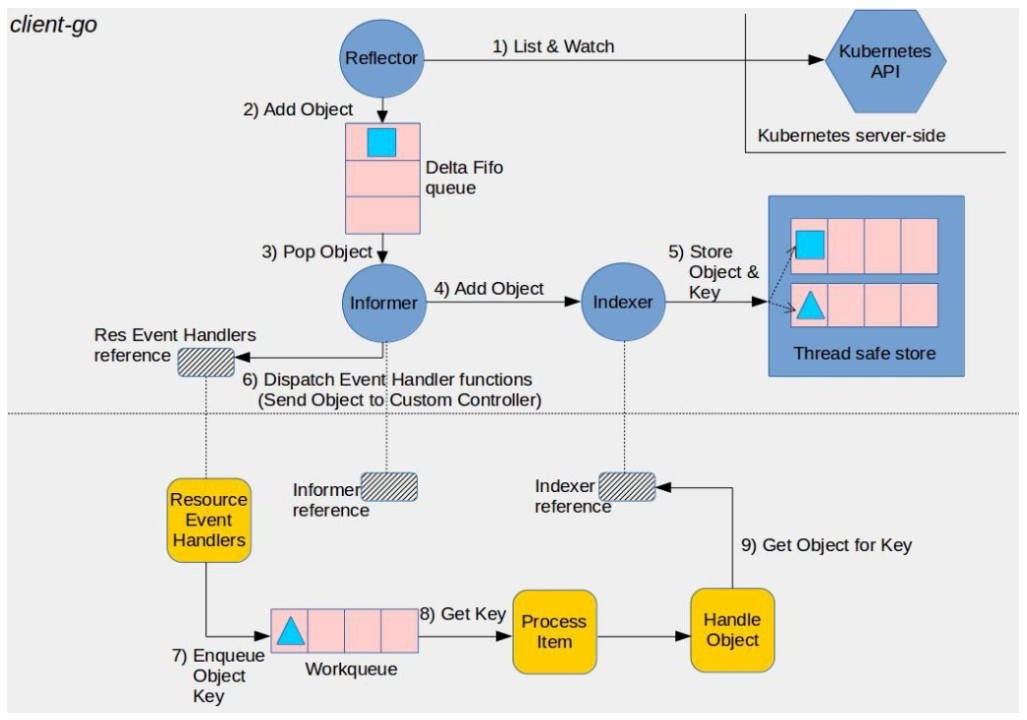
client-go组件其实就是一个带有本地缓存和索引机制的API Server客户端 , 是自定义控制器同API Server进行数据同步的重要组 件。借助Reflector ( 反射器 ) 中的ListAndWatch函数 , Informer首先 通过API Server中的Listing API获取注册筛选出的所有API对象 , 并由Indexer ( 索引器 ) 索引后缓存到本地 , 而后经由Watching API监视 这些对象的变动事件并同步实时更新本地缓存 , 同时向自定义控制器 调用Resource Event Handler来处理相关的资源变动事件。为确保缓 存的有效性 , Informer需要以resyncPeriod为周期强制更新本地缓存。下面是由client-go客户端库所提供的各关键组件的功能说明。
Reflector: 反射器 (clientgo/tools/cache/reflector.go) , 负责通过ListAndWatch函数监视Kubernetes API中指定类型的资源对象 ; 收到API Server的资源变动通知时 ,Reflector基于Listing API获取资源变动信息 , 并放置在由watchHandler函数定义的Delta FIFO队列中。Informer: 基于processLoop从Delta FIFO队列中取出 (POP) 对 象缓存至本地 , 同时调用控制器以便将对象传递给它。Indexer: 索引器 (client-go/tools/cache/index.go) , 负责 索引那些缓存在本地的资源对象。它支持多个不同的索引函数 , 默认使用的MetaNamespaceKeyFunc函数基于资源对象的名称及其名称空 间 , 以<namespace>/<name>为格式构建索引key , 但集群级别的资源对象的Key仅具有<name>部分。
自定义控制器调用Informer ( Informer Reference ) 注册并监听 目标资源类型 , 同时向Informer提供Resource Event Handler回调函数 , 以接收待处理对象的索引并存入Workqueue , 随后执行自定义的资 源对象业务逻辑代码 ( 定义在图中的Process Item处 ) 完成实际的处理过程 , 从而实现控制循环。有些资源变动相关操作仅根据资源对象的key即能完成 , 例如删除操作等 , 但有些操作可能还要用到资源具 体的规范及当前状态信息等 , 这时还需要调用Indexer ( Indexer Reference ) 从client-go的本地缓存中检索并获取资源对象的相关数据。下面是应该由程序员编写代码提供的各组件及其功能的简要说 明。
Resource Event Handler:Informer需要传递对象给自定义控制 器时调用的回调函数 , 由用户自行编写 , 负责从Informer接收待处理资源对象的key, 并存入Workqueue以便进一步处理。Workqueue: 用户在自定义控制器中自行实现的消息队列 , 它从Resource Event Handler接收和缓冲待处理的资源对象 , 并交由Process Item进行处理 , 从而将对象接收和处理的过程解耦。Process Item: 执行资源对象管理操作的业务代码 , 通常由一到 多个函数组成 , 负责从Workqueue中取出对象并完成真正的处理过程 , 必要时 , 这些函数还会调用Indexer以检索和获取资源的详细状态数 据。
client-go的早期版本中 , Informer是控制器私有的组件 , 它为相关资源对象创建的缓存信息仅可供当前一个控制器使用。而在 Kubernetes系统上 , 同一资源对象支持多个控制器协同管理 , 或者多个控制器监视同一资源对象也是较为常见的情形。于是 , 一个更高效 的方式是使用替代解决方案SharedInformer机制。SharedInformer支持在监控同类资源对象的控制器之间创建共享缓存 , 这有效降低了内 存资源开销 , 而且它也仅需在上游的API Server注册创建一个监视 器 , 这样能显著减轻上游服务器的访问压力。因此较之Informer , SharedInformer才是更为常用的解决方案。
不过 , SharedInformer无法跟踪每个控制器的位置 ( 因为它是共享的 ) , 于是控制器必须提供自用的工作队列及重试机制 , 这也是为 什么它的Resource Event Handler程序只是将事件放在每个消费者的 Workqueue中 , 而非直接进行处理的原因之一。目前 , 工作队列存在延 迟队列、定时队列和速率限制队列等几种形式。
显然 , 自定义控制器构建起来存在一定的复杂度。实践中 , 为了 便于用户使用client-go创建控制器 , client-go提供了队列代码示例workqueue example ( client-go/examples/workqueue ) 和模板类的控 制器项目sample-controller ( github.com/kubernetes/samplecontroller ) , 它们提供了一个自定义控制器项目应有的基础结构。 通常的做法是复制相应的代码并按需修改相应的部分 , 例如把 syncHandler修改为自定义资源类型的业务处理逻辑等 , 而后借助 code-generator项目用脚本生成相应的组件 , 例如typed clients、 informers等。即便较之从零构建自定义控制器的代码有所改进 , 但这 类方式总会有些美中不足之处。
好在 , 现有已经有几类更加成熟、更易上手的工具可用 , 它们甚 至可被视作开发CRD和控制器的SDK或框架 , 目前主流的项目有 Kubebuilder、Operator SDK和Metacontroller。Kubebuilder主要由 Google的工程师Phillip Wittrock创立 , 但目前归属于SIG API Machinery , 有较完善的在线文档。Operator SDK是CoreOS发布的开源 项目 , 是Operator Framework的一个子集 , 出现时间略早 , 社区接受度高 , 以至于很多人干脆就把自定义控制器与Operator当作同一事 物 , 不加区分地使用。目前已经有etcd、Prometheus、Rook和Vault多个成熟的Operator可用。Metacontroller由GCP发布 , 与前两个项目区 别较大 , 它把控制器模式直接委托给Metacontroller框架 , 并调用用户提供的Webhook实现模式的处理功能 , 支持任何编程语言开发 , 接收 并返回JSON格式的序列化数据。
限于篇幅 , 这里就不再介绍它们各自的具体用法 , 对自定义控制 器有兴趣的读者可参考相关项目的文档进行学习。另外 , 有兴趣测试 CRD及自定义控制器的读者朋友也可以参考GitHub上的项目 nikhita/custom-database-controller , 项目地址为 https://github.com/nikhita/custom-database-controller。
3.2 Operator与简单应用示例
发端于Google的SRE ( 站点可靠性工程 ) 是用于运营大型系统的一 组模式和准则 , 对行业惯例的形成有着难以估量的影响 , 甚至是催生 了SRE工程师这一岗位。Operator其实就是代码化的SRE工程师 , 它在 软件中封装应用程序的专业管理操作 , 从而能够代替SRE工程师完成有 状态应用程序的日常运维操作 , 例如应用集群部署、规模伸缩、数据 备份和恢复 , 以及版本升级等。因此 , 相较于Kubernetes内置的控制 器及用户自定义控制器 , Operator更像是重量级的、专用于管理有状 态应用复杂内生关系和运维操作的自定义控制器。
于今 , Operator业已成为Kubernetes环境下应用交付的一个实体 , 它使用基于CRD的自定义资源 , 以及一个将运维技能代码化的自定 义控制器作为基础模型 , 从而实现有状态应用的高效、自动化管理。 另一方面 , 云原生环境中的自动化 , Controller或者Operator也是与云端基础设施进行交互 , 充分分利用云产品能力和优化应用运行的关 键所在。
Operator借助自定义资源扩展Kubernetes API来描述要管理的目 标资源 , 而Operator自身内部实现的正是这类自定义资源实例化的资 源对象的编排任务的业务代码 , 它作为控制平面的扩展组件通常以Pod 形式托管运行在Kubernetes之上 ,
以CoreOS维护的etcd-operator为例 , 它使用自定义资源类型 etcdclusters来描述编排的etcd集群 , 相关的资源控制循环由etcdoperator提供。etcd-operator自身以Pod形式运行在Kubernetes之 上 , 它注册监视etcdcluser资源类型 , 相关编排的任务依赖的基础资源权限由Role和ClusterRole定义 , 并按需绑定在etcd-operator使用 的ServiceAccount之上。etcd-operator的文档中给出了其部署过程 , 具体如下所示。
# 克隆etcd-operator项目的仓库到本地
~$ git clone https://github.com/coreos/etcd-operator.git
# 生成必要的Role、ClusterRole , 以及RoleBinding和ClusterRoleBinding资源对象
~$ cd etcd-operator
~$ example/rbac/create_role.sh
# 部署etcd-operator , 该Operator自身由内置的Deployment控制器进行编排
~$ kubectl create -f example/deployment.yaml
部署完成后 , 待etcd-operator Pod运行成功后 , 可以使用类似如 下命令检查etcd.database.coreos.com群组中的自定义资源 etcdclusters是否创建完成。
~$ kubectl api-resources --api-group=etcd.database.coreos.com
NAME         SHORTNAMES APIGROUP                 NAMESPACED   KIND
etcdclusters etcd etcd.database.coreos.com true EtcdCluster自定义资源etcdclusters的规范较为简单 , 它使用.spec.size指定etcd集群中的实例数 , 而.spec.version则用于指定要使用的etcd镜像的版本标签。下面的配置清单示例 ( etcd-cluster-demo.yaml ) 定义了一个名为etcd-cluster-demo的etcd集群 , 该集群共有3个实例 , 运行的etcd版本为3.4.9。
apiVersion: "etcd.database.coreos.com/v1beta2"
kind: "EtcdCluster"
metadata:
  name: "etcd-cluster-demo"
spec:
  size: 3
  version: "3.4.9"
repository: "quay.io/coreos/etcd"自定义资源的管理方式与API Server的内置资源类型并无区别 , 我们根据该资源清单即可快速部署一个3节点的etcd集群实例来 , 具体的命令如下所示。
~$ kubectl apply -f etcd-cluster-demo.yaml
etcdcluster.etcd.database.coreos.com/etcd-cluster-demo createdetcd-operator会为每个集群中的Pod自动打上app、etcd_cluster 和etcd_node这3个可见名知义的标签 , 因此 , 下面的命令就使用了etcd_cluster标签在default名称空间下筛选etcd-cluster-demo集群相关的Pod对象。
~$ kubectl get pods -l etcd_cluster=etcd-cluster-demo
NAME                           READY STATUS   RESTARTS AGE
etcd-cluster-demo-6pkmmj6jf6   1/1   Running   0       2m19s
etcd-cluster-demo-nkj7fmng7t   1/1   Running   0       2m8s
etcd-cluster-demo-ql79njlhp5   1/1   Running   0       88s
接下来 , 我们可通过etcdctl查看集群成员状态来了解这3个Pod对象是否成功加入了同一个集群。
~$ ETCD_POD=$(kubectl get pods -l etcd_cluster=etcd-cluster-demo -o jsonpath={.items[0].metadata.name})
~$ kubectl exec $ETCD_POD -it -- etcdctl member list
4560cd2df2d9a7cb, started, etcd-cluster-demo-ql79njlhp5, ……
6e2ef696c6ebd588, started, etcd-cluster-demo-6pkmmj6jf6, ……
cfe7c5b7f0449580, started, etcd-cluster-demo-nkj7fmng7t, ……etcd-operator还会为每个集群在同一名称空间下自动创建<cluster_name>和<cluster_name>-client两个Service对象 , 前者主 要用于集群内部各实例间的通信 , 后者则专用于客户端通信 , 它默认为ClusterIP类型。
~$ kubectl get svc -l etcd_cluster=etcd-cluster-demo
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
etcd-cluster-demo ClusterIP None <none>
2379/TCP,2380/TCP 20s
etcd-cluster-demo-client ClusterIP 10.100.72.135 <none>
2379/TCP 20s
另外 , etcd-operator还支持etcd集群的伸缩、故障转移、故障恢复及数据的备份和恢复等操作 , 感兴趣的读者可参考项目文档自行测 试。由此可见 , etcd-operator的确能够以自动化的方式代替SRE工程 师执行完成etcd集群的大部分日常管理任务 , 这些基础能力是 Kubernetes内置的StatefulSet控制器自身不具备也无法具备的能力。
普遍存在的有状态应用的自动化管理需求 , 必然意味着在未来云 原生的生态里会有越来越多的应用通过Operator进行描述和定义 , 这 些应用将以Kubernetes为底层基础设施 , 基于CRD和Operator进行交 付。目前 , Kubernetes社区通过OperatorHub分享Operator , 而 Operator Framework提供的SDK , 能帮助用户快速构建出一个Operator 的基础框架结构 , 并且支持高级API和抽象形式 , 可帮助用户更直观地 将运维逻辑代码化。
4. kubernetes 集群高可用
Kubernetes具有自愈能力 , 它跟踪到某工作节点发生故障时 , 控 制平面可以将离线节点上的Pod对象重新编排至其他可用工作节点运 行 , 因此 , 更多的工作节点也意味着更好的容错能力 , 它使得 Kubernetes在实现工作节点故障转移时拥有更加灵活的自由度。而当 管理员检测到集群负载过重或无法容纳更多的Pod对象时 , 要么手动添 加新节点到集群中 , 要么为云计算环境中的Kubernetes启用clusterautoscaler以支持集群节点规模的自动缩放。
但添加更多工作节点并不能让集群应对所有常见故障 , 例如 , 若主API Server出现故障 ( 由于主API Server所在主机出现故障或网络分区将其从集群中隔离等 ) , Kubernetes将无法跟踪和控制集群。因此 , 还需要控制平面的各组件冗余以实现主节点的服务高可用性。基 于冗余数量的不同 , 控制平面能容忍一个甚至是几个节点的故障。一 般来说 , 高可用控制平面至少需要3个Master节点来承受最多1个 Master节点的丢失 , 才能保证处于等待状态的Master节点保持半数以 上 , 以满足节点选举时的法定票数。
事实上 , Kubernetes控制平面各组件中仅etcd需要复杂逻辑完成 集群功能 , 但管理员仅需按拓扑要求准备节点即可 , “集群”逻辑是其内置的功能。API Server利用etcd进行数据存储 , 它自身是无状态应用 , 多副本间能无差别地服务客户端请求。Controller Manager和 Scheduler都不支持多副本同时工作 , 它们各自需要选举出一个主节点作为活动实例 , 余下的实例在指定时间点监测不到主实例的“心跳” 信息后 , 将启动新一轮的选举操作以表决出新的主实例。
4.1 etcd高可用与控制平面拓扑
etcd基于Go语言开发 , 内部采用Raft协议作为共识算法进行分布 式协作 , 通过将数据同步存储在多个独立的服务实例上从而提高数据 的可靠性 , 避免了单点故障导致的数据丢失。Raft协议通过选举出的 leader节点实现数据一致性 , 由leader节点负责所有的写入请求并同 步给集群中的所有节点 , 在半数以上follower节点确认后予以持久存 储。这种需要半数以上节点投票的机制要求集群数量最好是奇数个节 点 , 推荐的数量为3个、5个或7个。建立etcd集群有3种方式。
静态集群 : 事先规划并提供所有节点的固定IP地址以组建集群 , 仅适合于能够为节点分配静态
IP地址的网络环境 , 好处是它不依赖任 何外部服务。基于
etcd发现服务构建集群 : 通过一个事先存在的etcd集群进行 服务发现来组建新集群 , 支持集群的动态构建 , 它依赖一个现存可用 的etcd服务。基于
DNS的服务资源记录构建集群 : 通过在DNS服务上的某域名下 为每个节点创建一条SRV记录 , 而后基于此域名进行服务发现来动态组 建新集群 , 它依赖于DNS服务及事先管理妥当的资源记录。
一般说来 , 对于etcd分布式存储集群来说 , 3节点集群可容错一个 节点 , 5节点集群可容错两个节点 , 7节点集群可容错3个节点 , 依此类 推 , 但通常多于7个节点的集群规模是不必要的 , 而且对系统性能也会 产生负面影响。
具体部署方案的选择方面 , 我们可以把etcd与Kubernetes控制平面的其他组件以“堆叠”的形式部署在同一组的3个节点之上 。也可把二者分离开来 , 让etcd运行为独立的外部集群 , 控 制平面部署为另一组集群 , API Server作为客户端远程访问etcd服 务
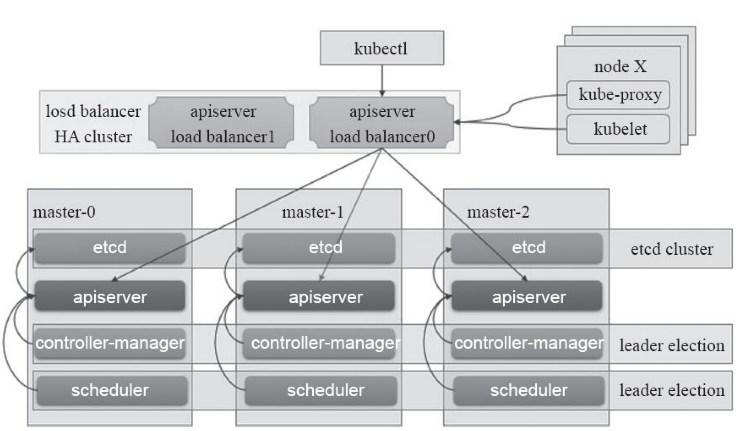
堆叠式etcd集群拓扑将相同节点上的控制平面同etcd成员耦合在 一起 , 每个控制平面节点分别运行一个etcd、kube-apiserver、kubescheduler和kube-controller-manager实例。而以kubeadm部署的该类 控制平面中 , 各kube-apiserver实例仅与本地节点上的etcd成员通 信 , 而各kube-scheduler和kube-controller-manager也仅与本地节点上的kube-apiserver通信。
使用独立etcd集群的设计方案中 , etcd集群与控制平面集群各自 独立运行 , 它们各自遵循自有的节点拓扑要求和能承载各自需求的成 员节点数量 , 例如etcd集群存在3个成员节点 , 而控制平面集群有4个成员节点等。kube-apiserver通常基于专用的域名与etcd集群中的任 何成员进行通信 , 而各kube-controller-manager和kube-scheduler实例也可以通过专用域名及外部的负载均衡器与任一kube-apiserver实例进行通信。这样就实现了kube-apiserver与etcd以及控制平面其他 组件在本地节点上的解耦。
这两种拓扑结构各有利弊 , 但第一种方案节点需求量较小 , 适合 中小规模的生产类集群 , 第二种方案节点需求量大 , 有较好的承载力 及故障隔离能力 , 较适合中大型规模的生产类集群。
4.2 Controller Manager与Scheduler高可用
Controller Manager中的各控制器通过监视API Server上的资源 状态变动并按需执行相应的操作完成资源管理 , 于是多实例运行的 kube-controller-manager进程可能会导致同一操作行为被每一个实例 分别执行一次 , 例如某一Pod对象创建的请求被3个控制器实例分别执 行一次 , 进而各自创建出一个同名Pod对象。因而控制平面同一时刻仅 应该允许一个kube-controller-manager运行为活动实例 , 余下的均处于备用状态 , 或称为等待状态。
同一控制平面中 , 多个协同的kube-controller-manager实例要同 时启用--leader-elect=true选项以自动实现leader选举。选举过程完 成后 , 仅leader实例处于活动状态 , 余下的其他实例均转入等待模 式 , 它们会在探测到leader故障时触发新一轮的选举操作。与etcd集 群基于Raft协议进行leader选举不同的是 , kube-controller-manager 集群各自的选举操作仅是通过在kube-system名称空间中创建一个与程 序同名的Endpoint资源对象实现。
~$ kubectl get endpoints -n kube-system
NAME                     ENDPOINTS   AGE
kube-controller-manager  <none>      13h
kube-scheduler <none> 13h这种leader选举操作是分布式锁机制的一种应用 , 它通过创建和 维护Kubernetes资源对象来维护锁状态 , 目前Kubernetes支持 ConfigMap和Endpoint两种类型的资源锁。初始状态时 , 各kube-controller-manager实例通过竞争方式去抢占指定的Endpoint资源 锁。胜利者将成为leader , 它通过更新相应的Endpoint资源的注解 control-plane.alpha.kubernetes.io/leader中的holderIdentity为其节点名称 , 从而将自己设置为锁的持有者 , 并基于周期性更新同一 注解中的renewTime以声明自己对锁资源的持有状态 , 以避免等待状态 的实例进行争抢。于是 , 一旦某leader不再更新renewTime , 等待状态的各实例将进行新一轮竞争。
~$ kubectl describe endpoints/kube-controller-manager -n kubesystem
Name: kube-controller-manager
Namespace: kube-system
Labels: <none>
Annotations: control-plane.alpha.kubernetes.io/leader:
{"holderIdentity":"k8s-master01.ilinux.io_2502a194-7aa4-4d3fa8e0-d5aad42bc11f","leaseDurationSeconds":15,"acquireTime":"...
Subsets:
Events:
 ……
 Normal LeaderElection 49m kube-controller-manager k8smaster01.ilinux.io_0ac18d82-50bd-437f-b9a6-d930bb09ad6a became
leader
 Normal LeaderElection 30m kube-controller-manager k8smaster01.ilinux.io_2502a194-7aa4-4d3f-a8e0-d5aad42bc11f became
leader
4.3 部署高可用控制平面
高可用控制平面节点的拓扑中 , 我们需要为无状态的API Server 实例配置外部的高可用负载均衡器 , 这些负载均衡器的VIP将作为各个 客户端 ( 包括kube-scheduler和kube-controller-manager组件 ) 访问 API Server时使用的目标地址。但是 , kubeadm init 初始化第一个控制平面节点时默认会将各组件的kubeconfig配置文件及admin.conf中的集群访问入口定义为该节点的IP地址 , 且随后加入 的各节点的TLS Bootstrap也会配置kubelet的kubeconfig配置文件使 用该地址作为集群访问入口 , 这将不利于后期高可用控制平面的配 置。
解决办法是为kubeadm init命令使用--control-plane-endpoint 选项 , 指定API Server的访问端点为专用的DNS名称 , 并将其临时解析 到第一个控制平面节点的IP地址 , 等扩展控制平面完成且配置好负载 均衡器后 , 再将该DNS名称解析至负载均衡器 , 以接收访问API Server 的VIP。
我们仍然基于hosts文件进行主机名称解析 , 在将计划添加的控制 平面节点k8s-master02.ilinux.io和k8s-master03.ilinux.io添加为 新的控制平面节点之前 , 需要更新各Master节点的/etc/hosts文件的内容类似如下所示。
172.29.9.1 k8s-master01.ilinux.io k8s-master01 k8s.api.ilinux.io
172.29.9.2 k8s-master02.ilinux.io k8s-master02
172.29.9.3 k8s-master03.ilinux.io k8s-master03
172.29.9.11 k8s-node01.ilinux.io k8s-node01
172.29.9.12 k8s-node02.ilinux.io k8s-node02
172.29.9.13 k8s-node03.ilinux.io k8s-node03同一高可用控制平面集群中的各节点需要共享CA和front-proxy的数字证书与密钥 , 以及专用的ServiceAccount账户的公钥和私钥。我们可以采用手动分发的方式将必要的证书和密钥文件从k8s-master01 复制到另外两个待加入节点 , 或者在k8s-master01上使用kubeadm init phase upload-certs --upload-certs将其上传为Kubernetes集群上kube-system名称空间中名为kubeadm-certs的Secret资源 , 而后 在其他主机上执行kubeadm join --control-plane命令添加新的控制平面节点时予以自动下载。这里采用第二种方式 , 因而首先需要在 k8s-master01节点上运行如下命令上传证书及密钥数据 :
~$ sudo kubeadm init phase upload-certs --upload-certs
[upload-certs] Storing the certificates in Secret "kubeadm-certs"
in the "kube-system" Namespace
[upload-certs] Using certificate key:
44c27c5588c52f29335c0e4d31336911f2e1ece7048e26c18607929cf0a7abbf
而后 , 在准备好基础环境的主机上运行kubeadm join --controlplane命令便可将其添加为控制平面节点。该命令同样需要借助共享令 牌进行首次与控制平面通信时的认证操作 , 还需要指定下载证书用到 的证书密钥 , 相关的令牌信息及完成的命令由初始化控制平面的命令 结果给出 , 而证书密钥则来自上面命令的结果。于是 , 在k8s-node02 上运行如下命令将它添加为控制平面节点 :
~$ kubeadm join k8s-api.ilinux.io:6443 --token
dnacv7.b15203rny85vendw \
 --discovery-token-ca-cert-hash
sha256:61ea08553de1cbe76a3f8b14322cd276c57cbebd5369bc362700426e21
d70fb8 \
 --control-plane \
--certificate-key
44c27c5588c52f29335c0e4d31336911f2e1ece7048e26c18607929cf0a7abbf
该命令成功执行后 , 会有成功操作的提示 , 以及将该节点作为管 理节点 ( 与k8s-master01一样 ) 时如何配置kubectl命令行工具的提 示。类似地 , 运行如下命令即可在本节点使用kubectl管理Kubernetes 集群
~$ mkdir -p $HOME/.kube
~$ sudo cp -i /etc/kubernetes/admin.conf $HOME/.kube/config
~$ sudo chown $(id -u):$(id -g) $HOME/.kube/config
不过 , 此时的hosts文件中仍是将k8s-api.ilinux.io这个DNS名称解析到了k8s-master01主机上 , kubectl命令仍是向k8s-master01上的 kube-apiserver实例发出的请求。为测试k8s-master02上的kubeapiserver实例 , 需要将hosts文件中的k8s-api.ilinux.io名称移动到 k8s-master02主机条目的后面 , 如下所示。为了节约篇幅 , 这里仅给出需要变动的两行。
172.29.9.1 k8s-master01.ilinux.io k8s-master01
172.29.9.2 k8s-master02.ilinux.io k8s-master02 k8s.api.ilinux.io而后运行如下命令测试kubectl和新的控制平面节点实例运行状 况 , 顺便查看节点当前状态。
~$ kubectl get nodes
NAME                     STATUS   ROLES   AGE   VERSION
k8s-master01.ilinux.io   Ready    master  62d   v1.19.0
k8s-master02.ilinux.io   Ready    master  21m   v1.19.0
k8s-master03.ilinux.io   Ready    master  7m    v1.19.0
……另一控制平面节点k8s-master03的设置方式完全类似上面的过 程 , 这里不再赘述。所有Master节点添加完成后 , 要确保如下命令显 示的Master各组件相关Pod的状态为Running , 每个组件共有3个实例 , 分别运行在3个不同的Master节点上。命令中的-l选项用于使用指定的 标签选择器筛选Pod对象。
~$ kubectl get pods -n kube-system -l tier=control-plane
NAME                                       READY      STATUS           RESTARTS   AGE
etcd-k8s-master01.ilinux.io                 1/1       Running          0          27m
etcd-k8s-master02.ilinux.io                 1/1       Running          0          9m17s
etcd-k8s-master03.ilinux.io                 1/1       Running          0          116s
kube-apiserver-k8s-master01.ilinux.io       1/1       Running          0          27m
kube-apiserver-k8s-master02.ilinux.io       1/1       Running          0          9m21s
kube-apiserver-k8s-master03.ilinux.io       1/1       Running          0          2m
……拥有高可用平面组件的Kubernetes集群即可应用在生产环境中 , 但若是存在大量的外部客户端 , 我们还需要为API Server添加前端的 负载均衡器 , 这可以是云服务商提供的负载均衡服务 , 也可以是由管理员手动构建的高可用负载均衡器 , 它们可由keepalived结合 envoy/harproxy/nginx/lvs等程序组合实现 , 也可以是专业的硬件设 备。