
3-11-1-pod资源调度
我们知道, Kubernetes把集群中所有工作节点提供的计算资源和 存储资源整合成一个大的资源池, 统一承载Pod形式的各类工作负载, 为用户提供了一个虚拟的逻辑视图。在底层物理视图上, 这些工作负 载终究还是要运行在集群中的某个特定节点上, 而控制平面组件 Kubernetes Scheduler就是为工作负载挑选最佳运行节点的调度器。 该组件的程序文件kube-scheduler实现了一款通用调度器, 能较好地完成绝大多数情况下的调度任务, 但它也难以成为满足用户特定场景 调度需求的最佳解决方案, 于是Kubernetes设计了易于增强和扩展的调度框架, 以允许用户自行增强默认调度器的功能。本章主要介绍与 工作负载调度及扩展等有关话题。
1. Kubernetes调度器
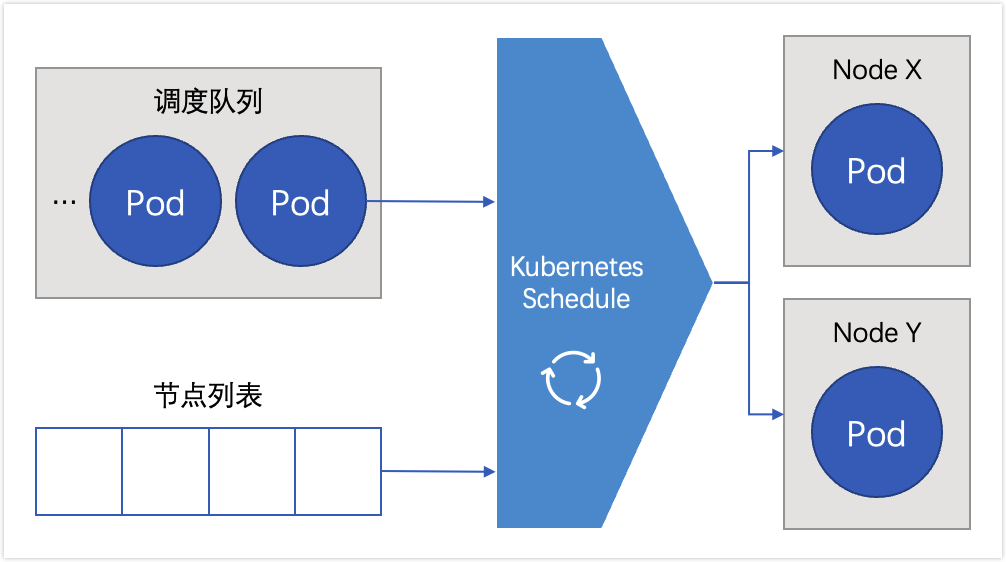
在Kubernetes系统上, 调度是指基于集群上当前各节点资源分配状态及约束条件为Pod选出一个最佳运行节点, 并由对应节点上的 kubelet创建并运行该Pod的过程。事实上, 对于每个未绑定至任何工作节点的Pod对象, 无论是新创建、被节点驱逐或节点故障等, Kubernetes Scheduler都要使用调度算法从集群中挑选一个最佳目标节点来运行它, 如图所示。
Kubernetes在v1.15版本之后引入的调度框架重构了此前使用的经典调度器架构, 它以插件化的方式在多个扩展点实现了调度器的绝大多数功能, 替代了经典调度器中以预选(predicate)函数和优选 (priority)函数为核心的调度载体, 并支持通过Scheduler Extender进行Webhook式扩展的架构, 为用户扩展使用自定义调度插件提供了便捷的接口。
1.1 调度器基础
Kubernetes内置了适合绝大多数场景中Pod资源调度需求的默认调度器, 它支持同时使用算法基于原生及可定制的工具来选出集群中最 适合运行当前Pod资源的一个节点, 核心目标是基于资源可用性把Pod 资源公平地分布到集群节点上。Scheduler是API Server的客户端, 它注册并监听所有Pod资源规范中spec.nodeName字段的状态变动信息, 并对该字段值为“空”的每个Pod对象启动调度机制。
显然, Pod中的每个容器对资源的需求各不相同, 不同Pod间也可能存在特定共存关系要求, 甚至Node也会有特定的限制条件, 从而调度器的调度决策会涉及单项或整体资源需求、硬件或软件甚至是策略的约束关系、亲和或反亲和性规范、数据的局部性以及工作负载间的干扰等方方面面。因此, 调度器需要根据特定的调度要求对现有节点进行预选, 以过滤掉那些无法满足Pod运行条件的节点, 而后对满足过滤条件的各个节点进行打分, 并按综合得分进行排序, 最后从优先级排序结果中挑选出得分最高节点作为适合目标Pod的最佳节点。如果中 间任何一个步骤返回了错误信息, 调度器就会中止调度过程。调度流程的最后, 调度程序在binding( 绑定) 的过程中将调度决策通知给 API Server, 如图所示, 而后由相应节点的代理程序kubelet启动 Pod的创建和启动等过程。
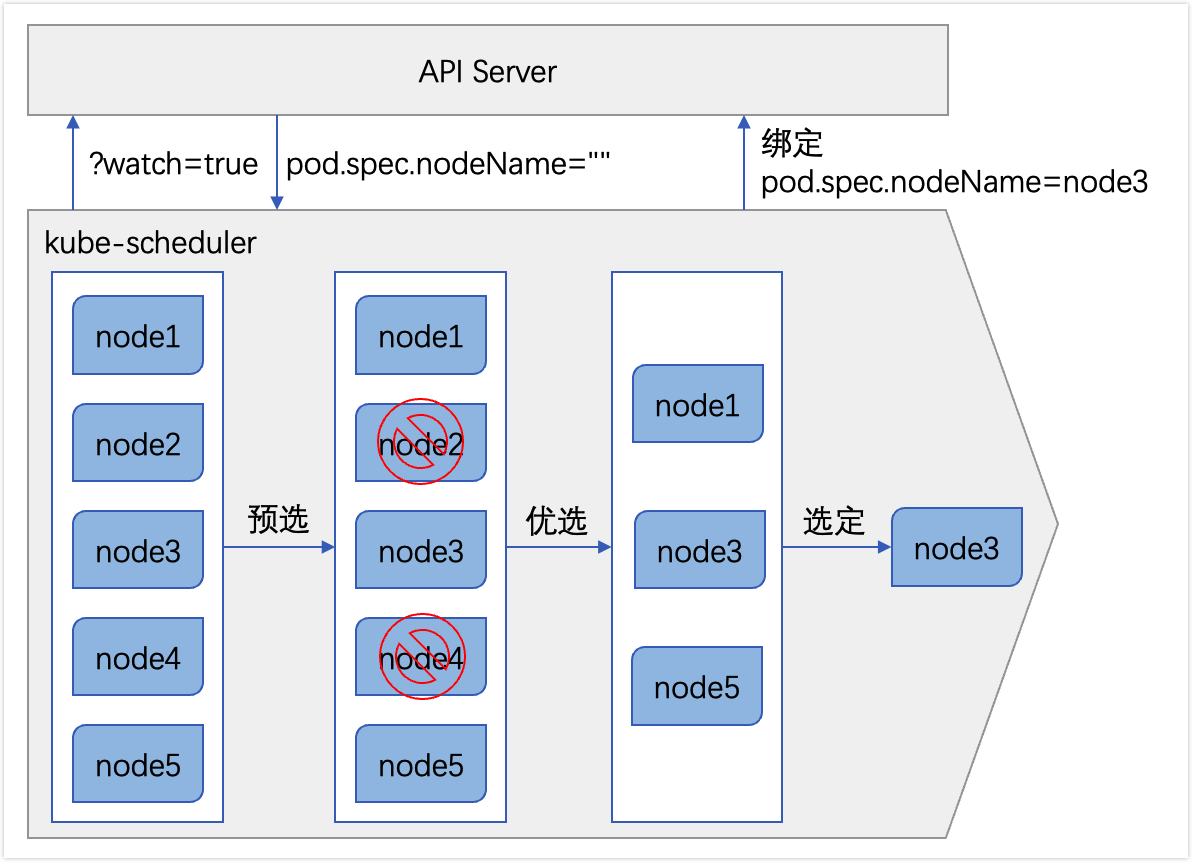
节点预选 : 基于一系列预选规则( 例如
NodeAffinity和VolumeBinding等) 对每个节点进行检查, 将那些不符合筛选条件的节点过滤掉 ; 没有节点满足目标Pod的资源需求时, 该Pod将被置于Pending状态, 直到出现至少一个能够满足条件的节点为止。节点优选 : 根据优先算法( 例如
ImageLocality和PodTopologySpread等) 对预选出的节点打分, 并根据最终得分进行优先级排序。从优先级排序结果中挑出优先级最高的节点运行
Pod对象, 最高优先级节点数量多于一个时, 则从中随机选择一个作为Pod可绑定的目标Node对象。
带有“通用”性质的调度器能在大多数Pod调度场景中工作得很好, 但也必定存在无法满足的需求场景, 例如根据GPU资源用量调度深度学习类的应用Pod的场景等, 扩展新的调度方式成为这类场景中必然要解决的问题。Kubernetes Scheduler支持源代码二次开发、多调度 器、Scheduler Extender和Scheduler Framework等几种扩展方式。
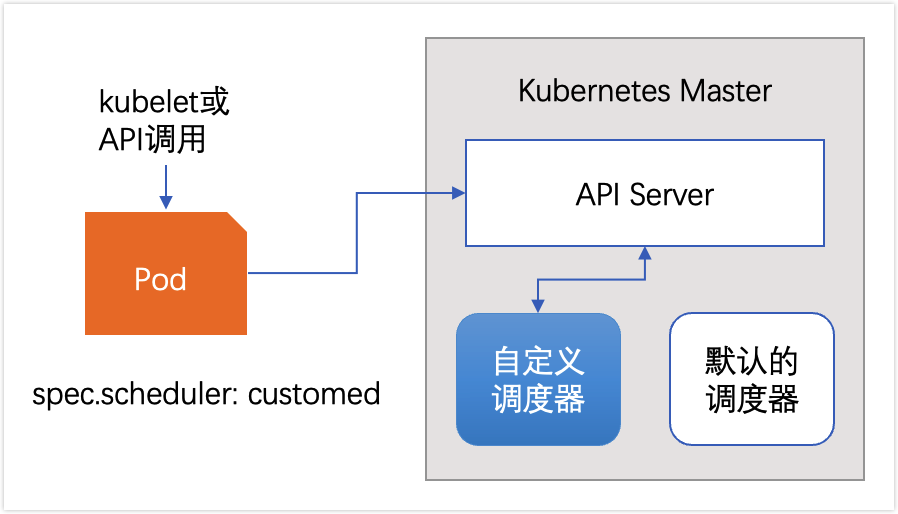
对kube-scheduler源代码进行二次开发( 添加自定义的调度机 制) 的扩展方式, 不仅对团队技术力量有着较高的要求, 也必然会带来程序版本更新方面的难题。比较来说, 同时提供多个调度器程序的扩展方式剥离了与原调度器程序的耦合关系, 这种方式仅要求在那些需要使用自定义调度机制的Pod资源上通过pod.spec.scheduler字段来指定使用的调度器名称即可, 如图所示。显然, 多个独立的调度器彼此间无协作在集群全局紧密地协作。
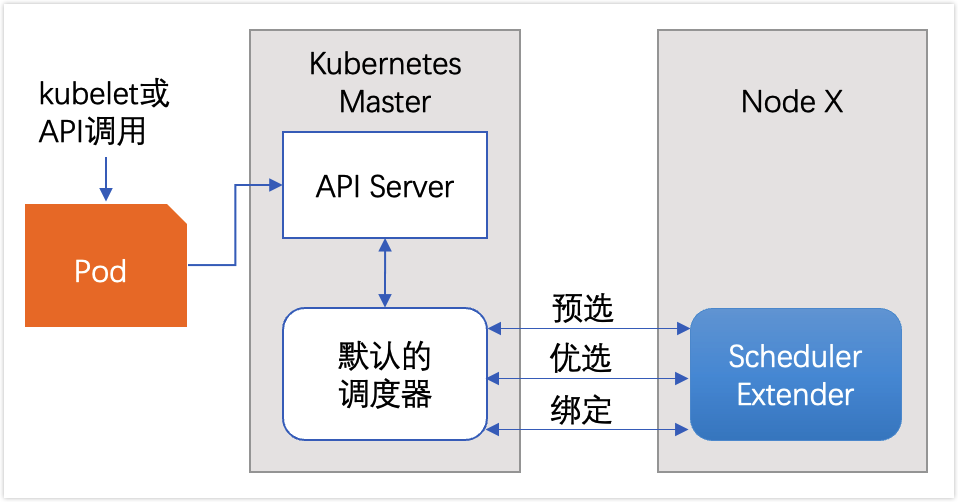
另一种扩展方式是基于Scheduler Extender( Webhook) 在指定的 扩展点对kube-scheduler进行功能扩展, 如图所示。但kube- scheduler这种扩展方式也存在不少的问题, 例如它仅支持 predicate、priority和bind这3个有限的扩展点, 通过Webhook进行扩 展有一定程度上的性能开销、很难中止调度过程, 也无法使用调度器默认的缓存功能等。
Kubernetes自v1.15版本引入调度框架( Scheduling Framework) 为现有的调度程序添加了一组新的“插件”API, 从而调度器支持以插件形式对kube-scheduler进行功能扩展, 如图所示。与Scheduler Extender不同的是, 调度框架支持多插件并存机制, 这些插件根据其功能可以在调度的一个或多个扩展点对原有的调度器进行扩展。调度器插件可根据自身的功能注册到一个或多个扩展点并由调度器进行调 用, 它们或许能够影响调度决策, 也可能仅提供有助于调度决策的信息。
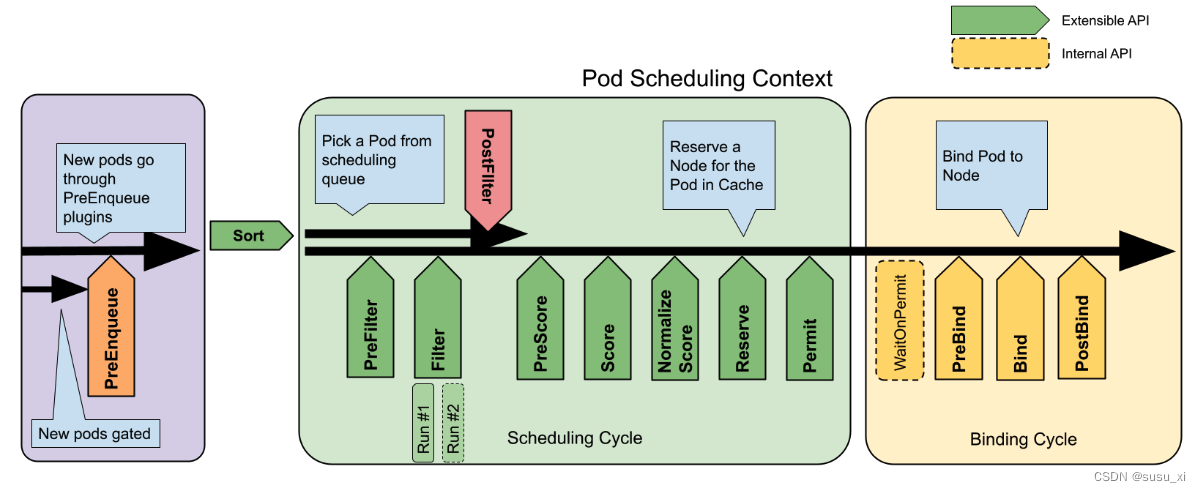
调度框架这种插件式API不仅允许将调度器的大部分调度功能以插件方式实现, 还能让调度“核心”保持简单且易于维护。因而, 传统调度器中的节点预选、优选( 打分) 和绑定等相关的函数代码也都转 而实现为新的调度框架下的插件。
调度框架将每次调度一个Pod的整个过程进一步细分为“调度周期”和“绑定周期”两个阶段, 前者负责为Pod选择一个最佳调度节点, 后者为完成Pod到节点的绑定执行必要的检测或初始化操作等, 它 们联合起来称为“调度上下文”。在图11-5中可以看出, 调度框架提 供了多个扩展点, 事实上, 其中的Filter相当于传统调度器上的 Predicate, Score则是Priority, Bind则保持了原有的名称。下面给出了调度框架支持的各扩展点的简单要功能描述。
QueueSort: 注册到该扩展点的插件负责对调度队列中的Pod资源 进行排序, 但一次仅支持启用单个插件 ;Pod排序队列的存在使得优选 级调度及优选级抢占成为可能。PreFilter:PreFilter类的插件用于预处理Pod相关信息, 或者检查Pod和集群必须满足的条件, 任何错误都将会导致调度过程中止而返回。Filter: 该类型的插件负责过滤无法满足Pod资源运行条件的节点, 对于每一个节点, 调度程序都会按顺序调用每个插件对其进行逐 一评估, 任何插件拒斥该节点都会直接导致该插件被排除, 且不再由 后续的插件进行检查。节点过滤能够以并行方式运行, 并且在一个调 度周期内可以多次调用该扩展点上的插件。PostFilter: 该类插件对成功通过过滤插件检查的节点执行过滤 后操作, 较早版本的调度框架不支持PreScore, 该扩展点后来被重命 名为PreScore, 而Kubernetes v1.19版本又重新添加了该扩展点。PreScore: 该类插件对成功通过过滤插件检查的节点进行预评分, 并生成可由各Score插件共享的状态结果, 任何错误都将导致调度 过程中止而返回。Score和NormalizeScore:Score类插件负责对成功通过过滤的节点进行评分和排序, 对于每个节点, 调度程序会调用每个插件为其打 分 ;NormalizeScore扩展点中注册的插件可为Score扩展点中的同名插 件提供节点得分修正逻辑, 以使得其满足特定的规范( 节点得分满足[MinNodeScore, MaxNodeScore]的范围要求) , 不提供NormalizeScore插件的话,Score插件自身必须确保得分满足该规范, 否则调度周期将被中止。Reserve: 信息类扩展点, 一般用于为给定的Pod保留目标节点上 的特定资源时提供状态信息, 以避免将Pod绑定到目标节点的过程中发 生资源争用。Permit: 该类型插件用于准许(approve) 、阻止(deny) 或延迟(wait)Pod资源的绑定, 所有插件都返回approve才意味着该Pod可进入绑定周期, 任意一个插件返回deny都会导致Pod重新返回调度队列, 并触发Unreserve类型的插件, 而返回wait则意味着Pod将保持在该阶段, 直接批准而返回approve或超时而返回deny。PreBind: 负责执行绑定Pod之前所需要的所有任务, 例如设置存储卷等 ; 任何插件返回错误都会导致该Pod被打回调度队列。Bind: 所有的PreBind类插件完成之后才能运行该类插件, 以将Pod绑定至目标节点上, 各插件依照其配置的顺序进行调用, 或者由某 个特定的插件全权“处理”该Pod, 从而跳过后续的其他插件。PostBind: 信息类扩展点, 相关插件在Pod成功绑定之后被调用, 通常用于设置清单关联的资源。Unreserve: 信息类扩展点, 对于在Reserve扩展点预留了资源的Pod对象, 因被其他扩展点插件所拒绝时, 可由该扩展点通知取消为其预留的资源 ; 一般来说, 注册到该扩展点的插件也必将注册到Reserve扩展点之上。
调度器框架允许单个调度器插件实现多个扩展点, 这意味着, 我们可以按需在一个插件中只实现一个扩展点, 也可以同时实现多个扩 展点, 例如, 内置的插件InterPodAffinity同时实现了PreFilter、 Filter、PreScore和Score扩展点。不过, 除非特别有必要, 否则应该尽力避免将同一个功能需求在不同的插件中重复实现。
Kubernetes自v1.18版本起将Scheduling Framework作为调度器的 默认实现, 此前基于Predicate、Priority和Bind的调度与扩展逻辑正式进入废弃阶段。为了便于描述, 我们把Kubernetes v1.17及之前版 本中使用的调度器模型称为经典调度器, 将其使用的调度模型及配置称为经典调度策略。
1.2 经典调度策略
如前所述, Kubernetes通用调度程序提供的经典调度策略使用 Predicate和Priority函数实现核心调度功能, 并支持多调度器和 Extender的扩展方式。预选函数是节点过滤器, 负责根据待调度Pod的 计算资源和存储资源需求, 以及节点亲和关系及反亲和关系规范等来 过滤节点。优选函数是节点优选级排序工具, 负责基于各节点上当前 的资源水位、Pod与Node的亲和或反亲和关系、Pod之间的亲和或反亲 和关系, 以及尽可能将同一组Pod资源合理分散到不同节点上的方式对 过滤后的节点进行优选级排序, 最高优选级的节点即为待调度Pod资源 的最佳运行节点。
1.2.1 节点预选
预选操作会针对所有或特定样本数量的节点进行, 对于每一个节 点, 调度器将使用配置的预选函数以特定次序进行逐一筛查, 其中任何一个预选函数的否决都将导致该节点被过滤掉。若不存在任何一个 满足条件的节点, 则Pod将被置于Pending状态, 直到至少有一个节点用。Kubernetes的每个版本支持的预选函数都可能会发生变动, 图给出了Kubernetes v1.17支持的各预选函数及它们的应用次序, 实线边框标识的为kube-scheduler程序默认启用的函数。
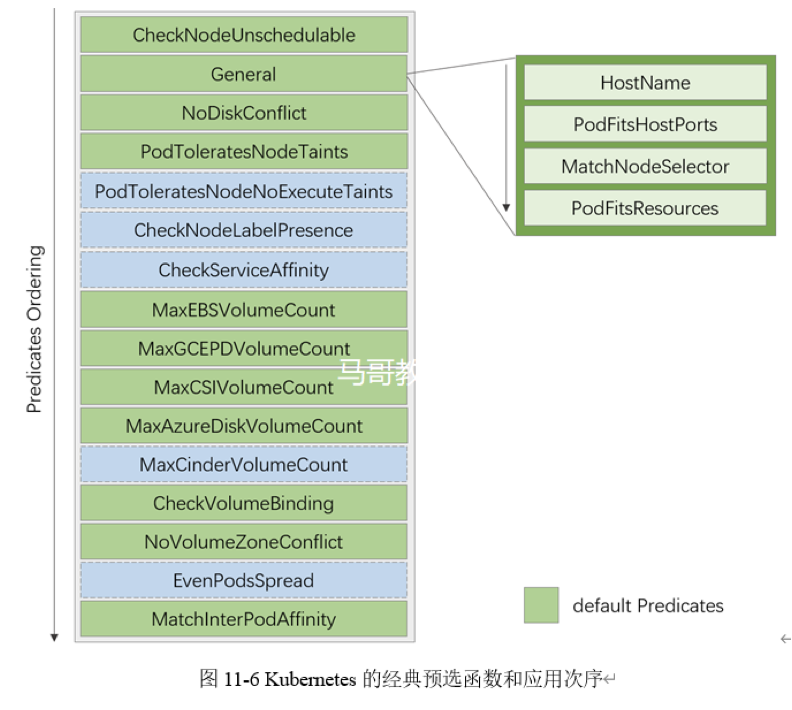
这些预选函数根据指定判定标准及各Node对象和当前Pod对象能否适配, 按照实现的主要目标大体可分为如下几类。
节点存储卷数量限制检测 :
MaxEBSVolumeCount、MaxGCEPDVolumeCount、MaxCSIVolumeCount、MaxAzureDiskVolumeCount和MaxCinderVolumeCount。检测节点状态是否适合运行
Pod:CheckNodeUnschedulable和CheckNodeLabel-Presence。Pod与节点的匹配度检测 :Hostname、PodFitsHostPorts、MatchNodeSelector、NoDisk-Conflict、PodFitsResources、PodToleratesNodeTaints、PodToleratesNodeNoExecuteTaints、CheckVolumeBinding和NoVolumeZoneConflict。Pod间的亲和关系判定 :MatchInterPodAffinity。将一组
Pod打散至集群或特定的拓扑结构中 :CheckServiceAffinity和EvenPods-Spread。
在Kubernetes Scheduler上启用相应的预选函数才能实现相关调 度机制的节点过滤需求, 下面给出了这些于Kubernetes v1.17版本中支持的各预选函数的简要功能, 其中仅ServiceAffinity和 CheckNodeLabelPresence支持自定义配置, 余下的均为静态函数。
CheckNodeUnschedulable: 检查节点是否被标识为Unschedulable, 以及是否将Pod调度到该类节点之上。HostName: 若Pod资源通过spec. nodeName明确指定了要绑定的目标节点, 则节点名称与与该字段值相同的节点才会被保留。PodFitsHostPorts: 若Pod容器定义了ports.hostPort属性, 该预选函数负责检查其值指定的端口是否已被节点上的其他容器或服务所占用, 该端口已被占用的节点将被过滤掉。MatchNodeSelector: 若Pod资源规范上定义了spec.nodeSelector字段, 则仅拥有匹配该标签选择器的标签节点才会被保留。NoDiskConflict: 检查Pod对象请求的存储卷在此节点是否可用, 不存在冲突则通过检查。PodFitsResources: 检查节点是否有足够资源( 例如CPU、内存和GPU等) 满足Pod的运行需求。节点声明其资源可用容量, 而Pod定义其资源需求, 于是调度器会判断节点是否有足够的可用资源运行Pod对象, 无法满足则返回失败原因( 例如,CPU或内存资源不足等) 。调度器评判资源消耗的标准是节点已分配资源量( 各容器的requests值 之和) , 而非节点上各Pod已用资源量, 但那些在注解中标记为关键性的Pod资源则不受该预选函数控制。PodToleratesNodeTaints: 检查Pod的容忍度 (spec.tolerations字段) 是否能够容忍该节点上的污点, 不过它仅关注带有NoSchedule和NoExecute两个效用标识的污点。PodToleratesNodeNoExecuteTaints: 检查Pod的容忍度是否能接纳节点上定义的NoExecute类型的污点。CheckNodeLabelPresence: 检查节点上某些标签的存在性, 要 检查的标签以及其可否存在取决于用户的定义。在集群中的部署节点以regions/zones/racks类标签的拓扑方式编制, 且基于该类标签对相 应节点进行了位置标识时, 预选函数可以根据位置标识将Pod调度至此类节点之上。CheckServiceAffinity: 根据调度的目标Pod对象所属的Service资源已关联的其他Pod对象的位置( 所运行节点) 来判断当前Pod可运行的目标节点, 目的在于将同一Service对象的Pod放置在同一 拓扑内( 如同一个rack或zone) 的节点上以提高效率。MaxEBSVolumeCount: 检查节点上已挂载的EBS存储卷数量是否超过了设置的最大值。MaxGCEPDVolumeCount: 检查节点上已挂载的GCE PD存储卷数 量是否超过了设置的最大值, 默认值为16。MaxCSIVolumeCount: 检查节点上已挂载的CSI存储卷数量是 否超过了设置的最大值。MaxAzureDiskVolumeCount: 检查节点上已挂载的Azure Disk存储卷数量是否超过了设置的最大值, 默认值为16。MaxCinderVolumeCount: 检查节点上已挂载的Cinder存储卷数量是否超过了设置的最大值。CheckVolumeBinding: 检查节点上已绑定和未绑定的PVC是否能满足Pod的存储卷需求, 对于已绑定的PVC, 此预选函数检查给定节点是否能兼容相应PV, 而对于未绑定的PVC, 预选函数搜索那些可满足PVC申请的可用PV, 并确保它可与给定的节点兼容。NoVolumeZoneConflict: 在给定了存储故障域的前提下, 检测节点上的存储卷是否可满足Pod定义的需求。EvenPodsSpread: 检查节点是否能满足Pod规范中topologySpreadConstraints字段定义的约束, 以支持Pod的拓扑感知调度。MatchInterPodAffinity: 检查给定节点是否能满足Pod对象的亲和性或反亲和性条件, 用于实现Pod亲和性调度或反亲和性调度。
1.2.2 节点优选
成功通过预选函数过滤的节点将生成一个列表, 调度流程随后进入优先级排序阶段。各优选函数主要评定成功通过过滤检查的节点对运行该Pod资源的适配程度。对于每个节点, 调度器会使用各个拥有权重值的优选函数分别为其打分( 0~10之间的分数) , 优选函数得出的初始分值乘以其权重为该函数最终分值, 而各个优选函数的最终分值之和则是该节点的最终得分, 如下面的公式所示。因此, 通用调度器为优选函数提供的权重属性赋予了管理员定义优先函数倾向性的能力。
finalScoreNode = (weight1 * priorityFunc1) + (weight2 * priorityFunc2) + …下面仍然以Kubernetes v1.17版本为例来说明其支持的各优选函数及其功能, 图给出了该版本支持的各优选函数, 实线边框标识的为kube-scheduler程序默认启用的优选函数。这些优选函数依然可大体分为节点资源对Pod的适配、节点对Pod的亲和性或反亲和性、Pod 间的亲和性或反亲和性, 以及将Pod打散为几个评估目标。
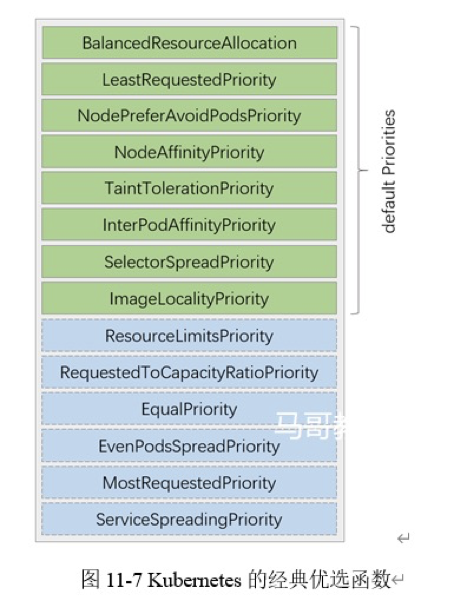
下面对这些经典优选函数进行介绍。
LeastRequestedPriority: 优先将Pod打散至集群中的各节点之上, 以让各节点有近似的计算资源消耗比例, 适用于集群规模变动较 少的场景 ; 其分值由节点空闲资源与节点总容量的比值计算而来, 即由CPU或内存资源的总容量减去节点上已有Pod对象需求的容量总和, 再减去当前要创建的Pod对象的需求容量得到的结果除以总容量。CPU和内存具有相同权重, 资源空闲比例越高的节点得分也就越高, 其计 算公式为 :(cpu((capacity – sum(requested)) * 10 / capacity) + memory((capacity – sum(requested)) * 10 / capacity)) / 2。MostRequestedPriority: 与优选函数LeastRequestedPriority评估节点得分的方法相似, 但二者不同的是, 当前函数将给予计算资源占用比例更大的节点以更高的得分, 计算公式为 :(cpu((sum(requested)) * 10 / capacity) + memory((sum(requested)) * 10 / capacity))/ 2。该函数的目标在于优先让节点以满载的方式承载Pod资源, 从而能够使用更少的节点 数, 因而较适用于节点规模可弹性伸缩的集群中, 以最大化地节约节点数量。BalancedResourceAllocation: 以CPU和内存资源占用率的相近 程度作为评估标准, 二者越接近的节点权重越高。该优选函数不能单 独使用, 它需要和Least-RequestedPriority组合使用来平衡优化节点资源的使用状态, 选择在部署当前Pod资源后系统资源更为均衡的节点。ResourceLimitsPriority: 以是否能够满足Pod资源限制为评估 标准, 能够满足Pod对CPU或( 和) 内存资源限制的节点将计1分, 节点 未声明可分配资源或Pod未定义资源限制时不影响节点计分。RequestedToCapacityRatio: 该函数允许用户自定义节点各类资 源( 例如CPU和内存等) 的权重, 以便提高大型集群中稀缺资源的利用 率 ; 该函数的行为可以通过名为requestedToCapacityRatioArguments的配置选项进行控制, 它由shape和resources两个参数组成。NodeAffinityPriority: 节点亲和调度机制, 它根据Pod资源规范中的spec.node-Selector来对给定节点进行匹配度检查, 成功匹配 到的条目越多则节点得分越高。不过, 其评估过程使用表示首选亲和的标签选择器PreferredDuringSchedulingIgnoredDuringExecution。ImageLocalityPriority: 镜像亲和调度机制, 它根据给定节点上是否拥有运行当前Pod对象的容器所依赖的镜像文件来计算节点得分值, 没有Pod对象所依赖的任何镜像文件的节点得分为0, 而存在相关镜像文件的各节点中, 被Pod依赖到的镜像文件的体积之和越大的节点得分越高。TaintTolerationPriority: 基于Pod资源对节点的污点容忍调度偏好进行优先级评估, 它将Pod对象的tolerations列表与节点的污点进行匹配度检查, 成功匹配的条目越多, 则节点得分越低。SelectorSpreadPriority: 尽可能分散Pod至不同节点上的调度机制, 它首先查找标签选择器能匹配当前Pod标签的ReplicationController、ReplicaSet和StatefulSet等控制器对象, 而后查找可由这类对象的标签选择器匹配的现存各Pod对象及其所在的节点, 而运行此类Pod对象越少的节点得分越高。简单来说, 如其名称所示, 此优选函数尽量把同一标签选择器匹配到的Pod资源打散到不同的节点上运行。ServiceSpreadingPriority: 类似于SelectorSpreadPriority, 它首先查找标签选择器能匹配当前Pod标签的Service对象, 而后查找可由这类Service对象的标签选择器匹配的现存各Pod对象及其所在的节点, 而运行此类Pod对象越少的节点得分越高。EvenPodsSpreadPriority: 用于将一组特定的Pod对象在指定的 拓扑结构上进行均衡打散, 打散条件定义在Pod对象的spec.topologySpreadConstraints字段上, 它内嵌labelSelector字段指定标签选择器以匹配符合条件的Pod对象, 使用topologyKey字段指定目标拓扑结构, 使用maxSkew描述最大允许的不均衡数量, 而无法满 足指定调度条件时的评估策略则由whenUnsatisfiable字段定义, 它有 两个可用取值, 默认值DoNotSchedule表示不予调度, 而ScheduleAnyway则表示以满足最小不均衡值的标准进行调度EqualPriority: 设定所有节点具有相同的权重1。InterPodAffinityPriority: 遍历Pod对象的亲和性条目, 并将 那些能够匹配到给定节点的条目的权重相加, 结果值越大的节点得分越高。NodePreferAvoidPodsPriority: 此优选级函数权限默认为10000, 它根据节点是否设置了注解信息scheduler.alpha.kubernetes.io/preferAvoidPods来计算其优选级。 计算方式是, 给定的节点无此注解信息时, 其得分为10乘以权重10000, 存在此注解信息时, 由ReplicationController或ReplicaSet控制器管控的Pod对象的得分为0, 其他Pod对象会被忽略( 得最高分) 。
这些优选函数中, LeastRequestedPriority和 BalancedResourceAllocationPriority的目标是根据节点的可分配资源状态优先打散Pod并均衡分配至集群节点, 而MostRequestedPriority的目标刚好相反, 它是优先将Pod“堆满”一 个节点后再启用下一个, 因而它们彼此间互斥。
另外, 除了程序中的默认配置, kube-scheduler启用的预选函数 和优选函数也能够通过称为调度策略的配置文件进行自定义。自定义的调度配置文件遵循JSON格式且必须命名为policy.cfg, 启用后它将 完全覆盖默认的调度策略, 因此需要用到的任何预选函数或优选函数 必须要在该文件中显式声明。
1.3 调度器插件
随着Kubernetes版本的快速演进, 内置的插件也可能会随之快速变动, 目前的v1.19版提供了20多个调度器插件, 调度周期中与过滤和 打分相关的插件同样大体用于检查节点与Pod的匹配度、节点自身的调度限制、Pod与节点的亲和性或反亲和性、Pod间的亲和性与反亲和 性, 以及将Pod打散到集群或指定拓扑结构中的节点上等不同的目标。
PrioritySort: 用于为调度队列提供基于Pod优先级的排序方式, 仅实现了QueueSort扩展点。DefaultPreemption: 用于为调度流程提供默认的抢占逻辑, 仅 实现了PostFilter扩展点。ImageLocality: 功能类似于同名的优选函数, 仅负责实现Score扩展点。TaintToleration: 用于实现基于Pod容忍度和Node污点的调度机制, 它实现了Filter、PreScore和Score这3个扩展点。NodeName: 纯过滤器, 仅实现了Filter扩展点, 负责检查节点名 称与Pod资源规范中的spec.nodeName值是否一致。NodePorts: 检查Pod请求使用的节点端口在该节点上是否可用, 实现了PreFilter和Filter扩展点。NodePreferAvoidPods: 根据节点上的注解scheduler.alpha.kubernetes.io/preferAvoidPods对节点进行打分, 默认权重较高(10000) , 它仅实现了Score扩展点。NodeAffinity: 负责实现基于Pod规范的nodeSelector或节点亲和(nodeAffinity) 的调度机制, 它支持Filter和Score扩展点。NodeUnschedulable: 纯过滤器, 仅实现了Filter扩展点, 负责 将那些.spec.unschedulable字段值为true的节点过滤掉。NodeLabel: 根据节点上配置的标签进行节点过滤和打分, 实现 了Filter和Score两个扩展点。VolumeBinding: 检查Pod请求的存储卷在节点上是否可用, 实现 了Filter、Reserve、Unreserve和PreBind扩展点。VolumeRestrictions: 检查节点上挂载的某种特定类型的存储卷是否能满足限制, 仅实现了Filter扩展点。VolumeZone: 检查节点上的存储卷是否能满足zone限制, 仅实现 了Filter扩展点。InterPodAffinity: 用于实现Pod间的亲和或反亲和调度, 实现 了PreFilter、Filter、PreScore和Score扩展点。DefaultTopologySpread: 倾向于将Service、ReplicaSets或StatefulSets的Pod对象打散并分布到集群不中同的节点之上 ; 该插件实现的扩展点有PreScore和Score两个。PodTopologySpread: 用于控制Pod在集群region/zone/rack/node故障域或者用户自定义的拓扑域中的分布, 是支撑PodtopologySpreadConstraints特性的基础组件 ; 该插件实现的 扩展点有PreFilter、Filter、PreScore和Score。ServiceAffinity: 同一Service下的Pod对象的反亲和调度机制, 倾向于将该Pod资源同其自身所属的Service对象的其他Pod分散运行于不同的节点, 实现的扩展点有PreFilter、Filter和Score。
不过, 经典调度器中的预选函数PodFitsResources, 以及优选函 数LeastRequested、MostRequested、BalancedResourceAllocation和 RequestedToCapacityRatio的功能被整合在名为noderesources的插件目录下, 但它们仍以独立的插件名称工作, 因而仍可被视作独立的调 度器插件, 下面是这几个插件的功能说明。
NodeResourcesFit: 在功能上对应于预选函数PodFitsResources, 仅用于实现Filter扩展点。NodeResourcesLeastAllocated: 功能上对应于优选函数LeastRequestedPriority, 仅用于实现Score扩展点。NodeResourcesBalancedAllocation: 功能上对应于优选函数BalancedResource-Allocation, 仅用于实现Score扩展点。 ▪NodeResourcesMostAllocated: 功能上对应于优选函数MostRequestedPriority, 且功能与NodeResourcesLeastAllocated互斥, 二者通常不应该同时使用, 仅用于实现Score扩展点。RequestedToCapacityRatio: 功能上对应于优选函数RequestedToCapacityRatio, 通常仅用于实现Score扩展点。
另外, 经典调度器中使用的检测节点上特定类型存储卷数量限制 的预选函数( 例如MaxEBSVolumeCount和MaxCSIVolumeCount等) 也被整合进同一个插件目录( nodevolumelimits) 中, 但它们各自仍然作为独立的插件使用, 且仅能用于实现Filter扩展点。下面几个是这类 插件的功能说明。
NodeVolumeLimits: 功能同预选函数MaxCSIVolumeCount, 检测节点是否满足指定的CSI存储插件类型上的存储卷数量限制。EBSLimits: 功能同预选函数MaxEBSVolumeCount, 检测节点是否 满足EBS存储卷数量限制, 默认为16个。AzureDiskLimits: 功能同预选函数MaxAzureDiskVolumeLimit, 检测节点是否满足AzureDisk存储卷数量限制。CinderLimits: 功能同预选函数MaxCinderVolumeCount, 检测节 点是否可满足Cinder存储卷数量限制。GCEPDLimits: 功能同预选函数MaxGCEPDVolumeCount, 检测节点 是否满足GCE PD存储卷数量限制。
目前, 可用于绑定周期的内置调度器插件仅DefaultBinder一个, 它为调度流程提供默认的Bind机制, 而且仅实现了Bind扩展点。
与经典调度器使用调度策略进行配置有所不同的是, 调度框架使 用调度配置来为调度器提供自定义的配置信息。启用了调度框架的 kube-scheduler会自动创建一个名为default-scheduler的Profile文件, 它默认启用除NodeResourcesMostAllocated、 RequestedToCapacityRatio、CinderLimits、NodeLabel和 ServiceAffinity之外的其他调度插件。
1.4 配置调度器
调度器程序kube-scheduler使用KubeSchedulerConfiguration格式的配置文件, 且支持通过--config选项加载用户自定义的遵循该格式的配置文件。该类配置文件遵循YAML或JSON数据规范, 隶属于 kubescheduler.config.k8s.io这一API群组。截至本章编写时, 该API 群组存在v1alpha2和v1beta1两个主要版本, Kubernetes v1.18及之后的版本才能支持v1alpha2, 且自Kubernetes v1.20版本晋升为 v1beta1。下面列出了v1alpha2版本的简要配置格式。
apiVersion: kubescheduler.config.k8s.io/v1alpha2 # v1alpha2版本
kind: KubeSchedulerConfiguration
AlgorithmSource:  # 指定调度算法配置源, 从v1alpha2版本起该配置进入废弃阶段
  Policy :                         # 基于调度策略的调度算法配置源
    File:                         # 文件格式的调度策略
      Path <string>:              # 调度策略文件policy.cfg的位置
    ConfigMap:                    # ConfigMap格式的调度策略
      Namespace <string>          # 调度策略ConfigMap资源隶属的名称空间
      Name <string>               # ConfigMap资源的名称
  Provider <string>               # 配置使用的调度算法的名称, 例如
DefaultProvider
LeaderElection: {}                # 多kube-scheduler实例并存时使用的领导选举算法
ClientConnection: {}              # 与API Server通信时提供给代理服务器的配置信息
HealthzBindAddress <string>       # 响应健康状态检测的服务器监听的地址和端口
MetricsBindAddress <string>       # 响应指标抓取请求的服务器监听的地址和端口
DisablePreemption <bool>          # 是否禁用抢占模式, false表示不禁用
PercentageOfNodesToScore <int32>  # 需要过滤出的可用节点百分比
BindTimeoutSeconds  <int64>       # 绑定操作的超时时长, 必须使用非负数
PodInitialBackoffSeconds  <int64> # 不可调度Pod的初始补偿时长, 默认值为1
PodMaxBackoffSeconds <int64>      # 不可调度Pod的最大补偿时长, 默认为10
Profiles <[]string> # 加载的KubeSchedulerProfile配置列表, v1alpha2支持加载多个配置列表
Extenders <[]Extender> # 加载的Extender列表由上面的KubeSchedulerConfiguration配置格式可知, 目前 Kubernetes Scheduler支持调度策略和调度配置两种调度器配置机制, 前者遵循传统调度器的预选、优选和选择等工作逻辑, 而后者则仅能够由新式调度框架通过扩展点来支持。
提示
kube-scheduler默认会生成KubeSchedulerConfiguration格式的配置, 我们可通过其命令行选项--write-config-to将其输出到指定的文件中。
1.4.1 调度策略
调度策略通过指定预选策略和优选函数分别实现节点过滤与计分功能, 相关的策略可保存在配置文件或ConfigMap资源中, 而后在 KubeSchedulerConfiguration配置中由AlgorithmSource字段引用, 或 者直接在kube-scheduler程序上使用选项进行指定。传统的调度策略简要配置格式如下所示。
kind: Policy
apiVersion: v1
Predicates <[]object>                 # Predicate对象列表
- Name <string>                       # Predicate名称
  Argument <Object>                   # 可选字段, 仅允许自定义配置的Predicate支持
Priorities <[]object>                 # Priority对象列表
- Name <string>                       # Priority名称
  Weight <int>                        # 权重
  Argument <Object>                   # 可选字段, 仅允许自定义配置的Priority支持
Extenders <[]object>                  # 加载的Extender列表
HardPodAffinitySymmetricWeight <int>  # Pod强制亲和调度关联的隐式首选亲和规则权重
AlwaysCheckAllPredicates <bool>       # 是否禁用Predicate进行节点过滤时的短路模式
下面示例( policy.cfg) 定义了一个不同于程序默认配置的调度策略, 它启用了Even-PodsSpreadPriority策略支持的Pod规范中由 topologySpreadConstraints定义的约束规则。
kind: Policy
apiVersion: v1
predicates:
- name: GeneralPredicates
- name: MaxCSIVolumeCountPred
- name: CheckVolumeBinding
- name: EvenPodsSpread
- name: MatchInterPodAffinity
- name: CheckNodeUnschedulable
- name: NoDiskConflict
- name: NoVolumeZoneConflict
- name: MatchNodeSelector
- name: PodToleratesNodeTaints
priorities:
- {name: LeastRequestedPriority, weight: 1}
- {name: BalancedResourceAllocation, weight: 1}
- {name: ServiceSpreadingPriority, weight: 2}
- {name: EvenPodsSpreadPriority, weight: 1}
- {name: TaintTolerationPriority, weight: 1}
- {name: ImageLocalityPriority, weight: 2}
- {name: SelectorSpreadPriority, weight: 1}
- {name: InterPodAffinityPriority, weight: 1}
- {name: EqualPriority, weight: 1}我们随后为kube-scheduler提供一个自定义的 KubeSchedulerConfiguration配置文件, 让它通过文件路径来引用自 定义的调度策略。下面的示例( kubeschedconf-v1alpha1-demo.yaml) 指定了基于v1alpha1的API版本从指定的文件处加载调度策略配置文件policy.cfg。
apiVersion: kubescheduler.config.k8s.io/v1alpha1
kind: KubeSchedulerConfiguration
bindTimeoutSeconds: 600
algorithmSource:
  policy:
    file:
      path: /etc/kubernetes/scheduler/policy.cfg
  provider: DefaultProvider
clientConnection:
  kubeconfig: "/etc/kubernetes/scheduler.conf"
disablePreemption: false将这两个文件放在控制平面节点k8s-master01主机上的某个目录 下( 例如/etc/kubernetes/ scheduler) , 然后编 辑/etc/kubernetes/manifests/kube-scheduler.yaml文件, 为kube-scheduler添加存储卷以及--config选项来引用它, 其中关键的配置部分如下所示。
spec:
  containers:
  - command:
    - kube-scheduler
    ……
    - --config=/etc/kubernetes/scheduler/kubeschedconf-v1alpha1-demo.yaml
   ……
    volumeMounts:
    ……
    - mountPath: /etc/kubernetes/scheduler
      name: scheduler-config
      readOnly: true
  volumes:
  ……
  - hostPath:
      path: /etc/kubernetes/scheduler
      type: Directory
name: scheduler-config待Kubernetes Scheduler的Pod重新加载配置并启动完成后, 我们可以在日志中看到加载指定Predicate和Priority函数的信息。接下来即可通过创建Pod对象来测试自定义调度策略的生效效果。另外, 通过 KubeSchedulerConfiguration引用指定的Extender, 我们还能够使用 调度器的经典扩展方式来添加外挂扩展。
1.4.2 调度配置
调度配置支持管理员为调度框架的各扩展点指定要调用的插件, 相关的配置定义在KubeSchedulerConfiguration配置文件的profile字段中。自API群组kubescheduler.config.k8s.io的v1alpha2版本起始, kube-scheduler支持同时使用多个Profile, 每个Profile拥有唯 一的名称标识, 并可由Pod资源在spec.schedulerName显式调用。调度框架默认会创建一个名为default-scheduler的配置文件, 它启用了大部分的调度插件, 而且是Pod资源默认使用的调度器。Profile的配置格式如下所示, 配置默认的调度器或添加新的调度器时, 需要在程序 默认启用的调度插件的基础上“启用”或“禁用”指定的插件。
SchedulerName <string>      # 当前Profile的名称
Plugins <Object>            # 插件配置对象
  <ExtendPoint> <Object>    # 配置指定的扩展点, 例如QueueSort, 每个扩展点按名称指定
    Enabled <[]Plugin>      # 启用的插件列表
    - Name <string>         # 插件名称
      Weight <int32>        # 插件权重, 仅Score扩展点支持
    Disabled <[]Plugin>     # 禁用的插件列表
    - Name <string>         # 插件名称
      Weight <int32>        # 插件权重
PluginConfig <[]Object>     # 插件特有的配置
- Name <string>             # 插件名称
Args <Object> # 配置信息下面的KubeSchedulerConfiguration配置示例( kubeschedconf-v1alpha2-demo.yaml) 中, 在profile字段中默认的default-scheduler之外添加了一个名为demo-scheduler的自定义调度器, 它采用了优先在节点上堆叠Pod的调度方式, 适合集群可弹性伸缩的环境中。
apiVersion: kubescheduler.config.k8s.io/v1alpha2
kind: KubeSchedulerConfiguration
clientConnection:
  kubeconfig: "/etc/kubernetes/scheduler.conf"
disablePreemption: false
profiles:
- schedulerName: default-scheduler
- schedulerName: demo-scheduler
  plugins:
    score:
      disabled:
      - name: NodeResourcesBalancedAllocation
        weight: 1
      - name: NodeResourcesLeastAllocated
        weight: 1
      enabled:
      - name: NodeResourcesMostAllocated
        weight: 5
采用与前一节类似的配置方式, 让kube-scheduler重新加载自定义的KubeScheduler-Configuration配置文件后, 即可借助Deployment 控制器创建多个Pod副本进行测试, 唯一的特殊要求是要在Pod模板上使用spec.schedulerName指定调度器为demo-scheduler。按照定义, 调度器将所有副本堆满一个节点后, 才会启用另一个节点。本章提供的用于测试的配置清单示例scheduler-test.yaml中定义了一个 Deployment对象, Pod模板定义了使用demo-scheduler调度器, 且请求使用1000MB的CPU资源和512MiB的内存资源, 它会在第一个节点无法容 纳某个Pod对象的CPU或内存资源需求时转而使用第二个节点 , 感兴趣 的读者可自行测试。
对于Kubernetes v1.20及上的版本, 我们也提供了一个用于测试的示例配置文件kubeschedconf-v1beta1-demo.yaml, 感兴趣的读者可 自行测试其使用机制。
2 节点亲和调度
节点亲和是调度程序用来确定Pod对象调度位置( 哪个或哪类节 点) 的调度法则, 这些规则基于节点上的自定义标签和Pod对象上指定的标签选择器进行定义, 而支持这种调度机制的有NodeName和 NodeAffinity调度插件。简单来说, 节点亲和调度机制支持Pod资源定义自身对期望运行的某类节点的倾向性, 倾向于运行指定类型的节点即为“亲和”关系, 否则即为“反亲和”关系。
在Pod上定义节点亲和规则时有两种类型的节点亲和关系 : 强制 ( required) 亲和和首选( preferred) 亲和, 或分别称为硬亲和与软亲和, 本书会不加区别地使用这两种称呼。强制亲和限定了调度Pod资源时必须要满足的规则, 无可用节点时Pod对象会被置为Pending状态, 直到满足规则的节点出现。相比较来说, 首选亲和规则实现的是 一种柔性调度限制, 它同样倾向于将Pod运行在某类特定的节点之上, 但无法满足调度需求时, 调度器将选择一个无法匹配规则的节点, 而 非将Pod置于Pending状态。
在Pod规范上定义节点亲和规则的关键点有两个 : 一是给节点规划并配置合乎期望的标签 ; 二是为Pod对象定义合理的标签选择器。正如 preferredDuringSchedulingIgnoredDuringExecution和 requiredDuringSchedulingIgnoredDuringExecution字段名字中的后半段符串IgnoredDuringExecution隐含的意义所指, 在Pod资源基于节点亲和规则调度至某节点之后, 因节点标签发生了改变而变得不再符合Pod定义的亲和规则时, 调度器也不会将Pod从此节点上移出, 因而亲和调度仅在调度执行的过程中进行一次即时的判断, 而非持续地监 视亲和规则是否能够得以满足。图中简单给出这种亲和关系作用机 制的示意图, 简便起见, 图中将 requiredDuringSchedulingIgnoredDuringExecution字段缩写为 required一词。
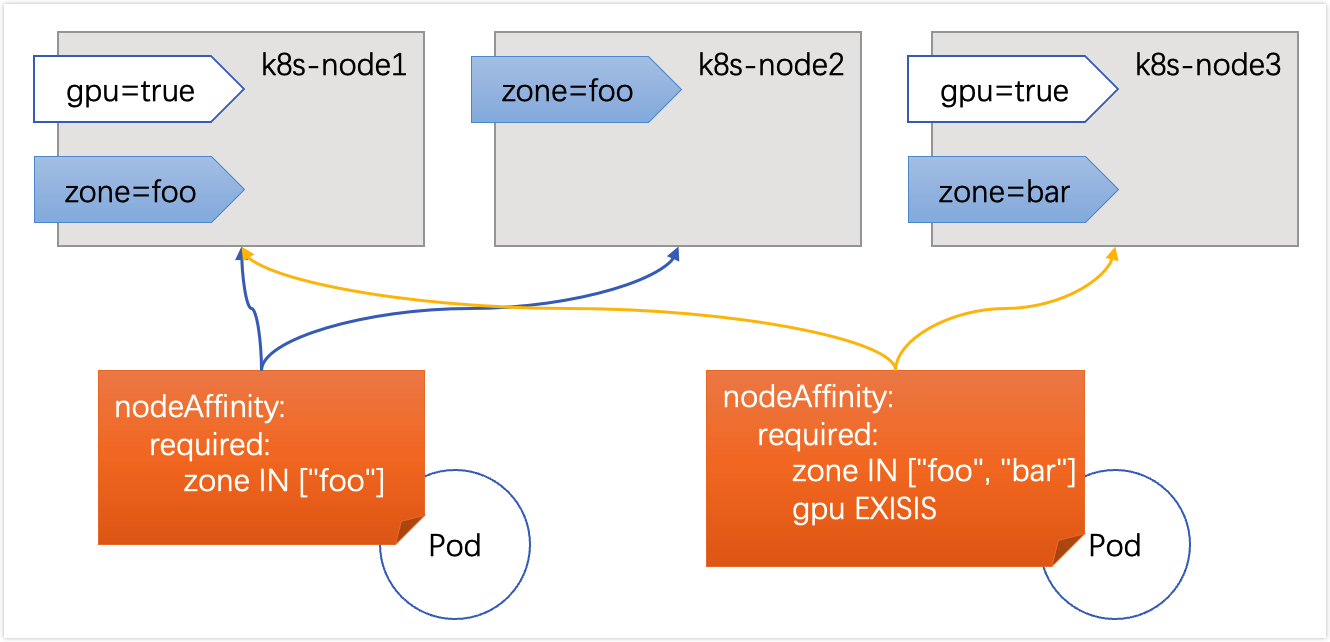
2.1 Pod节点选择器
Pod资源可以使用.spec.nodeName直接指定要运行的目标节点, 也可以基于.spec.nodeSelector指定的标签选择器过滤符合条件的节点作为可用目标节点, 最终选择则基于打分机制完成。因此, 后者也称 为节点选择器。用户事先为特定部分的Node资源对象设定好标签, 而 后即可配置Pod通过节点选择器实现类似于节点的强制亲和调度。
由kubeadm部署的Kubernetes集群默认会为每个节点附加 kubernetes.io/arch、kubernetes.io/hostname和kubernetes.io/os 等标签, 而且主节点还会有一个node-role.kubernetes.io/master标签, 其中kubernetes.io/hostname适合NodeName类型的调度。无法满足nodeSelector的调度需求时, 我们还可以使用kubectl label nodes/NODE命令为其附加自定义标签。例如, 下面为k8s-node01.ilinux.io和k8s-node03.ilinux.io节点设置无值的gpu标签以标识其拥有GPU设备, 并在标签设置完成后验证设置结果 :
~$ kubectl label nodes/k8s-node01.ilinux.io gpu=
node/k8s-node01.ilinux.io labeled
~$ kubectl label nodes/k8s-node03.ilinux.io gpu=
node/k8s-node03.ilinux.io labeled
~$ kubectl get nodes -l 'gpu' -o custom columns=NAME:.metadata.name
NAME
k8s-node01.ilinux.io
k8s-node03.ilinux.io
下面配置清单示例( pod-with-nodeselector.yaml) 中定义的Pod 资源使用节点选择器定义了节点亲和机制, 它倾向于运行在拥有GPU设 备的节点上。
apiVersion: v1
kind: Pod
metadata:
  name: pod-with-nodeselector
spec:
  containers:
  - name: demoapp
    image: ikubernetes/demoapp:v1.0
  nodeSelector:
    gpu: ''
按照规划, pod/pod-withnodeselector资源仅可能会运行在节点 k8s-node01或k8s-node03之上, 将如上资源清单中定义的Pod资源创建到集群中, 通过查看其运行的节点即可判定调度效果。
~$ kubectl apply -f pod-with-nodeselector.yaml
pod/pod-with-nodeselector created
~$ kubectl get pod/pod-with-nodeselector -o jsonpath={.spec.nodeName}
k8s-node03.ilinux.io
事实上, 多数情况下用户都无须关心Pod对象的具体运行位置, 除 非Pod依赖的特殊条件仅能由部分节点满足时, 例如GPU和SSD等。即便如此, 也应该尽量避免使用.spec.nodeName静态指定Pod对象的运行位置, 而是应该让调度器基于标签和标签选择器为Pod挑选匹配的工作节点。另外, Pod规范中的.spec.nodeSelector仅支持简单等值关系的节点选择器, 而.spec.affinity.nodeAffinity支持更灵活的节点选择器表达式, 而且可以实现硬亲和与软亲和逻辑。
2.2 强制节点亲和
Pod规范中的.spec.affinity.nodeAffinity.requiredDuringSchedulingIgnoredDuringExecution字段用于定义节点的强制亲和关系, 它的值是一个对 象列表, 可由一到多个nodeSelectorTerms对象组成, 彼此间为“逻辑 或”关系。nodeSelectorTerms用于定义节点选择器, 其值为对象列表, 它支持matchExpressions和matchFields两种复杂的表达机制。
matchExpressions: 标签选择器表达式, 基于节点标签进行过 滤 ; 可重复使用以表达不同的匹配条件, 各条件间为“或”关系。matchFields: 以字段选择器表达的节点选择器 ; 可重复使用以表达不同的匹配条件, 各条件间为“或”关系。
每个匹配条件可由一到多个匹配规则组成, 例如某个 matchExpressions条件下可同时存在两个表达式规则, 如下面的示例 所示, 同一条件下的各条规则彼此间为“逻辑与”关系。这意味着某 节点满足nodeSelectorTerms中的任意一个条件即可, 但满足某个条件指的是可完全匹配该条件下定义的所有规则。
下面配置清单示例( node-affinity-required-demo.yaml) 中, Pod模板使用了强制节点亲和约束, 它要求Pod只能运行在那些拥有gpu标签且不具有node-role.kubernetes.io/master标签的节点之上。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: node-affinity-required
  namespace: default
spec:
  replicas: 5
  selector:
    matchLabels:
      app: demoapp
      ctlr: node-affinity-required
  template:
    metadata:
      labels:
        app: demoapp
        ctlr: node-affinity-required
    spec:
      containers:
      - name: demoapp
        image: ikubernetes/demoapp:v1.0
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: gpu
                operator: Exists
              - key: node-role.kubernetes.io/master
operator: DoesNotExist2.1节中, 我们为k8s-node01和k8s-node03设定了gpu标签, 而 k8s-master01拥有主节点标识的标签。因此按照期望, 5个Pod副本仅 会运行在k8s-node01和k8s-node02之上, 下面的命令结果也完全证实了我们的设定。
~$ kubectl apply -f node-affinity-required-demo.yaml
deployment.apps/node-affinity-required created
~$ kubectl get pods -l ctlr=node-affinity-required \
     -o custom-columns=NAME:.metadata.name,NODE:.spec.nodeName
NAME                                     NODE
node-affinity-required-5c469987c-2fdql   k8s-node03.ilinux.io
node-affinity-required-5c469987c-hfcvn   k8s-node01.ilinux.io
node-affinity-required-5c469987c-mt4gg   k8s-node03.ilinux.io
node-affinity-required-5c469987c-pm56j   k8s-node01.ilinux.io
node-affinity-required-5c469987c-vwbtt   k8s-node03.ilinux.io
另外, 调度器调度Pod时, 支撑节点亲和机制的NodeName和 NodeAffinity等插件仅是其中组调度条件, Kubernetes配置的其他插件依然会参与到Pod的调度过程。例如可以为Pod模板中的demoapp容器添加如下资源请求后重新进行测试来验证调度器的工作模型, 为了便 于测试, 我们将修改后的配置保存到单独的配置清单node-affinity-and-resourcefits.yaml中。
  containers:
  - name: demoapp
    image: ikubernetes/demoapp:v1.0
    resources:
      requests:
        cpu: 2
memory: 2Gi注册到Filter扩展点的调度插件NodeResourcesFit负责检查节点的可分配资源是否能容纳Pod的资源请求, 计算方式是节点上的资源总量( CPU和内存分别计算) 减去已运行在该节点上的所有Pod对象的requests资源量之和。考虑本书试验环境中使用的4个节点( 其中一个 为master) 配置相同, 均为4核心CPU和8GB内存, 每个节点至少都运行 着kube-proxy和calico-node一类节点代理等系统应用。因而, 每个节点仅能满足配置示例中的单个Pod副本的运行需求。于是, 配置中定义的5个Pod实例中将有3个Pod的调度结果处于Pending状态, 如下命令的结果也证实了我们的猜想与设定。
~$ kubectl apply -f node-affinity-and-resourcefits.yaml
deployment.apps/node-affinity-and-resourcefits created
~$ kubectl get pods -l ctlr=node-affinity-and-resourcefits -o custom-columns=NAME:.metadata.name,STATUS:.status.phase
NAME                                               STATUS
node-affinity-and-resourcefits-5c98b765b5-5kxqb    Pending
node-affinity-and-resourcefits-5c98b765b5-f9qwb    Pending
node-affinity-and-resourcefits-5c98b765b5-g6k25    Running
node-affinity-and-resourcefits-5c98b765b5-kl4db     Running
node-affinity-and-resourcefits-5c98b765b5-lrtfm     Pending
由上述操作过程可知, 节点硬亲和机制实现的功能与节点选择器 ( nodeSelector) 相似, 但亲和性支持使用标签匹配表达式或字段选 择器来挑选节点, 提供了灵活且强大的选择机制, 因此可被理解为新 一代的节点选择器。
2.3 首选节点亲和
节点首选亲和机制为节点选择机制提供了一种柔性控制逻辑, 被调度的Pod对象不再是“必须”, 而是“应该”放置到某些特定节点之上, 但条件不满足时, 该Pod也能够接受被编排到其他不符合条件的节点之上。另外, 多个软亲和条件并存时, 它还支持为每个条件定义 weight属性以区别它们优先级, 取值范围是1~100, 数字越大优先级越高。下面配置清单示例( node-affinity-preferred-demo.yaml) 中, Pod模板定义了两个节点软亲和约束条件, 它们有着不同的权重。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: node-affinity-preferred
spec:
  replicas: 5
  selector:
    matchLabels:
      app: demoapp
      ctlr: node-affinity-preferred
  template:
    metadata:
      name: demoapp
      labels:
        app: demoapp
        ctlr: node-affinity-preferred
    spec:
      containers:
      - name: demoapp
        image: ikubernetes/demoapp:v1.0
        resources:
          requests:
            cpu: 1500m
            memory: 1Gi
      affinity:
        nodeAffinity:
          preferredDuringSchedulingIgnoredDuringExecution:
          - weight: 60
            preference:
              matchExpressions:
              - key: gpu
                operator: Exists
          - weight: 30
            preference:
              matchExpressions:
              - key: zone
                operator: In
                values: ["foo","bar"]
示例中, Pod资源模板定义了节点软亲和, 以选择尽量运行在指定 范围内拥有gpu标签或者zone标签的节点之上, 其中gpu标签是更为重要的倾向性规则, 它的权重为60, 相比较来说zone标签的重要性低了 一级, 因为它的权重为30。这么一来, 如果集群中拥有足够多的节 点, 它将被此规则分为4类 : 在指定范围内拥有gpu标签和zone标签、 仅满足gpu一个标签条件、仅满足zone一个标签条件, 以及不满足任何 标签筛选条件的节点, 如图所示。
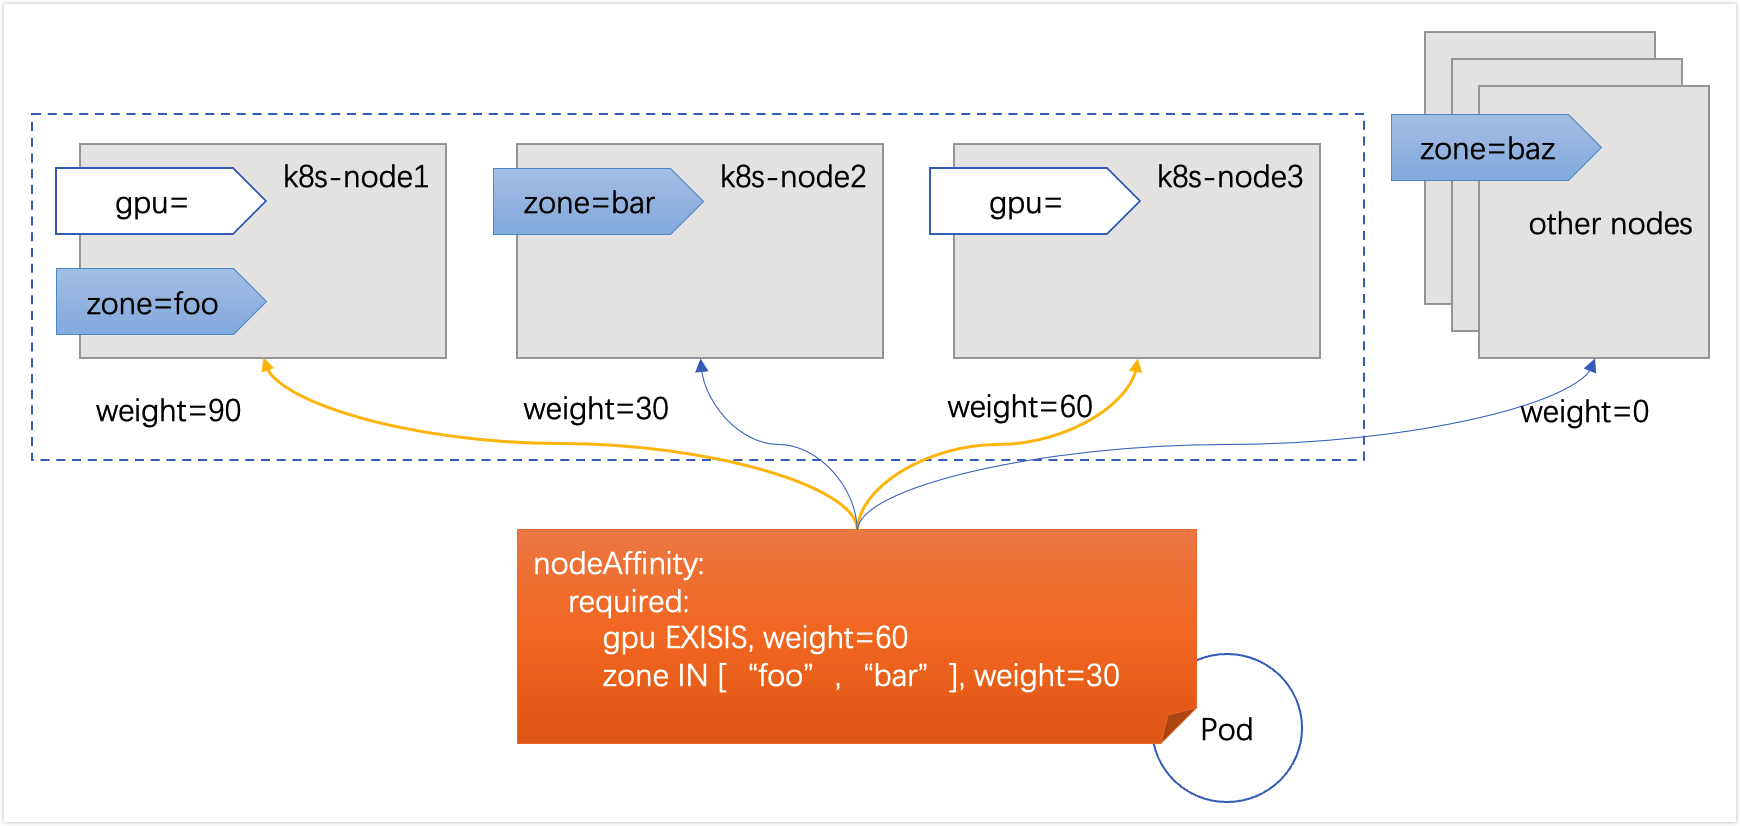
本书所用的测试环境共有3个节点( 图虚线内的节点) , 各自 有4颗CPU和8GiB的内存资源, 以配置清单示例中定义的节点亲和规则来说, 它们的倾向性权重分别如图中标识的信息所示。在创建所需的5个Pod对象副本时, 各Pod会由调度器根据节点软亲和及资源匹配度进行调度。
~$ kubectl label nodes k8s-node01.ilinux.io zone=foo
node/k8s-node01.ilinux.io labeled
~$ kubectl label nodes k8s-node02.ilinux.io zone=bar
node/k8s-node02.ilinux.io labeled
~$ kubectl get pods -l ctlr=node-affinity-preferred \
      -o custom-columns=NAME:.metadata.name,NODE:.spec.nodeName
NAME                                         NODE
node-affinity-preferred-6f975c57b5-6dknl     k8s-node01.ilinux.io
node-affinity-preferred-6f975c57b5-fjfbf     k8s-node01.ilinux.io
node-affinity-preferred-6f975c57b5-jsgcr     k8s-node03.ilinux.io
node-affinity-preferred-6f975c57b5-ksmqh     k8s-node03.ilinux.io
node-affinity-preferred-6f975c57b5-vh9jg     k8s-node02.ilinux.io
示例中, 我们有意为容器添加了资源需求以影响调度器的工作方式, 因此即便k8s-node01节点的倾向程度更大, 但无法满足Pod副本的资源需求时, 它将转而使用k8s-node03, 直到该节点资源也分配完毕才使用更低倾向性的k8s-node02节点。
3. Pod亲和调度
出于高效通信等需求, 偶尔需要把一些Pod对象组织在相近的位置 ( 同一节点、机架、区域或地区等) , 例如应用程序的Pod及其后端提供数据服务的Pod等, 我们可以认为这是一类具有亲和关系的Pod对象。偶尔, 出于安全或分布式容灾等原因, 也会需要把一些Pod对象与其所运行的位置隔离开来, 例如在IDC中的区域运行某应用的单个代理 Pod对象等, 我们可把这类Pod对象间的关系称为反亲和。
当然, 我们也能够通过Pod与节点的亲和关系来变相完成Pod对象间的亲和或反亲和特性, 但这要求我们必须明确指定Pod可运行的节点 标签, 显然这并非较优的选择。理想的实现方式是允许调度器把第一 个Pod放置在任何位置, 而后与其有着亲和或反亲和关系的其他Pod据此动态完成位置编排, 这就是Pod亲和调度与反亲和调度的功用。Pod 间的亲和关系也存在强制亲和及首选亲和的区别, 它们表示的约束意义同节点亲和相似。
Pod间的亲和及反亲和关系主要由调度插件InterPodAffinity来支撑, 它既要负责节点过滤, 也要完成节点的优先级排序。而经典调度 策略则使用内置的MatchInterPodAffinity预选策略和 terPodAffinityPriority优选函数进行各节点的优选级评估。
3.1 位置拓扑
Pod亲和调度的目标在于确保相关Pod对象运行在“同一位置”, 而反亲和调度要求它们不能运行在“同一位置”。而节点位置的定义取决于节点拓扑结构的定义, 若拓扑方式不同, 则对如图中所示 的Pod-A和Pod-B是否在同一位置的判定结果也可能有所不同。
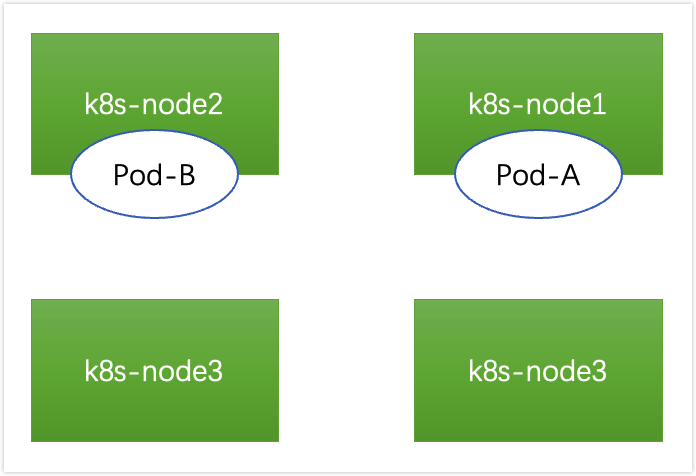
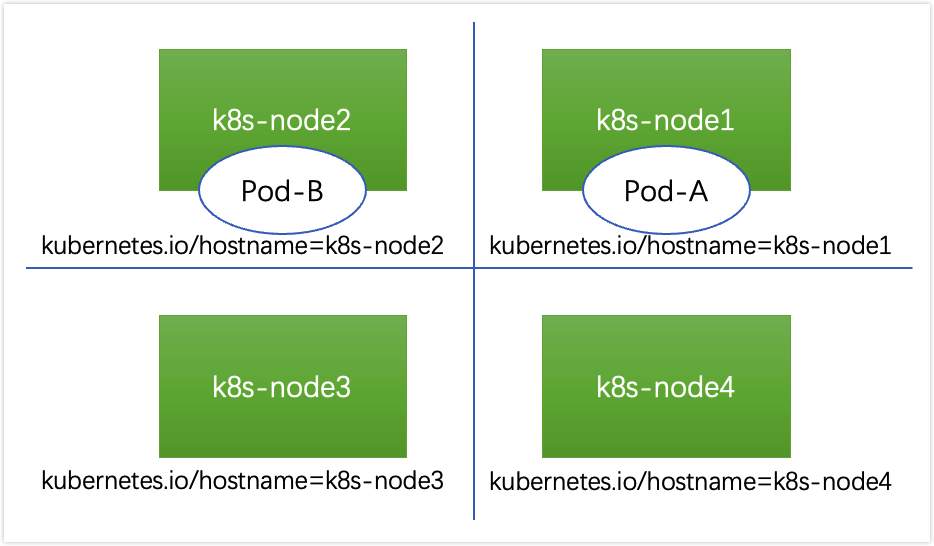
如果基于各节点的kubernetes.io/hostname标签作为评判标准, 显然“同一位置”意味着同一个节点, 而不同节点有不同位置, 如图
而如果根据图所划分的故障转移域来评判, k8s-node01和 k8s-node02属于同一位置, 而k8s-node03和k8s-node04属于另一个意义上的同一位置。
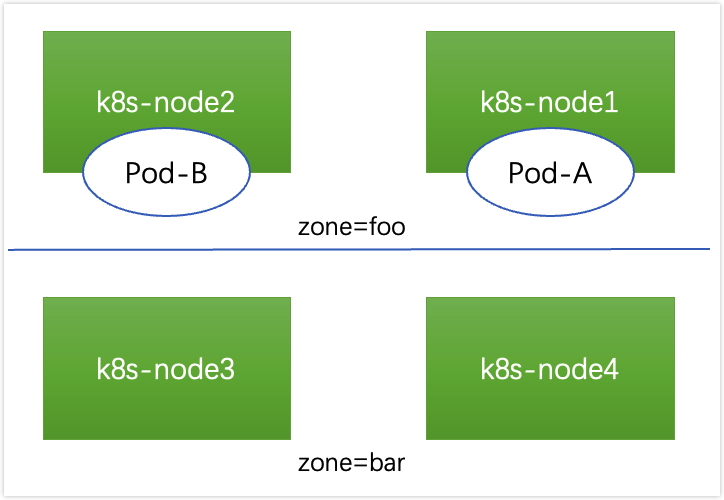
因而, 在定义Pod对象的亲和与反亲和关系时, 首先需要借助标签选择器来选择同一类Pod对象, 而后根据筛选出的同类现有Pod对象所在节点的标签来判定“同一位置”的具体所指, 而后针对亲和关系将该Pod放置在同一位置中优先级最高的节点之上, 或者针对反亲和关系将该Pod编排至不同拓扑优先级最高的节点上。
Pod间的亲和关系定义在spec.affinity.podAffinity字段中, 而反亲和关系定义在spec.affinity.podAntiAffinity字段中, 它们各自的约束特性也存在强制与首选两种, 它们都支持使用如下关键字段。
topologyKey: 拓扑键, 用来划分拓扑结构的节点标签, 在指定的键上具有相同值的节点归属为同一拓扑 ; 必选字段。labelSelector:Pod标签选择器, 用于指定该Pod将针对哪类现有Pod的位置来确定可放置的位置。namespaces <[]string>: 用于指示labelSelector字段的生效目 标名称空间, 默认为当前Pod所属的同一名称空间。
3.2 Pod间的强制亲和
如前所述, Pod间的亲和关系用于描述一个Pod对象与具有某特征 的现存Pod对象运行位置的依赖关系, 因而, 满足Pod亲和约束的前提是确定“被依赖的”Pod对象, 以及节点拓扑位置的确定机制。
Pod间强制约束的亲和调度也定义在 requiredDuringSchedulingIgnoredDuringExecution字段中。下面的示例中先定义了一个假设为被依赖的存储应用Redis, 而后定义了一个依赖该存储的demoapp应用, 后者使用Pod间强制亲和约束, 期望与 Redis运行在同一位置。为了尽量接近真实环境来模拟这种约束机制, 这里模拟k8s-node01和k8s-node02位于同一个机架rack001上, 而k8s-node03位于另一个机架rack002上, 并以节点标签rack作为 topologyKey, 即确定节点位置拓扑的键。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: redis
spec:
  replicas: 1
  selector:
    matchLabels:
      app: redis
      ctlr: redis
  template:
    metadata:
      labels:  # Pod的标签, 将被demoapp Pod选择作为参照系
        app: redis
        ctlr: redis
    spec:
      containers:
      - name: redis
        image: redis:6.0-alpine
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: pod-affinity-required
spec:
  replicas: 5
  selector:
    matchLabels:
      app: demoapp
      ctlr: pod-affinity-required
  template:
    metadata:
      labels:
        app: demoapp
        ctlr: pod-affinity-required
    spec:
      containers:
      - name: demoapp
        image: ikubernetes/demoapp:v1.0
      affinity:
        podAffinity:            # Pod亲和调度
          requiredDuringSchedulingIgnoredDuringExecution:  # 强制亲和定义
          - labelSelector:      # Pod对象标签选择器, 用于确定放置当前Pod的参照系
              matchExpressions:
              - {key: app, operator: In, values: ["redis"]}
              - {key: ctlr, operator: In, values: ["redis"]}
            topologyKey: zone   # 拓扑键, 用于确定节点位置拓扑的节点标签, 必选
我们可以推断出, 若Redis的单个Pod副本被调度至rack001标识的位置上, 则demoapp的所有Pod副本都会运行在该位置的k8s-node01或 k8s-node02节点上 ; 否则, 它们都会运行在rack002标识的位置上。为 了测试效果, 我们先为节点打上相应的标签。
~$ kubectl label nodes k8s-node01.ilinux.io rack=rack001
~$ kubectl label nodes k8s-node02.ilinux.io rack=rack001
~$ kubectl label nodes k8s-node03.ilinux.io rack=rack002
接着, 我们将配置清单示例中的Redis和demoapp应用部署在集群 上, 以测试demoapp Pod是否与Redis Pod存在强制亲和关系。
~$ kubectl apply -f pod-affinity-required-demo.yaml
deployment.apps/redis created
deployment.apps/pod-affinity-required created
随后, 可通过资源的详细描述中的Events信息或者资源规范查看 Redis Pod副本的运行位置。下面的内容取自Redis Pod的详细描述中 的事件, 它显示Redis Pod对象default/redis-844696cc84-fp4xz被 default-scheduler调度至k8s-node02节点之上, 该节点位于rack001 之上。
Events:
  ……
 Normal  Scheduled  <unknown>  default-scheduler
Successfully
 assigned default/redis-844696cc84-fp4xz to k8s-node02.ilinux.io
因而, deployment/demoapp的所有Pod对象也必将运行在rack001 机架的k8s-node01或k8s-node02节点之上, 如下面的命令结果所示。
~$ kubectl get pods -l app=demoapp,ctlr=pod-affinity-required \ -o custom-columns=NAME:.metadata.name,NODE:.spec.nodeName
NAME                                      NODE
pod-affinity-required-778d4ff894-cblpr    k8s-node01.ilinux.io
pod-affinity-required-778d4ff894-h4lkk    k8s-node02.ilinux.io
pod-affinity-required-778d4ff894-jkh4p    k8s-node01.ilinux.io
pod-affinity-required-778d4ff894-lt8p9    k8s-node02.ilinux.io
pod-affinity-required-778d4ff894-zddz9    k8s-node01.ilinux.io
由此可见, Pod间的亲和调度能够将有密切关系或密集通信的应用约束在同一位置, 通过降低通信延迟来降低性能损耗。需要注意的是, 若节点上的标签在运行时发生更改导致不能再满足Pod上的亲和关系定义时, 该Pod将继续在该节点上运行而不会被重新调度。另外, labelSelector属性仅匹配与被调度的Pod在同一名称空间中的Pod资 源, 不过也可以通过为其添加namespace字段以指定其他名称空间。
3.3 Pod间的首选亲和
因满足位置关系的节点上的可分配计算资源、存储卷和节点端口等原因导致Pod间的强制亲和关系在无法得到满足时, 调度器会将Pod 对象置于Pending状态, 但首选亲和约束则只是尽力满足这种亲和约束, 当无法保证这种亲和关系时, 调度器则会将Pod对象调度至集群中其他位置的节点之上。而对位置关系要求不甚严格的应用之间的部署需求, 首选亲和倒也不失为一种折中的选择。
Pod间的柔性亲和约束也使用 preferredDuringSchedulingIgnoredDuringExecution字段进行定义, 它同样允许用户定义具有不同权重的多重亲和条件, 以定义出多个不同适配级别位置。下面资源示意示例( pod-affinity-preferred demo.yaml) 中先是定义了一个Redis应用, 它由调度器自行选定目标节点, 但demoapp应用Pod将以柔性亲和的方式期望与Redis Pod运行在 同一节点( 带有kubernetes.io/hostname标签) , 当条件无法满足 时, 则期望运行在同一区域( zone标签) , 否则也能接受运行在集群中的其他任何节点之上。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: redis-preferred
spec:
  replicas: 1
  selector:
    matchLabels:
      app: redis
      ctlr: redis-preferred
  template:
    metadata:
      labels:  # Redis Pod的标签, 它也将是demoapp Pod亲和关系依赖的关键要素
        app: redis
        ctlr: redis-preferred
    spec:
      containers:
      - name: redis
        image: redis:6.0-alpine
        resources:  # 资源请求, 用于影响节点的可承载Pod数量
          requests:
            cpu: 500m
            memory: 512Mi
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: pod-affinity-preferred
spec:
  replicas: 4
  selector:
    matchLabels:
      app: demoapp
      ctlr: pod-affinity-preferred
  template:
    metadata:
      labels:
        app: demoapp
        ctlr: pod-affinity-preferred
    spec:
      containers:
      - name: demoapp
        image: ikubernetes/demoapp:v1.0
        resources:
          requests:
            cpu: 1500m
            memory: 1Gi
      affinity:
        podAffinity:     # Pod亲和关系定义
          preferredDuringSchedulingIgnoredDuringExecution:  # 柔性亲和
          - weight: 100  # 最大权重的亲和条件
            podAffinityTerm:
              labelSelector:
                matchExpressions:
                - {key: app, operator: In, values: ["redis"]}
                - {key: ctlr, operator: In, values: ["redis-prefered"]}
              topologyKey: kubernetes.io/hostname  # 确定节点位置拓扑的标签
          - weight: 50   # 第二权重的亲和条件
            podAffinityTerm:
              labelSelector:
                matchExpressions:
                - {key: app, operator: In, values: ["redis"]}
                - {key: ctlr, operator: In, values: ["redis-prefered"]}
              topologyKey: rack  # 确定节点位置拓扑的第二标签, 扩大了前一条件位置范围
我们沿用3.2节的集群环境, 假设Redis Pod被调度至k8s-node01节点之上, 则demoapp Pod同样更倾向运行在该节点, 当条件无法满足时, 调度器将以该节点所在的zone为标准来挑选同一个zone中的另一节点k8s-node02, 最后是k8s-node03。
~$ kubectl get pods -l "ctlr in (redis-preferred,pod-affinity-preferred)" \
    -o custom-columns=NAME:.metadata.name,NODE:.spec.nodeName
NAME                                        NODE
pod-affinity-preferred-66495459b4-2kgn4     k8s-node01.ilinux.io
pod-affinity-preferred-66495459b4-q64tf     k8s-node02.ilinux.io
pod-affinity-preferred-66495459b4-snhdr     k8s-node03.ilinux.io
pod-affinity-preferred-66495459b4-xp9rl     k8s-node02.ilinux.io
redis-preferred-78bd44b79d-ztdbv k8s-node01.ilinux.io假设Redis被调度到了k8s-node03之上, 则该节点无更多资源容纳 demoapp Pod时, 且同一zone内再无其他节点, 则相关的Pod只能被无 差别地调度至k8s-node01和k8s-node02之上。Pod间的柔性亲和关系尽力保证有紧密关系的Pod运行在一起的同时, 避免了因强制亲和条件得不到满足时而“挂起”Pod的局面。
3.4 Pod间的反亲和关系
Pod间的反亲和关系( podAntiAffinity) 要实现的调度目标刚好与亲和关系相反, 它的主要目标在于确保存在互斥关系的Pod对象不会 运行在同一位置, 或者确保仅需要在指定的位置配置单个代理程序 ( 类似于DaemonSet确保每个节点仅运行单个某类Pod) 等场景应用场 景。因此, 反亲和性调度一般用于分散同一类应用的Pod对象等, 也包括把不同安全级别的Pod对象调度至不同的区域、机架或节点等。下面资源配置清单( pod-antiaffinity-required-demo.yaml) 中定义了由 同一Deployment创建但彼此基于节点位置互斥的Pod对象。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: pod-antiaffinity-required
spec:
  replicas: 4
  selector:
    matchLabels:
      app: demoapp
      ctlr: pod-antiaffinity-required
  template:
    metadata:
      labels:
        app: demoapp
        ctlr: pod-antiaffinity-required
    spec:
      containers:
      - name: demoapp
        image: ikubernetes/demoapp:v1.0
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - {key: app, operator: In, values: ["demoapp"]}
              - key: ctlr
                operator: In
                values: ["pod-antiaffinity-required"]
            topologyKey: kubernetes.io/hostname
强制的反亲和约束下, deployment/pod-antiaffinity-required 创建的4个Pod副本必须运行于不同的节点之上, 但示例集群中一共只 存在3个节点, 因此, 必然会有一个Pod对象处于Pending状态, 如下所 示。
~$ kubectl get pods -l ctlr=pod-antiaffinity-required \
   -o custom
columns=NAME:.metadata.name,NODE:.spec.nodeName,STATUS:.status.ph
 ase
NAME                                          NODE                 STATUS
pod-antiaffinity-required-5745494d77-9g75r    k8s-node01.ilinux.io    Running
pod-antiaffinity-required-5745494d77-rsj9d    k8s-node03.ilinux.io    Running
pod-antiaffinity-required-5745494d77-xd446    k8s-node02.ilinux.io    Running
pod-antiaffinity-required-5745494d77-zzz8s    <none>               Pending
类似地, Pod反亲和调度也支持使用柔性约束机制, 调度器会尽量不把位置相斥的Pod对象调度到同一位置, 但约束关系无法得到满足时, 也可以违反约束规则进行调度, 而非把Pod置于Pending状态。这里不再给出具体的测试过程, 感兴趣的读者朋友可自行测试。
4. 节点污点与Pod容忍度
污点是定义在节点之上的键值型属性数据, 用于让节点有能力主动拒绝调度器将Pod调度运行到节点上, 除非该Pod对象具有接纳节点污点的容忍度。容忍度( tolerations) 则是定义在Pod对象上的键值型属性数据, 用于配置该Pod可容忍的节点污点。调度器插件 TaintToleration负责确保仅那些可容忍节点污点的Pod对象可调度运行在上面。经典调度机制使用PodToleratesNodeTaints预选策略和 TaintTolerationPriority优选函数完成该功能。节点污点和Pod容忍度在调度中的关系如图所示。
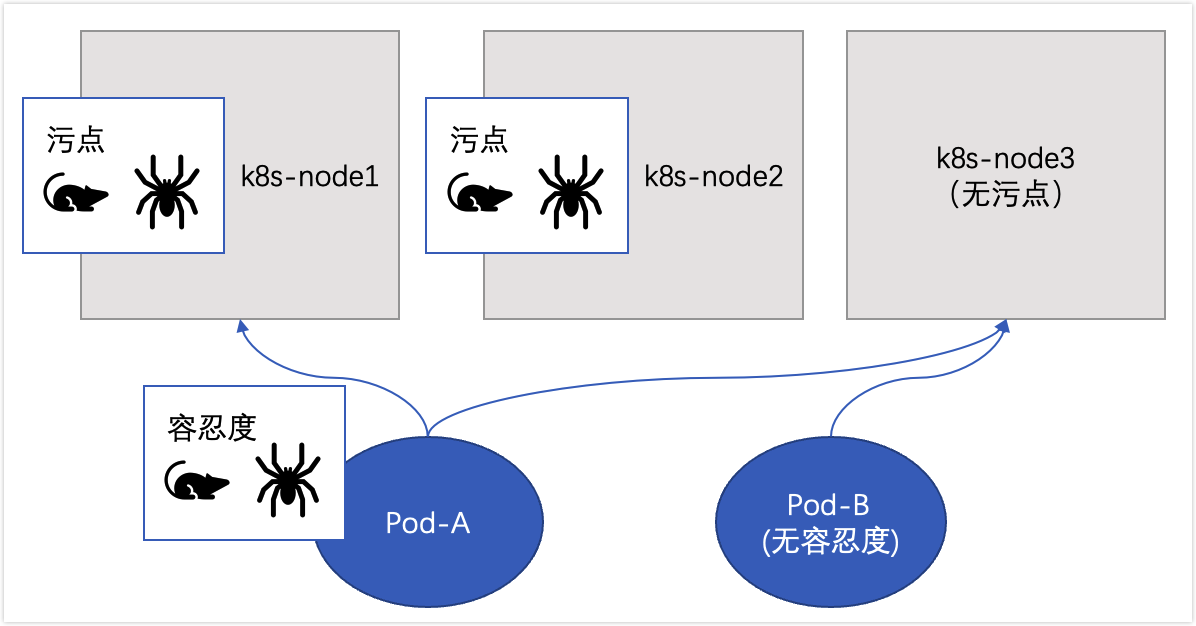
我们知道, 节点选择器( nodeSelector) 和节点亲和性 ( nodeAffinity) 两种调度方式都是通过在Pod对象上添加标签选择器来完成对特定类型节点标签的匹配, 从而完成节点选择和绑定, 相对而言, 基于污点和容忍度的调度方式则是通过向节点添加污点信息来控制Pod对象的调度结果, 从而给了节点控制何种Pod对象能够调度于其上的控制权。换句话说, 节点亲和调度使得Pod对象被吸引到一类特定的节点, 而污点的作用则相反, 它为节点提供了排斥特定Pod对象的能力。
4.1 污点与容忍度基础概念
污点定义在节点的nodeSpec中, 而容忍度定义在Pod的podSpec 中, 它们都是键值型数据, 但又都额外支持一个效用( effect) 标识, 语法格式为key=value:effect, 其中key和value的用法及格式与资源注解信息相似, 而污点上的效用标识则用于定义其对Pod对象的排斥等级, 容忍度上的效用标识则用于定义其对污点的容忍级别。效用标识主要有以下3种类型。
NoSchedule: 不能容忍此污点的Pod对象不可调度至当前节点, 属于强制型约束关系, 但添加污点对节点上现存的Pod对象不产生影 响。PreferNoSchedule:NoSchedule的柔性约束版本, 即调度器尽量确保不会将那些不能容忍此污点的Pod对象调度至当前节点, 除非不存在其他任何能够容忍此污点的可用节点 ; 添加该类效用的污点同样对节点上现存的Pod对象不产生影响。NoExecute: 不能容忍此污点的新Pod对象不可调度至当前节点, 属于强制型约束关系, 而且节点上现存的Pod对象因节点污点变动或Pod容忍度变动而不再满足匹配条件时,Pod对象将会被驱逐。
此外, 在Pod对象上定义容忍度时, 它支持两种操作符 : 一种是等值比较, 表示容忍度与污点必须在key、value和effect三者之上完全匹配, 另一种是存在性判断, 表示二者的key和effect必须完全匹配, 而容忍度中的value字段要使用空值。
一个节点可以配置使用多个污点, 而一个Pod对象也可以有多个容忍度, 将一个Pod对象的容忍度套用到特定节点的污点之上进行匹配度检测时将遵循如下逻辑。
首先处理与容忍度匹配的污点。
对于不能匹配到容忍度的所有污点, 若存在一个污点使用了
NoSchedule效用标识, 则拒绝调度当前Pod至该节点。对于不能匹配到容忍度的所有污点, 若都不具有
NoSchedule效用标识, 但至少有一个污点使用了PreferNoScheduler效用标识, 则调 度器会尽量避免将当前Pod对象调度至该节点。如果至少有一个不能匹配容忍度的污点使用了
NoExecute效用标识, 节点将立即驱逐当前Pod对象, 或者不允许该Pod调度至给定的节点 ; 而且, 即便容忍度匹配到使用了NoExecute效用标识的污点, 若在Pod上定义容忍度时同时使用tolerationSeconds属性定义了容忍时限, 则在超出时限后当前Pod也将会被节点驱逐。
对于本书使用kubeadm部署的Kubernetes集群来说, 其Master节点会被自动添加污点信息以阻止那些不能容忍此污点的常规工作负载类 Pod对象调度至该节点上, 以确保主节点仅用于处理控制平面相关的事 务。
~$ kubectl describe nodes k8s-master01.ilinux.io
Name:               k8s-master01.ilinux.io
Roles:              master
……
Taints:             node-role.kubernetes.io/master:NoSchedule
Unschedulable:      false
……
然而有些系统级应用也会在资源创建时被添加上相应的容忍度, 以确保它们被DaemonSet控制器创建时能调度至Master节点运行一个实例, 例如kube-proxy或者kube-flannel等。以任意一个kube-proxy实例为例 :
~$ POD=$(kubectl get pods -l k8s-app=kube-proxy -n kube-system \
     -o jsonpath={.items[0].metadata.name})
~$ kubectl describe pods $POD -n kube-system
……
Tolerations:
                 CriticalAddonsOnly
                 node.kubernetes.io/disk-pressure:NoSchedule
                 node.kubernetes.io/memory-pressure:NoSchedule
                 node.kubernetes.io/network-unavailable:NoSchedule
                 node.kubernetes.io/not-ready:NoExecute
                 node.kubernetes.io/pid-pressure:NoSchedule
                 node.kubernetes.io/unreachable:NoExecute
node.kubernetes.io/unschedulable:NoSchedule运行着系统组件的Pod对象是构成Kubernetes系统的关键组成部分, 因而它们通常被定义了更大的容忍度。从上面某kube-proxy实例 的容忍度定义来看, 这种容忍度还能容忍那些报告了存在磁盘压力、 内存压力和PID压力的节点, 以及那些未就绪的节点和不可达的节点 等, 以确保它们能在任何状态下正常调度至集群节点上运行。
由此可见, 通过污点和容忍度, 可在集群中辟出某种目的专用节点、配备有特殊硬件的特殊节点, 甚至可使用污点驱逐指定节点上某些Pod对象。
4.2 定义污点
任何符合键值规范要求的字符串均可用于定义污点信息 : 可使用 字母、数字、连接符、点号和下划线, 且仅能以字母或数字开头, 其中键名的长度上限为253个字符, 值最长为63个字符。实践中, 污点通常用于描述具体的部署规划, 它们的键名形如node-type、node-role、node-project或node-geo等, 而且一般还会在必要时带上域名以描述一些额外信息, 例如node-type.ilinux.io等。kubectl taint 命令可用于管理Node对象的污点信息, 该命令的语法格式如下 :
kubectl taint nodes <node-name> <key>=<value>:<effect> …例如, 定义节点k8s-node01.ilinux.io使用node-type=production:NoSchedule这一污点 :
~$ kubectl taint nodes k8s-node01.ilinux.io node-type=production:NoSchedule
node/k8s-node01.ilinux.io tainted node-type是具有NoScheduler效用标识的污点, 它对k8s-node01 上已有的Pod对象不产生影响, 但对之后调度的Pod对象来说, 不能容忍该污点则意味着无法调度至节点。类似下面的命令可以查看节点上的污点信息 :
~$ kubectl get nodes k8s-node01.ilinux.io -o jsonpath={.spec.taints}
[map[effect:NoSchedule key:node-type value:production]]
需要注意的是, effect同样是污点的核心组成部分, 即便键值数据相同但效用标识不同的污点也属于两个各自独立的污点信息。例如, 将上面命令中的效用标识定义为PreferNoSchedule再添加一次 :
~ $ kubectl taint nodes k8s-node01.ilinux.io node-type=production:PreferNoSchedule
node/k8s-node01.ilinux.io tainted删除节点上的污点仍旧可通过kubectl taint命令完成, 但它要使用如下的命令格式, 省略效用标识则表示删除使用指定键名的所有污点, 否则只删除指定键名上的对应效用标识的污点。
kubectl taint nodes <node-name> <key>[:<effect>]-例如, 下面的命令可删除k8s-node01上node-type键的效用标识为 NoSchedule的污点信息。
~$ kubectl taint nodes k8s-node01.ilinux.io node-type:NoSchedule-
node/k8s-node01.ilinux.io untainted
若要删除使用指定键名的所有污点, 在删除命令中省略效用标识 即能实现, 例如下面的命令能删除k8s-node01上键名为node-type的所有污点。
~$ kubectl taint nodes k8s-node01.ilinux.io node-type-
node/k8s-node01.ilinux.io untainted
若期望一次删除节点上的全部污点信息, 通过kubectl patch命令直接将节点属性spec.taints的值置空即可, 例如下面的命令可删除 k8s-node01节点上的所有污点。
~$ kubectl patch nodes k8s-node01.ilinux.io -p '{"spec":{"taints":[]}}'
node/k8s-node01.ilinux.io patched
需要再次提醒的是, 仅使用NoExecute标识的污点变动会影响节点上现有的Pod对象, 其他两个效用标识都不会影响节点上的现有Pod对 象。
4.3 定义容忍度
Pod对象的容忍度通过其spec.tolerations字段添加, 根据使用的操作符不同, 主要有两种可用形式 : 一种是与污点信息完全匹配的等值关系 ; 另一种是判断污点信息存在性的匹配方式, 它们分别使用 Equal和Exists操作符表示。下面容忍度的定义示例使用了Equal操作 符, 其中tolerationSeconds用于定义延迟驱逐当前Pod对象的时长。
tolerations:
- key: "node-type"
  operator: "Equal"
  value: "production"
  effect: "NoExecute"
  tolerationSeconds: 3600
下面的示例中定义了一个使用存在性判断机制的容忍度, 它表示能够容忍以node-type为键名的、效用标识为NoExcute的污点。
tolerations:
- key: "node-type"
  operator: "Exists"
  effect: "NoExecute"
  tolerationSeconds: 3600
实践中, 若集群中的一组机器专为运行非生产型的容器应用而设置, 这些机器可能随时按需上下线, 那么就应该为其添加污点信息, 确保能容忍此污点的非生产型Pod对象可以调度其上。另外, 有些有着特殊硬件的节点需要专用于运行一类有此类硬件资源需求的Pod对象时, 例如有GPU设备的节点也应该添加污点信息, 以排除其他的Pod对 象。
4.4 问题节点标识
Kubernetes自v1.6版本起支持使用污点自动标识问题节点, 它通过节点控制器在特定条件下自动为节点添加污点信息实现。它们都使用NoExecute效用标识, 因此不能容忍此类污点的Pod对象也会遭到驱逐。目前, 内置使用的此类污点有如下几个。
node.kubernetes.io/not-ready: 节点进入NotReady状态时被自动添加的污点。node.alpha.kubernetes.io/unreachable: 节点进入NotReachable状态时被自动添加的污点。node.kubernetes.io/out-of-disk: 节点进入OutOfDisk状态时被自动添加的污点。node.kubernetes.io/memory-pressure: 节点内存资源面临压力。node.kubernetes.io/disk-pressure: 节点磁盘资源面临压力。node.kubernetes.io/network-unavailable: 节点网络不可用。node.cloudprovider.kubernetes.io/uninitialized:kubelet由外部的云环境程序启动时, 它自动为节点添加此污点, 待云控制器管理器中的控制器初始化此节点时再将污点删除。
不过, Kubernetes的核心组件通常都要容忍此类的污点, 以确保相应的DaemonSet控制器能够无视此类污点在节点上部署相应的关键 Pod对象, 例如kube-proxy或kube-flannel等。
5. 拓扑分布式调度
我们知道, 根据指定的topologyKey将节点划分好拓扑结构是实现 Pod间亲和与反亲和调度的关键所在, 但Pod亲和调度仅能将相关的所有Pod分发到单个拓扑中, 而反亲和调度则仅能在一个拓扑中部署单实例。这两种调度方式事实上是将Pod分布到拓扑结构中的两种特殊用例, 更常规的用法是将一组Pod对象均匀地分布到拓扑中, 这便是 Kubernetes v1.16版引入的PodTopologySpread调度插件要实现的功能, 该插件在Kubernetes v1.18版本进化至Beta版。
提示 : 经典调度策略使用
EvenPodsSpread预选函数和EvenPodsSpreadPriority优选函数协同完成Pod的拓扑分布式调度。
Pod资源规范的拓扑分布约束嵌套定义在.spec.topologySpreadConstraints字段中, 指示调度器如何基于集群中已有Pod放置待调度的Pod实例。
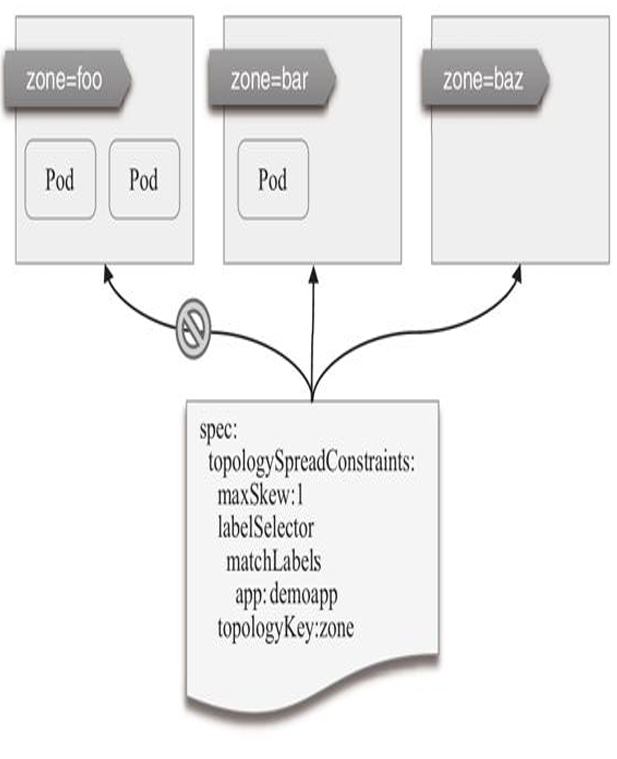
topologyKey: 拓扑键, 用来划分拓扑结构的节点标签, 在指定的键上具有相同值的节点归属为同一拓扑 ; 必选字段。labelSelector:Pod标签选择器, 用于定义该Pod需要针对哪类Pod对象的位置来确定自身可放置的位置。maxSkew: 允许Pod分布不均匀的最大程度, 即可接受的当前拓扑中由labelSelector匹配到的Pod数量与所有拓扑中匹配到 的最少Pod数量的最大差值, 可简单用公式表示为max(count(current_topo(matched_pods)) min(topo(matched_pods))), 其中的topo是表示拓扑关系的伪函数名称。whenUnsatisfiable: 拓扑无法满足maxSkew时采取的调度策略, 默认值DoNotSchedule是一种强制约束, 即不予调度至该区域 ; 而另一可用值Schedule-Anyway则是柔性约束, 无法满足约束关系时仍可将Pod放入该拓扑中。
以如图中的示例为例, 假设foo和bar两个zone中的Pod均为由labelSelector匹配的Pod对象, 于是Pod当前的分布模型为 [2,1,0]。以foo区域为例, 将图中的配置规范所属的Pod调度至该区域时, 则当前区域可由labelSelector匹配到的Pod数量为3, 而所有区域中可由同一个labelSelector匹配到的Pod数量最少的baz区域数量是 0, 因而Skew的值为3, 这违反了maxSkew的定义, 根据 whenUnsatisfiable的默认值, 该Pod将无法放入该拓扑。类似地, 调度至bar区域时Skew的值为2, 而调度至baz区域时Skew的值为0, 因而此时仅baz一个区域可满足约束条件, 这是该Pod唯一可放入的拓扑。 显然, 若maxSkew的值为2, 则bar和baz都是该Pod能够放入的拓扑。
事实上, 我们还可以在Pod规范上同时使用多个 PodTopologySpread约束以实现Pod在多级拓扑间的均匀分布。例如, 第一级约束负责将Pod分布在多个机架上, 而第二级约束负责将Pod在 每个机架上均匀分布到多个主机上等, 甚至使用类似于 region/zone/rack/host等多级约束等。
进一步地, 在Pod上结合使用Node亲和调度( NodeSelector或 NodeAffinity) , 我们还能用PodTopologySpread让Pod在某一类型节 点上的特定拓扑间均匀分布, 而不再是默认的集群中的所有节点。例 如, 我们可选择将某工作负载分布于不具有GPU设备的节点所属的某特定拓扑中等。
6. Pod优先级与抢占
调度器框架内置的QueueSort扩展点允许注册调度器队列排序的插件, 注册到该扩展点的内置插件是PrioritySort, 它根据Pod资源规范 中由spec.priorityClassName字段指定的PriorityClass所属的优先级进行排序, 从而优先调度级别最高的Pod对象。对于优先级别相同 Pod, 则根据其进入队列的时间戳执行先进先出逻辑。
未能找到可满足待调度Pod运行要求的节点时, 调度器会将该Pod 转入Pending状态并为其启动“抢占”过程, 调度器会在集群中尝试通 过删除某节点上的一个或多个低优先级的Pod, 让节点能够满足待调度Pod的运行条件, 并将待调度Pod与该节点绑定。但是, 若在等待驱逐完成的过程中出现了其他可用节点, 则调度器将待调度Pod绑定至该可 用节点。
Pod优先级使用32位的非负整数表示, 可用值范围为 [0,1000000000] , 值越大优先级越高, 而大于1000000000的优先级预留给了系统级的关键类Pod, 以防止这些Pod被驱逐。Kubernetes使用集群级别的API资源类型PriorityClass完成从优先级到名称的映射, 并可由Pod在其规范中按名引用。PriorityClass的资源规范及简要使用说明如下 :
apiVersion: scheduling.k8s.io/v1   # 资源隶属的API群组及版本
kind: PriorityClass                # 资源类别标识符
metadata:
  name <string>                    # 资源名称
value  <integer>                   # 优先级, 必选字段
description  <string>              # 该优先级描述信息
globalDefault <boolean>            # 是否为全局默认优先级
preemptionPolicy  <string> # 抢占策略, Never为禁用, 默认为
PreemptLowerPriority
提示 : 若集群上存在多个设定了全局默认优先级的
PriorityClass对象, 仅优先级最小的会生效。
完整的Kubernetes集群除了API Server、Controller Manager、 Scheduler和etcd等核心组件以外还有一些至关重要的组件, 例如 metrics-server、CoreDNS和Dashboard等, 这些组件以常规Pod形式运行在集群节点上, 以免于被驱逐。为此, Kubernetes默认直接附带了 system-cluster-critical和system-node-critical两个特殊的 PriorityClass以供这类Pod使用, 前者的优先级为2000000000, 而后者有着更高的优先级2000001000, 它们都位于系统预留的优先级范围 内。
下面的配置清单示例( priorityclass-demo.yaml) 中定义了一个 未禁用抢占机制的priorityclass/demoapp-priority资源, 它仅用于 为demoapp Service相关的Pod提供优先级配置。
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: demoapp-priority
value: 1000000
globalDefault: false
description: "Should be used for demoapp service pods only."
preemptionPolicy: PreemptLowerPriority
若期望全局禁用优先级抢占功能, 需要编辑kube-scheduler的 KubeSchedulerConfiguration配置, 设定DisablePreemption参数的值 为true。不过, Kubernetes自v1.15版本起也支持在单个 PriorityClass对象上设定preemptionPolicy的值为Never来禁用资源 级别的优先级抢占机制, 但截至目前的v1.19版本, 该功能仍处于 alpha级别, 需要在kube-scheduler启用NonPreemptingPriority功能才能被支持。当集群资源紧张时, 关键Pod需要依赖调度程序抢占功能 才能完成调度, 所以不建议全局禁用抢占功能, 而在PriorityClass级别的抢占禁止就显得格外有用了。