
3-4-3-Pod生命周期、健康、就绪状态探测以及资源限制
1. Pod生命周期
pod生命周期是指在pod开始创建到pod退出所消耗的时间范围 , 我们把开始到结束的这段时间范围就叫做pod的生命周期 ; 其大概过程如下图所示
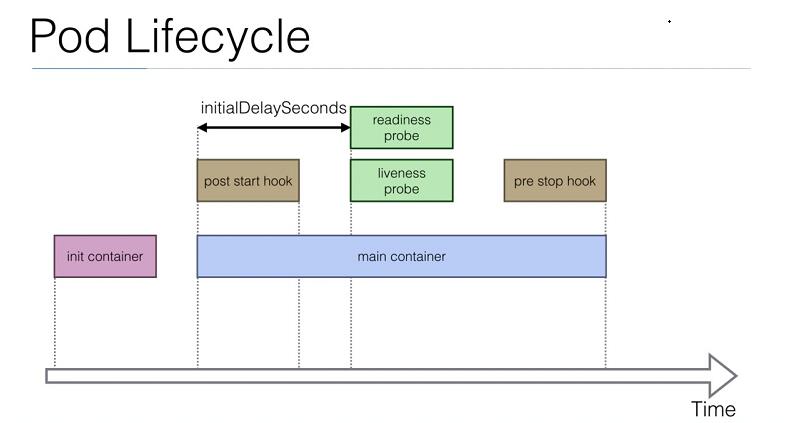
上图主要描述了一个pod从创建到退出 , 中间这段时间经历的过程 ; 从大的方向上看 , pod生命周期分两个阶段 , 第一阶段是初始化容器 , 第二阶段是主容器的整个生命周期 ; 其中对于主容器来来说 , 它的生命周期有分了三个阶段 , 第一阶段是运行post start hook , 这个阶段是主容器运行之后立即需要做的事 ; 第二阶段是主容器正常运行的阶段 , 在这个阶段中 , 我们可以定义对容器的健康状态检查和就绪状态检查 ; 第三阶段是运行pre stop hook , 这个阶段主要做容器即将退出前需要做的事 ; 这里需要注意对于初始化容器来说 , 一个pod中可以定义多个初始化容器 , 他们必须是串行执行 , 只有当所有的初始化容器执行完后 , 对应的主容器才会启动 ; 对于对容器的健康状态检查和就绪状态检查 , 我们也可以定义开始检查的延迟时长 ; 因为有些容器存在容器显示running状态 , 但内部程序还没有初始化 , 如果立即做健康状态检查 , 可能存在健康状态为不健康 , 从而导致容器重启的状况 ;
2. Pod创建过程
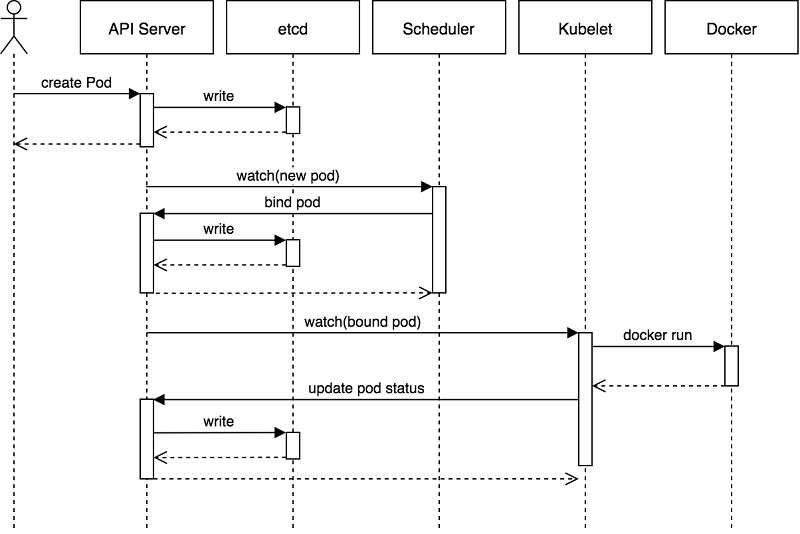
首先用户通过客户端工具将请求提交给apiserver , apiserver收到用户的请求以后 , 它会尝试将用户提交的请求内容存进etcd中 , etcd存入完成后就反馈给apiserver写入数据完成 , 此时apiserver就返回客户端 , 说某某资源已经创建 ; 随后apiserver要发送一个watch信号给scheduler , 说要创建一个新pod , 请你看看在那个节点上创建合适 , scheduler收到信号以后 , 就开始做调度 , 并把调度后端结果反馈给apiserver , apiserver收到调度器的调度信息以后 , 它就把对应调度信息保存到etcd中 , 随后apiServer要发送一个watch信号给对应被调度的主机上的kubelet , 对应主机上的kubelet收到消息后 , 立刻调用docker , 并把对应容器跑起来 ; 当容器运行起来以后 , docker会向kubelet返回容器的状体 ; 随后kubelet把容器的状态反馈给apiserver,由apiserver把容器的状态信息保存到etcd中 ; 最后当etcd中的容器状态信息更新完成后 , 随后apiserver把容器状态信息更新完成的消息发送给对应主机的kubelet ;
3. 在资源配置清单中定义初始化容器
root@k8s-master01:/opt/k8s-data/yaml/pod# cat pod-demo1.yaml
apiVersion: v1
kind: Pod
metadata:
name: nginx-pod-demo6
namespace: default
labels:
app: nginx
env: testing
annotations:
descriptions: "this is test pod "
spec:
containers:
- image: nginx:1.14-alpine
imagePullPolicy: IfNotPresent
name: nginx
ports:
- containerPort: 80
hostPort: 8080
name: web
protocol: TCP
initContainers:
- name: init-something
image: busybox
command:
- /bin/sh
- -c
- "sleep 60"
在资源配置清单中定义初始化容器需要在spec字段下 , 使用initContainers字段来定义 , 这个字段的值是一个列表对象 ; 初始化容器的定义和主容器的定义方式很类似 ; 上面初始化容器中主要干了一件事 , 就是sleep 60 , 意思是在启动主容器前 , 首先要让初始化容器中的操作执行完以后 , 对应的主容器才会开始运行 ; 如果定义的初始化容器有多个 , 则要等待所有初始化容器中的操作执行完以后 , 对应主容器才会开始启动 ;
4. Pod生命周期的两个函数钩子的使用
postStart : 这个函数钩子主要用来定义在主容器启动之后 , 立即需要做的事 , 比如执行一个命令 , 创建一个文件等等 ; 这里需要注意的是 , postStart这个函数钩子说定义的操作 , 都是针对主容器的 , 所以执行命令或其他操作的前提都是主容器上能够正常执行的操作 ;
示例 : 定义运行一个nginx容器 , 在容器启动之后立即在对应html目录下创建一个文件 , 作为用户自定义测试页面
root@k8s-master01:/opt/k8s-data/yaml/pod# cat pod-demo2.yaml
apiVersion: v1
kind: Pod
metadata:
name: nginx-pod-demo7
namespace: default
labels:
app: nginx
env: testing
annotations:
descriptions: "this is test pod "
spec:
containers:
- image: nginx:1.14-alpine
imagePullPolicy: IfNotPresent
name: nginx
ports:
- containerPort: 80
hostPort: 8080
name: web
protocol: TCP
lifecycle:
postStart:
exec:
command:
- /bin/sh
- -c
- "echo 'this is test page' > /usr/share/nginx/html/test.html"
在资源配置清单中定义主容器启动之后需要做的事 , 需要在对应主容器下用lifecycle字段来定义 ; 其中postStart字段使用用来指定主容器启动之后要做到事 , 这个字段的值是一个对象 ; 其中exec是用来定义使用exec来执行命令 , command字段用来指定要执行的命令 ; 除了可以用exec来定义执行命令 , 还可以使用httpGet来向当前容器中的url发起http请求 , 或者使用tcpSocket来向某个主机的某个端口套接字发起请求 , 默认不指定host表示向当前podip发起请求 ;
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl apply -f pod-demo2.yaml
pod/nginx-pod-demo7 unchanged
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl get pods
NAME READY STATUS RESTARTS AGE
nginx-pod-demo7 1/1 Running 0 49s
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl get pod -o wide
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES
nginx-pod-demo7 1/1 Running 0 3m1s 172.20.5.45 k8s-node03.cbear.top <none> <none>
访问对应pod看看test.html是否能够访问到
root@k8s-master01:/opt/k8s-data/yaml/pod# curl 172.20.5.45/test.html
this is test page可以看到访问对应的pod的ip地址 , 能够访问到我们刚才定义容器启动之后创建的文件内容 ;
preStop: 这个函数钩子主要用来定义在容器结束之前需要做的事情 , 使用方式和postStart一样 , 都是在对应主容器里的lifesycle字段下定义 ; 它也可以使用exec来执行命令或者httpGet来向容器的某个url发起请求 , 或者使用tcpSocket向某个套接字发起请求 ;
示例: 在容器结束前执行echo 命令
root@k8s-master01:/opt/k8s-data/yaml/pod# cat pod-demo3.yaml
apiVersion: v1
kind: Pod
metadata:
name: nginx-pod-demo3
namespace: default
labels:
app: nginx
env: testing
annotations:
descriptions: "this is test pod "
spec:
containers:
- image: nginx:1.14-alpine
imagePullPolicy: IfNotPresent
name: nginx
lifecycle:
postStart:
exec:
command:
- /bin/sh
- -c
- "echo 'this is test page' > /usr/share/nginx/html/test.html"
preStop:
exec:
command: ["/bin/sh","-c","echo goodbye.."]5. pod终止过程
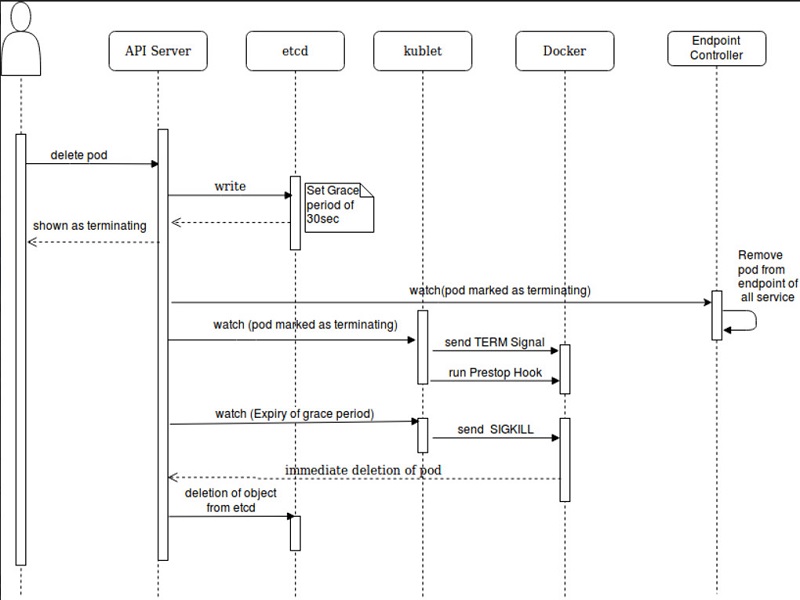
用户通过客户端工具想APIserver发送删除pod的指令 , 在APIserver收到用户发来的删除指令后 , 首先APIserver会把对应的操作写到etcd中 , 并设置其宽限期 , 然后etcd把对应数据写好以后 , 响应APIserver , 随后APIserver响应客户端说对应容器已经标记为terminating状态 ; 随后APIserver会发送一个把对应pod标记为terminating状态的消息给endpoint端点控制 , 让其删除与当前要删除pod相关的所有service , ( 其实在k8s上我们创建service关联pod不是直接关联pod , 是现关联endpoint端点控制器 , 然后端点控制器再关联pod ) , 随后APIserver会向对应要删除pod所在主机上的kubelet发送将pod标记为terminating状态的消息 , 当对应主机收到APIserver发送的标记pod为terminating状态消息后 , 对应主机上的kubelet会向对应pod里运行的容器发送TERM信号 , 随后再执行preStop中定义的操作 ; 随后等待宽限期超时 , 如果对应的pod还没有被删除 , 此时APIserver就会向对应pod所在主机上的kubelet发送宽限期超时的消息 , 此时对应kubelet会向对应容器发送SIGKILL信号来强制删除对应的容器 , 随后docker把对应容器删除后 , 把删除完容器的消息响应给APIserver , 此时APIserver会向etcd发送删除对应pod在etcd中的所有信息 ;
6. 状态探测
6.1 pod健康状态探测
pod健康状态探测是指检查对应pod是否健康 , 如果不健康就把对应的pod重启 ; 健康状态探测是一个周期性的工作 ; 只要发现对应pod不健康 , 就重启对应pod ; 在k8s上对pod的健康状态探测的方式有三种
第一种上执行命令 , 只有对应命令执退出码为
0就表示对应pod是处于健康状态 , 否则就不健康 ;第二种是用
httpGet来探测对应pod里的容器的某个url是否可以访问 , 只有请求对应的url状态码为200才表示对应pod是健康的 , 否则就不健康 ;第三种是使用
tcpSocket的方式来对某个套接字发送请求 , 只有套接字正常响应就表示对应pod是处于健康的 , 否则就是不健康 ; 至于我们要使用那种方式来判断pod的健康与否 , 这取决与pod里的服务和业务逻辑 ;
6.1.1 exec
示例 : 使用exec执行命令的方式来探测pod的健康状态
root@k8s-master01:/opt/k8s-data/yaml/pod# cat pod-demo4.yaml
apiVersion: v1
kind: Pod
metadata:
  name: liveness-exec
  namespace: default
  labels:
    app: nginx
    env: testing
  annotations:
    descriptions: "this is test pod "
spec:
  containers:
  - image: nginx:1.14-alpine
    imagePullPolicy: IfNotPresent
    name: nginx
    lifecycle:
      postStart:
        exec:
          command:
          - /bin/sh
          - -c
          - "echo 'this is test page' > /usr/share/nginx/html/test.html"
      preStop:
        exec:
          command: ["/bin/sh","-c","echo goodbay.."]
    livenessProbe:
      exec:
command: ["/usr/bin/test","-e","/usr/share/nginx/html/test.html"]使用配置清单定义pod的健康状态监测需要用到livenessProbe这个字段 , 这个字段的值是一个对象 ; 以上配置表示判断/usr/share/nginx/html/test.html这个文件是否存在 , 存在就表示对应pod健康 , 否则就不健康 ;
应用配置清单
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl apply -f pod-demo4.yaml
pod/liveness-exec created
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl get pods
NAME              READY   STATUS    RESTARTS   AGE
liveness-exec 1/1 Running 0 5s可以看到对应pod现在已经正常运行着 , 并且重启次数为0 ;
测试 : 进入对应pod把test.html文件删除 , 看看对应pod还会正常处于健康状态吗?重启次数还是0吗?
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl exec liveness-exec -- rm -f /usr/share/nginx/html/test.html查看对应pod状态
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl get pods
NAME              READY   STATUS    RESTARTS      AGE
liveness-exec 1/1 Running 1 (33s ago) 3m33s可以看到对应pod重启数已经变为1了 , 说明pod发生了重启 ;
查看pod的详细信息
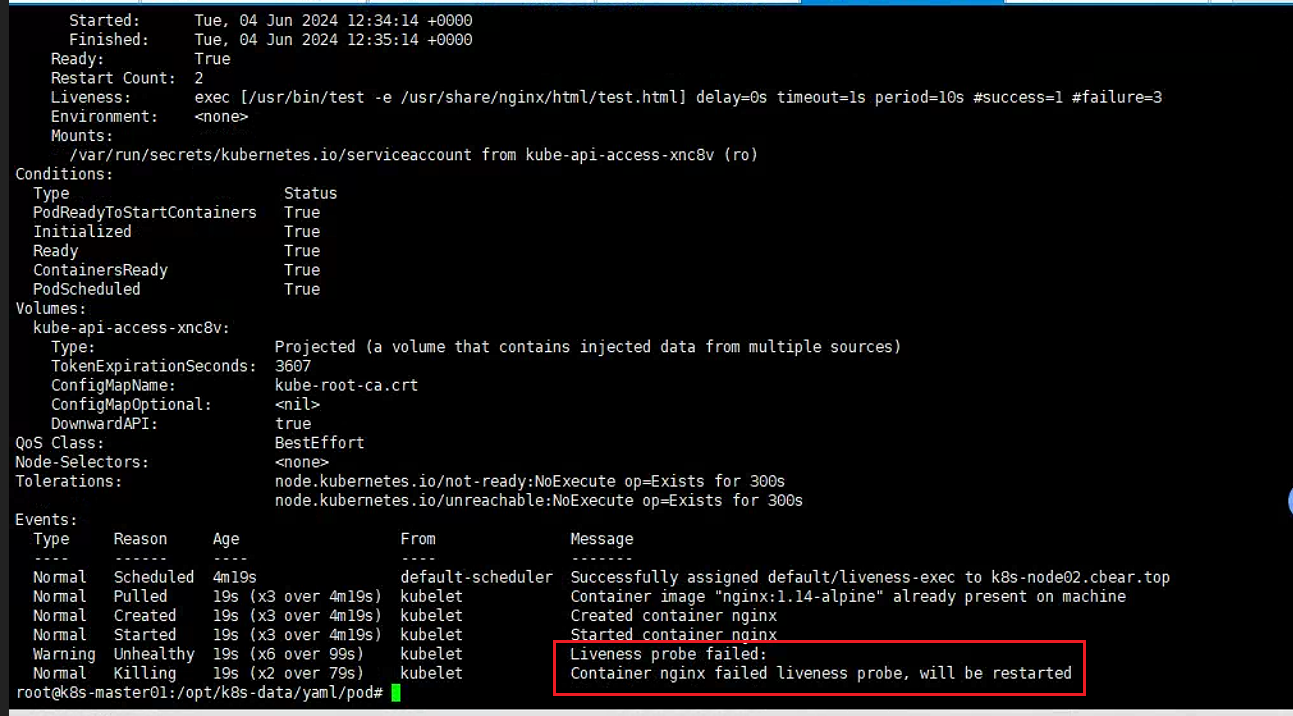
从上面的截图可以看到 , pod健康状态检查不通过 , 就把容器给重启了 ; 重启以后对应的文件又回重新创建 , 所以再次健康状态监测就通过了 , 所以pod处于健康状态 ;
6.1.2 httpGet
示例: 使用httpGet探测对应pod是否健康
root@k8s-master01:/opt/k8s-data/yaml/pod# cat liveness-httpget.yaml
apiVersion: v1
kind: Pod
metadata:
  name: liveness-httpget
  namespace: default
  labels:
    app: nginx
    env: testing
  annotations:
    descriptions: "this is test pod "
spec:
  containers:
  - image: nginx:1.14-alpine
    imagePullPolicy: IfNotPresent
    name: nginx
    ports:
    - name: http
      containerPort: 80
    lifecycle:
      postStart:
        exec:
          command:
          - /bin/sh
          - -c
          - "echo 'this is test page' > /usr/share/nginx/html/test.html"
      preStop:
        exec:
          command: ["/bin/sh","-c","echo goodbay.."]
    livenessProbe:
      httpGet:
        path: /test.html
        port: http
        scheme: HTTP
      failureThreshold: 2
      initialDelaySeconds: 2
periodSeconds: 3failureThreshold字段用于指定失败阈值 , 即多少次失败就把对应pod标记为不健康 ; 默认是3次 ;
initialDelaySeconds字段用于指定初始化后延迟多少时间再做健康状态监测 ;
periodSeconds字段用于指定监测频率 , 默认是10秒一次 ; 最小为1秒一次 ;
以上配置清单表示对pod容器里的/test.html这个url发起请求 , 如果响应码为200就表示pod健康 , 否则就不健康 ; httpGet中必须指定端口 , 端口信息可以应用上面容器中定义的端口名称 ;
应用配置清单
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl apply -f liveness-httpget.yaml
pod/liveness-httpget created

root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl get pods
NAME               READY   STATUS    RESTARTS   AGE
liveness-httpget   1/1     Running   0          3m19s
nginx-demo         1/1     Running   0          6h29m
nginx-demo2        1/1     Running   0          5h52m
验证: 进入对应pod , 把test.html文件删除 , 看看对应pod是否会重启
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl exec liveness-httpget -- rm -rf /usr/share/nginx/html/test.html

root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl get pods
NAME               READY   STATUS    RESTARTS     AGE
liveness-httpget   1/1     Running   1 (4s ago)   4m49s
nginx-demo         1/1     Running   0            6h31m
nginx-demo2 1/1 Running 0 5h54m可以看到对应pod已经发生了重启 ;
查看pod详细信息
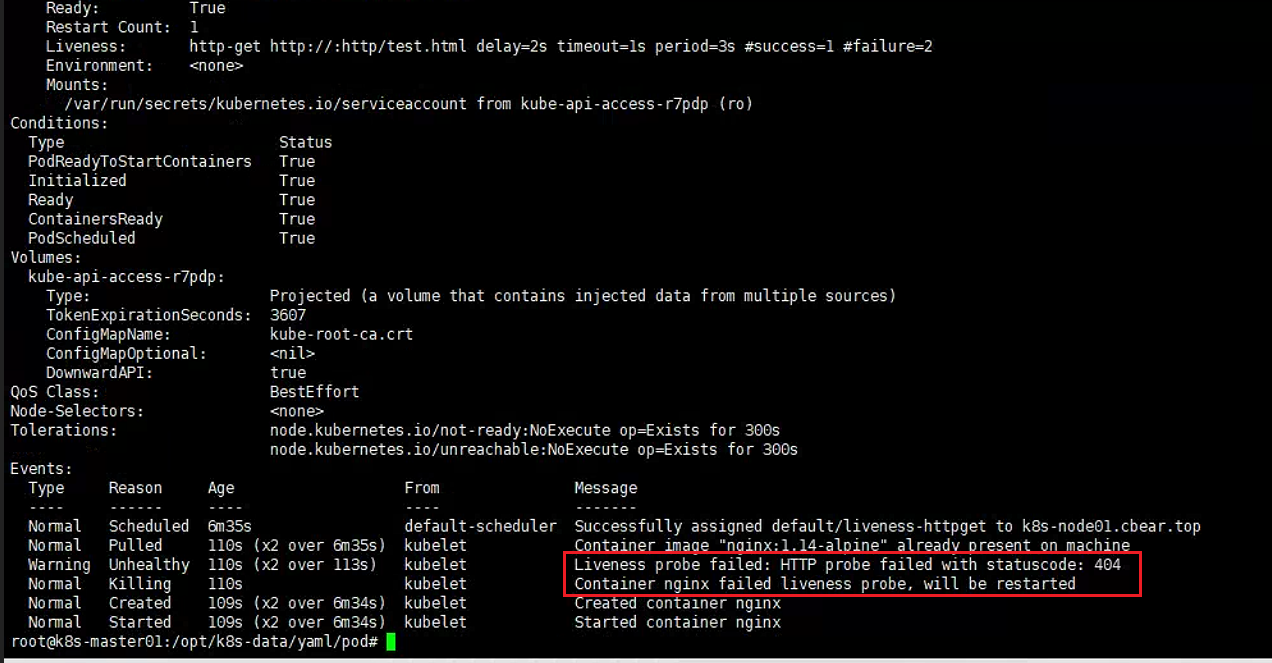
可以看到对应pod健康状态探测失败 , 并重启的事件 ;
6.1.3 tcpsocket
示例: 使用tcpsocket方式来探测pod健康状态
root@k8s-master01:/opt/k8s-data/yaml/pod# cat liveness-tcpsocket.yaml
apiVersion: v1
kind: Pod
metadata:
  name: liveness-tcpsocket
  namespace: default
  labels:
    app: nginx
    env: testing
  annotations:
    descriptions: "this is test pod "
spec:
  containers:
  - image: nginx:1.14-alpine
    imagePullPolicy: IfNotPresent
    name: nginx
    ports:
    - name: http
      containerPort: 80
    livenessProbe:
      tcpSocket:
        port: http
      failureThreshold: 2
      initialDelaySeconds: 2
periodSeconds: 3使用tcpSocket方式来探测健康与否 , 默认不指定host字段表示探测对应podip ;
应用资源配置清单
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl apply -f liveness-tcpsocket.yaml
pod/liveness-tcpsocket created
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl get pod
NAME                 READY   STATUS    RESTARTS        AGE
liveness-httpget     1/1     Running   1 (6m58s ago)   11m
liveness-tcpsocket   1/1     Running   0               48s
nginx-demo           1/1     Running   0               6h38m
nginx-demo2          1/1     Running   0               6h
测试: 进入pod里的容器 , 修改nginx的端口为81 , 看看对应pod是否会重启
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl exec liveness-tcpsocket -it -- /bin/sh
/ # netstat -ntl
Active Internet connections (only servers)
Proto Recv-Q Send-Q Local Address           Foreign Address         State
tcp        0      0 0.0.0.0:80              0.0.0.0:*               LISTEN
/ # grep "listen" /etc/nginx/conf.d/default.conf
    listen       80;
    # proxy the PHP scripts to Apache listening on 127.0.0.1:80
    # pass the PHP scripts to FastCGI server listening on 127.0.0.1:9000
/ # sed -i 's@    listen.*@    listen 81;@g' /etc/nginx/conf.d/default.conf
/ # grep "listen" /etc/nginx/conf.d/default.conf
    listen 81;
    # proxy the PHP scripts to Apache listening on 127.0.0.1:80
    # pass the PHP scripts to FastCGI server listening on 127.0.0.1:9000
/ # nginx -s reload
2024/06/04 12:55:03 [notice] 18#18: signal process started
/ # command terminated with exit code 137可以看到我们修改了配置文件让nginx监听81端口 , 没过几秒就退出了;
查看对应pod是否发生了重启
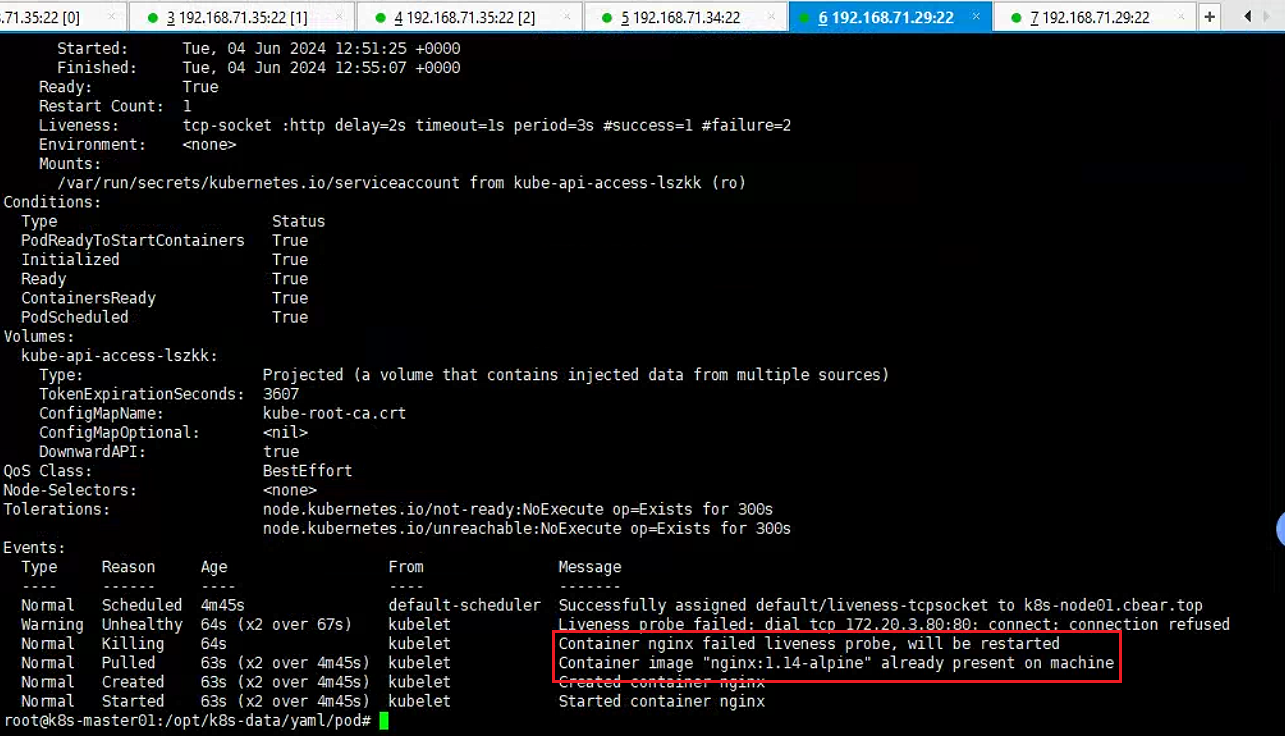
可以看到对应pod里的事件信息说健康状态监测172.20.3.80:80连接失败 , 容器重启了 ;
6.2 pod就绪状态探测
所谓pod就绪状态探测是指探测对应pod是否就绪 , 主要用在service关联后端pod的一个重要依据 , 如果对应pod未就绪 , 对应service就不应该关联pod , 否则可能发生用户访问对应service , 响应服务不可用 ; pod就绪状态检查和健康状态检查两者最主要的区别是 , 健康状态检查 , 一旦对应pod不健康了 , 就会执行重启对应pod的操作 , 而就绪状态检查是没有权限去重启pod , 如果对应pod没有就绪 , 它不会做任何操作 ; 同样的对就绪状态检查在k8s上也有三种方式和健康状态检查的方式一摸一样 ;
示例 : 使用exec方式探测pod就绪状态
root@k8s-master01:/opt/k8s-data/yaml/pod# cat readiness-demo.yaml
apiVersion: v1
kind: Pod
metadata:
  name: readiness-demo
  namespace: default
  labels:
    app: nginx
    env: testing
  annotations:
    descriptions: "this is test pod "
spec:
  containers:
  - image: nginx:1.14-alpine
    imagePullPolicy: IfNotPresent
    name: nginx
    ports:
    - name: http
      containerPort: 80
    lifecycle:
      postStart:
        exec:
          command: ["/bin/sh","-c","echo 'this is test page' > /usr/share/nginx/html/test.html"]
    readinessProbe:
      exec:
        command: ["/usr/bin/test","-e","/usr/share/nginx/html/test.html"]
      failureThreshold: 2
      initialDelaySeconds: 2
periodSeconds: 3以上清单表示如果/usr/share/nginx/html/test.html文件存在 , 则表示对应pod就绪 , 否则就表示为就绪 ;
应用配置清单
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl apply -f readiness-demo.yaml
pod/readiness-demo created
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl get pods
NAME                 READY   STATUS    RESTARTS      AGE
readiness-demo       1/1     Running   0             108s
测试: 删除pod容器中的test.html文件 , 看看对应pod是否会从就绪状态到未就绪状态
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl apply -f readiness-demo.yaml
pod/readiness-demo created
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl get pods
NAME                 READY   STATUS    RESTARTS      AGE
liveness-httpget     1/1     Running   1 (21m ago)   26m
liveness-tcpsocket   1/1     Running   1 (11m ago)   15m
nginx-demo           1/1     Running   0             6h52m
nginx-demo2          1/1     Running   0             6h15m
readiness-demo       1/1     Running   0             108s
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl exec readiness-demo -- rm -rf /usr/share/nginx/html/test.html

root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl get pods
NAME                 READY   STATUS    RESTARTS      AGE
liveness-httpget     1/1     Running   1 (29m ago)   34m
liveness-tcpsocket   1/1     Running   1 (20m ago)   23m
nginx-demo           1/1     Running   0             7h1m
nginx-demo2          1/1     Running   0             6h23m
readiness-demo 0/1 Running 0 10m可以看到对应pod已经处于未就绪状态了 ;
查看对应pod的详细信息
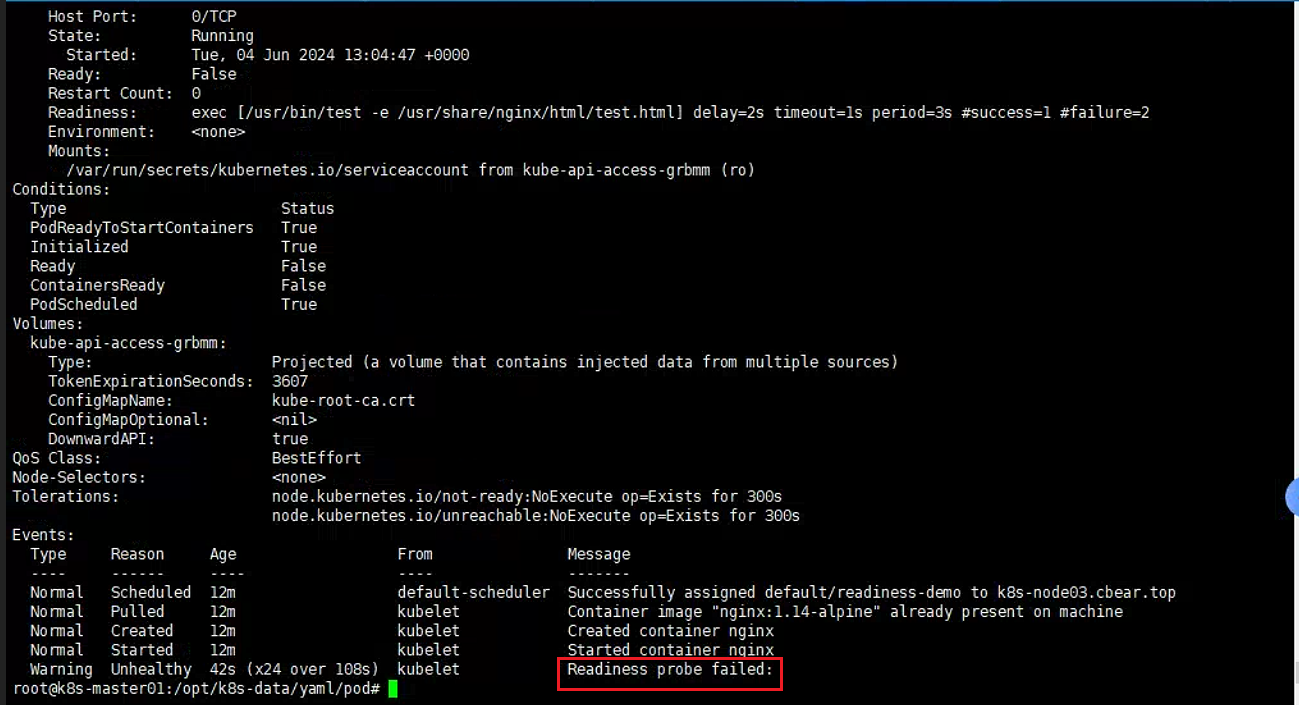
在对应pod的详细信息中也能看到对应的事件 , 不同于健康状态探测 , 就绪状态探测 , 它这里不会重启pod ;
测试: 创建test.html文件 , 看看对应pod是否会从未就绪状态到就绪状态
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl exec readiness-demo -- touch /usr/share/nginx/html/test.html
root@k8s-master01:/opt/k8s-data/yaml/pod# kubectl get pods
NAME                 READY   STATUS    RESTARTS      AGE
liveness-httpget     1/1     Running   1 (33m ago)   38m
liveness-tcpsocket   1/1     Running   1 (23m ago)   27m
nginx-demo           1/1     Running   0             7h4m
nginx-demo2          1/1     Running   0             6h27m
readiness-demo 1/1 Running 0 13m可以看到对应pod已经处于就绪状态 ;
6.3 启动探针
指示容器中的应用是否已经启动。如果提供了启动探针(startup probe), 则禁用所有其他探针, 直到它成功为止。如果启动探针失败, kubelet 将杀死容器, 容器服从其重启策略进行重启。如果容器没有提供启动探针, 则默认状态为成功Success。
启动探针 ( Startup Probe ) 用于Pod内程序告诉kubernetes, 其准备工作已经做好。这些准备工作主要是指业务运行前的前置条件, 比如资源文件下载完毕, 内置数据库文件下载完毕等。这步完成后存活和就绪探针才会开始工作。
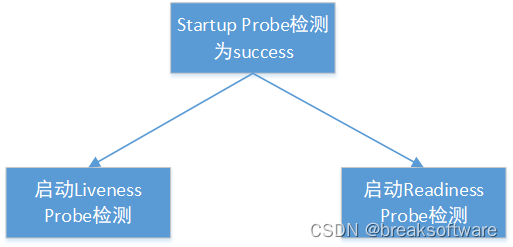
存活和就绪探针之间没有关系, 所以它们没有优先级区别, 即在启动探针确定Success后, 它们两个同时开始检测。有任何一个失败就会执行其对应的失败处理动作。 存活探针用于表示程序是否活着。如果被认定不存活, 会依据设置要么重启容器或让Pod调度失败。 就绪探针表示程序是否可以提供服务。一般Pod内程序是通过Service对外提供服务, 如果就绪探针失败, Service会将该Pod摘除, 这样流量就不会打到这个不能工作的Pod上 ; 如果就绪探针成功了, 该Pod又会被加进Service。 似乎有存活和就绪探针就够了, 为什么还要启动探针呢?因为一些准备工作我们并不知道其需要花多长时间, 比如可能网络带宽问题导致资源文件下载很慢。这个时候设置存活或者就绪探针就可能不准确, 或者导致其不灵敏。所以设置启动探针可以提升其他探针的灵敏度。
6.3.1 启动和存活探针
有时候 , 会有一些现有的应用在启动时需要较长的初始化时间。 要这种情况下 , 若要不影响对死锁作出快速响应的探测 , 设置存活探测参数是要技巧的。 技巧就是使用相同的命令来设置启动探测 , 针对 HTTP 或 TCP 检测 , 可以通过将 failureThreshold * periodSeconds 参数设置为足够长的时间来应对最糟糕情况下的启动时间。
# startup_liveness.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: startup-liveness-deployment
spec:
  selector:
    matchLabels:
      app: startup-liveness
  template:
    metadata:
      labels:
        app: startup-liveness
    spec:
      containers:
      - name: startup-liveness-container
        image: busybox
        command: ["/bin/sh", "-c", "sleep 6; touch /tempdir/ready; sleep 3;touch /tempdir/keepalive; while true; do sleep 5;  done"]
        volumeMounts:
        - name:  probe-volume
          mountPath:  /tempdir
        startupProbe:
          exec:
            command:
            - cat
            - /tempdir/ready
          initialDelaySeconds: 3
          failureThreshold: 6
          periodSeconds: 1
          successThreshold: 1
        livenessProbe:
          exec:
            command:
            - cat
            - /tempdir/keepalive
          failureThreshold: 6
          periodSeconds: 1
          successThreshold: 1
      volumes:
      - name: probe-volume
        emptyDir:
          medium: Memory
          sizeLimit: 1Gi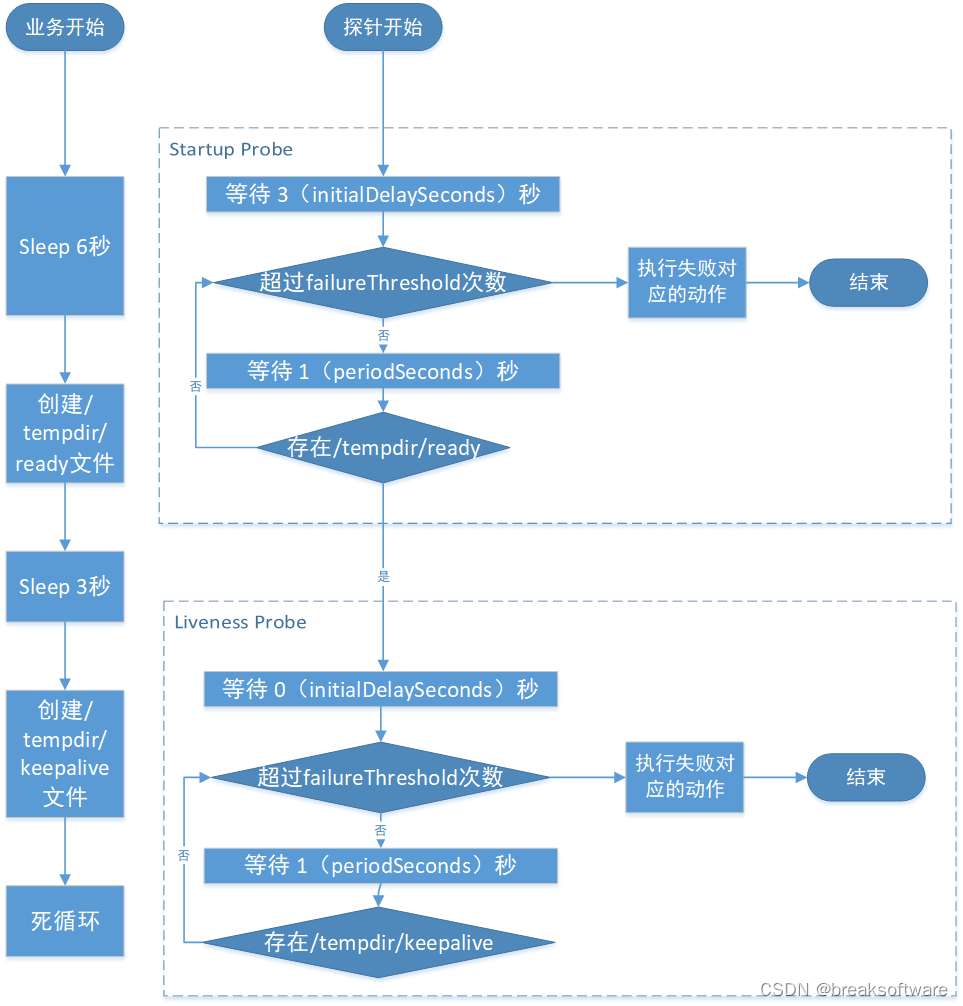
我们使用下面指令查看中间发生的事件
kubectl describe pod

Volumes:
  probe-volume:
    Type:       EmptyDir (a temporary directory that shares a pod's lifetime)
    Medium:     Memory
    SizeLimit:  1Gi
  kube-api-access-54ggd:
    Type:                    Projected (a volume that contains injected data from multiple sources)
    TokenExpirationSeconds:  3607
    ConfigMapName:           kube-root-ca.crt
    ConfigMapOptional:       <nil>
    DownwardAPI:             true
QoS Class:                   BestEffort
Node-Selectors:              <none>
Tolerations:                 node.kubernetes.io/not-ready:NoExecute op=Exists for 300s
                             node.kubernetes.io/unreachable:NoExecute op=Exists for 300s
Events:
  Type     Reason     Age                From               Message
  ----     ------     ----               ----               -------
  Normal   Scheduled  83s                default-scheduler  Successfully assigned default/startup-liveness-deployment-b98bc8df5-tvq89 to k8s-node02.cbear.top
  Normal   Pulling    83s                kubelet            Pulling image "busybox"
  Normal   Pulled     62s                kubelet            Successfully pulled image "busybox" in 20.477s (20.477s including waiting)
  Normal   Created    62s                kubelet            Created container startup-liveness-container
  Normal   Started    62s                kubelet            Started container startup-liveness-container
  Warning  Unhealthy  57s (x3 over 59s)  kubelet            Startup probe failed: cat: can't open '/tempdir/ready': No such file or directory
Warning Unhealthy 54s (x2 over 55s) kubelet Liveness probe failed: cat: can't open '/tempdir/keepalive': No such file or directory可以看到Startup Probe在第3次检测时 , /tempdir/ready文件还没创建。但是第4次时 , 就检测到了它 , 于是进入Liveness Probe检测状态。这从最后两个行为经历的时间差57s-54s=3s可以印证Startup Probe执行的次数大概在3次(因为检测周期periodSeconds是1秒) 。 Liveness Probe在第2次检测时 , /tempdir/keepalive还没创建。到第三次检测时 , 这个标志文件就创建了。于是整个Pod进入了Running状态。
6.3.2 启动和就绪探针
# startup_readiness.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: startup-readiness-deployment
spec:
  selector:
    matchLabels:
      app: startup-readiness
  template:
    metadata:
      labels:
        app: startup-readiness
    spec:
      containers:
      - name: startup-readiness-container
        image: busybox
        command: ["/bin/sh", "-c", "sleep 6; touch /tempdir/ready; sleep 3;touch /tempdir/readiness; while true; do sleep 5; done"]
        volumeMounts:
        - name:  probe-volume
          mountPath:  /tempdir
        startupProbe:
          exec:
            command:
            - cat
            - /tempdir/ready
          initialDelaySeconds: 3
          failureThreshold: 6
          periodSeconds: 1
          successThreshold: 1
        readinessProbe:
          exec:
            command:
            - cat
            - /tempdir/readiness
          failureThreshold: 6
          periodSeconds: 1
          successThreshold: 1
      volumes:
      - name: probe-volume
        emptyDir:
          medium: Memory
          sizeLimit: 1Gi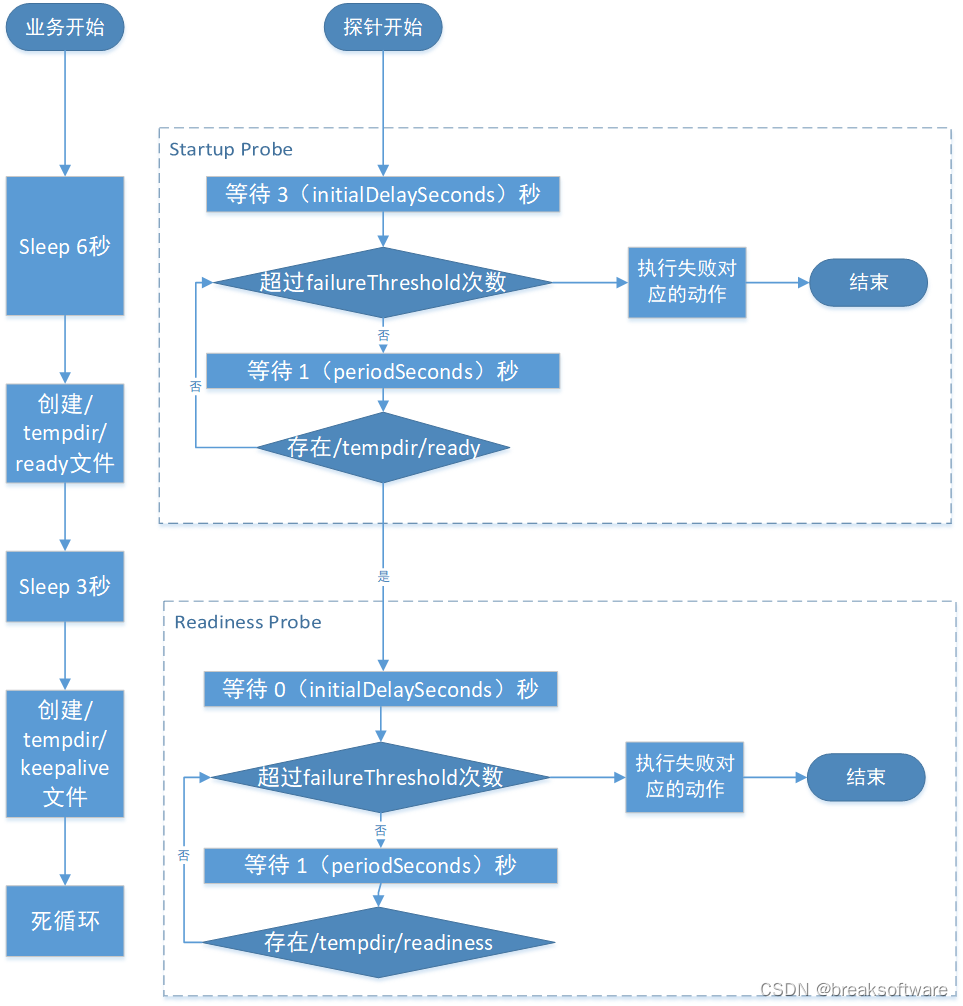
其执行事件如下:
Events:
  Type     Reason     Age                From               Message
  ----     ------     ----               ----               -------
  Normal   Scheduled  31s                default-scheduler  Successfully assigned default/startup-readiness-deployment-7bcb4b6bb5-ht6k9 to k8s-node02.cbear.top
  Normal   Pulling    31s                kubelet            Pulling image "busybox"
  Normal   Pulled     30s                kubelet            Successfully pulled image "busybox" in 443ms (443ms including waiting)
  Normal   Created    30s                kubelet            Created container startup-readiness-container
  Normal   Started    30s                kubelet            Started container startup-readiness-container
  Warning  Unhealthy  25s (x3 over 27s)  kubelet            Startup probe failed: cat: can't open '/tempdir/ready': No such file or directory
Warning Unhealthy 22s (x3 over 24s) kubelet Readiness probe failed: cat: can't open '/tempdir/readiness': No such file or directory这次readiness检测到第4次时才认定状态为success。
上述两个实验可以证明:启动探针 ( Startup Probe ) 检测状态是success后 , 存活 ( Liveness Probe ) 和就绪探针(Readiness Probe)才开始检测。
6.3.3 存活和就绪探针
# liveness_readiness.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: liveness-readiness-deployment
spec:
  selector:
    matchLabels:
      app: liveness-readiness
  template:
    metadata:
      labels:
        app: liveness-readiness
    spec:
      containers:
      - name: liveness-readiness-container
        image: busybox
        command: ["/bin/sh", "-c", "sleep 3; touch /tempdir/keepalive; sleep 3;touch /tempdir/readiness; while true; do sleep 5; done"]
        volumeMounts:
        - name:  probe-volume
          mountPath:  /tempdir
        livenessProbe:
          exec:
            command:
            - cat
            - /tempdir/keepalive
          initialDelaySeconds: 3
          failureThreshold: 6
          periodSeconds: 1
          successThreshold: 1
        readinessProbe:
          exec:
            command:
            - cat
            - /tempdir/readiness
          failureThreshold: 6
          periodSeconds: 1
          successThreshold: 1
      volumes:
      - name: probe-volume
        emptyDir:
          medium: Memory
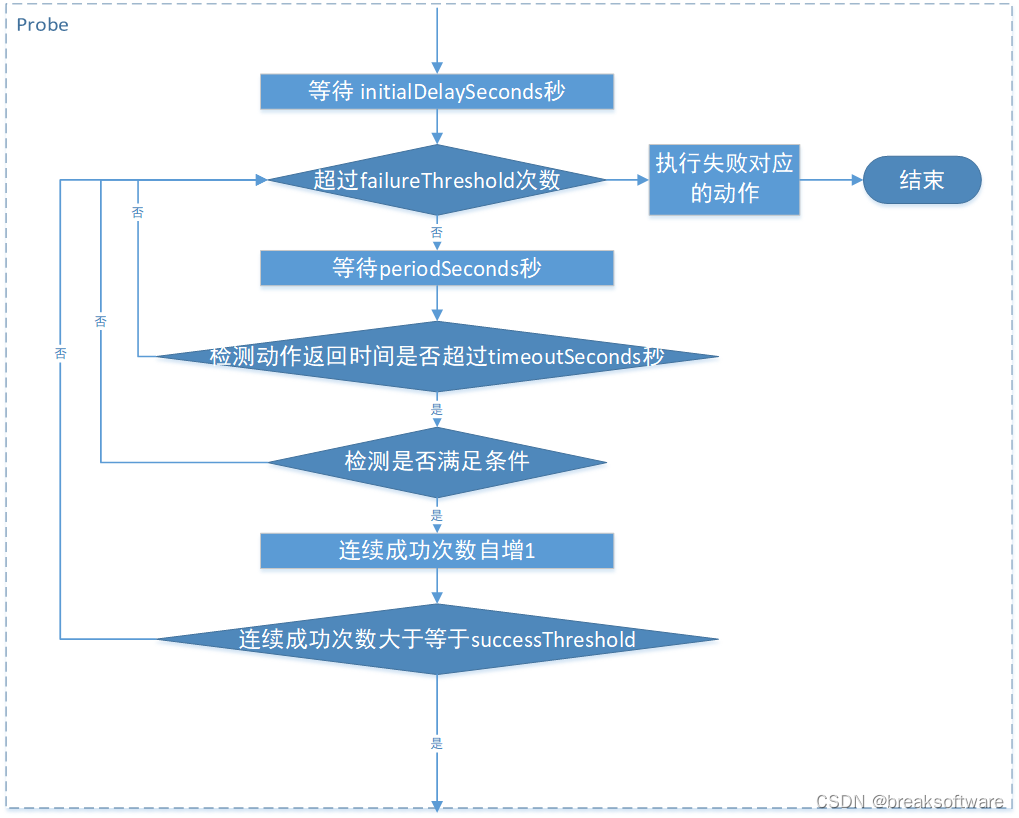
sizeLimit: 1Gi通过Pod的Event可以看到 , Liveness和Readiness Probe的生命长度一致(如下图都是6秒)。
Events:
  Type     Reason     Age                From               Message
  ----     ------     ----               ----               -------
  Normal   Scheduled  44s                default-scheduler  Successfully assigned default/liveness-readiness-deployment-6b8cf98b6b-ksqb5 to k8s-node01.cbear.top
  Normal   Pulling    44s                kubelet            Pulling image "busybox"
  Normal   Pulled     39s                kubelet            Successfully pulled image "busybox" in 5.426s (5.426s including waiting)
  Normal   Created    39s                kubelet            Created container liveness-readiness-container
  Normal   Started    38s                kubelet            Started container liveness-readiness-container
  Warning  Unhealthy  33s (x7 over 38s)  kubelet            Readiness probe failed: cat: can't open '/tempdir/readiness': No such file or directory
7. pod资源限制
所谓pod资源限制就是指限制对应pod里容器的cpu和内存使用量 ; 我们知道如果一个容器不限制其资源的使用大小 , 很有可能发生一个容器将宿主机上的内存耗尽的情况 , 如果一旦发生内存耗尽 , 内核很有可能向容器进程发起oom(out of memory),这样一来运行在docker上的其他容器也会相继退出 ; 所以为了不让类似的情况发生 , 我们有必要给pod里的容器做资源限定 ;
资源计量方式
对于cpu来讲 , 它是可压缩资源 , 所谓可以压缩资源就是表示cpu不够用时 , 它并不会报错 , pod可以等待 ; 对于内存来讲 , 它是不可压缩资源 , 不可压缩就是指如果内存不够用对应程序就会崩溃 , 从而导致容器退出 ; cpu的计量方式是m , 即1核心=1000m , 0.5个核心就等于500m ; 内存的计量方式默认单位是字节 , 我们在指定内存资源 , 直接加上单位即可 。 可以使用E、P、T、G、M、K为后缀单位 , 也可以使用Ei、Pi、Ti、Gi、Mi、Ki作为单位 。
示例 : 在资源清单中限制pod资源
[root@master01 ~]# cat resource.yaml
apiVersion: v1
kind: Pod
metadata:
  name: stress-pod
spec:
  containers:
  - name: stress
    image: ikubernetes/stress-ng
    command: ["/usr/bin/stress-ng", "-c 1", "-m 1", "--metrics-brief"]
    resources:
      requests:
        memory: "128Mi"
        cpu: "200m"
      limits:
        memory: "512Mi"
        cpu: "400m"
[root@master01 ~]#
提示 : 定义pod的资源限制 , 需要用到resources这个字段 , 这个字段的值为一个对象;其中requests字段用于指定下限 , limits指定资源的上限。
应用资源清单
[root@master01 ~]# kubectl apply -f resource.yaml
pod/stress-pod created
[root@master01 ~]# kubectl get pod -o wide
NAME                         READY   STATUS    RESTARTS   AGE     IP            NODE             NOMINATED NODE   READINESS GATES
liveness-exec                1/1     Running   2          147m    10.244.3.21   node03.k8s.org   <none>           <none>
liveness-httpget             1/1     Running   1          118m    10.244.2.14   node02.k8s.org   <none>           <none>
liveness-tcpsocket           1/1     Running   1          105m    10.244.3.22   node03.k8s.org   <none>           <none>
myapp-dep-5bc4d8cc74-cvkbc   1/1     Running   3          8d      10.244.1.16   node01.k8s.org   <none>           <none>
myapp-dep-5bc4d8cc74-gmt7w   1/1     Running   4          8d      10.244.3.17   node03.k8s.org   <none>           <none>
myapp-dep-5bc4d8cc74-gqhh5   1/1     Running   3          8d      10.244.2.11   node02.k8s.org   <none>           <none>
nginx-pod-demo7              1/1     Running   1          7h12m   10.244.1.14   node01.k8s.org   <none>           <none>
ngx-dep-5c8d96d457-w6nss     1/1     Running   3          8d      10.244.2.12   node02.k8s.org   <none>           <none>
readiness-demo               1/1     Running   0          82m     10.244.3.23   node03.k8s.org   <none>           <none>
stress-pod                   1/1     Running   0          13s     10.244.2.16   node02.k8s.org   <none>           <none>
[root@master01 ~]#
提示 : 可以看到stress-pod被调度到node02上运行了。
测试 : 在node02上使用docker stats命令查看对应stress-pod容器占用资源情况
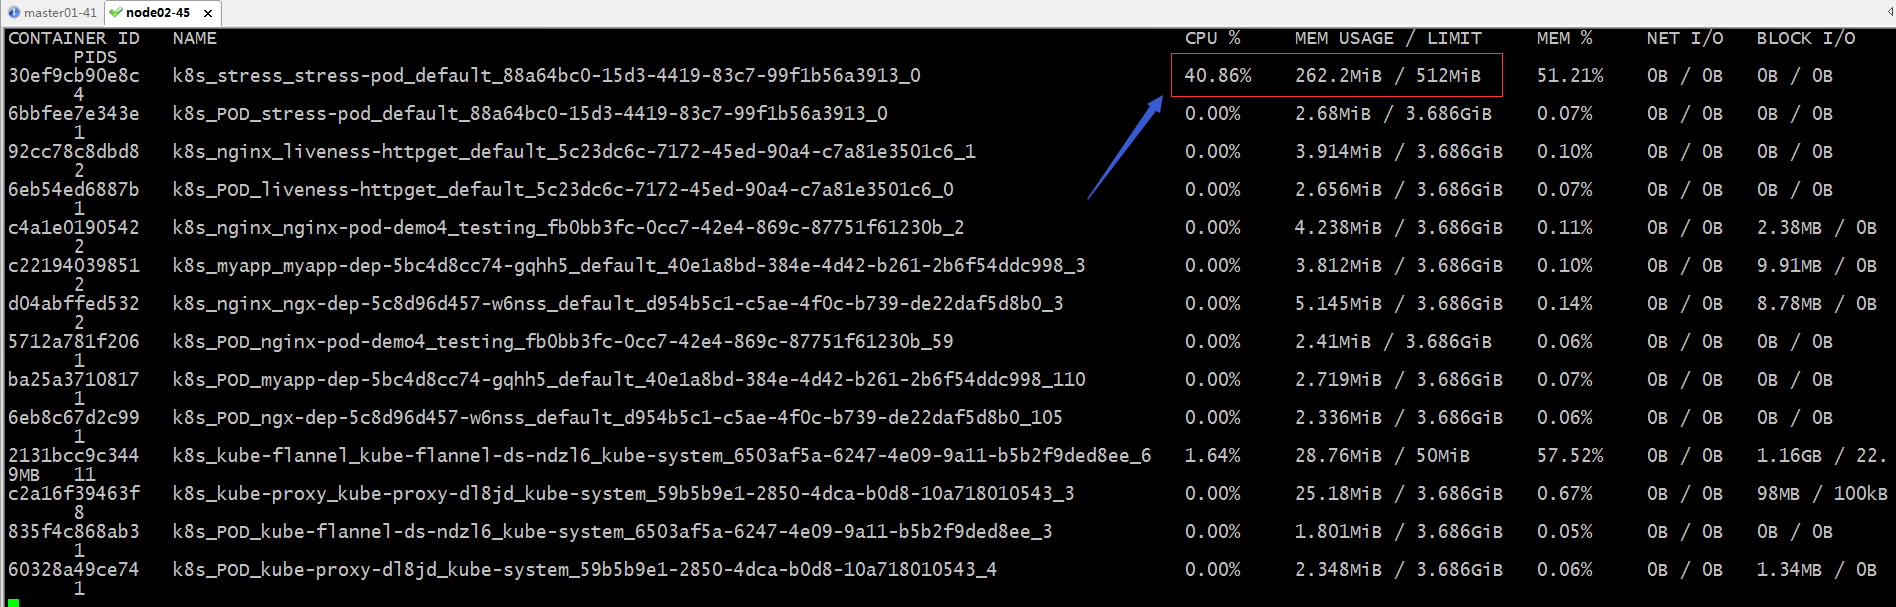
提示 : 可以看到在node02上跑的k8s_stress_stress-pod_default容器占有cpu和内存都是我们在资源清单中定义的量。
示例 : 当pod里的容器资源不够用时 , 对应pod是否会发生oom呢?
[root@master01 ~]# cat memleak-pod.yaml
apiVersion: v1
kind: Pod
metadata:
  name: memleak-pod
spec:
  containers:
  - name: simmemleak
    image: saadali/simmemleak
    resources:
      requests:
        memory: "64Mi"
        cpu: "1"
      limits:
        memory: "1Gi"
        cpu: "1"
[root@master01 ~]#
提示 : 以上配置清单主要限制了容器最大内存为1G , 最小内存为64M , cpu上下限都为1核心。
应用配置清单
[root@master01 ~]# kubectl apply -f memleak-pod.yaml
pod/memleak-pod created
[root@master01 ~]# kubectl get pod
NAME                         READY   STATUS              RESTARTS   AGE
liveness-exec                1/1     Running             2          155m
liveness-httpget             1/1     Running             1          126m
liveness-tcpsocket           1/1     Running             1          113m
memleak-pod                  0/1     ContainerCreating   0          2s
myapp-dep-5bc4d8cc74-cvkbc   1/1     Running             3          8d
myapp-dep-5bc4d8cc74-gmt7w   1/1     Running             4          8d
myapp-dep-5bc4d8cc74-gqhh5   1/1     Running             3          8d
nginx-pod-demo7              1/1     Running             1          7h21m
ngx-dep-5c8d96d457-w6nss     1/1     Running             3          8d
readiness-demo               1/1     Running             0          90m
stress-pod                   1/1     Running             0          8m46s
[root@master01 ~]# kubectl get pod
NAME                         READY   STATUS      RESTARTS   AGE
liveness-exec                1/1     Running     2          156m
liveness-httpget             1/1     Running     1          126m
liveness-tcpsocket           1/1     Running     1          114m
memleak-pod                  0/1     OOMKilled   0          21s
myapp-dep-5bc4d8cc74-cvkbc   1/1     Running     3          8d
myapp-dep-5bc4d8cc74-gmt7w   1/1     Running     4          8d
myapp-dep-5bc4d8cc74-gqhh5   1/1     Running     3          8d
nginx-pod-demo7              1/1     Running     1          7h21m
ngx-dep-5c8d96d457-w6nss     1/1     Running     3          8d
readiness-demo               1/1     Running     0          91m
stress-pod                   1/1     Running     0          9m5s
[root@master01 ~]#
提示 : 可以看到应用资源清单以后 , 对应的pod处于OOMKilled状态。原因是我们运行的镜像里面的程序一直申请内存 , 超出了最大限制。
查看pod详细信息
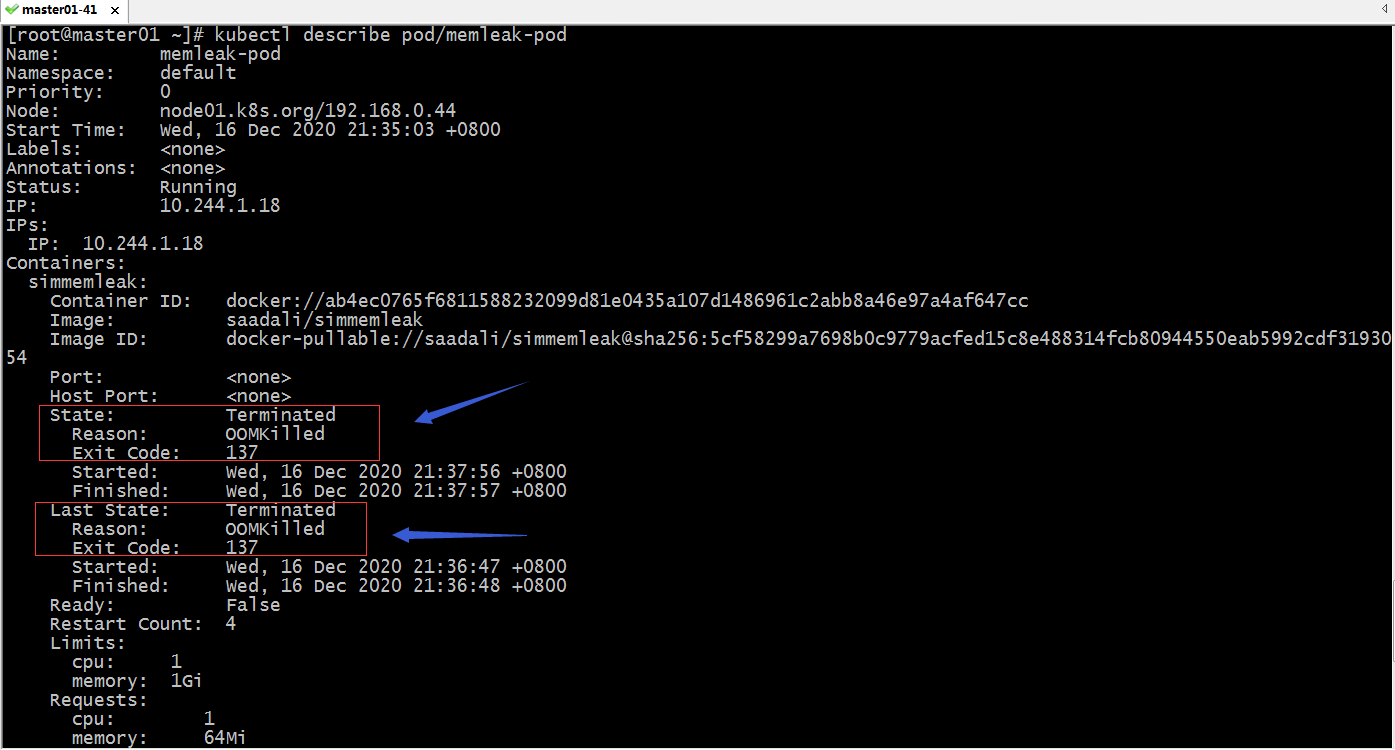
提示 : 可以看到当前pod状态为terminated状态,原因是OOMKilled 。上一次状态为terminated , 原因也是OOMKilled。
参考链接
研发工程师玩转Kubernetes——启动、存活和就绪探针-腾讯云开发者社区-腾讯云 (tencent.com)
容器编排系统k8s之Pod生命周期、健康/就绪状态探测以及资源限制 - Linux-1874 - 博客园 (cnblogs.com)