
3-4-1-pod基础
Kubernetes是分布式运行于多个主机之上、负责运行及管理应用 程序的“云操作系统”或“云原生应用操作系统” , 它将Pod作为运行应用的最小化组件和基础调度单元。因而Pod是Kubernetes资源对象模型中可由用户创建或部署的最小化应用组件 , 而大多数其他API资源基本都是负责支撑和扩展Pod功能的组件。因此 , 本章将重点介绍如何部署、运行并管理Kubernetes之上的Pod对象。
1. 应用容器与Pod资源
封装了应用容器的Pod资源代表运行在Kubernetes系统之上的进程或进程组 , 它可由单个容器或少量具有强耦合关系并共享资源的容器 组成 , 用于抽象、组织和管理集群之上的应用进程。本节重点解析Pod 内部组织和管理容器的方式。
1.1 Pod资源基础
现代应用容器技术用来运行单个进程(包括子进程) , 它在容器 中PID名称空间中的进程号为1 , 可直接接收并处理信号 , 因而该进程 终止也将导致容器终止并退出。这种设计使得容器与内部进程具有共同的生命周期 , 更容易发现和判定故障 , 也更利于对单个应用程序按 需求进行扩容和缩容。单进程容器可将应用日志直接送往标准输出 (STDOUT)和标准错误(STDERR) , 有利于让容器引擎及容器编排工具获取、存储和管理。因此 , 一个容器中仅应该运行一个进程是应用 容器“立身之本” , 这也是Docker及Kubernetes使用容器的标准方式。
凡事有利就有弊 , 单进程模型的应用容器显然不利于有IPC通信等需求的多个具有强耦合关系的进程间的协同 , 除非在组织这类容器时人为地让它们运行于同一内核之上共享IPC名称空间。于是 , 跨多个主机运行的容器编排系统需要能够描述这种容器间的强耦合关系 , 并确 保它们始终能够被调度至集群中的同一个节点之上 , Kubernetes为应对这种需求发明了Pod这一抽象概念 , 并将其设计为顶级API对象 , 是 集群的“一等公民”。
事实上 , 任何人都能够配置容器运行时工具(例如Docker CLI)来控制容器组内各容器之间的共享级别: 首先创建一个基础容器作为 父容器 , 而后使用必要的命令选项来创建与父容器共享指定环境的新容器 , 并管理好这些容器的生命周期即可。Kubernetes使用名为pause 的容器作为Pod中所有容器的父容器来支撑这种构想 , 因而也被称为 Pod的基础架构容器 , 如图所示。若用户为Pod启用了PID名称空间 共享功能 , pause容器还能够作为同一Pod的各容器的1号PID进程以回 收僵尸进程。不过 , Kubernetes默认不会为Pod内的各容器共享PID名 称空间 , 它依赖于用户的显式设定。
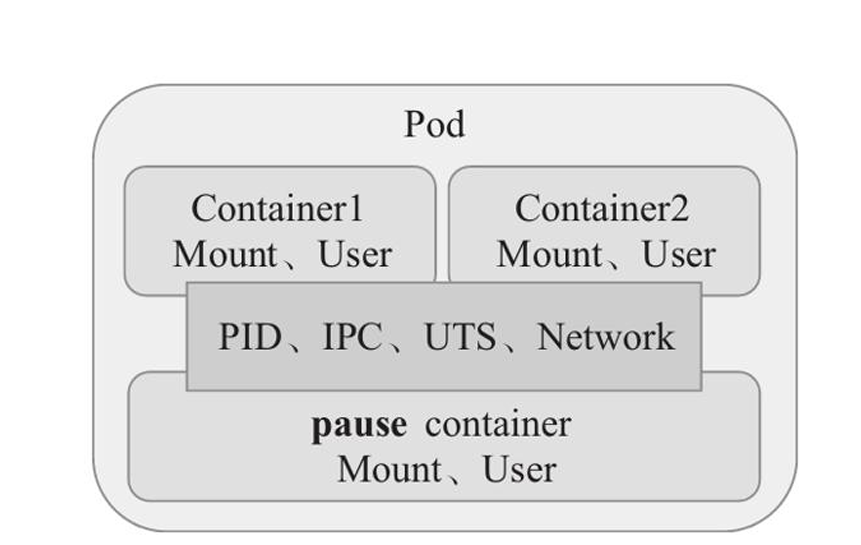
Pod除了是一组共享特定名称空间的容器的集合之外 , 其设计还隐 藏了容器运行时复杂的命令行选项以及管理容器实例、存储卷及其他 资源的复杂性 , 也隐藏了不同容器运行时彼此间的差异。从而让最终 用户只需要掌握Pod资源配置格式便能够创建并运行容器 , 且无须关心 具体的运行时就能够平滑地在不同的OCI容器运行时之间迁移容器。
同一Pod中 , 这些共享PID、IPC、Network和UTS名称空间的容器彼此间可通过IPC通信 , 共享使用主机名和网络接口、IP地址、端口和路由等各种网络资源 , 因而各容器进程能够通过lo网络接口通信且不能使用相同的网络套接字地址。尽管可以把Pod类比为物理机或虚拟机 , 但一个Pod内通常仅应该运行具有强耦合关系的容器 , 否则除了pause以外 , 只应该存在单个容器 , 或者只存在单个主容器和一个以上的辅助类容器(例如服务网格中的Sidecar容器等) , 这也更符合单进程应 用容器的设计初衷。
例如 , 对于典型的传统三层应用来说 , 处理业务的服务器应用和 数据库管理系统就应该分别组织在不同的Pod中 , 毕竟二者之间虽然存 在通信需求 , 但并不存在强耦合关系。更重要的是 , 因为运行于不同 的Pod中 , 这两个应用的Pod有可能被调度至不同的工作节点之上 , 从 而能更好地利用分布于集群中的计算资源和存储资源。再者 , 考虑到 服务器应用和数据库系统各自需要应对的请求量和业务处理压力 , 它 们在容量设计上也会存在不同需求 , 运行于各自的Pod中更有利于独立 扩容和缩容操作。究竟哪些容器应该组织在同一个Pod中 , 以及如何组织 , 我们将在下一节详细描述。
Pod本身并不能自愈 , 因工作节点故障或计算资源吃紧、管理需求 以及Pod自身故障等 , 集群中的每个Pod都存在被删除的可能性 , Kubernetes可使用kubelet和控制器件来“复活”这种被弃用的Pod对 象 , 并进行其他管理工作。因此 , 我们一般不应该手动创建这些 “裸”Pod , 而要通过控制器对象 , 并借助于“Pod模板”来创建和管理。另外 , 重建或者重新调度“复活”的Pod对象虽然与原Pod具有相 同的名称 , 然则二者并非完全等同 , 极有可能被分配了一个新的IP地 址 , 再考虑到Pod应用的水平伸缩导致的同一应用的Pod对象的规模变动 , 因而便有了Service资源这个中间层结合KubeDNS进行服务发现。 再者 , 跨工作节点生命周期实现Pod应用数据持久化存储的能力 , 则要依赖另一种称为Volume的资源来实现。
1.2 容器设计模式
软件工程领域 , 设计模式是对软件设计中普遍存在或反复出现的 各种问题而提出的通用解决方案。对于使用容器和微服务的云原生应用程序 , 同样存在实现类似功能的设计模式 , 它们被称为微服务设计模式或容器设计模式。这些设计模式蕴含着最佳实践 , 它们能简化开 发并有效增强基于容器和微服务的分布式系统的可靠性。
Google的Brendan Burns和David Oppenheimer在论文 Design patterns for container-based distributed systems 描述了基于容器的分布式系统中出现的3类设计模式: 1. 单容器模式; 2. 由强耦合容器协同共生的单节点模式(例如Pod) , 即单节点多容器模式; 3. 基于特定部署单元(Pod)实现分布式算法的多节点模式。这些容器设计模 式也代表了它们可以在Kubernetes运行的模式 , 即于Pod中组织容器的机制。
1.2.1 单容器模式
单容器模式就是指将应用程序封装为应用容器运行 , 这也是我们开始容器技术之旅的方式。需要特别强调的一点是 , 该模式需要遵循 简单和单一原则 , 每个容器仅承载一种工作负载 , 因而在同一个容器 中同时运行Web服务器和日志收集代理程序便违反了该设计原则。
传统的容器管理接口极为有限 , 尽管它暴露的run、pause和stop 这3个管理接口相当有用 , 但是更丰富的接口将为开发者及运维人员赋 予更多的管理能力。现代的编程语言几乎普遍支持HTTP Web服务和 JSON数据格式 , 因而云应用程序开发人员可以在应用程序的核心功能 之外轻松定义一个基于HTTP的管理API , 并通过特定的URL端点予以暴露
1.2.2 单节点多容器模式
单节点多容器模式是指跨容器的设计模式 , 其目的是在单个主机 之上同时运行多个共生关系的容器 , 因而容器管理系统需要将它们作为一个原子单位进行统一调度。Kubernetes编排系统设计的Pod概念就是这个设计模式的实现之一。
若多个容器间存在强耦合关系 , 它们具有完全相同的生命周期 , 或者必须运行于同一节点之上时 , 通常应该将它们置于同一个Pod中 , 较常见的情况是为主容器并行运行一个助理式管理进程。单节点多容器模式的常见实现有Sidecar(边车)、适配器(Adapter)、大使(Ambassador)、初始化(Initializer)容器模式等。
1.2.2.1 Sidecar模式
Sidecar模式是多容器系统设计的最常用模式 , 它由一个主应用程序(通常是Web应用程序)以及一个辅助容器(Sidecar容器)组成 , 该辅助容器用于为主容器提供辅助服务以增强主容器的功能 , 是主应用程序是必不可少的一部分 , 但却不一定非得存在于应用程序本身内部。
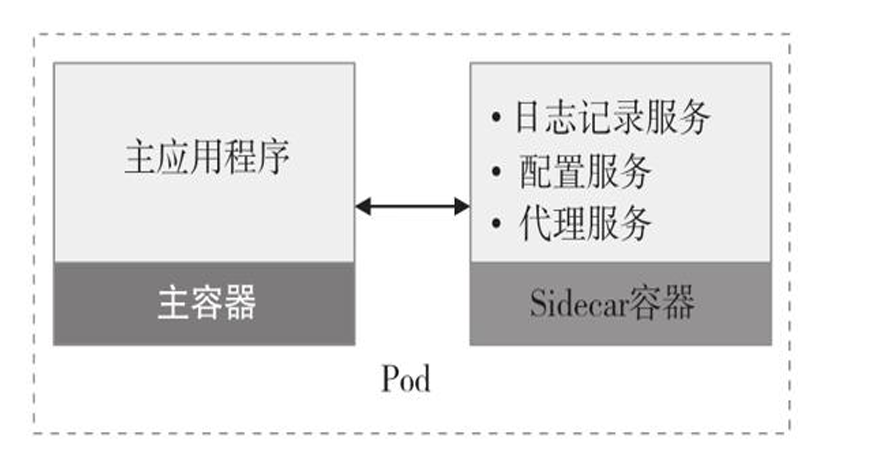
最常见的Sidecar容器是日志记录服务、数据同步服务、配置服务 和代理服务等。对于主容器应用的每个实例 , Sidecar的实例都被部署并托管在它旁边 , 主容器与Sidecar容器具有相同的生命周期 , 毕竟主容器未运行时 , 运行Sidecar容器并无实际意义。尽管完全可以将 Sidecar容器集成到主容器内部 , 但是使用不同的容器来进行处理不同功能还是存在较多的优势:
辅助应用的运行时环境和编程语言与主应用程序无关 , 因而无须为每种编程语言分别开发一个辅助工具;
二者可基于
IPC、lo接口或共享存储进行数据交换 , 不存在明显的通信延迟;容器镜像是发布的基本单位 , 将主应用与辅助应用划分为两个容器使得其可由不同团队开发和维护 , 从而变得方便及高效 , 单独测试 及集成测试也变得可能;
容器限制了故障边界 , 使得系统整体可以优雅降级 , 例如
Sidecar容器异常时 , 主容器仍可继续提供服务;容器是部署的基本单元 , 每个功能模块均可独立部署及回滚。
事实上 , 这些优势对于其他模型来说同样存在。
1.2.2.2 大使模式
云原生应用程序需要诸如断路、路由、计量和监视等功能 , 以及具有进行与网络相关的配置更新的功能 , 但更新旧有的应用程序或现有代码库以添加这些功能可能很困难 , 甚至难以实现 , 进程外代理便成了一种有效的解决方案。大使模式本质上就是这么一类代理程序 , 它代表主容器发送网络请求至外部环境中 , 因此可以将其 视作与客户端(主容器应用)位于同一位置的“外交官”。
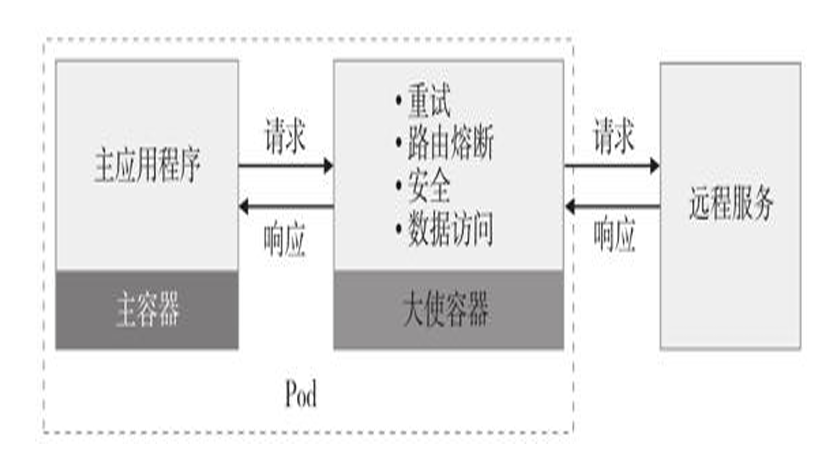
大使模式的最佳用例之一是提供对数据库的访问。实践中 , 开发环境、测试环境和生产环境中的主应用程序可能需要分别连接到不同的数据库服务。尽管使用环境变量可配置主容器应用完成此类功能 , 但更好的方案是让应用程序始终通过localhost连接至大使容器 , 而如 何正确连接到目标数据的责任则由大使容器完成。另外 , 需要以智能客户端连接至外部的分布式数据库时(例如Redis Cluster等) , 也可以使用大使来扮演此类的客户端程序。
代理会增加网络开销并导致一定的延迟 , 因而对延迟敏感的应用 应该仔细权衡模式的得失。
1.2.2.3 适配器模式
适配器模式用于为主应用程序提供一致的接口 , 实现了模块重用 , 支持标准化和规范化主容器应用程序的输出以便于外部服务进行聚合。相比较来说 , 大使模式为内部容器提供了简化统一的外部服务视图 , 适配器模式则刚好反过来 , 它通过标准化容器的输出和接口 , 为外界展示了一个简化的应用视图。
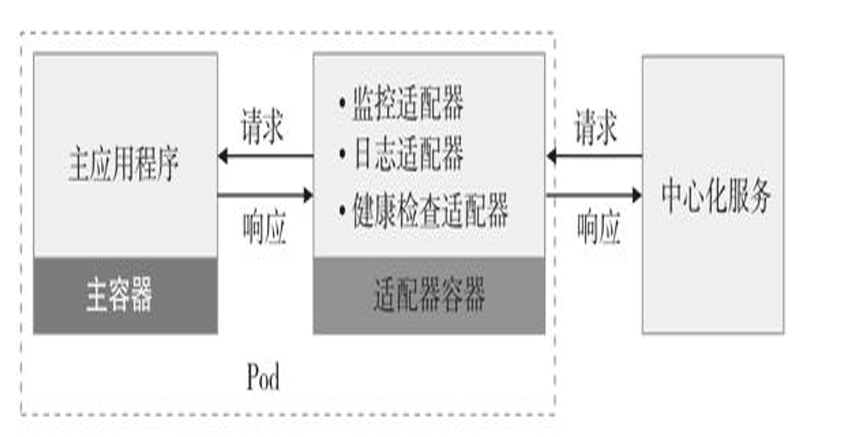
一个实际的例子就是借助于适配器容器确保系统内的所有容器提供统一的监控接口。如今应用通过各种各样的方式暴露不尽相同的指标格式(例如JMX和Statsd等) , 而通过一个固定的监控接口暴露指标将有助于分布式应用的监控工具收集、聚合及可视化等功能。尽管目前一些监控解决方案支持与多种类型的后端通信 , 但这种在监控系统内部置入与特定应用程序相关的代码却有违代码解耦及整洁性。
1.2.2.4 初始化容器模式
初始化容器模式负责以不同于主容器的生命周期来完成那些必要的初始化任务 , 包括在文件系统上设置必要的特殊权限、 数据库模式设置或为主应用程序提供初始数据等。但这些初始化逻辑无法包含在应用程序的镜像文件中 , 或者出于安全原因 , 应用程序镜像没有执行初始化活动的权限 , 再或者用户期望能延迟应用程序启动 , 直到外部环境满足其启动条件为止。
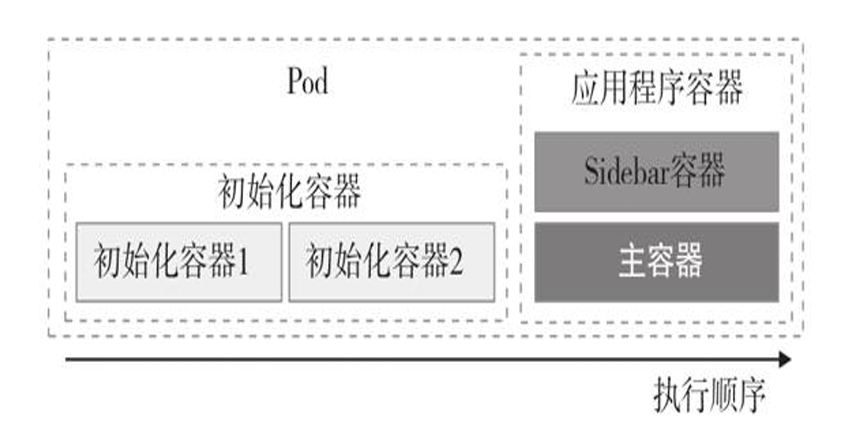
初始化容器将Pod内部的容器分成了两组: 初始化容器和应用程序容器(主容器和Sidecar容器等) , 初始化容器可以不止一个 , 但它们需要以特定的顺序串行运行 , 并需要在启动应用程序容器之前成功终止。不过 , 多个应用程序容器一般需要并行启动和运行。
就Kubernetes来说 , 除了初始化容器之外 , 还有一些其他可用的初始化技术 , 例如admission controllers、admission webhooks和 PodPresets等。
1.2.3 多节点模式
多节点模式就是将分布式应用的每个任务实例分布于多个节点 , 分别以单节点模式运行 , 并以更高级的形式进行彼此通信和协同的更高级模式。典型的分布式应用程序具有许多以协调方式并行执行的任 务 , 这些任务可能依赖于外部的协调机制来确保各任务实例互不冲突 , 以避免导致争抢共享资源或者意外干扰其他实例正在执行的工作。下面描述了几种以容器方式运行的分布式云应用程序的设计模 式。
领导者选举模式
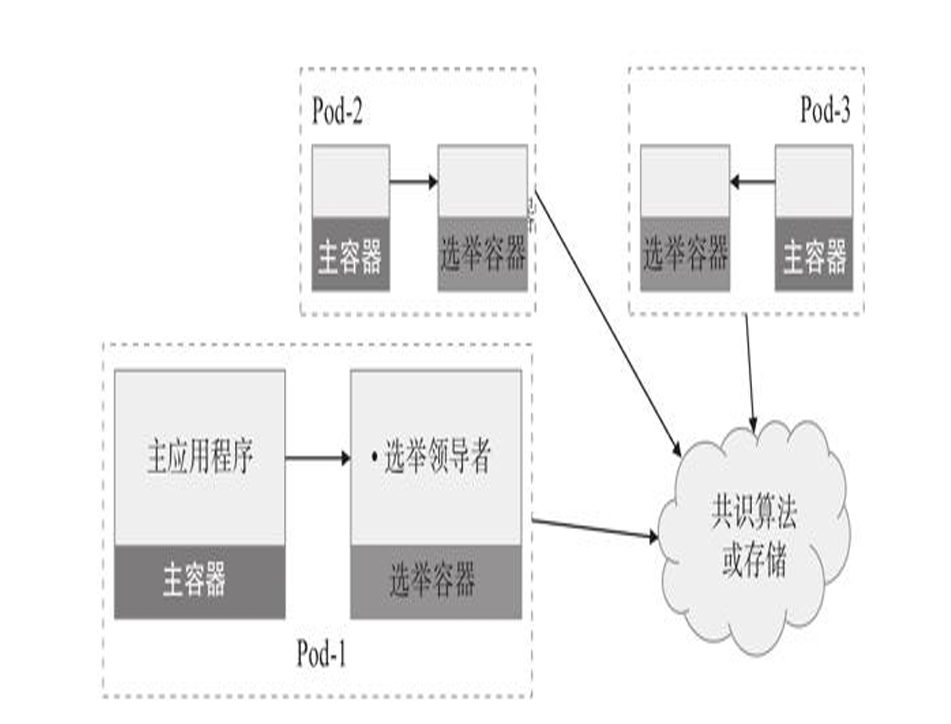
领导者选举的思想是 , 若一个分布式应用支持同时运行某一任务的多个无差别、完全对等实例以提高服务可用性级别 , 但这些实例存 在可写入的共享资源 , 或者支持将复杂计算分割为多个并行执行的任 务实例并需要对结果进行聚合时 , 就需要选举一个实例来充当领导者 以对其他下属任务实例的操作进行协调。运行相同的代码的每个实例 都可能被选举为领导者 , 因而必须确保选举流程正确进行 , 以防止两 个或更多实例同时接管领导者角色。一个系统也可能并行运行多个选举流程 , 例如每个数据分片子集需要分别选举各自的领导者等。图为领导者选举模式示意图。
以
etcd、ZooKeeper和Consul为代表的主流选举服务或存储系统业已相当成熟 , 但配套用于选举的代码库对特定业务领域的程序员来说 通常难以掌握和正确使用 , 且因编程语言而限制了适用范围 , 于是通过为每个分布式应用程序的每个任务实例外挂一个选举容器协同进行 领导者选举便成了不错的解决方案。这些能够提供选举能力的容器可以由分布式协同领域的专业人员提供 , 相关代码编译一次之后该容器 即可由各类编程语言的开发者所复用。工作队列模式
分布式应用程序的各组件间存在大量的事件传递需求 , 当某应用 组件需要将信息广播至大量订阅者时 , 可能需要与多个独立开发的 , 可能使用了不同平台、编程语言和通信协议的应用程序或服务通信 , 并且无须订阅者实时响应地通信 , 此时工作队列模式将是较为适用的 解决方案。它具有解耦子系统、提高伸缩能力和可靠性、支持延迟事件处理、简化异构组件间的集成等优势。图为工作队列模式示意图。
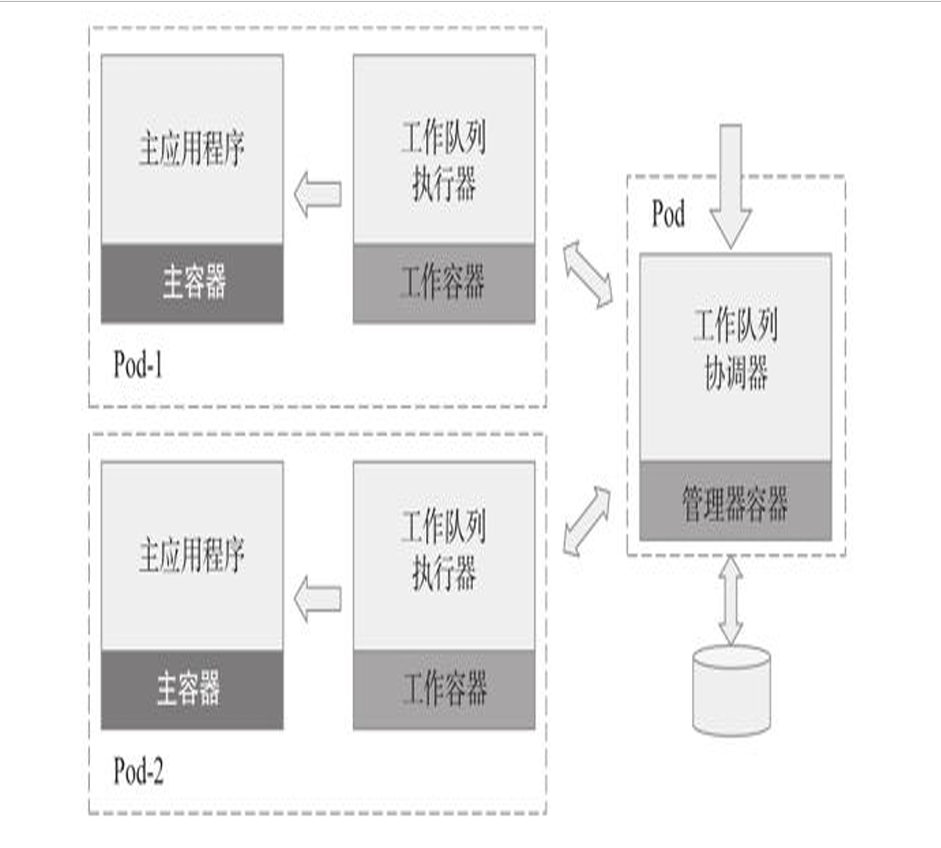
类似领导者选举模式 , 工作队列模式也受益于容器技术。工作队列已被深入研究并且有许多框架进行了实现 , 但这些框架同样受限于 编程语言或存在实现不完整的问题。容器实现的接口支持开发人员便捷地创建出一个通用队列的容器 , 而后创建另一个支持接受输入数据 并将其转换为目标数据格式的容器作为可重用框架容器 , 以便能够让主应用程序轻松使用工作队列。
分散/聚集
分散/聚集模式与工作队列模式非常相似 , 它同样将大型任务拆分 为较小的任务 , 区别是容器会立即将响应返回给用户 , 一个很好的例 子是
MapReduce算法。该模式需要两类组件: 一个称为“根”节点或 “父”节点的组件 , 将来自客户端的请求切分成多个小任务并分散到 多个节点并行计算; 另一类称为“计算”节点或“叶子”节点 , 每个 节点负责运行一部分任务分片并返回结果数据 , “根”节点收集这些 结果数据并聚合为有意义的数据返回给客户端。开发这类分布式系统 需要请求扇出、结果聚合以及与客户端交互等大量的模板代码 , 但大 部分都比较通用。因而要实现该模式 , 我们只需要分别将两类组件各 自构建为容器即可。
1.3 Pod生命周期
Pod对象从创建开始至终止退出之间的时间称为其生命周期 , 这段时间里的某个时间点 , Pod会处于某个特定的运行阶段或相位 (phase ) , 以概括描述其在生命周期中所处的位置。Kubernetes为Pod资源严格定义了5种相位 , 并将特定Pod对象的当前相位存储在其内部的子对象PodStatus的phase字段上 , 因而它总是应该处于其生命程中以下几个相位之一。
Pending:API Server创建了Pod资源对象并已存入etcd中 , 但它尚未被调度完成 , 或仍处于从仓库中下载容器镜像的过程中。Running:Pod已经被调度至某节点 , 所有容器都已经被kubelet创建完成 , 且至少有一个容器处于启动、重启或运行过程中。Succeeded:Pod中的所有容器都已经成功终止且不会再重启。Failed: 所有容器都已经终止 , 但至少有一个容器终止失败 , 即 容器以非0状态码退出或已经被系统终止。Unknown:API Server无法正常获取到Pod对象的状态信息 , 通常 是由于其无法与所在工作节点的kubelet通信所致。
需要注意的是 , 阶段仅是对Pod对象生命周期运行阶段的概括性描述 , 而非Pod或内部容器状态的综合汇总 , 因此Pod对象的status字段 中的状态值未必一定是可用的相位 , 它也有可能是Pod的某个错误状 态 , 例如CrashLoopBackOff或Error等。 Pod资源的核心职责是运行和维护称为主容器的应用程序容器 , 在其整个生命周期之中的多种可选行为也是围绕更好地实现该功能而进行 , 如图所示。其中 , 初始化容器(init container)是常用的 Pod环境初始化方式 , 健康状态检测(startupProbe、livenessProbe和readinessProbe)为编排工具提供了监测容器运行状态的编程接口 , 而事件钩子(preStop和postStart)则赋予了应用容器读取来自编排工具上自定义事件的机制。尽管健康状态检测也可归入较为重要的操作环节 , 但这其中仅创建和运行主容器是必要任务 , 其他都可根据需要在创建Pod对象时按需定义。
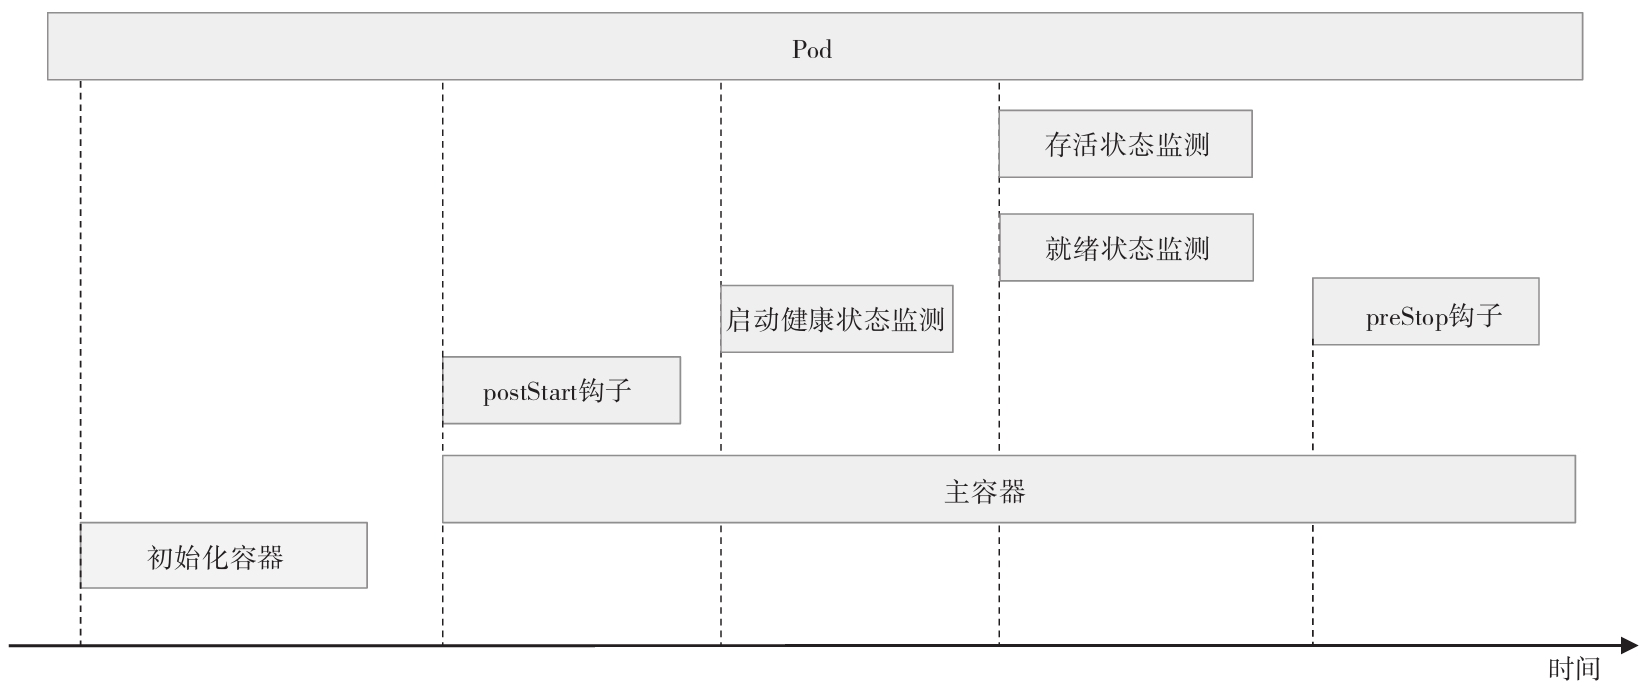
若用户给出了上述全部定义, 则一个Pod对象生命周期的运行步骤 如下。
在启动包括初始化容器在内的任何容器之前先创建
pause基础 容器, 它初始化Pod环境并为后续加入的容器提供共享的名称空间。按顺序以串行方式运行用户定义的各个初始化容器进行
Pod环境初始化; 任何一个初始化容器运行失败都将导致Pod创建失败, 并按其restartPolicy的策略进行处理, 默认为重启。待所有初始化容器成功完成后, 启动应用程序容器, 多容器
Pod环境中, 此步骤会并行启动所有应用容器, 例如主容器和Sidecar容器, 它们各自按其定义展开其生命周期; 本步骤及后面的几个步骤 都将以主容器为例进行说明; 容器启动的那一刻会同时运行主容器上 定义的PostStart钩子事件, 该步骤失败将导致相关容器被重启。运行容器启动健康状态监测(
startupProbe), 判定容器是否启动成功; 该步骤失败, 同样参照restartPolicy定义的策略进行处理; 未定义时, 默认状态为Success。容器启动成功后, 定期进行存活状态监测(
liveness)和就绪状态监测(readiness); 存活状态监测失败将导致容器重启, 而就绪状态监测失败会使得该容器从其所属的Service对象的可用端点列表中 移除。终止Pod对象时, 会先运行
preStop钩子事件, 并在宽限期 (terminationGrace-PeriodSeconds)结束后终止主容器, 宽限期默 认为30秒。
了解 Pod conditions
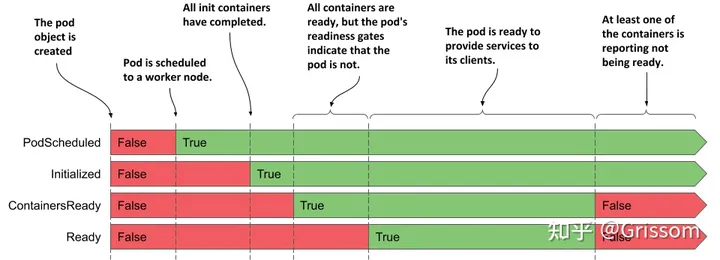
Pod 的条件(conditions)指示 Pod 是否已达到特定状态以及原因。与阶段相反, Pod 同时具有多个条件。
每个条件要么满足, 要么不满足。 如下图所示, PodScheduled 和 Initialized 条件一开始未满足, 但很快就满足, 并且在 Pod 的整个生命周期中保持这种状态。 相比之下, Ready 和 ContainersReady 条件在 Pod 的生命周期内可能会发生多次变化。
了解容器状态(Status)
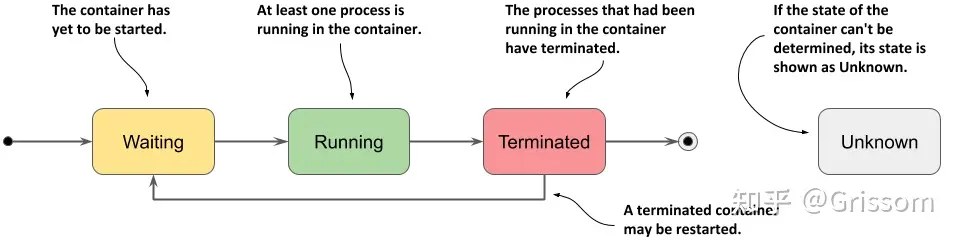
容器状态包含几个字段。 state 字段指示容器的当前状态, 而 lastState 字段显示前一个容器终止后的状态。 容器状态还指示容器的内部ID(containerID)、容器正在运行的镜像和imageID、容器是否准备好以及重新启动的频率()restartCount)。
容器状态最重要的部分是它的状态。 容器可以处于下图所示的状态之一。
2. 在pod中运行应用
Pod资源中可同时存在初始化容器、应用容器和临时容器3种类型的容 器, 不过创建并运行一个具体的Pod对象时, 仅有应用容器是必选项, 并且 可以仅为其定义单个容器。本节重点说明如何在Pod中简单使用应用容器。
2.1 使用单容器Pod资源
我们知道, 一个Pod对象的核心职责在于以主容器形式运行单个应用 , 因而定义API资源的关键配置就在于定义该容器, 它以对象形式定义在Pod对象的spec.containers字段中 , 配置清单的基本格式如下:
apiVersion: v1
kind: Pod
metadata:
  name: …               # Pod的标识名, 在名称空间中必须唯一
  namespace: …          # 该Pod所属的名称空间, 省略时使用默认名称空间, 例如
default
spec:
  containers:           # 定义容器, 它是一个列表对象, 可包括多个容器的定义,
至少得有一个
  - name: …             # 容器名称, 必选字段, 在当前Pod中必须唯一
    image: …            # 创建容器时使用的镜像
imagePullPolicy: … # 容器镜像下载策略, 可选字段image虽为可选字段, 这只是为方便更高级别的管理类资源(例如 Deployment等)能覆盖它以实现某种高级管理功能而设置, 对于非控制器管理的自主式Pod(或称为裸Pod)来说并不能省略该字段。下面是一个Pod资源清单示例文件 , 它仅指定了运行一个由ikubernetes/demoapp:v1.0 镜像启动的主容器demo , 该Pod对象位于default名称空间。
apiVersion: v1
kind: Pod
metadata:
  name: pod-demo
  namespace: default
spec:
  containers:
  - name: demo
    image: ikubernetes/demoapp:v1.0
    imagePullPolicy: IfNotPresent
把上面的内容保存于配置文件中, 例如pod-demo.yaml, 随后即可使用 kubectl apply或kubectl create命令进行资源对象创建, 下面是相应的命令及响应结果。
root@kubeadm-master1:~# kubectl apply -f pod-demo.yaml
pod/pod-demo created该Pod对象由调度器绑定至特定工作节点后, 由相应的kubelet负责创建和维护, 实时状态也将同步给API Server并由其存储至etcd中。Pod创建并尝试启动的过程中, 可能会经历Pending、ContainerCreating、Running等多种不同的状态, 若Pod可正常启动, 则kubectl get pods/POD命令输出字 段中的状态(STATUS)则显示为Running, 如下面的命令及结果所示, 使用 默认的名称空间时, 其中的-n选项及参数default可以省略。
root@kubeadm-master1:~# kubectl get pods/pod-demo -n default
NAME       READY   STATUS    RESTARTS   AGE
pod-demo 1/1 Running 0 2m37s随后即可对Pod中运行着的主容器的服务发起访问请求。镜像demoapp默认运行了一个Web服务程序, 该服务监听TCP协议的80端口, 镜像可通过 “/”、/hostname、/user-agent、/livez、/readyz和/configs等路径服务于客户端的请求。例如, 下面的命令先获取到Pod的IP地址, 而后对其支持 的Web资源路径/和/user-agent分别发出了一个访问请求:
root@kubeadm-master1:~# kubectl get pods/pod-demo -o jsonpath={.status.podIP}
10.10.6.79root@kubeadm-master1:~#
root@kubeadm-master1:~# demoIP=$(kubectl get pods/pod-demo -o jsonpath={.status.podIP})
root@kubeadm-master1:~# curl -s http://$demoIP
iKubernetes demoapp v1.0 !! ClientIP: 10.10.0.0, ServerName: pod-demo, ServerIP: 10.10.6.79!
root@kubeadm-master1:~# curl -s http://$demoIP/user-agent
User-Agent: curl/7.81.0Kubernetes系统支持用户自定义容器镜像文件的获取策略, 例如在网络资源较为紧张时可以禁止从仓库中获取镜像文件, 或者不允许使用工作节点 本地镜像等。容器的imagePullPolicy字段用于为其指定镜像获取策略, 它的可用值包括如下几个。
Always: 每次启动Pod时都要从指定的仓库下载镜像。IfNotPresent: 仅本地镜像缺失时方才从目标仓库wp下载镜像。Never: 禁止从仓库下载镜像, 仅使用本地镜像。
对于标签为latest的镜像文件, 其默认的镜像获取策略为Always, 其他标签的镜像, 默认策略则为IfNotPresent。需要注意的是, 从私有仓库中下载镜像时通常需要事先到Registry服务器认证后才能进行。认证过程要么需要在相关节点上交互式执行docker login命令, 要么将认证信息定义为专有的Secret资源, 并配置Pod通过imagePullSecretes字段调用此认证信息完 成。
删除Pod对象则使用kubectl delete命令。
命令式命令:
kubectl delete pods/NAME。命令式对象配置:
kubectl delete -f FILENAME。
若删除后Pod一直处于Terminating状态, 则可再一次执行删除命令, 并 同时使用--force和--grace-period=0选项进行强制删除。
2.2 获取Pod与容器状态详情
资源创建或运行过程中偶尔会因故出现异常, 此时用户需要充分获取相 关的状态及配置信息以便确定问题所在。另外, 在对资源对象进行创建或修改完成后, 也需要通过其详细的状态信息来了解操作成功与否。kubectl有 多个子命令, 用于从不同角度显示对象的状态信息, 这些信息有助于用户了 解对象的运行状态、属性详情等。
kubectl describe: 显示资源的详情, 包括运行状态、事件等信息, 但不同的资源类型输出内容不尽相同。kubectl logs: 查看Pod对象中容器输出到控制台的日志信息 ; 当Pod中运行有多个容器时, 需要使用选项-c指定容器名称。kubectl exec: 在Pod对象某容器内运行指定的程序, 其功能类似于docker exec命令, 可用于了解容器各方面的相关信息或执行必需的设定操 作等, 具体功能取决于容器内可用的程序。 下面通过具体的示例来说明这3个命令的使用方式及命令结果中重要字段的意义。
2.2.1 打印Pod对象的状态
kubectl describe pods/NAME -n NAMESPACE命令可打印Pod对象的详细描述信息 , 包括events和controllers等关系的子对象等 , 它会输出许多字段 , 不同的需求场景中 , 用户可能会关注不同维度的输出 , 但Priority、 Status、Containers和Events等字段通常是重点关注的目标字段 , 各级别的多数输出字段基本都可以见名知义。
另外 , 也可以通过kubectl get pods/POD -o yaml|json命令的status 字段来了解Pod的状态详情 , 它保存有Pod对象的当前状态。如下命令显示了 pod-demo的状态信息 , 结果输出做了尽可能的省略。
root@kubeadm-master1:~# kubectl get pods/pod-demo -o yaml
apiVersion: v1
kind: Pod
metadata:
  annotations:
    kubectl.kubernetes.io/last-applied-configuration: |
      {"apiVersion":"v1","kind":"Pod","metadata":{"annotations":{},"name":"pod-demo","namespace":"default"},"spec":{"containers":[{"image":"ikubernetes/demoapp:v1.0","imagePullPolicy":"IfNotPresent","name":"demo"}]}}
  creationTimestamp: "2024-05-10T03:52:31Z"
  name: pod-demo
  namespace: default
  resourceVersion: "485275"
  uid: db41f5dc-3938-4cef-8559-45f9cb735e04
spec:
  containers:
  - image: ikubernetes/demoapp:v1.0
    imagePullPolicy: IfNotPresent
....
  containerStatuses:        # 容器级别的状态信息
  - containerID: docker://8e69465d07bdebd61186a87e06a90fe79e679fa463d87209790aacaa2943b38c
    image: ikubernetes/demoapp:v1.0
    imageID: docker-pullable://ikubernetes/demoapp@sha256:6698b205eb18fb0171398927f3a35fe27676c6bf5757ef57a35a4b055badf2c3
    lastState: {}           # 前一次的状态
    name: demo
    ready: true             #是否已经就绪
    restartCount: 0         # 重启次数
    started: true
    state:                  # 当前状态
      running:
        startedAt: "2024-05-10T03:52:34Z"     # 启动时间
  hostIP: 192.168.71.37     # 节点IP
  hostIPs:
  - ip: 192.168.71.37
  phase: Running           # Pod当前的相位
  podIP: 10.10.6.79         # Pod的主IP地址
  podIPs:                   # Pod上的所有IP地址
  - ip: 10.10.6.79
  qosClass: BestEffort       # QoS类别
上面的命令结果中 , conditions字段是一个称为PodConditions的数组 , 它记录了Pod所处的“境况”或者“条件” , 其中的每个数组元素都可能由如下6个字段组成。
lastProbeTime: 上次进行Pod探测时的时间戳。lastTransitionTime:Pod上次发生状态转换的时间戳。message: 上次状态转换相关的易读格式信息。reason: 上次状态转换原因 , 用驼峰格式的单个单词表示。status: 是否为状态信息 , 可取值有True、False和Unknown。type: 境况的类型或名称 , 有4个固定值 ;PodScheduled表示已经与节点绑定 ;Ready表示已经就绪 , 可服务客户端请求 ;Initialized表示所有的初始化容器都已经成功启动 ;ContainersReady则表示所有容器均已就绪。
另外 , containerStatuses字段描述了Pod中各容器的相关状态信息 , 包括容器ID、镜像和镜像ID、上一次的状态、名称、启动与否、就绪与否、重 启次数和状态等。随着系统的运行 , 该Pod对象的状态可能会因各种原因发生变动 , 例如程序自身bug导致的故障、工作节点资源耗尽引起的驱逐等 , 用户可根据需要随时请求查看这些信息 , 甚至将其纳入监控系统中进行实时 监控和告警。
2.2.2 查看容器日志
规范化组织的应用容器一般仅运行单个应用程序 , 其日志信息均通过标 准输出和标准错误输出直接打印至控制台 , kubectl logs POD [-c CONTAINER]命令可直接获取并打印这些日志 , 不过 , 若Pod对象中仅运行有 一个容器 , 则可以省略-c选项及容器名称。例如 , 下面的命令打印了pod demo中唯一的主容器的控制台日志:
root@kubeadm-master1:~# kubectl logs pod-demo
 * Running on http://0.0.0.0:80/ (Press CTRL+C to quit)
10.10.0.0 - - [10/May/2024 03:58:41] "GET / HTTP/1.1" 200 -
10.10.0.0 - - [10/May/2024 03:58:53] "GET /user-agent HTTP/1.1" 200 -
需要注意的是 , 日志查看命令仅能用于打印存在于Kubernetes系统上的 Pod中容器的日志 , 对于已经删除的Pod对象 , 其容器日志信息将无从获取。 日志信息是用于辅助用户获取容器中应用程序运行状态的最有效途径之一 , 也是重要的排错手段 , 因此通常要使用集中式的日志服务器统一收集存储各 Pod对象中容器的日志信息。
2.2.3 在容器中额外运行其他程序
运行着非交互式进程的容器中缺省运行的唯一进程及其子进程启动后 , 容器即进入独立、隔离的运行状态。对容器内各种详情的了解需要穿透容器 边界进入其中运行其他应用程序进行 , kubectl exec可以让用户在Pod的某 容器中运行用户所需要的任何存在于容器中的程序。在kubectl logs获取的信息不够全面时 , 此命令可以通过在Pod中运行其他指定的命令(前提是容 器中存在此程序)来辅助用户获取更多信息。一个更便捷的使用接口是直接交互式运行容器中的某shell程序。例如 , 直接查看Pod中的容器运行的进程
~$ kubectl exec pod-demo -- ps aux
PID   USER     TIME  COMMAND
1     root      0:01 python3 /usr/local/bin/demo.py
8     root      0:00 ps aux
注意 : 如果
Pod对象中运行时有多个容器 , 运行程序时还需要使用-c选项指定运行程序的容器名称。
有时候需要打开容器的交互式shell接口以方便多次执行命令 , 为 kubectl exec命令额外使用-it选项 , 并指定运行镜像中可用的shell程序就能进入交互式接口。如下示例中 , 命令后的斜体部分表示在容器的交互式接口中执行的命令。
root@kubeadm-master1:~# kubectl exec pod-demo -it /bin/sh
kubectl exec [POD] [COMMAND] is DEPRECATED and will be removed in a future version. Use kubectl exec [POD] -- [COMMAND] instead.
[root@pod-demo /]# exit
root@kubeadm-master1:~# kubectl exec pod-demo -it -- /bin/sh
[root@pod-demo /]# hostname
pod-demo
[root@pod-demo /]# netstat -tnl
Active Internet connections (only servers)
Proto Recv-Q Send-Q Local Address           Foreign Address         State
tcp 0 0 0.0.0.0:80 0.0.0.0:* LISTEN 上述3个命令输出的信息对于了解应用运行状态 , 以及获取资源详细信 息进行故障排除等有着非常重要的提示作用 , 因而也是Kubernetes用户最为常用命令。
2.3 自定义容器应用与参数
容器镜像启动容器时运行的默认应用程序由其Dockerfile文件中的 ENTRYPOINT指令进行定义 , 传递给程序的参数则通过CMD指令设定 , ETRYPOINT指令不存在时 , CMD可同时指定程序及其参数。例如 , 要了解镜像 ikubernetes/demoapp:v1.0中定义的ENTRYPOINT和CMD , 可以在任何存在此 镜像的节点上执行类似如下命令来获取 :
root@node03:~# docker inspect ikubernetes/demoapp:v1.0 -f {{.Config.Entrypoint}}
[/bin/sh -c python3 /usr/local/bin/demo.py]
root@node03:~# docker inspect ikubernetes/demoapp:v1.0 -f {{.Config.Cmd}}
[]Pod配置中 , spec.containers[].command字段可在容器上指定非镜像默认运行的应用程序 , 且可同时使用spec.containers[].args字段进行参数传递 , 它们将覆盖镜像中默认定义的参数。若定义了args字段 , 该字段值将作为参数传递给镜像中默认指定运行的应用程序 ; 而仅定义了command字段 时 , 其值将覆盖镜像中定义的程序及参数。下面的资源配置清单保存在pod demo-with-cmd-and-args.yaml文件中 , 它把镜像 ikubernetes/demoapp:v1.0的默认应用程序修改为/bin/sh -c , 参数定义为 python3 /usr/local/bin/demo.py -p 8080 , 其中的-p选项可修改服务监听的端口为指定的自定义端口。
apiVersion: v1
kind: Pod
metadata:
  name: pod-demo-with-cmd-and-args
  namespace: default
spec:
  containers:
  - name: demo
    image: ikubernetes/demoapp:v1.0
    imagePullPolicy: IfNotPresent
    command: ['/bin/sh','-c']
args: ['python3 /usr/local/bin/demo.py -p 8080']下面将上述清单中定义的Pod对象创建到集群上 , 验证其监听的端口是否从默认的80变为了指定的8080 :
root@kubeadm-master1:~# kubectl create -f pod-demo-with-cmd-and-args.yaml
pod/pod-demo-with-cmd-and-args created
root@kubeadm-master1:~# kubectl exec  pod-demo-with-cmd-and-args -- netstat -tnl
Active Internet connections (only servers)
Proto Recv-Q Send-Q Local Address           Foreign Address         State
tcp 0 0 0.0.0.0:8080 0.0.0.0:* LISTEN 自定义args参数 , 也是向容器中应用程序传递配置信息的常用方式之一 , 对于非云原生的应用程序 , 这几乎是最简单的配置方式了。另一个常用 配置方式是使用环境变量。
2.4 容器环境变量
非容器化的传统管理方式中 , 复杂应用程序的配置信息多数由配置文件进行指定 , 用户借助简单的文本编辑器完成配置管理。然而 , 对于容器隔离出的环境中的应用程序 , 用户就不得不穿透容器边界在容器内进行配置编辑并进行重载 , 复杂且低效。于是 , 由环境变量在容器启动时传递配置信息就 成了一种受到青睐的方式。
注意: 这种方式需要应用程序支持通过环境变量进行配置 , 否则用户要在制作
Docker镜像时通过entrypoint脚本完成环境变量到程序配置文件的同步。
向Pod对象中容器环境变量传递数据的方法有两种 : env和envFrom , 这 里重点介绍第一种方式 , 第二种方式将在介绍ConfigMap和Secret资源时进行说明。
通过环境变量的配置容器化应用时 , 需要在容器配置段中嵌套使用env 字段 , 它的值是一个由环境变量构成的列表。每个环境变量通常由name和 value字段构成。
name: 环境变量的名称 , 必选字段。value: 传递给环境变量的值 , 通过$(VAR_NAME)引用 , 逃 逸格式为$$(VAR_NAME)默认值为空。
示例中使用镜像demoapp中的应用服务器支持通过HOST与PORT环境变量 分别获取监听的地址和端口 , 它们的默认值分别为0.0.0.0和80 , 下面的配置保存在清单文件pod-using-env.yaml中 , 它分别为HOST和PORT两个环境变量传递了一个不同的值 , 以改变容器监听的地址和端口。
apiVersion: v1
kind: Pod
metadata:
  name: pod-using-env
  namespace: default
spec:
  containers:
  - name: demo
    image: ikubernetes/demoapp:v1.0
    imagePullPolicy: IfNotPresent
    env:
    - name: HOST
      value: "127.0.0.1"
    - name: PORT
value: "8080"下面将清单文件中定义的Pod对象创建至集群中 , 并查看应用程序监听 的地址和端口来验证配置结果:
root@kubeadm-master1:~# kubectl apply -f pod-using-env.yaml
pod/pod-using-env created
root@kubeadm-master1:~# kubectl exec pod-using-env -- netstat -tnl
Active Internet connections (only servers)
Proto Recv-Q Send-Q Local Address           Foreign Address         State
tcp        0      0 127.0.0.1:8080          0.0.0.0:*               LISTEN
无论它们是否真正被用到 , 传递给容器的环境变量都会直接注入容器的 shell环境中 , 使用printenv一类的命令就能在容器中获取到所有环境变量的列表。
root@kubeadm-master1:~# kubectl exec pod-using-env -- printenv
PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin
HOSTNAME=pod-using-env
PORT=8080
HOST=127.0.0.1
KUBERNETES_SERVICE_PORT=443
TEST_PORT=tcp://10.20.142.253:80
TEST11_PORT_82_TCP_ADDR=10.20.154.8
TEST_SERVICE_PORT=80
TEST111_PORT=tcp://10.20.116.111:81
TEST_PORT_80_TCP=tcp://10.20.142.253:80
TEST_PORT_80_TCP_ADDR=10.20.142.253
TEST11_PORT_82_TCP_PROTO=tcp
KUBERNETES_PORT=tcp://10.20.0.1:443
KUBERNETES_PORT_443_TCP=tcp://10.20.0.1:443
TEST_SERVICE_HOST=10.20.142.253
TEST111_PORT_81_TCP_ADDR=10.20.116.111
TEST11_PORT=tcp://10.20.154.8:82
TEST111_PORT_81_TCP_PROTO=tcp
TEST11_SERVICE_PORT=82
KUBERNETES_PORT_443_TCP_PROTO=tcp
KUBERNETES_PORT_443_TCP_ADDR=10.20.0.1
TEST111_PORT_81_TCP=tcp://10.20.116.111:81
TEST111_SERVICE_HOST=10.20.116.111
TEST111_PORT_81_TCP_PORT=81
KUBERNETES_SERVICE_PORT_HTTPS=443
TEST_PORT_80_TCP_PORT=80
TEST11_PORT_82_TCP=tcp://10.20.154.8:82
TEST111_SERVICE_PORT=81
TEST11_SERVICE_HOST=10.20.154.8
TEST11_PORT_82_TCP_PORT=82
KUBERNETES_SERVICE_HOST=10.20.0.1
KUBERNETES_PORT_443_TCP_PORT=443
TEST_PORT_80_TCP_PROTO=tcp
DEPLOYENV=Production
RELEASE=Stable
PS1=[\u@\h \w]\$
HOME=/root
2.5 Pod的创建与删除过程
Pod是Kubernetes的基础单元 , 理解它的创建过程对于了解系统运作大 有裨益。图中描述了一个Pod资源对象的典型创建过程。
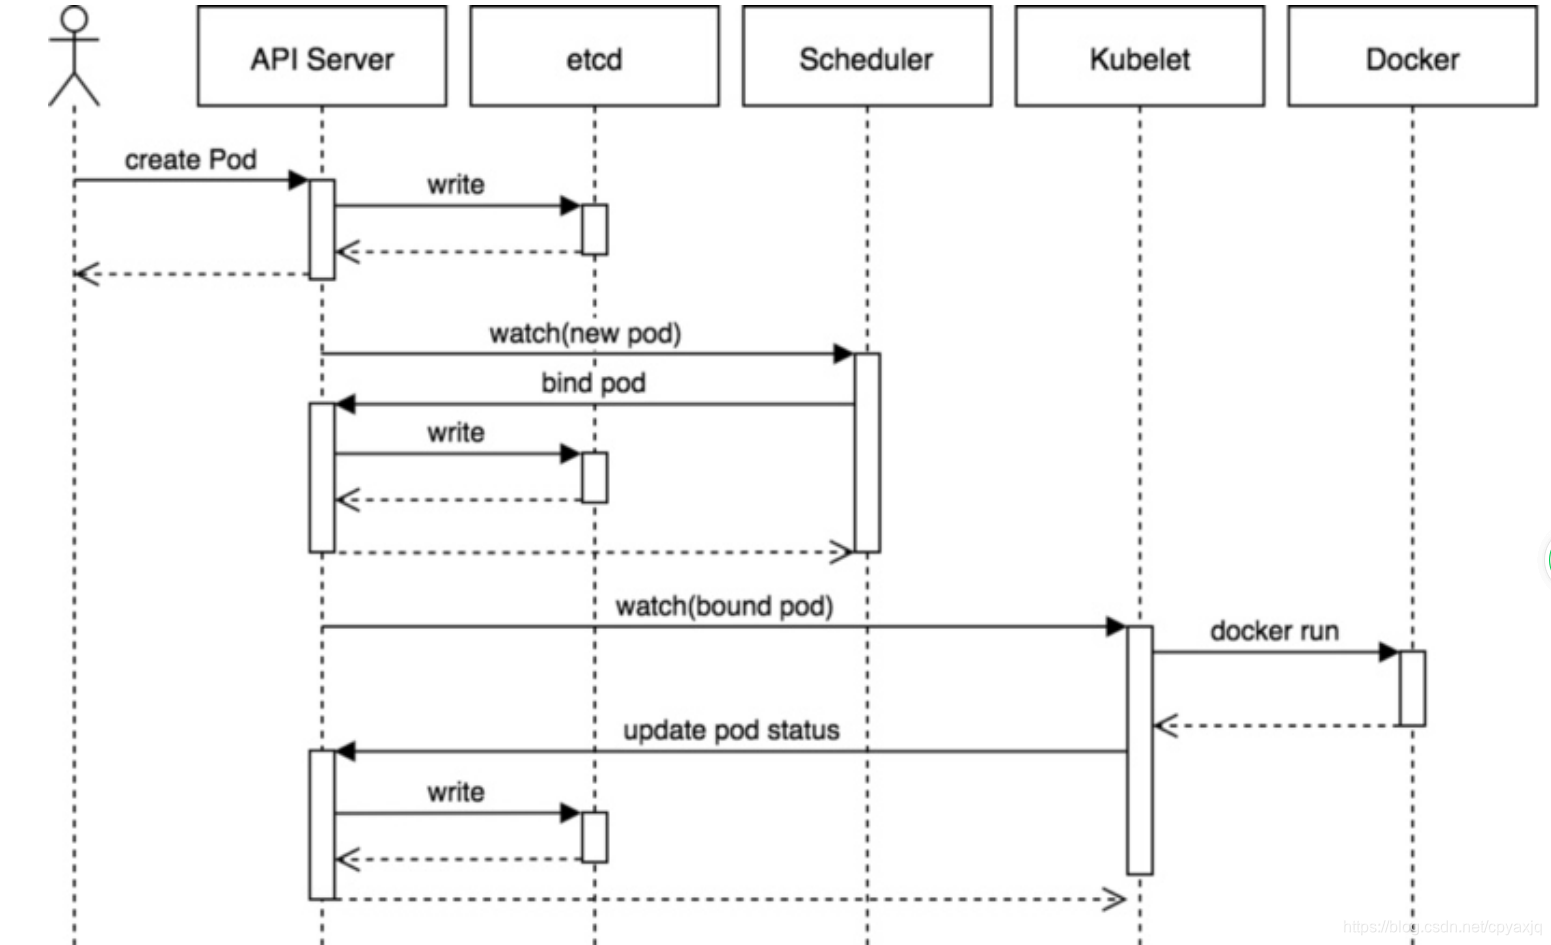
用户通过
kubectl或其他API客户端提交Pod Spec给API Server。API Server尝试着将Pod对象的相关信息存入etcd中 , 待写入操作执行完成 ,API Server即会返回确认信息至客户端。Scheduler(调度器)通过其watcher监测到API Server创建了新的Pod对象 , 于是为该Pod对象挑选一个工作节点并将结果信息更新至API Server。调度结果信息由
API Server更新至etcd存储系统 , 并同步给Scheduler。相应节点的
kubelet监测到由调度器绑定于本节点的Pod后会读取其 配置信息 , 并由本地容器运行时创建相应的容器启动Pod对象后将结果回存 至API Server。API Server将kubelet发来的Pod状态信息存入etcd系统 , 并将确认信息发送至相应的kubelet。
另一方面 , Pod可能曾用于处理生产数据或向用户提供服务等 , Kubernetes可删除宽限期确保终止操作能够以平滑方式优雅完成 , 从而用户也可以在正常提交删除操作后获知何时开始终止并最终完成。删除时 , 用户提交请求后系统即会进行强制删除操作的宽限期倒计时 , 并将TERM信号发送给Pod对象中每个容器的主进程。宽限期倒计时结束后 , 这些进程将收到强制终止的KILL信号 , Pod对象也随即由API Server删除。如果在等待进程终止的过程中kubelet或容器管理器发生了重启 , 则终止操作会重新获得一个满额的删除宽限期并重新执行删除操作。
Pod的终止过程如图所示。
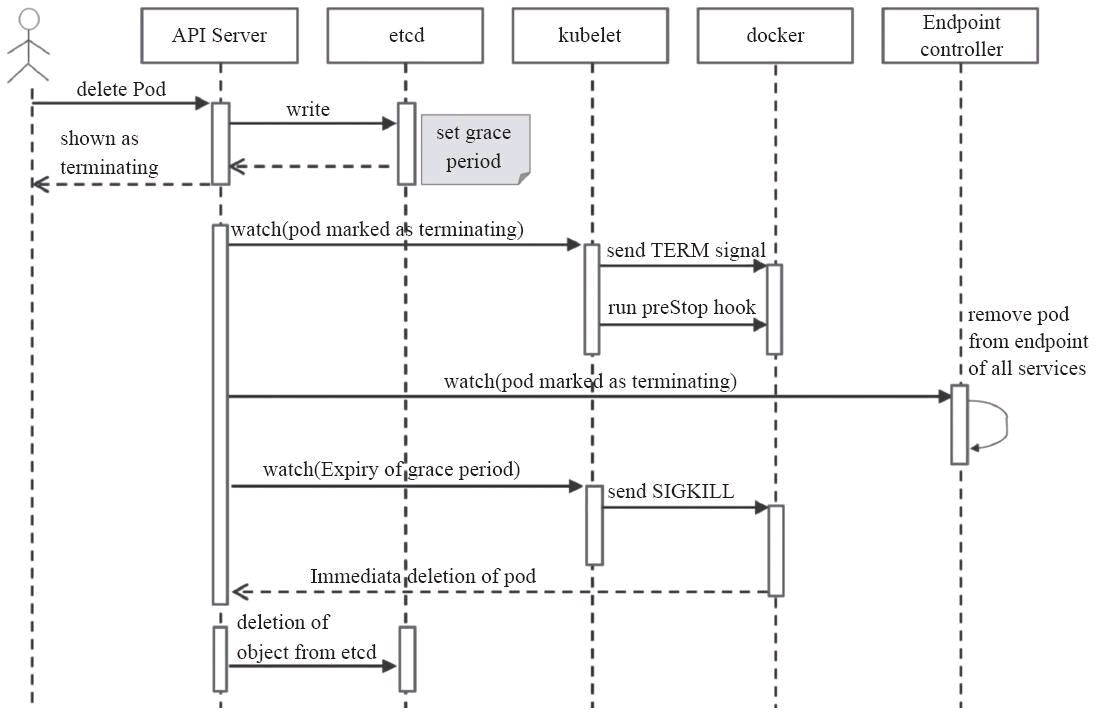
一个典型的Pod对象终止流程如下 :
用户发送删除
Pod对象的命令。API服务器中的Pod对象会随着时间的推移而更新 , 在宽限期内(默认为30秒) ,Pod被视为dead。将
Pod标记为Terminating状态。(与第3步同时运行)
kubelet在监控到Pod对象转为Terminating状态的同时启动Pod关闭过程。(与第3步同时运行)端点控制器监控到
Pod对象的关闭行为时将其从所有匹配到此端点的Service资源的端点列表中移除。如果当前
Pod对象定义了preStop钩子句柄 , 在其标记为terminating后即会以同步方式启动执行 ; 如若宽限期结束后 ,preStop仍未执行完 , 则重新执行第2步并额外获取一个时长为2秒的小宽限期。Pod对象中的容器进程收到TERM信号。宽限期结束后 , 若存在任何一个仍在运行的进程 ,
Pod对象即会收到SIGKILL信号。Kubelet请求API Server将此Pod资源的宽限期设置为0从而完成删除操作 , 它变得对用户不再可见。
默认情况下 , 所有删除操作的宽限期都是30秒 , 不过kubectl delete命令可以使用--grace-period=选项自定义其时长 , 使用0值则表示直接强制删除指定的资源 , 不过此时需要同时为命令使用--force选项。
3. 暴露容器服务
Pod对象的IP地址仅在集群内可达 , 它们无法直接接收来自集群外部客户端的请求流量 , 尽管它们的服务可达性不受工作节点边界的约束 , 但依然受制于集群边界。不考虑通过Service资源进行服务暴露的情况下 , 服务于集群外部的客户端的常用方式有两种 : 一种是在其运 行的节点上进行端口映射 , 由节点IP和选定的协议端口向Pod内的应用容器进行DNAT转发; 另一种是让Pod共享其所在的工作节点的网络名称空间 , 应用进程将直接监听工作节点IP地址和协议端口。
3.1 其他容器端口映射
其他Kubernetes系统的网络模型中 , 各Pod的IP地址处于同一网络 平面 , 无论是否为容器指定了要暴露的端口都不会影响集群中其他节 点之上的Pod客户端对其进行访问 , 这意味着 , 任何在非本地回环接口 lo上监听的端口都可直接通过Pod网络被请求。从这个角度来说 , 容器端口只是信息性数据 , 它仅为集群用户提供了一个快速了解相关Pod对象的可访问端口的途径 , 但显式指定容器的服务端口可额外为其赋予一个名称以方便按名称调用。定义容器端口的ports字段的值是一个列表 , 由一到多个端口对象组成 , 它的常用嵌套字段有如下几个。
containerPort: 必选字段 , 指定在Pod对象的IP地址 上暴露的容器端口 , 有效范围为(0,65536) ; 使用时 , 需要指定为容器应用程序需要监听的端口。name: 当前端口的名称标识 , 必须符合IANA_SVC_NAME规范且在当前Pod内要具有唯一性 ; 此端口名可被Service资源按名调用。protocol: 端口相关的协议 , 其值仅支持TCP、SCTP或UDP三者之一 , 默认为TCP。
需要借助于Pod所在节点将容器服务暴露至集群外部时 , 还需要使 用hostIP与hostPort两个字段来指定占用的工作节点地址和端口。如 图4-11所示的Pod A与Pod C可分别通过各自所在节点上指定的hostIP 和hostPort服务于客户端请求。
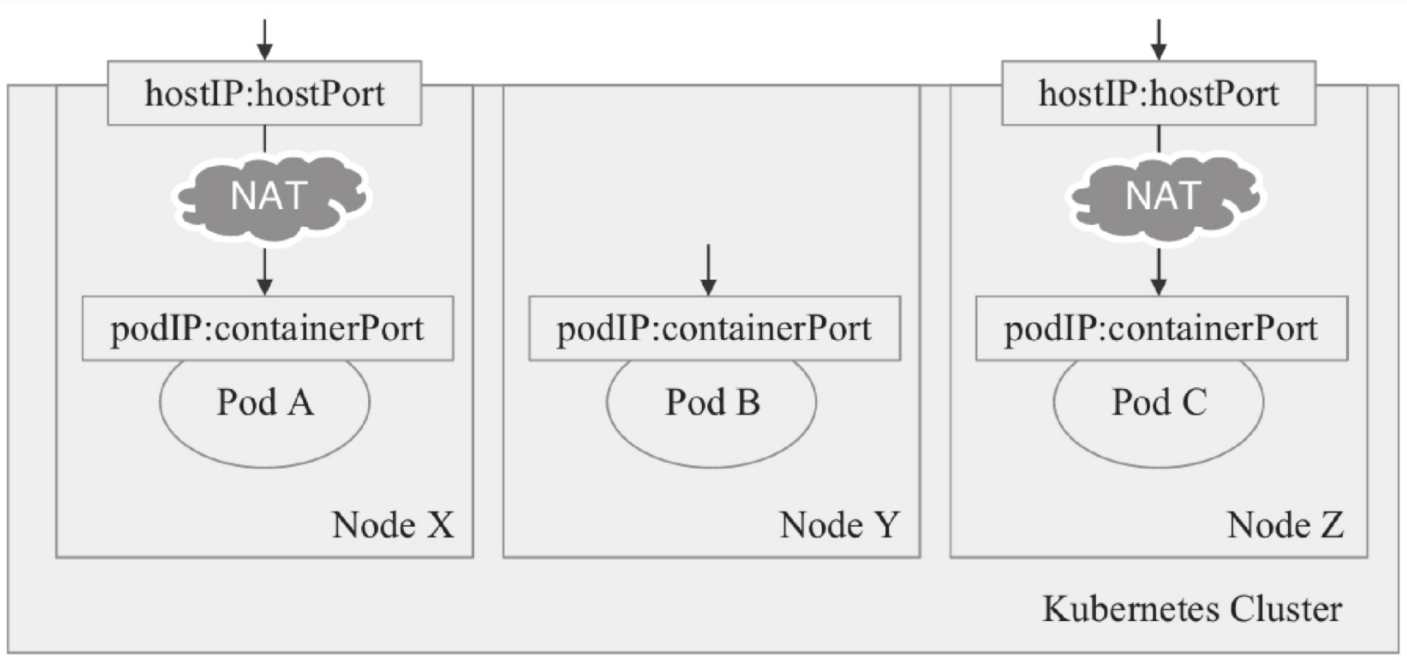
hostPort: 主机端口 , 它将接收到的请求通过NAT机制转发至由container-Port字段指定的容器端口。hostIP: 主机端口要绑定的主机IP, 默认为主机之上 所有可用的IP地址 ; 该字段通常使用默认值。
下面的资源配置清单示例(pod-using-hostport.yaml)中定义的 demo容器指定了要暴露容器上TCP协议的80端口 , 并将之命名为http , 该容器可通过工作节点的10080端口接入集群外部客户端的请求。
apiVersion: v1
kind: Pod
metadata:
  name: pod-using-hostport
  namespace: default
spec:
  containers:
  - name: demo
    image: ikubernetes/demoapp:v1.0
    imagePullPolicy: IfNotPresent
    ports:
    - name: http
      containerPort: 80
      protocol: TCP
hostPort: 10080在集群中创建配置清单中定义的Pod对象后 , 需获取其被调度至的目标节点 , 例如下面第二个命令结果中的k8s -node02.ilinux.io/172.29.9.12 , 而后从集群外部向该节点的10080端 口发起Web请求进行访问测试
root@kubeadm-master1:~# kubectl apply -f pod-using-hostport.yaml
pod/pod-using-hostport created
root@kubeadm-master1:~# kubectl describe pods/pod-using-hostport
Name:             pod-using-hostport
Namespace:        default
Priority:         0
Service Account:  default
Node:             node01.cbear.top/192.168.71.35
Start Time:       Fri, 10 May 2024 08:10:18 +0000
Labels:           <none>
Annotations:      <none>
Status:           Running
IP:               10.10.8.36
IPs:
  IP:  10.10.8.36
Containers:
  demo:
    Container ID:   docker://2a2e3d4594d8bbfb0eb3686ffb54a628d318513478caf1bc6a094d24fe197b9f
    Image:          ikubernetes/demoapp:v1.0
    Image ID:       docker-pullable://ikubernetes/demoapp@sha256:6698b205eb18fb0171398927f3a35fe27676c6bf5757ef57a35a4b055badf2c3
    Port:           80/TCP
    Host Port:      10080/TCP
    State:          Running
      Started:      Fri, 10 May 2024 08:10:20 +0000
    Ready:          True
    Restart Count:  0
    Environment:    <none>
    Mounts:
      /var/run/secrets/kubernetes.io/serviceaccount from kube-api-access-4w72p (ro)

C:\Users\xiong>curl 192.168.71.35:10080
iKubernetes demoapp v1.0 !! ClientIP: 192.168.71.41, ServerName: pod-using-hostport, ServerIP: 10.10.8.36!
注意 , hostPort与NodePort类型的Service对象暴露端口的方式不 同 , NodePort是通过所有节点暴露容器服务 , 而hostPort则能经由Pod 对象所在节点的IP地址进行。但Pod对象绑定的工作节点都由调度器根据其调度机制确定 , 除非人为地指示调度器将其绑定到指定的工作节 点 , 否则多数情况下其目标节点都难以预测。
3.2 配置Pod使用节点网络
同一个Pod对象的各容器运行于一个独立、隔离的Network、UTS和 IPC名称空间中 , 共享同一个网络协议栈及相关的网络设备 , 但也有些特殊的Pod对象需要运行于所在节点的名称空间中 , 执行系统级的管理任务(例如查看和操作节点的网络资源甚至是网络设备等) , 或借助 节点网络资源向集群外客户端提供服务等 , 如图中的右图所示。
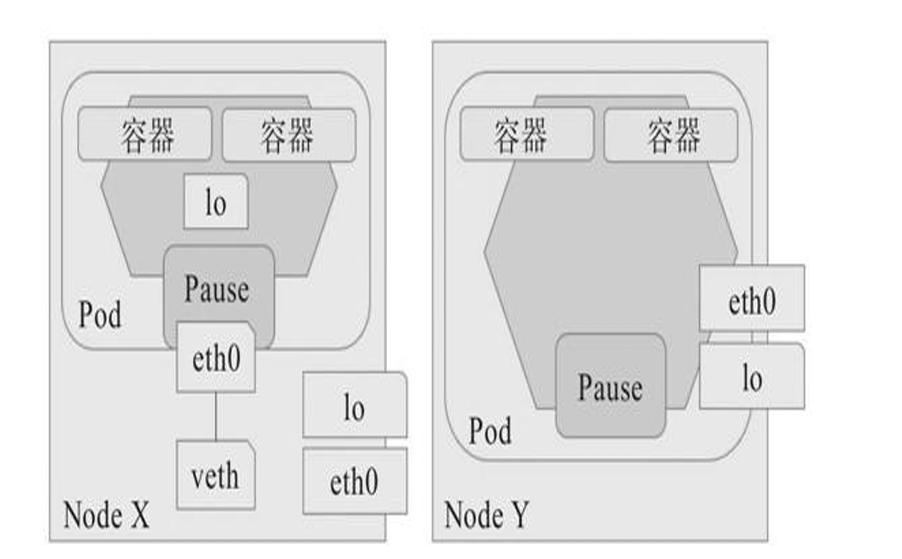
由kubeadm部署的Kubernetes集群中的kube-apiserver、kube-controller-manager、kube-scheduler , 以及kube-proxy和kube-flannel等通常都是第二种类型的Pod对象。网络名称空间是Pod级别的属性 , 用户配置的Pod对象 , 仅需要设置其spec.hostNetwork的属性为 true即可创建共享节点网络名称空间的Pod对象 , 如下面保存在pod using-hostnetwork.yaml文件中的配置清单所示。
apiVersion: v1
kind: Pod
metadata:
  name: pod-using-hostnetwork
  namespace: default
spec:
  containers:
  - name: demo
    image: ikubernetes/demoapp:v1.0
    imagePullPolicy: IfNotPresent
hostNetwork: true将上面配置清单中定义的pod-using-hostnetwork创建于集群上 , 并查看主机名称或网络接口的相关属性信息以验证它是否能共享使用 工作节点的网络名称空间。
root@kubeadm-master1:~# kubectl exec pod-using-hostnetwork -- hostname
node03.cbear.top
上面第二个命令的结果显示出的主机名称 , 表示该Pod已然共享了 其所在节点的UTS名称空间 , 以及Network和IPC名称空间。这意味着 , Pod对象中运行容器化应用可在其所在的工作节点的IP地址之上监听 , 这可以通过直接向node03.cbear.top节点发起请求来验证。
root@kubeadm-master1:~# curl node03.cbear.top
iKubernetes demoapp v1.0 !! ClientIP: 192.168.71.29, ServerName: node03.cbear.top, ServerIP: 192.168.71.37!
与容器端口映射存在的同样问题是, 用户无法事先预知Pod对象会调度至哪个节点 , 除非事先指示调度器将Pod绑定至固定的目标节点之上
4. 容器应用的管理接口
以镜像格式打包并托管运行于编排系统之上的容器就像是一个黑盒子 , 但任何为运行于 云原生环境而开发的应用程序都应该为运行时环境提供监测自身运行状态的API , 并支持通 过生命周期管理API接收平台的管理事件 , 这是以统一方式自动化容器更新及生命周期的基 本要求和先决条件。
4.1 健康状态监测接口
监测容器自身运行的API包括分别用于健康状态检测、指标、分布式跟踪和日志等实现类型 , 如图4-13所示。即便没有完全实现 , 至少容器化应用也应该提供用于健康状态检测 (liveness和readiness)的API , 以便编排系统能更准确地判定应用程序的运行状态。
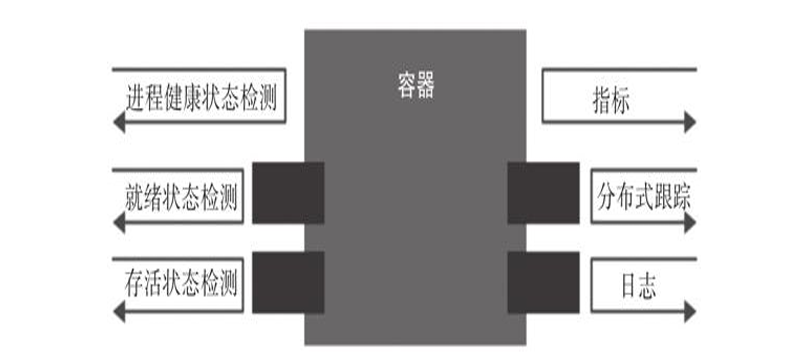
Kubelet仅能在控制循环中根据容器主进程的运行状态来判断其健康与否 , 主进程以非0 状态码退出代表处于不健康状态 , 其他均为正常状态。然而 , 有些异常场景中 , 仍处于运行状态的进程内部的业务处理机制可能已然处于僵死状态或陷入死循环等 , 无法正常处理业务 请求 , 对于这种状态的判断便要依赖应用自身专用于健康状态监测的接口。
存活状态(liveness)检测用于定期检测容器是否正常运行 , 就绪状态(readiness) 检测用于定期检测容器是否可以接收流量 , 它们能够通过减少运维问题和提高服务质量来使 服务更健壮和更具弹性。Kubernetes在Pod内部的容器资源上提供了livenessProbe和 readinessProbe两个字段 , 分别让用户自定义容器应用的存活状态和就绪状态检测。对于合格的云原生应用 , 它们可调用容器应用自身定义的相应API完成 , 而对于不具该类API的传统应用程序 , 用户也可精心设置一个更能反映其相应状态的系统命令或服务请求完成该功能。
容器探测是Pod对象生命周期中的一项重要日常任务 , 它由kubelet周期性执行。 kubelet可在活动容器上分别执行由用户定义的启动状态检测(startupProbe)、存活状态检测(livenessProbe)和就绪状态检测(readinessProbe) , 定义在容器上的存活状态和 就绪状态操作称为检测探针 , 它要通过容器的句柄(handler)进行定义。Kubernetes定义 了用于容器探测的3种句柄。
ExecAction: 通过在容器中执行一个命令并根据其返回的状态码进行的诊断操作称为Exec探测 , 状态码为0表示成功 , 否则即为不健康状态。TCPSocketAction: 通过与容器的某TCP端口尝试建立连接进行诊断 , 端口能够成功打 开即为正常状态 , 否则为不健康状态。HTTPGetAction: 通过向容器IP地址的某指定端口的指定path发起http GET请求进行诊 断 , 响应码为2xx或3xx即为成功 , 否则为失败。
上面的每种探测方式都可能存在3种返回结果: Success(成功)、Failure(失败)或 Unknown(未知) , 仅第一种结果表示成功通过检测。
另外 , Kubernetes自v1.16版本起还支持启动状态(startup)检测。将传统模式开发的大型应用程序迁移至容器编排平台运行时 , 可能需要相当长的时间进行启动后的初始化 , 但其初始过程是否正确完成的检测机制和探测参数都可能有别于存活状态检测 , 例如需要更长的间隔周期和更高的错误阈值等。该类检测的结果处理机制与存活状态检测相同 , 检测失败时kubelet将杀死容器并根据其restartPolicy决定是否将其重启 , 而未定义时的默认状态为 Success。需要注意的是 , 一旦定义了启动检测探针 , 则必须等启动检测成功完成之后 , 存活探针和就绪探针才可启动。
4.2 容器存活状态检测
有些应用程序因存在缺陷(例如多线程导致的应用程序死锁等)会在长时间持续运行后逐渐转为不可用状态 , 并且仅能通过重启操作恢复 , Kubernetes的容器存活性探测机制可发现诸如此类的问题 , 并依据探测结果结合重启策略触发后续的行为。存活性探测是隶属于容器级别的配置 , kubelet可基于它判定何时需要重启容器。目前 , Kubernetes在容器上支持的存活探针有3种类型: ExecAction、TCPSocketAction 和HTTPGetAction 。
4.2.1 存活探针配置格式
Pod配置格式中 , spec.containers.livenessProbe字段用于定义此类检测 , 配置格式如下所示。但一个容器之上仅能定义一种类型的探针 , 即exec、httpGet和tcpSocket三者互斥 , 它们不可在一个容器同时使用。
spec:
  containers:
  - name: …
    image: …
    livenessProbe:
      exec <Object>                   # 命令式探针
      httpGet <Object>                # http GET类型的探针
      tcpSocket <Object>              # tcp Socket类型的探针
      initialDelaySeconds <integer>   # 发起初次探测请求的延后时长
      periodSeconds <integer>         # 请求周期
      timeoutSeconds <integer>        # 超时时长
      successThreshold <integer>      # 成功阈值
      failureThreshold <integer>      # 失败阈值
探针之外的其他字段用于定义探测操作的行为方式 , 用户没有明确定义这些属性字段 时 , 它们会使用各自的默认值 , 各字段的详细说明如下。
initialDelaySeconds: 首次发出存活探测请求的延迟时长 , 即容器启动多久之后开始第一次探测操作 , 显示为delay属性 ; 默认为0秒 , 即容器启动后便立刻进行探 测 ; 该参数值应该大于容器的最大初始化时长 , 以避免程序永远无法启动。timeoutSeconds: 存活探测的超时时长 , 显示为timeout属性 , 默认为1秒 , 最小值也为1秒 ; 应该为此参数设置一个合理值 , 以避免因应用负载较大时的响应延迟 导致Pod被重启。periodSeconds: 存活探测的频度 , 显示为period属性 , 默认为10秒 , 最小值为1秒 ; 需要注意的是 , 过高的频率会给Pod对象带来较大的额外开销 , 而过低的频率又会使得对错误反应不及时。successThreshold: 处于失败状态时 , 探测操作至少连续多少次的成功才被认为通过检测 , 显示为#success属性 , 仅可取值为1。failureThreshold: 处于成功状态时 , 探测操作至少连续多少次的失败才被视为检测不通过 , 显示为#failure属性 , 默认值为3, 最小值为1; 尽量设置宽容一些的失败计数 , 能有效避免一些场景中的服务级联失败。
使用kubectl describe命令查看配置了存活性探测的Pod对象的详细信息时 , 其相关容器中会输出类似如下一行内容 , 它给出了探测方式及其额外的配置属性delay、timeout、 period、success和failure及其各自的相关属性值。
Liveness: …… delay=0s timeout=1s period=10s #success=1 #failure=34.2.2 exec探针
exec类型的探针通过在目标容器中执行由用户自定义的命令来判定容器的健康状态 , 命令状态返回值为0表示“成功”通过检测 , 其余值均为“失败”状态。 spec.containers.livenessProbe.exec字段只有一个可用属性command , 用于指定要执行的命令。
demoapp应用程序通过/livez输出内置的存活状态检测接口 , 服务正常时 , 它以200响应 码返回OK , 否则为5xx响应码 , 我们可基于exec探针使用HTTP客户端向该path发起请求 , 并根据命令的结果状态来判定容器健康与否。系统刚启动时 , 对该路径的请求将会延迟大约不 到5秒的时长 , 且默认响应值为OK。它还支持由用户按需向该路径发起POST请求 , 并向参数 livez传值来自定义其响应内容。下面是定义在资源清单文件liveness-exec-demo.yaml中的 示例
apiVersion: v1
kind: Pod
metadata:
  name: liveness-exec-demo
  namespace: default
spec:
  containers:
  - name: demo
    image: ikubernetes/demoapp:v1.0
    imagePullPolicy: IfNotPresent
    livenessProbe:
      exec:
        command: ['/bin/sh', '-c', '[ "$(curl -s 127.0.0.1/livez)" == "OK" ]']
      initialDelaySeconds: 5
periodSeconds: 5该配置清单中定义的Pod对象为demo容器定义了exec探针 , 它通过在容器本地执行测试 命令来比较curl -s 127.0.0.1/livez的返回值是否为OK以判定容器的存活状态。命令成功执行则表示容器正常运行 , 否则3次检测失败之后则将其判定为检测失败。首次检测在容器 启动5秒之后进行 , 请求间隔也是5秒。
root@kubeadm-master1:~# kubectl apply -f pod-using-hostnetwork.yaml
pod/pod-using-hostnetwork created
创建完成后 , Pod中的容器demo会正常运行 , 存活检测探针也不会遇到检测错误而导致 容器重启。若要测试存活状态检测的效果 , 可以手动将/livez的响应内容修改为OK之外的其 他值 , 例如FAIL。
root@kubeadm-master1:~# kubectl exec liveness-exec-demo -- curl -s -X POST -d 'livez=FAIL' 127.0.0.1/livez而后经过1个检测周期 , 可通过Pod对象的描述信息来获取相关的事件状态 , 例如 , 由下面命令结果中的事件可知 , 容器因健康状态检测失败而被重启。
~$ kubectl describe pods/liveness-exec-demo
……
Events:
Warning  Unhealthy  17s (x3 over 27s)  kubelet, k8s-node03.ilinux.io  Liveness probe
failed:
Normal   Killing     17s             kubelet, k8s-node03.ilinux.io  Container demo failed liveness probe, will be restarted
另外 , 下面输出信息中的Containers一段中还清晰显示了容器健康状态检测及状态变化 的相关信息: 容器当前处于Running状态 , 但前一次是为Terminated , 原因是退出码为137的 错误信息 , 它表示进程是被外部信号所终止。137事实上由两部分数字之和生成: 128+signum , 其中signum是导致进程终止的信号的数字标识 , 9表示SIGKILL , 这意味着进程 是被强行终止的。
Containers:
  demo:
    .......
    State:          Running
      Started:      Thu, 29 Aug 2020 14:30:02 +0800
    Last State:     Terminated
      Reason:       Error
      Exit Code:    137
      Started:      Thu, 29 Aug 2020 14:22:20 +0800
      Finished:     Thu, 29 Aug 2020 14:30:02 +0800
    Ready:          True
    Restart Count:  1
........
待容器重启完成后 , /livez的响应内容会重置镜像中默认定义的OK , 因而其存活状态检 测不会再遇到错误 , 这模拟了一种典型的通过“重启”应用而解决问题的场景。需要特别说明的是 , exec指定的命令运行在容器中 , 会消耗容器的可用计算资源配额 , 另外考虑到探测 操作的效率等因素 , 探测操作的命令应该尽可能简单和轻量。
4.2.3 HTTP探针
HTTP探针是基于HTTP协议的探测(HTTPGetAction) , 通过向目标容器发起一个GET请求 , 并根据其响应码进行结果判定 , 2xx或3xx类的响应码表示检测通过。HTTP探针可用配置字段有如下几个。
host: 请求的主机地址 , 默认为Pod IP; 也可以在httpHeaders使用 “Host:”来定义。port: 请求的端口 , 必选字段。httpHeaders <[]Object>: 自定义的请求报文头部。path: 请求的HTTP资源路径 , 即URL path。scheme: 建立连接使用的协议 , 仅可为HTTP或HTTPS, 默认为HTTP。
下面是一个定义在资源清单文件liveness-httpget-demo.yaml中的示例 , 它使用HTTP探 针直接对/livez发起访问请求 , 并根据其响应码来判定检测结果。
apiVersion: v1
kind: Pod
metadata:
  name: liveness-httpget-demo
  namespace: default
spec:
  containers:
  - name: demo
    image: ikubernetes/demoapp:v1.0
    imagePullPolicy: IfNotPresent
    livenessProbe:
      httpGet:
        path: '/livez'
        port: 80
        scheme: HTTP
initialDelaySeconds: 5上面清单文件中定义的httpGet测试中 , 请求的资源路径为/livez , 地址默认为Pod IP , 端口使用了容器中定义的端口名称http , 这也是明确为容器指明要暴露的端口的用途之一。下面测试其效果 , 首先创建此Pod对象:
~ $ kubectl apply -f liveness-httpget-demo.yaml
pod/liveness-httpget-demo created首次检测为延迟5秒 , 这刚好超过了demoapp的/livez接口默认会延迟响应的时长。镜像 中定义的默认响应是以200状态码响应、以OK为响应结果 , 存活状态检测会成功完成。为了 测试存活状态检测的效果 , 同样可以手动将/livez的响应内容修改为OK之外的其他值 , 例如 FAIL。
~$ kubectl exec liveness-httpget-demo -- curl -s -X POST -d 'livez=FAIL'
127.0.0.1/livez而后经过至少1个检测周期后 , 可通过Pod对象的描述信息来获取相关的事件状态 , 例如 , 由下面命令的结果中的事件可知 , 容器因健康状态检测失败而被重启。
~ $ kubectl describe pods/liveness-httpget-demo
……
Warning  Unhealthy  7s (x3 over 27s)  kubelet, k8s-node01.ilinux.io  Liveness probe
failed: HTTP probe failed with statuscode: 520
  Normal   Killing    7s          kubelet, k8s-node01.ilinux.io  Container demo failed
liveness probe, will be restarted
一般来说 , HTTP探针应该针对专用的URL路径进行 , 例如前面示例中特别为其准备的/livez , 此URL路径对应的Web资源也应该以轻量化的方式在内部对应用程序的各关键组件进行全面检测 , 以确保它们可正常向客户端提供完整的服务。
需要注意的是 , 这种检测方式仅对分层架构中的当前一层有效 , 例如 , 它能检测应用程序工作正常与否的状态 , 但重启操作却无法解决其后端服务(例如数据库或缓存服务)导致的故障。此时 , 容器可能会被反复重启 , 直到后端服务恢复正常。其他两种检测方式也存在类似的问题。
4.2.4 TCP探针
TCP探针是基于TCP协议进行存活性探测(TCPSocketAction) , 通过向容器的特定端口发起TCP请求并尝试建立连接进行结果判定 , 连接建立成功即为通过检测。相比较来说 , 它 比基于HTTP协议的探测要更高效、更节约资源 , 但精准度略低 , 毕竟连接建立成功未必意味 着页面资源可用。
spec.containers.livenessProbe.tcpSocket字段用于定义此类检测 , 它主要有以下两 个可用字段:
host: 请求连接的目标IP地址 , 默认为Pod自身的IP;port: 请求连接的目标端口 , 必选字段 , 可以名称调用容器上显式定义的端口
下面是一个定义在资源清单文件liveness-tcpsocket-demo.yaml中的示例 , 它向Pod对象的TCP协议的80端口发起连接请求 , 并根据连接建立的状态判定测试结果。为了能在容器中通过iptables阻止接收对80端口的请求以验证TCP检测失败 , 下面的配置还在容器上启用 了特殊的内核权限NET_ADMIN。
apiVersion: v1
kind: Pod
metadata:
  name: liveness-tcpsocket-demo
  namespace: default
spec:
  containers:
  - name: demo
    image: ikubernetes/demoapp:v1.0
    imagePullPolicy: IfNotPresent
    ports:
    - name: http
      containerPort: 80
    securityContext:
      capabilities:
        add:
        - NET_ADMIN
    livenessProbe:
      tcpSocket:
        port: http
      periodSeconds: 5
      initialDelaySeconds: 20
按照配置 , 将该清单中的Pod对象创建在集群之上 , 20秒之后即会进行首次的tcpSocket 检测。
~$ kubectl apply -f liveness-tcpsocket-demo.yaml
pod/liveness-tcpsocket-demo created容器应用demoapp启动后即监听于TCP协议的80端口 , tcpSocket检测也就可以成功执行。为了测试效果 , 可使用下面的命令在Pod的Network名称空间中设置iptables规则以阻止对80端口的请求:
~$ kubectl exec liveness-tcpsocket-demo -- iptables -A INPUT -p tcp --dport 80 -j REJECT而后经过至少1个检测周期后 , 可通过Pod对象的描述信息来获取相关的事件状态 , 例如 , 由下面命令的结果中的事件可知 , 容器因健康状态检测失败而被重启。
~ $ kubectl describe pods/liveness-httpget-demo
……
Events:
……
Warning  Unhealthy  3s (x3 over 23s)  kubelet, k8s-node03.ilinux.io  Liveness probe
failed: dial tcp 10.244.3.19:80: i/o timeout
    Normal   Killing    3s      kubelet, k8s-node03.ilinux.io  Container demo
failed liveness probe, will be restarted
不过 , 重启容器并不会导致Pod资源的重建操作 , 网络名称空间的设定附加在pause容器 之上 , 因而添加的iptables规则在应用重启后依然存在 , 它是一个无法通过重启而解决的问题。若需要手消除该问题 , 删除添加至Pod中的iptables规则即可。
4.2.5 探针示例
HTTP探针示例
# cat nginx.yaml
#apiVersion: extensions/v1beta1
apiVersion: apps/v1
kind: Deployment
 metadata:
  name: nginx-deployment
 spec:
   replicas: 1
   selector:
     matchLabels: #rs or deployment
       app: ng-deploy-80
     #matchExpressions:
     #  - {key: app, operator: In, values: [ng-deploy-80,ng-rs-81]}
    template:
      metadata:
        labels:
          app: ng-deploy-80
      spec:
        containers:
        - name: ng-deploy-80
          image: nginx:1.17.5
          ports:
          - containerPort: 80
          #readinessProbe:
          livenessProbe:
            httpGet:
              #path: /monitor/monitor.html
              path: /index.html
              port: 80
            initialDelaySeconds: 5
            periodSeconds: 3
            timeoutSeconds: 5
            successThreshold: 1
            failureThreshold: 3

---
apiVersion: v1
kind: Service
metadata:
  name: ng-deploy-80
spec:
  ports:
  - name: http
    port: 81
    targetPort: 80
    nodePort: 40012
    protocol: TCP
  type: NodePort
  selector:
app: ng-deploy-80TCP探针示例
# cat nginx.yaml
#apiVersion: extensions/v1beta1
apiVersion: apps/v1
  kind: Deployment
  metadata:
    name: nginx-deployment
spec:
  replicas: 1
  selector:
     matchLabels: #rs or deployment
        app: ng-deploy-80
    #matchExpressions:
    #  - {key: app, operator: In, values: [ng-deploy-80,ng-rs-81]}
 template:
   metadata:
     labels:
       app: ng-deploy-80
   spec:
     containers:
     - name: ng-deploy-80
       image: nginx:1.17.5
       ports:
       - containerPort: 80
       livenessProbe:
       #readinessProbe:
          tcpSocket:
            port: 80
            #port: 8080
          initialDelaySeconds: 5
          periodSeconds: 3
          timeoutSeconds: 5
          successThreshold: 1
          failureThreshold: 3
---
apiVersion: v1
kind: Service
metadata:
  name: ng-deploy-80
spec:
  ports:
  - name: http
    port: 81
    targetPort: 80
    nodePort: 40012
    protocol: TCP
  type: NodePort
  selector:
app: ng-deploy-80ExecAction探针:
# docker pull redis
# cat redis.yaml
#apiVersion: extensions/v1beta1
apiVersion: apps/v1
kind: Deployment
metadata:
  name: redis-deployment
spec:
  replicas: 1
  selector:
    matchLabels: #rs or deployment
      app: redis-deploy-6379
    #matchExpressions:
    #  - {key: app, operator: In, values: [redis-deploy-6379,ng-rs-81]}
  template:
    metadata:
      labels:
        app: redis-deploy-6379
    spec:
      containers:
      - name: redis-deploy-6379
        image: redis
        ports:
        - containerPort: 6379
        livenessProbe:
        #readinessProbe:
          exec:
            command:
            #- /apps/redis/bin/redis-cli- /usr/local/bin/redis-cli - quit
          initialDelaySeconds: 5
          periodSeconds: 3
          timeoutSeconds: 5
          successThreshold: 1
          failureThreshold: 3
---
apiVersion: v1
kind: Service
metadata:
  name: redis-deploy-6379
spec:
  ports:
  - name: http
    port: 6379
    targetPort: 6379
    nodePort: 40016
    protocol: TCP
  type: NodePort
 selector:
   app: redis-deploy-6379
配置参数一样
livenessProbe #连续探测失败会重启、重建pod,readinessProbe不会执行重启或者重建Pod操作
livenessProbe #连续检测指定次数失败后会将容器置于(Crash Loop BackOff)切不可用,readinessProbe不
会
readinessProbe #连续探测失败会从service的endpointd中删除该Pod,livenessProbe不具备此功能,但是
会将容器挂起livenessProbe
livenessProbe用户控制是否重启pod,readinessProbe用于控制pod是否添加至service
建议:
两个探针都配置4.3 Pod的重启策略
Pod对象的应用容器因程序崩溃、启动状态检测失败、存活状态检测失败或容器申请超 出限制的资源等原因都可能导致其被终止 , 此时是否应该重启则取决于Pod上的 restartPolicy(重启策略)字段的定义 , 该字段支持以下取值。
Always: 无论因何原因、以何种方式终止 ,kubelet都将重启该Pod, 此为默认设定。OnFailure: 仅在Pod对象以非0方式退出时才将其重启。Never: 不再重启该Pod。
需要注意的是 , restartPolicy适用于Pod对象中的所有容器 , 而且它仅用于控制在同一 个节点上重新启动Pod对象的相关容器。首次需要重启的容器 , 其重启操作会立即进行 , 而 再次重启操作将由kubelet延迟一段时间后进行 , 反复的重启操作的延迟时长依次为10秒、 20秒、40秒、80秒、160秒和300秒 , 300秒是最大延迟时长。
事实上 , 一旦绑定到一个节点 , Pod对象将永远不会被重新绑定到另一个节点 , 它要么 被重启 , 要么被终止 , 直到节点故障、被删除或被驱逐。
4.4 容器就绪状态检测
Pod对象启动后 , 应用程序通常需要一段时间完成其初始化过程 , 例如加载配置或数据、缓存初始化等 , 甚至有些程序需要运行某类预热过程等 , 因此通常应该避免在Pod对象 启动后立即让其处理客户端请求 , 而是需要等待容器初始化工作执行完成并转为“就绪”状态 , 尤其是存在其他提供相同服务的Pod对象的场景更是如此。
与存活探针不同的是 , 就绪状态检测是用来判断容器应用就绪与否的周期性(默认周期为10秒钟)操作 , 它用于检测容器是否已经初始化完成并可服务客户端请求。与存活探针触 发的操作不同 , 检测失败时 , 就绪探针不会杀死或重启容器来确保其健康状态 , 而仅仅是通知其尚未就绪 , 并触发依赖其就绪状态的其他操作(例如从Service对象中移除此Pod对象), 以确保不会有客户端请求接入此Pod对象。 就绪探针也支持Exec、HTTP GET和TCP Socket这3种探测方式 , 且它们各自的定义机制与存活探针相同。因而 , 将容器定义中的livenessProbe字段名替换为readinessProbe , 并略做适应性修改即可定义出就绪性检测的配置来 , 甚至有些场景中的就绪探针与存活探针的配置可以完全相同。
demoapp应用程序通过/readyz暴露了专用于就绪状态检测的接口 , 它于程序启动约15秒 后能够以200状态码响应、以OK为响应结果 , 也支持用户使用POST请求方法通过readyz参数传递自定义的响应内容 , 不过所有非OK的响应内容都被响应以5xx的状态码。一个简单的示 例如下面的配置清单(readiness-httpget-demo.yaml)所示。
apiVersion: v1
kind: Pod
metadata:
  name: readiness-httpget-demo
  namespace: default
spec:
  containers:
  - name: demo
    image: ikubernetes/demoapp:v1.0
    imagePullPolicy: IfNotPresent
    readinessProbe:
      httpGet:
        path: '/readyz'
        port: 80
        scheme: HTTP
      initialDelaySeconds: 15
      timeoutSeconds: 2
      periodSeconds: 5
      failureThreshold: 3
restartPolicy: Always下面来测试该Pod就绪探针的作用。按照配置 , 将Pod对象创建在集群上约15秒后启动首次探测 , 在该探测结果成功返回之前 , Pod将一直处于未就绪状态 :
~ $ kubectl apply -f readiness-httpget-demo.yaml
pod/readiness-httpget-demo created接着运行kubectl get -w命令监视其资源变动信息 , 由如下命令结果可知 , 尽管Pod对 象处于Running状态 , 但直到就绪检测命令执行成功后Pod资源才转为“就绪”。
~$ kubectl get pods/readiness-httpget-demo -w
NAME                     READY   STATUS    RESTARTS   AGE
readiness-httpget-demo   0/1     Running   0          10s
readiness-httpget-demo 1/1 Running 0 20sPod运行过程中的某一时刻 , 无论因何原因导致的就绪状态检测的连续失败都会使得该 Pod从就绪状态转变为“未就绪” , 并且会从各个通过标签选择器关联至该Pod对象的 Service后端端点列表中删除。为了测试就绪状态检测效果 , 下面修改/readyz响应以非OK内容。
~$ kubectl exec readiness-httpget-demo -- curl -s -XPOST -d 'readyz=FAIL'
127.0.0.1/readyz而后在至少1个检测周期之后 , 通过该Pod的描述信息可以看到就绪检测失败相关的事件描述 , 命令及结果如下所示:
~$ kubectl describe pods/readiness-httpget-demo
……
Warning  Unhealthy  4s (x11 over 54s)  kubelet, k8s-node03.ilinux.io  Readiness probe
failed: HTTP probe failed with statuscode: 521
这里要特别提醒读者的是 , 未定义就绪性检测的Pod对象在进入Running状态后将立即 “就绪” , 这在容器需要时间进行初始化的场景中可能会导致客户请求失败。因此 , 生产实践中 , 必须为关键性Pod资源中的容器定义就绪探针。
4.5 容器生命周期
许多编程语言框架都实现了生命周期管理的概念 , 其主要用于指定平台如何与它创建的组件在启动之后或停止之前进行交互。实现这类功能很重要 , 毕竟有时我们可能需要在Pod 上执行一些操作 , 例如测试同一个或多个依赖项的连接性 , 以及在销毁Pod之前进行一些清理活动等。容器应用生命周期管理是指它可从平台接收管理事件并执行相应的操作 , 以便于平台能够更好地管理容器的生命周期机制 , 因而也称为容器生命周期管理API。
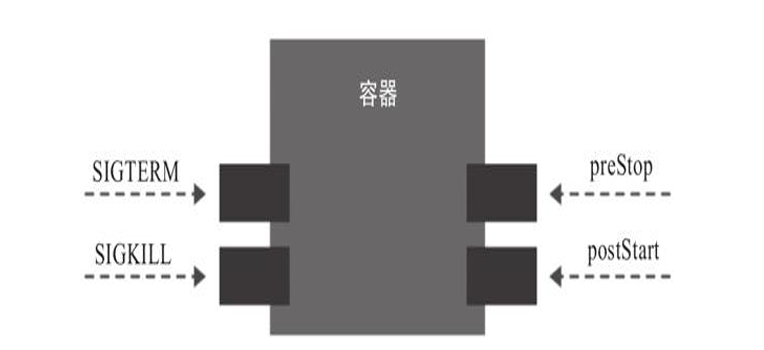
容器需要处理来自平台的最重要事件是SIGTERM信号 , 任何需要“干净”关闭进程的应用程序都需要捕捉该信号进行必要处理 , 例如释放文件锁、关闭数据库连接和网络连接等 , 而后尽快终止进程 , 以避免宽限期过后强制关闭信号SIGKILL的介入。SIGKILL信号是由底层 操作系统接收的 , 而非应用进程 , 一旦检测到该信号 , 内核将停止为相应进程提供内核资 源 , 并终止进程正在使用的所有CPU线程 , 类似于直接切断了进程的电源。
但是 , 容器应用很可能是功能复杂的分布式应用程序的一个组件 , 仅依赖信号终止进程很可能不足以完成所有的必要操作。因此 , 容器还需要支持postStart和preStop事件 , 前者常用于为程序启动前进行预热 , 后者则一般在“干净”地关闭应用之前释放占用的资源。
生命周期钩子函数lifecycle hook是编程语言(例如Angular)中常用的生命周期管理组件 , 它实现了程序运行周期中的关键时刻的可见性 , 并赋予用户为此采取某种行动的能力。类似地 , 容器生命周期钩子使它能够感知自身生命周期管理中的事件 , 并在相应时刻到来时运行由用户指定的处理程序代码。Kubernetes同样为容器提供了postStart和preStop两种生命周期钩子。
postStart: 在容器创建完成后立即运行的钩子句柄(handler) , 该钩子定义的事件 执行完成后容器才能真正完成启动过程 , 如图中的左图所示 ; 不过Kubernetes无法确保它一定会在容器的主应用程序(由ENTRYPOINT定义)之前运行。preStop: 在容器终止操作执行之前立即运行的钩子句柄 , 它以同步方式调用 , 因此在其完成之前会阻塞删除容器的操作 ; 这意味着该钩子定义的事件成功执行并退出 , 容器终止操作才能真正完成 ,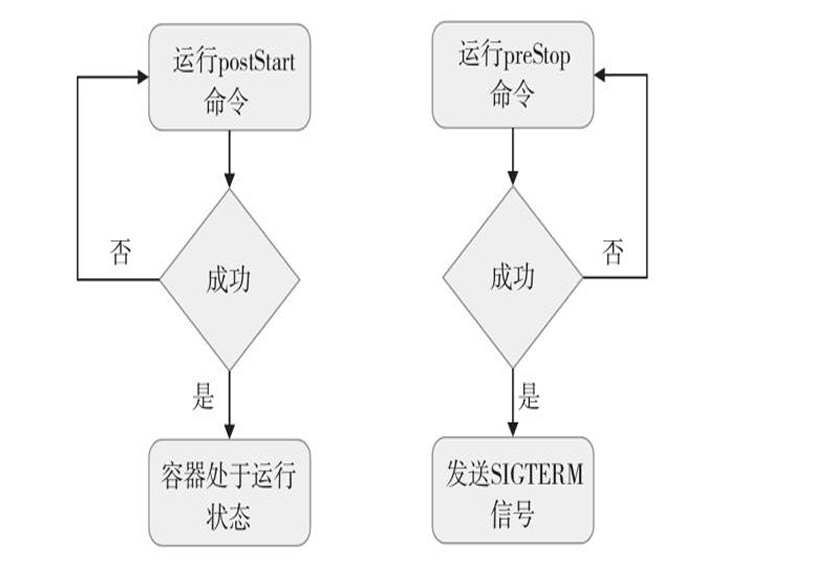
钩子句柄的实现方式类似于容器探针句柄的类型 , 同样有
exec、httpGet和tcpSocket这3种 , 它们各自的配置格式和工作逻辑也完全相同 ,exec在容器中执行用户定义的一个或多 个命令 ,httpGet在容器中向指定的本地URL发起HTTP连接请求 , 而tcpSocket则试图与指定的端口建立TCP连接。postStart和preStop句柄定义在容器的lifecycle字段中 , 其内部一次仅支持嵌套使用 一种句柄类型。下面的配置清单(lifecycle-demo.yaml)示例中同时使用了postStart和preStop钩子处理相应的事件。apiVersion: v1 kind: Pod metadata: name: lifecycle-demo namespace: default spec: containers: - name: demo image: ikubernetes/demoapp:v1.0 imagePullPolicy: IfNotPresent securityContext: capabilities: add: - NET_ADMIN livenessProbe: httpGet: path: '/livez' port: 80 scheme: HTTP initialDelaySeconds: 5 lifecycle: postStart: exec: command: ['/bin/sh','-c','iptables -t nat -A PREROUTING -p tcp --dport 8080 -j REDIRECT --to-ports 80'] preStop: exec: command: ['/bin/sh','-c','while killall python3; do sleep 1; done'] restartPolicy: Always示例中的
demo容器通过postStart执行iptables命令设置端口重定向规则 , 将发往该Pod IP的8080端口的所有请求重定向至80端口 , 从而让容器应用能够同时从8080端口接收请求。demo容器又借助preStop执行killall命令 , 它假设该命令能够更优雅地终止基于Python3运行的容器应用demoapp。将清单中的Pod对象创建于集群中便可展开后续的测试 :~$ kubectl apply -f lifecycle-demo.yaml pod/lifecycle-demo created而后可获取容器内网络名称空间中
PREROUTING链上的iptables规则 , 验证postStart钩子事件的执行结果 :~$ kubectl exec lifecycle-demo -- iptables -t nat -nL PREROUTING Chain PREROUTING (policy ACCEPT) target prot opt source destination REDIRECT tcp -- 0.0.0.0/0 0.0.0.0/0 tcp dpt:8080 redir ports 80上面的配置清单中有意同时添加了
httpGet类型的存活探针 , 我们可以人为地将探针检 测结果置为失败状态 , 以促使kubelet重启demo容器验证preStop钩子事件的执行。不过 , 该示例中给出的操作是终止容器应用 , 那么容器成功重启即验证了相应脚本的运行完成。
5. 多容器pod
容器设计模式中的单节点多容器模型中, 初始化容器和Sidecar容器是目前使用较多的模式, 尤其是服务网格的发展极大促进了Sidecar容器的应用
5.1 初始化容器
初始化是很多编程语言普遍关注的问题, 甚至有些编程语言直接支持模式构造来生成初始化程序, 这些用于进行初始化的程序结构称为初 始化器或初始化列表。初始化代码要首先运行, 且只能运行一次, 它们 常用于验证前提条件、基于默认值或传入的参数初始化对象实例的字段 等。Pod中的初始化容器(Init Container)功能与此类似, 它们为那些有先决条件的应用容器完成必要的初始设置, 例如设置特殊权限、生成必要的iptables规则、设置数据库模式, 以及获取最新的必要数据等。
有很多场景都需要在应用容器启动之前进行部分初始化操作, 例如等待其他关联组件服务可用、基于环境变量或配置模板为应用程序生成 配置文件、从配置中心获取配置等。初始化容器的典型应用需求有如下几种。
用于运行需要管理权限的工具程序, 例如
iptables命令等, 出于安全等方面的原因 , 应用容器不适合拥有运行这类程序的权限。提供主容器镜像中不具备的工具程序或自定义代码。
为容器镜像的构建和部署人员提供了分离、独立工作的途径, 部 署人员使用专用的初始化容器完成特殊的部署逻辑, 从而使得他们不必 协同起来制作单个镜像文件。
初始化容器和应用容器处于不同的文件系统视图中, 因此可分别安全地使用敏感数据, 例如
Secrets资源等。初始化容器要先于应用容器串行启动并运行完成, 因此可用于延后应用容器的启动直至其依赖的条件得以满足。
Pod对象中的所有初始化容器必须按定义的顺序串行运行, 直到它们全部成功结束才能启动应用容器, 因而初始化容器通常很小, 以便它们 能够以轻量的方式快速运行。某初始化容器运行失败将会导致整个Pod重新启动(重启策略为Never时例外), 初始化容器也必将再次运行, 因此需要确保所有初始化容器的操作具有幂等性, 以避免无法预知的副作 用。
Pod资源的spec.initContainers字段以列表形式定义可用的初始化 容器, 其嵌套可用字段类似于spec.containers。下面的资源清单(init-container-demo.yaml)在Pod对象上定义了一个名为iptables init的初始化容器示例。
apiVersion: v1
kind: Pod
metadata:
  name: init-container-demo
  namespace: default
spec:
  initContainers:   # 定义初始化容器
  - name: iptables-init
    image: ikubernetes/admin-box:latest
    imagePullPolicy: IfNotPresent
    command: ['/bin/sh','-c']
    args: ['iptables -t nat -A PREROUTING -p tcp --dport 8080 -j REDIRECT  --to-port 80']
    securityContext:
      capabilities:
        add:
        - NET_ADMIN
  containers:
  - name: demo
    image: ikubernetes/demoapp:v1.0
    imagePullPolicy: IfNotPresent
    ports:
    - name: http
      containerPort: 80
示例中, 应用容器demo默认监听TCP协议的80端口, 但我们又期望该 Pod能够在TCP协议的8080端口通过端口重定向方式为客户端提供服务, 因此需要在其网络名称空间中添加一条相应的iptables规则。但是, 添加该规则的iptables命令依赖于内核中的网络管理权限, 出于安全原因, 我们并不期望应用容器拥有该权限, 因而使用了拥有网络管理权限的初始化容器来完成此功能。下面先把配置清单中定义的资源创建于集群之上:
~$ kubectl apply -f init-container-demo.yaml
pod/init-container-demo created
随后, 在Pod对象init-container-demo的描述信息中的初始化容器 信息段可以看到如下内容, 它表明初始化容器启动后大约1秒内执行完成 返回0状态码并成功退出。
Command:
  /bin/sh
  -c
Args:
  iptables -t nat -A PREROUTING -p tcp --dport 8080 -j REDIRECT --to-port 80
State:          Terminated
  Reason:       Completed
  Exit Code:    0
  Started:      Sun, 30 Aug 2020 11:44:28 +0800
  Finished:     Sun, 30 Aug 2020 11:44:29 +0800
Ready:          True
Restart Count:  0
这表明, 向Pod网络名称空间中添加iptables规则的操作已经完成, 我们可通过应用容器来请求查看这些规则, 但因缺少网络管理权限, 该查看请求会被拒绝
~$ kubectl exec init-container-demo -- iptables -t nat -vnL
iptables v1.8.3 (legacy): can't initialize iptables table `nat':
Permission denied (you must be root)
Perhaps iptables or your kernel needs to be upgraded.
command terminated with exit code 3
另一方面, 应用容器中的服务却可以正常通过Pod IP的8080端口接 收并响应, 如下面的命令及执行结果所示
~$ podIP=$(kubectl get pods/init-container-demo -o jsonpath={.status.podIP})
~$ curl http://${podIP}:8080
iKubernetes demoapp v1.0 !! ClientIP: 10.244.0.0, ServerName: init
container-demo, …
由此可见, 初始化容器及容器的postStop钩子都能完成特定的初始 化操作, 但postStop必须在应用容器内部完成, 它依赖的条件(例如管 理权限)也必须为应用容器所有, 这无疑会为应用容器引入安全等方面 的风险。另外, 考虑到应用容器镜像内部未必存在执行初始化操作的命令或程序库, 使用初始化容器也就成了不二之选。
5.2 Sidecar容器
Sidecar容器是Pod中与主容器松散耦合的实用程序容器, 遵循容器 设计模式 , 并以单独容器进程运行, 负责运行应用的非核心功能, 以扩 展、增强主容器。Sidecar模式最著名的用例是充当服务网格中的微服务 的代理应用(例如Istio中的数据控制平面Envoy), 其他典型使用场景 包括日志传送器、监视代理和数据加载器等。
下面的配置清单(sidecar-container-demo.yaml)中定义了两个容器 : 一个是运行demoapp的主容器demo, 一个运行envoy代理的Sidecar 容器proxy。
apiVersion: v1
kind: Pod
metadata:
  name: sidecar-container-demo
  namespace: default
spec:
  containers:
  - name: proxy
    image: envoyproxy/envoy-alpine:v1.13.1
    command: ['/bin/sh','-c']
    args: ['sleep 3 && envoy -c /etc/envoy/envoy.yaml']
    lifecycle:
      postStart:
        exec:
          command: ['/bin/sh','-c','wget -O /etc/envoy/envoy.yaml https://raw.githubusercontent.com/iKubernetes/Kubernetes_Advanced_Practical_2rd/master/chapter4/envoy.yaml']
  - name: demo
    image: ikubernetes/demoapp:v1.0
    imagePullPolicy: IfNotPresent
    env:
    - name: HOST
      value: "127.0.0.1"
    - name: PORT
value: "8080" Envoy程序是服务网格领域著名的数据平面实现, 它在Istio服务网格中以Sidecar的模式同每一个微服务应用程序单独组成一个Pod, 负责代理该微服务应用的所有通信事件, 并为其提供限流、熔断、超时、重试等多种高级功能。这里我们将demoapp视作一个微服务应用, 配置 Envoy为其代理并调度入站(Ingress)流量, 因而在示例中demo容器基于环境变量被配置为监听127.0.0.1地址上一个特定的8080端口, 而 proxy容器将监听Pod所有IP地址上的80端口, 以接收客户端请求。proxy 容器上的postStart事件用于为Envoy代理下载一个适用的配置文件, 以 便将proxy接收到的所有请求均代理至demo容器。
下面说明整个测试过程。先将配置清单中定义的对象创建到集群之 上
~$ kubectl apply -f sidecar-container-demo.yaml
pod/sidecar-container-demo created
随后, 等待Pod中的两个容器成功启动且都转为就绪状态, 可通过各 Pod内端口监听的状态来确认服务已然正常运行。下面命令的结果表示, Envoy已经正常运行并监听了TCP协议的80端口和9901端口(Envoy的内置管理接口)。
$ kubectl exec sidecar-container-demo -c proxy -- netstat -tnlp
Active Internet connections (only servers)
Proto Recv-Q Send-Q Local Address    Foreign Address   State
PID/Program name
tcp        0      0 0.0.0.0:9901       0.0.0.0:*       LISTEN
1/envoy
tcp        0      0 0.0.0.0:80         0.0.0.0:*       LISTEN
1/envoy
tcp        0      0 127.0.0.1:8080     0.0.0.0:*       LISTEN
...
接下来, 我们向Pod的80端口发起HTTP请求, 若它能以demoapp的页面响应, 则表示代理已然成功运行, 甚至可以根据响应头部来判断其是 否有代理服务Envoy发来的代理响应, 如下面的命令及结果所示。
~$ podIP=$(kubectl get pods/sidecar-container-demo -o jsonpath={.status.podIP})
$ curl http://$podIP
iKubernetes demoapp v1.0 !! ClientIP: 127.0.0.1, ServerName: sidecar-container-demo, ……
~$ curl -I http://$podIP
HTTP/1.1 200 OK
content-type: text/html; charset=utf-8
content-length: 108
server: envoy
date: Sun, 22 May 2020 06:43:04 GMT
x-envoy-upstream-service-time: 3虽然Sidecar容器可以称得上是Pod中的常规容器, 但直到v1.18版 本, Kubernetes才将其添加作为内置功能。在此之前, Pod中的各应用程序彼此间没有区别, 用户无从预测和控制容器的启动及关闭顺序, 但多数场景都要求Sidecar容器必须要先于普通应用容器启动以做一些准备工作, 例如分发证书、创建存储卷或获取一些数据等, 且它们需要晚于其 他应用容器终止。Kubernetes从v1.18版本开始支持用户在生命周期字段 中将容器标记为Sidecar, 这类容器全部转为就绪状态后, 普通应用容器 方可启动。因而, 这个新特性根据生命周期将Pod的容器重新划分成了初 始化容器、Sidecar容器和应用容器3类。
所有的Sidecar容器都是应用容器, 唯一不同之处是, 需要手动为 Sidecar容器在lifecycle字段中嵌套定义type类型的值为Sidecar 。 配置格式如下所示:
spec:
  containers:
  - name: proxy
    image: envoyproxy/envoy-alpine:v1.13.1
    lifecycle:
      type: Sidecar
    ……
  - name: demo
    image: ikubernetes/demoapp:v1.0
    ……
另外, 可能也有一些场景需要Sidecar容器启动晚于普通应用容器, 这种特殊的应用需求, 目前可通过OpernKruise项目中的SidecarSet提供 的PostSidecar模型来解决。将来,该项目或许支持以DAG的方式来灵活 编排容器的启动顺序。
6. 容器安全上下文
我们知道, 尽管容器技术提供了强大的软件级别的资源隔离功能, 但共享内核机制导致其遭 受到内部攻击, 击破这种隔离的可能性还是要远大于由Hypervisor隔离的虚拟机, 更不用说物理级的隔离。容器运行时通常为管理员提供了许多与安全相关的可配置选项, 例如可使用的系统调 用集与是否可运行为特权模式(具有访问主机设备的权限)等, 管理员需要根据这些选项与容器 的实际运行需求来精心组织和设定容器的运行时选项以降低安全风险。
Kubernetes为安全运行Pod及容器运行设计了安全上下文机制, 该机制允许用户和管理员定义 Pod或容器的特权与访问控制, 以配置容器与主机以及主机之上的其他容器间的隔离级别。安全上下文就是一组用来决定容器是如何创建和运行的约束条件, 这些条件代表创建和运行容器时使用的运行时参数。需要提升容器权限时, 用户通常只应授予容器执行其工作所需的访问权限, 以 “最小权限法则”来抑制容器对基础架构及其他容器产生的负面影响。
Kubernetes支持用户在Pod及容器级别配置安全上下文, 并允许管理员通过Pod安全策略在集群全局级别限制用户在创建和运行Pod时可设定的安全上下文。本节仅描述Pod和容器级别的配置
Pod和容器的安全上下文设置包括以下几个方面。
自主访问控制(
DAC): 传统UNIX的访问控制机制, 它允许对象(OS级别, 例如文件等)的所有者基于UID和GID设定对象的访问权限。Linux功能:Linux为突破系统上传统的两级用户(root和普通用户)授权模型, 而将内核管理权限打散成多个不同维度或级别的权限子集, 每个子集称为一种“功能”或“能力”, 例如CAP_NET_ADMIN、CAP_SYS_TIME、CAP_SYS_PTRACE和CAP_SYS_ADMIN等, 从而允许进程仅具有一部分内核管理功能就能完成必要的管理任务。seccomp: 全称为secure computing mode, 是Linux内核的安全模型 , 用于为默认可发起的 任何系统调用进程施加控制机制, 人为地禁止它能够发起的系统调用, 有效降低了程序被劫持时的危害级别。AppArmor: 全称为Application Armor, 意为“应用盔甲” , 是Linux内核的一个安全模块 , 通过加载到内核的配置文件来定义对程序的约束与控制。SELinux: 全称为Security-Enhanced Linux, 意为安全加强的Linux, 是Linux内核的一个安全模块 , 提供了包括强制访问控制在内的访问控制安全策略机制。Privileged模式 : 即特权模式容器 , 该模式下容器中的root用户拥有所有的内核功能 , 即具有真正的管理员权限 , 它能看到主机上的所有设备 , 能够挂载文件系统 , 甚至可以在容器中运 行容器 ; 容器默认运行于非特权(unprivileged)模式。AllowPrivilegeEscalation: 控制是否允许特权升级 , 即进程是否能够获取比父进程更多的特权 ; 运行于特权模式或具有CAP_SYS_ADMIN能力的容器默认允许特权升级。
这些安全上下文相关的特性多数嵌套定义在Pod或容器的securityContext字段中 , 而且有些特性对应的嵌套字段还不止一个。而seccomp和AppArmor的安全上下文则需要以资源注解的方式进行定义 , 而且仅能由管理员在集群级别进行Pod安全策略配置。
6.1 配置格式速览
安全上下文可分别设置Pod级别和容器级别 , 前者的配置将应用到其内部的所有容器之上 , 而 后者的配置则仅在当前容器生效。但有些参数并不适合通用设定 , 例如特权模式、特权升级、只读根文件系统和内核能力等 , 它们只可用于容器之上。但也有参数仅可用于Pod级别进行通用设定 , 例如设置内核参数的sysctl和设置存储卷新件文件默认属组的fsgroup等。下面以Pod资源的 配置格式给出了这些配置选项 , 以便于读者快速预览和了解安全上下文的用法。
apiVersion: v1
kind: Pod
metadata: {…}
spec:
  securityContext:         # Pod级别的安全上下文 , 对内部所有容器均有效
    runAsUser <integer>    # 以指定的用户身份运行容器进程 , 默认由镜像中的USER指定
    runAsGroup <integer>   # 以指定的用户组运行容器进程 , 默认使用的组随容器运行时设定
    supplementalGroups  <[]integer>  # 为容器中1号进程的用户添加的附加组
    fsGroup <integer>      # 为容器中的1号进程附加一个专用组 , 其功能类似于sgid
    runAsNonRoot <boolean> # 是否以非root身份运行
    seLinuxOptions <Object>  # SELinux的相关配置
    sysctls  <[]Object>         # 应用到当前Pod名称空间级别的sysctl参数设置列表
    windowsOptions <Object>     # Windows容器专用的设置
  containers:
  - name: …
    image: …
    securityContext:            # 容器级别的安全上下文 , 仅在当前容器生效
      runAsUser <integer>       # 以指定的用户身份运行容器进程
      runAsGroup <integer>      # 以指定的用户组运行容器进程
      runAsNonRoot <boolean>    # 是否以非root身份运行
      allowPrivilegeEscalation <boolean> # 是否允许特权升级
      capabilities <Object>     # 为当前容器添加(add)或删除(drop)内核能力
        add  <[]string>         # 添加由列表定义的各内核能力
        drop  <[]string>        # 移除由列表定义的各内核能力
      privileged <boolean>      # 是否运行为特权容器
      procMount <string>        # 设置容器的procMount类型 , 默认为DefaultProcMount ;
      readOnlyRootFilesystem <boolean> # 是否将根文件系统设置为只读模式
      seLinuxOptions <Object>   # SELinux的相关配置
windowsOptions <Object> # Windows容器专用的设置Kubernetes默认以非特权模式创建并运行容器 , 同时禁用了其他与管理功能相关的内核能力 , 但未额外设定其他上下文参数。
6.2 管理容器进程的运行身份
制作Docker镜像时 , Dockerfile支持以USER指令明确指定运行应用进程时的用户身份。对于未通过USER指令显式定义运行身份的镜像 , 创建和启动容器时 , 其进程的默认用户身份为容器中 的root用户和root组 , 该用户有着其他一些附加的系统用户组 , 例如sys、daemon、wheel和bin 等。然而 , 有些应用程序的进程需要以特定的专用用户身份运行 , 或者以指定的用户身份运行时 才能获得更好的安全特性 , 这种需求可以在Pod或容器级别的安全上下文中使用runAsUser得以解决 , 必要时可同时使用runAsGroup设置进程的组身份。
下面的资源清单(securitycontext-runasuer-demo.yaml)配置以1001这个UID和GID的身份来运行容器中的demoapp应用 , 考虑到非特权用户默认无法使用1024以下的端口号 , 文件中通过环境变量改变了应用监听的端口。
apiVersion: v1
kind: Pod
metadata:
  name: securitycontext-runasuser-demo
  namespace: default
spec:
  containers:
  - name: demo
    image: ikubernetes/demoapp:v1.0
    imagePullPolicy: IfNotPresent
    env:
    - name: PORT
      value: "8080"
    securityContext:
      runAsUser: 1001
runAsGroup: 1001下面的命令先将配置清单中定义的Pod对象securitycontext-runasuser-demo创建到集群上 , 随后的两条命令验证了容器用户身份确为配置中预设的UID和GID。
~$ kubectl apply -f securitycontext-runasuser-demo.yaml
pod/securitycontext-runasuser-demo created
~$ kubectl exec securitycontext-runasuser-demo -- id
uid=1001 gid=1001
$ kubectl exec securitycontext-runasuser-demo -- ps aux
PID    USER      TIME  COMMAND
  1    1001      0:00  python3 /usr/local/bin/demo.py
若有必要 , 我们还可在上面的配置清单中的安全上下文定义中 , 同时使用supplement-Groups 选项定义主进程用户的其他附加用户组 , 这对于有着复杂权限模型的应用是一个非常有用的选项。
另外 , 若运行容器时使用的镜像文件中已经使用USER指令指定了非root用户的运行身份 , 我 们也可以在安全上下文中使用runAsNonRoot 参数定义容器必须使用指定的非root用户身份运行 , 而无须使用runAsUser参数额外指定用户。
6.3 管理容器的内核功能
传统UNIX仅实现了特权和非特权两类进程 , 前者是指以0号UID身份运行的进程 , 而后者则是 从属非0号UID用户的进程。Linux内核从2.2版开始将附加于超级用户的权限分割为多个独立单元 , 这些单元是线程级别的 , 它们可配置在每个线程之上 , 为其赋予特定的管理能力。Linux内核常用的功能包括但不限于如下这些。
CAP_CHOWN: 改变文件的UID和GID。CAP_MKNOD: 借助系统调用mknod()创建设备文件。CAP_NET_ADMIN:网络管理相关的操作 , 可用于管理网络接口、netfilter上的iptables规则、路由表、透明代理、TOS、清空驱动统计数据、设置混杂模式和启用多播功能等。CAP_NET_BIND_SERVICE: 绑定小于1024的特权端口 , 但该功能在重新映射用户后可能会失 效。CAP_NET_RAW: 使用RAW或PACKET类型的套接字 , 并可绑定任何地址进行透明代理。CAP_SYS_ADMIN: 支持内核上的很大一部分管理功能。CAP_SYS_BOOT: 重启系统。CAP_SYS_CHROOT: 使用chroot()进行根文件系统切换 , 并能够调用setns()修改Mount名称 空间。CAP_SYS_MODULE: 装载内核模块。CAP_SYS_TIME: 设定系统时钟和硬件时钟。CAP_SYSLOG: 调用syslog()执行日志相关的特权操作等。
系统管理员可以通过get命令获取程序文件上的内核功能 , 并可使用setcap命令为程序文件设定内核功能或取消(-r选项)其已有的内核功能。而为Kubernetes上运行的进程设定内核功能则 需要在Pod内容器上的安全上下文中嵌套capabilities字段 , 添加和移除内核能力还需要分别在下 一级嵌套中使用add或drop字段。这两个字段可接受以内核能力名称为列表项 , 但引用各内核能力名称时需移除CAP_前缀 , 例如可使用NET_ADMIN和NET_BIND_SERVICE这样的功能名称。
下面的配置清单(securitycontext-capabilities-demo.yaml)中定义的Pod对象的demo容器 , 在安全上下文中启用了内核功能NET_ADMIN , 并禁用了CHOWN。demo容器的镜像未定义USER指 令 , 它将默认以root用户的身份运行容器应用。
apiVersion: v1
kind: Pod
metadata:
  name: securitycontext-capabilities-demo
  namespace: default
spec:
  containers:
  - name: demo
    image: ikubernetes/demoapp:v1.0
    imagePullPolicy: IfNotPresent
    command: ["/bin/sh","-c"]
    args: ["/sbin/iptables -t nat -A PREROUTING -p tcp --dport 8080 -j  REDIRECT --to-port 80 && /usr/bin/python3 /usr/local/bin/demo.py"]
    securityContext:
      capabilities:
        add: ['NET_ADMIN']
drop: ['CHOWN']容器中的root用户将默认映射为系统上的普通用户 , 它实际上并不具有管理网络接口、 iptables规则和路由表等相关的权限 , 但内核功能NET_ADMIN可以为其开放此类权限。但容器中的 root用户默认就具有修改容器文件系统上的文件从属关系的能力 , 而禁用CHOWN功能则关闭了这种 操作权限。下面创建该Pod对象并运行在集群上 , 来验证清单中的配置。
$ kubectl apply -f securitycontext-capabilities-demo.yaml
pod/securitycontext-capabilities-demo created
而后 , 检查Pod网络名称空间中netfilter之上的规则 , 清单中的iptables命令添加的规则位 于NAT表的PREROUTING链上。下面的命令结果表示iptables命令已然生成的规则 , NET_ADMIN功能 启用成功。
$ kubectl exec securitycontext-capabilities-demo -- iptables -t nat -nL PREROUTING
Chain PREROUTING (policy ACCEPT)
target     prot    opt    source      destination
REDIRECT   tcp  --  0.0.0.0/0         0.0.0.0/0       tcp dpt:8080 redir ports 80
接着 , 下面用于检查demo容器中的root用户是否能够修改容器文件系统上文件的属主和属组 的命令结果表示 , 其CHOWN功能已然成功关闭。
$ kubectl exec securitycontext-capabilities-demo -- chown 200.200 /etc/hosts
chown: /etc/hosts: Operation not permitted
command terminated with exit code 1
内核的各项功能均可按其原本的意义在容器的安全上下文中按需打开或关闭 , 但SYS_ADMIN功能拥有内核中的许多管理权限 , 实在太过强大 , 出于安全方面的考虑 , 用户应该基于最小权限法 则组合使用内核功能完成容器运行。
6.4 特权模式容器
相较于内核功能 , SYS_ADMIN赋予了进程很大一部分的系统级管理功能 , 特权(privileged) 容器几乎将宿主机内核的完整权限全部开放给了容器进程 , 它提供的是远超SYS_ADMIN的授权 , 包括写操作到/proc和/sys目录以及管理硬件设备等 , 因而仅应该用到基础架构类的系统级管理容器之上。例如 , 使用kubeadm部署的集群中 , kube-proxy中的容器就运行于特权模式。
提示 : 我们可以将特权容器理解为拥有宿主机
root用户权限的容器 , 这显然严重违背了容器的隔离 原则。
下面的第一个命令从kube-system名称空间中取出一个kube-proxy相关的Pod对象名称 , 第二个命令则用于打印该Pod对象的配置清单 , 限于篇幅 , 这里仅列出了其中一部分内容:
~$ pod-name=$(kubectl get pods -l k8s-app=kube-proxy -n kube-system -o jsonpath={.items[0].metadata.name})
~$ kubectl get pods $pod-name -n kube-system -o yaml
#从命令结果中截取的启动容器应用的命令及传递的参数
containers:
  - command:
    - /usr/local/bin/kube-proxy
    - --config=/var/lib/kube-proxy/config.conf
    - --hostname-override=$(NODE_NAME)
    image: ……
    imagePullPolicy: IfNotPresent
    name: kube-proxy
    resources: {}
    securityContext:
      privileged: true
上面保留的命令结果的最后两行是定义特权容器的格式 , 唯一用到的privileged字段只能嵌套在容器的安全上下文中 , 它使用布尔型值 , true表示启用特权容器机制。
6.5 在Pod上使用sysctl
Linux系统上的sysctl接口允许在运行时修改内核参数 , 管理员可通过/proc/sys/下的虚拟文件系统接口来修改或查询这些与内核、网络、虚拟内存或设备等各子系统相关的参数。Kubernetes也允许在Pod上独立安全地设置支持名称空间级别的内核参数 , 它们默认处于启用状态 , 而节点级别内核参数则被认为是不安全的 , 它们默认处于禁用状态。
截至目前 , 仅kernel.shm_rmid_forced、net.ipv4.ip_local_port_range和 net.ipv4.tcp_syncookies这3个内核参数被Kubernetes视为安全参数 , 它们可在Pod安全上下文的 sysctl参数内嵌套使用 , 而余下的绝大多数的内核参数都是非安全参数 , 需要管理员手动在每个 节点上通过kubelet选项逐个启用后才能配置到Pod上。例如 , 在各工作节点上编辑/etc/default/kubelet文件 , 添加如下内容以允许在Pod上使用指定的两个非安全的内核参数 , 并重启kubelet服务使之生效。
KUBELET_EXTRA_ARGS='--allowed-unsafe-sysctls=net.core.somaxconn,net.ipv4.ip_unprivileged_port_start' net.core.somaxconn参数定义了系统级别入站连接队列最大长度 , 默认值是128 ; 而 net.ipv4.ip_unprivileged_port_start参数定义的是非特权用户可以使用的内核端口起始值 , 默认为1024 , 它限制了非特权用户所能够使用的端口范围。
下面配置清单(securitycontext-sysctls-demo.yaml)中定义的Pod对象在安全上下文中通过sysctls字段嵌套使用了一个安全的内核参数kernel.shm_rmid_forced , 以及一个已经启用的非安全内核参数net.ipv4.ip_unprivileged_port_start , 它将该非安全内核参数的值设置为0来允许非特权用户使用1024以内端口的权限。
apiVersion: v1
kind: Pod
metadata:
  name: securitycontext-sysctls-demo
  namespace: default
spec:
  securityContext:
    sysctls:
    - name: kernel.shm_rmid_forced
      value: "0"
    - name: net.ipv4.ip_unprivileged_port_start
      value: "0"
  containers:
  - name: demo
    image: ikubernetes/demoapp:v1.0
    imagePullPolicy: IfNotPresent
    securityContext:
      runAsUser: 1001
runAsGroup: 1001尽管上面配置清单设定了以非特权用户1001的身份运行容器应用 , 但受上面内核参数的影 响 , 非管理员用户也具有了监听80端口的权限 , 因而不会遇到无法监听特权端口的情形。下面将配置清单中定义的资源创建在集群之上 , 来验证设定的结果。
~$ kubectl apply -f securitycontext-sysctls-demo.yaml
pod/securitycontext-sysctls-demo created
下面的命令结果显示 , 以普通用户身份运行的demo容器成功监听了TCP协议的80端口。
~ $ kubectl exec securitycontext-sysctls-demo -- netstat -tnlp
Active Internet connections (only servers)
Proto Recv-Q Send-Q Local Address  Foreign Address    State   PID/Program name
tcp        0      0 0.0.0.0:80        0.0.0.0:*      LISTEN    1/python3
需要提醒读者朋友注意的是 , 在Pod对象之上启用非安全内核参数 , 其配置结果可能会存在无法预料的结果 , 在正式使用之前一定要经过充分测试。例如 , 在某一Pod之上同时配置启用前面示例的两个非安全内核参数可能存在生效结果异常的情况 , 感兴趣的朋友可自行测试。
本节中介绍了设置Pod与容器安全上下文配置方法及几种常用使用方式。从示例中我们可以看出 , 设置特权容器和添加内核功能等 , 以及在Pod上共享宿主机的Network和PID名称空间等 , 对于多项目或多团队共享的Kubernetes集群存在着不小的安全隐患 , 这就要求管理员应该在集群级别使用Pod安全策略(PodSecurityPolicy) , 来精心管控这些与安全相关配置的运用能力。
7. 资源需求与资源限制
容器在运行时具有多个维度 , 例如内存占用、CPU占用和其他资源的消耗等。每个容器都应该声明其资源需求 , 并将该信息传递给管理平台。这些资源需求信息会在CPU、内存、网络、磁盘等维度对平台执 行调度、自动扩展和容量管理等方面影响编排工具的决策。
7.1 资源需求与限制
在Kubernetes上 , 可由容器或Pod请求与消费的“资源”主要是指 CPU和内存(RAM) , 它可统称为计算资源 , 另一种资源是事关可用存储卷空间的存储资源。
相比较而言 , CPU属于可压缩型资源 , 即资源额度可按需弹性变化 , 而内存(当前)则是不可压缩型资源 , 对其执行压缩操作可能会导致某种程度的问题 , 例如进程崩溃等。目前 , 资源隔离仍属于容器级别 , CPU和内存资源的配置主要在Pod对象中的容器上进行 , 并且每个资源存在如图所示的需求和限制两种类型。为了表述方便 , 人 们通常把资源配置称作Pod资源的需求和限制 , 只不过它是指Pod内所有容器上的某种类型资源的请求与限制总和。
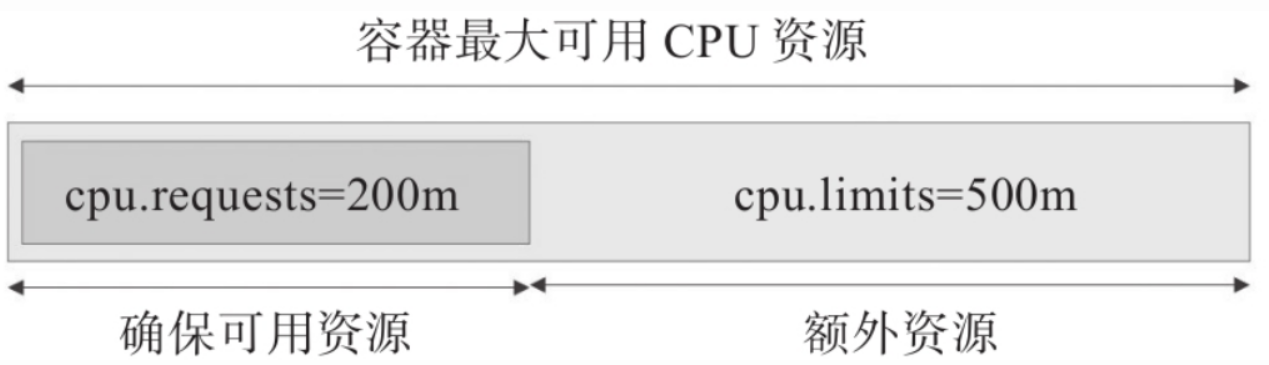
资源需求 : 定义需要系统预留给该容器使用的资源最小可用值 , 容器运行时可能用不到这些额度的资源 , 但用到时必须确保有相应数 量的资源可用。
资源限制 : 定义该容器可以申请使用的资源最大可用值 , 超出该额度的资源使用请求将被拒绝 ; 显然 , 该限制需要大于等于
requests的值 , 但系统在某项资源紧张时 , 会从容器回收超出request值的那部分。
在Kubernetes系统上 , 1个单位的CPU相当于虚拟机上的1颗虚拟 CPU(vCPU)或物理机上的一个超线程(Hyperthread , 或称为一个逻 辑CPU) , 它支持分数计量方式 , 一个核心(1 core)相当于1000个微核心(millicores , 以下简称为m) , 因此500m相当于是0.5个核心 , 即1/2个核心。内存的计量方式与日常使用方式相同 , 默认单位是字节 , 也可以使用E、P、T、G、M和K为单位后缀 , 或Ei、Pi、Ti、Gi、 Mi和Ki形式的单位后缀。
7.2 容器资源需求
下面的配置清单示例(resource-requests-demo.yaml)中的自主式Pod要求为stress容器确保128MiB的内存及1/5个CPU核心(200m)资源可用。Pod运行stress-ng镜像启动一个进程(-m 1)进行内存性能 压力测试 , 满载测试时stress容器也会尽可能多地占用CPU资源 , 另外再启动一个专用的CPU压力测试进程(-c 1)。stress-ng是一个多功能系统压力测试具 , master/worker模型 , master为主进程 , 负载生成 和控制子进程 , worker是负责执行各类特定测试的子进程 , 例如测试 CPU的子进程 , 以及测试RAM的子进程等。
apiVersion: v1
kind: Pod
metadata:
  name: stress-pod
spec:
  containers:
  - name: stress
    image: ikubernetes/stress-ng
    command: ["/usr/bin/stress-ng", "-m 1", "-c 1", "--metrics-brief"]
    resources:
      requests:
        memory: "128Mi"
        cpu: "200m"
上面的配置清单中 , stress容器请求使用的CPU资源大小为200m , 这意味着一个CPU核心足以确保其以期望的最快方式运行。另外 , 配置清单中期望使用的内存大小为128MiB , 不过其运行时未必真的会用到这么多。考虑到内存为非压缩型资源 , 当超出时存在因OOM被杀死的可能性 , 于是请求值是其理想中使用的内存空间上限。
接下来创建并运行此Pod对象以对其资源限制效果进行检查。因为显示结果涉及资源占用比例等 , 因此同样的测试配置对不同的系统环境来说 , 其结果也会有所不同 , 作者为测试资源需求和资源限制功能 而使用的系统环境中 , 每个节点的可用CPU核心数为8 , 物理内存空间 为16GB。
~$ kubectl create -f resource-requests-demo.yaml而后在Pod资源的容器内运行top命令 , 观察CPU及内存资源占用状态 , 如下所示。其中{stress-ng-vm}是执行内存压测的子进程 , 它默认使用256MB的内存空间 , {stress-ng-cpu}是执行CPU压测的专用子进程。
~$ kubectl exec stress-pod -- top
Mem: 5985904K used, 1997700K free, 6200K shrd, 179800K buff, 4658180K cached
CPU:  25% usr   0% sys   0% nic  74% idle   0% io   0% irq   0% sirq
Load average: 1.67 0.68 0.30 3/486 15
  PID  PPID USER     STAT   VSZ %VSZ CPU %CPU COMMAND
    7     1 root     R     6900   0%   1  13% {stress-ng-cpu} /usr/bin/stress-ng
    9     8 root     R     262m   3%   5  12% {stress-ng-vm} /usr/bin/stress-ng
    1     0 root     S     6260   0%   5   0% /usr/bin/stress-ng -m 1 -c 1 --met
    8     1 root     S     6260   0%   3   0% {stress-ng-vm} /usr/bin/stress-ng
10 0 root R 1520 0% 0 0% toptop命令的输出结果显示 , 每个测试进程的CPU占用率为13%(实际 12.5%) , {stress-ng-vm}的内存占用量为262MB(VSZ) , 此两项资源 占用量都远超其请求的用量 , 原因是stress-ng会在可用范围内尽量多地占用相关的资源。两个测试线程分布于两个CPU核心 , 以满载的方式 运行 , 系统共有8个核心 , 因此其使用率为25%(2/8)。另外 , 节点上的内存资源充裕 , 所以 , 尽管容器的内存用量远超128MB , 但它依然可以运行。一旦资源紧张时 , 节点仅保证该容器有1/5个CPU核心(其需求中的定义)可用。在有着8个核心的节点上来说 , 它的占用率为 2.5% , 于是每个进程占比为1.25% , 多占用的资源会被压缩。内存为非可压缩型资源 , 该Pod对象在内存资源紧张时可能会因OOM被杀死。
对于压缩型的资源CPU来说 , 若未定义容器的资源请求用量 , 以确保其最小可用资源量 , 该Pod占用的CPU资源可能会被其他Pod对象压缩至极低的水平 , 甚至到该Pod对象无法被调度运行的境地。而对于非压缩型内存资源来说 , 资源紧缺情形下可能导致相关的容器进程被杀 死。因此 , 在Kubernetes系统上运行关键型业务相关的Pod时 , 必须要使用requests属性为容器明确定义资源需求。当然 , 我们也可以为Pod 对象定义较高的优先级来改变这种局面。
集群中的每个节点都拥有定量的CPU和内存资源 , 调度器将Pod绑定至节点时 , 仅计算资源余量可满足该Pod对象需求量的节点才能作为该Pod运行的可用目标节点。也就是说 , Kubernetes的调度器会根据容器的requests属性定义的资源需求量来判定哪些节点可接收并运行相 关的Pod对象 , 而对于一个节点的资源来说 , 每运行一个Pod对象 , 该 Pod对象上所有容器requests属性定义的请求量都要给予预留 , 直到节点资源被绑定的所有Pod对象瓜分完毕为止。
7.3 容器资源限制
容器为保证其可用的最少资源量 , 并不限制可用资源上限 , 因此对应用程序自身Bug等多种原因导致的系统资源被长时间占用无计可施 , 这就需要通过资源限制功能为容器定义资源的最大可用量。一旦定义资源限制 , 分配资源时 , 可压缩型资源CPU的控制阀可自由调节 , 容器进程也就无法获得超出其CPU配额的可用值。但是 , 若进程申请使用超出limits属性定义的内存资源时 , 该进程将可能被杀死。不过 , 该进程随后仍可能会被其控制进程重启 , 例如 , 当Pod对象的重启策略为Always或OnFailure时 , 或者容器进程存在有监视和管理功能的父进程等。
下面的配置清单文件(resource-limits-demo.yaml)中定义使用 simmemleak镜像运行一个Pod对象 , 它模拟内存泄漏操作不断地申请使 用内存资源 , 直到超出limits属性中memory字段设定的值而被杀死。
apiVersion: v1
kind: Pod
metadata:
  name: memleak-pod
  labels:
    app: memleak
spec:
  containers:
  - name: simmemleak
    image: ikubernetes/simmemleak
    imagePullPolicy: IfNotPresent
    resources:
      requests:
        memory: "64Mi"
        cpu: "1"
      limits:
        memory: "64Mi"
cpu: "1"下面将配置清单中定义的Pod对象创建到集群中 , 测试资源限制的实施效果。
~$ kubectl apply -f resource-limits-demo.yaml
pod/memleak-pod created Pod资源的默认重启策略为Always , 于是在simmemleak容器因内存 资源达到硬限制而被终止后会立即重启 , 因此用户很难观察到其因OOM而被杀死的相关信息。不过 , 多次因内存资源耗尽而重启会触发 Kubernetes系统的重启延迟机制(退避算法) , 即每次重启的时间间 隔会不断地拉长 , 因而用户看到Pod对象的相关状态通常为 CrashLoopBackOff。
~$ kubectl get pods -l app=memleak
NAME      READY     STATUS      RESTARTS   AGE
memleak-pod 0/1 CrashLoopBackOff 1 24s 我们可通过Pod对象的详细描述了解其相关状态 , 例如下面的命令及部分结果所 示。
~]$ kubectl describe pods memleak-pod
Name:         memleak-pod
……
Last State:     Terminated
      Reason:       OOMKilled
      Exit Code:    137
      Started:      Mon, 31 Aug 2020 12:42:50 +0800
      Finished:     Mon, 31 Aug 2020 12:42:50 +0800
    Ready:          False
    Restart Count:  3
……
上面的命令结果中 , OOMKilled表示容器因内存耗尽而被终止 , 因此为limits属性中的memory设置一个合理值至关重要。与资源需求不 同的是 , 资源限制并不影响Pod对象的调度结果 , 即一个节点上的所有 Pod对象的资源限制数量之和可以大于节点拥有的资源量 , 即支持资源的过载使用(overcommitted)。不过 , 这么一来 , 一旦内存资源耗 尽 , 几乎必然地会有容器因OOMKilled而终止。
另外需要说明的是 , Kubernetes仅会确保Pod对象获得它们请求的 CPU时间额度 , 它们能否取得额外(throttled)的CPU时间 , 则取决于 其他正在运行作业的CPU资源占用情况。例如对于总数为1000m的CPU资源来说 , 容器A请求使用200m , 容器B请求使用500m , 在不超出它们各自最大限额的前下 , 则余下的300m在双方都需要时会以2 : 5(200m : 500m)的方式进行配置。
7.4 容器可见资源
细心的读者可能已经发现 , 在容器中运行top等命令观察资源可用量信息时 , 容器可用资源受限于requests和limits属性中的定义 , 但 容器中可见的资源量依然是节点级别的可用总量。例如 , 为前面定义的stress-pod添加如下limits属性定义。
 limits:
    memory: "512Mi"
cpu: "400m"重新创建stress-pod对象 , 并在其容器内分别列出容器可见的内 存和CPU资源总量 , 命令及结果如下所示。
~$ kubectl exec stress-pod -- cat /proc/meminfo | grep ^MemTotal
MemTotal:       16416472 kB
$ kubectl exec stress-pod -- cat /proc/cpuinfo | grep -c ^processor
8命令结果中显示其可用内存资源总量为16416472 kB(16GB) , CPU核心数为8个 , 这是节点级的资源数量 , 而非由容器的limits属性所定义的512MiB和400m。其实 , 这不仅让查看命令的显示结果看起来有些奇怪 , 也会给有些容器应用的配置带来不小的负面影响。
较为典型的是在Pod中运行Java应用程序时 , 若未使用-Xmx选项指定JVM的堆内存可用总量 , 则会默认设置为主机内存总量的一个空间比例(例如30%) , 这会导致容器中的应用程序申请内存资源时很快达到上限 , 而转为OOMKilled状态。另外 , 即便使用了-Xmx选项设置其堆内存上限 , 但该设置对非堆内存的可用空间不产生任何限制作用 , 仍然存在达到容器内存资源上限的可能性。
另一个典型代表是在Pod中运行Nginx应用时 , 其配置参数 worker_processes的值设置为auto , 则会创建与可见CPU核心数量等同 的worker进程数 , 若容器的CPU可用资源量远小于节点所需资源量时 , 这种设置在较大的访问负荷下会产生严重的资源竞争 , 并且会带来更多的内存资源消耗。一种较为妥当的解决方案是使用Downward API将 limits定义的资源量暴露给容器 , 这将在后面的章节中予以介绍
7.5 Pod服务质量类别
前面曾提到 , Kubernetes允许节点的Pod对象过载使用资源 , 这意味着节点无法同时满足绑定其上的所有Pod对象以资源满载的方式运 行。因而在内存资源紧缺的情况下 , 应该以何种次序终止哪些Pod对象就变成了问题。事实上 , Kubernetes无法自行对此做出决策 , 它需要借助于Pod对象的服务质量和优先级等完成判定。根据Pod对象的 requests和limits属性 , Kubernetes把Pod对象归类到BestEffort、 Burstable和Guaranteed这3个服务质量类别(Quality of Service , QoS)类别下。
Guaranteed:Pod对象为其每个容器都设置了CPU资源需求和资源限制 , 且二者具有相同值 ; 同时为每个容器都设置了内存资需求和内存限制 , 且二者具有相同值。这类Pod对象具有最高级别服务质量。Burstable: 至少有一个容器设置了CPU或内存资源的requests属性 , 但不满足Guaranteed类别的设定要求 , 这类Pod对象具有中等级别服务质量。BestEffort: 不为任何一个容器设置requests或limits属性 , 这类Pod对象可获得的服务质量为最低级别。
一旦内存资源紧缺 , BestEffort类别的容器将首当其冲地被终止 , 因为系统不为其提供任何级别的资源保证 , 但换来的好处是 , 它 们能够做到尽可能多地占用资源。若此时系统上已然不存任何 BestEffort类别的容器 , 则接下来将轮到Burstable类别的Pod被终止。Guaranteed类别的容器拥有最高优先级 , 它们不会被杀死 , 除非其内存资源需求超限 , 或者OOM时没有其他更低优先级的Pod对象存在。
每个运行状态的容器都有其OOM评分 , 评分越高越优先被杀死。 OOM评分主要根据两个维度进行计算: 由服务质量类别继承而来的默认分值 , 以及容器的可用内存资源比例 , 而同等类别的Pod对象的默认分值相同。下面的代码片段取自pkg/kubelet/qos/policy.go源码文件 , 它们定义的是各种类别的Pod对象的OOM调节(Adjust)分值 , 即默认分值。其中 , Guaranteed类别Pod资源的Adjust分值为–998 , 而 BestEffort类别的默认分值为1000 , Burstable类别的Pod资源的 Adjust分值经由相应的算法计算得出。
const (
    PodInfraOOMAdj        int = -998
    KubeletOOMScoreAdj    int = -999
    DockerOOMScoreAdj     int = -999
    KubeProxyOOMScoreAdj  int = -999
    guaranteedOOMScoreAdj int = -998
    besteffortOOMScoreAdj int = 1000
)
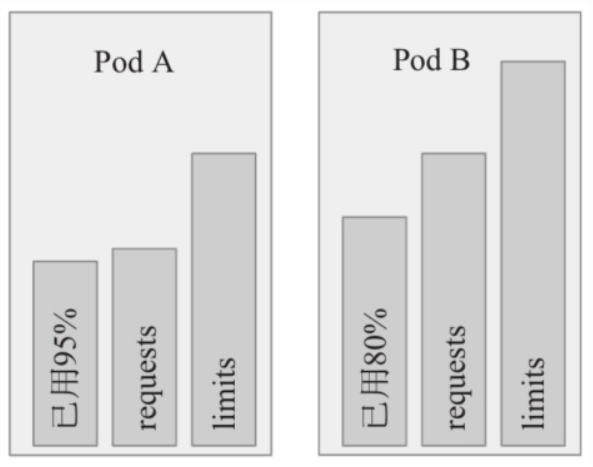
因此 , 同等级别优先级的Pod资源在OOM时 , 与自身的requests属性相比 , 其内存占用比例最大的Pod对象将先被杀死。例如 , 图中 的同属于Burstable类别的Pod A将先于Pod B被杀死 , 虽然其内存用量小 , 但与自身的requests值相比 , 它的占用比例为95% , 要大于Pod B 的80%。
8. 综合应用案例
下面的配置清单(all-in-one.yaml)中定义的Pod对象all-in one将前面的用到的大多数配置整合在一起: 它有一个初始化容器和两 个应用容器 , 其中sidecar-proxy为Sidecar容器 , 负责为主容器demo 代理服务客户端请求。
apiVersion: v1
kind: Pod
metadata:
  name: all-in-one
  namespace: default
spec:
  initContainers:
  - name: iptables-init
    image: ikubernetes/admin-box:latest
    imagePullPolicy: IfNotPresent
    command: ['/bin/sh','-c']
    args: ['iptables -t nat -A PREROUTING -p tcp --dport 8080 -j REDIRECT --to-port 80']
    securityContext:
      capabilities:
        add:
        - NET_ADMIN
  containers:
  - name: sidecar-proxy
    image: envoyproxy/envoy-alpine:v1.13.1
    command: ['/bin/sh','-c']
    args: ['sleep 3 && envoy -c /etc/envoy/envoy.yaml']
    lifecycle:
      postStart:
        exec:
          command: ['/bin/sh','-c','wget -O /etc/envoy/envoy.yaml https://raw.githubusercontent.com/iKubernetes/Kubernetes_Advanced_Practical_2rd/master/chapter4/envoy.yaml']
    livenessProbe:
      tcpSocket:
        port: 80
      initialDelaySeconds: 5
    readinessProbe:
      tcpSocket:
        port: 80
      initialDelaySeconds: 5
  - name: demo
    image: ikubernetes/demoapp:v1.0
    imagePullPolicy: IfNotPresent
    env:
    - name: PORT
      value: '8080'
    livenessProbe:
      httpGet:
        path: '/livez'
        port: 8080
      initialDelaySeconds: 5
    readinessProbe:
      httpGet:
        path: '/readyz'
        port: 8080
      initialDelaySeconds: 15
    securityContext:
      runAsUser: 1001
      runAsGroup: 1001
    resources:
      requests:
        cpu: 0.5
        memory: "64Mi"
      limits:
        cpu: 2
        memory: "1024Mi"
  securityContext:
    supplementalGroups: [1002, 1003]
fsGroup: 2000配置清单的Pod对象的各容器中 , 主容器demo在Pod的IP地址上监听TCP协议的8080端口 , 以接收并响应HTTP请求 ; Sidecar容器 sidecar-proxy监听TCP协议的80端口 , 接收HTTP请求并将其代理至 demo容器的8080端口 ; 初始化容器在Pod的Network名称空间中添加了 一条iptables重定向规则 , 该规则负责把所有发往Pod IP上8080端口 的请求重定向至80端口 , 因而demo容器仅能从127.0.0.1的8080端口接 收到请求。读者朋友可将清单中的Pod对象创建到集群上 , 并逐一测试其各项配置的效果。