
2-1-logstash配置详解
1. 文件结构
先来看看logstash的配置文件结构 , 配置文件分为3部分 ,input输入 , filter过滤 , output输出。配置文件是以{} 来定义区段的。
input { }
filter { }
output { }
顾名思义 , 它们分别表示logstash的输入来源 , 输入来源可以是文件 , filebeat等等。filter则是定义对输入源内容进行二次处理 , 过滤提取等等。outpout则是将处理后的内容重新输出到其他组件 , 比如elasticsearch或者通过http接口输出到自定义服务中。
2. 插件
在每一个区段内 , 可以引入logstash的插件 , 插件的配置同样也是用{}包裹起来的。如下 , 我在input区域内部定义了stdin和syslog插件。
input { stdin {} syslog {} }不过通常在filebeat和logstash搭配使用时 , 通常是将logstash的输入来源定义为filebeat的插件,如下
input {
  beats {
    port => 5044
  }
}而filebeat的配置文件中 , 则是将输出源设置为logstash,如下是filebeat的部分配置文件示例 ,
output.logstash:
  hosts:  192.168.0.2:5054
不同的插件具体有哪些配置 , 有哪些插件可以使用 , 参考官方文档 https://www.elastic.co/guide/en/logstash/current/plugins-inputs-beats.html
3. 语法规则
3.1 声明复制变量
在配置文件中 , 赋值一个变量使用的是=>符号 , 像前面提到把输入源定义为filebeat时 , 就将port变量赋值为5044了。
port => 5044除了数值类型 , logstash还会有字符串 , 布尔 , 数组 , hash类型 , 它们写法如下 ,
字符串类型
host =>"hostname"布尔类型
debug => true数组类型
match => ["datetime", "UNIX", "ISO8601"]hash类型
options => { key1 =>"value1", key2 =>"value2" }
3.2 引用变量
声明赋值完变量后 , 如何引用呢 , 在logstash中是通过[]对变量进行引用 , 如下,我声明了一个变量debug, 然后引用它。
filter {
 debug => true
}
output {
 if [debug]==true {
  ...
 }
}
如果是那种结构体类型 , 比如json , 或者hash结构 , 那么可以使用多重[]得到其值 , 如下 ,
output {
 options => { key1 =>"value1", key2 =>"value2" }
 if [options][key1]=="2" {
  ...
 }
}
Logstash中也支持倒序下标 , [array][-1]
3.3 内插变量
logstash还支持内插变量 , 如下 , 我在使用elasticsearch插件时 , 需要定义输出的索引名称 , 这个名称是根据日志来源中不同的内容建立不同的索引名称。[fields][log_type]引用的则是出入来源中的变量名。
"My name is %{[name]}"output {
elasticsearch {
hosts => ["http://elasticsearch:9200"]
index => "easymonitor-%{[fields][log_type]}-%{+yyyy.MM.dd}"
}
}4. 条件判断
其实在介绍变量引用的时候 , 你应该已经看到if语句 , 除此以外if else语句也是支持的。如下所示 ,
if "_grokparsefailure" not in [tags] {
 ...
} else if [status] !~ /^2\d\d/ and [url] == "/noc.gif" {
 ...
} else {
 ...
}logstash支持的判断表达式包括
比较大小: ==, !=, <, >, <=, >= ·
正则: =~, !~
包含关系: in, not in
布尔表达式: and, or, nand(非与), xor(非或)
对表达式取反操作: !( 表达式) 注意logstash是不支持&& 和 || 表示并且和或关系的 , 应该用and和or代替。
4.1 条件表达式定义多个输出源
使用条件表达式 , 在条件表达式中定义不同的输出插件 , 达到根据不同内容输出到不同组件的目的 , 以下是配置案例 , 通过判断日志的等级 , 等级为error或者日志类型是es的日志时 , 则输出到报警服务中。
output {
   elasticsearch {
    hosts => ["http://elasticsearch:9200"]
    index => "easymonitor-%{[fields][log_type]}-%{+yyyy.MM.dd}"
  }

  if [loglevel] == "Error" or  [fields][log_sub_type]=="es"  {

    http {
           http_method => "post"
           url => "http://192.168.0.2:36060/alert_log"
        }
  }
}
5. logstash配置详解
5.1 input
5.1.1 标准的控制台输入
input {
    stdin { }
}
5.1.2 接收来自文件的内容
Logstash使用一个名叫 FileWatch 的 Ruby Gem库来监听文件变化。这个库支持glob展开文件路径 , 而且会记录一个叫.sincedb 的数据库文件来跟踪被监听的日志文件的当前读取位置。所以不要担心logstash会漏过你的数据。
sincedb 文件中记录了每个被监听的文件的inode, major number, minor number 和 pos 。
input {
    file {
        path => ["/var/log/*.log", "/var/log/message"]
        type => "system"
        start_position => "beginning"
    }
}
配置说明 :
discover_interval logstash: 每隔多久去检查一次被监听的path下是否有新文件。默认值是15秒。exclude: 剔除不想监听的文件 , 这里和path一样支持glob。close_older: 一个已经监听中的文件 , 如果超过这个值的时间内没有更新内容 , 就关闭监听它的文件句柄。默认为3600s, 一个小时。ignore_older: 在每次检查文件列表的时候 , 如果一个文件的最后修改时间超过这个值 , 就忽略这个文件。默认为86400s, 一天。sincedb_path: 设置sincedb的文件存储位置 , windows默认在C:\Windows\System32\config\systemprofile\.sincedbsincedb_write_interval logstash: 每隔多久写一次sincedb文件 , 默认是15秒stat_interval:logstash: 每隔多久检查一次被监听文件状态( 是否有更新) , 默认是 1 秒。start_position:logstash从什么位置开始读取文件数据 , 默认是end(结束位置) , 也就是说logstash进程会以类似tail -F的形式运行。如果你是要导入原有数据 , 把这个设定改成"beginning",logstash进程就从头开始读取 , 类似less +F的形式运行。
注意:
如果想修改
@timestamp, 那么需要通过配置过滤器来设置。FileWatch仅支持文件的绝对路径 , 不会自动的递归目录 , 所以如果监听父目录和子目录 , 都需要在数组中明确地写出来。如果想递归多级目录可以这样写 ,
/path/to/**/*.log,用**来缩写表示递归全部子目录。start_position仅在该文件从未被监听过的时候起作用。如果sincedb文件中已经有这个文件的inode记录了 , 那么logstash依然会从记录过的pos开始读取数据。所以重复测试的时候每回需要删除sincedb文件(官方博客上提供了另一个巧妙的思路 : 将sincedb_path定义为/dev/null, 则每次重启自动从头开始读)。
5.1.3 接收来自beat 的数据
例如filebeat
input {
    # 配置filebeat
    beats {
        port => 10515
    }
}
结合filebeat使用 : 一个完整的示例
设置
filebeat的配置文件输出到logstashfilebeat.yml添加/修改#----------------------------- Logstash output -------------------------------- output.logstash: # The Logstash hosts hosts: ["127.0.0.1:10515"]启动
filebeat./filebeat -e -c filebeat.yml -d "publish"创建
logstash启动配置文件:filebeat10515.confinput { # 配置filebeat beats { port => 10515 } } filter { } output { # 配置输出到文件中 file{ path=>"/home/shaofei/output/output.log" } #配置输出到控制台 stdout{ codec=>rubydebug } }启动
logstashbin/logstash -f config/filebeat10515.conf测试
手动模拟向
filebeat监听的文件输入关键词信息 , 观察filebeat控制台输出 和logstash控制台输出
filebeat控制台输出


2021-07-07T22:27:42.534+0800    DEBUG    [publish]    pipeline/processor.go:308    Publish event: {
  "@timestamp": "2021-07-07T14:27:37.529Z",
  "@metadata": {
    "beat": "filebeat",
    "type": "doc",
    "version": "6.4.3"
  },
  "host": {
    "name": "node01"
  },
  "offset": 0,
  "source": "/home/shaofei/logs/javaException.log",
  "tags": [
    "tags1",
    "tags2"
  ],
  "prospector": {
    "type": "log"
  },
  "input": {
    "type": "log"
  },
  "message": "2020-08-04 23:39:27.213 ERROR [francis,76fc4531346b63e2,76fc4531346b63e2,false] 16121 --- [nio-8089-exec-8] com.example.demo.aspect.LogAspect        : com.example.demo.controller.StudentController.testError 请求异常 ,  原因 : \n\njava.lang.ArithmeticException: / by zero\n        at com.example.demo.controller.StudentController.testError(StudentController.java:48)\n        at com.example.demo.controller.StudentController8368FastClassBySpringCGLIB83687356fabf.invoke(<generated>)\n        at org.springframework.cglib.proxy.MethodProxy.invoke(MethodProxy.java:218)\n        at org.springframework.aop.framework.CglibAopProxy.invokeJoinpoint(CglibAopProxy.java:769)\n        at org.springframework.aop.framework.ReflectiveMethodInvocation.proceed(ReflectiveMethodInvocation.java:163)\n        at org.springframework.aop.framework.CglibAopProxy.proceed(CglibAopProxy.java:747)\n",
  "fields": {
    "review": 1,
    "name": "shaofei",
    "level": "debug",
    "env": "staging"
  },
  "beat": {
    "name": "node01",
    "hostname": "node01",
    "version": "6.4.3"
  }
}


logstash控制台输出


{
       "message" => "2020-08-04 23:39:27.213 ERROR [francis,76fc4531346b63e2,76fc4531346b63e2,false] 16121 --- [nio-8089-exec-8] com.example.demo.aspect.LogAspect        : com.example.demo.controller.StudentController.testError 请求异常 ,  原因 : \n\njava.lang.ArithmeticException: / by zero\n        at com.example.demo.controller.StudentController.testError(StudentController.java:48)\n        at com.example.demo.controller.StudentController8368FastClassBySpringCGLIB83687356fabf.invoke(<generated>)\n        at org.springframework.cglib.proxy.MethodProxy.invoke(MethodProxy.java:218)\n        at org.springframework.aop.framework.CglibAopProxy.invokeJoinpoint(CglibAopProxy.java:769)\n        at org.springframework.aop.framework.ReflectiveMethodInvocation.proceed(ReflectiveMethodInvocation.java:163)\n        at org.springframework.aop.framework.CglibAopProxy.proceed(CglibAopProxy.java:747)\n",
        "fields" => {
         "level" => "debug",
        "review" => 1,
          "name" => "shaofei",
           "env" => "staging"
    },
        "source" => "/home/shaofei/logs/javaException.log",
          "beat" => {
         "version" => "6.4.3",
            "name" => "node01",
        "hostname" => "node01"
    },
         "input" => {
        "type" => "log"
    },
          "tags" => [
        [0] "tags1",
        [1] "tags2",
        [2] "beats_input_codec_plain_applied"
    ],
    "prospector" => {
        "type" => "log"
    },
          "host" => {
        "name" => "node01"
    },
    "@timestamp" => 2021-07-07T14:27:37.529Z,
      "@version" => "1",
        "offset" => 0
}
5.2 filter
过滤器插件(Filter)
丰富的过滤器插件的存在是logstash威力如此强大的重要因素。 名为过滤器 , 其实提供的不单单是过滤的功能。在本章我们就会重点介绍几个插件 , 它们扩展了进入过滤器的原始数据 , 进行复杂的逻辑处理 , 甚至可以无中生有的添加新的 logstash 事件到后续的流程中去!
5.2.1 json
有些日志可能是一种复合的数据结构 , 其中只是一部分记录是JSON格式的。这时候 , 我们依然需要在filter阶段 , 单独启用JSON解码插件。
配置示例
filter {
    json {
        source => "message"
        target => "jsoncontent"
    }
}
当我们输入一下内容时
{"id":"1","ITV":"5312000222215"}运行结果为
{
    "jsoncontent" => {
        "ITV" => "5312000222215",
         "id" => "1"
    },
     "@timestamp" => 2021-07-07T16:14:08.665Z,
        "message" => "{\"id\":\"1\",\"ITV\":\"5312000222215\"}",
       "@version" => "1",
           "host" => "node01"
}
注意
如果不打算使用多层结构的话 , 删掉target配置即可。新的结果如下 :
这样可以实现数据完全透传 , 不需要加一层message
{
    "@timestamp" => 2021-07-07T16:16:27.986Z,
      "@version" => "1",
       "message" => "{\"id\":\"1\",\"ITV\":\"5312000222215\"}",
           "ITV" => "5312000222215",
          "host" => "node01",
            "id" => "1"
}
5.2.2 kv
Key-Value 切分
在很多情况下 , 日志内容本身都是一个类似于key-value的格式 , 但是格式具体的样式却是多种多样的。logstash 提供filters/kv插件 , 帮助处理不同样式的key-value日志 , 变成实际的LogStash::Event数据。
配置示例
input {
    # 配置filebeat
    beats {
        port => 10515
    }
    stdin { }
}

filter {
    kv {
        field_split => "&?"
    }
}

output {
    # 配置输出到文件中
    file{
       path=>"/home/shaofei/output/output.log"
    }


    #配置输出到控制台
    stdout{
        codec=>rubydebug
    }
}
使用示例
输入
http://127.0.0.1:9020/main/shandong/user/userorderquery/queryorder_init.action?UserID=531200442112&UserToken=03172910597510641278820924115047输出
{
        "UserID" => "531200442112",
     "UserToken" => "03172910597510641278820924115047",
    "@timestamp" => 2021-07-07T16:24:15.996Z,
      "@version" => "1",
          "host" => "node01",
       "message" => "http://127.0.0.1:9020/main/shandong/user/userorderquery/queryorder_init.action?UserID=531200442112&UserToken=03172910597510641278820924115047"
}
5.2.3 时间处理(Date)
5.2.3.1 基础用法
filters/date 插件可以按指定的时间格式读取事件的指定字段值后 , 赋值给指定的字段(默认为@timestamp)。
日期过滤器用于解析字段中的日期 , 然后使用该日期或时间戳作为事件的logstash时间戳。
syslog事件通常具有如下时间戳:
"Apr 17 09:32:01"您可以使用日期格式MMM dd HH:mm:ss来解析它
日期过滤器对于排序事件和回填旧数据尤其重要。如果你在活动中没有得到正确的日期 , 那么稍后搜索它们可能会出现问题。 在没有此过滤器的情况下 , 如果时间戳尚未在事件中设置 , logstash将根据第一次看到事件的时间(在输入时间)选择时间戳。例如 , 对于文件输入 , 时间戳被设置为每次读取的时间。
match按指定的时间格式格式化指定字段 , 可以指定多个时间格式 , 参数为
[ field, formats... ]match => [ "logdate", "yyyy-MM-dd HH:mm:ss", "yyyy-MM-dd", "ISO8601" ] match => [ "logdate", "MMM dd yyyy HH:mm:ss", "MMM d yyyy HH:mm:ss", "ISO8601" ]以上内容将与
syslog(rfc3164)或iso8601时间戳相匹配。有一些特殊的例外。以下格式文字可帮助您节省时间并确保日期解析的正确性。
ISO8601: 应解析任何有效的ISO8601时间戳 , 如2011-04-19T03:44:0.103ZUNIX: 将解析float或int值 , 以秒为单位表示UNIX时间戳格式, 记录的是从1970年起始至今的总秒数。如1326149001.132和1326149001UNIX_MS: 将解析int值 ,UNIX时间戳格式, 记录的是从1970年起始至今的总微秒。如1366125117000TAI64N: 将解析TAI64N时间值
target
将匹配的时间戳赋值给定的目标字段中。默认为赋值给
@timestamp字段。timezone
指定日期解析的时区 , 有效的ID值域在http://joda-time.sourceforge.net/timezones.html可用时区页面上。
logstash会将时间格式化为UTC时间 , 即比北京时间早8小时。如果非要校准该8小时时间差 , 可指定timezone字段为UTC+0的时区。但是不建议这么做 , 因为elasticsearch内部也是使用UTC时间储存时间 , 使用错误的时区会导致需要做额外的时间转换处理。
配置示例
filter {
    grok {
        # 匹配正则表达式 ,  将符合条件的数据赋值给timestamp字段
        match => {  "message" => "(?<timestamp>%{TIMESTAMP_ISO8601})"  }
    }
    date {
        # 匹配时间格式 ,  将timestamp值赋值给 @timestamp  ,  后面的规则可以写多个 ,  示例 : [ "logdate", "MMM dd yyyy HH:mm:ss","MMM  d yyyy HH:mm:ss", "ISO8601" ]
        match => [ "timestamp", "ISO8601" ]
    }
}
输入
2021-02-26 15:48:32.708-[INFO ] main RestfulApiProvider - initializing restful api provider打印
{
          "host" => "node01",
      "@version" => "1",
    "@timestamp" => 2021-02-26T07:48:32.708Z,
       "message" => "2021-02-26 15:48:32.708-[INFO ] main RestfulApiProvider - initializing restful api provider",
     "timestamp" => "2021-02-26 15:48:32.708"
}
注意
logstash中filter中date多个字段需要格式时间 , 只能一个date里边只能一个match和一个target
filter {
    date {
        match => ["message", "yyyyMMddHHmmss"]
        add_field =>["starTime","%{starTime}"]
    }
    date {
        match => ["message", "yyyyMMddHHmmss"]
        add_field =>["endTime","%{endTime}"]
    }


}
filters/date 插件支持五种时间格式 :
ISO8601类似 "
2011-04-19T03:44:01.103Z" 这样的格式。具体Z后面可以有 "08:00"也可以没有, ".103"这个也可以没有。常用场景里来说,Nginx的log_format配置里就可以使用$time_iso8601变量来记录请求时间成这种格式。UNIXUNIX时间戳格式, 记录的是从1970年起始至今的总秒数。Squid的默认日志格式中就使用了这种格式。UNIX_MS这个时间戳则是从
1970年起始至今的总毫秒数。据我所知,JavaScript里经常使用这个时间格式。TAI64NTAI64N格式比较少见, 是这个样子的 :@4000000052f88ea32489532c。我目前只知道常见应用中,qmail会用这个格式。Joda-Time库Logstash内部使用了Java的Joda时间库来作时间处理。所以我们可以使用Joda库所支持的时间格式来作具体定义。Joda时间格式定义见下表 :时间格式
5.2.3.2 时间语法
用于解析日期和时间文本的语法使用字母来指示时间值的类型(月、分钟等) , 并使用字母的重复来指示该值的形式(2位数的月、完整的月名称等)。 以下是您可以用来解析日期和时间的内容 :
y: 年yyyy: 显示年的全部数字。示例:2015.yy: 两个数字的年标识。 示例 :15实际为2015
M: 月份M: 最小数字显示月份。1表示一月, 12表示十二月MM: 始终使用两个数字显示月份。01表示一月,12表示十二月MMM: 月份的单词缩写。Jan表示一月。使用的语言取决于您的语言环境。MMMM: 显示月份的全部单词。January表示一月。使用的语言取决于您的语言环境。
d: 月份中的实际天数d: 以最少数字显示每个月中的天数。1表示每个月的第一天,31表示每个月的第31天dd: 始终以两个数字显示每个月中的所在的天。01表示每个月的第一天
H: 小时(按24小时计算)H: 最少数字显示小时。0表示每天的零点HH: 始终以两个数字显示小时。00表示每天零点
m: 分钟m: 最小数字显示分钟。1表示第一分钟mm: 按照两个数字显示分钟。01表示第一分钟
s: 秒s: 最小数字显示秒。1表示第一秒ss: 按照两个数字显示秒。01表示第一秒
S: 秒的分数最大精度是毫秒(SSS)。除此之外 , 还会附加零。S: 十分之一秒SS: 百分之一秒SSS: 千分之一秒
Z: 时区偏移或标识Z: 时区偏移量结构为HHmm。Zulu/UTC小时和分钟的偏移量。示例:-0700ZZ: 时区偏移量结构为HH:mm。用:将小时和分钟分隔开。示例:-07:00ZZZ: 时区标识。示例:America/Los_Angeles。具体的时区标识可以参考链接: Joda-Time - Java date and time API - Time Zones (sourceforge.net)
z: 时区名称。无法分析时区名称(z)w: 一年中的第几周w: 最小数字显示第几周。1表示一年中的第一周ww: 始终以两个数字显示第几周。01表示一年中的第一周
D: 一年中的第几天e: 一周中的第几天。按照数字显示E: 一周中的第几天。按照文本格式显示E, EE, EEE: 一周中的第几天, 按照文本缩写显示。示例:Mon,Tue,Wed,Thu,Fri,Sat,SunEEEE: 按照文本格式显示完整的天。示例:Monday,Tuesday....
对于非格式语法 , 您需要在值周围放置单引号字符。例如 , 如果您在分析ISO8601时间"2015-01-01T01:12:23" , 那么这个“T”不是有效的时间格式 , 并且您想说“字面上是T” , 那么您的格式将是 : "yyyy-MM-dd'T'HH:MM:ss"
5.2.4 grok
5.2.4.1 grok 基础
Grok的工作原理是将文本模式组合成与日志匹配的内容。
grok的匹配模式: %{SYNTAX:SEMANTIC}。SYNTAX是文本匹配的模式的名称。SEMANTIC是您为匹配的文本提供的标识符。后续这个标识符。同样会出现在收集的日志信息里面。
对于上面的例子 , 你的grok过滤器看起来是这样的:
%{NUMBER:duration} %{IP:client}您可以选择将数据类型转换添加到grok模式中。默认情况下 , 所有语义都保存为字符串。如果您希望转换语义的数据类型。例如 , 将字符串更改为整数 , 然后在其后面加上目标数据类型。例如%{NUMBER:num:int} , 它将num语义从字符串转换为整数。目前唯一支持的转换是int和float。
示例 : 有了语法和语义的想法 , 我们可以从示例日志中提取有用的字段 , 比如这个虚构的http请求日志 :
55.3.244.1 GET /index.html 15824 0.043匹配模式如下:
%{IP:client} %{WORD:method} %{URIPATHPARAM:request} %{NUMBER:bytes} %{NUMBER:duration}一个更现实的例子是 , 让我们从一个文件中读取这些日志 :
   input {
      file {
        path => "/var/log/http.log"
      }
    }
    filter {
      grok {
        match => { "message" => "%{IP:client} %{WORD:method} %{URIPATHPARAM:request} %{NUMBER:bytes} %{NUMBER:duration}" }
      }
}在grok过滤器之后, 该事件将有几个额外的字段:
client: 55.3.244.1method: GETrequest: /index.htmlbytes: 15824duration: 0.043
5.2.4.2 正则表达式
Grok位于正则表达式之上 , 因此任何正则表达式在Grok中也是有效的。正则表达式库是Oniguruma , 您可以在Onigurma网站上看到完全支持的regexp语法。
有时logstash没有您需要的模式。对此 , 您有几个选择。 首先 , 您可以使用Oniguruma语法进行命名捕获 , 这将允许您匹配一段文本并将其保存为字段 :
(?<field_name>the pattern here)例如 , 后缀日志的队列id是一个10或11个字符的十六进制值。我可以像这样轻松地捕捉到 :
(?<queue_id>[0-9A-F]{10,11})或者 , 也可以创建自定义匹配文件。 创建一个名为patterns的目录 , 其中有一个文件名为extra(文件名无关紧要 , 但要为自己命名) 在该文件中 , 将您需要的模式写为模式名称、空格 , 然后是该模式的regexp。 例如 , 如上所述执行后缀队列id示例:
    # contents of ./patterns/postfix:
POSTFIX_QUEUEID [0-9A-F]{10,11}然后使用此插件中的patterns_dir设置来告诉logstash您的自定义模式目录在哪里。下面是一个完整的示例日志:
Jan 1 06:25:43 mailserver14 postfix/cleanup[21403]: BEF25A72965: message-id=<20130101142543.5828399CCAF@mailserver14.example.com> filter {
grok {
patterns_dir => ["./patterns"]
match => { "message" => "%{SYSLOGBASE} %{POSTFIX_QUEUEID:queue_id}: %{GREEDYDATA:syslog_message}" }
}
}以上内容将匹配并产生以下字段:
timestamp:Jan 1 06:25:43logsource:mailserver14program:postfix/cleanuppid:21403queue_id:BEF25A72965syslog_message:message-id=<20130101142543.5828399CCAF@mailserver14.example.com>
timestamp, logsource, program, pid 字段来自SYSLOGBASE模式 , 该模式本身由其他模式定义。
另一种选择是使用pattern_definitions在过滤器中内联定义模式。这主要是为了方便 , 并允许用户定义一个仅可在该过滤器中使用的模式。pattern_definitions中这个新定义的模式在那个特定的grok滤波器之外将不可用。
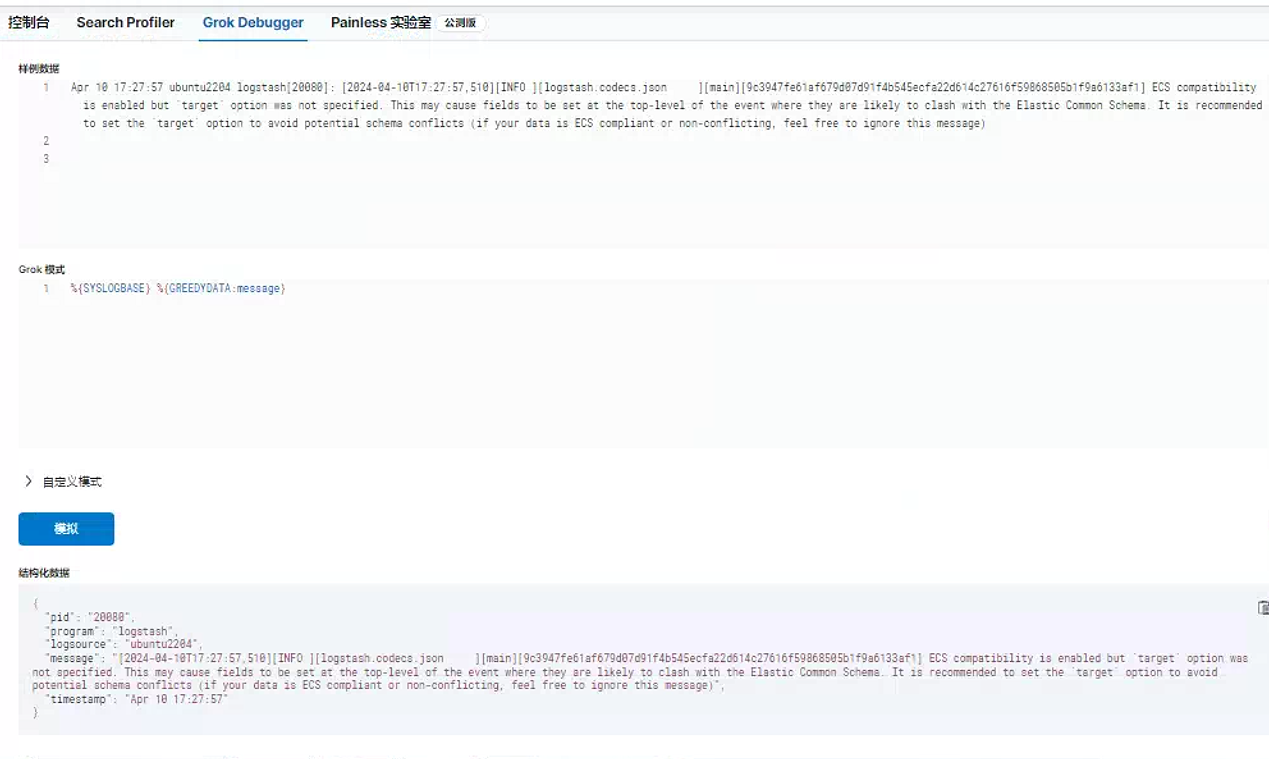
这里可以通过kibana的开发工具-->Grok Debugger中测试匹配模式是否可以正常使用
5.2.4.3 其他说明
Grok是Logstash最重要的插件。你可以在grok里预定义好命名正则表达式 , 在稍后(grok参数或者其他正则表达式里)引用它。
grok中的match属性 , 它的作用是从message字段中把符合正则表达式的数据赋值给另外一个字段 , 所有文本数据都是在Logstash的message字段中 , 我们要在过滤器里操作的数据就是message。grok插件是一个十分耗费资源的插件grok有超级多的预装正则表达式;(可以参考 : https://quxuecx.blog.csdn.net/article/details/118559962)所有预装正则表达式可以参考链接: https://github.com/logstash/logstash/tree/v1.4.2/patterns
可以在grok里写标准的正则 , 像下面这样 :
\s+(?<request_time>\d+(?:\.\d+)?)\s+修改配置文件进行使用
input {stdin{}}
filter {
    grok {
        match => {
            "message" => "\s+(?<request_time>\d+(?:\.\d+)?)\s+"
        }
    }
}
output {stdout{codec => rubydebug}}运行logstash进程然后输入 "begin 123.456 end" , 你会看到类似下面这样的输出 :
{
    "request_time" => "123.456",
         "message" => "begin 123.456 end",
        "@version" => "1",
      "@timestamp" => 2021-07-08T02:43:30.392Z,
            "host" => "node01"
}
实际运用注意点
实际运用中 , 我们需要处理各种各样的日志文件 , 如果你都是在配置文件里各自写一行自己的表达式 , 就完全不可管理了。所以 , 我们建议是把所有的grok表达式统一写入到一个地方。 然后用filter/grok的patterns_dir选项来指明。
如果你把 "message" 里所有的信息都grok到不同的字段了 , 数据实质上就相当于是重复存储了两份。所以你可以用remove_field参数来删除掉message字段 , 或者用 overwrite 参数来重写默认的message字段 , 只保留最重要的部分。
重写参数的示例如下 :
filter {
    grok {
        patterns_dir => ["/path/to/your/own/patterns"]
        match => {
            "message" => "%{SYSLOGBASE} %{DATA:message}"
        }
        overwrite => ["message"]
    }
}
多项选择
有时候我们会碰上一个日志有多种可能格式的情况。这时候要写成单一正则就比较困难 , 或者全用 | 隔开又比较丑陋。 logstash 的语法提供给我们一个解决方式 , 可以传递多个正则来匹配同一个字段 :
match => [
    "message", "(?<request_time>\d+(?:\.\d+)?)",
    "message", "%{SYSLOGBASE} %{DATA:message}",
    "message", "(?m)%{WORD}"
]logstash会按照这个定义次序依次尝试匹配 , 到匹配成功为止。虽说效果跟用|分割写个大大的正则是一样的 , 但是可阅读性好了很多。
5.2.5 mutate
filters/mutate插件是Logstash另一个重要插件。它提供了丰富的基础类型数据处理能力。包括类型转换 , 字符串处理和字段处理等。
5.2.5.1 类型转换
可以设置的转换类型包括 : "integer" , "float" 和 "string"。示例如下 :
input {stdin{}}
filter {
    grok {
        match => {
            "message" => "\s+(?<request_time>\d+(?:\.\d+)?)\s+"
        }
    }


    # 该配置可以把 request_time 转换为float类型
    mutate {
        convert => ["request_time", "float"]
    }
}
output {stdout{codec => rubydebug}}
输出结果 :
{
        "@version" => "1",
         "message" => "begin 123.456 end",
      "@timestamp" => 2021-07-08T02:54:37.539Z,
            "host" => "node01",
    "request_time" => 123.456
}
注意 : mutate除了转换简单的字符值 , 还支持对数组类型的字段进行转换 , 即将["1","2"] 转换成[1,2]。但不支持对哈希类型的字段做类似处理。
5.2.5.2 字符串处理
splitfilter { mutate { split => ["message", "|"] } }随意输入一串以
|分割的字符 , 比如 "userId|110|addTime|2021-07-18" , 可以看到如下输出 :{ "message" => [ [0] "userId", [1] "110", [2] "addTime", [3] "2021-07-18" ], "@timestamp" => 2021-07-08T03:11:50.024Z, "host" => "node01", "tags" => [ [0] "_grokparsefailure" ], "@version" => "1" }join仅对数组类型字段有效
我们在之前已经用
split割切的基础再join回去。配置改成 :
filter { mutate { split => ["message", "|"] } mutate { join => ["message", ","] } }filter区段之内 , 是顺序执行的。所以我们最后看到的输出结果是 :{ "tags" => [ [0] "_grokparsefailure" ], "message" => "userId,110,addTime,2021-07-18", "@timestamp" => 2021-07-08T03:15:19.398Z, "@version" => "1", "host" => "node01" }merge合并两个数组或者哈希字段。
在之前
split的基础上继续修改配置 :filter { mutate { split => ["message", "|"] } mutate { merge => ["message", "message"] } }我们会看到输出 :
{
       "message" => [
        [0] "userId",
        [1] "110",
        [2] "addTime",
        [3] "2021-07-18",
        [4] "userId",
        [5] "110",
        [6] "addTime",
        [7] "2021-07-18"
    ],
    "@timestamp" => 2021-07-08T03:21:09.248Z,
          "tags" => [
        [0] "_grokparsefailure"
    ],
      "@version" => "1",
          "host" => "node01"
}
如果
src字段是字符串 , 会自动先转换成一个单元素的数组再合并。把上一示例中的来源字段改成 "host" :filter { mutate { split => ["message", "|"] } mutate { merge => ["message", "host"] } }结果变成 :
{
       "message" => [
        [0] "userId",
        [1] "110",
        [2] "addTime",
        [3] "2021-07-18",
        [4] "node01"
    ],
    "@timestamp" => 2021-07-08T03:21:09.248Z,
          "tags" => [
        [0] "_grokparsefailure"
    ],
      "@version" => "1",
          "host" => "node01"
}
还有更多的插件字段 , 不再一一表述 , 请参考官方文档 https://www.elastic.co/guide/en/logstash/6.4/plugins-filters-mutate.html
5.2.5.3 执行次序
需要注意的是 , filter/mutate内部是有执行次序的。其次序如下 :
    rename(event) if @rename
    update(event) if @update
    replace(event) if @replace
    convert(event) if @convert
    gsub(event) if @gsub
    uppercase(event) if @uppercase
    lowercase(event) if @lowercase
    strip(event) if @strip
    remove(event) if @remove
    split(event) if @split
    join(event) if @join
    merge(event) if @merge


filter_matched(event)而filter_matched这个filters/base.rb里继承的方法也是有次序的。
  @add_field.each do |field, value|
  end
  @remove_field.each do |field|
  end
  @add_tag.each do |tag|
  end
  @remove_tag.each do |tag|
  end
5.2.6 ruby
最灵活的插件 , 可以以ruby语言来随心所欲的修改Logstash Event对象
配置示例
filter {
    ruby {
        init => "@kname = ['client','servername','url','status','time','size','upstream','upstreamstatus','upstreamtime','referer','xff','useragent']"
        code => "
            new_event = LogStash::Event.new(Hash[@kname.zip(event.get('message').split('|'))])
            new_event.remove('@timestamp')
            event.append(new_event)"
    }
}
解释
通常我们都是用filters/grok插件来捕获字段的 , 但是正则耗费大量的CPU资源 , 很容易成为Logstash进程的瓶颈。 而实际上 , 很多流经Logstash的数据都是有自己预定义的特殊分隔符的 , 我们可以很简单的直接切割成多个字段。 filters/mutate插件里的 "split" 选项只能切成数组 , 后续很不方便使用和识别。 而在filters/ruby里 , 我们可以通过 "init" 参数预定义好由每个新字段的名字组成的数组 , 然后在 "code" 参数指定的 Ruby语句里通过两个数组的zip操作生成一个哈希并添加进数组里。 短短一行Ruby代码 , 可以减少 50% 以上的 CPU 使用率。
注1 : 从Logstash-2.3开始 , LogStash::Event.append不再直接接受 Hash 对象 , 而必须是LogStash::Event对象。所以示例变成要先初始化一个新event , 再把无用的@timestamp移除 , 再append进去。否则会把@timestamp变成有两个时间的数组了!
注2 : 从Logstash-5.0开始 , LogStash::Event改为Java实现 , 直接使用event["parent"]["child"]形式获取的不是原事件的引用而是复制品。需要改用event.get('[parent][child]')和 event.set('[parent][child]', 'value') 的方法。
ruby 官网教程 : https://www.elastic.co/guide/en/logstash/6.4/plugins-filters-ruby.html
5.2.7 split
split 拆分事件
我们可以通过multiline插件将多行数据合并进一个事件里 , 那么反过来 , 也可以把一行数据 , 拆分成多个事件。这就是split插件。
配置示例
filter {
    split {
        field => "message"
        terminator => "#"
    }
}
运行结果
输入一行数据 : "test1#test2" , 结果看到输出两个事件 :
{
       "message" => "test1",
    "@timestamp" => 2021-07-08T06:49:19.722Z,
          "host" => "node01",
      "@version" => "1"
}
{
       "message" => "test2",
    "@timestamp" => 2021-07-08T06:49:19.722Z,
          "host" => "node01",
      "@version" => "1"
}
重要提示
split插件中使用的是yield功能 , 其结果是split出来的新事件 , 会直接结束其在filter阶段的历程 , 也就是说写在split后面的其他filter插件都不起作用 , 进入到output阶段。 所以 , 一定要保证split配置写在全部filter配置的最后。
5.3 output
5.3.1 elasticsearch
output {
    elasticsearch {
        hosts => ["192.168.0.2:9200"]
        index => "logstash-%{type}-%{+YYYY.MM.dd}"
        document_type => "%{type}"
        sniffing => true
        template_overwrite => true
    }
}
解释
索引名
写入的
ES索引的名称 , 这里可以使用变量。为了更贴合日志场景 ,Logstash提供了%{+YYYY.MM.dd}这种写法。在语法解析的时候 , 看到以+号开头的 , 就会自动认为后面是时间格式 , 尝试用时间格式来解析后续字符串。所以 , 之前处理过程中不要给自定义字段取个加号开头的名字……这可以使用
%{foo}语法进行动态操作。默认值将按天对索引进行分区, 这样您就可以更容易地删除旧数据或只搜索特定的日期范围。索引不能包含大写字符。对于每周索引, 建议使用ISO 8601格式, 例如logstash-%{+xxxx.ww}。Logstash使用Joda格式, 每个事件的@timestamp字段被用作日期的源。注意 : 索引名中不能有大写字母 , 否则
ES在日志中会报InvalidIndexNameException, 但是Logstash不会报错 , 这个错误比较隐晦 , 也容易掉进这个坑中。模板
Elasticsearch支持给索引预定义设置和mapping(前提是你用的elasticsearch版本支持这个API, 不过估计应该都支持)。Logstash自带有一个优化好的模板 , 内容如下:{ "template" : "logstash-*", "version" : 50001, "settings" : { "index.refresh_interval" : "5s" }, "mappings" : { "_default_" : { "_all" : {"enabled" : true, "norms" : false}, "dynamic_templates" : [ { "message_field" : { "path_match" : "message", "match_mapping_type" : "string", "mapping" : { "type" : "text", "norms" : false } } }, { "string_fields" : { "match" : "*", "match_mapping_type" : "string", "mapping" : { "type" : "text", "norms" : false, "fields" : { "keyword" : { "type": "keyword" } } } } } ], "properties" : { "@timestamp": { "type": "date", "include_in_all": false }, "@version": { "type": "keyword", "include_in_all": false }, "geoip" : { "dynamic": true, "properties" : { "ip": { "type": "ip" }, "location" : { "type" : "geo_point" }, "latitude" : { "type" : "half_float" }, "longitude" : { "type" : "half_float" } } } } } } }这其中的关键设置包括 :
template for index-pattern只有匹配
logstash-*的索引才会应用这个模板。有时候我们会变更Logstash的默认索引名称 , 通过PUT方法上传可以匹配你自定义索引名的模板。建议的做法是 , 把你自定义的名字放在 "logstash-" 后面 , 变成index => "logstash-custom-%{+yyyy.MM.dd}"这样。refresh_interval for indexingElasticsearch是一个近实时搜索引擎。它实际上是每1秒钟刷新一次数据。对于日志分析应用 , 我们用不着这么实时 , 所以 logstash 自带的模板修改成了5秒钟。你还可以根据需要继续放大这个刷新间隔以提高数据写入性能。multi-field with keywordElasticsearch会自动使用自己的默认分词器(空格 , 点 , 斜线等分割)来分析字段。分词器对于搜索和评分是非常重要的 , 但是大大降低了索引写入和聚合请求的性能。所以logstash模板定义了一种叫"多字段"(multi-field)类型的字段。这种类型会自动添加一个 ".keyword" 结尾的字段 , 并给这个字段设置为不启用分词器。简单说 , 你想获取url字段的聚合结果的时候 , 不要直接用 "url" , 而是用 "url.keyword" 作为字段名。
其他elasticsearch插件支持的参数
ilm_enabled: 允许的值为,true,false,auto。设置索引的生命周期管理ilm_pattern: 默认值为,{now/d}-000001。用于生成由索引生命周期管理管理的索引的模式。模式中指定的值将附加到写入别名 , 并在ILM创建新索引时自动递增。ilm_policy: 默认值为,logstash-policy。修改此设置以使用自定义索引生命周期管理策略 , 而不是默认策略。如果未设置此值 , 默认策略将自动安装到Elasticsearch中manage_template: 默认值对于非时间序列数据为true , 对于数据流为false。从
Logstash 1.3开始 , 如果名为template_name的模板不存在 , 则会在Logstash启动期间将模板应用于Elasticsearch。默认情况下 , 此模板的内容是logstash-%{+YYYY.MM.dd}的默认模板 , 它始终匹配基于模式logstash-*的索引。如果您需要对其他索引名称的支持 , 或者希望通常更改模板中的映射 , 可以通过将模板设置为模板文件的路径来指定自定义模板。 将manage_template设置为false将禁用此功能。如果您需要对模板创建进行更多控制(例如 , 根据字段名称动态创建索引), 则应将manage_template设置为false, 并使用RESTneneneba API手动应用模板。output { elasticsearch { manage_template => true template => "path/to/my_template.json" template_name => "my_template" } }这样 ,
Logstash就会在启动时自动使用 "path/to/my_template.json" 中定义的模板创建名为 "my_template" 的索引模板。如果索引模板已经存在 ,Logstash会更新它;如果不存在 ,Logstash会创建它。template: 如果你愿意 , 你可以在这里设置你自己的模板的路径。如果未设置 , 将使用包含的模板。template_name: 此配置选项定义了在Elasticsearch中如何命名模板。请注意,如果您已经使用了模板管理功能并随后对此进行了更改,则需要手动修剪旧模板template_overwrite:template_overwrite选项将始终用template指示的模板或包含的模板覆盖Elasticsearch中指示的模板。默认情况下,此选项设置为false。如果你总是想了解Logstash提供的模板的最新情况,这个选项可能对你非常有用。
5.3.2 email
126邮箱发送到qq 邮箱 示例如下
output {
    email {
        port           =>    "25"
        address        =>    "smtp.126.com"
        username       =>    "test@126.com"
        password       =>    ""
        authentication =>    "plain"
        use_tls        =>    true
        from           =>    "test@126.com"
        subject        =>    "Warning: %{title}"
        to             =>    "test@qq.com"
        via            =>    "smtp"
        body           =>    "%{message}"
    }
}
解释
outputs/email插件支持SMTP协议和sendmail两种方式 , 通过 via 参数设置。SMTP 方式有较多的options参数可配置。
5.3.3 exec
调用命令执行(Exec) outputs/exec 插件的运用也非常简单 , 如下所示 , 将logstash切割成的内容作为参数传递给命令。这样 , 在每个事件到达该插件的时候 , 都会触发这个命令的执行。
output {
    exec {
        command => "sendsms.pl \"%{message}\" -t %{user}"
    }
}
需要注意的是。这种方式是每次都重新开始执行一次命令并退出。本身是比较慢速的处理方式(程序加载 , 网络建联等都有一定的时间消耗)。最好只用于少量的信息处理场景 , 比如不适用nagios的其他报警方式。示例就是通过短信发送消息。
5.3.4 file
保存成文件(File) 通过日志收集系统将分散在数百台服务器上的数据集中存储在某中心服务器上 , 这是运维最原始的需求。Logstash 当然也能做到这点。 和LogStash::Inputs::File不同, LogStash::Outputs::File里可以使用sprintf format格式来自动定义输出到带日期命名的路径。
配置示例
output {
    file {
        path => "/path/to/%{+yyyy}/%{+MM}/%{+dd}/%{host}.log.gz"
        gzip => true
    }
}
5.3.5 stdout
标准输出(Stdout) 和之前inputs/stdin插件一样 , outputs/stdout插件也是最基础和简单的输出插件。同样在这里简单介绍一下 , 作为输出插件的一个共性了解。
配置示例
output {
    stdout {
        codec => rubydebug
        workers => 2
    }
}
解释
输出插件统一具有一个参数是workers。Logstash为输出做了多线程的准备。 单就outputs/stdout插件来说 , 其最重要和常见的用途就是调试。所以在不太有效的时候 , 加上命令行参数-vv运行 , 查看更多详细调试信息。
学习更多 : https://www.elastic.co/guide/en/logstash/6.4/index.html
参考链接
时间处理(Date) | Logstash 最佳实践 (yonyoucloud.com)