8-Prometheus 数据查询语言 PromQL
1. Prometheus 数据模型
Prometheus 中 , 每个时间序列都由指标名称(Metric Name)和标签(Label)来唯一标识格式为 : {= , …}
指标名称 : 通常用于描述系统上要测定的某个特征
例如 ,
prometheus_http_requests_total表示接收到的HTTP请求总数标签 : 键值型数据 , 附加在指标名称之上 , 从而让指标能够支持多纬度特征 ; 可选项
例如 ,
prometheus_http_requests_total{code=“200”}和prometheushttp_requests_total{code=“302”}代表着两个不同的时间序列双下划线的标签( 例如
address) 是Prometheus系统默认标签 , 是不会显示在/metrics页面里面的 ;系统默认标签在
target页面中也是不显示的 , 需要鼠标放到Labels字段上才会显示。
常见的系统默认标签 :
__address : 当前target 实例的套接字地址。
__scheme : 采集当前target 上指标数据时使用的协议( http或https) 。
__metrics_path : 采集当前target 上的指标数据时使用URI路径 , 默认为/metrics。
___param : 传递的URL参数中第一个名称为的参数的值。
__name : 此标签是标识指标名称的预留标签 , 能够使用标签选择器对指标名称进行过滤。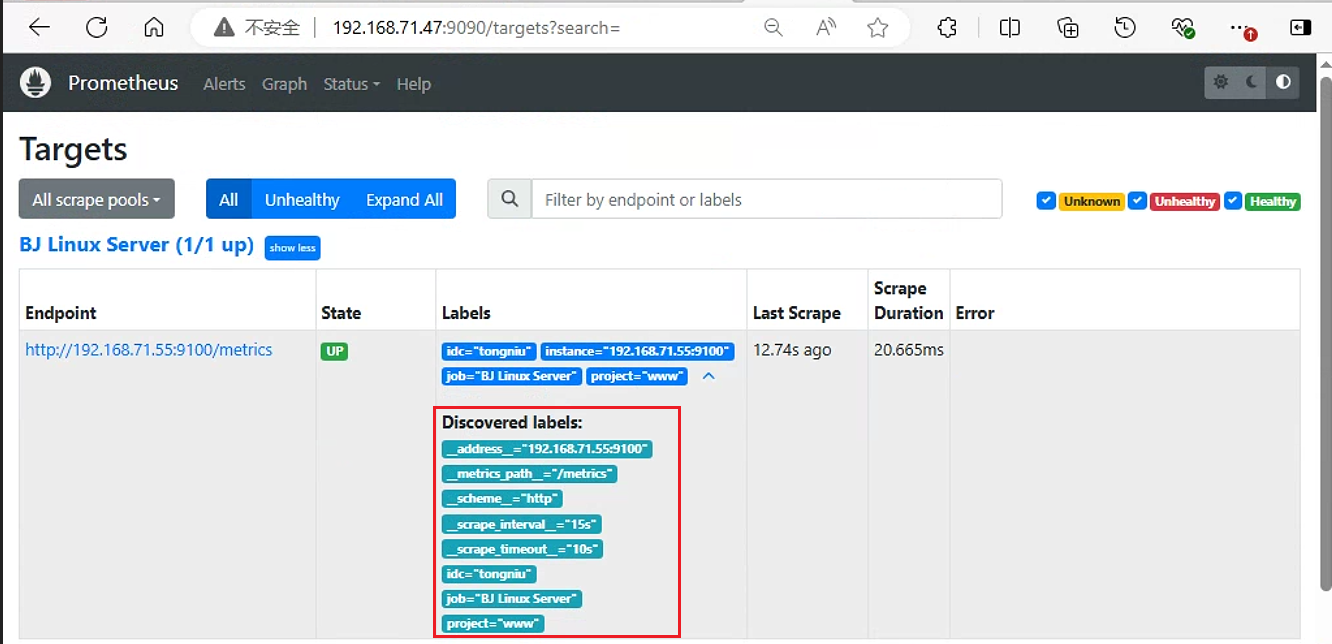
指标名称及标签使用注意事项
指标名称和标签的特定组合代表着一个时间序列。指标名称相同 , 但标签不同的组合分别代表着不同的时间序列。不同的指标名称自然更是代表着不同的时间序列 。
PromQL支持基于定义的指标维度进行过滤和聚合。更改任何标签值 , 包括添加或删除标签 , 都会创建一个新的时间序列。应该尽可能地保持标签的稳定性 , 否则很可能创建新的时间序列 , 更甚者会生成一个动态的数据环境 , 并使得监控的数据源难以跟踪 , 从而导致建立在该指标之上的图形、告警及记录规则变得无效。
样本数据格式
Prometheus 的每个数据样本由两部分组成 :
毫秒精度的时间戳
float64格式的数据
2. PromQL 简介
PromQL( Prometheus Query Language) 是Prometheus内置的数据查询语言 , 支持用户进行实时的数据查询及聚合操作。类似于MySQL的SQL语句 , PromQL 允许你以灵活的方式选择、聚合等其他方式转换和计算时间序列数据 , 该语言仅用于读取数据。
Prometheus基于指标名称( metrics name) 以及附属的标签集( labelset) 唯一定义一条时间序列。
指标名称代表着监控目标上某类可测量属性的基本特征标识
标签则是这个基本特征上再次细分的多个可测量维度
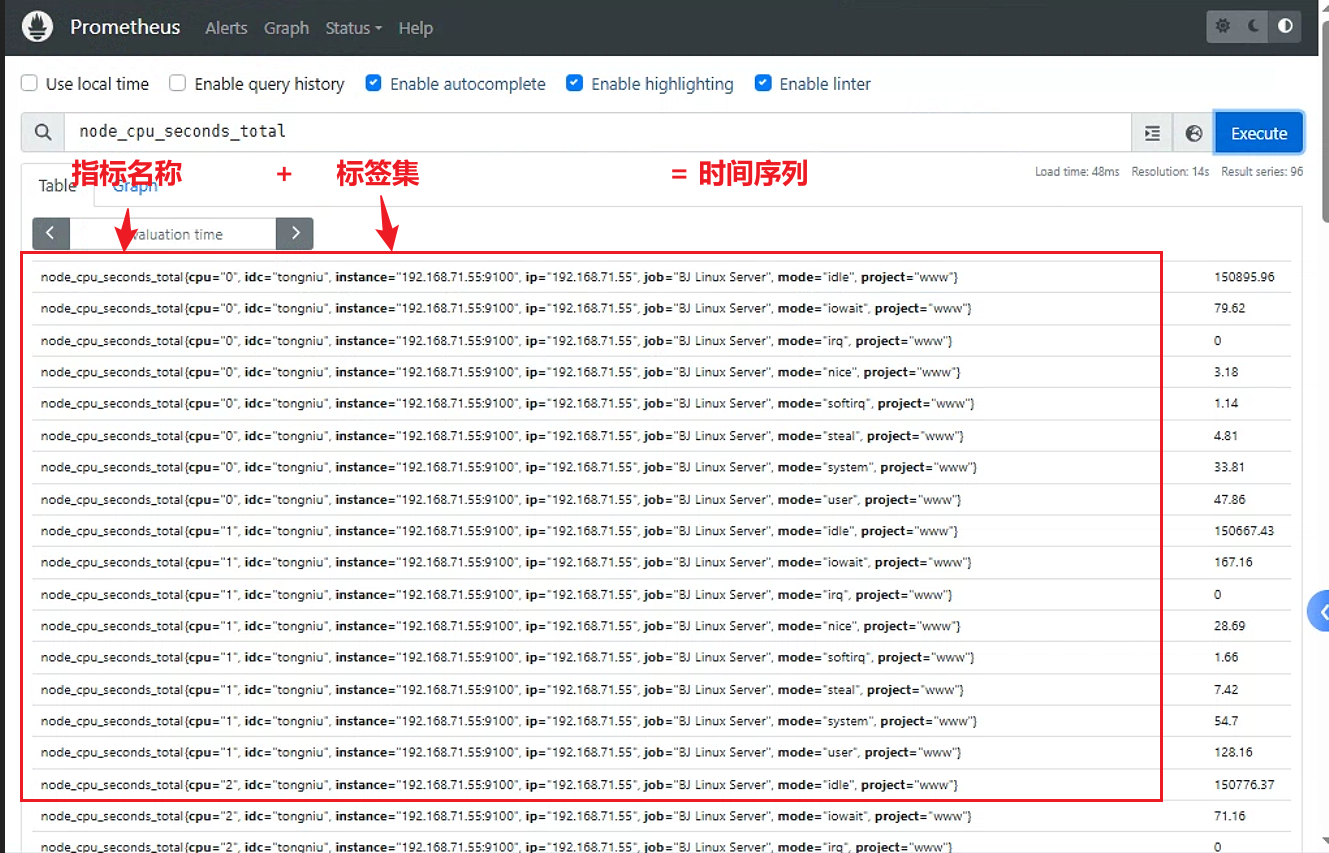
基于PromQL表达式 , 用户可以针对指定的特征及其细分的纬度进行过滤、聚合、统计等运算从而产生期望的计算结果。
PromQL使用表达式(expression)来表述查询需求根据其使用的指标和标签 , 以及时间范围 , 表达式的查询请求可灵活地覆盖在一个或多个时间序列的一定范围内的样本之上 , 甚至是只包含单个时间序列的单个样本
3. PromQL 的数据类型
瞬时向量 (
Instant vector): 特定或全部的时间序列集合上 , 具有相同时间戳的一组样本值。区间向量 (
Range vector): 特定或全部的时间序列集合上 , 在指定的同一时间范围内的所有样本值。标量数据 (
Scalar): 一个浮点型的数据值。字符串 (
String): 一个字符串 , 支持使用单引号、双引号进行引用。
3.1 时间序列选择器(Time series Selectors)
PromQL的查询操作可能需要针对若干个时间序列上的样本数据进行 , 挑选出目标时间序列是构建表达式时最为关键的一步 ;
用户可使用向量选择器表达式来挑选出给定指标名称下的所有时间序列或部分时间序列的即时样本值或至过去某个时间范围内的样本值 , 前者称为瞬时向量选择器 , 后者称为区间向量选择器。
3.1.1 瞬时向量选择器( Instant Vector Selectors)
瞬时向量选择器可以返回0个、1个或多个时间序列上在给定时间戳( instant) 上的各自的一个样本。
瞬时向量选择器由两部分组成 :
指标名称 : 用于限定特定指标下的时间序列 , 即负责过滤指标 ; 可选
标签选择器 : 用于过滤时间序列上的标签 ; 定义在
{}之中 ; 可选
定义瞬时向量选择器时 , 以上两个部分应该至少给出一个 ; 因此存在以下三种组合 :
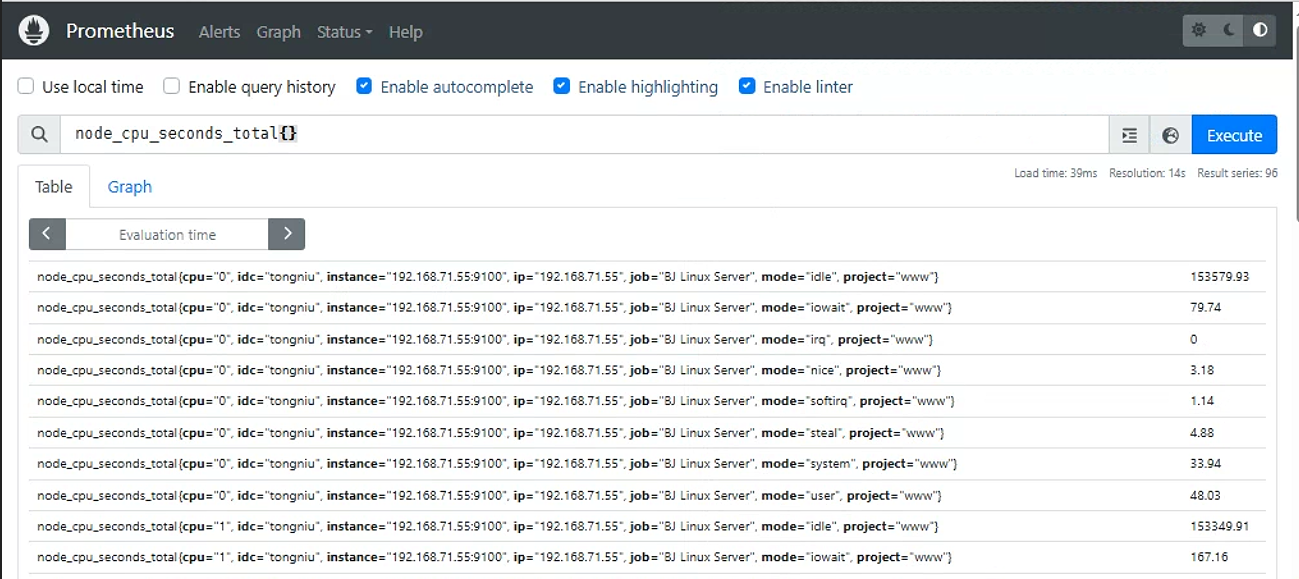
仅给定指标名称 , 或在标签名称上使用了空值的标签选择器 : 返回给定的指标下的所有时间序列各自的即时样本。
例如 ,
node_cpu_seconds_total和node_cpu_seconds_total{}的功能相同 , 都是用于返回这个指标下各时间序列的即时样本( 所有) 。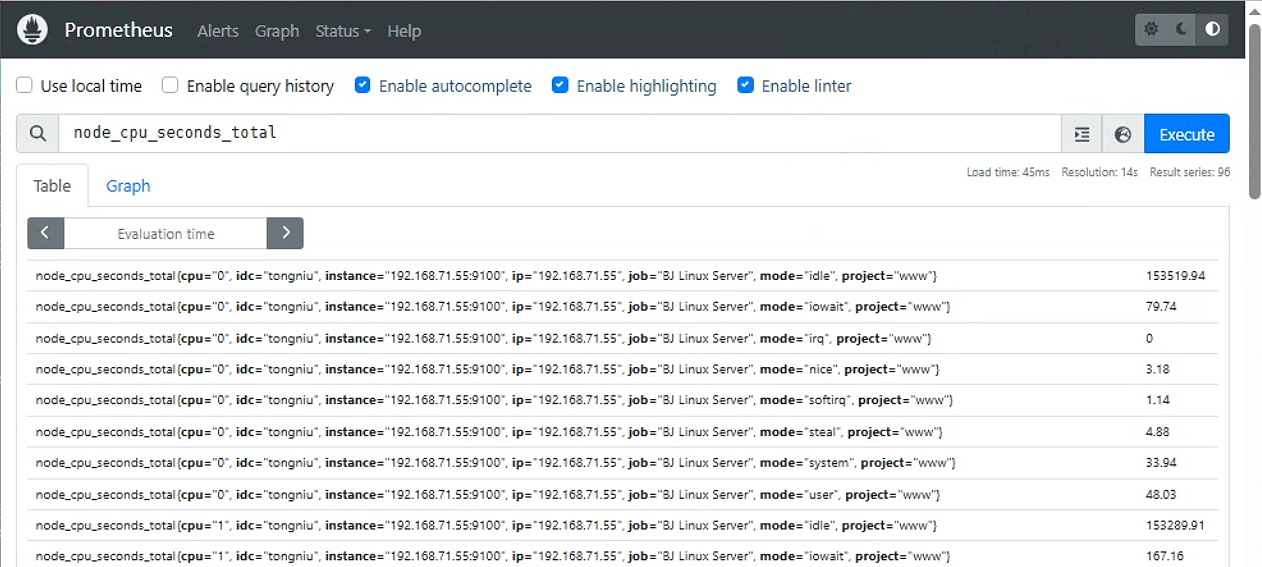
仅给定标签选择器 : 返回所有符合给定的标签选择器的所有时间序列上的即时样本 。
例如 ,
{project="www",job="BJ Linux Server"}, 这样的时间序列可能会有着不同的指标名称。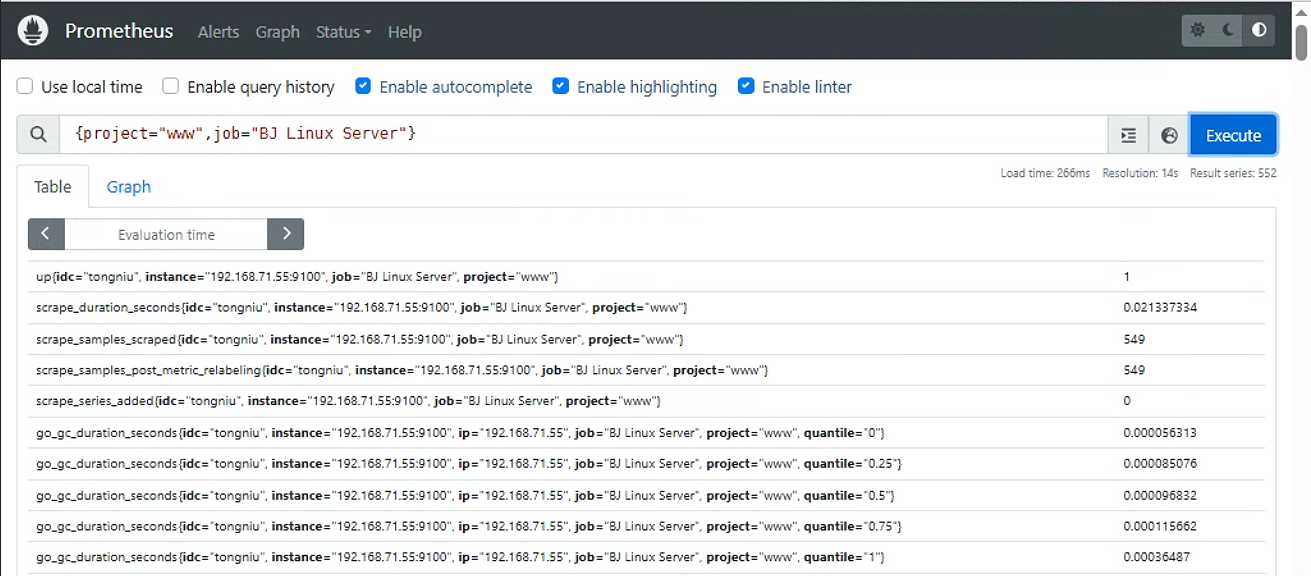
指标名称和标签选择器的组合 : 返回给定的指标下的 , 且符合给定的标签过滤器的所有时间序列上的即时样本 。
例如 ,
node_cpu_seconds_total{project="www",job="BJ Linux Server"}, 用于返回这个指标project为www, 并且job为BJ Linux Server的时间序列的即时样本。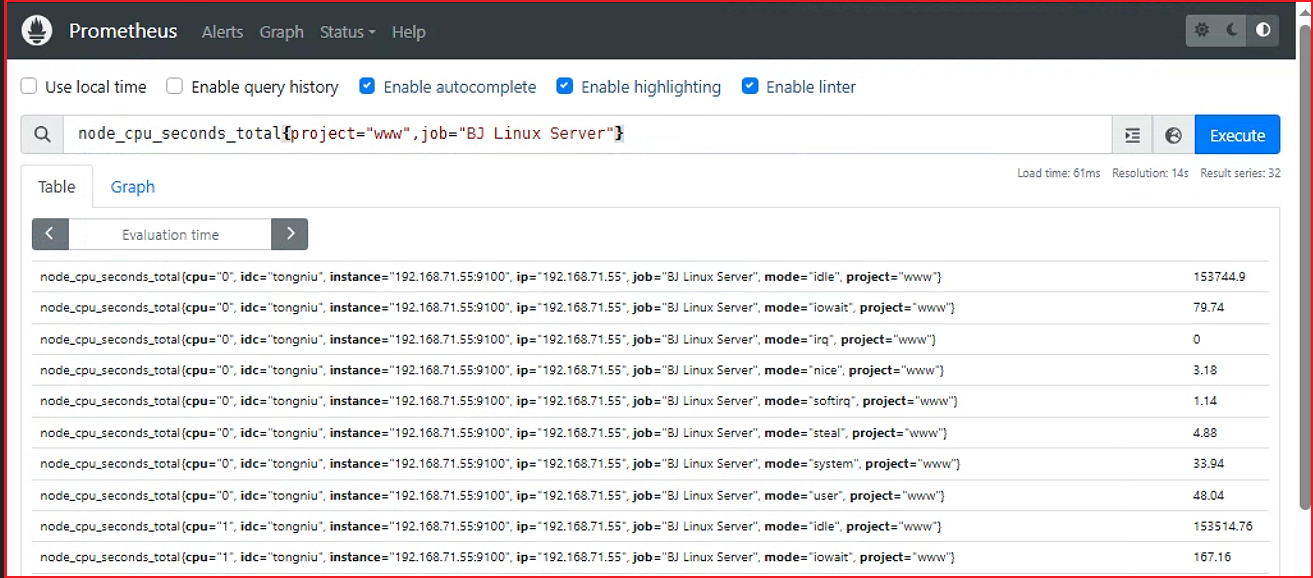
注意事项
匹配到空标签值的标签选择器时 , 所有未定义该标签的时间序列同样符合条件。
例如 ,
prometheus_http_requests_total{handler= ""}, 则该指标名称上所有未使用该标签(handler)的时间序列也符合条件。
正则表达式将执行完全锚定机制 , 它需要匹配指定的标签的整个值。
向量选择器至少要包含一个指标名称 , 或者至少有一个不会匹配到空字符串的标签选择器。
例如 ,
{ job=""}为非法的向量选择器。
使用
____name____做为标签名称 , 还能够对指标名称进行过滤。例如 ,
{name=~“.*http_requests_total”}能够匹配所有以http_requests_total为后缀的所有指标{__name__=~"node_memory.*bytes"}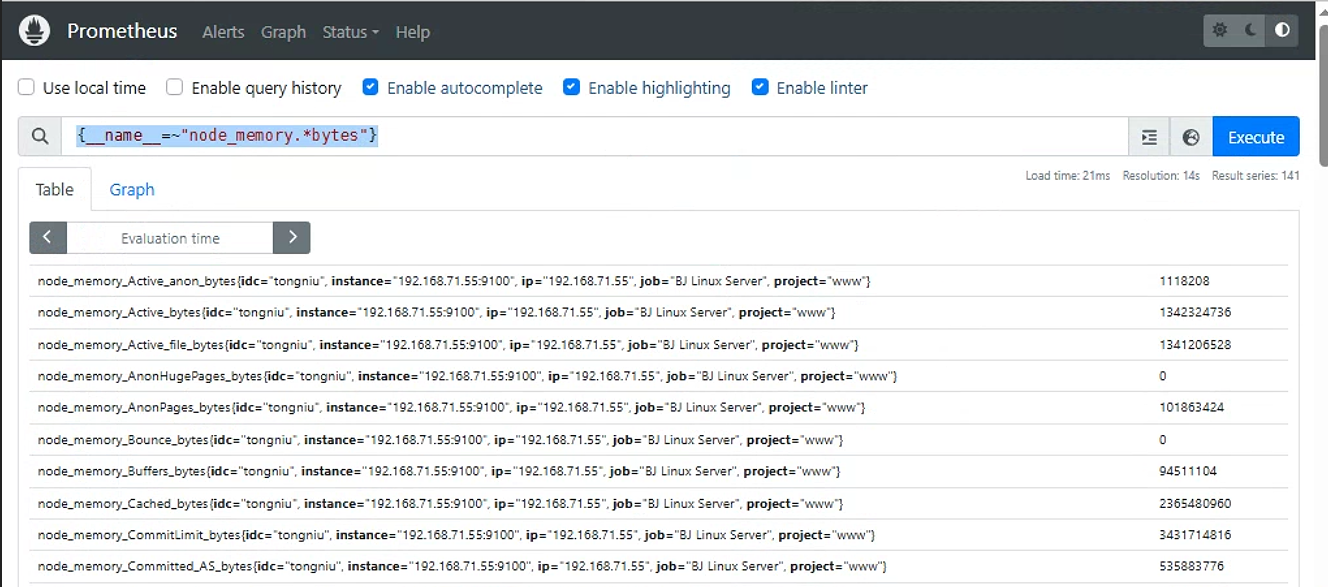
{__name__=~"node_load.*"}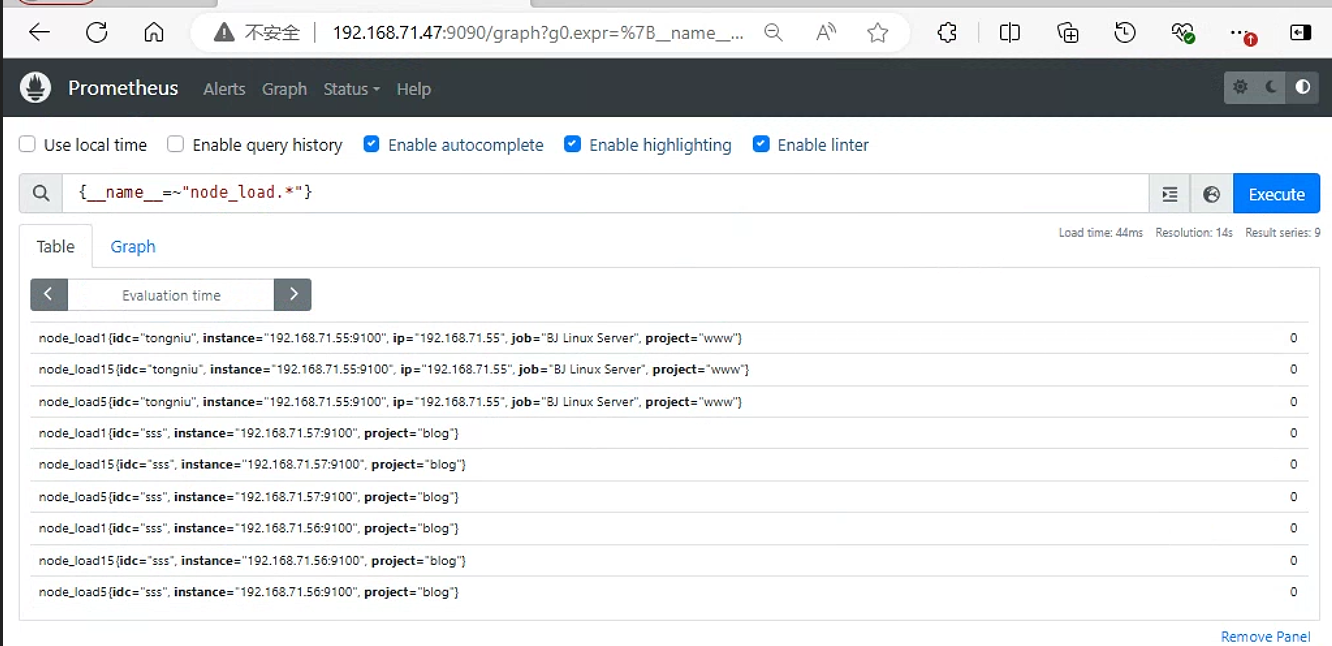
3.1.2 区间向量选择器 ( Range Vector Selectors)
区间向量选择器可以返回0个、1个或多个时间序列上在给定时间范值围内的各自的一组样本。
区间向量选择器的不同之处在于 , 需要通过在瞬时向量选择器表达式后面添加包含在[] 里的时长来表达需在时间时序上返回的样本所处的时间范围。
时间范围 : 以当前时间为基准时间点 , 指向过去一个特定的时间长度 ; 例如 , [5m] 是指过去5分钟之内。
可用的时间单位有
ms( 毫秒) 、s( 秒) 、m( 分钟) 、h( 小时) 、d( 天) 、w( 周) 和y( 年)必须使用整数时间 , 且能够将多个不同级别的单位进行串联组合 , 以时间单位由大到小为顺序 , 例如
1h30m, 但不能使用1.5h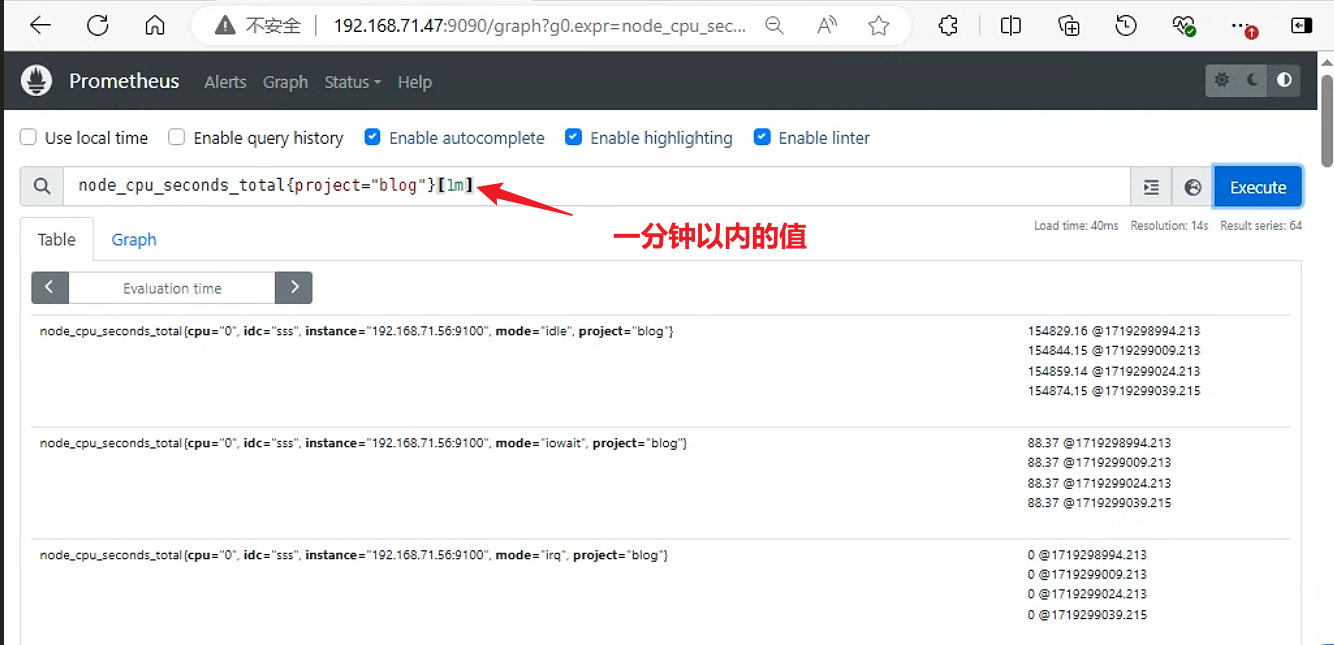
3.1.3 偏移向量选择器
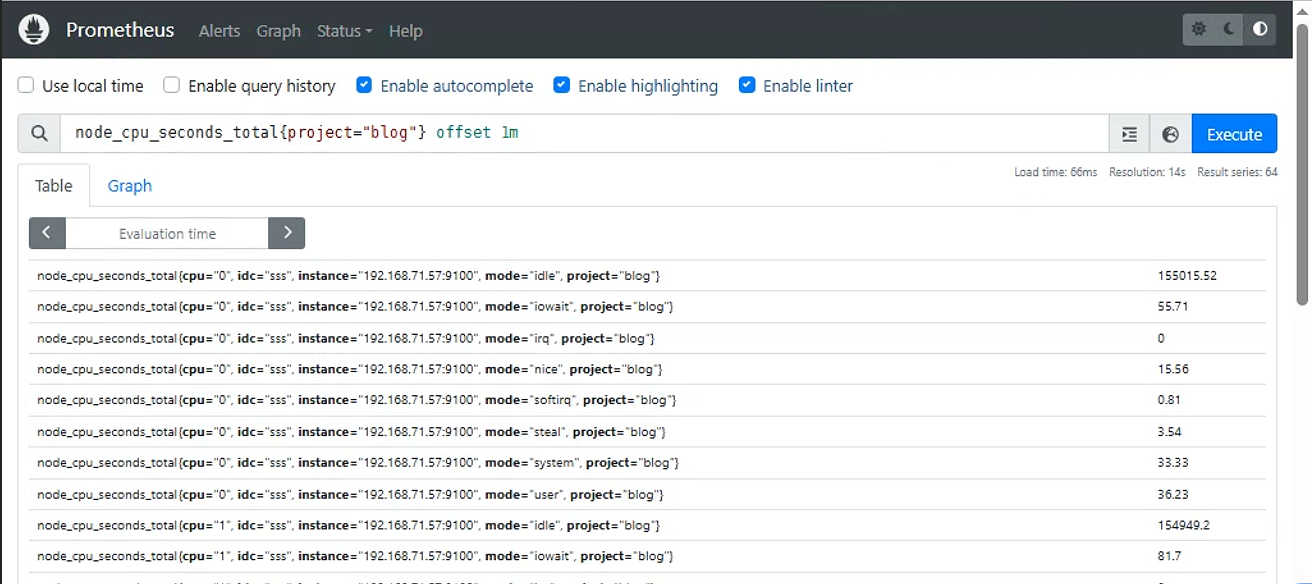
前面介绍的选择器默认都是以当前时间为基准时间 , 偏移修饰器用来调整基准时间 , 使其往前偏移一段时间。偏移修饰器紧跟在选择器后面 , 使用关键字 offset 来指定要偏移的量。(查询的不是当前时间为起点的)
例如 : node_cpu_seconds_total{project="blog"} offset 1m , 表示获取以 node_cpu_seconds_total{project="blog"} 为指标名称的所有时间序列在过去 1 分钟之时的即时样本 ;
node_cpu_seconds_total{project="blog"}[5m] offset 1h , 表示获取距此刻一个小时时间之前的 5 分钟之内的所有样本
3.2 向量表达式使用要点
表达式的返回值类型亦是即时向量、范围向量、标题或字符串4种数据类型其中之一 , 但是 , 有些使用场景要求表达式返回值必须满足特定的条件 , 例如 :
需要将返回值绘制成图形时 , 仅支持瞬时向量类型的数据。
对于诸如
rate、irate之类的速率函数来说 , 其要求使用的却又必须是区间向量型的数据。由于区间向量选择器的返回的是区间向量型数据 , 它不能用于表达式浏览器中图形绘制功能 。
区间向量选择器通常会结合速率类的函数
rate、irate一同使用。
4. PromQL 的指标类型
4.1 PromQL 的指标类型
PromQL 有四个指标类型 :
Counter: 计数器 , 用于保存单调递增型的数据 ; 例如站点访问次数等。数据单调递增 , 不支持减少 , 不能为负值 , 重启进程后 , 会被重置回0;Gauge: 仪表盘 , 用于存储有着起伏特征的指标数据 , 例如内存空闲大小等。数据可变大 , 可变小 ; 重启进程后 , 会被重置 ;Histogram: 累积直方图 , 将时间范围内的数据划分成不同的时间段 , 并各自评估其样本个数及样本值之和 , 因而可计算出分位数 ;可用于分析因异常值而引起的平均值过大的问题 ;
分位数计算要使用专用的
histogram_quantile函数 ;
Summary: 类似于Histogram, 但会在客户端直接计算并上报分位数 ;
4.2 Counter
通常 , Counter 的总数并没有直接作用 , 而是需要借助于 rate、topk、increase 和 irate 等函数来生成样本数据的变化状况(增长率) :
topk(3, node_cpu_seconds_total)
#获取该指标下 节点cpu使用 排名前 3 的时间序列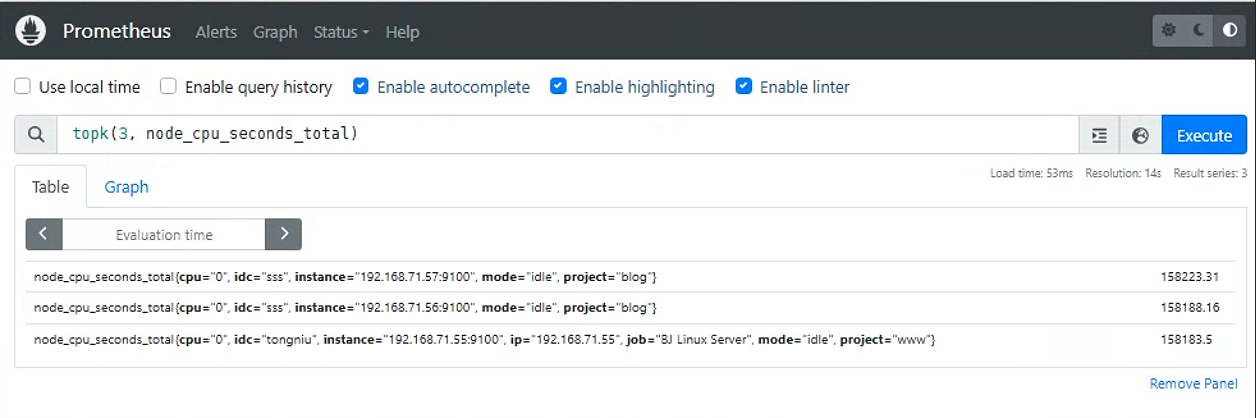
rate(node_cpu_seconds_total[1h])
#获取 1小时内 , 该指标下各时间序列上的 节点各类cpu使用时长的增长速率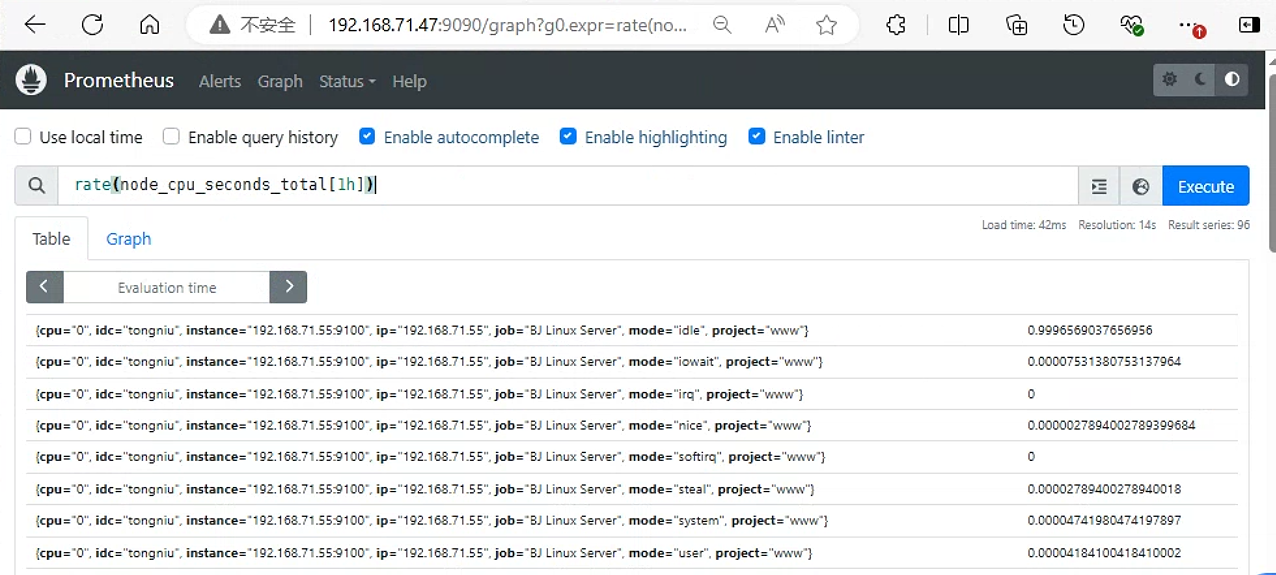
irate(node_cpu_seconds_total[1h])
#irate 为高灵敏度函数 , 用于计算指标的瞬时速率 , 基于样本范围内的最后两个样本进行计算 , 相较于 rate 函数来说 , irate 更适用于短期时间范围内的变化速率分析。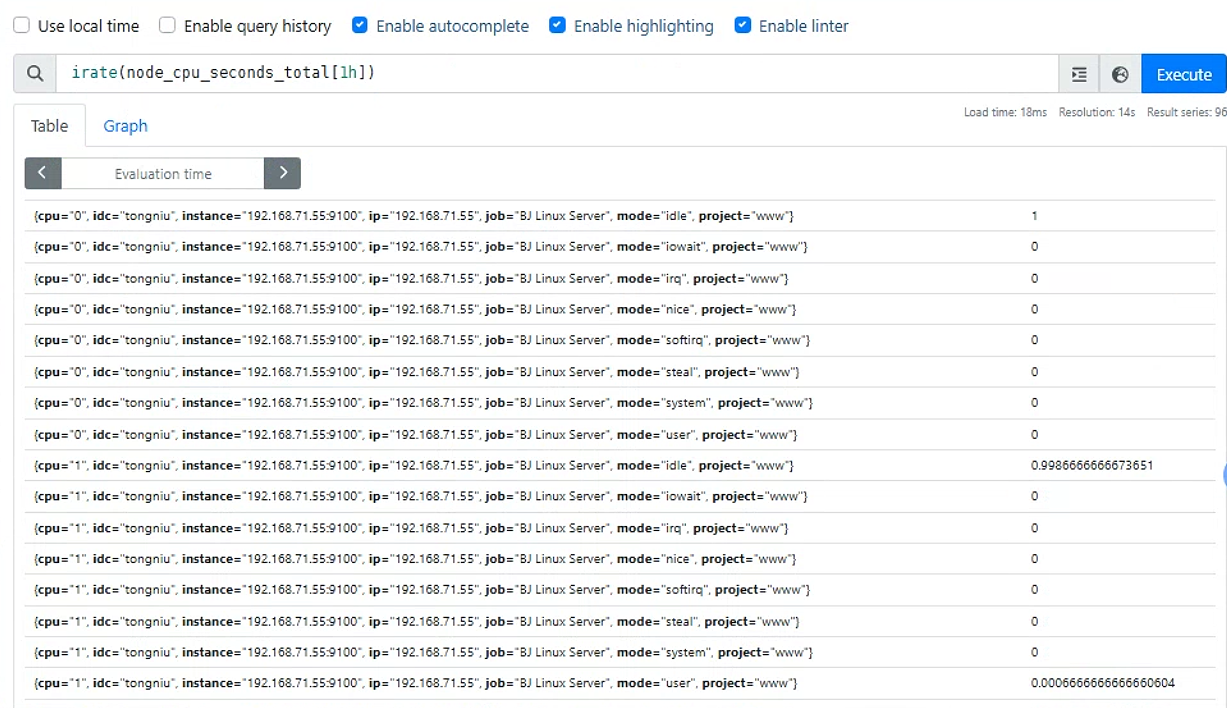
4.3 Gauge
Gauge 用于存储其值可增可减的指标的样本数据 , 常用于进行求和、取平均值、最小值、最大值等聚合计算。也会经常结合 PromQL 的 delta 和 predict_linear 函数使用:
delta函数计算范围向量中每个时间序列元素的第一个值与最后一个值之差 , 从而展示不同时间点上的样本值的差值。delta(cpu_temp_celsius{host="node01"}[2h]) #返回该服务器上的CPU温度与2小时之前的差异predict_linear函数可以预测时间序列v在t秒后的值 , 它通过线性回归的方式 , 对样本数据的变化趋势做出预测。predict_linear(node_filesystem_free{job="node"}[2h], 4 * 3600) #基于 2 小时的样本数据 , 来预测主机可用磁盘空间在 4 个小时之后的剩余情况
4.4 Histogram
为什需要用histogram柱状图?
    在大多数情况下人们都倾向于使用某些量化指标的平均值 , 例如 CPU 的平均使用率、页面的平均响应时间。这种方式的问题很明显 , 以系统 API 调用的平均响应时间为例:如果大多数 API 请求都维持在 100ms 的响应时间范围内 , 而个别请求的响应时间需要 5s , 那么就会导致某些 WEB 页面的响应时间落到中位数的情况 , 而这种现象被称为长尾问题。
    为了区分是平均的慢还是长尾的慢 , 最简单的方式就是按照请求延迟的范围进行分组。例如 , 统计延迟在 0~10ms 之间的请求数有多少 , 而 10~20ms 之间的请求数又有多少。通过这种方式可以快速分析系统慢的原因。Histogram 和 Summary 都是为了能够解决这样问题的存在 , 通过 Histogram 和 Summary 类型的监控指标 , 我们可以快速了解监控样本的分布情况
对于 Prometheus 来说 , Histogram 会在一段时间范围内对数据进行采样(通常是请求持续时长或响应大小等), 并将其计入可配置的 bucket ( 存储桶) 中 , 后续可通过指定区间筛选样本 , 也可以统计样本总数 , 最后一般将数据展示为直方图。
Prometheus 取值间隔的划分采用的是累积区间间隔机制 , 即每个 bucket 中的样本均包含了其前面所有 bucket 中的样本 , 因而也称为累积直方图。
Histogram 类型的每个指标有一个基础指标名称 , 它会提供多个时间序列:
_sum: 所有样本值的总和_count: 总的采样次数 , 它自身本质上是一个Counter类型的指标_bucket{le="<上边界>"}: 观测桶的上边界 , 即样本统计区间 , 表示样本值小于等于上边界的所有样本数量_bucket{le="+Inf"}: 最大区间(包含所有样本)的样本数量
使用 histogram
在大多数情况下人们一般倾向于使用某些量化指标的平均值 , 例如 CPU 的平均使用率、页面的平均响应时间。这种方式的问题很明显 , 以系统 API 调用的平均响应时间为例: 如果大多数 API 请求都维持在 100ms 的响应时间范围内 , 而个别请求的响应时间需要 5s , 那么就会导致某些 Web 页面的响应时间落到中位数的情况 , 而这种现象被称为长尾问题。
为了区分是平均的慢还是长尾的慢 , 最简单的方式就是按照请求延迟的范围进行分组。例如 , 统计延迟在 0~10 ms 之间的请求数有多少 , 而 10~20 ms 之间的请求数又有多少。通过这种方式可以快速分析系统慢的原因。Histogram和Summary都是为了能够解决这样问题的存在 , 通过 Histogram 和 Summary 类型的监控指标 , 我们可以快速了解监控样本的分布情况。
http 请求响应时间 <= 0.005 秒 的请求次数为 10。
prometheus_http_request_duration_seconds_bucket{handler="/metrics",le="0.005"} 10http 请求响应时间 <= 0.01 秒 的请求次数为 15。
prometheus_http_request_duration_seconds_bucket{handler="/metrics",le="0.01"} 15http 请求响应时间 <= 0.025 秒 的请求次数为 18。
prometheus_http_request_duration_seconds_bucket{handler="/metrics",le="0.025"} 18
prometheus_http_request_duration_seconds_bucket{handler="/metrics",le="0.05"} 18
prometheus_http_request_duration_seconds_bucket{handler="/metrics",le="0.075"} 18
prometheus_http_request_duration_seconds_bucket{handler="/metrics",le="0.1"} 18
prometheus_http_request_duration_seconds_bucket{handler="/metrics",le="0.25"} 18
prometheus_http_request_duration_seconds_bucket{handler="/metrics",le="0.5"} 18
prometheus_http_request_duration_seconds_bucket{handler="/metrics",le="0.75"} 18
prometheus_http_request_duration_seconds_bucket{handler="/metrics",le="1.0"} 18
prometheus_http_request_duration_seconds_bucket{handler="/metrics",le="2.5"} 18
prometheus_http_request_duration_seconds_bucket{handler="/metrics",le="5.0"} 20
prometheus_http_request_duration_seconds_bucket{handler="/metrics",le="7.5"} 20
prometheus_http_request_duration_seconds_bucket{handler="/metrics",le="+Inf"} 20
所有样本值的大小总和 , 命名为 _sum
prometheus_http_request_duration_seconds_sum{handler="/metrics"} 10.107670803000001样本总数 , 命名为 _count , 效果与 _bucket{le=“+Inf”} 相同
prometheus_http_request_duration_seconds_count{handler="/metrics"} 20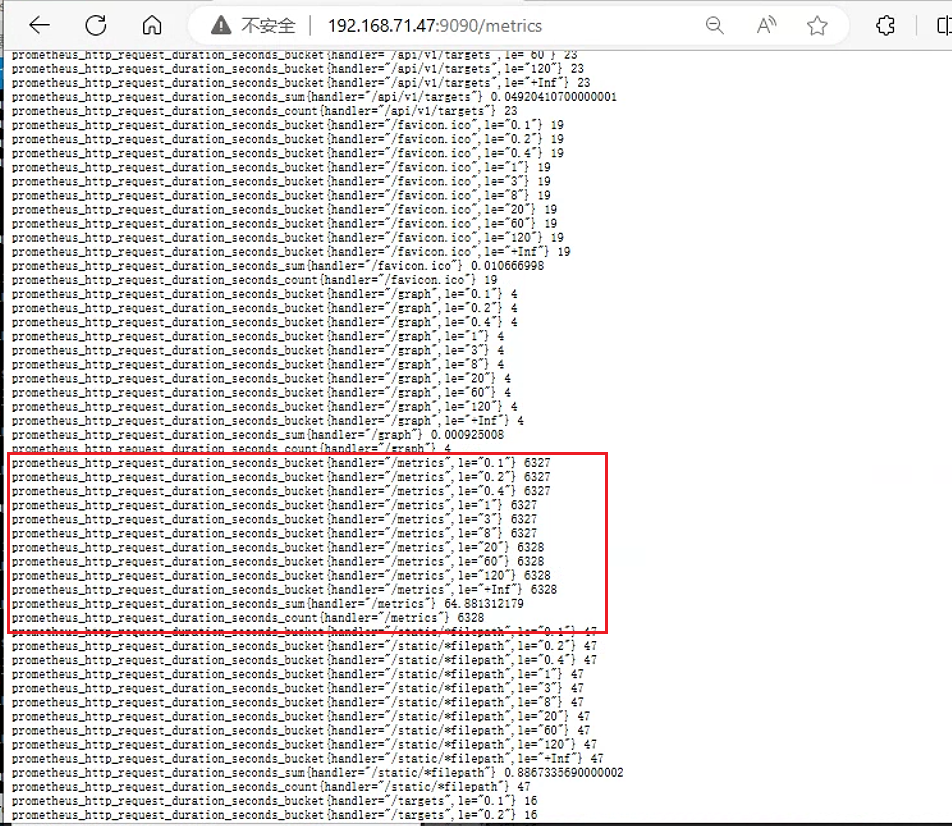
注意 :
bucket可以理解为是对数据指标值域的一个划分 , 划分的依据应该基于数据值的分布。注意后面的样本是包含前面的样本 , 假设prometheus_http_request_duration_seconds_bucket{…,le=“0.01”}的值为10, 而prometheus_http_request_duration_seconds_bucket{…,le=“0.05”}的值为30, 那么意味着这30个样本中 , 有10 个是小于0.01s的 , 其余20个采样点的响应时间是介于0.01s和0.05s之间的。累积间隔机制生成的样本数据需要额外使用内置的
histogram_quantile函数即可根据Histogram指标来计算相应的分位数(quantile) , 即某个bucket的样本数在所有样本数中占据的比例。histogram_quantile函数在计算分位数时会假定每个区间内的样本满足线性分布状态 , 因而它的结果仅是一个预估值 , 并不完全准确
预估的准确度取决于
bucket区间划分的粒度 ; 粒度越大 , 准确度越低
例如 , 假设 http 请求响应时间的样本的 9 分位数(quantile=0.9)的上边界为0.01 , 即表示小于等于 0.01 的样本值的数量占总体样本值的 90%。
histogram_quantile(prometheus_http_request_duration_seconds_bucket{handler="/metrics",le="0.01"}) 0.94.5 Summary
Histogram 在客户端仅是简单的桶划分和分桶计数 , 分位数计算由 Prometheus Server 基于样本数据进行估算 , 因而其结果未必准确 , 甚至不合理的 bucket 划分会导致较大的误差。
Summary 是一种类似于 Histogram 的指标类型 , 但它在客户端于一段时间内 ( 默认为 10 分钟) 的每个采样点进行统计 , 计算并存储了分位数数值 , Server 端直接抓取相应值即可。
对于每个指标 , Summary 以指标名称为前缀 , 生成如下几个指标序列 :
_sum  : 统计所有样本值之和
_count  : 统计所有样本总数
{quantile=“x”}  : 统计样本值的分位数分布情况 , 分位数范围 : 0 ≤ x ≤ 1
示例 :
prometheus_tsdb_wal_fsync_duration_seconds{quantile="0.5"} 0.012352463
prometheus_tsdb_wal_fsync_duration_seconds{quantile="0.9"} 0.014458005
prometheus_tsdb_wal_fsync_duration_seconds{quantile="0.99"} 0.017316173
prometheus_tsdb_wal_fsync_duration_seconds_sum 2.888716127000002
prometheus_tsdb_wal_fsync_duration_seconds_count 216从上面的样本中可以得知当前Promtheus Server进行 wal_fsync 操作的总次数为 216 次 , 耗时 2.888716127000002s。其中中位数 ( quantile=0.5) 的耗时为 0.012352463s , 9分位数 ( quantile=0.9) 的耗时为0.014458005s。
4.6 Histogram 与 Summary 的异同
它们都包含了_sum和 _count 指标 , Histogram 需要通过 _bucket 来计算分位数 , 而 Summary 则直接存储了分位数的值。
5. PromQL匹配器
标签选择器用于定义标签过滤条件 , 目前支持如下4种匹配操作符:
查询格式 : <metric name>{<label name>=<label value>, ...}
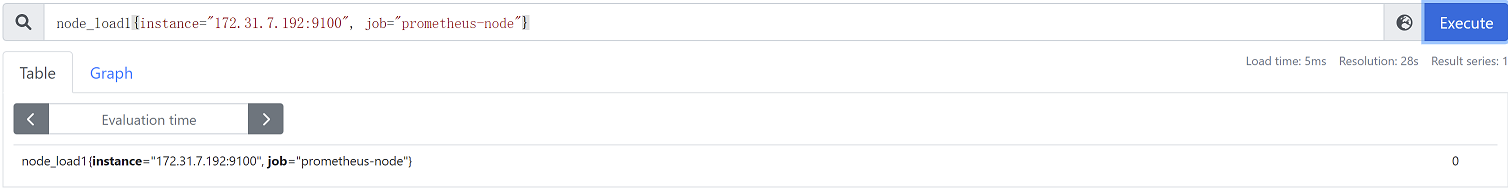
示例: node_load1{instance="172.31.7.192:9100", job="prometheus"} #精确匹配
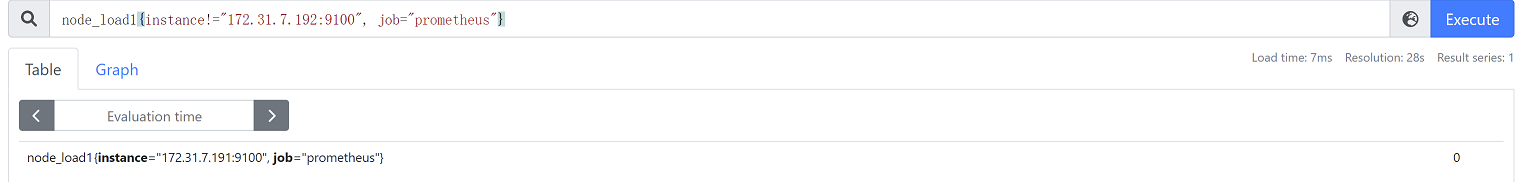
node_load1{instance!="172.31.7.192:9100", job="prometheus"} #取反
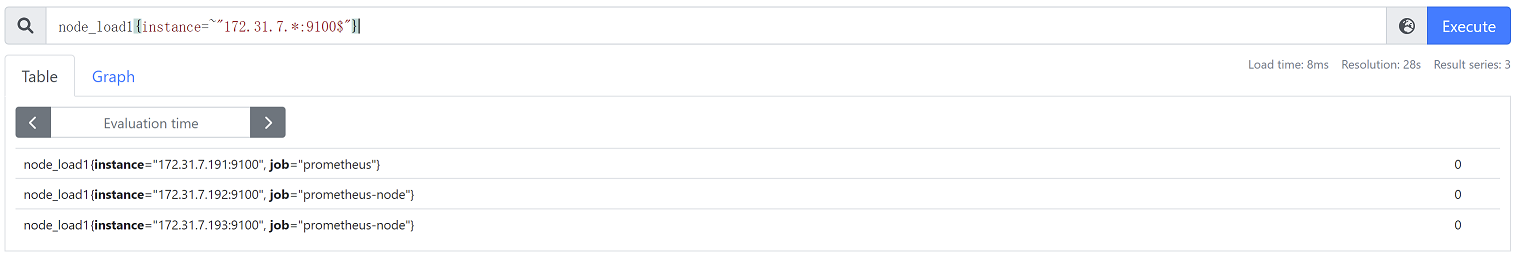
node_load1{instance=~"172.31.7.*:9100$"} #包含正则且匹配 ( 查询以172.31.7开头的主机)
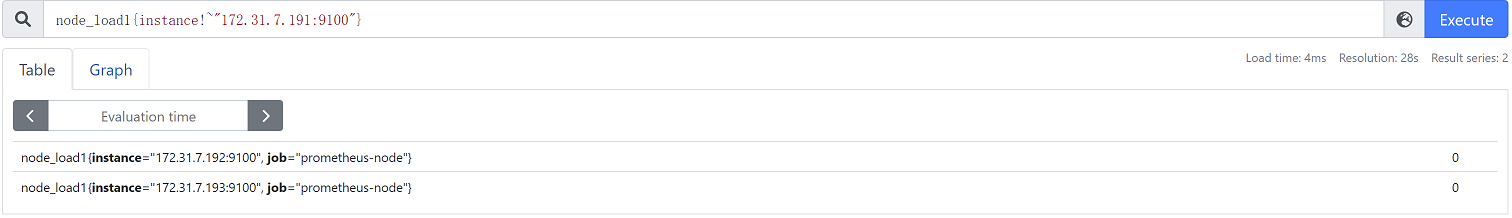
node_load1{instance!~"172.31.7.191:9100"} #包含正则且取反 ( 查询不包括以172.31.7.191的主机)
6. Prometheus 的聚合函数
一般说来 , 单个指标的价值不大 , 监控场景中往往需要联合并可视化一组指标 , 这种联合机制即是指“聚合”操作 , 例如 , 将计数、求和、平均值、分位数、标准差及方差等统计函数应用于时间序列的样本之上生成具有统计学意义的结果等。
对查询结果事先按照某种分类机制进行分组 ( group by) 并将查询结果按组进行聚合计算也是较为常见的需求 , 例如分组统计、分组求平均值、分组求和等。
Prometheus 的聚合操作由聚合函数针对一组值进行计算并返回值作为结果。
Prometheus 内置提供的 11 个聚合函数 , 也称为聚合运算符 :
6.1 max、min、avg
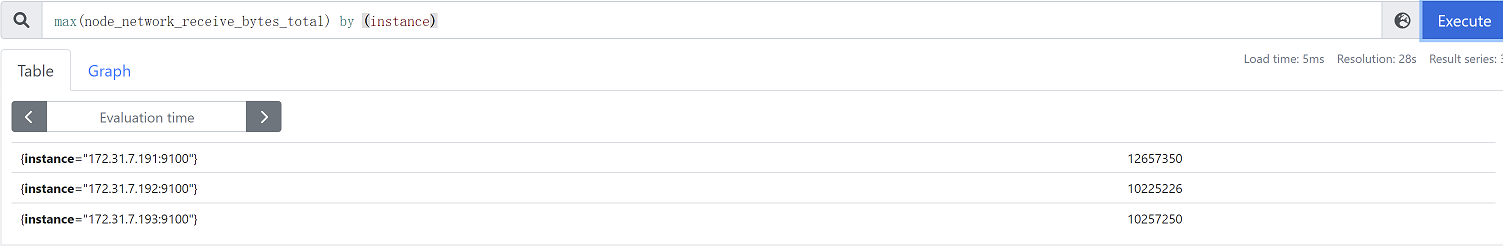
计算每个节点的最大的流量值 : max(node_network_receive_bytes_total) by (instance)
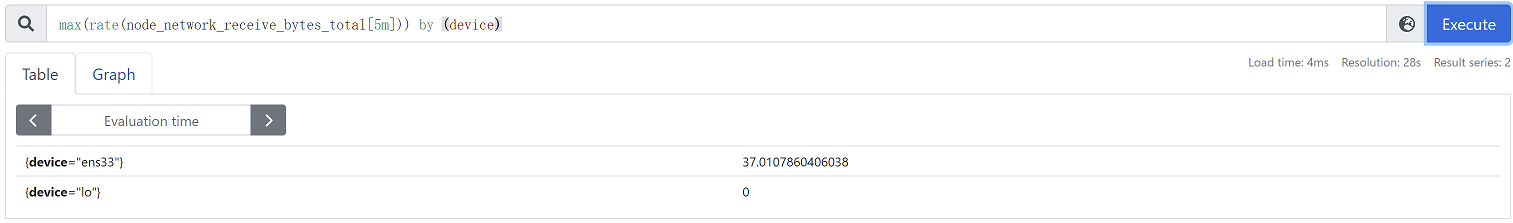
计算每个节点最近五分钟每个device的最大流量 : max(rate(node_network_receive_bytes_total[5m])) by (device)
6.2. sum、count
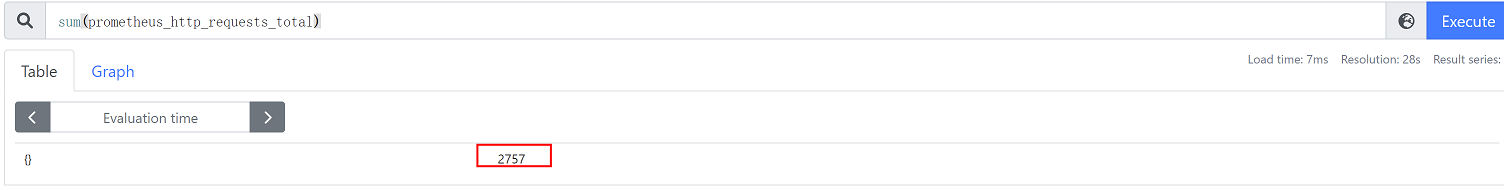
sum() #求数据值相加的和(总数) sum(prometheus_http_requests_total){} #下图中2757是指 最近总共请求数为2757次 , 用于计算返回值的总数(如http请求次数)
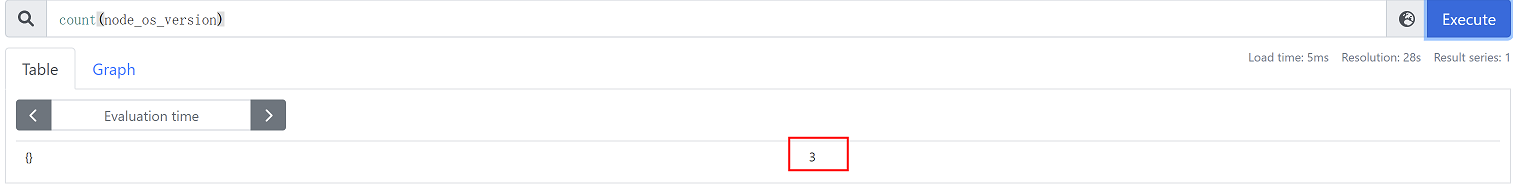
count() #统计返回值的条数 count(node_os_version) #下图中3表示一共3条返回的数据 , 可以用于统计节点数、pod数量等
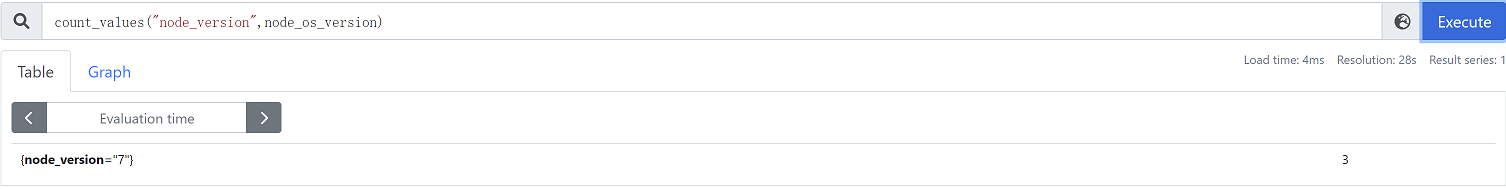
count_values() #对value的个数(行数)进行计数 count_values("node_version",node_os_version) #统计不同的系统版本节点有多少
6.3 abs、absent
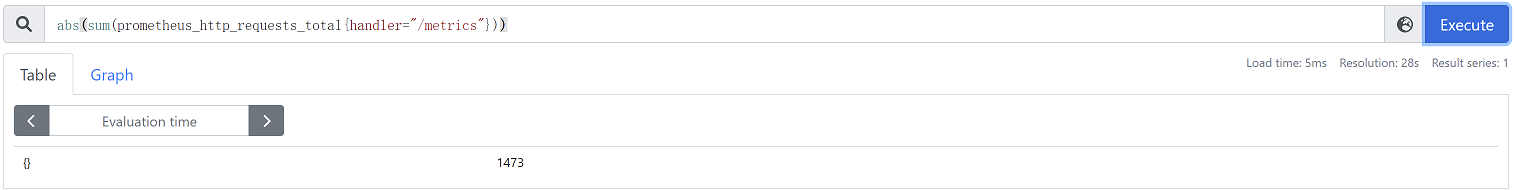
abs() #返回指标数据的值 abs(sum(prometheus_http_requests_total{handler="/metrics"})) #返回请求prometheus监控url为/metrics的总次数的值
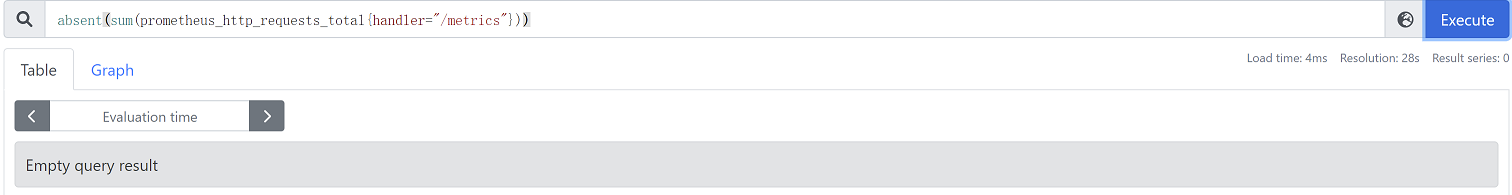
absent() 如果监指标有数据就返回空 , 如果监控项没有数据就返回1 , 可用于对监控项设置告警通知 absent(sum(prometheus_http_requests_total{handler="/metrics"})) #返回为空 , 说明有数据
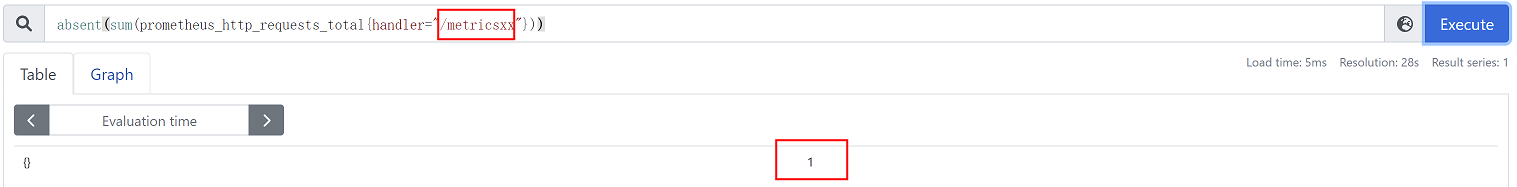
absent(sum(prometheus_http_requests_total{handler="/metrics"})) #假如请求一个不存在的url /metricsxx , 返回为1 , 说明没数据
6.4 stddev、stdvar
stddev() #标准差 比如5+5=10,1+9=10,那么1+9这一组的数据差异就大 , 在系统上表示数据波动较大 , 不稳定 stddev(prometheus_http_requests_total) #得出的值越大 , 说明差异越大 , 表示数据波动大 , 不稳定
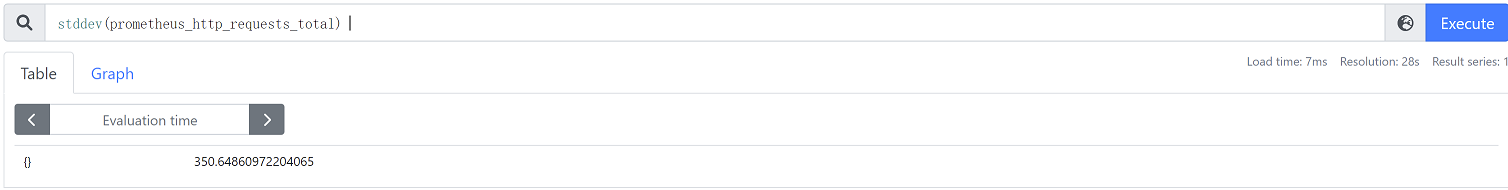
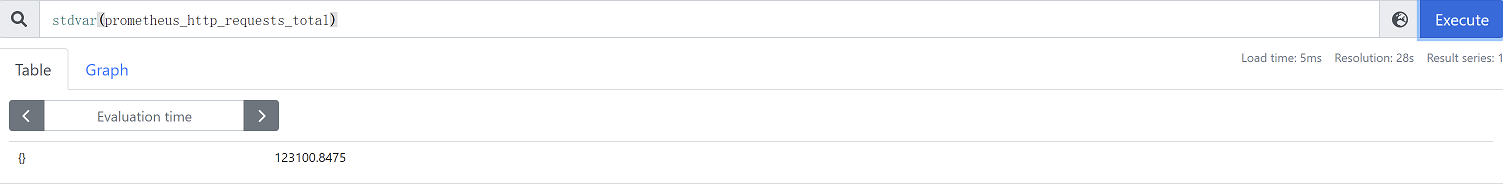
stdvar() #求方差 stdvar(prometheus_http_requests_total) #进行平方运算得出的值
6.5 topk、bottomk
topk() #样本值排名最大的N个数据 topk(6, prometheus_http_requests_total) #取从大到小的前6个
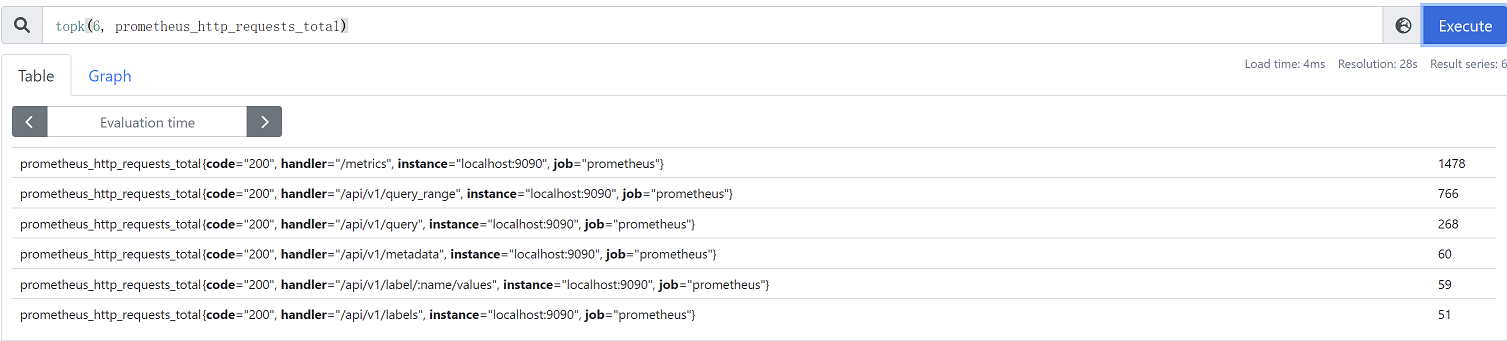
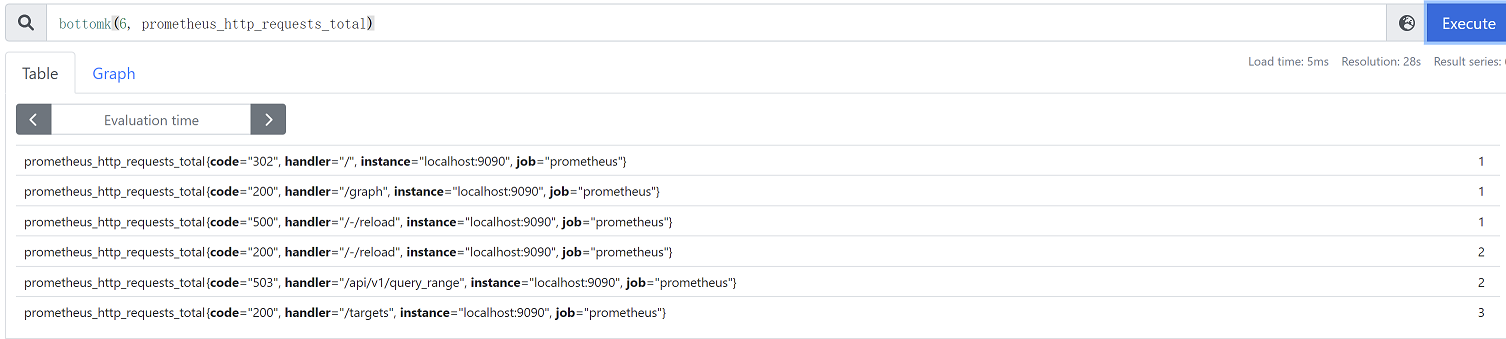
bottomk() #样本值排名最小的N个数据 bottomk(6, prometheus_http_requests_total) #取从小到大的前6个
6.6 rate、irate
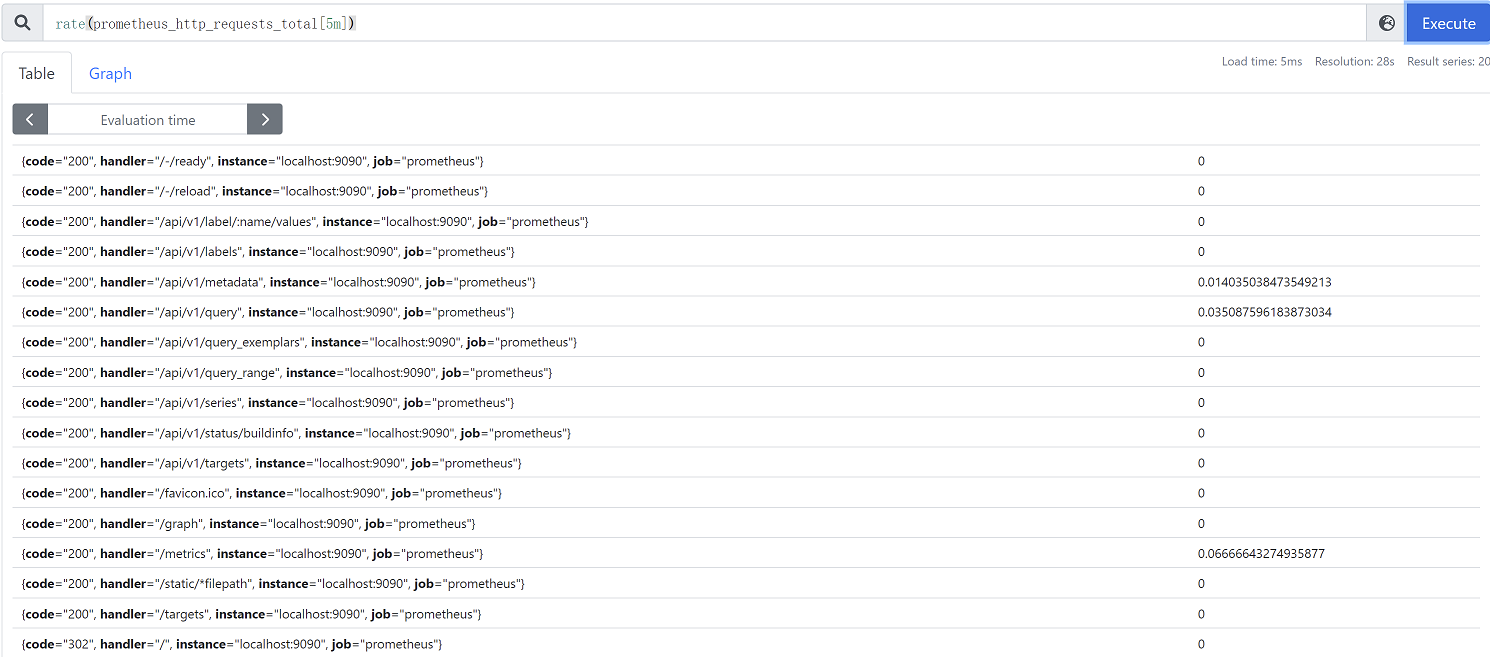
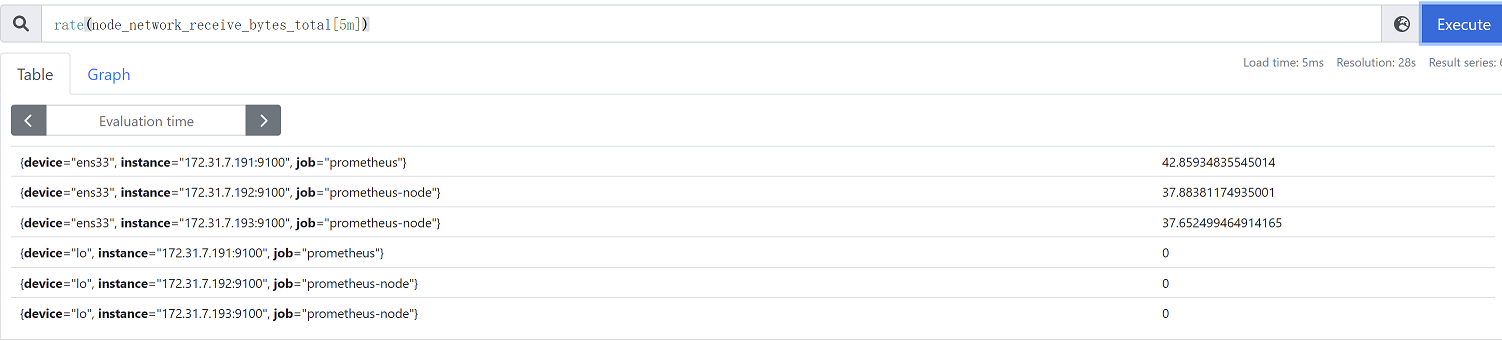
这两个参数广泛用于监控网卡速率 rate() rate()函数是专门搭配counter数据类型使⽤函数 , 其功能是取counter数据类型在这个时间段中平均每秒的增量平均数,适合用于计算数据相对平稳的数据。 rate(prometheus_http_requests_total[5m]) #取出5分钟的数据 , 计算每秒的平均数
rate(node_network_receive_bytes_total[5m]) #取出5分钟的数据 , 计算每秒的平均数
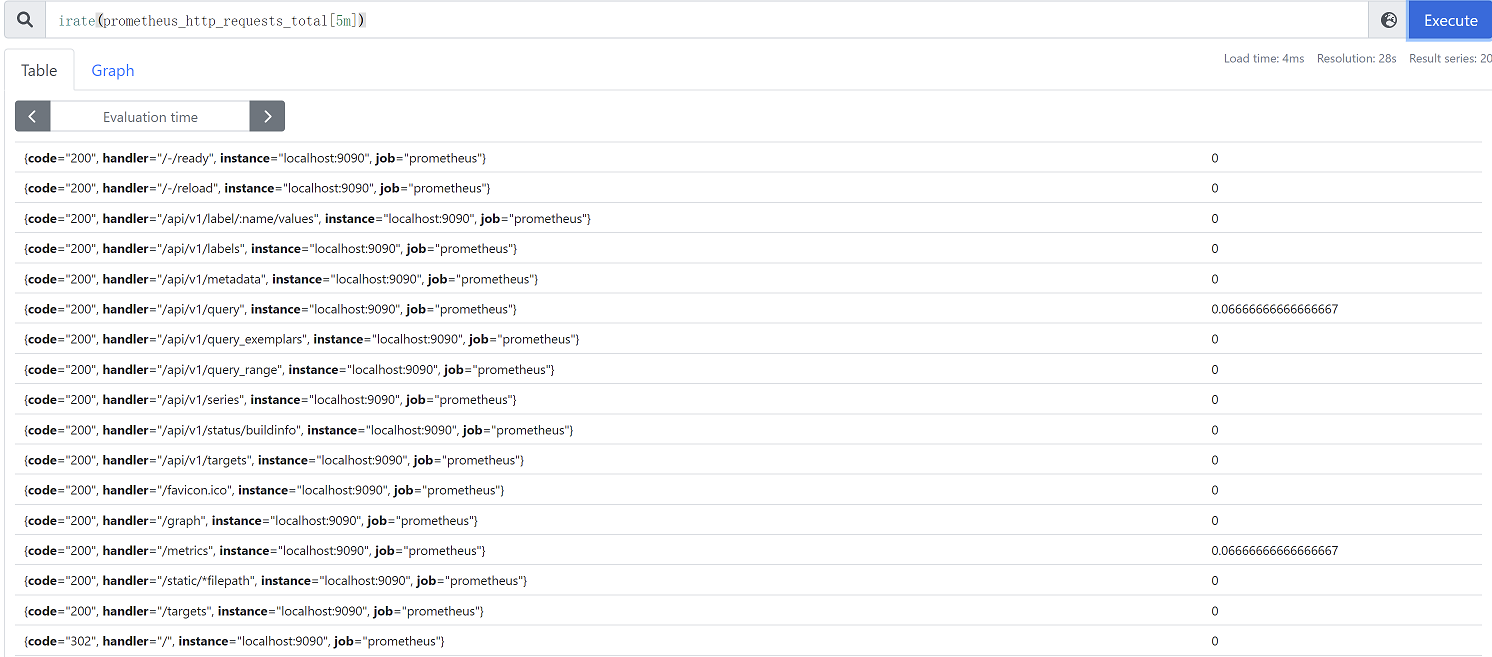
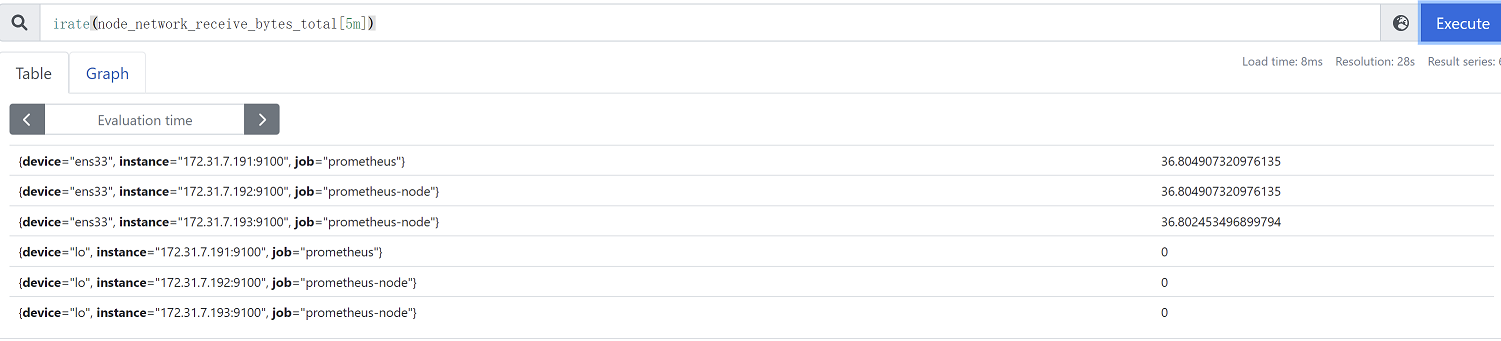
irate() irate()函数是专门搭配counter数据类型使⽤函数 , irate获取的是指定时间范围内最近的两个数据来计算数据的差异 , 适合计算数据变化比较大的数据 , 显示的数据相对比较准确。 irate(prometheus_http_requests_total[5m]) #5分钟内最近的两个请求总量的差异
irate(node_network_receive_bytes_total[5m]) #5分钟内最近的两个接收字节总量的速率
6.7 by、without
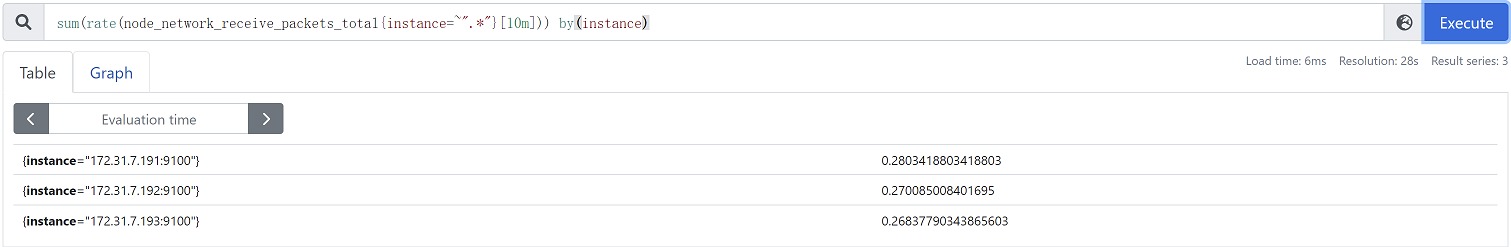
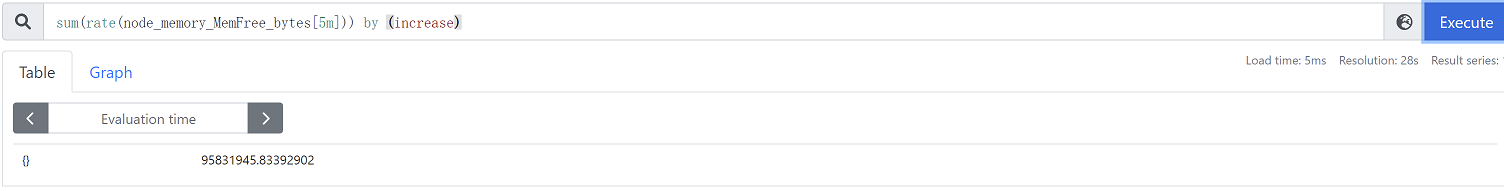
by , 在计算结果中 , 只保留by指定的标签的值 , 并移除其它所有的 sum(rate(node_network_receive_packets_total{instance=~".*"}[10m])) by(instance)
sum(rate(node_memory_MemFree_bytes[5m])) by (increase)
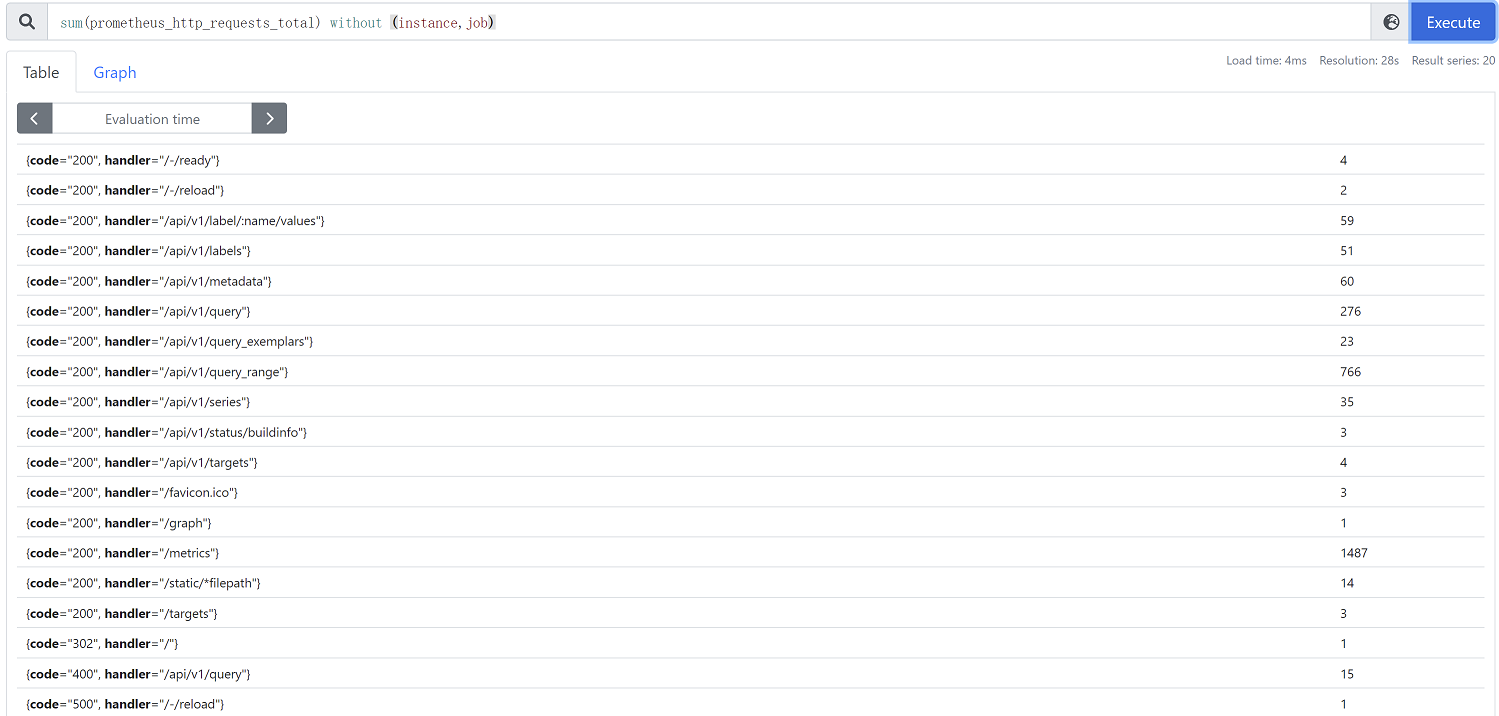
without , 从计算结果中移除指定的instance,job标签 , 保留其它标签 sum(prometheus_http_requests_total) without (instance,job)
6. PromQL 的聚合表达式
PromQL 中的聚合操作语法格式可采用如下面两种格式之一 :
<聚合函数>(向量表达式) by|without (标签)<聚合函数> by|without (标签) (向量表达式)
分组聚合 : 先分组、后聚合
by : 仅使用by子句中指定的标签进行聚合 , 结果向量中出现但未被 by 指定的标签则会被忽略;为了保留上下文信息 , 使用 by 子句时需要显式指定其结果中原本出现的 job、instance 等一类的标签。
without : 从结果向量中删除由 without 指定的标签 , 未指定的那部分标签则用作分组标准
示例 :
每台主机
CPU在最近5分钟内的平均使用率(1-avg(rate(node_cpu_seconds_total{mode="idle"}[5m])) by (instance)) * 100node_cpu_seconds_total{mode="idle"}: 得出不同主机的空闲时间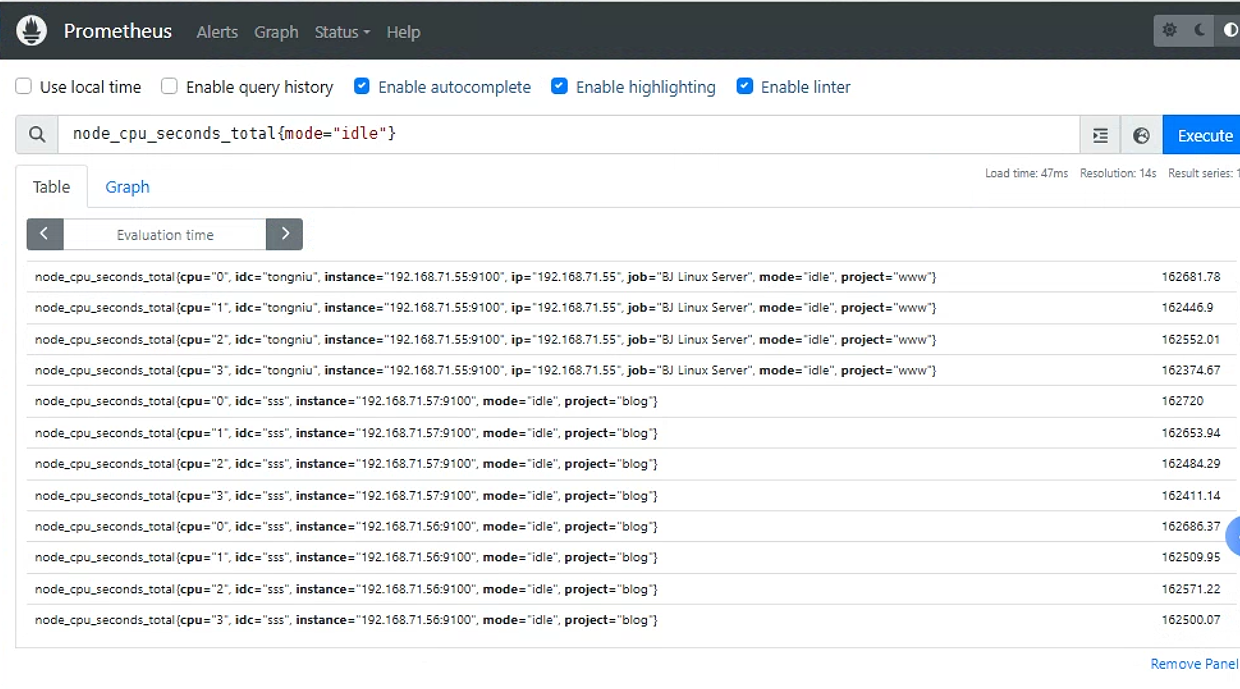
rate(node_cpu_seconds_total{mode="idle"}[5m]): 得出5分钟内的空闲增长率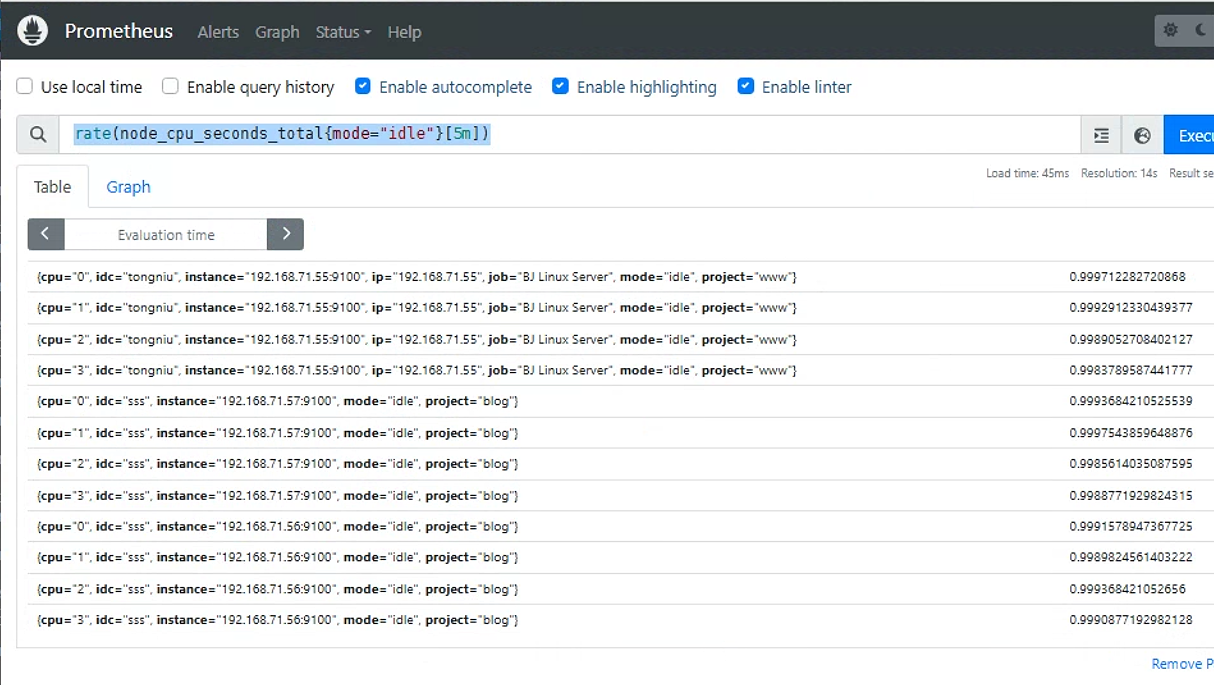
(1-avg(rate(node_cpu_seconds_total{mode="idle"}[5m])) by (instance)) * 100: 每台服务器CPU5分钟内的平均使用率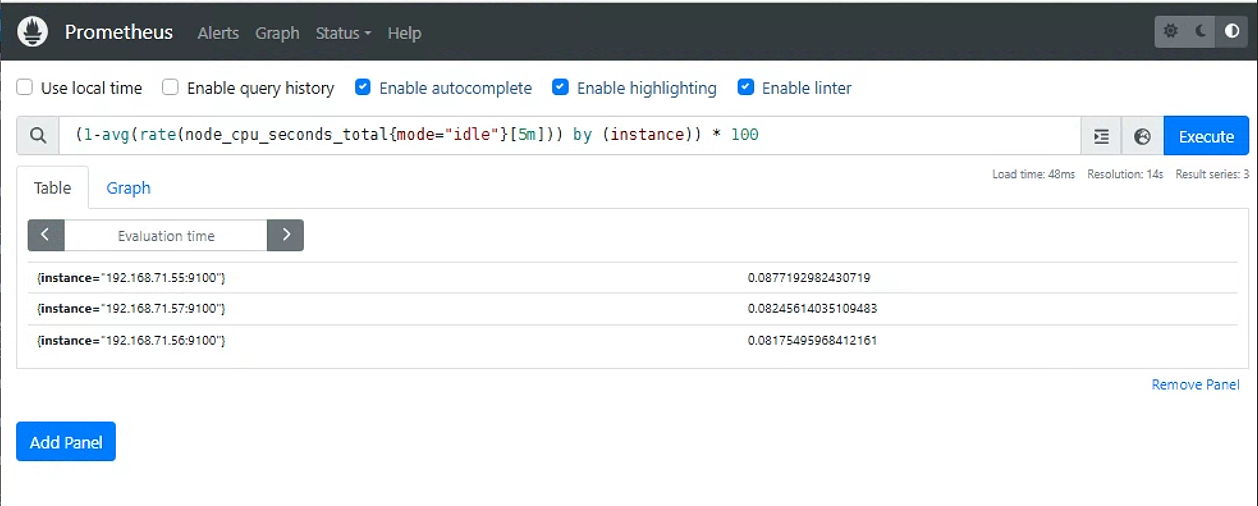
查询 1 分钟的
load average的时间序列是否超过主机CPU数量2倍node_load1 > on (instance) 2 * count (node_cpu_seconds_total{mode="idle"}) by (instance)count(node_cpu_seconds_total{mode="idle"}) by(instance): 计算出每台主机是4核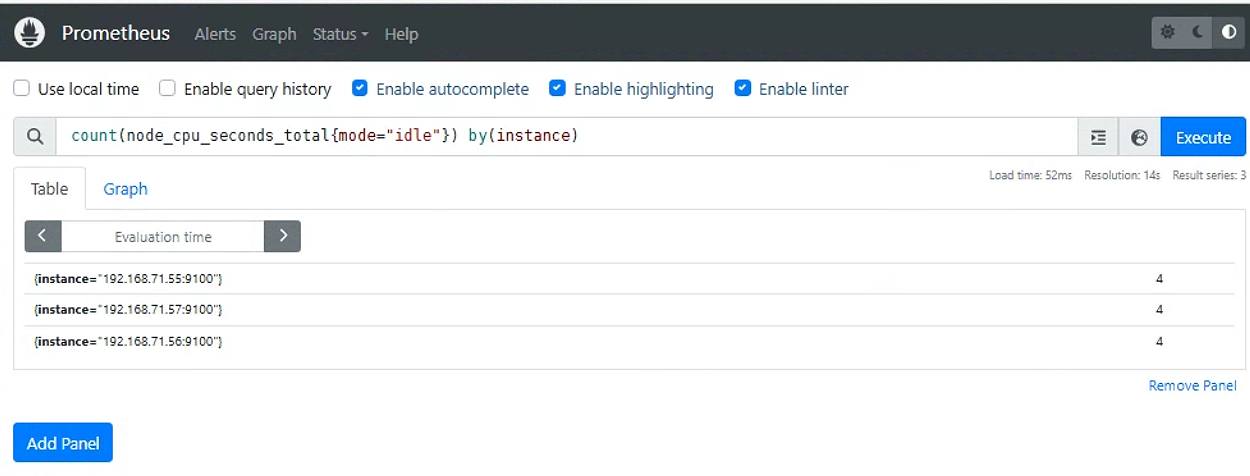
node_load1 > on (instance) count (node_cpu_seconds_total{mode="idle"}) by (instance): 没有值说明没有超负荷运行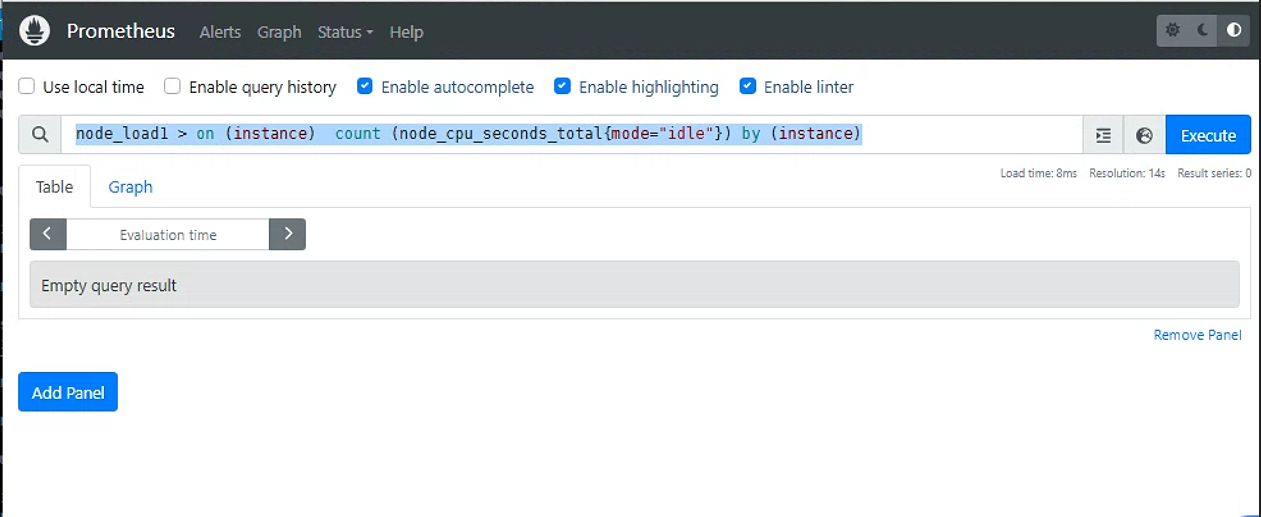
计算主机内存使用率
可用内存空间 : 空闲内存、
buffer、cache指标之和node_memory_MemFree_bytes + node_memory_Buffers_bytes + node_memory_Cached_bytes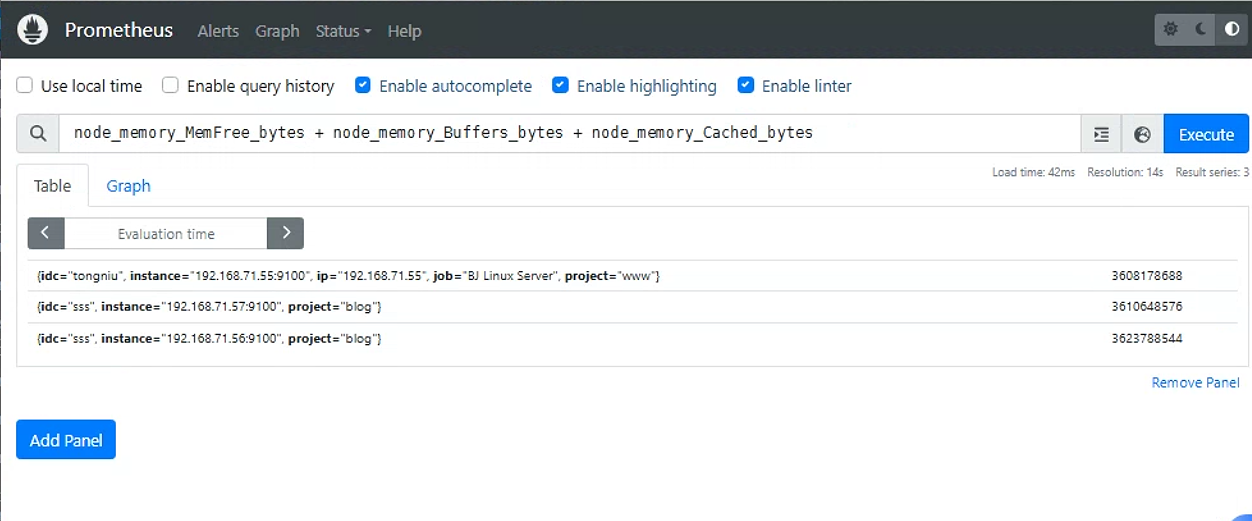
已用内存空间:总内存空间减去可用空间
node_memory_MemTotal_bytes - (node_memory_MemFree_bytes + node_memory_Buffers_bytes + node_memory_Cached_bytes)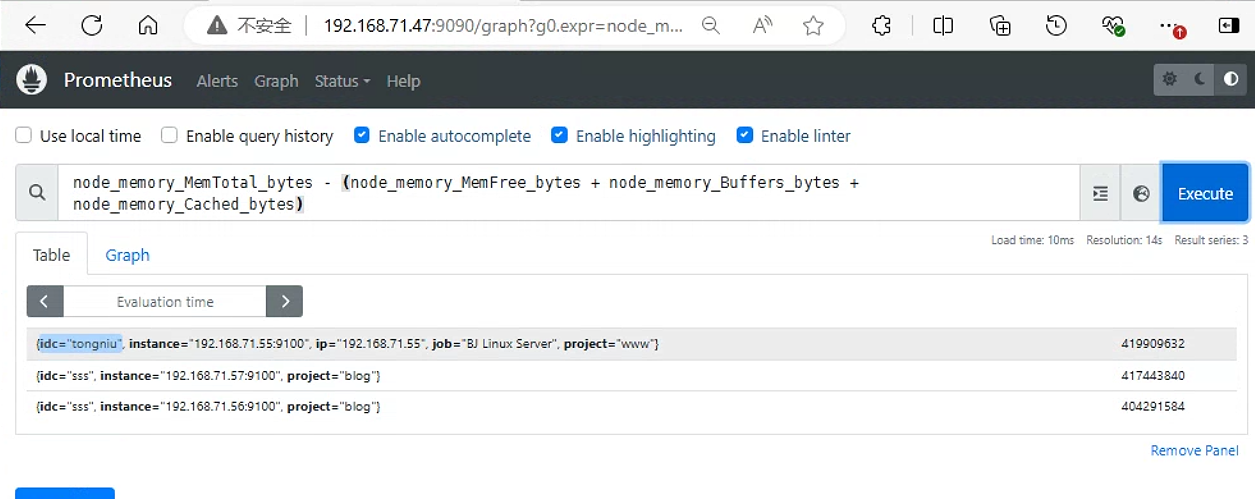
使用率:已用空间除以总空间
(node_memory_MemTotal_bytes - (node_memory_MemFree_bytes + node_memory_Buffers_bytes + node_memory_Cached_bytes)) / node_memory_MemTotal_bytes * 100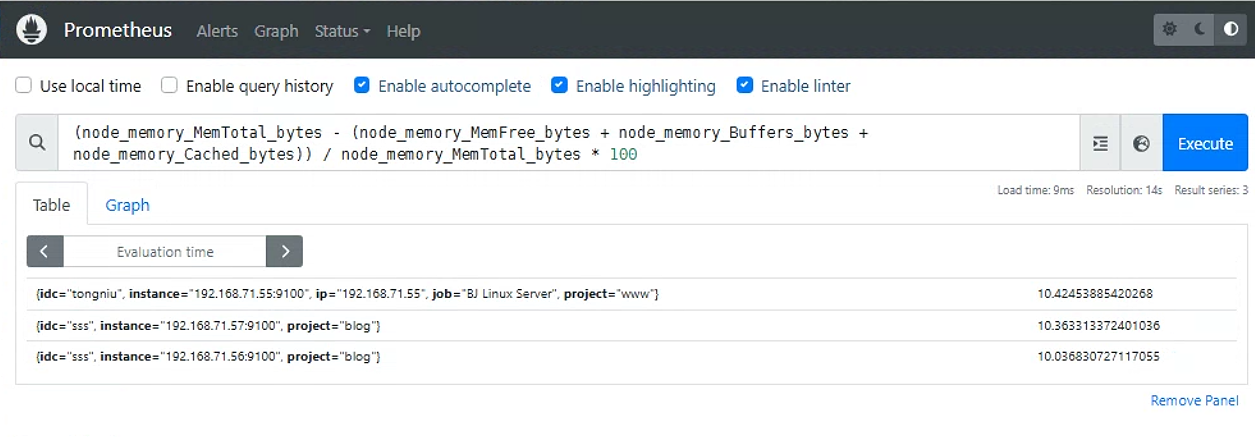
针对查看k8s的监控可使用以下表达式 :
计算所有
node节点所有容器总计内存 :sum by (instance) (container_memory_usage_bytes{instance=~"node*"})/1024/1024/1024计算
node01节点最近1m所有容器cpu使用率 :sum (rate(container_cpu_usage_seconds_total{instance="node01"}[1m])) / sum (machine_cpu_cores{instance =~"node01"}) * 100计算最近
1m所有容器cpu使用率sum by (id) (rate(container_cpu_usage_seconds_total{id!="/"}[1m]))查询
K8S集群中最近1m每个Pod的CPU使用率sum by (name) (rate(container_cpu_usage_seconds_total{image!="", name!=""}[1m]))
参考链接
构建企业级监控平台系列( 十八) : Prometheus 数据查询语言 PromQL (qq.com)