1-Prometheus基础概念
1. Prometheus概述
Prometheus 是一个开源的服务监控系统和时序数据库 , 最初由SoundCloud开发的开源的系统监控和报警工具包。自2012年诞生以来 , 被许多公司和组织采用 , 该项目拥有非常活跃的社区和开发者。Prometheus 现在是一个独立的开源项目 , 独立于任何公司进行维护。为了证明这一点 , Prometheus 于2016年加入了云原生计算基金会CNCF , 成为了继Kubernetes之后的第二个CNCF托管项目。
Prometheus收集和存储metrics作为时间序列数据 , 也就是说 , metrics与它被记录的时间戳以及称为标签的可选键值对一起被存储。
Prometheus 能够直接把API Server作为服务发现系统使用 , 进而动态发现和监控集群中的所有可被监控的对象。
官网地址: https://prometheus.io
github地址: https://github.com/prometheus
2. Prometheus主要特点
多维的数据模型(基于时间序列的
Key、value键值对)灵活的查询和聚合语言
PromQL提供本地存储和分布式存储
通过基于
HTTP和HTTPS的Pull模型采集时间序列数据(pull数据的拉取 , 时间序列:每段 时间点的数据值指标 , 持续性的产生。横轴标识时间 , 纵轴为数据值 , 一段时间内数值的动态变化 , 所有的点连线形成大盘式的折线图)可利用
Pushgateway(Prometheus的可选中间件)实现Push模式可通过动态服务发现或静态配置发现目标机器 ( 通过
consul自动发现和收缩)支持多种图表和数据大盘
3. Prometheus 原理及架构图
3.1 原理
Prometheus的基本原理是通过 HTTP 周期性抓取被监控组件的状态 , 任意组件只要提供对应的 HTTP 接口并且符合Prometheus定义的数据格式 , 就可以接入Prometheus监控。
Prometheus的实现架构并不复杂 , 原理其实就是收集数据、处理数据、可视化展示 , 再进行数据分析以及报警处理。但其珍贵之处在于提供了一整套可行的解决方案 , 并且形成了一整个生态 , 能够极大地降低我们的研发成本。
3.2 架构图
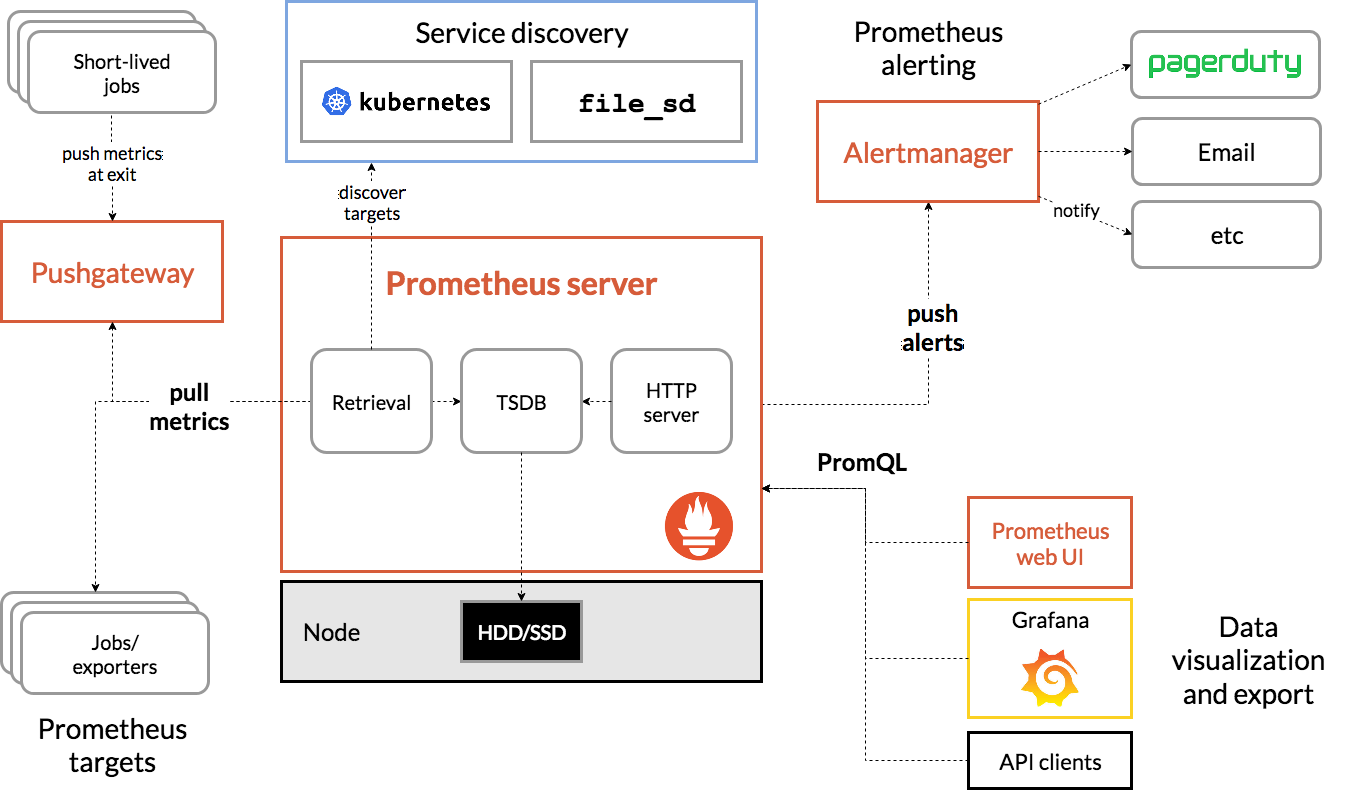
3.3 组件介绍
Prometheus Server 负责定期在目标上抓取 metric(指标)数据 , 每个抓取目标都需要暴露一个 HTTP 服务接口用于 Prometheus 定时抓取。
Storage 通过一点的规则清理和整理数据 , 并把得到的结果存储到新的时间序列中。
Prometheus 通过 PromQL 和其他 API 可视化地展示收集的数据。Prometheus 支持多种方式的图表可视化 , 例如 Grafana、自带的 PromDash 及自身提供的模板引擎等。Prometheus 还提供 HTTP API 查询方式 , 自定义所需要的输出。
AlertManager 是独立于 Prometheus 的一个组件 , 在出发了预先设置在 Prometheus 中的高级规则后 , Prometheus 便会推送告警消息到 AlertManager。AlertManager 提供了十分灵活的告警方式 , 可以通过邮件、slack 或者钉钉等途径推送。并且 AlertManager 支持高可用部署 , 为了解决多个 AlertManager 重复告警的问题 , 引入了 Gossip , 在多个 AlertManager 之间通过 Gossip 同步告警信息。
4. 适用场景
Prometheus适用于记录文本格式的时间序列数据。既适合以机器为中心的监控 , 也适合面向服务的体系结构的监控。在微服务的世界里 , 对多维数据收集和查询的支持是一个特别的优势。
Prometheus 是专为提高系统可靠性而设计的 , 可以在断电期间快速诊断问题 , 每个 Prometheus Server 都是相互独立的 , 不依赖于网络存储或其他远程服务。当基础架构出现故障时 , 可以通过 Prometheus 快速定位故障点 , 而且不会消耗大量的基础架构资源。
Prometheus 非常重视可靠性 , 即使在出现故障的情况下 , 也可以随时查看有关系统的可用统计信息。如果需要百分之百的准确度 , 例如按请求数量计费 , 那么 Prometheus 不太适合 , 因为它收集的数据可能不够详细完整。这种情况下 , 最好使用其他系统来收集和分析数据以进行计费 , 并使用 Prometheus 来监控系统的其余部分。
5. Prometheus 工作模式与流程
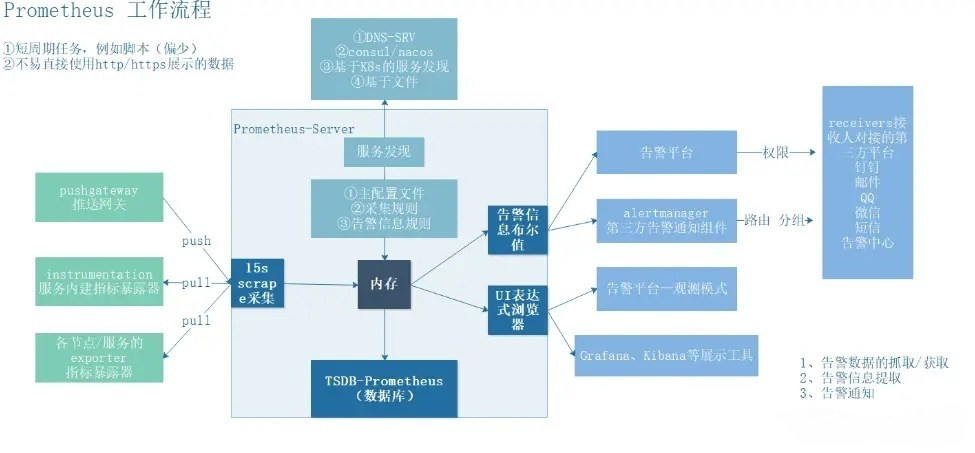
5.1 Prometheus的工作模式:
Prometheus Server基于服务发现 (Service Discovery) 机制或静态配置获取要监视的目标 (Target) , 并通过每个目标上的指标exporter来采集 (Scrape) 指标数据 ;Prometheus Server内置了一个基于文件的时间序列存储来持久存储指标数据 , 用户可使用PromQL接口来检索数据 , 也能够按需将告警需求发往Alertmanager完成告警内容发送 ;一些短期运行的作业的生命周期过短 , 难以有效地将必要的指标数据供给到
Server端 , 它们一般会采用推送 (Push) 方式输出指标数据 ,Prometheus借助于Pushgateway接收这些推送的数据 , 进而由server端进行抓取。
5.2 Prometheus的工作流程
Prometheus以prometheus Server为核心 , 用于收集和存储时间序列数据。Prometheus Server从监控目标中通过pull方式拉取指标数据 , 或通过pushgateway把采集的数据拉取到Prometheus server中。Prometheus server把采集到的监控指标数据通过TSDB存储到本地HDD/ssD中。Prometheus采集的监控指标数据按时间序列存储 , 通过配置报警规则 , 把触发的报警发送到Alertmanager。Alertmanager通过配置报警接收方 , 发送报警到邮件、钉钉或者企业微信等。Prometheus自带的Web UI界面提供PromQL查询语言 , 可查询监控数据。Grafana可接入Prometheus数据源 , 把监控数据以图形化形式展示出。
5.3 时序数据介绍
时序数据 , 是在一段时间内通过重复测量(measurement ) 而获得的观测值的集合将这些观测值绘制于图形之上 , 它会有一个数据轴和一个时间轴 , 服务器指标数据、应用程序性能监控数据、网络数据等也都是时序数据。
5.3.1 数据来源
prometheus基于HTTP call(http/https请求 ) , 从配置文件中指定的网络端点(endpoint/IP:端口)上周期性获取指标数据很多环境、被监控对象 , 本身是没有直接响应/处理
http请求的功能 ,promethens-exporter则可以在被监控端收集所需的数据 , 收集过来之后 , 还会做标准化 , 把这些数据转化为prometheus可识别 , 可使用的数据 ( 兼容格式 )
5.3.2 收集数据
监控概念 : 白盒监控、黑盒监控
白盒监控 : 自省方式 , 被监控端内部 , 可以自己生成指标 , 只要等待监控系统来采集时提供出去即可
黑盒监控 : 对于被监控系统没有侵入性 , 对其没有直接"影响" , 这种类似于基于探针机制进行监控 (
snmp协议)
Prometheus支持通过三种类型的途径从目标上"抓取 (Scrape)"指标数据 ( 基于白盒监控)。Exporters一>工作在被监控端 , 周期性的抓取数据并转换为pro兼容格式等待prometheus来收集 , 自己并不推送。Instrumentation一>指被监控对象内部自身有数据收集、监控的功能 , 只需要prometheus直接去获取。Pushgateway—>短周期5s-10s的数据收集脚本。
5.4 Prometheus(获取方式)
Prometheus同其它TSDB相比有一个非常典型的特性:它主动从各Target上拉取(pull)数据 , 而非等待被监控端的推送(push)
两个获取方式各有优劣 , 其中 , Pull模型的优势在于:
集中控制 : 有利于将配置集在
Prometheus server上完成 , 包括指标及采取速率等;Prometheus的根本目标在于收集在target上预先完成聚合的聚合型数据 , 而非一款由事件驱动的存储系统通过targets(标识的是具体的被监控端)比如配置文件中的
targets : [ ‘localhost:9090’]
6. Prometheus 生态组件
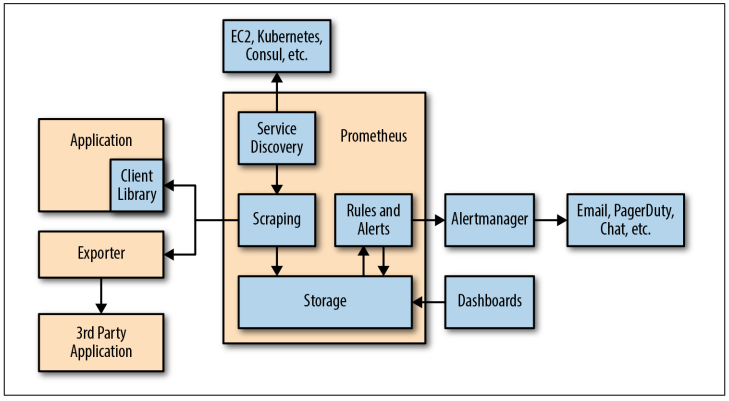
prometheus-server服务核心组件 , 采用
pull方式收集监控数据 , 通过http协议传输。并存储时间序列数据。Prometheus server由三个部分组成:Retrival,Storage,PromQL。Retrieval: 负责在活跃的target主机上抓取监控指标数据。Storage: 存储 , 主要是把采集到的数据存储到磁盘中。默认为15天( 可修改)。PromQL: 是Prometheus提供的查询语言模块。
client Library客户端库 , 目的在于为那些期望原生提供
Instrumentation功能的应用程序提供便捷的开发途径 , 用于基于应用程序内建的测量系统。Exporters指标暴露器 , 负责收集不支持内建
Instrumentation的应用程序或服务的性能指标数据 , 并通过HTTP接口供Prometheus Server获取。换句话说 ,Exporter负责从目标应用程序上采集和聚合原始格式的数据 , 并转换或聚合为Prometheus格式的指标向外暴露。常用的
ExportersNode-Exporter: 用于收集服务器节点(例如k8s)的物理指标状态数据 , 如平均负载、CPU、内存、磁盘、网络等资源信息的指标数据 , 需要部署到所有运算节点。mysqld-exporter/nginx-exporterKube-state-Metrics: 为prometheus采集k8s资源数据的exporter, 通过监听APIServer收集kubernetes集群内资源对象的状态指标数据 , 例如pod、deployment、service等等。同时它也提供自己的数据 , 主要是资源采集个数和采集发生的异常次数统计。需要注意的是
kube-state-metrics只是简单的提供一个metrics数据 , 并不会存储这些指标数据 , 所以可以使用prometheus来抓取这些数据然后存储 , 主要关注的是业务相关的一些元数据 , 比如Deployment、Pod、副本状态等 ; 调度了多少个replicas?现在可用的有几个?多少个Pod是running/stopped/terminated状态?Pod重启了多少次?有多少job在运行中。cAdvisor: 用来监控容器内部使用资源的信息 , 比如CPU、内存、网络I/0、磁盘I/0。blackbox-exporter: 监控业务容器存活性。
Service Discovery服务发现 , 用于动态发现待监控的
Target,Prometheus支持多种服务发现机制 : 文件、DNS、Consul、Kubernetes等等。服务发现可通过第三方提供的接口 ,
Prometheus查询到需要监控的Target列表 , 然后轮询这些Target获取监控数据。该组件目前由Prometheus Server内建支持Alertmanager是一个独立的告警模块 , 从
Prometheus server端接收到“告警通知”后 , 会进行去重、分组 , 并路由到相应的接收方 , 发出报警 , 常见的接收方式有: 电子邮件、钉钉、企业微信等。Prometheus Server仅负责生成告警指示 , 具体的告警行为由另一个独立的应用程序AlertManager负责 ; 告警指示由Prometheus Server基于用户提供的告警规则周期性计算生成 ,Alertmanager接收到Prometheus Server发来的告警指示后 , 基于用户定义的告警路由向告警接收人发送告警信息。Pushgateway类似一个中转站 ,
Prometheus的server端只会使用pull方式拉取数据 , 但是某些节点因为某些原因只能使用push方式推送数据 , 那么它就是用来接收push而来的数据并暴露给Prometheus的server拉取的中转站。可以理解成目标主机可以上报短期任务的数据到Pushgateway, 然后Prometheus server统一从Pushgateway拉取数据。Grafana是一个跨平台的开源的度量分析和可视化工具 , 可以将采集的数据可视化的展示 , 并及时通知给告警接收方。其官方库中具有丰富的仪表盘插件。
7. Prometheus监控体系
系统层监控( 需要监控的数据)
CPU、Load、Memory、swap、disk i/o、process等网络监控 : 网络设备、工作负载、网络延迟、丢包率等
存储监控
存储性能监控方面: 存储通常监控块的读写速率 ,
IOPS。读写延迟 , 磁盘用量等 ; 文件存储通常监控文件系统inode。读写速度、目录权限等。存储系统监控方面: 不同的存储系统有不同的指标 , 例如 , 对于
ceph存储需要监控OSD,MON的运行状态 , 各种状态pg的数量以及集群IOPS等信息。存储设备监控方面: 对于构建在x86服务器上的存储设备 , 设备监控通过每个存储节点上的采集器统一收集磁盘、
SSD、网卡等设备信息 ; 存储厂商以黑盒方式提供商业存储设备 , 通常自带监控功能 , 可监控设备的运行状态 , 性能和容量的。
服务器监控
CPU: 涉及整个CPU的使用量、用户态百分比、内核态百分比 , 每个CPU的使用量、等待队列长度、I/O等待百分比、CPU消耗最多的进程、上下文切换次数、缓存命中率等。内存: 涉及内存的使用量、剩余量、内存占用最高的进程、交换分区大小、缺页异常等。
网络
I/O: 涉及每个网卡的上行流量、下行流量、网络延迟、丢包率等。磁盘
I/O: 涉及硬盘的读写速率、IOPS、磁盘用量、读写延迟等。
中间件及基础设施类监控端监控( 移动
APP、特定程序等)消息中间件 :
kafka、RocketMQ、等消息代理WEB服务器容器 :
tomcat、weblogic/apache/php/spring系列数据库/缓存数据库:
MysQL、PostgresQL、MogoDB、es、redis
应用层监控
用于衡量应用程序代码状态和性能
监控的分类:黑盒监控 , 白盒监控(
promtheus)白盒监控: 自省指标 , 等待被下载( 只需要去拿就行)
黑盒指标: 基于探针的监控方式 , 不会主动干预、影响数据( 摄像头这种)
业务层监控
用于衡量应用程序的价值 , 如电商业务的销售量 ,
ops、dau日活、转化率等 , 业务接口:登入数量 , 注册数、订单量、搜索量和支付量。
8.Prometheus的局限性
Prometheus是一款指际监控系统 , 不适合存储事件及日志等 ; 它更多地展示的是趋势性的监控 , 而非精准数据 ;
Prometheus认为只有最近的监控数据才有查询的需要 , 其本地存储的设计初衷只是保存短期( 例如一个月)数据 , 因而不支持针对大量的历史数据进行存储 ; 若需要存储长期的历史数据 , 建议基于远端存储机制将数据保存于InfluxDB或openTsDB等系统中 ;
Prometheus的集群机制成熟度不高 , 可基于Thanos( 和灭霸是一个单词)实现Prometheus集群的高可用及联邦集群。
mysql、nginx、k8s等使用多个不同的Prometheus收集 , 形成联邦集群。
参考链接
构建企业级监控平台系列 ( 十二 ) : Prometheus 入门与安装 (qq.com)