GlusterFS是一种分布式文件系统 , 项目中使用它作为数据文件冷备存储后台。GlusterFS的技术特点是采用无元数据中心的架构 , 采用Xlator以调用栈的形式组织各功能模块 , Xlator之间通过RPC进行通信 , 客户端与服务端共用某些Xlator , 下图就是Gluster客户端与服务端的Xlator栈示意图。
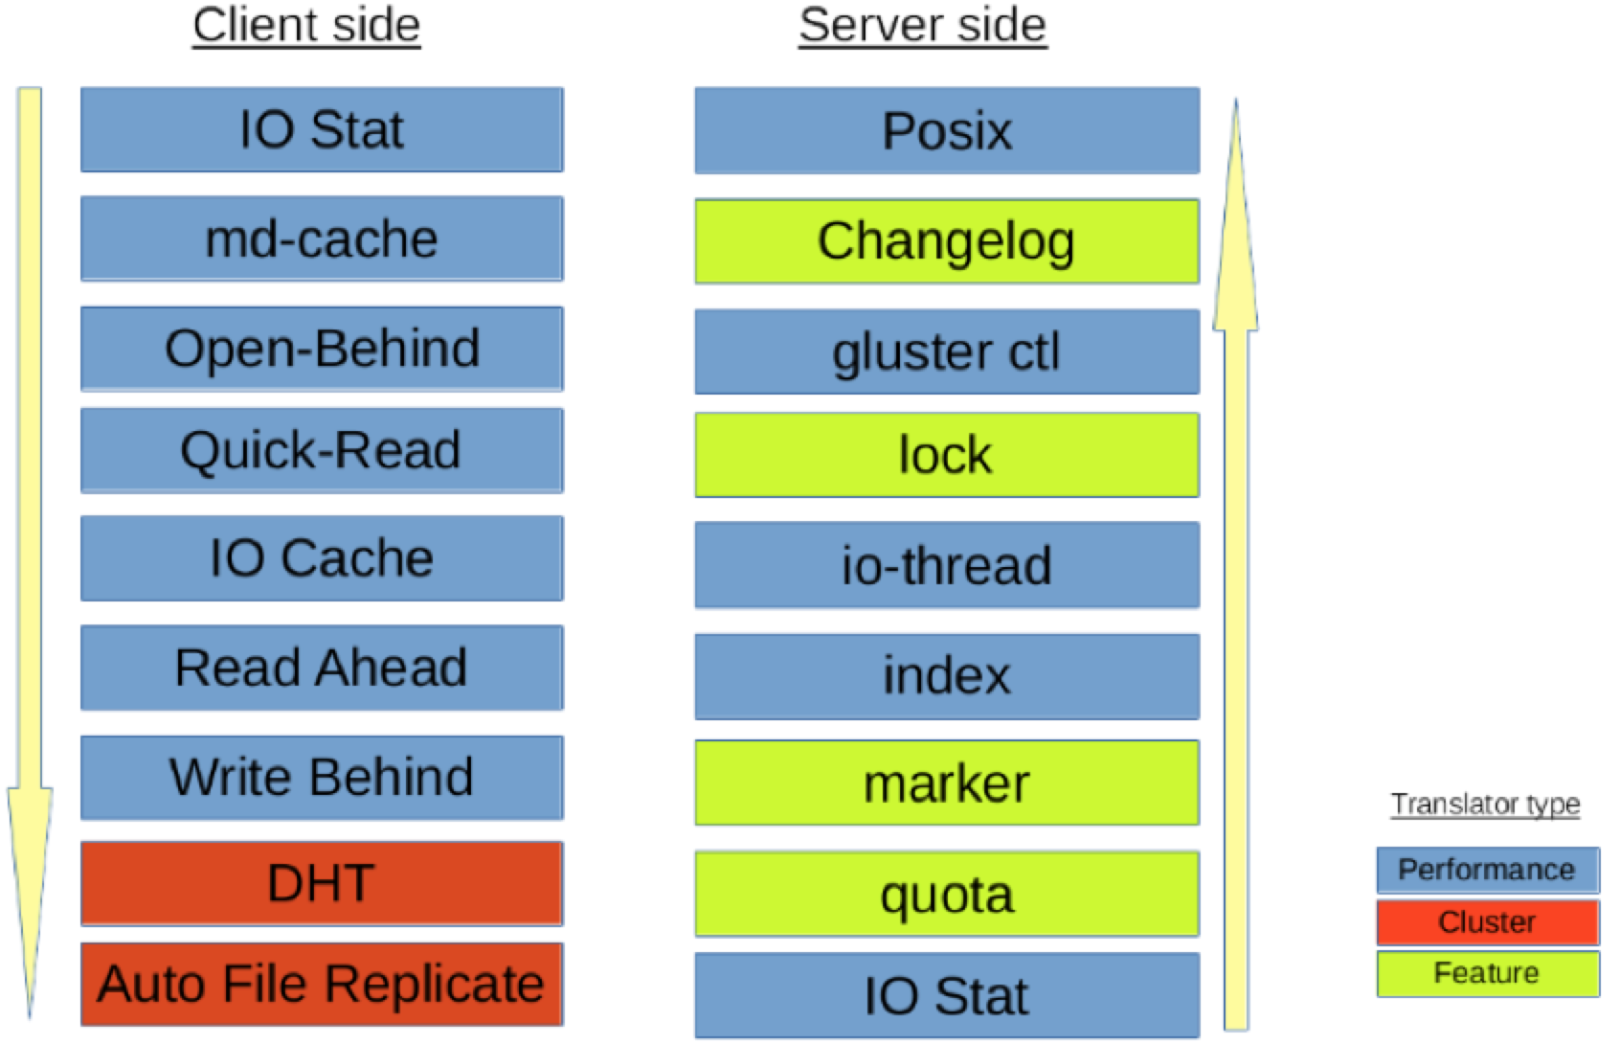
由于GlusterFS采用了Xlator的架构 , 所以Distributed Replicated Volume在代码结构上是Distributed Xlator和Replicated Xlator的组合 , Distributed Striped Volume类似。
GlusterFS的使用方式
FUSE方式 (mount -t glusterfs)NFS方式 (mount -t nfs)libgfapi方式
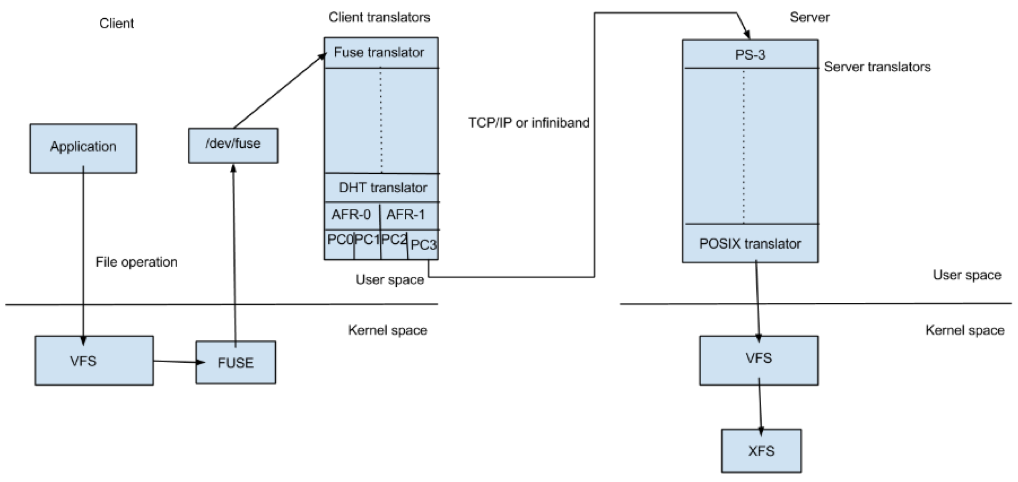
下图是FUSE模式下的GlusterFS I/O流
1. GlusterFS数据分布DHT
GlusterFS的分布式哈希表(Distributed Hash Tables DHT)机制是数据分布的核心 , 以目录作为文件分布的基本单位。
当用户在挂载点内创建目录
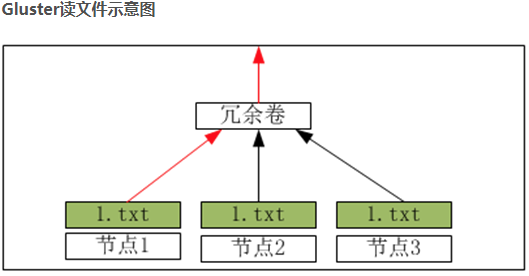
dir0, 目录会在所有brick生成GlusterFS将每个目录的哈希地址空间规定为0x00000000~0xffffffff的32位整数区间 , 然后按每个brick分割成一组连续的地址空间 , 每个brick对应的地址区间 (Layout)保存在对应目录的扩展文件属性(xattr)中扩展属性是文件系统提供的一个功能 , 通过
Key-Value的方式将一些元数据信息同文件本体或目录存储在一起Glusterfs能够通过brick的大小 , 对不同的brick分配不同大小的layout
当在
dir0目录下写文件时 , 根据所在目录GFID和文件名作为输入参数 , 通过D-M算法计算哈希值通过文件的哈希值确定文件位于哪一个
brick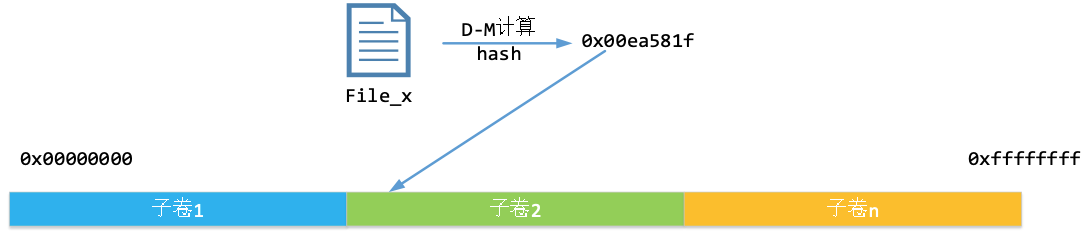
如果创建其他目录
dirx, 那么会重新生成这个目录在每个brick上的划分区间 , 存储在扩展属性中(分布元数据保存在文件及目录中 , 体现去中心化) , 如果在目录dir0中再创建下级目录dir0/sub-dir1, 类似6, 会生成自己的哈希分布空间Hash算法有一定概率 , 极端情况下会出现brick之间分布不均的情况 , 此时GlusterFS采用链接解决这种问题 , 文件读写时 , 客户端会先到源brick查找文件如果读取到的文件是链接形式 , 则通过文件的扩展属性定位到真实的brick, 然后客户端会直接在真实brick读写文件。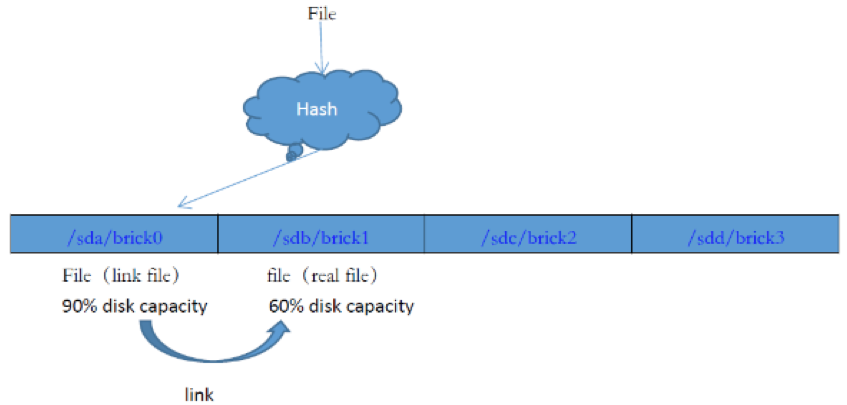
扩容 ,
GlusterFS的扩容有两个步骤添加
brick, 现有的目录分布不会扩展到新brick;旧文件不会迁移到新brick;在现有的目录分布下创建新文件不会写到新brickReblance, 修复现有的目录hash分布(Fix-Layout)并扩展到新brick;部分文件开始迁移到新brick(Migrate-Data);新创建的文件按照新的哈希分布确定存储位置。Gluster挂载目录(root)开始 , 深度优先遍历策略修复所有目录。
缩容
重新计算缩容后的
hash分布 , 将被缩容brick的数据迁走 , 将被缩容brick从卷中摘除
分布式副本卷的数据读写
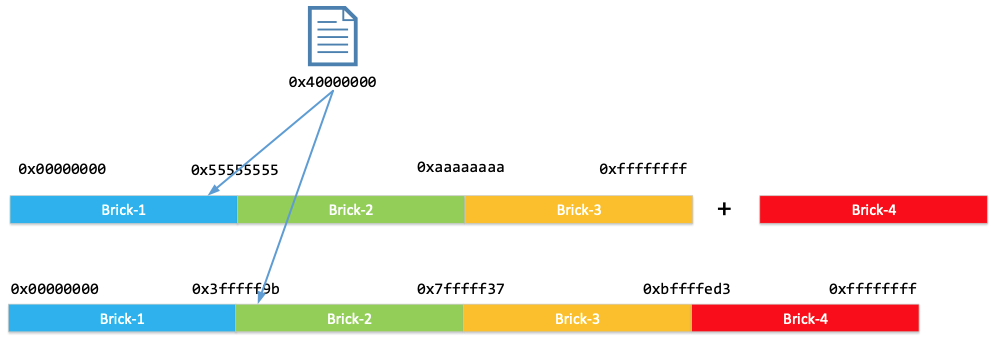
写 : 采用一个文件同时写入多个副本的模式 , 当有一个副本成功写入就返回成功
数据写入过程中 , 可能会发生有副本写入失败的情况
更有甚者 , 各副本之间会发生脑裂(
brain-split)
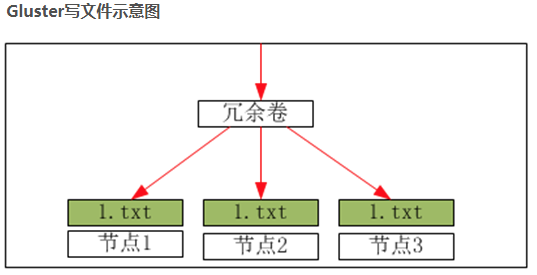
读 : 从多个镜像副本中选取一个状态为正常的读取
多个副本之中只要有一份是正常的 , 都可以正确读取
操作示例
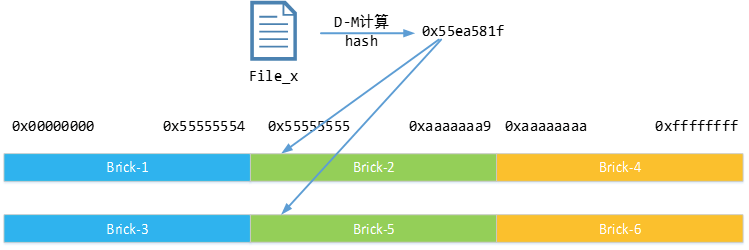
创建一个
replicate为2, 共有6个brick的distributed replicate卷 , 数据目录分别为/brick1~/brick6挂载目标卷
/data/mount创建目录
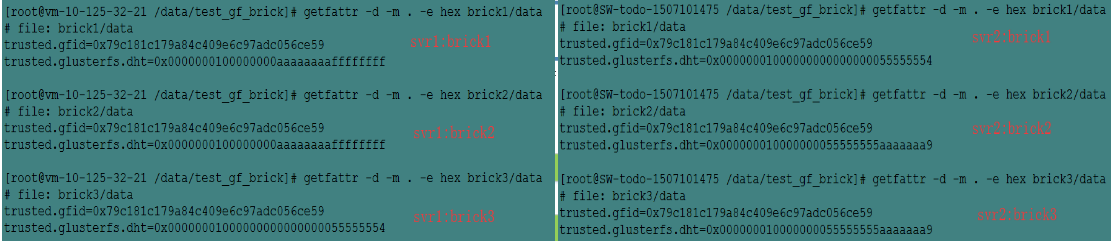
/data/mount/test, 此时分别会生成/brick1/test~/brick6/test的文件目录 , 每个目录的扩展属性中记录了本test目录在本brick的hash分布区间对于
test目录 ,6个brick会分成3组 , 每组两个brick有着相同的分布区间 , 每组将存储相同的文件互为备份。
2. GlusterFS 自动文件副本(AFR)
GlusterFS恢复数据都是基于副本卷来说的 , GlusterFS复制卷是采用镜像的方式做的 , 并且是同步事务性操作。简单来说就是 , 某一个客户要写文件时 , 先把这个文件锁住 , 然后同时写两个或多个副本 , 写完后解锁 , 这个操作才算结束。那么在写某一个副本时发生故障没有写成功 , 或者运行过程中某一个节点断电了 , 造成数据丢失了 , 等等 , 就能通过另一个副本来恢复。
就是GlusterFS写副本时同步写的 , 就是客户端同时写两份数据 , 这样就会产生两倍的流量 , 测2副本的分布式复制卷性能时 , 能明确看到性能只有无副本的一半 , 或者只有读的一半;另一个分布式文件系统ceph就不是这样 , 是异步来写副本的 , 就是写到一个主OSD(ceph的存储单元)就返回了 , 这个OSD再通过内部网络异步写到其他的OSD , 这样不是更快了。那么这两种方法有什么优缺点呢 , 那种比较好 , 或者各自为什么采用这样的方法?
说道恢复就有什么时候恢复 , 怎么恢复 , 凭什么说这个副本是好的 , 那个副本是坏的呢 , 这样的问题 , 一个一个来说吧。
首先 , 什么时候恢复?有这样三种场景会触发恢复 , 宕机的节点恢复正常时;副本缺失的文件被读写到时 , 比如运行如下命令:
ls -l <file-path-on-gluster-mount>; 每十分钟gluster会自行检查;手动下命令触发恢复 , 命令为gluster volume heal VOLNAME怎么恢复?在这三种环境的任何一种下 ,
gluster都会做检查 , 看需不需要来个恢复 , 检查什么呢 , 就是changelog, 通过这个changelog来决定哪个副本坏了 , 要修复了。凭什么说它坏了呢?刚才说了
changelog会记录的 , 记录的什么呢 , 就是这个文件操作了什么 , 这个可以从文件的扩展属性反正出来 , 每一个文件都有一个扩展属性 , 主要记录了这个文件操作了什么 , 以及所有其他的副本操作了什么 , 副本的扩展属性如果不一样 , 那么就是有问题 , 要恢复自己 , 还是凭自己去恢复其他副本 , 都看这个扩展属性了 , 可以用命令getfattr -m . -d -e hex <FILENAME>, (和getfattr对应 , 有一个setfattr命令是可以设置这些属性的 , 具体命令为setfattr -n trusted.glusterfs.volume-id -v 0x937d9caf46544ed0a2d22e25edb23a75 /brick2, )这样设置了/brick2所在卷的id, 查到扩展属性的值就是如下图所示的这样的一个东西: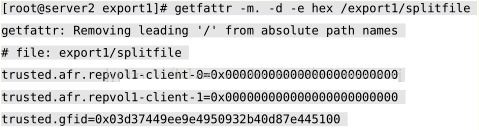
这张图中值得注意的是 ,
trusted.afr.repvol1-client-0, 还有trusted.afr.repvol1-client-1, 这两条就是自己的和副本的扩展属性了。先讲名字 ,repvol1是卷名 ,client是固定的 ,0或1是subvolume-index, 是brick的一个编号。后面的值看起来一大串 , 一共有24bit, 分三部分 , 每部分4byte, 如下图所示: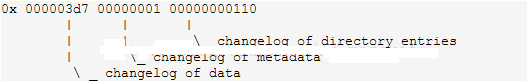
分别表示数据,元数据,和
entry(gfid),那么这三个东西每一个变化了在这个扩展属性上都会做相应的变化,怎么变化呢,这三个部分分别是三个计数,操作文件之前要先写计数,简单来说可以理解为加一,操作完就减一,这样最后还是保持0,就表示OK。扩展属性被设置的文件和目录会在/<BRICK>/.glusterfs/indices/xattrop目录中有一个索引,具体如下所示,这个文件的内容好像是会定时清空的,啥时候清空呢?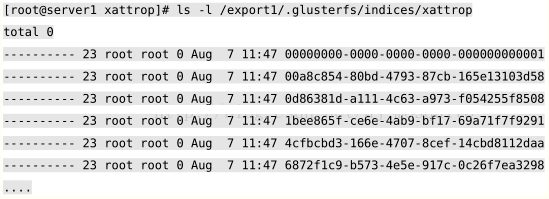
GlusterFS的自动文件副本(Automatic File Replication AFR)机制是实现Gluster故障恢复 , 自修复等高可用功能的基础。GlusterFS利用文件/目录的扩展属性存储元数据信息(以trusted.afr开头)文件写入流程(
from GlusterFS v3.7)一个完整的AFR Transaction下发
Write操作文件加锁
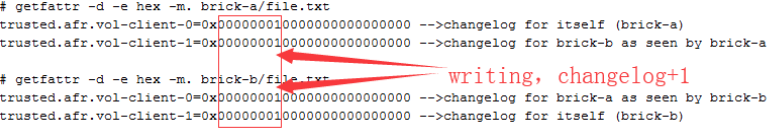
LockPre-op设置文件扩展属性,changelog+1文件写入
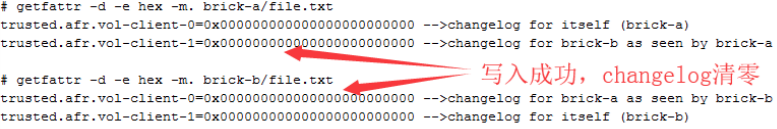
Post-op如果写入成功,changelog-1, 如果失败就保持此属性解锁
UnLock
扩展属性是由一个24位的十六进制数字构成 , 被分为三个8位十六进制段
1-8位是数据内容(data)changelog9-16位是元数据(metadata)changelog17-24位是目录项(entry)changelog
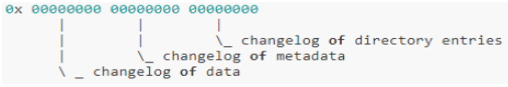
下面是两副本文件写入属性变化示意图:
Pre-OP前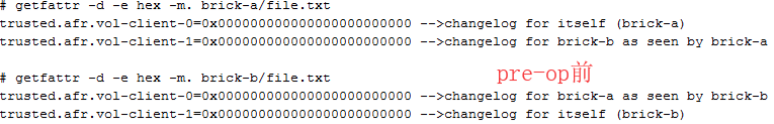
数据写入中
写入成功
副本b写入失败
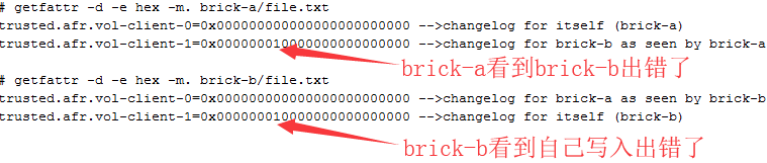
数据写入
Transaction完成后根据扩展属性changelog, 文件存在以下几种状态:WISE: 自身changelog全零 , 其他副本changelog非零INNOCENT: 自身和其他changelog全为零FOOL: 自身changelog非零IGNORANT:changelog丢失副本都为
WISE: 脑裂 典型场景:数据写入时 ,brick-x服务宕机(进程停止、网络断连、系统卡死…) , 一段时间之后又恢复
GlusterFS脑裂
如果文件写入后 , 不同副本
changelog都保持WISE状态(副本互相指责对方出现错误) , 这种情况即发生了脑裂(Brain Split)脑裂可能出现的典型场景(
replica 2为例)文件
X副本XA,XB分别位于svr1、svr2, 分别由proc-a和proc-b进程管理 , 若客户端对X的写入过程中svr1,svr2间网络中断 , 那么proc-a和proc-b将分别负责各自副本的写入但看到的对方都异常 , 当网络恢复即发生脑裂Svr1掉线 ,Svr2创建了一个文件 ,Svr2掉线 ,Svr1上线 ,Svr1创建了一个相同路径和名字的文件
读取脑裂的文件会出现
Input/Output Error因为
Changelog有三段 , 分别对应三种类型数据的状态 , 所以脑裂也有三种类型Data脑裂 – 副本之间数据内容不一致Metadata脑裂 – 副本之间元数据(文件权限 , 所属组 , 文件类型等)不一致Entry/GFID脑裂 – 副本之间GFID不一致(无法使用命令行方法修复 , 需要手工介入)
脑裂如何修复(
GlusterFS > 3.3)人工介入通过一定策略选择正确的副本在
GlusterFs集群节点上 , 通过命令行方式修复选择文件比较大的文件为正确副本
选择修改时间
mtime靠后的作为正确副本强制指定副本作为正确副本
在挂载点 , 通过命令修复
手工修复 https://docs.gluster.org/en/latest/Troubleshooting/resolving-splitbrain/
如何预防脑裂
Client-Quorum机制 , 采用3个副本 ,3个副本写成功2个才返回成功(存储成本上升)Arbiter Volume, 采用3个brick , 其中有一个特殊的副本仅存储元数据和目录结构信息
涉及到数据恢复,有如下几种场景:
所有文件都是
IGNORANT,这是手动触发了heal,也就是通过命令,这是怎么恢复呢,就找UID最小的文件作为源,去恢复大小为0的那些文件。有一个节点为
WISE,其他是FOOL,或其他非WISE的状态,那么就以WISE去恢复其他节点。好几个都是
WISE,就是好几个副本都说自己正常,同时还说别人不正常,这就是脑裂现象,这样就必须靠管理员手动找出脑裂的副本,自行判断哪些是对的哪些不对,自行恢复了,通常的做法留下一个对的副本,其他都删除,同样还要删除/<BRICK>/.glusters这个目录下对应的文件,这样就只有一个WISE副本了,再出发heal,就以这个为源恢复所有副本了,触发命令为gluster volume heal <VOLMUENAME> full,这里的full是一种自愈方式,全部恢复文件,另一种自愈方式叫diff,是差异化恢复。
通常脑裂的文件时读不出来的,读写它时会报Input/Output error,查看日志/var/log/glusterfs/glustershd.log你会有收获:
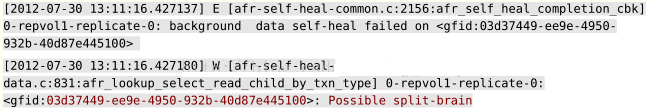
要找到脑裂文件,还有一个命令可以用,gluster volume heal <VOLMUENAME> info split-brain,它的输出如下:
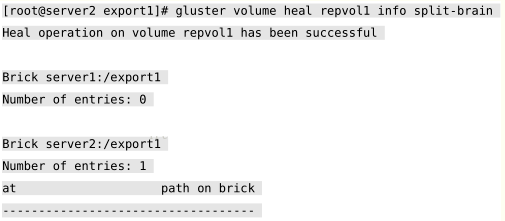
正常情况下,所有brick的entries都是0,这里同一个副本一个是1一个是0,就是不对劲了,通过此方法找到脑裂的文件,再按上面的方法删除也可以。
参考链接
GlusterFS的数据分布(DHT)和文件副本(AFR)机制-腾讯云开发者社区-腾讯云
GlusterFS分布式存储数据的恢复机制(AFR)的说明 - 散尽浮华 - 博客园